论文
我的论文与在研工作,附研究简介和已公开的代码。
显示 5 篇论文
Hybrid Computer Use: A Unified Programmatic, Semantic, and Visual Interface for General Agents
Haoqing Wang, Xiaoyi Zhang†, Sicheng Fan, Zhexin Zhang, Xinjie Zhang, Jiahao Li, Bin Li, Yan Lu
arXiv 预印本 arXiv:2610.41432 · 2026
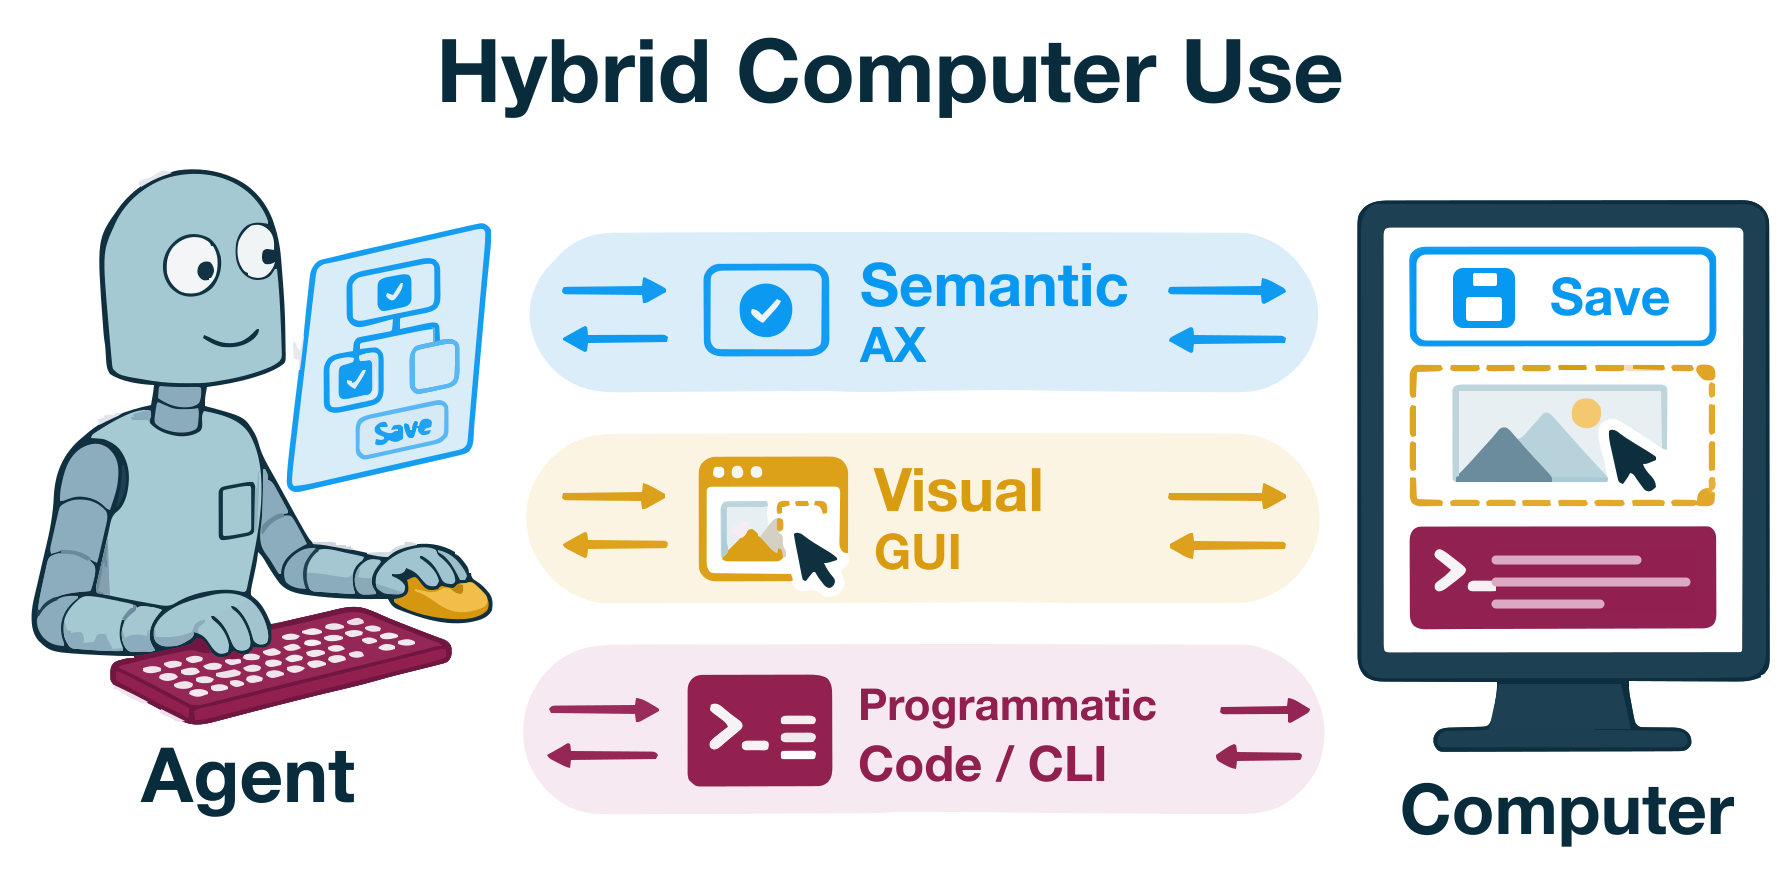
探索 Hybrid Computer Use:为通用 Agent 提供统一的计算机交互接口,让模型自主选择和组合编程(代码与 CLI)、语义(AX)和视觉(GUI)三种通道。
Computer Use Agent 需要完成日常桌面任务和长程专业工作流。以截图和鼠标键盘为中心的接口需要模型反复理解画面,却未充分利用计算机的语义与编程能力。Hybrid Computer Use(HCU)为通用 Agent 统一提供三种互补的交互通道:代码与 CLI 等编程工具、通过无障碍接口(AX)访问控件的语义交互,以及通过图形界面(GUI)完成的视觉交互。HCU 通过 MCP 在 Agent 已有工具之外加入 AX 和 GUI 工具,由模型自主选择和组合通道。AX 工具提供紧凑观察,支持附带后置条件的批量操作,并以 AX 差分返回操作结果。跨通道操作保护会在输入前对照实时状态检查目标与布局,减少依据过期观察执行操作的问题。配套技能说明工具用法和通道协作方式。在 OSWorld 2.0 上,HCU 在对比系统中取得最高的 Partial 和 Binary 分数。轨迹分析显示,所有被评测模型使用 HCU 后均有提升,但各模型分配通道工作的方式不同。
@article{hcu2026,
  title = {Hybrid Computer Use: A Unified Programmatic, Semantic, and Visual Interface for General Agents},
  author = {Haoqing Wang and Xiaoyi Zhang and Sicheng Fan and Zhexin Zhang and Xinjie Zhang and Jiahao Li and Bin Li and Yan Lu},
  year = {2026},
  month = {oct},
  journal = {arXiv preprint arXiv:2610.41432},
  doi = {10.48550/arXiv.2610.41432},
  url = {https://arxiv.org/abs/2610.41432}
}
Mage-VL-Cowork: A Full Training Recipe to Learn Hybrid Computer Use from Evolved Harnesses
Xiaoyi Zhang*†, Haoqing Wang*, Xinjie Zhang, Xiang Ming, Xing Wang, Senqiao Yang, Kaichen Zhang, Zhaoyang Jia, Andong Tan, Xinjiang Wang, Jinghao Guo, Yifei Shen, Xiao Li, Peng Zhang, Xun Guo, Jiahao Li, Shicheng Zheng, Jinglu Wang, Zongyu Guo, Wenxuan Xie, Bin Li, Yan Lu,以及
技术报告 · 2026
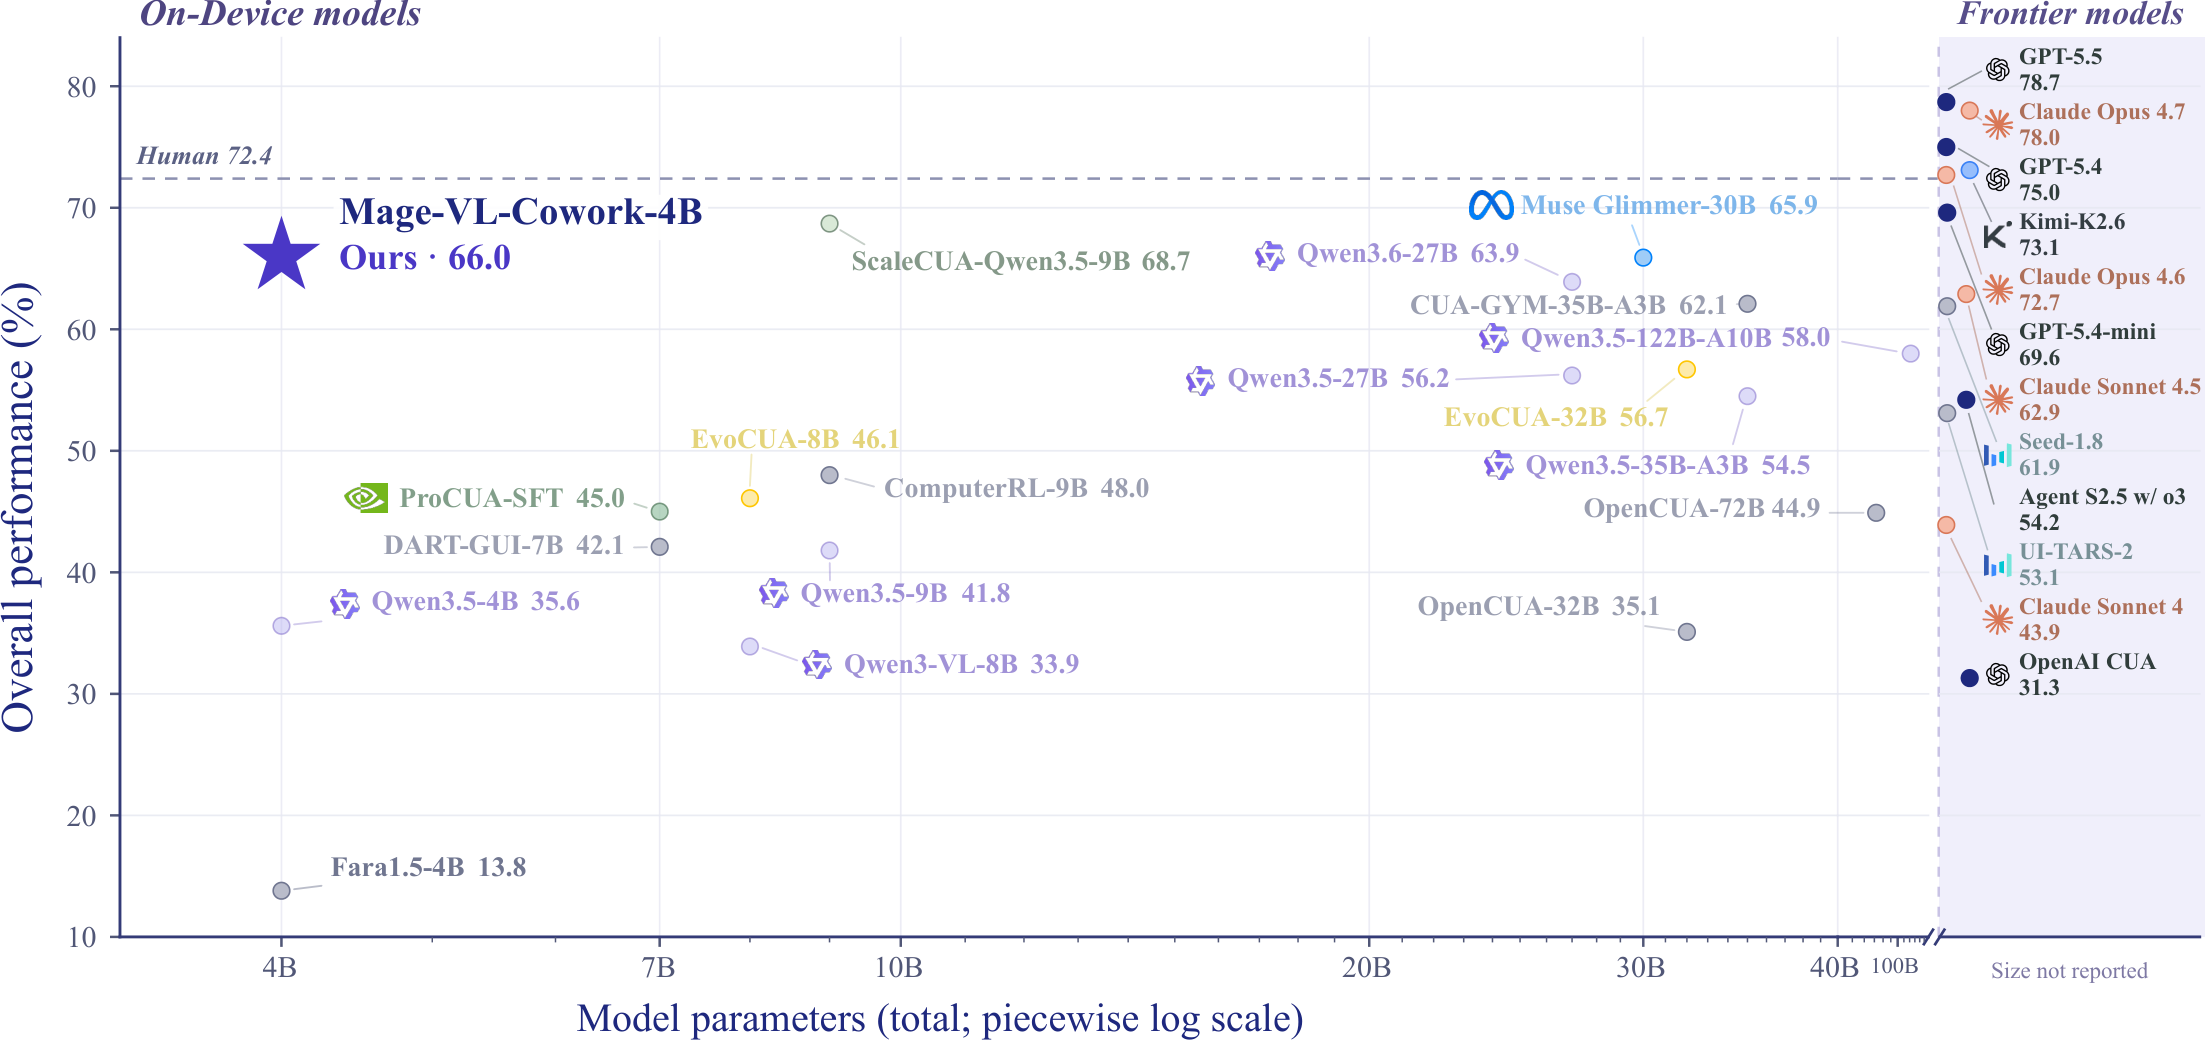
一个 4B 混合 Computer Use Agent,在单一策略中结合 GUI 交互与代码、终端执行,在 50 步预算下于 OSWorld-Verified 取得 66.0%。
有效的 Computer Use Agent 应在单一策略中结合视觉 GUI 交互与代码、终端执行。Mage-VL-Cowork 是一个 4B 混合 Computer Use Agent,从通用多模态对齐检查点出发,经过中期训练、SFT 和 RL 共五个阶段训练。Mage-CUA-Forge 使用可复用、以技能为条件的生成工作流和应用专用准备器,取代逐个任务构造的 Agent 流程。它在 6,915 个技能上合成 293,806 个桌面与网页任务,并将每个任务的重复生成成本降低 82.6%。研究先演化教师 harness,再用专门的 harness 生成高质量轨迹和分阶段监督。Mage-VL-Cowork-4B 在 OSWorld-Verified 上达到 66.0%,推理成本更低,是同参数规模下报告的最佳结果。

Mage-VL: An Efficient Codec-Native Streaming Multimodal Foundation Model
Senqiao Yang*, Kaichen Zhang*, Zhaoyang Jia*, Jinghao Guo*, Yifei Shen*†, Xinjie Zhang*†, Xiaoyi Zhang, Haoqing Wang, Xiao Li, Peng Zhang, Xiang An, Yin Xie, Zhening Liu, Xun Guo, Jiahao Li, Shicheng Zheng, Jinglu Wang, Zongyu Guo, Wenxuan Xie, Zihan Zheng, Yuxuan Luo, Bin Li, Yan Lu,以及
arXiv 预印本 arXiv:2607.24904 · 2026
一种高效的编解码原生流式多模态基础模型,将视觉 Token 用量减少 75% 以上,推理实际耗时最高加速 3.5 倍。
标准视觉语言模型(VLM)面临莫拉维克悖论:它们擅长复杂的离线视觉推理,却难以高效完成简单的流式感知任务。Mage-VL 是一种面向实时多模态理解与交互的高效编解码原生流式基础模型。其视觉编码器 Mage-ViT 利用稀疏锚帧(I 帧)和预测帧(P 帧)之间的运动矢量与残差能量,选择性地编码动态且信息丰富的区域,取代均匀帧采样。该方法以 16 × 16 图像块为单位,在保留时空上下文的同时,将视觉 Token 用量减少 75% 以上。Mage-ViT 从零开始在约 5.6 亿张无标注图像和 1 亿帧无标注视频上训练,性能达到或超过使用数十亿图文对训练的主流编码器。研究还构建了 AI4AI 数据流程,通过提示词与代码联合优化多模态描述,并利用 AI 驱动的性能诊断指导训练方案。受生物机制启发,模型结合轻量的 System 1 事件门控与因果 System 2 解码器,支持主动流式感知。实验显示,Mage-VL-4B 在静态任务上与 Qwen3-VL-4B 相当,在视频理解和二维、三维空间推理上取得提升,推理实际耗时最高加速 3.5 倍,并全面超过 15B 的 Phi-4-reasoning-vision 基线。研究同时给出了七项经验发现,涉及预训练数据效率、可变分辨率扩展、编解码系统加速、VideoQA 监督微调冗余、运动与空间协同、AI4AI 数据流程,以及用于多模态强化学习的 Zero-Vision 监督微调。
@article{yang2026magevl,
  title = {Mage-VL: An Efficient Codec-Native Streaming Multimodal Foundation Model},
  author = {Senqiao Yang and Kaichen Zhang and Zhaoyang Jia and Jinghao Guo and Yifei Shen and Xinjie Zhang and Xiaoyi Zhang and Haoqing Wang and Xiao Li and Peng Zhang and Xiang An and Yin Xie and Zhening Liu and Xun Guo and Jiahao Li and Shicheng Zheng and Jinglu Wang and Zongyu Guo and Wenxuan Xie and Zihan Zheng and Yuxuan Luo and Bin Li and Yan Lu},
  year = {2026},
  month = {jul},
  journal = {arXiv preprint arXiv:2607.24904},
  doi = {10.48550/arXiv.2607.24904},
  url = {https://arxiv.org/abs/2607.24904}
}Learning to Respond: A Large-Scale Benchmark and Progressive Learning Framework for Trigger-Centric Online Video Understanding
Jiawen Qian*, Hang Du*, Guoshun Nan, Shan Huang, Jiaqi Yu, Haoqing Wang, Jingfeng Chen, Mengxue Cai, Mengdi Yang, Jiarong Li, Zhilong Li, Hua Wang, Jun Liu, Xudong Jiang, Sicong Leng†,以及
审稿中 · 2025
面向触发时机的在线视频理解,构建大规模基准 TV-Online 与渐进式学习框架。
在线视频平台的快速发展带来了实时视频理解的需求。与离线任务不同,在线视频理解强调主动响应:模型需要识别视频流中何时出现了足以回答问题的证据,并立即作答。研究提出 TV-Online(Trigger Video-Online)数据集,包含 5 万段视频、20 万个问题和 50 万条带时间戳的答案,覆盖逐步增加复杂度的触发式任务。研究还提出面向流式输入的建模范式,结合协议层标签与结构化状态管理。模型利用难度标注和强化学习目标逐步训练。最后,研究引入统一评测指标,综合衡量语义、时间和覆盖程度。
@unpublished{qian2025learningToRespond,
  title = {Learning to Respond: A Large-Scale Benchmark and Progressive Learning Framework for Trigger-Centric Online Video Understanding},
  author = {Jiawen Qian and Hang Du and Guoshun Nan and Shan Huang and Jiaqi Yu and Haoqing Wang and Jingfeng Chen and Mengxue Cai and Mengdi Yang and Jiarong Li and Zhilong Li and Hua Wang and Jun Liu and Xudong Jiang and Sicong Leng},
  year = {2025},
  month = {sep},
  booktitle = {Under review}
}