Self-Evolving Agents 2026
课程导读:自进化 Agent 究竟在进化什么
这组报告并不把“自进化”限制为继续微调模型权重,而是把 Agent 看成一个由模型、环境、经验、记忆、工具、验证器、训练基础设施和治理机制共同组成的系统。系统只要能把交互产生的新信息沉淀到后续决策中,就已经具备某种跨时间改进能力;区别只在于被更新的是参数、提示、记忆、技能、环境课程,还是整个 Agent harness。
贯穿九讲的统一闭环
可以把课程中的方法统一写成:提出任务或问题 \(\rightarrow\) 与环境交互 \(\rightarrow\) 获取可验证反馈 \(\rightarrow\) 诊断失败模式 \(\rightarrow\) 更新策略、经验或环境 \(\rightarrow\) 进入下一轮交互。各讲的分歧主要发生在“环境从哪里来”“反馈是否可信”“更新什么状态”和“如何防止错误经验累积”四个位置。
四个分析维度
读每一讲时都应追踪四个问题。第一,evolution target:究竟更新模型参数、上下文、长期记忆、工具链、任务分布还是环境本身。第二,feedback source:反馈来自规则验证器、人类偏好、执行结果、世界模型、对手 Agent 还是市场与用户行为。第三,credit assignment:长轨迹中的成功或失败应归因到哪一步。第四,safety boundary:系统如何避免把偶然成功、奖励漏洞和错误自我评价固化为新策略。
为什么要把这组研讨会整理成一门课
九个单元分别从 causal world model、Agentic RL、失败预见、环境合成、经验学习、外部化、统一理论和产业实践切入。单看任何一场都容易把自进化误解为某个算法名;按课程顺序阅读,才能看到它实际上是一套跨越学习理论、数据工程、系统基础设施和产品闭环的系统设计问题。
课程路线图
| 讲次 | 核心问题 | 主要机制 | 与课程主线的关系 |
|---|---|---|---|
| 1 | Agent 如何理解开放世界 | causal world model、主动干预、meta-causal graph | 给自进化提供可解释的环境模型 |
| 2 | 如何规模化产生 Agent experience | rollout infrastructure、并行环境、经验递归利用 | 把交互经验变成可训练资源 |
| 3 | 为什么 foresight 会失败 | world model 失配、显式训练、curriculum generation | 从失败诊断转向有目标的改进 |
| 4 | Agent 与环境如何协同进化 | 环境发现、任务合成、可验证奖励、Agentic RL | 同时扩展训练环境与策略能力 |
| 5 | 上午场方法如何互补 | 因果、经验、奖励与环境的边界 | 暴露研究假设和实践冲突 |
| 6 | Context 如何从工程变成学习 | experience intelligence、个性化、context learning | 把部署期交互变成长期能力 |
| 7 | 为什么要把能力外部化 | memory、tool、artifact、workflow externalization | 降低只靠参数更新的成本与风险 |
| 8 | Agent 是否需要统一理论 | interaction、state、tool use 与 intelligence boundary | 尝试定义机器智能的“下半场” |
| 9 | 如何落地并持续治理 | 产品反馈、个性化、评测、组织与商业约束 | 把研究闭环映射到真实用户系统 |
不要把“自进化”自动等同于更强
如果反馈不可验证、环境分布过窄、记忆没有遗忘机制,或评估器与被评估策略共同漂移,系统完全可能越学越偏。课程中所有漂亮的闭环图都必须进一步追问:谁定义成功、失败能否复现、更新是否可回滚、旧能力是否被破坏。
因果世界理解:开放世界中的 Self-Improving Agent
杨梦月的报告从一个比“如何训练更强策略”更基础的问题出发:Agent 如果连环境为什么变化都不理解,所谓自我改进很可能只是在重复奖励较高的轨迹。开放世界中的状态、任务和规律会不断扩展,单靠记忆过去的成功动作无法保证迁移;系统需要形成一个可以被干预、被反驳并持续修正的 causal world model。
本章中心命题
稳定的自我改进不只需要预测未来,还需要回答“如果采取另一个动作会怎样”“观察到的相关性是否由隐藏条件造成”“当前规律在什么 context 下会失效”。这正是因果表示相对于纯关联预测的增量价值。
从 Agent decision making 到 world model
先把 Agent 抽象为一个闭环:环境产生 observation,Agent 从 observation 推断 state,根据目标选择 action,环境执行动作并返回新的 observation 与反馈。这里的 state 不是画面本身,而是对位置、对象、属性和关系等潜在变量的压缩描述;policy 则把当前信息映射为动作分布。
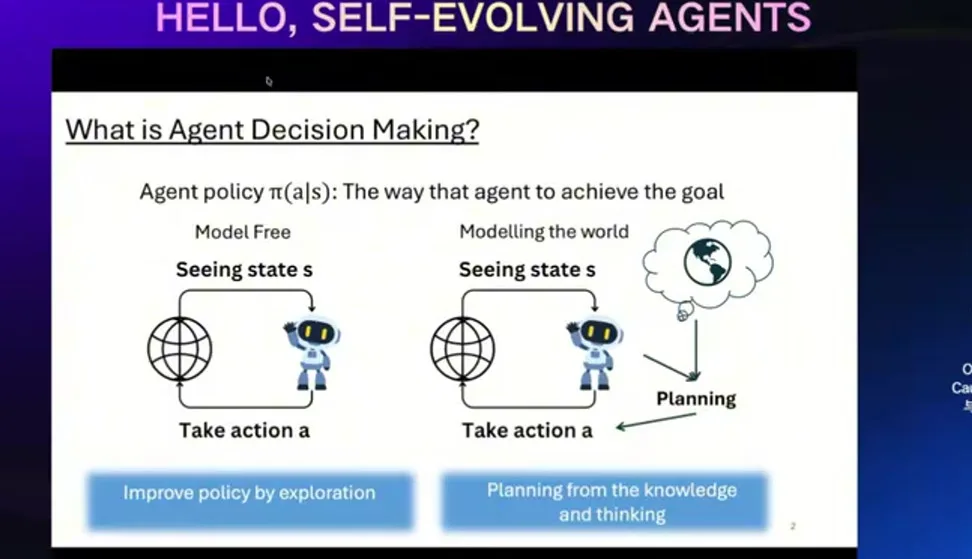
来源:视频讲解区间:00:01:15–00:04:00。
Model-free 与 model-based 的差别
Model-free 方法直接从轨迹回报更新 policy,不显式预测环境转移;model-based 方法学习一个近似的状态转移模型 \(\hat P(s_{t+1}\mid s_t,a_t)\),再用它进行规划、想象 rollout 或风险估计。两者不是互斥标签:现代 Agent 常用模型生成候选计划,再用真实执行反馈校正策略。
为什么开放世界更依赖 world model?在固定迷宫里,状态空间有限,反复试错最终可能覆盖关键路径;但现实环境无法穷举,任务会变化,动作还可能产生不可逆后果。老师强调,语言模型做数学推理也有类似问题:如果基础模型在当前问题分布上几乎采不到正确轨迹,仅仅扩大 rollout 次数并不能保证找到解,系统需要利用结构知识缩小搜索空间。
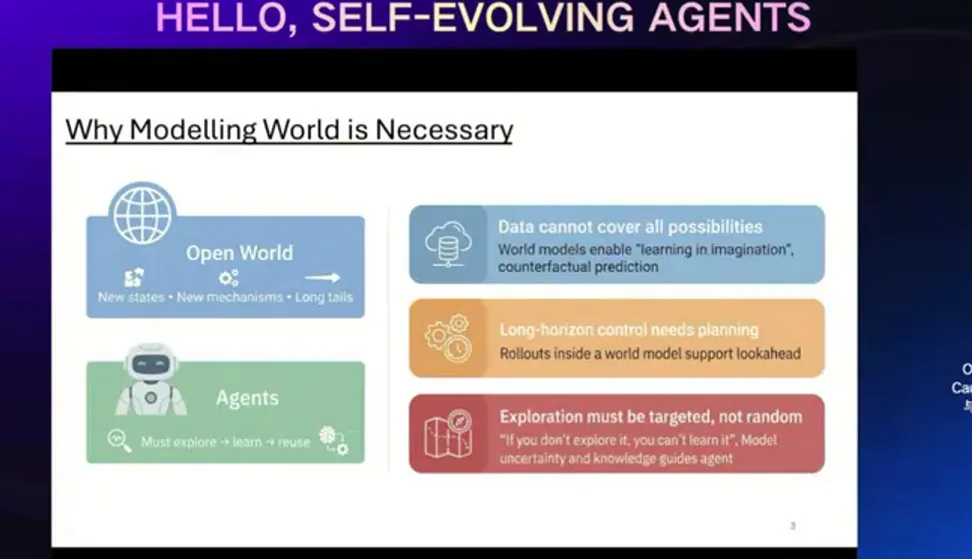
来源:视频讲解区间:00:04:00–00:07:15。
预测不等于理解:Pearl 因果层级
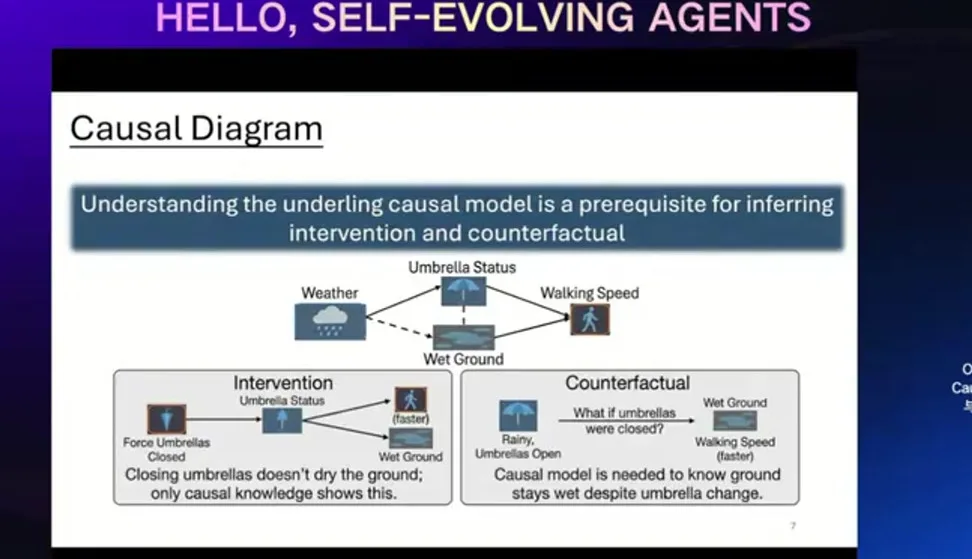
一个能够预测下一帧的模型,未必理解动作造成了什么。报告借用 Pearl's causal hierarchy 区分三层能力:association 回答“观察到什么”,intervention 回答“主动做某事会发生什么”,counterfactual 回答“已经发生的结果如果换一个动作会怎样”。三层分别对应条件分布、干预分布和个体层面的反事实推断。
其中 \(do(X=x)\) 表示外部把变量 \(X\) 设置为 \(x\),切断原有父节点对 \(X\) 的影响;\(Y_{x'}\) 表示在同一个体上假设执行另一个干预 \(x'\) 时的潜在结果。因果问题难就难在后两类分布通常不能只靠被动观测直接识别。
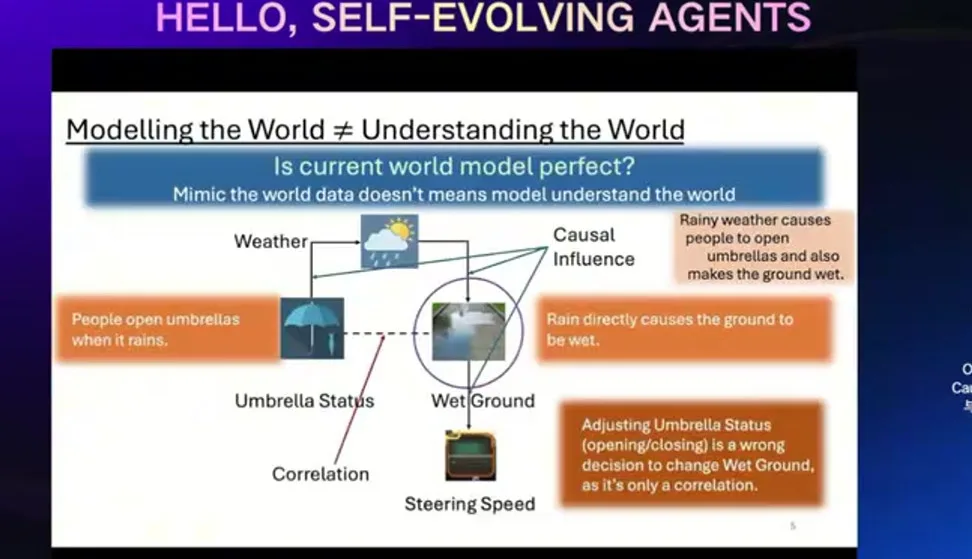
来源:视频讲解区间:00:08:15–00:10:15。
高预测精度不能自动推出因果正确
模型可能利用背景纹理、数据采集流程或共同原因做出准确预测,但一旦 Agent 主动改变环境,这些相关性就会失效。部署到可交互环境时,必须单独检查 intervention 与 counterfactual 能力,不能把离线 prediction accuracy 当作充分证据。
报告中的 causal diagram 用有向图表达变量间的生成关系。若 \(Z\) 同时影响 \(X\) 与 \(Y\),则仅观察 \(X\) 和 \(Y\) 会产生混杂;若 Agent 能干预 \(X\) 并保持其他条件可控,就能更直接地判断 \(X\rightarrow Y\)。这种结构使 world model 不只是黑箱模拟器,还能解释哪些机制应在环境变化后保持稳定。
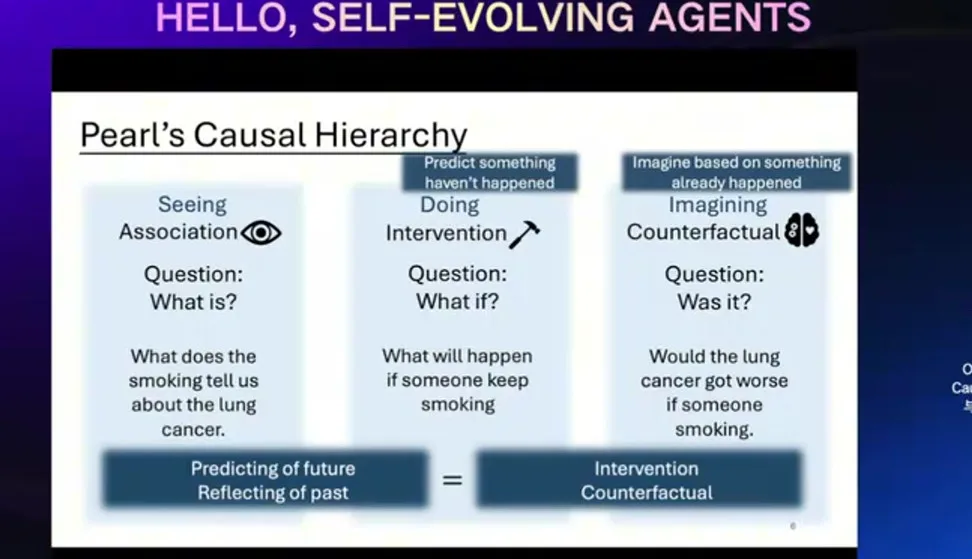
来源:视频讲解区间:00:10:15–00:13:30。
Causal world model 如何进入 Agent 闭环
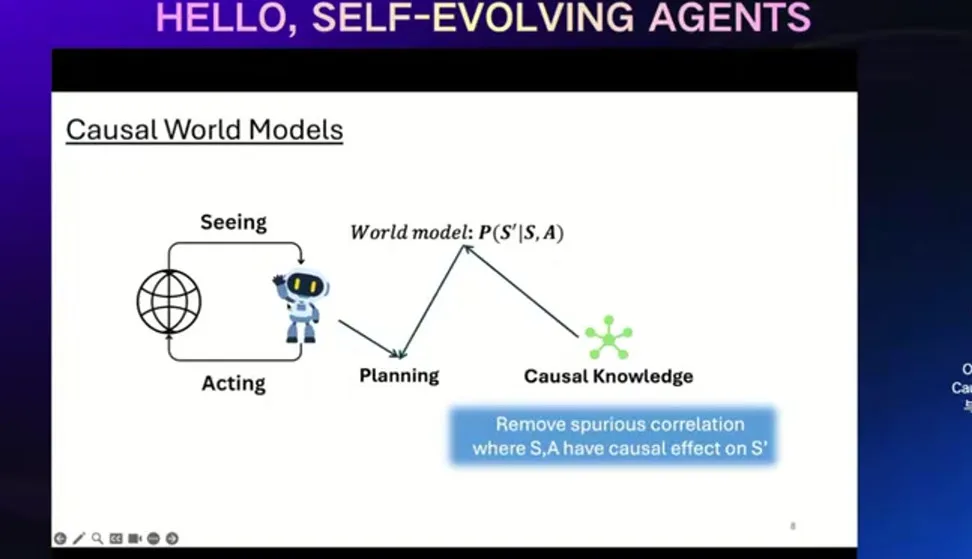
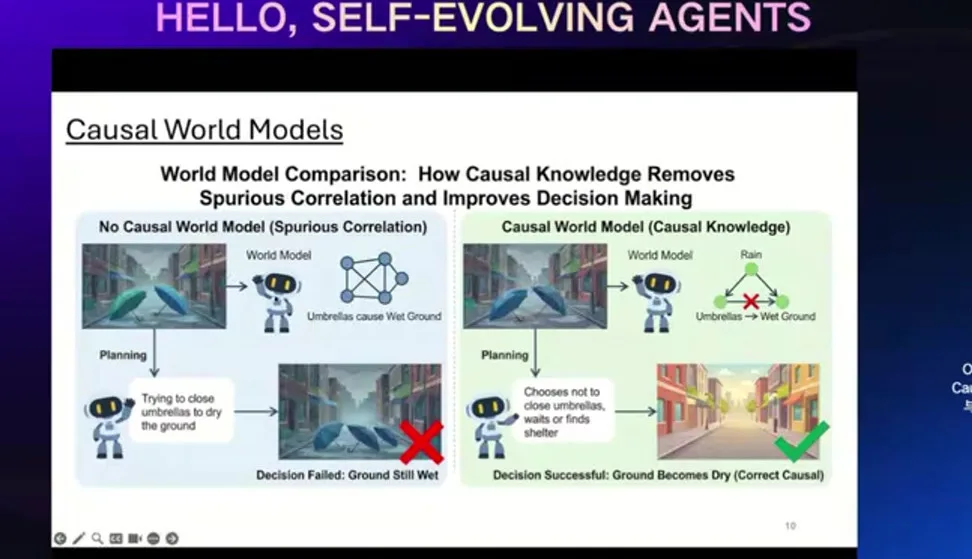
普通 world model 重点拟合 observation 或 state 的转移;causal world model 进一步显式表示 action、环境变量和结果之间的结构。规划器可以先在模型中比较多个 intervention,再选择真实执行成本最低、信息增益最高或最可能完成目标的动作。
来源:视频讲解区间:00:13:30–00:14:00。
来源:视频讲解区间:00:14:00–00:14:45。
如果把环境动力学写成结构因果模型,可以表示为
其中 \(s_{t+1}^{(i)}\) 是下一时刻第 \(i\) 个状态变量,\(\mathrm{pa}_i(s_t)\) 是因果图中它的父变量,\(a_t\) 是 Agent 动作,\(u_t^{(i)}\) 是未观测噪声。相比直接学习一个大函数 \(s_{t+1}=F(s_t,a_t)\),结构化分解允许系统在局部机制变化时只更新受影响的部分。
课堂提示:因果模型的价值是约束搜索
老师并没有宣称所有 Agent 都必须恢复“真实世界唯一因果图”。工程上更现实的目标是得到足以支持当前干预和迁移的局部结构:它能排除明显无效动作、指出需要收集什么数据,并在预测失败时提供可诊断的机制单元。
来源:视频讲解区间:00:15:30–00:16:15。
开放世界的真正难点:规律会随 context 显现为“漂移”
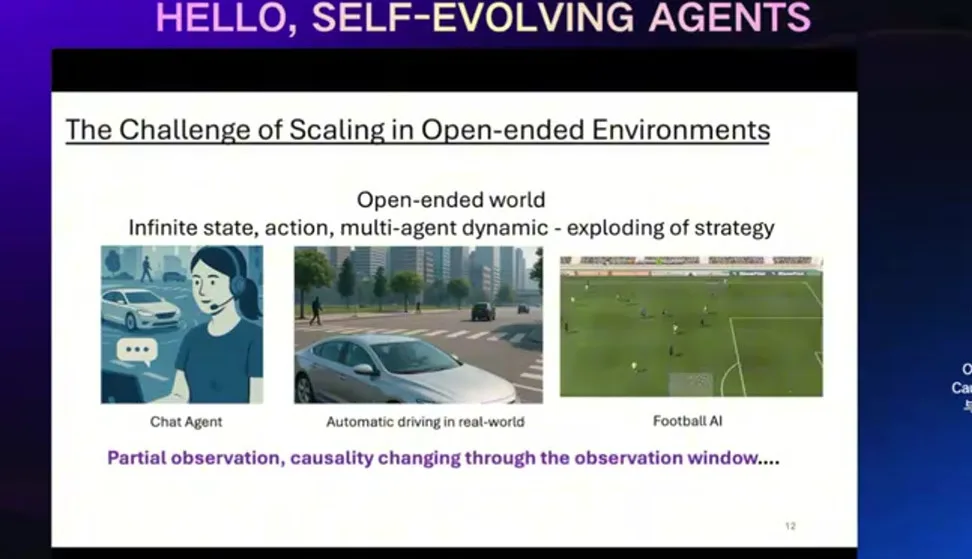
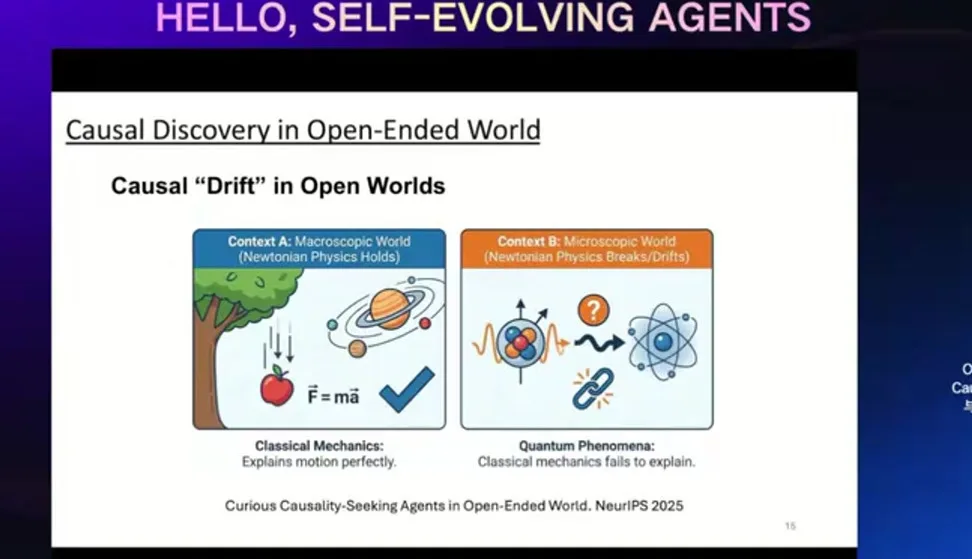
传统 causal discovery 常假设数据来自固定机制,但开放世界会不断暴露新的对象、尺度和条件。报告用经典力学与微观现象作类比:在有限 observation window 内,Agent 可能误以为一套规律普遍成立;当窗口扩展后,旧规律并非完全错误,而是只在特定 context 中有效。
来源:视频讲解区间:00:17:15–00:19:30。
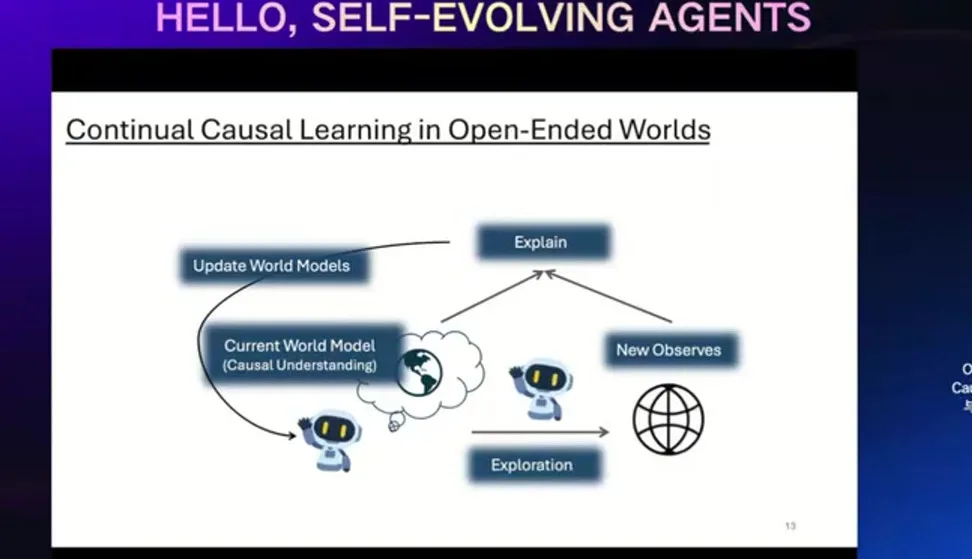
来源:视频讲解区间:00:19:30–00:21:15。
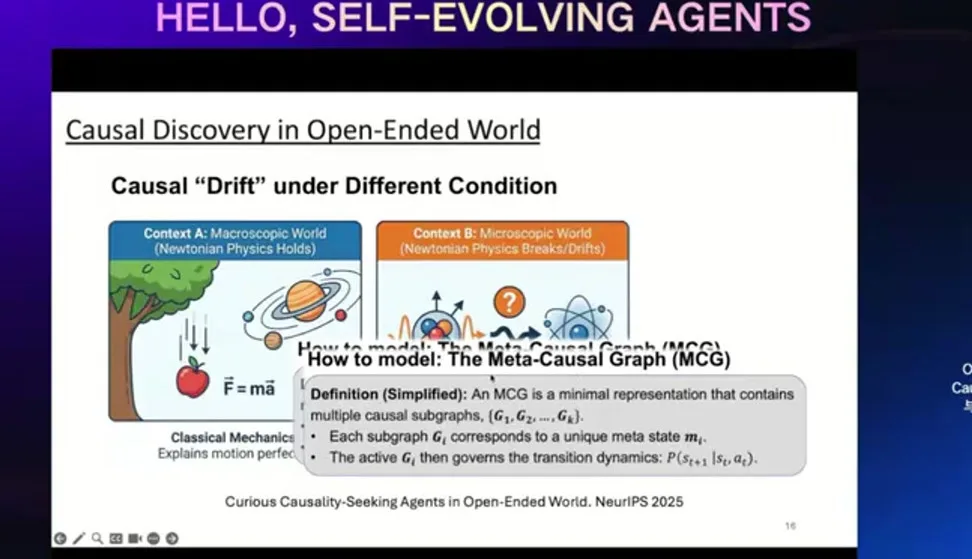
这意味着 self-improving Agent 不能只在误差变大时重新拟合全部模型,而要先判断:是噪声增加、观测变量缺失、机制参数变化,还是出现了一个决定机制切换的 meta-state。若把 context 记为 \(c\),更合适的形式是
并让 Agent 主动寻找能解释机制切换的 \(c\)。这类变量可能是“门是否上锁”“对象材料”“用户当前目标”或“工具权限”。
不要把所有分布变化都叫 causal drift
输入频率变化不一定意味着结构因果机制改变;传感器噪声、采样偏差和策略自身改变也会造成分布漂移。更新因果图前,应先区分 observation shift、policy-induced shift 与 mechanism shift,否则 Agent 会把自己的探索行为误判为世界规律变化。
来源:视频讲解区间:00:21:15–00:21:30。
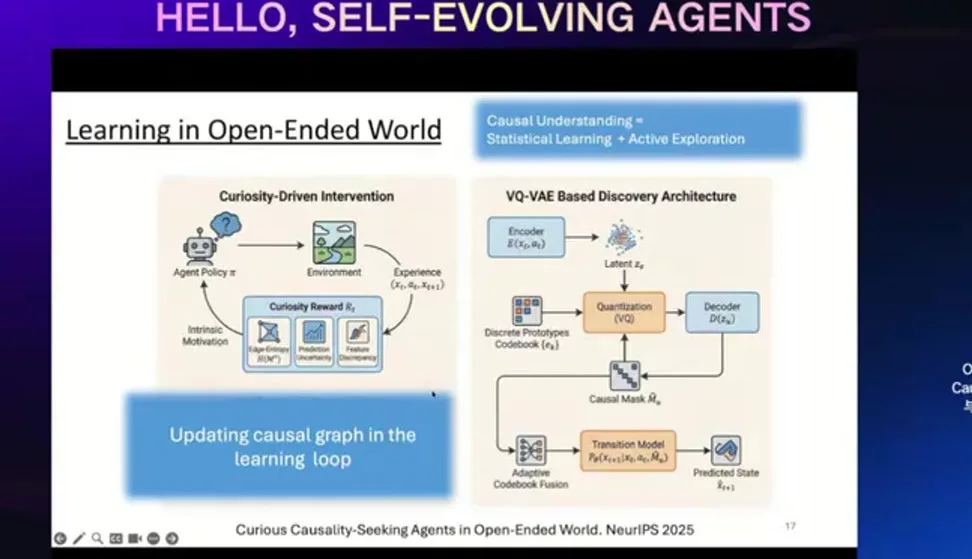
Curious Causality-Seeking Agent:主动寻找反例
报告介绍的 Curious Causality-Seeking Agent 不满足于在已有数据上拟合图,而是选择能最大化因果信息的 intervention。核心直觉是:如果当前模型对多个因果假设都能解释被动数据,就应主动执行能让这些假设产生不同预测的动作。
来源:视频讲解区间:00:21:30–00:22:45。
来源:视频讲解区间:00:22:45–00:24:00。
可以把候选干预 \(a\) 的选择抽象为最大化期望信息增益:
其中 \(G\) 是候选因果图,\(D\) 是已有数据,\(H\) 是熵。动作的价值不是立即获得任务奖励,而是减少对机制结构的不确定性。这个思想把 exploration 从“随机尝试更多状态”升级为“有目的地区分模型”。
自我改进中的双层目标
Agent 同时优化任务回报与模型可信度。只追求短期 reward 会反复利用当前已知策略;只追求信息增益又可能沉迷无关探索。实用系统需要在 exploitation、epistemic exploration 和安全成本之间做动态权衡。
来源:视频讲解区间:00:24:00–00:24:15。
从 causal learning 回到 LLM Agent
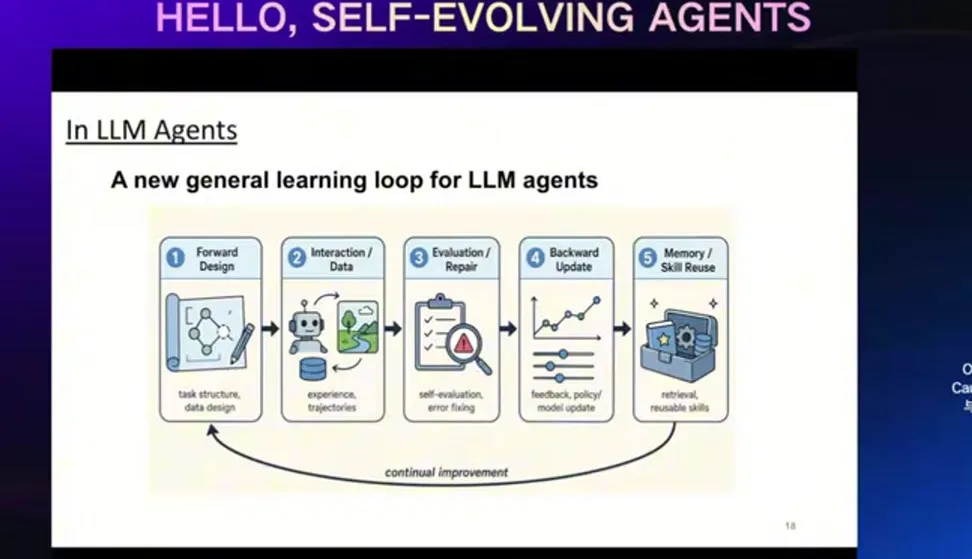
后半段把上述框架映射到 LLM Agent:语言模型提出问题、计划或工具调用,环境返回可验证结果,系统再从成功与失败轨迹中更新。这里的“更新”既可以是参数训练,也可以是修订 prompt、memory、tool schema、奖励函数或任务生成器。
来源:视频讲解区间:00:24:15–00:28:15。
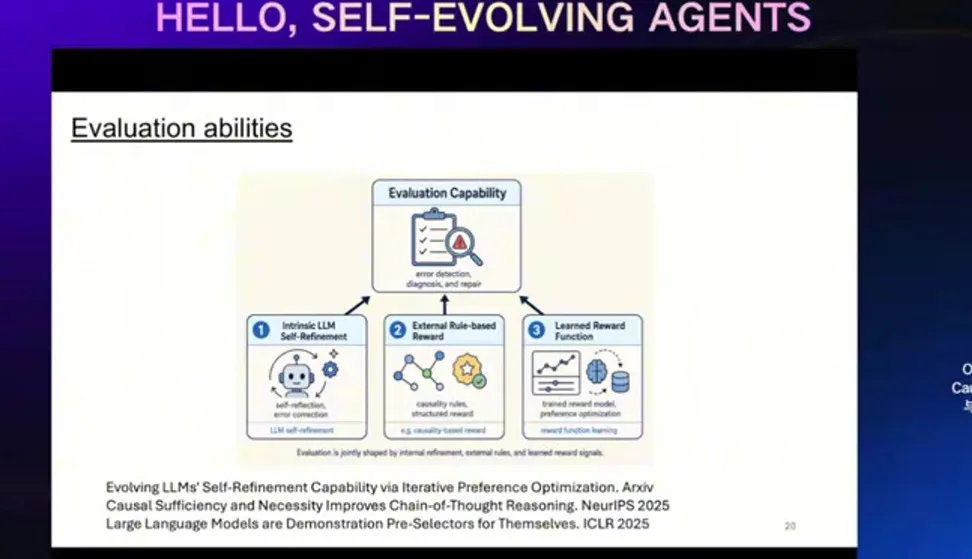
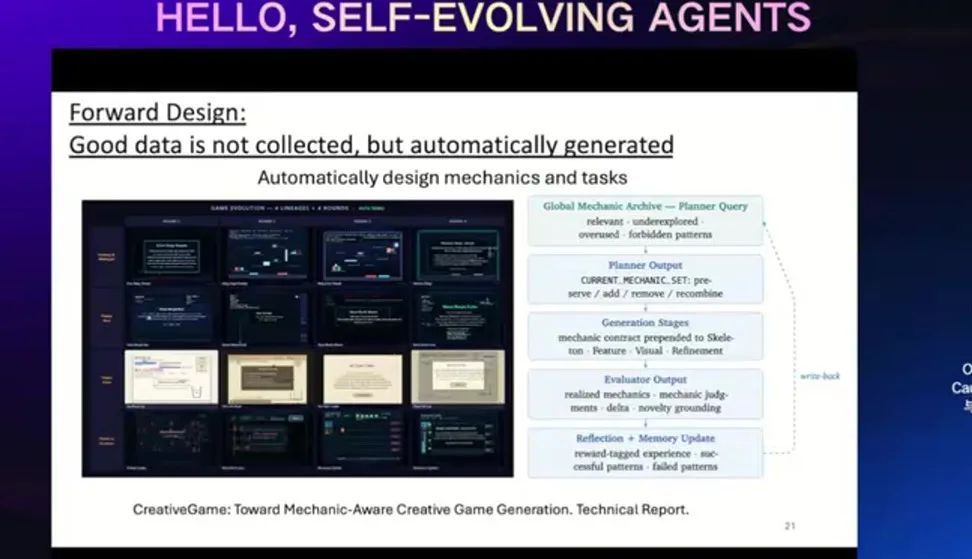
报告把闭环拆成三类能力。Evaluation ability 判断结果是否正确、失败发生在哪里;forward design 生成有价值的新任务、新环境或新组合;backward update 把 reward 与轨迹转化为可迁移的策略变化。缺少任一环节都会让 self-improvement 停留在口号:没有评估就不知道进步,没有新任务就会过拟合已有 benchmark,没有稳定更新则经验无法沉淀。
来源:视频讲解区间:00:28:15–00:28:45。
来源:视频讲解区间:00:28:45–00:29:15。
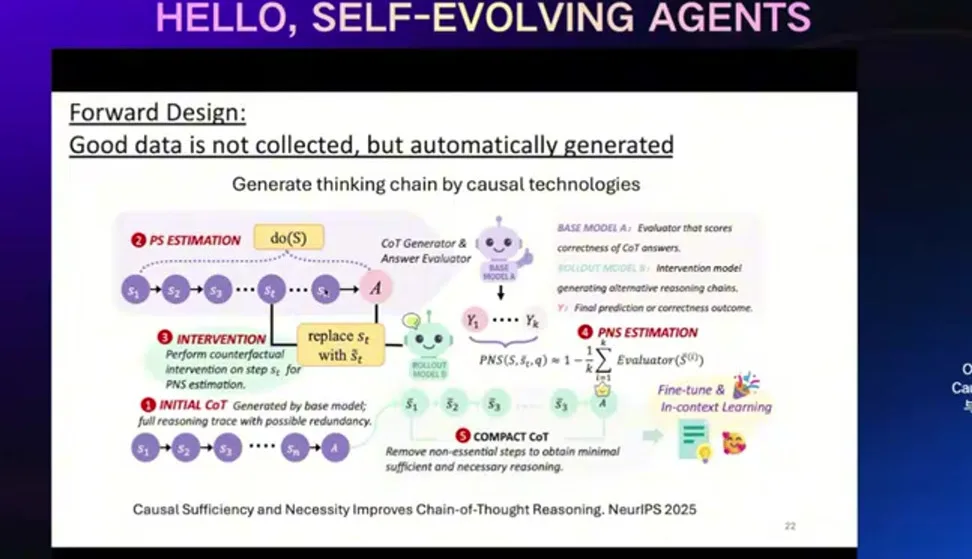
来源:视频讲解区间:00:29:15–00:29:45。
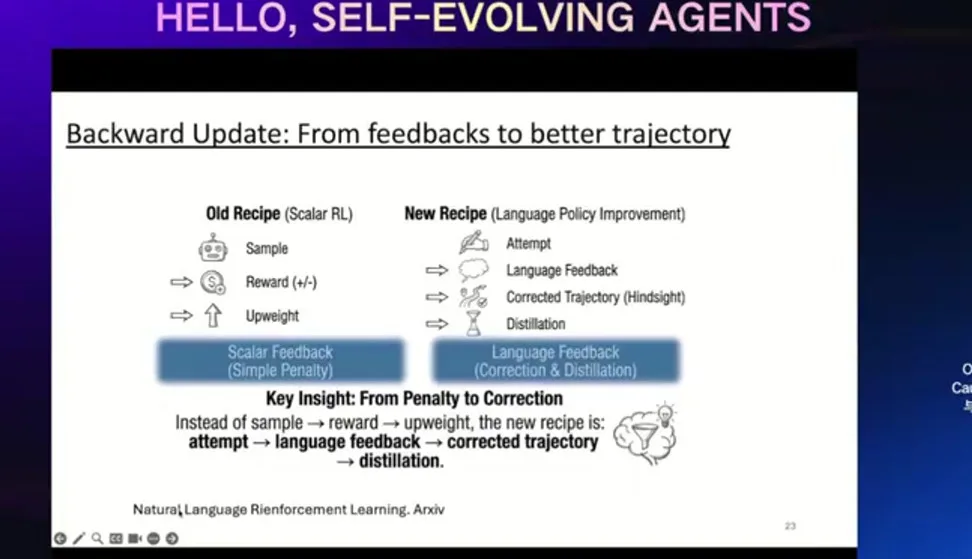
来源:视频讲解区间:00:29:45–00:30:00。
老师强调:好数据不是“自动生成”就够了
自动任务生成只有在任务可验证、难度覆盖合理、能暴露当前策略弱点时才有价值。否则模型可能批量生成自己擅长的问题,再用自己的评估器确认自己进步,形成封闭的自我强化幻觉。
本章小结
本章把 self-improving Agent 的基础从“更多 rollout”推进到“更好的世界理解”。因果模型提供 intervention 与 counterfactual 语义,meta-causal graph 处理 context 相关机制,主动探索寻找能区分假设的反例;这些能力最终服务于 LLM Agent 的 evaluation、forward design 与 backward update 闭环。
实践检查表
- 明确系统当前学习的是 correlation、intervention effect 还是 counterfactual explanation;
- 把环境变化拆成观测漂移、策略诱导漂移和机制漂移;
- 记录每次模型更新适用的 context 与证据,不把局部规律写成全局规则;
- 为探索动作设置真实成本、安全边界和停止条件;
- 使用外部可验证信号评估自我生成任务,避免模型同时垄断出题、答题与判分。
递归自学习与可扩展 Agent Experience
张少坤的报告把 self-evolving Agent 拆成两个必须同时满足的条件:一是系统能递归地改进自己的可学习组件,二是训练数据来自当前 Agent 与环境的 on-policy 交互,而不是无差别地复制别的模型轨迹。前半段用 AgentOptimizer 说明 harness 也可以成为优化对象;后半段用 ProRL Agent Server 讨论如何把大规模 rollout 变成可复用基础设施。
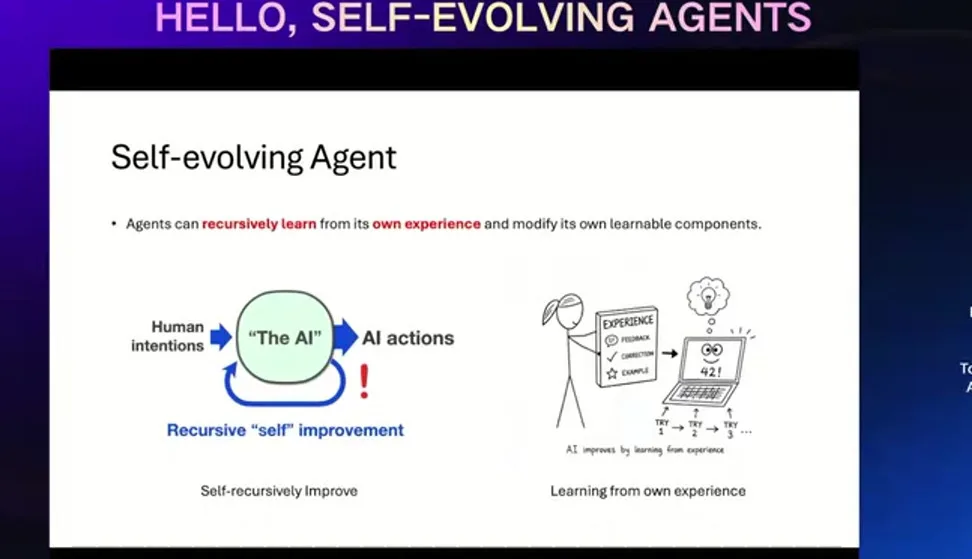
来源:视频讲解区间:00:01:30–00:03:45。
为什么必须强调 own experience
同一批离线轨迹对不同 Agent 的学习价值并不相同:有些样本已经过于简单,有些又远超当前能力。On-policy experience 会自然暴露当前策略的薄弱点,并形成随能力变化的 curriculum;这也是 Agentic RL 相比静态 imitation data 的核心吸引力。
Agent 不只有 model,还有 harness
报告把现代 Agent 写成 \(\text{Agent}=\text{Model}+\text{Harness}\)。Model 提供语言、推理和决策能力;harness 则包含 system prompt、tool schema、memory、workflow、观察压缩、错误恢复和调用模型的控制逻辑。即使底座模型相同,不同 harness 也会产生完全不同的轨迹分布。
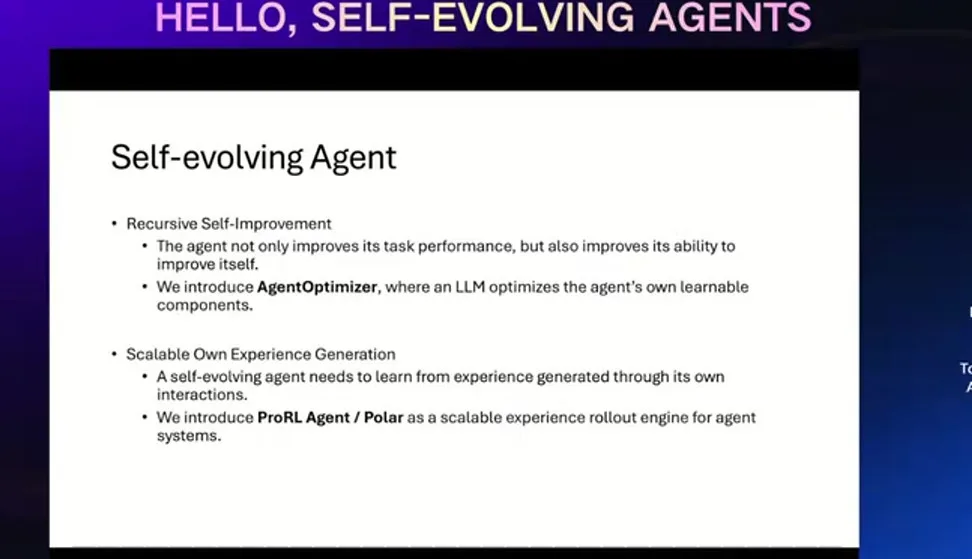
来源:视频讲解区间:00:03:45–00:05:15。
Harness Engineering 的第一原则
Harness 不是“包一层 API”的胶水代码,而是 Agent 的行动空间与信息边界。不给编程 Agent shell、编辑器和测试工具,它就无法完成真实软件任务;给出含糊或冲突的工具描述,则会把模型能力消耗在协议猜测上。
AgentOptimizer:让优化器改写 Agent 组件
AgentOptimizer 把一个候选 Agent 看作可迭代编辑的对象。优化器读取当前 prompt、tool 配置或 workflow,观察执行轨迹与评价,再提出新的组件版本。这个过程形成“优化器 Agent 改写任务 Agent,任务 Agent 的新表现又反过来训练优化器判断”的递归结构。
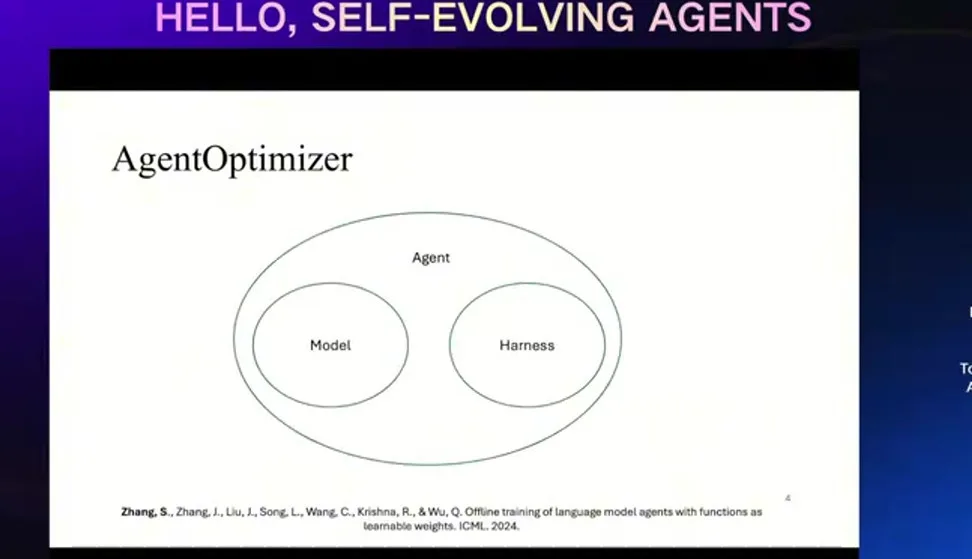
来源:视频讲解区间:00:05:15–00:06:45。
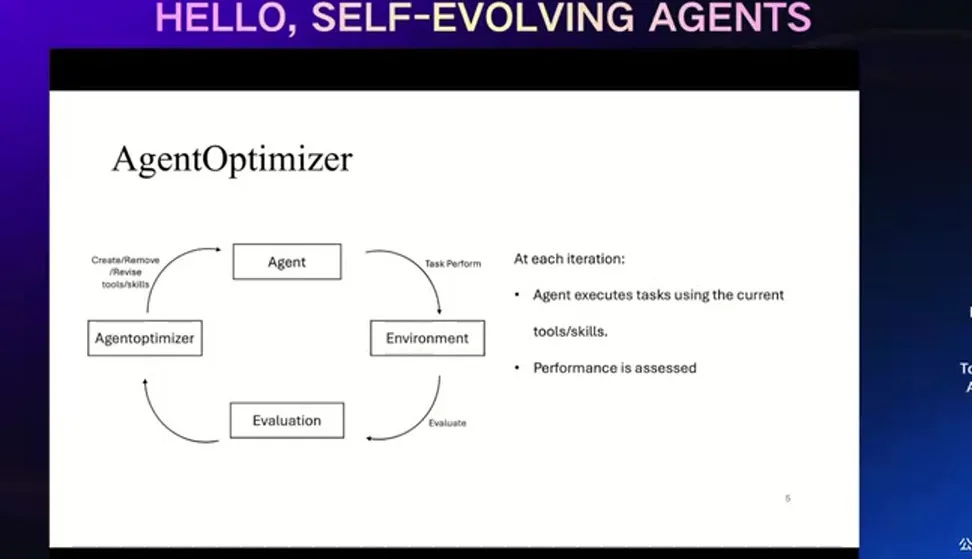
来源:视频讲解区间:00:07:45–00:09:15。
如果把 harness 参数记为 \(h\),评价函数记为 \(R\),优化过程可以抽象为
其中 \(\tau_k\) 是第 \(k\) 轮使用 \(h_k\) 产生的轨迹,\(\mathcal{O}\) 是语言模型驱动的 optimizer。这里没有要求 \(h\) 可微;它可以是自然语言 prompt、工具说明或控制流程。因此优化器能够处理传统梯度下降难以直接更新的离散系统组件。
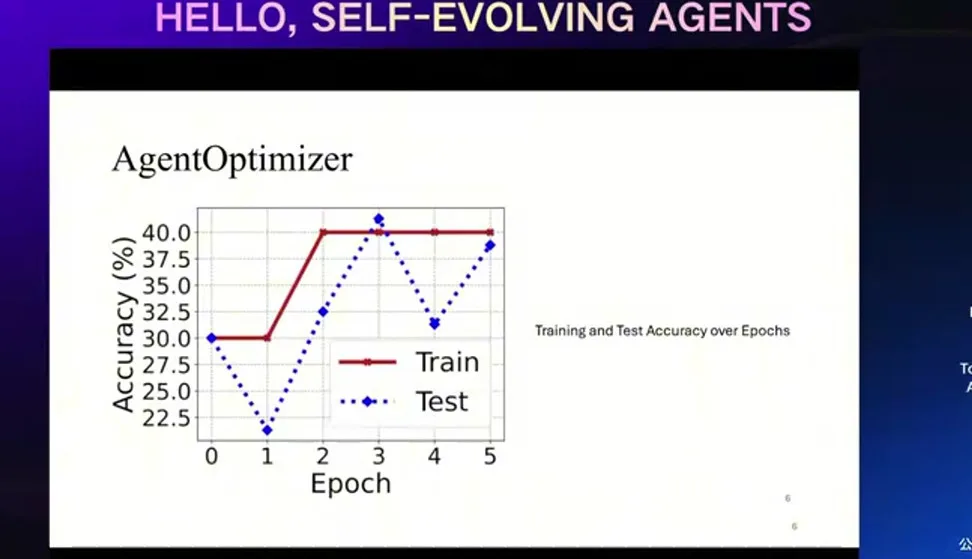
来源:视频讲解区间:00:09:15–00:10:00。
递归改进不保证单调提升
轨迹评价有噪声,optimizer 还可能过拟合少量任务。图中的波动提醒我们:每轮修改都应保留版本、独立验证集和回滚路径;不能因为一次分数上升就覆盖已验证的 harness。
报告总结,AgentOptimizer 能在较早期模型上观察到多轮改进,说明递归修改并不完全依赖最强底座模型;但它同时暴露了样本效率和稳定性问题。要把这种机制扩展到复杂 Agentic RL,必须有更高吞吐、更少侵入的 rollout 基础设施。
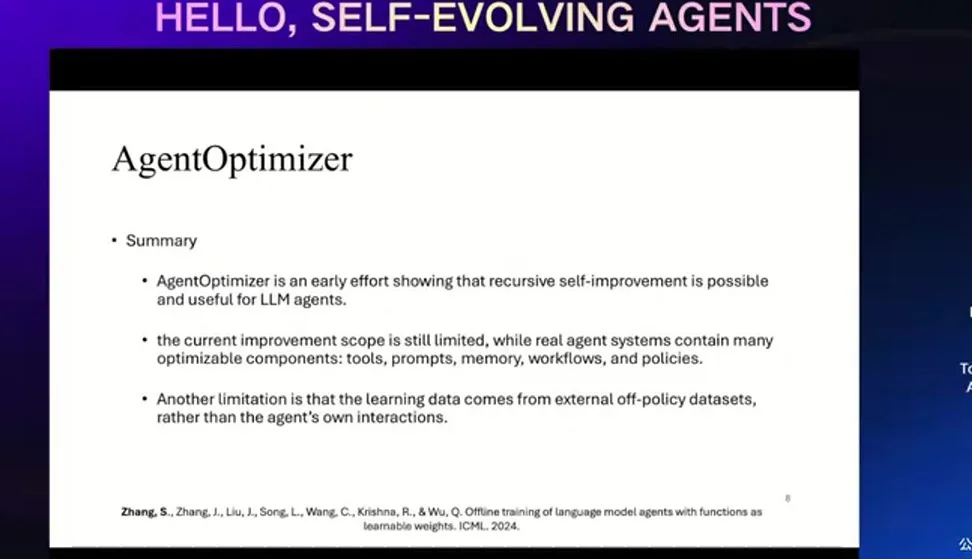
来源:视频讲解区间:00:11:30–00:13:15。
为什么 Agentic RL 的瓶颈在 rollout
传统语言模型 RL 的一次采样主要是 token generation;Agent rollout 却包含多轮模型调用、工具执行、环境等待、错误重试和动态上下文。不同任务的轨迹长度差异巨大,单个环境阻塞就可能拖慢整个同步 batch。
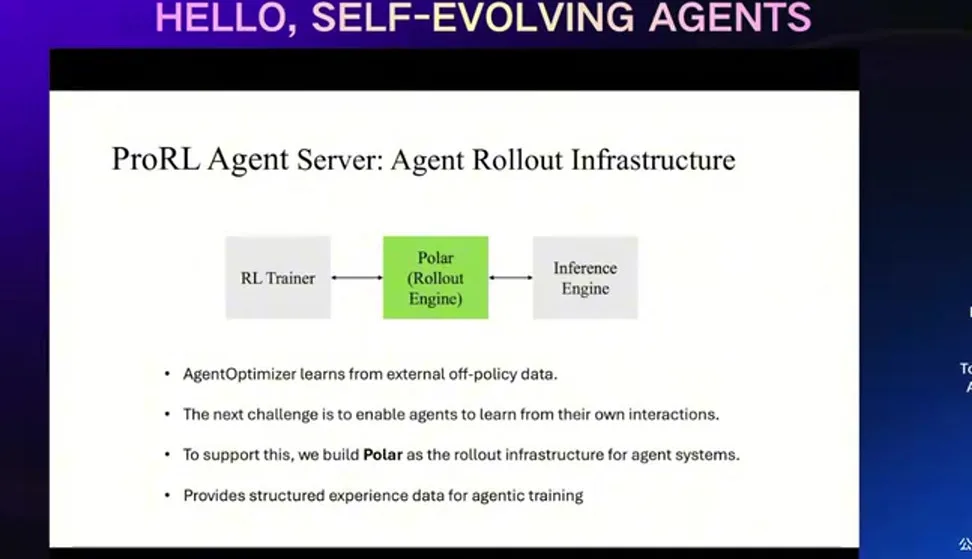
来源:视频讲解区间:00:13:15–00:14:30。
Rollout 的含义
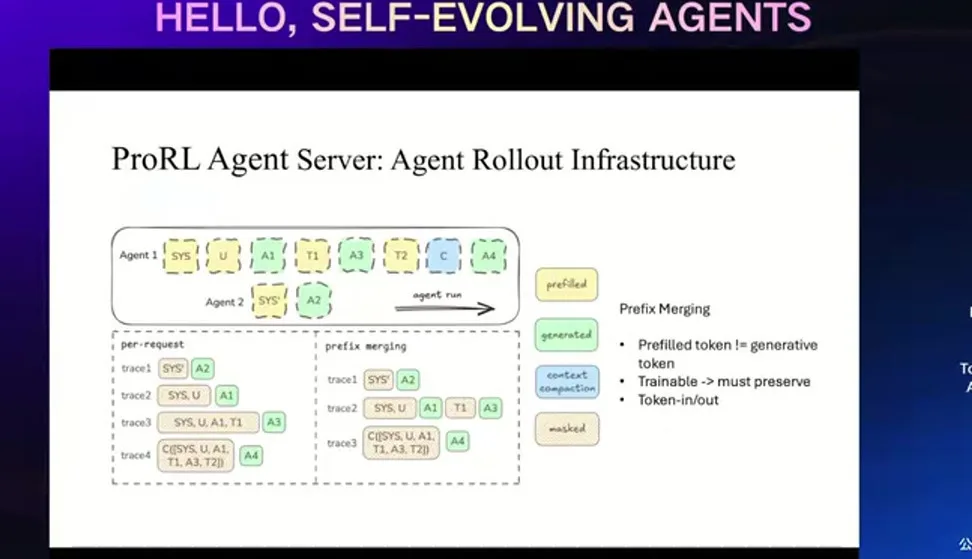
Rollout 是从当前 policy 采样完整交互轨迹的过程。训练器最终需要保留每次 LLM call 的 input token、response token、log probability、reward 与轨迹归属;工具本身不需要可微,但它对后续 prompt 和 reward 的影响必须被记录。
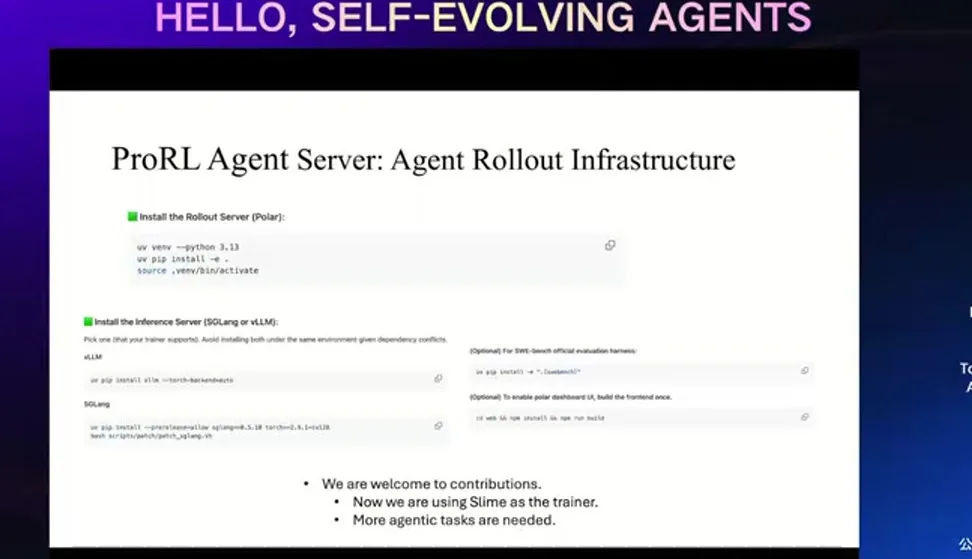
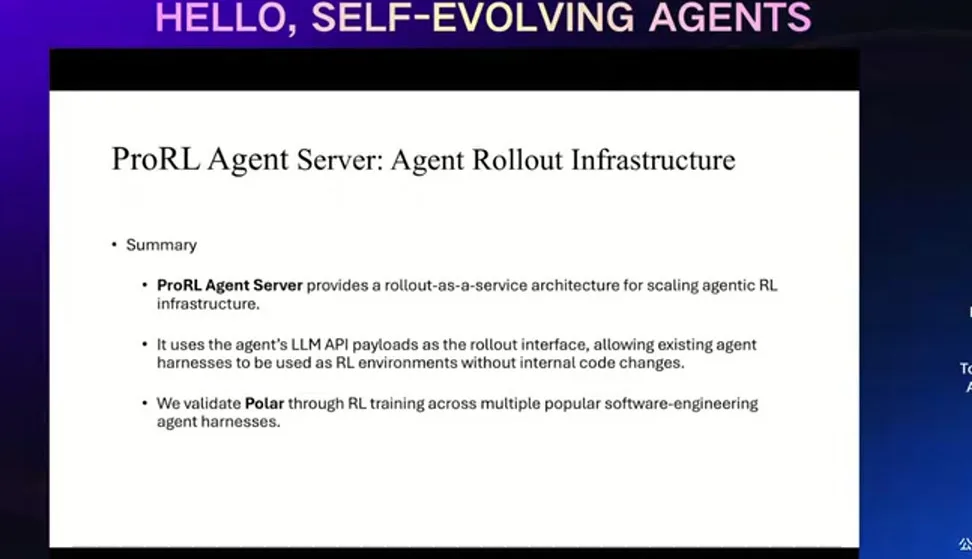
ProRL Agent Server 的关键设计是把 agent harness 与 trainer 解耦。它拦截 harness 对模型服务的标准 API 调用,记录训练所需 token 与元数据,再把请求路由到 inference engine。这样现有 Agent 代码不必改写成某个 RL 框架的专用环境。
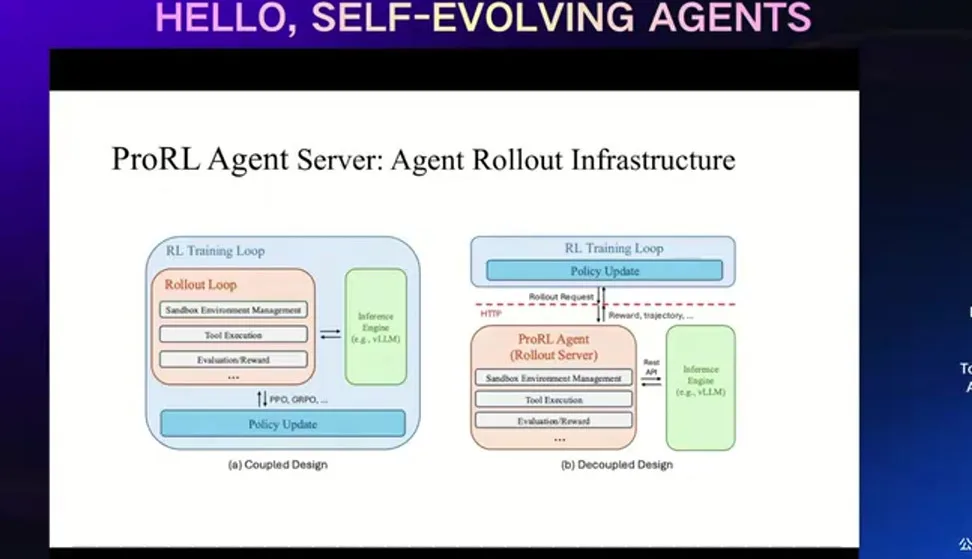
来源:视频讲解区间:00:14:30–00:17:45。
可扩展架构:异步环境、集中推理与轨迹归并
大规模系统需要同时解决三类不均衡:环境执行时间不均衡、模型生成长度不均衡、同一 episode 内多次 LLM call 的归属不均衡。报告采用 service architecture,把 rollout worker、inference engine、environment 与 trainer 通过稳定接口连接,使慢环境不会迫使所有样本同步等待。
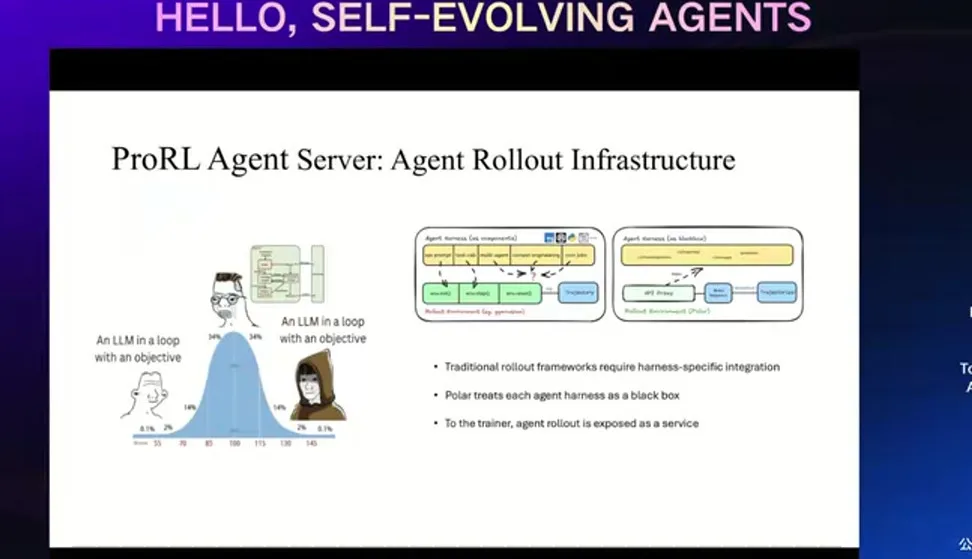
来源:视频讲解区间:00:19:45–00:21:30。
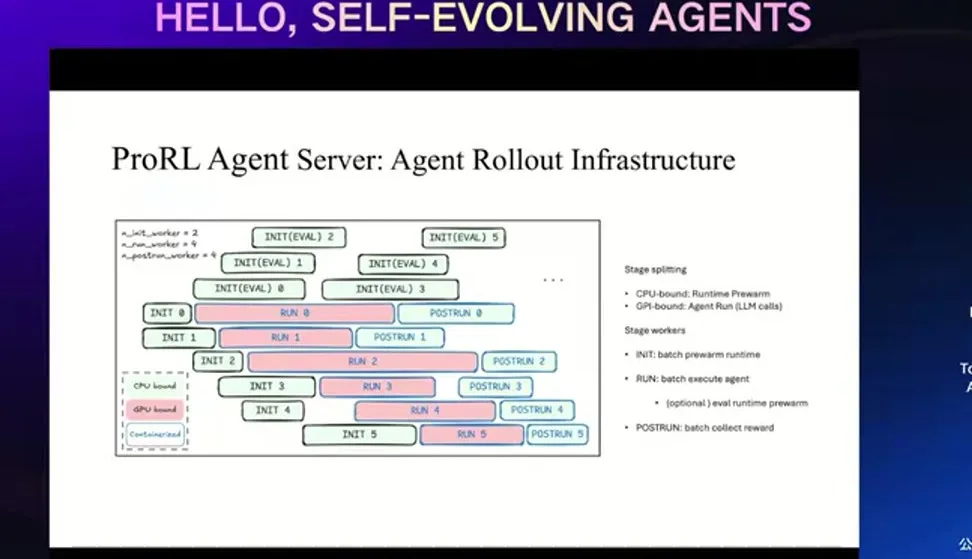
来源:视频讲解区间:00:21:30–00:23:00。
梯度到底如何穿过工具
问答环节明确说明:梯度不需要穿过 shell、浏览器或 Python 工具。Policy gradient 只对模型生成 token 的 log probability 求导,工具执行结果作为后续 observation 进入下一次模型调用。真正困难的是正确保存每个 call 与 episode reward 的对应关系,而不是让工具可微。
若一条轨迹由多次模型调用组成,可把目标写为
其中 \(\mathcal{M}(\tau)\) 只包含模型生成步骤,\(x_t\) 是包含工具 observation 的上下文,\(y_t\) 是 response token,\(A_t\) 是由最终或过程 reward 估计的 advantage。工具调用改变轨迹,却不直接出现在可微参数中。
来源:视频讲解区间:00:23:00–00:24:30。
实验结果应该如何解读
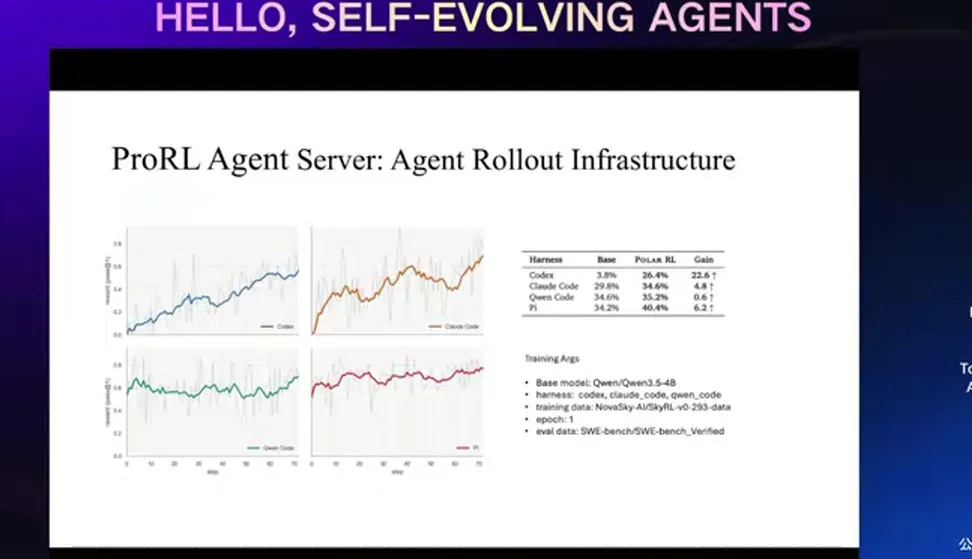
报告在 software engineering task 和不同 Agent harness 上验证训练后的模型。这里的 gain 不是“服务器架构本身提高了 benchmark 分数”,而是基础设施让 on-policy 训练可稳定运行,训练后的 model 更适配复杂 harness,最终在同一 harness 下超过 base model。
来源:视频讲解区间:00:24:30–00:25:45。
来源:视频讲解区间:00:26:30–00:27:30。
Infra result 与 algorithm result 要分开
吞吐提高只说明能更快收集经验;benchmark 提升还依赖 reward、采样策略、训练算法和任务分布。评估系统时应分别报告系统效率、数据效率、最终能力与成本,避免把某一层的改进全部归功于“Agentic RL”。
来源:视频讲解区间:00:27:30–00:28:45。
本章小结
本章从“自我修改什么”与“如何规模化获得自身经验”两端构成闭环。AgentOptimizer 说明 prompt、tool 与 workflow 可以通过非可微 optimizer 递归更新;ProRL 则把异构 harness 的 LLM 调用统一为可训练 rollout。两者结合后,系统才有可能持续采集当前策略真正需要的经验,并把经验转化为下一版模型或 harness。
工程实践要点
- 为 model、harness、reward 与环境分别做版本控制,避免无法归因;
- rollout 日志必须保留 episode、LLM call、tool result 和 token span 的映射;
- 用异步队列隔离慢环境,不让长尾 episode 阻塞全部 GPU;
- 将吞吐、单位有效样本成本、训练稳定性和最终任务成功率分开监控;
- 任何自动 harness 修改都要经过独立验证和可回滚发布。
从 Foresight Failure 到有目标的自进化
钱成的报告研究一个常被忽略的 Agent 能力:foresight,即在行动前预见环境演化、工具后果和长期约束。Agent 可以拥有工具,也可以接入 world model,但这不代表它会在正确时机调用、会相信模型,或能把预测转化为更好的决策。
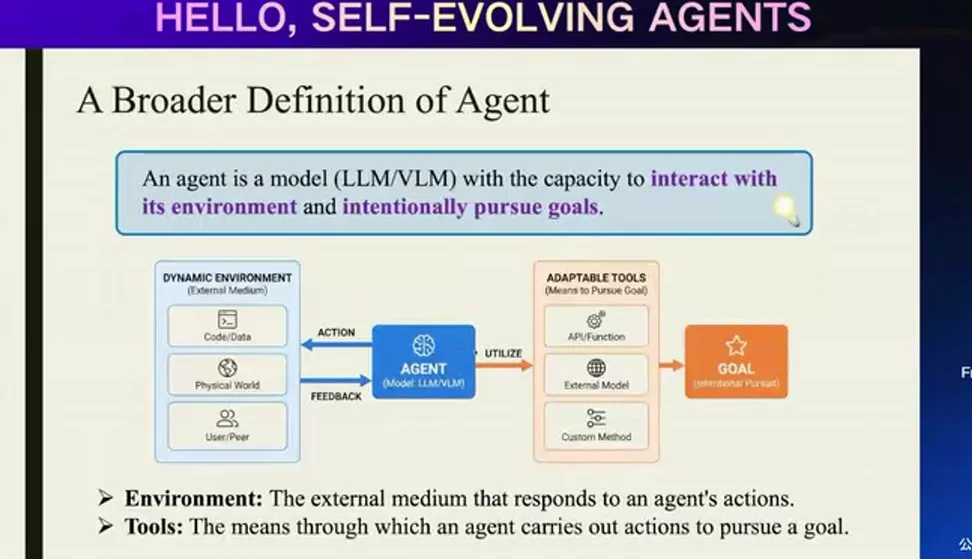
来源:视频讲解区间:00:01:45–00:03:45。
Foresight 是比“会调用工具”更高一层的能力
在复杂任务中,Agent 需要先估计动作可能引发的后续状态,再选择当前步骤。世界模型、搜索和模拟器都只是提供预测的工具;真正的 foresight 还包括识别何时预测值得付出成本、如何处理预测不确定性,以及何时停止继续想象。
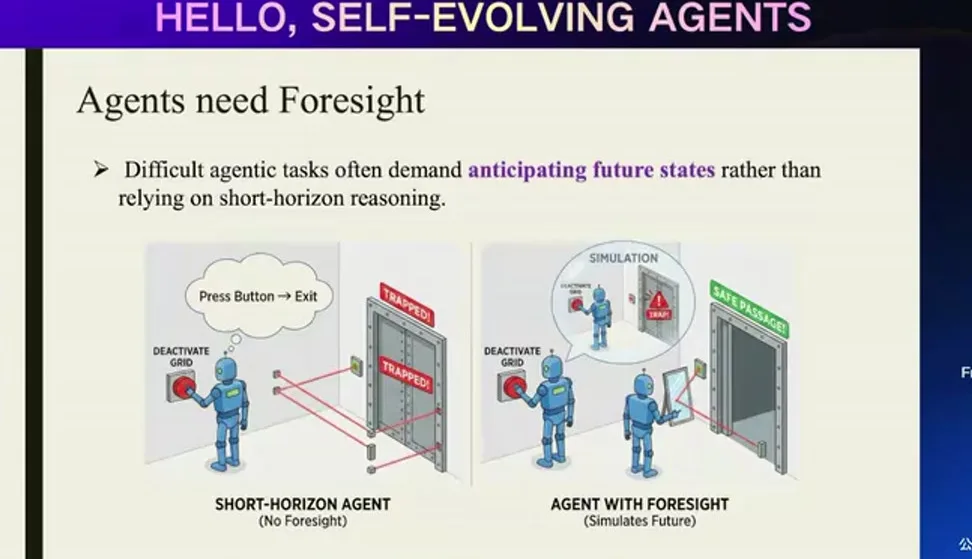
来源:视频讲解区间:00:03:45–00:05:15。
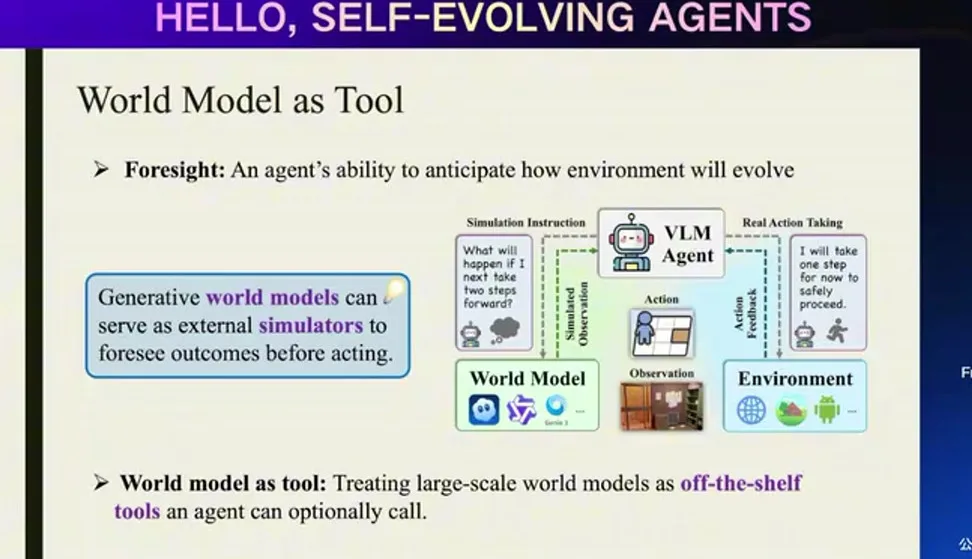
来源:视频讲解区间:00:05:15–00:07:15。
能力缺口不一定在模型精度
实验发现,即使提供较强 world model,Agent 也可能很少调用它;即使调用,也可能在输出与原有判断冲突时选择忽略。系统失败因此不能只归因于“预测器不准”,还要检查调用策略、信任校准和决策整合。
实验:更好的 world model 为何没有自动带来更强 Agent
报告在多个交互任务中替换不同能力的 world model,并比较 Agent 最终表现。理想情况下,预测器更强应单调提高成功率;实际结果却显示收益有限,说明模型能力与 Agent 使用模型的能力之间存在明显接口鸿沟。
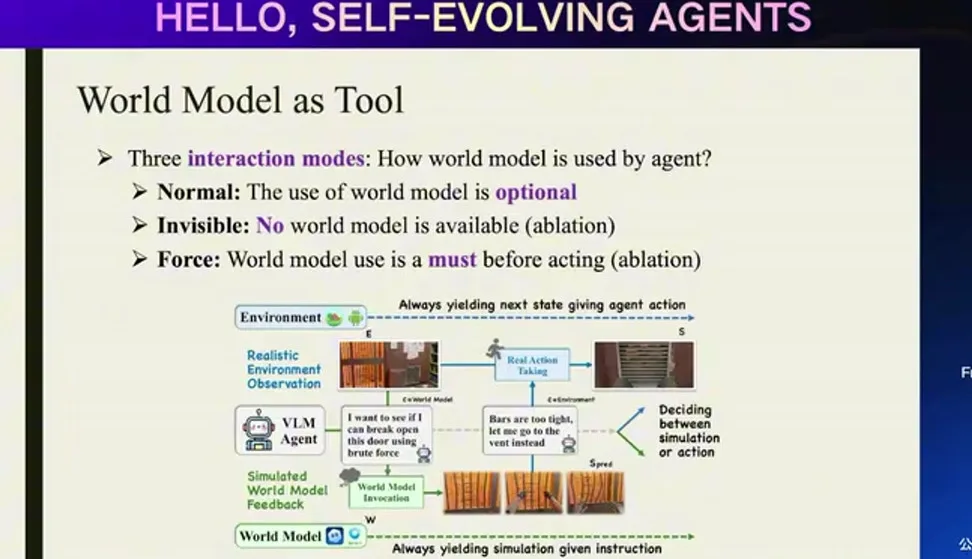
来源:视频讲解区间:00:07:15–00:07:45。
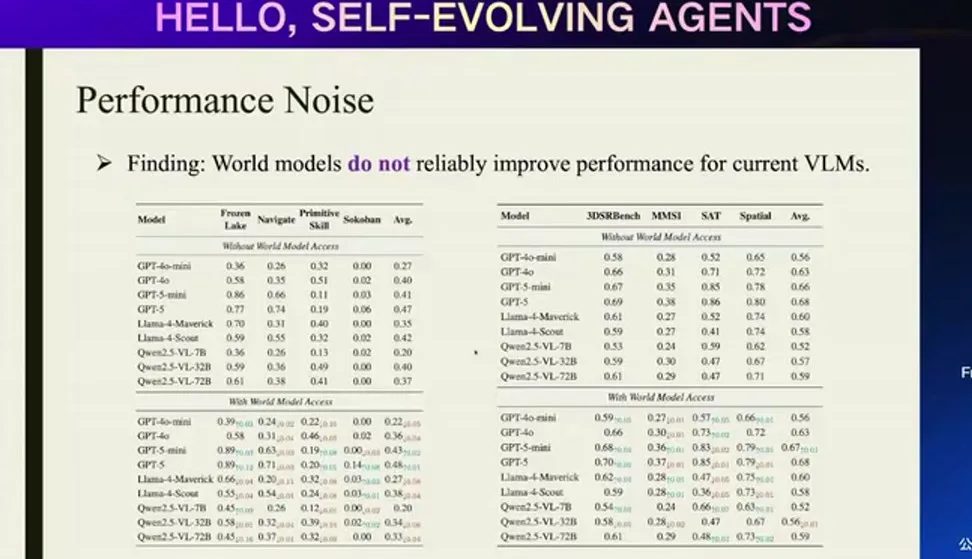
来源:视频讲解区间:00:09:00–00:09:15。
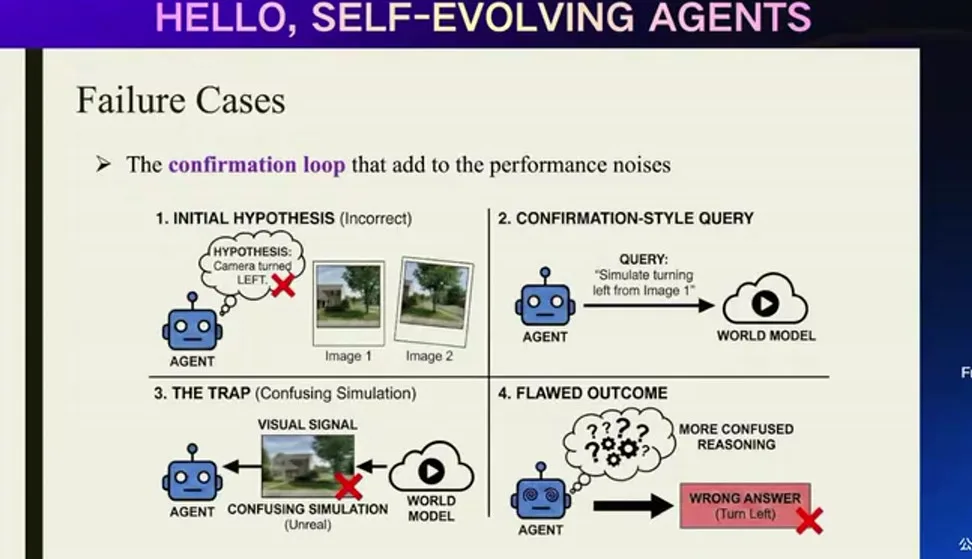
来源:视频讲解区间:00:11:00–00:13:15。
报告归纳的失败可理解为三类。第一,不调用:Agent 直接依据语言先验行动。第二,调用但不整合:预测只成为附加文本,没有改变计划。第三,错误信任:Agent 无条件接受预测,反而被不可靠 world model 带偏。
World model 不是 oracle
部署系统必须同时估计预测误差与使用价值。若模拟器在分布外状态上不可靠,强制每一步都调用会增加延迟并传播错误;若从不调用,又浪费了可用于规避高成本失败的信息。正确目标是学习 calibrated invocation policy。
Foresight Governor:把“是否思考未来”显式化
报告提出治理式视角:在执行 Agent 外再增加一个模块,决定何时请求预测、选择哪个 world model、如何把结果写回决策上下文。这个 governor 不应只靠 prompt 临时提醒,而要接受显式训练,让“使用 foresight”本身成为可优化行为。
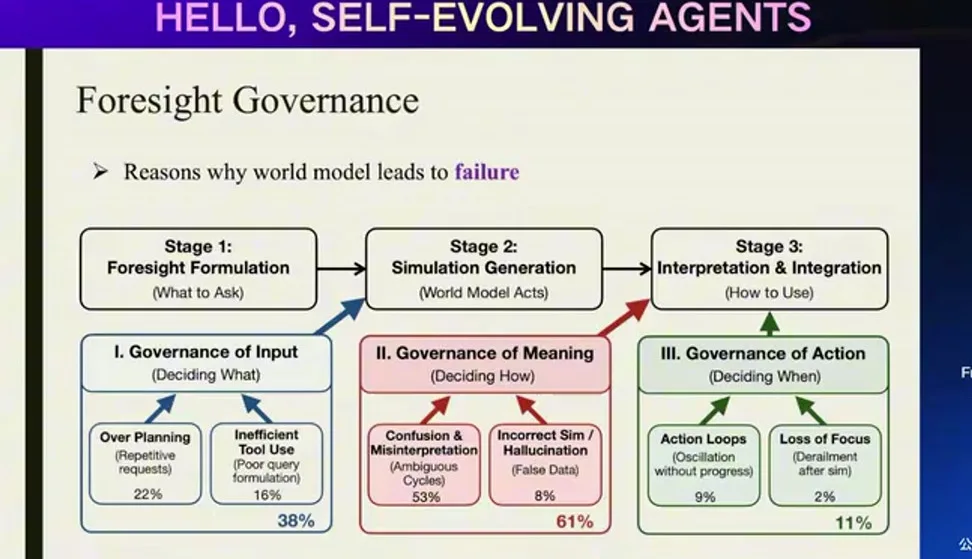
来源:视频讲解区间:00:13:15–00:14:45。
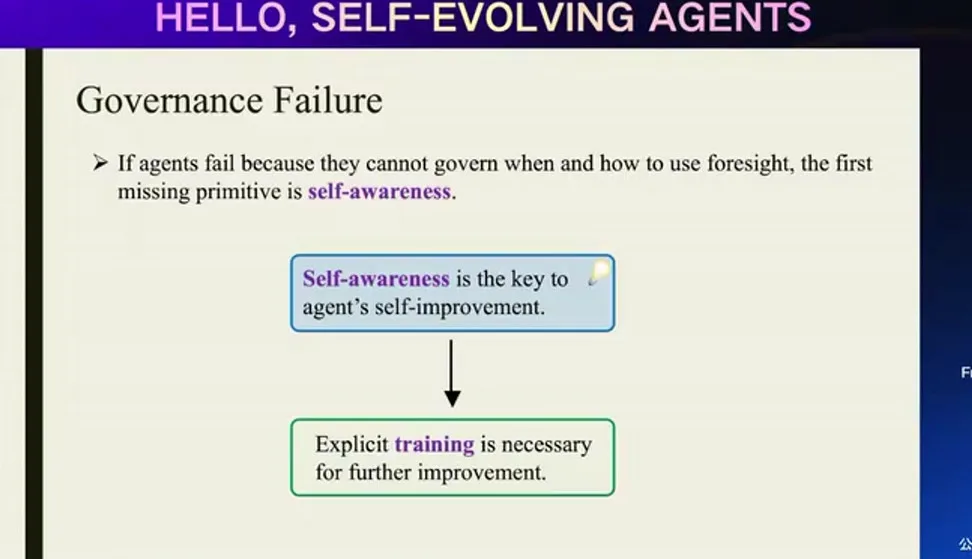
来源:视频讲解区间:00:14:45–00:16:15。
为什么 prompt 提醒不够
“行动前请认真预测”只改变当前上下文,不能保证模型在新任务、长轨迹或冲突证据下保持同样策略。显式训练通过大量成功与失败轨迹塑造调用倾向,并让模型学会比较预测收益与成本。
Test-Time Training:把一次任务变成局部学习过程
报告进一步把 self-improvement 放到测试时:Agent 在处理当前任务族时,先从失败轨迹产生 self-awareness 或可复用经验,再把这些经验用于后续 episode。更新可以发生在 memory 层,也可以通过小规模训练进入参数层。
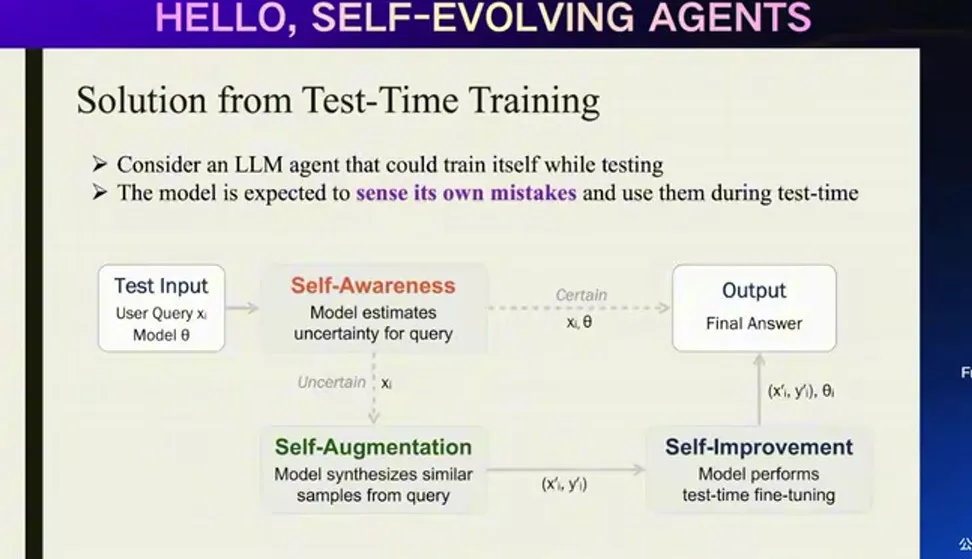
来源:视频讲解区间:00:16:15–00:18:00。
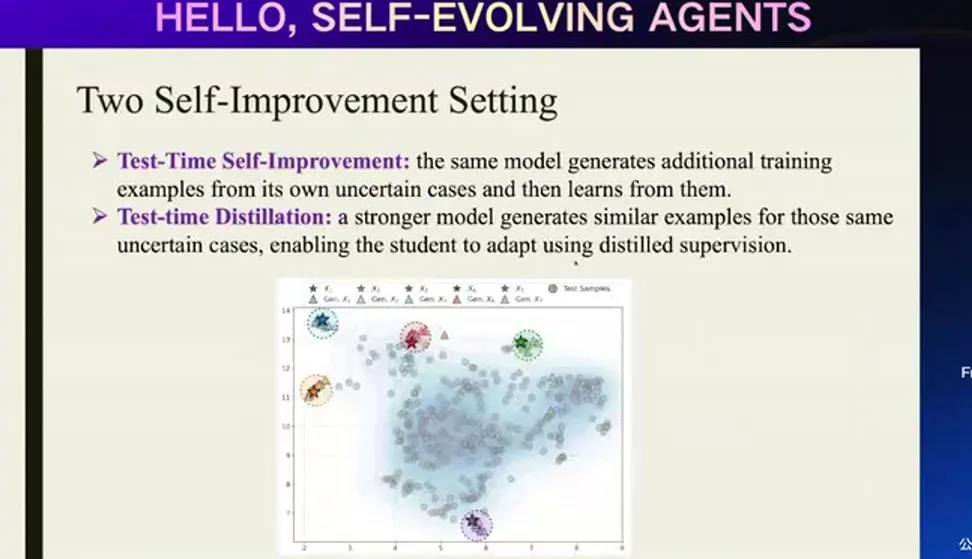
来源:视频讲解区间:00:18:00–00:19:15。
Self-awareness 与 self-improvement 要分开
Self-awareness 是识别“我为什么失败、缺少什么能力”;self-improvement 是据此改变后续行为。只生成漂亮的反思文本不代表能力提升,必须验证它是否改变了调用、规划或训练结果。
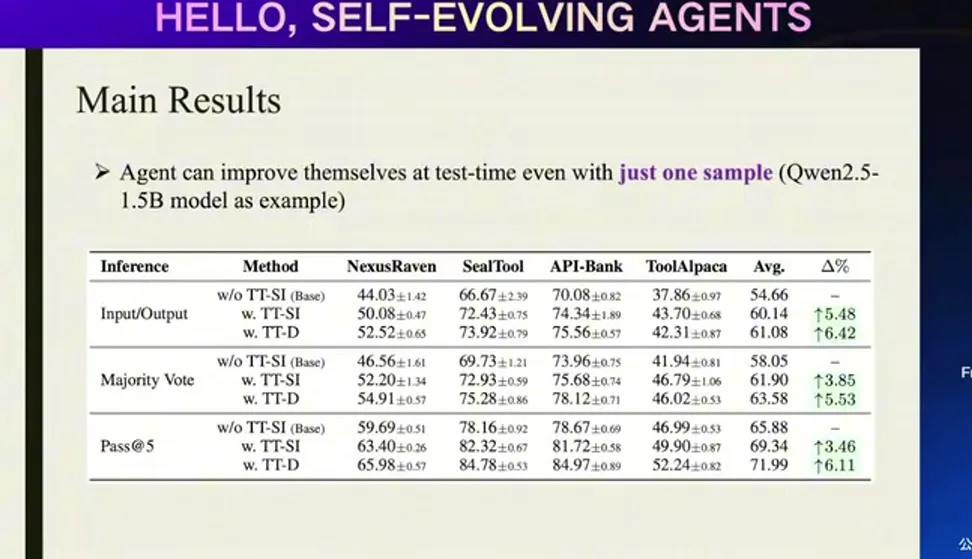
来源:视频讲解区间:00:19:15–00:20:00。
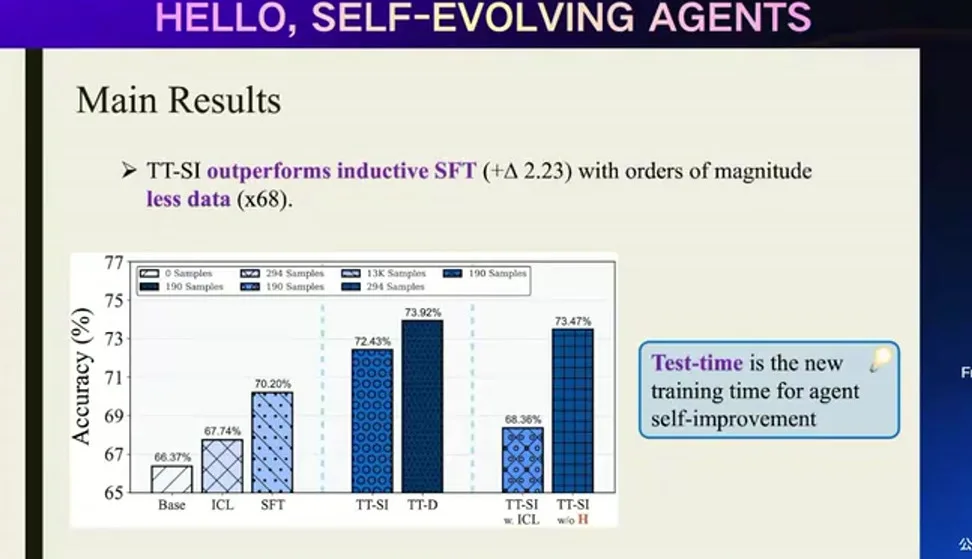
来源:视频讲解区间:00:20:00–00:20:45。
Generator–Solver 与自动 curriculum
为了不让 Agent 只重复已有任务,报告引入 generator–solver 结构。Generator 根据当前 solver 的能力边界产生新问题;solver 尝试解决并返回结果;课程设计器再依据成功率、难度和新颖性调整任务分布。
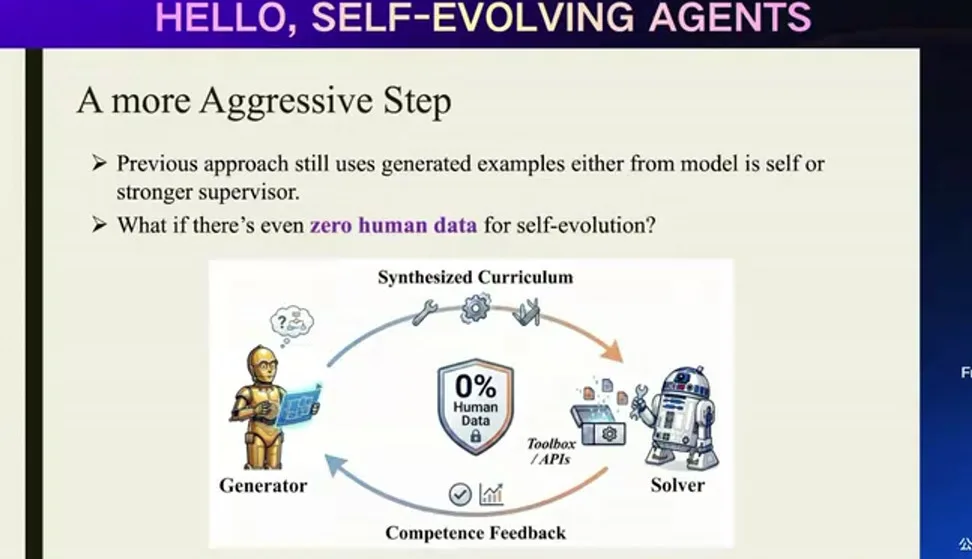
来源:视频讲解区间:00:20:45–00:21:45。
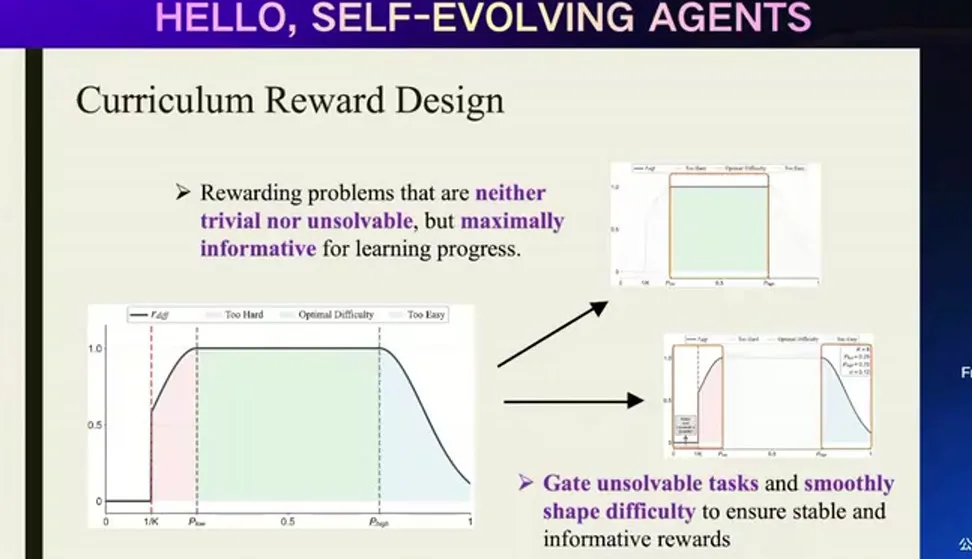
来源:视频讲解区间:00:22:30–00:23:45。
设生成任务为 \(q\),solver 成功概率为 \(p_\theta(q)\)。一个实用 curriculum 不应只最大化失败率,而应偏好能力边界附近的问题,例如
过易任务没有训练增量,过难任务又无法提供可学习信号;\(p(1-p)\) 在成功概率接近 \(0.5\) 时最大,表达“略高于当前能力”的课程直觉。
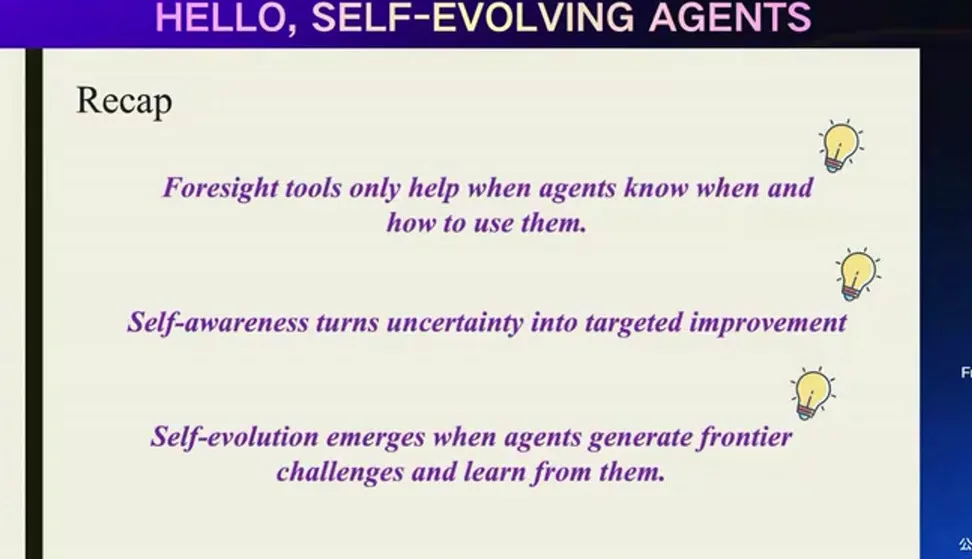
来源:视频讲解区间:00:25:30–00:26:30。
来源:视频讲解区间:00:26:45–00:27:15。
本章小结
本章说明,Agent 失败常常不是“没有 world model”,而是缺少使用预测的 governor。自进化因此需要显式训练 foresight、从失败中抽取可执行经验,并通过 generator–solver 自动构造位于当前能力边界的新课程。真正的闭环是:预见失败、诊断失败、生成针对性任务、验证能力是否改变。
Agent-World:让训练环境与策略协同进化
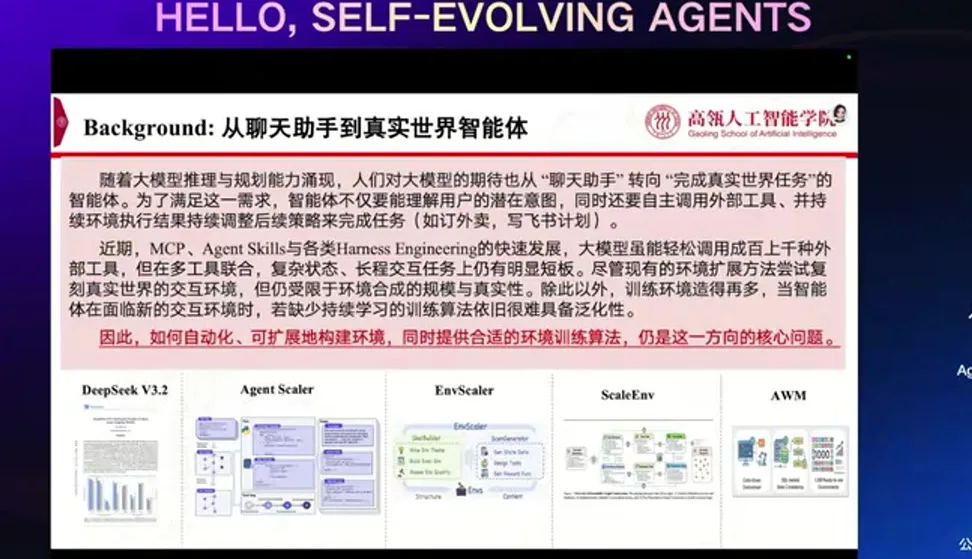
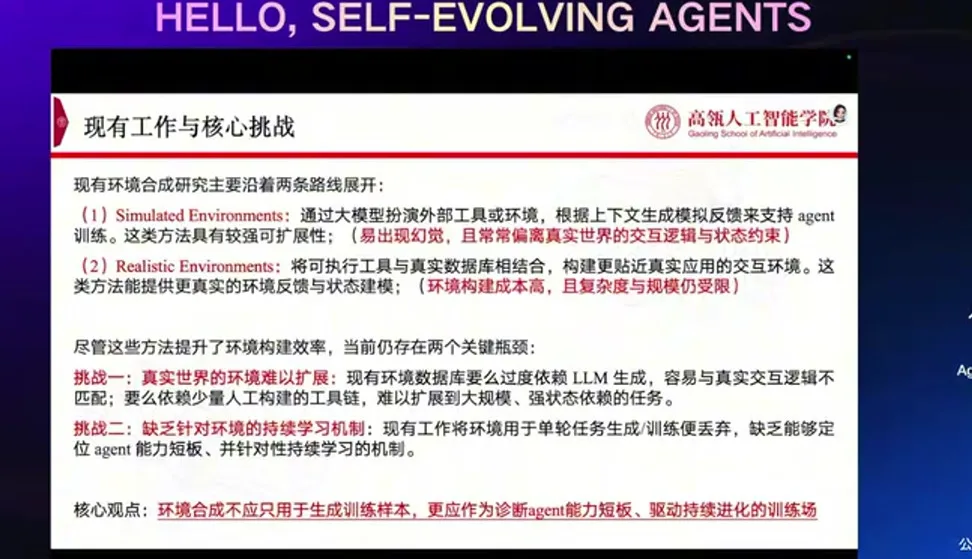
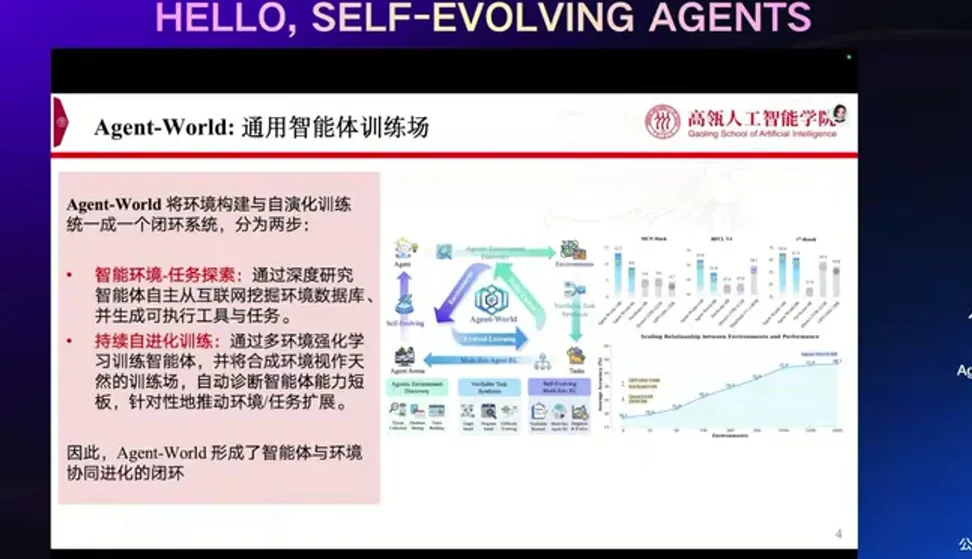
董冠霆的 Agent-World 把 self-evolving Agent 的瓶颈定位在环境侧:Agentic RL 需要大量可执行、可验证且难度可控的任务,但人工构造环境和标注奖励无法跟上策略增长。解决思路不是只扩充数据集,而是建立能持续发现环境、合成任务、验证结果并诊断能力缺口的 arena。
来源:视频讲解区间:00:00:30–00:01:00。
环境不足为何成为 Agentic RL 的主要约束
语言模型预训练可以从静态语料获得海量 token,Agent 训练却要求每个样本都具有状态、工具、动作和可执行反馈。真实服务 API 可能不稳定、昂贵或涉及隐私;手工 sandbox 又覆盖有限,最终导致策略反复在少数 benchmark 上优化。
来源:视频讲解区间:00:01:00–00:04:15。
环境是训练分布的一部分
Agent 的能力上限不仅由模型和算法决定,也由它能接触到的工具生态、数据库模式、任务难度和验证器决定。环境单一时,继续增加 rollout 只会更充分地过拟合有限交互模式。
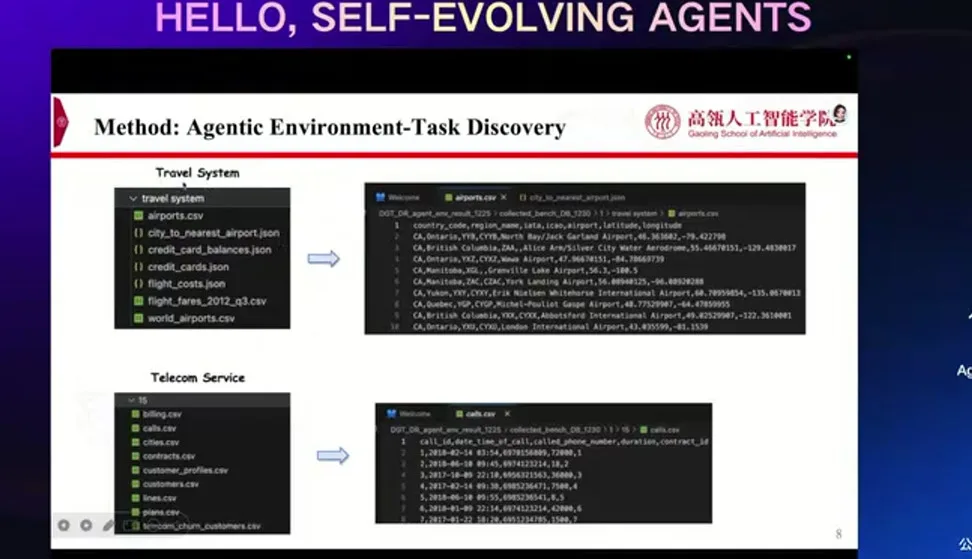
第一阶段:Environment–Task Discovery
Agent-World 先从大规模真实主题出发,寻找数据库、API 或可执行工具集合,再把它们标准化为统一交互接口。随后系统分析 schema 与工具能力,提出需要多步查询、组合或推理的任务。
来源:视频讲解区间:00:04:15–00:07:45。
Task discovery 不等于随便生成问题
高价值任务必须依赖环境中的真实状态,答案不能仅靠语言先验猜出;任务还应要求多个工具步骤,并覆盖不同错误模式。否则生成器会生产看似丰富、实则不需要交互的伪 Agent 任务。
第二阶段:Verifiable Task Synthesis
合成任务最大的风险是无法可靠判分。Agent-World 通过环境约束、程序执行、数据库查询或规则检查构造 verifier,使 reward 尽量来自外部状态而非另一个语言模型的主观判断。
来源:视频讲解区间:00:07:45–00:09:15。
若任务 \(q\) 的目标状态为 \(g_q\),Agent 轨迹为 \(\tau\),验证器可写成
其中 \(V\) 是确定性或受控随机验证程序。对于长轨迹,还可加入格式、工具约束和中间状态检查,避免 Agent 通过奖励漏洞绕过真正任务。
可验证不等于没有 reward hacking
如果 verifier 只检查最终字符串,Agent 可能伪造答案;如果只检查数据库状态,又可能通过未授权副作用完成目标。验证器必须同时覆盖结果、过程约束与安全边界,并对生成任务做独立审计。
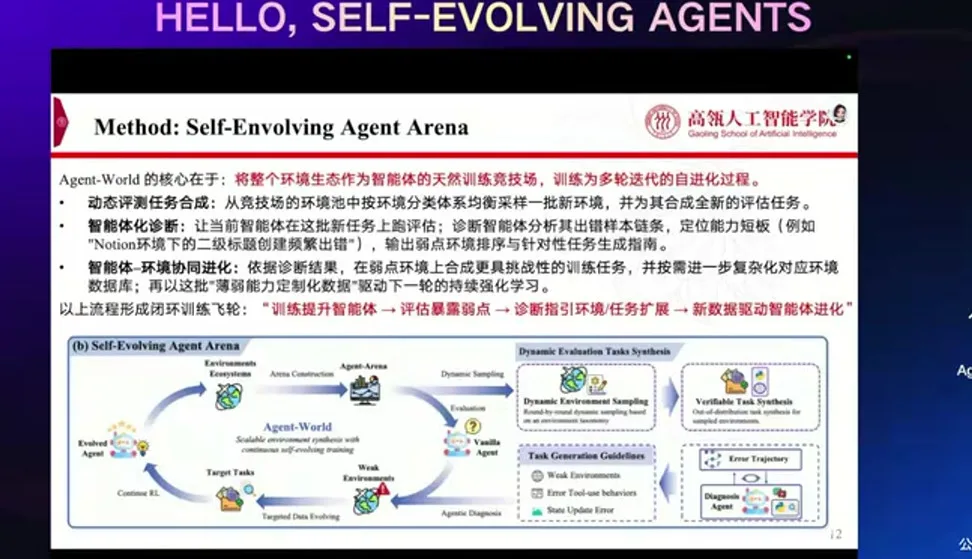
第三阶段:Continuous Self-Evolving Agent Training
环境与任务准备好后,系统使用多环境 Agentic RL 训练策略,再把评测中暴露的弱点送回 arena。Arena 不是固定 leaderboard,而是一个诊断器:它识别模型在哪类工具组合、长程依赖或错误恢复上失败,并定向生成下一轮任务。
来源:视频讲解区间:00:11:45–00:12:30。
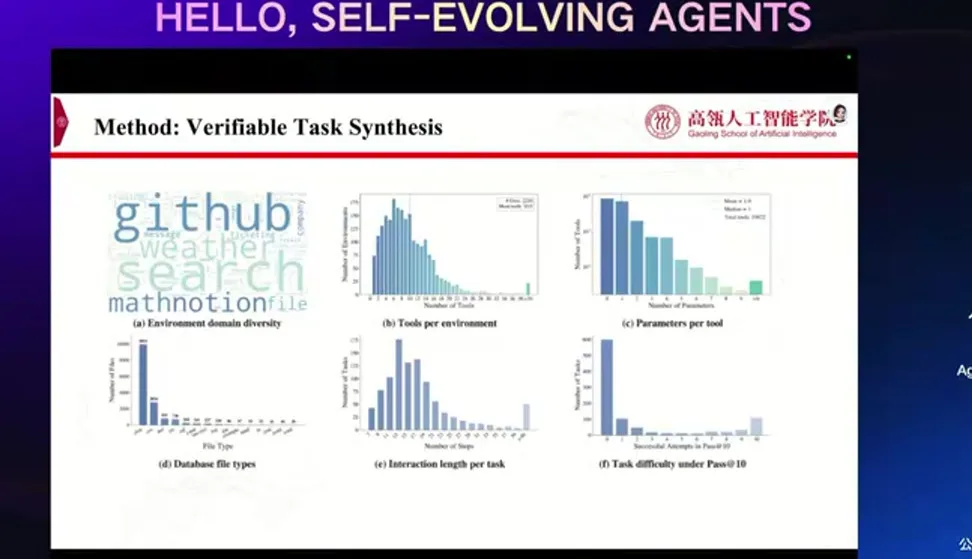
来源:视频讲解区间:00:14:00–00:15:00。
协同进化的含义
策略变强后,旧任务失去训练价值;环境生成器必须提高组合复杂度或引入新工具。反过来,新环境暴露的失败又决定策略下一轮训练重点。两侧共同变化,才称得上 agent–world co-evolution。
实验结果与正确解读
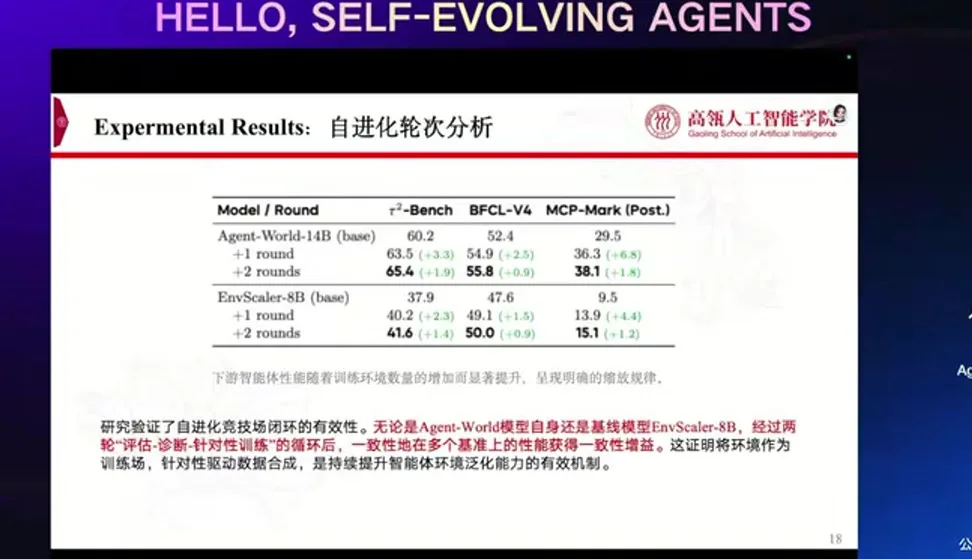
报告在多项 Agent benchmark 上比较基础模型、仅增加环境数据、以及完整 Agent-World 闭环。总体趋势是,跨环境训练比单一 benchmark 训练具有更好的平均迁移,定向生成的任务还能改善特定弱项。
来源:视频讲解区间:00:16:00–00:18:00。
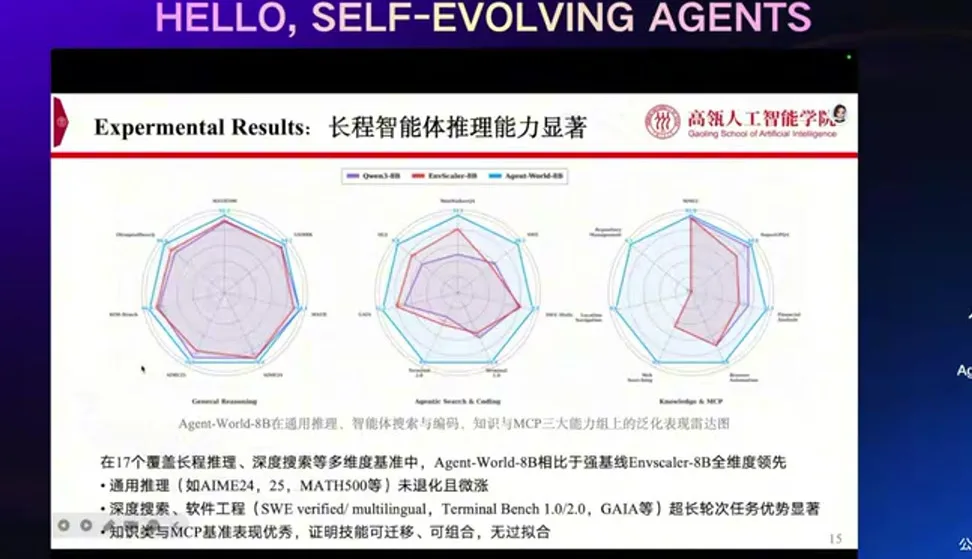
来源:视频讲解区间:00:20:15–00:21:00。
来源:视频讲解区间:00:22:00–00:22:30。
Benchmark 增长不等于现实世界已解决
合成环境仍可能比真实系统更整洁,工具错误、权限变化、延迟和非确定性都较弱。实验支持“可扩展环境合成有效”,但不能直接推出 Agent 已能在开放互联网或企业系统中长期自治。
本章小结
Agent-World 将训练数据问题升级为环境工程问题。系统先发现可执行环境,再合成带 verifier 的任务,通过多环境 RL 训练策略,并用 arena 诊断弱点、生成下一轮课程。它与前两章形成自然连接:causal world model 帮助理解环境,rollout infrastructure 负责规模化交互,Agent-World 则持续提供值得交互的新世界。
上午场 Panel:模型、Harness、奖励与环境谁先演化
上午场 Panel 汇集杨梦月、张少坤、钱成、董冠霆与胡梦康,讨论前四场报告之间最直接的冲突:短期效果往往来自 harness 与 context 优化,长期能力却需要 model update;Agent 需要自己设计任务和 reward,但自评又最容易产生 reward hacking;真实应用要求开放探索,却又必须有可验证边界。
Auto-Research 为什么成为自进化试验场
嘉宾普遍把自动科研视为高价值场景,因为研究任务包含问题发现、检索、实验、代码执行、结果解释和报告生成,天然形成长周期反馈。更进一步的 “auto-research for auto-research” 让 Agent 不只完成实验,还尝试改进研究流程、benchmark 或自身工具。
Panel 共识:自进化必须改变未来行为
无论更新的是 prompt、harness、memory 还是模型参数,都必须在后续任务上观察到可复现变化。只生成反思、总结或新想法,但没有改变执行策略,不构成有效自进化。
Model evolution 还是 Harness evolution
Panel 给出的工程答案不是二选一,而是分时间尺度处理。Harness 修改成本低、反馈快,适合验证新工具、新流程和约束;当某种结构在大量任务上稳定有效后,再考虑通过训练把它内化为模型能力。这样既能快速迭代,又避免每次产品变化都重新训练基础模型。
从外部化到内化的路线
一个常见路径是:先用 prompt 或 workflow 实现能力,收集真实轨迹并验证收益;再把稳定行为蒸馏或通过 RL 写入模型;最后简化 harness。Harness 因此既是产品组件,也是探索未来模型能力的数据生成器。
老师们同时提醒,harness 与 model 并非完全正交。Harness 改变观察、动作和反馈分布,训练后的模型也会反过来改变最佳 harness。真正成熟的系统需要共同版本化并进行联合评估。
Reward 能否由 Agent 自己设计
开放任务很少有连续、无歧义的奖励。若让 Agent 自己生成 proxy reward,它往往会优化最容易测量的指标,而不是人真正关心的目标。Panel 将这视为 self-evolution 的核心风险:任务生成、作答和判分如果由同一模型控制,系统可能在封闭循环中持续确认自己进步。
Reward hacking 的三种来源
第一,代理指标遗漏真实目标;第二,验证器存在可利用漏洞;第三,评估器与策略共同漂移。应尽量引入程序执行、环境状态、人类抽查和多评估器交叉验证,并保留对旧版本任务的回归测试。
环境、世界模型与主动探索
因果世界模型强调 Agent 应主动寻找能区分假设的干预,Agent-World 强调持续生成新环境与任务。Panel 将两者连接起来:环境生成器提供探索空间,world model 预测信息价值,rollout infrastructure 执行交互,reward/verifier 判断是否获得新知识。
开放性与可验证性的张力
越开放的任务越可能产生新能力,但越难自动判分;越容易验证的任务越适合 RL,却可能过窄。实用课程应混合强验证任务、弱验证探索任务和人类审阅样本,而不是只选择其中一端。
近期产品形态:垂直 Agent 的联邦
嘉宾判断,近期更现实的形态不是一个无所不能的 Agent,而是多个垂直 Agent 通过 MCP、skills 或服务接口互相调用。代码、数据分析、检索和科研等领域会先形成高可靠单元,再逐步组合为更复杂系统。这种联邦结构也要求明确能力声明、权限和失败传播边界。
本章小结
上午场 Panel 给出一条务实路线:先在 harness 层快速试验,用可验证环境收集 on-policy experience,把稳定模式内化到模型,同时让环境与课程随策略能力增长。任何自进化机制都必须防止自评闭环、保留回滚,并把开放探索与外部验证配对。
迈向经验智能:从 Context Engineering 到 Context Learning
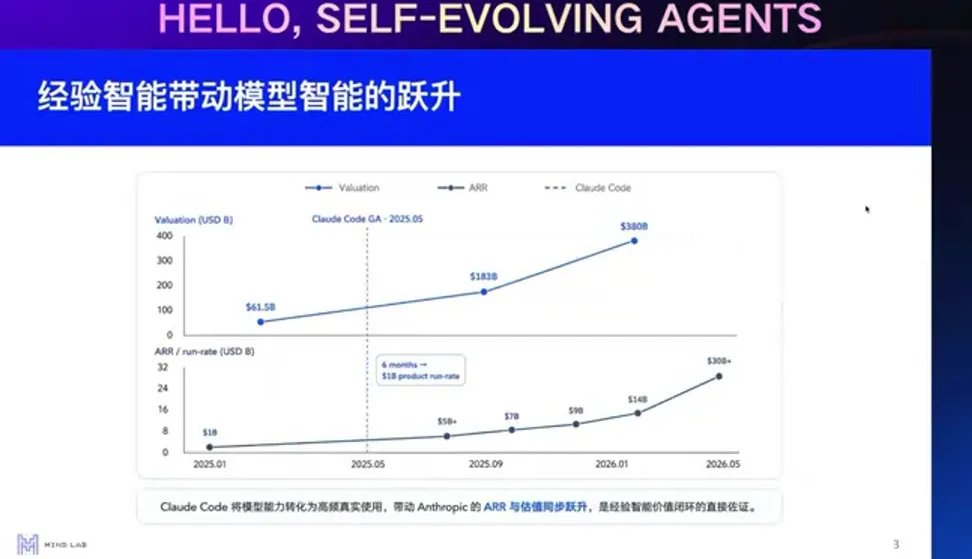
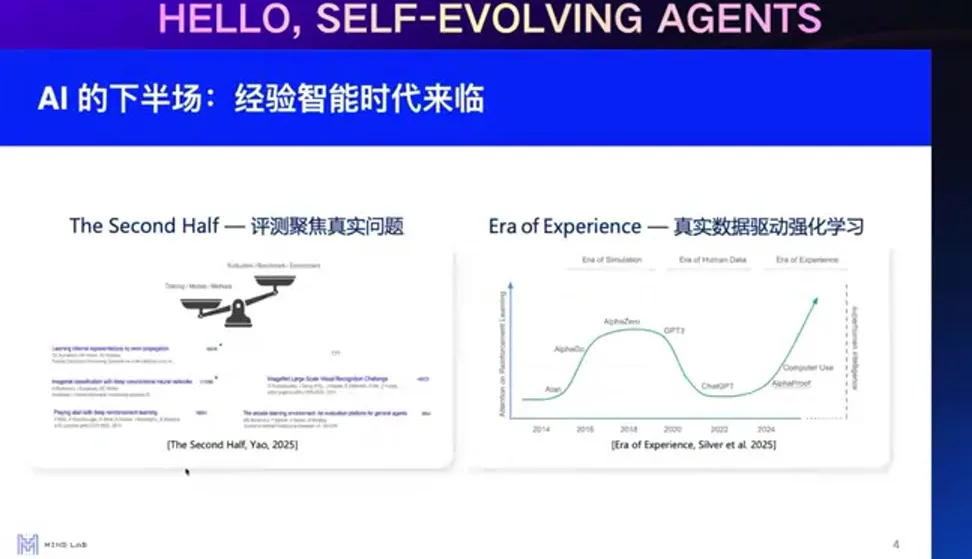
马骁腾把下一阶段的 Agent 能力称为 Experiential Intelligence:系统不只在单次请求中拼装 context,而是从长期交互中学习“什么信息对这个用户、这个任务和这个时刻最有用”。这要求把 context engineering 从人工规则升级为可训练、可评估、可持续服务的 context learning。
来源:视频讲解区间:00:00:30–00:01:00。
为什么只扩模型规模不够
模型规模继续增长,但每个用户真正需要的是稳定的个人偏好、项目状态和历史经验。通用参数无法及时吸收私有且不断变化的信息;把全部历史塞进 prompt 又会带来上下文成本、噪声和隐私问题。
来源:视频讲解区间:00:01:00–00:01:45。
来源:视频讲解区间:00:01:45–00:02:00。
Context Learning 的对象
学习的不是一段固定 prompt,而是“如何从记忆、环境、用户状态和工具结果中选择、压缩、排序并更新 context”的策略。它决定哪些经验进入当前推理,哪些写回长期状态,哪些应该遗忘。
LoRA as Memory:参数高效的经验载体
报告探索把 LoRA adapter 视为可训练记忆。相比完整微调,LoRA 只学习低秩增量
其中基础权重 \(W\) 保持冻结,\(A,B\) 存储特定经验。多个用户或任务可以拥有独立 adapter,服务时按需加载。
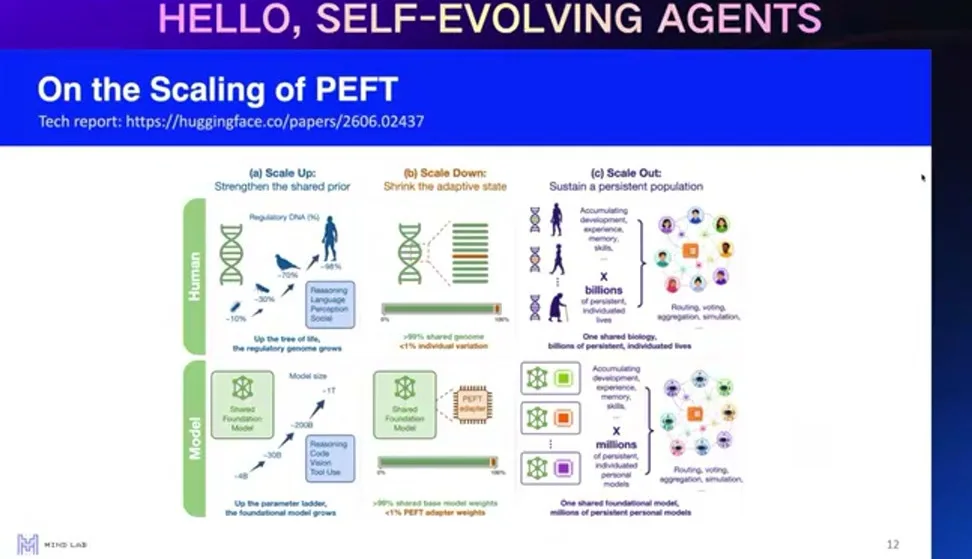
来源:视频讲解区间:00:08:30–00:11:30。
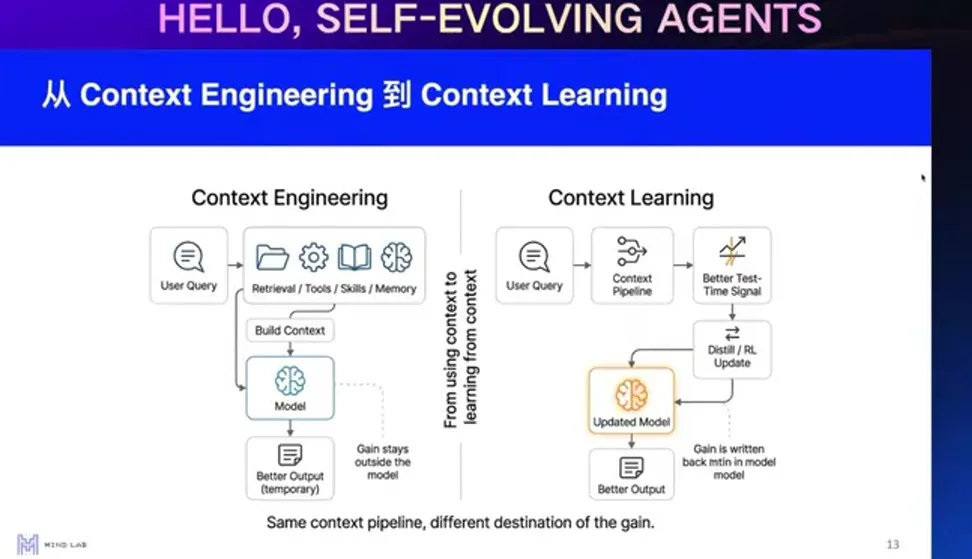
来源:视频讲解区间:00:11:30–00:13:15。
参数记忆不是万能数据库
LoRA 适合沉淀行为偏好和可泛化模式,不适合精确保存需要删除、审计或逐条引用的事实。事实记录仍应保留在外部 memory store;参数更新与可检索记忆需要协同,而不是互相替代。
从离线 adapter 到在线 Context Learning
个性化系统要处理连续到来的少量样本,要求训练稳定、低成本并能避免灾难性遗忘。报告通过 LoRA 初始化、rank/scale sweep 和评测协议研究经验如何快速写入,同时保持基础能力。
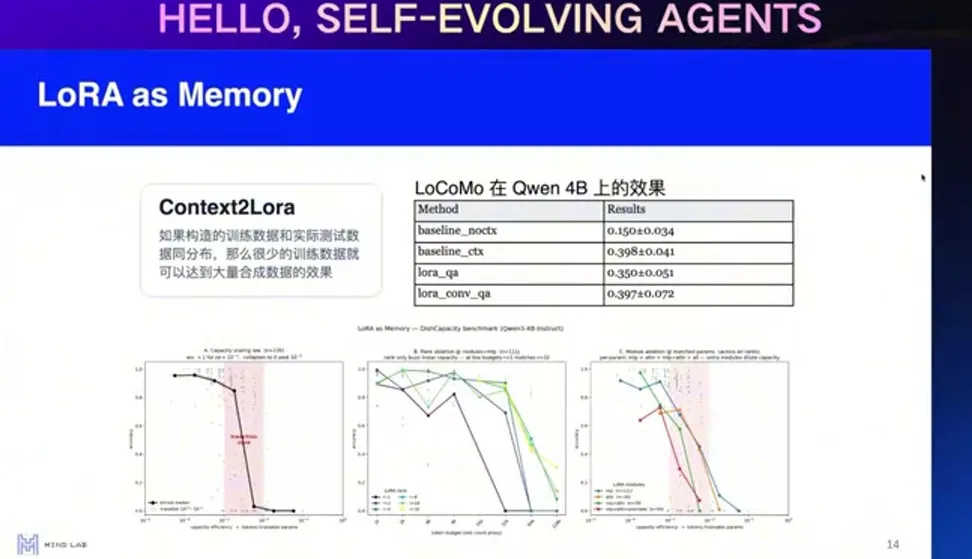
来源:视频讲解区间:00:13:15–00:16:00。
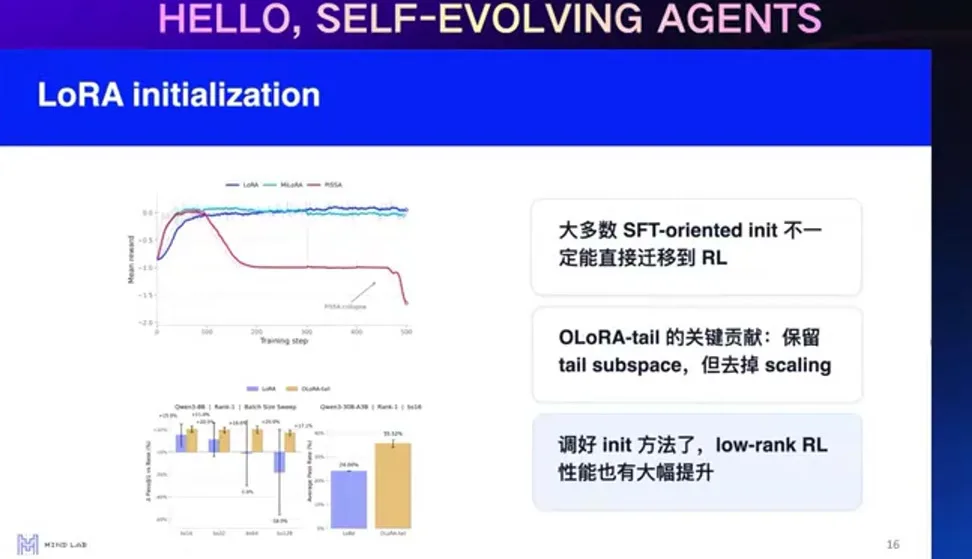
来源:视频讲解区间:00:17:30–00:19:00。
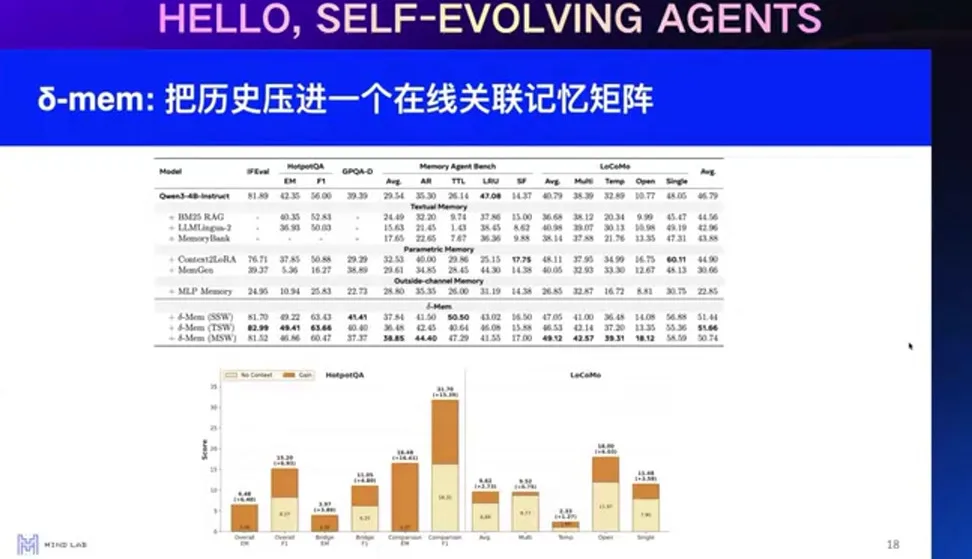
来源:视频讲解区间:00:20:45–00:22:45。
经验写入需要三道门
第一道是价值判断:这次交互是否包含未来可复用信息;第二道是归因:应该更新用户偏好、任务技能还是环境知识;第三道是验证:更新后是否改善目标任务且没有破坏旧能力。
MiNT:训练与服务百万级个性化模型
当每个用户都可能拥有 adapter,问题从算法转向系统:如何调度训练、缓存热模型、合并 batch、管理版本与回滚。MiNT 类基础设施把 adapter 训练和 serving 抽象成服务,使大量小模型共享基础权重与 GPU。
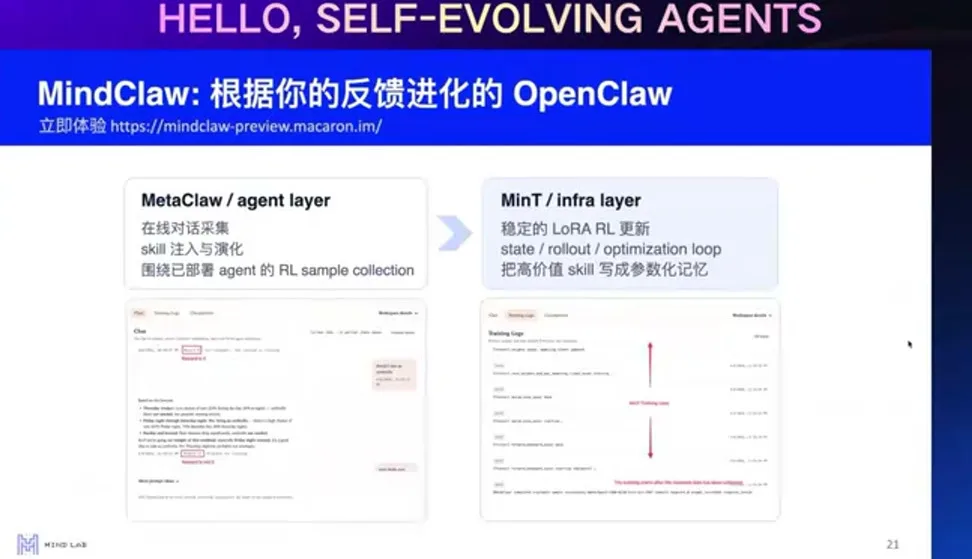
来源:视频讲解区间:00:25:30–00:26:30。
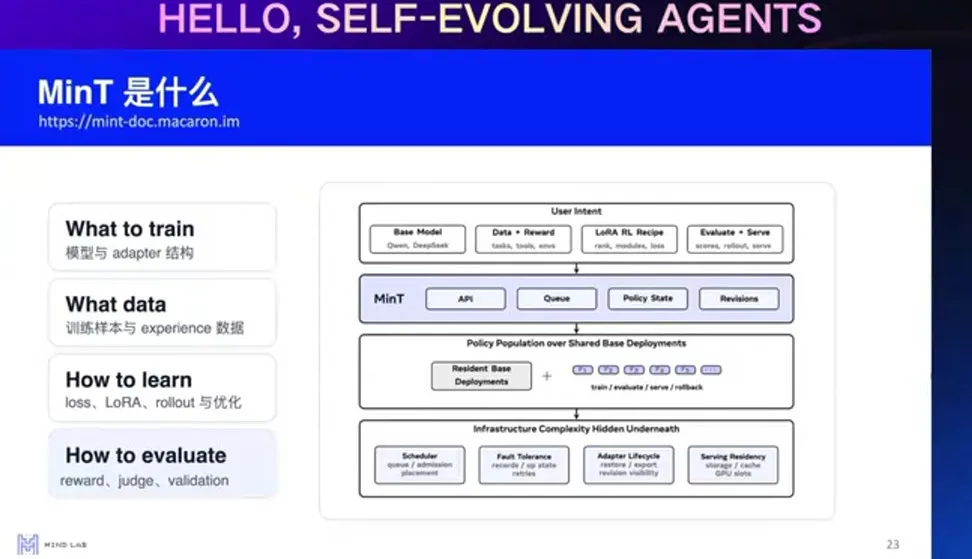
来源:视频讲解区间:00:26:45–00:27:15。
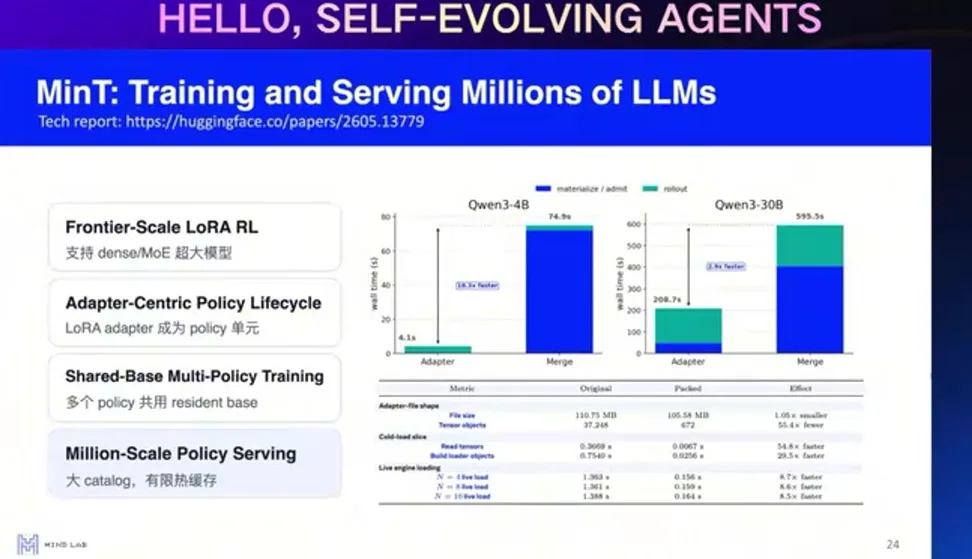
来源:视频讲解区间:00:27:15–00:29:30。
从研究系统到 Personal Agent
最终目标是把记忆、个性化模型和环境工具组合成 Personal Agent。个人智能不只表现为“记得名字”,而是能长期理解目标、协作方式、风险偏好和正在进行的项目,并让这些经验跨任务复用。
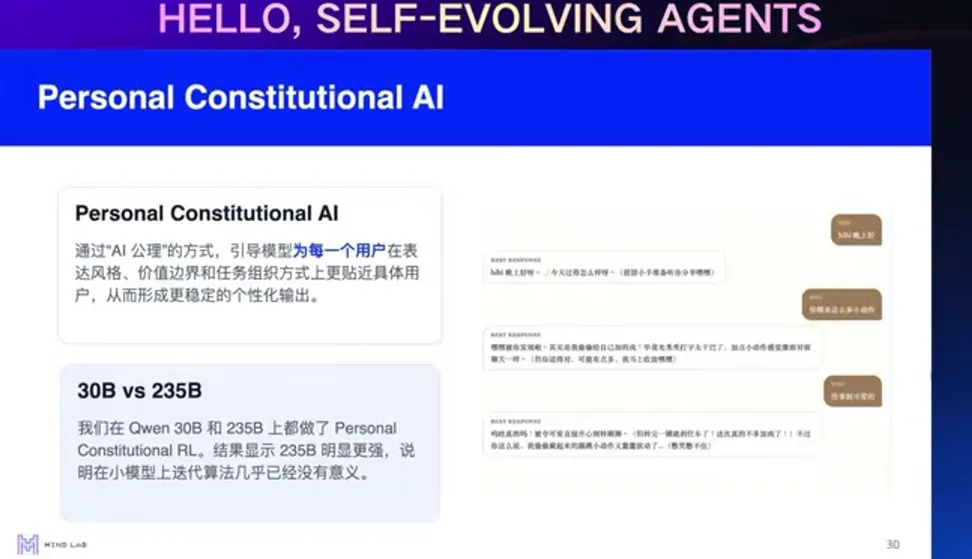
来源:视频讲解区间:00:30:30–00:32:15。
个性化必须包含遗忘与授权
系统应允许用户查看、纠正、删除和冻结经验;敏感信息不能因为被写入 adapter 就失去治理能力。长期学习的产品必须把 consent、retention policy 和模型版本审计作为一等功能。
本章小结
Context Learning 把“给模型什么上下文”变成可学习策略,并用参数高效更新承载可泛化经验。真正可用的经验智能还依赖大规模 adapter 训练与服务、外部可审计记忆,以及明确的写入、验证和遗忘机制。
Agent Externalization:把能力沉淀到参数之外
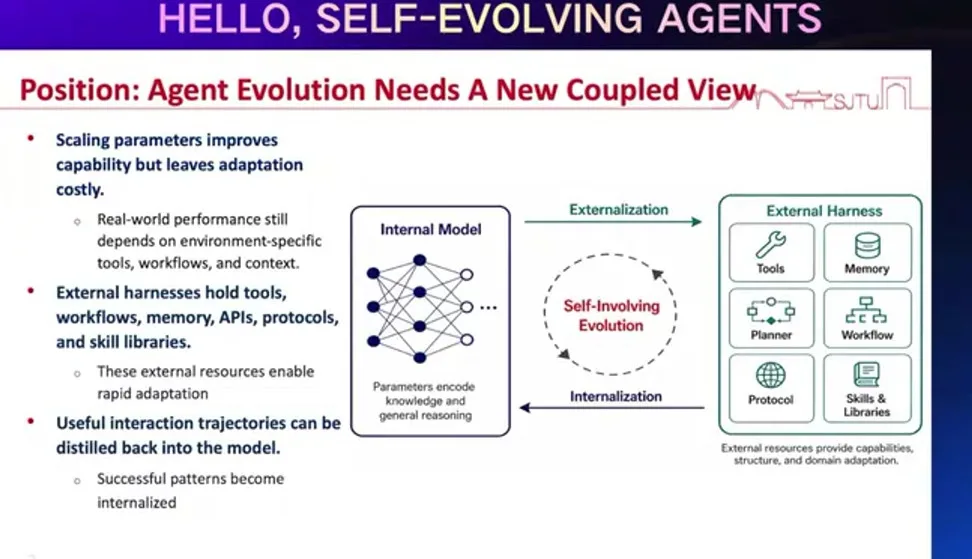
刘卫文的报告讨论从 model scaling 走向 agent evolution 的路线:很多能力不必全部压入基础模型参数,而可以外部化为 memory、tool、skill、workflow 和可持续修改的 harness。Externalization 降低更新成本,也让能力更容易审计与组合。
来源:视频讲解区间:00:00:15–00:01:00。
来源:视频讲解区间:00:01:00–00:04:00。
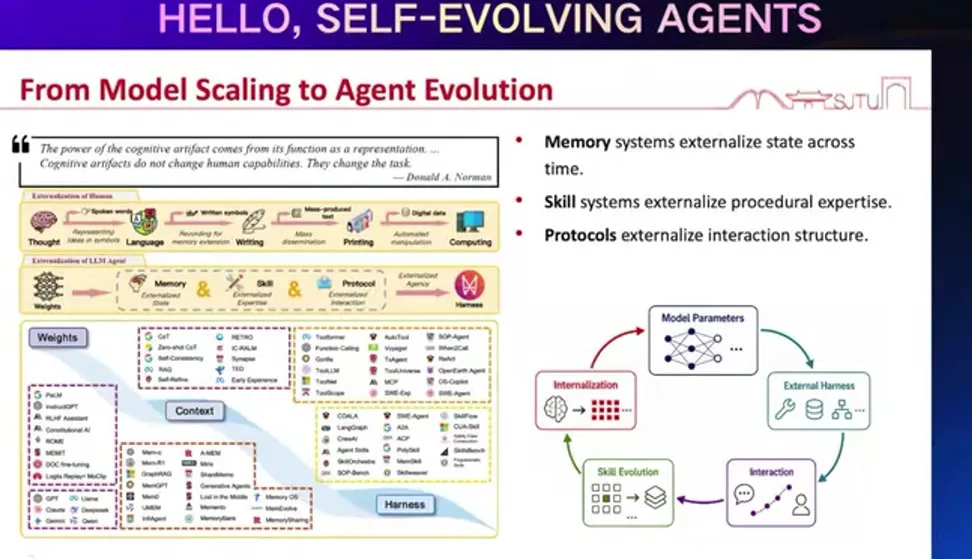
从 Model Scaling 到 Agent Evolution
基础模型提供通用先验,但部署后的改进往往来自外部组件:检索记忆补充新事实,工具提供可执行能力,技能库保存成功流程,harness 决定调用顺序。系统的有效 policy 因而是模型与外部状态的联合函数。
来源:视频讲解区间:00:04:00–00:06:30。
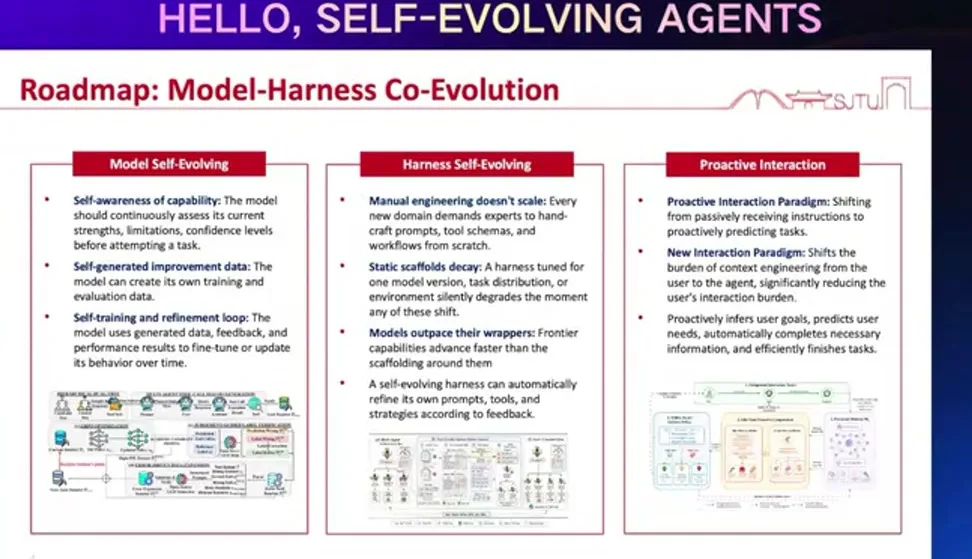
来源:视频讲解区间:00:06:30–00:09:00。
Externalization 的判断标准
需要频繁更新、可解释、可删除或可组合的知识更适合外部化;稳定而广泛复用的模式适合进入参数。错误的边界会导致要么上下文过载,要么每次小变化都必须重新训练大模型。
BALTO:从反思文本到可复用行为
BALTO 类方法让 Agent 从失败轨迹中产生 reflection,再把反思用于下一轮行动。关键不是生成“下次更仔细”的空话,而是抽取可触发、可执行、可验证的规则,并评估它是否跨任务迁移。
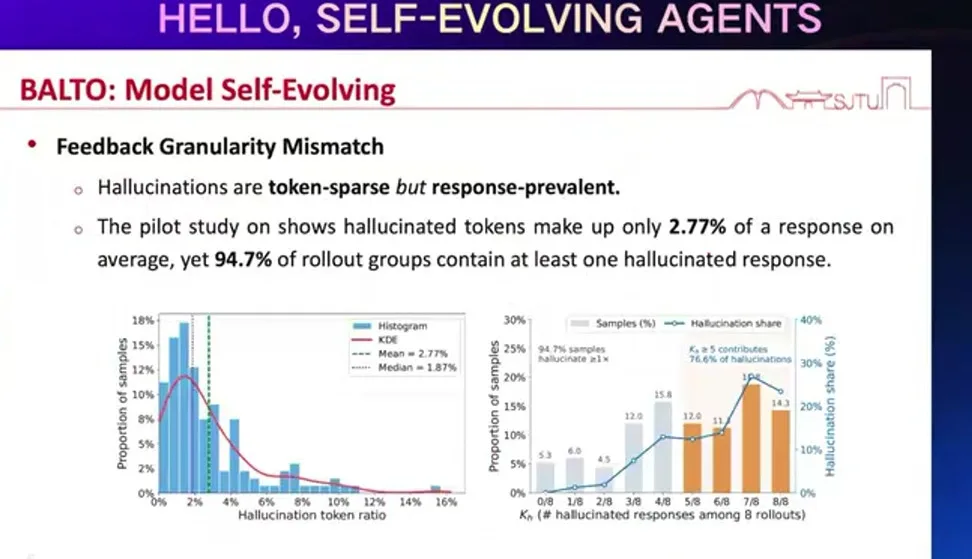
来源:视频讲解区间:00:09:00–00:12:00。
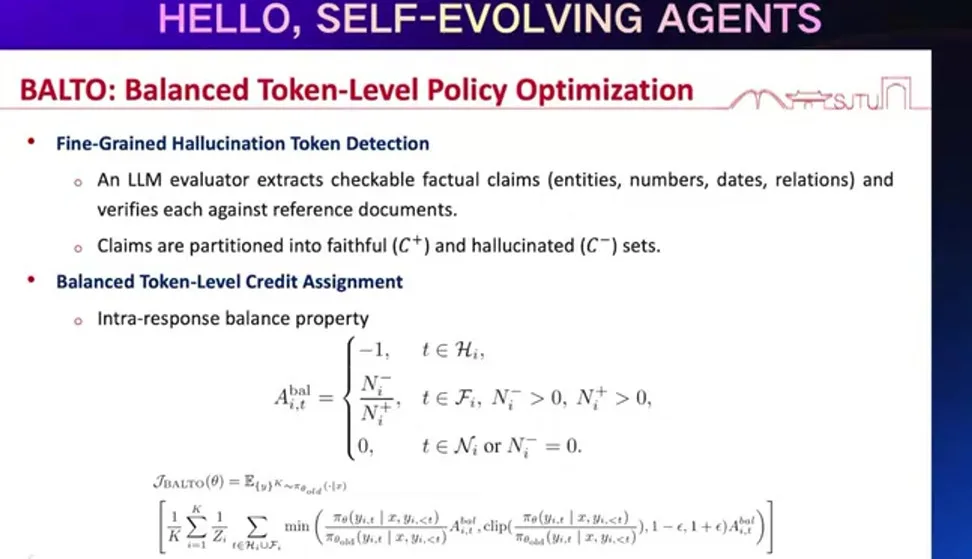
来源:视频讲解区间:00:12:00–00:13:30。
Memory pollution
若每次失败都写入长期记忆,错误归因、偶然经验和互相冲突的规则会迅速污染 context。记忆系统需要置信度、作用域、版本、去重和淘汰机制,并通过真实执行验证写入内容。
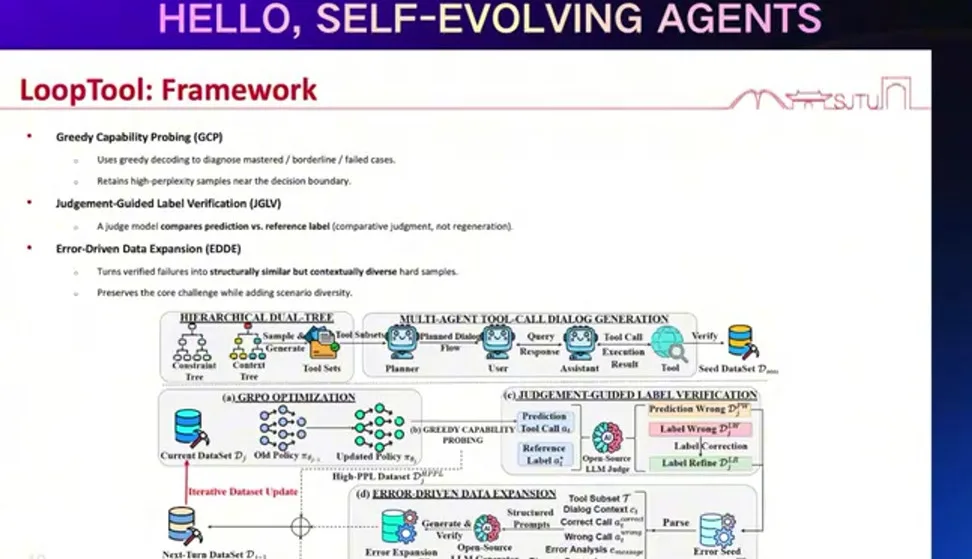
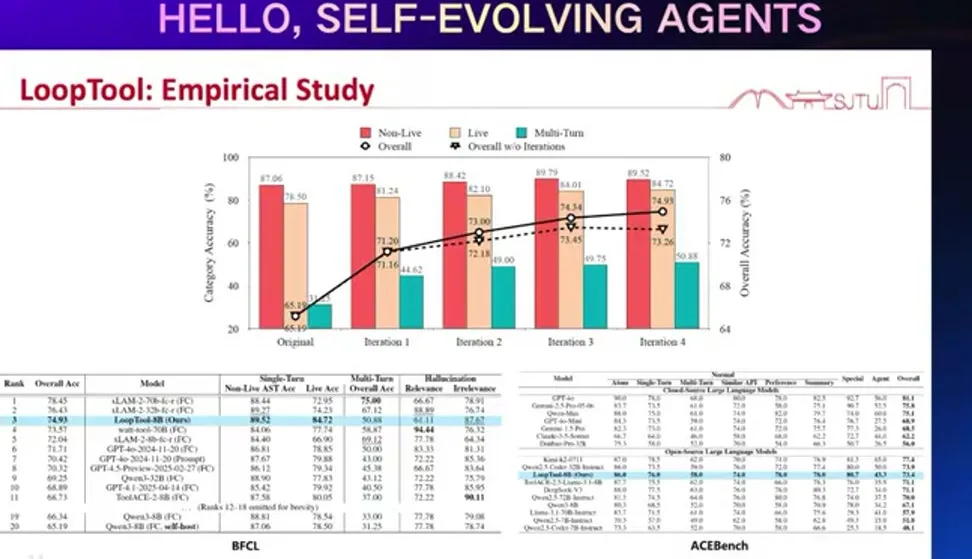
LongTool:让工具能力可增长
工具学习不仅是选择已有 API,还包括理解长工具文档、组合多个工具并把成功调用沉淀为 reusable skill。LongTool 关注长上下文工具环境下的学习与泛化,说明外部工具生态本身可以成为 Agent 进化的能力库。
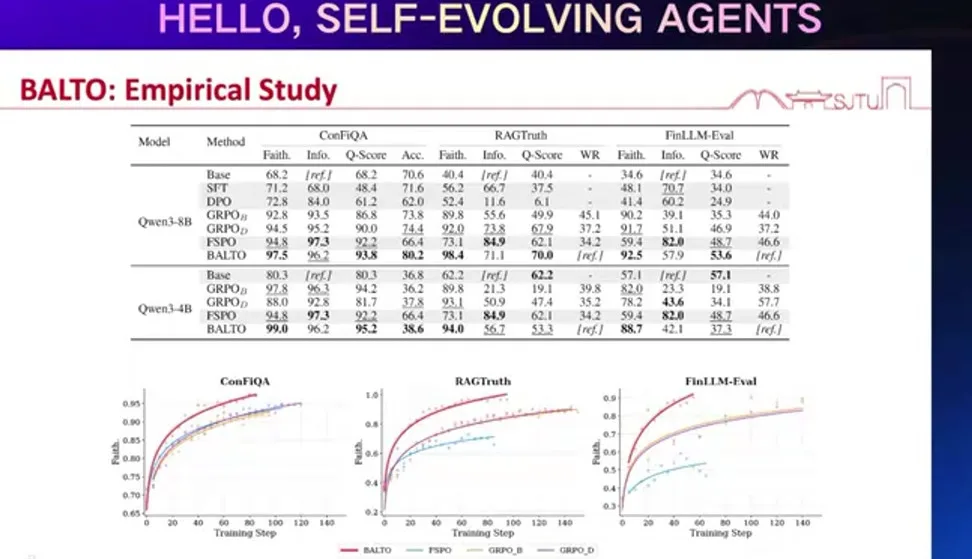
来源:视频讲解区间:00:14:00–00:14:30。
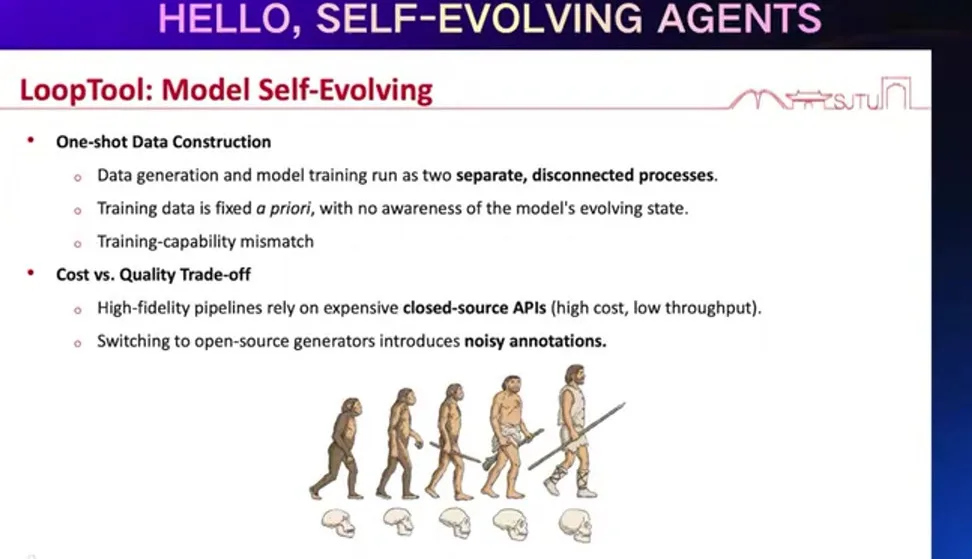
来源:视频讲解区间:00:14:30–00:16:15。
SKiMAS 与 MIMSkill:Harness 和多模态技能也能学习
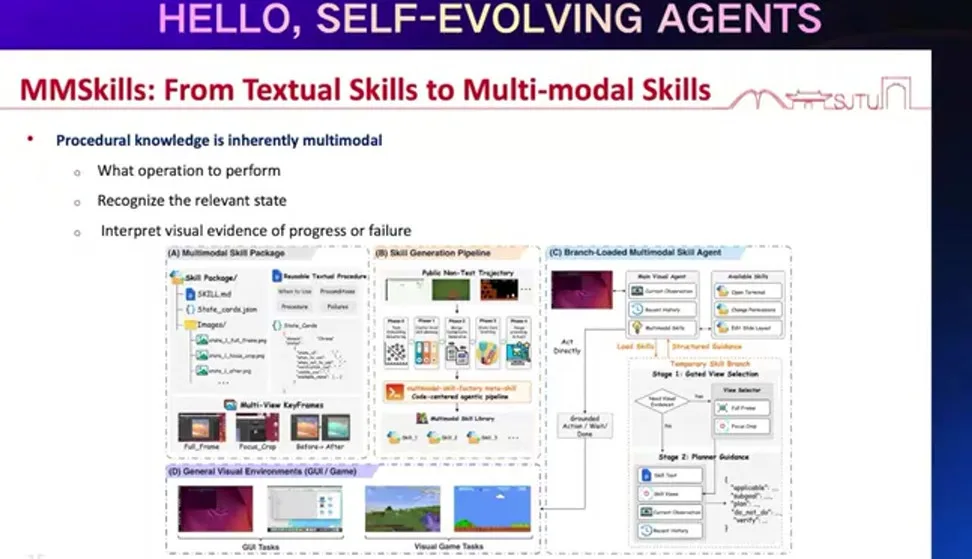
SKiMAS 把 harness 视为可修改对象,让系统从交互中更新模块编排;MIMSkill 则把文本技能迁移到多模态任务。两者共同说明,skill 可以成为连接抽象策略与具体环境的中间表示。
来源:视频讲解区间:00:16:15–00:18:30。
来源:视频讲解区间:00:18:30–00:19:30。
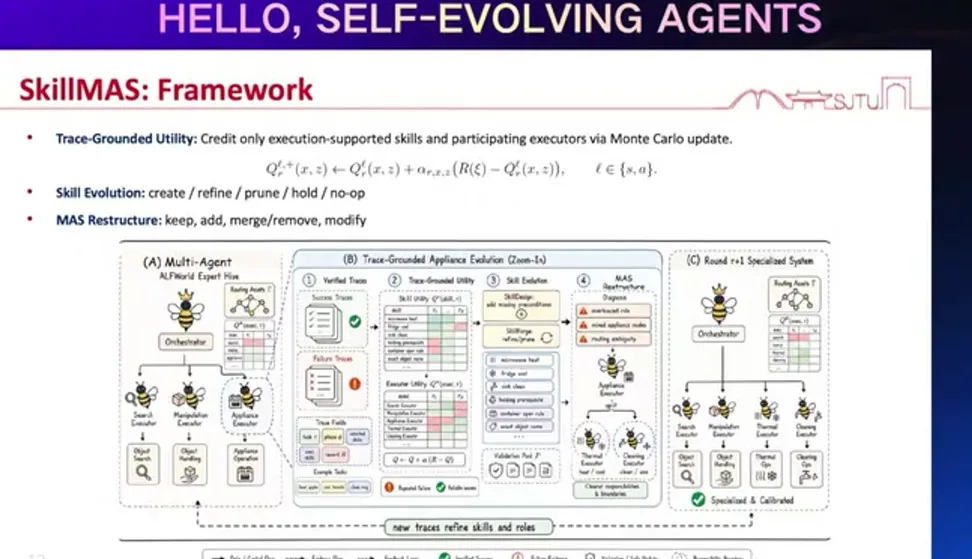
来源:视频讲解区间:00:22:45–00:25:15。
Skill 的工程定义
一个可复用 skill 至少应包含触发条件、所需输入、动作序列、失败恢复和完成判据。只有自然语言总结而没有执行接口的“技能”,很难稳定进入自动规划。
ProAct:从被动响应到主动交互
当 Agent 能维护长期目标和环境状态后,它不必等待用户每次明确提问,而可以在合适时机主动提醒、收集信息或执行准备动作。ProAct 研究 proactive interaction,同时也暴露新的治理问题:主动行为必须控制打扰、权限和不可逆风险。
来源:视频讲解区间:00:26:00–00:28:30。
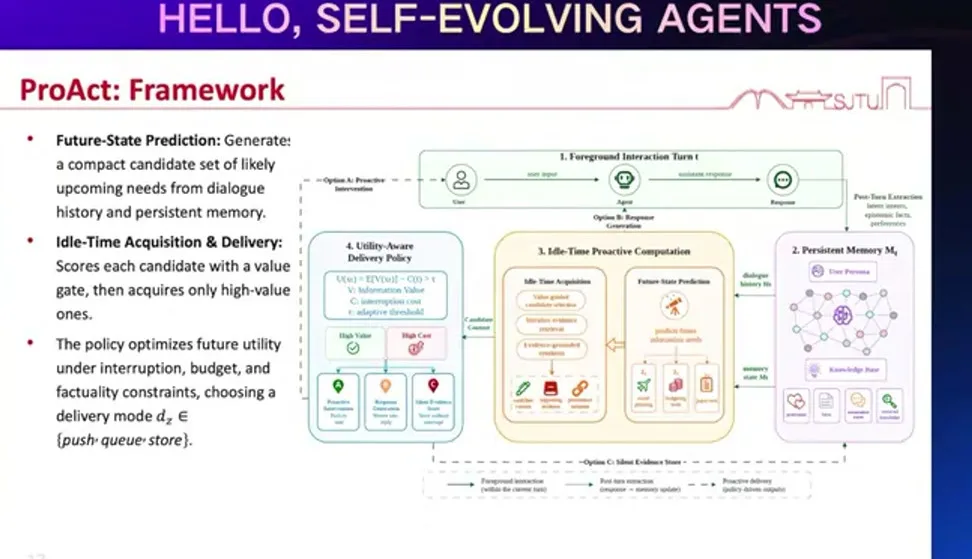
来源:视频讲解区间:00:30:45–00:32:15。
本章小结
能力外部化使 Agent 可以用更低成本持续学习:memory 保存经验,tool 扩展行动,skill 固化流程,harness 组织组件,proactive policy 决定何时主动行动。真正的 self-evolving system 应同时研究 model evolution 与 harness evolution,并给外部状态配置治理和回滚机制。
Theory of Agent:机器智能的“下半场”
王鸿儒试图给 Agent 建立统一分析框架。传统语言模型主要优化“看到输入后生成什么文本”,Agent 则必须回答“什么时候需要行动、应该调用什么外部能力、如何维护跨时间状态,以及如何知道自己不知道”。
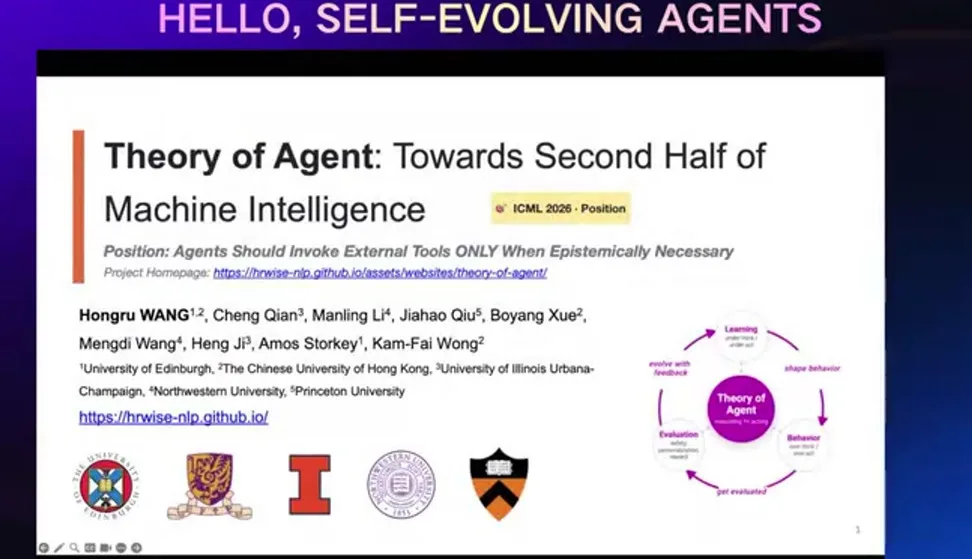
来源:视频讲解区间:00:00:45–00:01:45。
Thinking/Reasoning 与 Doing/Acting
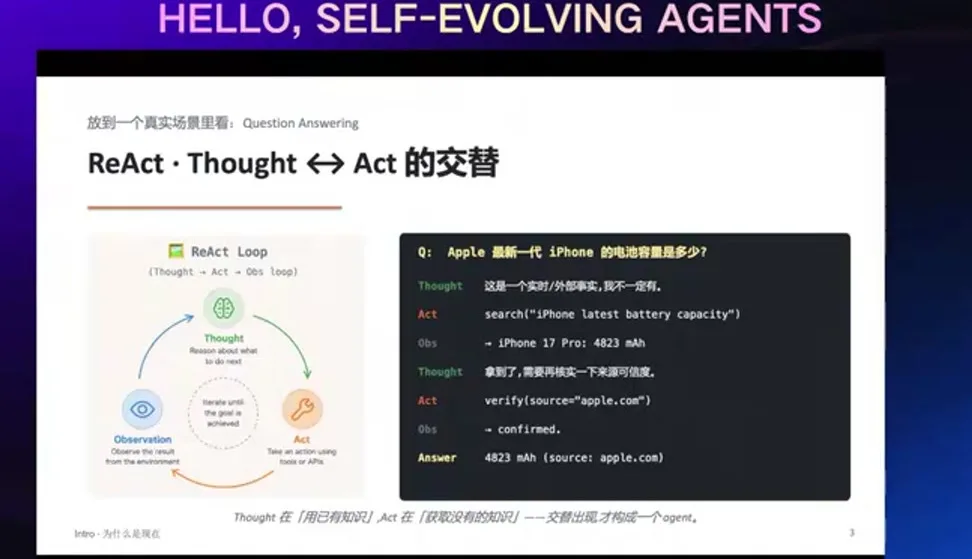
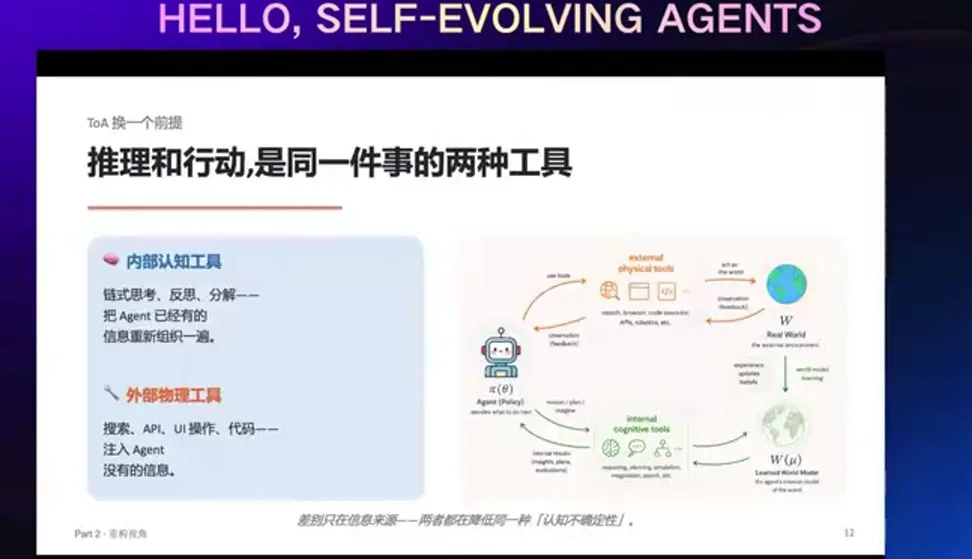
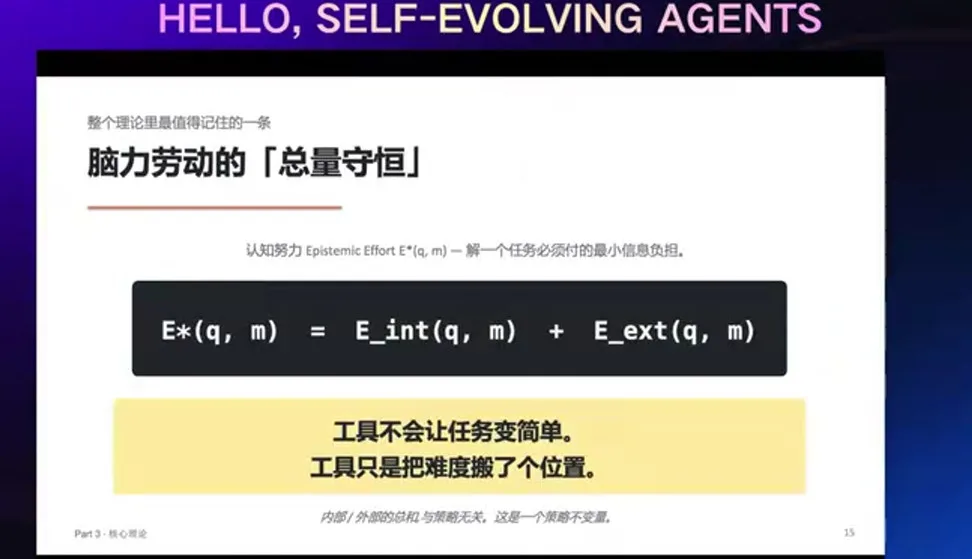
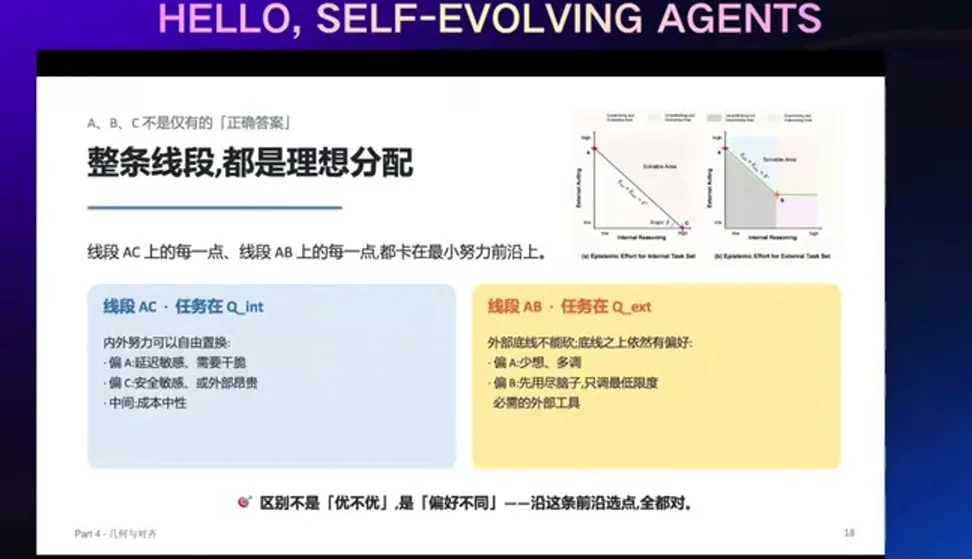
报告首先区分内部推理和外部行动。Reasoning 改变内部 token state,acting 改变环境并获得新信息。一个系统即使能产生很长的 chain-of-thought,也不一定知道何时应该停止内部推演、转而调用搜索、代码或真实执行。
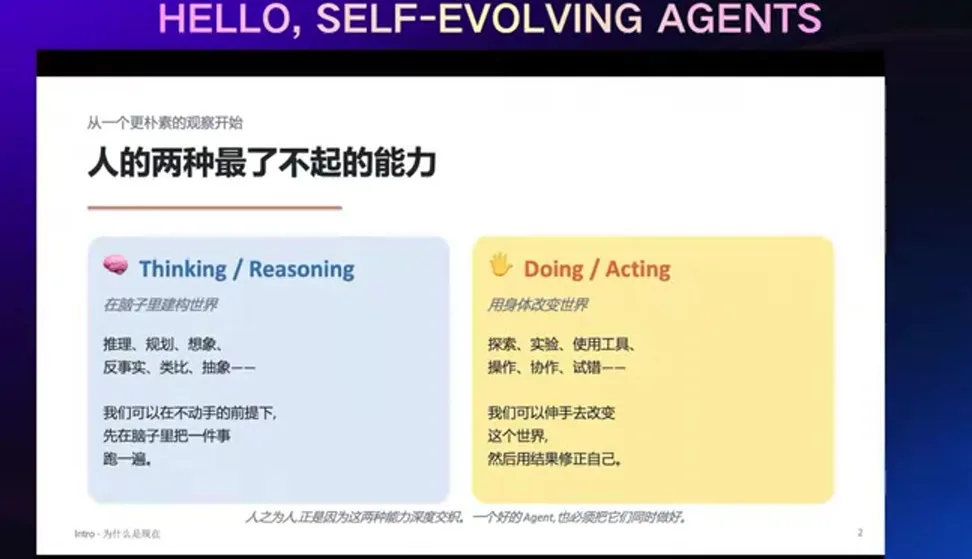
来源:视频讲解区间:00:01:45–00:02:30。
来源:视频讲解区间:00:02:30–00:03:15。
Agent 的核心决策
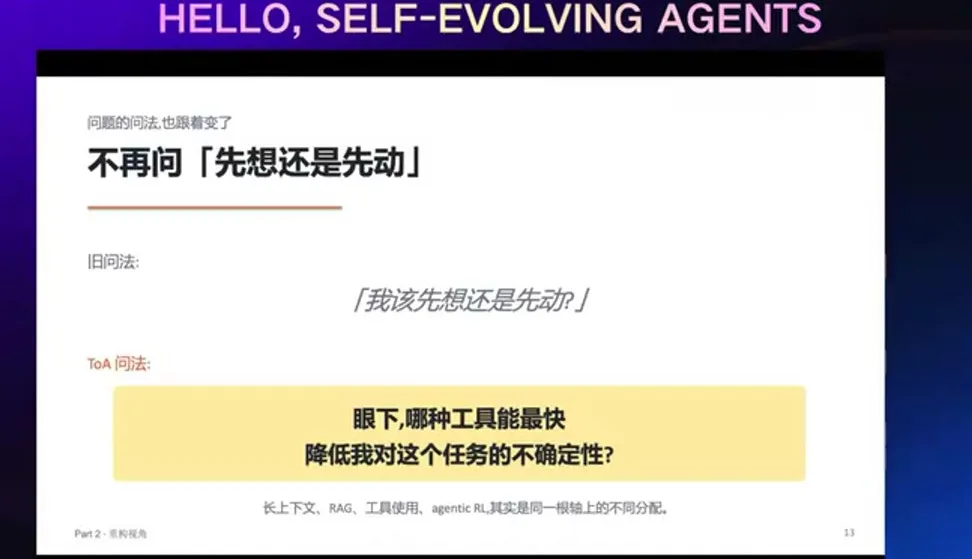
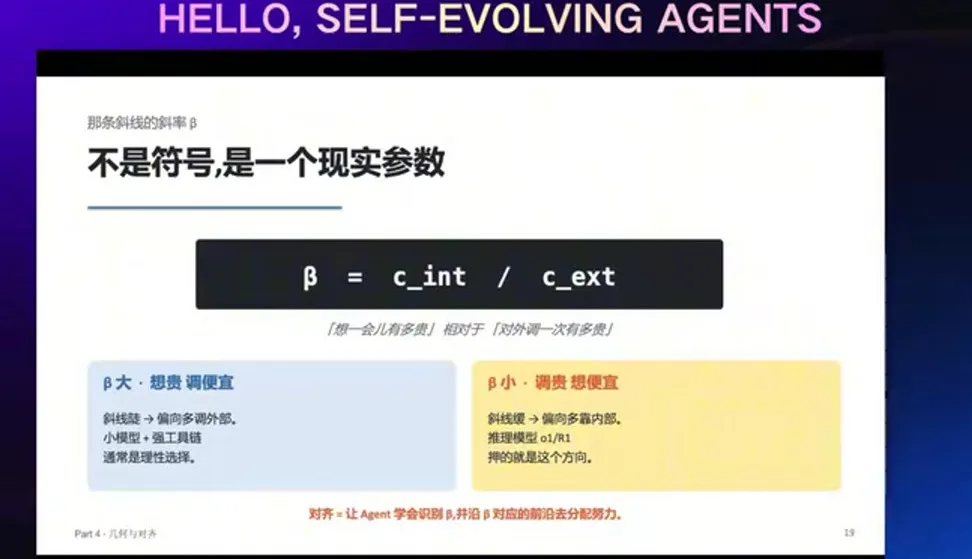
Agent 的基本动作不是“输出答案”,而是在内部推理、调用工具、观察环境、向用户提问和终止任务之间选择。工具调用因此是一个具有成本和信息价值的决策问题。
知识边界与能力边界
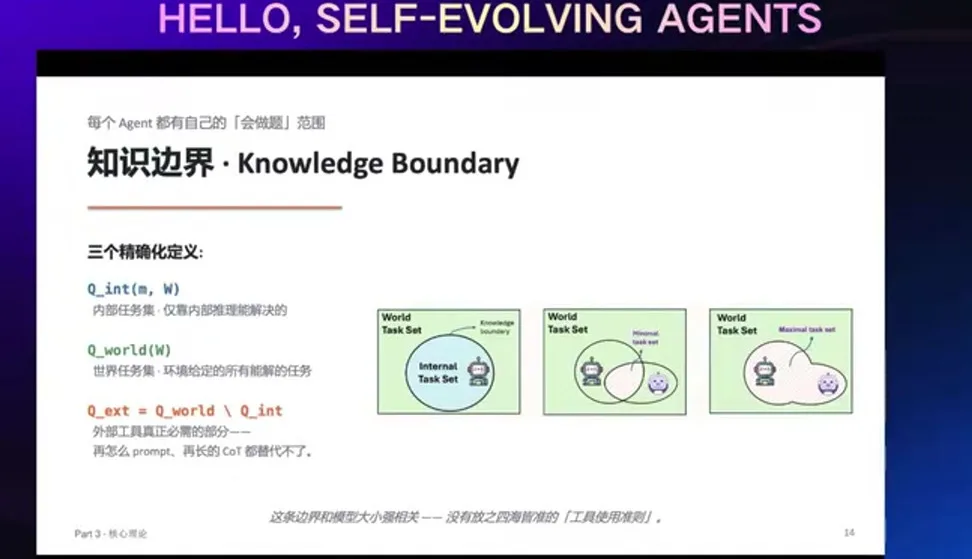
系统需要区分三种状态:已知且可直接回答、未知但可通过工具获得、未知且当前工具也无法解决。若没有 knowledge boundary,Agent 会在需要检索时幻觉;若没有 capability boundary,又会在无法完成的任务上无限尝试。
来源:视频讲解区间:00:11:30–00:13:00。
来源:视频讲解区间:00:13:00–00:14:30。
可以把工具调用写成价值比较:
其中 \(U\) 是任务效用,\(C_{\text{tool}}\) 包含延迟、金钱、隐私和执行风险。Agent 应学习的是期望净收益,而不是“能用工具就用”。
长上下文、RAG、记忆与工具的统一视角
长上下文、检索增强、长期记忆和工具调用都在扩大模型当下可利用的信息边界,但它们成本结构不同。长上下文直接增加 token;RAG 外部检索文档;memory 保存与用户或任务有关的状态;工具则能读取或改变环境。
来源:视频讲解区间:00:14:30–00:15:45。
来源:视频讲解区间:00:15:45–00:17:45。
更多 context 不等于更好决策
上下文越长,检索噪声和注意力竞争也越大;工具越多,选择错误和协议成本越高。系统必须学习 resource routing,而不是无条件扩展输入。
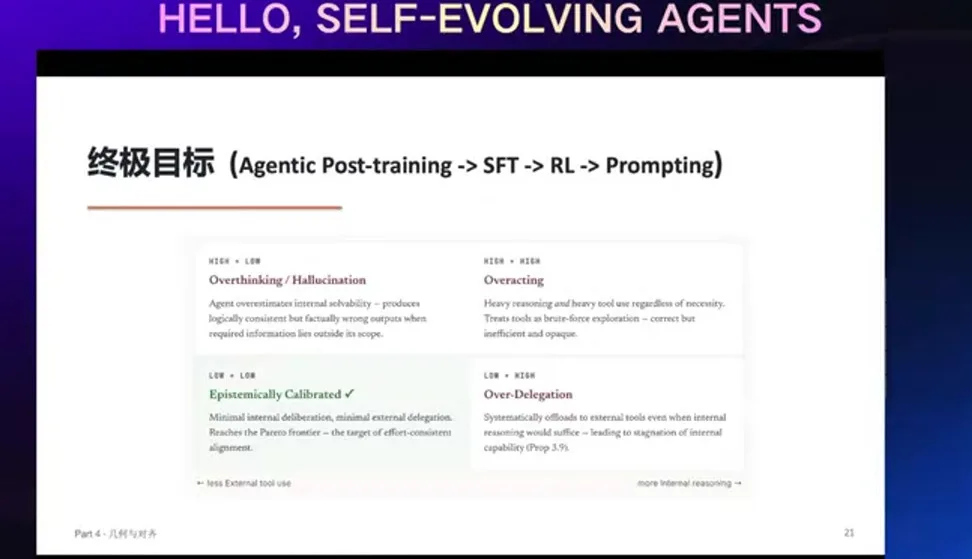
Agentic Post-Training 与统一目标
若希望模型学会何时思考、何时行动,就需要在包含工具和环境的轨迹上训练。Agentic post-training 不只奖励最终答案,还要处理行动成本、过程约束、信息获取和终止时机。
来源:视频讲解区间:00:23:45–00:25:15。
来源:视频讲解区间:00:25:15–00:25:30。
Self-Evolving Agent 的形式化
报告把自进化写成跨 episode 的状态更新。设 Agent 内部可持久化状态为 \(z_t\),单次交互轨迹为 \(\tau_t\),评价为 \(e_t\),则
\(z\) 可以包含模型参数、memory、skill、tool policy 或 harness。这个定义的关键是更新必须跨任务持续存在,并能在未来行为中被验证。
来源:视频讲解区间:00:26:30–00:27:15。
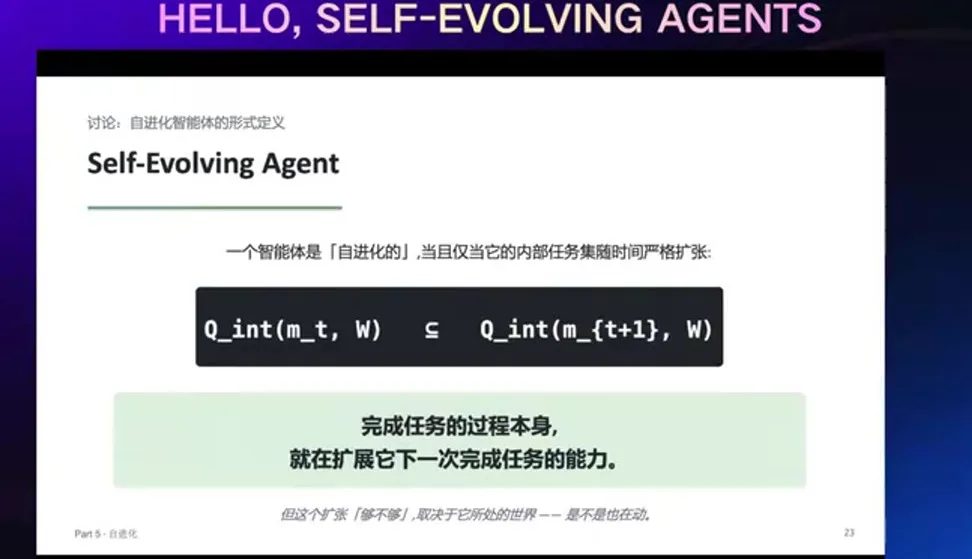
来源:视频讲解区间:00:28:30–00:29:15。
理论的价值
统一框架不一定立刻给出更高 benchmark 分数,但它迫使研究者说明:状态在哪里、工具成本是什么、学习跨越哪个时间尺度、哪些变量能被更新、评估信号来自哪里。没有这些定义,“Agent”“记忆”“自进化”很容易只剩产品标签。
本章小结
Theory of Agent 把机器智能的下半场描述为资源与行动决策:模型要认识知识边界,比较内部推理与外部工具的价值,维护跨时间状态,并通过 agentic post-training 学习成本敏感的交互策略。Self-evolution 则是这些持久状态在反馈作用下发生可验证更新。
下午场 Panel:主动 Agent、AGI 与产业落地
下午场 Panel 由马骁腾、刘卫文、王鸿儒等嘉宾继续讨论经验智能、能力外部化和 Agent 理论,并邀请产业实践者从产品与创业角度补充。讨论的核心不再是单个算法,而是何时可以把一个持续运行的 Agent 交给真实用户。
从 reactive interaction 到 proactive interaction
当前大多数系统等待用户给出明确任务,再在既定 context 中完成;主动 Agent 则需要发现信息缺口、预测未来后果、选择合适时机提醒或行动。主动性带来更高价值,也把错误成本从“回答不好”升级为“做了不该做的事”。
主动性的三项前置能力
系统需要维护长期目标,理解当前环境状态,并估计行动的未来影响。缺少任何一项,主动行为都可能退化为频繁打扰、错误自动化或越权执行。
AGI 是否已经到来:定义比时间预测更重要
嘉宾没有给出统一时间表,但提出了更可操作的判断标准:系统能否面对边界模糊的问题,主动发现未知、定义问题、分解问题,并在没有完整人工脚手架时持续探索。按这个标准,当前 Agent 在垂直任务上很强,却仍高度依赖人提供目标、context、harness 和 verifier。
“知道自己不知道”只是起点
AGI 讨论中反复出现 knowledge boundary。真正困难的不只是识别未知,还要提出可验证问题、选择获取信息的行动,并在新证据到来后更新原有判断。这正好连接 causal exploration、tool use 和 self-evolution。
短期形态:垂直 Agent 的联邦
Panel 认为未来数年更可能出现大量专业 Agent,而不是单一万能体。代码、数据分析、科研、个人助理等垂直系统通过 MCP、skills 或服务接口互相调用,形成类似多细胞系统的联合能力。
这种架构的关键不是接口数量,而是可信委托:调用方必须知道对方能力范围、数据权限、失败模式和成本;被调用 Agent 需要返回可验证结果与 provenance。否则多 Agent 只会放大错误传播。
Agent federation 的系统性风险
一个 Agent 的错误 observation 可能成为另一个 Agent 的输入,局部权限还可能组合成超出任何单体授权的全局能力。联邦系统需要端到端审计、最小权限、预算限制和跨 Agent 的责任链。
个性化产品:长期价值来自 experience loop
产业嘉宾强调,用户不会为抽象的“自进化”付费,而会为持续减少重复沟通、越来越理解工作方式和能主动完成准备工作的产品付费。因此个性化闭环必须落到可观察指标:任务完成时间、纠错次数、用户采纳率和长期留存,而不是只展示记忆数量。
Personal Agent 的产品闭环
用户交互产生经验;系统判断哪些经验值得持久化;memory 或 adapter 更新;下一次任务表现变化;用户纠正又成为新的反馈。每一步都需要可解释入口,尤其是“系统为什么记住这件事”。
研究原型到生产系统的缺口
研究 benchmark 通常有明确任务边界和重置条件,真实产品却面对并发用户、隐私、费用、延迟、模型升级和不可逆副作用。自进化机制进入生产前,至少要解决四个问题:更新隔离、离线回放、灰度发布和回滚。
- 更新隔离:一个用户或任务的错误经验不能污染全局模型;
- 离线回放:新 memory、adapter 或 harness 必须在历史任务上回归;
- 灰度发布:只对小流量启用,并监控能力与安全指标;
- 回滚:保留更新前状态,出现行为漂移时能快速恢复。
自进化系统如何接受治理
传统软件发布的是固定版本,自进化 Agent 的行为分布会在部署后变化,因此治理对象必须从“模型文件”扩展到完整学习过程。需要记录经验来源、更新规则、评估集、审批者和生效范围。
不能让用户成为无意识训练数据
产品应明确说明哪些交互只用于当前会话、哪些进入个人记忆、哪些可能用于全局改进。默认收集一切不仅带来隐私风险,也会把临时情绪、错误输入和敏感内容固化为长期行为。
本章小结
下午场 Panel 将 self-evolving Agent 拉回现实:主动性需要目标、状态和后果预测;AGI 更像主动发现与解决未知的能力,而非某个 benchmark 阈值;近期产品形态可能是垂直 Agent 联邦与个人 Agent。真正可持续的产业落地依赖经验治理、可信委托、灰度更新和用户可控的记忆机制。
总结与延伸
自进化 Agent 的真正难点不是再增加一个 reflection prompt,而是建立一个能够长期运行的学习制度:系统必须持续获得新经验,区分噪声与可迁移规律,把反馈归因到正确决策,并在更新后重新验证旧能力。世界模型提供可干预的解释,环境合成提供课程,rollout infrastructure 提供规模,外部记忆和工具提供低成本持久化,理论与评测则约束系统不要把局部成功误当作一般智能。
拓展阅读
- A Survey of Self-Evolving Agents: What, When, How, and Where to Evolve on the Path to Artificial Super Intelligence.
- Curious Causality-Seeking Agents in Open-ended Worlds.
- Agent-World: Scaling Real-World Environment Synthesis for Evolving Agents.
- Robust Agents Learn Causal World Models.