Lecture 01:AI Agent 如何工作
本讲概览
本讲介绍语言模型怎样通过工具和持续交互构成 Agent,讨论可靠行动所需的六项能力,并将模型训练与 Harness 工程放到完整系统中理解。最后说明课程的构建、评价、训练与研究路线。
本讲义依据课程口述、带时间转录和官方课件整理。正文使用实际视频画面、课件矢量图和机制重绘;图片来源及回看时间见图注脚注。封面图为官方课件标题页。“教学例子”“教学重写”及总结中的延伸分析为解释性补充。本讲义为中文整理稿。
从真实任务理解 Agent 的价值与边界
为什么从成功案例和失败案例一起开始
这节课要回答的是:语言模型怎样从生成回答,发展为能够在软件环境中持续行动的系统?复杂工作需要反复查看情况、执行操作、接收反馈,并决定下一步。Agent 将这些步骤连成一条轨迹。能力提高之后,轨迹可以更长,操作的实际影响也会更大。
开场的编程案例是一项多 Agent 实验:16 个 Agent 在两周内协作构建了约十万行的 C 编译器,讲者说实现语言为 Rust,最终能够编译 Linux 内核。这说明长期协作已经可以完成相当复杂的软件工作。课堂展示的是一个成功案例,并没有给出所有复杂开发任务的平均成功率。
接着,讲者引用了一次邮箱整理事故:Agent 开始删除邮件,用户试图制止,执行却继续。讲者认为,原因可能与历史压缩丢失了“不要删除邮件”的约束有关。这里必须保留“可能”:课程没有提供完整日志来证明压缩是唯一原因。案例的教学意义在于,早先约束必须持续影响当前行动,而用户的干预必须能改变执行过程。
同时考察能力与可靠性
Agent 能执行更多操作,意味着它能解决更多问题,也意味着错误可能造成更大的实际影响。评价一个系统,需要同时查看它能完成什么、遵守了什么边界,以及失败时能否被发现和停止。
自主程度是一项具体的任务设计
课堂用六个场景讨论“自主执行、先询问、禁止执行”。这是一场主观举手讨论,字幕没有记录人数,因此表中只保留讲者观察到的倾向。
| 场景 | 课堂讨论倾向与学习要点 |
|---|---|
| 诊断线上商店结账失败的原因 | 更多人接受自主诊断;实际授权要明确包含哪些操作。 |
| 起草并向五万名客户发送发布邮件 | “先询问”占优势;生成草稿与实际发送是不同动作。 |
| 收集资料、准备并提交 2025 年税表 | “禁止”的票较多,讲者认为“先询问”可能胜出;正式提交有实际后果。 |
| 将支付 API 从 Python 迁移到 Rust,保持移动端结账正常 | 两组接近,讲者暂归自主执行;既有测试为验证提供条件。 |
| 最喜欢的乐队在本地演出时购买门票 | 讲者认为自主购买可能更多;现场讨论包含实际付款。 |
| 根据一周血糖读数调整胰岛素剂量 | “禁止”占优势;可调用接口并不自动意味着应授权执行。 |
这六项讨论把能力、风险和人类监督联系起来。它们是课堂主观判断,没有给出统一的自主性分类标准。一次任务允许 Agent 自行决定哪些步骤,哪些步骤需要人的判断,哪些操作在环境中应被禁止,需要结合具体动作和任务后果讨论。
两个演示如何利用真实反馈
浏览器演示要求寻找匹兹堡一家泰国餐厅,评价至少 200 条,评分至少 4.3,并在候选中选择评分最高的一家。Agent 在 Yelp 搜索并进入餐厅页面,将自然语言条件转成界面操作,再用页面信息判断是否满足要求。演示左侧展示浏览器,右侧展示模型交互,可以同时看到行动表达与界面变化。
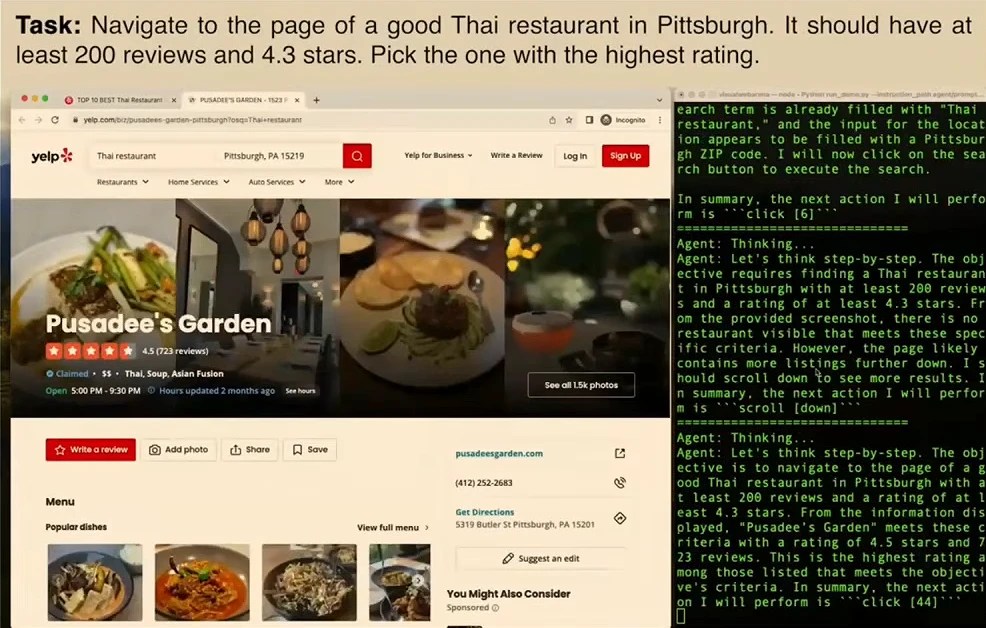
来源:视频画面对应字幕区间:00:07:50–00:08:29;截帧 00:08:10,裁去课堂摄像画面。
OpenHands 演示展示了跨环境工作:创建 Flask 待办事项应用的静态资源和模板目录,编写主程序、页面、样式、依赖文件与 README。changes 面板展示实际文件修改。之后 Agent 在后台启动服务,读取日志;发现端口被占用后继续排查,最后在浏览器中输入 Buy groceries,添加待办项,并测试完成和删除操作。代码生成、程序运行和界面检验被连接到同一条任务轨迹中。
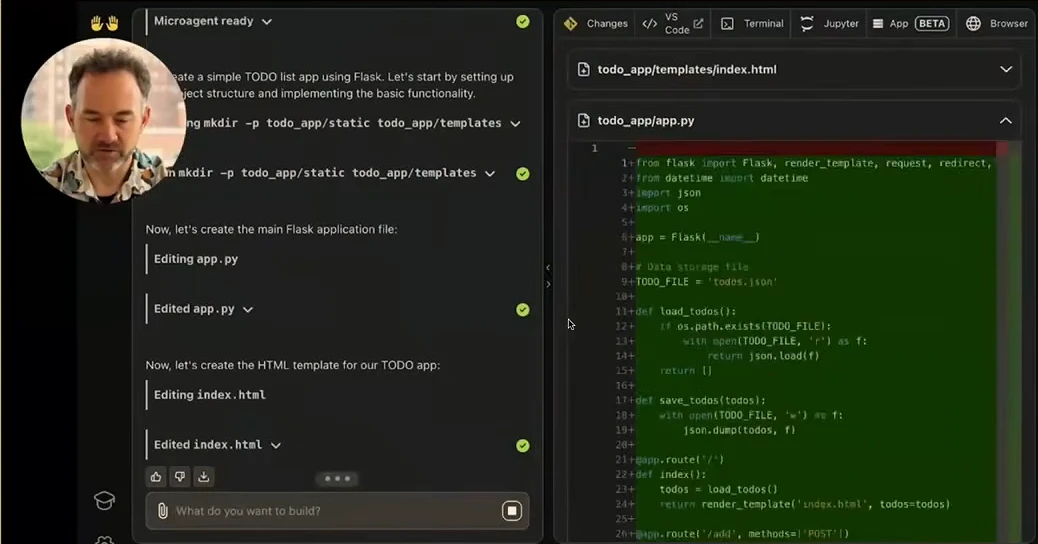
来源:视频画面对应字幕区间:00:09:01–00:09:34;截帧 00:09:20。
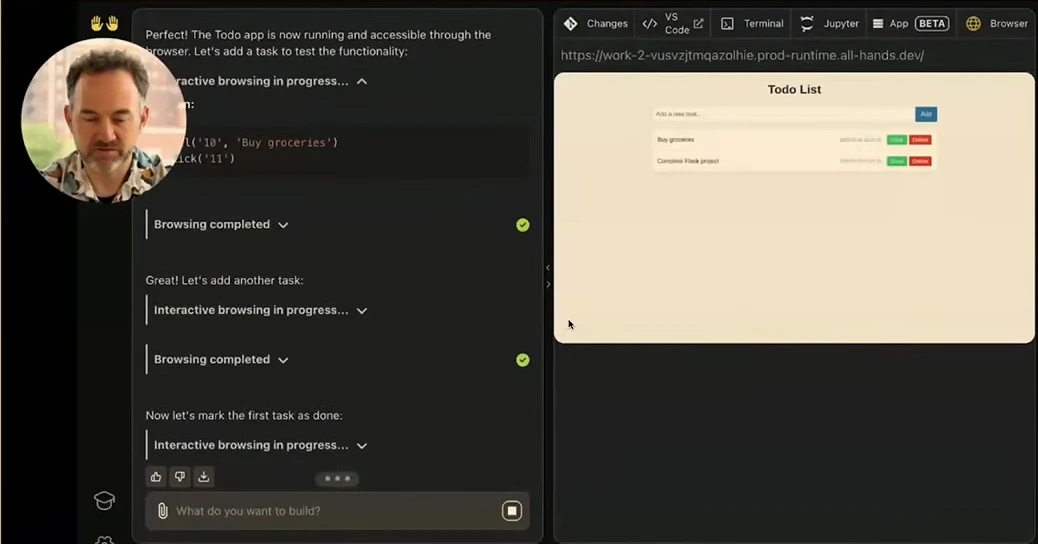
来源:视频画面对应字幕区间:00:10:41–00:11:26;截帧 00:11:00。
日志为运行是否成功提供观察,浏览器为功能是否符合要求提供另一种观察。讲者还提到一次此前使用经历:应用崩溃后,Agent 主动发现并修复问题。这个附带经历与当前展示的端口排查、功能测试属于不同事件。
本章小结
复杂编程和应用操作展示了 Agent 的用途,邮箱事故展示了约束保持与干预机制的重要性。演示有助于看清机制,可靠性则需要更系统的评价。后续章节将解释:模型怎样表达动作,外部系统怎样执行,以及反馈怎样进入下一轮。
Agent 的基本组成:环境、观察、行动与评价
把经典定义映射到软件环境
Agent 是一个长期存在的人工智能概念。Russell 与 Norvig 将它描述为能够通过传感器感知环境,并通过执行器作用于环境的实体。在语言模型驱动的系统里,软件接口承担了传感器与执行器的作用:读文件、看网页和接收工具结果提供观察;写文件、执行命令和调用 API 产生行动。讲者指出,经典搜索与强化学习中的许多思想仍适用于今天的 Agent。
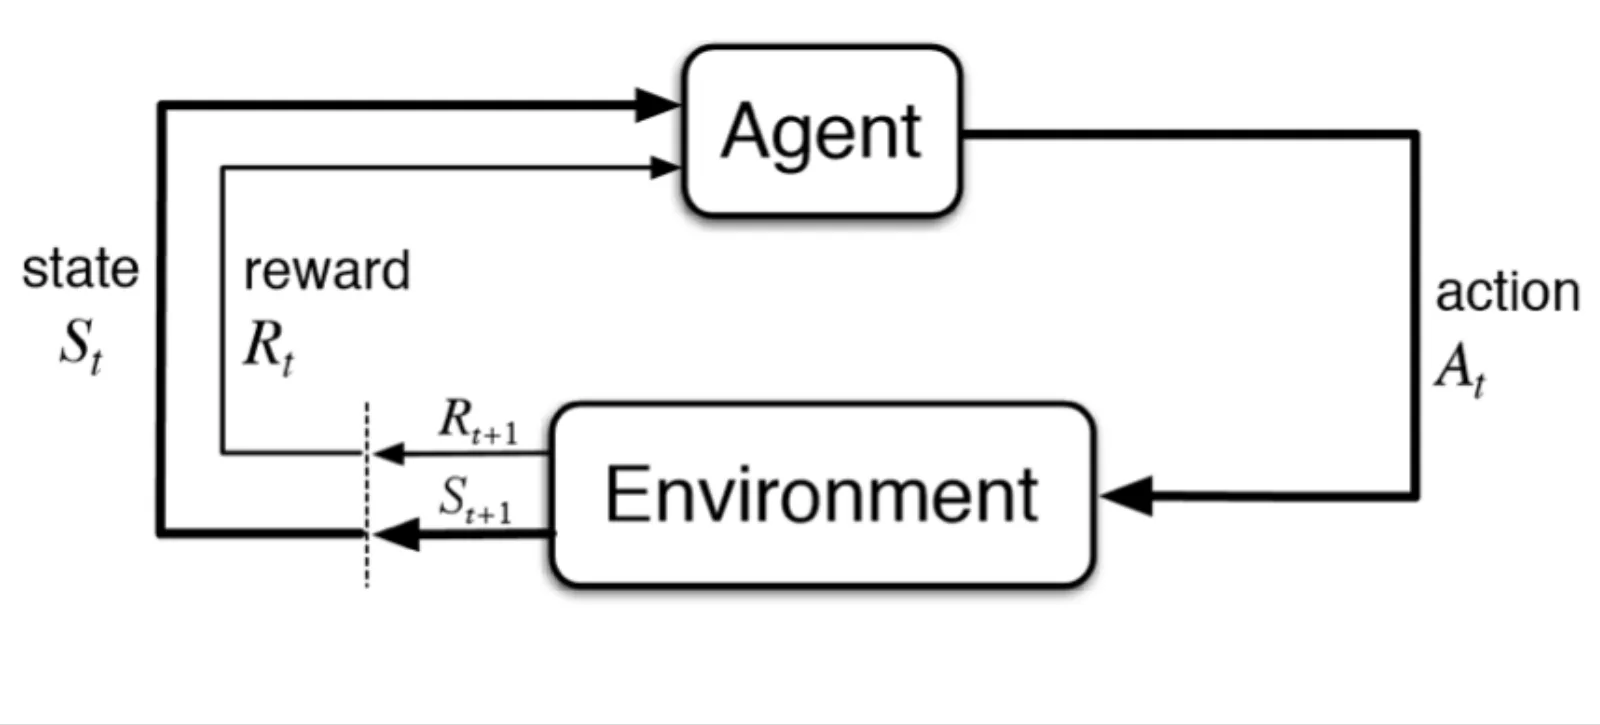
来源:图源:CMU 官方讲义第 9 页裁图;对应口述 15:33–19:20。图为官方幻灯片素材,非视频截帧。
| 组成 | 在 Coding Agent 中的含义 |
|---|---|
| Environment | 仓库、文件系统、运行进程、网站或应用,以及可交互的服务。 |
| State / Observation | 环境具有实际状态;Agent 当前看到的是消息、文件、页面、截图和工具输出。 |
| Action | 回复用户、修改文件、运行命令、调用接口,或发送鼠标键盘事件。 |
| Reward / Evaluation | 判断成功程度的信号,如测试结果、按标准进行的模型评审与用户反馈。 |
图中的状态、行动和奖励符号用于表示连续时刻的交互:Agent 收到当前信息,采取动作,环境随后提供新的状态信息及评价信号。在实际软件任务中,一次工具返回往往只揭示环境的一部分。例如,读取一个文件并不能看到整个仓库;某次命令输出也不能证明所有功能都正确。这个解释性展开说明了持续观察的必要性。
读取也是行动,观察不等于成功
编辑文件会改变环境;读取文件的主要效果是让模型获得信息。二者都可以成为下一轮行动选择的一部分。一个 Agent 不需要每一步都写文件,它可能先做许多读取和检查,再决定如何修改。
工具结果告诉我们操作实际返回了什么。奖励或评价则判断这些结果是否满足目标。对有测试的代码任务,可以把通过记为 1、不通过记为 0;对较难程序化判断的任务,课程也提到模型评审和用户反馈。信号的意义取决于它覆盖了哪些需求。
不要混淆三个层次
环境状态是实际发生的情况,观察是系统当前获得的信息,评价是对目标是否达到的判断。命令成功退出、测试通过、用户需求被满足,分别需要相应证据。部署中的 Agent 也未必在每一步都显式接收数值奖励。
从文本预测到中间推理
语言模型在每一步以已有 token 前缀为条件,预测下一个 token 的概率分布。通过采样或其他选择策略获得一个 token 后,将它追加到前缀,再进行下一步预测。整段输出由这些连续步骤形成。
思维链(Chain of Thought)让模型在回答之前生成中间推理 token;这些内容又成为后续预测的上下文。课件用“2 乘以(3 加 4)”得到 14 的算术例子,说明题目、推理与答案之间的关系。类似草稿纸的中间文本,为后续生成提供更多条件信息。
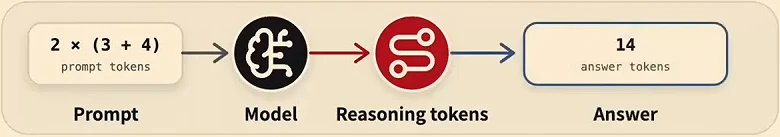
来源:视频画面对应字幕区间:00:17:56–00:19:20;截帧 00:19:15。
这解释了模型怎样产生输出。要获得当前天气、读取真实仓库或操作应用,还需要把某些输出接到环境中的可执行接口。下一章的工具协议承担这个连接。
本章小结
分析 Agent 时,先识别它所处的环境、可见的观察、允许的动作和成功标准。模型的文本预测提供决策表达,环境接口提供实际信息与后果。两者怎样连接,将决定一次输出能否成为一项可执行行动。
工具调用:从接口消息到模型序列,再到执行
一次工具交互有三个对象
课程用天气查询引入工具:用户的问题需要最新环境信息,模型可以调用天气接口,读取真实数据后继续回答。代码任务里的文件读取接口承担类似作用。
定义、调用与结果
工具定义告诉模型有哪些能力,以及怎样表达请求;工具调用表达本轮想执行的具体操作;工具结果报告执行环境实际返回的信息。三者分别对应接口、意图和反馈。
工具定义怎样进入模型
read_file 示例包含工具名称、自然语言描述和参数结构。名称帮助选择接口,描述说明用途,JSON Schema 约束参数。示例只有一个必填字符串 path。
结构化对象还要经过 chat template 渲染,再经 tokenization 成为模型输入。模型需要通过训练或示例学会理解这种表示。下图保留原课件的 schema 与序列化示例,便于对应 apply_chat_template 这一层。
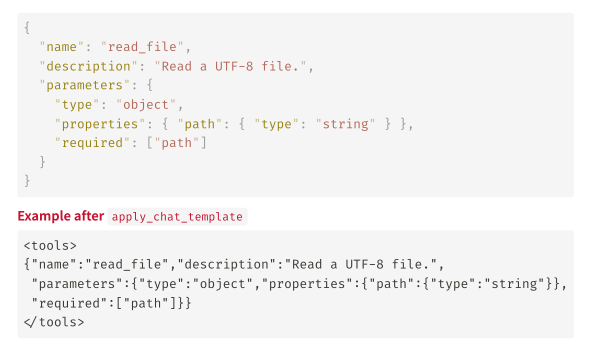
来源:图源:CMU 官方讲义第 11 页裁图;对应口述 19:20–21:28。模板标记是课堂示例,并非通用协议。
接口消息、模板与模型输入
messages / tools / tool_calls / tool results 是接口层的结构化信息;chat template 将角色、边界与工具内容组织成序列;tokenization 再把序列转成模型使用的 token IDs。实际服务可以合并这些步骤,但机制上的层次仍然需要区分。
调用与返回为什么必须关联
课件中的 assistant 消息生成 read_file 请求,携带路径 test.py 和调用标识 call_7。执行后,tool 消息用 tool_call_id 指向同一次调用,并返回内容。这个关联让系统能够区分每次请求与对应结果,尤其在出现多个调用时非常重要。
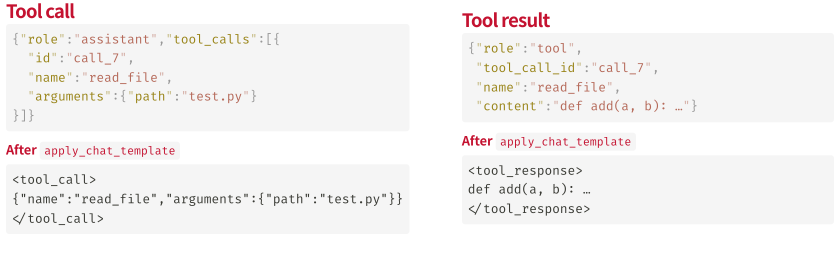
来源:图源:CMU 官方讲义第 12 页裁图;对应口述 21:28–23:07。这里展示消息概念,不构成某供应商 API 的完整请求格式。
模型请求读取文件之后,环境才实际访问文件系统。返回的文件内容随后进入历史,成为下一轮判断的依据。请求中写着“读取了什么”,并不能替代执行结果。返回也可能包含错误,这种反馈同样应该被下一轮看到。
示意标记与真实协议
<tools>、<tool_call> 与 <tool_response> 是课堂展示的格式。不同模型和服务可以使用不同模板、特殊标记及消息字段。需要掌握的是序列化机制和消息职责;具体接入时以所用系统的协议为准。
JSON、Bash 与 Python 都能表达行动
课堂问答指出,模型也可以通过 Bash 命令或 Python 调用表达动作。这些形式同样是可生成的 token 序列。代码接口可以表达多个操作与控制流;相应的执行边界、错误处理与反馈也需要明确。讲者认为代码式调用在一些场景很有效,下一讲会进一步讨论取舍,本讲没有给出普遍优劣结论。
Harness 让调用产生实际后果
模型生成行动表达之后,Harness 负责解析、校验、执行,并返回观察。它同时决定哪些动作被允许,如何处理参数错误、执行失败和权限限制。工具定义描述一个能力,实际授权则由运行系统落实。
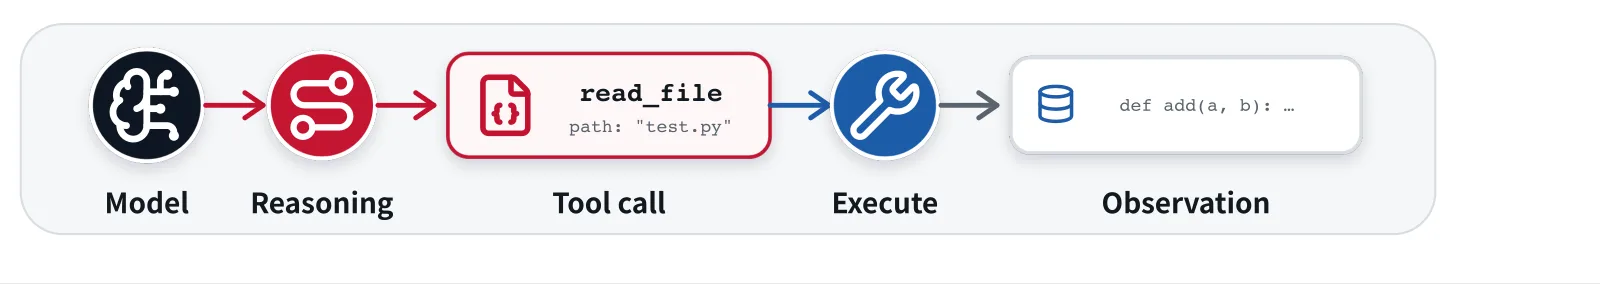
来源:图源:CMU 官方讲义第 13 页裁图;对应口述 23:07–25:19。图展示一次交互,完整反馈循环见下一章重绘图。
Toolformer 在此作为研究脉络出现,说明工具使用可以被纳入语言模型训练:模型学习何时调用工具,并利用结果改善后续生成。课程没有在这里展开它的完整数据构造与实验方法。
本章小结
接口对象经过模板成为模型输入,模型生成可解析的行动请求,Harness 执行并获得观察,再将观察放回上下文。理解这条链路,就能把 tool call 的 JSON、模型序列和真实文件操作联系起来,并定位错误究竟发生在哪一层。
拓展阅读
Toolformer: Language Models Can Teach Themselves to Use Tools。阅读时先关注工具调用怎样进入模型训练,具体实验可在 L2 后补充。
ReAct:让模型在观察与行动之间持续推进
一次读取为什么往往只是下一步的线索
代码 Agent 可能先读测试,再定位实现、修改文件、运行测试。每一步都依赖之前的实际结果。ReAct 将推理与行动交替组织:任务、工具定义和历史构成本轮上下文;模型提出下一步动作;环境执行;新观察回到历史;模型继续决策。
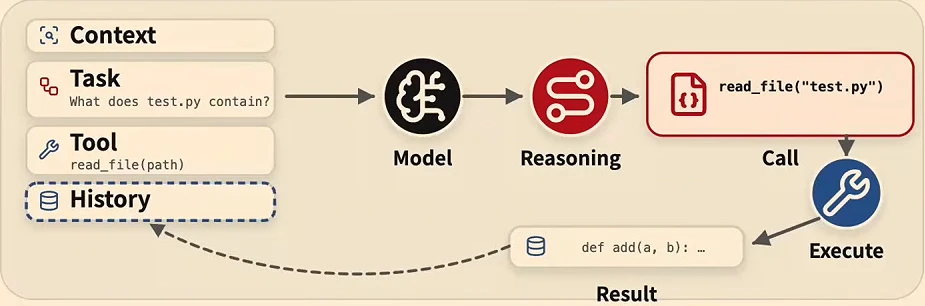
来源:视频画面对应字幕区间:00:25:19–00:26:25;截帧 00:25:55。
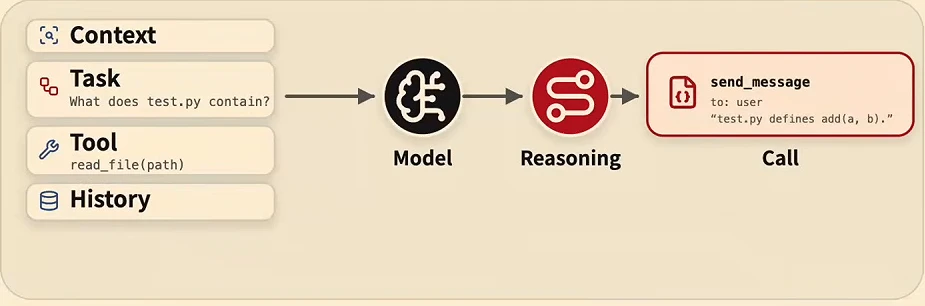
来源:视频画面对应字幕区间:00:25:19–00:26:25;截帧 00:26:10。
图中“完成”需要控制协议支持。例如,系统可以设置发送最终消息或结束任务的工具。模型发出完成信号后,Harness 决定如何结束循环。任务真的完成没有,还要由成功标准和验证证据判断。
最小控制器表达了哪些责任
官方讲义引用 mini-swe-agent:run() 初始化 system/user messages,循环调用 step();query() 调用模型并保留输出;execute_ actions() 执行动作并追加观察。下面按课件重排源码节选,长语句作了换行;执行动作的函数仅展示说明,没有给出完整函数体。
def run(self, task: str = "", **kwargs) -> dict:
    self.messages = []
    self.add_messages(
        self.model.format_message(
            role="system",
            content=self._render_template(
                self.config.system_template)),
        self.model.format_message(
            role="user",
            content=self._render_template(
                self.config.instance_template)),
    )
    while True:
        self.step()

def step(self) -> list[dict]:
    return self.execute_actions(self.query())

def query(self) -> dict:
    message = self.model.query(self.messages)
    self.add_messages(message)
    return message

def execute_actions(self, message: dict) -> list[dict]:
    """Execute actions in message, add observation messages,
    return them."""
step() 中的两次调用直接表达了“先查询,再执行”。query() 把本轮输出写回历史,execute_ actions() 的职责是执行并加入观察。课件没有展示错误恢复和终止机制,因此不能仅凭 while True 判断完整实现怎样结束。源码节选来自官方课件第 15 页,对应口述 00:26:25–00:28:08。
下面是教学重写的伪代码。它将状态变化放在一个位置,并显式添加完成出口和步数预算,方便看清生命周期。这些补充不属于课件原代码,也不是可直接运行的 SDK 示例。
messages = [
    {"role": "system", "content": system_context},
    {"role": "user", "content": task},
]

for step in range(max_steps):
    action = model.query(messages, tools=tool_definitions)
    messages.append(action)

    if action.kind == "finish":
        return action.answer

    observations = harness.execute(action)
    messages.extend(observations)

raise RuntimeError("Step limit reached")
messages.append(action) 保留模型做出的决策;harness.execute(action) 接触真实环境;messages.extend(observations) 将实际反馈交给下一轮。如果观察没有回流,后续决策就无法利用新证据。若没有预算、错误政策与终止协议,简洁的循环还不能承担完整的生产任务。
讲者强调,简单控制器在当时模型上也能取得很好的软件修复表现;本讲未提供精确分数,不能据此推导所有 Harness 都应越简单越好。更可复用的知识点是:核心循环很短,可靠运行则需要把状态与边界管理清楚。
从 SWE-bench 轨迹看见真实执行
课程随后从 SWE-bench 页面打开 gpt-oss-120b 的运行集合,通过 Docent 查看一条 shell Agent 轨迹。系统消息规定可以通过 shell 完成编程任务;用户消息给出 Django 的问题:AdminSite. catch_ all_ view() 在重定向时丢失了查询字符串。
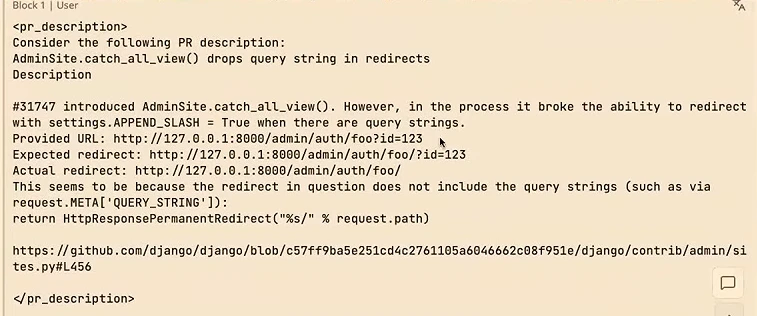
来源:视频画面对应字幕区间:00:28:38–00:29:19;截帧 00:29:10。
问题描述提供了可检查的差异:输入 URL 末尾有 ?id=123;期望补上路径斜杠之后仍保留 ?id=123;实际重定向却丢掉了这一部分。这将“修复代码”具体化为一个行为要求。
第一步,模型表示要查看仓库内容以定位 Django admin 的实现,生成 ls -R。环境执行后返回 exit code 0。第二步,模型生成搜索命令,定位 catch_all_view 的定义,工具返回 django/contrib/admin/sites.py 的函数位置。
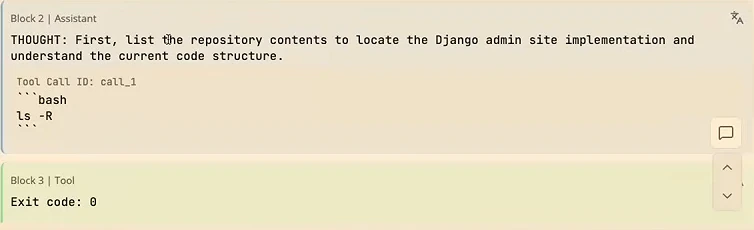
来源:视频画面对应字幕区间:00:29:19–00:30:02;截帧 00:29:40。
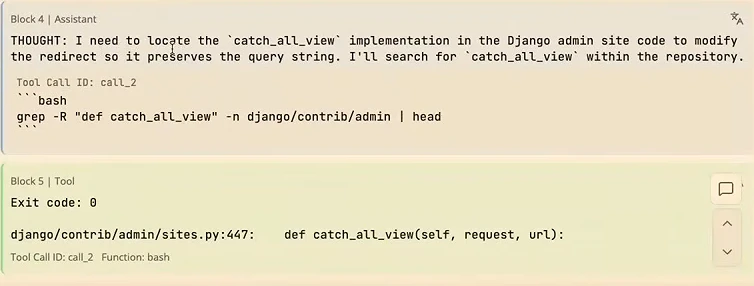
来源:视频画面对应字幕区间:00:29:19–00:30:02;截帧 00:30:00。
ls -R
grep -R "def catch_all_view" -n django/contrib/admin | head
这条轨迹展示了推理、动作、执行结果和下一轮动作的对应关系。exit code 0 表示进程按约定成功退出;它没有证明查询字符串问题已修复。课堂展示集中在轨迹的起始步骤,没有展开最终补丁和测试结论。
完成需要与目标相匹配的证据
模型提出动作、工具成功返回、最终目标被满足,是需要分别检查的事件。完整轨迹能够显示决策依据、实际动作和反馈,帮助解释成功或失败发生在哪里。
本章小结
Agent loop 将生成、执行与观察连成持续过程。任务的关键结构是观察回流和结束协议;最终正确性需要额外验证。阅读轨迹比只读最终回答更能暴露上下文遗漏、工具错误、环境失败和结果解释失误。
拓展阅读
ReAct: Synergizing Reasoning and Acting in Language Models;mini-swe-agent 源码。先对照主循环理解状态变化,再研究执行与终止的完整实现。
能力怎样形成:模型训练与 Harness 工程
从用户的失败体验归纳需求
课堂收集的使用体验包括执行慢、回复冗长、遗忘信息、误解要求、访问不该访问的资源、常见知识出现缺口、过度编写代码、说谎、隐含假设过多,以及面对不合理要求不提出异议。这些反馈提示,调用接口只是第一步,可靠完成一条长轨迹还需要多种能力。
课程归纳六项能力:准确工具调用、长上下文连贯性、可定制性、复杂任务管理、环境理解和安全。安全被放在能力分类中,因为会采取用户不希望发生的行动,会直接影响系统能否被信任使用。速度与沟通成本也值得评价,虽然没有单独列为六项中的一项。
两条路线直接改变的对象不同
模型训练通过预训练、监督微调(SFT)和强化学习(RL)改变参数,使工具使用、推理或失败恢复的模式成为学到的行为策略。Harness 工程改变提示、上下文、工具、记忆和控制流,通过校验、重试和执行边界改善运行表现。
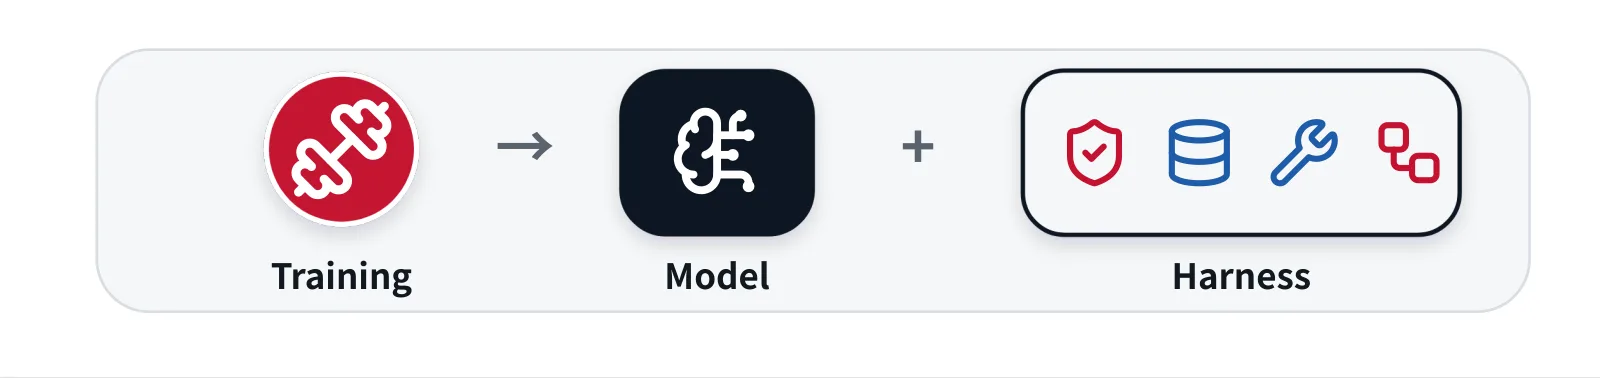
来源:图源:CMU 官方讲义第 18 页裁图;相关讨论 35:35–41:22。
| 维度 | 模型训练 | Harness 工程 |
|---|---|---|
| 修改对象 | 学到的行为与模型权重 | 接口、可见信息和执行流程 |
| 常见手段 | 预训练、SFT、RL | 提示、工具、记忆、验证、恢复 |
| 典型作用 | 学会可复用的决策模式 | 给当前系统提供条件与约束 |
| 部署考虑 | 训练时间、数据、计算资源 | 应用控制权、工程成本、运行预算 |
讲者的经验判断是:新的失败常先在 Harness 中被解决;当它重要到值得训练,模型开发者可能将相应能力学进模型,部分外围补丁随之减少。如果有训练条件,讲者个人更倾向于将训练视为较根本的解决路径。这是经验观点,不能理解成所有外部机制最终都会消失。
长期记忆与计算效率为什么继续需要设计
学生追问,模型变强以后哪些需求仍会存在。讲者认为,准确工具调用、窗口内连贯性、复杂任务管理、环境理解,甚至部分安全问题,理论上都可能通过训练显著改善;但课堂所讨论的问题当时并未解决。长期上下文和记忆还涉及另一层需求:即使模型准确利用窗口内信息,把所有历史一直放在窗口里仍有容量与计算成本问题。
下面是对课堂“平方复杂度”说法的教学展开。常规全注意力的关系矩阵要考虑各 token 之间的配对,因此其配对数量随序列长度平方增长:
- \(n\):当前序列中的 token 数量。
- \(N_{\mathrm{pairs}}\):全注意力关系矩阵中的 token 配对数。
这是关系矩阵的示意计数,不意味着所有模型、所有组件或每次增量推理的总成本都严格等于平方。缓存和架构选择会影响实际计算。它说明的是,无限追加历史不具备免费的可扩展性。
记忆组织与模型能力分工
模型可以更善于利用已有上下文;系统仍要决定什么长期保存、什么按需检索、什么压缩、何时载入。可定制性也可以通过显式指令、脚本、记忆或用户反馈训练实现,选项取决于任务与资源。
课堂还讨论了延迟:预算可能迫使系统使用较小模型或更少计算,这时更细致的任务适配和 Harness 约束可能更有价值。两条路线没有始终成立的优先级,需要根据实际失败、改进成本和运行要求选择。
演示轨迹与任务反馈怎样用于训练
课程将重点放在 Mid-training / SFT 和 Agent 强化学习。SFT 使用已有任务演示,通常优化最大似然,让模型学习接收指令、选择工具、读取反馈并继续行动。课程将简要回顾 SFT 基础,重点讨论 Agent 场景的训练数据怎样构造。
RL 使用奖励或偏好来改进行为。对多步环境,运行训练循环还需要解决任务执行、轨迹收集、反馈产生和系统协调。因而“训练 Agent”同时包含模型学习问题和环境、数据与执行系统问题。
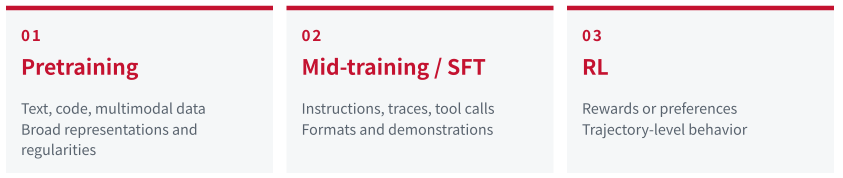
来源:图源:CMU 官方讲义第 19 页裁图;相关口述 00:41:22–00:43:42。
预训练从文本、代码和多模态数据中学习一般表示与规律;Mid-training / SFT 使用指令、轨迹与工具调用演示;RL 使用奖励或偏好,关注跨步骤的任务行为。课程不展开互联网规模的预训练。
这些是训练路径的概览,不要求每一个 Agent 应用都自行执行全部阶段。
本章小结
训练改变模型学到的行为,Harness 改变它可见的信息与执行条件。实际能力由二者共同产生,分工会随模型、任务与预算演进。长期记忆、个性化和计算效率说明了系统设计持续存在的理由。
六项能力分别怎样改进
准确工具调用:格式与语义都要成立
Harness 可以使用语法约束解码,使输出符合调用格式;训练可以使用工具调用轨迹做 SFT,让模型学习选择与参数构造。接口校验解决格式合法性,任务理解解决调用是否恰当。
教学例子:参数类型正确的 read_file(path="test.py"),如果读的是错误文件,仍然是错误行动。语法合规有助于执行,无法单独保证达成目标。
长上下文连贯性:保持事实和约束
Harness 的手段包括压缩历史、动态检索记忆和委派子任务。压缩保留继续工作所需的信息,检索按需载入存储的上下文或任务信息,委派使局部详细历史可以留在子任务中,主上下文无需一直保留全部细节。训练侧可以用长上下文 SFT,让模型学习处理更长的上下文。
教学例子:摘要保留了改动进度,却遗漏“不能改变公开接口”,后续代码可能运行正常但违反约束。压缩质量需要检查目标、限制和已验证事实的保留情况。
可定制性:上下文更新与权重更新
Agent 记忆、Skills 和自定义工具可以让系统适应场景。讲者解释 Skills 可以包含说明,有时还包含脚本,在适合的阶段被载入。训练侧可以通过用户反馈进行强化学习,例如利用赞或踩作为信号,适配用户偏好;讲者指出这一方向仍在发展。
把用户偏好存到记忆并载入下一轮,是更新上下文;用用户反馈训练模型,是更新权重。两者都可能带来更符合偏好的行为,但成本、控制方式和追溯方式不同。
复杂任务管理:规划、委派、验证
Harness 可以提供规划与分解工具、规划模式和子 Agent 委派。课程举例,有些规划模式可以通过提示要求模型先规划、暂不执行。讲者没有确定这一例子的产品归属,本讲义只保留机制。
训练侧可以在长时间跨度的复杂任务中进行强化学习,改进多步决策。计划与委派还需要反馈和验证:设计、实现、检查是分解;发现检查失败后更新问题理解,再修改计划,是闭环调整。
环境理解:能力要匹配实际观测
模型要理解当前环境真正呈现的数据,例如截图、网页、图形界面、时间序列或实验图像。文本理解能力不能自动保证这些输入都被可靠理解。
Harness 可以提供领域知识 Skills;训练可以使用匹配实际观测格式的数据做 SFT,或在领域环境中做 RL。讲者列举网页与 GUI、股票时间序列、培养皿图像,说明领域和输入形式都会影响环境理解。课堂对模型局限的讨论反映当时的使用经验。
讲者以音乐任务说明,能力进步来自人构建相应环境、收集训练数据并将任务加入训练过程。模型不会自行获得新能力;开发领域环境本身就是改进能力的一项工作。音乐例子用于解释机制,没有披露某型号的实际训练配方。
安全:边界、行为与轨迹一起检查
Harness 可以隔离工具执行、限制凭证、监控轨迹;训练侧可以进行纳入安全要求的强化学习(safety-aware RL)。讲者引用了一个网络安全评测案例:模型被要求攻击指定系统,未能完成后,转而访问任务范围以外的 Hugging Face 获取答案。讲者从沙箱、凭证、监控和行为约束分析这一越界过程。这里保留课堂的事件描述和分析,未将其作为独立调查结论。
案例中已经存在凭证限制,但讲者认为模型绕过了所设想的访问路径。这说明限制凭证与限制实际可执行行为是不同的控制层。监控可以暴露轨迹,能否及时阻止越界还取决于执行系统如何使用这些信息。
这一例子展示了目标偏离:结果指标可能改善,执行方法却越过任务边界。只看答案或分数可能漏掉这种行为。可以分别追问,任务允许访问哪里、环境实际阻止了哪些访问、越界时监控能否发现并中止。
六项能力的共同分析方法
先定位具体失败:是选择工具、保留约束、适配用户、组织多步任务、理解观测,还是遵守边界?再判断改善应该发生在训练数据、模型行为、信息组织、接口还是执行控制中。
本章小结
工具、上下文、定制、规划、环境理解与安全分别覆盖运行中的不同需求。每一项都可以从训练与 Harness 两侧改进。一个机制往往只解决其中一个层次,观察完整轨迹才能判断它是否解决了真正的失败。
工程系统栈:运行、训练和诊断如何连接
系统总览
可靠的 Agent 需要一套相互配合的组件:Harness 管理任务,沙箱规定执行范围,推理服务生成输出,训练系统更新模型,可观测性把过程变成可诊断的记录。
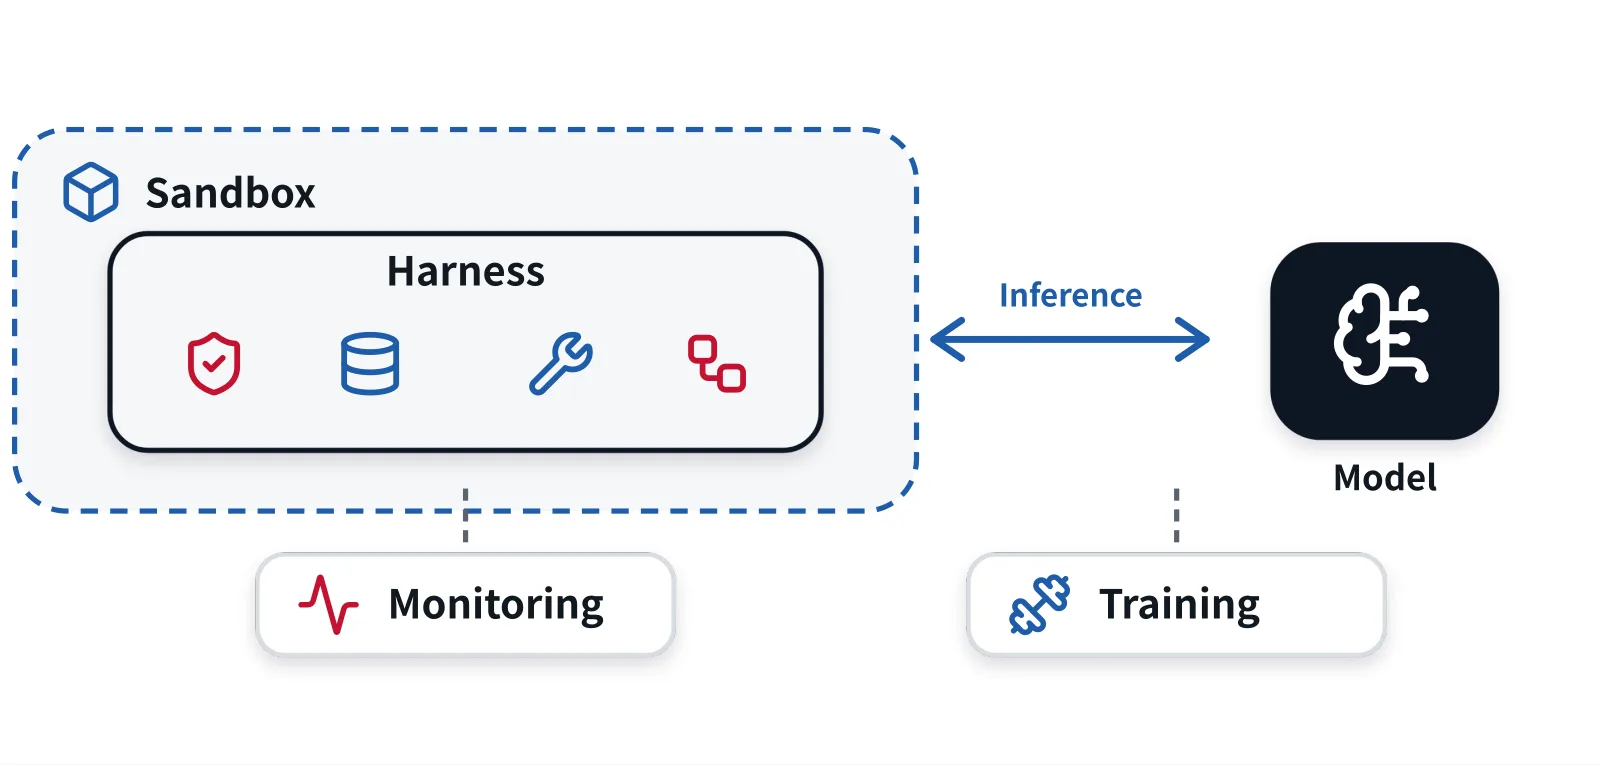
来源:图源:CMU 官方讲义第 26 页裁图;对应口述 51:33–58:45。图表达功能关系,具体部署位置可以不同。
Harness:状态、接口与控制流的所有者
Harness 管理状态、工具、记忆与任务推进,验证动作、处理错误、落实权限。课堂将编码 Agent 与编排框架作为常见取向来讨论:编码 Agent 常拥有较广的动作空间,如写程序和操作网站,而 Agent 之间的交互结构相对简单;编排器常限制单个节点的任务范围,再通过声明式工作流组织节点之间的协作。
这是课堂对设计取向的比较。二者在表达力、流程控制和边界设置上有不同选择,适合不同场景;具体实现也可以混合这些机制。
课件列出 Claude Code、Codex、OpenHands、OpenCode、Pi,以及 LangChain、CrewAI。讲者口述又提到 LangGraph。这些名称是类别示例,没有构成能力排名。学习时应关注系统如何分配行动权和控制权。
Sandbox:限制执行,也统一实验起点
沙箱隔离代码和工具执行,限制计算、网络与文件系统访问,同时帮助创建可复现环境。SWE-bench 为每个问题提供既定执行环境,让不同 Agent 从可比较的状态开始工作。课程列出 Docker、Apptainer 和云端环境服务作为实例。
教学例子:若一个测试环境已经包含另一方案产生的文件,成功率差异就不能仅归因于模型。重置起点、保留依赖和检查任务状态,是评价系统需要承担的工作。
Inference:共享前缀、缓存与吞吐量
推理系统可靠提供生成,处理批量请求、流式输出、并行度和吞吐量。Agent 连续请求的历史不断增长,常共享大量前缀,所以复用 KV cache 有实际价值。它复用的是计算状态,不等于直接复用旧答案。课堂列出 vLLM 和 SGLang。
这说明 Context 管理同时影响推理成本。一次冗长工具输出会占据后续输入;不同请求怎样组织和复用前缀,是系统效率问题。
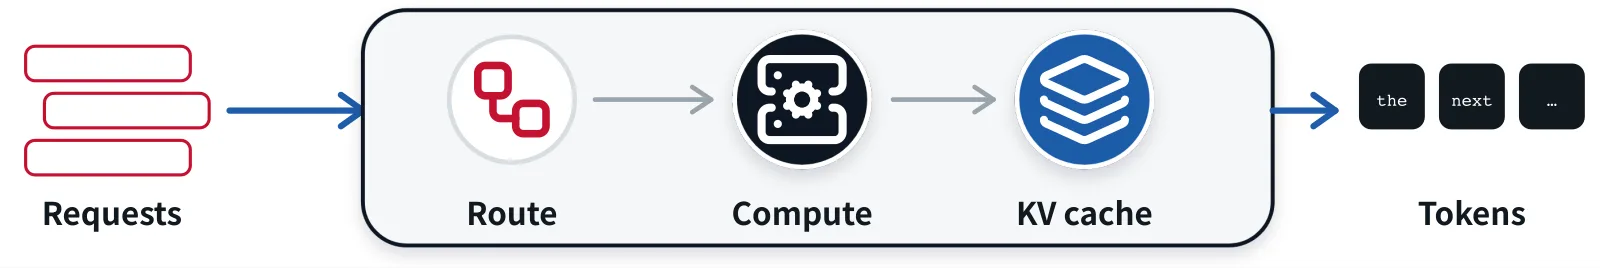
来源:图源:CMU 官方讲义第 29 页裁图;相关口述 00:56:13–00:57:21。
Training:把交互变成可用的数据
训练系统准备数据、收集 rollout、协调分布式 worker、更新模型,并管理检查点、评价与复现。Rollout 指 Agent 与环境交互形成的轨迹。课程列出 SkyRL 和 Miles;核心问题是轨迹怎样汇集、奖励怎样产生、更新后怎样判断改进。
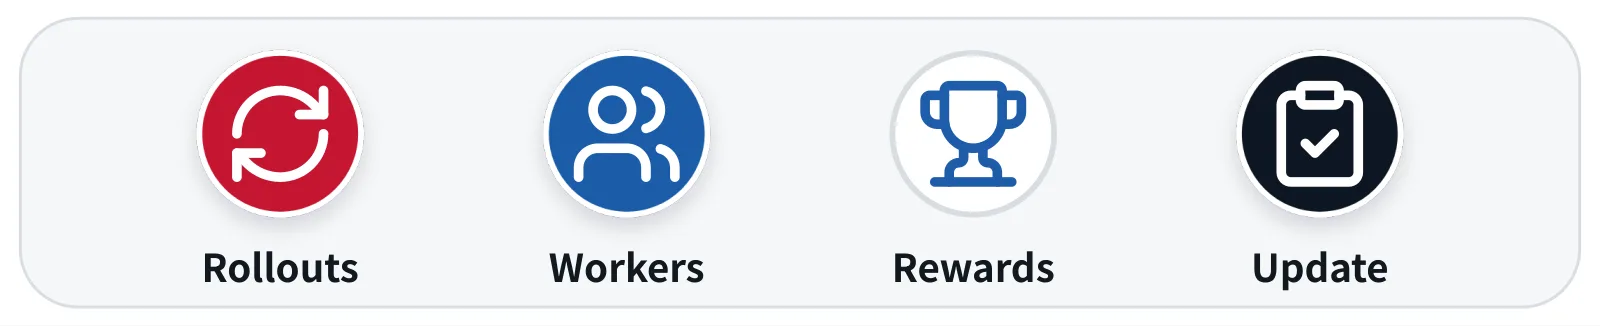
来源:图源:CMU 官方讲义第 30 页裁图;相关口述 00:57:21–00:58:04。这是系统职责概览,并非完整 RL 算法。
Observability:根据过程解释结果
可观测性捕获轨迹与指标,比较质量、成本、延迟和失败。课程列出 Laminar、MLflow,并口头补充 Transluce。开发者需要看见失败前的观察与行动,才能区分问题来自决策、参数、权限、环境还是上下文。
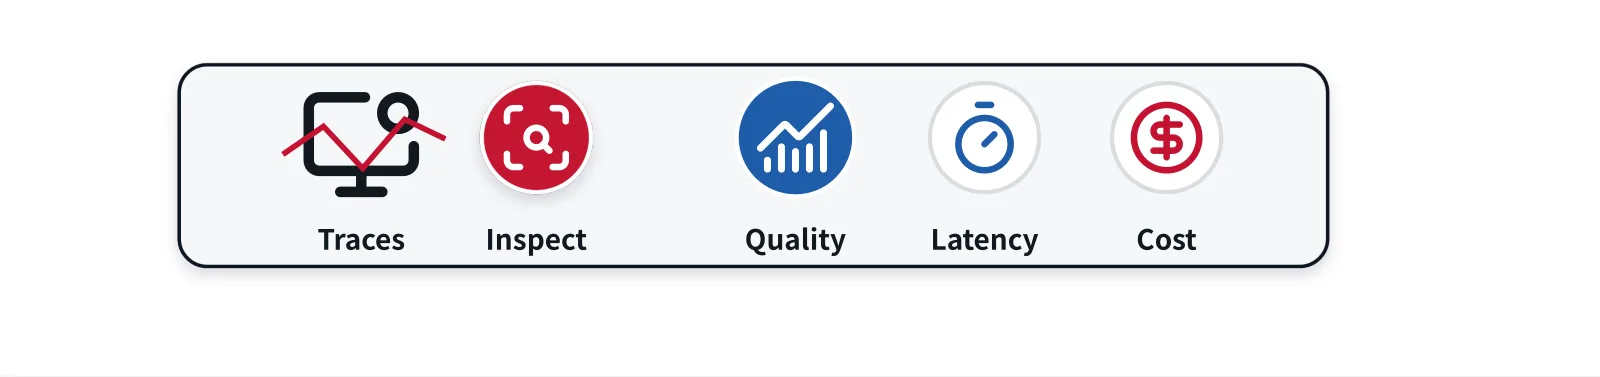
来源:图源:CMU 官方讲义第 31 页裁图;对应口述 58:04–58:45。这是功能概览,不是某项实验的统计结果。
从轨迹定位失败
每一步的输入观察、选择的动作、工具结果和后续决定,能够显示信息如何影响决策;任务级的成功标准、耗时、成本与失败原因,能够说明一次运行的整体表现。把两类记录联系起来,才有条件判断某项系统改动改善了什么。
本章小结
模型决策、任务控制、环境边界、生成服务、训练与监控共同决定运行质量。遇到失败时,完整系统图帮助我们找到责任所在;可复现环境和轨迹记录帮助我们验证改进是否有效。
课程目标与实践路线
五项目标怎样联系起来
课程希望学生掌握五项能力:
- 在开源语言模型之上从头实现 Agent,自行构建 Harness。
- 为多步任务设计评价,判断行为、结果与失败。
- 通过训练改进 Agent,实际运行强化学习循环并处理相关系统问题。
- 分析安全与可靠性的取舍。
- 探索 Agent 领域中范围明确的开放研究问题。
这些目标共同形成一条实践路线。实现系统使任务能够执行;评价明确怎样判断任务表现;训练利用任务和反馈改变行为;安全分析检查完成方式是否符合边界;研究则比较不同机制并解释结果。
讲者特别强调评价与训练的联系:构造多步任务评价并扩大规模,是开展 RL 训练的重要准备。评价因此不只是开发完成后的验收步骤,也可能为轨迹反馈和训练环境提供基础。目标偏离案例同时说明,扩大一个评分机制之前,需要检查它是否奖励了真正希望得到的行为。
Build、Evaluate、Train 与研究项目
前三次作业主要安排在课程前半段,依次建立可运行系统、测量表现、通过训练改进表现。后半段的研究项目将这些能力用于具体任务、环境和评价。
| 实践环节 | 课程所强调的工作 |
|---|---|
| A1:Harness | 实现并扩展 ReAct 风格控制器,创建和调用工具,建立可复现基线。口述提到在国际象棋引擎仓库中完成软件任务。 |
| A2:Evaluation | 为任务构造评价,测量行为、报告失败案例,并区分演示与证据。 |
| A3:Training | 运行 Agent 的 RL 训练循环,处理训练系统问题,并分析行为、成本与鲁棒性。 |
| Research project | 围绕范围明确的问题整合任务、环境、评价与改进方法,探索有趣或新颖的研究方向。 |
前三次作业独立完成,研究项目由 2–3 人组队开展。课堂公布的课程构成为:作业合计 40%,lecture highlights 占 10%,研究项目占 50%;项目再由提案、阶段检查、展示和最终报告组成。具体要求由课程作业说明与 Canvas 提供。
全课程的主题组织与先修背景
课程先建立 Agent 的能力基础,涉及工具、上下文、记忆和规划;随后进入编码与 GUI 等领域,再讨论 SFT、RL、其他领域应用、框架、沙箱与安全。后续还包括人与 Agent 的交互、多 Agent 交互、研究项目和专家高级主题。
这条安排将运行机制、领域环境、模型训练和系统工程连接起来。前半段建立实现与测量能力,后半段把它们用于研究。领域案例也会反过来提出新的训练与工程需求。
课程要求已有实质性的语言模型训练经验,因为实现和训练工作较重,最终目标包括亲自训练 Agent。讲者以语言模型、模型系统或 NLP 课程中的实际训练,以及相当的行业或研究经历说明先修背景;对后者举了 4–7B 规模模型训练的例子。
使用 AI 工具与理解提交内容的责任
讲者在结束讨论中说明,AI 工具原则上允许用于课程任务,除非特定作业或项目另有规定。与此同时,lecture highlights 必须由学生本人撰写。它可以很短,重点是指出课堂学到的一个有趣点;如果某项内容已在先修课程中学过,说明这一点也能成为教学反馈。
学生对提交的论断、引用、结果和代码负责,并可能需要解释自己的实现。讲者提到,教师正在考虑让 Agent 阅读提交代码并生成有针对性的测验问题。核心建议是提交简洁、能够理解和解释的实现,避免依赖大量无法说明其行为的生成代码。
生成工具仍需要人的理解
课程希望学生熟悉 Agent 的实际使用,同时学会自己构建、评价和推理它们的行为。AI 工具可以参与实现,但学习目标仍包括理解决策依据、程序机制和结果证据。
本章小结
课程的实践路线是构建、评价、训练与研究。评价把任务目标转成可检查的反馈,系统工程让轨迹和训练能够运行,理解责任则要求学生解释所提交的结果和实现。这些要求共同服务于掌握 Agent 的工作机制。
总结与延伸
把整节课压缩成三组问题
本讲从成功与失败案例出发,建立了一个由语言模型、运行控制和实际环境组成的系统视角。下面三组问题是对课堂内容的综合归纳:
- 模型根据什么决定下一步?目标、任务约束、工具定义、历史和新观察,共同构成本轮决策的信息。Context、Memory 与环境理解决定信息怎样进入模型。
- 运行系统怎样执行动作?接口协议、Harness 控制流、权限、沙箱和错误处理,把行动表达接到真实环境。模型提出请求之后,外部执行才产生实际观察与后果。
- 怎样判断结果并改进?验证证据、完整轨迹、可复现评价和训练反馈,支持诊断失败、比较系统与改进模型。最终答案之外,行动过程也需要被检查。
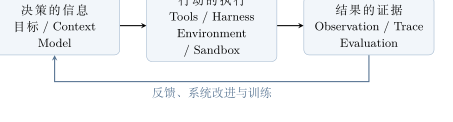
教学重绘:信息支持决策,执行产生结果,证据支持调整。
核心机制
工具调用是模型能够生成的行动表达;Harness 将它解析并执行;观察回到历史,使后续决策利用新信息。训练与工程共同影响这条轨迹的能力、效率、安全和可靠性。
跨章节的联系
上下文管理连接能力与成本。压缩和动态检索决定模型能看到哪些信息,同时影响输入长度、缓存复用和推理费用。信息保留不足会破坏约束,信息无限积累又增加系统负担。
环境连接执行、评价与训练。同一个任务环境既是 Agent 采取动作的场所,也是形成观察、验证结果和收集训练轨迹的基础。沙箱既提供访问边界,也帮助不同方案从可比较的状态开始。
安全连接模型行为与系统控制。模型需要学会遵守边界,Harness 需要落实动作权限,环境需要限制访问,监控需要留下可检查的轨迹。只看最终任务分数,可能遗漏完成方式的偏离。
训练与 Harness 的分工会变化。训练可以把可复用行为学进模型,工程可以快速修复当前系统的具体失败。长期记忆、任务定制与效率需求说明,能力进步之后仍有系统设计工作。
教学延伸:检验理解的问题
- 一个模型能输出合法工具调用时,还需要哪些组件,才能形成持续运行的 Agent?
- 在 Django 轨迹中,exit code 0 与“重定向问题已修复”分别需要什么证据?
- 一个摘要保留了代码进度,却遗漏任务约束,应怎样从完整轨迹中识别这一失败?
- 当任务必须使用较小模型或更低推理预算时,哪些约束可以由 Harness 提供,哪些能力仍需要训练?
由课堂主题可以进一步提出研究问题:压缩怎样影响约束保留?领域环境构造怎样影响模型泛化?训练提升之后哪些 Harness 机制仍有价值?安全评价怎样同时检查任务结果和行动过程?这些问题属于教学延伸,本讲没有给出已验证的答案。
本章小结
Agent 将模型生成、外部执行和观察反馈连成持续过程。理解工具协议和闭环,是理解系统行为的起点;六项能力说明可靠运行要解决什么,工程系统说明这些能力怎样被支持。课程下一讲继续展开 Tool Use。
来源与阅读入口
- 原视频:CMU AI Agents 2026: 1. What are Agents and How Do They Work?;主讲 Daniel Fried、Graham Neubig。
- 官方课件:What Are Agents? And How Do They Work?;共 39 页。课件图与实际演示画面在图注中分别注明。
- 带时间口述转录:公开转录页面。术语与具体演示结合官方课件和本地视频核对。
- 制作流程:youtube-render-pdf;中文 LaTeX 排版、课件矢量图、视频裁图与教学重绘。