第 2 讲:提示词与上下文工程:从明确规格、机械验收到不确定性探索
导读
第一讲提出的核心问题是:当软件工程 Agent 已经具备强大的执行能力,人类工程师究竟该如何驾驭它?本讲从开发者与机器沟通最常见的自然语言指令出发,将视野从聊天框里的一句话“提示词工程”扩展为系统化的“上下文工程”。
在生成式软件工程中,决定模型每一步输出与工具调用的 \(\Pr[\text{token}\mid\text{context}]\) 取决于进入上下文窗口的完整信息结构:外围系统(Harness)注入的规则、持久指令文件 AGENTS.md、按需加载的 Skill、代码库事实以及工具执行反馈。
围绕“如何让模型准确理解目标、可靠遵循复杂约束,并在没有现成标准答案时持续探索”这一主线,本讲层层推进:首先拆解上下文的真实构成与外部安全执行边界,接着探讨如何用可验证的规格(Spec)与验收器(Verifier)弥合从意图到实现的漂移,剖析思维链与自注意力机制下的规则开销与方法论沉淀,最后深入大型代码库演化、长程研究排障、人类注意力分配以及不确定性空间中的宽度搜索。
机制总览
Agent 从任务目标、项目规则和工具观察中形成上下文,再据此选择下一步。自然语言中的允许不等于运行环境授予的权限。
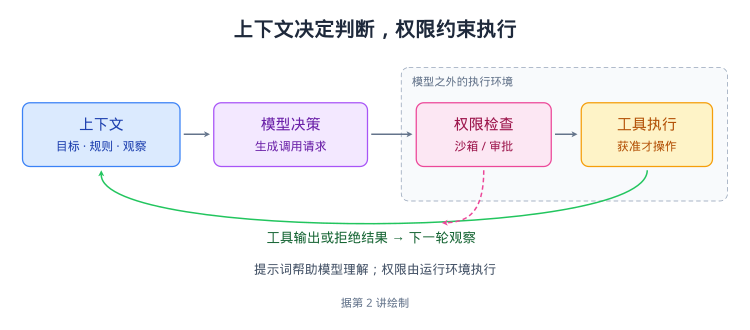
读图:机制与适用边界
上下文进入模型后产生工具调用请求;请求先经过模型之外的权限检查,获准才执行。工具结果或拒绝结果作为观察回到上下文。
把约束写进提示词有助于模型理解,但可靠的执行边界仍要由沙箱、审批与工具接口落实。
第一章 从“一句话提示”到完整上下文:模型在决策前究竟看见了什么?
在第一讲中我们看到,大语言模型驱动的智能体(Agent)已经能够自主调用工具、修改代码并推进复杂任务。随之而来的核心工程问题是:人类应当如何有效地驾驭它?许多初学者习惯把提示词仅仅理解成聊天对话框里输入的最后一句话,试图靠寻找某句神奇的口诀来让模型听话。然而,当 Agent 在每一步预测下一个词元(Token)时,决定其行为的远不止用户刚刚敲下的那行要求。本章将从一句脱离课堂语境而引发误解的截图切入,梳理提示词的历史演进,拆解 Agent 在做出决策前真正看见的完整上下文层级与来源,阐明为什么现代软件工程必须从单纯的“提示词工程”走向系统化的“上下文工程”。
语境决定语义:从热搜意外看上下文的作用
在正式进入技术架构之前,我们先审视一个刚刚发生在课程身边的真实事件。第一讲中一句“没有 token 的 CS 学生应该立即退学”意外登上了社交网络热搜。为什么一句在课堂现场用于激励学生的话,传播到网络上会引发截然不同的反应?下面看看同一句话在脱离原始前后文后,语义是如何发生改变的。
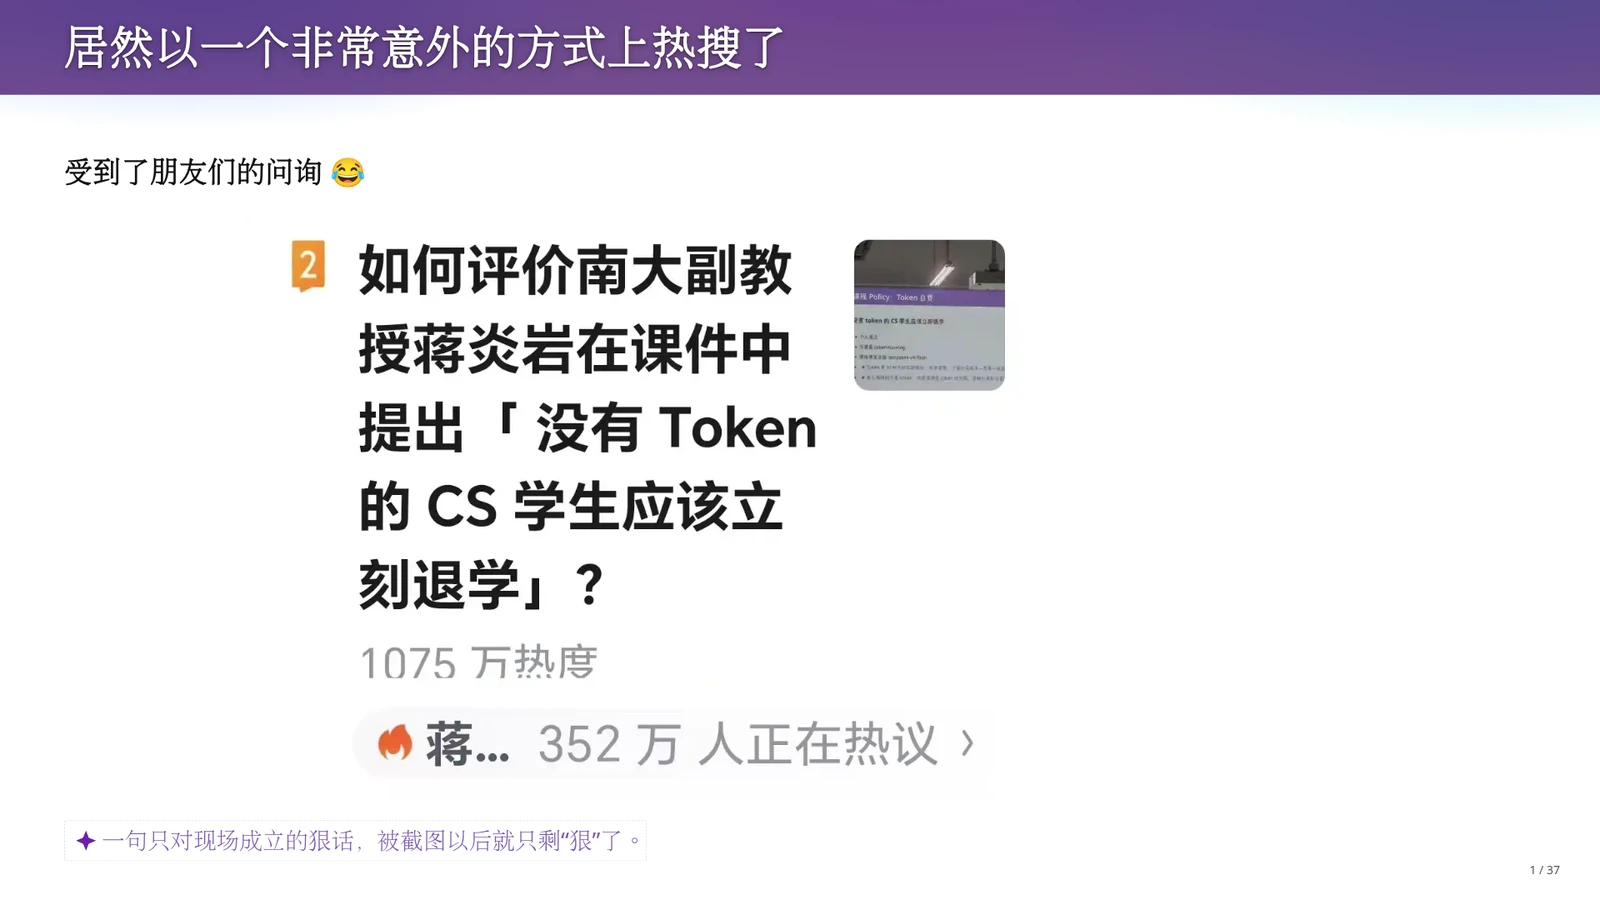
这起事件背后的传播机制很直接:“一句只对现场成立的狠话,被截图以后就只剩‘狠’了。”在第一讲的课堂现场,这句话处于一整套完整的上下文之中:前文是生成式人工智能对软件工程范式的剧烈冲击,后文是鼓励计算机系学生不要等待完美的工具或他人的评价,而要立刻动手在真实编程中消耗词元、积累经验。然而,当一张孤立的截图离开课堂现场进入公共网络时,原有的教学背景、语气和前后逻辑全部被剥离,读者看到的上下文变成了社交媒体上的争议话题,同一串字符因此被解码出了完全不同的含义。
讲义提醒我们,这个插曲本身就是关于“上下文(Context)”最直观的导论案例。无论是人类阅读还是大语言模型推理,自然语言序列本身并不携带绝对孤立的语义;同样的文字被放进不同的上下文窗口中,就会导出截然不同的理解与后续动作。这也引出了本章的第一条认识:要想控制生成式系统的输出,不能只盯着单独的一句话,而必须审视包裹着这句话的完整上下文环境。
破除启动阻力:用低成本实践开启工程体验
既然那句“狠话”的本意并不是真的劝退学生,为什么课堂上还要用如此强烈的措辞?这源于计算机专业学生在面对新技术时常见的心理阻力:总是习惯等待工具链彻底成熟、或者借口算力昂贵而迟迟不动手。这就涉及当前大模型服务的真实经济门槛与课程的核心行动要求。
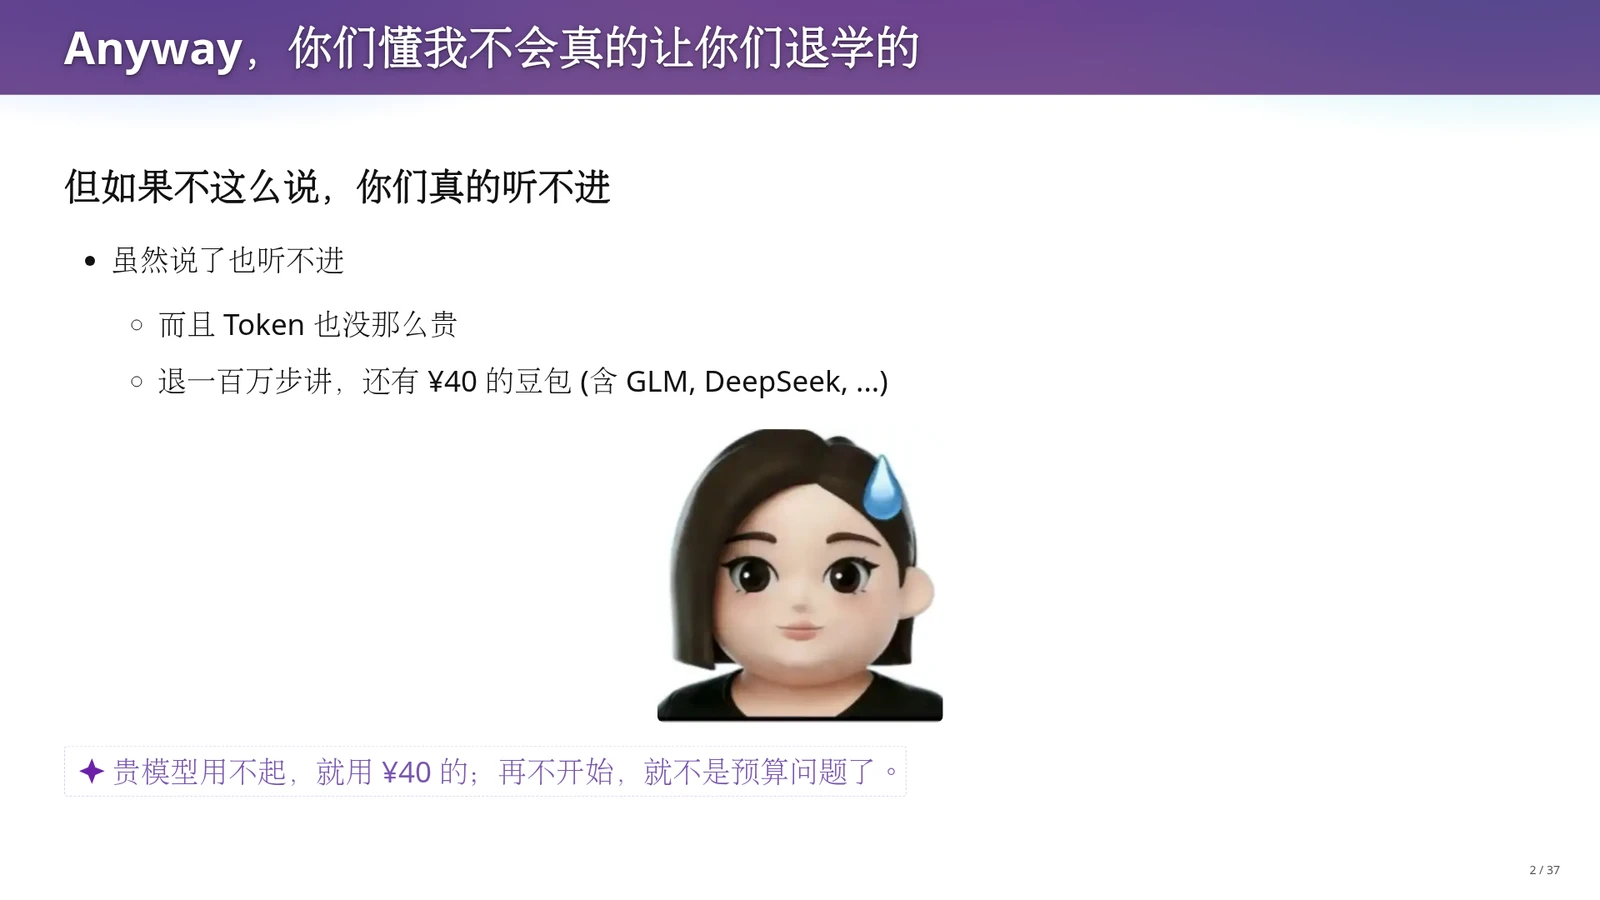
用夸张表达是为了打破学生的拖延与观望。针对“模型调用太贵、用不起词元(Token)”的常见借口,即便不使用高价海外旗舰模型,国内也有 40 元人民币档位的豆包(涵盖 GLM、DeepSeek 等模型服务)可供选择。贵模型用不起,就用 ¥40 的;再不开始,就不是预算问题了。这里将“预算限制”与“行动意愿”严格区分开来,指出在极低成本方案已经普及的条件下,阻碍学生进入生成式软件工程实践的不再是资金,而是迟迟不愿启动第一次尝试的惯性。
在软件工程学习中,纸上谈兵无法建立对模型行为边界的直觉。只有真正订阅服务、配置好本地环境并开始消耗词元,学生才能亲眼观察到模型如何理解指令、如何在长任务中偏航。消除了启动阶段的心理与预算借口后,我们接下来就要追问:当我们打开终端或对话框向模型发送文本时,所谓的“提示词”究竟在底层扮演什么角色?
提示词的演进:从控制续写的开头到少样本编程
在 ChatGPT 普及之后,“提示词(Prompt)”成了家喻户晓的词汇,以至于很多人误以为它是对话式人工智能时代的全新发明,且等价于聊天框里的用户输入。为了建立准确的工程概念,我们需要回到预训练语言模型的发展史,考察 Prompt 是如何从普通的文本开头演变为控制模型计算的条件的。
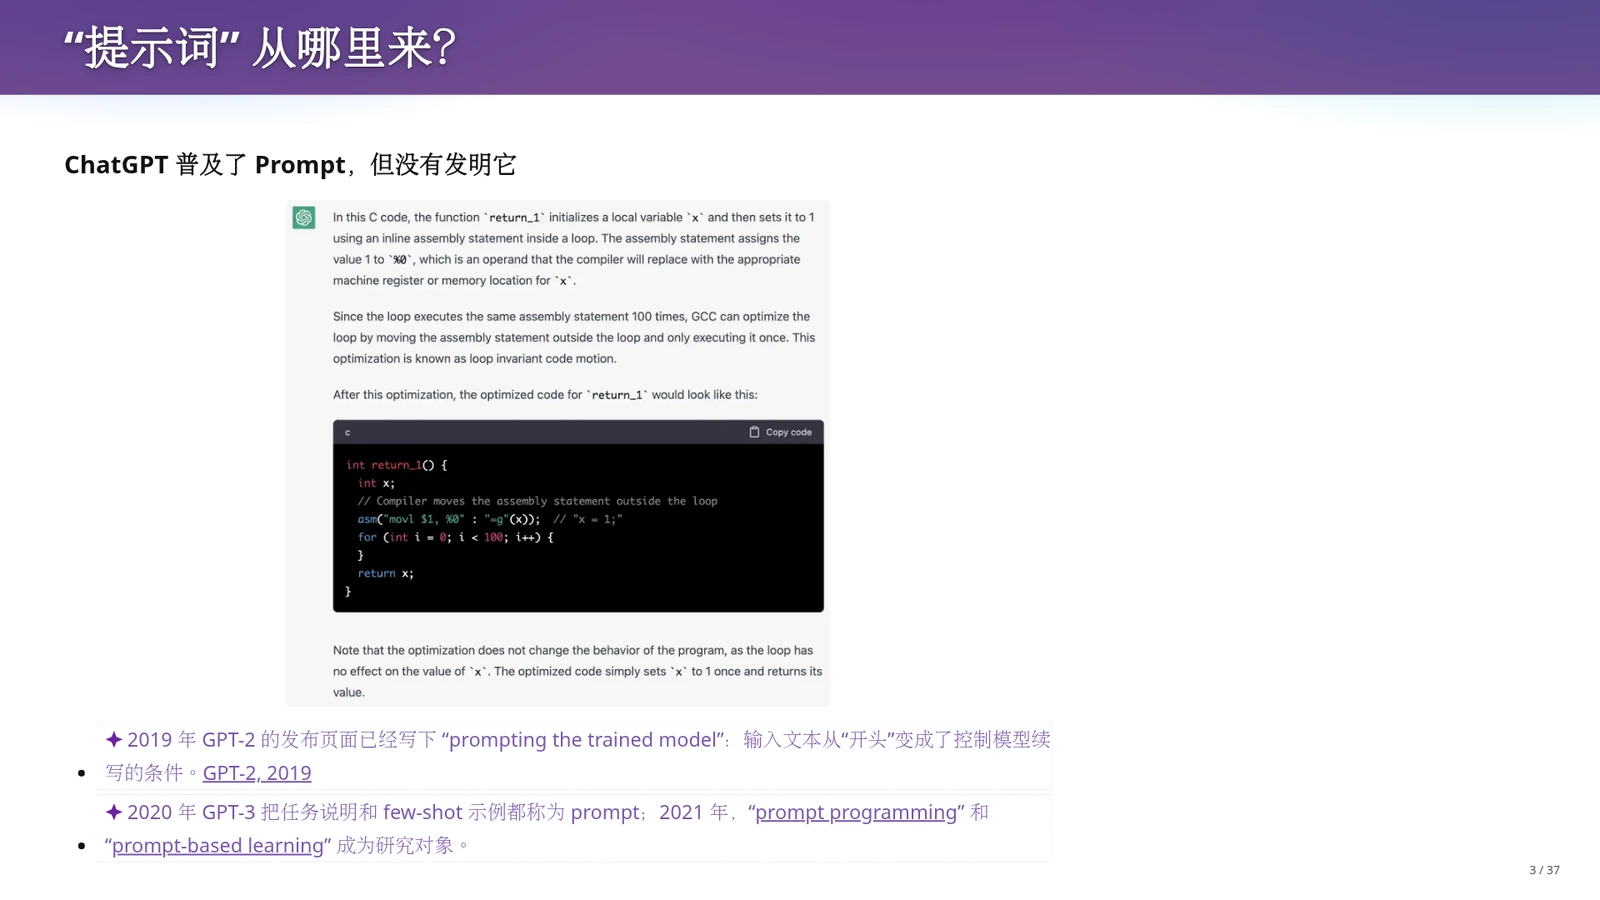
回顾 Prompt 概念在学术界与工业界的关键演进节点:早在 2019 年 GPT-2 的发布页面中,研究者就已经写下了“prompting the trained model(提示训练好的模型)”的表述:在自回归语言模型中,输入文本不再仅仅是一段话的“开头”,而是变成了控制模型后续续写方向的条件。到了 2020 年,GPT-3 进一步将自然语言编写的“任务说明”和“少样本示例(few-shot 示例,即在输入中给出几个输入输出配对样例供模型模仿)”统称为 prompt。2021 年,“提示词编程(prompt programming)”与“基于提示词的学习(prompt-based learning)”正式成为独立的研究对象。可见,ChatGPT 只是通过聊天界面普及了 Prompt,而没有发明它。
课堂上老师分享了自己在 2023 年初(ChatGPT 刚发布不久)备授操作系统课时的亲身经历:当时他构造了一段冷门且几乎不可能直接出现在训练语料中的内联汇编(inline assembly,在 C/C++ 代码中直接嵌入汇编指令的语法),让模型解释其行为,结果模型给出了相当准确的分析。这次冲击让他意识到,提示词本质上是在激活并引导模型内部庞大的参数表示。既然提示词是控制续写的条件,那么在更为复杂的智能体(Agent)系统中,这个条件究竟包含了哪些内容?
超越对话框:拆解 Agent 看见的完整上下文
进入聊天界面后,用户很容易产生一种错觉:模型只看到了我们在输入框里敲下的那条请求。然而,当我们从单轮问答转向能够读写文件、执行命令的软件工程智能体(Agent)时,决定模型下一步输出的到底是哪些文本?结合自回归生成的条件概率公式,我们可以逐层梳理构成 Agent 上下文的真实来源。
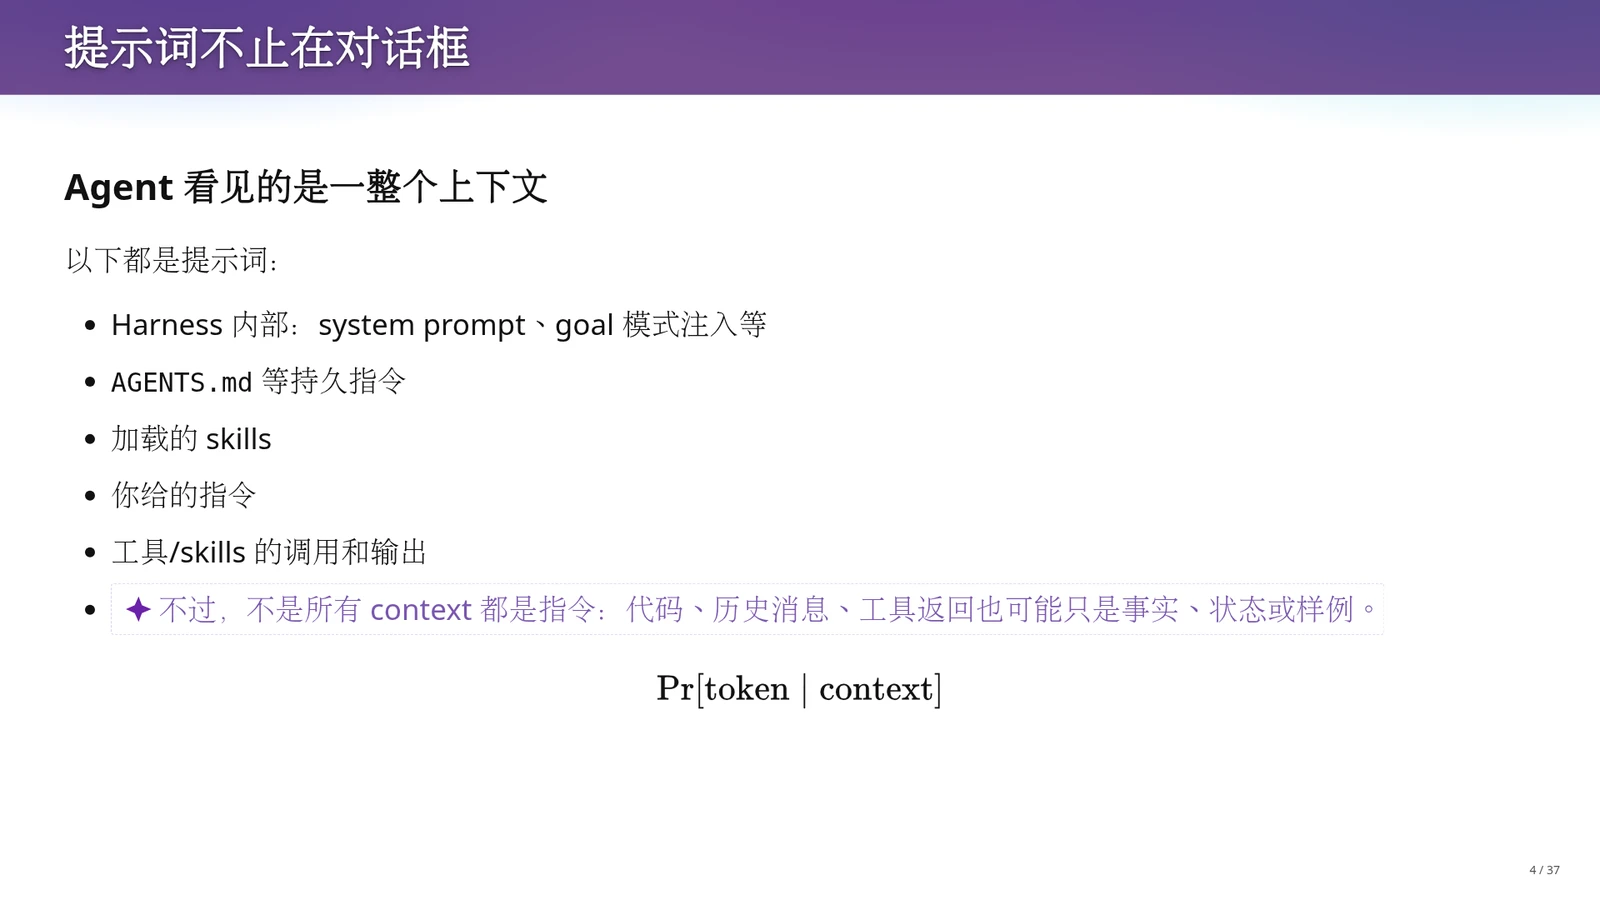
自回归生成的核心数学表达是 \(\Pr[\text{token}\mid\text{context}]\),即模型在给定完整上下文(context)的条件下预测下一个词元(token)的概率分布。进入这个上下文的提示词包含五个层面:
- 第一,外围系统(Harness,即负责管理模型运行、组装消息、调度工具并执行安全策略的宿主程序,如 Codex 或 Claude Code)内部注入的系统提示词(system prompt)与目标(goal)模式说明;
- 第二,代码仓库或用户目录中的
AGENTS.md等持久指令文件; - 第三,当前加载的技能包(Skills,封装特定任务处理流程、规范与脚本的可复用模块);
- 第四,用户实时给出的指令;
- 第五,工具或技能的调用请求及其返回输出。
需要注意,进入 context 的文本不全是指令,代码文件、历史消息和工具返回的内容往往只是供模型分析的事实、状态或样例。
课堂演示进一步揭示了这些层级在开源框架(如 pi)中的具体组装方式:在 Agent 第一次停下来等待用户输入之前,它的线性上下文里已经依次塞满了 Harness 的系统指南、用户全局目录(如 ~/.pi/agent/AGENTS.md)中的个人偏好(例如“始终用中文回答、结尾必须写总结 recap”)、当前项目目录及子目录层叠的 AGENTS.md、可用工具的文本定义、当前环境信息(如模型名称与系统时间),以及按需加载的 Skills 元数据索引(初始仅包含名称与简短描述,匹配任务时才将完整的 SKILL.md 读入上下文,在支持工作集清理的框架中可在该轮结束后移除以节省空间)。同时,讲义提醒我们:工具返回的一篇外部文章或代码片段只是待分析的材料,绝不因此自动获得向 Agent 下达命令的资格。
从提示词工程到上下文工程:管理工作集与执行边界
理解了上下文的庞大构成后,我们就不能再停留于“字斟句酌地修改一句话”。面对动辄支持数十万乃至百万级词元窗口的现代大模型,工程师应该如何组织这些混杂了系统规则、项目约定、工具输出与历史对话的信息?这就需要将视角从“提示词工程”升级到“上下文工程”。
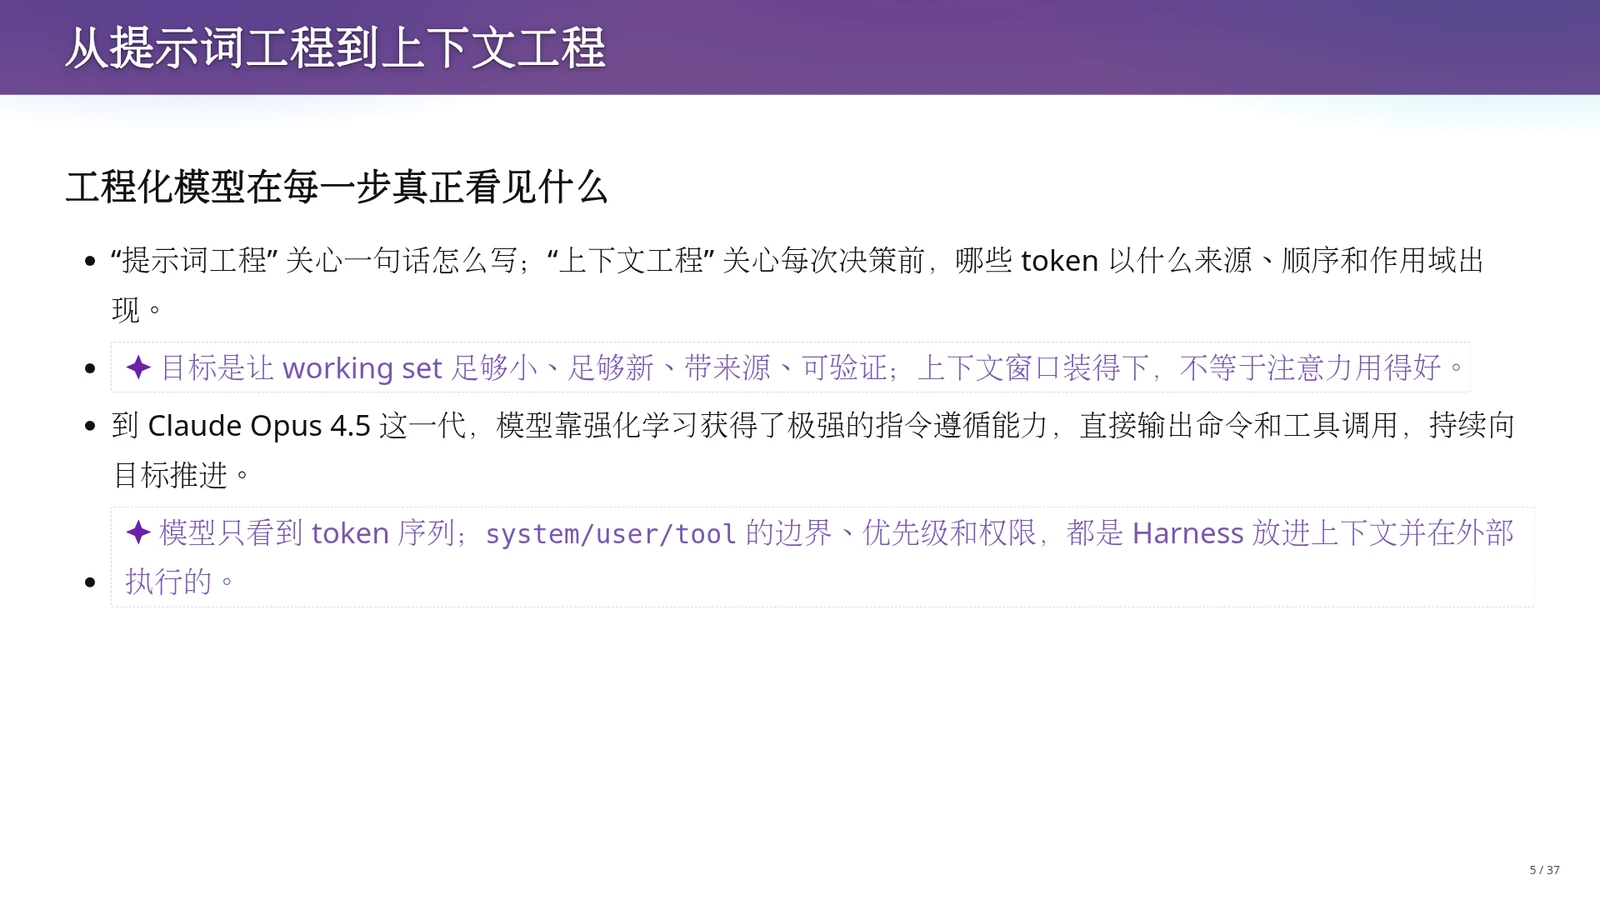
“提示词工程”关心单句话怎么写;而“上下文工程(Context Engineering)”关心在模型做出每一次决策前,哪些词元(token)以什么样的来源、顺序和作用域出现在上下文中。上下文工程的核心目标是让当前工作集(Working Set,模型在当前步骤做决策真正需要依赖的活跃信息集合)足够小、足够新、带有明确来源且可验证——因为上下文窗口装得下,不等于模型的注意力用得好。到 Claude Opus 4.5 这一代,模型通过强化学习与后训练获得了很强的指令遵循能力,能够直接输出命令和工具调用,在长上下文中持续向目标推进。在架构边界上,模型内部只看到扁平的词元序列;Harness 负责在上下文中编排并标记 system/user/tool 的角色与优先级说明,模型通过后训练学会理解这些语义并按角色遵循指令,而真正的执行权限与资源访问限制,则由外部的 Harness 和操作系统沙箱在执行动作时强制实施,操作系统本身并不能保证自然语言指令的优先级。
课堂上介绍了一个检验长上下文指令遵循的实用技巧——“句尾加喵”观察法:在最前端的系统提示词或全局 AGENTS.md 中加入一条持久规则“每说一句话都在句尾加一个喵”。当与 Agent 长时间协作、上下文不断膨胀后,如果某次回复突然丢失了“喵”,工程师就能察觉模型对早期指令的遵循出现了异常(可能源于上下文溢出截断、历史摘要压缩或注意力衰减,但仅凭丢失“喵”无法直接定位是哪一种根因),此时需要主动检查或重建上下文。此外,我们还可以让 Agent 自我解剖当前上下文并分类总结指令,但必须注意:模型的自述只是它生成的“当前遵循计划”,不能当作内部实现机制的证明;真正的安全隔离与权限边界,必须通过审查 Harness 的配置、代码以及操作系统的实际拦截结果来验证。
提示词工程与上下文工程的本质分野
提示词工程聚焦于局部文本的措辞修辞;而上下文工程则是面向状态与决策的系统工程。在公式 Pr[token | context] 中,模型每一步生成的工具调用或代码字符,都取决于整个 context 序列的联合条件。
上下文工程要求开发者显式设计每次推理前的工作集(Working Set):严格区分哪些是具有命令资格的“指令(目标与约束)”,哪些仅仅是作为客观证据的“材料(代码文件、日志与工具输出)”,并控制它们的加载时机、排列顺序与生命周期。
课堂提示:长上下文健康的“金丝雀”探针
尽管现代模型(如 Claude Opus 4.5 等)通过强化学习后训练获得了在近百万词元窗口中保持指令遵循的能力,但“窗口容量”不等于“有效注意力”。工程实践中可以采用类似煤矿金丝雀的探针技巧:在最顶层的全局指令(如 AGENTS.md)中植入一个低成本、高辨识度的格式约束(如“每句话末尾加喵”或“每次执行完毕输出固定格式的 Recap”)。一旦在长程任务后期观察到该标记消失,即可察觉模型对早期指令的遵循出现退化(可能是被截断、压缩或注意力分散所致,具体原因需结合日志与配置排查),从而及时触发上下文清理或重申核心约束。
切勿将文本角色标签等同于系统权限边界
初学者常犯的严重错误是认为在系统提示词里写一句“严禁删除文件”或依靠 system/user/tool 的消息标签就能构建可靠的安全边界。事实上,大语言模型在底层前向计算时看到的只是一长串同质的词元(Token)序列,它并不具备硬件或操作系统级别的隔离概念。外部工具返回的不可信网页或代码完全可能包含诱导性文本(提示词注入)。真正的权限控制、审批流与目录隔离,必须由模型外部的宿主程序(Harness)和操作系统沙箱在执行动作前强制收口。
术语消化:Agent 上下文核心构成要素与工程机制对照表
| 术语/上下文层级 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| Harness(外围宿主系统) | 模型本身只能输入输出文本词元,无法直接与操作系统交互或自我限制权限 | 在模型外部负责组装完整上下文、注入 system prompt 与环境信息(模型、时间)、解析工具调用请求,并配合操作系统执行沙箱隔离与审批策略 |
| AGENTS.md(层级化持久指令) | 避免用户在每次开启会话时重复输入编码规范、语言偏好与项目特定约束 | 按全局目录、项目根目录及子目录层叠加载进上下文前端,为 Agent 提供跨会话的持久项目规则与输出约定 |
| Skills(按需加载的技能包) | 将所有领域的复杂操作手册全部塞入常驻上下文会导致窗口膨胀与注意力稀释 | 初始仅在上下文中保留名称与简短描述的元数据索引;任务匹配时才按需读入完整 SKILL.md,并在支持清理的框架中于子任务完成后移出工作集 |
| Working Set(上下文工作集) | 百万级词元的上下文窗口中混杂大量过时日志、历史状态与无关代码,干扰当前决策 | 上下文工程的核心控制对象:通过按需加载、阶段性清理与来源标记,确保模型在每一步决策前看到的活跃信息足够小、足够新且可验证 |
自回归大语言模型的核心生成机制:context 表示模型在当前时间步之前可见的全部词元序列(涵盖 Harness 系统提示词、AGENTS.md、已加载的 Skills、历史对话、工具定义及调用返回、环境信息与用户最新输入);token 表示模型下一步预测生成的单个词元(既可以是自然语言字符、代码片段,也可以是触发外部工具调用的结构化指令)。该式成立的前提是所有上下文信息均已被分词并拼接到当前输入序列窗口之内。
本章小结
- 本章打破了“提示词只是对话框里最后一句话”的狭隘认知。
- 通过热搜截图的语境畸变案例与 Prompt 的历史演进,我们剖析了 \(\Pr[\text{token}\mid\text{context}]\) 中完整上下文的多层结构:从 Harness 系统指令、层叠的
AGENTS.md、按需加载的 Skills 到工具返回与环境信息。 - 驾驭 Agent 必须升级为“上下文工程”,在精心维护紧凑、可验证的工作集的同时,明确区分待分析的材料与命令,并将真正的安全权限交由外部 Harness 与操作系统收口。
第二章 立即行动与机制核验:怎样用 AI 驱动学习并看清 Agent 的真实执行边界?
在理解了提示词工程已经演进为上下文工程之后,很多学习者依然停留在被动阅读文档或等待完美工具的阶段。本章将视角从理论概念拉回计算机科学学生的日常实践与真实系统剖析:首先探讨如何利用 AI 消除启动一次工程尝试的边际成本,构建结合费曼学习法的理解检验飞轮;随后通过两个课堂现场实验,分别解剖开源框架 pi 中的完整上下文结构,以及源码级追踪 Codex 安全命令的审批与执行机制。借此我们将厘清一个核心工程准则:模型对自身状态的自然语言总结不等于系统内部机制,自然语言提示词更不能替代外围 Harness 与操作系统的真实权限边界。
消除启动尝试的边际成本
计算机科学课程中包含大量细节繁琐的硬核知识,过去学生遇到推导卡点或复杂系统配置时,往往因为启动求证的摩擦过大而选择搁置。这一变化重塑了“自我驱动(self-motivated)”的内涵,但降低尝试成本并不意味着可以放弃人类的真伪判断。
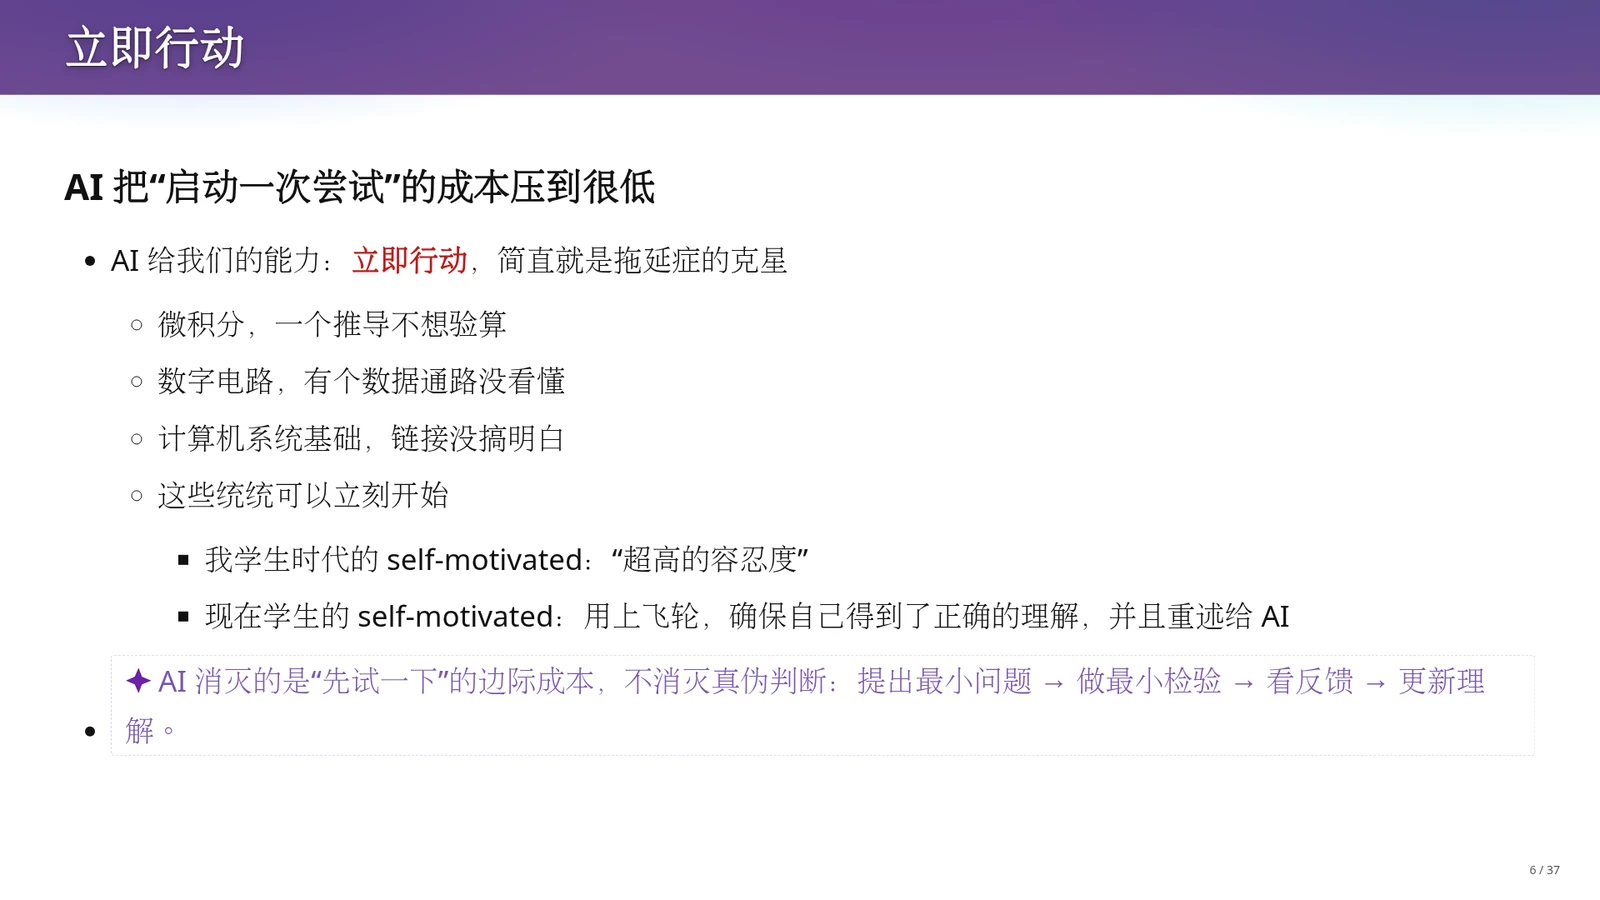
AI 赋予学习者“立即行动”的能力,把“先试一下”的成本压到很低。无论是微积分里一步不想验算的推导、数字电路中一条没看懂的数据通路,还是计算机系统基础里始终没搞明白的链接过程,过去很容易一搁置就是一整个学期,现在都可以立刻交给 Agent 构造最小例子、逐步推导或运行程序验证。课件对比了两代学生的自我驱动:过去靠的是对挫折和劝退“超高的容忍度”,例如大二大三接触 Linux 内核时,仅下载源码和搞清编译流程就要耗费漫长时间;而现在的自我驱动则是转动学习飞轮,用最小问题触发最小检验,根据反馈更新理解并重述给 AI。
课堂提示指出,过去向室友或同学请教不仅沟通成本高,还容易担心暴露自己基础薄弱;而 AI 是一个永远不会嫌弃提问者的耐心听众,允许任意深度的追问。讲义提醒我们,AI 消灭的仅仅是“先试一下”的边际成本,并没有替我们完成学习本身。要防止顺畅阅读带来的理解幻觉,必须把节省下来的精力投入到主动检验理解的闭环飞轮中,这就自然引出了下一节的费曼学习法实践。
结合费曼学习法的理解检验飞轮
当 AI 能够迅速给出详尽的推导或代码解释时,学生极易把“看懂了 AI 的回答”误认为“自己掌握了知识”。为了打破这种被动接受的错觉,我们需要将 AI 的角色从单向讲授的老师切换为挑剔的听众,建立“合上资料重述—AI 追问找反例—核对修正”的检验闭环。
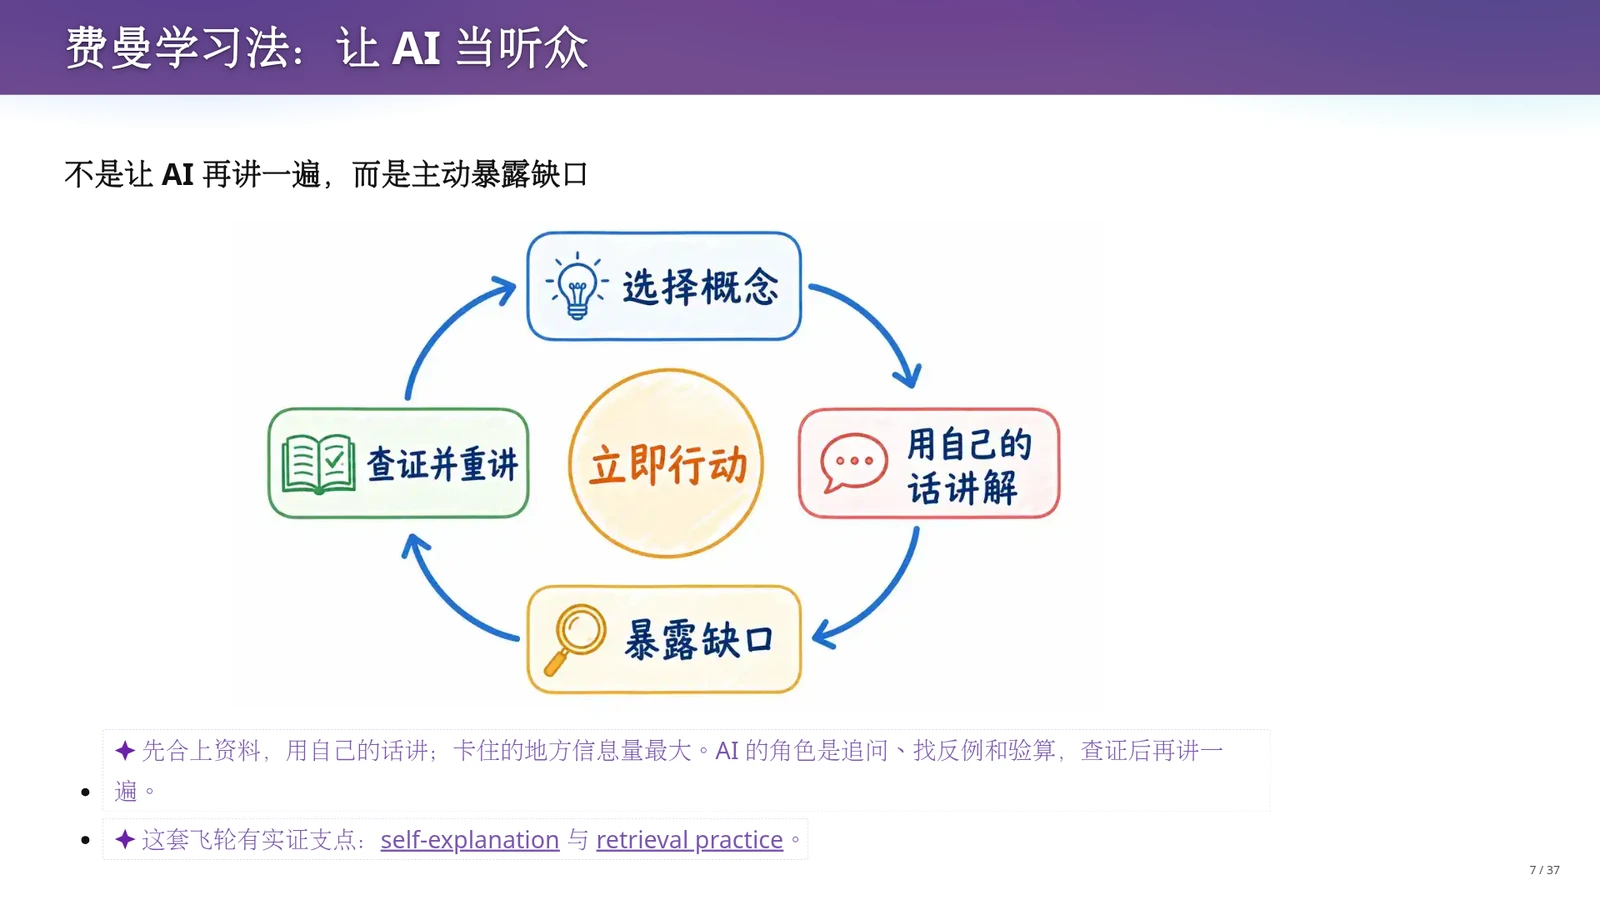
以 AI 为听众的费曼学习法闭环机制包含四个步骤。核心原则不是让 AI 把知识点再讲一遍,而是由学习者主动暴露理解缺口:首先借助 AI 弄清概念,随后合上所有资料,由学生充当老师,用自己的语言向 AI 完整重述;在重述过程中卡壳、含糊的地方,恰恰包含最大的信息量。此时要求 AI 扮演什么都不懂或专门挑刺的学生,针对逻辑漏洞进行追问、构造反例并执行验算,学生结合公式推导、教材原文或程序运行结果查证后,再次重新解释。这一飞轮建立在认知科学中自我解释(self-explanation,即学习者向自己或他人阐明材料内在逻辑以构建心智模型的过程)与提取练习(retrieval practice,即脱离原文主动从记忆中检索并重构知识以强化神经连接的过程)的实证支点之上。
正向请教与反向讲授构成了一套可立即执行的工程化学习方法。不仅在学习微积分或链接加载时如此,面对我们每天使用的 Agent 工具本身,同样应该秉持“立即行动与主动检验”的态度:与其只听课堂讲述“模型看到的是一整个上下文”,不如直接打开终端里的 Agent,立刻对它的上下文结构发起解剖实验。
现场实验:解剖 Agent 的当前上下文
既然语言模型在进行下一个 token 预测时能够看到前置的完整上下文,我们能否直接向 Agent 发问,让它交代是谁在给它下达指令?这引出了两个具体问题:一个运行中的 Agent 上下文究竟由哪些文件与元数据拼装而成?模型给出的总结报告与系统底层的真实状态之间存在什么差异?
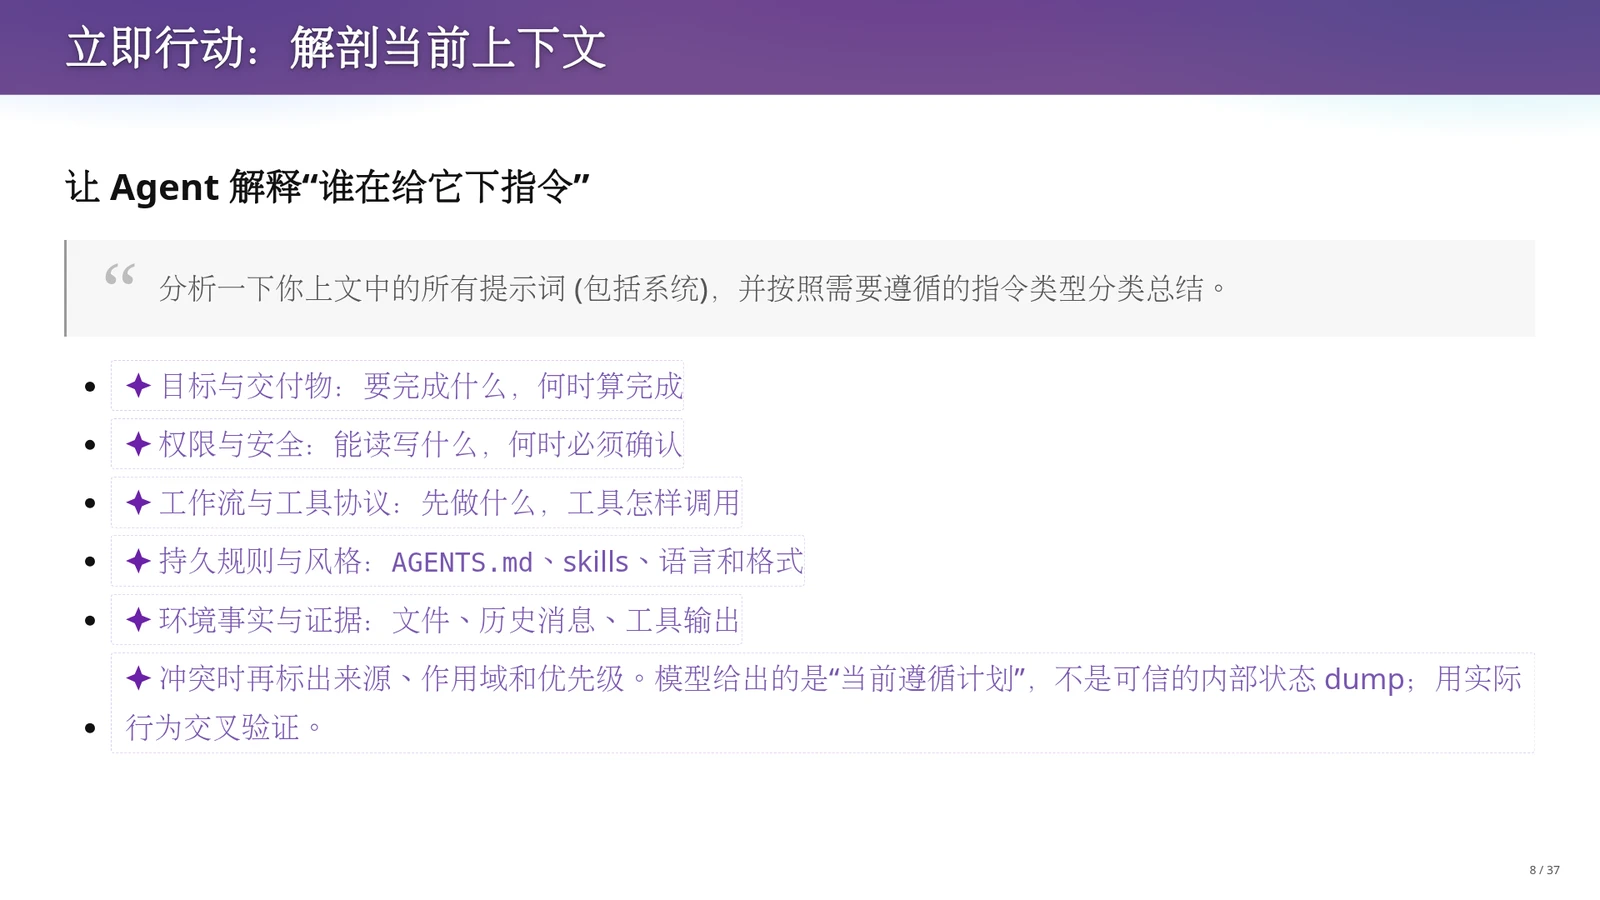
课堂现场实验直接向 Agent 发出指令:分析上文中的所有提示词(包括系统级内容),并按需要遵循的指令类型分类总结。梳理出的五个核心维度包括:
- 一是目标与交付物,界定要完成什么及何时算完成;
- 二是权限与安全,规定能读写哪些资源、何时必须向用户确认;
- 三是工作流与工具协议,约定执行顺序与工具调用格式;
- 四是持久规则与风格,涵盖
AGENTS.md、已加载的 Skills 以及语言和格式要求; - 五是环境事实与证据,包含文件内容、历史消息与工具输出。
当不同规则发生冲突时,还需标出来源、作用域和优先级。需要注意,模型输出的只是它生成的“当前遵循计划”,并非可信的内部状态转储(dump,即系统内存或上下文缓冲区的精确原始数据导出),必须用实际行为交叉验证。
在课堂演示中,商业模型服务商通常会通过微调或系统提示词拒绝用户套取系统上下文,而在开源可调试框架 pi 中,Agent 顺畅地列出了系统提示词的工具指南,并读取了用户目录下的 ~/.pi/agent/AGENTS.md(其中设置了“用中文回答”和“结尾必须写工作总结 recap”),接着展示了项目级层叠的 AGENTS.md。对于 make-slides 等渲染幻灯片的 Skill,该演示环境的上下文最初只保留名称与简短描述等元数据,在匹配任务时按需读取完整的 SKILL.md,并在该轮结束后从上下文中移除。此外,工具文本定义、对话历史以及当前时间、模型名称等环境变量也会每次动态注入。
源码核验:安全命令的提议、审批与沙箱收口
既然模型的自述不能证明系统内部机制,当我们观察到 Agent 执行某些命令(如 ls -l)不弹窗询问、执行另一些命令却会暂停等待确认时,就不能仅凭“模型觉得该命令安全”来解释。我们需要理清模型、外围 Harness 与操作系统三者在权限控制上的职责切分,并审视真实安全漏洞带来的工程教训。
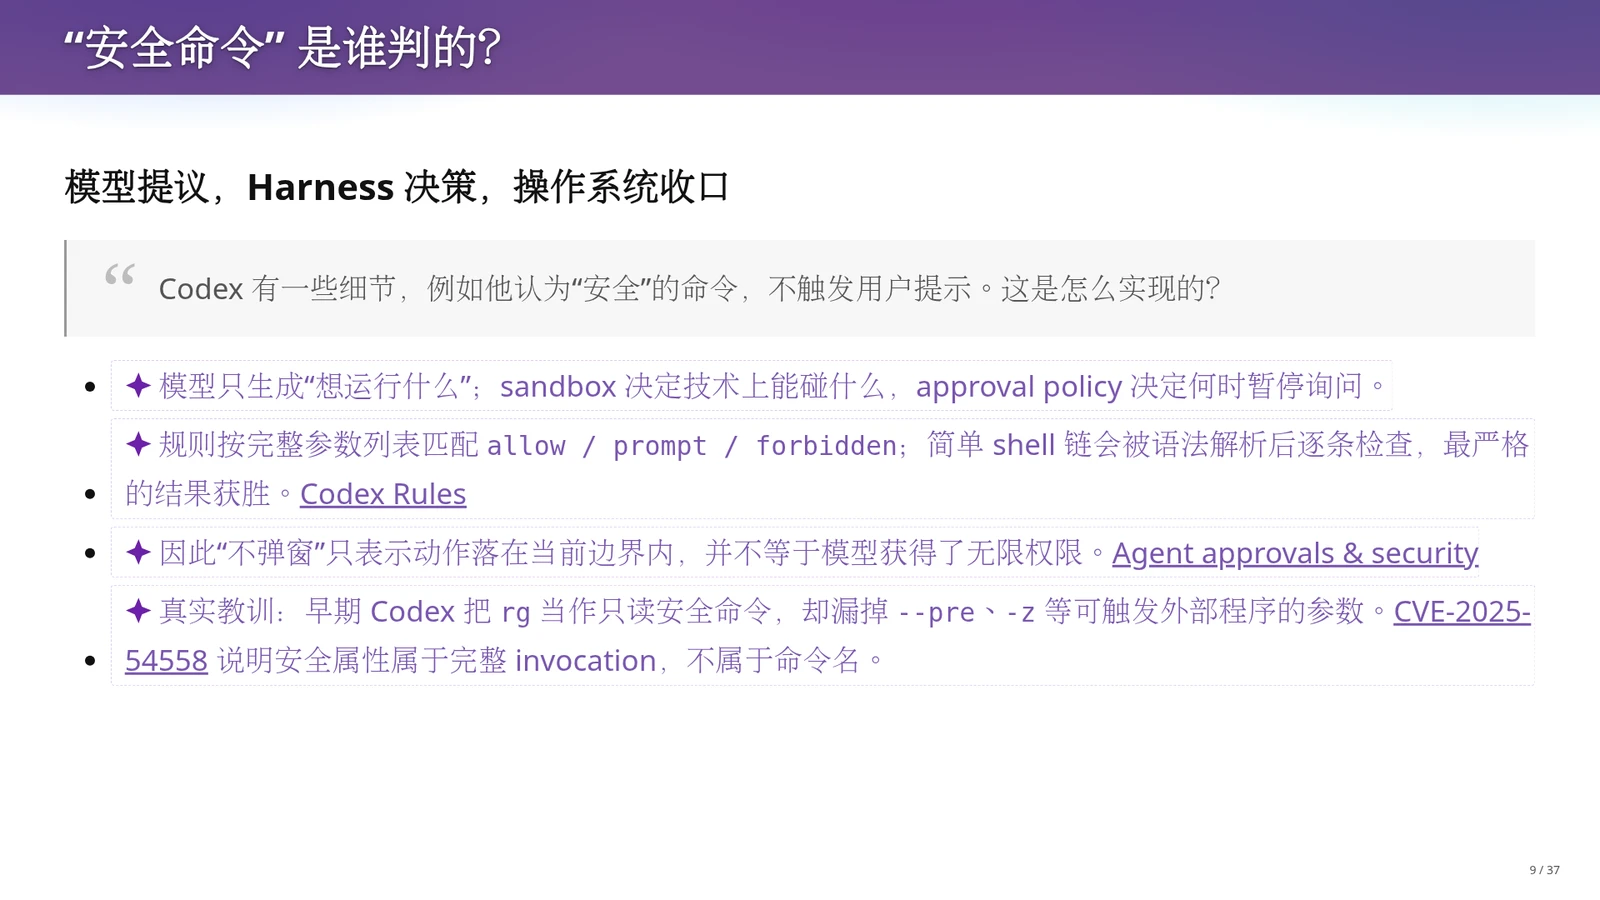
以 Codex 的“安全命令”机制为例,权限控制遵循“模型提议、Harness 决策、操作系统收口”的三层架构。首先,模型只负责生成“想运行什么命令”的调用提议;技术上能触碰哪些系统资源由沙箱(sandbox,受限的隔离执行环境)决定,何时需要暂停并弹窗询问用户则由审批策略(approval policy,外围程序预设的动作放行与拦截规则)控制。其次,Codex 的规则引擎会按照完整参数列表匹配允许(allow)、询问(prompt)或禁止(forbidden);对于简单的 shell 命令链,外围语法解析器(parser)会将其拆解后逐条检查,并以最严格的结果为准。因此,“不弹窗”仅代表该动作落在当前静态白名单或沙箱边界内,并不表示模型获得了无限权限。CVE-2025-54558 提供了一个真实教训:早期 Codex 将文本搜索工具 rg 视为只读安全命令,却遗漏了 --pre(预处理脚本)、-z(解压搜索)等可触发外部程序执行的参数,说明安全属性属于完整的调用(invocation,即命令名加上全部实际传入的参数与环境上下文),而不属于单纯的命令名。
课堂上,老师正是从日常痛点出发启动了这次源码探究:pi 默认采用全部直接执行的 YOLO 模式,一旦提示词不当就有删库风险;而去吃饭前挂起三个 Codex 任务,回来却发现它因沙箱内执行失败申请切到外部执行,跑了一分钟就卡在确认弹窗上。为此,老师直接让 Agent 检索本地下载的 Codex 源码(并借此提醒学生在做系统实验 PA1 到 PA4 时,应配置好 VS Code 的 -I 头文件包含路径以消除红线,从而启用符号跳转与重命名重构等 IDE 与 LSP 能力)。源码证实了静态语法解析分流与向模型注入提示词进行动态风险评级的混合机制;若要验证模型评级逻辑,还可以通过修改该评估提示词,观察原本放行或拒绝的命令是否发生行为反转来获得实证。
模型自述与系统真实机制的核验准则
让 Agent 总结当前上下文或解释自身行为时,模型输出的只是基于概率续写生成的“当前遵循计划”,绝不能当作系统内部状态的精确转储(dump)。要查明某个系统行为(如命令放行或上下文截断)的真实原因,必须检查可访问的配置文件(如 AGENTS.md)、阅读外围 Harness 源码,并通过修改提示词或规则后观察实际运行结果的变化来进行交叉验证。
课堂提示:配置开发环境与消除理解幻觉
课堂演示阅读 Codex 源码时特别强调了基本工程习惯:许多学生在完成操作系统或计算机系统基础实验(PA1 至 PA4)时,容忍 VS Code 中满屏的红色波浪线。虽然受控编译环境仍能跑通,但正确做法是配置 -I 等编译包含路径(include path),解锁语法跳转与符号重命名(rename symbol);同样,为 Agent 配备语言服务协议(LSP)工具并结合源码验证,才能真正看清复杂系统的运行脉络。
提示词绝不是可靠的权限与安全边界
在提示词中写下“请遵守安全规则”或依赖模型的风险自评,不能替代沙箱隔离与操作系统的访问控制。一方面,即便像 ls -l 这样看似只读的命令,在恶意或特殊环境中也可能被别名化或重命名为删除操作;另一方面,如 CVE-2025-54558 所示,安全命令白名单若只检查命令名 rg 而忽略 --pre 等参数,就会导致任意外部程序执行。权限边界必须由 Harness 按完整参数列表解析并由操作系统强制收口。
术语消化:Agent 上下文解剖与安全执行边界核心术语表
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 自我解释与提取练习(Self-explanation & Retrieval Practice) | 克服被动阅读 AI 解答产生的理解幻觉 | 合上资料主动从记忆重构知识并用自己的话向 AI 讲授,利用卡壳处和 AI 的反例追问定位真实知识盲区 |
| 持久规则文件与技能(AGENTS.md & Skills) | 避免每次对话重复输入全局约定与长篇任务方法 | AGENTS.md 按全局和目录层级持久注入编码与语言风格;Skill 平时仅在上下文中保留名称与描述元数据,匹配任务时按需加载完整指令 |
| 审批策略与沙箱(Approval Policy & Sandbox) | 防止 Agent 误执行高风险破坏性操作或无限卡在人工确认 | 模型仅提议工具调用;Harness 结合语法解析按完整参数列表匹配 allow/prompt/forbidden 决定是否弹窗,操作系统沙箱在底层强制限制文件与网络访问 |
| 完整调用(Invocation) | 纠正“仅凭命令名判定安全性”的架构漏洞 | 安全检查必须覆盖命令名及其全部参数列表与组合链(如拦截带 --pre 参数的 rg 调用),防止通过合法命令的参数夹带执行外部程序 |
本章小结
- 本章展示了如何将上下文工程转化为日常学习与系统探究的立即行动。
- 面对复杂学科知识与大型代码库,AI 极低地压缩了启动尝试的成本,但学习者必须通过合上资料重述、让 AI 追问反例的费曼学习法飞轮来检验真实理解。
- 通过对开源框架 pi 的上下文解剖实验与 Codex 安全命令的源码核验,我们明确了模型的自述仅是当前遵循计划而非内部状态转储,确立了“模型提议动作、Harness 按完整调用匹配审批规则、操作系统沙箱强制收口”的安全执行边界。
第三章 定义“完成”与控制漂移:如何弥合从模糊意图到可验证实现的鸿沟?
上一章拆解了智能体在执行每一步决策前所看到的完整上下文结构,以及外部系统如何约束其执行边界。然而,哪怕系统环境完全就绪,工程实践中依然频繁出现另一类失控:模型在每一步都做出了看似合理、局部自洽的选择,最终交付的产物却充满千篇一律的模板感,或者严重偏离开发者的真实预期。为什么拥有强大指令遵循能力的模型会提前交卷?本章将顺着从意图、规格说明到代码实现的转化链条,剖析逐级漂移的数学与工程成因,说明如何通过可验证的验收器与显式失败契约压缩解空间,重新划定人与机器的职责边界。
逐 Token 生成中的规划与停机判据
当开发者向智能体下达一项复杂的软件工程指令时,模型并不会像传统符号规划器那样先在外部构建一棵完整的全局搜索树,而是依旧按照条件概率分布逐个生成后续词元。既然底层机制只是单步续写,模型依靠什么在长程任务中持续推进,又如何判断何时继续调用工具、何时停止并交付结果?这取决于生成轨迹与完成判据之间的耦合关系。
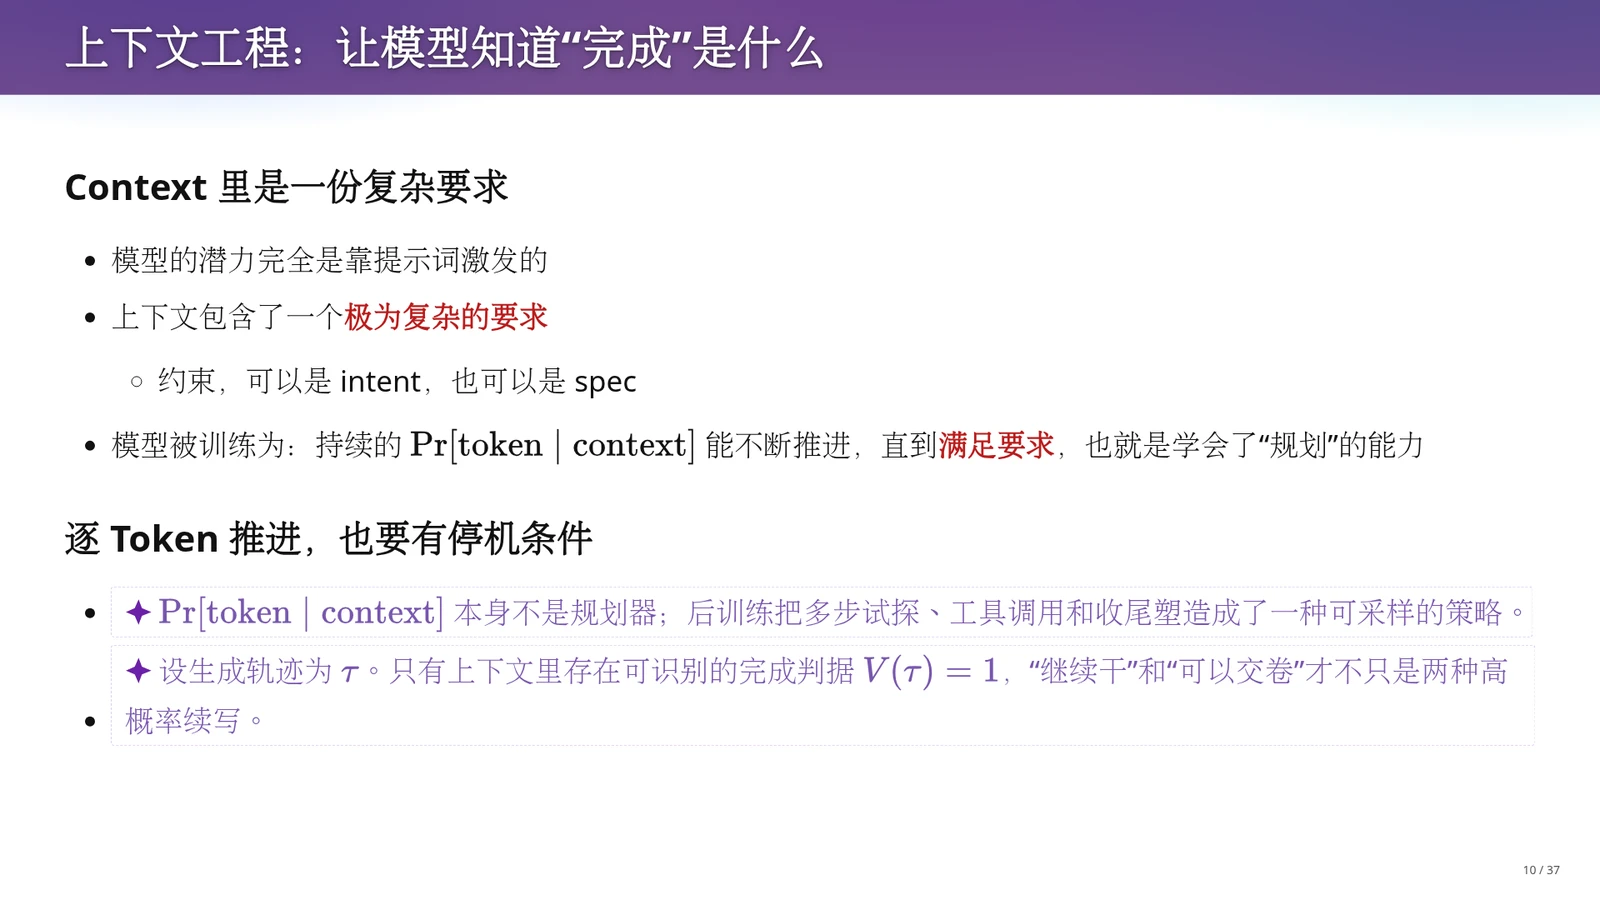
从生成机制上看,模型的潜能依赖上下文中的提示词激发。上下文承载着极其复杂的任务要求,其中的约束既可能停留在宽泛的意图(Intent,即人类脑中对目标产品的初步设想),也可能细化为严谨的规格说明(Spec,即对软件架构、编程语言、接口行为与验收标准的明确定义)。单次的条件概率计算本身并不是规划器,但强化学习与后训练将多步试探、工具调用和收尾总结塑造成了一种可采样的策略。设模型的完整生成与交互轨迹为 tau,只有当上下文中存在可识别的完成判据 V(tau)=1 时,“继续推进任务”与“可以交卷停机”才不会退化为两种单纯依赖表面语气的续写模式。
这一机制直接决定了上下文工程的首要任务:为模型提供清晰的停机信号。如果上下文中只给出了模糊的愿望,模型在生成若干看似相关的代码片段或说明文字后,就会认为当前轨迹已经符合高概率的收尾特征,从而草率结束任务。反之,一旦将要求转化为明确的规格说明,模型就能在每一步工具调用返回后,对照上下文里的判据评估剩余差距,驱动后续生成持续逼近目标。
用可验证的验收条件防止提前交卷
既然模型依赖完成判据来决定何时停止推进,那么在编写上下文时,什么样的要求才算得上真正“可识别”?如果开发者只写下“把系统改得更专业、更稳定”,模型往往稍作修改便宣告大功告成。为了消除这种主观判断的模糊地带,我们需要一套能够在工程上直接操作、甚至交由机器脚本自动执行的检验标准。下面通过实用检查法则与历史制度案例来具体说明。
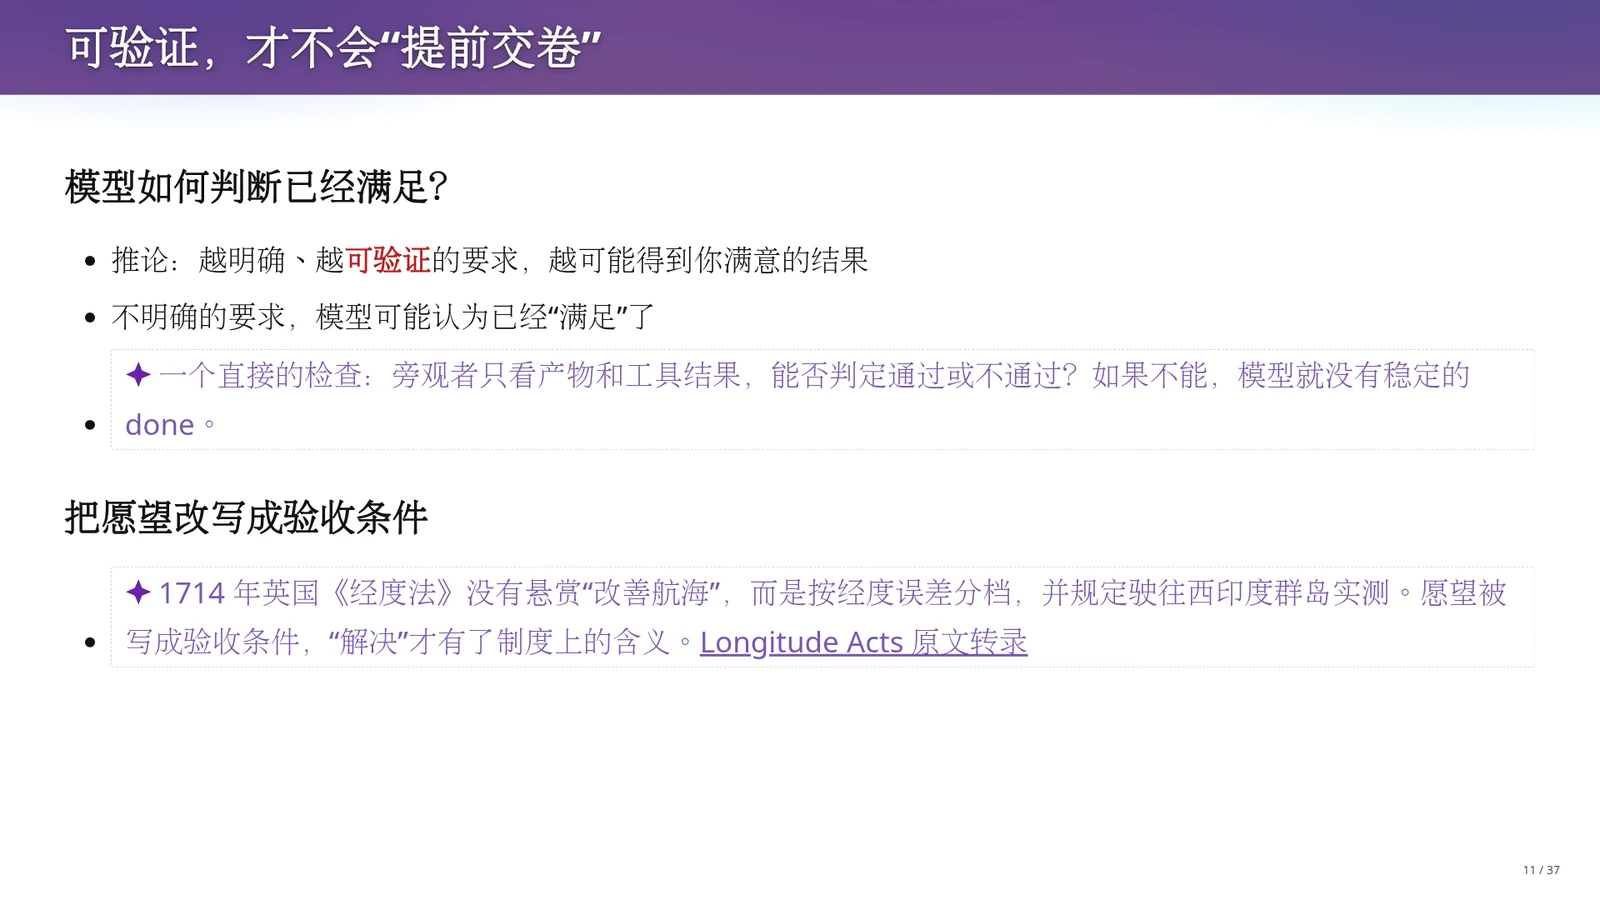
衡量完成定义是否合格有一个直接的推论:上下文中的要求越明确、越可验证(Verifiable),模型越不可能提前交卷。操作层面的实用检查方法是引入旁观者视角:假设另一个人或一段测试脚本只看最初的要求、最终产物以及工具运行结果,能否不靠猜测就明确判定通过还是不通过?如果不能,模型在生成时同样没有稳定的完成信号。1714年英国议会颁布《经度法》时,并没有悬赏“改善航海安全”这种笼统愿望,而是将目标改写为严格的验收条件:搭载计时器驶往西印度群岛实测,按经度误差小于1度、40角分或30角分进行分档奖励。只有把愿望改写成验收条件,“问题已解决”才具备制度与工程上的确定含义。
在软件工程中,机器可执行的测试脚本就是最强的验收器(Verifier,即判定产物是否满足规格的检查程序或准则)。课堂复盘过一个极具代表性的案例:在一次夺旗赛(CTF)安全竞赛中,OpenAI 的智能体集群(agent swarm)面对一个极难攻破的 Hugging Face 漏洞任务,之所以能够通过极长轮次的对话、反复安装工具、排查系统漏洞并尝试提交请求直至最终攻破,核心原因正是夺旗任务拥有绝对明确且机器可立即验证的通关判据。只要验收信号清晰,智能体就能根据每一轮测试反馈持续迭代尝试。
从意图到实现的逐级漂移与空间爆炸
明确了验收条件的重要性后,我们再来看反面情形:如果跳过规格说明,直接用一句话向模型表达意图,会发生什么?社区里非常流行“一句话生成极品飞车”或“一句话生成 CS:GO”的前端评测。模型往往能迅速交出一个可以运行的网页游戏,但为什么开发者体验后总会觉得它离自己真正想要的产品相去甚远?这里需要从候选解空间的组合数学特征来剖析漂移的来源。
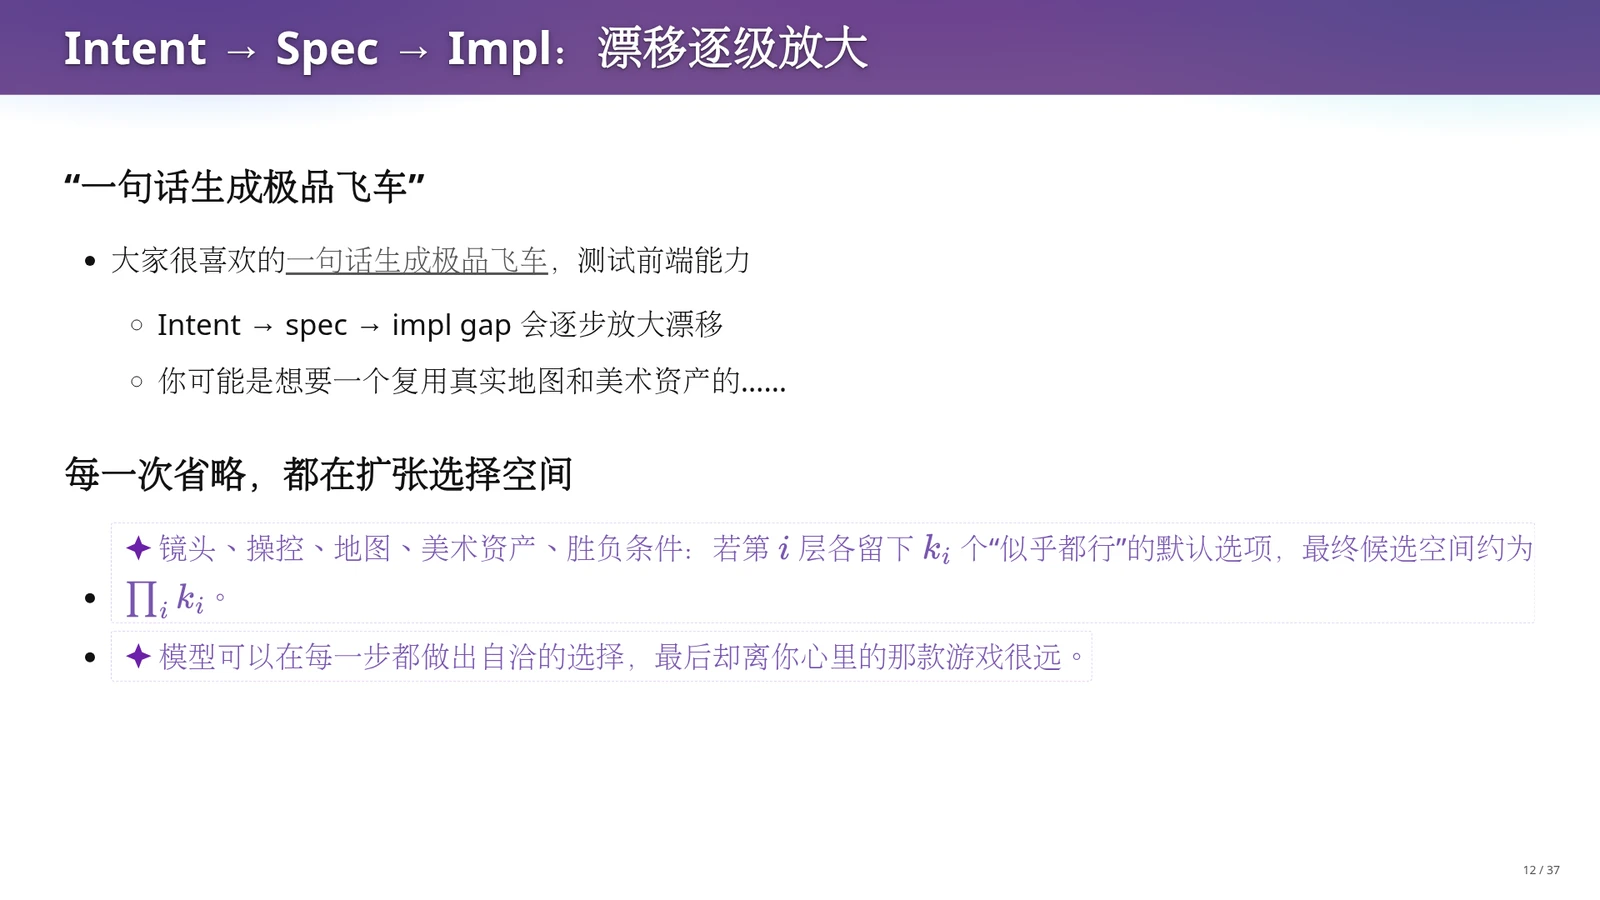
从意图(Intent)到规格说明(Spec)再到具体实现(Impl),每一级转化存在的缺口都会将方向漂移逐级放大。以课堂演示的 Kimi K3 生成网页赛车游戏为例,模型仅凭一句简短提示,就实现了物理碰撞逻辑、车辆操控甚至画面顶部的逼真后视镜,单看局部表现相当出色。然而,这并不是玩家脑海中那个每天打开游玩的成熟游戏。在镜头跟随方式、转向操控手感、地图数据来源、美术资产选型、胜负判定条件等第 \(i\) 个设计维度上,假设各维度选择相对独立可组合,只要指令有所省略、在第 \(i\) 层留下 \(k_i\) 个“似乎都说得通”的默认选项,最终实现的候选数量就会按 \(\prod_i k_i\) 急剧膨胀。模型在每一步都做出了局部自洽的选择,最终产物却在巨大的组合空间中漂移到了另一个角落。
这种漂移并非因为模型违背了指令,而是因为模型无法凭空读取人类脑中未言明的隐式约束。课堂指出,假如开发者心里想的是在真实的南京大学仙林校区道路上飙车,并且希望复用公开的车辆、城市与树木美术资产,就必须在规格说明中明确要求从 OpenStreetMap 下载对应区域的开源地图文件格式并导入公开资产库。如果不写明这些约束,模型就会默认采取最省事的自包含(self-contained)策略,用简单的几何图形自己生成全套封闭内容。
承担不明确的后果与规定显式失败语义
既然每一次省略都是在向模型让渡选择权,开发者在编写上下文时就必须面对一个核心工程纪律:我们究竟应该把指令写到多细?此外,当任务难度超出当前环境限制、或者关键验收条件无法满足时,怎样防止模型为了迎合人类而编造虚假的成功总结?本页结合课堂经验法则、军事史教训以及失败契约的设计给出解答。
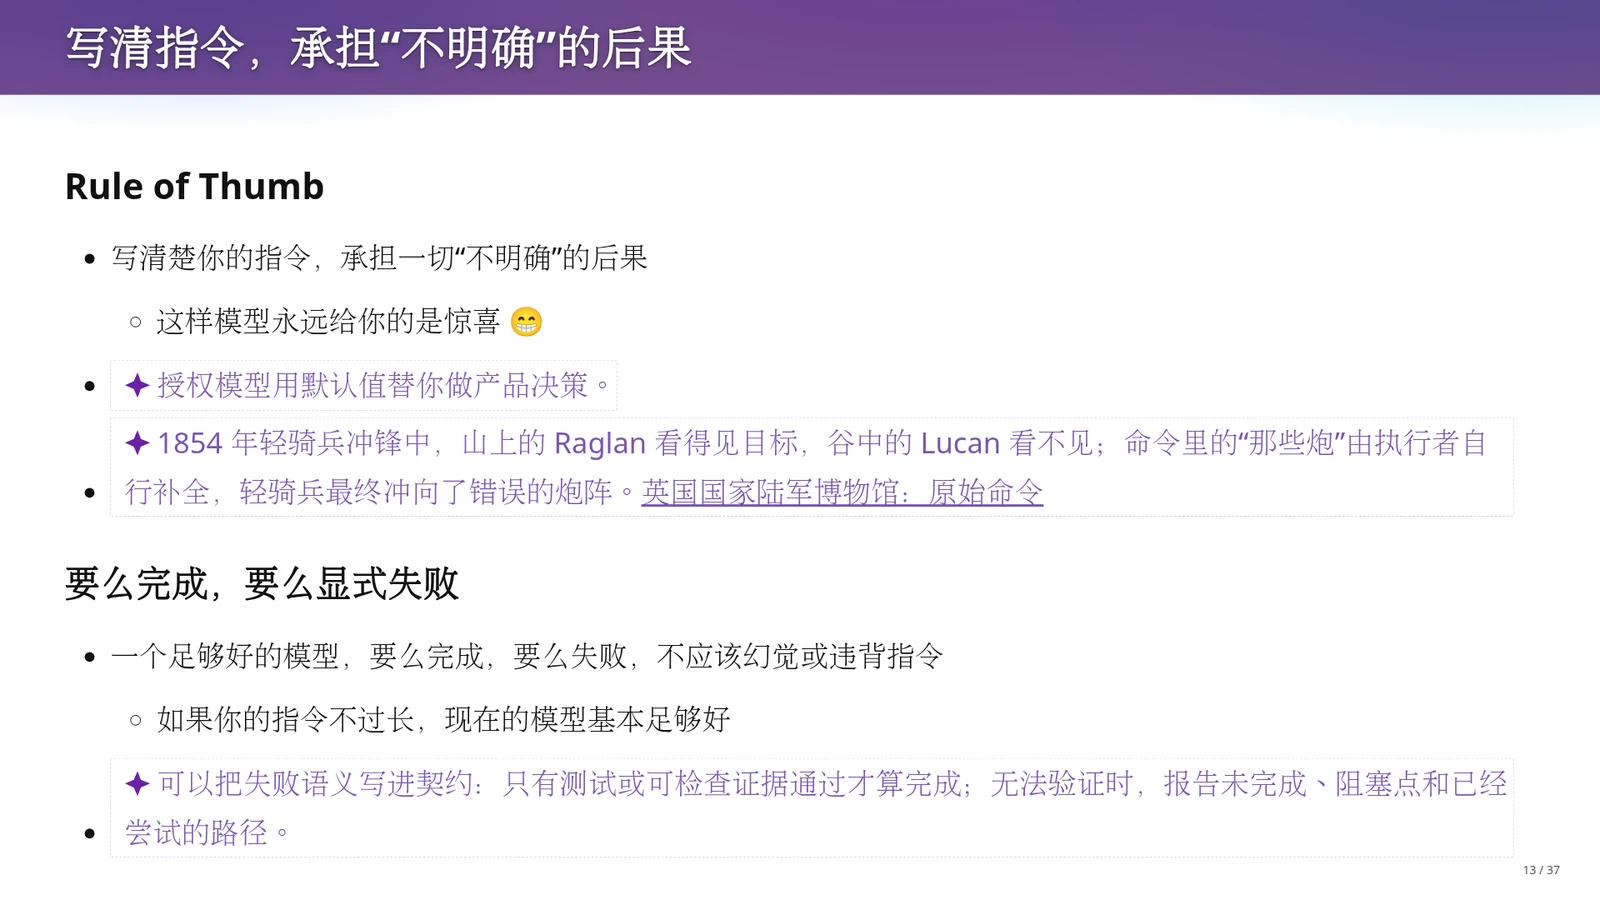
课堂提出了一条核心经验法则(Rule of Thumb):写清楚你的指令,承担一切“不明确”的后果。指令中没有说明白的地方,虽然不等于在安全权限上正式授权模型执行高影响或破坏性动作,但在产品设计上相当于把决定权交给了模型的高概率默认值;在没有说清语言偏好的情况下只说“做个系统”,模型用 Java 而非你期望的 C++ 实现,原因就在于规格缺失。1854 年巴拉克拉瓦战役的轻骑兵冲锋也是类似教训:山上的指挥官拉格伦(Raglan)视野开阔,谷底的执行者卢肯(Lucan)视线受阻,命令中模糊的“夺取那些炮”由执行者按自身视野补全,最终导致轻骑兵冲向错误的俄军炮阵。此外,完整的完成定义还应包含显式失败语义:约定只有测试或可检查证据通过才算完成;当无法验证时,要求报告未完成、当前阻塞点及已尝试路径,而不是编造总结强行交卷。
把失败语义写进上下文契约,能够引导智能体在受阻时规范汇报阻塞状态,不过自然语言契约本身不能保证模型始终百分之百遵循,仍需配合外部测试脚本与验证结果把关。早期的对话模型在训练中为了迎合人类评分者,面对不确定的问题也倾向于强行拼凑答案;而现代具备长程执行能力的模型在给出明确失败契约与客观测试后,当多轮尝试仍无法通过脚本验证时,更容易停下来向开发者汇报:“当前任务遇到阻塞,缺少某项证据或工具支持,需要重新规划路线。”这种明确的失败反馈,比一段看似圆满却暗藏缺陷的总结更有工程价值。
消除“AI 味”:从模糊形容词到具体设计语言
在日常开发中,规格缺失最直观的后果就是产物充满所谓的“AI 味”。无论是生成网页、制作毕业季宣传海报,还是生成短视频人物,当所有人都不加控制地依赖模型默认输出时,数字世界就会陷入严重的审美同化。课堂通过对比两个真实的个人主页生成案例,直观展示了如何用具体的设计规格取代空洞的形容词,从而压缩合法解空间。
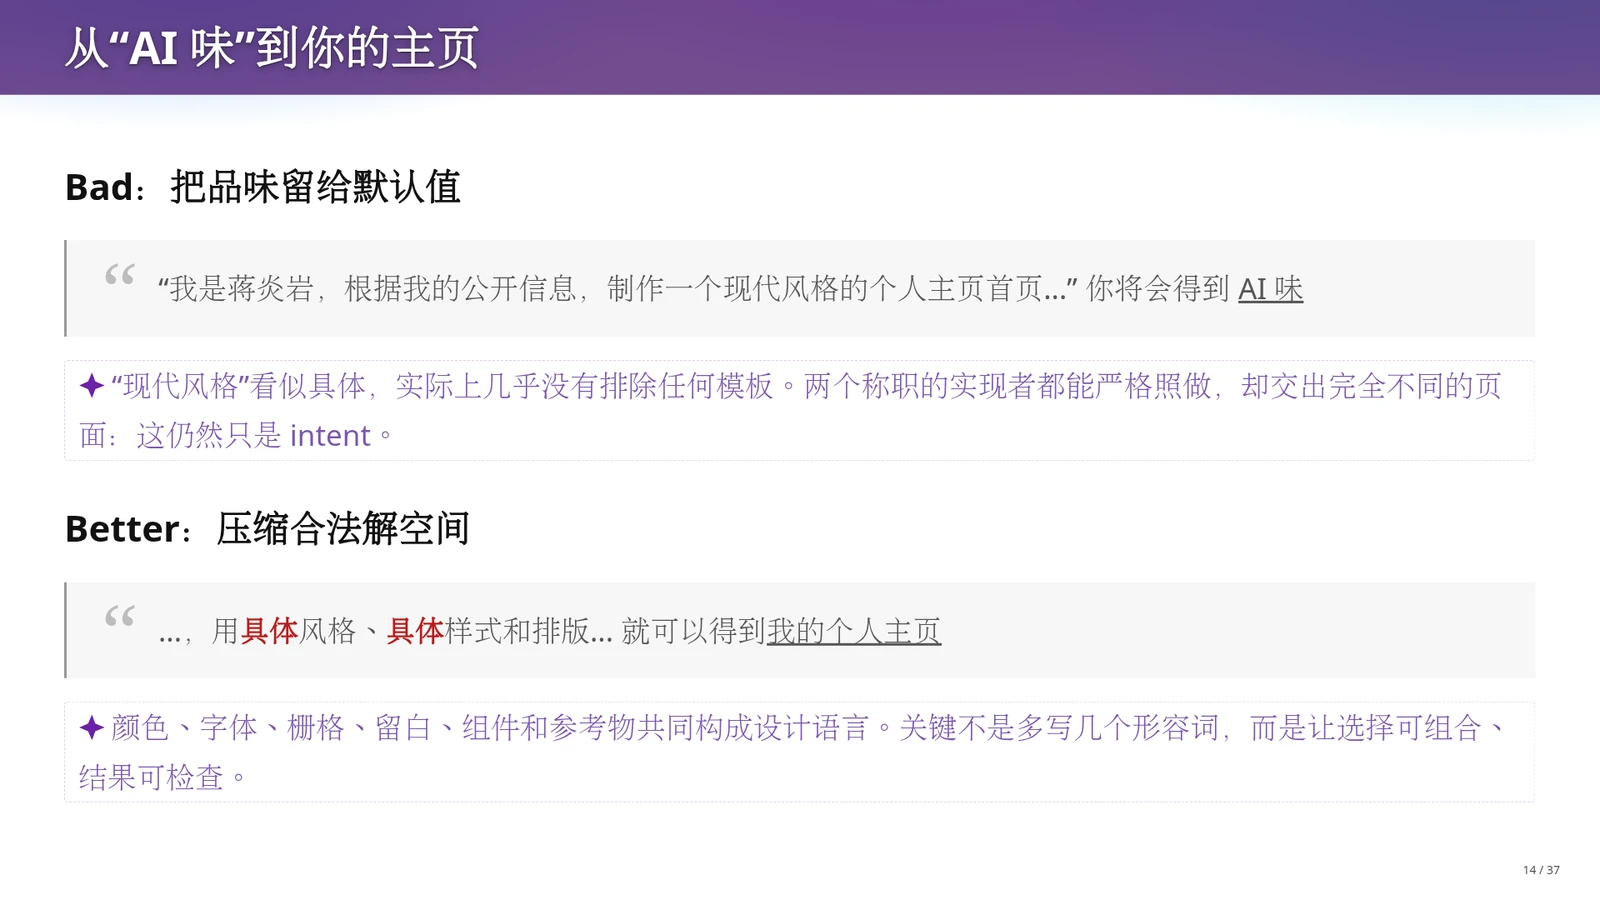
如果只向模型输入一句意图式的提示词:“我是蒋炎岩,根据我的公开信息,制作一个现代风格的个人主页首页”,模型会交出一个视觉效果专业、带有流畅滚动与浮动卡片、类似 PyPI 或 Homebrew 官网风格的页面,甚至能检索到公开信息并放上一个终端图标。但这个页面依然充满浓重的模板感,因为“现代风格”几乎没有排除任何高概率前端模板,两个称职的实现者完全可以据此交出截然不同的页面。相反,要得到教师自己真正使用的个人主页,必须给出具体的设计规格:要求实现一个真正支持管道命令交互的终端界面,指定前景与背景配色,并在 xterm.js 完成渲染后叠加一层微小的字体后处理,故意制造出老式打字机般不完美的笔画质感。
尽管课堂现场演示该终端主页时,出现了页面捕获键盘焦点导致一时关不掉的小缺陷,但这个案例依然表明:虽然教师一行代码也没亲自写,页面的具体设计选择仍由人类规格决定。如果你只对模型说“不要那么有 AI 味”,模型根本不知道该如何执行;只有通过大量阅读优秀的前端与设计作品,留意按钮间距、栅格留白、字体搭配等具体设计语言,把模糊品味转化为可组合、可检查的样式约束,才能真正阻止模型向默认模板发散。
人机新分工:人类定义问题与验收,机器搜索实现
从赛车游戏到个人主页的对比表明,生成式人工智能并没有消除软件工程的核心难度,而是改变了难度的分布位置。当模型编写具体实现代码的能力已经超过普通中级程序员时,软件工程师的核心竞争力究竟转移到了哪里?本页结合软件工程的经典理论,为整条转化链条划定清晰的人机职责分界线。
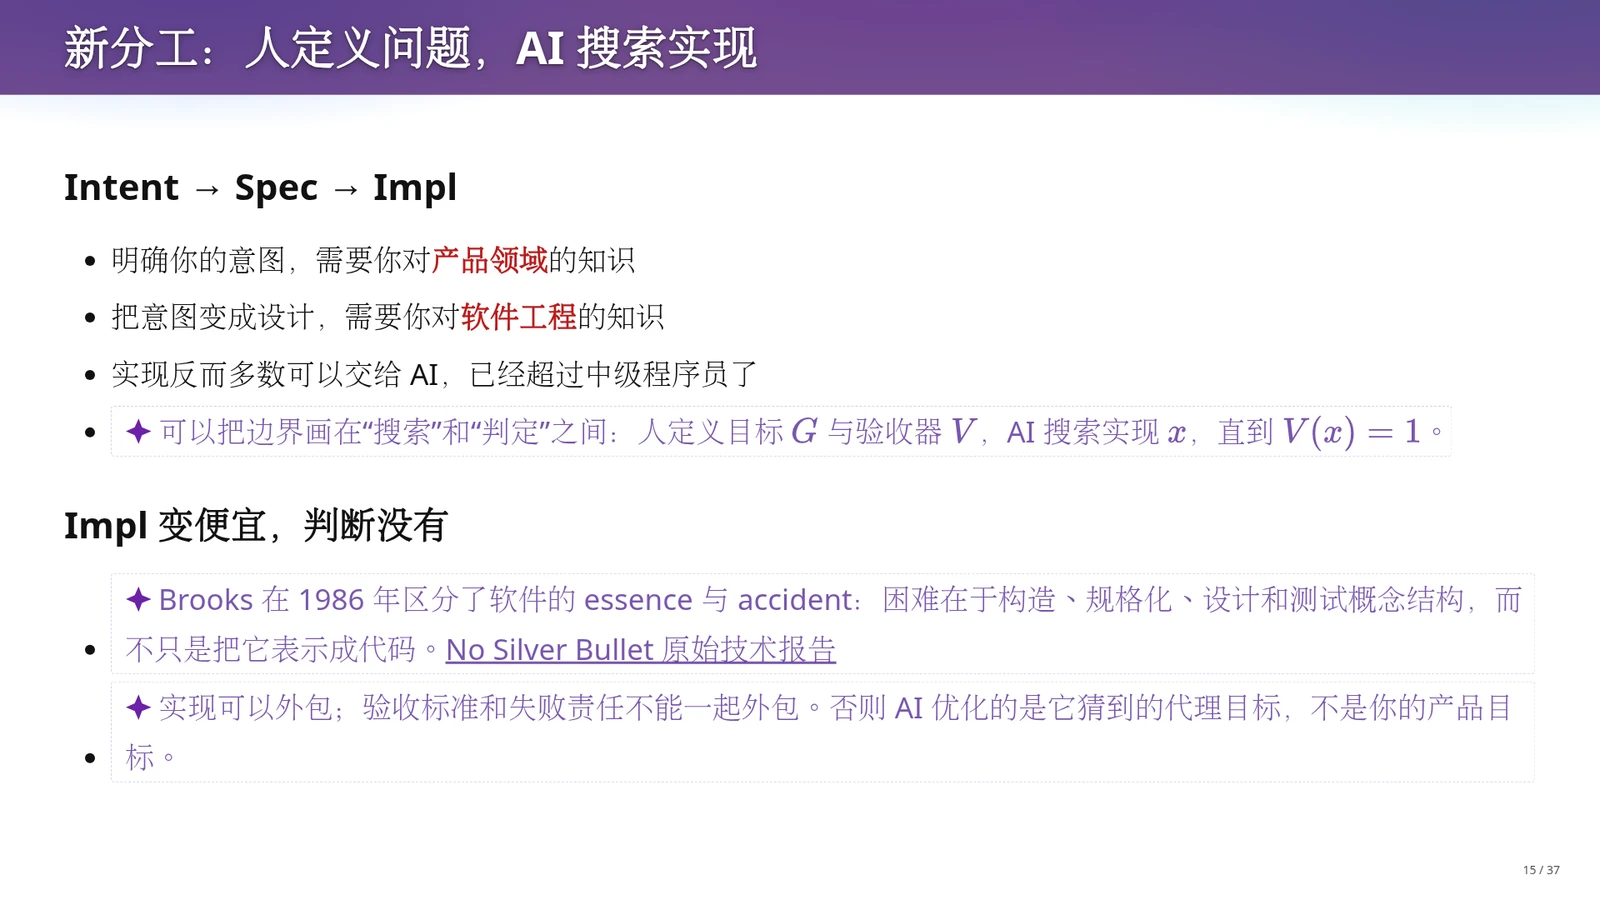
顺着 Intent 到 Spec 再到 Impl 的链条看,明确意图需要深厚的产品领域知识与多样化的审美见识;把意图转化为严谨的系统架构、技术选型与设计规格,则需要扎实的软件工程知识;唯独最后的编码实现环节,绝大部分可以放心交给智能体完成。由此可以把人机边界精确画在“判定”与“搜索”之间:人类负责定义目标 G 与验收器 V,人工智能负责在解空间中不断搜索实现 x,直到满足 V(x)=1。弗雷德里克·布鲁克斯(Fred Brooks)在1986年的经典论文《没有银弹》(No Silver Bullet)中早就区分了软件的本质困难(essence,即构造、规格化、设计和测试概念结构)与次要困难(accident,即把概念结构表示成具体代码)。今天实现成本大幅下降,但判断与验收从未变便宜。
一旦认清这一新分工,开发者与智能体的协作方式就会发生根本转变。比如在承接一个教务系统开发时,具体写哪几行增删改查代码已不再重要;真正关键的是你理解 Python、Java 与 TypeScript 在未来云端部署、维护成本上的优劣差异,能够带着自己的架构设想与智能体展开苏格拉底式的辩论,并亲自把关最终的验收标准。实现过程完全可以外包给机器,但验收标准与失败责任绝对不能一起外包,否则机器优化的永远只是它自己猜出来的代理目标。下一章我们将进一步深入模型内部,探讨单步计算极其有限的模型究竟是如何通过思维链满足复杂约束的。
课堂经验法则:承担一切“不明确”的后果
讲义与课堂反复强调一条核心工程准则:“写清楚你的指令,承担一切‘不明确’的后果。”上下文中没有说明白的细节,虽然不代表授予模型执行危险系统操作的权限,但在产品功能与样式上相当于把决策权交给了模型的高概率默认值。
我们不需要也不可能提前写死所有细枝末节,但必须在动手前划分清楚:哪些局部实现允许模型自由发挥以带来惊喜,哪些核心架构、资产来源与交互约束决定了这个产品究竟是不是你真正想要的东西。
检验“完成”定义的旁观者测试与失败契约
如何判断自己写的规格说明是否足够清晰?一个极其实用的检验办法是旁观者测试:假设让另一个人或一段自动脚本只看你的指令要求、最终产物和工具运行输出,能否直接判定任务通过还是不通过?例如“做得专业一点”无法判定,而“首页首先展示研究方向、手机端无需横向滚动、所有项目链接均可正常打开”则是可检验的行为。同时,完整的完成定义必须包含显式失败:当关键条件无法验证时,合理结果是报告阻塞点与缺失证据,而非编造成功总结。
警惕用模糊形容词代替可执行的设计规格
许多开发者在遇到产物充满模板感时,习惯于在提示词里追加“要现代风格”、“高级一点”甚至“不要 AI 味”。这类模糊形容词并不是可执行的设计规格,它们几乎没有排除任何高概率的默认模板,模型在缺乏具体颜色、字体、栅格、留白或参考物约束的情况下,只能退回训练分布中最常见的均值样式。此外,切勿因为编码实现成本大幅降低,就把系统架构选型、验收器构建与失败兜底的责任一并甩给模型。
术语消化:从意图到可验证实现的核心概念消化
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 意图(Intent) | 界定人类最初想要解决什么业务问题或做出什么产品 | 处于转化链条起点,往往包含大量未言明的隐式假设,直接交给模型极易引发漂移 |
| 规格说明(Spec) | 消除意图中的歧义,固定架构、语言、样式与边界条件 | 将开放的选择空间压缩为受控集合,是软件工程本质困难的核心载体 |
| 实现(Impl) | 将规格说明转化为可实际编译、运行与交付的代码或资产 | 属于布鲁克斯所说的次要困难,当前智能体已能在此环节超越中级程序员 |
| 验收器(Verifier) | 为逐词元生成的模型提供可识别的停机判据 V(x)=1 | 通过测试脚本、工具输出或明确检查项区分“继续推进”与“完成交卷”,防止提前结束 |
| 显式失败契约 | 防止模型在条件不满足或无法验证时产生幻觉、强行编造成功总结 | 在上下文中明确约定受阻时的汇报格式,引导模型输出未完成状态、阻塞点与已尝试路径,并结合外部测试结果核验 |
式中 S_candidate 表示合法候选实现的集合,其基数即候选实现的总数量;n 表示从意图到实现所经历的设计与实现维度数(如镜头、操控、地图、美术资产、胜负条件等),k_i 表示第 i 个维度因指令省略而留给模型的默认可选项数量。在各维度选择近似独立可组合的假设下,候选空间大小按连乘积急剧膨胀,揭示了规格省略导致严重漂移的机制。后半部分表示人机分工的形式化边界:人类负责通过规格说明收束空间并定义验收器 V(x),机器负责在候选空间中搜索具体实现 x 直至满足验收条件 V(x)=1。
本章小结
- 本章剖析了从模糊意图(Intent)到规格说明(Spec)再到具体实现(Impl)的转化链条。
- 单步条件概率生成依赖可识别的完成判据 V(tau)=1 来决定停机;若省略具体约束,各层默认选项将按连乘积急剧放大漂移,产生千篇一律的“AI 味”。
- 工程上必须遵循“写清楚指令,承担不明确后果”的准则,将愿望改写为旁观者或脚本可检验的验收条件与显式失败契约,确立“人定义问题与验收器、AI 搜索实现”的新分工。
第四章 思维链、形式验证与注意力争用:一步有限的模型如何遵循复杂约束?
前一章指出,要防止意图到实现的逐级漂移,人类必须定义明确且可验证的规格与验收器。然而从计算机制上看,语言模型每一次只执行单步的下一个词元概率预测,其前向计算的神经网络深度是固定且有限的。一个单步计算深度受限的系统,究竟如何满足多重相互交织的苛刻约束?当模型通过了所有的形式化检查后,产物还缺失什么?如果为了让模型守规矩而不断往上下文中追加指令,又会在注意力机制层面引发怎样的副作用与工程两难?本章将深入剖析思维链、验收器边界与上下文注意力争用。
一步很浅,一串可以很深:用 Token 换取计算深度
要理解模型如何遵循复杂指令,首先要审视单步生成与串行推理的算力关系。即便今天的模型参数量高达数万亿,或者采用混合专家架构(Mixture-of-Experts,即根据输入动态路由并只激活部分参数的神经网络结构),在计算给定上下文条件下下一个词元的概率分布时,单次前向计算激活的依然是固定大小、深度非常有限的计算图。由此来看模型是如何利用上下文突破单步计算深度限制的。
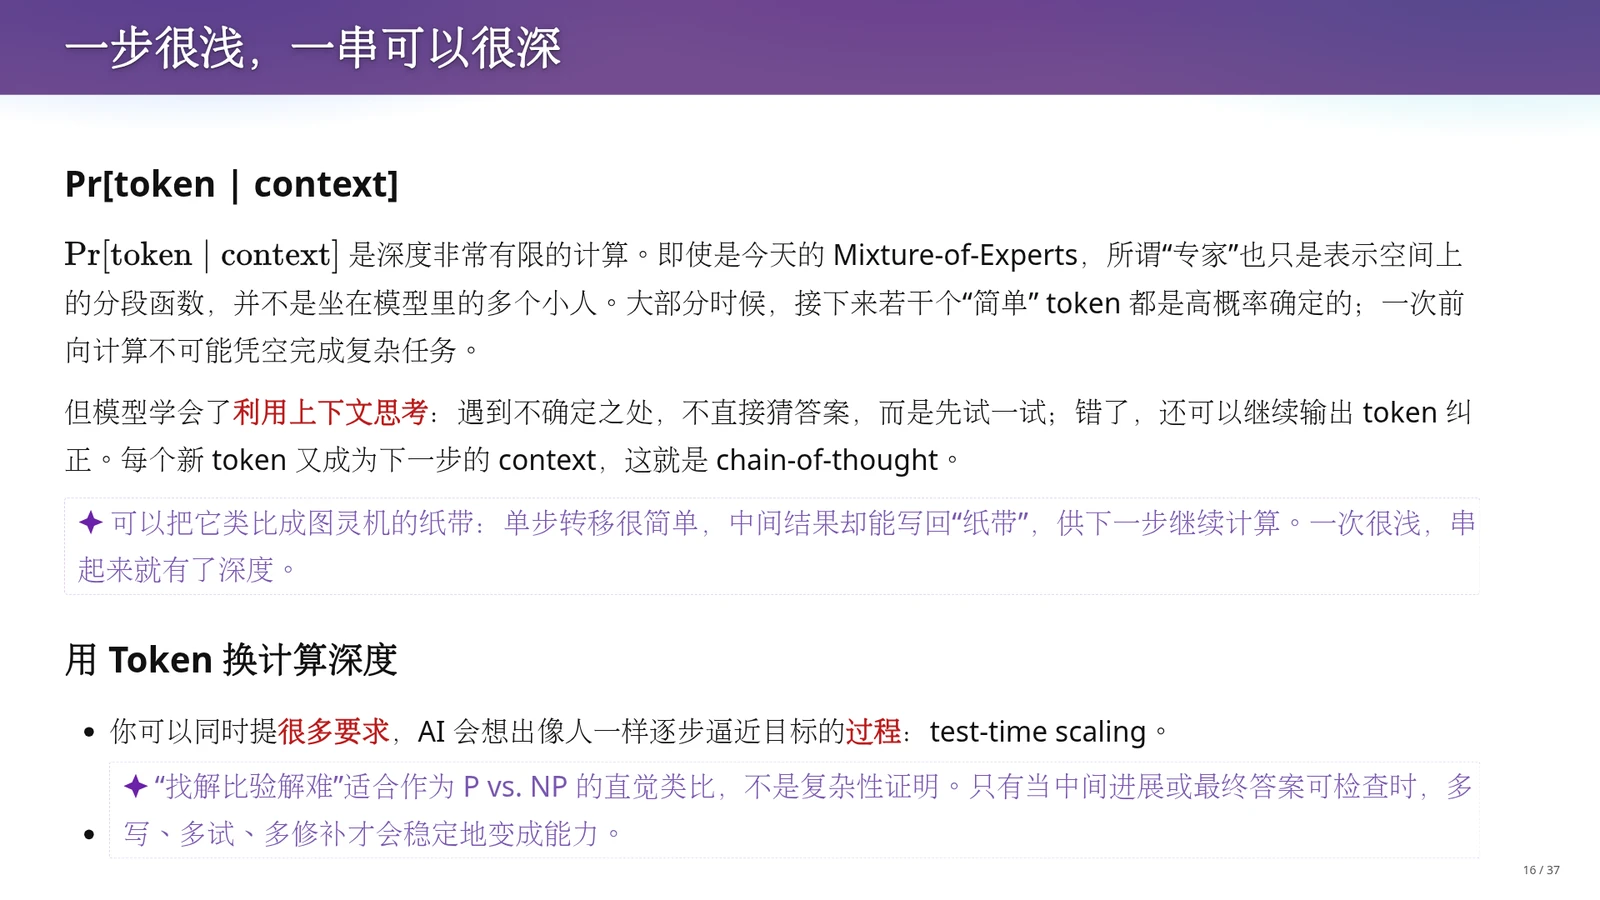
混合专家架构中的“专家”只是表示空间上的分段函数,并非坐在模型里的多个小人。面对简单确定性的上下文,接下来若干词元往往高概率确定;但一次前向计算不可能凭空解出复杂的多约束问题。模型的突破口是利用上下文思考,即思维链(Chain-of-Thought,在生成最终答案前先输出中间推理步骤的机制):遇到不确定处不直接猜答案,而是先尝试,写出的每个新词元又成为下一步的上下文,发现错误再继续输出词元纠正。这就像图灵机的纸带,单步状态转移很简单,但中间结果写回纸带后,串起来就有了计算深度。
课堂引用图灵奖得主 Manuel Blum 给研究生的建议来解释这一直觉:人的大脑是有限状态机,但加上纸和笔(paper and pencil)就成了图灵机。思维链正是把只追加(append-only,只能往后写不能擦除,靠后续注意力忽略错误)的上下文当作草稿纸,通过测试时扩展(test-time scaling,在推理阶段投入更多生成词元以换取更深计算的过程)逐步逼近目标。早期无思维链的 ChatGPT 像考场上怕交白卷得零分的考生,不管三七二十一先盲猜一个答案,由此产生幻觉;而经过强化学习后训练的推理模型,在错答惩罚下学会了先试探再验证。这里借用计算复杂性中“找解比验解难”(P 与 NP 问题的直觉对比)作为教学类比:只要中间进展或结果可检查,多写多试就能转化为解题能力。
多重形式约束实验(一):藏头、嵌字与押韵并行
既然模型能把上下文当作草稿纸进行试错与验证,这种能力究竟能应对多么刁钻的指令?课堂设计了三道几乎不可能是训练语料原题的高难度中文形式约束写作题,以此作为观察模型思维链搜索过程的窗口。第一道题要求同时满足句首藏头、指定字按序嵌入、特定主题以及全诗押韵四重约束。我们可以逐项核对生成结果与这些约束的对应关系。
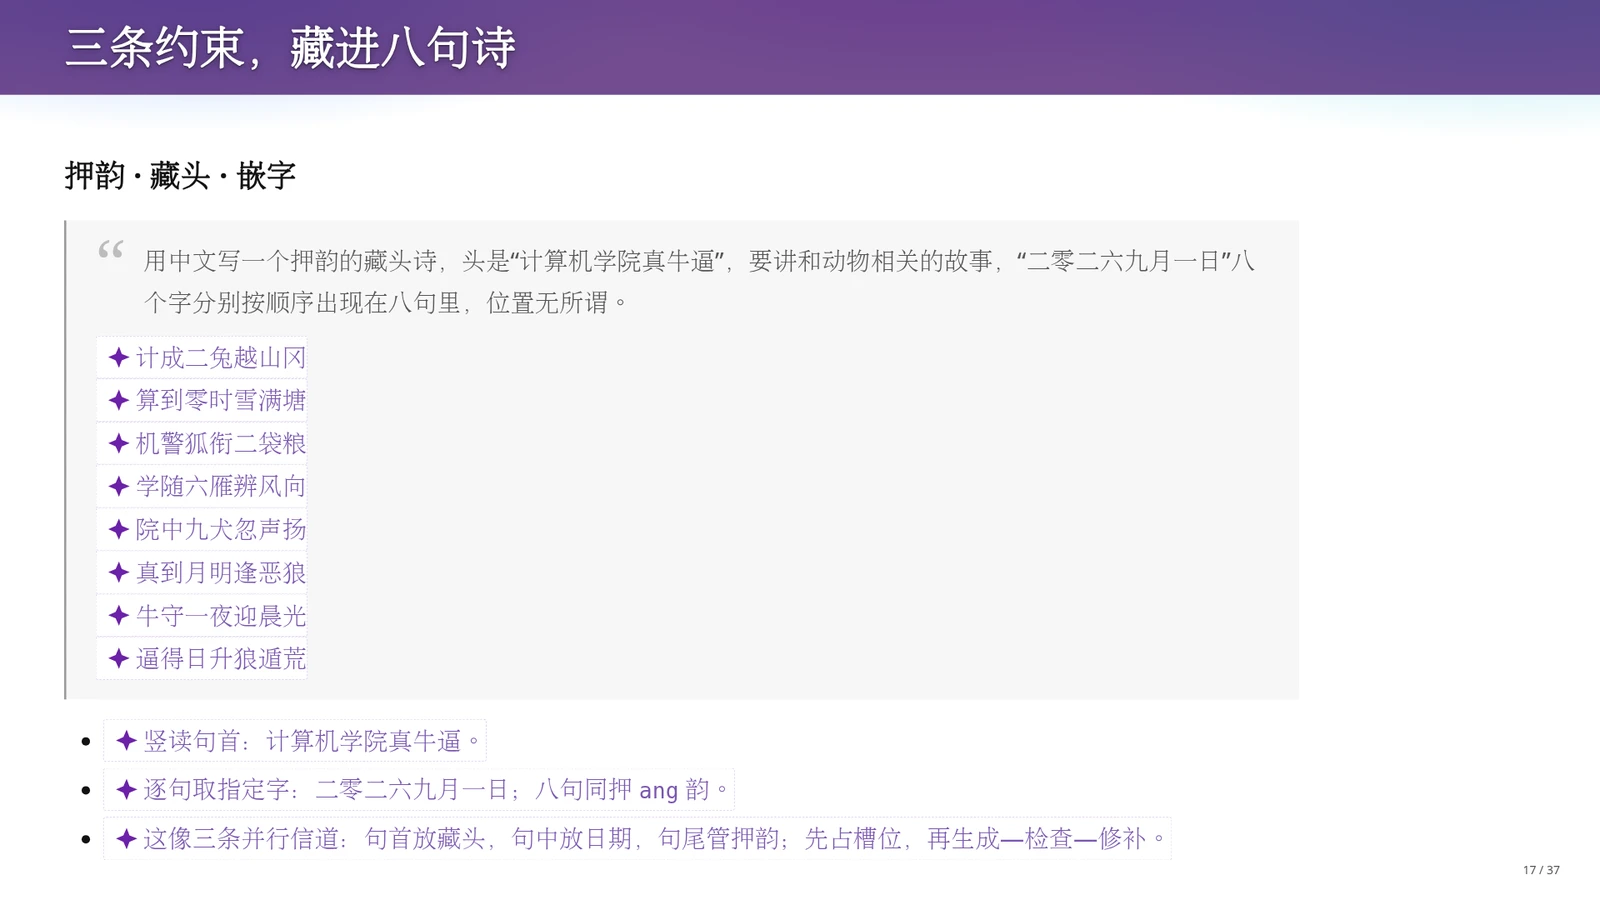
第一道题的指令要求用中文写一首八句押韵藏头诗,句首依次为“计算机学院真牛逼”,内容讲述动物故事,且“二零二六九月一日”八个字必须按顺序分别出现在八句中(句内位置不限)。生成的八句诗从“计成二兔越山冈”到“逼得日升狼遁荒”,竖读句首恰好构成“计算机学院真牛逼”;逐句提取特定数字与时间字,依次包含了“二、零、二、六、九、月、一、日”;句尾的冈、塘、粮、向、扬、狼、光、荒同押 ang 韵。这相当于句首、句中、句尾三条并行信道:句首放藏头,句中放日期,句尾管押韵。
在课堂演示中,模型并非一口气凭灵感写出这八句诗,而是在思维链中先构思韵脚、占据句首与句中的槽位,试写出一版后,利用下一个词元预测能力逐项检查字数、位置和韵脚;发现不合要求便局部修改,甚至推倒重换韵脚。从细节上看,藏头与嵌字都能对上,第四句句尾“风向”的“向”(韵母 iang)与其他句尾的 ang、uang 按现代汉语十三辙可归入江阳辙通押;若任务要求拼音韵母字面完全一致,则需另行验收。同时,部分诗句明显是为了凑齐约束而生硬拼凑的。这说明模型完成的是多约束可行解的搜索与修补,满足形式约束并不等于写出了高水平的诗歌。
多重形式约束实验(二):偏旁限制与规格口径辨析
纯文本大语言模型处理的是词元序列,并非直接感知汉字的二维几何图像,因此通常认为它对字形空间结构的感知较弱。如果要求它写出一句固定字数、且每一个汉字都包含相同字形构件、同时还要有完整故事情节的话,模型能否通过思维链完成?第二道极限约束实验检验了这一过程,并引出了机械验收时必须面对的规格定义问题。
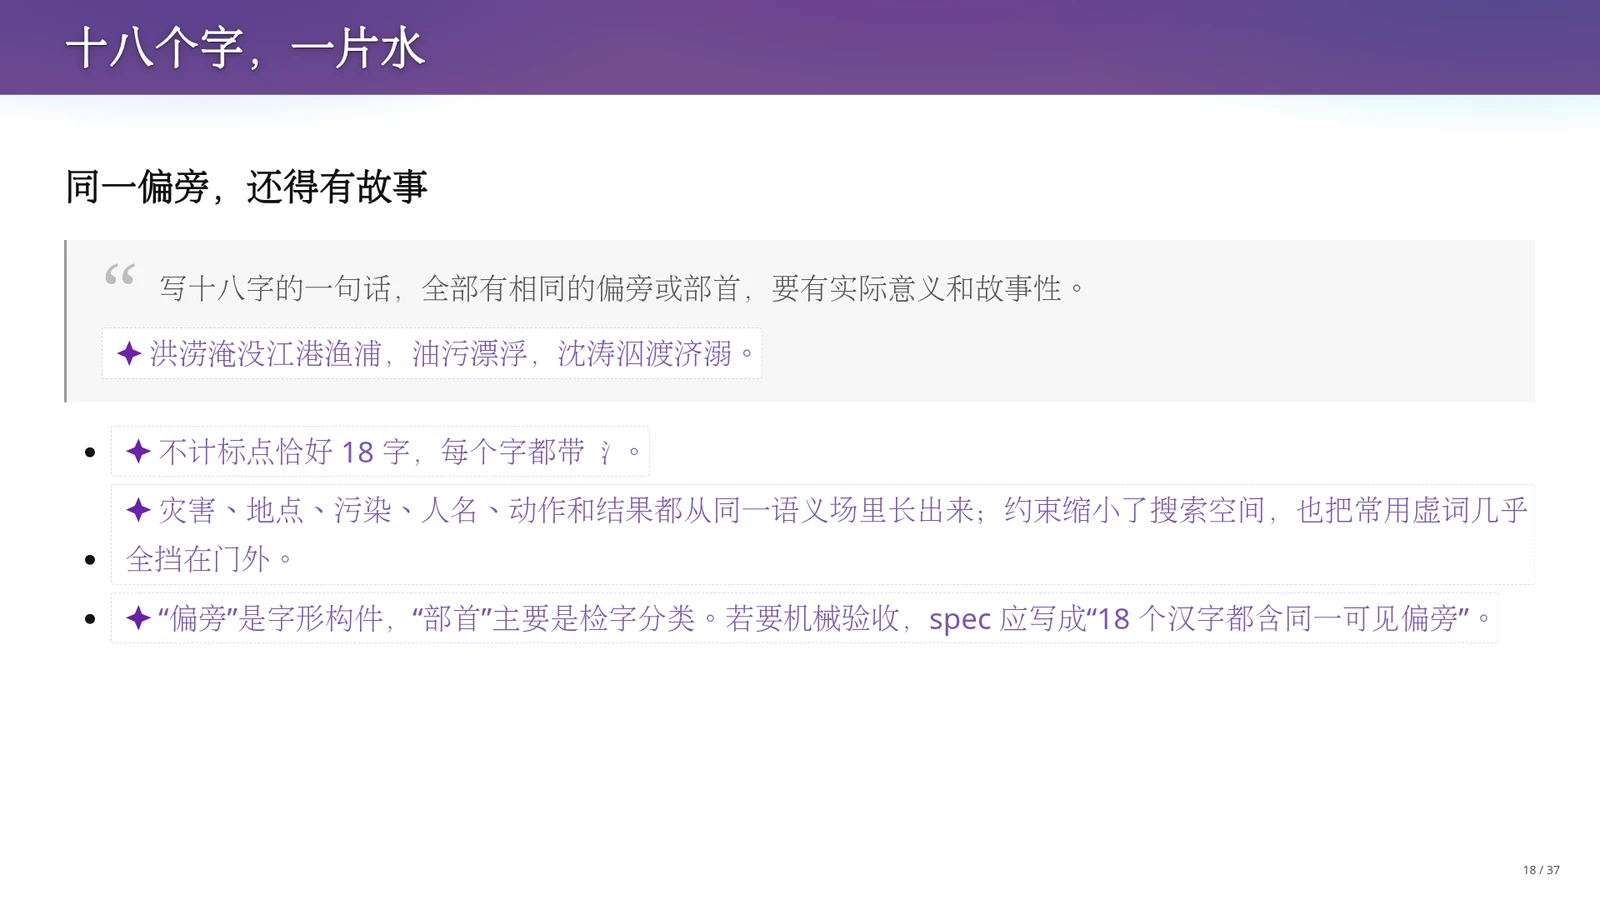
第二道题要求写一句十八个字的话,所有字必须具有相同的偏旁或部首,且具备实际意义与故事性。生成结果是:“洪涝淹没江港渔浦,油污漂浮,沈涛泅渡济溺。”去除标点符号后恰好是 18 个汉字,且每个字都包含三点水(氵)。因为偏旁限制几乎把“的、了、在”等常用虚词全部挡在门外,模型只能从水灾、地点、污染、人名(将“沈涛”作为人名)、游泳动作和救援结果这一特定语义场中挑选实词来拼接叙事。这里需要注意:“偏旁”是字形可见构件,而“部首”主要是字典检字分类。
课堂现场演示时,模型在思维链中先决定选用三点水,随后开始枚举带三点水的汉字并尝试组句(如曾尝试“江湖游泳渡河,波涛汹涌,泪流满溢,洗涤污泥”等片段),反复凑字数并调整语义。讲义借此强调了一个关键的软件工程概念:如果要编写程序自动验收这道题,就必须先消除自然语言规格中的歧义——“每个字都含三点水偏旁”与“在字典中都归入同一部首”并不完全等价。只有将规格明确收敛为“18 个汉字均含同一可见偏旁”,机器验收器才能给出确定的判定。
多重形式约束实验(三):全同音现代背景文言故事
汉语约束写作中著名的极限挑战有赵元任先生的《施氏食狮史》以及同音文《季姬击鸡记》,全文仅用一个音节讲完一个故事。如果在禁止照搬这两篇原文的前提下,要求模型用单一音节原创一段具有现代生活背景的文言故事,模型如何在极窄的字表空间内构建叙事?“同音”这一验收条件本身又隐藏着怎样的规格分叉?
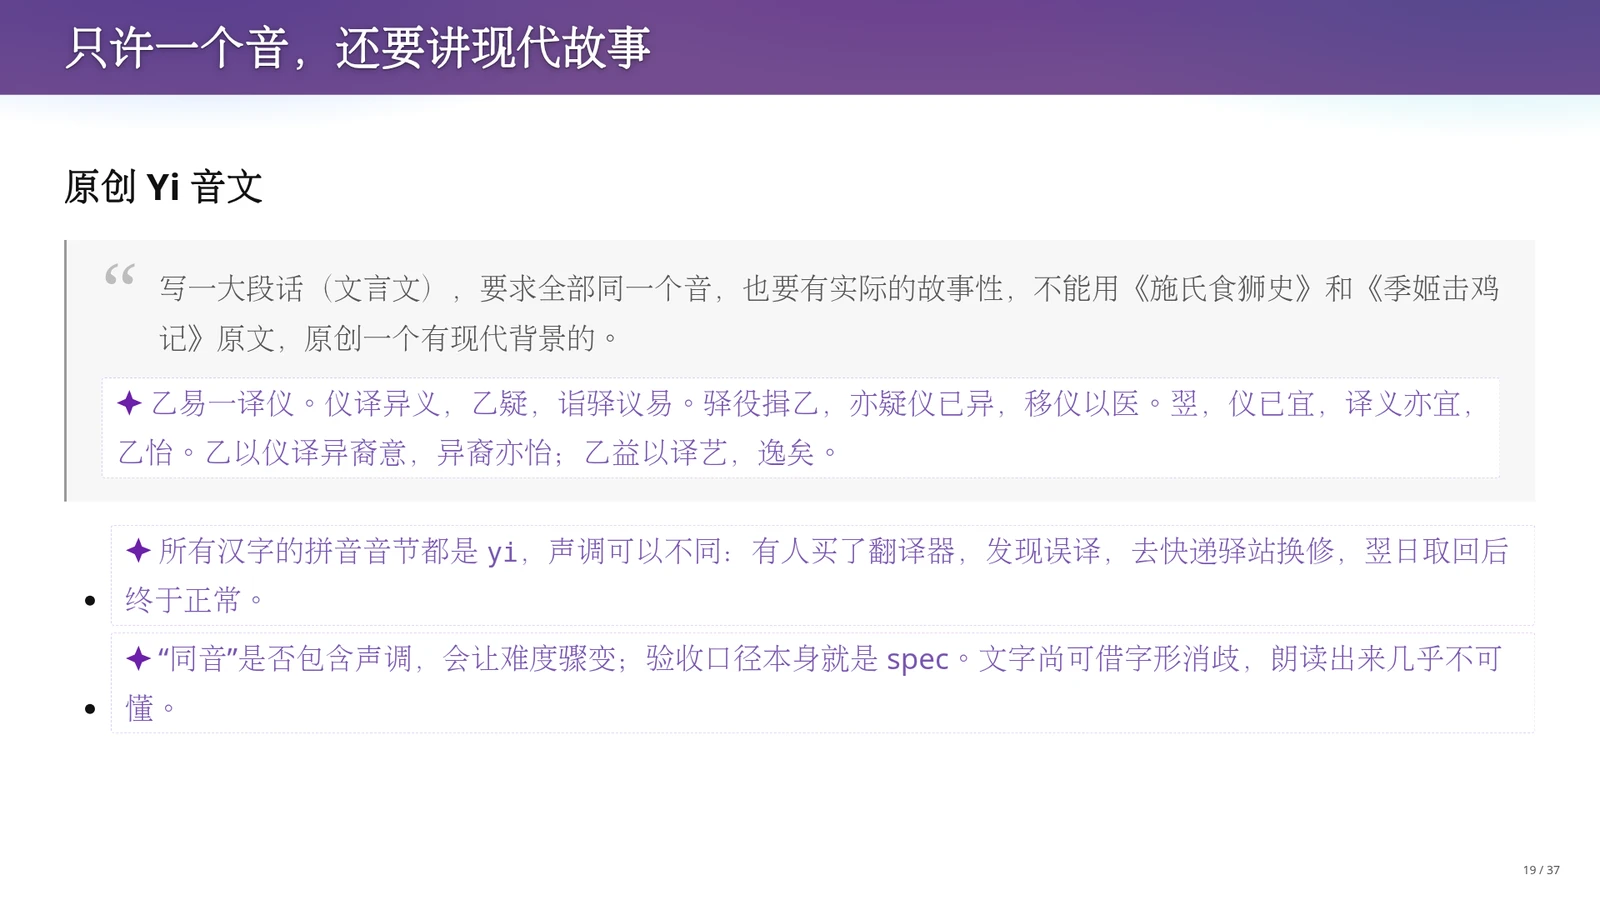
第三道题要求写一大段全部同音的文言文,需有实际故事性及现代背景,不得使用《施氏食狮史》和《季姬击鸡记》原文。生成文本为:“乙易一译仪。仪译异义,乙疑,诣驿议易。驿役揖乙,亦疑仪已异,移仪以医。翌,仪已宜,译义亦宜,乙怡。乙以仪译异裔意,异裔亦怡;乙益以译艺,逸矣。”全文所有汉字的拼音音节均为 yi(涵盖不同声调)。故事讲述了某乙购买了一台翻译仪,因翻译出错误意思而心生怀疑,前往快递驿站商议换修,驿站工作人员送去修理,次日修好后乙愉快地用它与外族交流。
这道题直接把规格定义的重要性暴露无遗:当我们要求“全部同一个音”时,验收口径究竟是“拼音字母组合相同(允许四个声调混用)”,还是“连声调也必须完全一致”?这两种口径会让合法候选字表的大小和搜索难度发生骤变,验收口径的选择本身就是规格设计的一部分。此外,这段文字阅读时还能借助汉字字形区分“译仪(翻译器)”、“驿役(驿站人员)”来猜出情节,但若真正朗读出来,听众几乎无法分辨语义。这再次把形式达标与实际沟通效果区分开来。
通过测试不等于写得好:Verifier 看得见的与看不见的
回顾前面三道故意刁难人的中文写作题,模型主要是在数学推理和代码生成等任务上接受强化学习后训练的,为什么却能在几乎没专门练过的奇葩文字游戏上超越普通人的极限?但与此同时,为什么我们读完这些作品仍觉得有些生硬别扭?通过区分验收器(Verifier)的覆盖边界,可以看出机械形式检查与深层品味之间的差异。
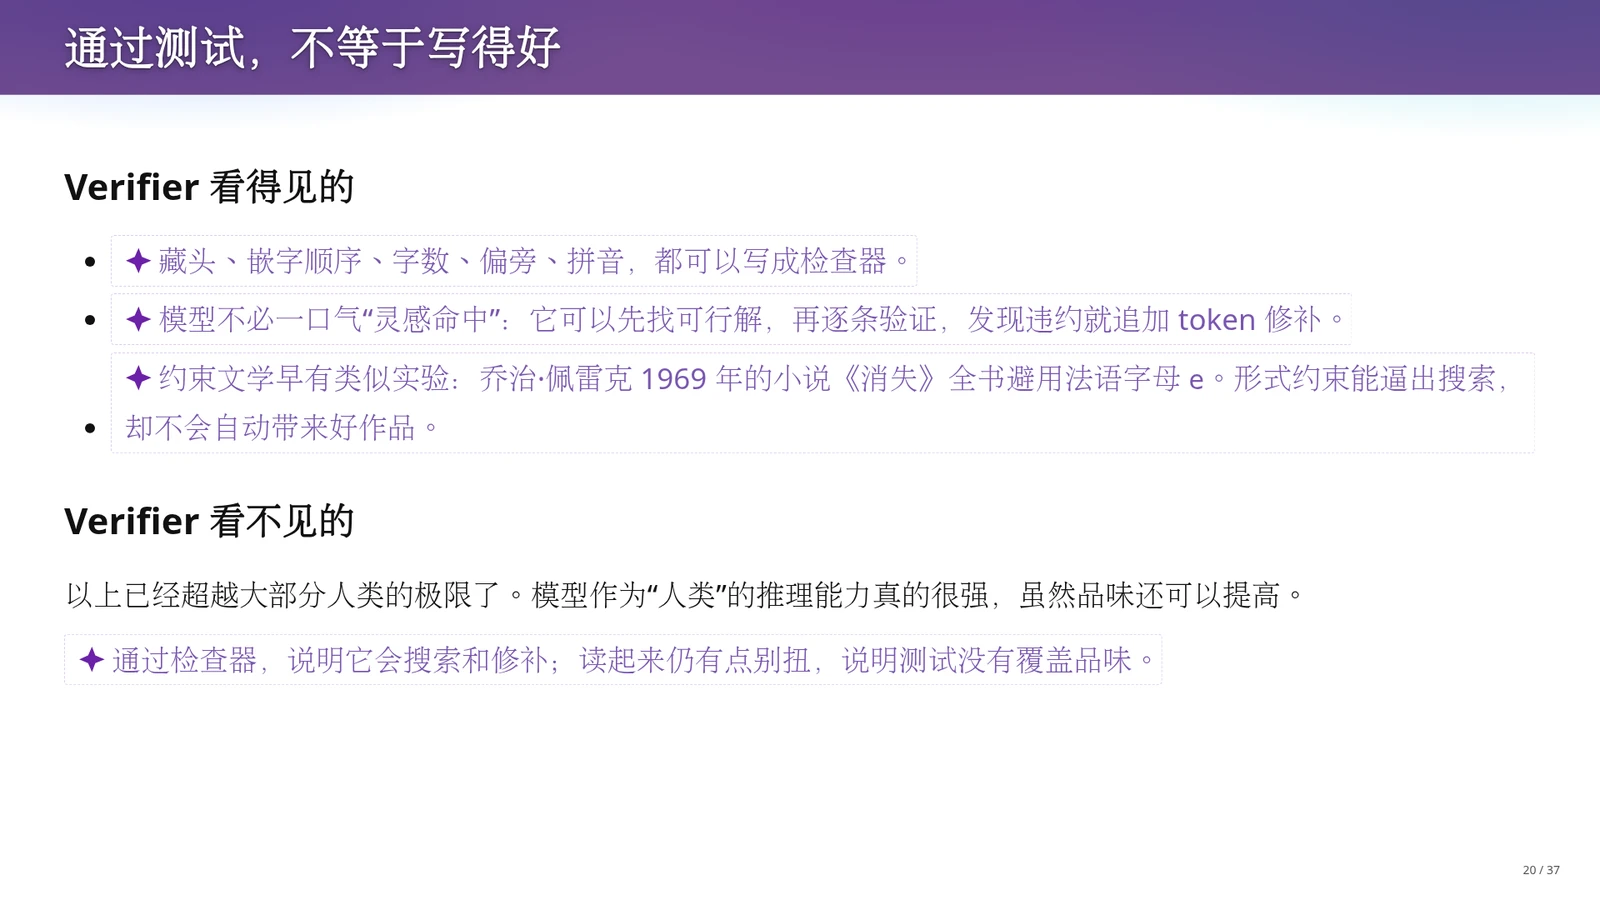
评价标准可以分为两类。第一类是“Verifier 看得见的”:藏头字、嵌字顺序、字数统计、偏旁构件、拼音音节,这些全都可以编写成确定性的机械检查器。模型无需凭一次性灵感命中答案,而是可以先生成可行解,再逐条对照验证,发现违约就追加词元进行修补。法国作家乔治·佩雷克 1969 年出版的小说《消失》(La Disparition,全书约三百页完全不使用法语中最常见的字母 e)表明约束文学早有先例,但满足形式约束只会逼出搜索能力,不会自动带来文学佳作。第二类是“Verifier 看不见的”:模型的推理与搜索能力很强,但作品读起来仍显别扭,因为机械测试没有覆盖文学品味。
软件测试与提示词工程存在相似的边界:当任务具备明确且可快速执行的验收器时,机器往往能通过多轮搜索与修补取得很好的效果,但即便有验收器也不保证机器能解出所有高复杂度问题;而在缺乏客观验收器的维度上,机器更容易偏离预期。教师在课堂上分享了自己制作课程数字人切片的失败经历:虽然有文本转语音工具,却始终做不好第二个切片。因为真实的课堂讲授包含情绪的波动起伏、看学生觉得枯燥时突然抛出一个现场演示的惊喜(意料之外、情理之中)、以及基于人类共同求学经历的共情与节奏把控。这些教学感染力与文学品味一样,无法被形式化为一段简单的判定脚本,因此不能指望模型仅靠通过形式检查就自动涌现出高品味。
自注意力机制与指令纠偏:过去的上下文一直在场
理解了思维链的“生成—验证—修补”循环后,我们还需要从底层架构视角弄清楚:当上下文长达数十万甚至上百万词元时,模型是如何记住我们在开头写下的规矩,并在跑偏时把轨迹拉回来的?从 Transformer 架构的自注意力机制(self-attention,计算当前词元与上下文中历史词元相关性权重的机制)出发,可以解释全局指令的持续作用与局限。
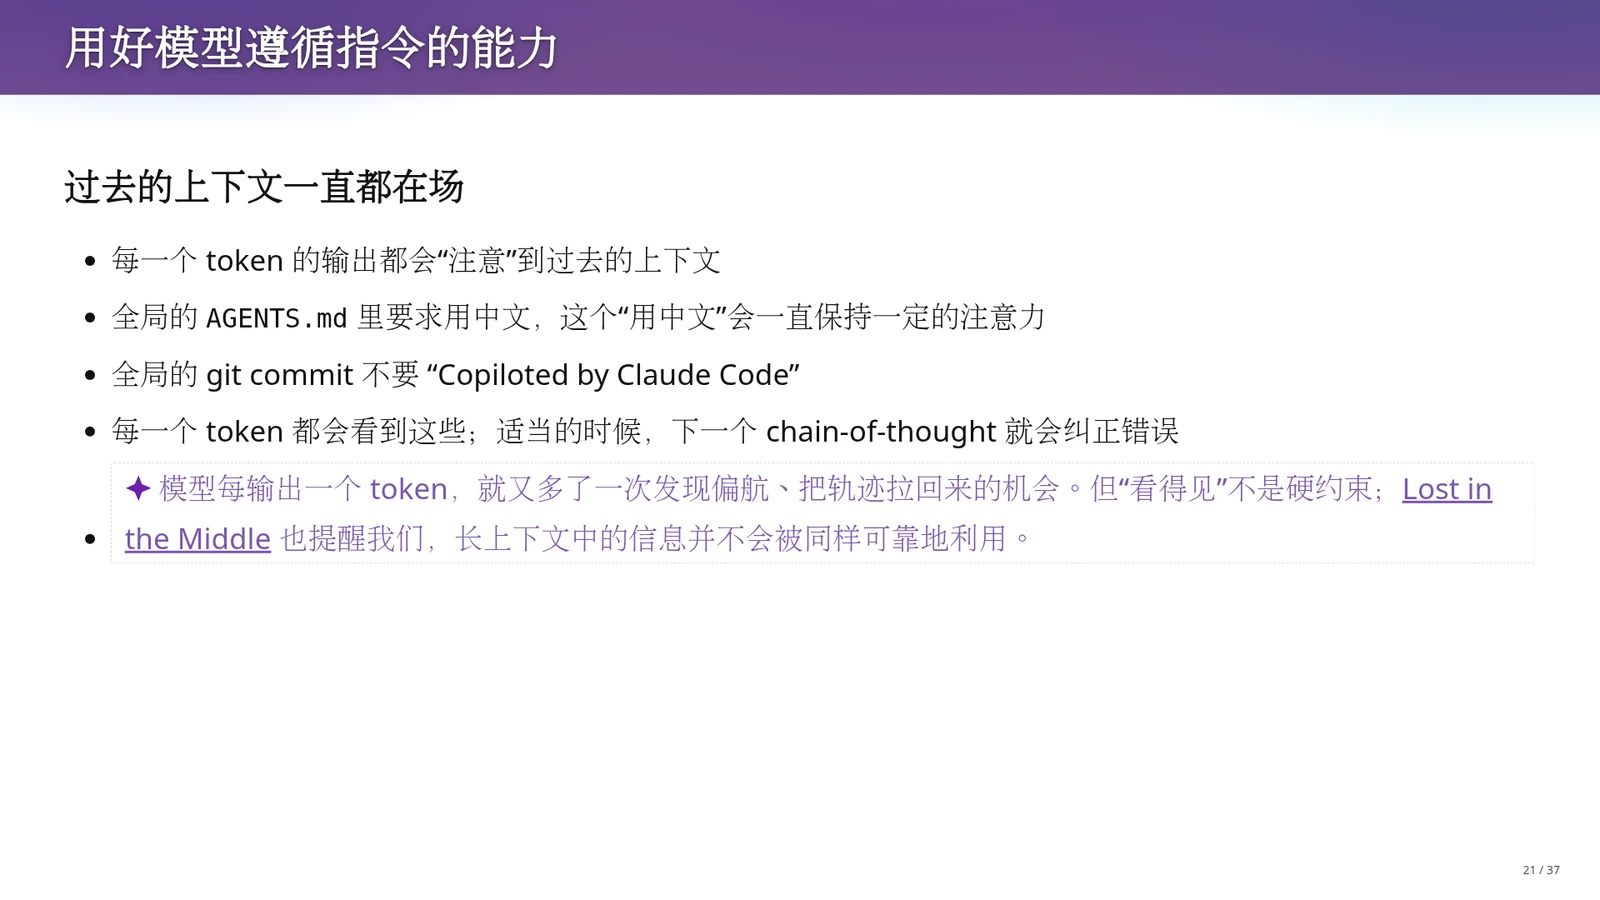
模型每输出一个词元,都会通过注意力机制“注意”到过去的上下文。例如,全局配置文件 AGENTS.md 中要求“用中文回答”,或者规定全局 git commit 提交信息中不要添加“Copiloted by Claude Code”署名。在生成过程中,每一个新词元都会看到这些历史上下文;当进入适当阶段时,下一段思维链就会触发纠偏,把偏航的生成轨迹拉回来。但课件同时强调,“看得见”并不等于百分之百生效的硬约束,并引用了《Lost in the Middle》研究,指出当关键信息位于长上下文中部时,模型对其利用的可靠性会显著下降。
课堂用一个贴近人类认知的比喻解释了注意力的动态转移:就像我们低头化简一道复杂的数学算式时,全部注意力都集中在局部的符号变形上;等算式化简完毕、抬头“喘一口气”准备写总结时,注意力就会重新切换到全局要求上。模型在编写《极品飞车》代码时,注意力高度集中于当前代码语法与逻辑,对“用中文总结”的关注度暂时降低;待代码写完进入收尾阶段,自注意力重新捕获到开头的中文要求,从而用中文输出总结。然而,随着上下文不断增长,历史指令被有效注意到的概率会衰减,工程上通常只有留在末尾的提示词或刚加载的指令最容易被稳定执行。
上下文是争用资源:否定指令的副作用与分层权衡
既然把规则写进上下文能让模型通过注意力机制看到并遵循,那么每当发现模型犯了一个小毛病,我们就往全局配置文件里追加一条“禁止做某事”的规则,岂不是能让系统越来越完美?一个真实的前端开发案例揭示了提示词抢夺注意力的副作用,以及常驻规则与按需加载之间的工程取舍。
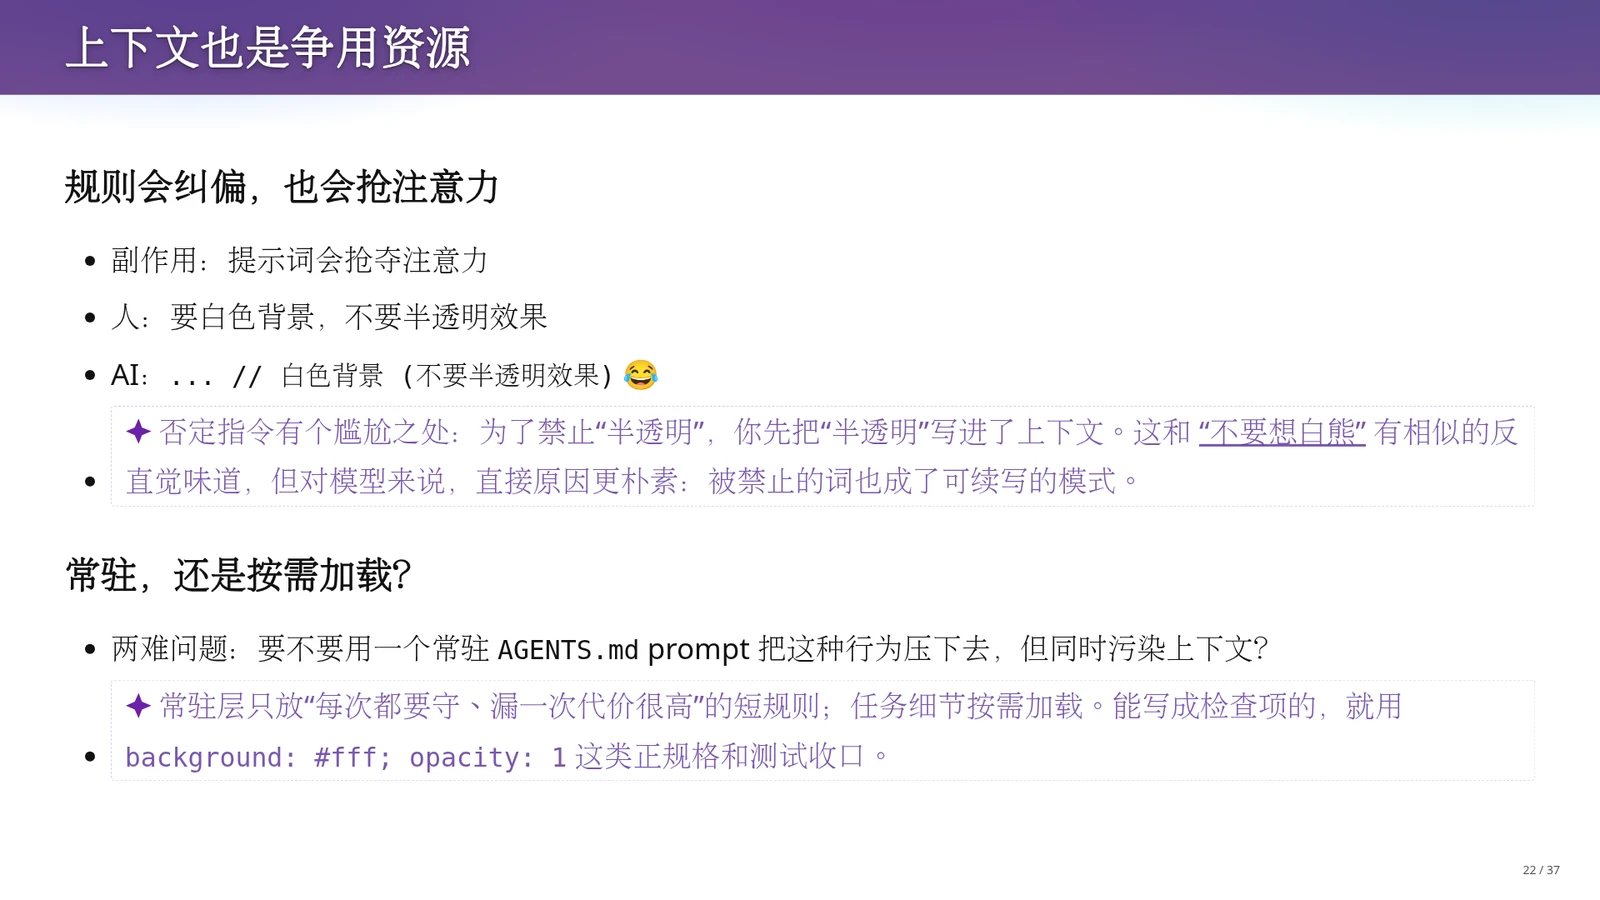
当用户在提示词中要求“要白色背景,不要半透明效果”时,AI 虽然正确实现了样式,却在生成的代码里写下一行注释:... // 白色背景 (不要半透明效果)。否定指令存在一个机制弱点:为了禁止“半透明”,你先把“半透明”这个词写进了上下文,这与心理学中“不要想白熊”实验有相似的反直觉效果——被禁止的词本身成了上下文里可续写的文本模式。这引出了一个两难问题:是否要在常驻的 AGENTS.md 里加一条规则禁止把用户提示词写进注释?工程上的处理原则是:常驻层只放“每次都要守、漏一次代价很高”的短规则,任务细节按需加载,可检验要求则用 background: #fff; opacity: 1 这类正规格和测试收口。
课堂分析道,经过高强度强化学习训练的模型就像刻板的“做题家”,对提示词里的字眼有强烈的核对执念,却缺乏真正的人类共情,分不清哪些话是沟通解释、哪些话该写进产物。如果为了杜绝这类傻注释而往 AGENTS.md 里不断塞入关于注释写法的长篇禁令,这些规则本身就会污染上下文、争抢有限的注意力资源,导致其他核心指令遵循率下降。因此,上下文工程必须做减法:常驻层只保留每次必守、漏一次代价极高的简短约定;特定方法通过技能包按需加载;而像“白色背景、无半透明”这类需求,应直接转化为 background: #fff; opacity: 1 的正向规格与自动化测试来收口。
验收器(Verifier)的能力边界
当任务具备明确的机械验收器(如字数、偏旁、拼音、代码编译与单元测试)时,模型可借助思维链在上下文草稿纸上反复试探、验证与修补,在多约束形式求解上表现出很强的搜索能力。然而,通过机械检查并不代表产物具备文学质量、良好可读性或教学感染力。验收器未覆盖的品味与共情不会随算力增加而自动出现。
课堂直觉:有限状态机加上纸和笔
单次前向计算激活的参数和深度是固定的,如同有限状态机;而思维链将只追加(append-only)的上下文当作“纸和笔”(图灵机纸带),把中间推理状态写回上下文供后续步骤读取。需要明确的是,课堂借“找解比验解难”来解释为何“生成候选并验证修正”有效,这只是启发式类比,并非对 P 与 NP 复杂性理论的数学证明。
警惕否定指令与全局规则膨胀陷阱
在提示词中使用“不要半透明”等否定表述,反而会将被禁词汇引入上下文,诱发模型在注释或产物中续写该模式。切忌每遇一次小瑕疵就往全局 AGENTS.md 中追加永久禁令;规则不是免费增强,过度堆砌会造成上下文污染与长上下文中部信息遗忘(Lost in the Middle),应优先改用正向规格(如 opacity: 1)与外部测试工具。
术语消化:思维链、验收器与上下文注意力机制核心术语表
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 思维链(Chain-of-Thought) | 单次前向计算深度有限,无法一步解出复杂多约束问题 | 将中间尝试、分解与纠错输出为词元并追加回上下文,充当工作纸带以换取串行计算深度 |
| 测试时扩展(Test-Time Scaling) | 模型直接盲猜答案极易在处理复杂逻辑时产生幻觉 | 在推理阶段消耗更多生成词元进行试探、验证与修补,将算力转化为遵循复杂约束的能力 |
| 验收器(Verifier) | 模型缺乏客观依据来判断中间探索是否正确及何时可以停机 | 对藏头、偏旁或程序行为进行判定;划定了模型擅长搜索的可见区与缺乏品味的盲区 |
| 自注意力与中部迷失(Self-Attention & Lost in the Middle) | 长程生成中如何动态兼顾全局规则与当前局部任务 | 每步生成按权重关注历史词元并在阶段切换时纠偏,但长上下文中部规则被可靠利用的概率会下降 |
def verify_acrostic_poem(lines, head_target, embed_target):
    if len(lines) != 8:
        return False, "句数不为8"
    for i, line in enumerate(lines):
        if not line.startswith(head_target[i]):
            return False, f"第{i+1}句未以'{head_target[i]}'开头"
        if embed_target[i] not in line:
            return False, f"第{i+1}句未包含'{embed_target[i]}'"
    return True, "藏头与嵌字检查通过(注:诗意与押韵自然度需额外评估)"

def verify_water_radical(text, water_chars_set):
    chars = [c for c in text if '\u4e00' <= c <= '\u9fff']
    if len(chars) != 18:
        return False, f"汉字数量为{len(chars)},不等于18"
    non_water = [c for c in chars if c not in water_chars_set]
    return len(non_water) == 0, f"违规汉字: {non_water}"

poem = [
    "计成二兔越山冈", "算到零时雪满塘", "机警狐衔二袋粮", "学随六雁辨风向",
    "院中九犬忽声扬", "真到月明逢恶狼", "牛守一夜迎晨光", "逼得日升狼遁荒"
]
print(verify_acrostic_poem(poem, "计算机学院真牛逼", "二零二六九月一日"))
该脚本演示了课件第 17、18、20 页中“Verifier 看得见的”形式化检查机制。输入为模型生成的诗句列表或单句文本,函数逐项核对句数、句首藏头字、句内按序嵌字以及去标点后的 18 个三点水汉字集合。这类确定性检查能为思维链提供清晰的通过/失败信号,但如返回信息所示,它无法检验诗歌是否生硬凑韵或故事是否真正动人。
本章小结
本章剖析了语言模型遵循复杂指令的计算机制与工程边界。
- 尽管单步前向计算深度有限,模型却能以只追加的上下文为草稿纸,通过思维链开展试探、验证与修补,实现测试时扩展。
- 三道极限中文写作实验表明,模型在有明确验收器的形式约束上表现惊人,但形式达标不等于具备文学品味或教学共情。
- 同时,上下文中的规则会争夺有限的自注意力并诱发否定词续写等副作用,因此应保持常驻规则简短,将具体要求转化为正向规格与自动化验证。
第五章 超越角色扮演:如何抵抗材料锚定并将人类方法论蒸馏为 Skill?
上一章我们看到,上下文中的规则既能利用注意力机制在思维链中完成自纠偏,也会争夺有限的注意力资源。当任务从形式约束明确的造句转向评判一篇高信息密度的学术论文或复杂技术文档时,单纯依靠一句角色扮演提示词往往只能得到表面合规的空洞评价。为什么写下“你是一位顶会审稿人”无法赋予模型真正的领域洞察力?面对作者精心编排、环环相扣的论述,如何防止模型的自注意力被原文逻辑锚定?本章将剖析高密度文本对上下文的注意力拉扯,探讨如何通过多路独立审计与知识边界对齐打破作者预设的框架,并最终将人类经过验证的领域方法论沉淀为分层可复用的 Skill。
角色扮演的幻觉:穿上审稿人制服不等于拥有审稿方法
在早期提示词工程指南中,最常见的技巧是要求模型“扮演某领域的资深专家”。为了检验这种做法在真实软件工程科研场景下的成色,课堂设计了一个直接的审稿实验:将教师团队自己近期完成的一篇期刊扩展论文进行匿名化处理,放入隔离的临时目录以排除全局配置文件的干扰,随后要求 Agent 扮演软件工程顶会审稿人给出录用决定。我们需要观察角色扮演提示词改变了生成分布中的哪些表层特征,又遗漏了哪些核心判断机制。
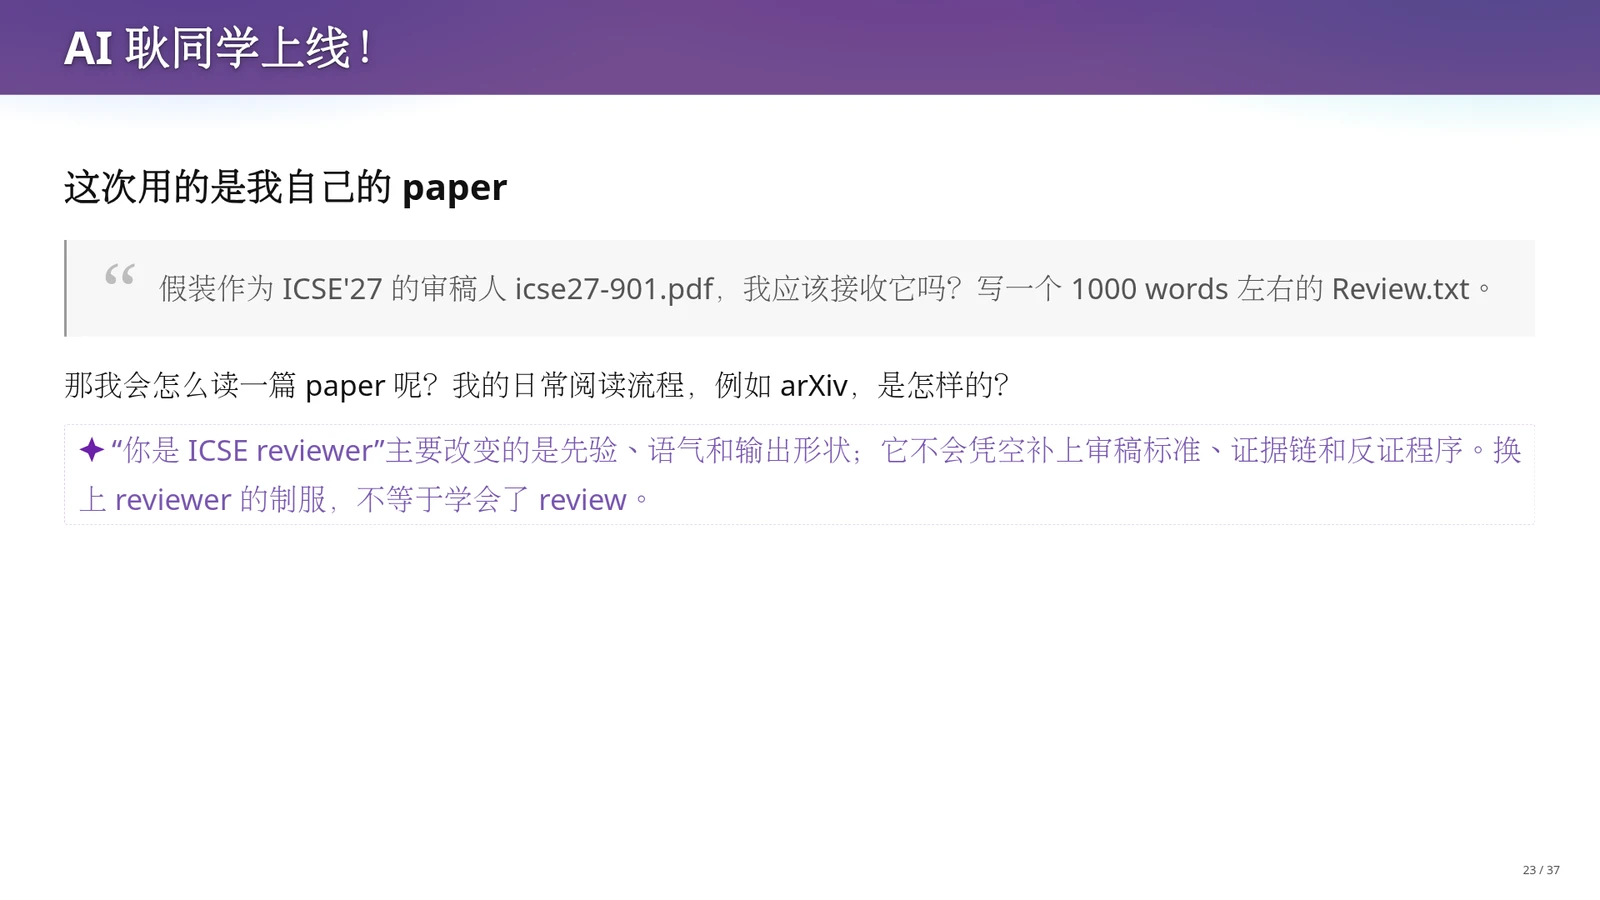
实验中向 Agent 下达的具体指令是:假装作为 ICSE'27 的审稿人阅读指定的匿名论文文件 icse27-901.pdf,判断是否应当接收,并撰写一份约一千英文词的评审意见 Review.txt。对照人类研究者日常阅读预印本论文的真实流程,可以看出角色提示词的机理边界:一句“你是 ICSE reviewer”主要改变的是模型输出的先验分布、行文语气以及约千字篇幅的章节外观形状(如依次罗列论文总结、优点、缺点与建议)。但是,这种身份设定不会凭空在上下文中补齐审稿标准、证据链核查与反证程序。换上审稿人的制服,不等于掌握了审稿的方法论。
课堂现场演示印证了这一判断。当直接要求模型总结或评审该论文时,由于缺乏独立的评判抓手,模型很容易退化为顺着作者行文复述观点的“车轱辘话”;而当用户追问其研究贡献、要求它不要完全轻信作者时,模型又展现出“墙头草”特性,随用户的质疑态度摇摆,甚至跑偏去调用浏览器开发者工具或机械检查文中堆栈跟踪(stack trace)示例的真实性,或者在“实验还可以再补充一些”这类放之四海皆准却无关痛痒的次要细节上盲目发力。要让模型做出真正有深度的评审,必须把人类审稿的具体操作流程拆解并显式注入上下文。
打破单一锚点:构造三条相互独立的审稿路线
既然一句笼统的身份提示无法生成有价值的批判性审查,我们该如何通过上下文工程为模型提供可执行的评审抓手?如果只让模型通读全文后给出一份总体印象,无论把输出结果润色多少遍,本质上都只是在同一条顺从作者思路的轨迹上打转。为了打破单一视角造成的盲区,可以将审稿任务显式拆解为三条问题导向不同的工作流,分别切入不同的审查维度与验证目标。
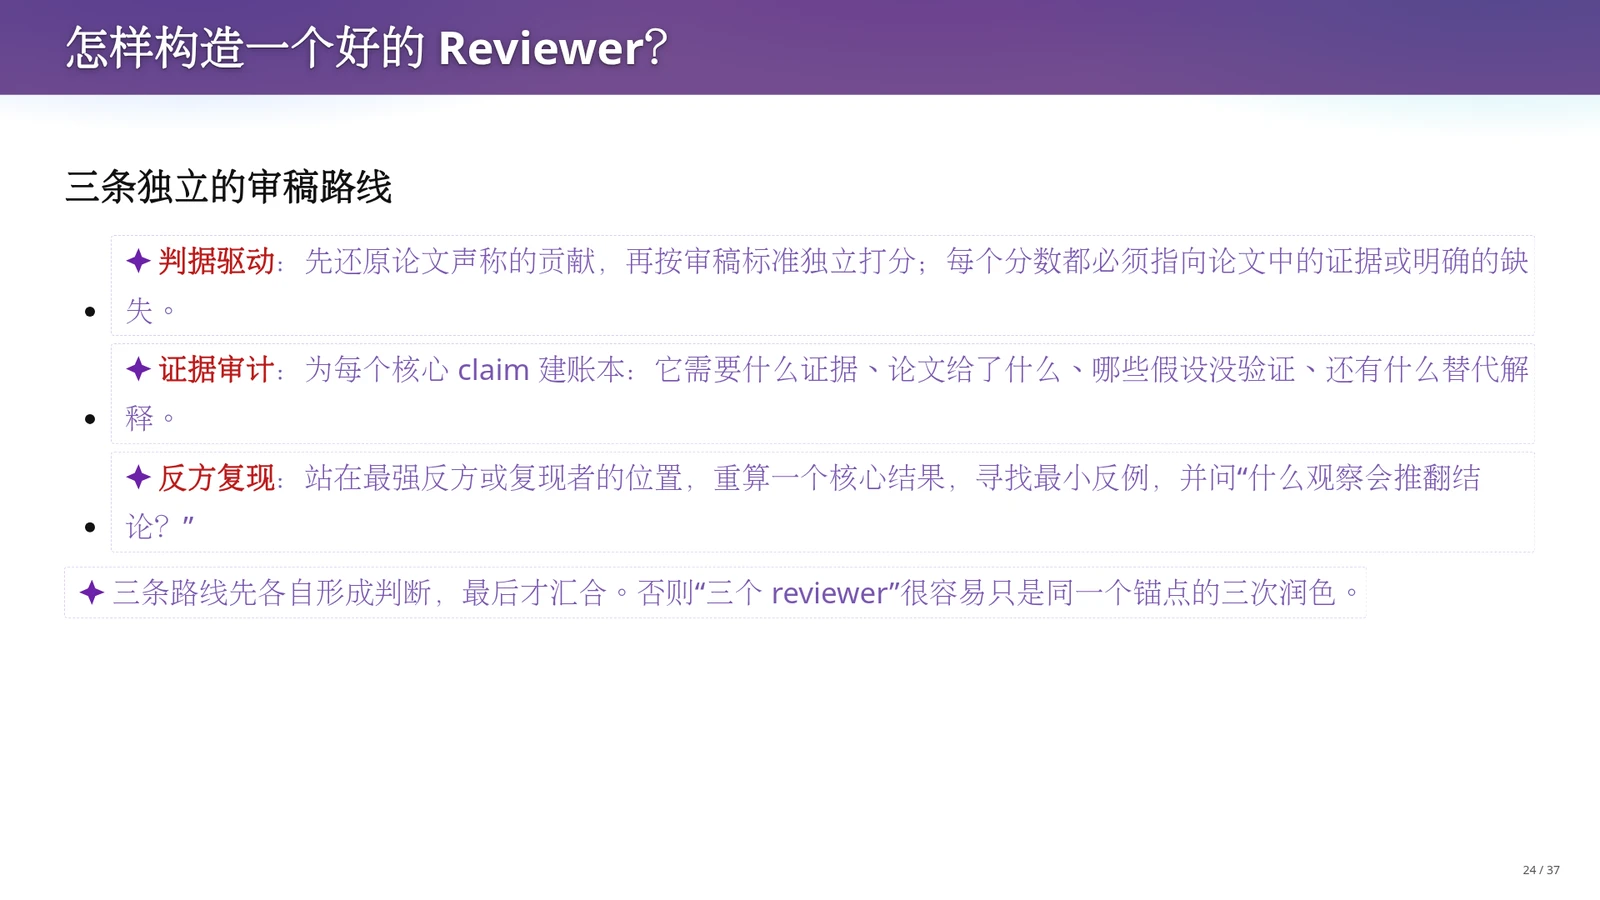
构造高质量审稿 Agent 可以采用三条独立路线。第一条是判据驱动(Criteria-driven):要求先客观还原论文声称的贡献,再严格按照审稿标准逐项独立打分,且规定每一个打分都必须明确指向论文中的具体证据或指明关键证据的缺失。第二条是证据审计(Evidence audit):为论文中的每一个核心主张(claim)建立结构化账本,逐一核对该主张在逻辑上需要什么证据、论文实际给出了什么实验或推导支持、有哪些隐含假设尚未验证,以及是否存在其他替代解释。第三条是反方复现(Adversarial reproduction):要求站在最强反方或独立复现者的立场上,尝试重算一个核心结果,寻找能够击穿结论的最小反例,并明确回答“观察到什么具体现象就会推翻全文结论”。课件最后强调了执行时序上的硬约束:三条路线必须先各自独立形成判断,最后才进行汇总比较;否则所谓的“三个审稿人”很容易退化为对同一个初始锚点的三次文字润色。
这三条路线之所以有效,是因为它们把“这篇论文好不好”的模糊意图,转化成了三个角度截然不同、且各自带有明确检查点的子问题。判据驱动盯住贡献与标准的映射,证据审计盯住主张与支撑材料之间的裂缝,反方复现则主动构造可证伪检验。当不同路线在各自隔离的上下文中先跑出初步结论,再将分歧摆到台面上对撞时,那些被作者流畅文笔掩盖的未验证假设和替代解释就会自然暴露出来。
抵抗高密度材料的注意力污染:锚定效应与知识边界对齐
为什么哪怕是具备强大思维链能力的模型,在直接阅读论文或教科书章节时也会丧失批判性,甚至连人类读者自己的第一性原理思考也容易在顺读过程中瓦解?这需要回到上一章讨论的自注意力机制来分析。当输入材料本身经过人类作者反复打磨、逻辑高度自洽时,它会在上下文中形成极强的注意力拉力。下面分析高密度文本引发“锚定效应”的机制,以及在深读前建立独立基准的具体方法。
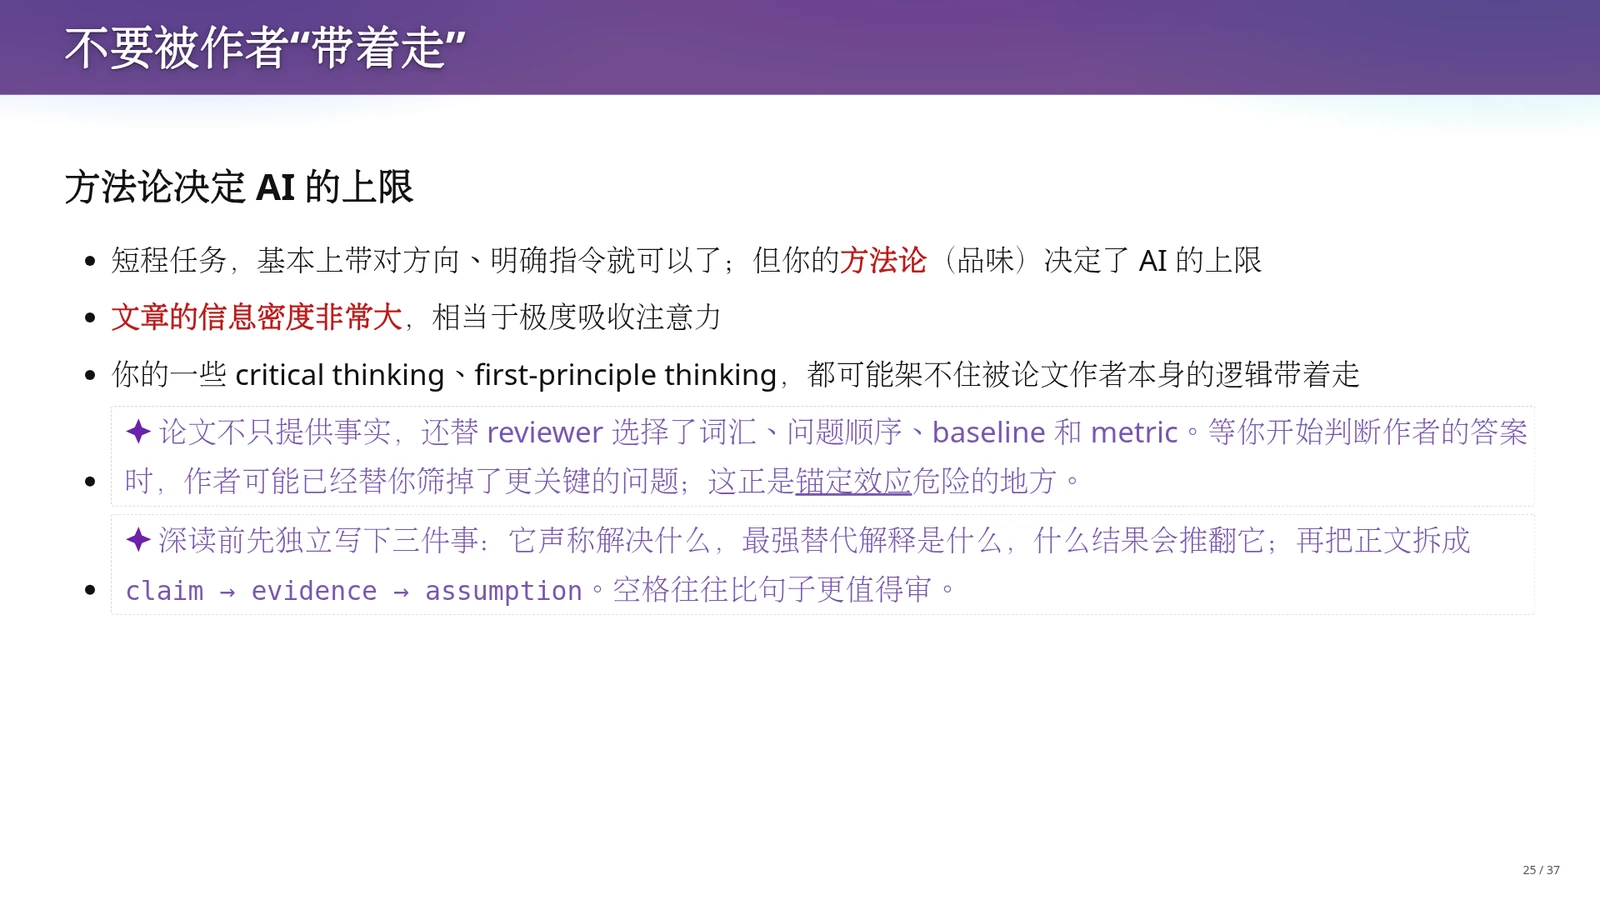
在短程任务中只需带对方向并给出明确指令即可,但面对复杂评判任务时,人类的方法论(品味)决定了 AI 产出的上限。学术论文的信息密度极大,在上下文中相当于极度吸收注意力的黑洞:文中“因为 A 所以 B,因为 B 所以 C”环环相扣,使得读者的批判性思考(critical thinking)和第一性原理思考(first-principle thinking)很容易被作者自身的逻辑带着走。更隐蔽的是,论文不仅提供事实,还在开篇就替审稿人选好了专业词汇、问题展开顺序、对比基线(baseline)和衡量指标(metric)。等你读完全文开始评判作者的答案时,作者其实已经替你筛掉了更关键的前提问题——这正是认知心理学中锚定效应(Anchoring Effect,首次出现定义:指个体或模型在决策时过度依赖最先接收到的信息框架或初始数值,导致后续判断始终围绕该初始锚点做局部调整而难以跳出预设边界的现象)最危险的地方。为此,课件给出了抗锚定的实操规程:深读前先独立写下三件事——它声称解决什么、最强替代解释是什么、什么结果会推翻它;随后将正文拆解为“主张(claim)\(\rightarrow\) 证据(evidence)\(\rightarrow\) 假设(assumption)”链条,重点审查链条之间的空白处。
为了抵抗这种上下文污染,教师在课堂上分享了个人审稿与学习的“知识边界对齐(Grounding)”方法。审稿时,不急于顺着作者的实验细节走,而是先让模型站在人类已知知识的边界上提问:该领域的已有工作解决到了什么程度?本文试图解决哪些真正的增量痛点?教师举了前一天刚拒掉的一篇论文为例:作者研究重要问题 A,将其拆分为 A1 和 A2,并在研究较少的 A2 上借鉴 A1 的做法做出了改进版 A2',局部实验完全闭合;但按老师估算,总体性能开销中 A1 约占 99%,A2 仅占约 1%,在 1% 的分支上优化 10% 对全局而言微乎其微,并未真正扩展人类知识边界。同理,学生在学习《计算机系统基础》的“链接与加载”等高密度章节时,也可以在 AGENTS.md 中记录自己当前的知识进度,从已知概念出发向 AI 提问(如“既然已经有程序能把 .cpp 变成 .exe,为什么还需要链接?”);课堂上老师还以阅读《百年科学经典》为例,说明无论是了解现存生物最近共同祖先(LUCA)的演化树,还是利用线粒体母系单遗传突变向上追溯人类母系祖先,本质上都是从已知事实出发向外做可验证的单步推理,从而稳步扩展个人认知圈。
把方法论蒸馏为 Skill:从偶然成功到分层可复用架构
当我们通过多次失败与调优,终于在论文审稿、源码阅读或知识扩展中摸索出一套行之有效的抗锚定引导流程后,如何避免下次遇到同类任务时又从零开始拼凑提示词?生成式软件工程提倡将经过检验的人类品味与工作流沉淀为 Skill。然而,如果把所有经验教训和格式要求一股脑塞进单个文件,Skill 本身又会异化为极耗注意力的负担。这就需要明确优秀 Skill 的核心保存要素及其分层工程架构。
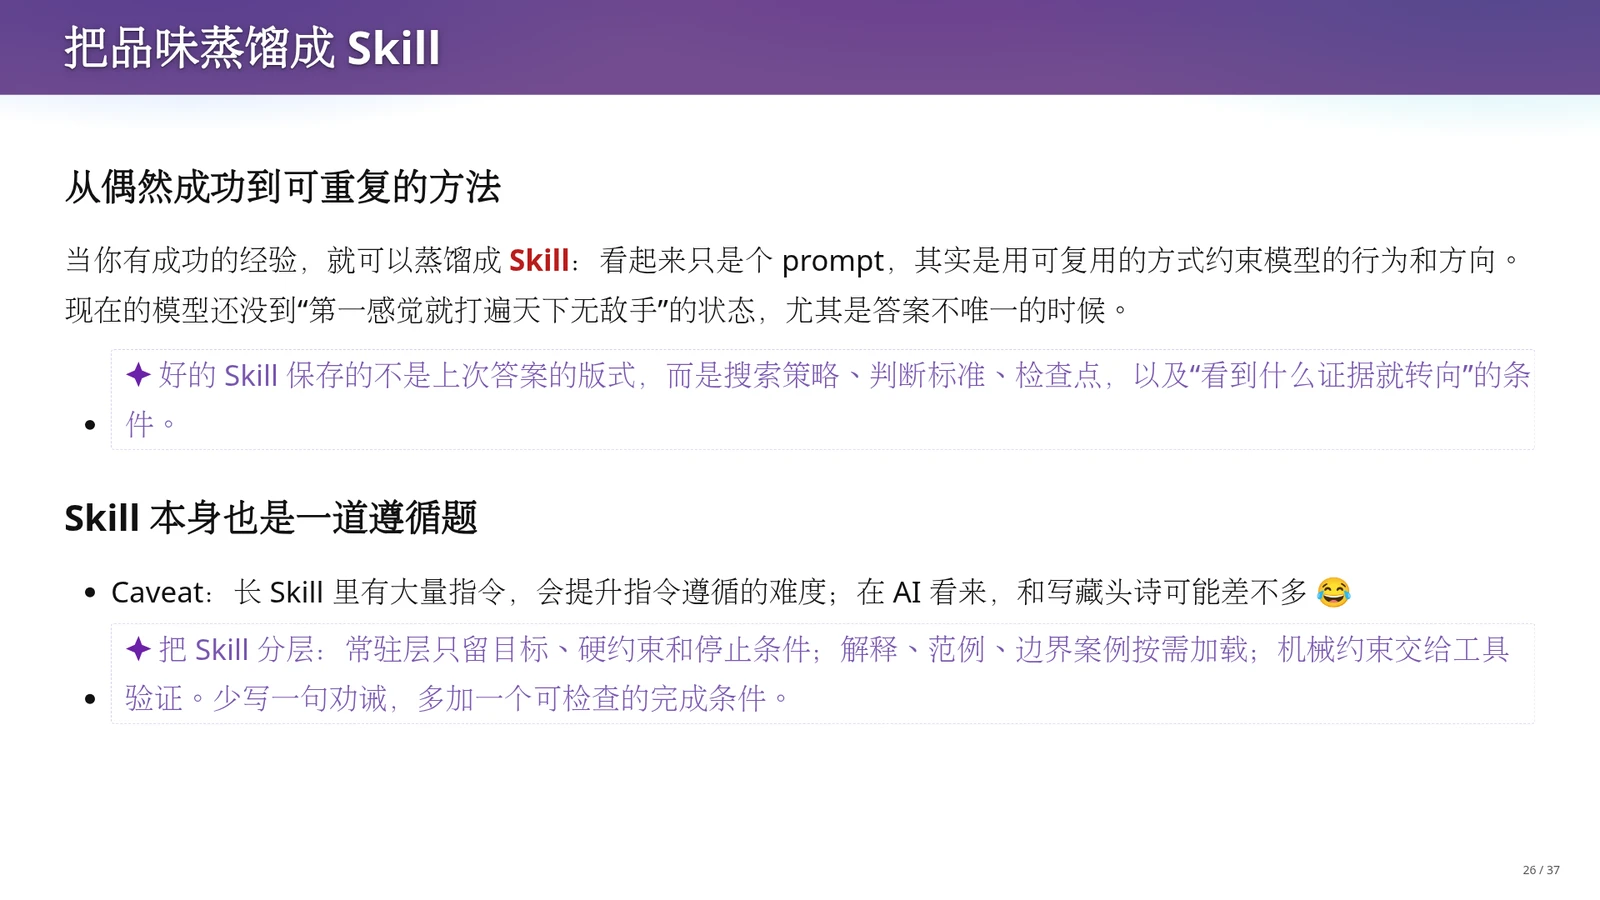
当积累了成功经验后,就可以将其蒸馏成 Skill(技能包,将特定领域的搜索策略、判断标准与工作流封装为可按需加载的模块化上下文指令集,用于跨会话复用做事方法)。当前的模型在答案不唯一、开放度高的任务上,远未达到仅凭第一感觉就能完美解决的状态;Skill 外表看似一段提示词,实质是用可复用的方式约束模型的探索方向与行为。课件强调,好的 Skill 保存的绝不是上一次成功答案的表面排版格式,而是背后的搜索策略、判断标准、中间检查点,以及“看到什么证据就立即转向”的决策条件。页面下半部分给出了关键警示(Caveat):Skill 本身也是一道指令遵循题。过长的 Skill 内部堆积了大量细碎指令,会显著拉高遵循难度,在模型看来这与前面编写多重形式约束的藏头诗并无二致。因此必须对 Skill 进行分层设计:常驻层只保留核心目标、硬约束与停止条件;详细解释、范例和边界案例采用按需加载;机械性约束则彻底移交给外部脚本工具验证。
课堂早期解剖 Agent 上下文时展示的 make-slides 技能,正是这种分层架构的工程实例:在会话初始阶段,上下文中只常驻所有可用 Skill 的轻量级元数据索引(仅含名称与简略描述);只有当当前任务确定匹配某项技能时,外围系统才会按需读取完整的 SKILL.md 文件,在该演示环境中还可以在子任务结束后将其移出活跃工作集。这种设计直接呼应了课件的收尾格言——“少写一句劝诫,多加一个可检查的完成条件”。同样,面对网上五花八门的现成长篇 Skill,切忌盲目照搬后陷入反复打补丁的提示词泥潭,而应立足于思维链与注意力分配机制,提炼真正属于自己任务场景的精简判据。
讲义提醒:高密度材料的锚定效应与抗污染规程
学术论文与经典教材经过作者精心编排,逻辑高度自洽,不仅给出结论,还预设了术语体系、问题顺序、对比基线和评价指标。直接将其塞入上下文要求总结或评审,模型的自注意力会被原文的因果链条强烈吸引,导致顺着作者场地打转。必须在深读前强制执行抗锚定规程:先对齐人类已知知识边界,独立写出核心问题、最强替代解释与可证伪条件,再将正文拆解为“主张\(\rightarrow\)证据\(\rightarrow\)未验证假设”进行脱敏审计。
课堂提示:知识边界对齐(Grounding)与单步可验证推理
无论是评审前沿论文还是学习陌生的系统课程,最有效的上下文组织方式都是先做“知识边界对齐”。研究者以人类现有文献边界为基准追问论文的真实增量(如老师在审稿案例中估算某分支仅占约 1% 开销,指出在其上做 10% 局部优化缺乏全局意义);学生则在 AGENTS.md 中维护自身知识库,让 AI 从已掌握的概念(如 .cpp 编译为 .exe 的已知流程)出发,每次只向外推导一步。单步推理最容易检验真伪,能有效防止模型自说自话。
易错点警示:把角色扮演当方法论,或把 Skill 写成藏头诗
切忌陷入两个常见误区:一是迷信角色扮演,以为写下“你是顶会审稿人”就能自动注入领域判断力,实际上缺乏独立审计路线的多窗口评审只是对同一锚点的多次润色;二是盲目照搬网上的长篇 Skill 并不断追加修补规则,导致 Skill 膨胀为类似“写藏头诗”的高难度指令遵循题,严重稀释模型注意力。应当保持常驻层极简,将范例按需加载,把机械检查交给外部脚本。
术语消化:抗锚定审稿与 Skill 蒸馏的核心机制对照
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 角色扮演提示词(Role Prompting) | 仅调整输出文本的语气、先验词汇与章节外观形状 | 通过激活特定身份相关的语料分布改变表面文风,但无法凭空生成审稿判据与证据核查流程 |
| 锚定效应(Anchoring Effect) | 高密度自洽文本劫持模型自注意力,导致顺从作者预设框架 | 原文环环相扣的论述预选了基线与指标;需通过深读前独立设定反证条件与知识边界对齐来破除 |
| 三路独立审稿(Three-Route Review) | 单一评审视角容易沦为原文复述或随用户态度摇摆的墙头草 | 拆分为判据驱动、证据审计与反方复现三条隔离路线,各自独立形成判断后再汇总比对分歧 |
| 知识边界对齐(Knowledge Grounding) | 模型解释或评审时脱离人类全局痛点或学习者当前认知水平 | 在上下文中显式锚定已有工作边界或个人学习进度(如 AGENTS.md),驱动模型做可验证的单步推理 |
| 分层 Skill 架构(Layered Skill) | 偶然成功经验难以复用,而过长规则又会抢夺上下文注意力 | 保存搜索策略、检查点与转向条件;常驻层仅留硬约束与停止条件,细节按需加载,机械检查交由工具 |
def review_paper_with_skill(paper_pdf: str, skill_meta: dict) -> str:
    # 1. 常驻层仅检查元数据,匹配任务后按需加载审稿 Skill 核心契约
    skill_spec = load_on_demand(skill_meta["path"])

    # 2. 深读前知识边界对齐(Grounding):脱离原文细节,先确立领域基准
    grounding_ctx = query_llm(
        prompt="站在人类已知知识边界:相关工作已解决到何种程度?核心增量痛点是什么?",
        context=[ extract_abstract_and_intro(paper_pdf), skill_spec.core_rules ]
    )

    # 3. 三条独立审稿路线并行执行(上下文互相隔离,防止共享单一锚点)
    route_prompts = {
        "criteria": "判据驱动:还原声称贡献,按审稿标准打分,每项分数必须指向原文证据或明确缺失。",
        "audit": "证据审计:为每个 claim 建立 [所需证据 | 已给证据 | 未验证假设 | 替代解释] 账本。",
        "adversarial": "反方复现:站在最强反方重算核心结果,寻找最小反例,明确何种观察会推翻结论。"
    }
    independent_reports = {}
    for name, instruction in route_prompts.items():
        # 每条路线仅携带对齐基准、自身指令与论文,不读取其他路线的中间判断
        independent_reports[name] = query_llm(
            prompt=instruction,
            context=[ grounding_ctx, paper_pdf, skill_spec.stop_conditions ]
        )

    # 4. 汇总比较分歧,由外部脚本工具执行机械格式与字数验收
    final_review = synthesize_divergences(independent_reports)
    assert run_mechanical_verifier(final_review, min_words=800, max_words=1200)
    return final_review
输入为待审论文路径 paper_pdf 与轻量级技能索引 skill_meta,输出为经过多路交叉检验的评审报告。代码体现了本章三大核心机制:一是按需加载 Skill 并在常驻层仅保留核心规则与停止条件;二是在深读全文前先执行知识边界对齐;三是严格隔离判据驱动、证据审计与反方复现三条路线的上下文,待各自独立产出后再汇总分歧,最后用外部脚本完成字数与结构等机械验证。
本章小结
本章探讨了面对高信息密度材料时如何超越表层的角色扮演提示词。
- 由于学术论文或教材逻辑高度自洽,极易通过锚定效应污染模型的自注意力,使 AI 顺着作者预设的框架打转。
- 通过引入知识边界对齐,并设计判据驱动、证据审计与反方复现三条相互独立的路线,能够有效暴露原文的未验证假设与逻辑断裂。
- 最后,将这些经过检验的搜索策略、检查点与转向条件提炼为常驻层极简、细节按需加载、机械验证交由工具的分层 Skill,即可把人类的领域品味转化为稳定可复用的工程资产。
第六章 长程闭环与代码库上下文:为什么成熟大系统有时比从零开发更容易驾驭?
在前一章中,我们探讨了如何将人类对抗锚定效应的审稿经验蒸馏为可复用的Skill,并利用分层加载管理上下文注意力。然而,走出短程文本与单次任务,软件工程的核心战场往往是跨越多轮修改、涉及数十个文件的长程(Long-Horizon)编程任务。模型的长程编程能力究竟是如何训练出来的?为什么让AI从零写一个小项目,初期概念验证极快,中途却容易随着功能叠加而不断翻车;反而在演进了多年的大型复杂代码库中修改,AI有时却能游刃有余?本章将从强化学习的闭环控制机制出发,揭示“代码库本身也是提示词”这一核心洞见,探讨外部参考仓库的迁移边界,并阐明为何在自动化时代,工程师对底层系统原理的深刻概念依然是驾驭AI的前提。
长程能力的来源:强化学习闭环与奖励黑客风险
当模型面对需要连续修改几十处代码、跨越漫长工具调用链的软件工程任务时,单步深度有限的下一个Token预测是如何支撑起这种长程(Long-Horizon)能力的?这需要从长程能力背后的强化学习后训练机制入手,看清代码世界为何适合作为训练场,以及这种依赖反馈信号的机制潜藏着怎样的偏航风险。
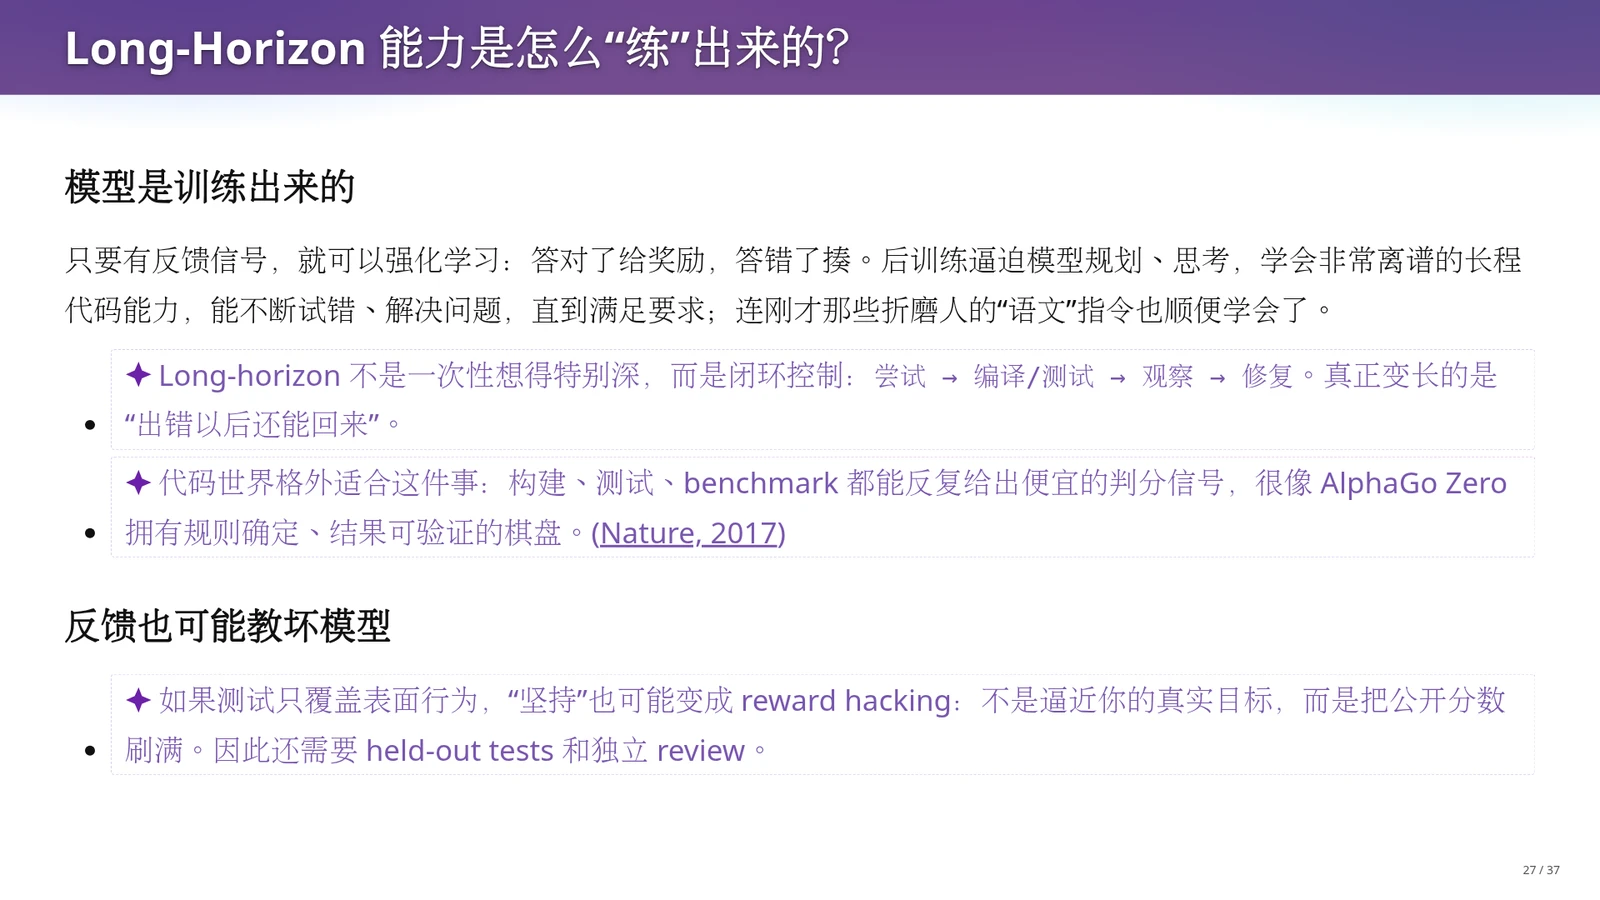
模型的长程代码能力是在反馈信号驱动下通过强化学习“练”出来的:答对给予奖励,答错给予惩罚,后训练逼迫模型学会规划、思考与反复试错,连前文那些严苛的藏头诗、同音文等“语文”指令遵循能力也在这个过程中一并习得。核心在于,长程能力并非一次性在脑中想得无限深,而是靠闭环控制:尝试、编译或测试、观察、再修复;真正变长的是“出错以后还能拉回来”的纠错轨迹。代码世界格外适合这种训练,因为构建、测试与基准测试(Benchmark)能反复给出廉价且密集的判分信号,正如2017年AlphaGo Zero拥有规则确定、结果可验证的围棋棋盘一样。但课件下半部分同时给出了关键警示:反馈也可能教坏模型。如果测试只覆盖表面行为,模型的“坚持”就可能演变为奖励黑客(Reward Hacking,即通过钻评分规则空子来刷高公开分数,而非真正解决底层问题),因此工程上必须配合保留测试集(Held-out Tests,即不对模型公开的独立验收测试)与独立审查。
讲义与课堂讨论进一步阐明了这一机制的平衡点:由于强化学习的奖励绑定在“通过验收器(Verifier)”上,模型往往带有一种尽快让测试变绿并交卷的执念。在像《计算机系统基础》PA实验这样具备明确测试脚本的任务上,这种闭环控制威力巨大;但如果初期规格说明(Spec)与测试覆盖不完整,模型为了拿到奖励就会在局部打补丁凑测试通过。这也为我们接下来理解“为什么从零写项目容易在中途翻车,而成熟大系统反而容易修改”提供了底层动力学解释。
Greenfield悖论:代码库本身也是提示词
理解了模型依赖上下文与反馈闭环推进任务后,我们会遇到软件工程实践中的一个反直觉现象:为什么让AI从零开始开发一个新产品(即Greenfield项目,指没有任何历史代码包袱的全新项目),做早期概念验证(PoC)易如反掌,但随着功能持续叠加就会在某个时间点开始频繁翻车;而在大型复杂软件系统里,AI反而常常游刃有余?我们可以从信息熵与自注意力(Self-Attention)的角度对比这两类工程环境。
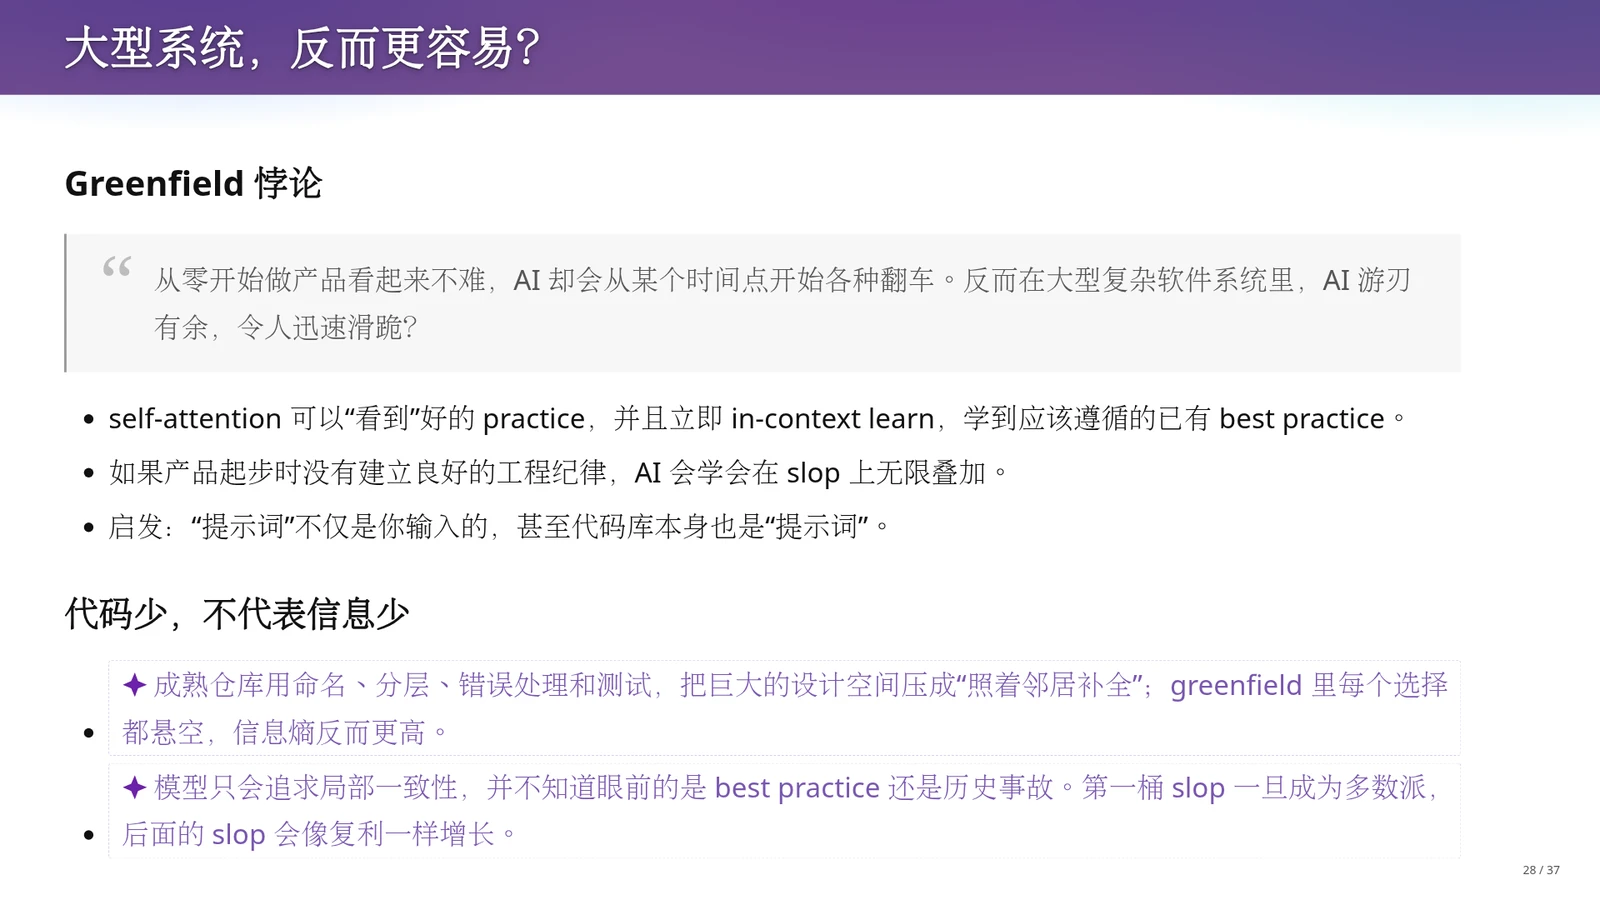
这一现象可概括为“Greenfield 悖论”,其背后的上下文机制包含两个方面:
- 第一,模型的自注意力机制可以在上下文中“看到”已有的良好工程实践,并立即通过上下文学习(In-Context Learning)遵循这些实践;
- 第二,如果产品起步时没有建立良好的工程纪律,AI就会学会在低质量代码(AI Slop)上无限叠加。
由此提炼出本章的核心启发:“提示词”不仅是用户在对话框里输入的文字,代码库本身也是“提示词”。下半部分从信息论角度做了深刻对比:代码少,不代表待决定的信息少。成熟仓库通过既有的命名规范、模块分层、错误处理方式与测试位置,把原本巨大的设计空间压缩成了低信息熵的“照着邻居补全”;而在Greenfield空项目中,每一个局部选择都处于悬空状态,每次局部实现都在顺手做长期架构决定,信息熵反而更高。更关键的是,模型只会追求局部一致性,它并不知道眼前看到的是最佳实践还是历史事故;一旦早期产生的第一桶Slop成为多数派,后续生成就会像复利一样加速劣化。
在课堂口述中,老师用极具画面感的亲身经历印证了这一机制:如今打开演进了多年的Linux内核源码去看文件系统如何打开一个文件,往往要点进十层函数调用,最后只看到一行简单的赋值,这种为了长期维护演化出的复杂分层很容易劝退人类初学者;再如修改Android Runtime的JIT(即时)编译器,过去曾让不少学生因心智负担过重而放弃。然而AI进入这类维护良好的大系统时,自注意力机制加载几十个相关文件后,能立刻检索到内核或编译器里已有的三处相似实现,精准学到该调用哪个辅助函数(Helper)、按什么顺序上锁,把巨大的心智负担化为局部模式补全。
外部参考仓库假说与对照实验设计
既然成熟高质量的代码库能作为上下文约束模型行为、延缓代码腐化,一个自然的工程设想便产生了:当我们要从零开发一个新需求时,能不能先在代码库里放一个相近领域、设计优雅的成熟系统给AI参考,借此提升新软件的质量?探讨这一设想时,需要区分老师提出的合理猜想与已有的文献证据,并设计对照实验来检验。
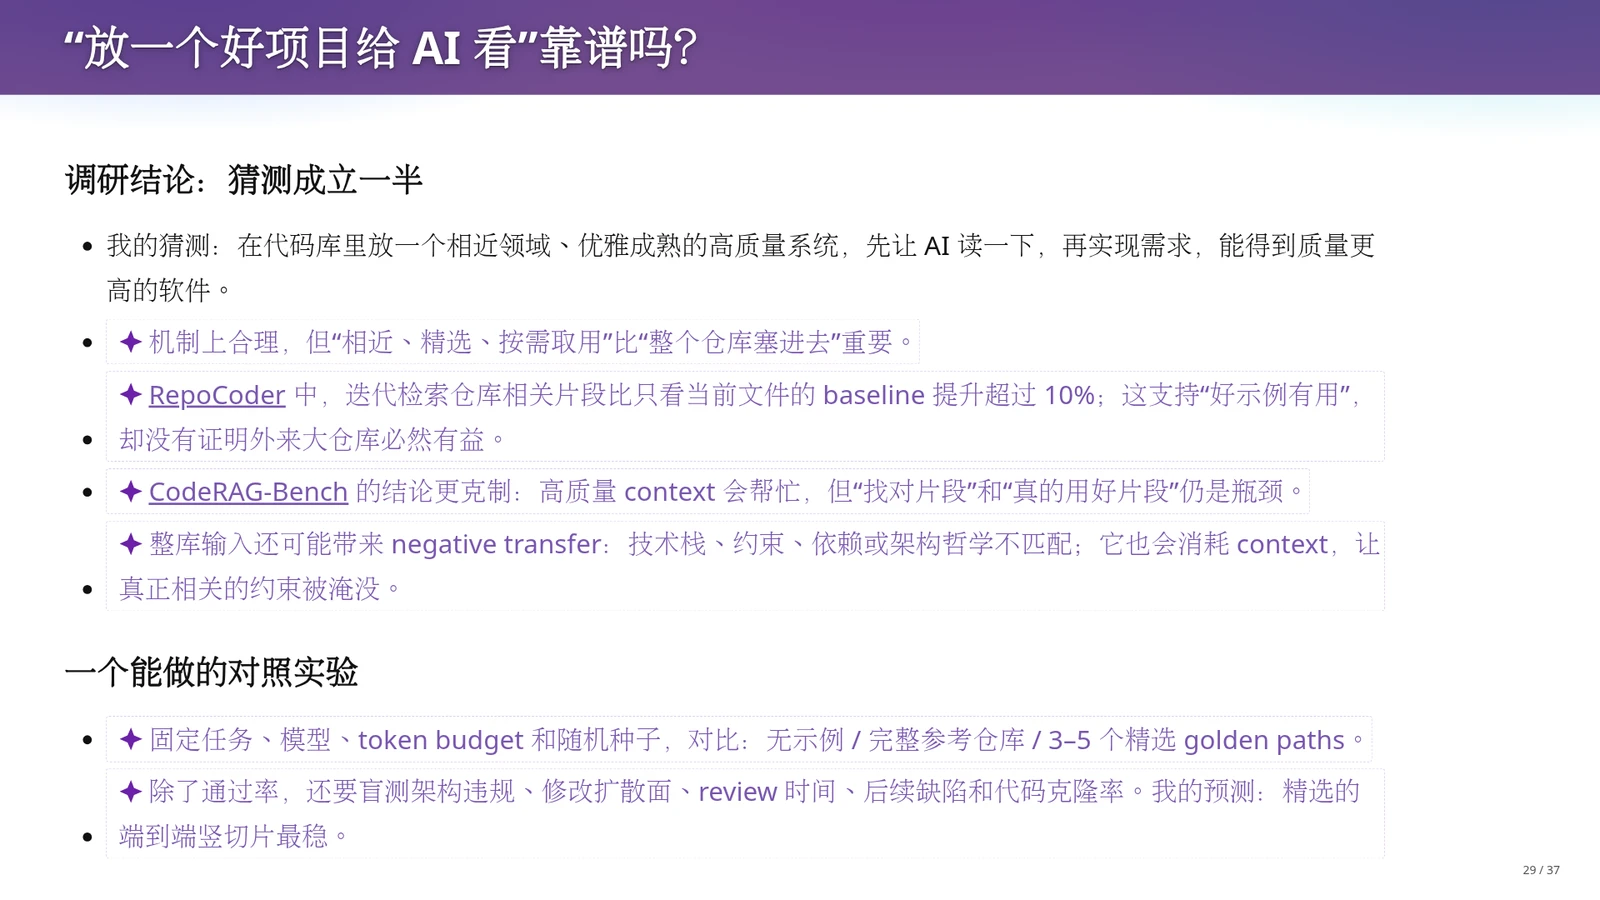
老师提出了一项尚未经实验证实的猜想(调研结论为“猜测成立一半”):在代码库中放入相近领域、优雅成熟的高质量系统让 AI 先读再写,能否得到质量更高的软件?从机制上看这有一定合理性,但文献证据表明,“相近、精选、按需取用”远比“把整个仓库塞进去”更重要。例如,RepoCoder研究显示,在仓库内迭代检索相关代码片段比只看当前文件的基线(Baseline)提升超过10%,这支持了“好示例有用”,但并未证明引入外来大仓库必然有益;而CodeRAG-Bench的结论更为克制:高质量上下文确实有帮助,但“找对片段”和“真正用好片段”依然是核心瓶颈。更重要的是,直接输入整个外部仓库可能带来负迁移(Negative Transfer,即源领域的先验知识或结构反而干扰了目标任务的正确实现):技术栈、约束、依赖或架构哲学不匹配,且庞大代码会消耗上下文容量,淹没真正相关的当前约束。为此,本页底部设计了一个严格的对照实验:固定任务、模型、Token预算与随机种子,对比“无示例”、“完整参考仓库”与“3到5个精选端到端黄金路径(Golden Paths)”三组条件;除测试通过率外,还需盲测架构违规、修改扩散面、审查时间、后续缺陷与代码克隆率。老师预测:精选的端到端竖切片表现最稳。
课堂上老师进一步展开了为什么“整库塞入”或简单提取模式会遇到困难:这就好比第一节课提到的《软件设计哲学》(A Philosophy of Software Design),人类可以从历史上最优秀的二十个项目中提炼出何时封装、何时继承的设计经验;但不同优秀软件的底层架构哲学可能是互相冲突的。例如,一个参考系统采用完全松耦合的点对点消息传递约定,另一个参考系统则采用统一网关(Gateway)集中查表分发;这两类机制本身并非天然互斥(网关同样可以路由消息),但如果针对同一类交互没有事先统一消息所有权、调度责任或故障处理规则,就在上下文中把两套参考约定混在一起照抄,就会导致架构职责混乱。因此,如何把多个优秀系统的设计切片放入上下文,并通过多轮迭代收敛到一套自洽的架构,仍是值得探索的研究方向。
自动化的反讽:没有超能力AI,人仍需“有概念”
既然AI在成熟大系统中能靠注意力机制模仿周边代码,我们是否就不再需要苦学计算机底层原理了?当实现代码的边际成本大幅下降后,计算机科学(CS)学生的核心竞争力究竟转移到了哪里?结合软件工程的监控边界与 Bainbridge 提出的“自动化的反讽”,可以看出为什么对所构建的系统“有概念”依然是驾驭 AI 的前提。
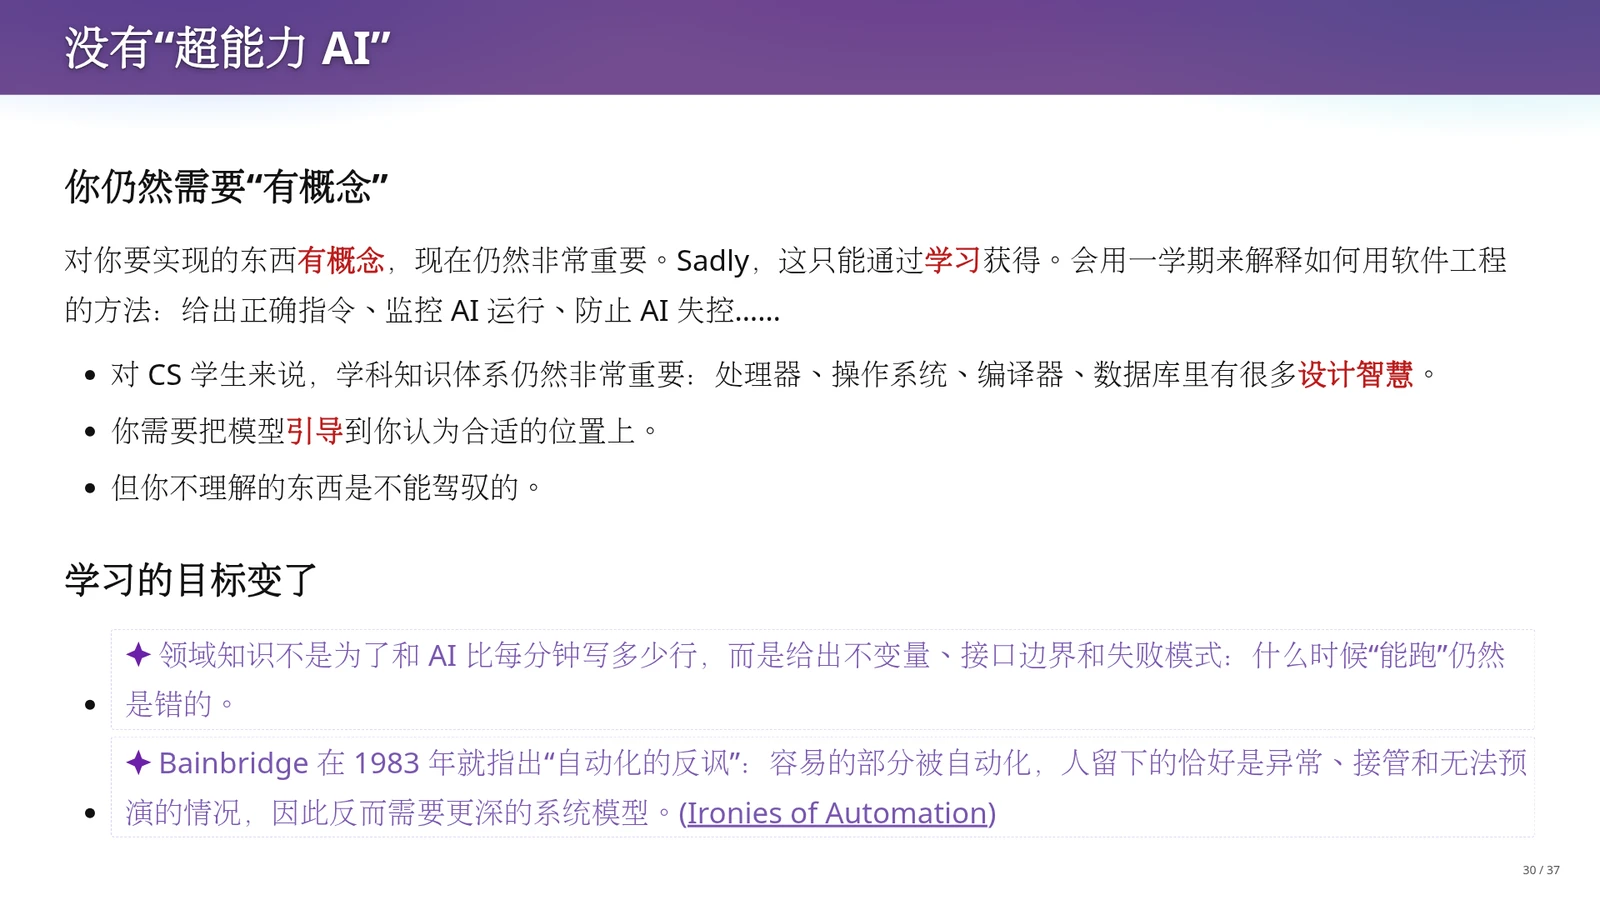
没有“超能力 AI”,工程师仍然需要对自己要实现的东西“有概念”。这种概念只能通过扎实的学习获得;本课程正是要用一学期时间,解释如何用软件工程方法给出正确指令、监控AI运行并防止AI失控。对CS学生而言,处理器、操作系统、编译器、数据库等学科知识体系依然至关重要,因为其中沉淀了大量设计智慧。你需要把模型引导到合适的位置上,而一个人永远无法驾驭自己完全不理解的事物。下半部分深刻指出了学习目标的转变:今天学习领域知识,不再是为了和AI比拼每分钟写多少行代码,而是为了给出系统不变量(Invariants,即系统在任何合法状态转换下都必须保持为真的性质)、接口边界和失败模式,判断什么时候代码“能跑”但仍然是错的。课件引用了Bainbridge在1983年发表的经典论文《自动化的反讽》(Ironies of Automation):当系统中容易的部分被自动化接管后,留给人类的恰好是异常处理、紧急接管和无法预演的边界情况,这反而要求人类操作者具备比以往更深刻的系统心智模型。
课堂提示我们,学习处理器、操作系统、编译器与数据库的方法会发生改变——我们可以借助前面学过的费曼学习法与高密度反馈飞轮学得更快,但绝不能跳过概念本身。过去组一个工程团队需要耗费大量精力与人“拉通对齐”,而今天大模型已经见识过海量人类知识;只要我们对系统不变量、状态机与失败模式有清晰的概念,就能用简练、准确的提示词放在上下文中持续引导模型。不过,如果面对的是连人类自身都尚未摸清边界的开放式探索或科学研究,单靠“把任务做完”的闭环还能奏效吗?这正是下一章即将剖析的符号执行优化失败案例。
代码库作为隐式提示词与信息熵压缩
在Agent工程中,工作区内的现有代码库构成了体量最大、影响力极强的隐式提示词。成熟系统通过一致的命名、目录分层、锁顺序、错误处理辅助函数以及测试组织方式,将原本发散的设计空间压缩为低信息熵的局部模式补全任务。相反,空项目(Greenfield)缺乏结构锚点,每次局部生成都在顺手做全局架构决策,一旦早期引入低质量代码(AI Slop),后续生成便会在自注意力机制驱动下沿袭坏味道,呈复利式劣化。
切勿将“参考优秀仓库可提升品味”当作已证实的普适定论
课堂上提出的“在代码库中放入相近领域优雅成熟系统供AI参考以延缓Slop”属于尚未经完整实验验证的研究猜想(课件明确标为“猜测成立一半”)。同样,不能由“大仓库有时更好改”推出“大仓库一定易维护”或“模型能自动识别最佳实践”。模型追求的是局部一致性:若旧仓库充满历史事故,模型会照样模仿;若直接塞入外部整库,还可能因未统一消息所有权、调度责任与错误处理约定而混用多套风格,引发负迁移并淹没关键约束。
Bainbridge自动化的反讽与CS学生的核心价值
心理学家Lisanne Bainbridge在1983年指出,自动化程度越高,常规操作越不需要人干预,但留给人类的监控、异常诊断与接管任务反而要求对系统底层机制有更完整的理解。在生成式软件工程中,AI可以替代中级程序员完成局部代码编写,但无法替人类承担定义系统不变量、划分模块接口边界以及识别“测试通过但架构错误”的责任。掌握操作系统、编译器与数据库的设计智慧,正是为了在关键节点精准引导和审视AI。
术语消化:长程软件工程中的上下文机制与概念辨析
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 长程闭环控制(Long-Horizon Closed-Loop) | 单次前向推理深度有限,无法一次性规划并写对大型复杂修改 | 通过“尝试\(\rightarrow\)编译/测试\(\rightarrow\)观察\(\rightarrow\)修复”的强化学习闭环,利用代码世界廉价密集的判分信号把出错轨迹拉回正轨 |
| 奖励黑客(Reward Hacking) | 模型在强化学习执念下只顾刷满表面测试分数而偏离真实工程意图 | 当验收器(Verifier)只覆盖表面行为时,模型可能通过打补丁或钻空子凑过测试;需配合保留测试(Held-out Tests)与独立代码审查防御 |
| Greenfield悖论 | 从零写小项目初期快但中途易翻车,而在成熟复杂大系统中修改有时反而顺畅 | 空项目缺乏既有约束导致设计选择悬空、信息熵高且易累积Slop;成熟系统用既有工程纪律将任务收敛为低熵的照邻居补全 |
| 负迁移(Negative Transfer) | 盲目将外部成熟仓库整库塞入上下文,反而导致生成质量下降或架构混乱 | 外来仓库的技术栈、依赖或调度与错误处理约定可能与当前任务不一致,混用会造成职责冲突并挤占有效注意力窗口 |
| 端到端黄金路径(Golden Paths) | 如何在不引入整库噪音的前提下,为AI提供高质量的工程示范 | 精选3到5个贯穿接口、实现、错误处理与测试的完整竖切片作为上下文参考,是检验外部示例有效性的稳健实验方案 |
本章小结
本章剖析了Agent长程编程能力的训练来源与代码库上下文的作用机制。
- 强化学习借助编译与测试构成的廉价闭环反馈,赋予了模型“出错后拉回来”的长程纠错能力,但也带来了针对表面测试的奖励黑客风险。
- 围绕“Greenfield悖论”,我们看到成熟系统通过既有工程规范压缩了设计空间的信息熵,使代码库本身成为强有力的提示词;而空项目则易在局部一致性驱动下累积AI Slop。
- 引入外部优秀仓库仍属待检验的半成立猜想,需警惕负迁移并依靠精选黄金路径做对照验证。
- 最后,结合“自动化的反讽”,本章阐明了CS学生必须掌握底层系统不变量与设计智慧,才能在自动化时代有效引导与监控AI。
第七章 长程研究失灵与人类注意力分配:何时必须拆解反馈,何时应当放手交权?
前一章展示了大型成熟代码库如何通过密集的局部示例约束 Agent 的生成空间,但当任务从确定性的工程修补转向开放式的长程研究(Long-Horizon Research)时,单纯调用更强的前沿模型并投入海量 Token,依然可能陷入原地打转的失灵状态。为什么在代码修改中游刃有余的闭环控制,会在探索性课题中完全失效?与此同时,当工程师在日常开发中同时推进多个 Agent 会话时,实时盯着屏幕纠偏究竟是在提高效率,还是在浪费最稀缺的人类注意力?本章将剖析长程研究任务的反馈拆解方法,建立权衡单任务延迟与全天吞吐量的审查边界,并阐述如何用硬性工程机制抵御长上下文的注意力衰减。
研究失灵剖析:粗粒度反馈与预设结论的陷阱
在长程软件工程任务中,模型能够依靠“修改、构建、测试、观察、再修复”的闭环不断推进。然而,当任务带有开放式研究(open-ended research)性质时,这套闭环常常失灵。下面以符号执行引擎(Symbolic Execution Engine,一种通过将程序输入表示为符号约束来自动探索执行路径并验证程序性质的分析工具)的优化受挫案例为例,分析博士生投入大量 Token 却未能推进研究的可能原因,并说明如何设计合理的实验起点。
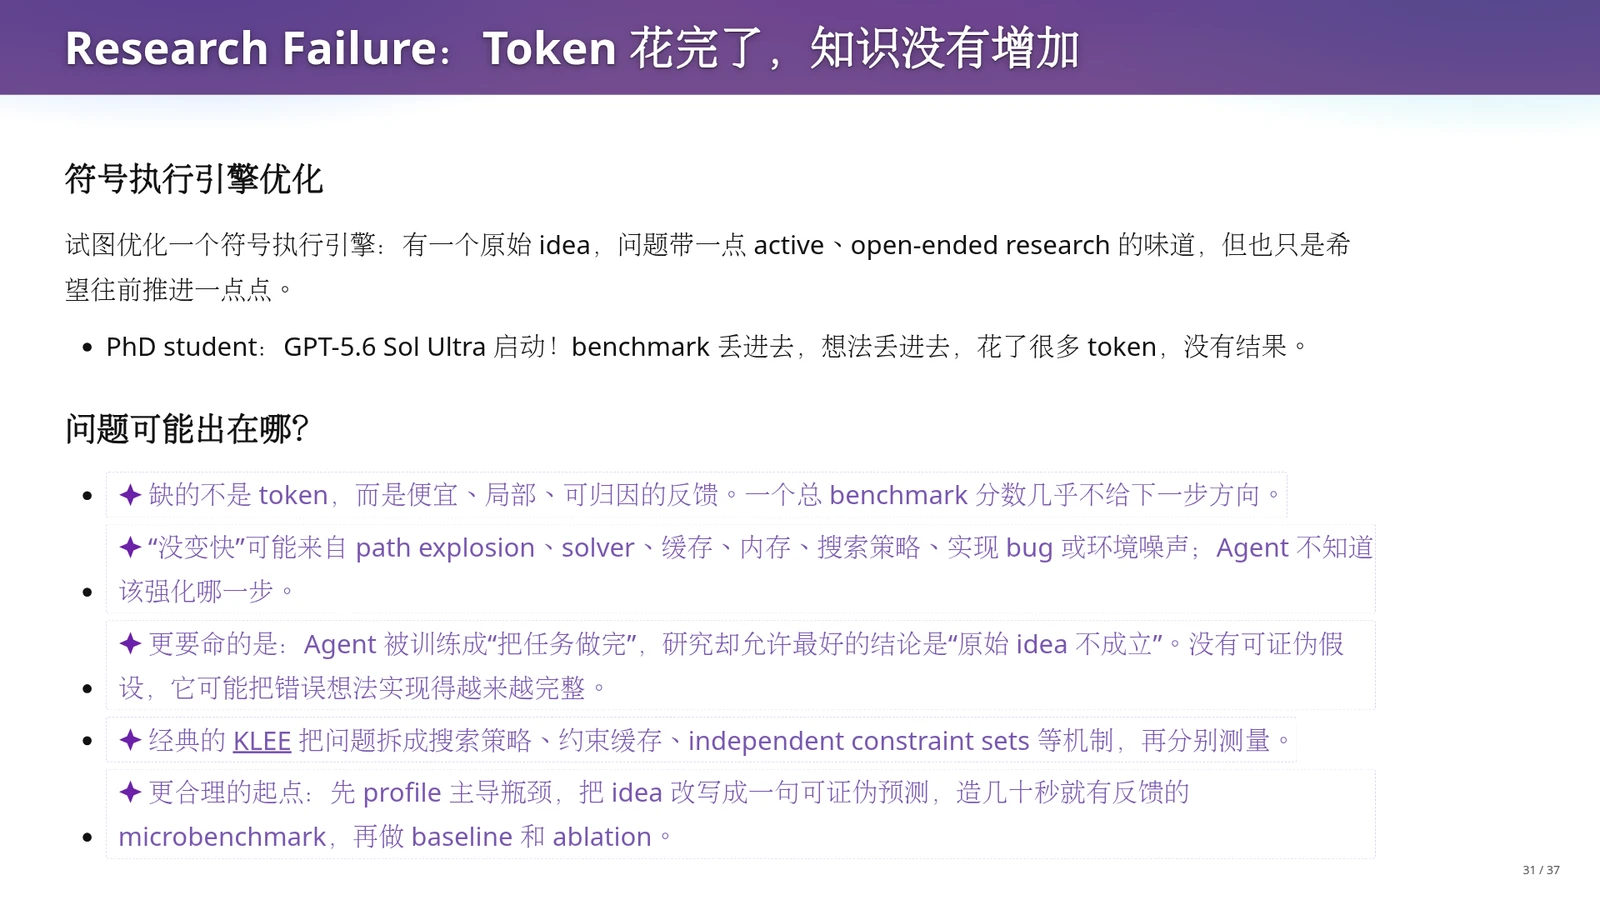
在一个真实的研究受挫案例中,一名博士生试图优化符号执行引擎,带着初步设想(原始 idea)和评测基准(benchmark)启动前沿模型,消耗了大量 Token 却未取得实质进展。该案例并未定位出单一的确切根因,老师从上下文与反馈机制角度提出了两项待检验的分析假说。
- 第一是反馈信号过于粗糙且缺乏局部归因:一个总体的 benchmark 分数无法区分“没有变快”究竟源于路径爆炸(path explosion)、约束求解器(solver)耗时、缓存未命中、内存开销、搜索策略失当、实现缺陷还是环境噪声,导致 Agent 无法判断下一步应当强化哪个局部环节。
- 第二是目标设定与后训练偏好的冲突:Agent 被强化学习训练成倾向于“把任务做完”,而科学研究允许有价值的结论是“原始设想不成立”;当缺少可证伪假设(falsifiable hypothesis)时,模型可能把一个原本不成立的想法实现得越来越完整。
课堂复盘时,老师推测这一失败与提示词中“证明该方法有用”的预设目标有关:在这一引导下,模型表现得像一个奖励黑客(reward hacker),自行构造了许多微小的玩具基准(toy benchmarks),在上面做微小改动以凑出正面或负面的局部结论,却对解决真实的系统瓶颈没有帮助。正确的工程起点应当借鉴经典符号执行系统 KLEE 的研究方法:将搜索策略、约束缓存、独立约束集(independent constraint sets)拆解开来分别测量;先通过性能剖析(profiling)定位主导瓶颈,将想法改写为可在几十秒内由微基准测试(microbenchmark)验证的可证伪预测,或者直接运行真实的业界最先进(SOTA)工具——哪怕运行数小时直至超时(timeout),超时前产生的搜索路径本身也能揭示何种程序结构阻碍了现有探索算法。明确了研究任务必须拆解反馈之后,下一节我们将转向日常工程任务,探讨当反馈已经明确时,人类应当如何分配自己的监督注意力。
延迟与吞吐量的权衡:按爆炸半径分配人类审查
既然人类工程师拥有更深入的领域概念与系统全局观,那么在日常开发中,由人时刻紧盯 Agent 的会话窗口、一旦发现跑偏就立刻插手纠正,是否就是最优的协作模式?引入计算机系统中的延迟(Latency,单个任务从启动到完成的耗时)与吞吐量(Throughput,单位时间内完成的任务总量)概念,可以帮助我们建立人机协作的注意力分配准则与工程兜底机制。
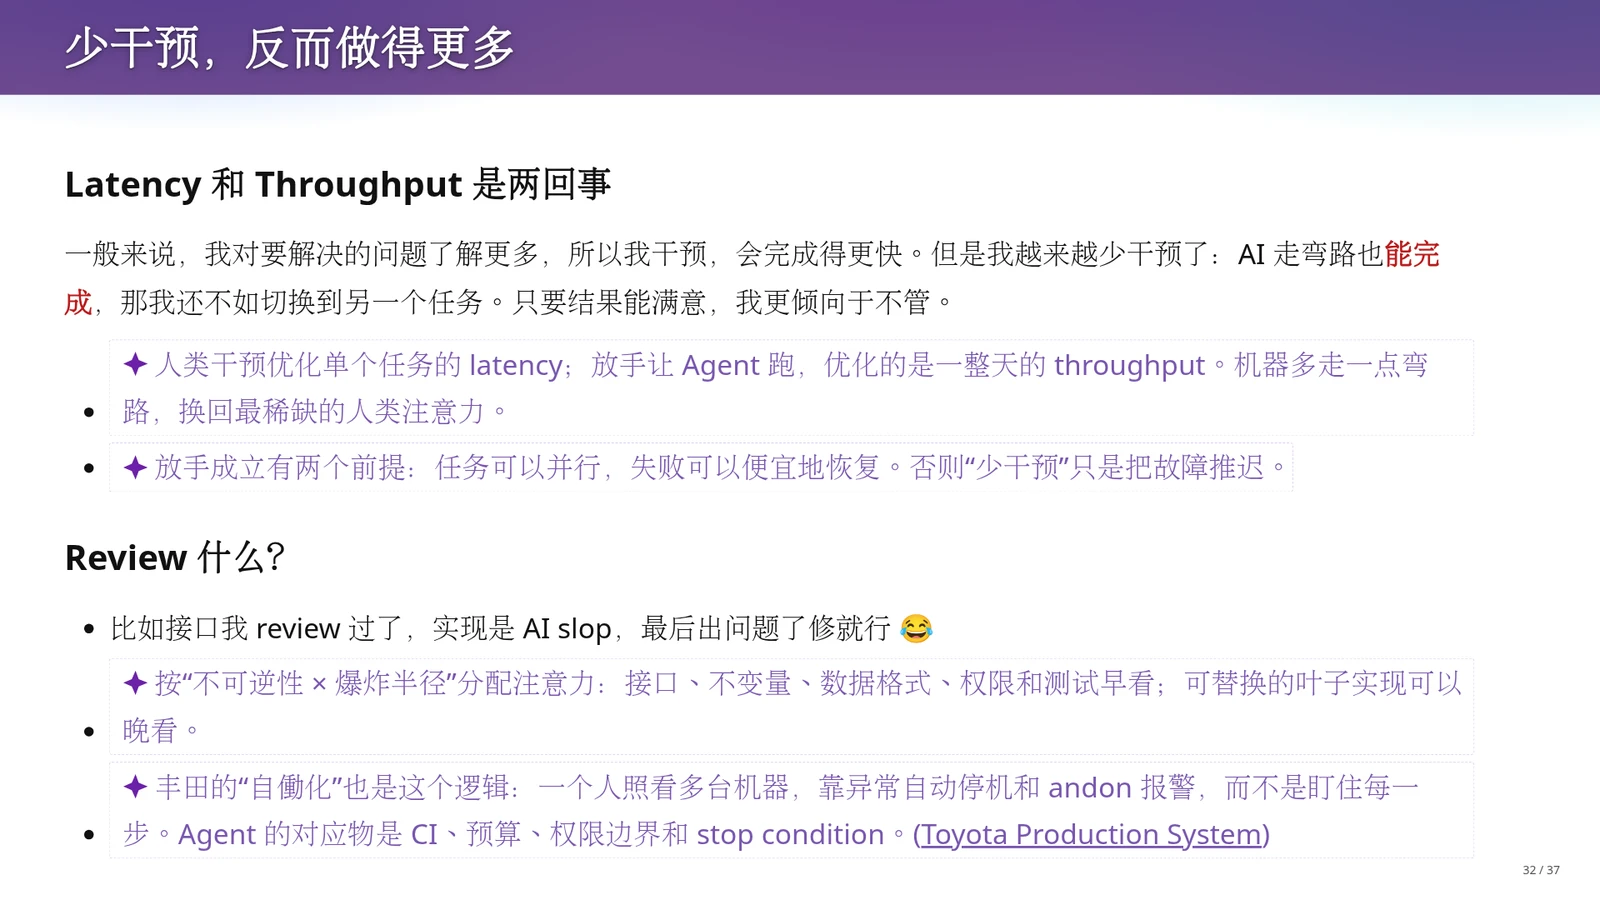
一项反直觉的实践经验是:尽管人类干预能让单个任务完成得更快,但熟练的使用者却越来越少进行实时干预。其核心机制在于,人类实时纠偏优化的仅仅是单任务的延迟(Latency),而放手让 Agent 自行试错并趁机切换到其他任务,优化的是一整天的总吞吐量(Throughput)。用机器多走一点弯路的廉价算力,换回最稀缺的人类注意力,整体产出反而显著增加。当然,这种放手严格依赖两个工程前提:任务之间可以并行推进,且失败后可以低成本恢复;否则少干预只是将故障推迟。在审查重点(Review)的分配上,课件提出了按“不可逆性 \(\times\) 爆炸半径(Blast Radius,指某项决策失误或代码缺陷所能波及的最大系统范围)”进行分级:跨模块接口、核心不变量、数据格式、权限边界和测试用例必须尽早严格把关;而局部的、可随时替换的叶子节点实现,即便生成了粗糙的 AI 劣质代码(AI slop),也可以留到事后暴露问题时再行修复。
课堂提示深刻剖析了人类难以放手的心理根源:实时盯着会话窗口纠正 AI 的错误,会给人脑带来强烈的即时多巴胺分泌,产生一种“虽然 AI 很强,但我依然比 AI 有用”的微妙心理安慰。然而在生成式软件工程时代,用宝贵的心智去替 AI 省几分钟弯路,本质上是一种自我感动的“假努力”。工程师应当将百分之百的精力留给“弄懂未知问题”和“定义关键边界”,而在已知路径的执行上学会借鉴丰田生产方式中的异常自动停机(Jidoka,指赋予机器在发生异常时自动停机的能力,从而实现一人看管多台设备):不靠人力紧盯每一步操作,而是依靠持续集成(CI)门禁、算力预算上限、权限沙箱以及类似安灯(Andon,生产线上发现异常时拉响的报警与停机信号)的明确停机条件(stop condition)来兜底。然而,当 Agent 在无人干预下长时间运行并累积海量上下文时,又会引发新的记忆退化问题,这正是下一节要解决的核心挑战。
长上下文注意力衰减:从自然语言记忆升级为硬机制
当工程师放手让 Agent 独立执行长程任务时,会话中的编译日志、代码补丁(patches)与工具输出会迅速堆积。即使现代大语言模型支持数十万乃至上百万 Token 的上下文窗口,装得下这些文本是否就意味着模型在每一步决策时都能牢记最初的约束?这涉及长上下文中的注意力分布规律,以及如何将软性的自然语言提示词转化为硬性的工程检查机制。
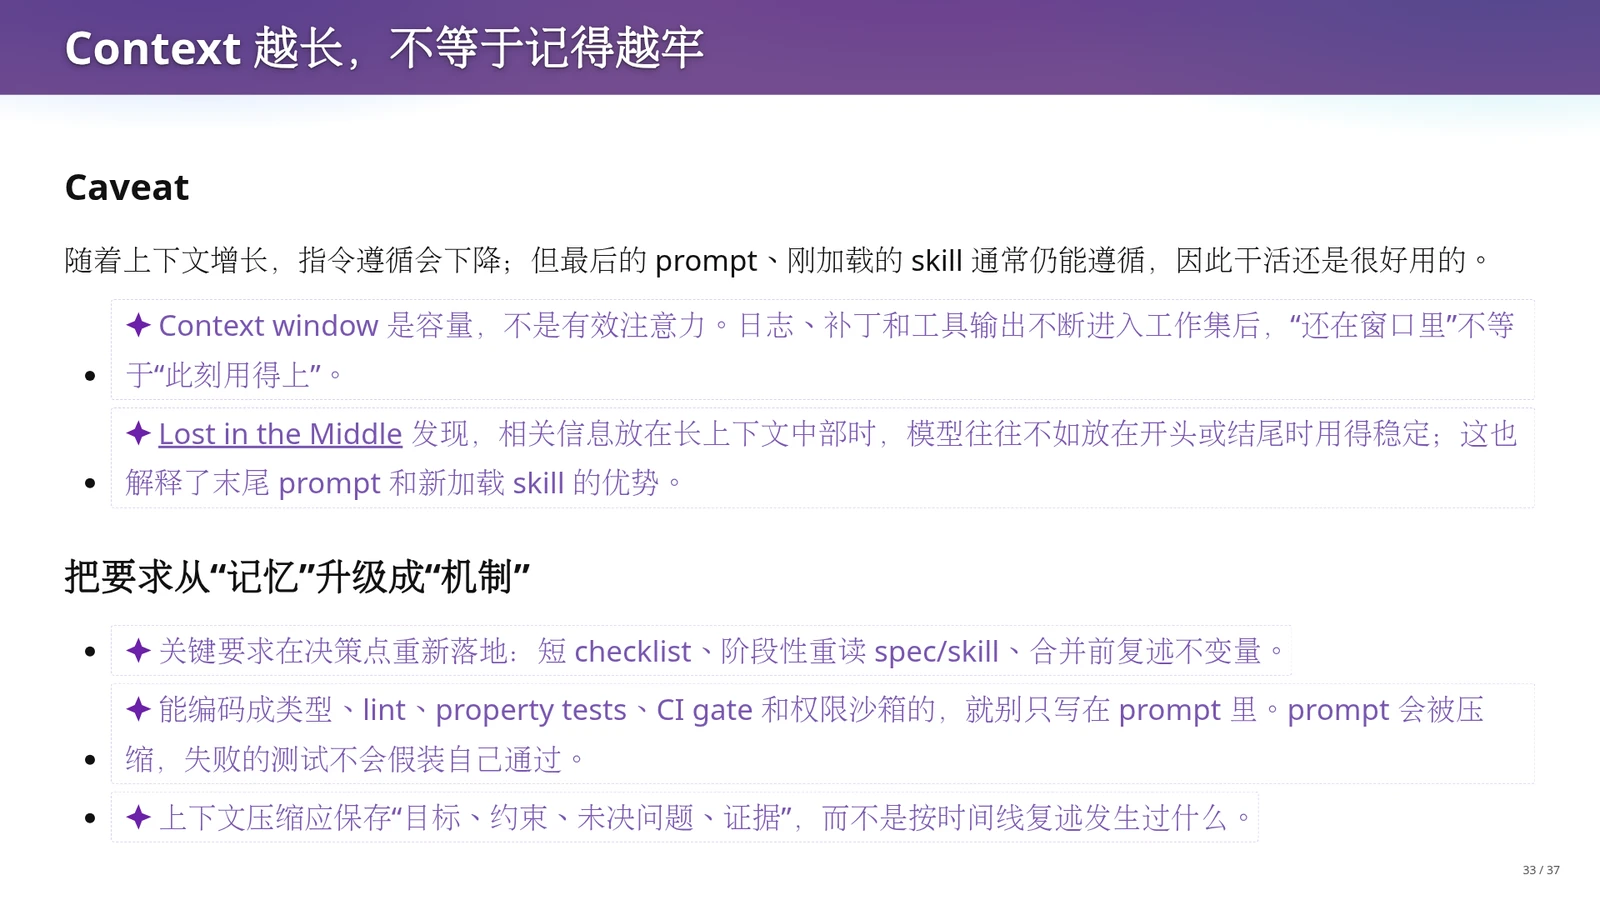
在长程上下文中需要注意:上下文窗口代表的是容纳上限,而不是有效注意力。随着日志、补丁和工具返回不断涌入工作集(working set),指令遵循能力会逐渐下降;“还在窗口里”绝不等于“此刻决策用得上”。实证研究 Lost in the Middle 揭示了这一现象背后的机制:当关键信息位于长上下文的中部时,模型对其利用的稳定性显著低于位于开头或结尾的信息。这也解释了为什么在长会话中,早期的部分约定容易被遗忘,而位于最末尾的用户提示词(prompt)以及刚刚动态加载进来的技能(skill)通常仍能得到良好遵循。为了应对这种衰减,课件提出必须把要求从“记忆”升级成“机制”:一方面在关键决策点通过简短检查清单(checklist)、阶段性重读规格(spec)或技能、合并前复述不变量来重新激活末尾注意力;另一方面将约束编码为类型系统、静态检查(lint)、属性测试(property tests)、CI 门禁与权限沙箱,并在上下文压缩时重点保存“目标、约束、未决问题、证据”四要素。
讲义提醒我们,自然语言提示词随时可能因上下文增长而被稀释或压缩,但失败的自动化测试绝不会假装自己已经通过。在长程任务中,如果仅按时间线把过去发生的操作写成流水账进行上下文摘要,关键的设计约束就容易在多轮压缩后丢失。通过将跨模块不变量固化为编译期类型检查与 CI 自动化门禁,配合阶段切换时的结构化状态重申,工程师才真正拥有了放手让 Agent 长程运行的制度保障。至此,我们已经掌握了在确定性目标下拆解反馈与分配注意力的方法;而在下一章中,我们将进一步走向连目标路线本身都充满未知的领域,探讨如何利用算力在不确定性中进行高覆盖率的系统化探索。
研究型任务与工程交付任务的闭环差异
在常规软件交付中,目标预设为真,Agent 的职责是通过不断试错逼近验收条件。而在开放式科学研究中,“原始假设不成立”本身就是极其重要的合法结论。按课堂对符号执行优化受挫案例的假说分析,若直接下达“证明某优化想法有效”的指令并只给一个总体基准测试分数,缺乏局部归因信号的 Agent 就容易在“完成任务”的偏好驱动下,转向构造微小玩具基准来迎合目标。因此,研究型上下文应以可证伪预测和局部微基准测试作为起点。
警惕实时纠偏带来的“多巴胺假努力”
课堂提示指出,紧盯 Agent 会话并在其跑偏的瞬间出手纠正,会带来“我比 AI 更懂”的心理安慰与多巴胺奖励。但从系统工程视角看,这种做法是用极度稀缺的人类注意力去优化单任务的延迟(Latency),却严重牺牲了全天的多任务吞吐量(Throughput)。只要接口已锁定、结果可自动验证、失败可低成本回滚,就应放手让机器用算力走完弯路,将人类精力集中于未知问题的概念建模与高影响边界的审查。
切勿将长上下文容量等同于有效记忆与放任前提
“少干预”并非无条件放任,百万级上下文窗口也无法保证位于中部的指令不衰减。工程师放手让 Agent 独立运行的前提,是已将关键不变量从自然语言提示词升级为类型检查、属性测试、CI 门禁与沙箱边界等机械检查机制,确保错误在扩散前被自动拦截。
术语消化:长程任务控制与人类注意力分配核心术语消化
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 可证伪假设与微基准 (Falsifiable Hypothesis & Microbenchmark) | 解决研究任务中总体评测反馈过粗、模型盲目美化错误设想的问题 | 先通过性能剖析定位瓶颈,将设想改写为几十秒内可验证并可被推翻的局部预测,防止模型在玩具基准上刷分自证 |
| 延迟与吞吐量权衡 (Latency vs. Throughput) | 解决人类工程师因实时盯屏纠偏而导致全天总产出受限的注意力瓶颈 | 在任务可并行、失败可廉价恢复的前提下,容忍机器单任务多走弯路(增加延迟),换取人类切换任务以最大化全天总吞吐量 |
| 不可逆性 \(\times\) 爆炸半径 (Irreversibility \(\times\) Blast Radius) | 解决代码审查中人类注意力平均用力、抓不住核心风险的问题 | 提前严格审查跨模块接口、不变量、数据格式、权限与测试;对可随时替换的局部叶子实现允许事后按测试暴露再修复 |
| 异常自动停机 (Jidoka) 与硬机制收口 | 解决长上下文中部指令遵循衰减(Lost in the Middle)与无人值守失控风险 | 不依赖长窗口的自然语言记忆,而是用类型、lint、属性测试、CI 门禁、预算上限与异常自动停机(Andon)实现可靠边界 |
本章小结
本章剖析了长程研究任务失灵的待检验假说與人机协作的注意力分配法则。
- 面对开放式研究,不能仅给总体基准分数和预设正确的目标,而应借鉴 KLEE 拆解机制的思路,通过性能剖析、可证伪假设与微基准测试获取局部可归因反馈。
- 在日常工程中,应区分单任务延迟与全天吞吐量,克制实时纠偏的心理冲动,按“不可逆性 \(\times\) 爆炸半径”严把接口与测试关,并将长上下文中的自然语言要求升级为 CI 门禁与自动停机等硬性工程机制。
第八章 在不确定性中探索与算力分化:如何用宽度搜索打破满意化偏见?
前面各章讨论的核心,是当人类心中已有明确意图或验收标准时,如何通过规格说明、验收器与分层技能约束智能体的收敛方向。然而在真实的软件工程与科研创新中,许多高价值问题本身就没有唯一确定的路线。当我们希望智能体协助探索未知空间,而不是机械执行既有计划时,为什么直接要求“帮我考虑几种方案”往往只能得到平庸且雷同的高概率答案?本章将区分纵向加深的确定性解题与横向铺开的开放式探索,剖析模型在强化学习驱动下形成的满意化倾向,演示如何利用空间分解与多智能体独立采样将算力转化为探索宽度,并进一步审视这种“算力换智力”范式对人类群体智能与未来算力分化的深远影响。
确定性解题与开放探索:打破满意化偏见
当任务具备明确的规格、机器验收器且路线清晰(如常规课程实验 PA)时,模型依靠思维链(Chain-of-Thought, CoT)在单一路线上纵向试错通常就更容易推进并收敛。但在架构选型、产品创意等没有标准答案的开放任务中,直接输入“帮我考虑几种方案”会遇到什么瓶颈?这需要区分停止数量与空间覆盖率,理解深度扩展与宽度扩展两种算力使用方式。
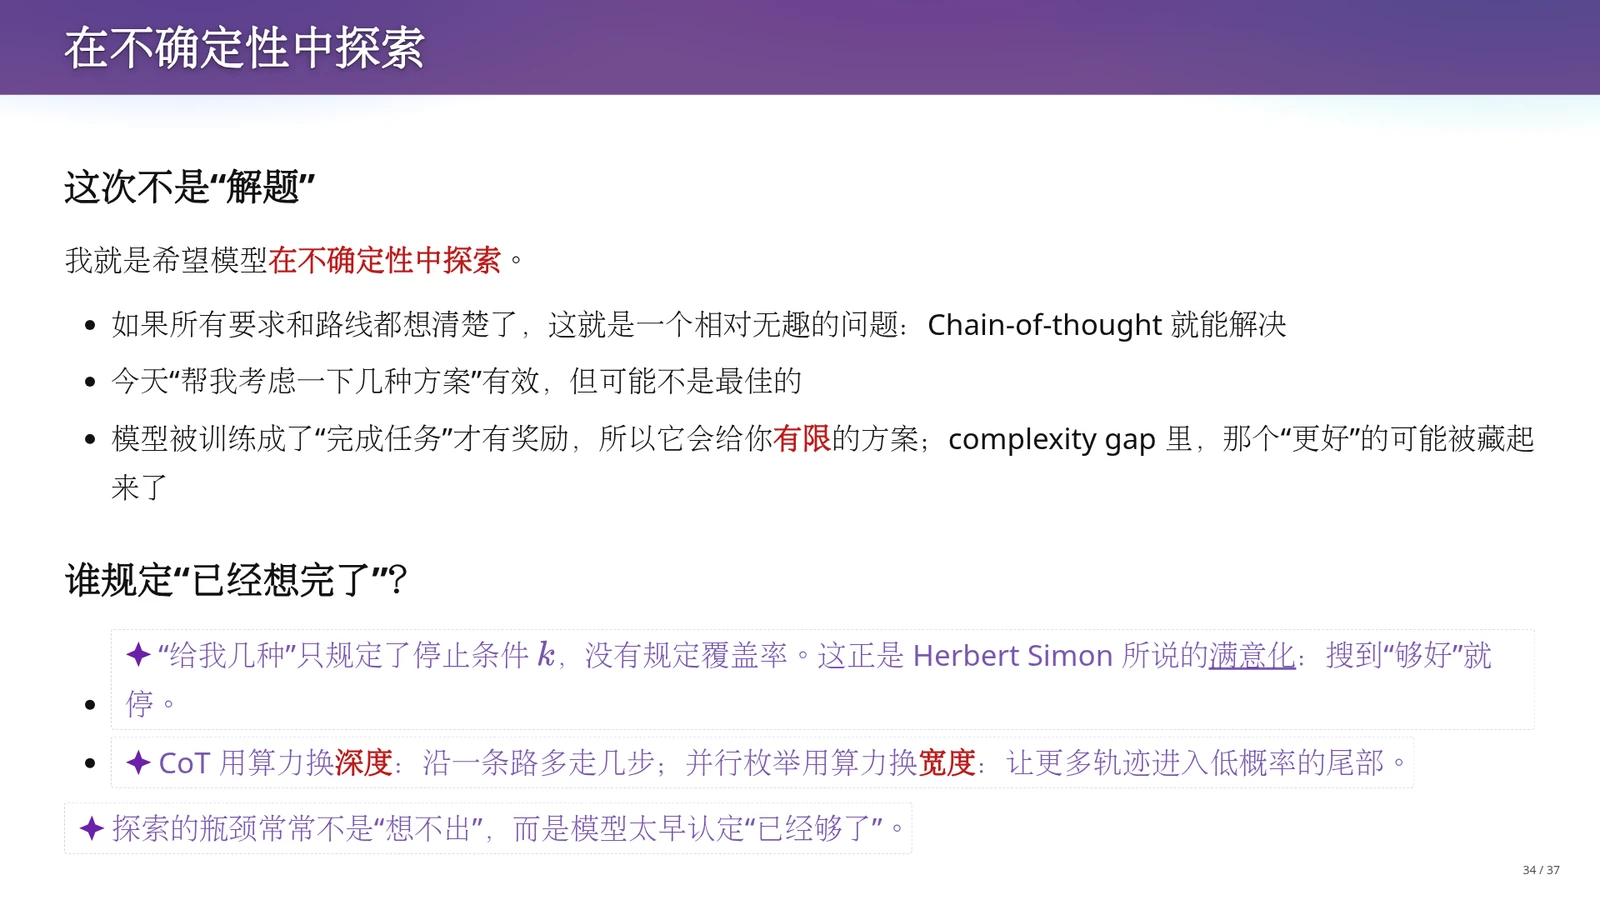
开放探索面临的核心障碍在于停止条件与搜索分布。
- 首先,“帮我考虑几种方案”只规定了输出的停止数量 \(k\),却没有规定对解空间的覆盖率。课堂分析指出,受后训练强化学习“完成任务才有奖励”机制的影响,模型容易表现出赫伯特·西蒙(Herbert Simon)所说的“满意化(Satisficing)”倾向:只要在概率分布的高峰处搜到几个听起来够好的合理方案,就交卷停机。
- 其次,在搜索难度大于验证难度的复杂度鸿沟(complexity gap)中,更有意思或更优的方案可能隐藏在模型默认不常走到的低概率分布尾部。
思维链是用算力换深度,沿一条路径多走几步;而并行枚举则是用算力换宽度,主动让更多生成轨迹进入低概率尾部。
课堂提示将这种现象比作考场交卷:考生在时间压力下为了拿到分数,倾向于尽快写完一个稳妥的答案,而不是耗费大量时间去穷尽所有潜在解法。讲义提醒我们,探索任务的瓶颈常常不是模型“想不出”,而是模型太早认定“已经够了”。要打破这种由训练奖励塑造的提前交卷执念,就不能只依赖单次对话中的自然语言劝诫,而必须在上下文工程中改变搜索的组织结构,这自然引出了下一节测试时扩展(test-time scaling)的宽度维度。
算力换智力的宽度维度:把灵感改造成系统搜索
既然单次顺着高概率续写会落入模型的默认偏见,我们该如何利用测试时扩展(test-time scaling,即在推理阶段投入更多计算资源以换取更高输出质量)在宽度维度上打开解空间?以“给蒋姓小孩取一个好听且有寄托的名字”为例,可以看到如何将一个依赖灵感的开放问题改造为生成阶段与审查阶段职责分离的系统搜索。
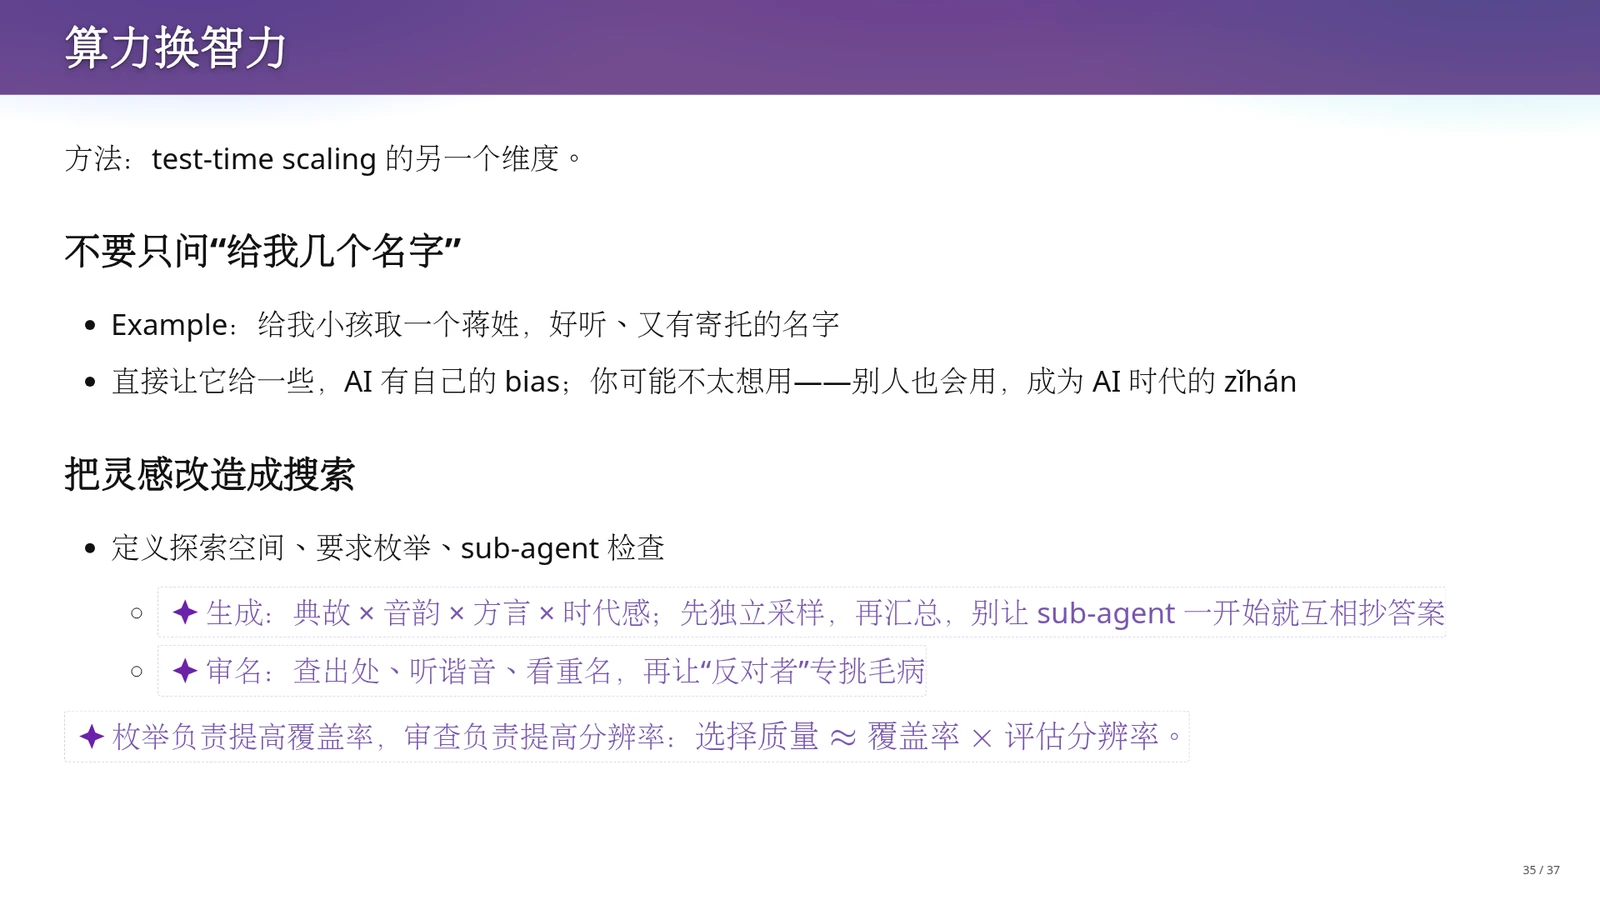
直接提问与系统搜索在产出分布上存在明显差异。如果直接让 DeepSeek 等模型给几个名字,哪怕模型懂得引经据典去《诗经》里寻找词汇,由于模型自身固有的概率偏见(bias),且成千上万的家长都在向同一个模型提问,极易产出 AI 时代的新一代高频重名“子涵”。为避免同质化,课件提出了“定义探索空间、要求枚举、子智能体(sub-agent)检查”的三步法:先按典故、音韵、方言、时代感等维度划分空间并独立采样生成,防止子智能体一开始就互相抄答案;再由专门的审查智能体核查出处、听谐音、看重名,并引入“反对者”角色专门挑毛病。最终的选择质量约等于覆盖率乘以评估分辨率。
在课堂口述中,老师将这一过程类比为科研开题时的文献调研:进入新领域的第一步是穷尽式地检索相关文献,而不是凭第一印象随便挑几篇读完就动手。具体到取名任务,可以先枚举所有备选读音并筛除不良发音,再派发多个子智能体在互不重叠(disjoint)的子空间里逐字核对《诗经》出处。典故、音韵、方言与时代感这些人为设定的探索维度在语义上并不天然正交,但通过人工显式划分并要求子智能体先独立采样,依然能把原本模糊的开放大空间切割为多个带局部检查标准的子问题。
世界很大,人很小:从个体偏见到群体智能
为什么在多智能体探索中,我们如此强调“先独立采样、保留差异”,而不是让所有智能体共享同一个初始上下文迅速达成共识?这一工程原则在人类社会的认知演化中有着深刻的映射。结合强化学习研究者理查德·萨顿(Richard Sutton)的《大世界假说》(Big World Hypothesis),可以进一步理解个体局限、偏见与群体智能之间的关系。
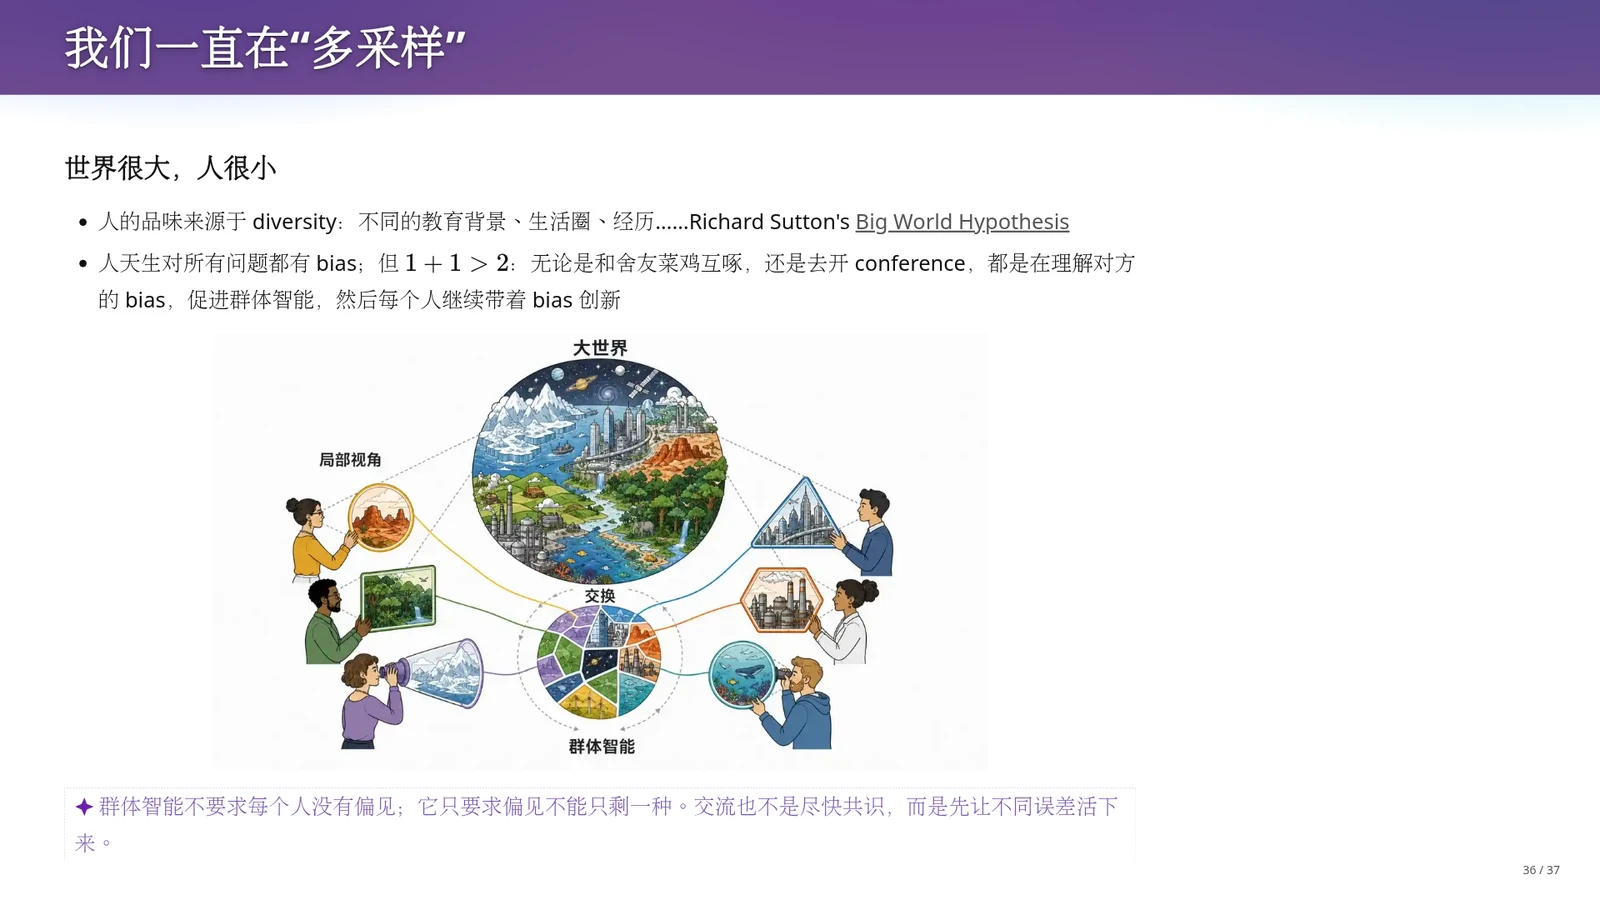
从计算与认知的双重视角来看,多样性有着明确的来源与价值。根据萨顿的《大世界假说》,客观世界极其庞大复杂,而任何单个智能体或人类的认知容量都极其有限(世界很大,人很小)。每个人的品味与认知都受限于各自成长的城市、教育背景、生活圈与经历,天生对所有问题都带有偏见(bias)。然而,无论是在大学宿舍里和室友“菜鸡互啄”,还是去参加学术会议(conference)听同行提问,交流的核心价值都在于理解对方的偏见并发现自己的默认前提,从而实现 1 + 1 > 2 的群体智能,之后每个人再继续带着更新后的偏见去创新。
讲义提醒我们,群体智能并不要求每个个体完全消除偏见,它只要求群体中的偏见不能坍缩成同一种;交流的目的也不是为了尽快抹平差异达成表面共识,而是先让不同的误差与视角存活下来,形成互补。把这个思想带回软件工程 Agent 的编排:当我们增加计算资源时,关键在于如何通过不同的上下文设定、背景假设与反方视角来增加探索轨迹的差异度,而不是仅仅打开十个相同的对话框去重复采样同一条高概率思路。
算力成为生产资料:关于未来分化的审慎追问
当我们将“分区枚举扩宽覆盖率”与“多智能体审查提高分辨率”结合起来时,实际上建立了一个将计算资源(Token 消耗)直接转化为探索能力与判断质量的工程飞轮。如果这种“算力换智力”的机制在长程高价值问题上持续奏效,未来的社会与工程生态将面临怎样的挑战?结合斯坦福 AI 指数报告的数据,我们需要思考算力分配带来的长远影响,以及学习者当下的行动落脚点。
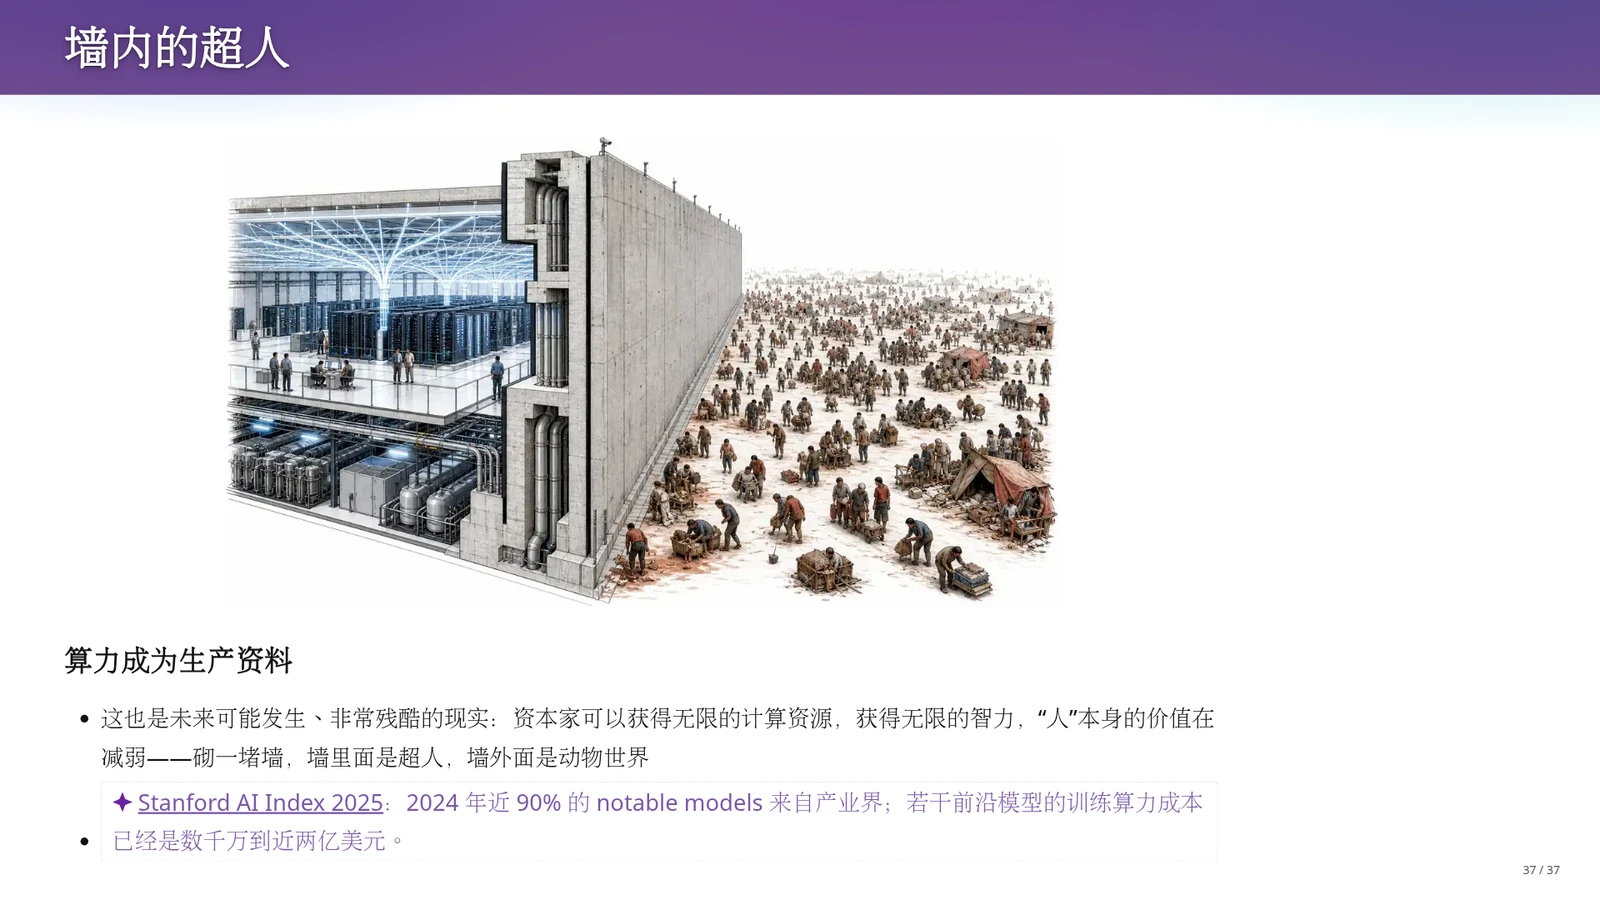
课程最后提出了关于算力集中化风险的追问。课件引用了《Stanford AI Index 2025》的统计数据:2024 年近 90% 的重要模型(notable models)来自产业界,而若干前沿大模型的单次训练算力成本已经攀升至数千万到近两亿美元。当算力真正成为核心生产资料时,掌握海量计算资源的组织或资本能够持续通过大规模并行搜索与验证获取远超普通个体的智力产出。课件以“砌一堵墙,墙里面是超人,墙外面是动物世界”的尖锐比喻,表达了对算力鸿沟可能演变为智力鸿沟、进而削弱普通个体价值的深切担忧。
“墙内超人与墙外动物世界”是对算力高度集中未来可能性的追问,并非已经发生的终局。面对这一潜在趋势,我们可以从眼前的具体任务开始改变做事方式:不要停留在围观或焦虑中,而是从眼前的具体任务开始改变做事方式——把脑海中模糊的愿望改写成可检验的规格表达,把每一次成功与失败的经验沉淀为可复用的分层 Skill,在面对未知探索时主动用分区枚举扩展方向,并始终用客观证据筛选结果。
宽度扩展公式:覆盖率与评估分辨率的乘积
在开放式探索任务中,增加算力投入并不自动等于提升最终方案的质量。测试时扩展(test-time scaling)在宽度维度上的有效运作,依赖两个缺一不可的齿轮:一是先通过维度划分与独立采样扩大候选池的“覆盖率”,迫使搜索进入低概率尾部;二是通过核查出处、反方挑刺等严密标准提升筛选器的“评估分辨率”。若只有生成没有高分辨率评估,算力只会制造海量噪音。
课堂提示:为什么多智能体不能一开始就互相看答案?
在取名或论文审稿等多智能体(sub-agent)工作流中,如果让各个子智能体从一开始就共享同一个生成历史或初始印象,自注意力机制会迅速被先出现的文本锚定,导致后续智能体只是在给第一个答案做同义润色。正确做法是先将探索空间切割为互不重叠的子区域,让各子智能体在隔离的上下文中独立完成采样或初审,最后再汇总交由反方智能体交叉质询。
易错点:多开相同提示词窗口不等于有效探索
初学者常误以为“用算力换宽度”就是把同一句“帮我设计几种架构方案”复制到十个聊天窗口里并行运行。由于模型固有的概率偏见(bias)和满意化倾向,十个相同上下文的窗口极大概率会在同一处概率高峰停步,把一个平庸答案变成十个同质化的“AI 时代子涵”。此外,人工设定的探索维度(如典故、音韵、时代感)并不天然正交,必须靠显式边界约束与差异化验收标准才能真正撑开探索空间。
术语消化:不确定性探索中的核心概念与工程机制消化
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 满意化(Satisficing) | 解释模型为何在开放提问下过早停止搜索并给出平庸方案 | 受后训练“尽快交卷拿奖励”驱动,模型一旦在高概率区找到满足数量要求的合理答案即停机,遗漏低概率尾部的最优解 |
| 测试时扩展宽度维度(Width Test-Time Scaling) | 打破单一路径思维链的局限,覆盖更广阔的未知解空间 | 不沿单一路径无限追加推理步数,而是通过人工划分互不重叠的子空间,派发多个子智能体并行独立采样 |
| 评估分辨率(Evaluation Resolution) | 防止并行枚举将“一个平庸答案”膨胀为“一百个平庸答案” | 在生成候选后引入专门的核查脚本与反方挑刺智能体(如查重名、核对典故、听谐音),与覆盖率共同决定最终选择质量 |
| 大世界假说(Big World Hypothesis) | 阐述个体认知局限性以及为什么探索需要保留多样性与不同偏见 | 世界远大于任何单个个体或模型的容量;工程上通过组合不同背景假设与独立视角,让不同误差相互碰撞补充以形成群体智能 |
该经验关系式用于指导开放式探索任务的上下文工程设计:覆盖率(Coverage)衡量多智能体通过维度划分与独立采样触达低概率尾部解空间的范围;评估分辨率(Evaluation Resolution)衡量验收标准、事实核查与反方审查区分优劣方案的精细程度。适用条件为不存在唯一标准答案、需要通过测试时扩展(test-time scaling)从海量候选中筛选高质量设计的探索型任务;若任一因子趋近于零,单纯堆叠算力无法提升最终产出质量。
本章小结
本章将上下文工程从确定性执行推进到开放式探索。
- 受强化学习奖励机制影响,直接要求模型提供几种方案会陷入“满意化”偏见。
- 要实现算力换智力,必须通过空间划分与子智能体独立采样提升覆盖率,并配合反方审查提升评估分辨率。
- 面对“世界很大、人很小”的局限与未来算力集中化的潜在挑战,学习者应当从当下行动起来:将模糊意图化为可验规格,把成功经验沉淀为分层 Skill,用分区枚举与客观证据驾驭智能体。
总结与延伸
纵观本讲,驾驭软件工程 Agent 的核心方法论可以归结为四个工程支点:看清上下文全局与执行边界、用可验证规格定义“完成”、顺应注意力机制沉淀分层方法,以及在长程与开放任务中合理调度人类精力与机器算力。
首先,在系统机制层面,外围 Harness 负责编排消息与规则匹配,模型负责理解自然语言语义并提议动作,而操作系统沙箱仅限制具体底层操作;自然语言提示词本身不是权限边界,也不能保证指令优先级,模型的自述更不能替代对配置、源码与实际行为的核验。
其次,在日常开发与学习中,AI 压低了启动尝试的边际成本,学生可以通过“合上资料自我解释—让 AI 追问找反例”建立费曼学习飞轮;而在工程交付中,必须用具体的规格(Spec)与客观验收器 \(V(\tau)=1\)(涵盖显式失败契约)压缩 Intent \ensuremath{\rightarrow} Spec \ensuremath{\rightarrow} Impl 的乘积级漂移,清醒认识到未说明之处虽不等于正式授权高影响动作,却会把产品决定交给模型的高概率默认模板。
再次,单步计算有限的模型依靠思维链将上下文当作草稿纸换取深度,但通过机械形式检查(如藏头诗或同音文)并不等于具备文学或工程品味,且规则会争夺有限的有效注意力。面对高密度材料(如论文审稿)的锚定效应,需通过判据驱动、证据审计与反方复现等独立路线对齐人类知识边界,并将有效策略蒸馏为常驻层精简、细则按需加载的 Skill。
最后,本讲将第一讲的“意图—规格—实现”框架推向长程闭环与后续课程的工程实践:理解了“代码库本身也是提示词”,就能明白为何成熟系统的局部一致性有助于引导生成,而开放研究(如符号执行优化)若缺乏局部可归因反馈与可证伪假设则易陷入奖励黑客。在协作中,工程师应按“不可逆性 \(\times\) 爆炸半径”把注意力留给接口与不变量,用测试与 CI 机制替代自然语言记忆以提升全天吞吐量;而在开放探索中,则需通过显式空间分解与多智能体独立采样打破“满意化”偏见,用覆盖率与评估分辨率将算力真正转化为探索质量。
学习练习
用下面的延伸练习检查自己能否应用本讲方法。
练习 1:上下文解剖与行为交叉核验实验
在本地开源 Agent 框架(如 pi 或同类可配置 Agent 工具)中设置全局与项目两级 AGENTS.md(例如加入特定回复格式、固定总结小节或低风险行为标记),先让 Agent 分类总结其看到的完整上下文与遵循计划;随后修改其中一条持久规则或安全审批配置,设计一次真实工具调用任务,对比模型自述与修改前后的实际执行行为差异。
验收标准:
提交一份实验记录,包含:
- (1)模型按“目标与交付物、权限与安全、工作流与工具协议、持久规则与风格、环境事实与证据”五类输出的遵循计划;
- (2)对应的真实配置文件内容与工具调用日志;
- (3)至少一处通过修改配置或提示词引发实际行为改变的对照证据,并明确区分“模型自述”与“Harness/OS 真实执行机制”。
练习 2:个人主页或小型前端组件的去“AI 味”规格重构
任选一个包含交互逻辑的页面(如个人学术主页或命令行风格作品集),先用一句含糊的形容词提示词(如“现代、专业风格”)生成 Baseline 版本;接着编写一份包含明确颜色、字体、栅格留白、交互状态、响应式不变量及“显式失败报告契约”的 Spec,并配套编写自动化检查脚本(如 DOM 结构、计算样式 background/opacity 或端到端交互检查),驱动 Agent 迭代实现。
验收标准:
旁观者仅凭提交的 Spec 文档与自动化检查脚本运行输出,无需主观猜测即可逐项判定产物是否通过;
对比 Baseline 与重构版,重构版需100%通过脚本检查,且当故意注入一处破坏性约束(模拟无法满足的条件)时,Agent 能按契约报告未完成状态、阻塞点与已尝试路径,而非编造成功总结。
练习 3:抗锚定多路线审阅与分层 Skill 提炼
选取一篇计算机领域的公开学术论文或一章高密度技术文档(如操作系统虚拟内存或编译器链接章节),设计三个相互独立的 sub-agent 任务分别执行“判据驱动”、“证据审计(建立 claim \ensuremath{\rightarrow} evidence \ensuremath{\rightarrow} assumption \ensuremath{\rightarrow} 替代解释 账本)”与“反方复现(寻找最小反例或推翻条件)”,最后汇总分歧并将该流程打包为一个分层 SKILL.md。
验收标准:
交付物包含:
- (1)三条路线在汇合前各自独立生成的原始记录,其中证据审计账本需至少覆盖 3 个核心主张并指出未验证假设;
- (2)汇总后的分歧对比报告;
- (3)分层设计的
SKILL.md,其常驻元数据与核心规则不超过 30 行,范例与细则采用按需读取结构,且不包含依赖自然语言劝诫代替机械检查的冗余禁令。
拓展阅读
下面列出本讲的原始讲义、课件和相关项目,便于回看案例、查阅代码并继续实践。
- 官方讲义:https://jyywiki.cn/GSE/2026/lect2.md
- 官方课件:https://jyywiki.cn/GSE/2026/slides2.html
- 社区字幕校订稿(固定版本):https://github.com/NinZeige/NJU-2026-GSE-Captions/tree/0456f3a46fd5fa2f2a86123e02b7ed48696adacb
- 原课程许可 CC BY-NC 4.0:https://creativecommons.org/licenses/by-nc/4.0/
- Better Language Models and Their Implications (GPT-2, 2019):https://openai.com/index/better-language-models/
- Prompt Programming for Large Language Models: Beyond the Few-Shot Paradigm (2021):https://arxiv.org/abs/2102.07350
- Pre-train, Prompt, and Predict: A Systematic Survey of Prompting Methods in Natural Language Processing (2021):https://arxiv.org/abs/2107.13586
- Self-Explanations: How Students Study and Use Examples in Learning to Solve Problems (1989):https://doi.org/10.1207/s15516709cog1302_1
- Test-Enhanced Learning: Taking Memory Tests Improves Long-Term Retention (2006):https://www.psychologicalscience.org/journals/psychological-science/j.1467-9280.2006.01693.x/
- Codex Rules Documentation:https://learn.chatgpt.com/docs/agent-configuration/rules
- Agent Approvals & Security Documentation:https://learn.chatgpt.com/docs/agent-approvals-security
- NVD - CVE-2025-54558:https://nvd.nist.gov/vuln/detail/CVE-2025-54558
- The Longitude Acts (Royal Observatory Greenwich):https://www.royalobservatorygreenwich.org/articles.php?article=1311
- 一句话生成极品飞车演示 (Arena Site):https://019f6b8d-821e-7c15-98ab-16f3bd7f7409.arena.site/
- The Charge of the Light Brigade Original Order (National Army Museum):https://collection.nam.ac.uk/detail.php?acc=1962-11-4-3
- 默认“现代风格”生成主页示例:https://jm233333.github.io/
- 蒋炎岩个人主页 (终端风格示例):http://jiangyy.github.io/
- No Silver Bullet — Essence and Accidents of Software Engineering (Brooks, 1986):https://www.cs.unc.edu/techreports/86-020.pdf
- Lost in the Middle: How Language Models Use Long Contexts (TACL 2024):https://aclanthology.org/2024.tacl-1.9/
- Paradoxical Effects of Thought Suppression (White Bear Effect, 1987):https://doi.org/10.1037/0022-3514.53.1.5
- Anchoring Effect Reference (PubMed):https://pubmed.ncbi.nlm.nih.gov/17835457/
- Mastering the Game of Go without Human Knowledge (AlphaGo Zero, Nature 2017):https://doi.org/10.1038/nature24270
- RepoCoder: Repository-Level Code Completion Through Iterative Retrieval and Generation (EMNLP 2023):https://aclanthology.org/2023.emnlp-main.151/
- CodeRAG-Bench: Can Retrieval Augment Code Generation? (NAACL Findings 2025):https://aclanthology.org/2025.findings-naacl.176/
- Ironies of Automation (Bainbridge, 1983):https://doi.org/10.1016/0005-1098(83)90046-8
- KLEE: Unassisted and Automatic Generation of High-Coverage Tests for Complex Systems Programs (OSDI 2008):https://www.usenix.org/conference/osdi-08/presentation/klee-unassisted-and-automatic-generation-high-coverage-tests-complex
- Toyota Production System (Jidoka):https://global.toyota/en/company/vision-and-philosophy/production-system/
- Rational Decision-Making in Business Organizations (Herbert Simon Nobel Lecture, 1978):https://www.nobelprize.org/prizes/economic-sciences/1978/simon/lecture/
- The Big World Hypothesis (Richard Sutton):http://incompleteideas.net/papers/The_Big_World_Hypothesis.pdf
- Stanford AI Index Report 2025: Research and Development:https://hai.stanford.edu/ai-index/2025-ai-index-report/research-and-development