第 7 讲:需求和架构 (2):从驾驭复杂性到显式数据依赖
导读
在上一讲中,我们从十行汉诺塔、两万行二维码工具到五十万行教务系统,看到了软件架构无处不在。即便逆向整理出了一份详尽规范的需求说明书,如果只是“脑子一热”直接选定数据库并照单全收地编码交付,系统往往从诞生之初就会背上沉重的技术债。从模糊的客户意图(Intent)到规约(Spec)再到实现(Impl),每一步未经确认的假设都会引发目标漂移。
本讲将追问软件架构最核心的使命:当人类“小脑袋”的注意力极其有限、而未来的需求又处于开放变化中时,好的架构究竟在替我们做什么?我们将从 Brooks 对本质复杂性与附带复杂性的经典区分出发,重访《Structured Programming》的概念层次与《Growing a Language》中“设计解空间”的哲学;进而剖析 UNIX、关系数据库与 Internet 三大底层系统如何依靠通用接口与协作规则支撑起未曾预见的生态。
随后,我们将视线拉回教务与财务等具体业务系统,沿着“页面内嵌 SQL/JSP \(\rightarrow\) MVC \(\rightarrow\) MVVM/React 派生界面 \(\rightarrow\) Event Sourcing(事件溯源)”的演进脉络,揭示为什么仅靠切分模块和保存“当前状态”仍会在长周期、强规则业务中陷入数据静默损坏的泥潭,并最终阐明现代架构与生成式软件工程的关键跃迁——将“多份可变状态的一致性问题”转化为可重算、可测试、可审计的“显式数据依赖与计算正确性问题”。
机制总览
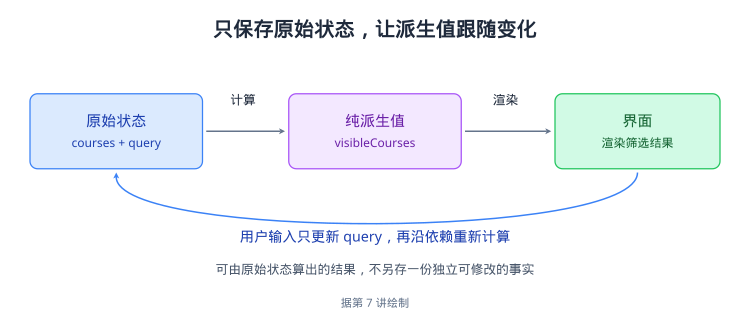
同一个事实若被复制成多份可独立修改的状态,就需要额外同步。把可计算的结果保留为派生值,可以缩小一致性问题。
读图:机制与适用边界
课程列表 courses 和查询条件 query 是原始状态,纯函数计算 visibleCourses,再渲染界面。用户输入只更新 query,随后重新计算与渲染,而不直接维护第二份筛选结果。
图描述状态依赖关系;Vue 可以用 computed 表达派生值,React 可以在渲染时计算。纯派生计算不应夹带扣费、发消息等外部副作用。
一、意图、规约与复杂性:需求与架构的职责边界
在上一讲中,我们从教务系统的需求泥潭出发,考察了从十行汉诺塔、两万行二维码生成工具到五十万行教务系统的演化过程。当软件规模不断膨胀、外部业务持续变化时,为什么最初看似清晰的客户意图,最终落到代码实现上却常常发生目标漂移?面对千头万绪的业务规则与技术细节,哪些困难是问题领域天然自带的,哪些又是程序员自己的实现方式额外制造出来的?本章将确立需求工程与软件架构各自的职责边界,剖析如何系统性地驾驭软件复杂性。
从意图到实现的目标漂移
在开发软件时,开发者往往以为拿到了明确的需求就能直接写出对应的代码。然而,从客户的真实想法到最终运行的代码之间跨越了多个认知层次。从意图到规约再到实现呈树状发散,每向下走一步都需要补充条件与选择方案,未经确认的隐含假设就会在这一过程中导致目标漂移。
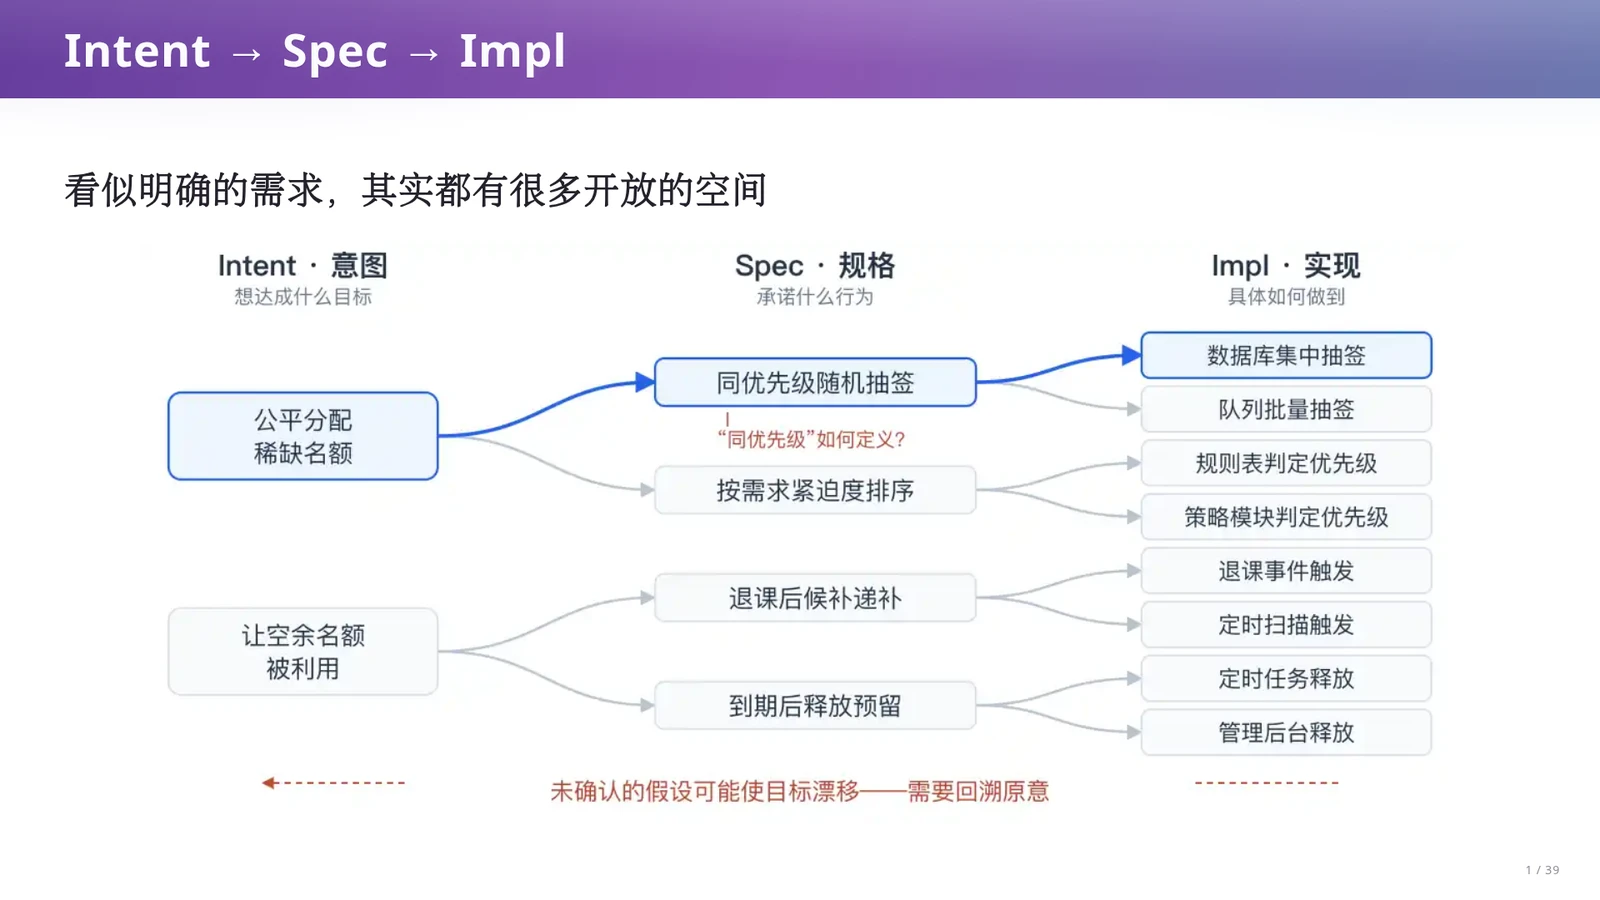
从意图(Intent,客户或用户想要达成的目标)到规约(Specification,简称 Spec,对系统外部行为与约束的精确描述),再到实现(Implementation,简称 Impl,具体的代码、数据结构与运行机制),每一步跨越都包含大量设计决策。
两个看似简单的意图,各自可以派生出多种规约方案;而每一种规约之下,又对应着多种具体实现。从意图到规约再到实现并不是一条唯一的翻译路径。
讲义用“让学生方便地选课”这一意图来具体说明这种发散:落到规约层,它可以被定义为先到先得、志愿排序或随机抽签等完全不同的机制;即便选定了其中一种规约,落到实现层仍有各种数据结构、模块划分与交互流程可供选择。如果在转化过程中,开发者对未指明的细节自行猜测并作出未经确认的决定,这些微小偏差就会逐层累积,最终造成严重的目标漂移。这正是我们需要跳出代码本身、审视全局架构的起点。
架构无处不在与技术债的起源
既然从规约到实现存在如此多的选择,那么无论程序大小,只要涉及模块划分与组织方式,架构决策就已经开始了。结合上一讲的三个不同量级的程序案例,思考为什么一个已经能够正常运行、甚至百分之百满足当前需求清单的系统,依然可能在日后陷入维护泥潭。
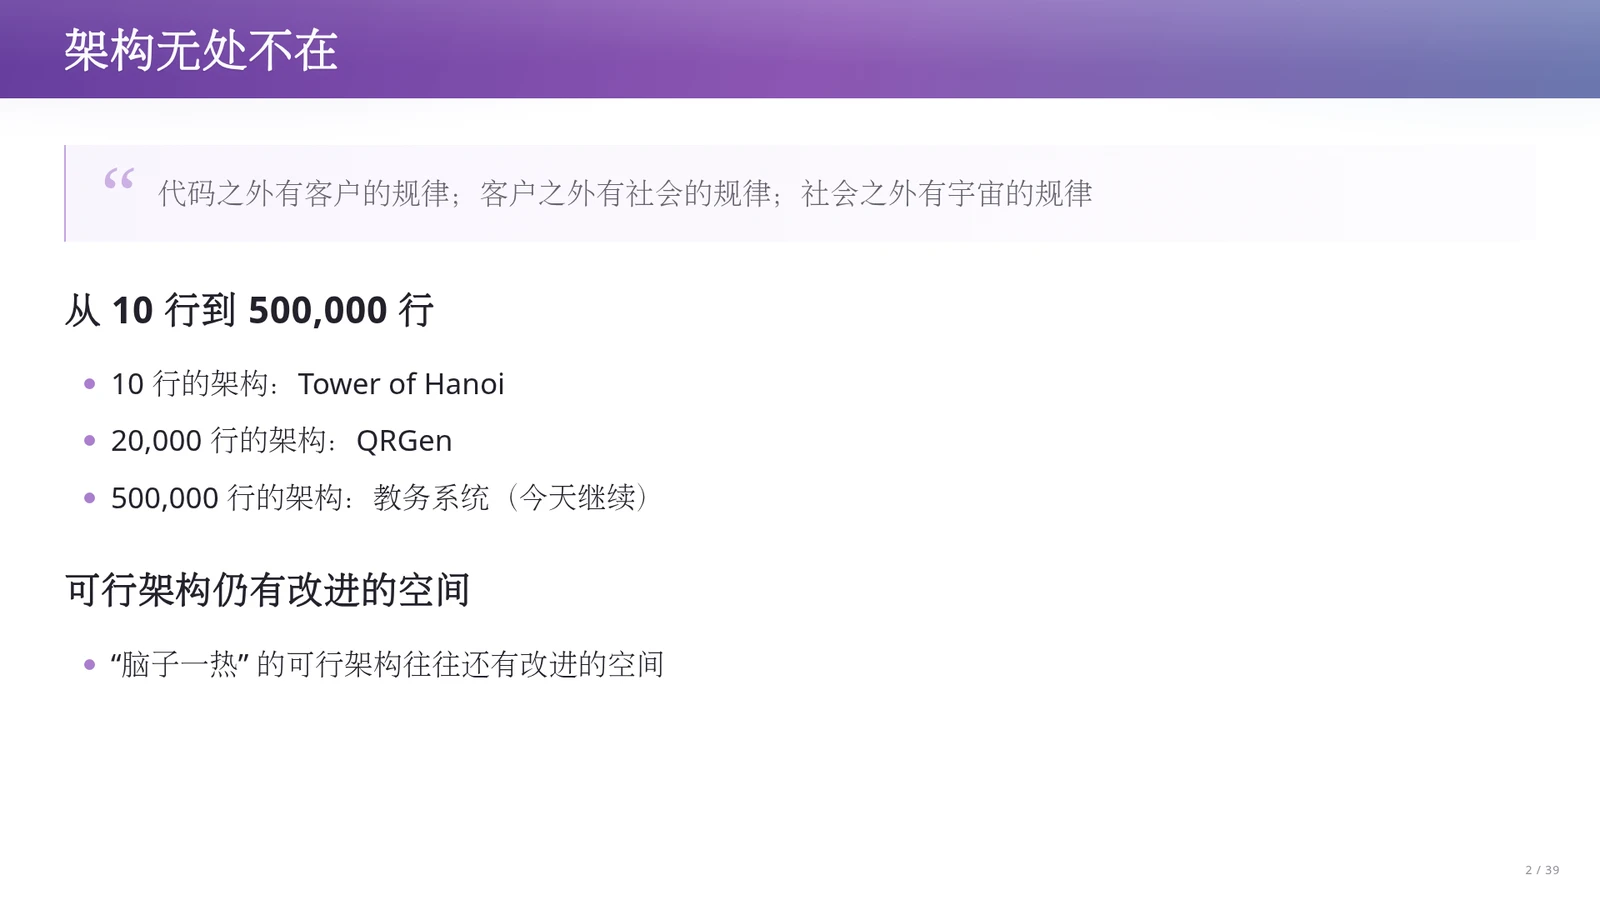
“代码之外有客户的规律;客户之外有社会的规律;社会之外有宇宙的规律。”跳出局部代码,往往能找到更契合的数学结构、成熟的业务规则或更高层的抽象。从 10 行代码的汉诺塔(Tower of Hanoi)、20,000 行代码的二维码生成工具(QRGen),到 500,000 行代码的教务系统,架构无处不在。哪怕是一个已经能够跑通需求的架构,如果只是“脑子一热”定下来的,往往还有很大的改进空间。
在课堂口述中,老师回顾了做实验时的常见做法:把逆向出来的教务系统需求直接复制给大语言模型,靠不断对话修改也能拼凑出一个百分之百满足当前需求的产品。但从拍脑袋定下数据库表结构和模块划分的那一刻起,系统就背上了长期的技术债(Technical Debt,即为了短期快速交付而采取次优设计所累积的后续维护与修改成本)。因此,面对可行的初步方案,我们必须先剖析系统复杂性的真正来源。
本质复杂性与附带复杂性
为什么五十万行的教务系统或大型业务软件总是让人觉得千头万绪?为了对症下药,我们不能把所有困难混为一谈。剖析复杂性,首先要区分哪些麻烦来自业务问题本身,哪些麻烦是我们在技术实现中额外制造出来的。
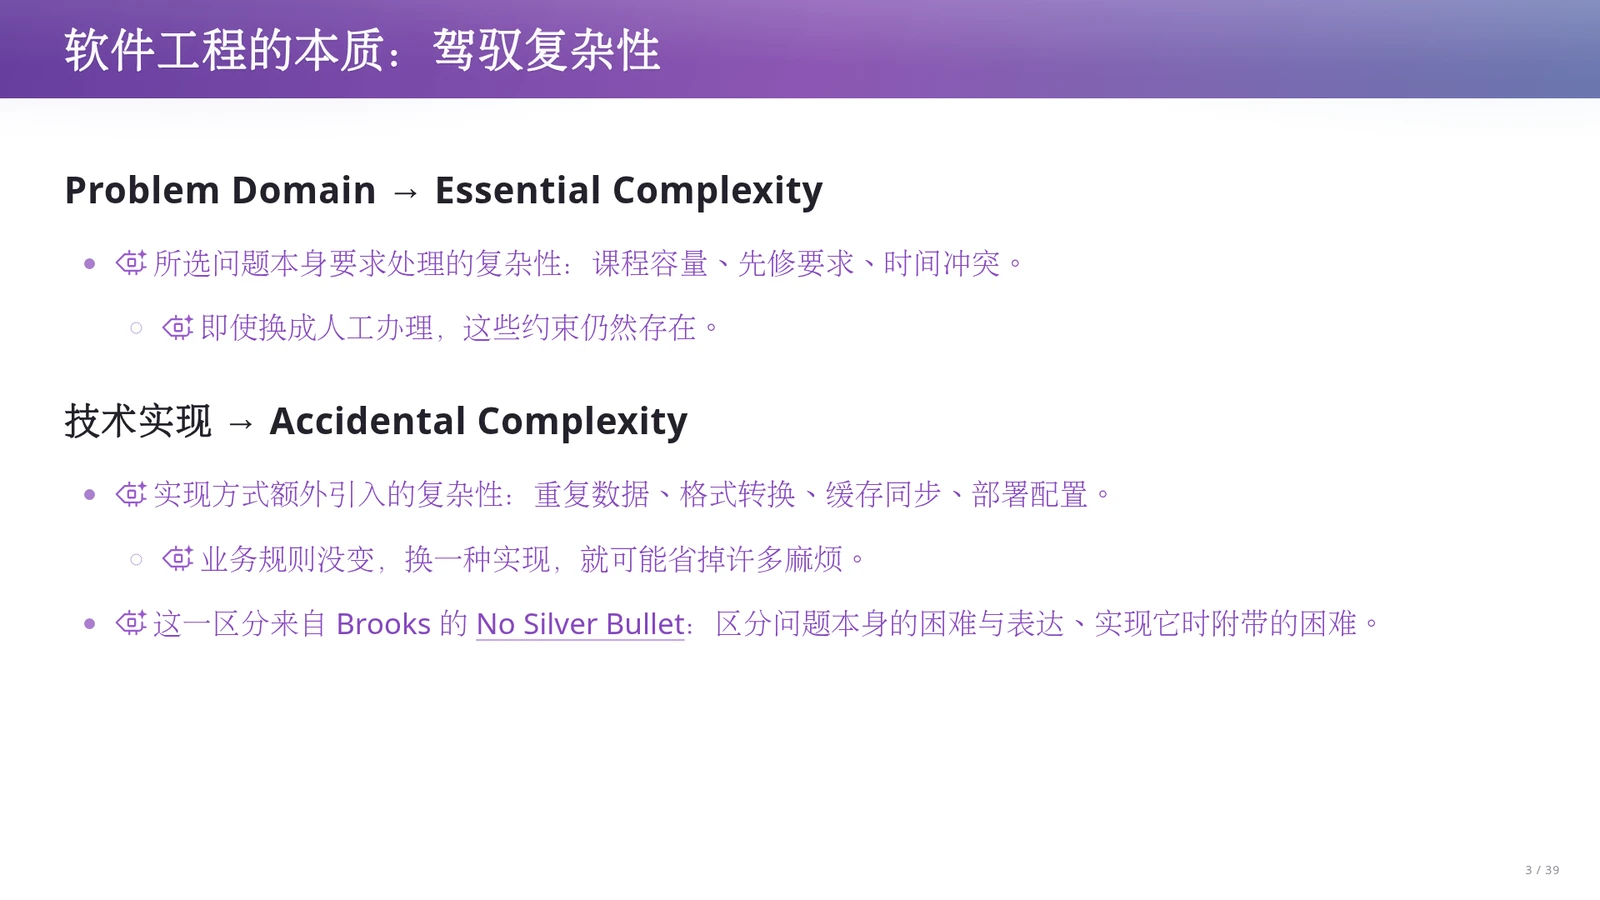
Fred Brooks 在论文《No Silver Bullet》中提出了两类复杂性的核心划分:本质复杂性(Essential Complexity,所选问题领域本身要求处理的固有复杂性)与附带复杂性(Accidental Complexity,在表达和实现软件时由技术手段额外引入的复杂性)。在教务系统中,课程容量限制、先修要求、时间冲突属于本质复杂性,哪怕完全不用计算机、改成人工拿纸笔办理,这些约束依然存在;而重复保存同一份数据、模块间的日期格式转换、缓存同步、部署配置等则属于附带复杂性,只要换一种实现方式,业务规则不变,却能省去大量麻烦。
讲义与课堂进一步补充了丰富的例子:在问题领域,除了选课规则,学生转专业后的学分认定、师生借用教室排课等,都是物理世界投影到信息世界时无法消除的本质复杂性。而在技术选型上,课堂对比了文件系统与数据库:直接用文件组织业务数据时,雖然方便组合命令行工具,但多文件并发一致性与原子性事务(Transaction,一组读写操作要么全部成功要么全部不生效的机制)通常要由应用额外设计,尽管理论上操作系统也能提供文件锁或原子重命名(rename)等原语;改用关系数据库直接获得了内建的事务保障,但在人工调试或让智能体调用时,又多了一层 SQL 查询转换的间接开销。既然两类复杂性成因不同,需求工程与架构设计就必须分工应对。
需求工程:收缩意图空间的代价与权衡
面对无法消除的本质复杂性,需求工程是第一道防线。如果客户只说一句模糊的口号,开发者或大语言模型就会胡乱猜测。但是,把需求规格说明书写得事无巨细、越长越好吗?请结合本页分析完善需求的正反两面效应。
需求工程的核心任务是直面本质复杂性,收缩意图空间(Intent Space)的不确定性。需求描述得越完备,留给实现者的歧义就越小。例如只说“课程容量 100 人”还不够,必须追问:候补学生算不算?跨院预留名额能否借用?特殊批准能不能突破上限?但需求管理也存在高昂代价:每增加一个需求点,就多了一份后续审计与核对的成本;在生成式软件工程中,这些条文还会直接转化为上下文长度、token 开销,以及模型在复杂约束下出错的风险。
课堂上,老师结合 grill-me 这一追问细节的技能插件和“登录功能”的例子做了生动展开:如果你只对模型说“我要登录功能”,它会随便猜一套注册加密码的方案;一旦做了密码登录,用户忘记密码怎么办?这就逼着你继续接入发短信或发邮件找回密码的服务。如果换成微信或支付宝第三方登录呢?虽然免去了密码管理,却可能需要注册企业实体、具备资质并缴纳费用。因此,我们需要在深度优先(先做最小可行产品 MVP 快速验证核心需求)与广度优先(在需求空间里审视全局方案与边界)之间取得平衡,避免盲目堆砌需求条文。
架构设计:分解复杂性与评估标准
当需求工程把意图空间收缩到合理的规约范围后,接力棒就交到了软件架构手中。既然架构不能让先修条件、课程容量这些业务规则凭空消失,它究竟靠什么本领来帮助我们驾驭复杂性?又该如何用一句最朴素的话检验架构的好坏?
架构设计承担着分解本质复杂性与减少附带复杂性的双重职责。一方面,它将容量、选课资格、时间冲突分开建模,使每一部分都能被单独理解;同时让前端页面、管理员补选和批量导入共用同一套规则接口,消除重复实现与口径不一。另一方面,架构通过明确模块职责、数据归属和接口约定,排除了规约与实现空间(Spec / Impl Space)中大量随意组合的可能性。检验架构好坏有一个很朴素的标准:需求改一处,系统里需要跟着改多少处?
课堂上还举了高校信息化的真实痛点作为对照:学校花了很长时间才把统一身份认证打通,让师生不必在每个子系统里重复填表;但财务系统由于包含极其繁杂的做账与审计领域规则,至今仍难与其他系统完全打通共享通知与数据。这正体现了分解本质复杂性与消除重复填表等附带复杂性的长期博弈。至此,我们明确了需求与架构的宏观边界;下一章我们将深入计算机科学的经典文献,看看前辈大师们是如何在人类有限的脑力下构造出层次分明、可生长的优秀架构的。
本质复杂性与附带复杂性的判定准则
判断一项复杂性属于本质还是附带,最直接的检验方法是“去计算机化测试”:假设完全撤销现有的软件系统,改为教务员用纸笔和算盘人工办理业务,课程容量上限、先修课资格审查、上课时间冲突检查、转专业学分认定等问题依然一个不少,这就是问题领域固有的本质复杂性;反之,因为同一个学生信息在五个模块存了五份而导致修改时必须同步四处、不同模块日期格式不一致需要来回转换,这些由软件组织方式制造出来的麻烦就是附带复杂性。
课堂提示:深度优先(MVP)与广度优先的需求探索
在收集与定义需求时,单一策略往往会顾此失彼。以实现用户登录为例,如果缺乏广度思考、直接按默认想法自建用户名密码体系,就会顺带掉进忘记密码、接入短信或邮件网关的泥潭;而改用微信第三方登录虽省事,却又受制于企业资质与接口费用。因此,实践中应当将广度优先(利用追问工具提前看清认证方式、页面布局等需求空间的分支代价)与深度优先(聚焦核心链路快速做出最小可行产品 MVP 以验证真实反馈)结合起来。
易错警示:切勿以为架构能消除本质复杂性或需求越长越好
初学者常犯两个认识错误:一是试图通过精巧的分模块或设计模式“消灭”本质复杂性,实际上业务约束不会因为分模块而消失,架构只能分解、隔离并复用它们;二是认为需求规格说明书写得越长、越细就越完美,忽视了每写下一条需求承诺,就多了一条在系统演进时需要持续检查、审计和维护的约束,在生成式软件工程中更会直接增加上下文长度、token 消耗以及大模型在多重复杂约束下顾此失彼的出错概率。
术语消化:需求与架构阶段的核心概念与职责对照
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 意图 / 规约 / 实现(Intent / Spec / Impl) | 刻画软件从模糊想法到最终代码的转化阶段,解释目标漂移的成因 | 每个意图可对应多种规约,每种规约又可对应多种实现;缺乏确认的中间假设会导致最终代码偏离原始意图 |
| 本质复杂性(Essential Complexity) | 界定问题领域天然存在的业务规则与约束难度 | 如选课容量、先修条件、时间冲突等,即使改为纸笔人工办理也无法消除;由需求工程直面澄清,由架构设计分解隔离 |
| 附带复杂性(Accidental Complexity) | 识别由技术选型与代码组织方式额外制造的工程麻烦 | 如一份数据存五份需到处同步、日期格式反复转换、规则复制到多个页面;通过改进架构、统一数据归属与接口来减少 |
| 需求工程(Requirements Engineering) | 消除客户原始想法中的模糊性与歧义 | 通过追问边界条件收缩意图空间的不确定性,但需在表达完备性与审计成本、上下文 token 开销之间取得平衡 |
| 架构设计(Architecture Design) | 防止规约与实现阶段出现随意拼凑和牵一发而动全身的泥潭 | 明确模块职责、数据归属与接口约定以收缩 Spec/Impl 空间;用“需求改一处,系统需跟着改多少处”检验其解耦效果 |
本章小结
本章从汉诺塔、QRGen 与教务系统出发,阐明了从意图(Intent)到规约(Spec)再到实现(Impl)的发散性转化过程。基于 Brooks 的理论,我们将软件复杂性划分为问题领域固有的本质复杂性与实现方式带来的附带复杂性:
- 需求工程负责直面本质复杂性以收缩意图空间,但需权衡审计与 token 代价;
- 架构设计则负责分解本质复杂性并减少附带复杂性,使系统在面对需求变更时只需局部修改。
二、尊重有限的“小脑袋”:结构化编程与概念层次
明确了软件架构的核心使命在于分解本质复杂性并削减附带复杂性之后,我们必须追问一个更为根本的认知问题:人类为什么如此迫切地需要架构?当一个软件系统从十几行增长到数十万行时,代码的增长并不是简单的重复堆砌,而是状态组合的指数级爆炸。人类大脑在任意时刻能够同时精确追踪的状态数量极其有限。如果试图依靠蛮力记忆去掌控全局,系统很快就会超出心智负担的极限。早在软件工程诞生初期,计算机科学的先驱们就已经深刻意识到了这一生理局限。本章将回到 1972 年的经典著作《Structured Programming》,剖析先驱们为人类这颗“小脑袋”锻造的思维辅助工具与程序组织层次。
直面人类注意力的物理局限
为什么需求一复杂,我们就必须谈论架构与分层?在动手切分模块之前,我们需要先确立一个认知基线:架构设计首先不是为了迎合机器的执行效率,而是为了迁就人类心智的物理瓶颈。随着程序规模扩大,状态组合数量迅速超出了人脑的工作记忆极限,必须依靠分层封装来保护有限的注意力。
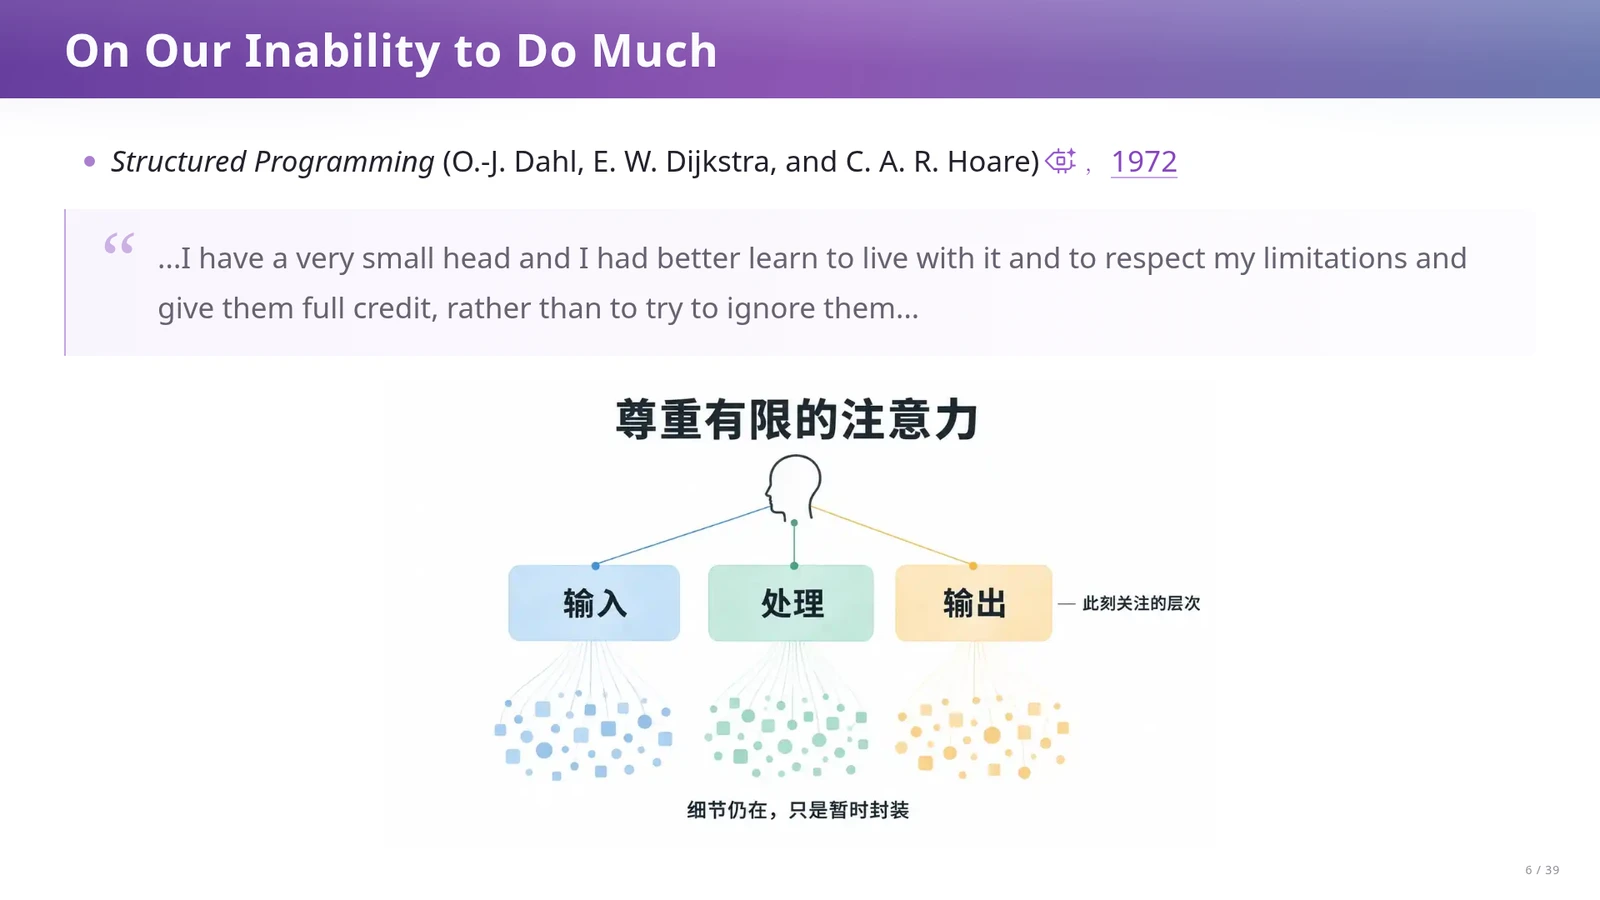
在 O.-J. Dahl、E. W. Dijkstra 和 C. A. R. Hoare 于 1972 年合著的《Structured Programming》第一部分“On Our Inability to Do Much”中,Dijkstra 坦言:我只有一个非常小的脑袋(very small head),最好学会尊重这一限制,而不是假装它不存在。
要迁就有限的注意力,在当前思维层级只需同时关注“输入、处理、输出”三个顶层概念,而将庞大的底层实现细节逐层封装在各层之下。
课堂提示将人类大脑形象地比作一个“参数有限、上下文窗口很小的模型”。你能在脑海中同时追踪 10 个状态,绝不意味着你能用同样的办法追踪 10,000 个状态。承认自己“脑袋小”绝非消极妥协,而是全部软件工程方法的起点。正是为了用有限的心智构造并检验庞大的系统,Dijkstra 紧接着总结了人类大脑赖以运作的三种核心思维工具。
三种思维辅助工具与“珍珠项链”
既然大脑无法一次性装下整个系统的全部细节,人类究竟靠什么机制去确信一个大程序是正确的?同时,当我们将系统切分成多个抽象层时,设计决策的先后顺序又会对系统的可维护性产生怎样的影响?下面来看三种思维辅助工具的作用,以及“珍珠项链”比喻如何说明设计决策的先后顺序。
Dijkstra 在《Structured Programming》第一部分提出了三种思维辅助工具(Mental Aids):枚举(Enumeration)、归纳(Induction)和抽象(Abstraction)。枚举帮助我们逐一检查有限的分支路径(如顺序与条件分支);归纳帮助我们用有限的步骤理解潜在无限的循环与递归过程;抽象则允许我们在调用一个操作时,只依赖它对外承诺的效果,而不必每次都展开其内部执行过程。在此基础上,书中提出了“珍珠项链(Necklace of Pearls)”的比喻:整个程序就像一串相互衔接的珍珠,每颗珍珠承载一项独立的设计决策,上层直接使用下层提供的概念;只要两颗珍珠提供相同的接口,就可以替换其中一颗而不影响其余部分。
讲义提醒我们,珍珠项链的精髓不仅在于“切分”,更在于设计决策的先后顺序。例如,如果过早地将一幅图像(image)在高层就解释为一行一行的像素表示(lines),那么项链中间的所有层级都被迫要理解“行”这个概念;相反,如果推迟这一表示决策,中间各层就能继续用纯粹的“图像”概念思考。表示细节传播得越远,未来修改时牵动的代码就越多。接下来我们看这种层次化思想如何在编程语言机制中落地。
对象抽象与控制流解耦:从子程序到协程
在《Structured Programming》的第三部分“Hierarchical Program Structures”中,Dahl 与 Hoare 将层次化分解的思想落实到了 SIMULA 语言机制中。除了把数据与操作打包在一起,程序片段之间的控制流往往也会产生严重的耦合。以“两个下棋程序互相对弈”为例,可以看到传统的子程序调用为什么会破坏对等协作关系。
精确的思考每次只能在少数几个元素之间进行。为此,SIMULA 引入了类与对象抽象(class/object abstraction):类描述一组相关对象的结构与行为,对象保存各自的状态,从而明确了“哪份数据和哪些操作属于同一个概念”。在控制流组织上,SIMULA 进一步区分了子程序(Subroutine)与协程(Coroutine)。书中第 4 节(pp. 184–185)提出了一个绝佳的例子:让两个下棋程序互相对弈。如果只用服从“调用—返回”关系的子程序,就必须强行规定谁是主程序、谁是子程序;而协程允许双方在执行中暂停,保留各自的局部状态和执行位置,并在需要时交替恢复执行。
课堂提示指出,许多同学今天在操作系统或 Go 语言中接触协程时,往往只把它看作一种为了高性能而实现的轻量级线程;但回到 1972 年的设计初衷,协程首先是为了应对软件复杂性、解除控制流耦合的建模工具。在对弈问题中,双方都要计算下一步、交给对方、等待回应再继续,强行把一方改写成另一方的子程序会让原本对等的合作关系变得极其别扭。用协程保留双方各自的程序主干,正是用语言机制保护概念结构的典范。
构建概念金字塔:借助 AI 精读经典
理解了类与协程的原语之后,怎样把它们层层搭建成解决复杂业务的系统?《Structured Programming》第三部分第 7 节展示了一个完整的概念层次(Concept Hierarchies)演进过程。在生成式 AI 时代,我们不仅要读懂这三层结构,还要学会如何向 AI 提出高质量的精读问题。这一节沿着从底层链表到上层车间调度的三层结构,展示如何逐层缩短问题与机器之间的距离。
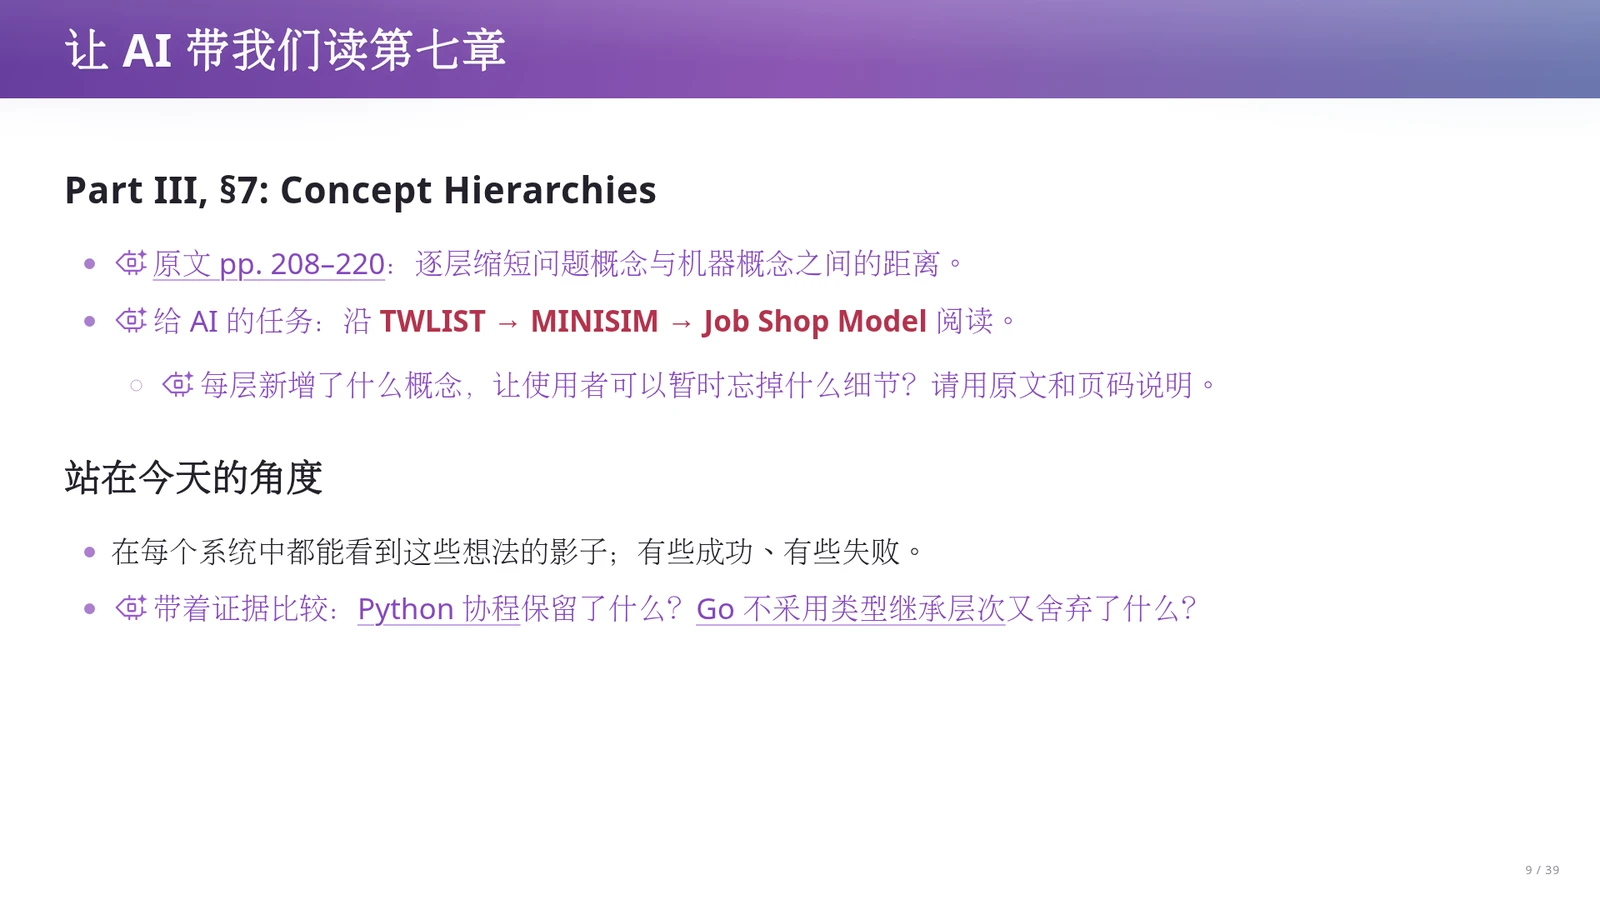
原文第三部分第 7 节(pp. 208–220)展示了程序如何逐层缩短“问题概念”与“机器概念”之间的距离。书中的案例沿着三条清晰的层次展开:最底层的 TWLIST 负责提供基础的双向链表指针操作;中间层的 MINISIM 在双向链表之上结合协程构造出离散事件模拟机制,负责管理模拟时间、进程等待与唤醒;最上层的 Job Shop Model 则直接使用中层机制,描述车间里的订单流转与机器加工。本页同时给出了站在今天视角下的延伸对比任务:带着原文证据去比较现代 Python 协程(PEP 342)保留了什么,以及 Go 语言选择不采用类型继承层次又舍弃了什么。
讲义提醒我们,在 TWLIST \ensuremath{\rightarrow} MINISIM \ensuremath{\rightarrow} Job Shop Model 的金字塔中,每向上一层,调用者就获得一套更贴近业务问题的词汇(如直接表达“请求一台机器,加工一段时间,再释放机器”),同时可以暂时忘掉底层的链表连接与时间队列细节。课堂提示强调,今天用 AI 读经典文献时,绝不能只让它泛泛总结“这本书很经典”,而必须要求 AI 给出对应代码和原文页码,明确回答:这一层新引入了什么概念?调用者因此不再关心什么?哪些越界操作会破坏底层的假设?这种构建概念层次并借助工具深挖本质的能力,将直接引出下一章关于“语言生长与解空间设计”的探讨。
把动态规划还原为可调试的“小架构”
课堂上老师结合算法竞赛(OJ)指出了一个常见痛点:两百行的动态规划代码一旦算错且不崩溃,往往比模拟题难调试得多。原因在于,我们在思考时处于“有向无环图(DAG)上的状态空间与无后效性迁移”这一高层抽象,写代码时却把它彻底扔掉,直接退化成了纯数学下标表示 dp[i][j][k] 和三重循环。如果在代码中重新引入 state 抽象,实现诸如 get(i, j, k) 的接口来显式返回所有合法的状态迁移,并将状态与迁移图可视化打印出来,确认逻辑无误后再改写为高效的数组形式,这同样是在用概念层次保护我们的“小脑袋”。
用 AI 精读经典文献的正确姿势
在 1980 至 2010 年的系统与编程语言黄金时代,诞生了大量奠基性的文献。过去受限于查阅门槛,读者看到教材脚注引用《Structured Programming》时往往只能一带而过;今天则可以把原书 PDF 直接交给大模型。有价值的阅读方式是从自身已有知识出发向外扩张:要求 AI 针对具体章节(如 pp. 208–220)指出原文页码与代码证据,核实每一层抽象隐藏了什么细节、暴露了什么原语,甚至在通勤时开启语音会话与模型反复追问,让经典设计真正融入自己的知识网络。
切勿将协程窄化为单纯的性能优化手段
现代工业界常把协程宣传为“切换与管理开销极小的用户态轻量级线程”,这容易让人忽略它在软件架构与程序结构上的核心价值。在 1972 年 SIMULA 的语境下,协程解决的是控制流的主从耦合难题:当两个或多个程序片段处于对等合作关系(如博弈对弈、编译器中词法分析与语法分析的交替配合、离散事件模拟中的多个并发实体)时,如果强行采用子程序的“调用—返回”模式,必有一方要被打碎成状态机。保留各自局部状态与执行位置的协程,首先是一种让代码结构忠实反映业务主体的抽象机制。
术语消化:《Structured Programming》中的核心复杂性分解机制对比
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 枚举、归纳与抽象(Mental Aids) | 人类大脑无法同时精确追踪大规模程序中的所有状态与执行路径。 | 用枚举检查有限分支,用归纳理解循环与递归,用抽象仅依赖操作承诺的效果而隐藏内部过程,构成架构分解的认知基础。 |
| 珍珠项链(Necklace of Pearls) | 设计决策顺序不当会导致底层表示细节向上层蔓延,增加修改代价。 | 将程序组织为一串相互衔接的抽象层,每颗珍珠封装一项独立决策;推迟具体表示决策(如推迟将图像解释为行)以实现信息隐藏。 |
| 类与对象抽象(SIMULA Class/Object) | 散落的数据与操作难以对应到问题领域的业务概念,心智负担重。 | 将相关的数据结构与操作打包定义为类,由对象保存各自状态,并支持通过前缀机制逐层搭建如 TWLIST 到 MINISIM 的概念金字塔。 |
| 协程(Coroutine) | 传统的子程序“调用—返回”模式迫使对等合作的模块分出主从关系,扭曲程序结构。 | 允许程序片段在执行中暂停并保留局部状态与执行位置,通过对等交替恢复实现控制流解耦,支撑下棋对弈与离散事件模拟等场景。 |
本章小结
本章从人类认知的物理局限出发,阐述了软件架构存在的根本理由:尊重我们参数有限的“小脑袋”。
通过回顾 1972 年《Structured Programming》的经典思想,我们学习了枚举、归纳、抽象三种思维辅助工具,理解了“珍珠项链”比喻中推迟表示决策、隐藏实现细节的重要性,并剖析了 SIMULA 如何利用类、对象与协程解除数据及控制流的耦合,沿着 TWLIST \ensuremath{\rightarrow} MINISIM \ensuremath{\rightarrow} Job Shop Model 逐层构建概念金字塔。
三、生长的语言与开放的解空间:架构设计的品味
上一章借助《结构化程序设计》中的珍珠项链比喻、类抽象与协程机制,说明了人类应当如何尊重自己有限的注意力,通过层次化抽象缩短问题概念与机器操作之间的距离。然而,静态地划分好当前的抽象层仍然不够:现实世界的软件需求始终处于变化之中,我们不可能在系统诞生之初就预见未来的全部功能。既然无法把未来的需求一次性写死,好的软件架构究竟在设计什么?当海量拼凑教程与低质生成内容充斥视野时,为什么阅读经典文献反而成为AI时代建立工程品味的必经之路?本章将从编程语言的设计哲学切入,探讨如何为开放的需求变化设计一片可生长的解空间。
命名、联想记忆与概念的封装
在探讨软件架构如何应对未来变化之前,我们需要先理解人类大脑究竟依靠什么机制在复杂系统中进行高层思考。如果我们每次讨论业务规则或系统交互时,都必须把底层的所有指针跳转、状态标志位和数据表字段重新展开一遍,有限的脑力很快就会耗尽。计算机科学家 Guy L. Steele Jr. 从人类的命名能力与联想记忆切入,解释了一个恰当的术语名称如何在架构中充当知识容器。
Guy L. Steele Jr. 在 SICP(《计算机程序的构造和解释》)前言中指出:人类非常擅长给事物命名,因为我们拥有强大的联想记忆(associative memories);看到一个名字,就能迅速唤起与之关联的整体概念。
在软件工程中,当程序员使用“事务”“队列”或“选课资格”这些名称时,实际上是在直接调用一整套已经理解过的约束与行为约定,不必每次退回到全部底层细节。
Steele 本人正是这些抽象工具的重要创造者:他与 Gerald Jay Sussman 共同设计了 Scheme 语言,撰写了《Common Lisp: The Language》,并作为合著者参与编写了《Java 语言规范》。他在 1998 年 OOPSLA 会议上的主题演讲《Growing a Language》进一步阐述了语言与架构的演化。
为什么一位深刻影响了Lisp与Java两大技术生态的语言设计大师,会把软件工程与语言演化的突破口放在“命名”与“生长”上?这是因为任何复杂的软件架构本质上都是在构建一套面向特定领域的词汇表。当我们把零散的操作提炼为“选课资格”或“原子事务”时,不仅压缩了沟通成本,更为后续的系统扩展确立了稳定的支点。顺着这一思路,我们将进入Steele在那场著名演讲中展示的语言生长实验。
《Growing a Language》:设计允许后人创造的模式
知道了好名字能够承载抽象概念,接下来的难题是:一套系统或一门语言的初始词汇表应该设计得多大?如果初始内置的概念太少,使用者连基本业务都难以表达;如果试图一开始就把所有可能用到的概念全部塞进标准规范,系统又会因为过于庞大且难以定义严密的形式语义而无法落地。Steele 在演讲中用一场“只准说单音节词”的实验,说明了为什么设计一种“允许后来者继续扩充的模式”比直接交付固定成品更有价值。
《Growing a Language》提出:设计一个具体的东西固然很好,但设计一种模式(pattern)可能更有价值,也更困难;我们应当把语言设计看作一种“用于设计语言的模式”,即用来制造更多同类工具的工具。为了直观展现这一困境,Steele在演讲开场进行了一场行为艺术:规定自己一开始只能使用单音节英语单词(如man),任何双音节或多音节词(如woman、machine、computer)在使用前都必须用已有的单音节词当场定义,或者通过已声明的构词规则生成。听众在漫长的铺垫中亲身经历了一个道理:必须先建立共同的词汇和构词规则,才能顺畅地表达复杂思想。课件下半部分指出,这种保留空位(slots)、允许后来者继续选择和演化的设计空间,凝聚了长程任务中的顶级智慧。Steele还引用了建筑师Christopher Alexander在《俄勒冈实验》中的观点:预先定死总体规划会夺走使用者塑造未来的机会;决定把哪些选择留给后来的人,本身就是一项核心设计。
课堂上进一步用几门具体的编程语言剖析了“小语言与大语言”的权衡困境。极端最小的图灵完备语言Brainfuck只提供纸带指针移动和加减判断等寥寥几个字符,虽然极易实现编译器,但人类根本无法阅读和维护;C语言贴近硬件、易于移植,却因缺乏运算符重载和泛型抽象能力,导致标准库中的qsort接口被迫使用缺乏类型安全的const void *指针,还要手动传入元素个数nmemb与单个元素大小size;而早期C++在引入模板机制后,部分开发者及Boost库又走向了过度滥用,写出了极其晦涩的模板代码。因此,Steele当时建议Java重点补充泛型、运算符重载和轻量级用户自定义值类型这三项元工具,正是为了让使用者能像内建类型一样自然地扩充语言词汇。
好的架构:固定协作规则,开放局部解空间
将编程语言“提供元工具与构词规则、允许使用者扩充词汇”的思想放回软件工程,我们就能回答本章开头的核心问题:当需求还在不断变化、未来尚未到来时,架构师究竟在设计什么?如果把软件开发仅仅当成照着当前需求清单逐条写代码,系统很快就会在后续的需求变更中崩溃。开放的需求空间与可演化的解空间,正是通过架构所规定的接口、约束与组合规则连接起来的。
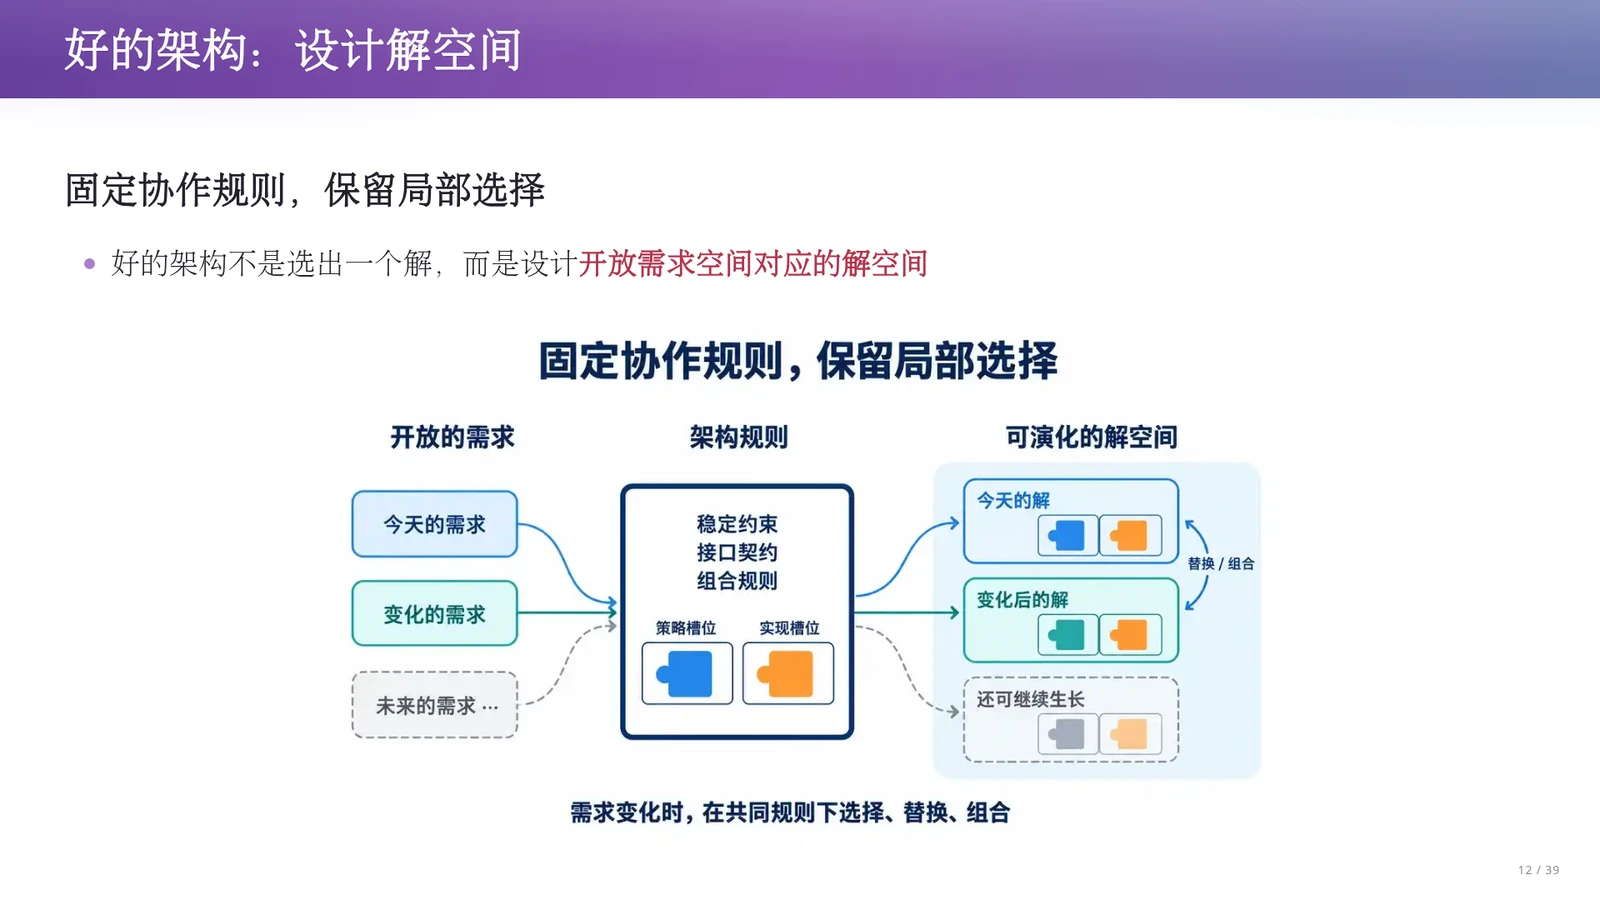
把语言生长的思想放回软件工程,就得到本讲的核心架构命题:好的架构不只是选出一个静态解,而是通过“固定协作规则,保留局部选择”,为开放的需求空间设计对应的解空间。持续演化的需求经过架构确立的约束条件、公共接口与组合规则,映射向一族可选择、可替换、可演化的具体解,在共同规则内部留出可供未来填入的空位(slots)。在这套机制下,架构师在今天确定的是数据交换的协议、模块的职责边界以及业务对象的交互接口;而在这些固定规则保护的局部空位内部,未来既可以增加新的处理步骤,也可以随时替换具体的算法或存储实现,而不会破坏系统的整体结构。
这种“面向解空间而非单一静态解”的设计思维,恰恰是许多计算机专业学生在长期刷在线评测(OJ)算法题时容易缺失的。课堂提示指出,OJ题目需求完全固定,代码只要通过测试数据就可以用后即扔,不需要考虑三个月后的需求变更,长期如此容易把人训练成不考虑扩展性的解题机器。而在真实的工程系统里,提供清晰的原语(primitives)和组合机制、让扩展本身成为一等公民,才能让一类未来的需求变化拥有合理的落脚点。那么,我们该如何培养这种划分固定规则与开放空位的判断力呢?这就要回到对经典的阅读与工程实践。
阅读经典建立品味与“算力换智力”的探索
既然优秀的架构需要在“固定什么规则”和“开放什么选择”之间做出高水平的权衡,开发者怎样才能获得这种被称为“架构品味”的直觉?在当今的技术环境里,搜索引擎与生成式模型每秒都在产出海量代码与教程,为什么许多开发者反而越来越难写出结构优雅的系统?面对海量低质内容的干扰,我们需要借助经典文献培养判断力,并把其中的思想转化为对自己系统的具体设计追问。
在快速发展的时代里,许多经典设计被掩埋,而拼凑粘贴的博客、把有用思想埋进生硬术语的“防自学教科书”以及大语言模型生成的 AI Slop(低质敷衍的生成内容),很容易让人停留在“能跑就行”的水平。阅读一手经典文献有助于建立工程品味。老师还在课堂上提出了“大学毁灭计划”的设想,反思现有教材体系的改进空间。要把经典读进自己的设计,每当审视一个系统时都可以追问两个问题:作者把哪些判断交还给了使用者?这些局部选择需要什么共同规则才能彼此兼容?
课堂上老师进一步展开了“大学毁灭计划”的设想:1970年至2010年是计算机系统、编程语言与软件工程的黄金时代,诞生了大量从零构建系统的开创性文献;今天完全可以借助AI工具,将这些经典文献中的原始知识拆解出来,根据学习者的认知网络重新串联生成个性化教材。这一思想也直接落实在课程实验(2)《Deeper Research》中:面对复杂问题,缺乏经验的求解者或Agent往往顺着第一个想到的方向深度优先(DFS)一路走到黑;而高品味的工程探索应当结合广度优先(BFS)与深度优先,将求解过程建模为一棵搜索树。通过把经典论文中的问题拆解、关键假设与验证方法提炼为引导Prompt,在持续维护的Workspace中执行“求解\(\rightarrow\)审查\(\rightarrow\)按反馈修改”的循环,用更高的计算预算(effort)探索设计空间、淘汰劣质方案,正是我们在AI时代用“算力换智力”、锤炼架构判断力的实战路径。
核心命题:好的架构设计的是一片解空间
面对充满不确定性的未来,架构师不可能提前猜中所有具体需求。好的软件架构不是针对当前需求清单给出一个僵化的单一解,而是为开放的需求空间设计一片对应的解空间(Design Space)。它通过制定清晰的数据格式、接口契约与组合规则,把系统各部分的协作方式固定下来;同时在规则内部保留可替换、可扩展的空位(slots),把局部选择权交还给未来的使用者与演化过程。
课堂提示:结合BFS与DFS的“算力换智力”循环
在实验(2)《Deeper Research》与日常架构设计中,切忌拿到需求就顺着第一个直觉写到底。优秀的求解策略会将问题建模为搜索树:先在设计空间中广度优先(BFS)采样多种架构或算法方向,再对有潜力的分支深度优先(DFS)推进。借助经典文献提炼的高层提问Prompt,让不同模型分别承担实现与严格审查(Review),在预算内迭代保留最优候选解,即可将算力优势转化为架构品味。
易错警示:保留扩展空间绝不等于不做约束或过度设计
理解“开放解空间”时,常犯两种极端错误:一是误以为开放就是不做任何限制,导致模块间缺乏共同约定而无法组合;二是走向过度设计,例如早期C++开发中滥用复杂模板元编程,用晦涩难懂的语法炫技掩盖业务本质。“固定共同协作规则”与“保留局部自由度”缺一不可——只有共同规则足够简单、严密且稳定,局部留出的空位才能安全地生长出多样化的功能。
术语消化:生长的语言与开放解空间核心术语表
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 联想记忆与命名(Associative Memory & Naming) | 人脑短期工作记忆有限,无法在思考高层业务逻辑时同时追踪所有底层实现细节。 | 通过为已验证的机制赋予精准名称(如事务、队列、选课资格),将复杂约束打包封装,使架构师能在更高抽象层级组合概念。 |
| 可生长的语言(Growing a Language) | 极小语言难以表达复杂领域需求,而预先包揽一切的大语言又因形式语义过于庞大而难以实现和演化。 | 提供核心原语、元工具(如泛型、轻量自定义类型)与构词规则,允许使用者在不破坏底层语义的前提下自行扩充词汇表。 |
| 解空间与空位(Solution Space & Slots) | 一次性写死的静态架构无法抵御需求变更,需求改一处往往导致全系统散落的代码跟着崩塌。 | 固定跨模块的协作规则与接口契约,同时在局部留下可延后填入或替换的空位(slots),让一类未来变化拥有清晰的落脚点。 |
| 算力换智力搜索树(Compute-for-Intelligence Search Tree) | 人类新手或Agent在解决复杂工程问题时,容易沿着首个直觉方案一条路走到黑,陷入局部劣质解。 | 将问题求解建模为包含求解状态(Solve State)的搜索树,结合BFS广泛采样与DFS深入验证,通过“求解-审查-修改”循环提升输出质量。 |
本章小结
本章从Guy L. Steele Jr.关于命名与《Growing a Language》的经典洞见出发,阐明了编程语言与软件架构的共通本质:好的设计不是只交付一个静态成品,而是打造一种允许后来者继续创造的模式。通过固定全局协作规则、保留局部可演化的空位(slots),架构得以将开放的需求空间映射为可生长的解空间。
面对快餐教程与 AI Slop 的干扰,精读一手经典文献并结合广度与深度搜索策略探索设计空间,有助于培养辨别“固定什么、开放什么”的工程品味。
下一章我们将通过UNIX、关系数据库与Internet三个工业级系统,检验这一原则在真实基础设施中的威力。
四、支撑通用应用的系统抽象:UNIX、关系数据库与 Internet
上一章我们确立了软件架构的核心准则:好的架构不是只选出一个静态解,而是为开放的需求空间设计一片可生长的解空间。那么,在计算机工业几十年的演进中,那些支撑了无数后来者创新的底层基础设施,究竟是如何践行这一准则的?本章将深入剖析 UNIX 操作系统、关系数据库与 Internet 三大经典系统,揭示它们如何通过定义通用接口、分离逻辑语义与物理实现、制定分层协作规则,在各自领域开辟出持续生长的应用生态。
UNIX 哲学与通用文本流接口
当系统需要提供大量小工具来应对千变万化的日常任务时,如果每个工具都使用私有的二进制格式通信,它们就会变成无法互操作的孤岛。UNIX 哲学的前两条原则并不难懂,而第三条“处理文本流”才是把独立工具连接成组合空间的枢纽。
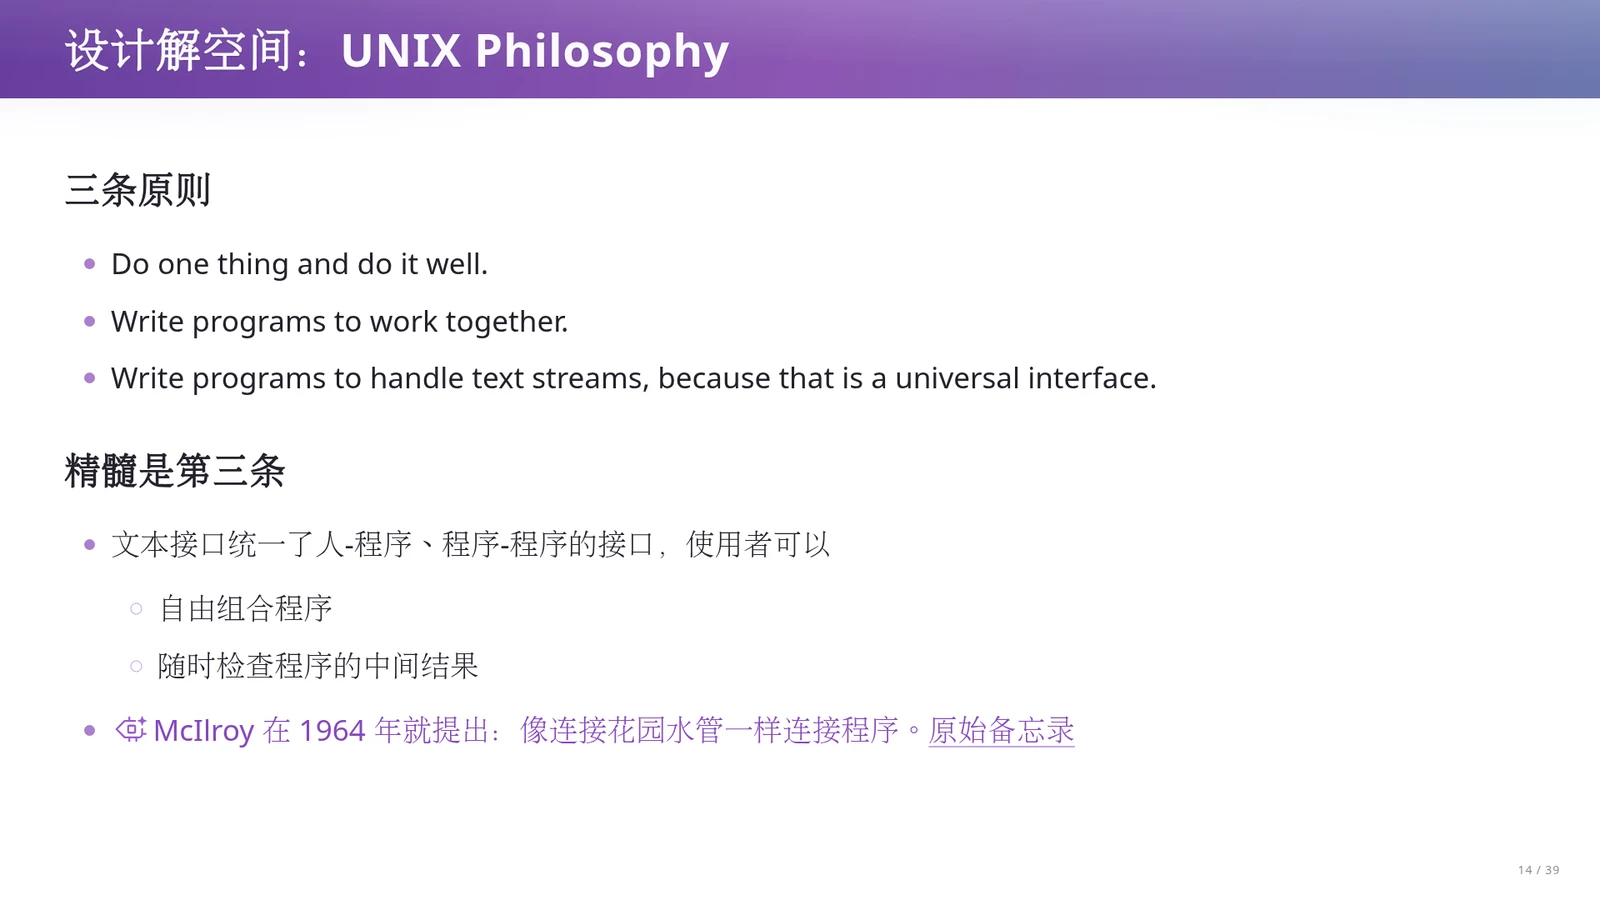
UNIX 哲学包含三条核心原则:
- 每个程序做好一件事(Do one thing and do it well);
- 让程序能够协作(Write programs to work together);
- 让程序处理文本流,因为文本是一种通用接口(Write programs to handle text streams, because that is a universal interface)。
讲义指出,前两条原则很容易得到赞同,但真正让它们落地的精髓在于第三条。文本接口同时统一了“人—程序”与“程序—程序”的交互方式。正如 Doug McIlroy 在 1964 年的备忘录中所设想的那样,我们应当能像连接花园水管一样把程序连接起来。
因为接口是人类可直接阅读的文本流,一个工具的输出既可以直接打印到屏幕供人查看,也可以写入文件,或者通过管道交给下一个工具继续加工。更重要的是,当一条复杂的处理流水线出现结果异常时,使用者随时可以在管道中间截断并检查前一步究竟生成了什么文本。这种对组合与中间检查的天然支持,使 UNIX 工具集超越了固定功能的软件,成为一片可自由拼接的解空间。
保护组合可靠性的公共约定
仅仅规定“大家都输出文本”还不足以让程序可靠地拼接在一起。如果一个程序把报错信息和正常数据混在一起输出,或者文件名里恰好带有换行符,下游程序就会解析出错。本页梳理了 POSIX 标准与社区实践如何通过细致的公共约定来守住文本接口的边界。
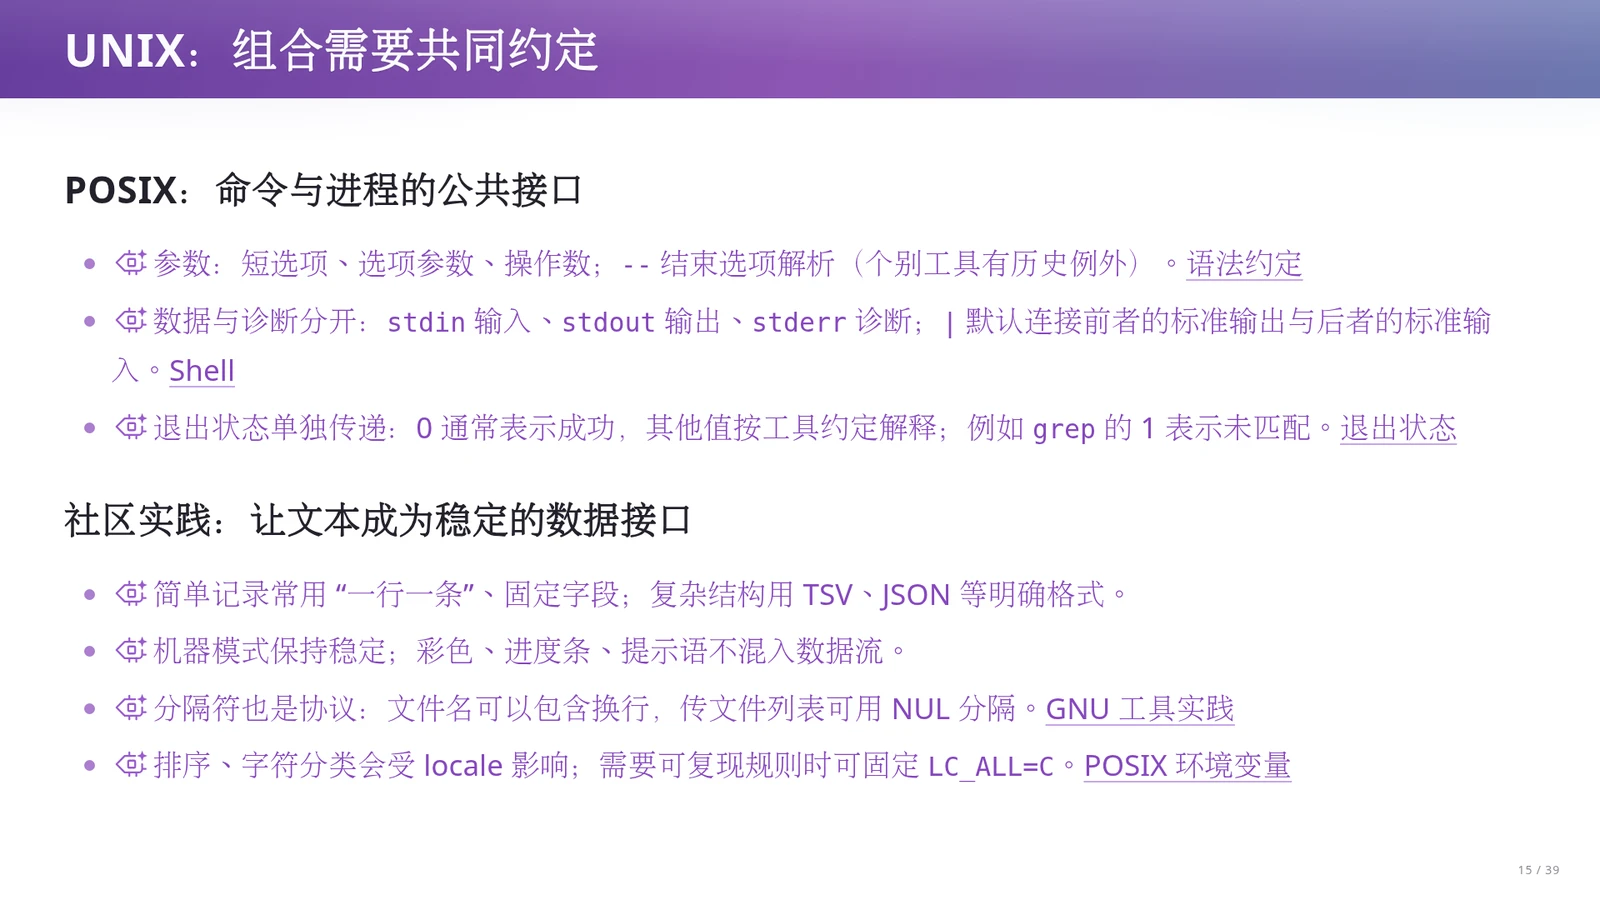
UNIX 的组合能力依赖两个层面的具体约定。在 POSIX 公共接口层面:命令行参数明确区分短选项、选项参数与操作数,并规定用 -- 结束选项解析(个别工具因历史原因保留例外);数据流与诊断流严格分离,stdin 负责输入、stdout 负责输出、stderr 负责诊断信息,Shell 的管道符 | 默认只把前一个程序的 stdout 连接到后一个程序的 stdin;进程退出状态码单独传递成败,0 通常代表成功,非 0 按工具约定解释(例如 grep 返回 1 表示未匹配到内容)。在社区实践层面:简单记录采用一行一条,复杂结构采用 TSV 或 JSON;供机器处理的输出不混入彩色控制符、进度条或提示语;面对可含换行符的文件名列表时改用 NUL 字符分隔;在需要可复现的排序与字符分类规则时,显式固定环境变量 LC_ALL=C 以消除不同地区语言环境(locale)带来的差异。
讲义提醒我们,这些看似琐碎的约定恰恰是在保护程序组合的可靠性。固定了参数解析、通道分离、退出码和分隔符协议后,任何一个新编写的工具只要遵守这套契约,就能无缝接入现有的成百上千个工具链中。接下来我们将看到,现代命令行工具是如何在这一契约之上继续拓展边界的。
设计者定规则,使用者创用途
几十年前的 UNIX 设计者不可能预见到今天的 Web API JSON 数据格式,也不可能预见到现代桌面窗口管理器的交互需求。现代命令行工具只要接入标准输入输出管道,就能把 JSON 解析、人的交互挑选与图形窗口操作都变成流水线中的一环。
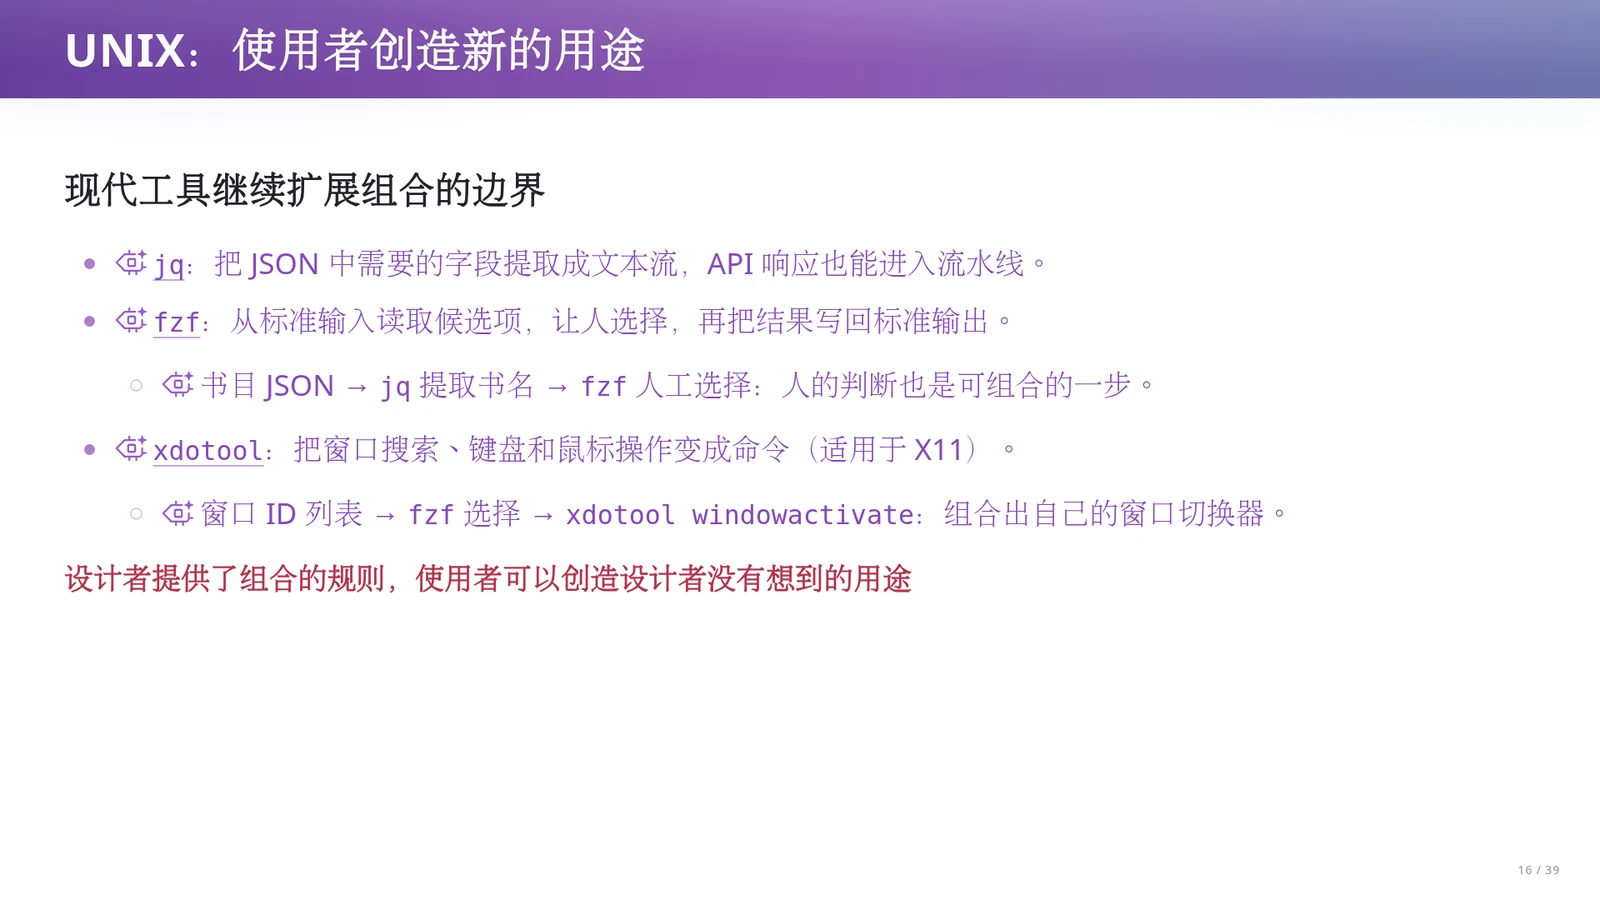
jq、fzf 与 xdotool 三个现代工具展示了如何利用 UNIX 规则扩展组合边界。第一,jq 能够解析结构化的 JSON 数据并将所需字段提取为纯文本流,从而让现代 Web API 的响应直接进入传统管道。第二,fzf 是一个交互式模糊选择器,它从 stdin 读取候选文本行,在终端界面里让人进行交互挑选,再把选中的结果写回 stdout。这样,“读取书目 JSON \(\rightarrow\) 用 jq 提取书名 \(\rightarrow\) 用 fzf 人工挑选一本”就构成了一条完整流水线,人的判断成了程序之间可组合的一步。第三,面向 X11 图形环境的 xdotool 把搜索窗口、模拟键鼠操作变成了命令行接口;将窗口 ID 列表送入 fzf 挑选后再传给 xdotool windowactivate,使用者就能自己拼装出一个窗口切换器。
老师在课堂上还现场演示了用一行命令把文件列表交给选择菜单、再将选中项传给 nano 编辑器打开,从而无需修改 nano 源码就为它定制了“打开文件”菜单。这些工具的作者都不必提前设计好每一种具体的书目管理、窗口切换或编辑器菜单功能。设计者提供组合的规则,使用者便可以创造出设计者从未想到的用途。
关系数据库与数据独立性
如果直接用文件系统和文本流管理大型业务数据,程序员就必须自己处理磁盘读写格式、索引维护和并发冲突;一旦数据规模膨胀需要修改底层存储结构,所有上层业务代码都会被迫重写。本页引入第二个经典系统抽象——关系数据库,探讨它如何切分数据的逻辑理解与物理组织。
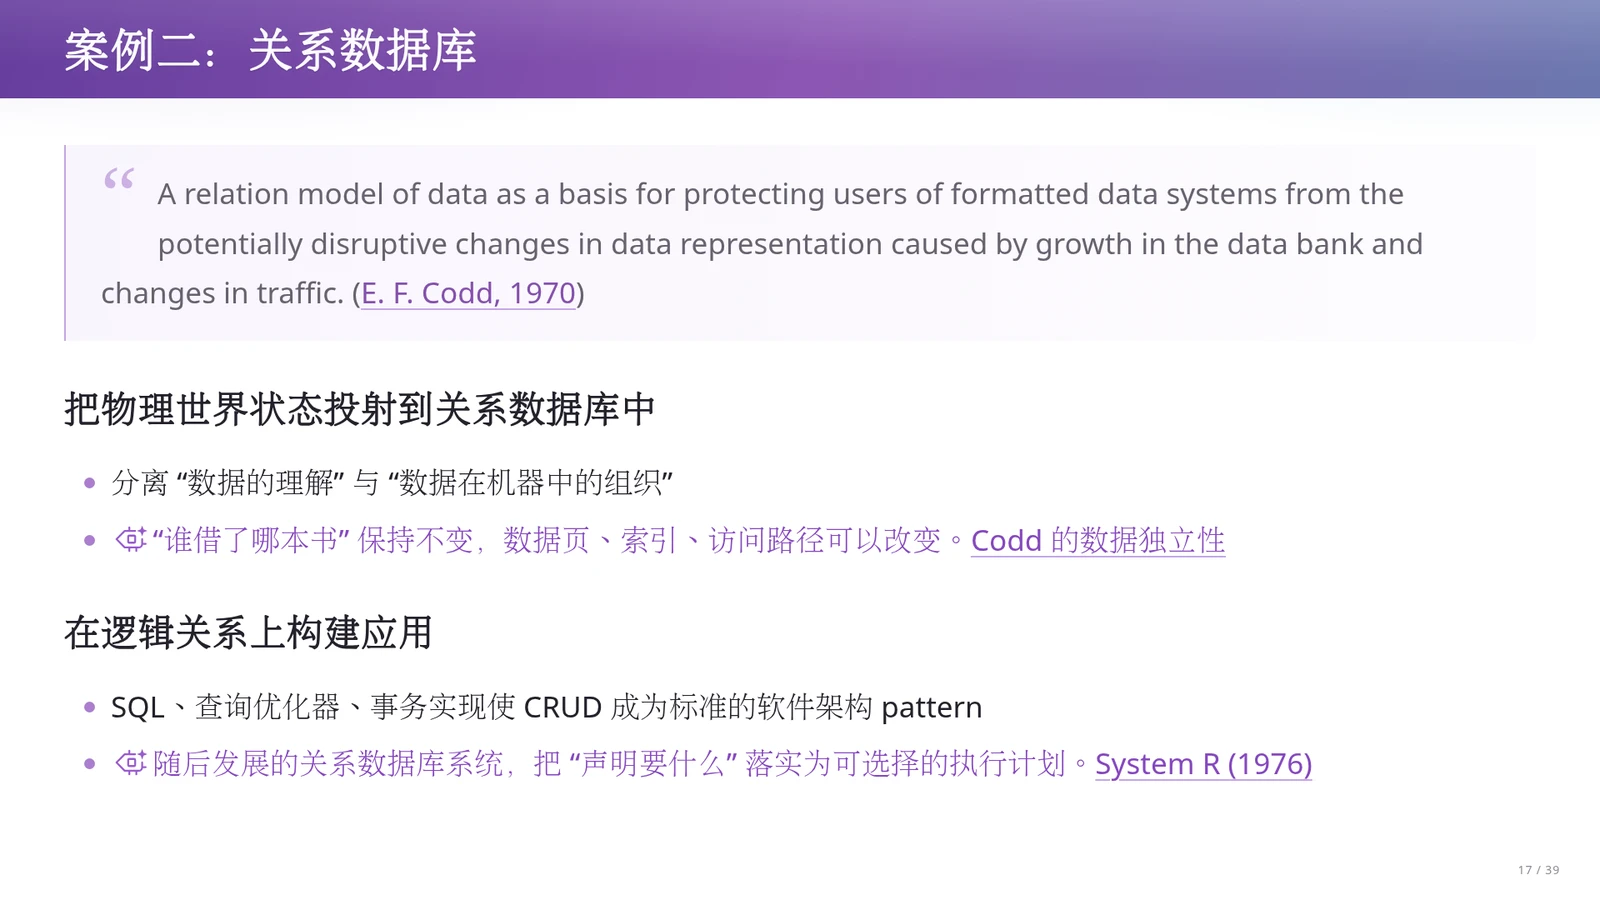
E. F. Codd 在 1970 年发表了论文《A Relational Model of Data for Large Shared Data Banks》。Codd 提出关系数据模型(Relational Model)的初衷,是保护格式化数据系统的用户,使他们免受因数据规模增长和访问流量变化所引发的底层数据表示变更的冲击。这一思想被称为数据独立性(Data Independence):把物理世界的状态投射到关系数据库中,严格分离“数据在逻辑上意味着什么”与“数据在机器中怎样物理组织”。在逻辑关系之上,后续以 IBM System R(1976)为代表的数据库系统发展出了结构化查询语言 SQL、查询优化器(Query Optimizer)以及事务(Transaction)机制,把用户“声明想要什么数据”自动转化为底层可选择的物理执行计划。
正是因为数据库把磁盘数据页布局、B+ 树索引维护、并发锁与崩溃恢复等极度复杂的工程细节封装在了抽象层之下,创建(Create)、读取(Read)、更新(Update)、删除(Delete)即 CRUD 才得以成为业务软件通用的架构骨架。程序员从此可以把注意力集中在业务概念的关系建模上,而不必每次都先手写一套存储引擎。
逻辑关系与物理组织的分离
为了直观理解 Codd 所说的“逻辑理解与物理组织分离”,我们来看一个具体的图书馆借阅场景。在图书馆借阅场景中,同一个借阅事实转化为二维表关系后,既能支持不同维度的查询,又允许底层独立调整物理存储。
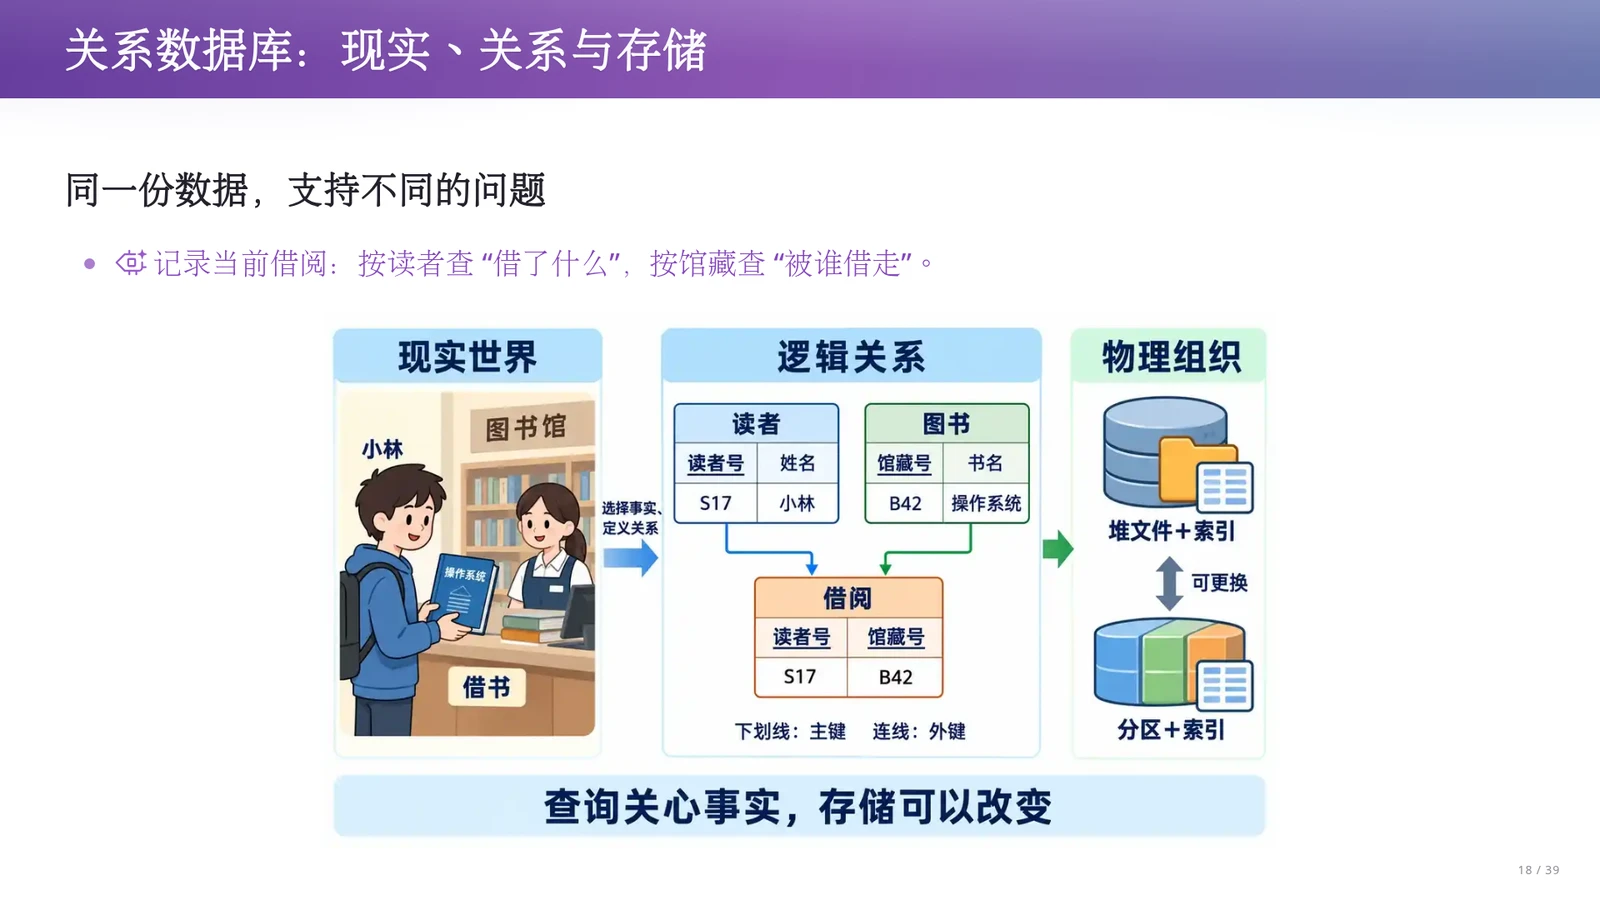
在图书馆借阅案例中,现实世界、逻辑关系与物理存储三者分层对应。在现实世界中,发生了“某位读者借走了某册图书”的事实;投射到关系模型中,系统用“读者”“馆藏图书”和“借阅关系”三组二维表结构来表达这一逻辑状态。基于同一份借阅关系数据,上层应用既可以按读者维度查询“他当前借了哪些书”,也可以反过来按馆藏维度查询“某册书当前被谁借走”。而在物理存储层,这些记录究竟存放在哪个磁盘数据页、建立了哪些索引、查询时先扫描哪张表,完全由数据库系统在幕后组织和调整。
这种分层同样体现了解空间的生长能力:数据库的发明者并没有预先穷举全世界的图书馆报表、电商订单查询或教务统计需求,而是提供了一套表达实体关系、完整性约束与关系代数查询的通用规则。只要上层的逻辑关系保持稳定,应用开发者就可以不断提出新的查询问题,底层数据库引擎也可以独立升级索引与执行策略,双方互不干扰。
Internet 的分层通信抽象
当软件从单机走向全球互联,通信链路跨越了无线基站、海底光缆与数据中心交换机。如果每个应用程序都要自己处理物理信号丢失、路由寻址与中间节点转发,网络应用根本无法编写。本页通过手机访问数据中心的实例,展示 TCP/IP 协议栈如何通过分层抽象屏蔽跨网通信的复杂性。
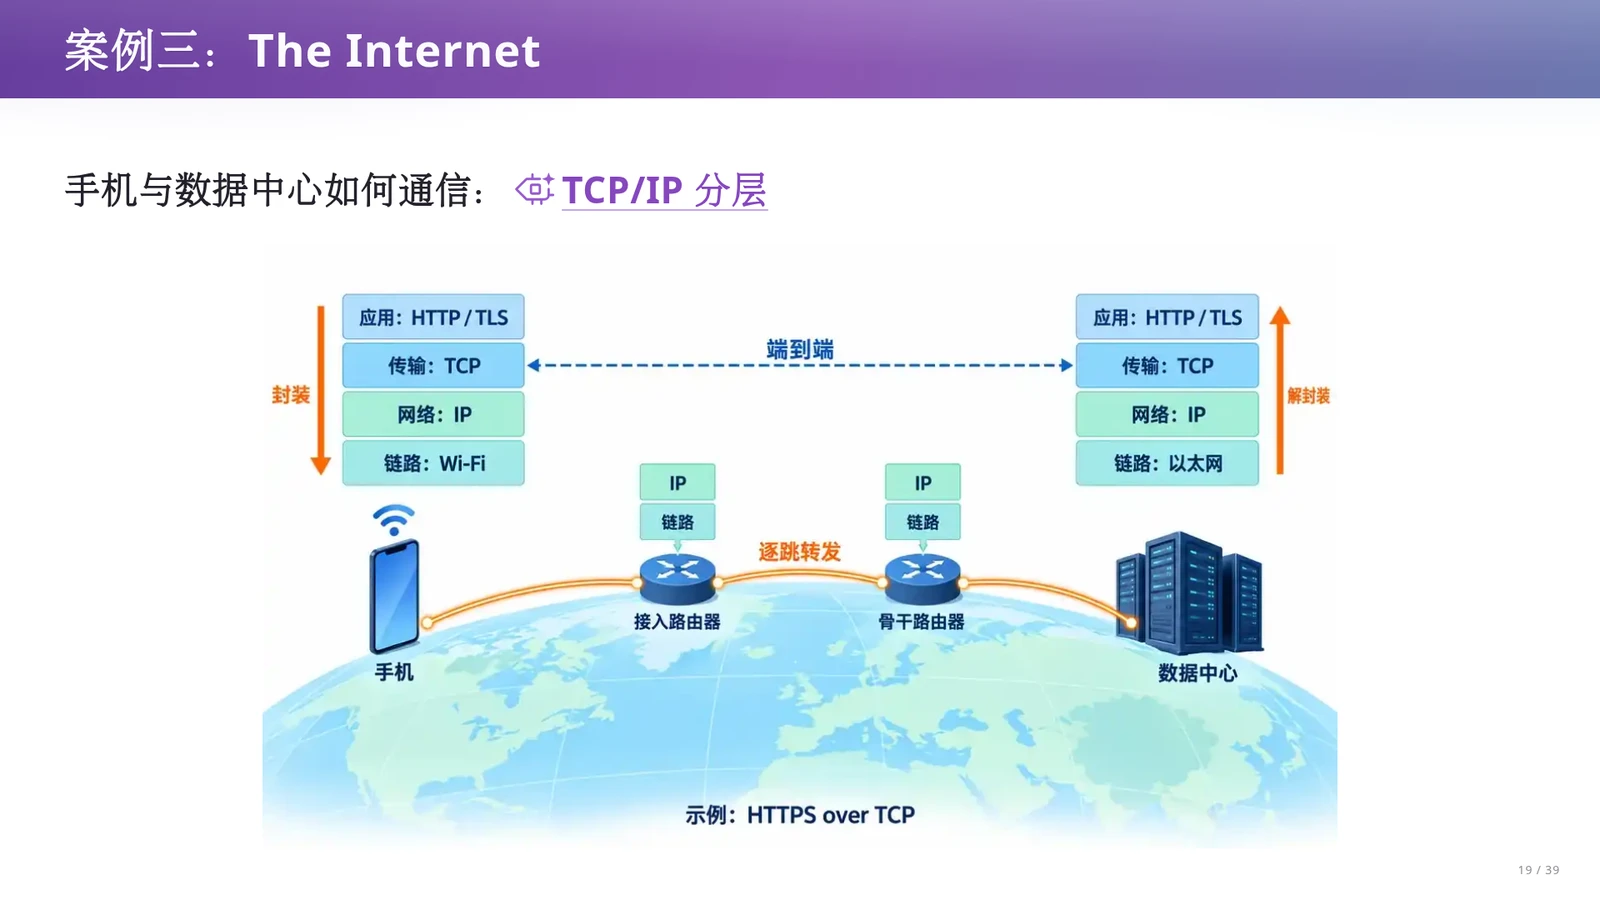
以手机通过 TCP 协议访问远端数据中心的 HTTPS 服务为例,可以看到 TCP/IP 分层架构的协作方式。在通信过程中,顶层应用发起请求,安全层与传输层协议(TLS/TCP)负责端到端的数据加密、分段、重传与拥塞控制,网络层(IP)负责跨网络的分组路由与寻址,底层的链路层与物理层则负责相邻设备节点之间的逐跳传送。请求数据包跨越地球上的多跳异构网络到达数据中心服务器后,接收端再自底向上逐层解包并还原出应用请求。
借助这套分层协议栈,无论是开发手机 App 还是编写后端微服务,程序员只需面对传输层提供的可靠字节流或上层的 HTTPS 接口。应用程序完全不需要知道报文在途中经过了多少个路由器、每一段物理链路使用的是光纤还是 Wi-Fi,更不必因为网络物理拓扑的某次动态切换而修改半行代码。
在持续变化中保持协作的 Internet
面对不断涌现的新硬件与新应用,Internet 通过收敛底层职责来换取上层协议的演化空间。
1996 年发布的《RFC 1958: Architectural Principles of the Internet》总结了互联网的演化原则。文档开篇指出,寻找互联网架构原则时必须铭记:信息技术行业的技术变革是持续不断的。Internet 的核心策略是专注做好“基础数据传输与连通性(Connectivity)”这一件事。在此之上,上层应用协议经历了显著的新陈代谢:远程登录因安全需求从明文的 Telnet 演进到了加密的 SSH;文件传输与日常信息访问大量从早期的 FTP、明文 HTTP 迁移到了安全的 HTTPS;而电子邮件领域的 SMTP 与 IMAP 协议则一直沿用至今。RFC 1958 将这种演化比作一座城市:街道与建筑在不断地翻修、改建和局部替换,但整座城市依然在共同的交通与市政规则下持续运转。
讲义特别澄清,这里说 Internet“做好数据传输这一件事”,绝不是指网络层包办一切,而是指基础设施应当提供足够通用的分组通信抽象,把具体的应用语义、安全策略与交互格式留给上层协议自行演进。少量的底层合作规则,就这样生成了一个庞大、多样且能局部持续更新的技术解空间。
计算浪潮中的通用系统抽象层
回顾了 UNIX、关系数据库与 Internet 之后,再看整个计算机系统发展史:从大型机到云原生时代,每一轮计算浪潮中的代表性“System”都在为通用应用搭建新的抽象层。
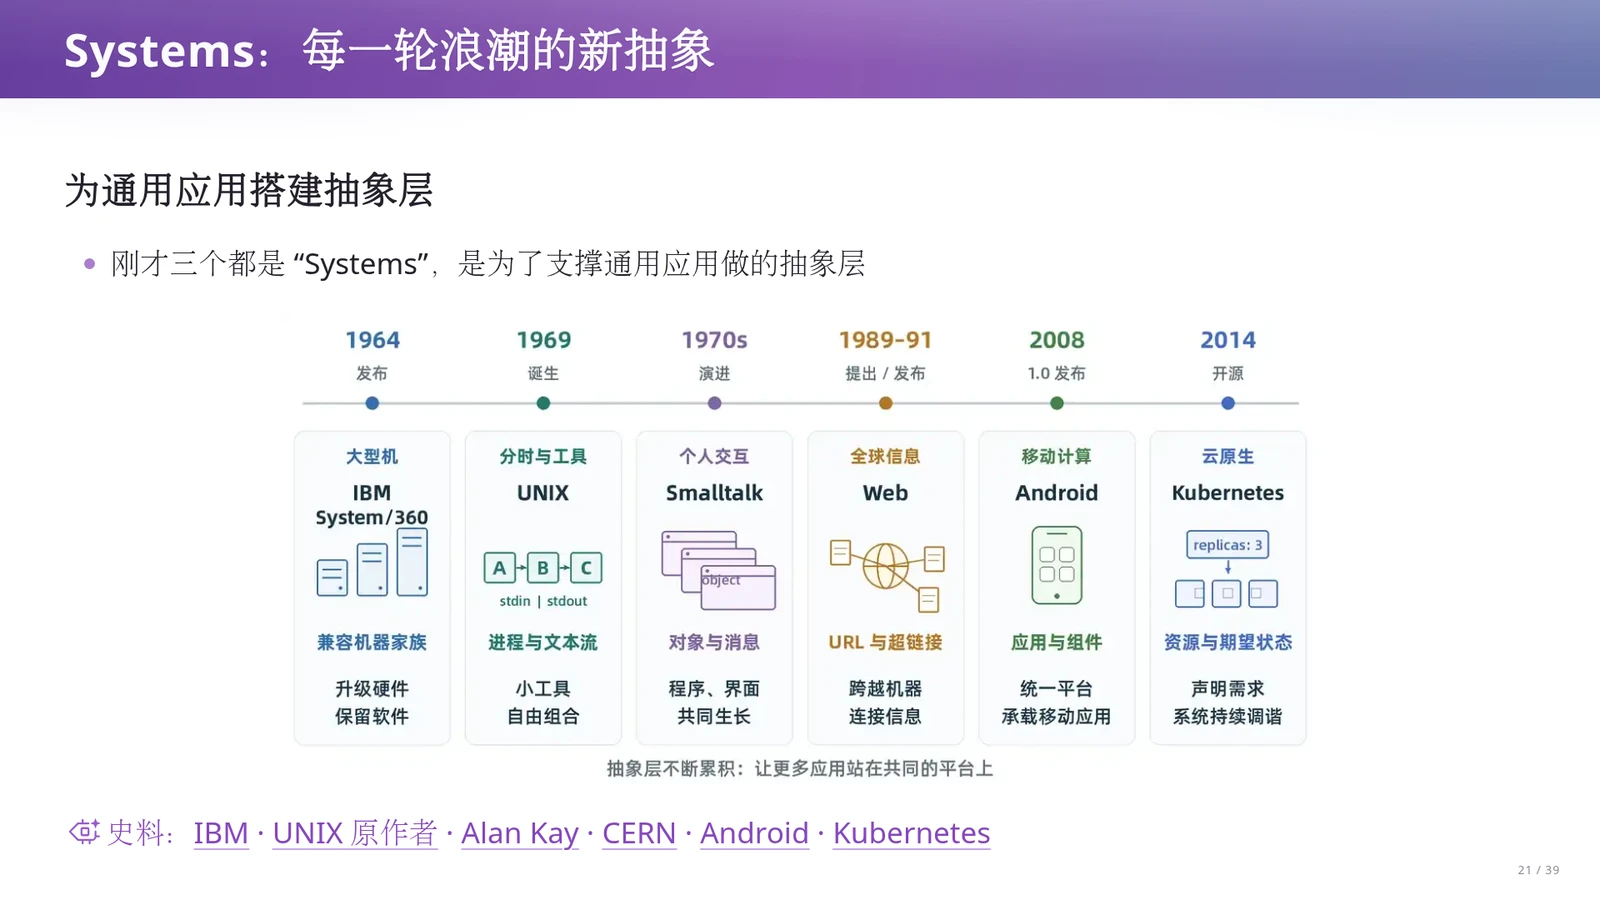
计算机历史上的每一轮技术浪潮都诞生了代表性的通用系统(Systems):从早期统一指令集架构以兼容不同硬件型号的 IBM System/360,到提供进程、文件与文本流管道抽象的 UNIX,再到开创图形界面与面向对象消息传递范式的 Smalltalk;随后是构建全球超文本信息空间的 Web(CERN)、面向移动触控设备提供应用框架的 Android,以及在云原生时代将集群机器抽象为容器编排资源的 Kubernetes。课件指出,这些系统之所以能成为基石,是因为它们都是为了支撑通用应用而搭建的抽象层。
这些顶级系统的价值,不仅在于它们各自解决了多么棘手的底层技术难题,更在于它们通过稳定的抽象边界,让上层成千上万原本难以企及的应用问题变得可解。现在,操作系统、关系数据库与 Internet 已经为我们搭好了坚实的舞台;从下一章开始,我们将把视线移向舞台中央,探讨如何为具体客户构建复杂的业务软件系统。
组合规则比现成用途更有力量
无论是 UNIX 的文本流管道、关系数据库的声明式 SQL,还是 Internet 的 TCP/IP 协议栈,它们之所以能历经数十年而不衰,核心在于设计者没有试图提前穷举所有具体应用,而是定义了清晰的数据表示、接口契约与组合规则。固定公共协作规则,把具体用途的组合权交还给未来的使用者,是构建长寿架构的根本秘诀。
课堂提示:人的交互判断也是流水线中可组合的一步
初学者常把 UNIX 管道理解为全自动的后台批处理。但在课堂演示中,像 fzf 这样的现代工具从标准输入读取候选行,弹出交互界面等待人做出选择,再把选中行写入标准输出。这说明只要遵守 stdin/stdout 的流式契约,连“人类的大脑判断”和“图形窗口激活(xdotool)”都可以被封装成标准组件,无缝嵌入自动化流水线中。
易错点辨析:切勿混淆“通用规则”与“绝对无例外”或“包办一切”
在理解系统抽象时需注意两个边界:第一,POSIX 规定了用 -- 结束选项解析的通用规则以保护文件名操作数的安全,但具体 UNIX 工具中仍保留了个别历史例外,不可声称所有命令绝对统一而无任何例外;第二,Internet“做好数据传输一件事”是指提供通用的跨网连通性抽象,把加密、业务语义留给上层演进,而非由网络层包办所有功能。
术语消化:三大基础设施的抽象边界与解空间机制对比
| 系统名称 | 解决的核心复杂性问题 | 抽象机制与解空间生长方式 |
|---|---|---|
| UNIX 管道与文本流 | 工具各自为战,人与程序、程序与程序之间缺乏统一的连接与检查方式 | 以纯文本流统一接口,配合 POSIX 参数、stdin/stdout/stderr 通道分离、退出码与分隔符约定,允许用户将独立小工具自由拼接成未知的新工作流 |
| 关系数据库(Relational Model) | 底层存储结构、数据规模与访问路径变化时,迫使上层应用重写数据处理逻辑 | 通过数据独立性分离“数据的逻辑关系”与“物理存放方式(数据页、索引)”,配合声明式 SQL、查询优化器与事务,支撑上层任意组合业务查询与 CRUD 操作 |
| Internet(TCP/IP 协议栈) | 全球异构物理链路动态变化,上层应用难以直接处理跨网寻址与传输可靠性 | 通过分层协议栈专注做好基础数据包传输与连通性(Connectivity),在保持底层转发规则稳定的前提下,允许上层应用从 Telnet/HTTP 持续演进至 SSH/HTTPS |
# 示例 1:从书目 JSON 流中提取书名,经人工交互挑选后输出选中项
cat books.json | jq -r '.[] | .title' | fzf

# 示例 2:检索当前 X11 窗口 ID 列表,人工挑选后激活目标窗口
xdotool search --onlyvisible --name "." | fzf | xargs -r xdotool windowactivate

# 示例 3:利用 -- 保护以连字符开头的文件名,并使用 LC_ALL=C 保证确定性排序
LC_ALL=C sort -- "-strange-filename.txt"
代码块展示了 UNIX 管道的组合能力与安全约定。示例 1 与示例 2 将结构化数据提取器 jq、X11 窗口控制工具 xdotool 与交互选择器 fzf 通过标准输入输出管道连接,前提是运行环境已安装对应工具且示例 2 需运行在 X11 图形会话下;示例 3 展示了用 -- 显式结束选项解析以防止文件名被误判为命令行选项,并用 LC_ALL=C 固定字符排序规则。
本章小结
本章剖析了 UNIX、关系数据库与 Internet 三大通用系统抽象。
- UNIX 借助文本流与 POSIX 社区约定,让独立工具得以像水管般自由拼接;
- 关系数据库通过分离数据的逻辑关系与物理存储,配合 SQL 与事务奠定了 CRUD 业务系统的基石;
- Internet 则依靠分层协议栈专注解决基础连通性,支撑上层应用在持续变化中局部演进。
三者共同印证了“固定协作规则、开放应用空间”的架构哲学,也为下一章探讨具体客户业务软件的架构设计铺平了道路。
五、面向客户需求的业务架构:从页面内嵌 SQL/JSP 到 MVC
在操作系统、关系数据库与互联网把底层通用基础设施搭建完毕之后,软件工程的重心便转向了具体客户需求的业务系统。当学校需要一套教务系统、商家需要一套在线商城时,最容易想到的做法就是让每个网页直接对应一段数据库事务。然而,为什么这种快速跑通的直观写法会在需求演进时迅速走向维护泥潭?本章将顺着早期 Web 开发的演进脉络,剖析页面模板技术解决了什么问题、又掩盖了什么问题,并说明 MVC 架构如何通过关注点分离,让业务规则、界面展示与用户交互的变化各归其位。
从“一个页面一段 SQL”看业务规则散落的代价
当操作系统、CRUD 数据库和网络通信把服务器与世界连接起来后,开发业务软件最直接的架构思路是什么?假设我们要实现教务系统的选课功能,如果把每个网页请求直接对应为一个数据库事务(SQL Transaction,即一组需要原子性执行的数据库读写操作),会遇到怎样的长期维护障碍?如果把同一条业务规则复制到多个页面入口中,任何一次规则调整都会带来遗漏和状态矛盾的风险。
基于操作系统、数据库与网络,最直接的 Web 开发模式是让每个页面对应一段 SQL 事务,借此快速搭建在线商城、社交网络或教务系统。例如一次选课请求的处理流程是:读取课程信息、检查学生是否满足选课条件、写入选课记录,最后返回结果页面,并将需要保持一致的读写包裹在数据库事务中。
但接下来的问题是“业务代码应该放在哪里”:在教务系统中,学生选课页、管理员补选页乃至批量导入脚本,都必须遵守课程容量限制等规则。如果把容量检查逻辑直接复制到每个页面里,一旦规则发生变动,就必须找遍所有入口逐一修改。
讲义提醒我们,判断一个架构是否有帮助,可以先问一个朴素的问题:需求改了一处,系统里需要跟着改多少处?把业务规则散落在各个页面中,是典型的由代码组织方式制造出来的附带复杂性。如果某次修改课程容量规则时漏掉了管理员补选页或批量脚本,各个页面表面上依然能正常打开和运行,但底层业务数据却已经开始自相矛盾。为了消除这种散落状态,工程界首先需要理清页面生成与代码执行的关系。
Java Web 浪潮与页面模板的反转思路
在 20 世纪 90 年代后期的 Web 开发浪潮中,除了数据库操作,程序员还面临一个极其繁琐的工程问题:如何动态生成 HTML 页面?如果在后端代码里一行行拼接 HTML 字符串,页面结构很快就会难以辨认。请阅读本页,理解从 Servlet 到 JSP(JavaServer Pages)等模板语言的演进动机,以及这种编写方式的转变带来了怎样的新诱惑。
20 世纪 90 年代后期的 Java Web 浪潮推动了页面模板技术的普及。一方面,Java 虚拟机(JVM)提供了跨平台运行基础,自动内存管理把程序员从手工管理内存的泥潭中解救出来;但繁杂的部署配置也带来了新的附带复杂性,使“Write once, run anywhere”被调侃为“Write once, configure everywhere”。另一方面,为了解决在 Java Servlet 中用字符串拼接输出 HTML 的痛苦,继 PHP/FI(1995)和 ASP(1996)探索在页面内嵌服务器端脚本之后,JSP 1.0(1999)把关系反了过来:允许开发者在 HTML 模板里直接嵌入 Java 代码,再由容器将 JSP 页面翻译成 Servlet 执行。这种反转成功地“让 HTML 留在 HTML 里”,恢复了清晰的页面结构。
在课堂讨论中,老师将这种模板思想与今天 AI 应用开发中的 Prompt 管理进行了类比:定制提示词时,与其用 Python 字符串做 prompt = A + B + C 的硬拼接,不如使用 Jinja2 等模板语言写好固定框架并留出 instructions 槽位,渲染时再填入变量,从而获得良好的可维护性。然而,JSP 虽然改善了页面编写方式,却也提供了一个新的便利陷阱:因为可以直接在 HTML 里写 Java 代码,程序员很容易在渲染页面的同时,顺手把数据库查询和业务判断也塞进页面之中。
JSP 的两代写法与标签化的架构局限
既然在 HTML 中直接混写大段 Java 脚本会让页面显得杂乱,那么把脚本升级为更整洁的表达式语言和标准标签,能不能彻底解决架构问题?对比同一张动态页面在 JSP 两代技术下的写法差异,可以看出模板语法的改良并不能代替架构上的职责分离。
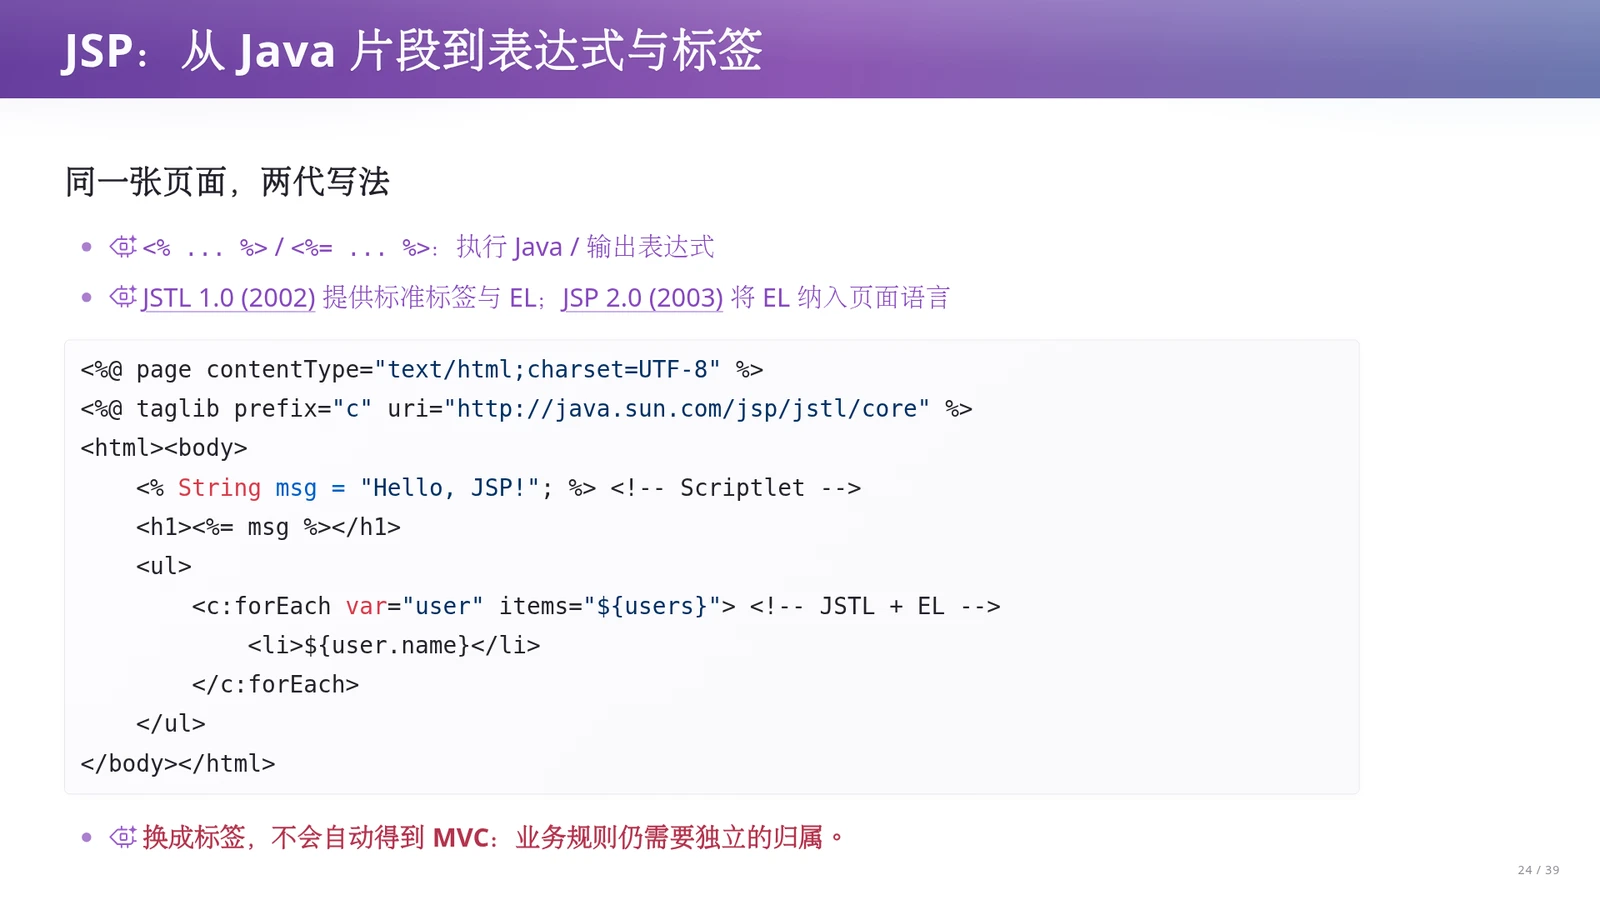
同一张 JSP 页面经历了两代写法的演进。早期写法使用 Scriptlet 脚本片段(<% ... %>)直接执行 Java 语句(如定义变量 String msg = "Hello, JSP!";),并用 <%= msg %> 输出表达式结果。到了 JSTL 1.0(2002,JavaServer Pages 标准标签库)与 JSP 2.0(2003),页面引入了标准标签与表达式语言(EL,Expression Language)。遍历用户列表不再需要手写 Java 循环与括号配对,而是使用 <c:forEach var="user" items="${users}"> 标签配合 ${user.name} 表达式(实际工程中若输出用户输入文本,通常配合 <c:out value="${user.name}" /> 进行 HTML 转义),使代码更接近模板描述。但把 Java 片段换成标签,不会自动得到 MVC 架构,业务规则仍然需要独立的归属。
为什么语法变优雅了,架构问题却依旧存在?因为模板标签解决的仅仅是“如何更清晰地描述界面结构与数据插值”,并没有阻止开发者在页面或标签背后直接操作数据库、编写容量校验逻辑。如果在每个 JSP 页面里继续各自实现一套选课条件判断,多入口规则复制导致的维护泥潭就丝毫没有改变。要真正解决职责混杂,不能只停留在表面语法的改良,而必须从架构层面对系统职责进行分解。
MVC 架构:用关注点分离让变化各有归属
为了让业务规则不再散落于各个页面,我们需要怎样的模块划分原则?1979 年提出的 MVC(Model–View–Controller,模型—视图—控制器)模式给出了影响深远的答案。我们可以用三个问题来理解 MVC 如何划定职责边界:系统知道什么、怎样展示这些知识、怎样接收和解释用户的操作?
MVC 架构的核心思想是关注点分离(Separation of Concerns,将软件系统按不同职责切分为独立部分,使各部分分别应对不同维度的变化)。MVC 最初面向交互式图形界面,旨在让同一个业务对象能够拥有不同的展示和操作方式,后来演变为教务系统等 Web 应用的标准架构。其中,Model(模型)负责封装数据、状态和业务逻辑,在教务系统里涵盖课程、选课记录以及课程容量、时间冲突等规则,绝不只是数据库里几张表的别名;View(视图)专门负责展示界面,可视为将 Model 投影为可视化表示的纯函数;Controller(控制器)负责接收用户输入,协调 Model 与 View 完成交互。
职责切分清楚之后,不同维度的需求变化就有了明确的归属:如果学校要求把课表展示从文字列表改成周历视图,主要只需修改 View;如果教务处调整了选课容量或时间冲突的限制条件,主要只需修改 Model 中的业务规则;如果新增一个“管理员补选”入口,Controller 只需接收新请求并复用已有的 Model 业务能力,同时显式声明它与普通学生选课不同的授权规则。理解界面时不必展开底层业务细节,修改同一项业务决定也无需再翻遍所有页面。
Web MVC 中一次选课请求的完整协作流
当 MVC 的概念落实到具体的 Web 服务器端架构(如经典的 Spring Web MVC)时,一次真实的选课请求是如何在各个组件之间流转的?沿着从浏览器发起请求到最终返回页面的链路,可以清楚看到 Controller、Model、事务数据库与 View 各自的协作次序。
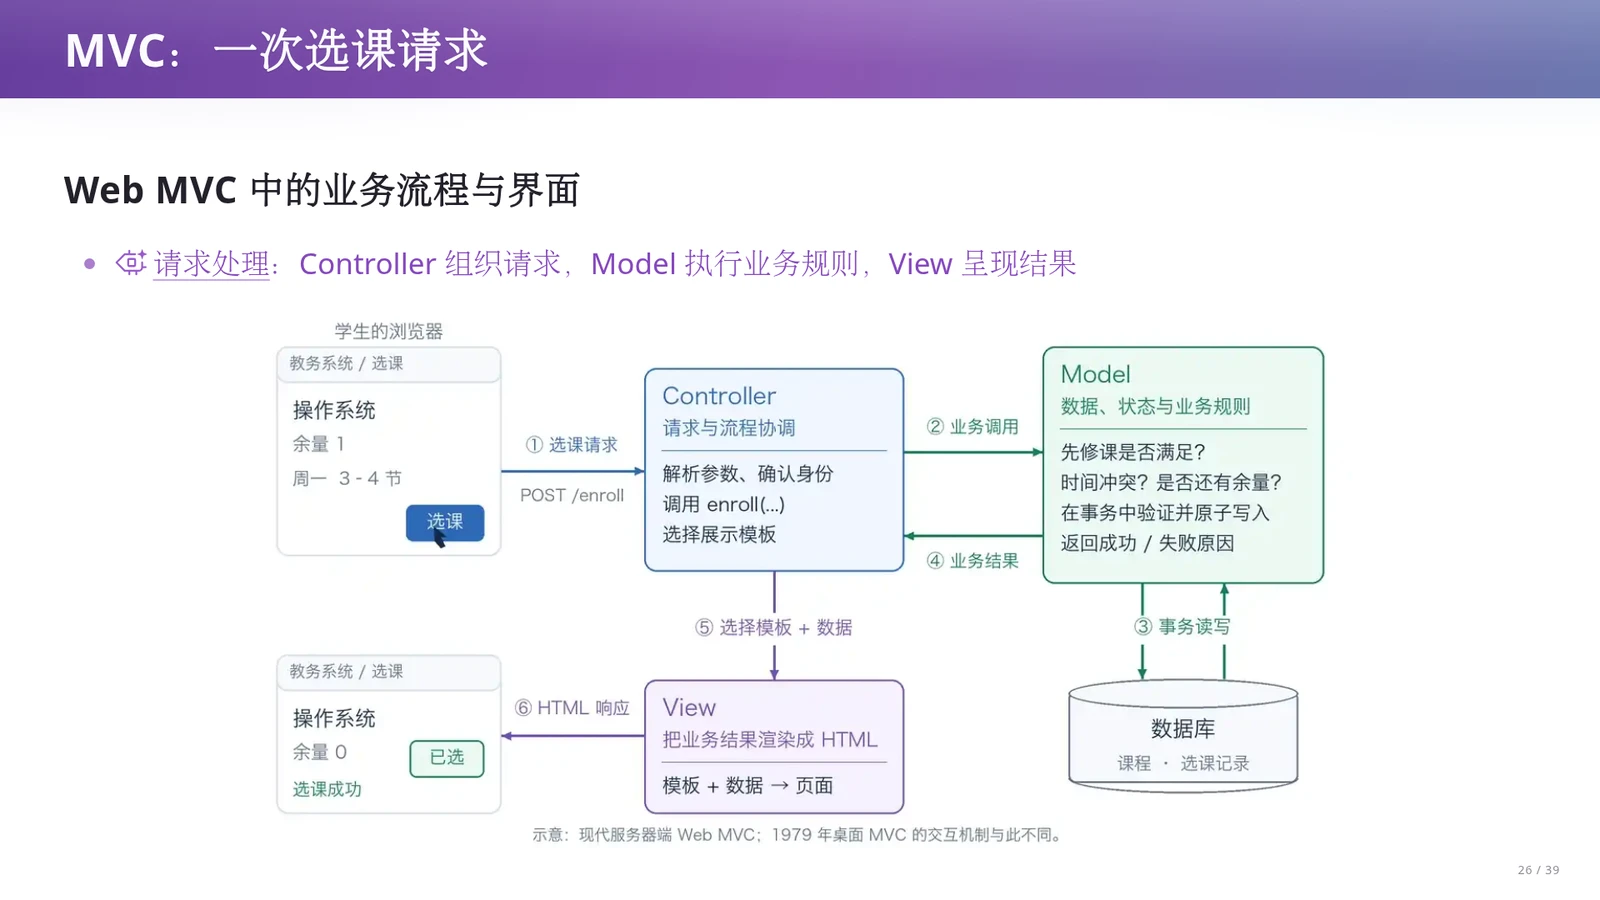
在 Web MVC 处理一次选课请求的标准流程中:首先,用户在浏览器界面点击“选课”按钮发起请求,由 Controller 率先接收并解析输入参数,将请求组织并转交给对应的业务操作;接着,承载核心业务规则的 Model 被调用,在事务数据库的支持下读取课程与已选信息,统一执行课程容量检查、时间冲突判定等业务规则,并完成选课记录的持久化更新;最后,Controller 根据 Model 返回的执行结果,交由 View 将“选课成功”或具体的“失败原因”渲染成页面呈现给浏览器。
通过这条清晰的请求处理链路可以看到,数据库事务与业务规则被严密地收敛在 Model 层内部,而 View 只负责根据处理结果生成展示内容。无论是学生页面点击选课,还是管理员页面发起补选,Controller 最终都会汇聚到同一个 Model 的业务规则接口上。不过,Web MVC 解决了后端业务逻辑与页面模板的分离后,随着现代前端交互日益丰富,网页自身又涌现出大量不进数据库的临时交互状态——这正是下一章探讨 MVVM 与 React 的起点。
MVC 的三个核心追问与变化归属
理解 MVC 架构的关键不在于死记三个缩写词,而在于用三个问题切分系统职责:第一,系统知道什么(Model,承载领域数据、状态与核心业务规则);第二,怎样向用户展示这些知识(View,将状态映射为界面的展示层);第三,怎样接收和解释用户的操作(Controller,把输入事件协调转发给业务处理与视图更新)。切分后,界面改版找 View,规则变更找 Model,交互入口调整找 Controller,变化不再四处蔓延。
课堂提示:模板语言与 AI Prompt 工程的共通性
在讲授 JSP 将“Java 拼接 HTML”反转为“在 HTML 模板中留槽位嵌代码”时,老师特别提示了一个直接服务于生成式软件工程的直觉:开发 AI Agent 时,切忌在代码里用字符串加法到处硬拼长篇 Prompt。采用 Jinja2 等模板语言,将固定的角色设定写成模板正文,预留出 instructions、当前日期等插值槽位,本质上与 Web 页面模板一样,都是在用专门的领域表达隔离拼接细节,降低维护的附带复杂性。
两个常见的 MVC 认知误区
第一,切勿把 Model 等同于数据库表结构或单纯的数据传输对象(DTO)。在教务系统中,课程容量限制、先修要求、时间冲突校验等核心业务规则都属于 Model 的一部分;若把 Model 退化成空壳数据结构、把规则塞回 Controller 或页面,依然会导致多入口规则复制。第二,切勿认为引入了 JSTL、EL 表达式或现代模板语法就自动实现了 MVC,语法层面的整洁不能替代架构层面的职责分离。
术语消化:从页面内嵌脚本到 MVC 架构的关键概念对比
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| SQL Transaction(数据库事务) | 保证单次业务操作中多步数据库读写的原子性与一致性 | 将选课流程中的“读课程、查条件、写记录”打包为不可分割的整体,但仅靠每个页面一段事务无法解决跨页面的业务规则复用问题 |
| JSP / 页面模板 | 消除在后端代码(如 Servlet)中用字符串拼接 HTML 的繁琐与混乱 | 容器将内嵌脚本、JSTL 标签或 EL 表达式的 HTML 模板翻译为可执行代码,让页面保持 HTML 结构,但需警惕顺手将业务规则塞进页面 |
| 关注点分离(Separation of Concerns) | 避免界面展示、输入控制与业务规则混杂在同一处代码中 | 通过划分模块职责与接口约定收缩实现空间,使界面改版、规则调整、新增入口等不同维度的变化各自独立演进 |
| Model–View–Controller (MVC) | 为交互式系统与 Web 业务系统提供职责清晰的架构分解 | Model 封装数据、状态与容量/冲突等业务规则,View 负责展示,Controller 接收输入并协调二者,解决多页面复制业务逻辑引发的自相矛盾 |
<%@ page contentType="text/html;charset=UTF-8" %>
<%@ taglib prefix="c" uri="http://java.sun.com/jsp/jstl/core" %>
<html><body>
    <% String msg = "Hello, JSP!"; %> <!-- Scriptlet -->
    <h1><%= msg %></h1>
    <ul>
        <c:forEach var="user" items="${users}"> <!-- JSTL + EL -->
            <li><c:out value="${user.name}" /></li>
        </c:forEach>
    </ul>
</body></html>
该代码片段展示了同一张 JSP 页面中的两代动态内容生成机制。上半部分使用早期 Scriptlet(<% ... %>)定义 Java 变量并用 <%= msg %> 输出;下半部分引入 JSTL 核心标签库,接收上下文传入的 users 集合,通过 <c:forEach> 循环标签、${user.name} EL 表达式与负责转义输出的 <c:out> 标签渲染列表。代码体现了模板表达的改进,但课程强调:若不将业务规则抽离到独立的 Model 层,仅把脚本换成标签并不能实现 MVC。
本章小结
本章探讨了面向客户需求的 Web 业务架构如何从早期直观做法演进到 MVC 模式。“一个页面对应一段 SQL 事务”配合 JSP 模板虽然能让业务系统快速跑通,但极易把课程容量检查等业务规则顺手复制进学生选课、管理员补选等多个页面,导致修改遗漏与业务矛盾。即使将 Java 脚本升级为 JSTL 标签和 EL 表达式,也只是美化了模板语法。
MVC 通过关注点分离,将包含业务规则的 Model、负责展示的 View 与协调输入的 Controller 明确解耦,使不同维度的需求变化各归其位。
六、界面状态也是状态:MVVM、Vue 与 React 的派生视图
上一章我们借助 MVC 将业务数据与规则收拢进 Model,把页面渲染交给 View。然而,走进现代交互式界面,一个棘手的问题浮现出来:为什么后端业务数据库里的 Model 完全没变,用户在屏幕上看到的界面却截然不同?传统教务系统常把简单的课程列表过滤做成一次后端数据库查询,或者每次点击都整页刷新,体验十分割裂。本章将探讨搜索框关键词、展开的菜单、鼠标悬停元素等不进数据库的界面状态,剖析 MVVM、Vue 与 React 如何通过显式建模界面状态与派生依赖,减少手动同步 DOM 的附带复杂性。
把 ViewState 当作一等模型
在经典 Web MVC 中,如果每次交互都向服务器发起请求并刷新整张 HTML 页面,把 View 单纯看作业务 Model 的投影尚能应付。但在富交互前端中,大量界面变化并不涉及后端业务事务。那些不写入业务数据库的临时交互信息同样决定着界面呈现;如果不为它们建模,程序员就必须在各个控件回调里手工维护界面同步。
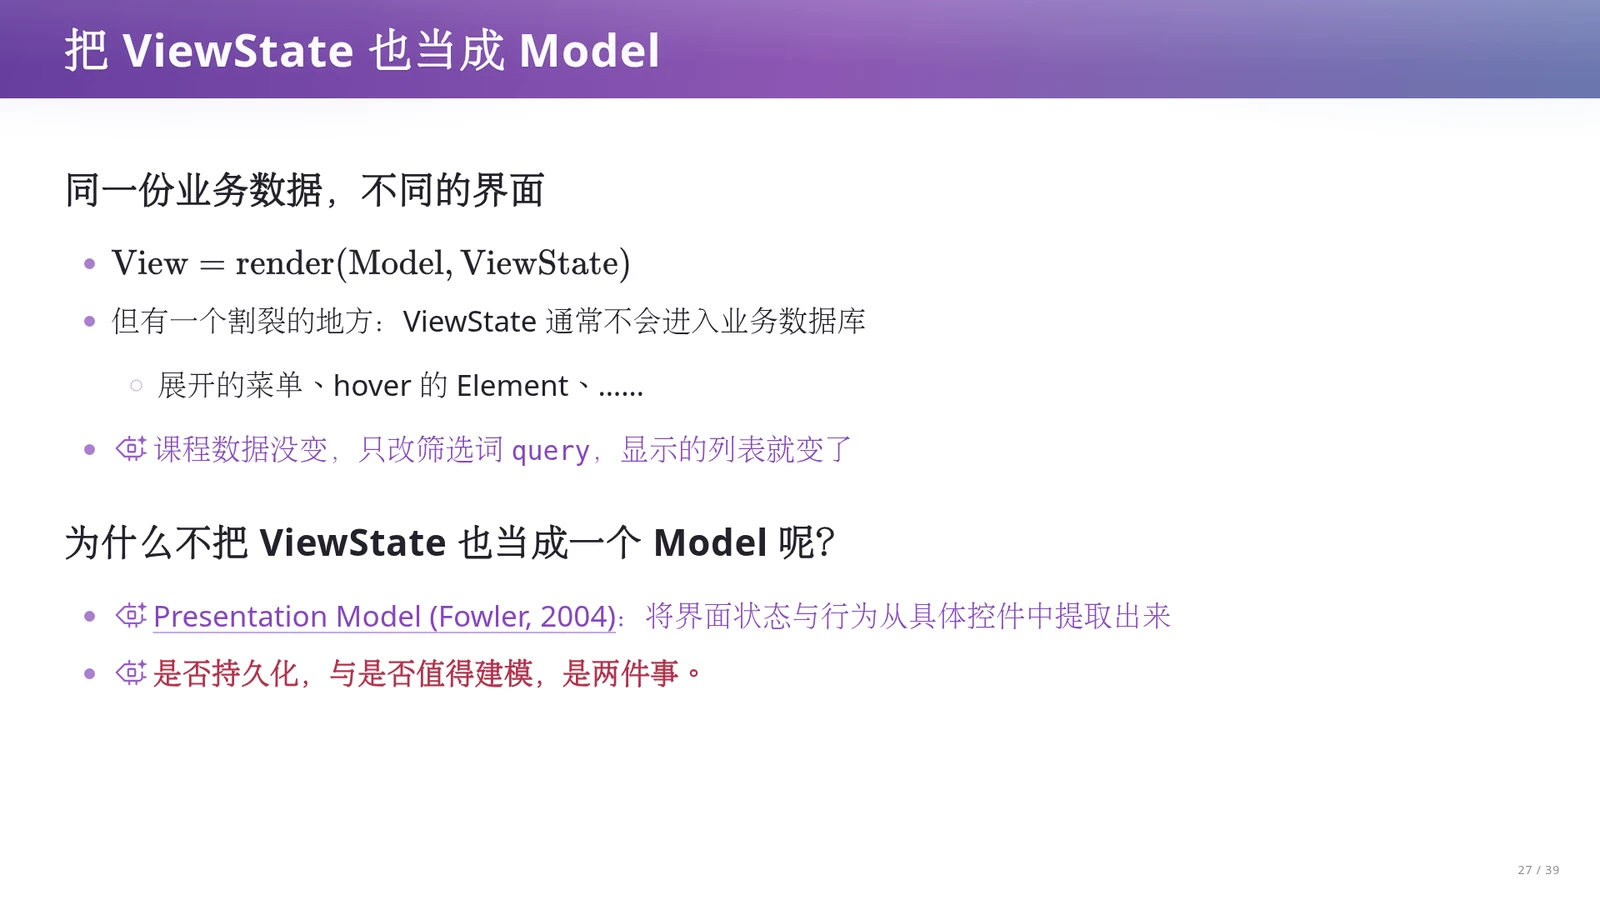
同一份业务数据在不同交互下会呈现不同界面,概念上可以写为 \(\mathrm{View} = \mathrm{render}(\mathrm{Model}, \mathrm{ViewState})\)。这里 ViewState(视图状态,即界面自身持有的状态)包括展开的菜单、当前鼠标悬停(hover)的元素、搜索框里的筛选词 query 等。
它们有一个看似割裂的特征:通常不会持久化进后端的业务数据库。但是,当后端的课程数据分毫未动、用户仅仅修改了前端筛选词 query 时,页面显示的课程列表就发生了变化。
为此,课件引入了 Martin Fowler 在 2004 年提出的 Presentation Model(展示模型)思想:将界面状态与行为从具体的 UI 控件中提取出来独立建模。
讲义提醒我们一个核心的架构判断:一项数据是否需要持久化保存,与它是否值得在程序中认真建模,完全是两件事。在早期的命令式前端写法中,程序员习惯把 ViewState 散落在各个 DOM 控件属性和事件回调函数里。结果就是,人类有限的“小脑袋”必须时刻记住“点击这个按钮之后,要顺手去修改另外那三个 DOM 节点”。把 ViewState 提升为正式的模型,正是为了终结这种靠人脑记忆维护多处界面同步的泥潭。
MVVM 与 Vue 的响应式派生
既然承认 ViewState 值得建模,我们该如何组织它与业务 Model 以及最终界面之间的关系?如果既保存原始课程列表,又手工维护一份“当前可见课程列表”,每次输入框变化或课程数据更新时都要写代码同步两份列表,依然容易遗漏。本页以 Vue 为例,展示 MVVM 如何用声明式依赖取代手工状态同步。
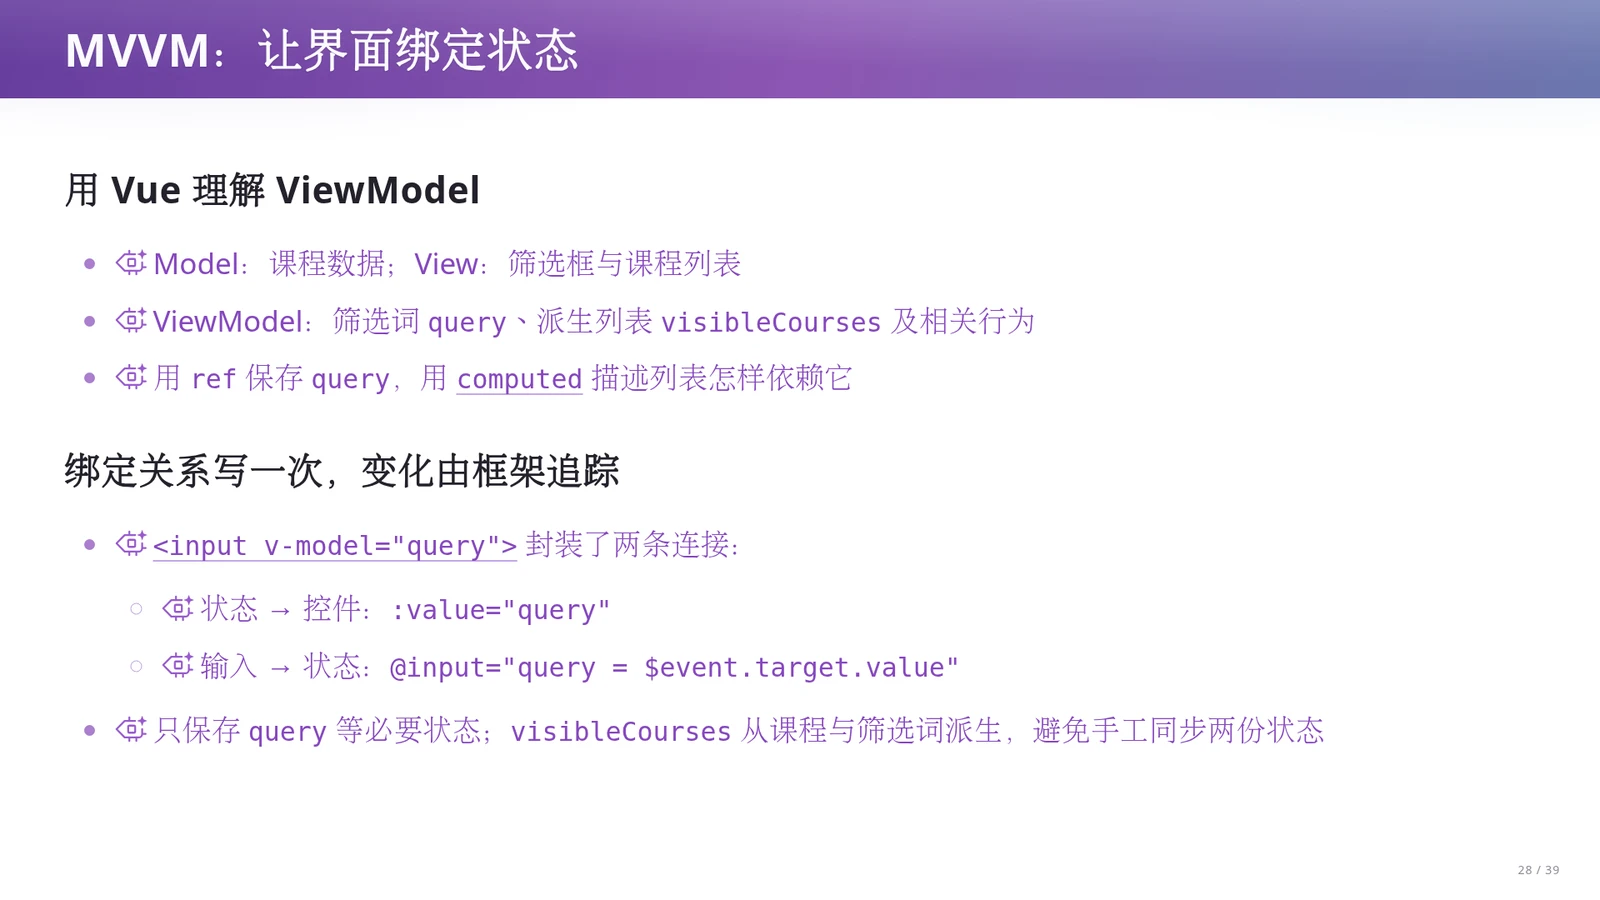
MVVM(Model–View–ViewModel,模型—视图—视图模型架构)将面向展示的状态和行为组织为 ViewModel。在课件的课程筛选例子中,Model 是原始课程数据,View 是页面上的筛选框与课程列表,而 ViewModel 则包含筛选词 query、派生列表 visibleCourses 以及相关交互行为。在 Vue 的实现机制里,我们用响应式引用 ref 保存基础状态 query,用计算属性 computed 声明 visibleCourses 如何由课程数据与 query 共同计算得出。同时,输入框上的 v-model="query" 语法糖明确封装了两条单点连接:一是状态到控件的值传递 :value="query",二是用户输入事件更新状态 @input="query = $event.target.value"。
通过这种设计,状态依赖关系只需声明一次,后续变化全部由框架自动追踪。计算属性 computed 会追踪它在求值过程中读取到的响应式依赖;当 query 或响应式课程列表(如通过 defineProps 传入的 props.courses 或 ref 包装的课程数组)改变时,框架会自动重新计算 visibleCourses 并更新 DOM。这里的关键在于:我们只保存 query 和原始课程这两份基础状态,让 visibleCourses 成为二者的纯派生结果,从而免去了在输入事件里手工维护第二份可见课程列表的同步负担。
React 的状态快照与纯函数渲染
除了像 Vue 那样由框架自动追踪响应式依赖图,还有没有另一种表达“界面随状态变化”的方式?课堂上提到,我们希望把界面直接写成状态的纯函数,给定当前所有状态就能算出整棵界面树。本页将切换到 React 的视角,看看它如何用“状态快照”与显式更新函数来实现相同的课程筛选功能。
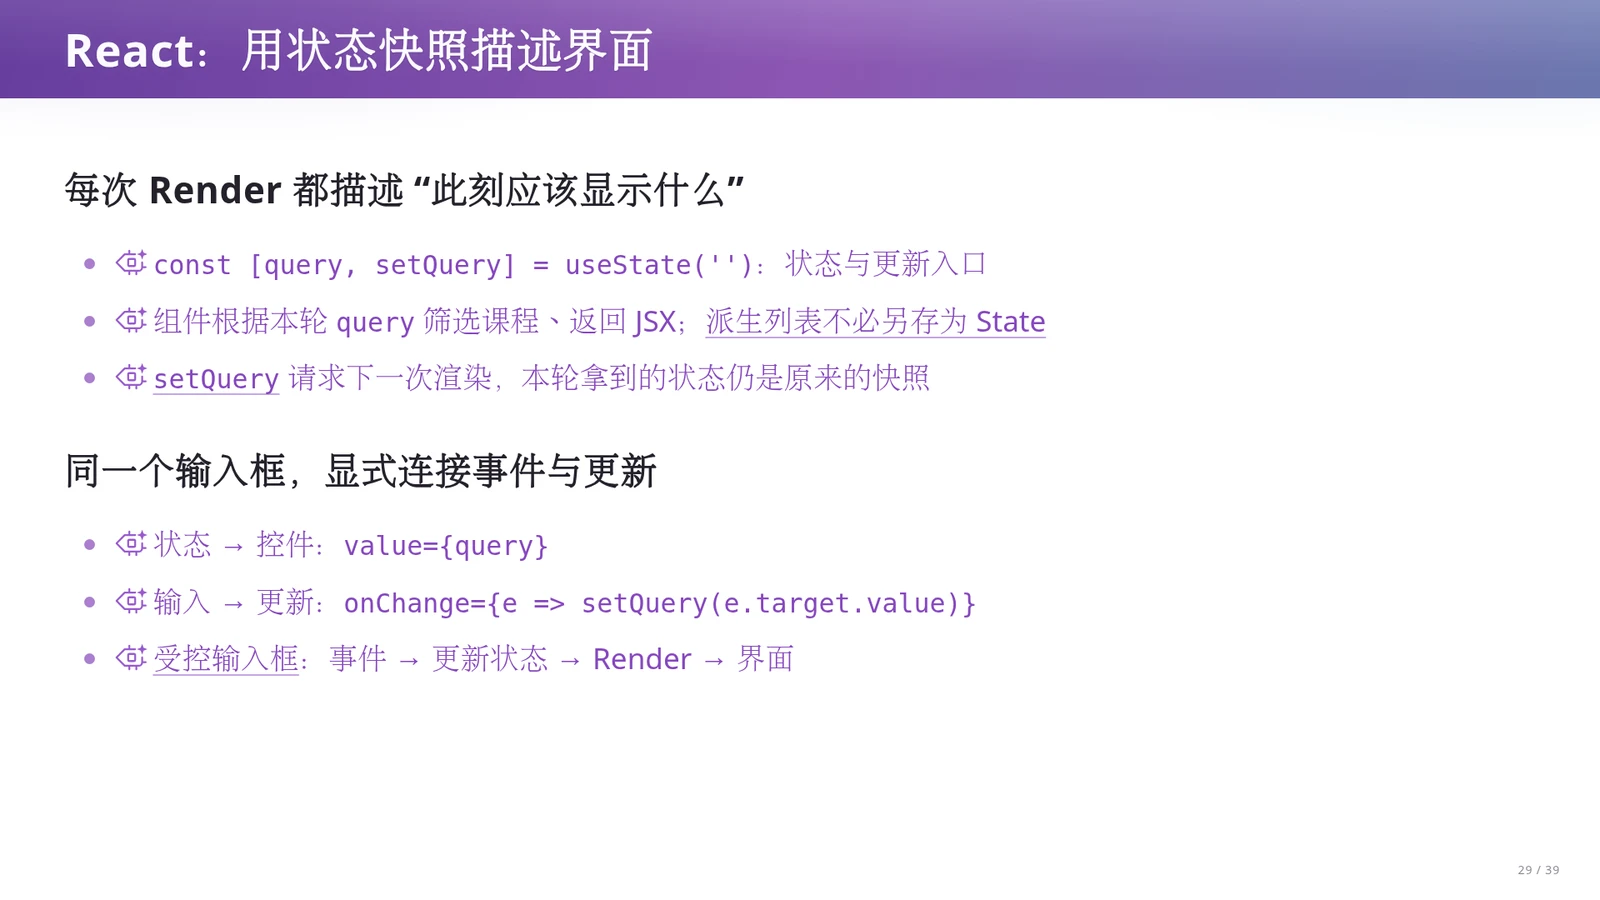
React 的核心理念是每次渲染(Render)都描述“此刻应该显示什么”。课件代码中,组件通过 const [query, setQuery] = useState(”) 声明状态与更新入口,并在当次渲染执行时直接根据本轮拿到的 query 过滤课程列表、返回 JSX 界面描述。既然可见课程列表能从现有课程属性和 query 直接算出来,就绝不把它另存为一份独立的 State。对于同一个受控输入框(Controlled Input,即显示值完全由 React 状态驱动的输入控件),React 将两条连接显式写出:用 value={query} 把状态传给控件,用 onChange={e => setQuery(e.target.value)} 在事件回调中调用 setQuery 请求更新,形成“事件 \(\rightarrow\) 更新状态 \(\rightarrow\) Render \(\rightarrow\) 界面”的闭环。
理解 React 机制必须把握一个关键原则:状态即快照(State as a Snapshot)。在某一次渲染函数执行期间,组件拿到的 query 是一份固定的快照;当用户输入触发事件并调用 setQuery 时,它只是向 React 请求使用新状态进行下一次渲染,绝不会立即修改当前这次渲染执行上下文中已经拿到的 query 变量值。这种快照机制让“某一次看到的界面究竟是由哪些输入算出来的”变得极其清晰、可预测。
对比 Vue 与 React:显式依赖与单向数据流
前端社区常为 Vue 与 React 的语法风格争论不休,但如果跳出具体的 API 表面,从软件架构分解复杂性的高度审视,它们究竟达成了怎样的共识?对比同一个课程筛选功能在 Vue 与 React 中的实现,可以看到二者在原始状态、派生值以及单向组件数据流上的共同设计。
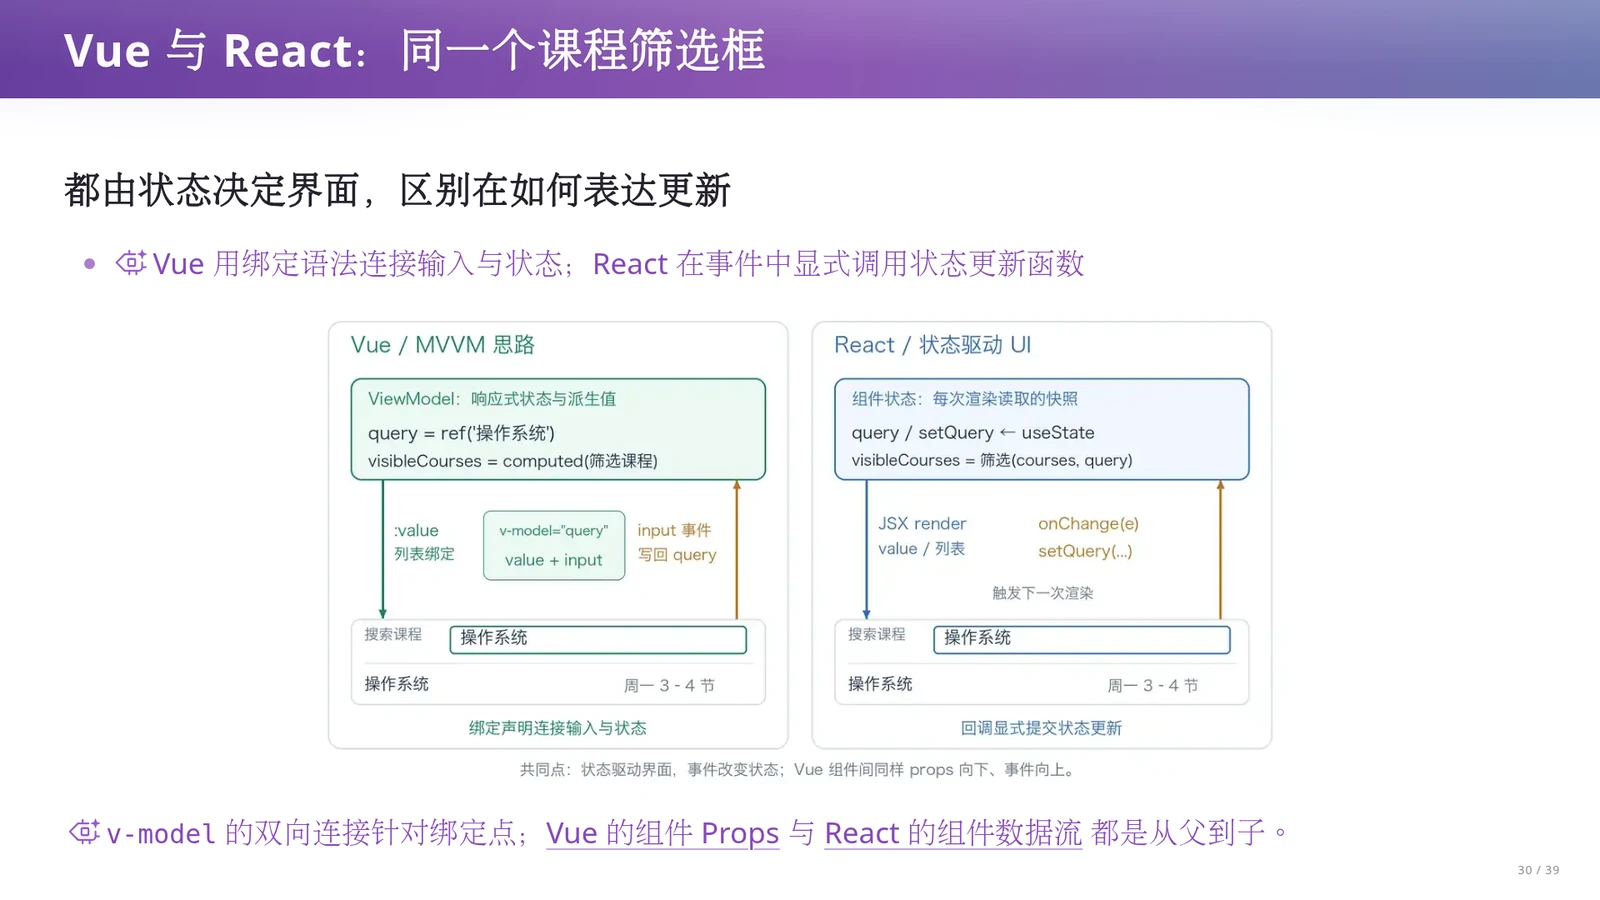
将同一个课程筛选框的 Vue 与 React 实现放在一起对比:左侧 Vue 依靠响应式状态 ref、计算属性 computed 与 v-model 双向绑定语法糖自动追踪依赖并更新 DOM;右侧 React 则依靠 useState 状态快照、渲染期直接计算派生列表以及 onChange 事件回调显式触发重渲染。课件底部特别指出,尽管表达更新的编程体验不同,但二者的界面都严格由状态决定;哪怕 Vue 提供了 v-model,该双向连接也仅针对具体的表单绑定点,Vue 的组件 Props 与 React 的组件数据流一样,都严格遵循从父组件到子组件的单向数据流。
课堂上补充解释了背后的工程权衡:如果页面有几万个元素,每次敲击键盘改一个字符都把整棵原生 DOM 树推倒重算,会有严重的性能问题。因此现代前端框架在底层通过 Virtual DOM(虚拟 DOM)或响应式依赖图隐藏了增量更新的附带复杂性,让程序员在关注状态逻辑时不必同时操心怎样把它一步步同步到 DOM 上。这种“只保存原始状态,让派生值跟随变化”的思想,马上就会在下一章跨越前端边界,进入更复杂的后端长周期业务。
只保存原始状态,让派生值跟随变化
无论是前端界面还是后端业务,同一个事实一旦被复制成多份可独立修改的状态,就会立刻引入多处同步的一致性难题。在课程筛选案例中,原始课程数据 courses 与搜索词 query 是基础状态(Source of Truth),而可见课程列表 visibleCourses 完全可以由二者经纯函数计算得出。无论用 Vue 的 computed 还是在 React 渲染期直接过滤,核心原则都是不把派生结果另存为可独立修改的第二事实源(后端为性能保留的缓存或物化视图也必须受控地从原始事实刷新重建),且纯派生计算中不得夹带扣费、发消息等外部副作用。
课堂提示:用 Virtual DOM 与依赖图解放“小脑袋”
老师在课堂上指出,理想情况下我们希望写一个无副作用的纯函数 View = f(State),直接算出整棵 DOM 树。但页面可能有上万个元素,每次输入一个字符都全量重算原生 DOM 会有严重的性能问题。Vue 的响应式依赖追踪图与 React 的 Virtual DOM 机制,本质上都是架构层面的抽象:框架替我们承担了高效的局部 DOM 更新,从而解放人类有限的“小脑袋”,让我们在关注状态逻辑时不必同时操心底层的 DOM 同步细节。
核心易错点:React 状态快照与 v-model 的边界
第一,调用 React 的 setState 或 setQuery 不会改变当前渲染执行上下文中的状态变量值,它只是请求使用新状态进行下一次渲染(State as a Snapshot);在同一轮事件处理中读取旧变量名拿到的仍是本轮快照。第二,切勿将可通过原始状态直接算出的派生列表(如 visibleCourses)再存进一份独立的 useState。第三,不可将 Vue 的 v-model 误解为组件间数据可以随意双向篡改,v-model 仅作用于具体绑定点,Vue 与 React 的组件 Props 均是从父到子的单向数据流。
术语消化:现代前端架构中的状态与派生机制消化
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| ViewState / Presentation Model | 解决搜索词、菜单展开、悬停等不进数据库的界面状态散落在控件与回调中难以同步的问题 | 将界面自身状态从具体控件提取出来独立建模,确立 View = render(Model, ViewState) |
| MVVM 与 Vue computed | 消除输入变化时手工维护第二份可见列表(如 visibleCourses)的多处同步负担 | 用响应式引用保存基础状态,用 computed 声明派生依赖,由框架追踪读取并自动更新结果 |
| Vue v-model 表单绑定 | 简化表单控件显示值与响应式状态之间的手动事件接线 | 语法糖封装了“状态到控件(:value)”与“输入事件更新状态(@input)”两条连接,不破坏父子组件单向 Props 流 |
| React State as a Snapshot | 防止渲染过程中状态被就地突变,避免“当前界面究竟由哪份数据算出”难以推理 | 每次 Render 拿到固定状态快照并直接算出派生视图;调用 setQuery 仅请求下一轮渲染,不改当前上下文变量 |
// --- Vue 3 (<script setup>:响应式 props/ref + computed 派生 + v-model) ---
const props = defineProps({ courses: { type: Array, required: true } })
const query = ref('')
const visibleCourses = computed(() =>
  props.courses.filter(c => c.name.includes(query.value))
)
// 模板:<input v-model="query">
//       <ul><li v-for="c in visibleCourses" :key="c.id">{{ c.name }}</li></ul>

// --- React (状态快照风格:Render 期直接计算派生值 + 受控输入框) ---
function CourseList({ courses }) {
  const [query, setQuery] = useState('')
  // 派生列表直接由本轮快照算出,不另存为独立 useState
  const visibleCourses = courses.filter(c => c.name.includes(query))
  return (
    <>
      <input
        value={query}
        onChange={e => setQuery(e.target.value)}
      />
      <ul>
        {visibleCourses.map(c => <li key={c.id}>{c.name}</li>)}
      </ul>
    </>
  )
}
输入为父组件传入的课程列表 courses(每项含稳定主键 id 与名称 name)以及用户在输入框键入的筛选词 query;输出为同步更新的输入框与过滤后的可见课程列表界面。在 Vue 中,computed 追踪响应式属性 props.courses 与 query.value,当任一响应式依赖变化时自动重算 visibleCourses;在 React 中,每次渲染函数基于本轮 courses 与 query 快照直接算出 visibleCourses 并渲染 <li> 列表,用户输入通过 onChange 调用 setQuery 请求下一次渲染。
Model 表示业务数据与领域规则(如课程列表),ViewState 表示不一定要进入业务数据库但决定界面呈现的视图状态(如筛选词 query、展开菜单、hover 元素),render 表示无副作用的视图映射计算,View 表示最终呈现给用户的界面结构。
本章小结
本章从交互式界面的痛点出发,指出是否需要持久进数据库与是否值得认真建模是两回事。通过引入 ViewState 与 Presentation Model,我们将界面归纳为 Model 与 ViewState 的共同函数。
无论是 Vue 借助响应式状态、computed 计算属性与 v-model 绑定,还是 React 借助状态快照、受控组件与渲染期即时计算,现代前端框架都坚持单向组件数据流,并将“派生值如何依赖原始状态”显式化,把程序员从手动同步多处 DOM 的泥潭中解放出来。
七、跨越时间的长流程:复式记账、Event Sourcing 与 LLM 编译器
在前端界面中,MVVM 与 React 通过显式声明状态依赖,消除了视图与本地数据之间的手工同步麻烦。然而,当我们将视线移回后端业务系统,会发现许多核心业务跨越漫长的时间周期并伴随严密的领域规则,例如经历下单、锁库存、风控到售后对账的电商订单,或是从修读课程到特批准出的教务流程。如果依然沿用基础的 CRUD 思路,仅仅把复杂代码塞进 Model 目录并在数据库里只覆盖保存“当前状态”,系统为何会迅速陷入数据静默损坏的泥潭?本章将从会计复式记账法出发,探讨如何利用事件溯源(Event Sourcing)与大语言模型编译器分离过去、现在与未来。
把复杂性放进 Model,为何仍难应对长流程与强规则
在掌握了 MVC 与 MVVM 的关注点分离之后,开发者很容易产生一种错觉:只要把页面里的业务判断统统抽离并塞进名为 Model 的代码目录,配合数据库的增删改查,就能应付所有软件需求。在阅读本页前,我们需要先追问:普通的信息展示系统与跨越漫长周期的核心业务系统,在状态演化上究竟存在什么本质区别?
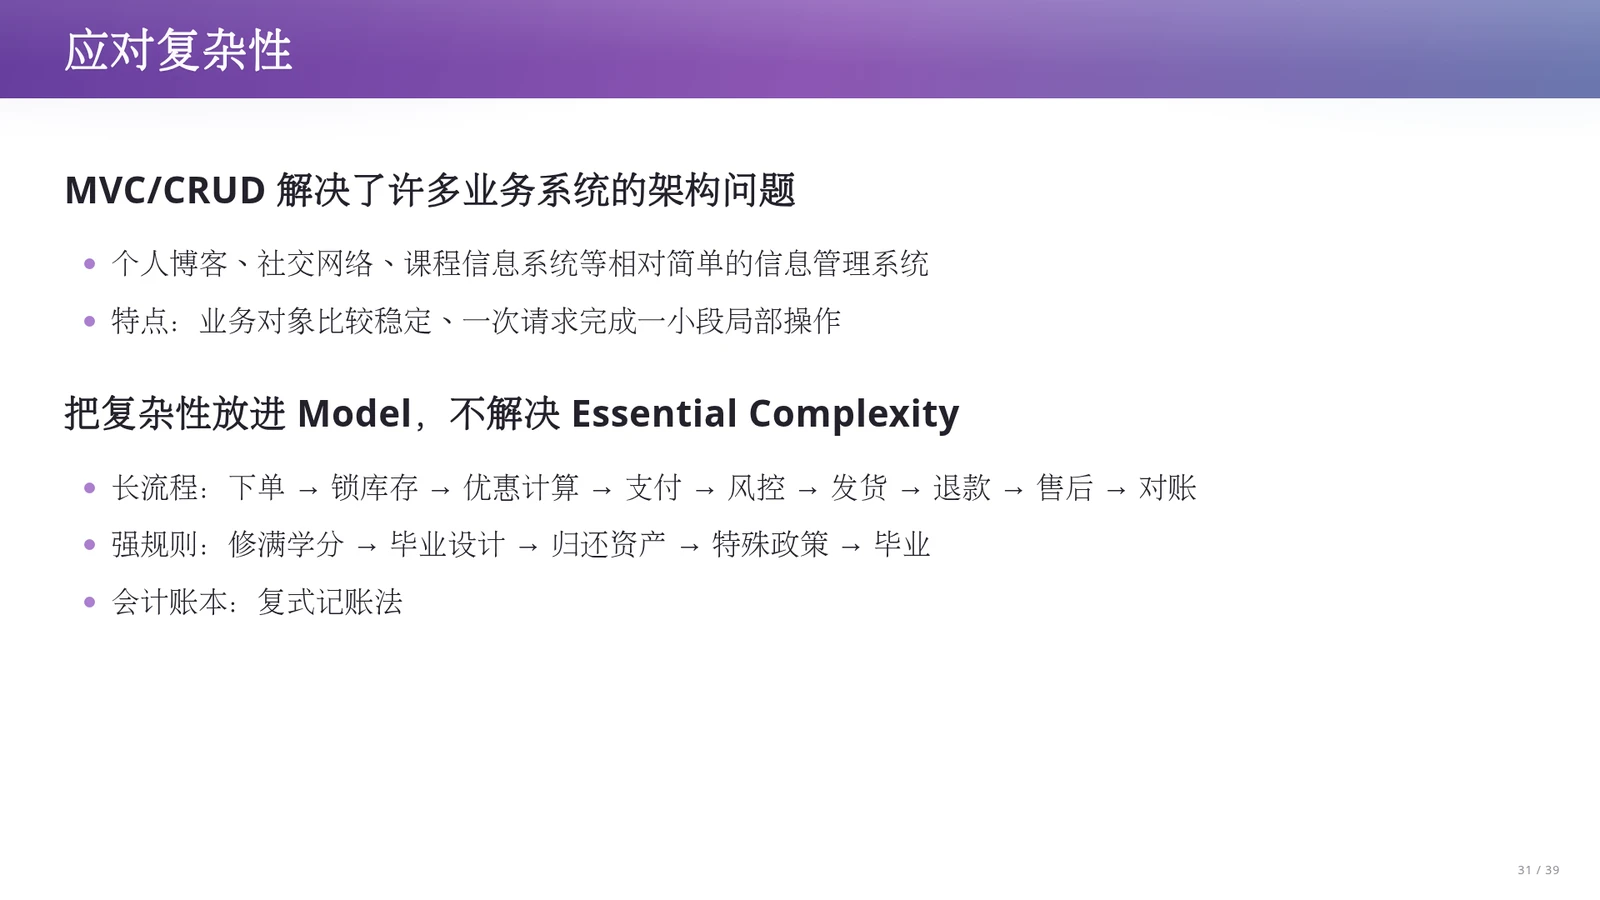
我们可以把业务系统划分为两个层次进行对比。
- 第一类是相对简单的信息管理系统,如个人博客、社交网络基础功能或静态课程信息查询,其特点是业务对象结构稳定,单次用户请求即可在局部完成读取或写入操作,MVC 与 CRUD 模式对此非常有效。
- 第二类则是长流程与强规则系统:电商订单需要跨越下单、锁库存、优惠计算、支付、风控、发货、退款、售后与对账;教务毕业审核涉及修满学分、毕业设计、归还资产与特殊政策批准;会计账本则受制于严密的复式记账法。
仅仅把代码挪进 Model 目录,并不能消解这些领域固有的本质复杂性。
课堂提示指出,如果在长流程中仅用数据库二维表的一列或几列字段(如用数字 1、2、3 表示订单阶段)来覆盖记录“当前状态”,一旦中间某个节点触发风控回退,或因特殊审批被工程师手工覆盖(override),抑或存在局部代码缺陷,表内就会留下“风控失败却已进入下一环节”或“既能毕业又不能毕业”的自相矛盾记录。老师在课堂上推测,许多长期运行的教务系统数据库里都难免留有这类因手工修改或分支遗漏造成的不一致数据(silently corrupted),之所以难以排查,是因为只存当前快照丢掉了状态演化的来龙去脉。人类为了防范此类状态损坏,在会计领域早就发明了复式记账法。
复式记账法:借贷平衡与结构化的防错约束
既然单纯修改单个余额字段极易因为局部遗漏或手误导致账目静默损坏,人类在没有计算机的年代是如何管理复杂财务状态的?会计学中的复式记账法(Double-Entry Bookkeeping)提供了一种结构化的防错思路:一笔业务发生时,不能只记单边流水,而必须同时记录相互对应的账户。
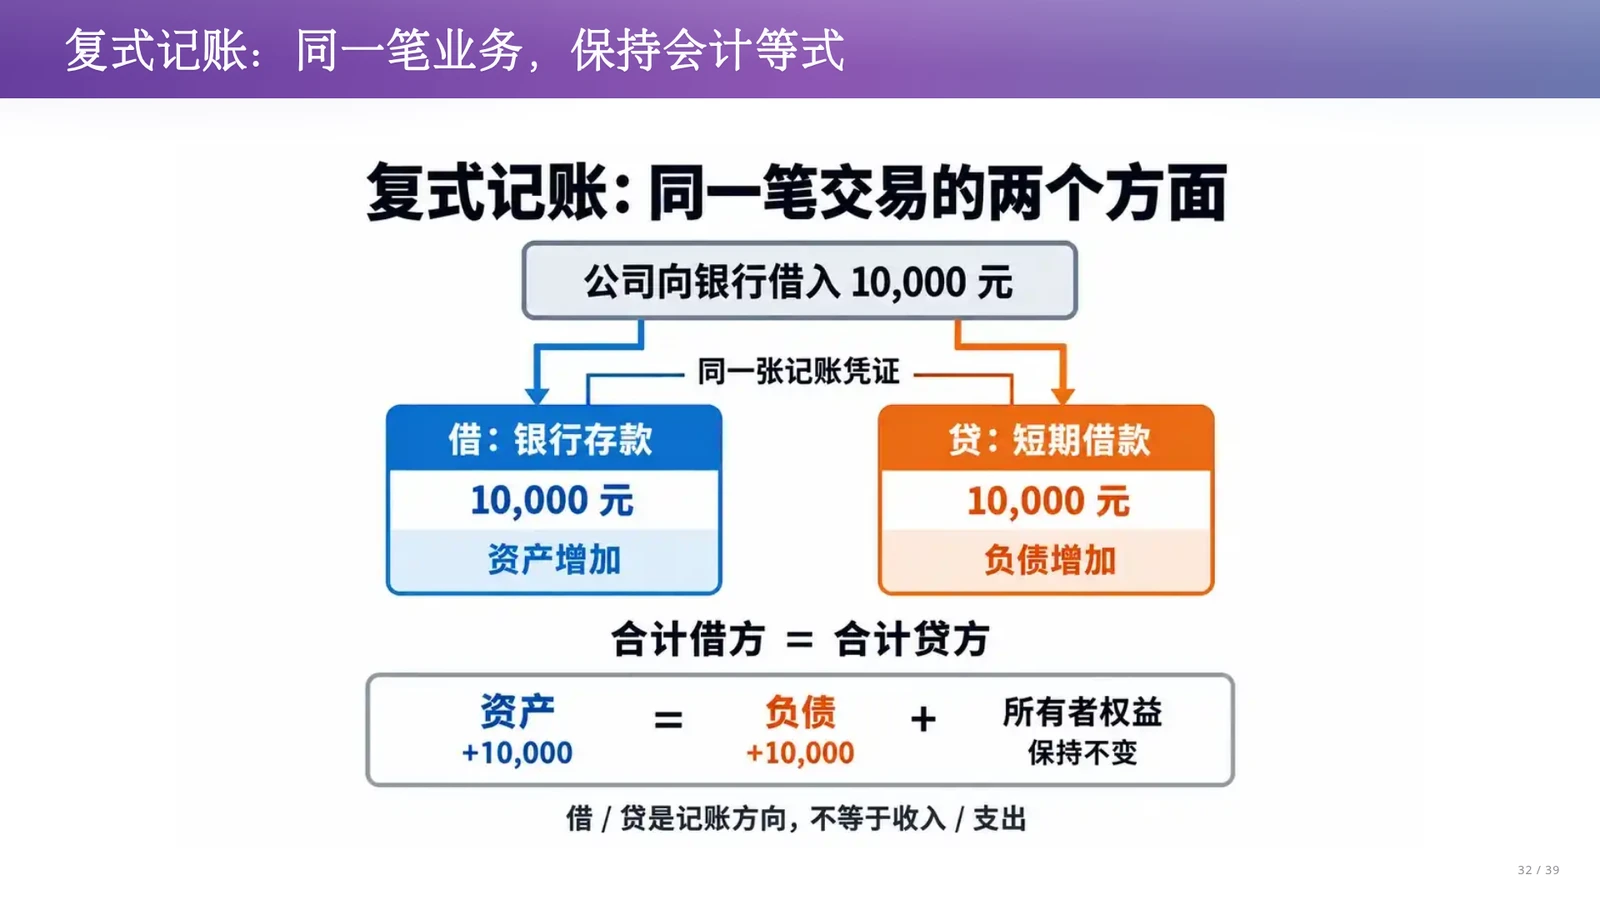
在复式记账法中,任何一笔经济业务都必须以相等的金额,同时在两个或两个以上相互联系的账户中进行登记。在会计术语中,“借”(Debit)和“贷”(Credit)纯粹表示记账符号与方向,绝不能按日常口语字面理解为“向别人借钱”或“贷款给别人”。每一笔分录的借方金额合计必须严格等于贷方金额合计,所有账户的变化共同维持“资产 = 负债 + 所有者权益”这一核心会计等式。例如收到一笔银行借款时,资产端的银行存款增加,同时负债端的短期借款等额增加;归还部分本金时,存款与债务同步等额减少。
复式记账之所以比单式流水账强大,在于它通过冗余但正交的双向记录,建立了一套具备自平衡校验能力(即试算平衡,Trial Balance)的数学结构。如果只改了现金却漏改了负债,借贷立刻失衡,系统马上就能发现状态损坏。但讲义提醒我们必须严守一条边界:算得平绝不等于记得对。如果把餐饮开销错归入办公设备科目,或者把同一笔借贷相等的分录重复录入两次,账面依然完美平衡。因此,结构约束只能拦截格式与算术失衡,原始凭证、业务实质与记账动作之间的对应关系仍须专门核对。
Event Sourcing 与 LLM 编译器:从原始凭证到受约束分录
一位没有系统学过会计专业的程序员,如果要按法规生成包含现金、存货、应付账款、所有者权益的资产负债表与现金流量表,应该如何设计系统?课堂上的记账工具将事件溯源(Event Sourcing)与“把大语言模型当作编译器(LLM as a Compiler)”结合起来,让不懂会计细节的开发者也能生成规范报表。
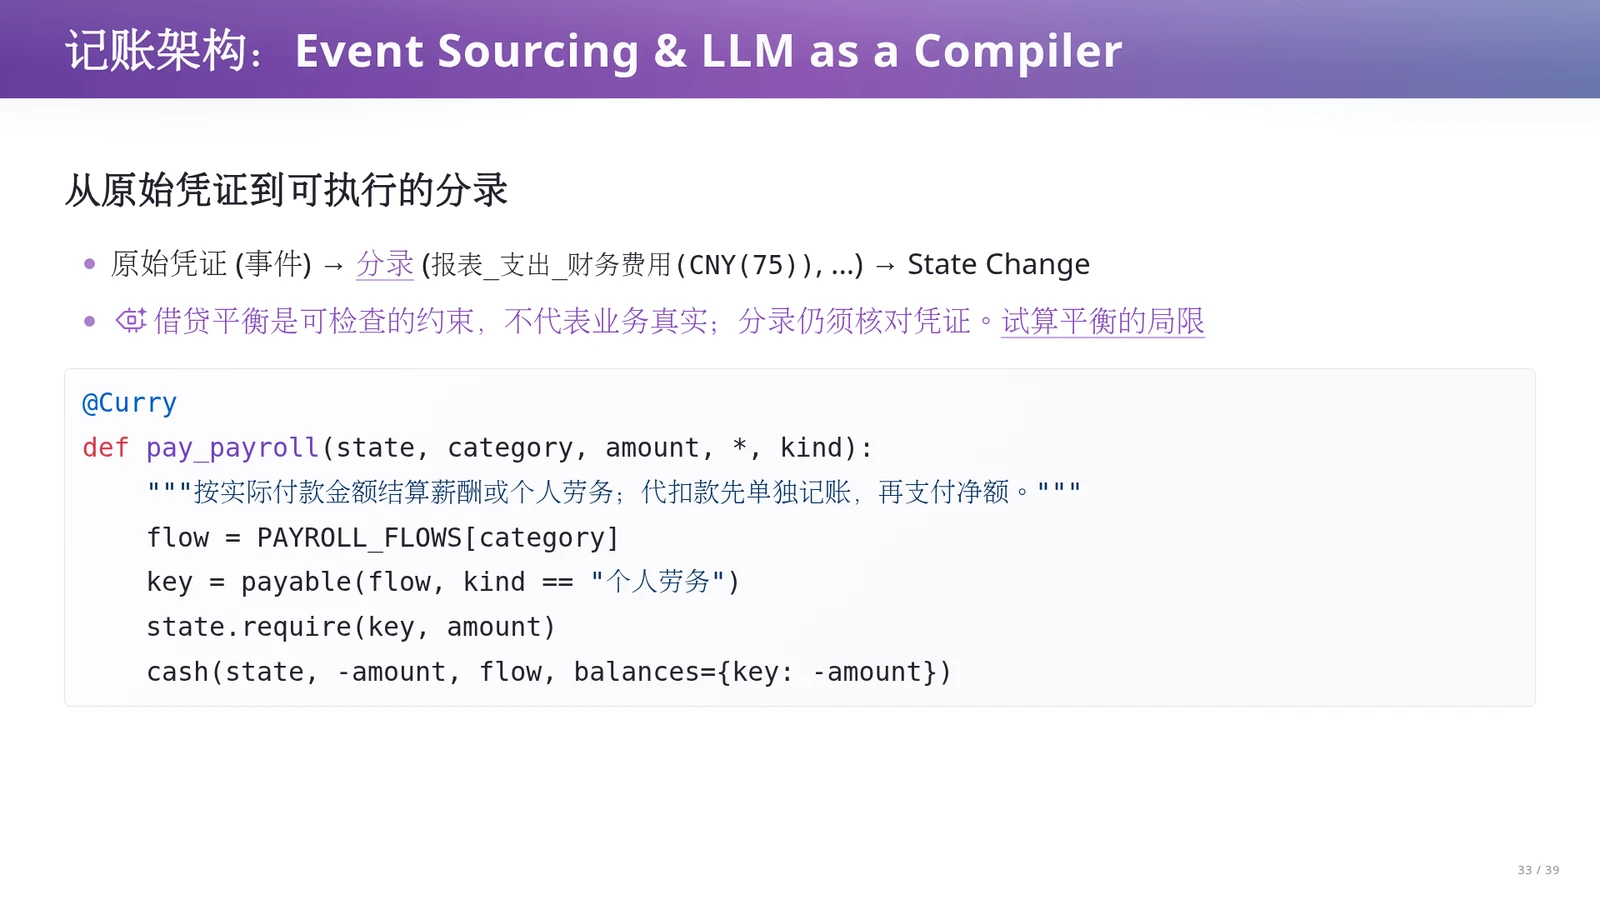
该记账架构包含“原始凭证(事件)\(\rightarrow\) LLM 编译 \(\rightarrow\) 受约束的记账动作 \(\rightarrow\) 状态变更(State Change)”的完整流水线。首次出现的术语“事件溯源”(Event Sourcing)是指不直接覆盖修改数据库中的当前状态,而是将已发生的业务事实作为不可篡改的事件序列持久保存,通过按序重放(replay)并归约(reduce)这些事件来计算出当前状态。在这里,LLM 扮演编译器前端的角色,读取杂乱的银行回单或报销单据,将其翻译成受严格约束的领域函数调用,如 报表_支出_财务费用(CNY(75)),其中 CNY 将数值封装为人民币金额类型。页面下方还给出了利用函数式柯里化(Currying,即 @Curry 装饰器)简化的薪酬结算代码片段 pay_payroll。
在 pay_payroll 中,柯里化技巧允许先绑定账本状态参数 state,从而生成只需传入业务剩余参数的简洁记账动作。业务规则上,代码通过 PAYROLL_FLOWS[category] 和 payable 区分普通薪酬与个人劳务对应的应付款科目,先调用 state.require(key, amount) 校验应付余额充足,再调用 cash 同步扣减现金与应付账款,而代扣税款则要求先通过独立动作记账后再支付净额,以此严格区分“确认费用、形成应付、实际支付”。需要注意,这段代码依赖项目内部的金额类型、分类表及账本接口定义,不能脱离项目上下文单独运行;同时,LLM 编译出的分录仍须经过人工对照原始凭证审查。
从分录归约到多维报表:确定性的状态派生
当原始单据被编译成一行行受约束的记账函数调用后,最终交付给财务审计的资产负债表、利润表和现金流量表是怎样生成的?为什么绝不能让大语言模型直接去填写最终报表里的每一个单元格数字?从记账分录到财务报表的生成完全由确定性规则驱动,同一笔受约束动作会按规则同时更新多张报表。
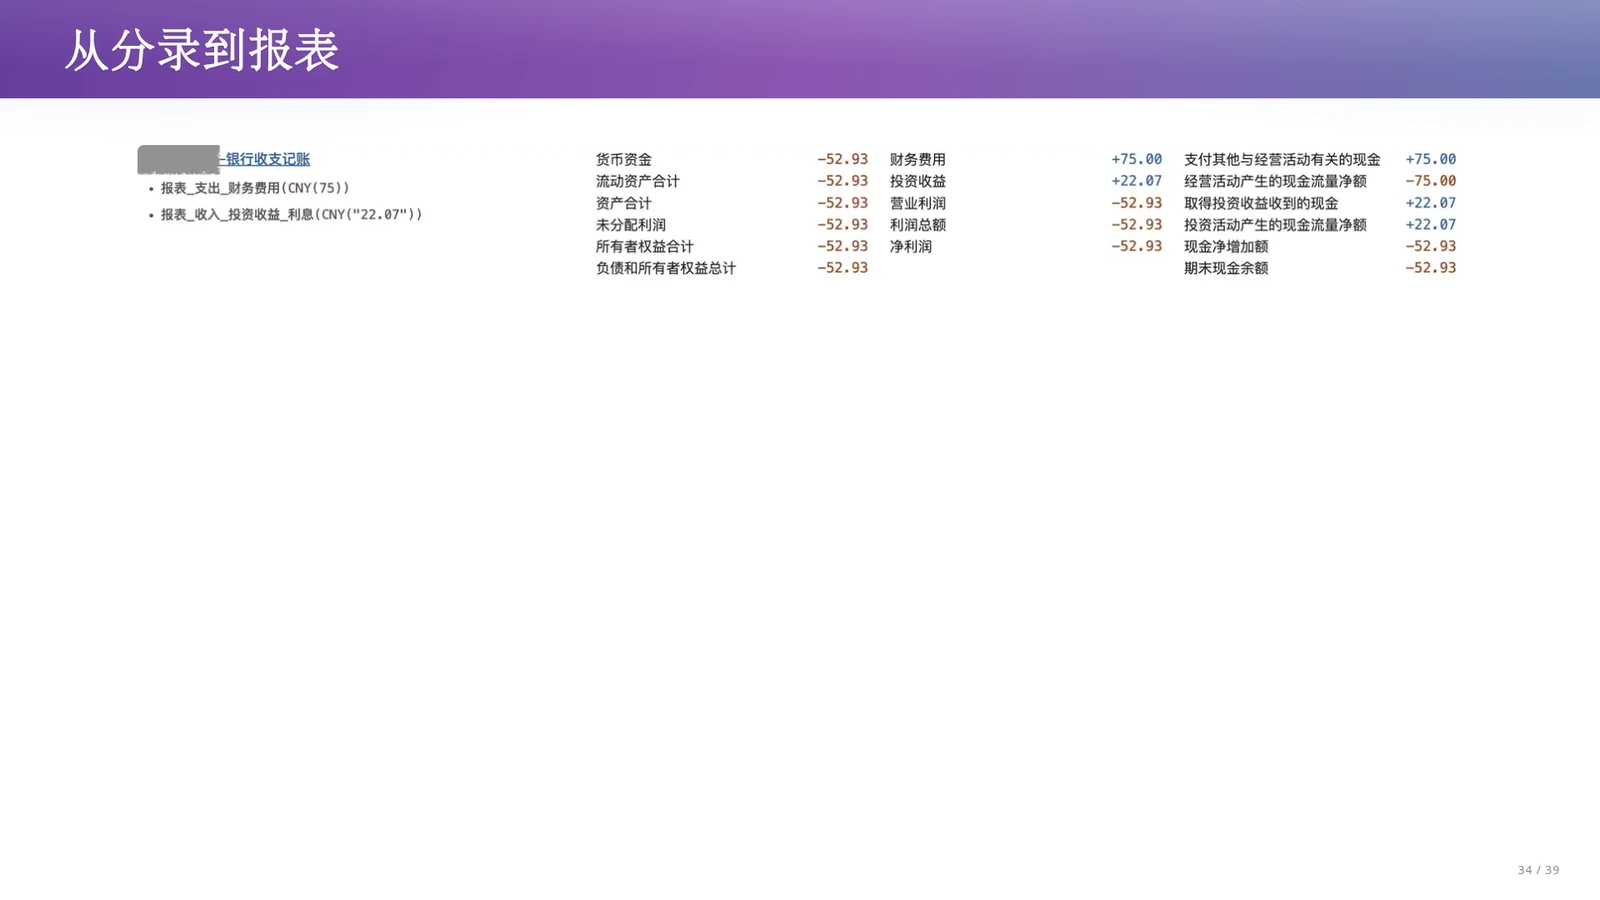
事件流经由确定性的账本规则表归约生成财务报表。在老师的记账工具中,每一类记账动作对资产负债表、利润表和现金流量表各个科目的加减影响(side effects),都被预先编码在确定性的 Python 账本规则中。以讲义中的实际银行收支记录为例,当期发生了两笔动作:一笔是财务费用支出 75 元(即 报表_支出_财务费用(CNY(75))),另一笔是投资收益中的利息收入 22.07 元。程序按时间顺序执行这两条动作后,资产负债表上货币资金的净变化精确计算为 22.07 - 75 = -52.93 元;与此同时,利润表自动记录 75 元费用与 22.07 元收益,计算出净利润减少 52.93 元,所有者权益与现金流量表中的对应项目也按规则同步派生出结果。
这种架构将“非结构化材料理解”与“算术状态计算”分离开来:LLM 只负责把自然语言凭证翻译成候选动作指令,不直接填写报表数字;报表上的所有数字都由确定性的程序从同一组动作重放(replay)计算得出。在当期结账前的人工审核阶段,若发现尚未封存的草稿分录被 LLM 译错了科目,可以直接修正该编译草稿并重跑归约;而一旦账目已经正式确认入账,历史事件便不再原地涂改,发现错账时通过追加冲销或更正事件再重新计算报表,从而避免手工修改多张报表时改此漏彼。
记账为什么麻烦:“当前状态”混杂了过去、现在与未来
跳出具体的会计科目,我们从软件架构的高度反思:为什么无论是企业记账、电商订单还是教务学籍管理,只要采用只存“当前状态”的传统数据库表设计,最终都会演变成难以维护的泥潭?一个看似简单的“当前余额”或“订单状态”字段,背后往往混杂了过去、现在与未来三个时间维度的信息。
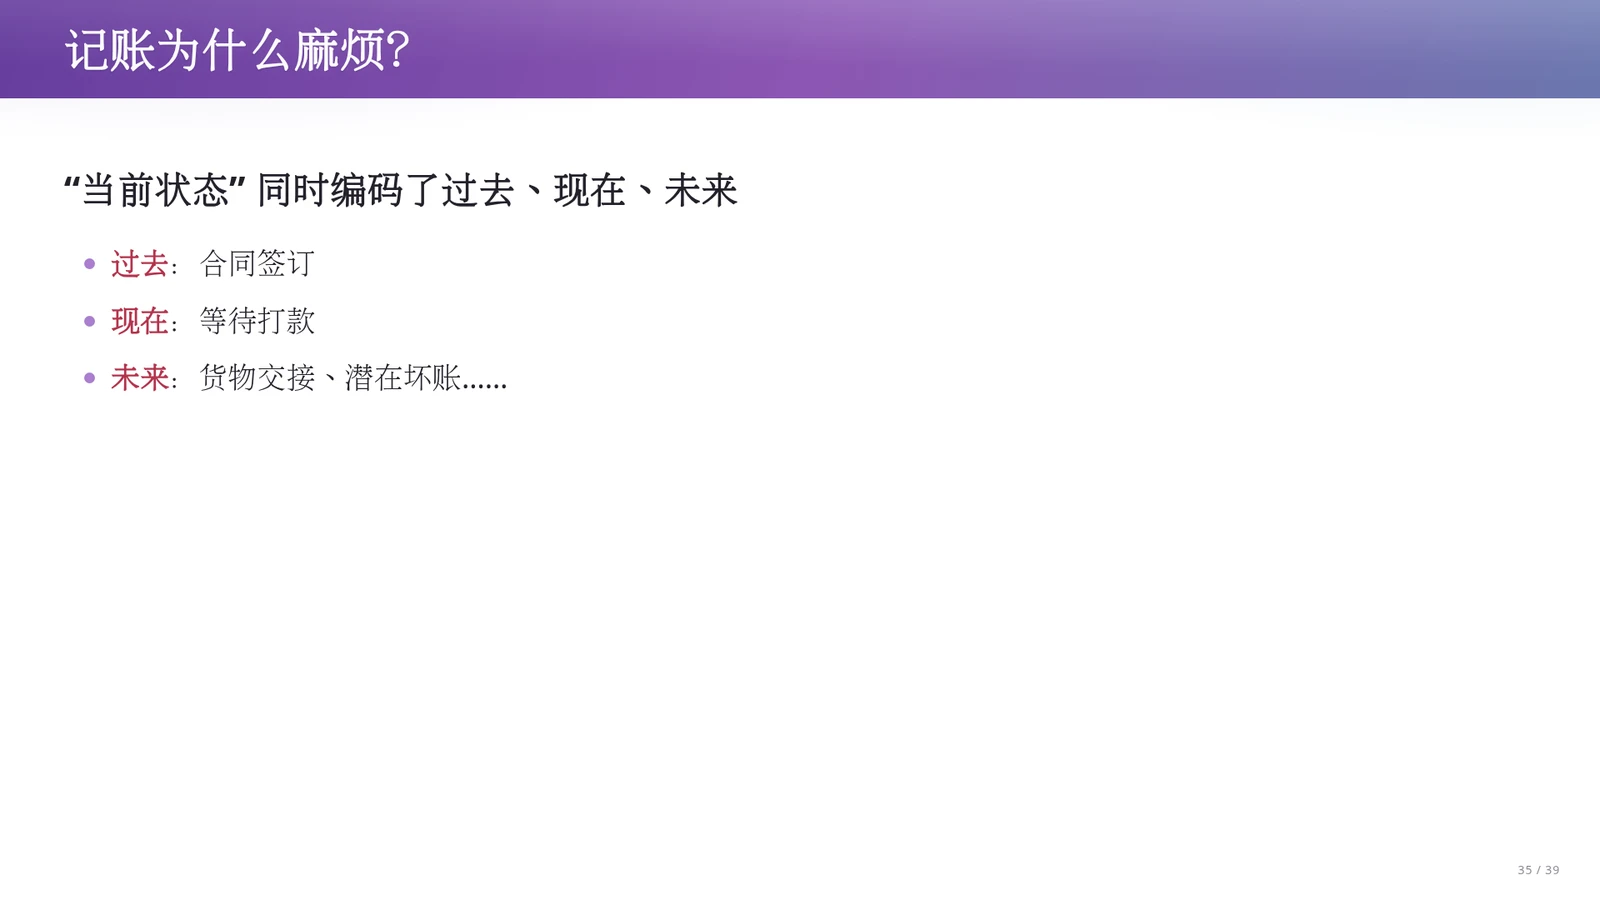
状态管理之所以困难,是因为单一的“当前状态”常常同时编码了过去、现在与未来三个时间维度的语义。以商业交易为例,“过去”代表已经发生且不可抹杀的历史事实,例如双方已经签订了销售合同;“现在”代表系统在当前时刻所处的阶段,例如货已发出、正在等待买方打款;“未来”则代表尚未兑现的业务预期,例如后续的货物交接、尾款结算,乃至可能发生的买方违约与潜在坏账。
讲义提醒我们,如果系统只盯着一个当前余额数字和一个状态枚举字段,截然不同的业务历史就会被压缩进同一种表面状态里,而尚未发生的预期又会与既成事实混为一谈。例如在电商或账本中,“客户从未支付过”与“客户已经全额支付但随后发生了全额退款”,两者的净现金变化虽然都是零,但它们代表完全不同的业务历史与风控含义;再如一笔应收账款,过去已确认收入并形成应收,现在等待收回,未来若确认无法收回而变成坏账,绝不能通过偷偷抹掉当年“曾形成应收”的历史记录来平账。
用 Event Sourcing 分解复杂性:把事实、视图与预期拆开
既然把过去、现在和未来揉进同一个可变状态字段是引发数据静默损坏与逻辑混乱的罪魁祸首,优秀的软件架构应当如何沿着时间维度重新切分问题?事件溯源(Event Sourcing)沿着时间维度重新分解问题,将系统中的信息区分为“事实”“视图”与“预期”。
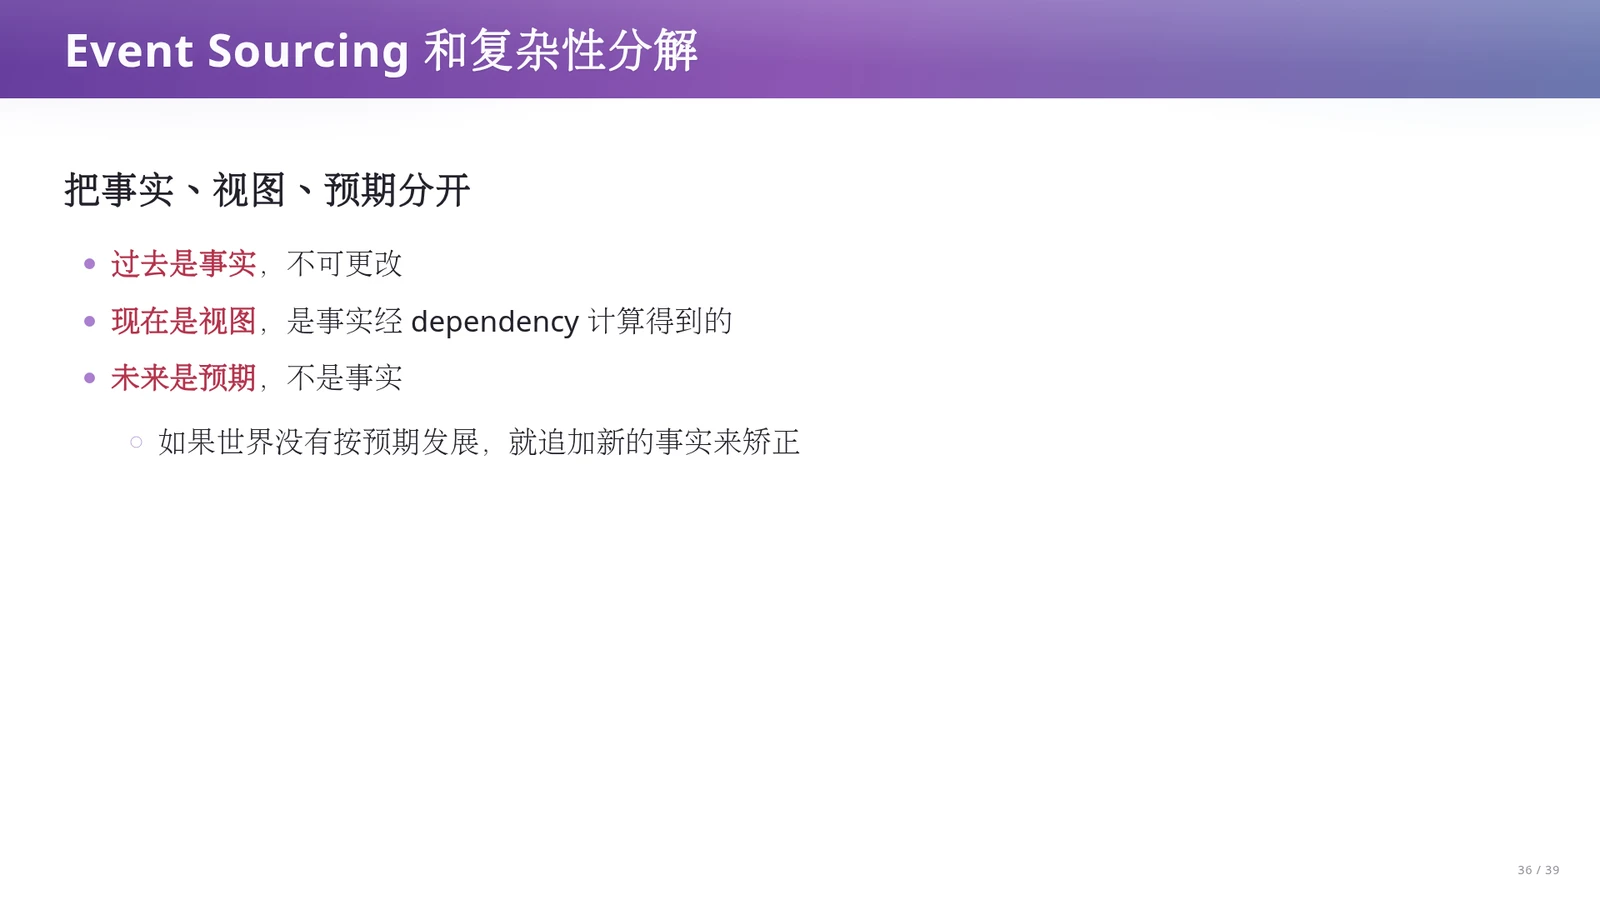
沿着时间轴,系统中的信息可以拆解为三部分:第一,“过去是事实”,已经确认发生的业务事件一旦记入账本便不可原地篡改;第二,“现在是视图”,当前系统呈现的状态并非独立存储的原始数据,而是由历史事实经过显式的数据依赖(dependency)与业务规则计算得出的派生结果;第三,“未来是预期”,预期只是对后续发展的推演或计划,还不是事实。当现实世界没有按照预期发展,或者发现先前的记录有误时,系统绝不靠工程师进数据库手工涂改历史,而是通过追加新的事实(如更正、撤销、冲销、坏账确认或领导特批豁免事件)来矫正当前视图。
课堂讨论进一步展示了这种架构带来的演进与推演能力:因为“现在”完全由“过去”经确定性规则重放得出,我们不仅能在规则变更或历史事实更正时安全地重算当前状态,还能在现有历史序列的基础上挂载模拟分支来推演“未来”。例如在订单支付环节模拟风控通过或失败的不同后续状态,或者在账本事件流之上结合概率模型,推演当多少比例的应收账款变成坏账时企业会面临破产风险。这种将隐式状态同步转化为显式依赖计算的思想,将在下一章直接应用到教务系统的毕业审核重构中。
试算平衡(算得平)绝不证明业务记录正确(记得对)
复式记账法要求每笔分录借贷必相等,维持“资产 = 负债 + 所有者权益”的会计等式。这提供了强大的结构化自检约束,能立即捕获单边记账或算术错误。但讲义明确强调,试算平衡存在固有局限:如果将业务科目归错类别、借贷方向同时颠倒,或将同一笔借贷相等的分录重复录入,账面依然完全平衡。同理,LLM 编译生成的记账动作即使通过了借贷平衡检查,仍必须结合原始凭证进行人工核对。
课堂提示:用 LLM 当编译器前端,用确定性代码守住算术底线
在处理非结构化财务单据时,直接让大语言模型逐格填写资产负债表和利润表是极不可靠的。课堂案例展示了一种稳健的生成式软件工程架构:将 LLM 限制为“编译器前端”,只负责把自然语言凭证翻译成受类型与接口约束的记账函数调用(如 报表_支出_财务费用(CNY(75)));而状态归约、余额校验与多表联动则完全交给确定性的 Python 账本代码执行,从而兼顾了意图理解的灵活性与财务计算的精确性。
易错辨析:“过去不可更改”不等于系统无法修正错误
初学者常误以为 Event Sourcing 要求“过去不可更改”,就意味着一旦录错账目或判错成绩,系统就无法挽回。事实上,“不可更改”是指禁止通过偷偷抹掉或原地覆盖历史记录来解释今天的状态。当发生录入错误、退款或特批豁免时,正确做法是向事件流追加一条新的“冲销”“更正”或“特批override”事件。这样既能让当前视图计算出修正后的正确结果,又完整保留了“曾发生过什么、后来为何改变”的审计线索。
术语消化:长流程与记账架构核心术语消化表
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 复式记账法(Double-Entry Bookkeeping) | 单式流水账无法反映业务全貌、单边漏记或手误导致状态静默损坏却难以发觉的问题。 | 同一笔业务以相等金额同时记入相互对应的借方与贷方账户,共同维持“资产 = 负债 + 所有者权益”,用结构约束提供试算平衡校验。 |
| 事件溯源(Event Sourcing) | 只存“当前状态”导致过去、现在与未来混杂,历史过程丢失,反悔或特批时手工改库引发多处状态不一致。 | 将过去已发生的业务事实保存为不可篡改的事件序列,当前状态作为视图由历史事件经确定性规则重放(replay)与归约计算得出。 |
| LLM 编译器(LLM as a Compiler) | 非结构化原始凭证难以直接由传统程序解析,而直接让大模型生成最终报表数字又缺乏算术可靠性与一致性保障。 | 让大模型充当编译器前端,将业务材料翻译成受约束的领域记账动作代码,再由确定性的账本程序执行状态变更并派生多维报表。 |
| 函数式柯里化(Currying) | 记账或业务动作函数参数众多,在构建事件流与规则映射时直接编写完整调用会导致代码冗长且重复。 | 通过 @Curry 等机制将多参数函数转化为可分步传参的函数,先绑定账本状态 state 等上下文,返回只需业务分类与金额的精简操作函数。 |
@Curry
def pay_payroll(state, category, amount, *, kind):
    """按实际付款金额结算薪酬或个人劳务;代扣款先单独记账,再支付净额。"""
    flow = PAYROLL_FLOWS[category]
    key = payable(flow, kind == "个人劳务")
    state.require(key, amount)
    cash(state, -amount, flow, balances={key: -amount})
该代码片段展示了课堂记账工具中如何用受约束的 Python 函数定义记账动作。输入参数包括账本状态 state、支出类别 category、实际支付金额 amount 以及关键字参数 kind(区分普通薪酬与个人劳务)。执行时,先通过 PAYROLL_FLOWS 与 payable 定位对应的应付款科目 key,再调用 state.require(key, amount) 校验应付余额充足,最后调用 cash 同步扣减现金(-amount)与对应的应付账款余额(balances={key: -amount})。使用条件与限制:代扣款须先通过独立动作记账后再调用此函数支付净额;本片段依赖项目内部定义的 @Curry、金额类型、PAYROLL_FLOWS、payable 及 cash 接口,不能脱离项目单独运行。
本章小结
本章剖析了为何单纯将代码塞进 Model 并只存“当前状态”无法应对跨越漫长周期与强规则的业务系统。通过引入会计复式记账法与“Event Sourcing + LLM 编译器”记账案例,我们看到:必须严格区分不可篡改的过去(事实)、由事实经规则派生计算的现在(视图)以及尚未发生的未来(预期)。
将非结构化凭证编译为受约束的事件动作,并由确定性代码归约出报表视图,不仅能防止状态静默损坏,更为审计溯源、错账冲销与未来风险推演提供了坚实的架构基础。
八、显式数据依赖:从状态一致性转向计算正确性
上一节借助会计账本与事件溯源,将业务系统中的过去(不可篡改的事实)、现在(由事实派生的视图)与未来(预期)清晰剥离。现在将这一思想带回本讲开篇的教务系统毕业审核难题:为什么一次成绩更正或培养方案微调,常常让系统陷入前后矛盾的状态泥潭?本章将展示如何通过显式建模数据依赖,构建一条从原始记录到审核结论的可追溯计算路径,并进一步探讨为什么把“多份状态的一致性维护问题”转化为“可重算、可测试、可审计的计算正确性问题”,是现代软件架构与生成式软件工程的核心转折。
教务系统的数据依赖:让毕业结论可追溯
在传统面向当前状态的数据库设计中,教务系统往往在同一张或几张表里并列存放学生的成绩记录、已修课程列表、总学分、分类学分,以及一个代表“是否满足毕业条件”的 0 或 1 布尔字段。如果把这些字段都当成可独立修改的事实,一旦发生“查卷反悔”或政策变动,人工与零散代码就极易漏改下游状态。跳出零散的字段修改,我们可以用数据依赖(Data Dependency,即一个数据项的取值由哪些上游数据项及计算规则决定)来重新组织毕业审核架构。
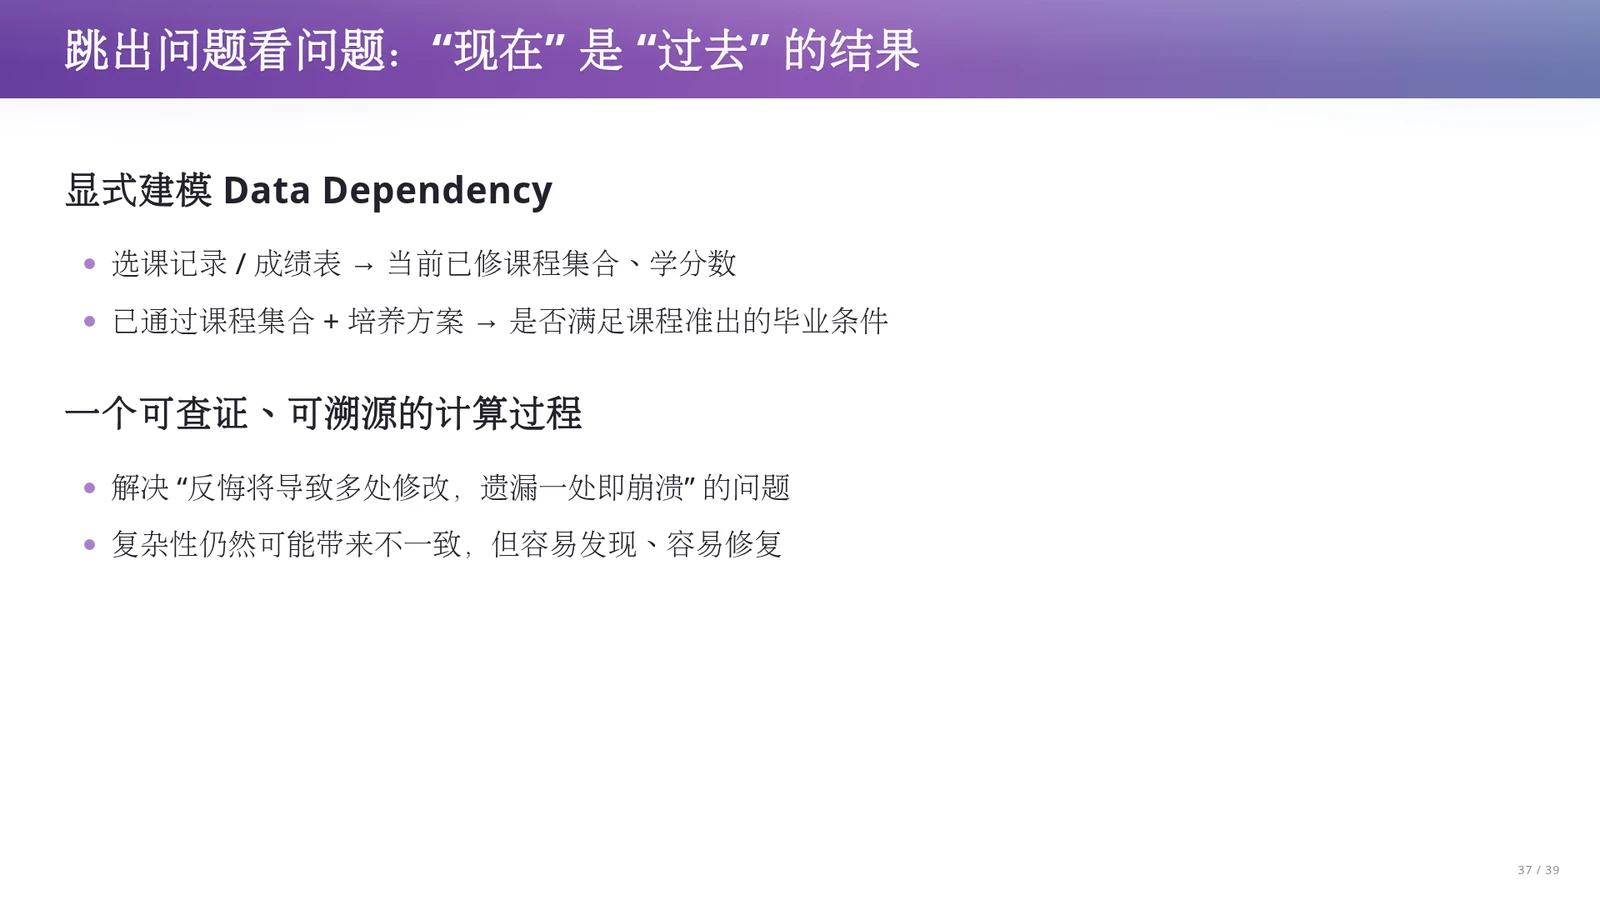
跳出局部字段来看,“现在”本质上是“过去”的结果。通过对数据依赖进行显式建模,教务系统的核心状态形成了一条清晰的推导链:底层的选课记录与成绩表作为基础事实,决定当前已修课程集合与学分数;已通过课程集合再与适用的培养方案结合,计算出该学生是否满足课程准出的毕业条件。
这种设计将原本隐含在各处增删改操作里的业务联系转化为一个可查证、可溯源的计算过程。
当上游发生“反悔”变更时,无需靠人工寻找并修改多处副本,从而避免了“遗漏一处即导致系统状态崩溃”的隐患;即便计算规则存在缺陷导致不一致,也能顺着依赖链快速发现并修复。
课堂上举了一个具体例子:某位学生原本通过了《计算机系统基础》(ICS),并据此选修了后续的《操作系统》,学分汇总与准出状态也已更新;后来该生坚持查卷,发现一道原本空着却被老师酌情给分的题目,扣回分数后成绩从及格更正为不及格。若靠人工去数据库里逐处改字段,极易漏改下游状态;而显式建立数据依赖后,系统可以根据更正后的成绩事件自动重算当前已通过课程集合、分类学分、课程准出结论,并重新校验后续课程的先修条件是否仍满足(至于已经选上的《操作系统》是否退课或由院系人工复核,则交由专门的教务规则处理,而不必靠偷偷涂改历史或漏改汇总列来应付)。同时需要注意两点架构边界:第一,课程准出条件满足,不能悄悄等同于毕业设计、资产归还等其他独立毕业要求均已满足,各项要求应进入各自明确的判断分支;第二,当存在交换课程学分认定(如两门合抵一门必修课)或“领导特批豁免”时,不能直接把最终的毕业布尔值手改为 1,而必须将认定记录或特批的批准对象、适用范围与依据作为正式事实保存下来参与计算。这样下一次重算时,系统依然能回答“他为什么能通过审核”。
跨层计算依赖的缺失与现代框架的显式化演进
既然许多业务状态本质上都是上游事实与规则的派生结果,为什么工程师在实际开发中仍然习惯于在数据库里到处新建冗余的状态列(如 can_graduate = 0/1),并在业务代码里手工同步它们?这促使我们重新审视关系数据库与查询语言在整个软件栈中的角色边界:当计算逻辑跨越存储层、应用层与展示层时,谁来充当依赖关系的维护者?
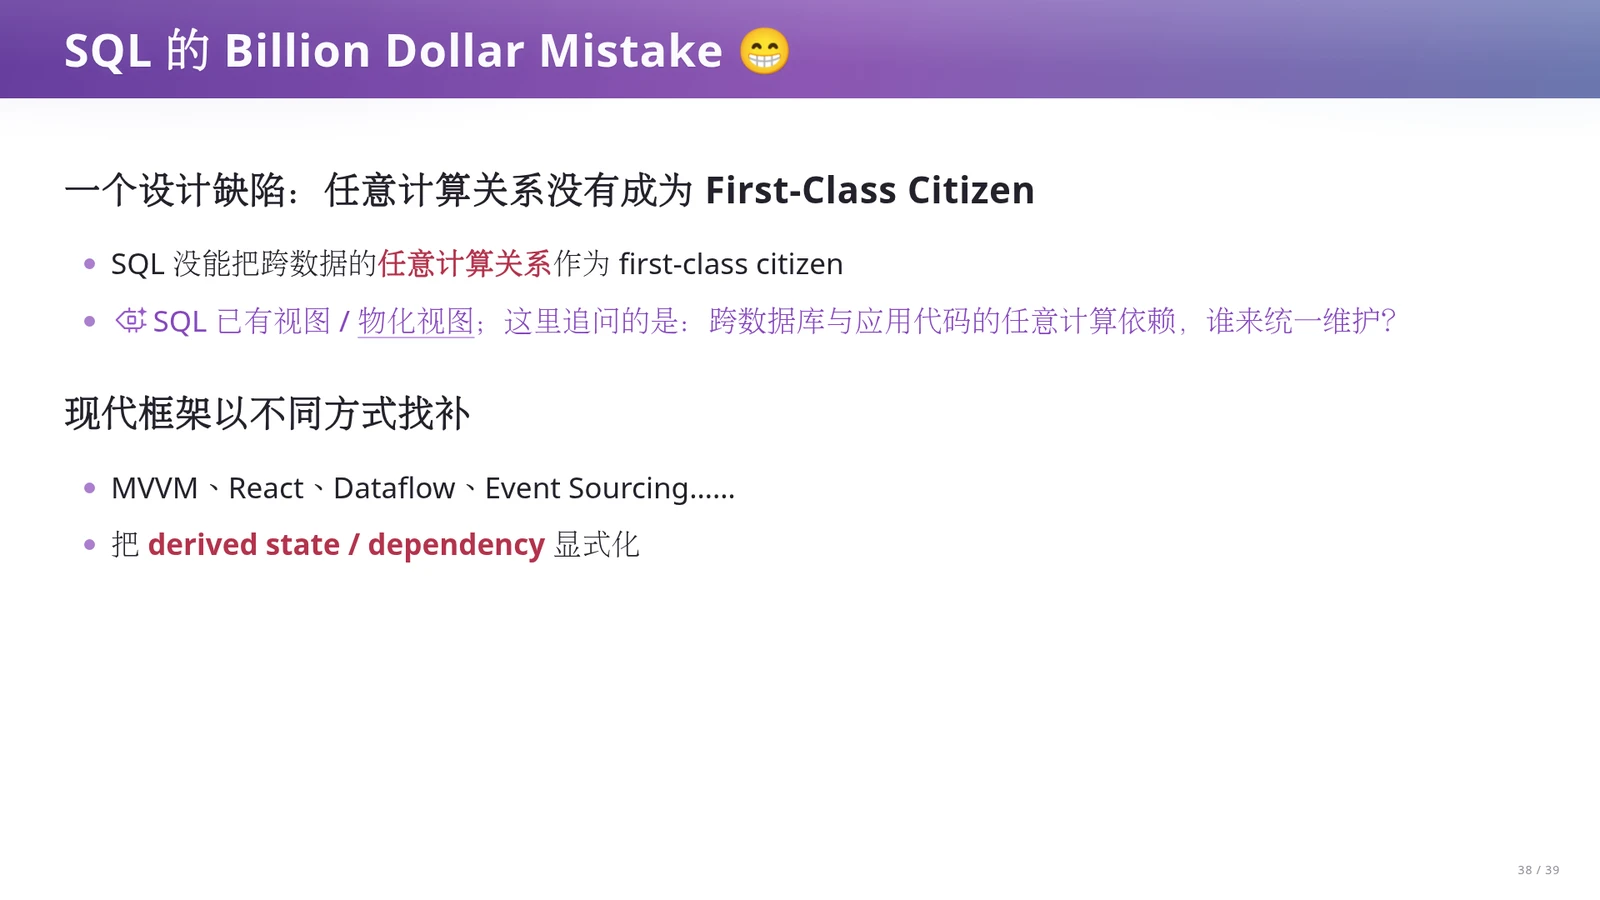
从跨层数据依赖的角度反思,课堂上对 SQL 提出了一个带有调侃意味的批评,将其比作类似 Tony Hoare 空指针(Null Pointer)的“Billion Dollar Mistake”。批评的核心在于:SQL 未能把跨数据的任意计算关系(即图灵完备的通用业务推导逻辑)作为一等公民(First-Class Citizen,指在语言或系统中可以直接声明、传递、组合、检查并由系统自动追踪维护的实体)来统一管理。课件同时客观指明了技术事实:SQL 本身已经具备视图(View)、约束以及物化视图(如 PostgreSQL Materialized Views,可持久化查询结果并通过刷新重新生成);此处真正追问的痛点是,当任意复杂的计算依赖跨越了数据库、应用层业务代码、缓存乃至前端界面时,谁来统一维护这些依赖、判断何时失效并追溯来源?下半部分指出,MVVM、React、Dataflow(数据流架构,将计算建模为有向图上的数据流动与节点变换)与 Event Sourcing 等现代技术,都在各自层次上尝试把派生状态(Derived State,由其他基础状态通过计算得出的状态)与数据依赖显式化。
理解这一页需要把握严谨的工程分寸:把 MVVM、React、Dataflow 与 Event Sourcing 放在同一张幻灯片中,是老师提供的一种理解软件架构演进的统一视角,绝不是断言这些处于不同系统层次、机制各异的框架都是因为 SQL 的某个缺陷才诞生的。例如在前端层次,课程筛选列表 visibleCourses 完全可以由原始课程数据 courses 与筛选词 query 经纯函数计算得出;Vue 通过 computed 追踪依赖,React 通过每次渲染的状态快照重算界面,二者都避免了手工去同步第二份列表状态。而在后端业务层次,当毕业审核或薪酬结算的规则无法简单写进一句 SQL 查询时,显式构建应用层的数据流或事件溯源,正是为了填补跨层依赖管理的空白,这自然引出了下一节的核心架构原则。
从状态一致性转向计算正确性及其工程前提
理解了派生状态与显式依赖之后,我们需要将其提炼为可指导系统设计的通用架构原则。如果不在多处复制并手工维护可变状态,系统究竟应该持久化什么?当历史事实被重放、派生视图被重新计算时,又必须满足哪些严格的工程前提才能保证结果可靠且不闯祸?
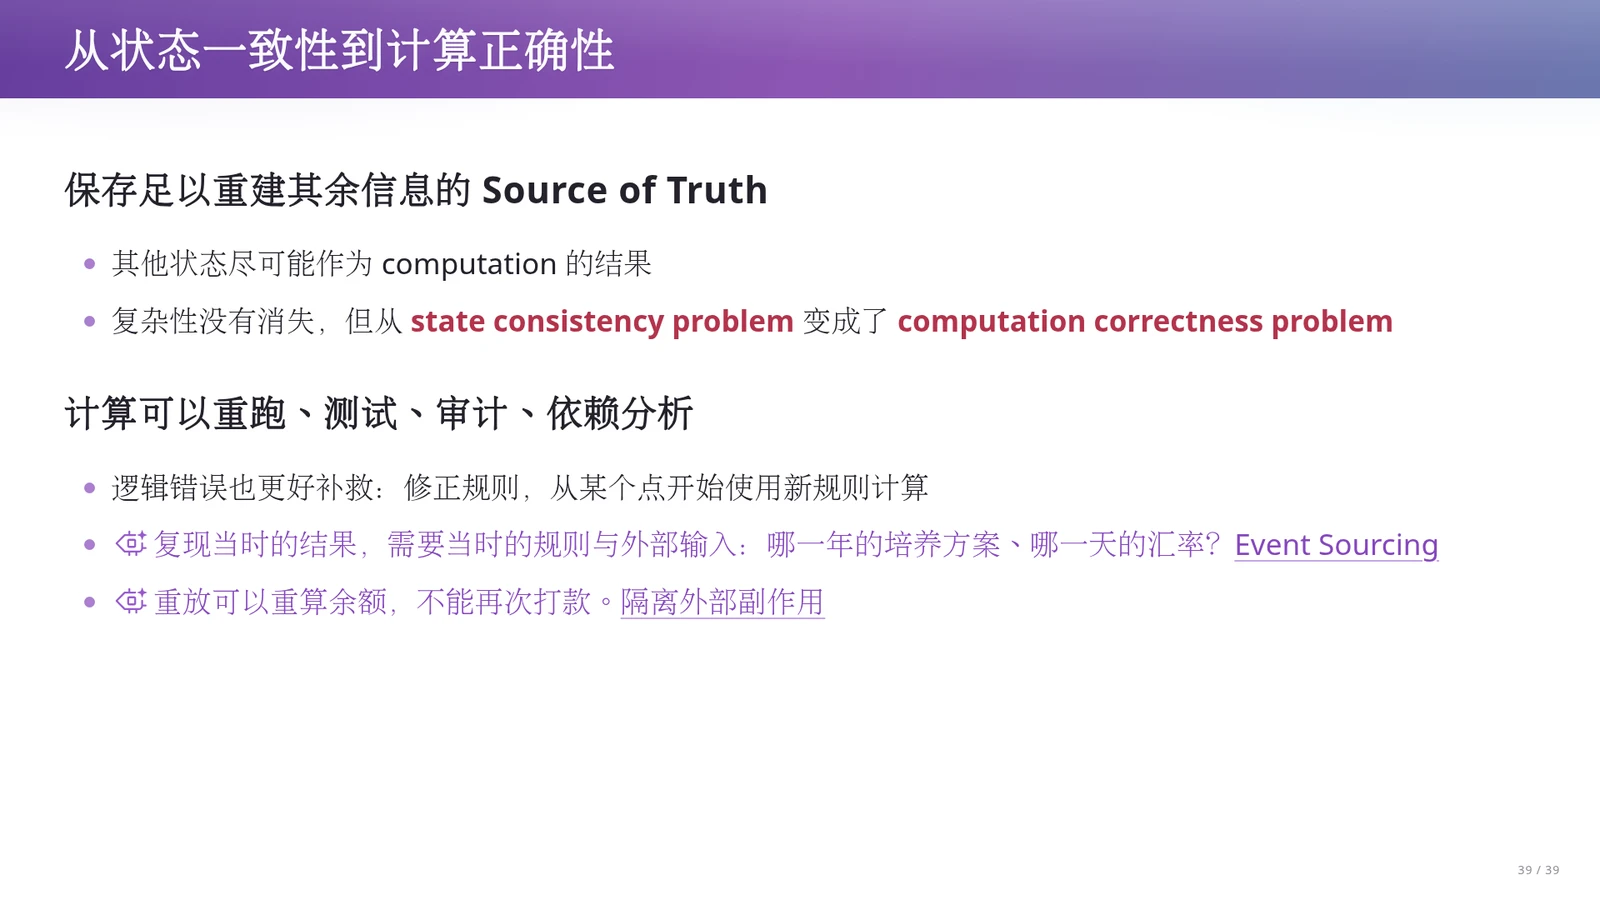
由此可以提炼出一条核心设计原则:系统应当保存足以重建其余信息的事实依据(Source of Truth,系统中作为最终依据、不可随意篡改的原始事实集合),而其他状态应尽可能作为计算(Computation)的结果存在。这样做的实质,是将原本令人头疼的“状态一致性问题(State Consistency Problem,即如何保证散落在多处的可变状态副本在任何修改路径下永远同步)”转化为“计算正确性问题(Computation Correctness Problem,即给定输入事实与规则函数,如何验证输出结果的逻辑正确性)”。课件进一步列出了这种转化带来的四大工程收益:计算可以重跑、可以编写有意义的测试、可以审计推导步骤、可以做静态或动态的依赖分析;一旦发现旧规则有逻辑错误,只需修正规则并从明确的边界开始重新计算。最后,课件结合 Martin Fowler 对 Event Sourcing 的经典分析,强调了重算与重放的两项硬性约束:第一,复现历史结论必须保留当时的规则版本与外部查询输入(如哪一年的培养方案、哪一天的汇率);第二,重放过程只能重算内部状态(如账户余额),必须隔离外部副作用(如不能把已完成的外部打款再执行一次)。
讲义对这一原则作了务实的补充:在实际工程中,为了查询性能,系统完全可以保存汇总表、索引、物化视图或缓存,但架构上必须明确它们从哪些事实派生而来、在什么条件下失效,以及如何全量或增量重建。例如计算机系统基础这门课后来调整了学分,重算往届学生的毕业资格时,必须读取该学生修读当年的课程学分与适用培养方案,而不能偷偷替换成今天的最新表数据。在生成式软件工程与实验二(Deeper Research)的背景下,这一原则同样至关重要:如果让 AI 面对散落各处的隐式状态同步,模型只能靠猜测去修补数据;当我们把原始事实、研究资料、评审意见与推导规则在工作区(Workspace)中显式分离并建立可验证的评估循环时,无论是业务代码生成还是 Agent 通过“算力换智力”迭代求解,都有了清晰、可审计、可回滚的检验对象。
核心架构原则:区分事实依据与派生状态
系统应持久化保存足以重建其余信息的事实依据(Source of Truth),包括不可篡改的历史事件、人工审批决定及其依据、以及当时的规则与外部参数版本;其余状态应尽可能作为这些事实经由明确规则计算出的派生结果。为性能保留的缓存、汇总列或物化视图,必须明确其数据来源、失效条件与重建机制,绝不能作为独立修改的入口。
课堂提示:为什么“计算正确性”对人类和 AI 都更友好
维护多份可变状态的同步,要求开发者或 AI 在每次写操作时枚举所有潜在受影响的角落,一旦遗漏就会造成静默的数据损坏(Silently Corrupted)。相反,将问题转化为纯函数式的计算推导后,输入与输出边界清晰:既可以用单元测试覆盖边界案例,也可以在规则变更或大模型翻译出错时,直接修正规则并重跑流水线,无需编写高风险的手工数据库修补脚本。
易错点核查:SQL 的能力边界与事件重放的两大禁忌
第一,课堂将 SQL 缺乏跨层通用计算依赖管理调侃为 Billion Dollar Mistake,但切勿误以为 SQL 没有视图、约束或物化视图,也不可将 MVVM、React 等不同层次框架的诞生全部归因于 SQL。第二,重放事件流重算状态时,严禁直接读取随时间变化的当前外部数据(须固化历史培养方案、历史汇率等输入),且严禁在重放内部账本时重复触发真实扣款、发送外部通知等外部世界副作用。
术语消化:从状态同步到显式依赖的核心概念消化
| 术语 | 解决的问题 | 机制与课程关系 |
|---|---|---|
| 数据依赖 (Data Dependency) | 消除多处手工修改同一业务结论导致的遗漏与状态矛盾 | 显式声明下游状态由哪些上游事实与规则计算得出,使教务审核等结论可追溯、可重算 |
| 派生状态 (Derived State) | 避免将本可推导出的结果当作独立可变事实重复存储 | 如前端的筛选后课程列表、后端的分类学分汇总,仅随上游输入变化而更新,不直接手改 |
| 单一事实来源 (Source of Truth) | 界定系统中哪些信息是不可随意抹除或覆盖的根基 | 保存选课成绩、审批豁免记录、历史规则版本等原始事实,作为重建一切派生视图的唯一依据 |
| 计算正确性问题 (Computation Correctness) | 替代难以穷举检验的“多副本状态一致性问题” | 将架构重心放在验证“事实 + 规则 \(\rightarrow\) 视图”的推导逻辑上,支持测试、审计、依赖分析与AI辅助验证 |
| 外部副作用隔离 (External Side-Effect Isolation) | 防止事件溯源在重放历史记录时对外部系统造成重复变更 | 区分内部状态重算(如重新汇总余额)与外部网关调用(如银行真实打款),重放时只算账不打款 |
def evaluate_course_clearance(transcript_events, waivers, curriculum_snapshot):
    """
    输入:
      transcript_events: 选课、成绩录入与更正的历史事实序列
      waivers: 经审批的课程替代与豁免记录(含批准依据与适用范围)
      curriculum_snapshot: 学生适用年级的培养方案快照(固定历史版本)
    输出:
      包含已通过课程、分类学分、课程准出结论及溯源依据的派生视图
    """
    passed_courses = derive_passed_courses(transcript_events)
    effective_credits = calculate_credits(
        passed_courses, waivers, curriculum_snapshot.credit_rules
    )
    is_course_cleared, audit_trail = check_requirements(
        effective_credits, waivers, curriculum_snapshot.graduation_rules
    )
    return {
        "passed_courses": passed_courses,
        "credits": effective_credits,
        "course_clearance": is_course_cleared,
        "explanation": audit_trail
    }
该伪代码展示了如何将教务系统的课程准出判断从“手改数据库布尔列”转化为纯计算过程。函数接收成绩事件流、正式豁免记录以及固化版本的培养方案快照作为输入,逐层派生出已通过课程集合、有效分类学分以及最终的课程准出结论与审计线索(audit_trail)。当发生查卷改分或新增特批豁免时,只需追加事件并重新调用此函数即可获得一致的新视图;注意此处仅计算“课程准出”,毕业设计、资产归还等其他毕业条件由各自独立的计算链路负责。
本章小结
本章回到教务系统毕业审核案例,揭示了将派生结论当作独立可变状态存储的危害。通过显式建模数据依赖,坚持“只保存足以重建其余信息的事实依据,让其他状态尽可能成为计算结果”的架构原则,我们将棘手的多处状态一致性问题转化为了可重跑、可测试、可审计的计算正确性问题。
配合历史规则版本固化与外部副作用隔离,这一原则不仅让复杂业务系统清晰可溯源,也为生成式软件工程中的 AI 生成与验证奠定了可靠基石。
总结与延伸
- 回顾本讲,我们完成了一次从软件工程底层哲学到具体系统架构演进的深度穿透。软件工程的本质是驾驭复杂性:需求工程直面问题领域的本质复杂性,通过合理的权衡(兼顾 MVP 深度优先与全局广度思考,警惕过度承诺带来的审计成本与大模型上下文/token 开销)来收缩意图空间的不确定性;而架构设计则致力于分解本质复杂性、减少由技术选型和实现方式额外制造的附带复杂性。检验架构好坏最朴素的试金石,正是“当需求改了一处,系统里需要跟着改多少处?”
- 为了迁就人类参数有限的“小脑袋”,先驱者们给出了跨越时代的答案:Dijkstra 的“珍珠项链”与 SIMULA 的概念层次、协程机制,教会我们推迟具体表示决策、用分层抽象缩短问题与机器的距离;Steele 的《Growing a Language》与 UNIX、关系数据库、Internet 三大基础设施则共同印证了一个核心命题——好的架构不是只给出一个静态解,而是固定公共协作规则、保留局部扩展空位(slots),为开放的需求空间设计一片可生长的解空间。
- 当我们在操作系统、数据库和网络之上构建面向客户的业务系统时,这一思想一步步推动着架构演进:MVC 将业务规则(Model)、界面展示(View)与输入协调(Controller)分离,克服了 JSP 等模板页面随手复制业务逻辑的弊端;MVVM、Vue 与 React 进一步认识到“是否持久化与是否值得建模是两件事”,将搜索词
query等ViewState纳入模型,坚持只保存原始状态,让派生列表随响应式计算属性或状态快照(注意 React 中调用setState仅请求下一次渲染,不改变当前渲染快照)自动更新。 - 然而,面对跨越漫长周期与强规则约束的业务(如电商全链路订单、复式记账账本、教务毕业审核),仅在数据库里维护“当前状态”会把过去、现在和未来揉作一团,一旦发生查卷改判挂科或人工特批覆盖,极易造成多处状态漏改与静默损坏。课堂记账工具“Event Sourcing + LLM as a Compiler”的实践,以及教务毕业审核依赖链的重构,为我们指明了方向:将不可篡改的过去(事实 Event)、由事实经规则派生的现在(视图 View)与尚未兑现的未来(预期)清晰分开。同时我们也须谨记工程边界:复式记账试算平衡不代表业务记录真实正确,LLM 编译出的分录与依赖项目内部接口的代码片段(如
pay_payroll)仍需凭证核对与上下文支撑;重放历史必须固化当时的培养方案或汇率等外部输入,并严格隔离真实打款等外部副作用。 - 本讲在上一讲“需求逆向与初步架构认知”的基础上,完成了向“数据依赖与状态演进”的纵深推进,并与实验(2)《Deeper Research》中通过搜索树探索设计解空间、用算力换智力的 Agent 实践紧密呼应。课堂上对 SQL 未能将跨系统任意计算关系作为一等公民的启发式批评(尽管 SQL 已有视图、约束与物化视图),实则是为了引出贯穿全讲的黄金准则:只保存足以重建其余信息的事实依据(Source of Truth),让其他状态尽可能成为显式依赖下的计算结果。 在生成式软件工程时代,代码生产越廉价,我们越需要通过经典阅读建立架构品味,把隐式的状态同步转化为显式的计算正确性问题,让系统中的每一个重要结论都能清晰回答“我是怎样算出来的”。
学习练习
用下面的延伸练习检查自己能否应用本讲方法。
练习 1:用 AI 精读经典文献中的“概念层次”(Concept Hierarchies)
请阅读 Dahl、Dijkstra 和 Hoare 合著的《Structured Programming》第三部分第 4 节(pp. 184–185)与第 7 节(pp. 208–220),借助 AI 工具沿着 TWLIST(双向链表)\(\rightarrow\) MINISIM(离散事件模拟)\(\rightarrow\) Job Shop Model(车间调度模型)三层结构进行拆解,撰写一份读书笔记;并在笔记末尾对比 SIMULA 协程与现代 Python 协程(PEP 342)或 Go 语言舍弃类型继承层次的设计取舍。
验收标准:
- 笔记必须针对
TWLIST、MINISIM、Job Shop Model每一层明确回答三个问题:该层新引入了什么业务或系统概念?上层调用者因此可以忽略哪些底层细节?哪些越界操作会破坏底层的假设? - 每一层的分析必须附带原文对应的具体代码标识符(过程名/类名)及准确页码(在 pp. 208–220 范围内核实),不得仅有空洞的概括性赞美。
- 准确阐述第 4 节(pp. 184–185)下棋程序案例中“协程(Coroutine)”解除主从调用控制流耦合的建模本意,并与现代语言特性给出至少两项有据可查的异同对比。
练习 2:前端派生状态重构与 UNIX 组合管道实践
第一部分(前端建模):针对教务系统的“课程列表筛选与已选学分统计”界面,分别用 Vue 3(Composition API)或 React(Hooks)编写一个最小原型组件,支持按关键词 query 和“仅看有余量课程”复选框过滤课程,并实时显示当前可见课程数量。第二部分(UNIX 组合):假设课程数据以 JSON 数组存放在本地文件 courses.json 中,编写一条 POSIX 兼容的 Shell 流水线,结合 jq 和 fzf 实现交互式检索课程并将选中课程的编号输出到标准输出。
验收标准:
- 前端组件代码中,原始状态只允许包含课程源数据、
query字符串和复选框布尔值;过滤后的可见课程列表visibleCourses与统计数量必须作为派生值(Vue 使用computed,React 在渲染函数内基于当前状态快照直接计算),严禁为visibleCourses额外声明独立的ref或useState并手动同步。 - 若使用 React,需在代码注释或说明文档中结合具体事件处理函数,解释为何调用
setQuery后在当前渲染函数上下文里直接打印query仍是旧值(State as a Snapshot)。 - Shell 流水线能够正确处理包含空格的课程名称,不混入彩色控制符或多余提示语到数据管道中,且能根据退出状态码区分“用户正常选中课程”与“用户按 Esc 取消选择”。
练习 3:基于 Event Sourcing 与显式数据依赖重构“教务成绩更正与毕业课程准出审核”模块
设计并实现一个不依赖数据库可变汇总字段的内存级或轻量持久化原型系统,用于处理学生的选课、成绩录入、查卷成绩更正(反悔)、交换课程学分认定以及领导特批豁免,并能随时计算并解释某位学生“当前是否满足课程准出条件”。
验收标准:
- 系统中持久化的 Source of Truth 只能是不可篡改的历史事件序列(如
GradeRecorded、GradeAmended、CreditRecognized、ExemptionGranted)以及带版本号的培养方案规则,不得将“当前总学分”或“是否准出(0/1)”作为独立可直接手改的存储字段。 - 构造并跑通“查卷反悔”测试用例:某学生《计算机系统基础》初始成绩为及格(满足《操作系统》先修要求及必修学分),随后追加一条
GradeAmended事件将其更正为不及格;系统重算后须自动反映出已通过课程集合、必修学分、课程准出结论以及当前先修条件满足状态的连锁变化(可按原型预设的教务规则标记已选后续课程需复核或失效,但不得覆写既有选课历史事件),无需人工修改多处状态。 - 每一个计算得出的准出结论(通过或未通过)必须附带可审计的追溯信息(Provenance/Trace),能够输出该结论具体依据了哪些历史事件 ID、哪一版培养方案规则以及哪条特批豁免记录;同时在文档中明确区分“课程准出条件”与“毕业设计、资产归还等其他毕业要求”。
拓展阅读
下面列出本讲的原始讲义、课件和相关项目,便于回看案例、查阅代码并继续实践。
- 官方讲义:https://jyywiki.cn/GSE/2026/lect7.md
- 官方课件:https://jyywiki.cn/GSE/2026/slides7.html
- 社区字幕校订稿(固定版本):https://github.com/NinZeige/NJU-2026-GSE-Captions/tree/0456f3a46fd5fa2f2a86123e02b7ed48696adacb
- 原课程许可 CC BY-NC 4.0:https://creativecommons.org/licenses/by-nc/4.0/
- Frederick P. Brooks, Jr. - No Silver Bullet: Essence and Accidents of Software Engineering (1986):https://www.cs.unc.edu/techreports/86-020.pdf
- Edsger W. Dijkstra - Notes on Structured Programming (EWD249):https://www.cs.utexas.edu/~EWD/transcriptions/EWD02xx/EWD249/EWD249.html
- Ole-Johan Dahl & C. A. R. Hoare - Hierarchical Program Structures (Structured Programming Part III, 1972):https://www.informatik.uni-bremen.de/agbkb/lehre/programmiersprachen/artikel/dahl-hoare-hierarchical.pdf
- Guy L. Steele Jr. - Growing a Language (OOPSLA 1998 Keynote):https://langev.com/pdf/steele99growing.pdf
- Douglas McIlroy - Bell Labs Memo on Pipes (1964):https://cm-bell-labs.github.io/who/dmr/mdmpipe.html
- POSIX.1-2017 Utility Conventions (Chapter 12):https://pubs.opengroup.org/onlinepubs/9699919799/basedefs/V1_chap12.html
- E. F. Codd - A Relational Model of Data for Large Shared Data Banks (1970):https://research.ibm.com/publications/a-relational-model-of-data-for-large-shared-data-banks
- RFC 1958 - Architectural Principles of the Internet (1996):https://www.rfc-editor.org/rfc/rfc1958.html
- Trygve Reenskaug - Models - Views - Controllers (1979):/GSE/2026/p7/1979-12-MVC.pdf
- Martin Fowler - Presentation Model (2004):https://martinfowler.com/eaaDev/PresentationModel.html
- Vue.js Guide - Computed Properties:https://vuejs.org/guide/essentials/computed.html
- React Documentation - Thinking in React & State as a Snapshot:https://react.dev/learn/state-as-a-snapshot
- OpenStax Principles of Financial Accounting - Double-Entry Bookkeeping & Trial Balance:https://openstax.org/books/principles-financial-accounting/pages/3-6-prepare-a-trial-balance
- Martin Fowler - Event Sourcing:https://martinfowler.com/eaaDev/EventSourcing.html
- PostgreSQL Documentation - Materialized Views:https://www.postgresql.org/docs/current/rules-materializedviews.html