Lecture 07:Cursor 基础设施——索引、数据库事故与全球推理
来源审计:把增长故事改写成系统机制
本讲由 Cursor CTO 与联合创始人 Sualeh Asif 主讲。公开视频在 2026 年 8 月 11 日核验时已经 private,仓库保留 1288 条时间戳字幕和官方封面。字幕记录了 2025 年 3 月的架构与事故经验;Cursor 2026 年的 secure indexing、privacy、CursorBench、Router 和 agent 文档只用于验证持久机制或说明后续演化,不倒写为课堂当时已经存在的能力。
规模数字的证据边界
课堂提到过去一年约百倍增长、自研模型每日约一亿次调用、索引系统每日约十亿文档等数量。本文把它们保留为讲者估计/课堂口径,用于理解负载形状,不作为当前规模、商业排名或供应商关系的审计结论。
全讲的三个闭环
- Context loop:workspace change \(\rightarrow\) incremental index \(\rightarrow\) retrieval context;
- Edit loop:request \(\rightarrow\) model/provider \(\rightarrow\) plan/edit \(\rightarrow\) fast apply \(\rightarrow\) validation;
- Reliability loop:traffic/failure \(\rightarrow\) telemetry \(\rightarrow\) mitigation/migration \(\rightarrow\) safer architecture。
为什么 AI coding 不是一个模型 API
AI coding 的用户体验由上下文 freshness、retrieval quality、模型能力、provider capacity、edit application 和 editor validation 共同决定。即使模型输出正确,索引过期、provider 排队、patch 应用慢或 diagnostics 卡顿,用户仍会感到系统失败。基础设施优化因此必须以完整 interaction loop 为对象。
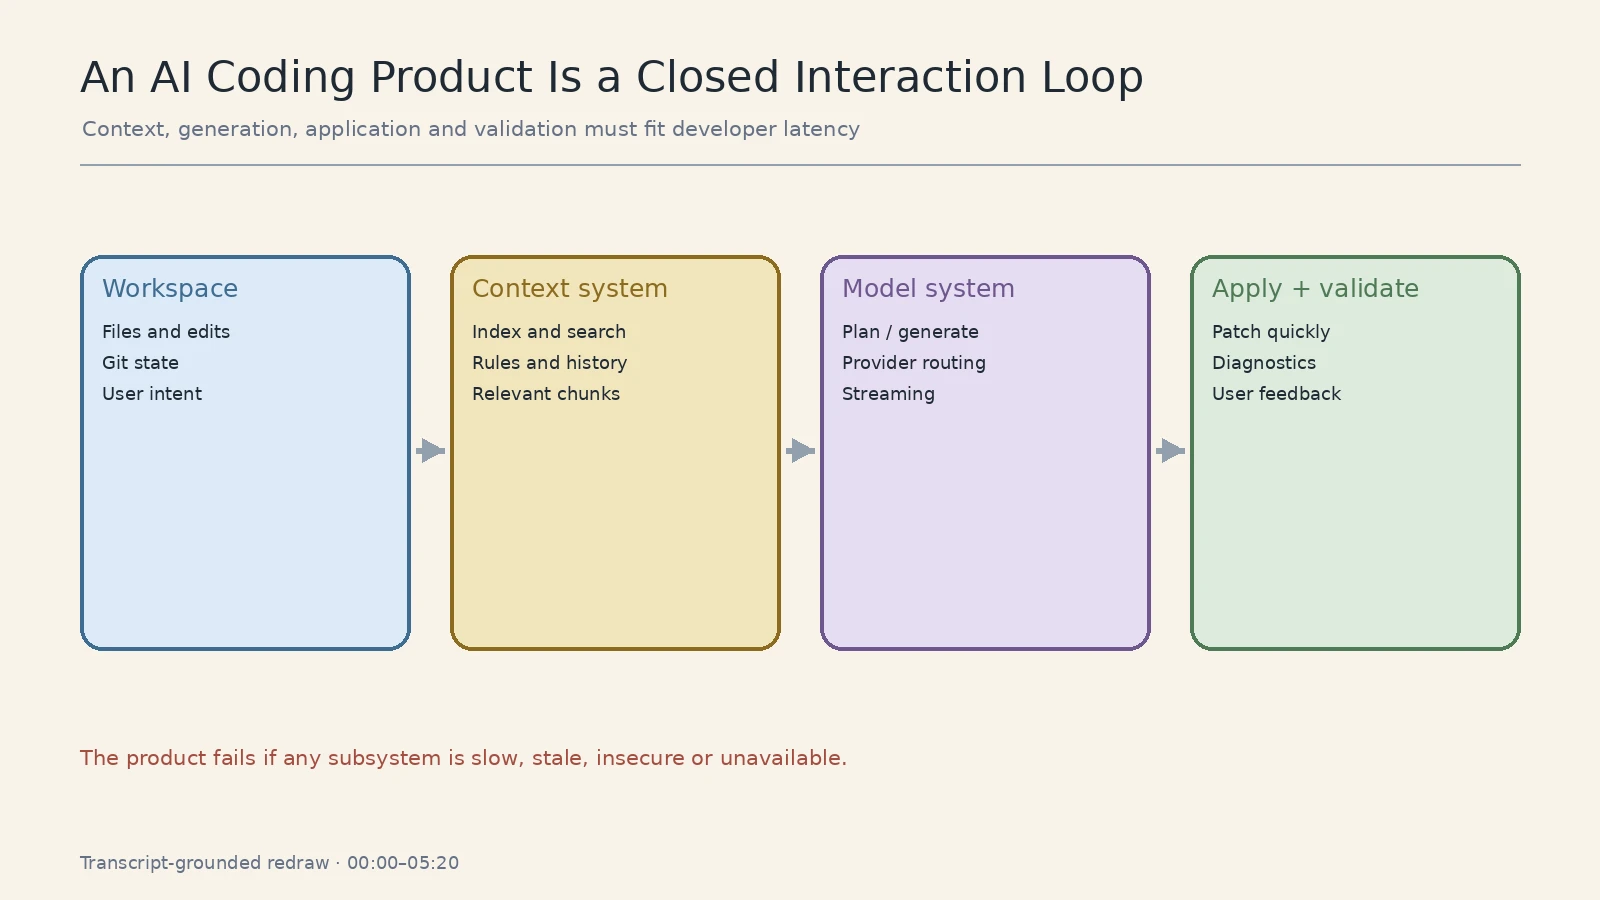
来源:本地字幕 00:00–05:20;概念重绘。
读图:Latency budget 属于整条链
把一次交互近似拆为
其中任一项的 p95/p99 都会破坏流畅感。Streaming 可以降低 time-to-first-token,却不能消除 context lookup、queueing、patch conflict 或 diagnostics 的尾延迟。
课堂提示
Asif 用“如果一亿次调用听起来不吓人,那它其实很吓人”提醒学生:增长改变的不只是容量,而是每个默认假设。曾经偶发的 retry、全量 rebuild 或人工修复,在高基数下都会成为持续负载。
本章小结
Lecture 07 的主角不是 Cursor 品牌,而是一个高频 AI interaction system。后文每个架构选择都必须回答:它改善了哪一段 loop、增加了什么状态、故障时如何降级。
三个 Product-Critical Systems:Indexing、Inference 与 Apply
课程先把系统拆成 indexing、model inference 和 product/apply layer。它们都服务同一个 editor,却有完全不同的资源曲线:indexing 偏异步与 data-intensive;inference 受 GPU capacity、batching 和 latency 约束;apply layer 需要把生成结果快速而安全地映射回用户正在编辑的文件。
不同 workload 需要不同 SLO
本节把上一段的 workload 差异转成可观测合同。读图时先为 indexing、inference、apply 和 data plane 分别定义“成功、降级和失败”,再选择 freshness、recall、queue time、edit success 或 job correctness 等指标;如果所有路径只共享一个 availability 数字,事故时就无法判断应当牺牲哪类工作来保护交互主链。
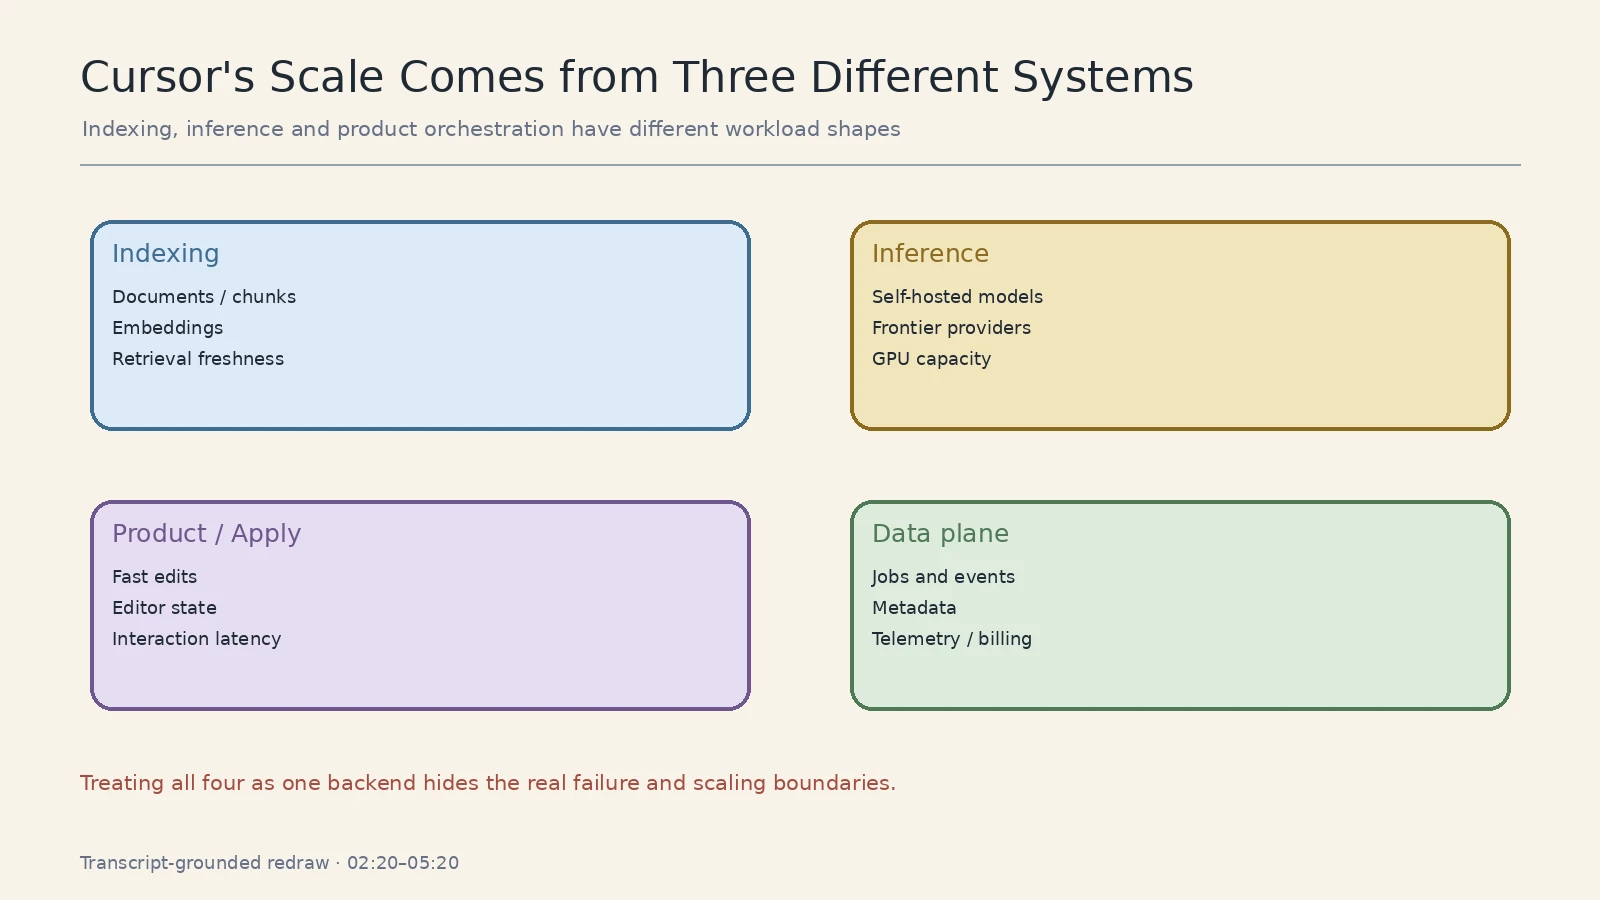
来源:本地字幕 02:20–05:20;概念重绘。
读图:先给每个系统定义失败
Indexing 的失败可能是 stale、missing 或低 recall;inference 的失败可能是 timeout、rate limit 或低质量;apply 的失败可能是 patch 冲突、位置错误或 editor freeze;data plane 的失败可能是 job 丢失、重复执行或 billing 不可解释。只有先分类型,报警和降级才不会互相污染。
SLO 不能只写“99.9% available”
- Index freshness:workspace change 到可检索的延迟;
- Retrieval quality:在给定 latency 和 filter 下的 recall/utility;
- Inference:time-to-first-token、tokens/s、error 与 queue time;
- Apply:edit success、conflict、validation latency 与 undo safety。
Apply model:把“想改什么”与“如何落盘”分开
规划模型擅长理解意图、选择文件和生成修改;specialized apply model 则处理位置匹配、局部重写和高速 token application。把两者分开,是因为最强模型未必在低延迟、确定性 patch application 上最优。系统需要为“思考”和“写入 editor state”设计不同接口。
课堂提示
课堂反复强调产品层并不是模型输出后的薄 UI。真正让工具“感觉好用”的,往往是 apply、streaming、context preparation 和 editor integration 这些不容易在 benchmark 中出现的系统工作。
本章小结
AI coding 平台不是一个后端服务,而是多个 SLO 和数据形状不同的系统组合。产品价值来自这些系统在一次交互中的协同,而不是某个单点模型指标。
Monolith 与 Blast Radius:代码边界不等于故障边界
Asif 并不把 microservice 当作规模化前提。课程更关注 blast radius(爆炸半径):一次代码、配置或依赖故障能影响多少用户、功能、region 和时间。Monolith 可以共享代码和部署流程,同时通过 traffic cell、queue、database、feature flag 与权限边界隔离高风险路径。
Critical path 与 experimental path 分开
本节回答“一个仓库怎样仍然拥有小故障域”。读图时不要数 service 数量,而要检查 auth、editor request、index job、new model 与 shared schema 的运行边界。若 experimental code 可以耗尽 critical database connection 或污染共享 queue,即使它被拆成独立 service,blast radius 仍然很大。
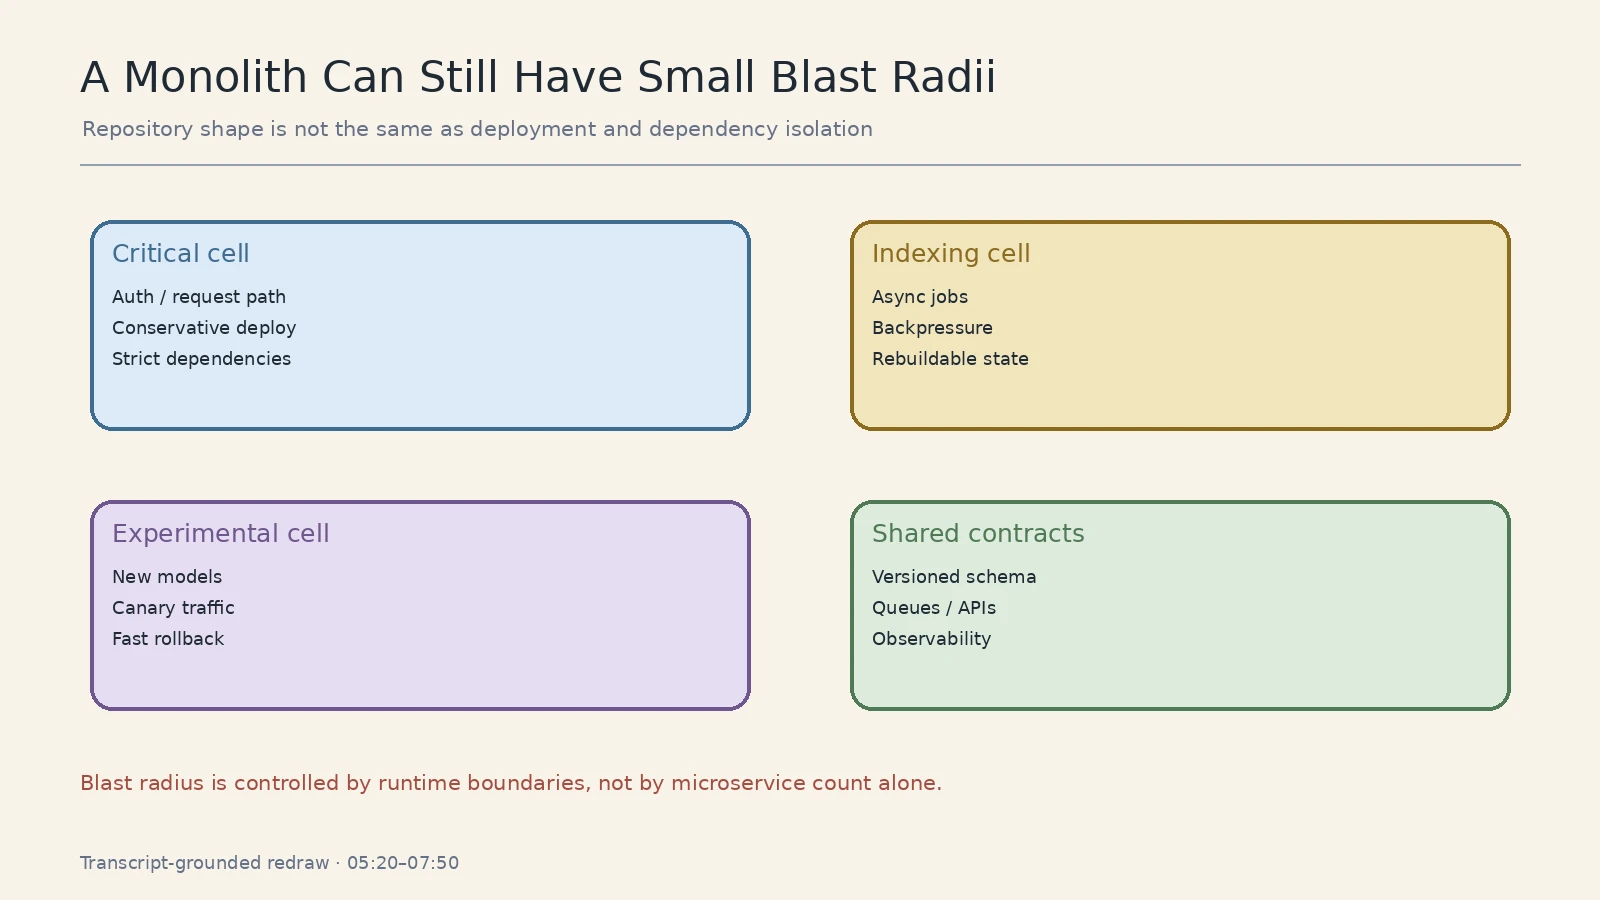
来源:本地字幕 05:20–07:50;概念重绘。
读图:四个隔离旋钮
Traffic 用 canary、tenant/region cell;resource 用独立 quota、queue 和 pool;state 用 versioned schema 与 rebuildable derived data;change 用 feature flag、rollback 与 deploy policy。Microservice 只是实现这些隔离的一种方式。
Blast radius 的诊断式
可粗略写为
其中 \(A\) 是 affected requests/users,\(D\) 是持续时间,\(S\) 是状态损坏或恢复复杂度。架构应优先降低不可逆的 \(S\),再通过 canary 和 cell 降低 \(A\),通过 detection/rollback 降低 \(D\)。
“保持代码简单”不是少写抽象
简单性应体现在 invariant 可解释、dependency 少、failure mode 可测试和 recovery path 明确。把复杂性藏进 global state、隐式 retry 或共享 database,代码行数可能减少,系统复杂度反而上升。
课堂提示
Asif 的选择并非“永远不要拆服务”,而是优先让少量工程师理解完整 critical path。只有当组织、故障域或资源形状真的需要独立演进时,再为分布式边界支付成本。
本章小结
规模化首先是隔离问题,而不是 service 数量问题。好的 monolith 与好的 distributed system 都需要显式 blast radius、资源预算、版本契约和恢复策略。
Incremental Indexing:只处理发生变化的代码
Codebase indexing 的第一原则是避免重复工作。Workspace 大部分文件在两次同步之间没有变化,系统应通过 content hash 和 tree summary 找出 delta,再对 changed content 解析、chunk、embedding 和 index。当前 Cursor secure indexing 文档进一步说明了 content-based embedding cache 和 index sharing,但这些是后续演化,本文只用来解释 durable mechanism。
Merkle-style sync 与 content identity
Merkle tree 是一种层次化 hash tree:叶节点表示文件或 chunk 内容,父节点 hash 由子节点决定。若两个 root hash 相同,可快速判断整个 subtree 未变;若不同,则向下定位变化。它减少同步 metadata 和全量扫描,但不自动解决 permission、rename semantics 或 semantic equivalence。
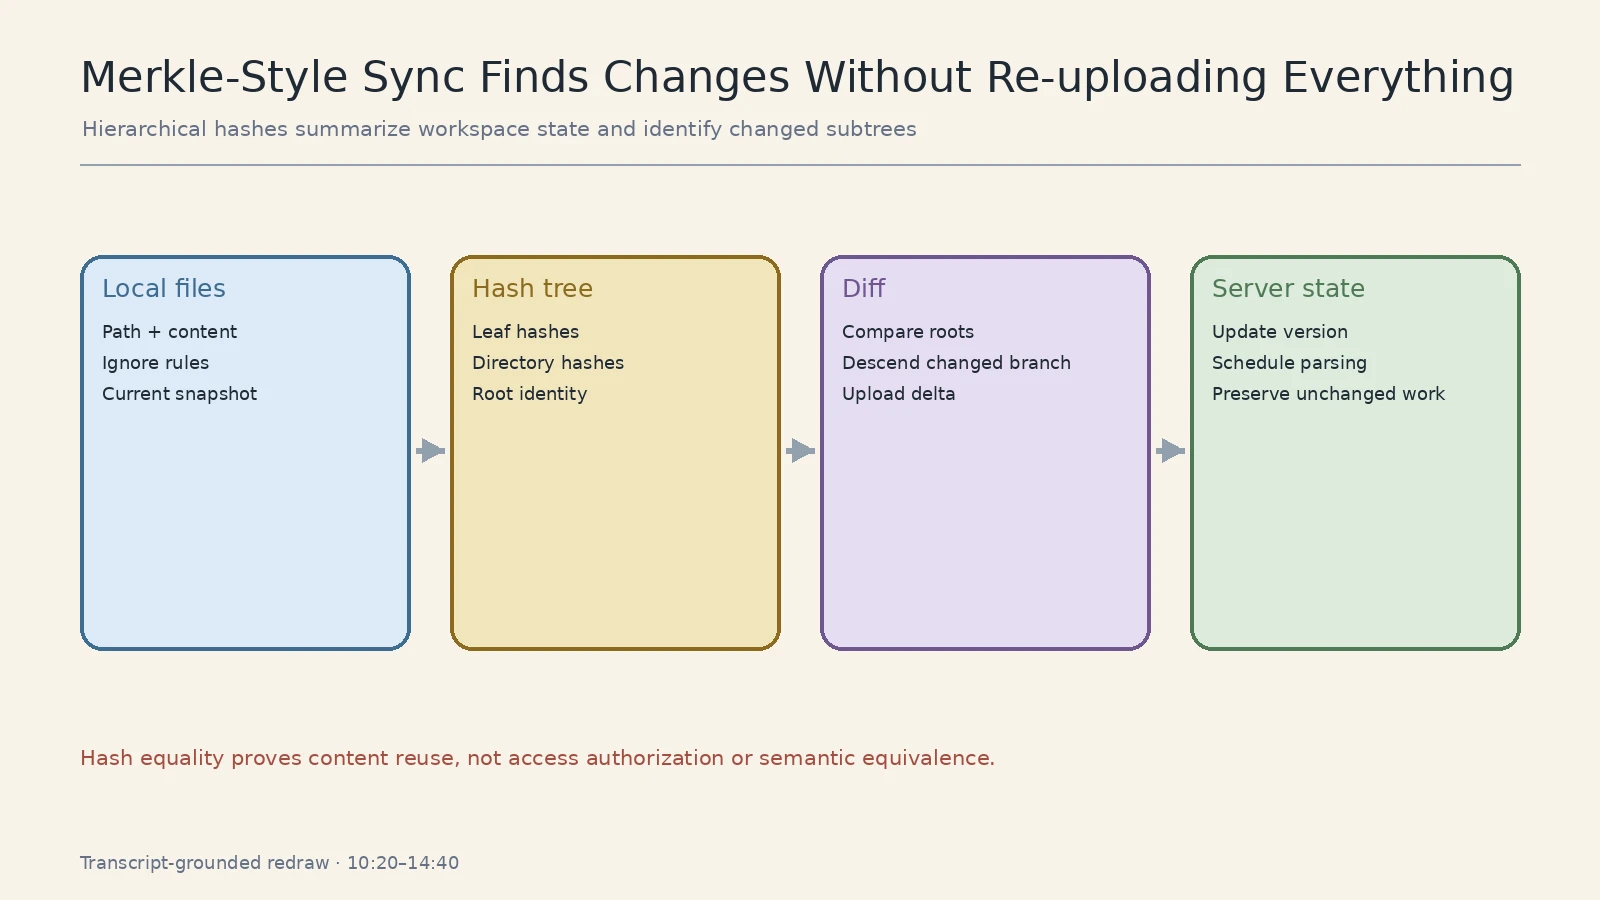
来源:本地字幕 10:20–14:40;概念重绘。
读图:Hash 相等证明什么
Hash equality 证明 byte-level content identity,可以安全复用解析或 embedding;它不证明两个 path 权限相同,也不证明相似代码具有相同语义。Index key 至少要包含 content hash、embedding model/version、chunking version 和 access scope。
Incremental work 的成本模型
若 workspace 有 \(N\) 个 chunk,本次变化为 \(\Delta N\),理想增量成本应接近
而不是每次支付 \(O(N)\)。实际系统还要承担 tree comparison、deleted/renamed content、queue overhead 与 cache miss。
Parse、chunk、embed、store、retrieve
embedding(向量表示)把代码 chunk 映射到数值向量,使相似 query 和 content 在向量空间接近;vector search(向量检索)在大量 embedding 中寻找近邻。它不是“理解整个 repo”的同义词:chunk boundary、metadata filter、lexical search、reranking 与 context budget 都会影响结果。
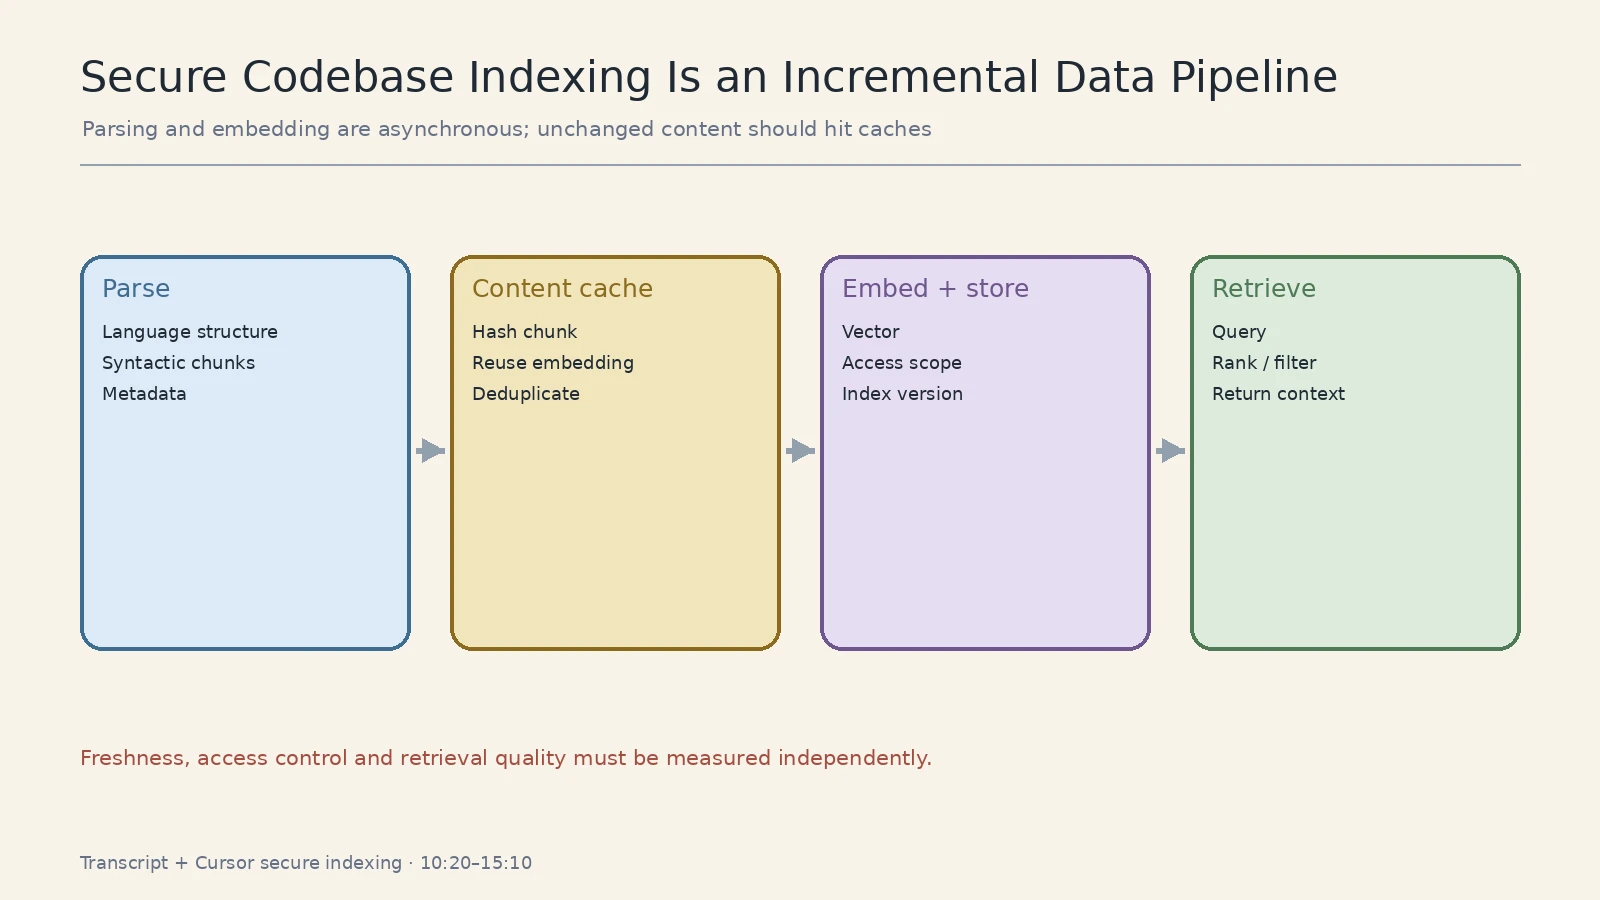
来源:本地字幕 10:20–15:10;Cursor secure indexing 官方资料。
读图:Freshness、security 与 recall 分开测
Freshness 看新 edit 多久可检索;security 看谁能 query 哪些 chunk;recall(召回率)看应返回的相关内容有多少被检索到,可写为 \(\mathrm{recall}=\frac{\text{relevant retrieved}}{\text{all relevant}}\)。高 recall 仍可能带来噪声,因此还要测 precision、ranking utility 与最终任务成功。
Embedding cache 也需要版本和删除语义
内容相同可以复用 embedding,但 model version、chunker、language parser 或 security policy 改变时,旧 cache 可能失效。用户删除 repo 或权限变化后,系统还要撤销 index reference;content cache 可继续存在的条件必须由 retention 与隔离策略决定。
本章小结
Incremental indexing 的核心是 content identity、versioned transform 和 access scope。Hash 能减少重复计算,retrieval quality 与 security 仍需要独立证据。
数据模型演进:哪些状态真的需要数据库
随着索引规模增长,把 users、repos、jobs、documents、vectors 和 source artifacts 全放进同一种数据库会制造互相冲突的 workload。Transactional metadata 需要一致更新;job state 需要 lease 与 retry;向量段适合大块 immutable data;source chunks 应能重建 derived index。本节用 source-of-truth 分层替代“哪种数据库最好”的争论。
四类状态,四种存储目标
source of truth(权威数据源)是恢复时被认为正确的原始状态。Derived vector index 可以从 source artifact 和 transform version 重建,不应承担唯一 truth;job progress 若丢失可重试,却必须保证幂等;permission metadata 则需要强约束和 audit。
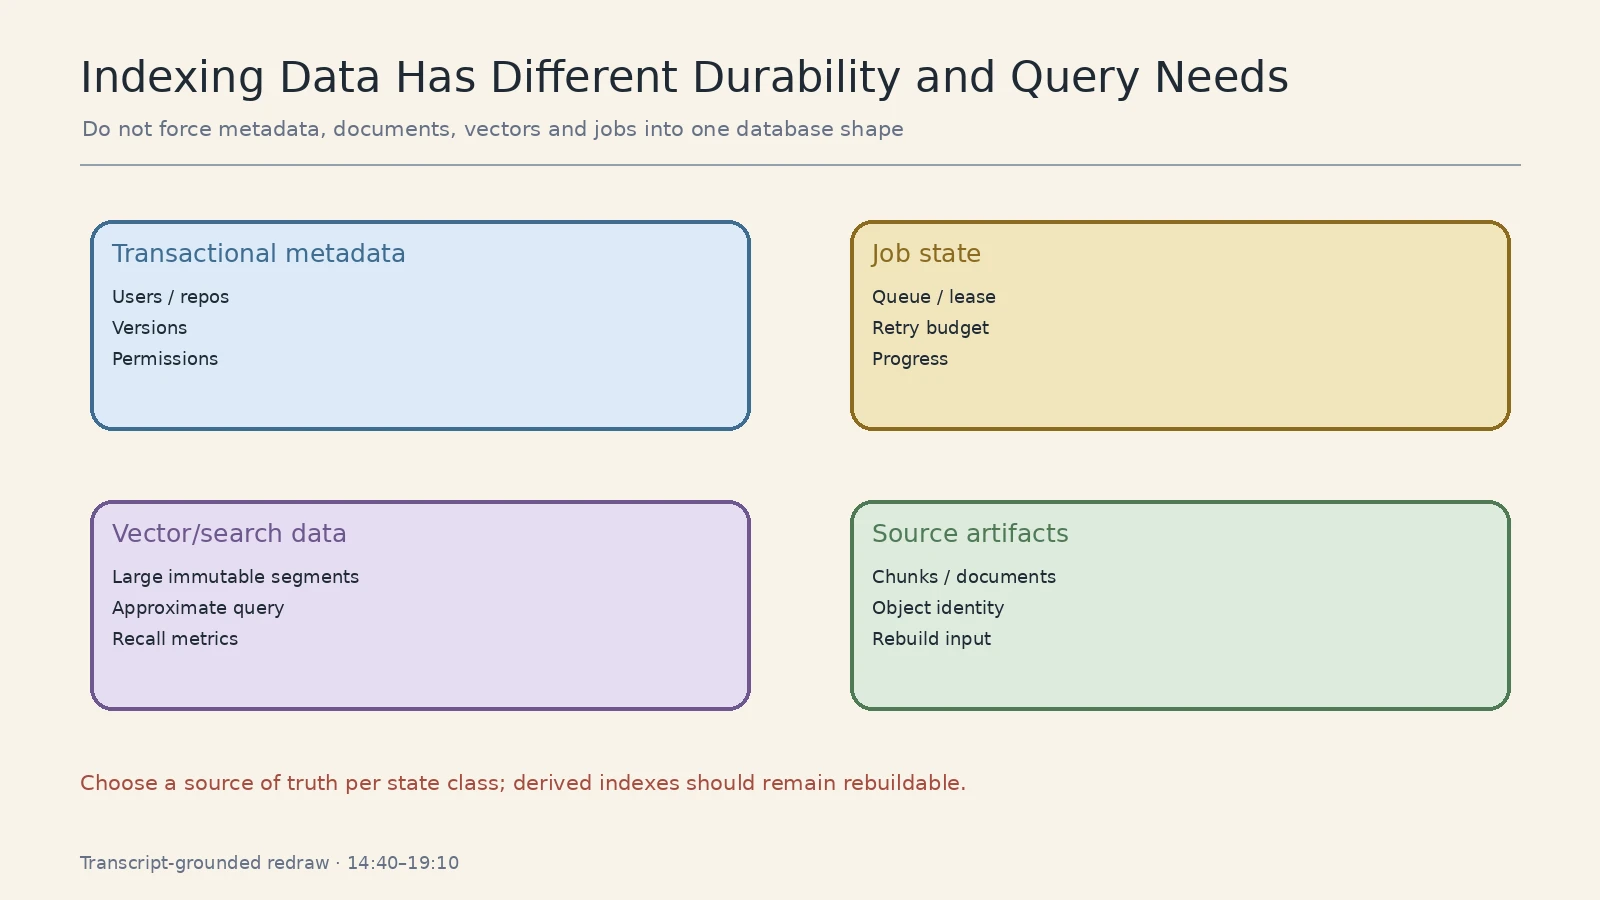
来源:本地字幕 14:40–19:10;概念重绘。
读图:先问“丢了怎么办”
如果状态丢失后只能向用户道歉,它可能是 source of truth;如果可从 object 重建,它是 derived state;如果可以重复执行,关键是 idempotency;如果只为加速 query,它是 cache。这个分类比先选 PostgreSQL、MongoDB 或 vector DB 更稳定。
重建能力是一种架构资产
对 derived index,恢复目标不仅是 RPO/RTO,还要记录:输入版本、embedding/chunking 版本、rebuild throughput、验证集和 cutover 方法。没有可重复 rebuild 的“索引”会逐渐变成无法迁移的第二权威数据库。
Backpressure、lease 与幂等
backpressure(背压)让下游饱和时上游减速或拒绝新工作,避免 queue 无限增长。Index job 应带 version 和 idempotency key;worker 通过 lease 获得有限时间所有权;超时后可安全重试;同一 repo 的新版本可以 supersede 旧版本,避免无意义地完成过期 rebuild。
Retry 不是可靠性的免费午餐
没有预算、jitter、deadline 和 idempotency 的 retry 会把一次 timeout 变成重复写和连接风暴。每个 retry policy 必须说明:哪些错误可重试、最多多少次、是否消耗同一 budget、何时转入 dead-letter 或人工处理。
本章小结
存储架构应从 state class、source of truth 和恢复路径出发。Database brand 是实现细节;状态的可重建性、幂等、版本与背压才是长期约束。
事故一:Retry、Cron 与 Rebuild 的正反馈
课堂第一段事故不是“一个数据库挂了”,而是多个自动机制同时响应:timeout 触发 retry,repair job 和 cron 增加负载,queue 拉长,cache miss 与 rebuild 又进一步压垮依赖。Incident response 的首要动作不是添加更多修复工作,而是识别正反馈并停止 producer。
从 initial fault 到 cascade
本节把课堂事故改写成 dependency feedback graph,而不是按时间复述操作。读图时要从 initial fault 追踪 automatic reaction、load amplification 和 mitigation:关键判断不是哪个组件先报错,而是哪些 retry、repair job 和 rebuild 在持续增加 saturated dependency 的输入,以及哪个控制点能最快降低系统增益。
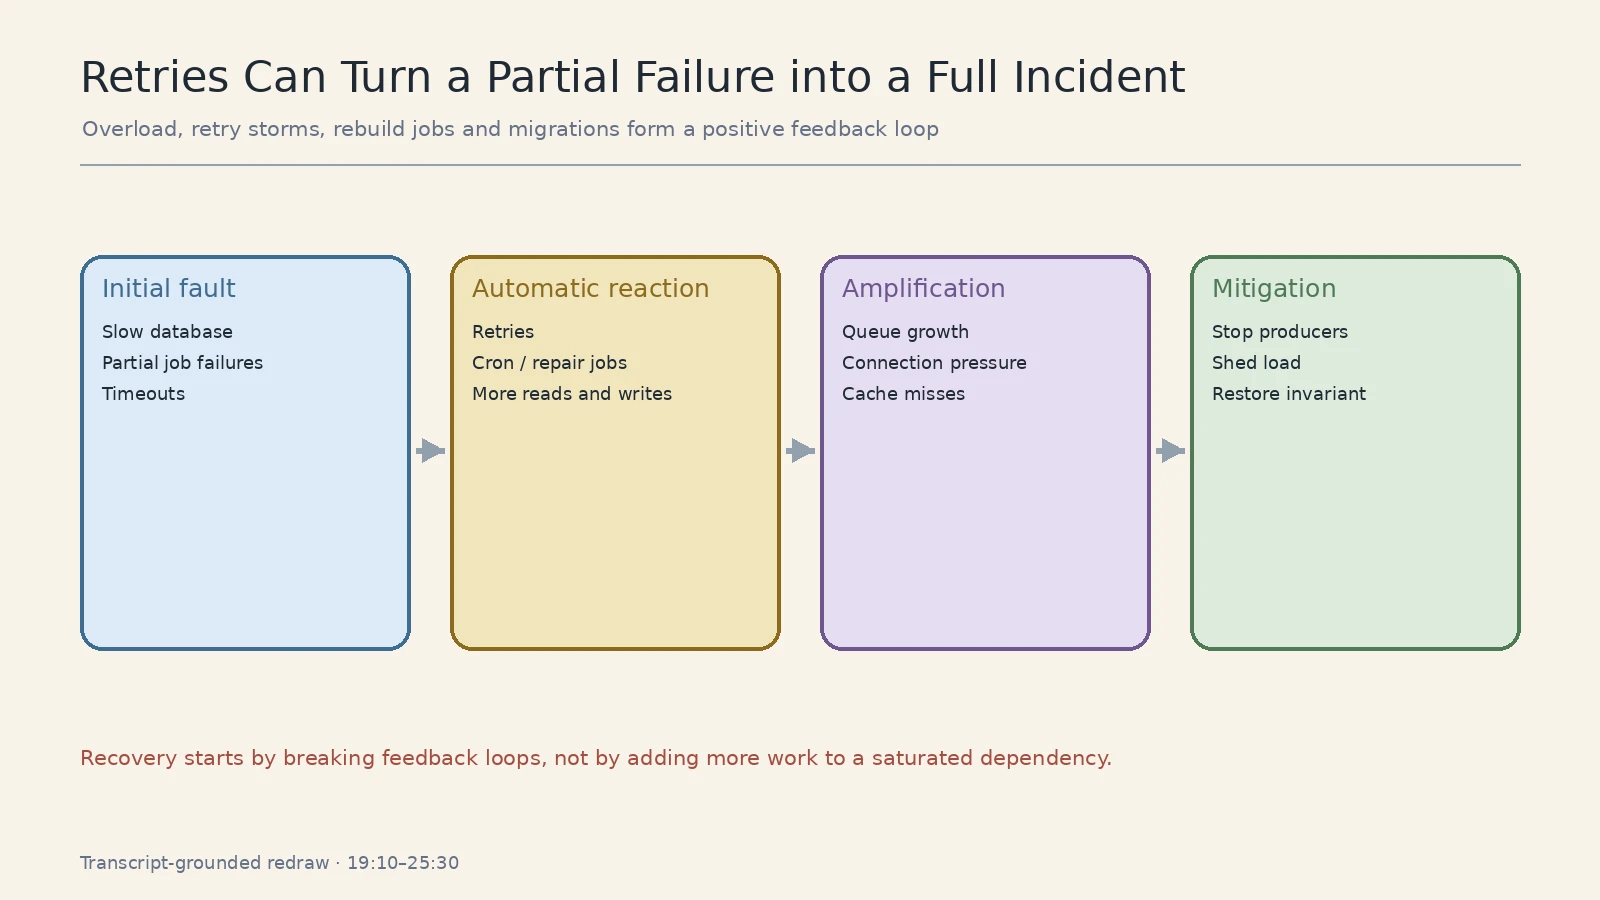
来源:本地字幕 19:10–25:30;概念重绘。
读图:恢复顺序与平时优化顺序相反
平时追求吞吐和自动化;事故中先保护 invariant:停止非关键 producer、限制 retry、shed load、冻结 deploy,再恢复最小 read/write path。只有 dependency 有 headroom 后,才逐步放开 backlog 和 rebuild。
Retry amplification
若原始请求率为 \(\lambda\),每次失败平均触发 \(r\) 次重试,失败概率为 \(p\),附加负载可近似为
当 \(pr\) 接近 1 时,重试链会非常敏感。实际系统用 bounded retry、exponential backoff、jitter、circuit breaker 和 global retry budget 控制放大。
课堂提示
课程中的事故叙述有很强的“一个人坐在那里救系统”的戏剧感。真正应该学习的是 command structure:谁能停止 producer、谁判断数据 invariant、谁负责用户沟通,以及哪些自动化在 degraded mode 必须关闭。
本章小结
Incident cascade 的根因常是 feedback loop,而非单点组件。恢复需要先降低系统增益,再修复状态;postmortem 应把 retry、cron、queue 与 migration 纳入同一 dependency graph。
事故二:PostgreSQL Storage Pressure 与迁移账单
第二段事故聚焦 PostgreSQL 存储压力。PostgreSQL 使用 MVCC(Multi-Version Concurrency Control,多版本并发控制):update/delete 后旧 tuple 不会立即从文件移除,需要 vacuum 回收可复用空间。长事务、写入量、index 和 autovacuum lag 会造成 bloat;磁盘接近耗尽时,maintenance 自身也需要 I/O 和空间,恢复风险陡增。
Dead tuple、VACUUM 与 disk headroom
dead tuple 是不再对任何活跃 transaction 可见的旧行版本;VACUUM 标记空间可复用并维护可见性信息,常规 VACUUM 通常不把文件归还给操作系统;VACUUM FULL 重写表并可回收更多磁盘,却需要额外空间和强锁。事故处理不能在饱和时盲目运行最重 maintenance。
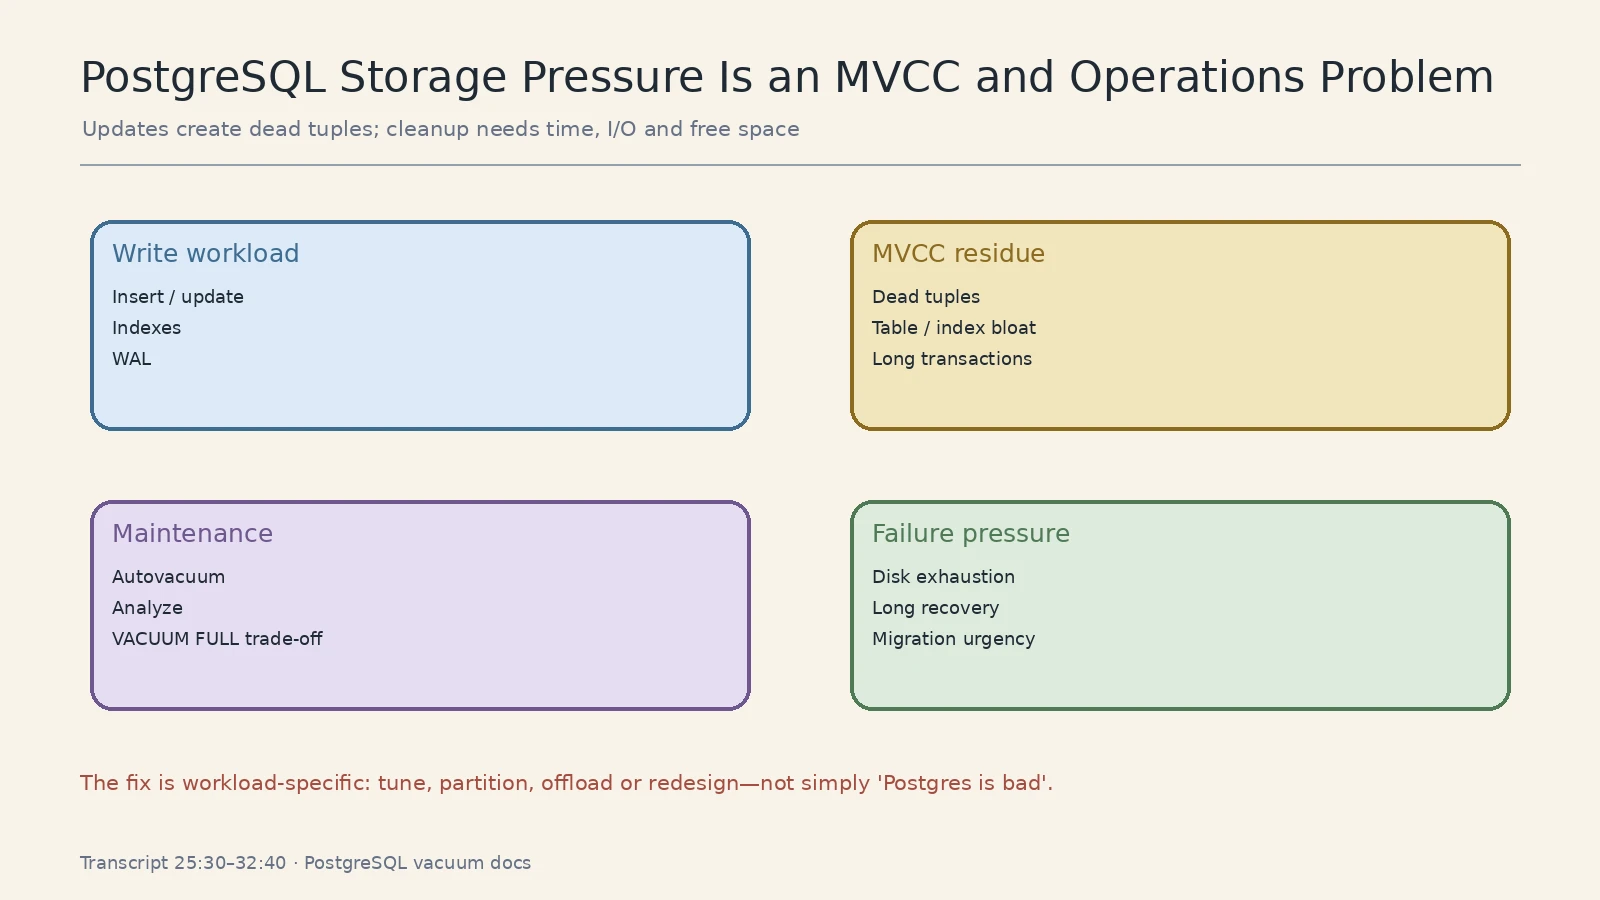
来源:本地字幕 25:30–32:40;PostgreSQL 官方 vacuum 文档。
读图:不是“Postgres 不可扩展”
先检查 transaction age、dead tuple、table/index growth、WAL、autovacuum thresholds、I/O 和 free space,再决定 tune、partition、archive、offload 或 migrate。讲者的痛苦来自特定 workload 与时点,不能推出所有 indexing 系统都应避免 PostgreSQL。
Emergency migration 会叠加负载
迁移期间旧系统继续 serving,新系统要 backfill,validation 要 dual read/query,失败还会 retry。若没有独立 capacity 和 throttle,migration 本身会让原系统更难恢复。先 offload 非关键 workload 和冻结 schema,通常比立即全速搬迁更安全。
Cold start:重建 embedding 与 cache
cold start 在这里不仅是新 process 启动,而是新 index 缺少 embedding、segment、cache 和统计信息。重建每个 repo 需要读取 source、chunk、调用 embedding、写入新 storage,再用 query 验证。课堂提到 migration 还会消耗额外 inference capacity,这正是隐藏账单。
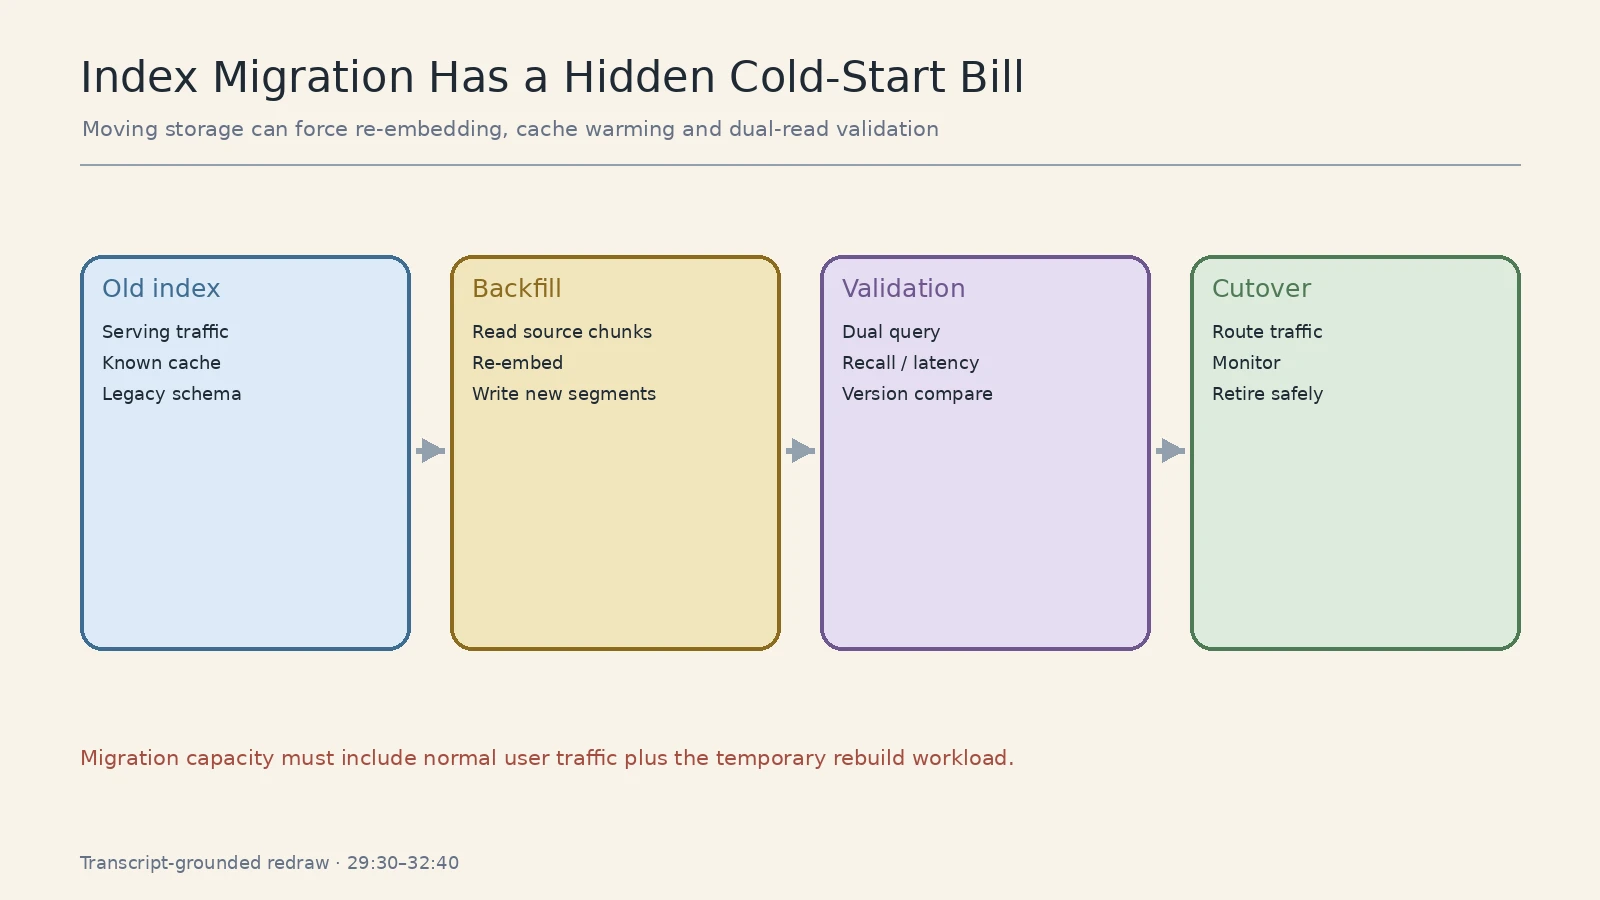
来源:本地字幕 29:30–32:40;概念重绘。
读图:Cutover 之前先定义 equivalence
新旧系统不一定返回完全相同 top-\(k\)。Validation 应比较 recall/utility、filter correctness、latency、freshness 和 cost;对关键用户可 shadow query;只有满足阈值后再按 tenant/region 渐进切流,并保留 rollback 期间的双写或源数据。
课堂提示
“最好的扩数据库方式是不要让数据库承担这份工作”是一句有用但危险的课堂口号。正确理解是:把 immutable、可重建、吞吐型数据移出 transactional hot path,而不是删除所有 database。
本章小结
PostgreSQL 事故揭示了 MVCC maintenance、disk headroom 与 migration workload 的耦合。数据库迁移不是复制数据,而是重建派生状态、验证等价性并管理双系统风险。
Object-Storage-Native Search:耐久层与热查询层分离
事故后的架构方向是把大块 immutable index segment 放入 object storage,把 query compute 和 SSD/memory cache 做成可替换层。Amazon S3 提供对象级耐久存储与强读后写一致性;turbopuffer 等系统在其上构建 search。优势是 durable cost 与 compute 解耦,代价是首次读取、tail latency、cache admission 和 segment management。
Durable objects、cache 与 stateless compute
object storage 以 object key 存放 blob 与 metadata,适合大对象、低成本耐久和海量 namespace,不提供传统 row update 与 join。stateless compute 指 query worker 不持有唯一耐久状态,可从 object 和 shared metadata 恢复;它仍可以有本地 cache,只是 cache 丢失不破坏 correctness。
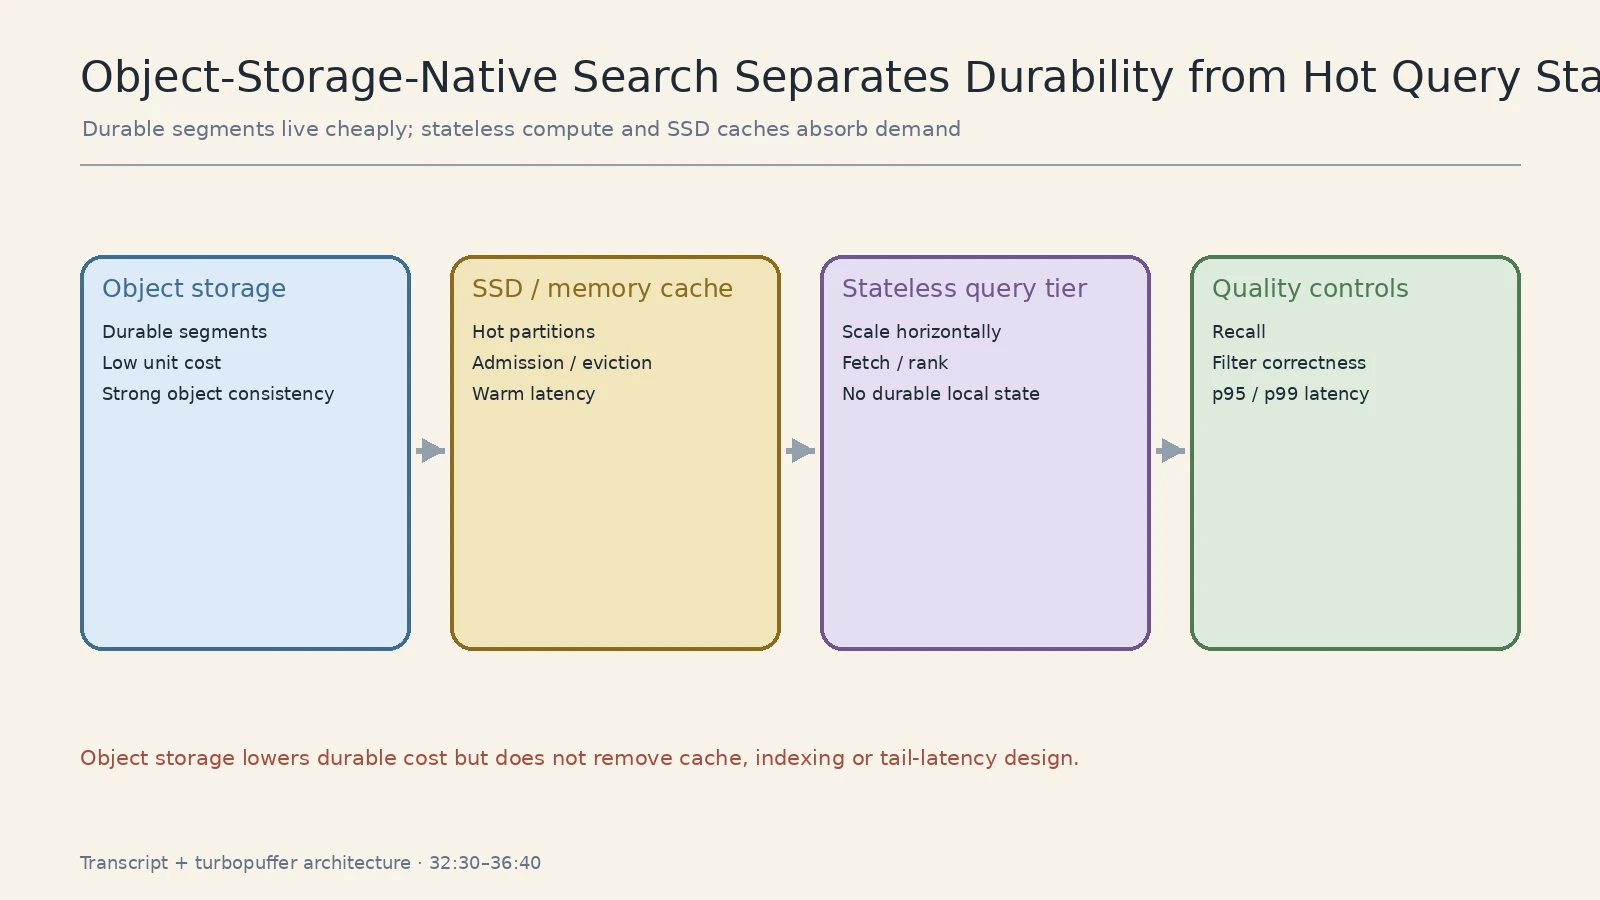
来源:本地字幕 32:30–36:40;turbopuffer 官方架构资料。
读图:Object storage 没有消灭 database 问题
系统仍需要 metadata catalog、segment version、compaction、cache coherence、filter index、recall measurement 和 deletion。对象层降低 durability cost 并简化 replacement,却把性能问题移动到 prefetch、cache 和 query planning。
Cache 的价值取决于 reuse
若 object fetch latency 为 \(L_o\),cache hit latency 为 \(L_c\),hit rate 为 \(h\),平均读取延迟近似
但用户体验更受 p95/p99 影响;热门 tenant、扫描 query 和 cold region 会让平均值掩盖尾部。需要按 namespace 与 query type 观察 hit rate。
Low cost per TB 不等于 low query cost
Object storage 的容量便宜,但 frequent GET、data transfer、decompression、CPU ranking 和 cache miss 会增加单位 query 成本。价格模型必须同时计算 stored bytes、read amplification、QPS、recall target 和 latency SLO。
本章小结
Object-storage-native search 把 durable state 与 query compute 解耦,适合 immutable、可重建的大规模 index。它不是无数据库架构,而是重新定义 metadata、object 和 cache 的职责。
Global Inference 与 Provider Portfolio
Cursor 同时运行自研模型和调用 frontier providers。Autocomplete 对 latency 极敏感,需要全球 GPU replica 与 overload behavior;复杂 agent request 更看质量、context 与 tool use,也受 provider rate limit 和版本变化影响。本节将 self-hosted serving 与 multi-provider routing 放在同一个 capacity/evaluation 控制面中。
Self-hosted model 的 region、queue 与 fallback
本节先回答 autocomplete 为何不能只部署一个集中集群。读图时沿 user region、router、GPU region 和 fallback 观察:距离、queue depth、model replica 和 KV cache 都会影响 p99;当本地 region 饱和时,系统要在远端 latency、smaller model 和 graceful degradation 之间选择。
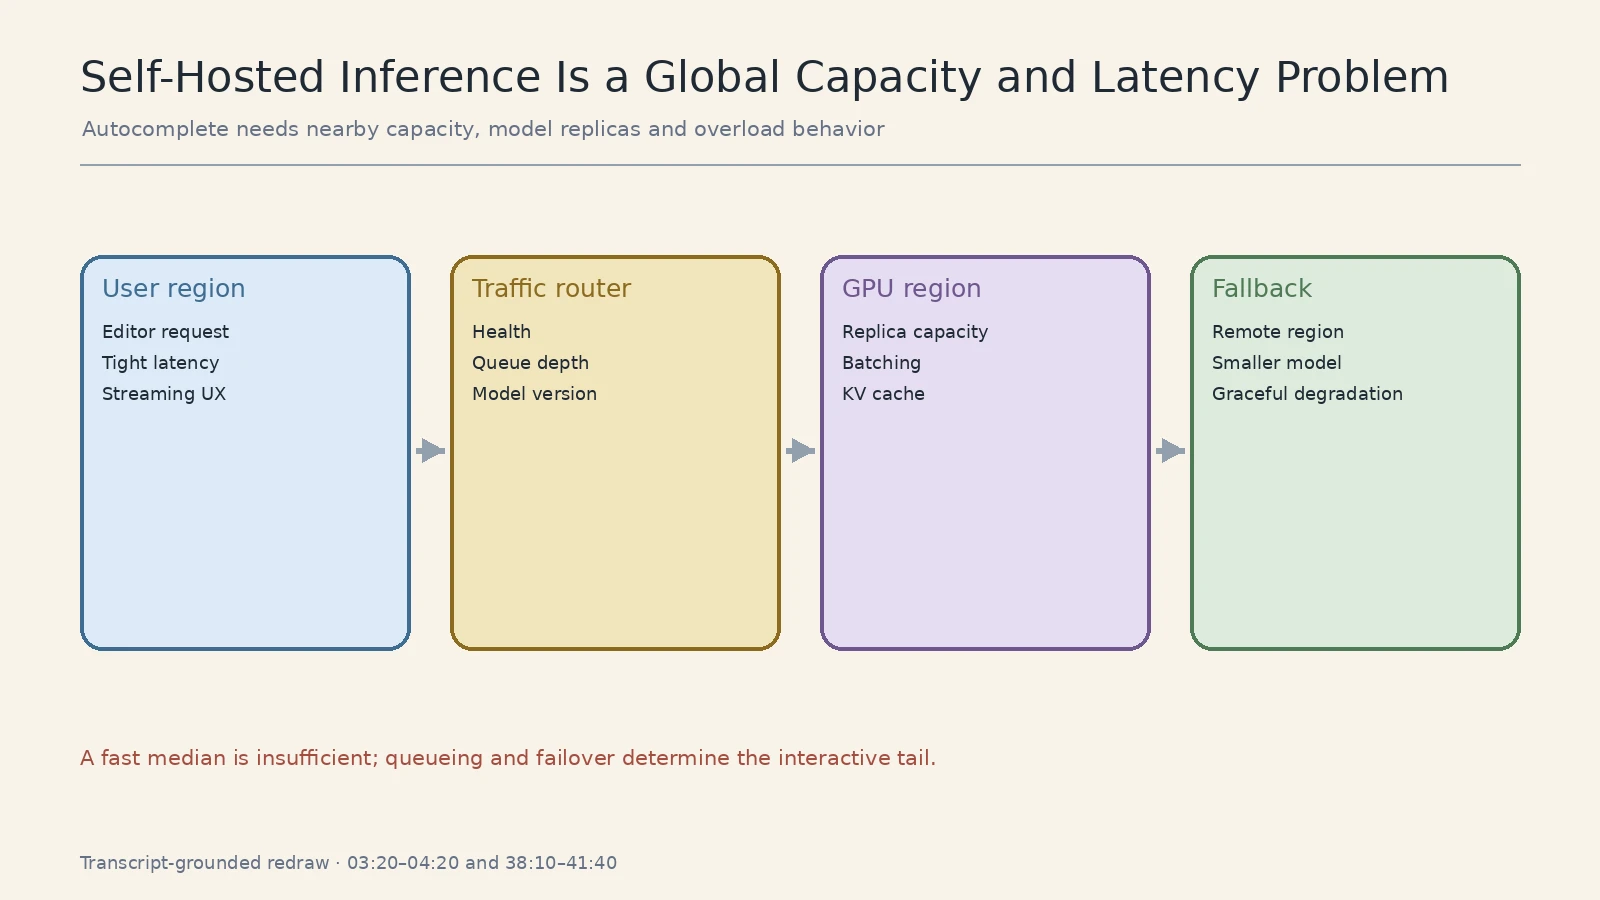
来源:本地字幕 03:20–04:20、38:10–41:40;概念重绘。
读图:Capacity headroom 不是浪费
Interactive serving 不能把平均 utilization 推到 100%。Queueing 在饱和附近非线性增长;需要 replica headroom、admission control、deadline 和 preemption。低优先级 batch/re-embedding 可以填谷,但必须在在线流量上升时让出资源。
Frontier providers:Rate limit、quality、cost 与 failover
rate limit 是 provider 对 request/token 并发或时间窗口的限制;provider routing 按任务、质量、健康、quota、成本和 policy 选择模型。简单 round-robin 会忽略不同模型能力与 context/tool interface,真正可用的 portfolio 需要 normalized request、versioned eval 和 provider-specific fallback。
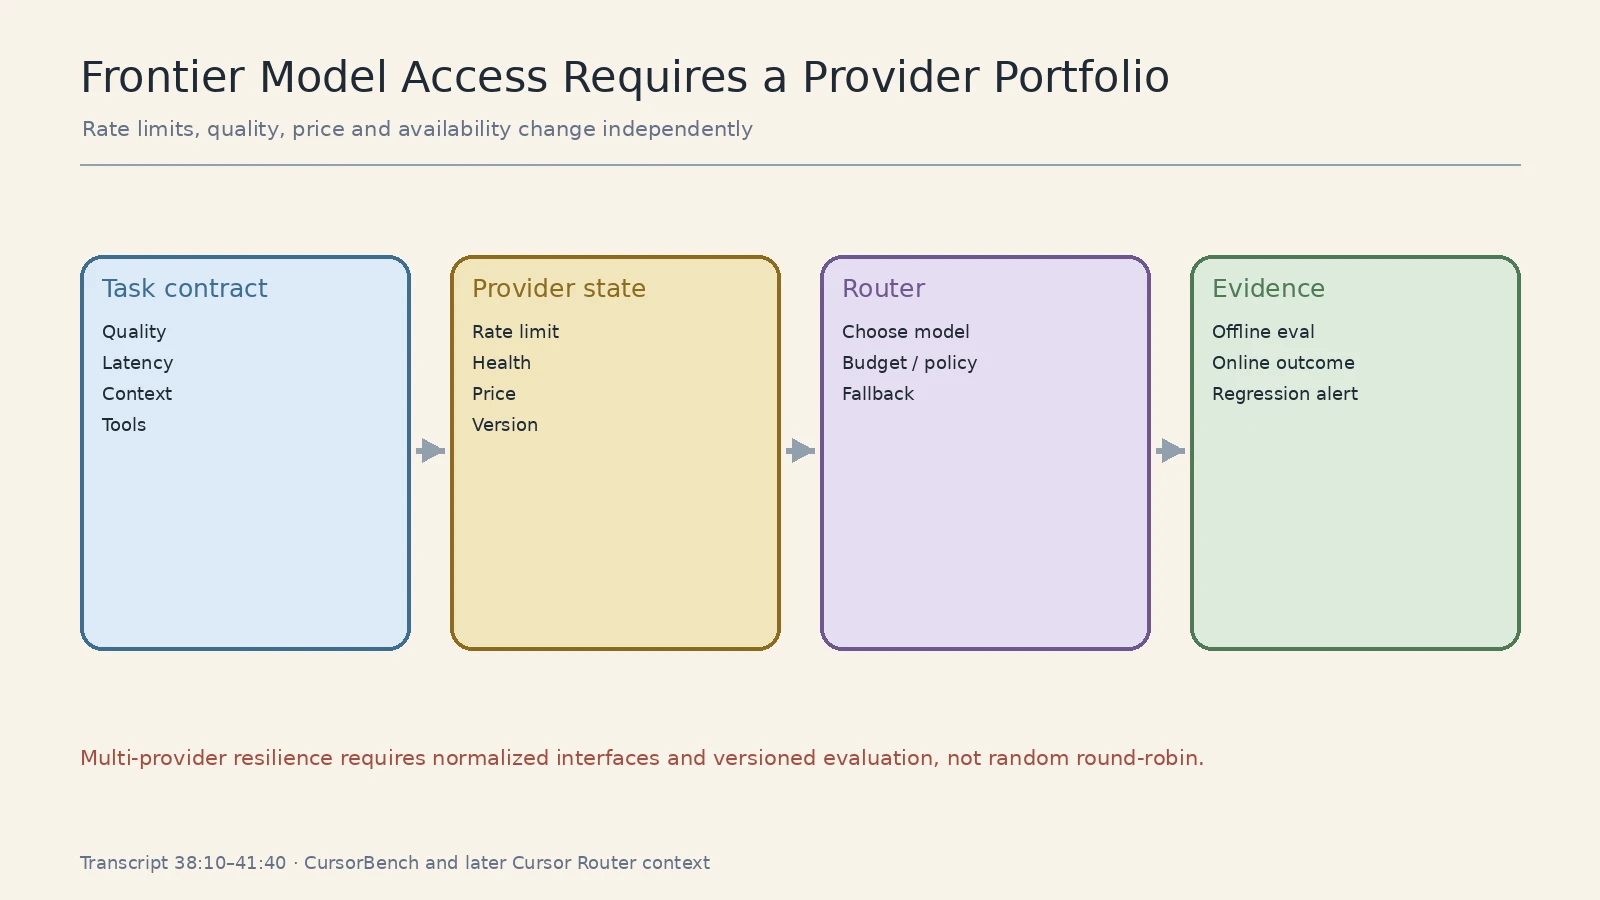
来源:本地字幕 38:10–41:40;CursorBench 与后续 Cursor Router 资料。
读图:Offline eval 与 online outcome 各自缺什么
Offline benchmark 可重复、适合回归,却不完全反映真实 repo、latency 和 user acceptance;online metric 接近产品结果,却受 selection、UI 和 traffic mix 影响。Router 应同时使用二者,并把 model/version 记录到每次 request 和 incident。
Routing 是约束优化
对 task \(x\) 和候选 model/provider \(m\),可抽象为
并满足 privacy、availability、context、tool 和 quota 约束。权重 \(\alpha,\beta\) 会随 plan、tenant 和交互路径变化,因此不应只维护一个全局“最佳模型”。
课堂提示
课堂中的现实感在于,快速增长的客户会持续打电话请求更多 capacity,同时准备多 provider 和自有 GPU。Resilience 不是在供应商失败后临时接第二家,而是平时就保持接口、eval、quota 和数据政策可切换。
本章小结
Global inference 同时是 queueing、capacity、evaluation 和 supply-chain 问题。Self-hosted 与 frontier provider 不是二选一,而是具有不同控制权、成本和故障模式的组合。
Fast Apply:把模型输出变成可验证编辑
模型生成 patch 后,系统仍要定位文件位置、处理用户同时修改、应用 diff、保持格式并触发 diagnostics。Cursor 后来的 Fast Apply 公开资料说明 specialized model 可以承担高吞吐 edit application;本节将其作为 durable design pattern,而不是把后续性能倒写进课堂。
Plan、generate、apply、validate
上一章解决“从哪里获得模型输出”,本章解决“怎样安全进入 editor state”。读图时重点看 plan 与 apply 的职责分离,以及 validation/undo 为什么是产品基础设施。若 apply 静默修改错误位置,即使文本质量高也会破坏信任。
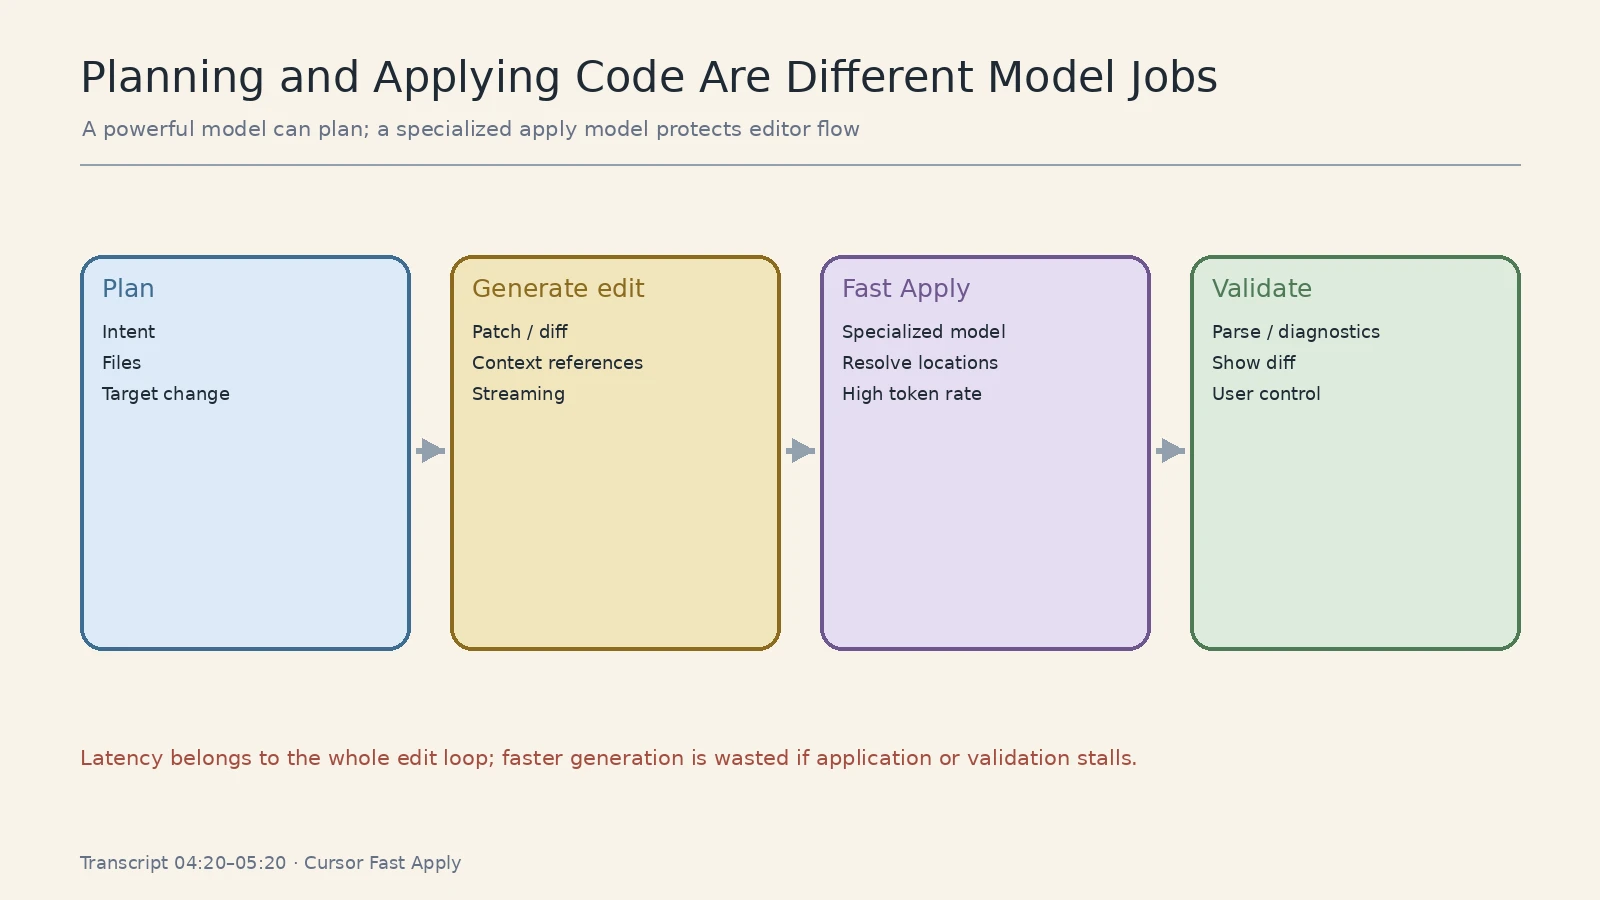
来源:本地字幕 04:20–05:20;Cursor Fast Apply 官方资料。
读图:Patch application 的四个失败面
定位错误、context drift、语法/类型失败、用户并发编辑。系统应使用 file/version precondition、structured edit、parser/diagnostic、visible diff 和 atomic undo。对大改动,还需要分批 apply 与中间 validation,避免 editor 被单次巨型 patch 锁死。
交互速度不是单纯 tokens/s
用户感知时间包含 first useful preview、edit stabilization 与 validation complete。一个更慢但可渐进展示、冲突少、能快速 undo 的 apply path,可能比纯 token throughput 更好。指标应包括 accepted edit、rework 和 rollback,而不仅是生成速度。
本章小结
Fast Apply 把 AI coding 从文本生成问题变成 state transition 问题。模型负责提出修改,系统必须负责 precondition、application、validation、visibility 与 recovery。
Security、Privacy 与 Abuse:代码和 Token 都是高价值资产
AI coding 平台同时接触私有源代码和昂贵模型 quota。安全不仅是“数据库加密”,还包括 workspace ignore、access scope、retention、provider data policy、agent tool approval、secrets 与 audit;反滥用也不是独立风控,而是保护 inference capacity 和 unit economics 的基础设施。
代码数据流与 shared responsibility
envelope encryption(信封加密)通常用 data encryption key 加密数据,再用 key encryption key 保护前者;client-held 或 tenant-controlled key 可以缩小 server compromise 的可读范围,但 key lifecycle、metadata、access log 和 provider path 仍需治理。Current Cursor docs 还区分 Privacy Mode、retention 与 enterprise controls。
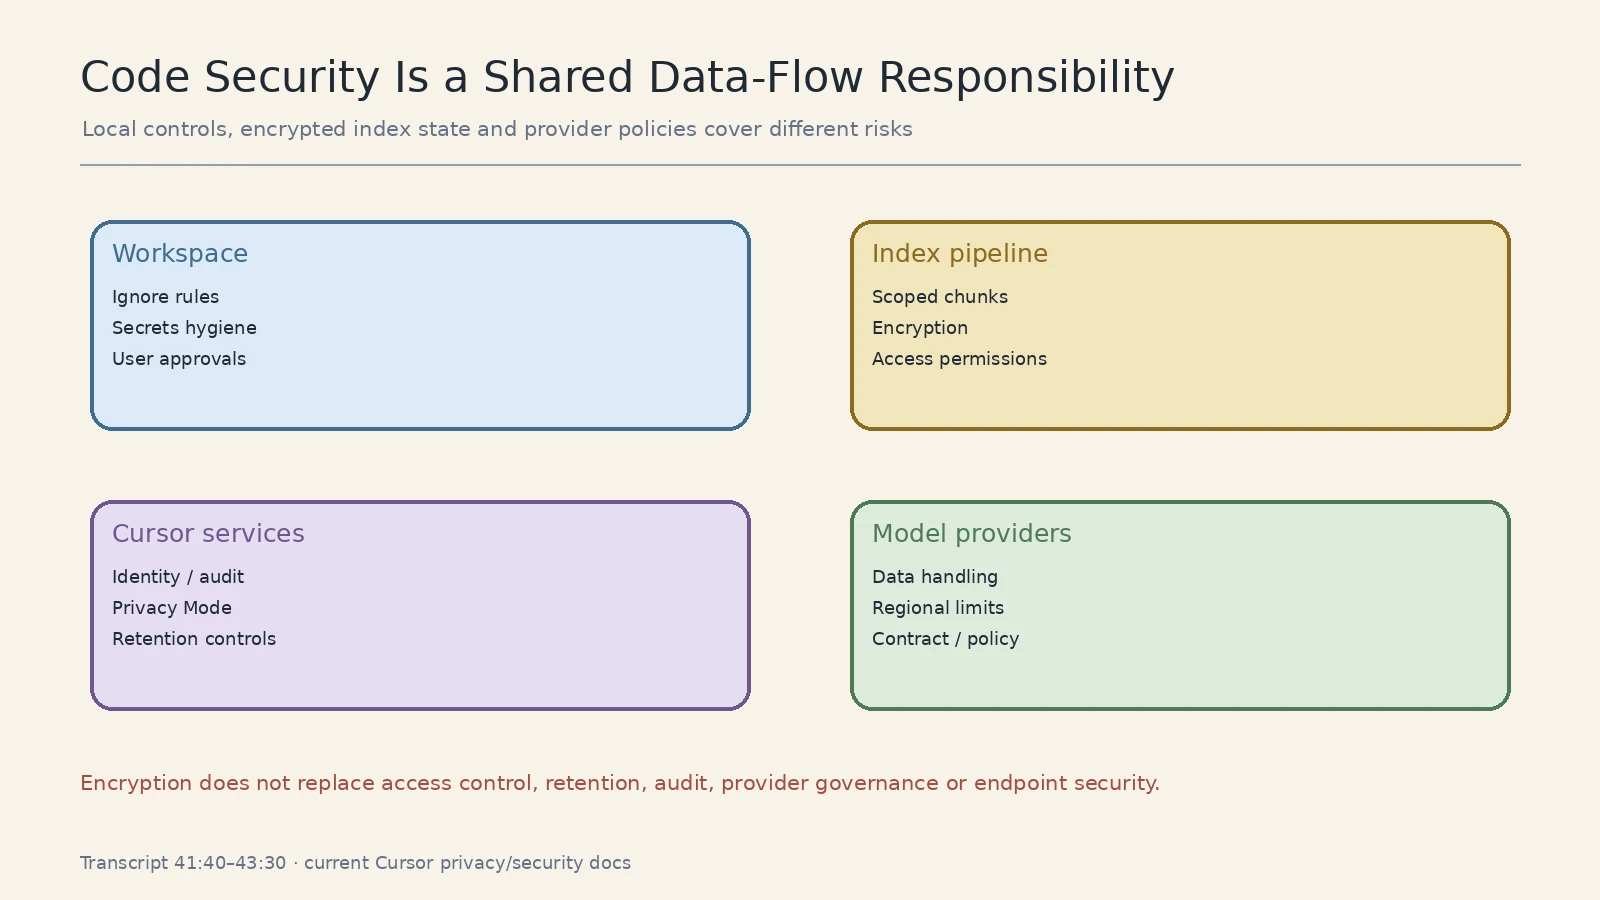
来源:本地字幕 41:40–43:30;Cursor 当前 privacy/security 文档。
读图:Encryption 不能替代五件事
Access control 决定谁能读;retention 决定保留多久;audit 记录谁做了什么;data minimization 减少不必要传输;provider governance 约束第三方处理。加密只保护特定静态/传输风险,不会阻止合法身份误用或 agent 读取 workspace secrets。
Agent tool approval 需要风险分级
Read-only search、local edit、terminal command、network request 和 deployment 的影响不同。默认策略应按 tool、target、workspace trust 和 user intent 分级;审批 UI 要显示将执行什么,而不是让用户盲目点击“允许”。
Free-token arbitrage 与资源控制
课堂描述攻击者利用免费或补贴账户获取昂贵 frontier token。系统要把 identity、plan、device/payment signal、per-user/model quota、velocity 和 anomaly 组合,而不是只依赖 CAPTCHA。abuse prevention 的目标是限制损失并保留申诉,不是无限增加普通用户摩擦。
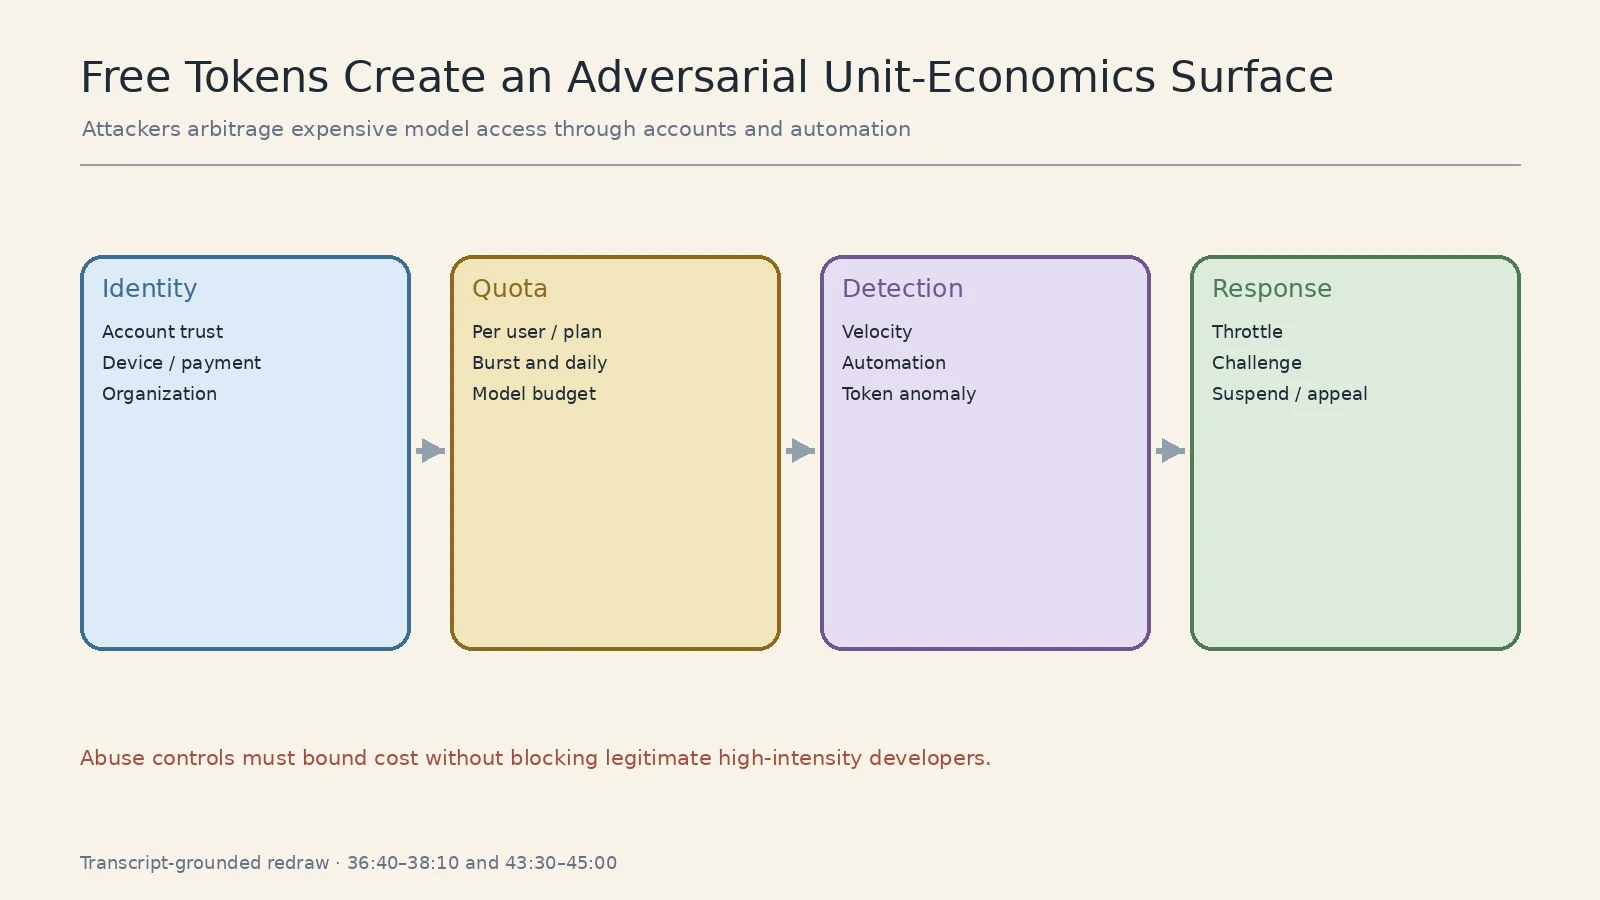
来源:本地字幕 36:40–38:10、43:30–45:00;概念重绘。
读图:Quota 必须映射真实成本
不同模型的 token price、context、cache 和 tool call 成本不同;统一 request count 会低估高成本路径。Budget 应支持 token/model 权重、burst、daily cap、organization pool 与 suspicious velocity,并在 throttling 时向合法用户解释原因。
反滥用不可把高强度开发误判为攻击
大型 refactor、CI agent 或团队 rollout 可能产生异常高流量。Detection 应结合 account age、payment、organization、repetition pattern、concurrency 和 model mix,并提供 temporary verification 或 enterprise quota,而不是直接永久封禁。
课堂提示
课堂把 security 和 abuse 放在同一场问答里很合理:私有代码泄漏损害信任,token 被套利损害经济性;两者都会让产品无法持续。安全团队和平台团队必须共享 request、identity、cost 与 incident telemetry。
本章小结
AI coding 的安全边界跨越 endpoint、index、service 和 model provider。Privacy controls、agent approvals 与 abuse budget 需要共同设计,才能同时保护代码、用户控制和计算资源。
AI 对软件工程的影响:更需要 Systems Judgment
课程最后转向教育和 IDE 未来。Asif 的判断不是“CS 基础失效”,而是生成代码增多后,理解 state、performance、security、failure 和 interface 的能力更重要。Agent 可以写更多代码,也会更快制造依赖、重试和权限问题;工程师的工作从逐行输入扩展到定义 contract、验证 evidence 和管理 change。
IDE 变成 Agent workspace
IDE 会承载多个 agent、background task、terminal、browser、test 和 deployment feedback。基础设施必须让用户知道 agent 在读什么、改什么、运行什么,并保留可暂停、可审查、可回滚的 control plane。更强 autonomy 不应以失去 workspace state visibility 为代价。
AI-native software engineering 的四项核心能力
- 设计 versioned interface、invariant 和 permission;
- 为 generated change 建立 test、eval、diff 和 rollback;
- 识别 queue、database、network 与 provider 的系统瓶颈;
- 把 incident 和 user feedback 转成 guardrail,而不是只修 prompt。
AI-assisted incident response
AI 可以汇总 logs、关联 deploy、生成 query、解释 runbook 和提出 hypothesis,但生产事故处于证据不完整、成本快速变化的环境。AI 不应直接拥有无限 production authority;incident commander 需要确认目标、停止 feedback loop、选择风险和记录决策。
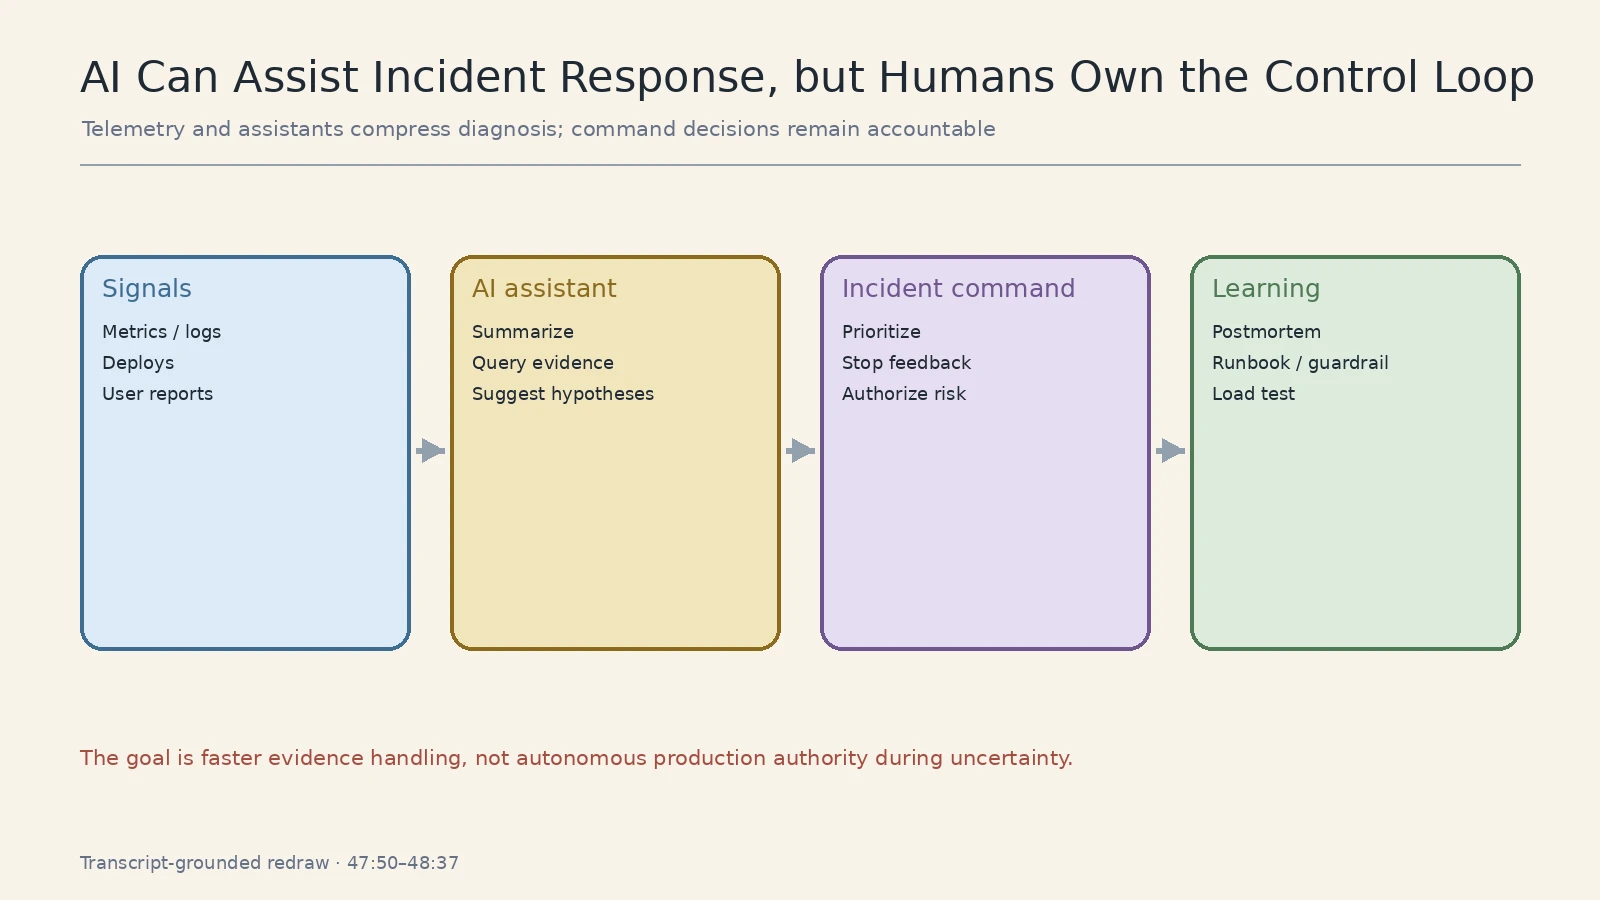
来源:本地字幕 47:50–48:37;概念重绘。
读图:Assistant 最适合缩短哪一步
它可以从海量 metrics/logs 中定位时间相关性,生成 safe read-only query,比较最近 deploy,或把聊天记录整理成 timeline。高风险 write、failover、data repair 和 customer communication 仍需要显式 owner 与 approval。
AI 生成的根因同样需要证据
语言模型容易把相关性写成因果故事。每个 hypothesis 都应链接 metric、trace、log、config 或 reproduction;postmortem 记录 unknown 与 rejected hypothesis,避免把流畅解释误当事实。
课堂提示
课堂的结尾把 AI-assisted incident response 当成可能方向。最稳妥的迁移结论是:让 AI 提高 evidence bandwidth,让人保留目标、风险和 authority。
本章小结
AI coding 并未降低 systems knowledge 的价值。相反,生成能力越强,验证、隔离、恢复、安全和资源会计越成为产品与职业的核心。
总结与延伸
核心结论
八条可迁移结论
- AI coding 是 context、model、apply、validation 的闭环,各层需要不同 SLO。
- Blast radius 由 runtime/state boundary 决定,不由 service 数量决定。
- Merkle-style sync、content cache 和 retrieval evaluation 把全量工作变为可测 delta work。
- Metadata、jobs、source objects 与 derived index 需要不同 source of truth 和 rebuild path。
- Retry、cron、MVCC bloat 和 rebuild 会形成事故正反馈,恢复时先停止 producer。
- Migration 的隐藏成本是 re-embedding、dual validation、cache warming 和临时 capacity。
- Object storage 解耦耐久与 compute;global inference 仍需 cache、region、provider eval 与 fallback。
- Security、abuse、tool approval 与 incident response 都是产品持续性的基础设施。
实践作业:设计一个 AI coding backend
为一个支持 autocomplete、repo chat 与 multi-file agent 的系统完成以下设计:
- 定义 indexing、inference、apply 和 data plane 的 SLO 与 blast radius;
- 设计 Merkle-style sync、chunk/version key、embedding cache 和 deletion semantics;
- 列出 metadata、job、source object、vector segment 的 source of truth、rebuild path 与 migration validation;
- 为 retry storm、database disk pressure、object-storage cache miss 和 provider rate limit 写 degraded mode;
- 建立 self-hosted/frontier routing、offline/online eval、privacy、quota、tool approval 与 incident command。
验收标准
高质量方案不会只列“vector DB + LLM + queue”。它应说明可重建状态、retry 放大、dual validation、model version telemetry,以及代码与 terminal 权限怎样被理解和撤销。
拓展阅读
建议依次阅读 Cursor 的 secure indexing、Fast Apply、CursorBench、privacy 与 agent security;再读 turbopuffer 的 object-storage search 和 continuous recall;最后对照 PostgreSQL vacuum 与 Amazon S3 object/consistency model。