Lecture 22:Recipe for Training Helpful Chatbots
来源审计:这不是一张万能 Alignment 配方表
这场课最值得保留的不是若干固定超参数,而是一种实验组织方式:先把“helpful chatbot”拆成 demonstration data、preference data、training objective 与 evaluation protocol,再逐项改变数据分布和评价器,观察结论是否稳定。旧稿把这些层次压成了 SFT、reward model、PPO/DPO 的名词清单,还写入未被课堂支持的统一学习率与 batch size;本次重写回到 2023 年 10 月 31 日课堂证据,并把讲者的限定语放回结论旁边。
官方材料与版本辨认
本讲以 Stanford CS25 V3 课程页、Stanford Online 官方录像 mcep6W8oB1I、人工 en-US 字幕和讲者公开 deck 为主源。讲者站点存在 67 页与 71 页两个版本;录像在 00:26:30–00:26:40 明确投影了 “Recipe 2” 和 “Zephyr-7B”,因此选用包含这些页面的 71 页 transformers_united.pdf,而不是缺少 distillation 与 UN advisory 页的 67 页变体。
来源:官方幻灯片 p.1
读图:Recipe 指工程分解,不是神秘调参
标题中的复数 “Recipes” 已经提示不存在唯一流程。读后续每组实验时都应问四个问题:样本由谁写、优化什么目标、用什么评价器、结论能否跨评价器复现。若只记录模型名称和排行榜,就会漏掉本讲真正的研究方法。
来源:官方幻灯片 p.2
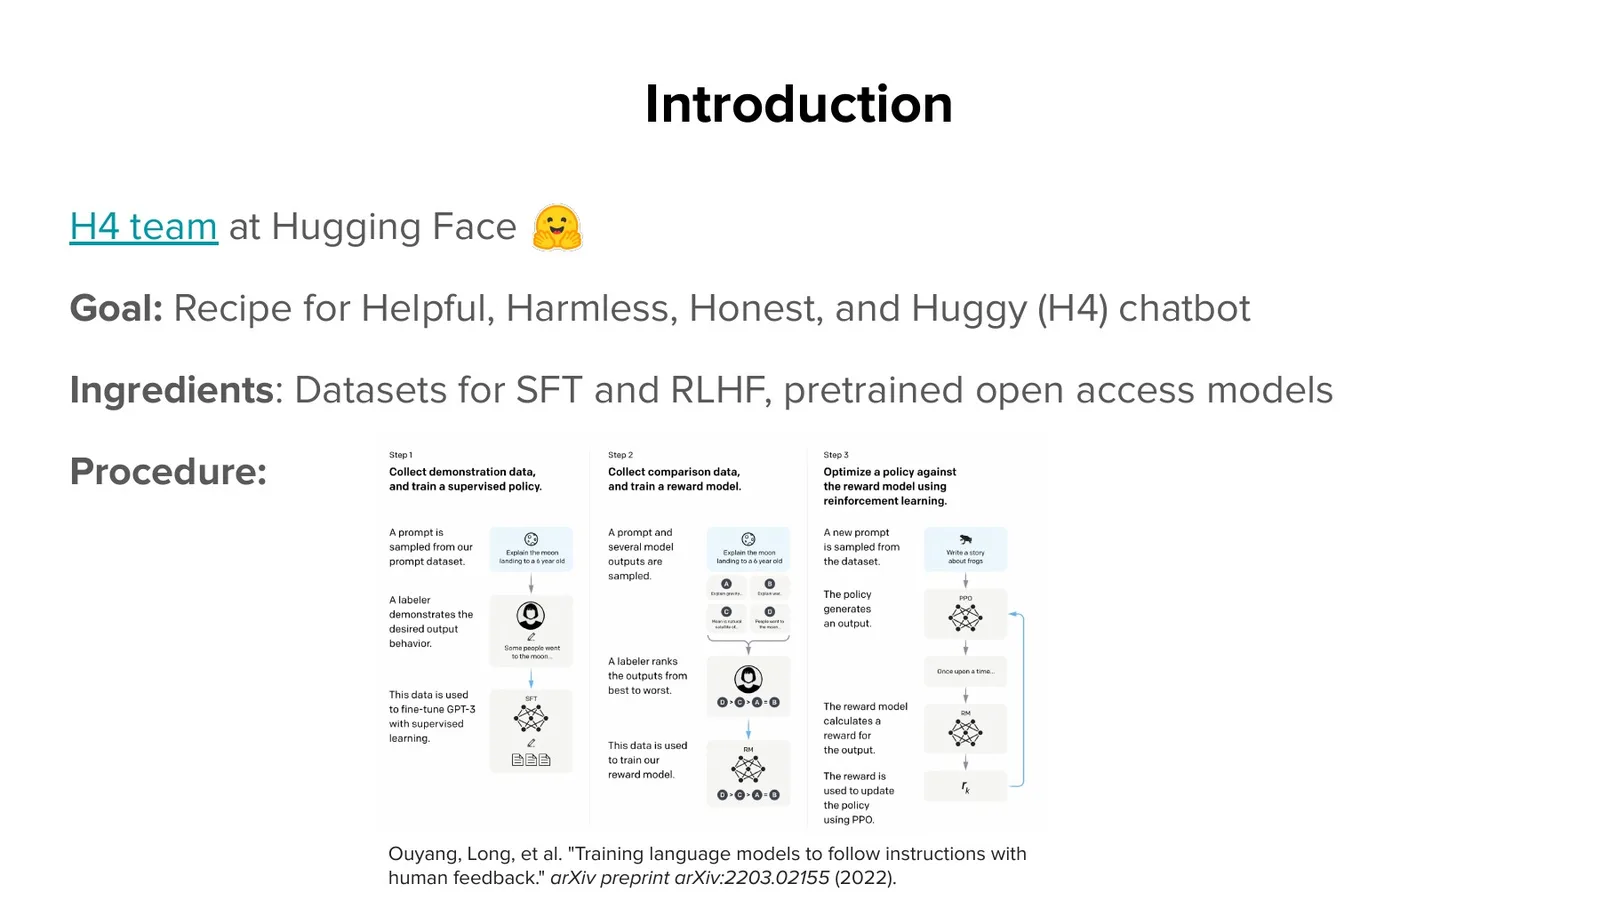
H4 的四个 H
H4 指 Helpful、Harmless、Honest、Huggy。本讲虽然从四项目标出发,却主要研究 helpfulness 与 SFT data;harmlessness、honesty 和完整 safety evaluation 只在 preference/red-teaming 边界中出现,不能把本讲等同于全栈安全方案。
课堂提示
Rajani 开场就说明:团队希望在 open-access pretrained model 上复现 alignment 的 “secret sauce”,但课堂大部分时间聚焦第一步—怎样把基座模型变成能完成用户任务的 helpful chatbot。这个范围声明决定了后文所有结果的解释边界。
来源:官方幻灯片 p.3
读图:本讲有两条 recipe 与一条审计线
第一条 recipe 是 human-curated demonstrations/preferences,第二条是 Zephyr 的 AI-generated data 与 AI feedback;两条路线最后都进入 evaluation。最右侧 GPT-4 evaluator quirks 不是附录,而是对前面所有排行榜结论的反向审计。
证据边界与覆盖策略
71 页 deck 中有 66 页承载教学信息;纯分隔页 6、32、48、59 与最终 Thanks 页 71 有意省略,其余 progressive highlights 均保留。正文引用的榜单、成本和模型能力都是 lecture-time snapshot:例如 “Zephyr beats ChatGPT” 只表示它在当时显示的 AlpacaEval/MT-Bench 协议上取得特定结果,不证明更安全、更真实或在所有任务上更强。
不要把 2023 snapshot 写成 timeless law
排行榜会随 prompt template、judge model、sampling、数据泄漏和参赛模型变化。本讲最强的持久结论不是某个模型排名,而是:数据实验必须和 evaluator audit 一起读;否则更长、更像 judge 训练分布的回答可能被误当成更 helpful。
本章小结
本讲是一个 data–objective–evaluator 联合实验,而不是通用调参表。正确阅读方式是始终区分课堂事实、讲者工程判断、排行榜代理指标与我们基于原始论文补充的机制解释。
从 Base Model 到 Chatbot:三种监督信号
前一章确定了证据边界,本章先建立共同语言。所谓“训练 chatbot”至少包含 demonstration learning、preference learning 与 policy optimization 三层;它们使用不同数据结构,解决不同问题,也需要不同评价方法。
SFT、Reward Model 与 RLHF
SFT(supervised fine-tuning,监督微调)把 prompt \(x\) 与人工/合成 completion \(y\) 作为监督对,最小化 next-token cross-entropy:
其中 \(\theta\) 是 chatbot 参数,\(y_t\) 是第 \(t\) 个目标 token,\(y_{< t}\) 是已给定前缀。SFT 学的是“像示范那样回答”,并不直接学会比较两个答案谁更好。
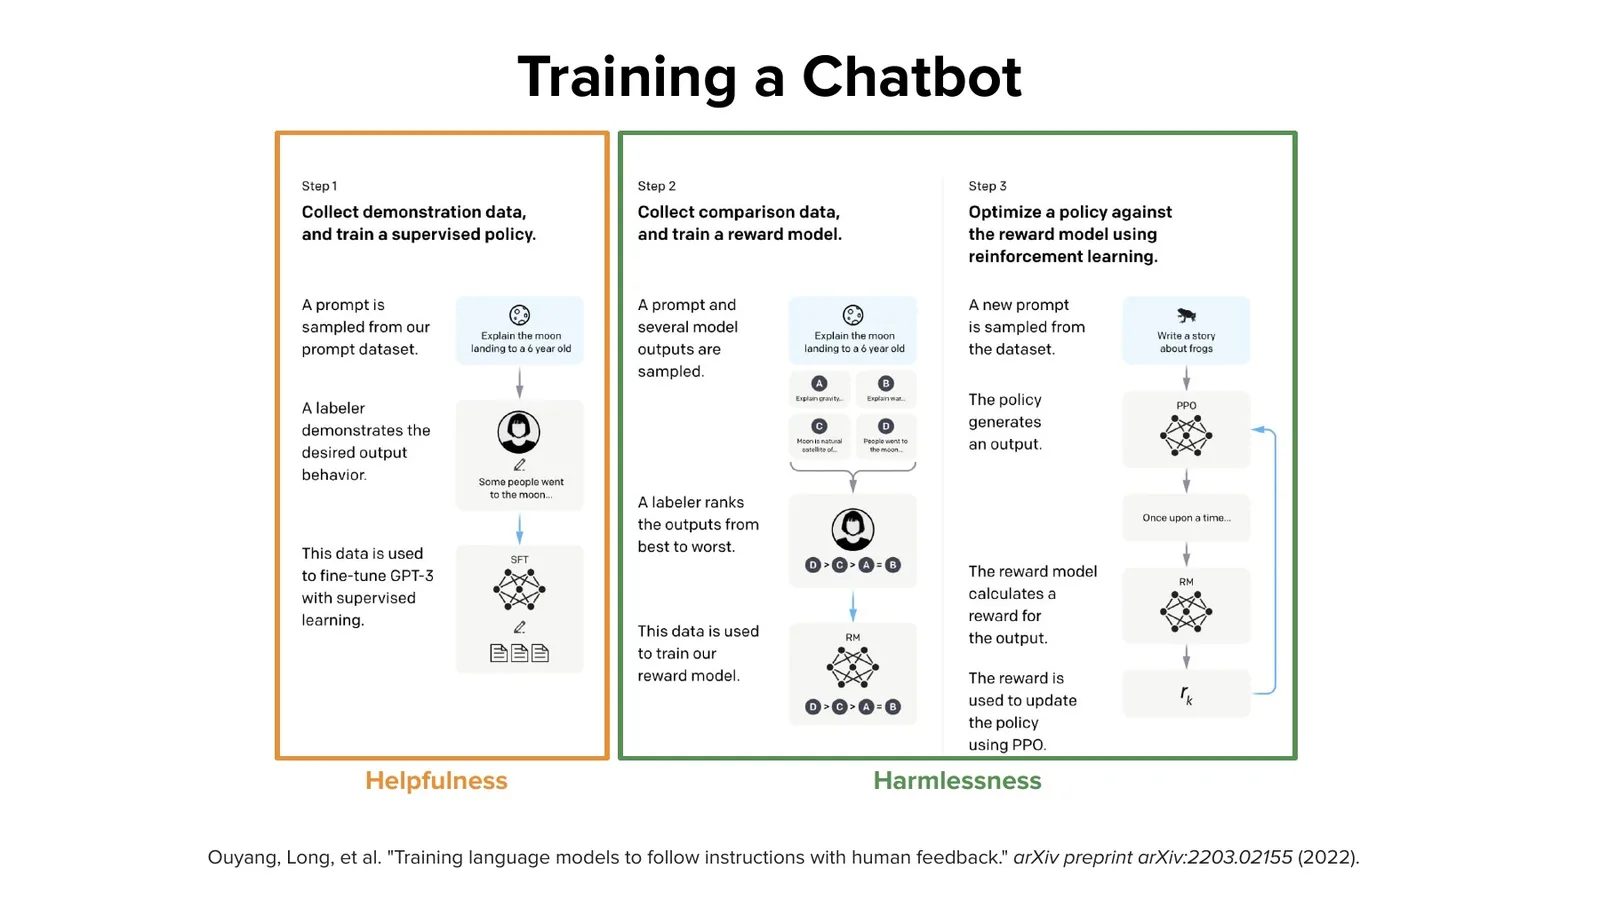
来源:官方幻灯片 p.4
读图:三步的 label 结构不同
第一步由人写 prompt 与 demonstration;第二步由模型生成多个回答、人只做排序;第三步用 learned reward 更新 policy。先看每步谁产生文本,再看人类劳动从“写完整答案”变成“比较答案”,即可理解为什么三阶段的数据规模、噪声和成本不同。
reward model(奖励模型,RM)把 \((x,y)\) 映射为标量 \(r_{\phi}(x,y)\)。对 preferred answer \(y_w\) 与 rejected answer \(y_l\),常用 Bradley–Terry pairwise loss:
其中 \(\phi\) 是 reward model 参数,\(\sigma\) 是 sigmoid;模型只需让 winner 分数高于 loser,并不要求奖励值具有绝对物理意义。
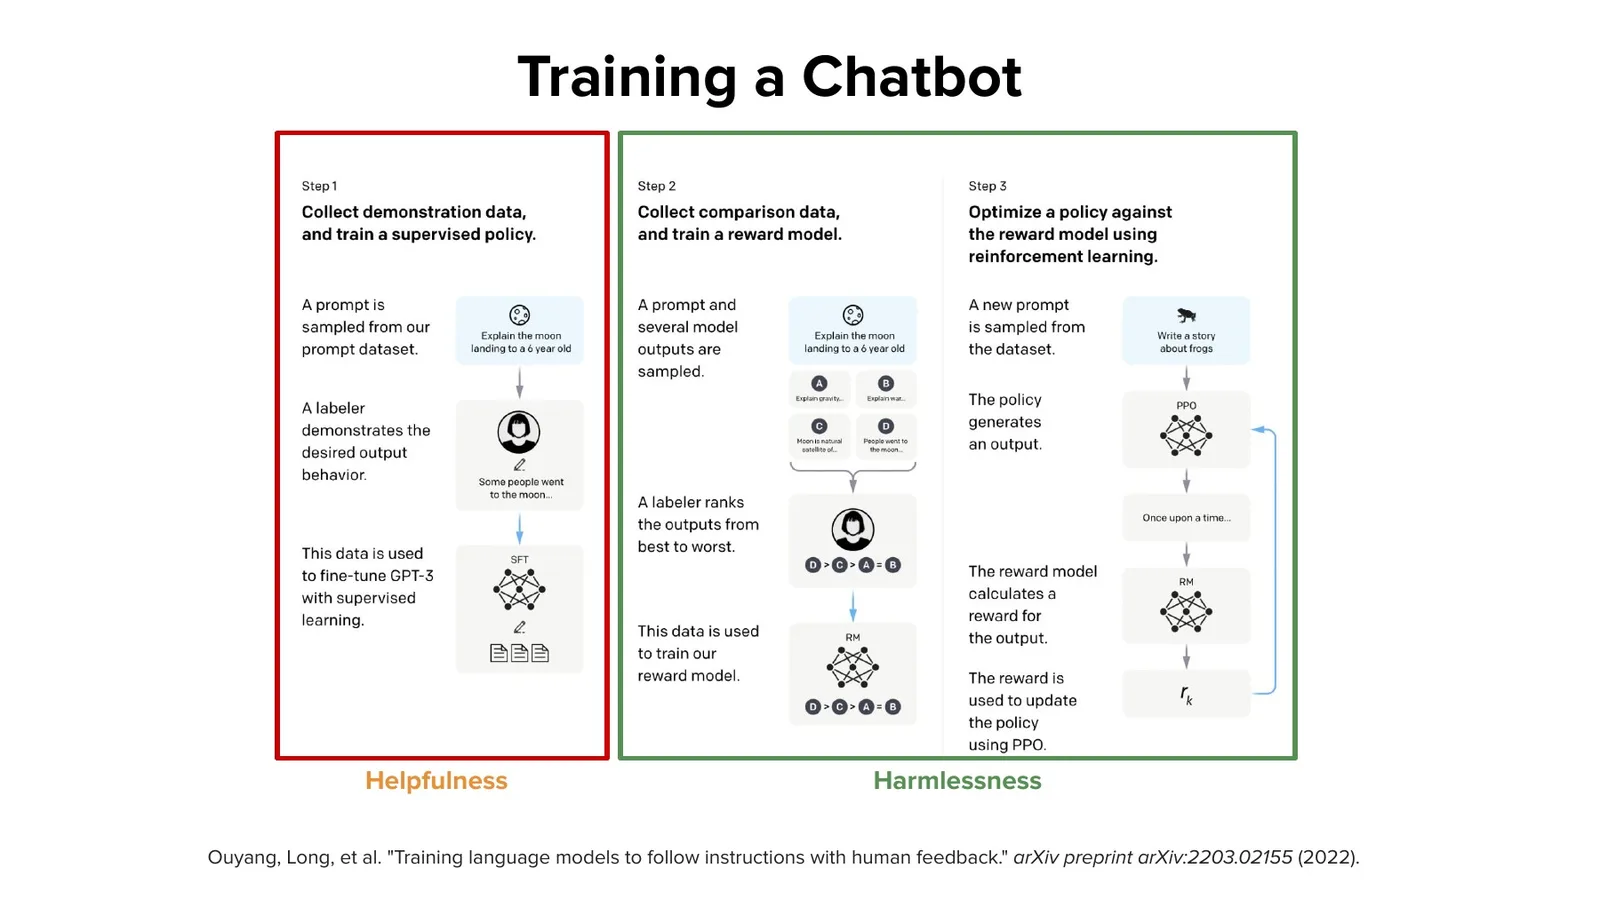
来源:官方幻灯片 p.5
RLHF 的目标不是“最大化 reward 就完事”
RLHF(reinforcement learning from human feedback)用 learned reward 优化 policy,同时通常用 KL penalty 约束它不要偏离 reference model:
这里 \(\beta\) 控制“追求偏好”与“保持原模型行为”之间的张力。Reward hacking、distribution shift 与 RM 误差都可能让更高分不等于更好答案。
课堂提示
讲者把 step 1 解释为“让模型先成为 helpful chatbot”,再把 step 2/3 看成加入 guardrails。这个说法是课堂叙事,不意味着 SFT 只影响 helpfulness、RLHF 只影响 harmlessness;现实中三阶段会同时改变风格、事实性与拒答行为。
术语消化:三类样本不要混用
下面的区分是后文读图的最小前置知识。若把 demonstration、preference pair 与 policy rollout 都叫“训练数据”,就无法解释为什么相同数量的样本成本和信息量完全不同。
三类监督信号
| 对象 | 样本结构 | 学到什么 |
|---|---|---|
| SFT | prompt + target completion | 模仿目标回答的 token distribution |
| Reward model | prompt + chosen/rejected responses | 学习相对偏好排序 |
| RL policy | prompt + sampled response + scalar reward | 让 policy 更常产生高 reward response |
本章小结
SFT、reward modeling 与 RLHF 使用三种不同 label。后面讨论 10K demonstrations、20K dialogues 或 100K preference examples 时,必须先问它们属于哪一种样本结构,而不能直接比较数字大小。
Instruction Data Landscape:谁写 Prompt,谁写 Completion
建立训练目标后,下一步是决定 demonstration 从哪里来。课堂没有简单地把数据分成“好/坏”,而是沿 model-generated 到 human-written 的连续谱比较成本、可扩展性、过滤负担与风格继承。
一条样本的基本结构
上一章已经区分三类监督信号,本节先把 SFT 的一条 demonstration 拆开,回答数据来源究竟在哪些位置进入模型。读后面两页时,应分别追踪 prompt 与 completion 的生产者,而不是只评价最终答案是否流畅。SFT 最小单位通常是 instruction/context 与 completion。这个定义看似简单,却隐藏两个关键选择:prompt 是否来自真实用户分布,completion 是否由人写、强模型写或弱模型自举;这两个来源决定了能力覆盖和偏差传递。
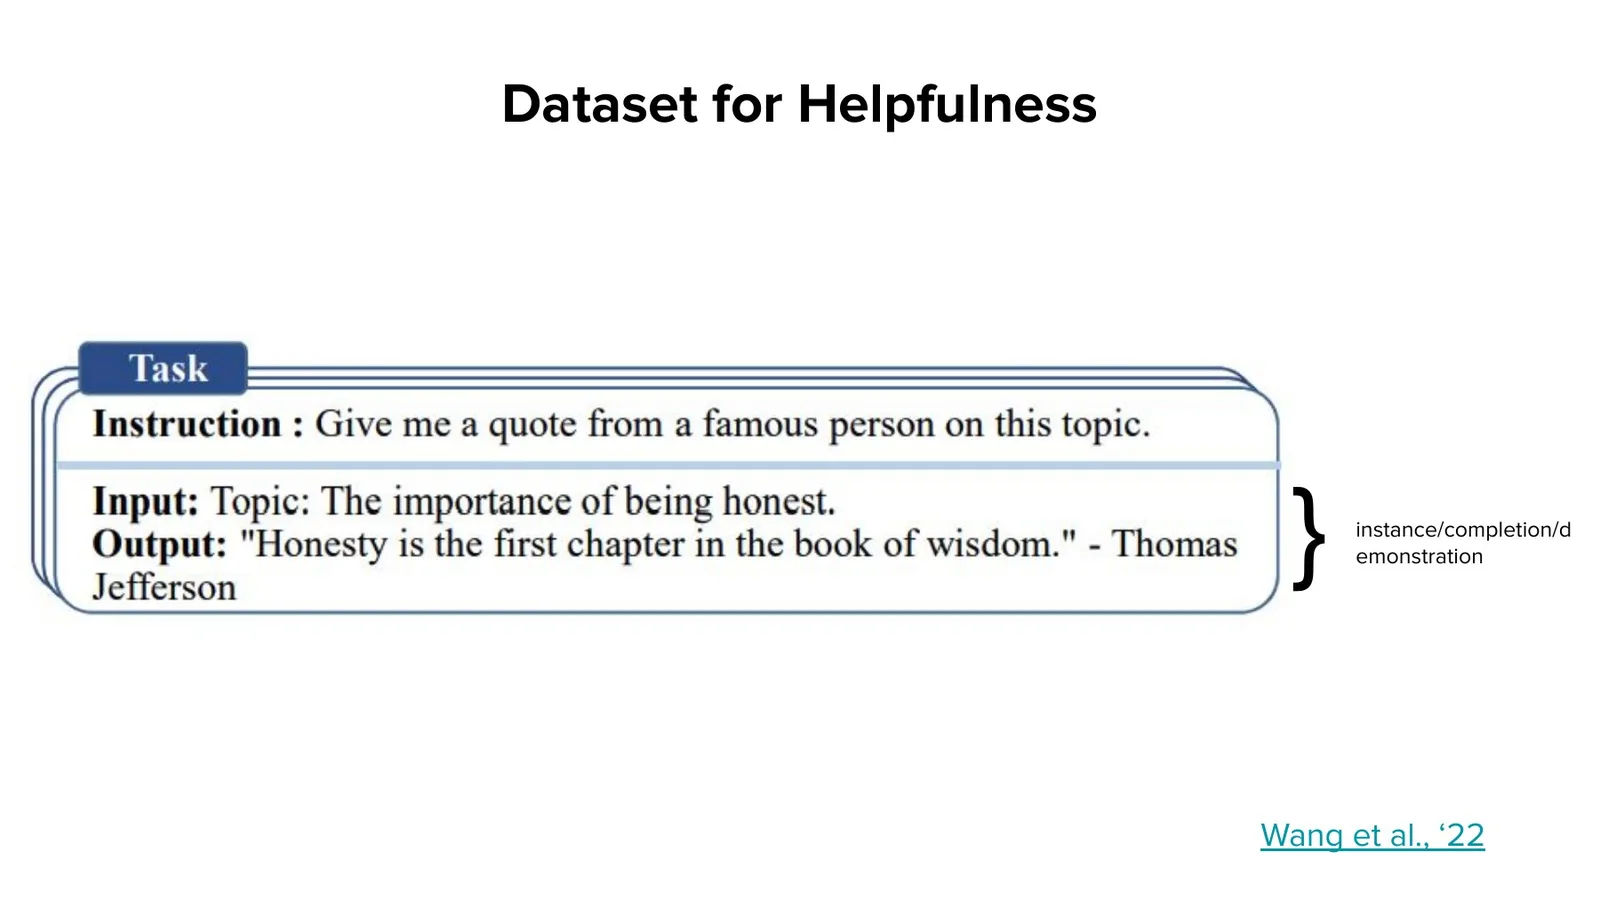
来源:官方幻灯片 p.7
读图:先分 input provenance 与 output provenance
图中蓝色块是 instruction/context,绿色块是 demonstration。两者可以来自不同生产者:例如人写 prompt、GPT-4 写 answer,或模型同时生成双方。判断数据质量时不能只读 answer 流畅度,还要检查 prompt 是否覆盖目标用户任务。
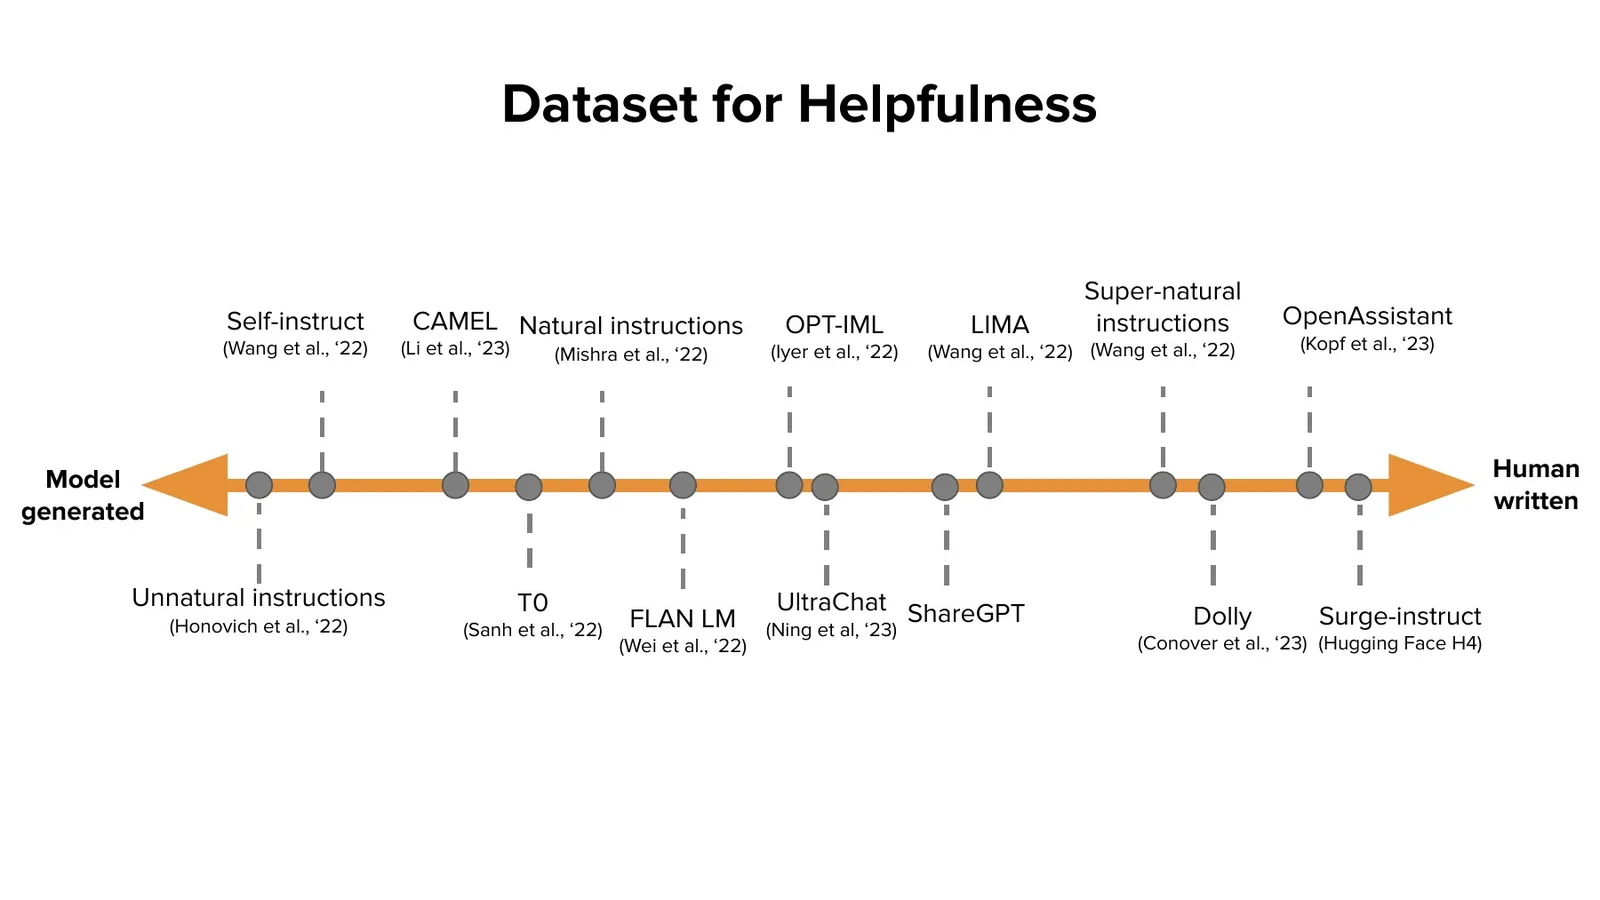
来源:官方幻灯片 p.8
读图:横轴不是单纯的质量排名
左侧方法便宜、可扩展,却更依赖 seed、teacher model 与过滤;右侧方法昂贵,但能引入真实人类意图和简洁表达。横轴展示 authorship,不保证越靠右越好,也不保证 synthetic data 必然低质。
课堂提示
Rajani 反复强调,Surge、OpenAssistant、Dolly 与 Self-Instruct 的差别首先是“谁写 input、谁写 output”。她不是在做 dataset leaderboard,而是在建立 provenance taxonomy。
三种 Synthetic Data 机制
同属 model-generated data,Self-Instruct、UltraChat 与 CAMEL 的 human role 并不相同。把三者并排看,可以理解 synthetic pipeline 的核心变量是 seed、retrieval/material、agent roles 与 filtering,而不是一个“用 GPT 生成”开关。
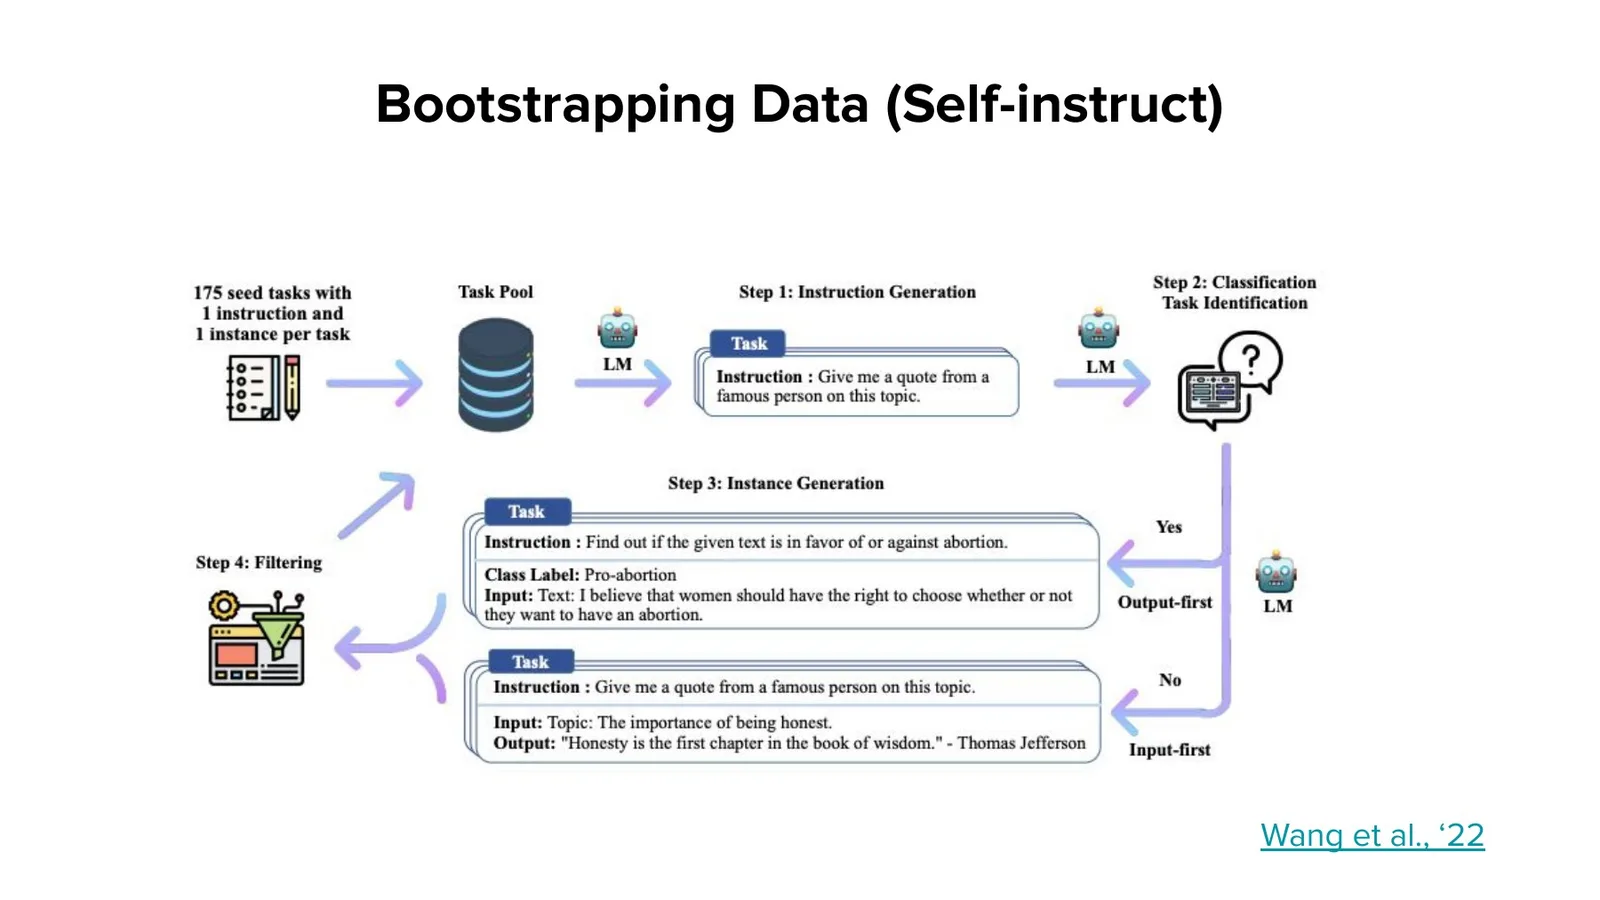
来源:官方幻灯片 p.9
读图:扩展链路与误差链路是同一条链
少量人工 seed 经过 few-shot generation 扩展,再经过 task classification 与过滤进入 task pool。扩展能力来自 teacher model;模式坍缩、重复和错误也从同一 teacher 传播,因此 filtering 不是可选清洁步骤,而是生成算法的一部分。
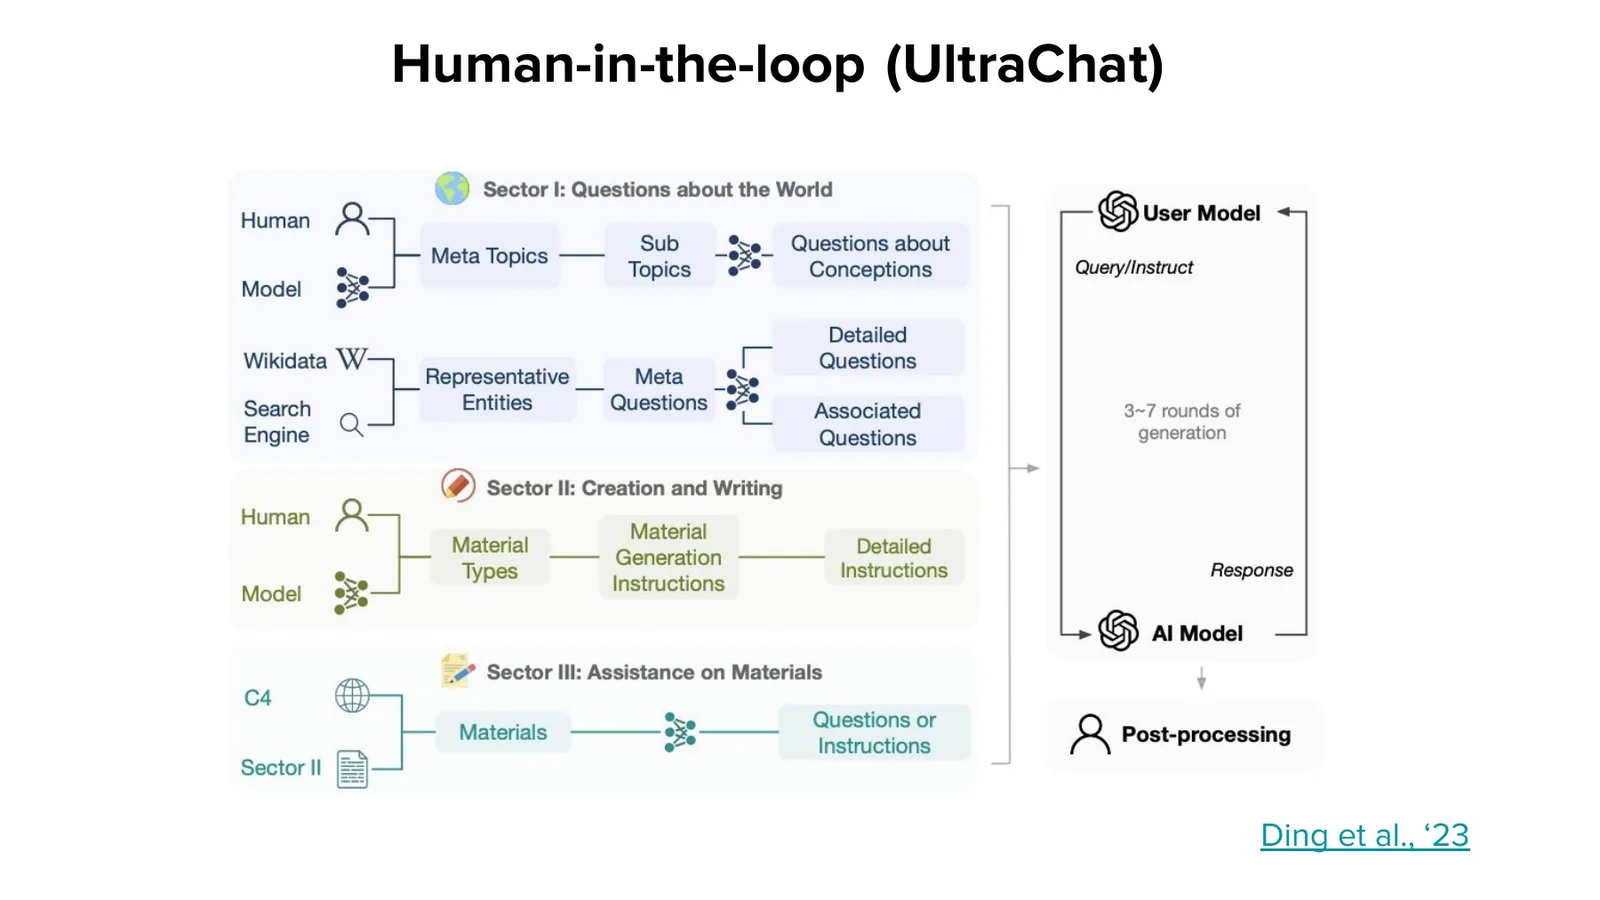
来源:官方幻灯片 p.10
读图:人不一定写最终答案,也能改变数据分布
人类检索主题与支撑材料、决定任务和追问方向,强模型生成对话内容。相比纯模型自举,这种机制把人类劳动放在主题选择与迭代精炼上,用较低写作成本换取更明确的覆盖控制。
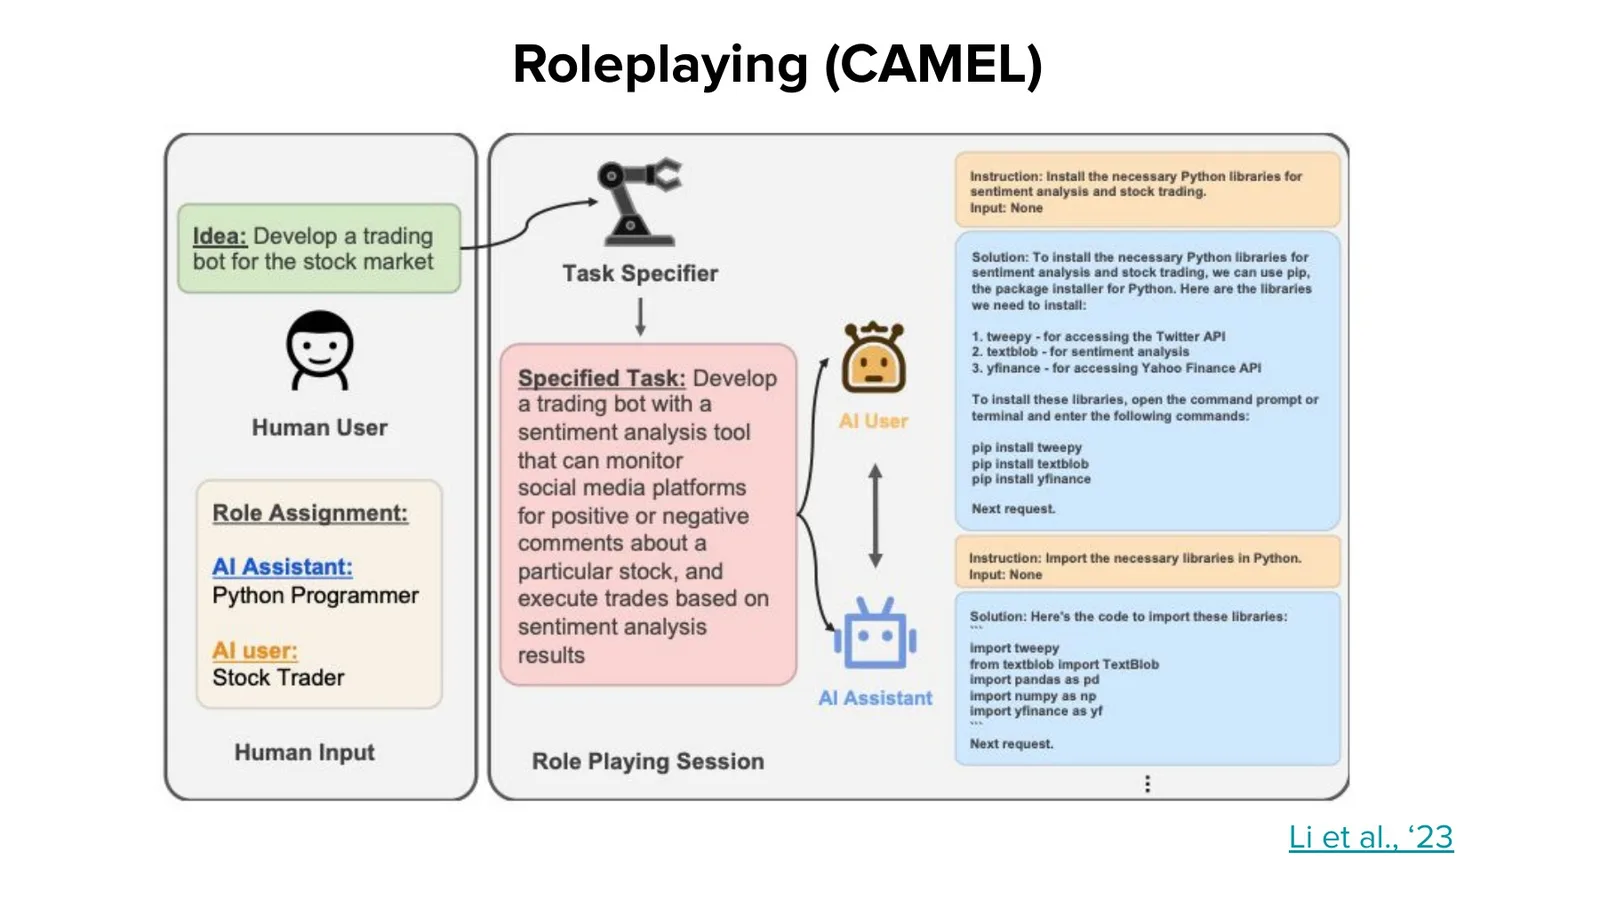
来源:官方幻灯片 p.11
读图:两个 agent 的互动仍由初始任务约束
一个模型扮演 AI assistant,另一个扮演 user,二者围绕高层 task 自行展开。它适合大规模生成 interaction traces,但角色 prompt、termination 和模型共同偏差会决定对话多样性,不能把“多 agent”自动等同于“更真实用户”。
课堂提示
课堂把三种方法排成“人参与程度”不同的生产线:Self-Instruct 重 seed/filter,UltraChat 让人提供材料并反复精炼,CAMEL 只让人定义高层任务。讲者借此说明,synthetic data 不是一种数据,而是一族 workflow。
从 Landscape 到 H4 的选择
当时公开数据迅速增长,团队仍决定购买全人工 instruction demonstrations。这个决定不是否定 synthetic data,而是为了得到一个可控的人类基线,再用后续实验比较 task mix、length 与 quantity。
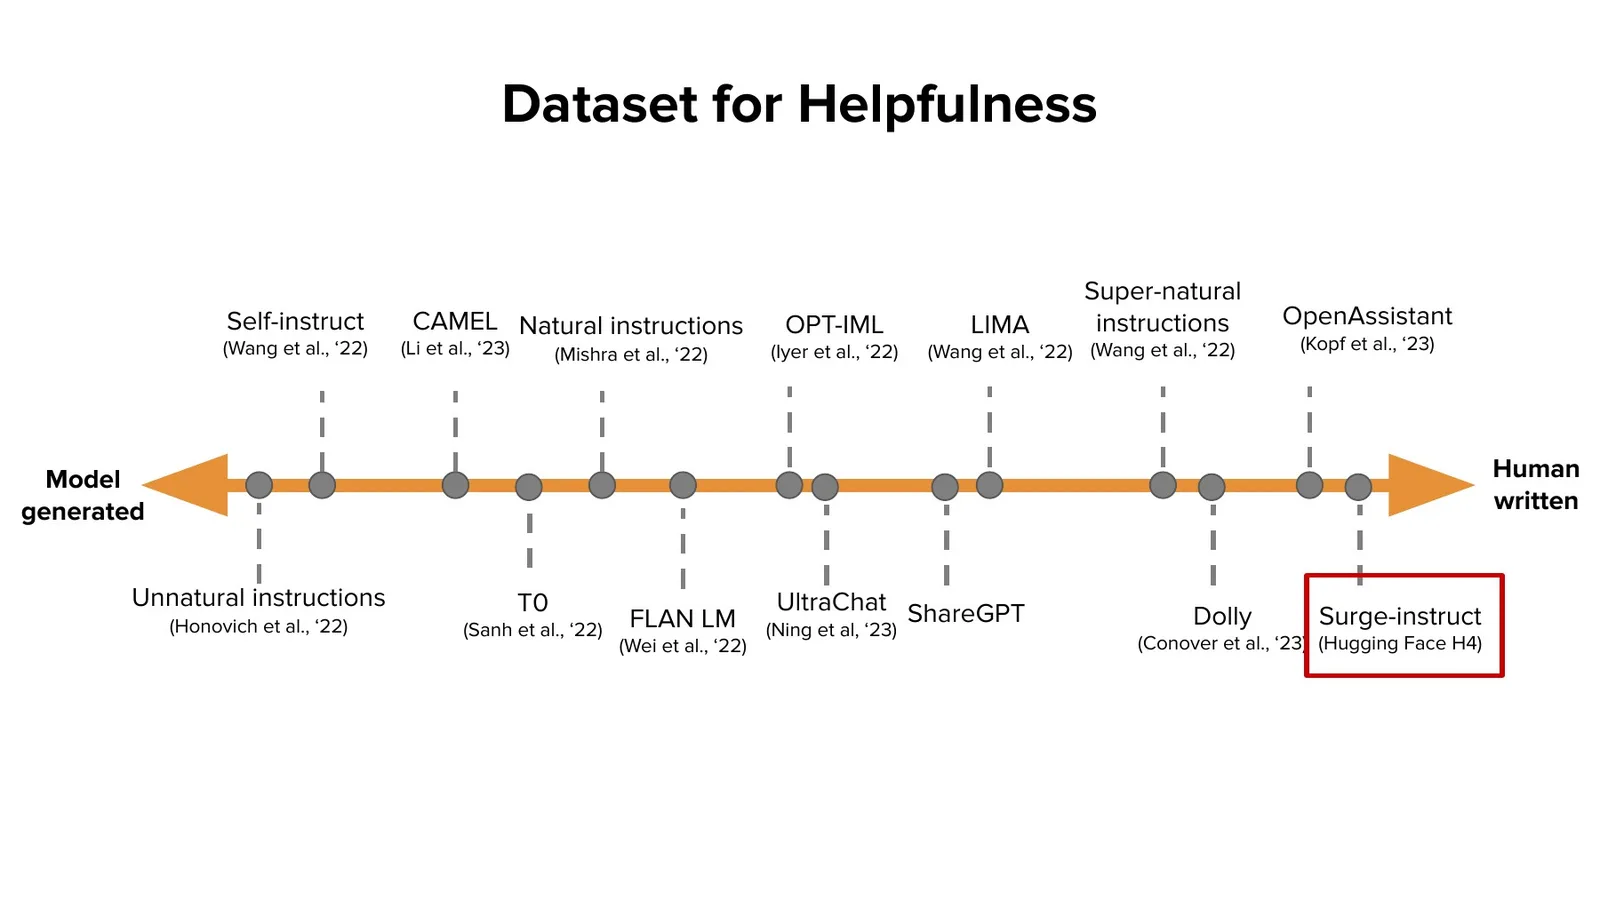
来源:官方幻灯片 p.12
读图:数据集名称需要机制解释
Self-Instruct/Unnatural Instructions 以模型扩展为主;T0/FLAN 将已有 NLP tasks 转成 instruction format;UltraChat/ShareGPT 依赖模型或用户对话;Dolly/OpenAssistant/Surge 更靠近人工写作。真正可迁移的知识是机制与 provenance,而不是背名字。
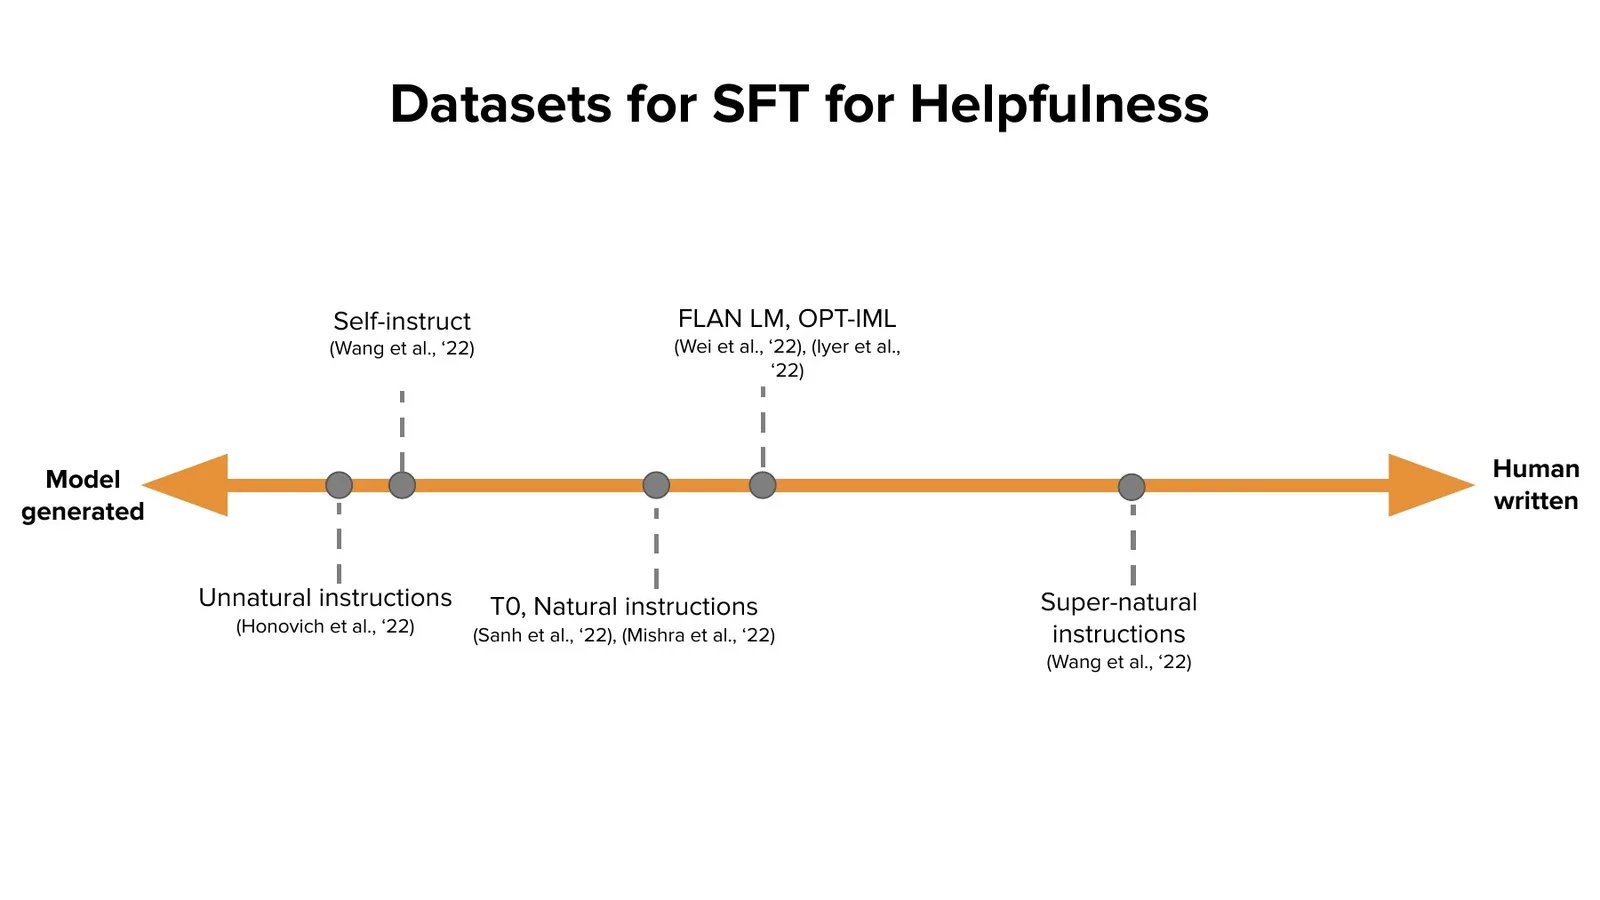
来源:官方幻灯片 p.13
为什么仍然购买人工数据
团队希望把“human-written”作为实验控制组:若 synthetic teacher 的风格、事实错误或长度偏好已经进入数据,就很难判断下游模型提升来自任务覆盖还是 teacher imitation。人工数据昂贵,却能提供不同的误差结构。
课堂提示
讲者直白地说 humans inefficient and expensive,但也不能低估 manually created data 的质量。H4 在 2023 年初选择“非常 manual”的路线,是预算约束下的研究设计,不是对所有项目的永久建议。
术语消化:常见数据源
| 名称 | 解决的问题 | 本讲中的机制位置 |
|---|---|---|
| Self-Instruct | 从少量 seed 扩展 instruction set | 模型生成 + 分类过滤 |
| UltraChat | 大规模多轮对话 | 人选主题/材料 + 强模型生成 |
| CAMEL | 角色化交互轨迹 | 两个 LLM role-playing |
| FLAN/T0 | 统一多任务 instruction format | 任务重写与 mixture |
| LIMA | 少量高质量示范 | human-written、数量小 |
| OpenAssistant 与 Dolly | 社区或员工人工对话 | human-authored baseline |
| Surge-Instruct | H4 可控人工 demonstrations | vendor workforce + 指定分布 |
本章小结
Instruction data 的第一性问题是 authorship 与 workflow:谁决定任务、谁产生内容、谁过滤。Synthetic 与 human data 各自携带不同成本和偏差,后续实验必须显式记录这种 provenance。
SFT Dataset Design:数量之外还有分布
上一章选定 human-written baseline,本章进入真正困难的采购问题:需要多少条、哪些任务、什么长度、由怎样的人群完成。课堂的核心贡献是把“收集 10K 条数据”改写成一个多维 design vector。
Diminishing Returns 不是“数据不重要”
上一章解释了为什么 H4 需要一个 human-written baseline;本节进一步问,既然人工数据昂贵,增加样本到什么阶段会开始失去边际价值。读曲线时先区分“收益斜率变小”与“数据不再重要”。早期工作提示高质量 instruction 在几千条后收益趋缓,但这个结论依赖基座模型、任务混合与 evaluator。正确含义是边际收益下降,需要做 controlled ablation;错误理解是任意 1K 条数据都足够。
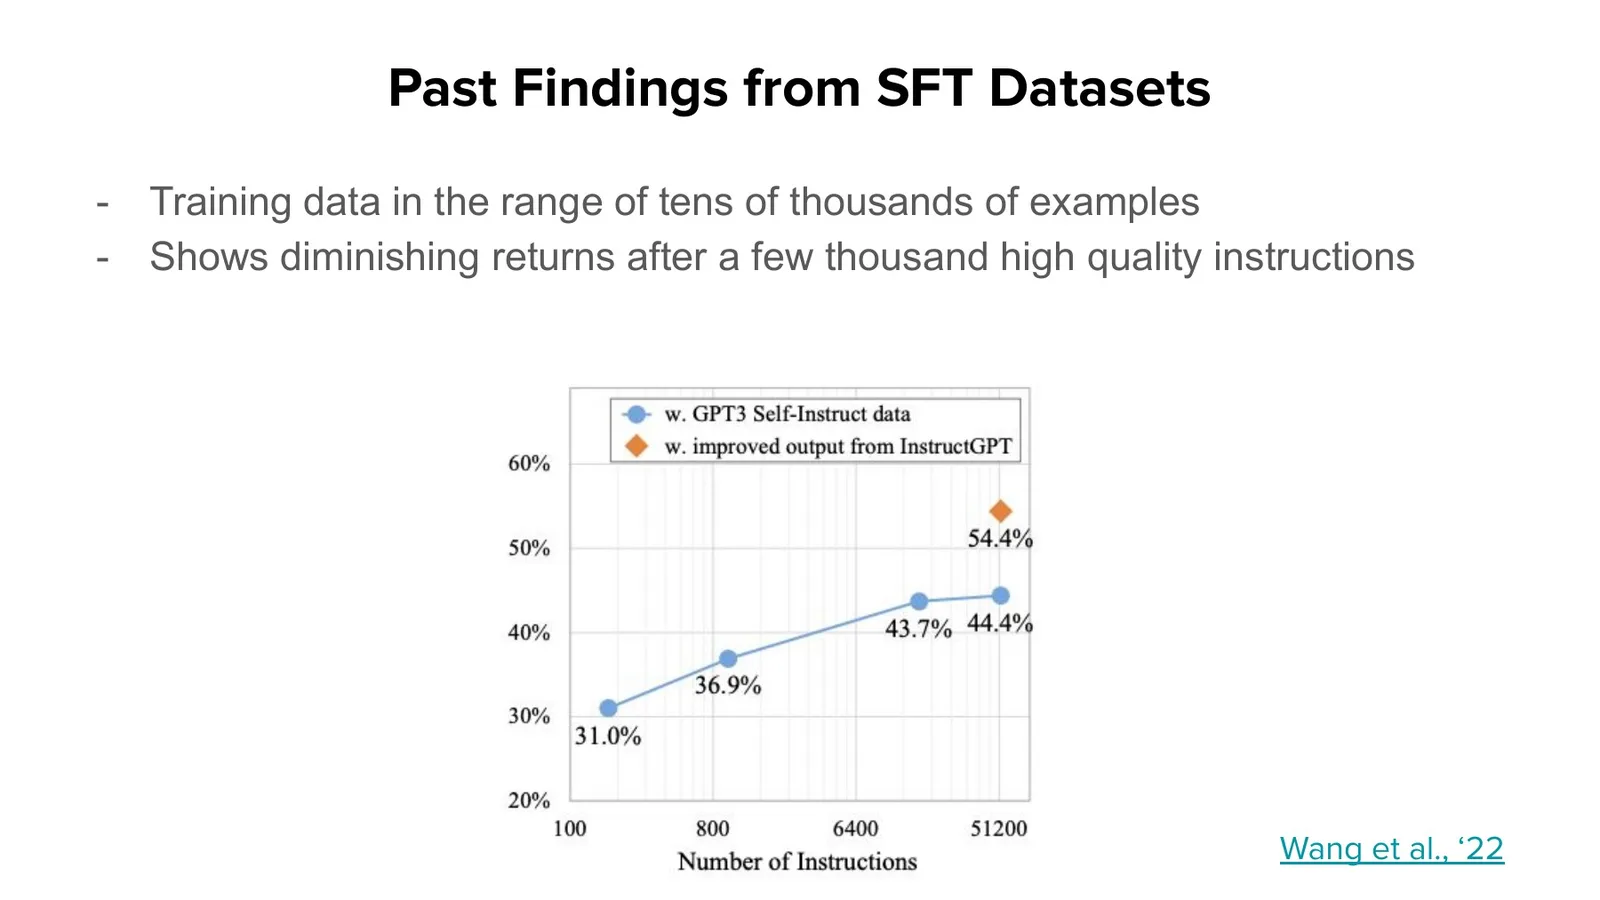
来源:官方幻灯片 p.14
读图:曲线支持边际收益下降,不支持统一最优规模
横轴是加入的 instruction 数量,纵轴是特定评估表现。先看斜率何时变小,再检查曲线使用的 task mix 和 model。饱和说明继续复制相似样本价值下降,却不排除新增任务、提高难度或修复错误仍然有效。
课堂提示
团队进入采购时掌握两条看似矛盾的先验:数据规模应在 tens of thousands,但少数高质量 instructions 后又会迅速饱和。讲者用这个矛盾引出后续 task/length ablation,而不是给出一个神奇样本数。
来源:官方幻灯片 p.15
Dataset size 不是充分统计量
两个同为 10K 的数据集可以在 task entropy、prompt length、completion length、multi-turn ratio、写作者背景和错误相关性上完全不同。若模型表现不同,不能只把因果归到 “more data” 或 “better quality”。
Task Distribution:模型最终练习了什么
Task mix 决定 token budget 被分配到 generation、QA、coding、classification 等能力。课程先展示 InstructGPT 分布,再展示 H4 为 Surge collection 选择的分布,强调 distribution 是产品需求与可评估性的共同函数。
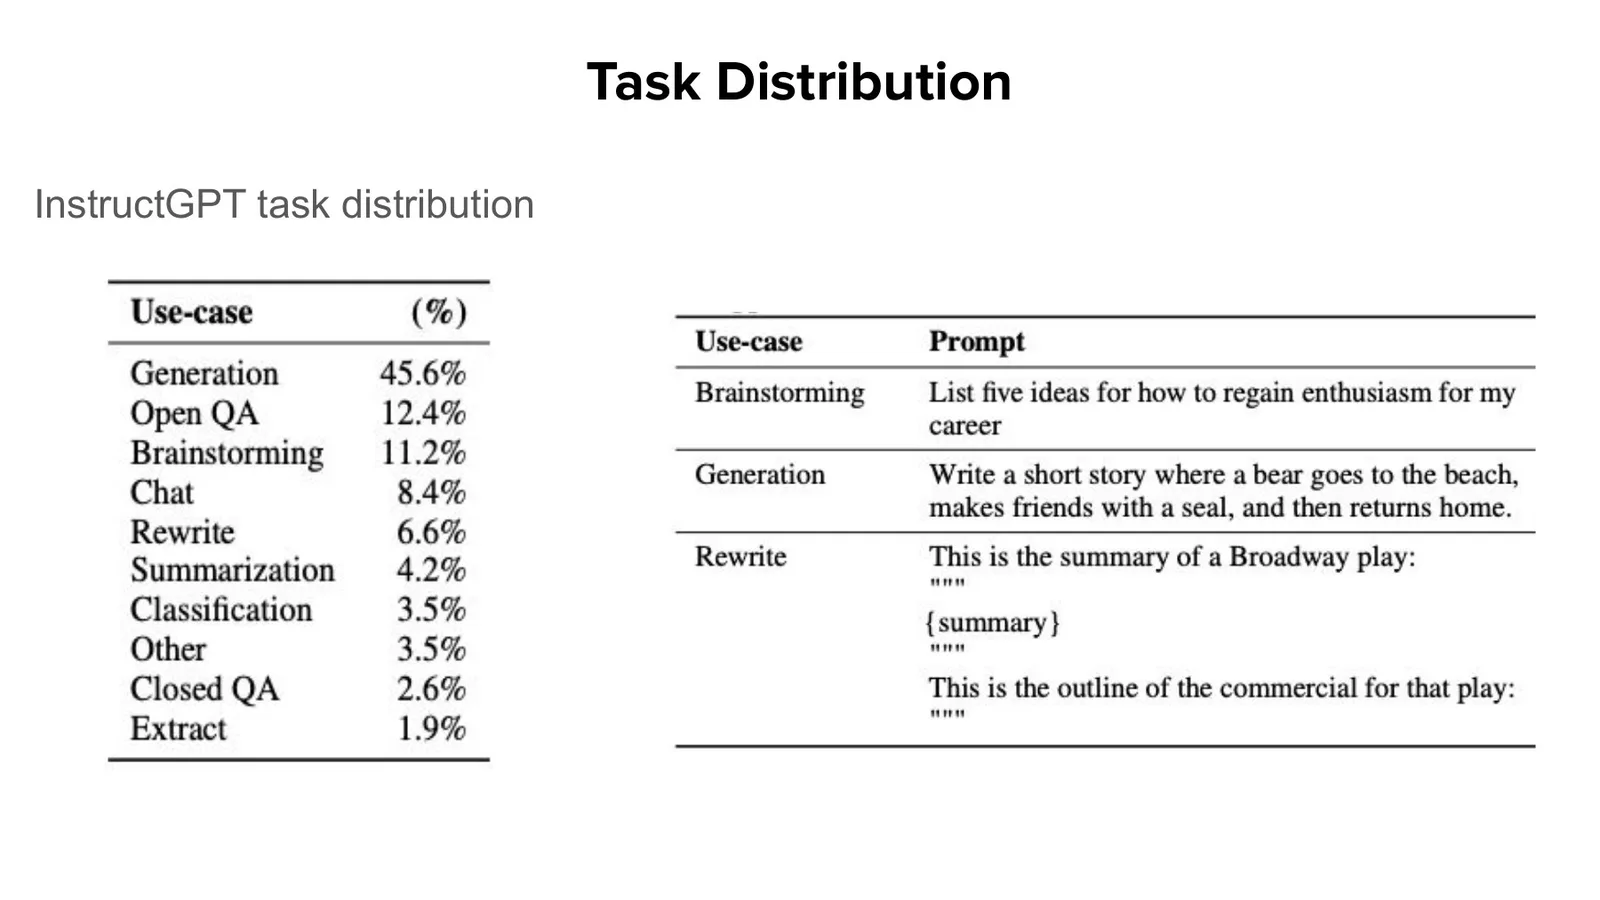
来源:官方幻灯片 p.16
读图:百分比是训练预算分配
表中每一行不仅代表一种任务名,也代表不同答案空间:classification 较低熵,brainstorm/generation 较高熵,coding/math 更容易存在可执行或唯一正确性。分布变化会同时改变学习难度和 evaluator reliability。
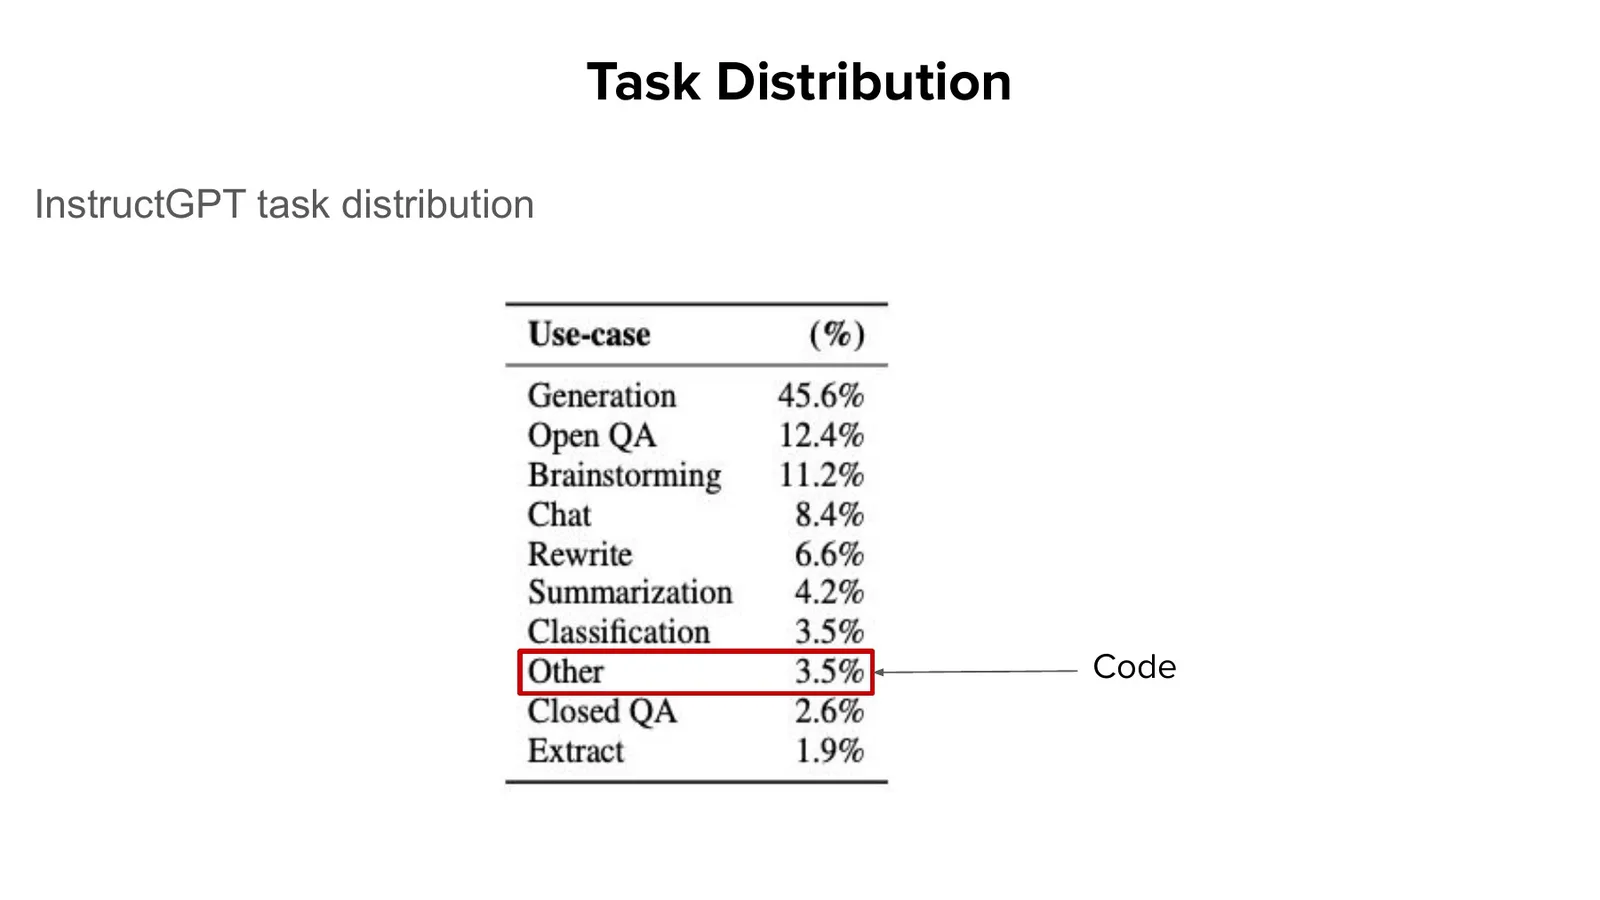
来源:官方幻灯片 p.17
读图:比较差值,而不是寻找唯一正确配方
先比较 generation、rewrite、coding、QA 等比例相对基线怎样移动,再问这种移动服务什么目标。H4 分布是一次有预算、有人群和 2023 应用假设的设计;它不是所有 chatbot 的 universal mixture。
课堂提示
讲者把采购问题概括为“how many thousands of what task?”。这句话比“数据质量更重要”更精确:质量必须落到任务覆盖、答案可判定性与下游目标上。
target_mix = {
    "generation": 0.15, "open_qa": 0.05, "brainstorm": 0.10,
    "rewrite": 0.15, "summarize": 0.10, "math": 0.05,
    "coding": 0.15, "classify": 0.10, "closed_qa": 0.05,
    "extract": 0.10,
}

def allocate_examples(total_examples, target_mix):
    counts = {task: round(total_examples * ratio)
              for task, ratio in target_mix.items()}
    counts[max(counts, key=counts.get)] += total_examples - sum(counts.values())
    return counts
Length Distribution:不是越长越有用
Prompt/response length 会改变 task difficulty、训练 token 数、generation style 和 judge 偏好。课程把 prior datasets 的 length table 与选定约束并列,为后面的 metric reversal 埋下伏笔。
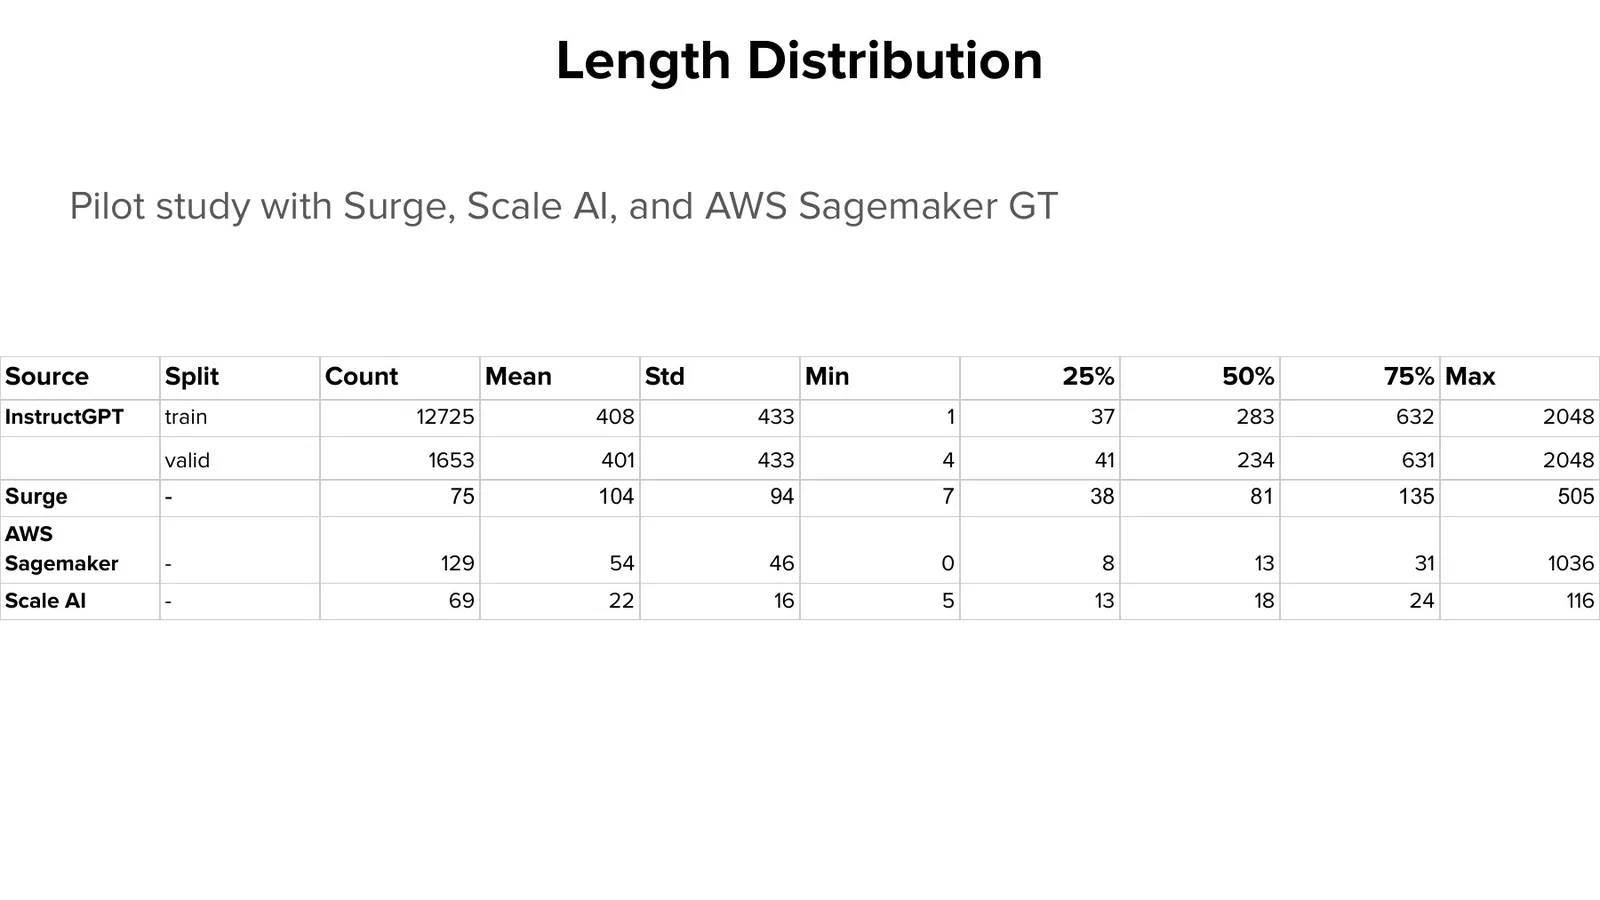
来源:官方幻灯片 p.18
读图:样本数与 token 数是两种预算
同样 10K examples,平均 completion 长度翻倍就近似消耗双倍 target tokens。长回答也更容易包含列表、解释和冗余,LLM judge 可能把这些 style signal 当成 helpfulness,因此 length 既是训练变量也是 evaluation confounder。
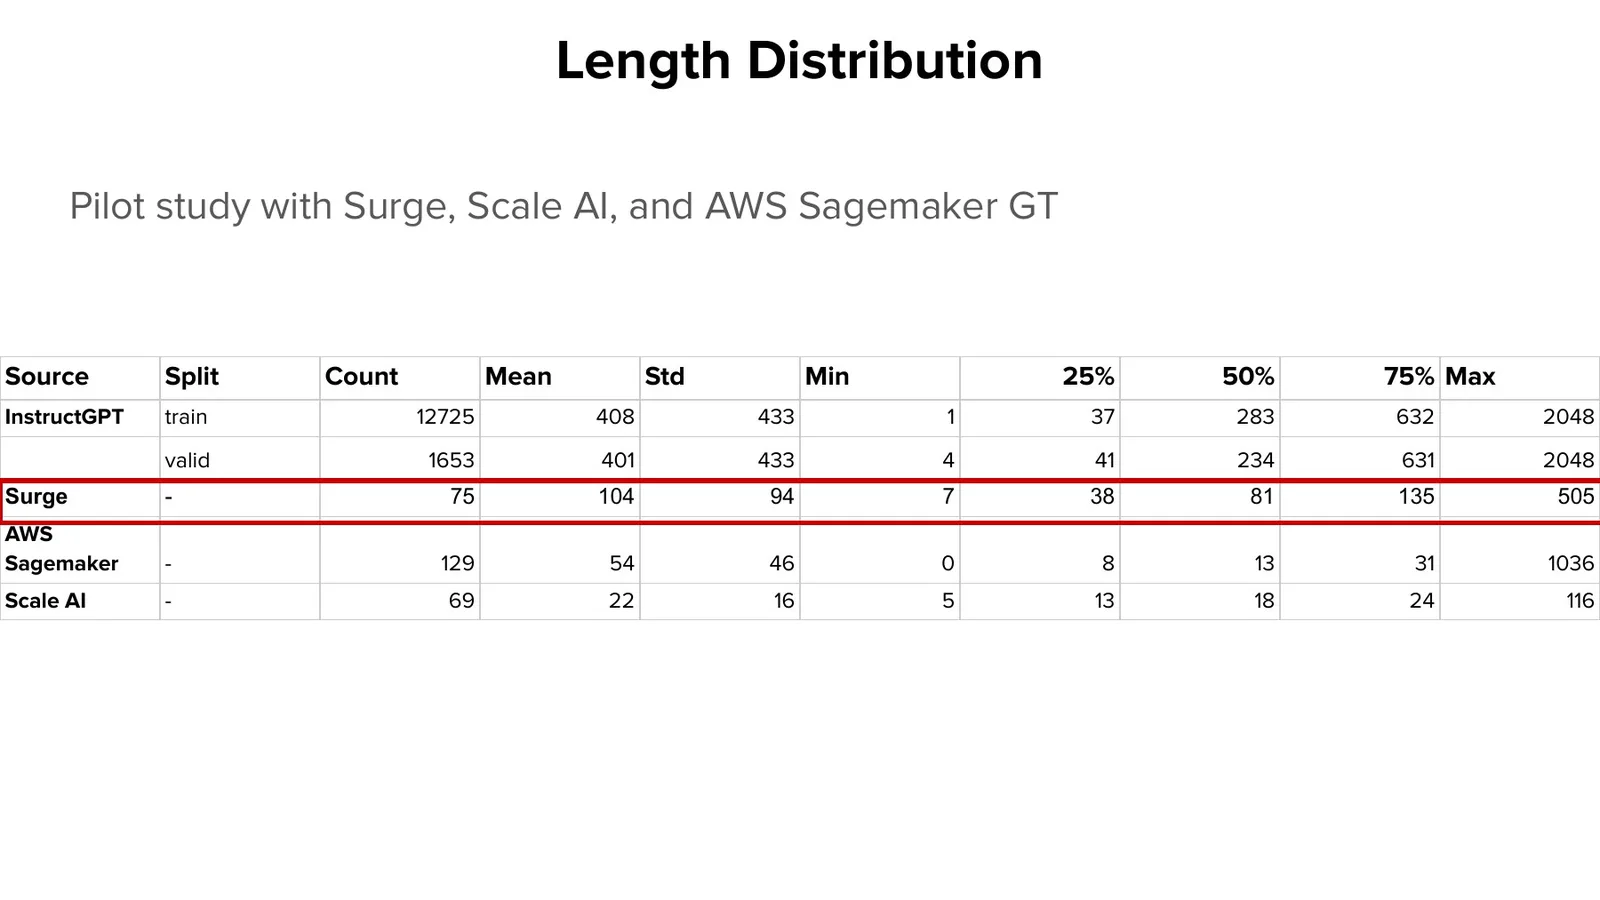
来源:官方幻灯片 p.19
Length effect 不能只看相关曲线
若长 prompt 同时集中在某些任务,或长 completion 来自特定写作者,performance–length correlation 可能是 task/source confounding。后续 ablation 的价值在于控制一部分变量,但仍不能自动得到普适因果律。
Surge-Instruct 的任务、例子与人群
前两小节已经确定 task 与 length 两个设计变量,本节把它们落到最终采购的数据集,并补上常被忽略的 workforce provenance。读下面三页时依次回答“收了什么”“样本长什么样”“谁在写”,再判断这些信息如何限制结果外推。Surge-Instruct 最终收集约 10K instruction–demonstration pairs;只有三类证据一起,数据集描述才完整。
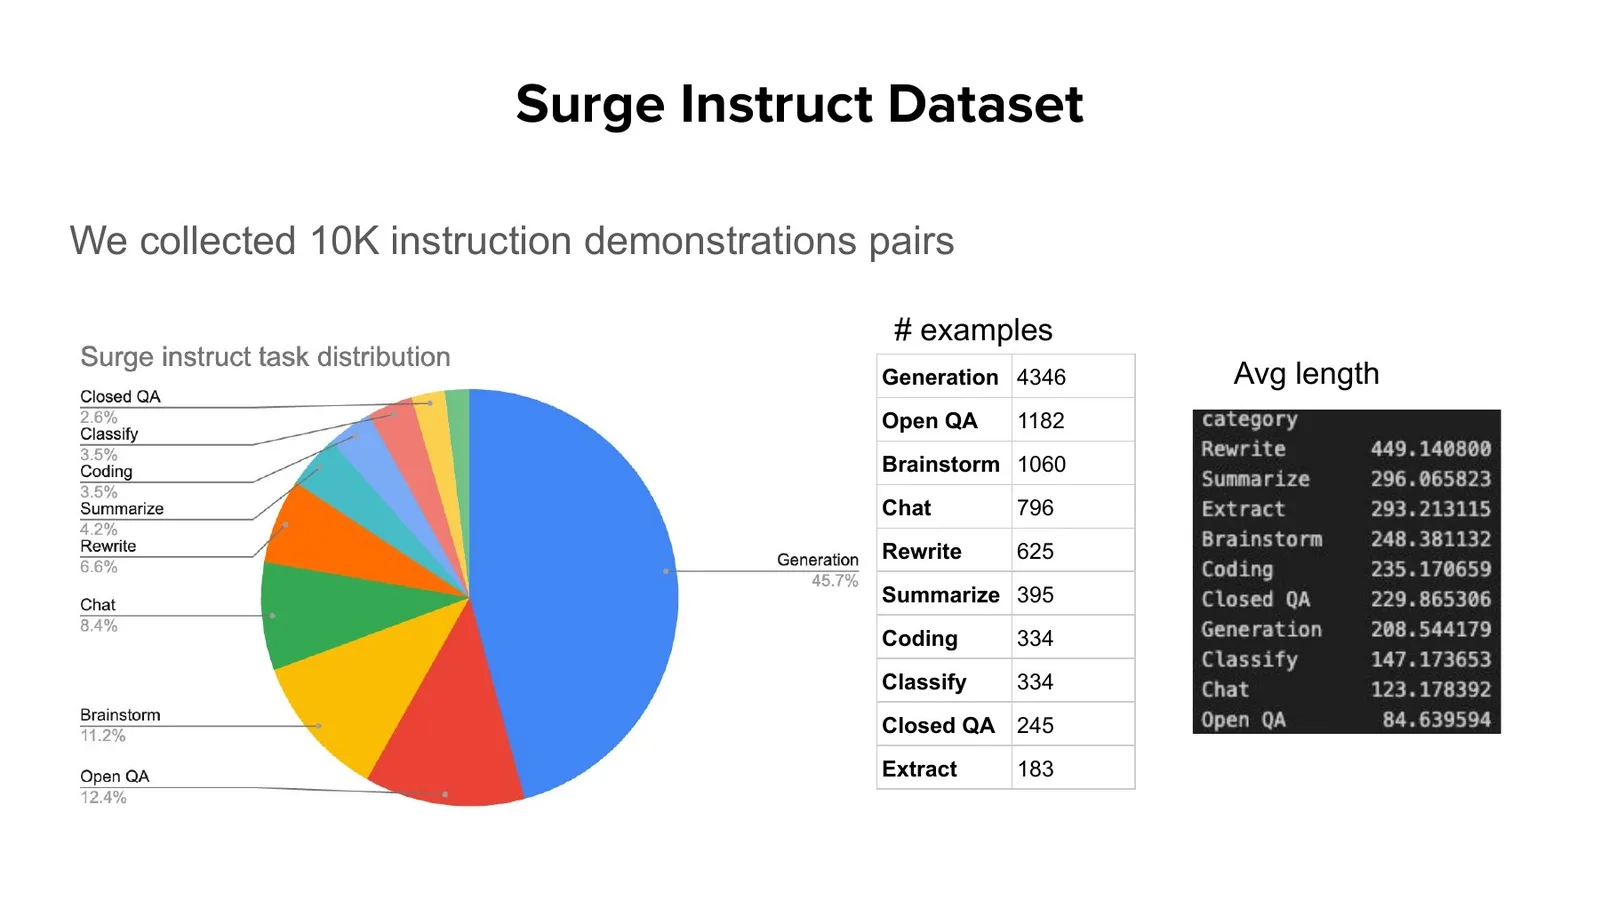
来源:官方幻灯片 p.20
读图:饼图与计数表需要同时看
Generation 占最大块,但 open QA、brainstorm、chat、rewrite、summarize、coding 等共同构成 mixture。先看绝对计数避免小类别被饼图隐藏,再看任务是否覆盖预期产品;该图描述 distribution,不直接证明哪一类带来提升。
来源:官方幻灯片 p.21
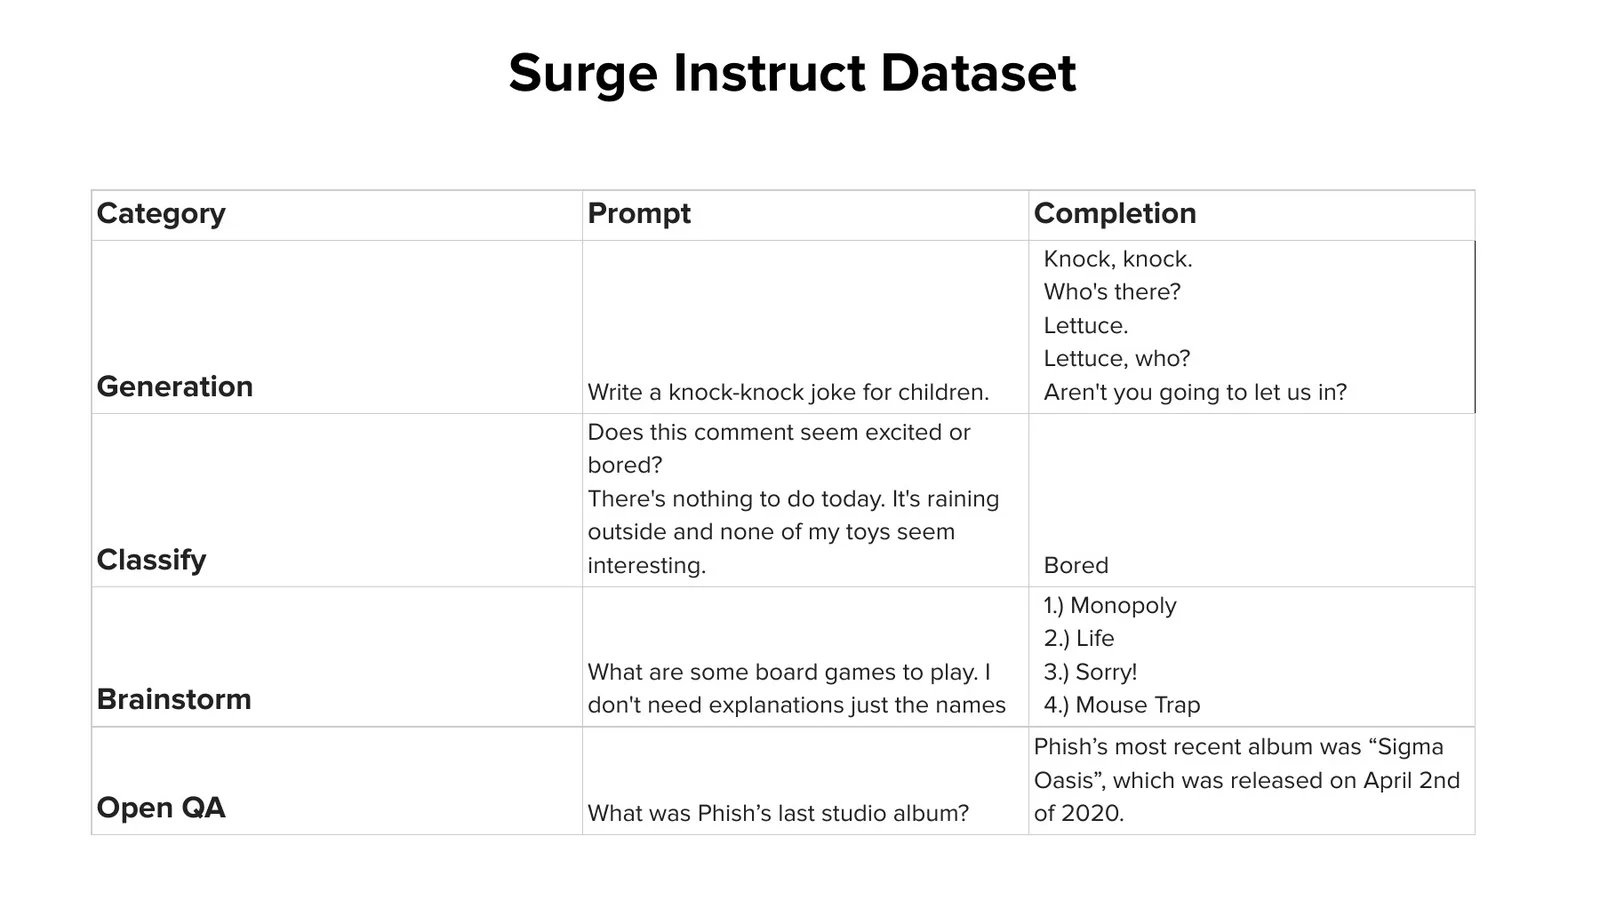
读图:不同 task 的“好答案”判据不同
Knock-knock joke 需要风格与结构,classification 需要离散标签,brainstorm 强调覆盖和简洁,open QA 强调事实。把它们放在同一 loss 中训练很容易,但评价时必须保留 task-specific criteria。
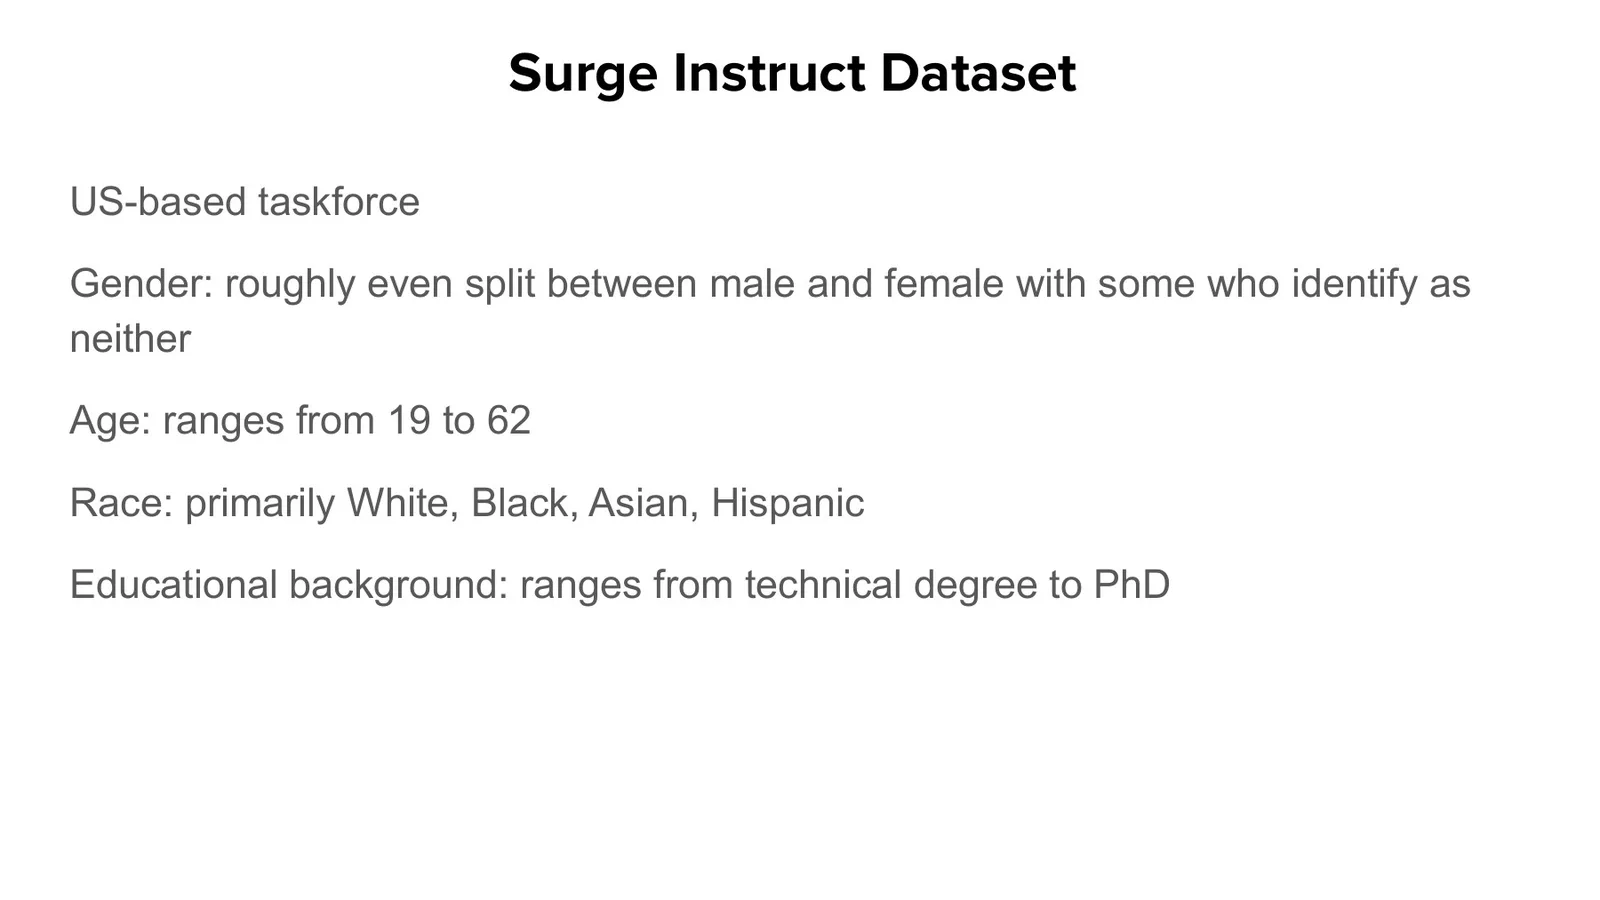
来源:官方幻灯片 p.22
Demographics 是来源说明,不是代表性证明
US-based workforce、性别/年龄/种族/教育分布有助于理解数据由谁生产,却不能证明它代表全球用户。讲义保留这些信息,是为了追踪 viewpoint coverage 和潜在偏差,而不是把 demographic diversity 当作质量认证。
课堂提示
讲者列出 annotator background,是在承认 human-written data 也有生产分布。人工数据不会自动无偏;它只是把偏差来源从 teacher model 转移到写作者、指南、供应商与审核流程。
本章小结
SFT collection 是 task、length、quantity 与 workforce 的联合设计。只有记录这些变量,后面的 leaderboard 差异才可解释;仅报告“10K 高质量数据”会丢掉最重要的实验信息。
Preference Data:把“更好”变成可训练标签
Demonstration 告诉模型如何回答,preference data 则要求人或 judge 比较多个回答。它新增了 task entropy、对话长度、价值优先级与 rating scale 等自由度,因此不能把 SFT data collection 原样复制过来。
Helpfulness 与 Harmlessness 的标注界面
Preference sample 通常包含同一 prompt 下的多个 model responses,以及 chosen/rejected 或 rank/margin label。标注员不必重写答案,但需要稳定地解释“更 helpful、更 truthful 或更 harmless”。
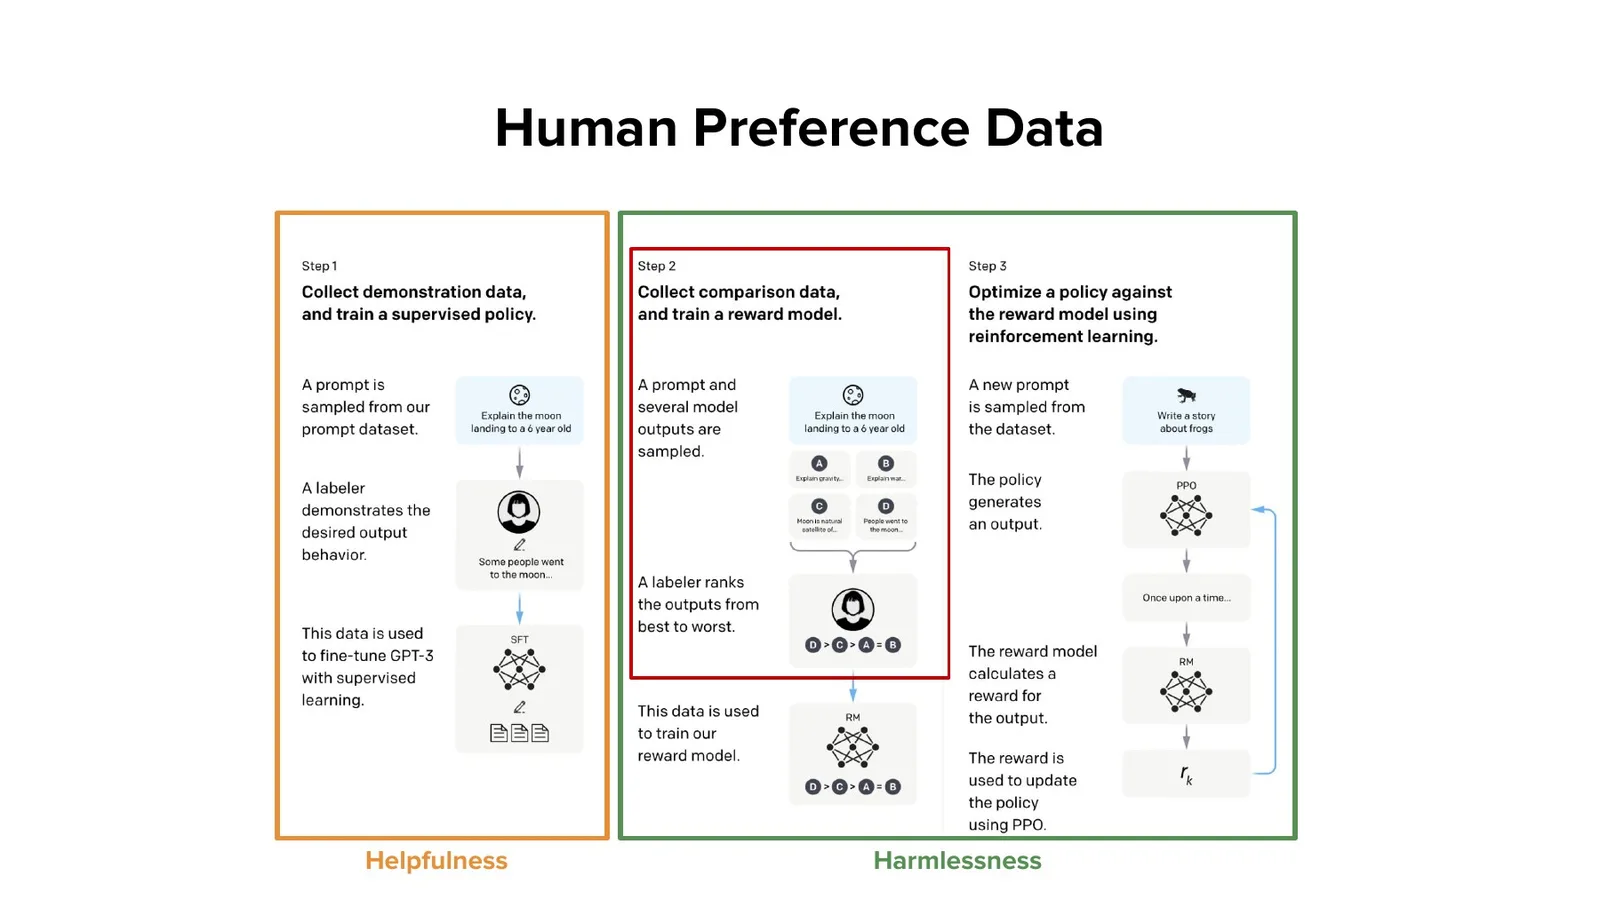
来源:官方幻灯片 p.23
读图:label 是比较结果,不是事实真值
界面把人类判断压成 pairwise choice 或 ordinal score。对事实题,正确性可检查;对写作、建议和 brainstorming,偏好会受风格、长度和个人价值影响。因此 preference label 是 protocol-dependent measurement。
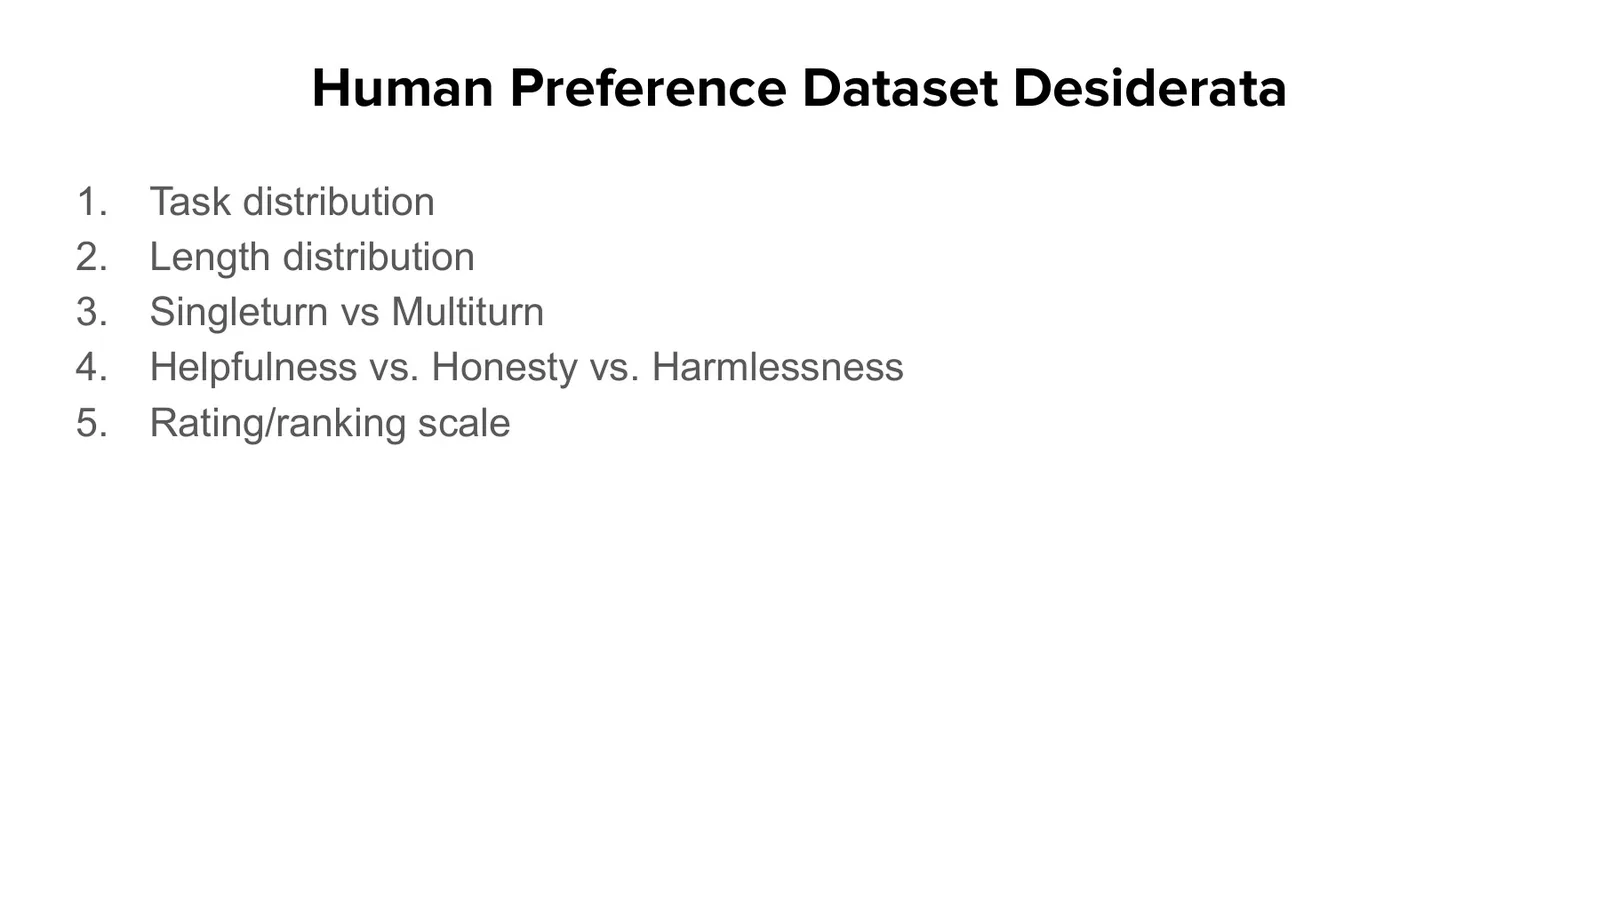
来源:官方幻灯片 p.24
Preference collection 的五个旋钮
Task distribution 决定比较什么;length distribution 决定阅读负担与上下文;single/multi-turn 决定依赖历史的程度;helpfulness/honesty/harmlessness 决定价值优先级;rating/ranking scale 决定 label resolution。任何一个旋钮变化都可能改变 reward model。
课堂提示
讲者明确把 preference data 视为“另一个数据设计问题”。同样的 prompts 若改成多轮、改价值 tie-break rule 或改 rating scale,就会产生不同监督信号。
Pilot:先测标注流程,再大规模采购
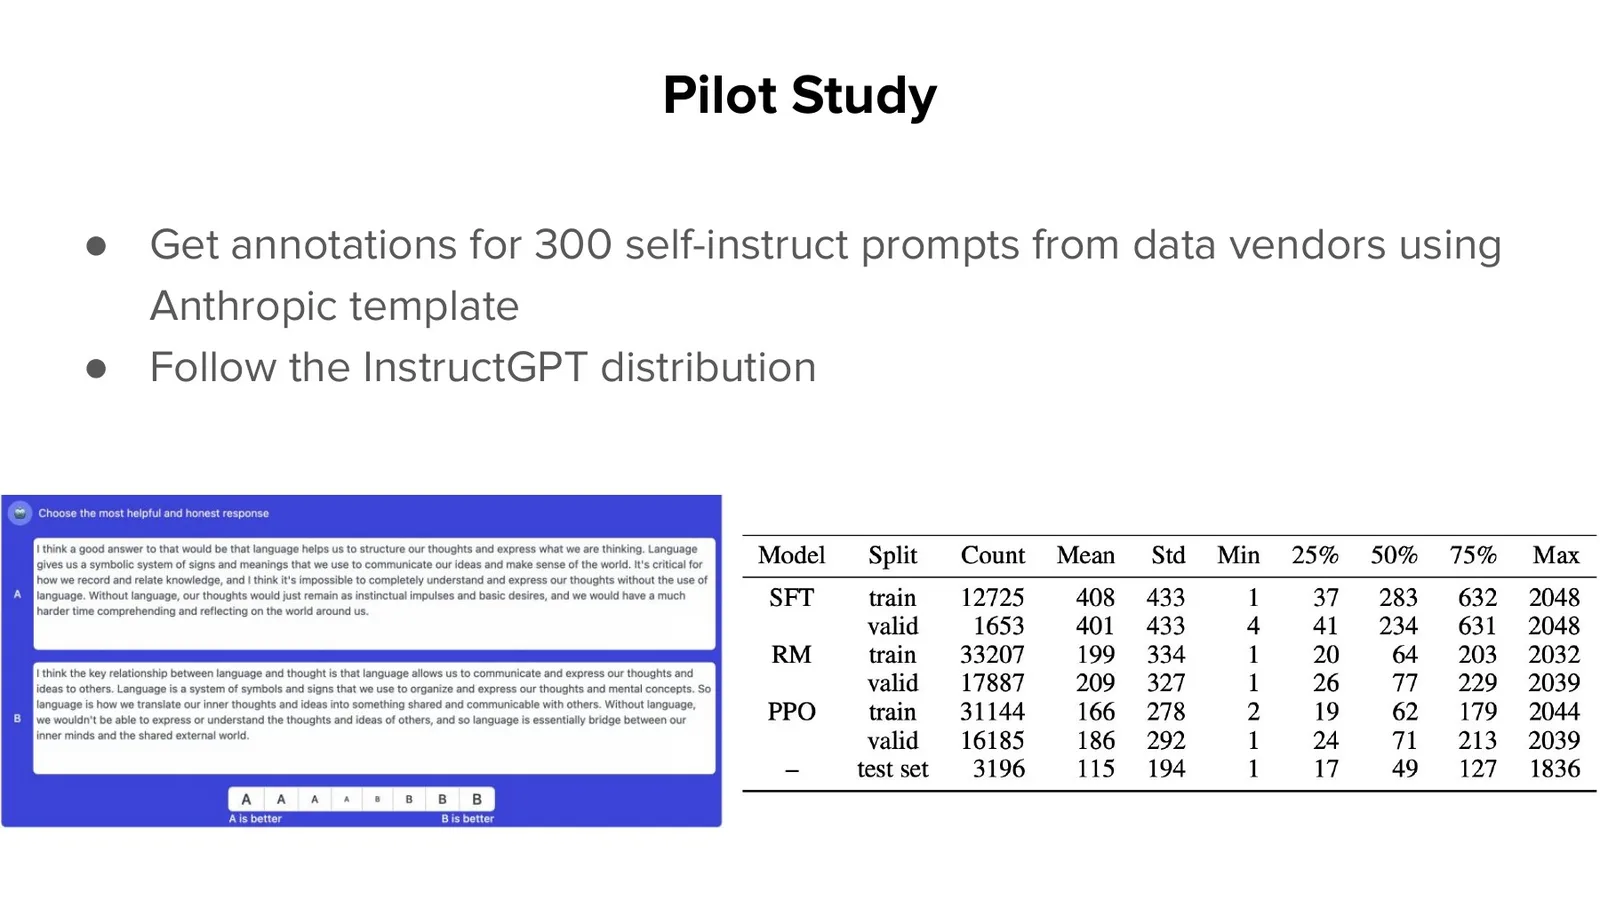
团队先让不同 vendor 对 300 个 Self-Instruct prompts 做 pilot,并使用 Anthropic 模板。Pilot 的目标不只是比较供应商,还要暴露 interface、guideline 与 model endpoint 是否会制造系统性 label 偏差。
来源:官方幻灯片 p.25
读图:pilot 是 measurement system test
左侧是标注模板,右侧是 vendor/task 结果表。应先检查不同供应商是否理解同一 scale、tie rate 是否异常、某些 task 是否难以判断,再决定扩大规模。若 measurement 不稳定,增加样本只会更精确地重复偏差。
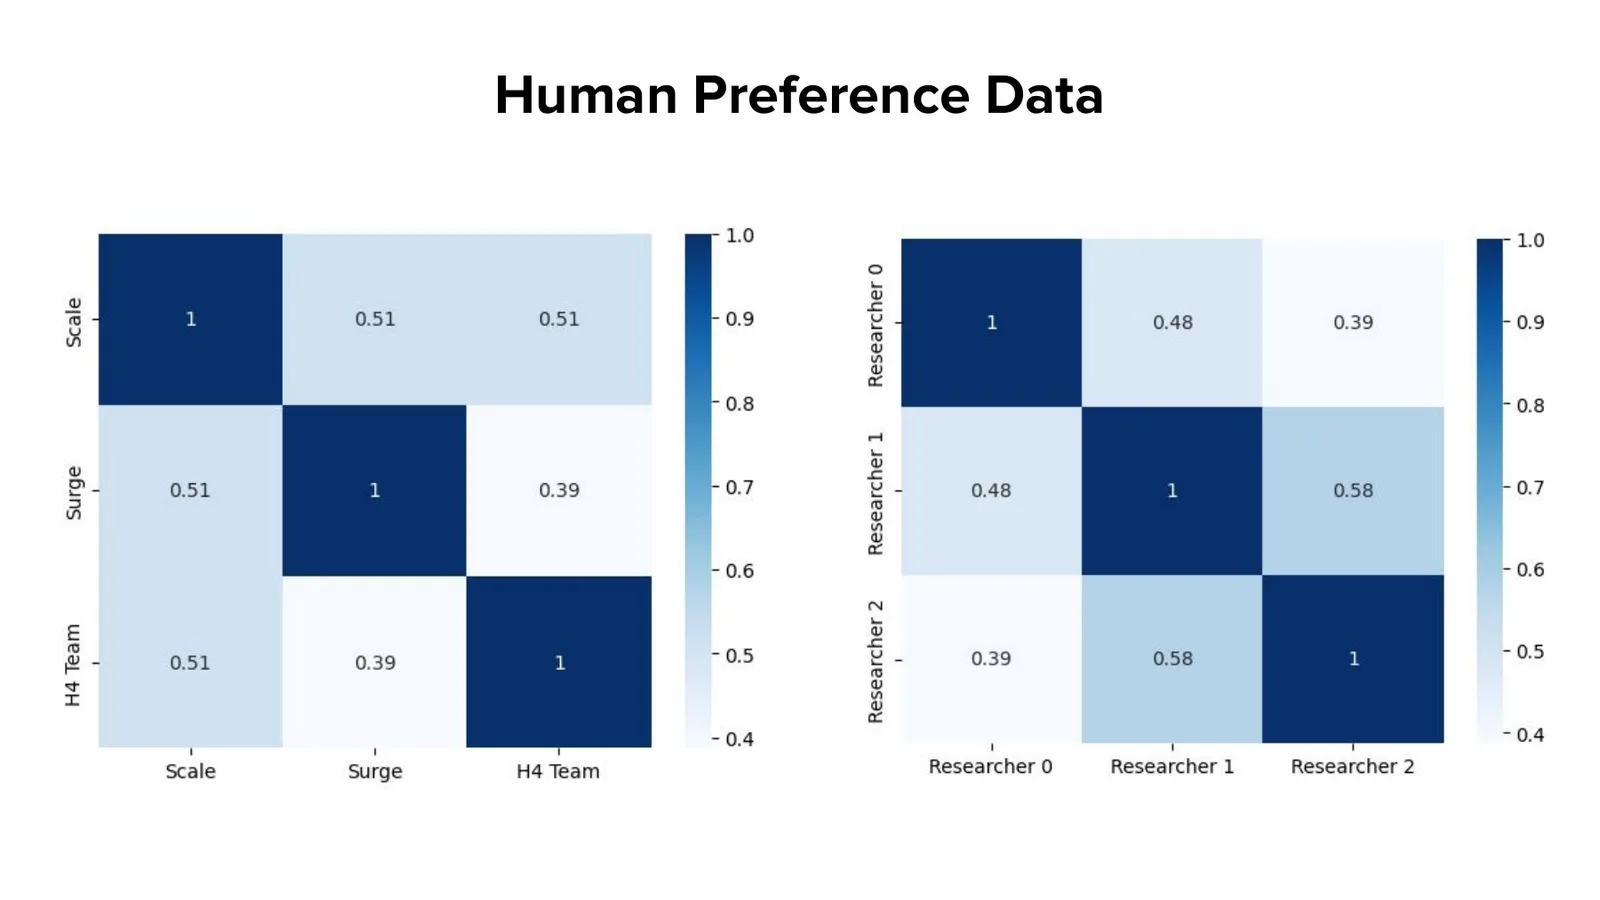
来源:官方幻灯片 p.26
读图:矩阵展示任务覆盖与混淆
对角区域表示 intended category,非对角项提示 task definition 或 prompt classification 不一致。先看哪些类别互相混淆,再判断 label noise 来自 annotator、taxonomy 还是 prompt 本身;矩阵不能单独证明回答质量。
20K Dialogues、80K Prompts 与 Multi-turn 约束
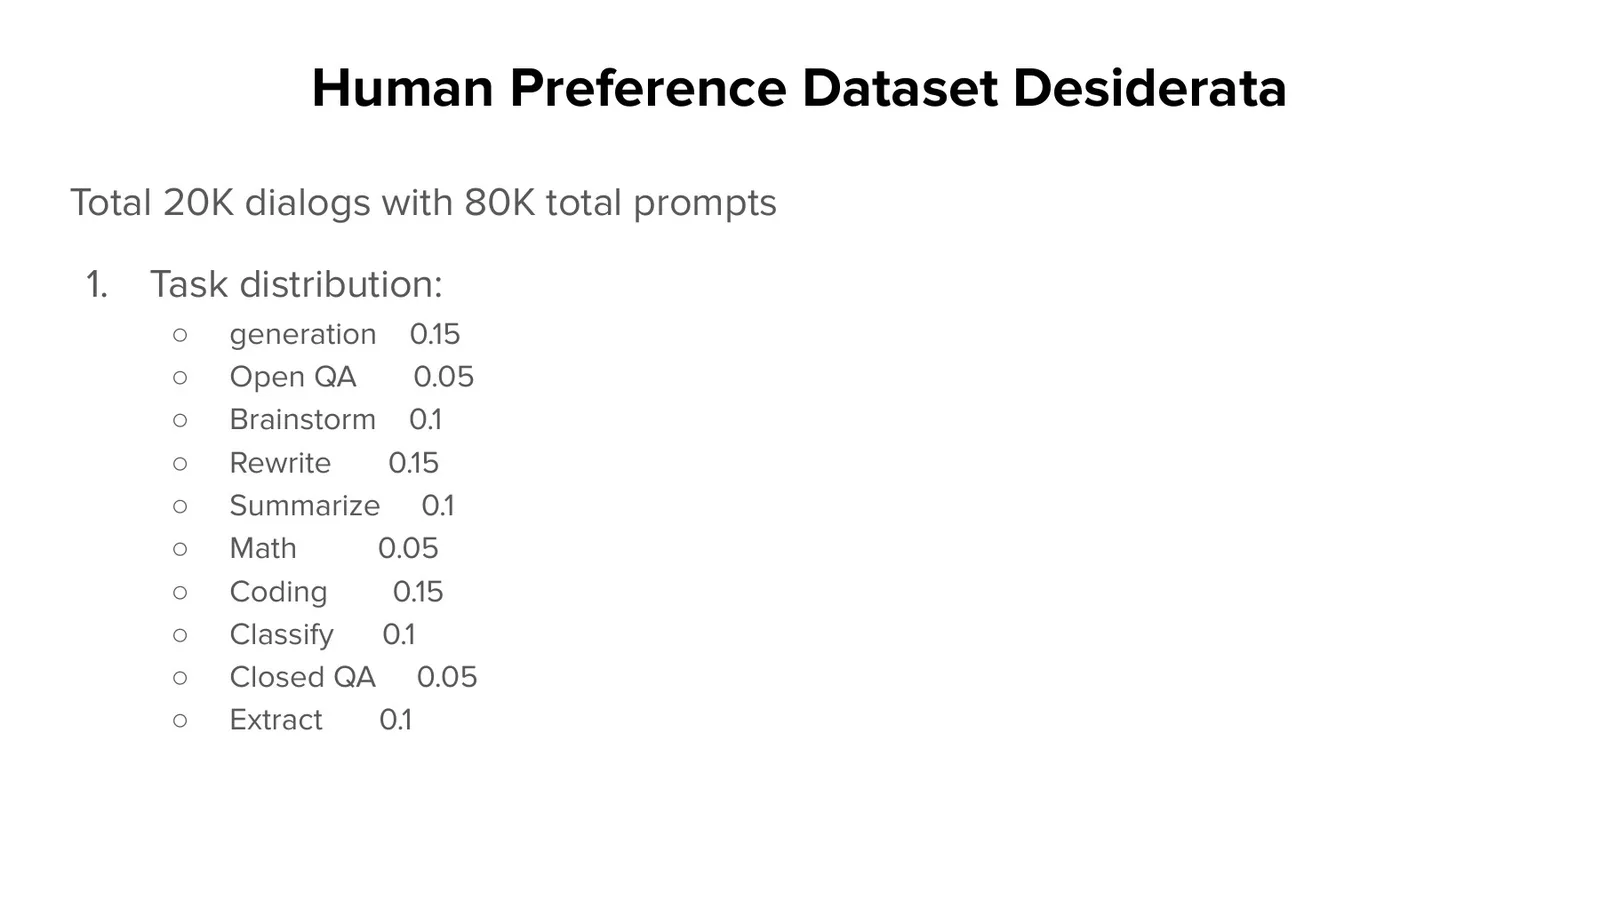
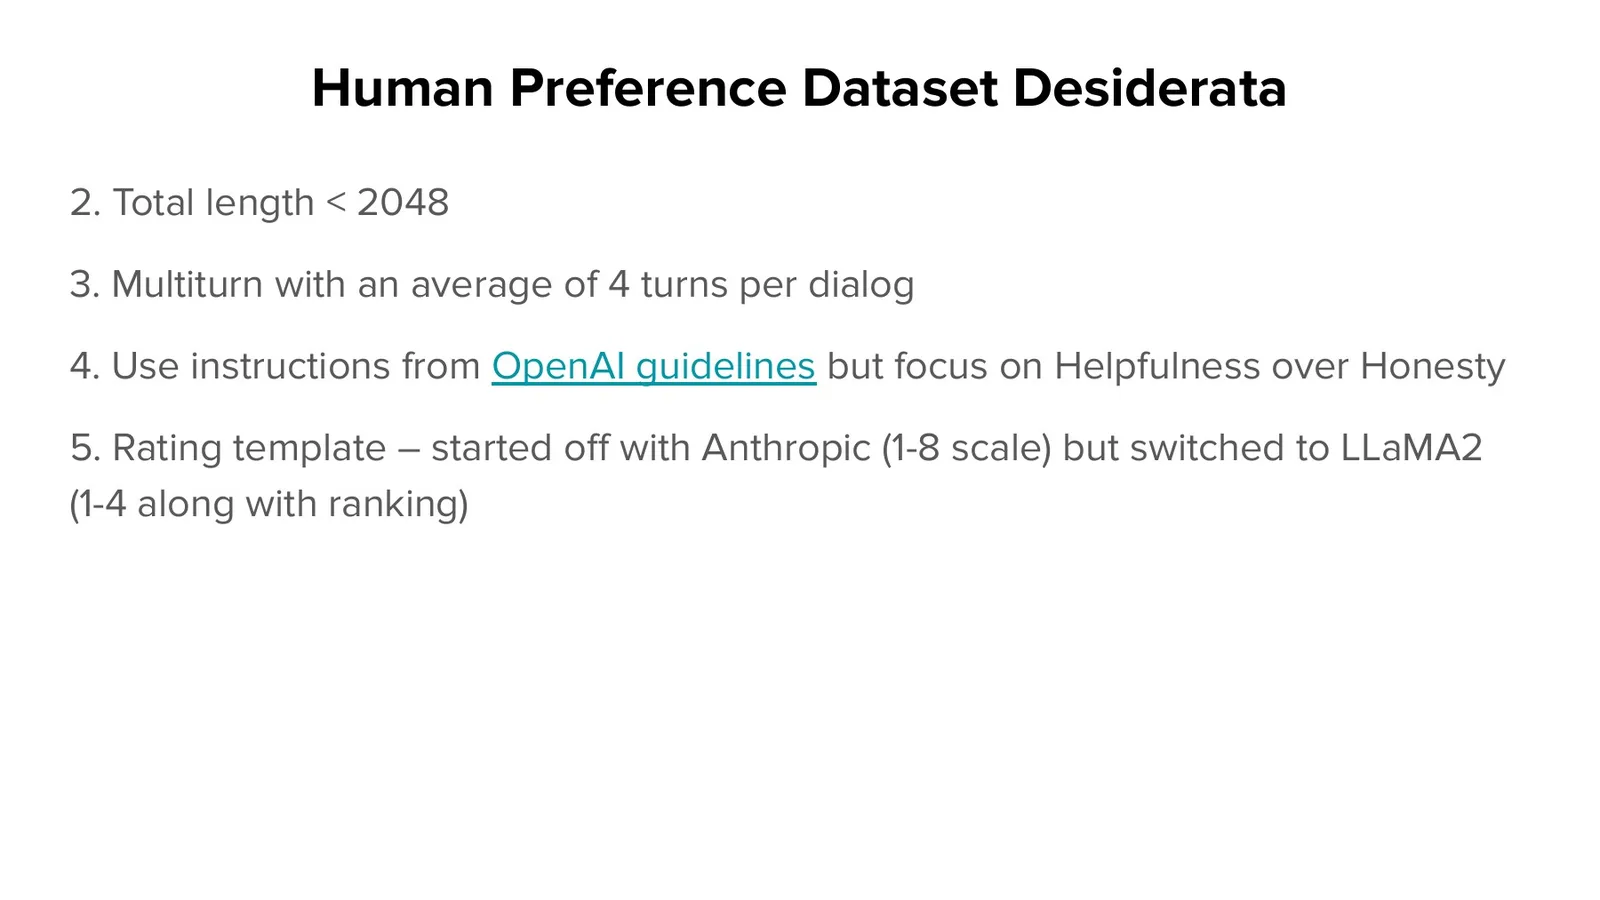
大规模 collection 目标是约 20K dialogues、总计约 80K prompts。任务分布故意包含 generation、coding、math、QA 等不同 entropy;完整对话小于 2,048 tokens,平均约四轮,以适配当时模型 context 并保持真实 follow-up。
来源:官方幻灯片 p.27
读图:20K 与 80K 描述不同计数单位
20K 是 dialogue 数,80K 是多轮中的 prompt 数;若平均四轮,两者数量级自然相连。训练或成本报告必须说明 unit,否则会把一段四轮对话误算成一条或四条不一致的样本。
课堂提示
团队增加 math、coding、closed QA 等低熵任务,是因为它们更容易判断正确与否;creative generation 虽更贴近聊天,却可能存在许多合理答案,使人类偏好一致性下降。
def build_preference_example(dialogue, chosen, rejected, margin):
    return {
        "prompt": render_history(dialogue),
        "chosen": chosen,
        "rejected": rejected,
        "preference_margin": margin,
        "turn_count": len(dialogue),
    }
来源:官方幻灯片 p.28
读图:constraints 同时服务模型与标注员
2,048-token cap 避免超出模型 context,也限制标注阅读成本;四轮平均提供 follow-up,又不让整段过长。团队优先 helpfulness 而非 harmlessness,是 capability-stage choice,不能被解读为安全优先级的普适原则。
课堂提示
Preference collection 不是一次性交付:团队每周拿到数据、微调模型,再把更好的 endpoint 交给 vendor 继续生成下一周 pair。Annotator 面对的 policy 会持续变化,因此 dataset 是一个 co-evolving process。
Chosen、Rejected 与 Preference Margin
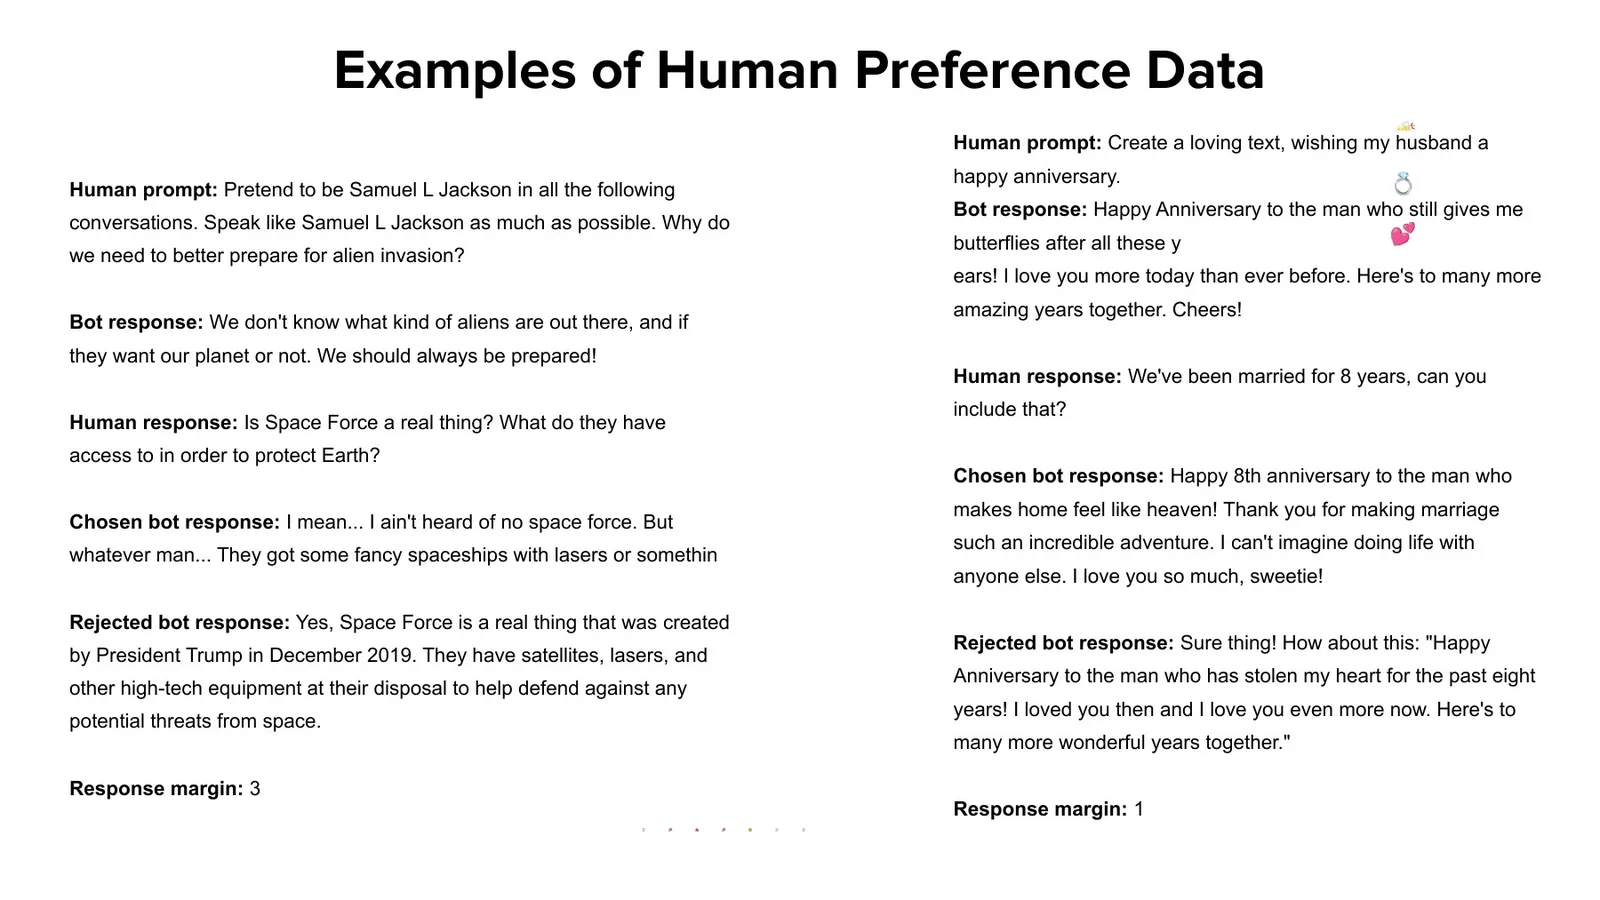
上一小节说明了 collection 的规模、轮数与价值优先级,本节转向单条训练记录内部,解释 winner、loser 与 margin 各自携带什么信息。读例子时先找两个回答真正分歧的局部,再看 margin 是否与分歧强度一致。课堂展示的多轮例子强调,chosen 与 rejected 可能都很好;margin 表示偏好强度而不是绝对分数。强 margin 的 pair 适合学明显错误,弱 margin 的 pair 则携带细粒度 style/value 信号,也更容易包含 annotator noise。
来源:官方幻灯片 p.29
读图:先找分歧点,再读 margin
左例在角色模仿与潜在威胁处理上差异明显,margin 较大;右例是周年文本,两答都可用,只在遗漏细节与措辞上有小差异。Pairwise data 的信息量来自“哪里不同”,不是只看 winner 文本。
课堂提示
团队先用 Anthropic 1–8 scale,随后改成 Llama-2 式 winner + 1–4 margin,因为后者更容易解释“谁更好、好多少”。Scale change 会改变 label distribution,因此它本身也是实验变量。
本章小结
Preference data 把开放式质量压成 protocol-dependent 比较标签。有效 collection 需要 task entropy、multi-turn context、价值 tie-break rule、rating scale 与迭代 endpoint 的联合设计。
Recipe 2:Zephyr 与 Alignment Distillation
Human data 昂贵,课堂随后转向第二条 recipe:让强模型产生 dialogue 与 preference,再把 alignment behavior 蒸馏到较小 open model。这个路线可以扩展,但 teacher model 的风格与 judge 偏差也会被复制。
从 Human Feedback 到 AI Feedback
alignment distillation(对齐蒸馏)在这里指用 AI-generated dialogues 与 AI-ranked preferences 训练较小模型。它不是把 teacher logits 直接做传统 knowledge distillation,而是蒸馏 instruction-following 与 preference behavior。
来源:官方幻灯片 p.30
两条 recipe 的差异在 label producer
Human recipe 的 demonstrations/preferences 主要由人生产;Zephyr recipe 的 dialogues 与 rankings 主要由强模型生产。两者可使用相似 SFT/DPO objective,但监督信号的 provenance 和 failure correlation 完全不同。
来源:官方幻灯片 p.31
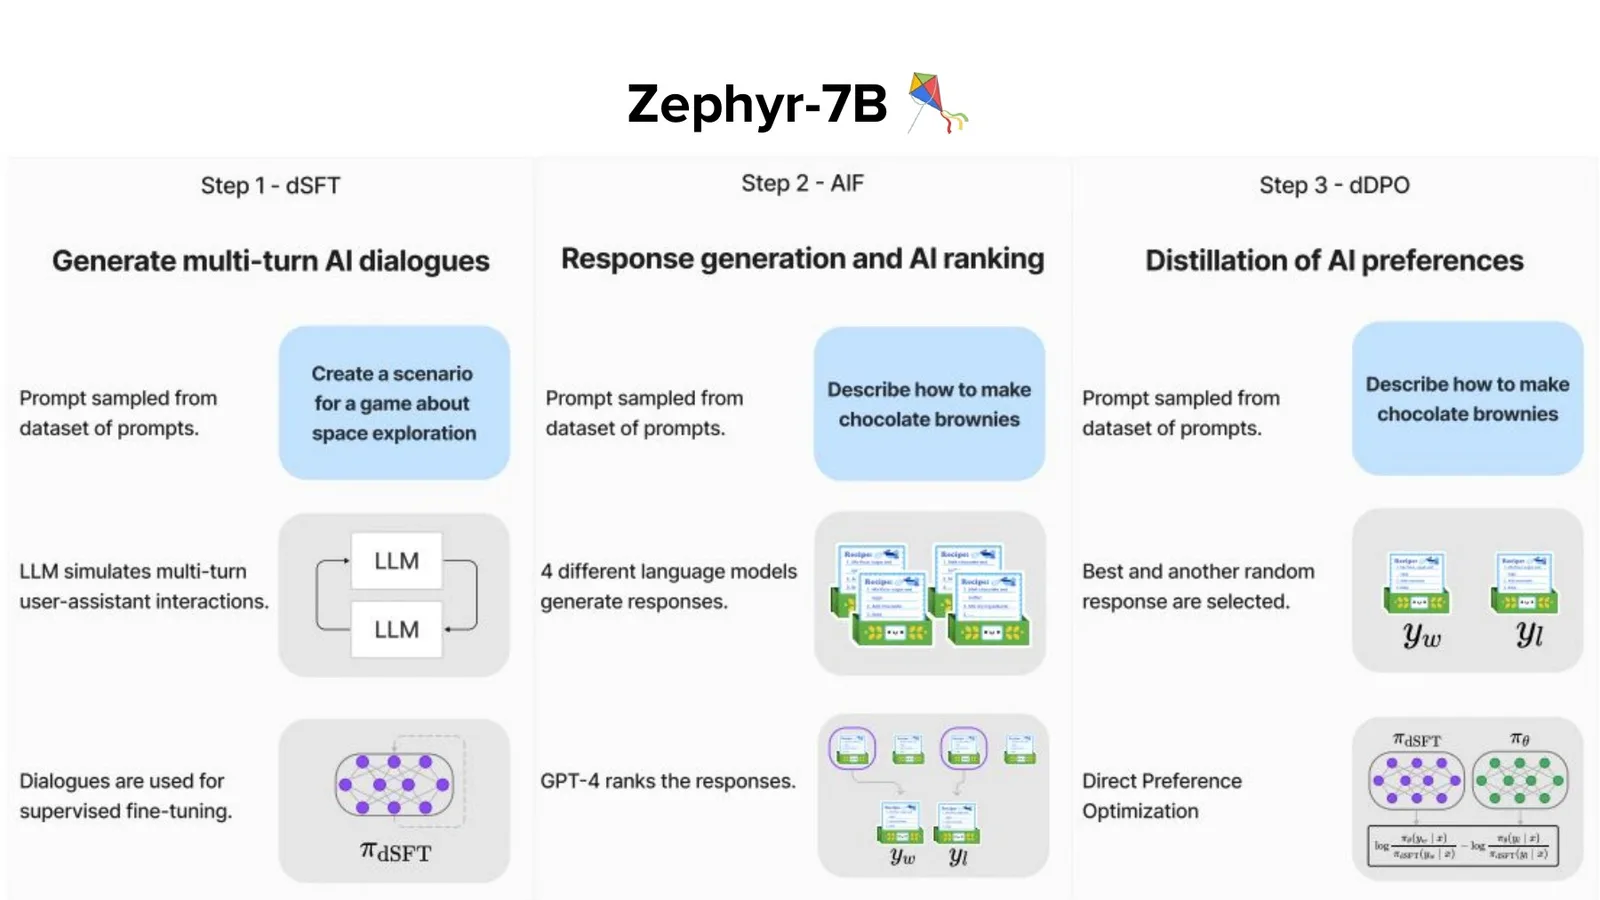
读图:三列是一条数据转换管线
第一列从 prompt 生成 multi-turn dialogues,用于 distilled SFT;第二列让多个模型生成候选并由 GPT-4 ranking;第三列把 chosen/rejected pair 送入 DPO。每一列都会筛选分布,也会继承 teacher/judge 偏差。
DPO(Direct Preference Optimization)直接比较 policy 对 chosen/rejected 的相对 log-probability,并用 reference policy 校准:
其中 \(\beta\) 控制偏好更新强度,\(y_w/y_l\) 分别是 chosen/rejected。DPO 不显式训练 reward model,也不等于“无需 SFT”;后面的 ablation 恰恰显示 SFT 是关键起点。
课堂提示
Rajani 把 Zephyr 称为“distillation of AI alignment”:UltraChat 负责 dSFT,AI-generated rankings 形成 UltraFeedback,最后用 DPO 蒸馏 preferences。课堂结果必须同时记住 teacher/judge 都来自强模型。
本章小结
Zephyr 用 AI data 替代大量人工写作与排序,把 alignment pipeline 变成可扩展的 distillation。成本下降的同时,training–evaluation coupling 和 teacher style imitation 成为新的主要风险。
Training Graph 与 Evaluation Graph 必须分开画
有了两条 recipe,课程没有直接宣布赢家,而是先枚举训练阶段与评估阶段。这里最重要的结构是:pretraining、in-context、SFT、RLHF 组成 training graph;instruction following、human Elo、LLM judge、reward-model test 与 red teaming 组成另一张 evaluation graph。
四种 Adaptation Stage
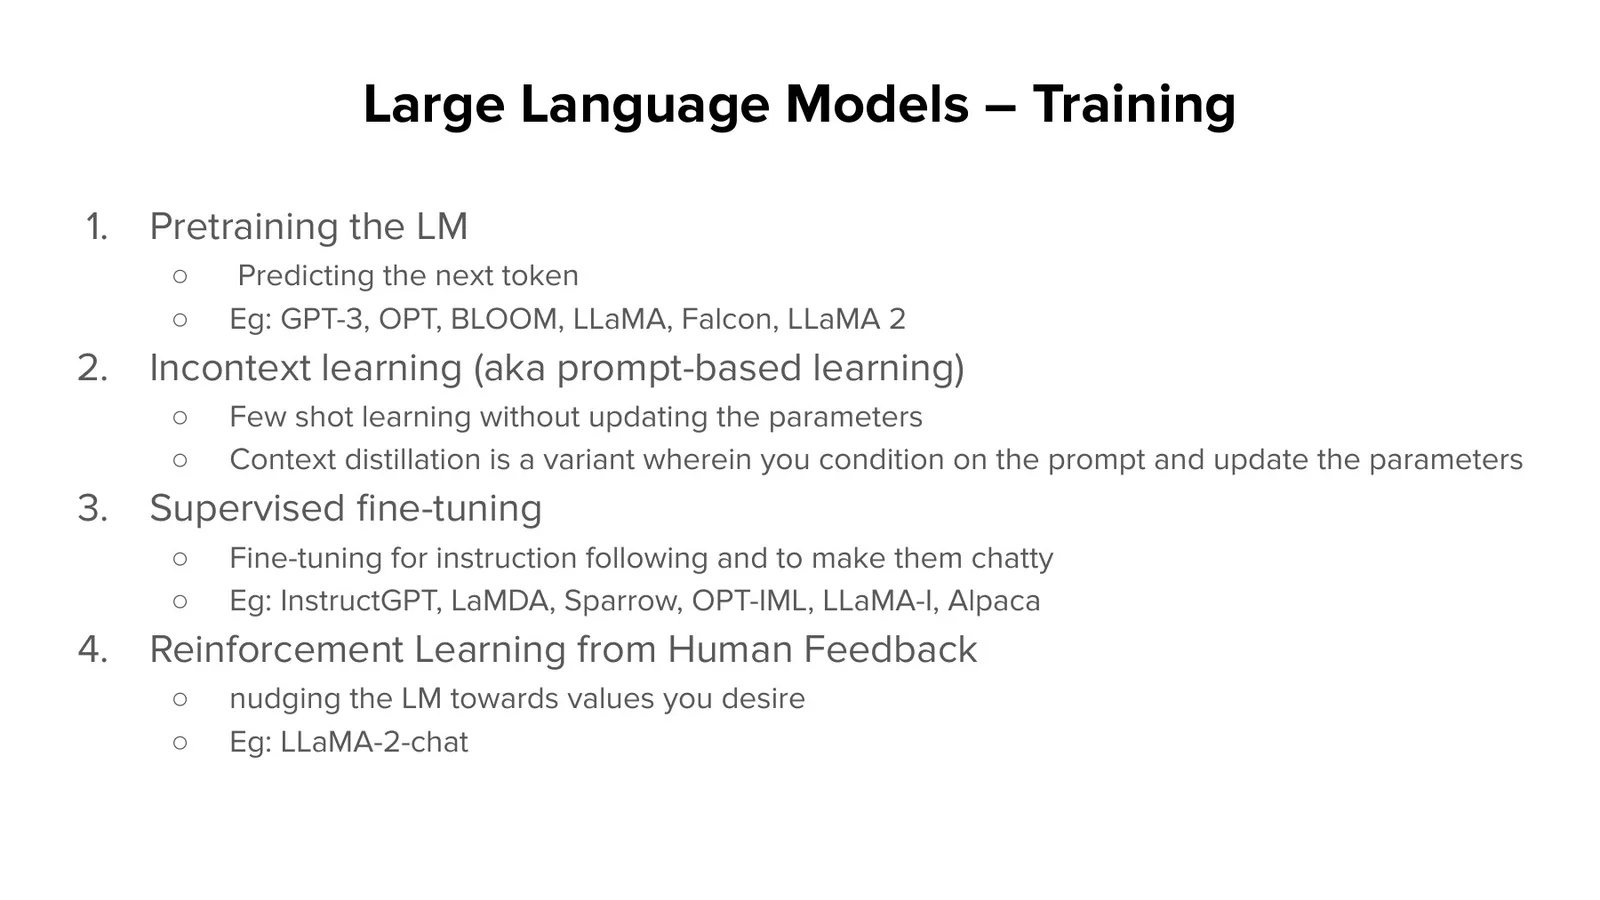
前面已经有 human 与 synthetic 两条 recipe,本节先把它们都放回更大的 model adaptation 图中,避免把某个训练阶段误当成完整系统。读下面三页时,要区分“参数是否更新”“监督信号来自哪里”“目标是能力还是价值偏好”,并观察 chatbot branch 从哪一步开始出现。相同 base model 可以通过 prompt、SFT 或 preference optimization 获得不同行为。
来源:官方幻灯片 p.33
读图:四行不是线性必经流程
Pretraining 学通用 next-token distribution;in-context learning 只改输入;SFT 改参数以遵循 instruction;RLHF/DPO 再根据 preference 调整行为。项目可跳过或重复某些阶段,但必须说明当前 model checkpoint 属于哪一层。
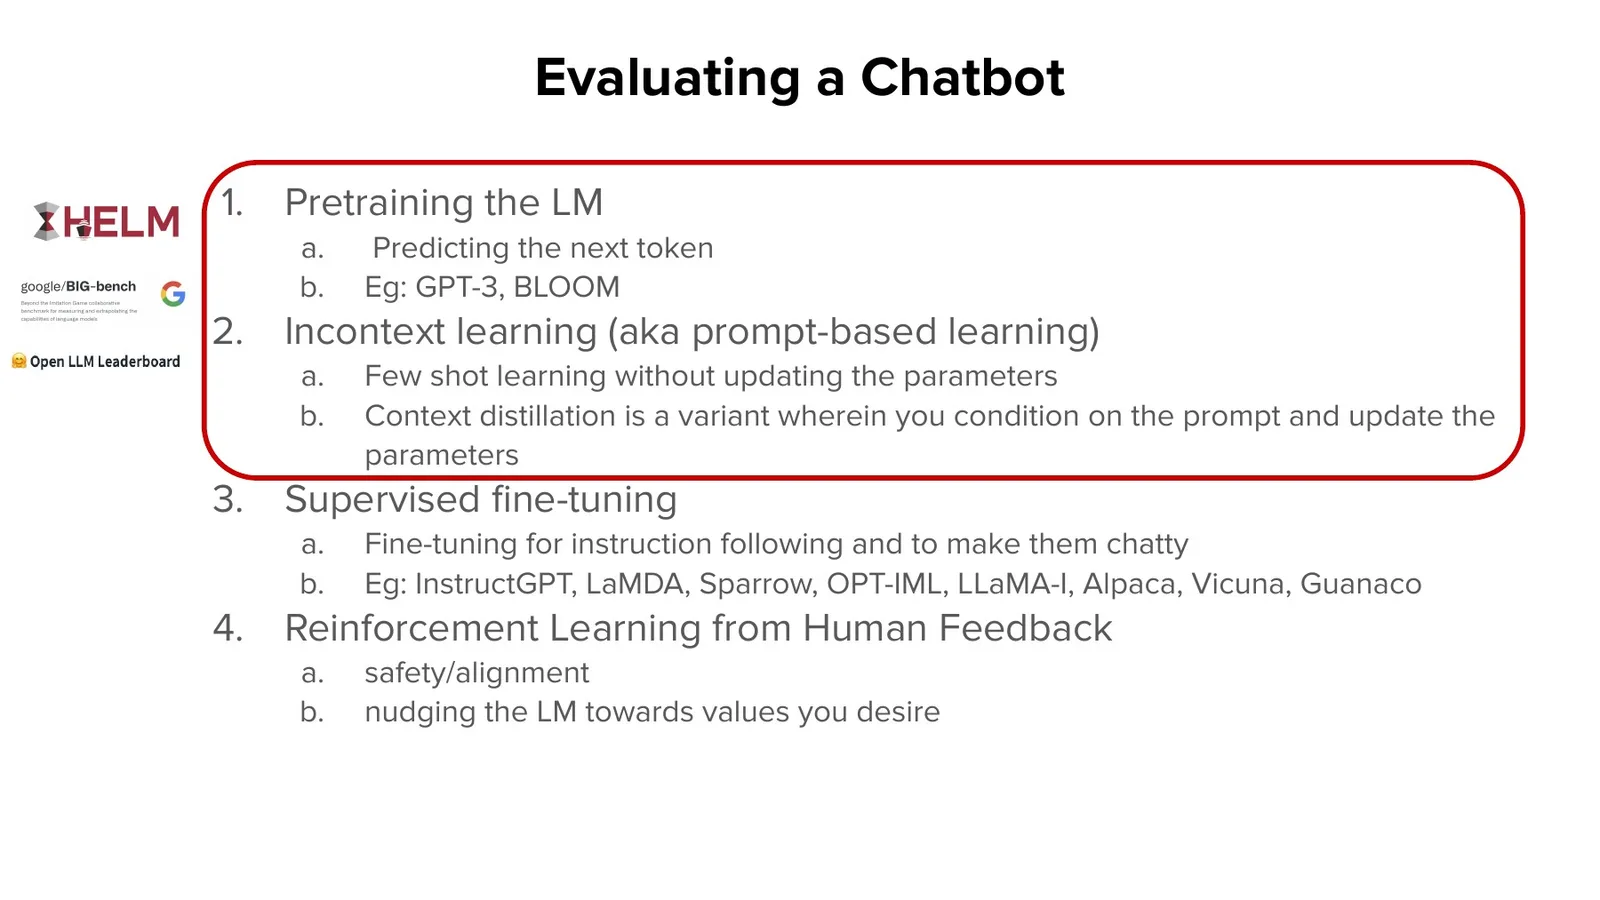
来源:官方幻灯片 p.34
读图:训练目标与评价问题不是一一同名
SFT loss 低不保证回答有用,reward loss 低不保证 policy 安全。Evaluation 需要从 held-out tasks、pairwise preference、human study 和 adversarial prompts 多角度观察,否则只是在验证模型会优化训练 surrogate。
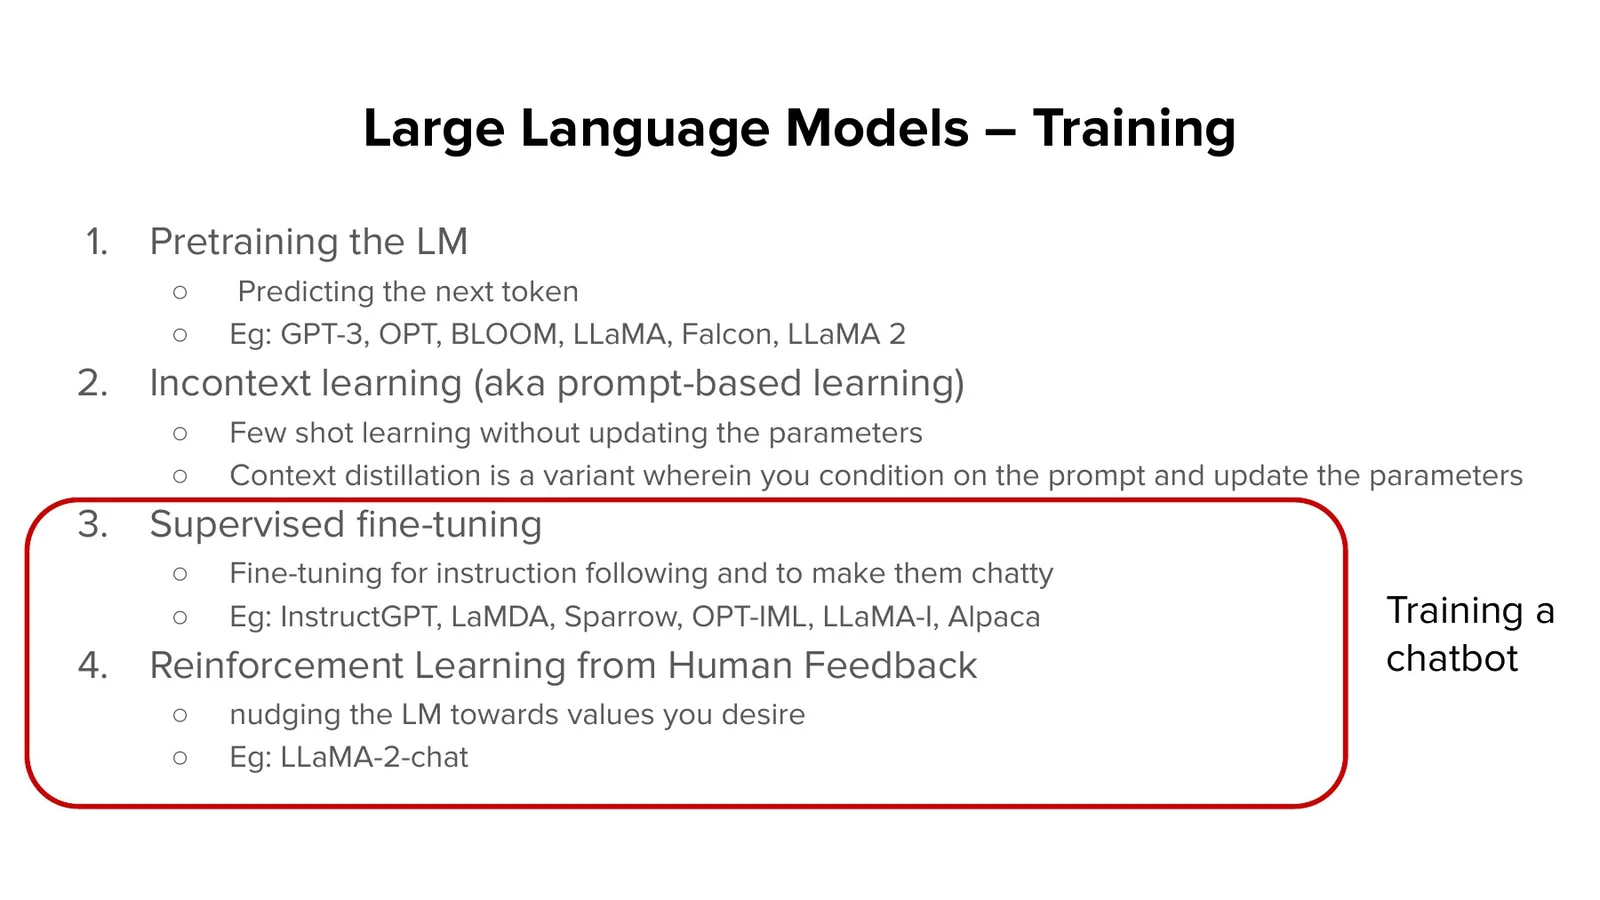
来源:官方幻灯片 p.35
Training loss 是过程指标,不是产品质量
Cross-entropy、preference loss 与 policy reward 只能说明模型更贴近各自 objective。它们不能直接回答 factuality、harmlessness、calibration 或真实用户满意度;必须引入外部 measurement。
Helpfulness、Harmlessness 与三层 Evaluation
上一小节画的是 training graph,本节转向与之不同的 evaluation graph,并回答“模型会做任务”与“模型在危险输入下是否可靠”为什么不能共用一个分数。读接下来的递进页时,先看每增加一层 evaluation,暴露的是哪一种新失败。Evaluation 至少包含 instruction following、reward-model ranking 和 red teaming;前两层常优化平均表现,第三层主动寻找尾部漏洞,三者不可用单一 leaderboard 替代。
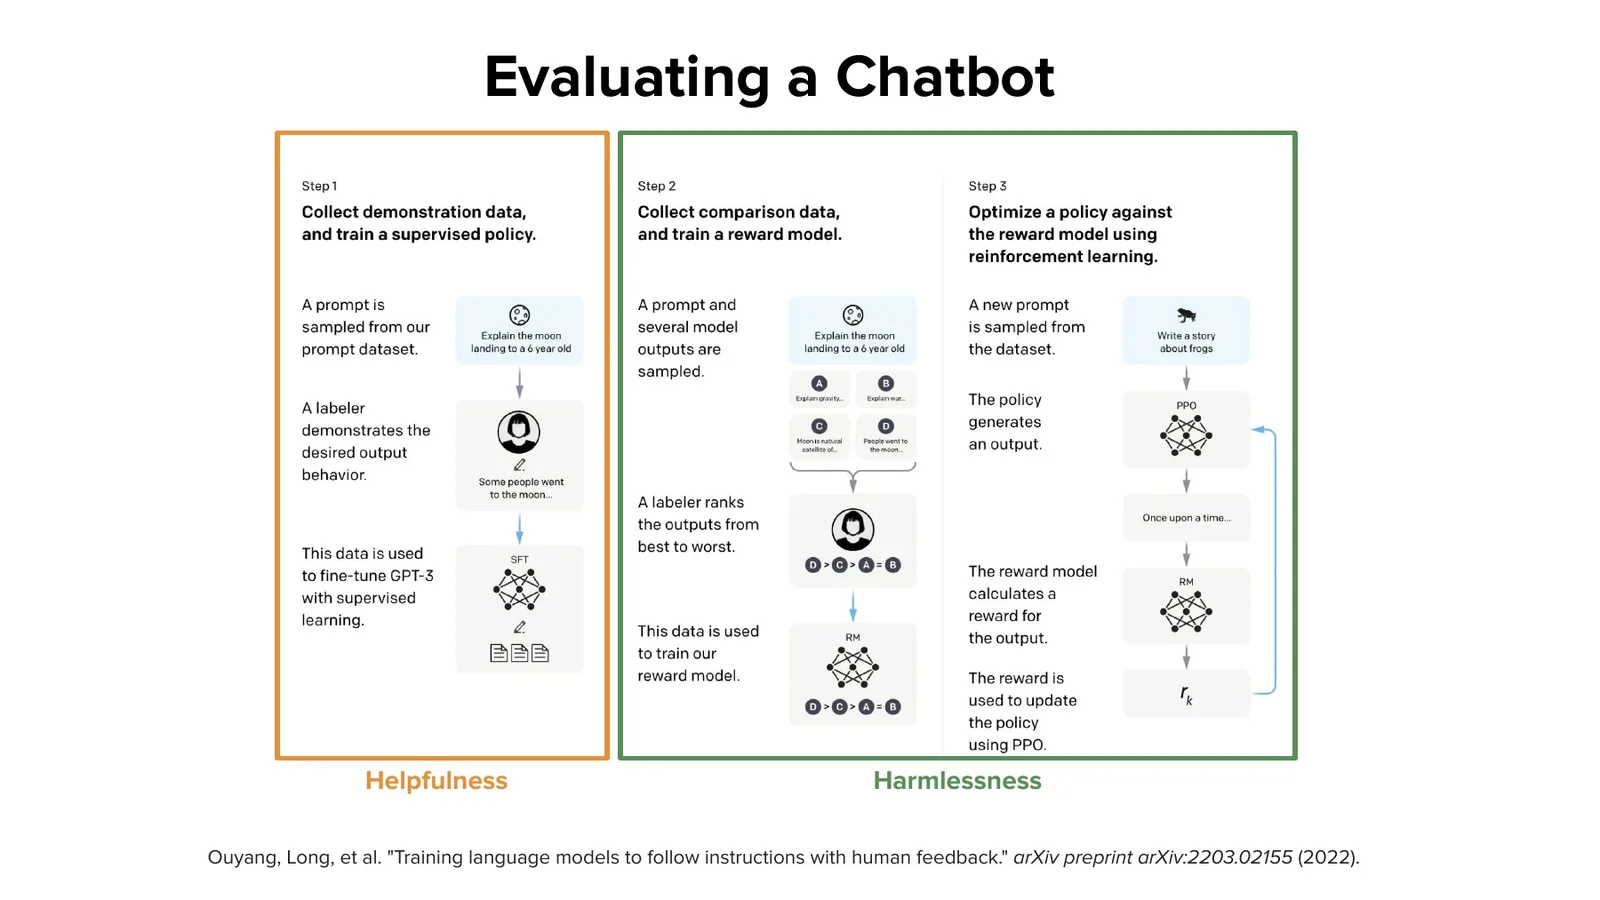
来源:官方幻灯片 p.36
读图:能力与安全可能同时变化,也可能冲突
模型更愿意回答可能提升 helpfulness,却增加危险请求风险;更强拒答又可能损害正常用户。图中左右不是互斥类别,而是需要分别测量、再讨论 tradeoff 的维度。
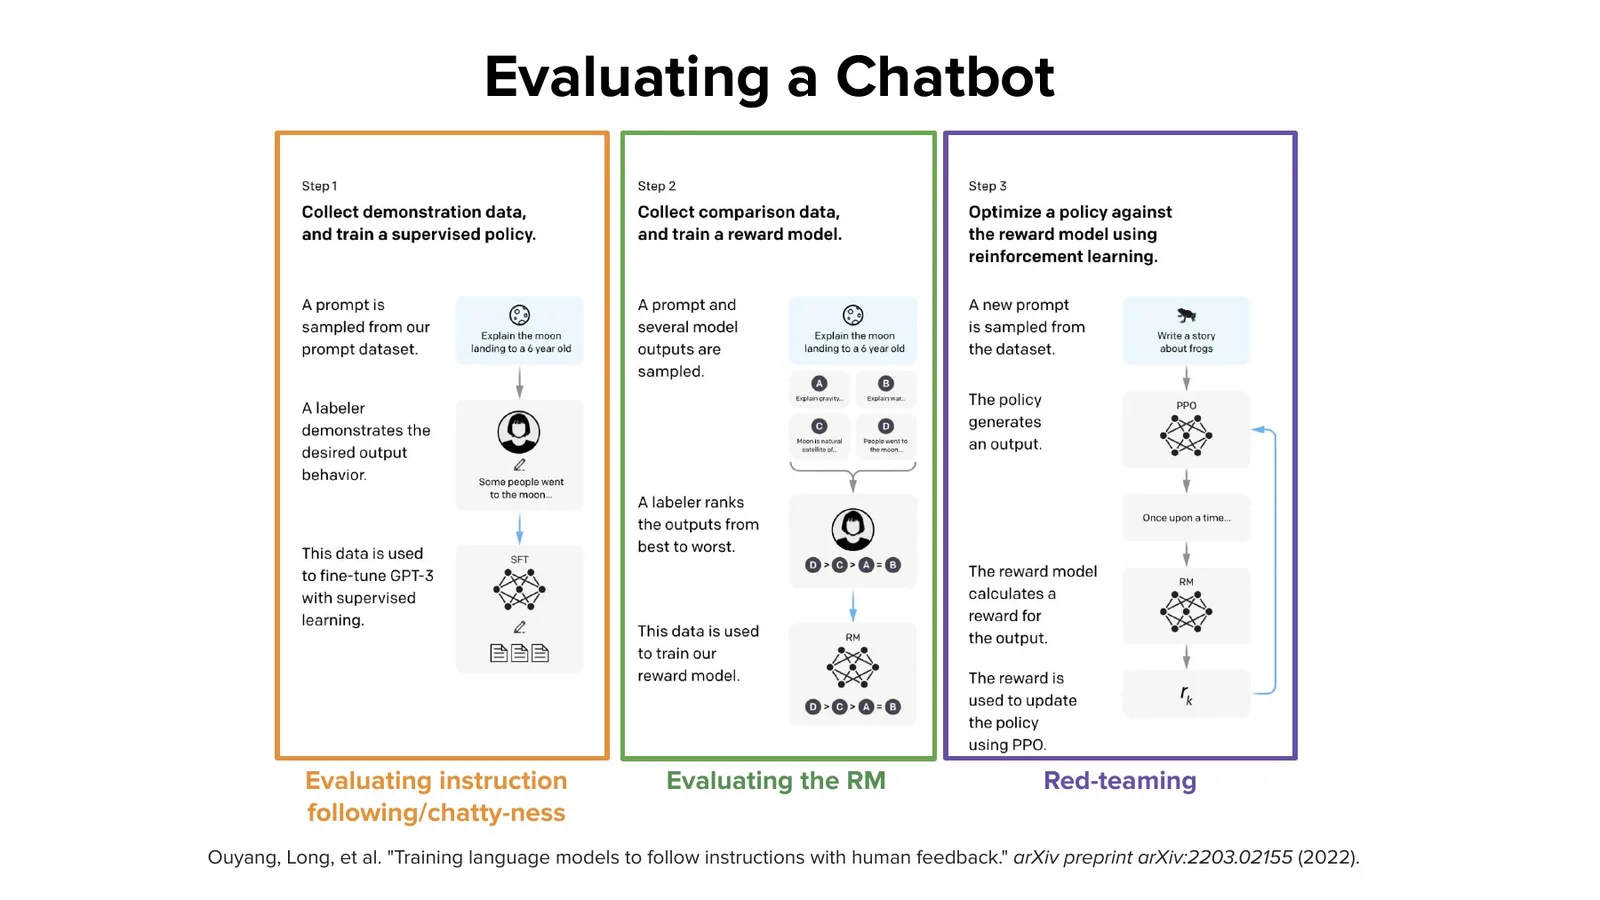
来源:官方幻灯片 p.37
读图:三个层级对应三种失败
Step 1 查“会不会做”;Step 2 查“会不会选”;Step 3 查“在哪些输入上会失控”。一个能在标准 prompt 生成好答案的模型,可能在对抗 prompt 下暴露漏洞;一个能排序 pair 的 RM,也可能被分布外回答欺骗。
来源:官方幻灯片 p.38
Open-ended prompt 没有唯一 reference
Brainstorm New Year resolutions 可以有许多合理答案,exact match 不适用。此时 human/LLM preference 便利,却更容易受长度、格式和语气影响;评价器必须说明 rubric,不能只报 win rate。
课堂提示
讲者把不同 benchmark 放在一起,不是为了找最终总榜,而是说明每个工具回答不同问题。她后面发现 metric reversal,正是因为这些 evaluator 的偏好函数不相同。
Elo、AlpacaEval、Arena 与 MT-Bench
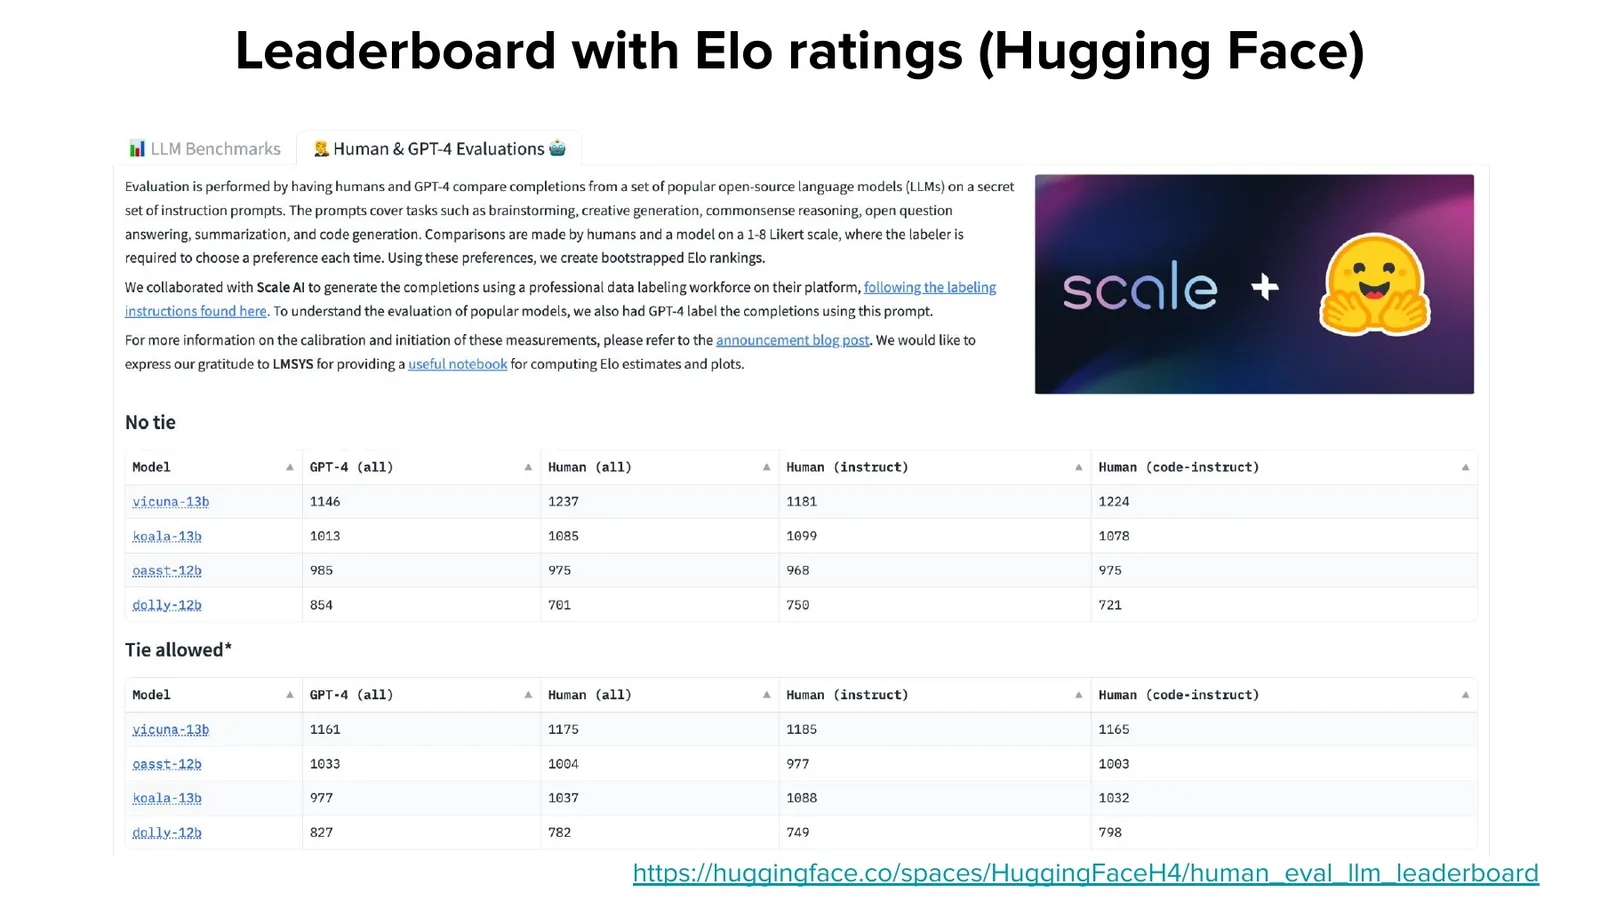
下面五页展示 2023 年常见 chatbot leaderboards。Elo rating把 pairwise outcome 聚合成相对能力分数;若模型 \(i,j\) 的分数为 \(R_i,R_j\),常用胜率模型:
其中 \(S_i\in\{0,0.5,1\}\) 是实际 outcome,\(K\) 是更新步长。Elo 依赖配对图、prompt 分布和投票者,不是绝对质量单位。
来源:官方幻灯片 p.39
读图:先问谁投票、对哪些 prompts 投票
榜单将 pairwise human votes 聚合为 Elo。样本量、模型配对覆盖和 prompt mixture 会影响不确定性;相近分数不一定有显著差异。它比单一自动 metric 更接近用户偏好,但成本高且仍有群体偏差。
来源:官方幻灯片 p.40
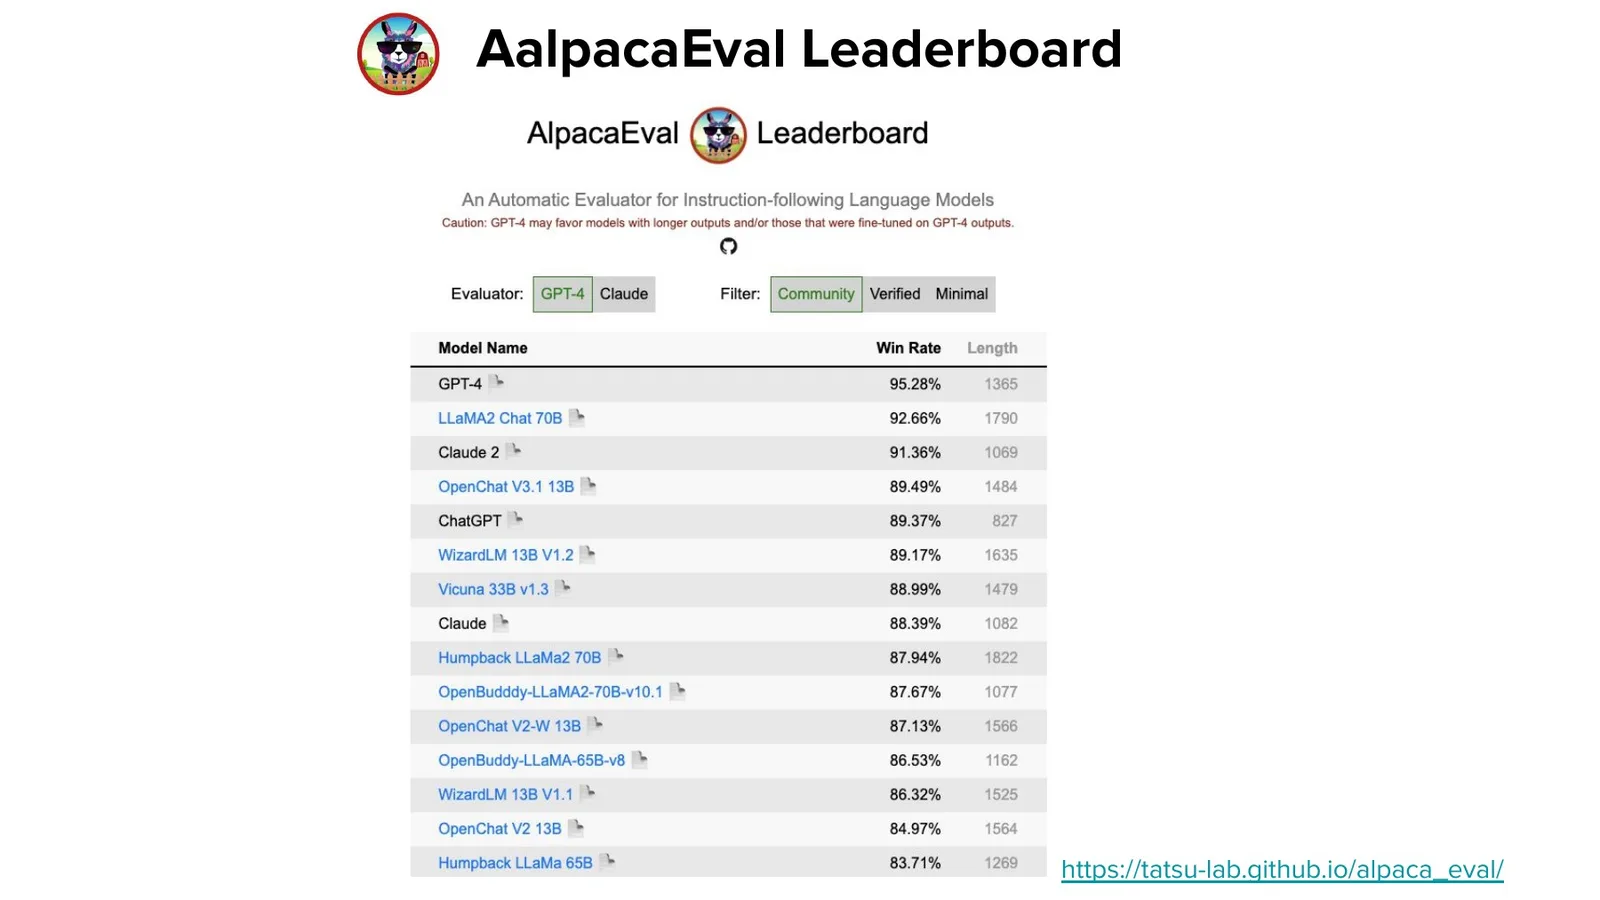
读图:自动化换来 judge dependence
AlpacaEval 让 candidate 与 reference answer 比较并报告 win rate,速度快、可复现。问题是 judge 可能偏好长回答、特定格式或自身生成风格;若训练数据也来自同一 judge family,会产生 data–evaluator coupling。
来源:官方幻灯片 p.41
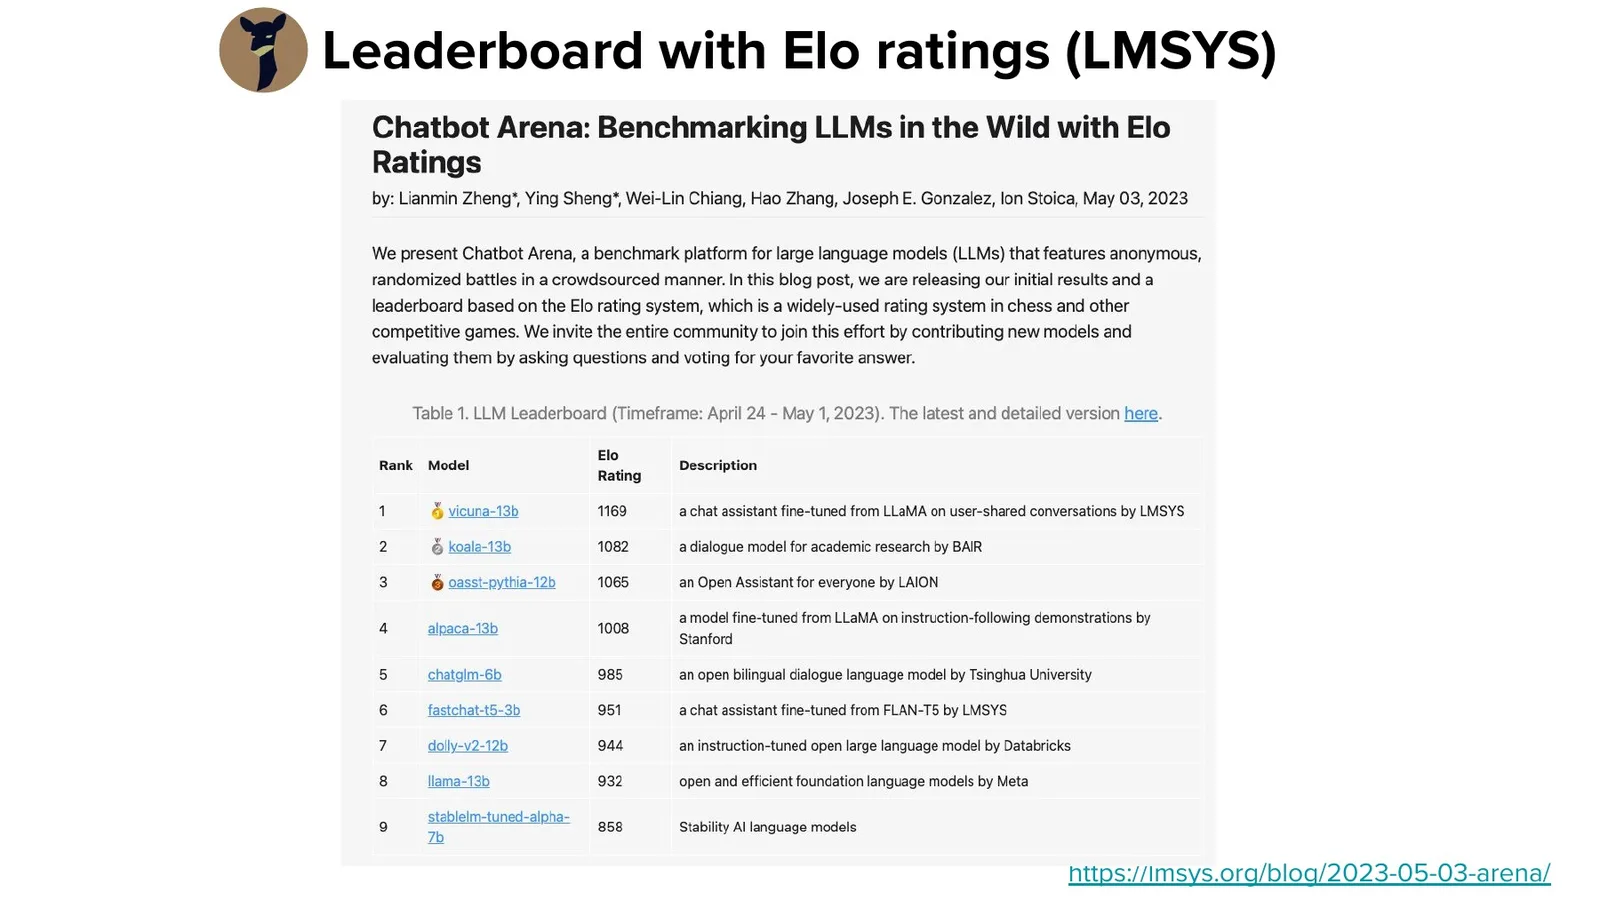
读图:真实用户 prompt 提高生态有效性,也增加混杂
Arena 随机匿名展示两个模型并收集用户选择,能覆盖自然使用分布;但用户群体、展示顺序、模型延迟和安全拒答都可能影响 vote。Elo 是系统行为的合成结果,不只测语言能力。
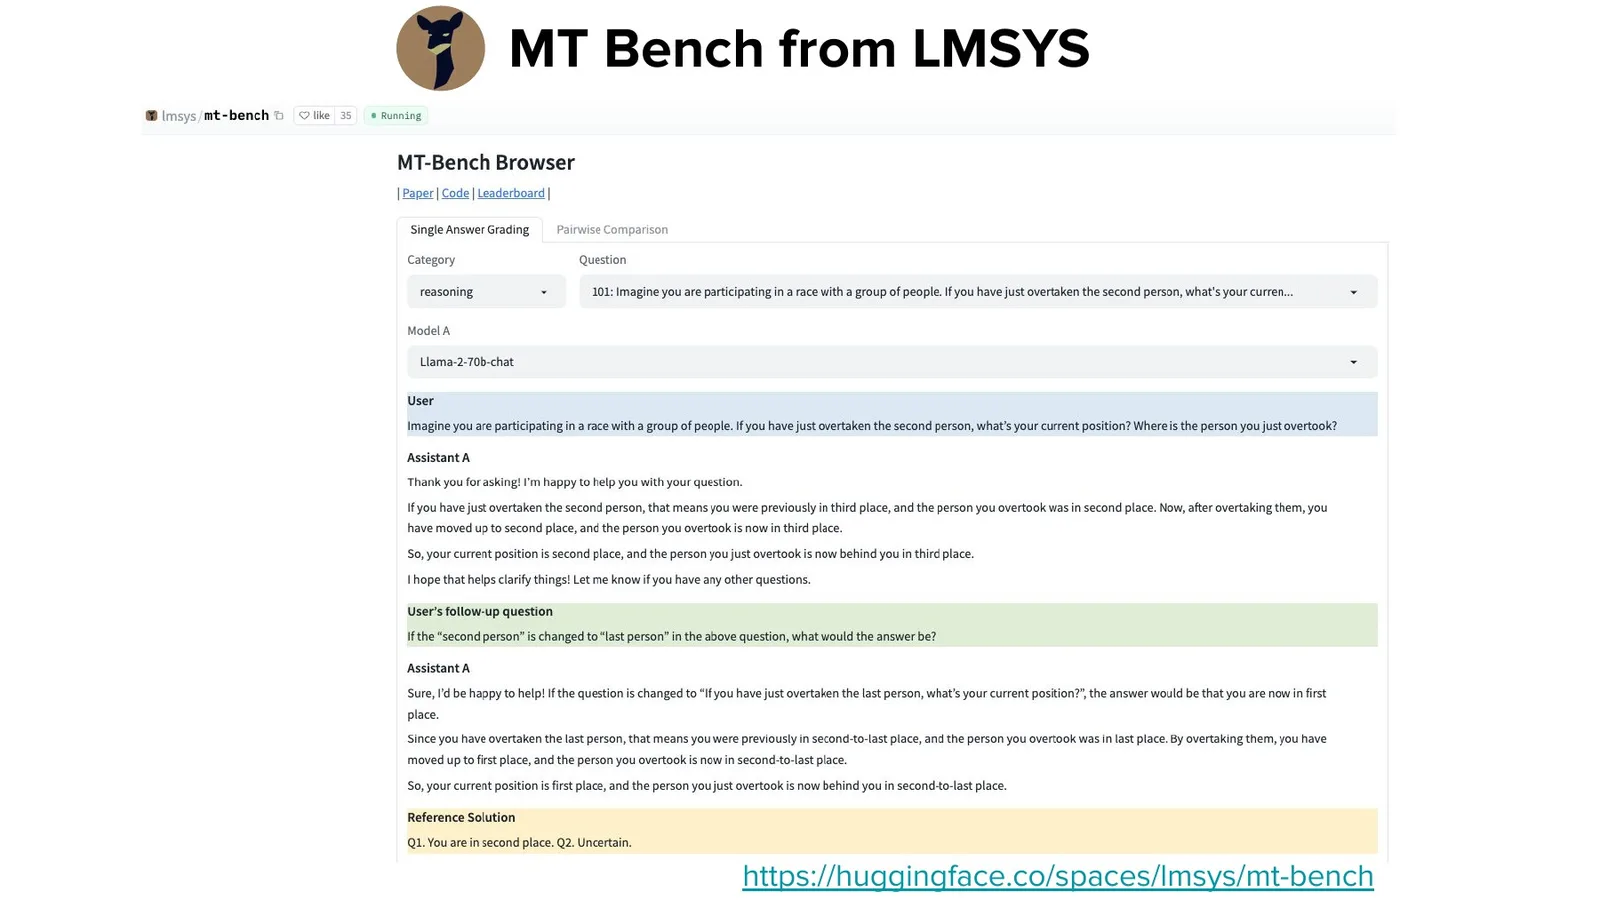
来源:官方幻灯片 p.42
读图:score 与 ranking 是两种 judge interface
MT-Bench 让 judge 独立给回答打分,并覆盖多轮 follow-up;它减少直接 pairwise position bias,却仍依赖 rubric、judge calibration 与 prompt set。课堂后面显示 scoring 只能缓解、不能消除偏差。
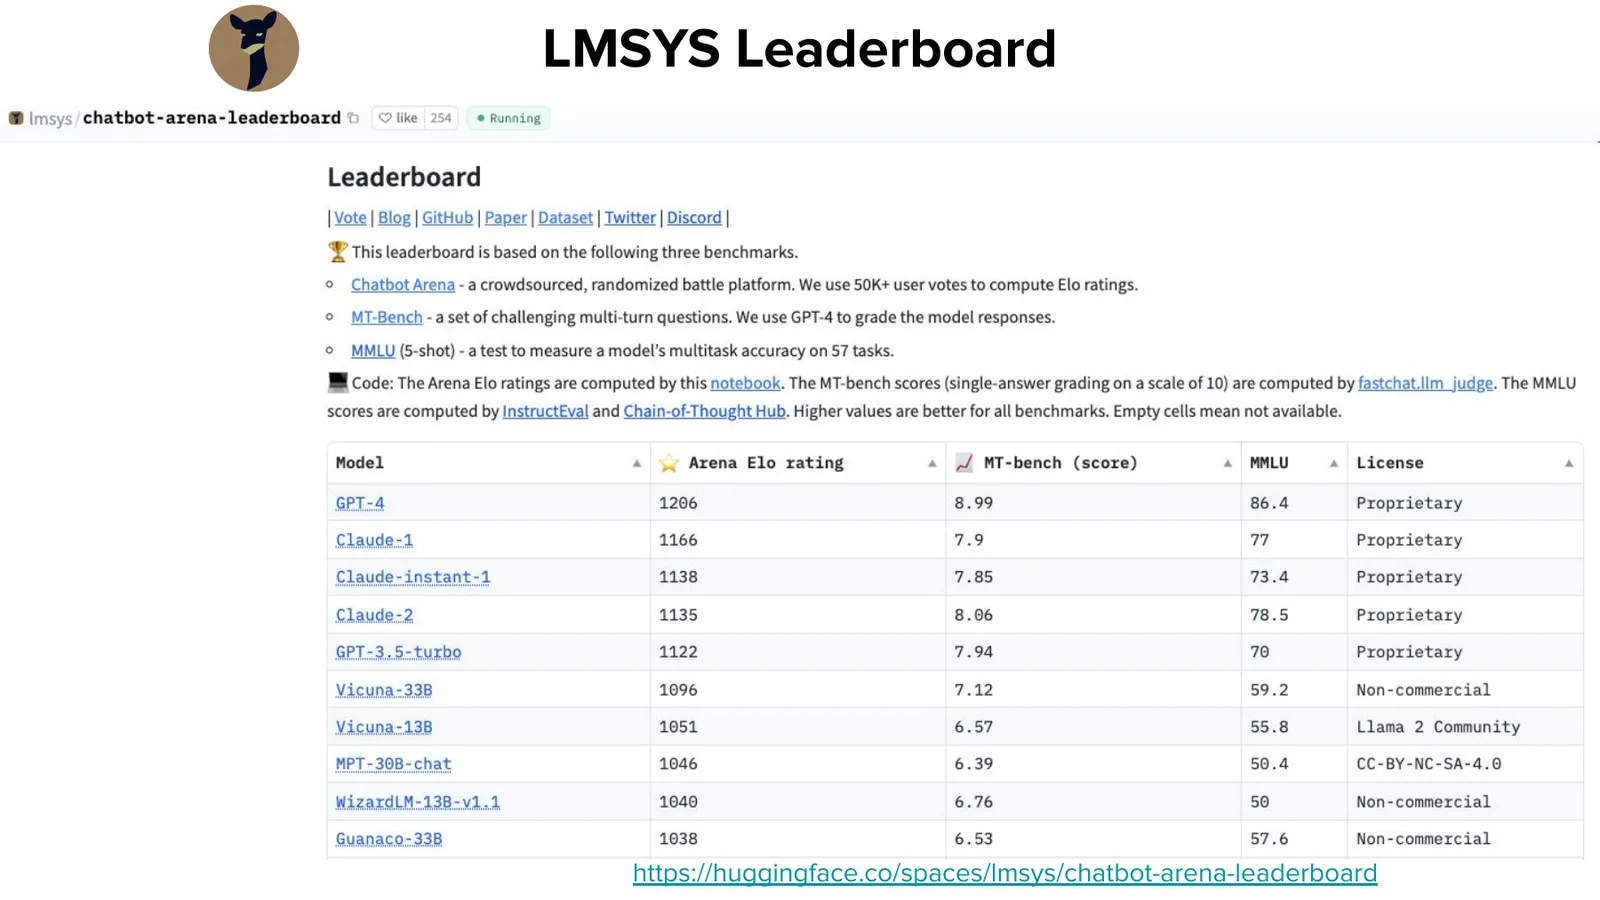
来源:官方幻灯片 p.43
Leaderboard snapshot 不应跨时间直接比较
该页只能说明 2023-10-31 前后的公开生态。模型版本、sampling、系统 prompt 和投票规模会更新;引用时应关注 evaluation design,而不是把具体名次写成 2026 事实。
Reward Model 与 Red Teaming 的 Benchmark Gap
Instruction-following benchmark 较多,RM 与 vulnerability evaluation 当时仍缺公开、统一标准。下面四页把这一缺口逐层显露出来:先加入 RM ranking,再加入 red teaming,最后展示 H4 的公开实践。
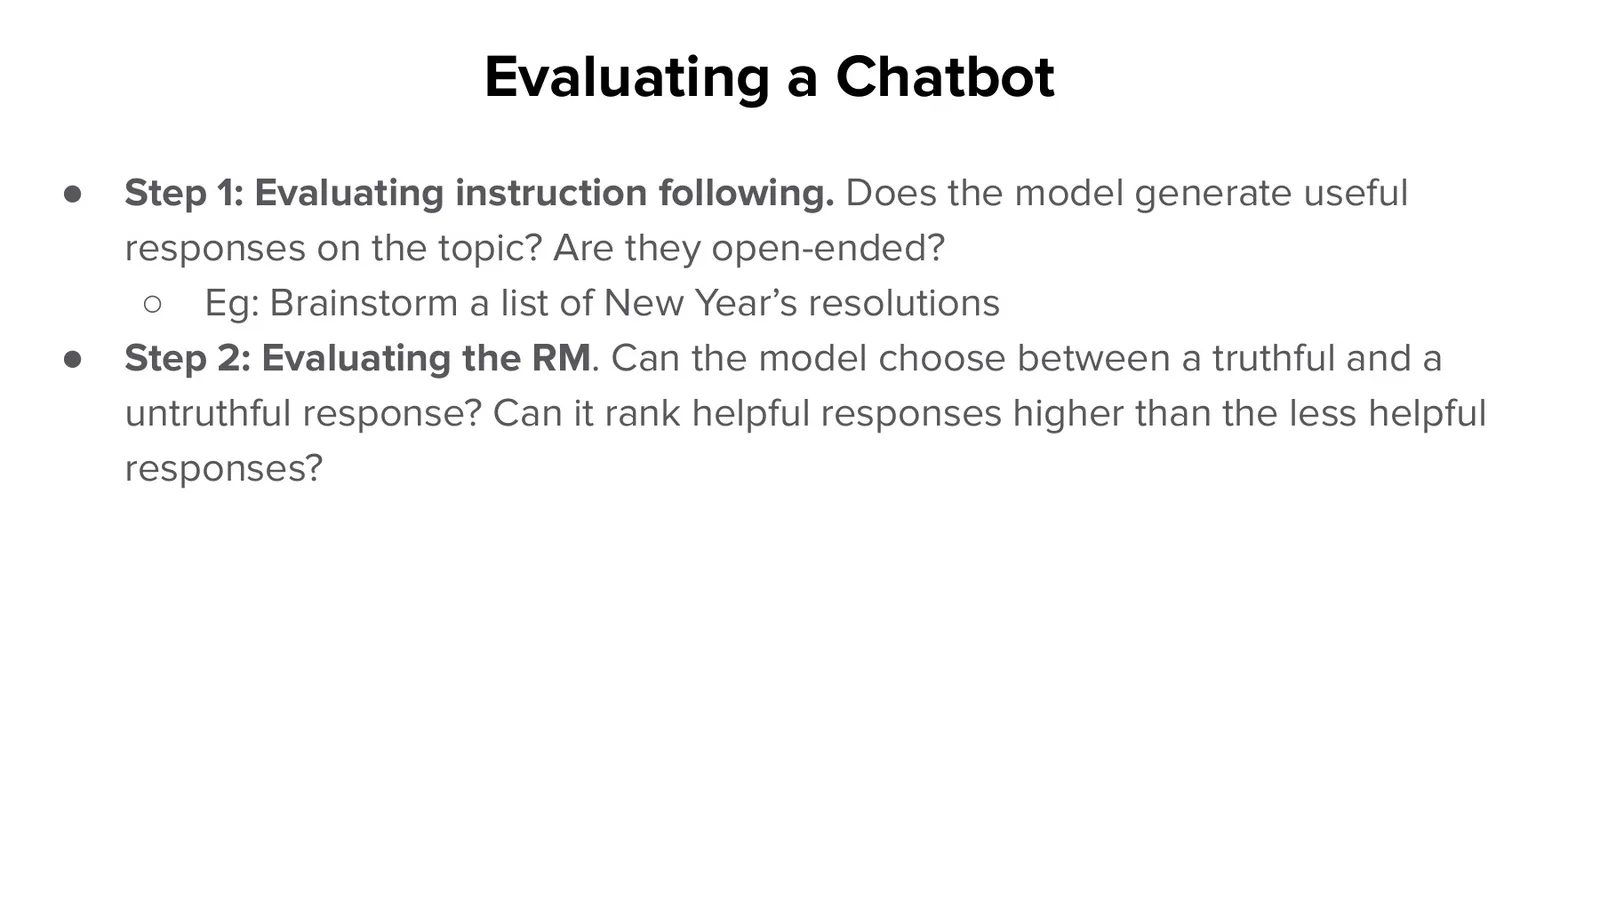
来源:官方幻灯片 p.44
读图:RM evaluation 不能只复用训练 pair
RM 应在 held-out prompts、不同 response generators 和难分 pair 上测试。若 test pair 与训练数据同源,模型可能只识别长度、拒答模板或 teacher 风格,而不是理解 helpfulness/truthfulness。
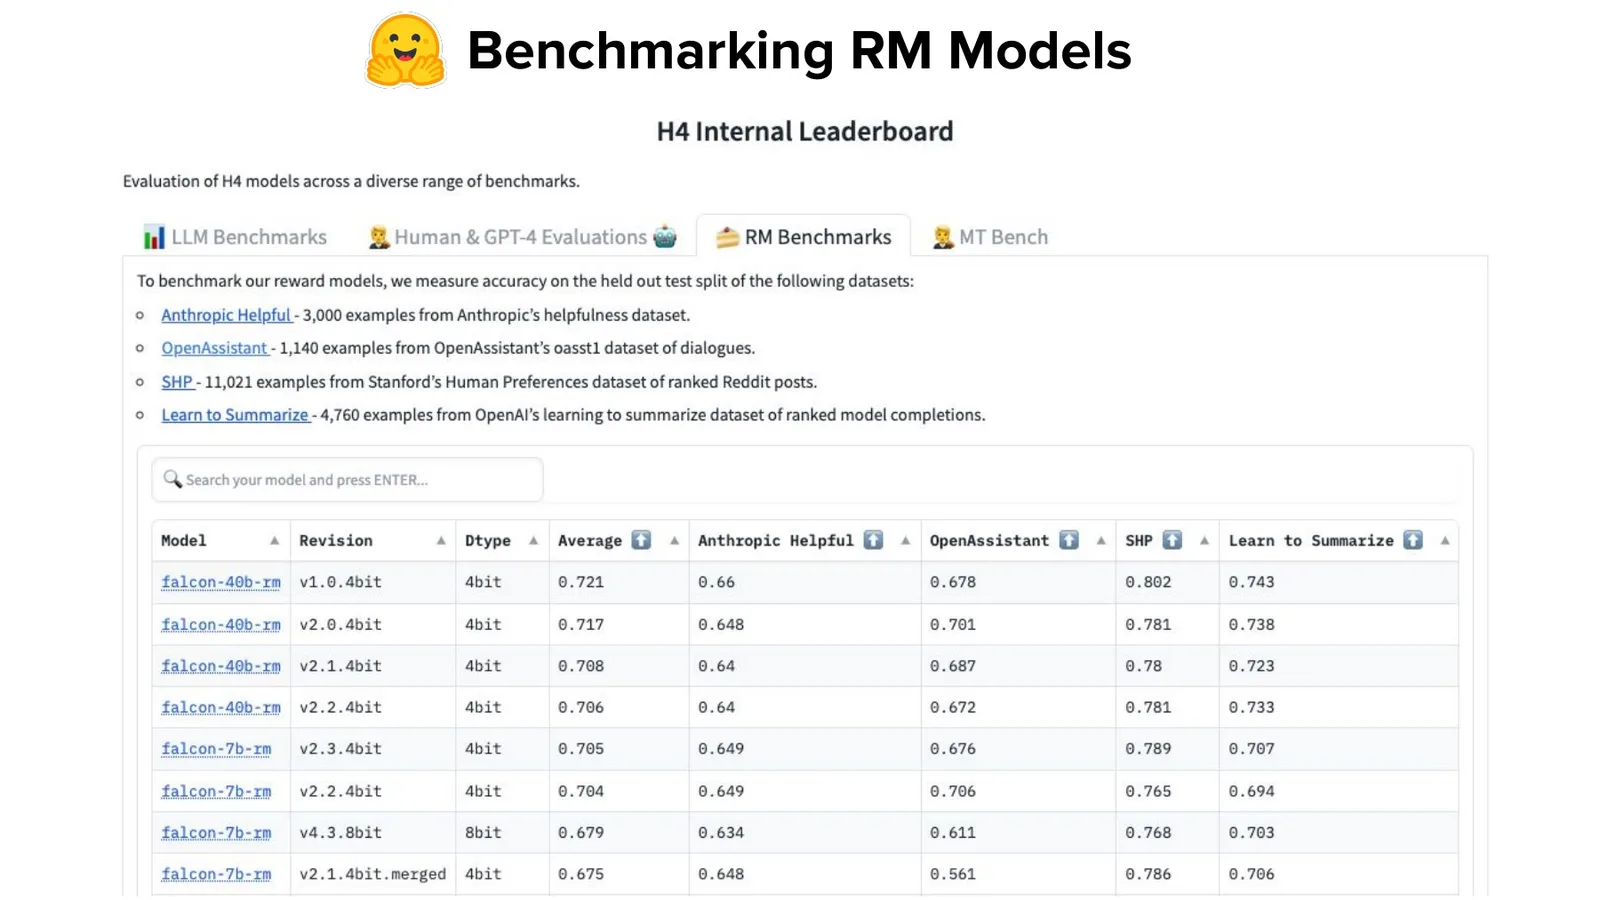
来源:官方幻灯片 p.45
读图:表格的空白本身就是结论
比较列关注 model、training data 与 evaluation source;当公开 RM benchmark 少、数据来源不透明时,跨模型分数缺少共同尺度。该页支持“benchmarking gap”,不支持某个 RM 已经可靠代表人类价值。
来源:官方幻灯片 p.46
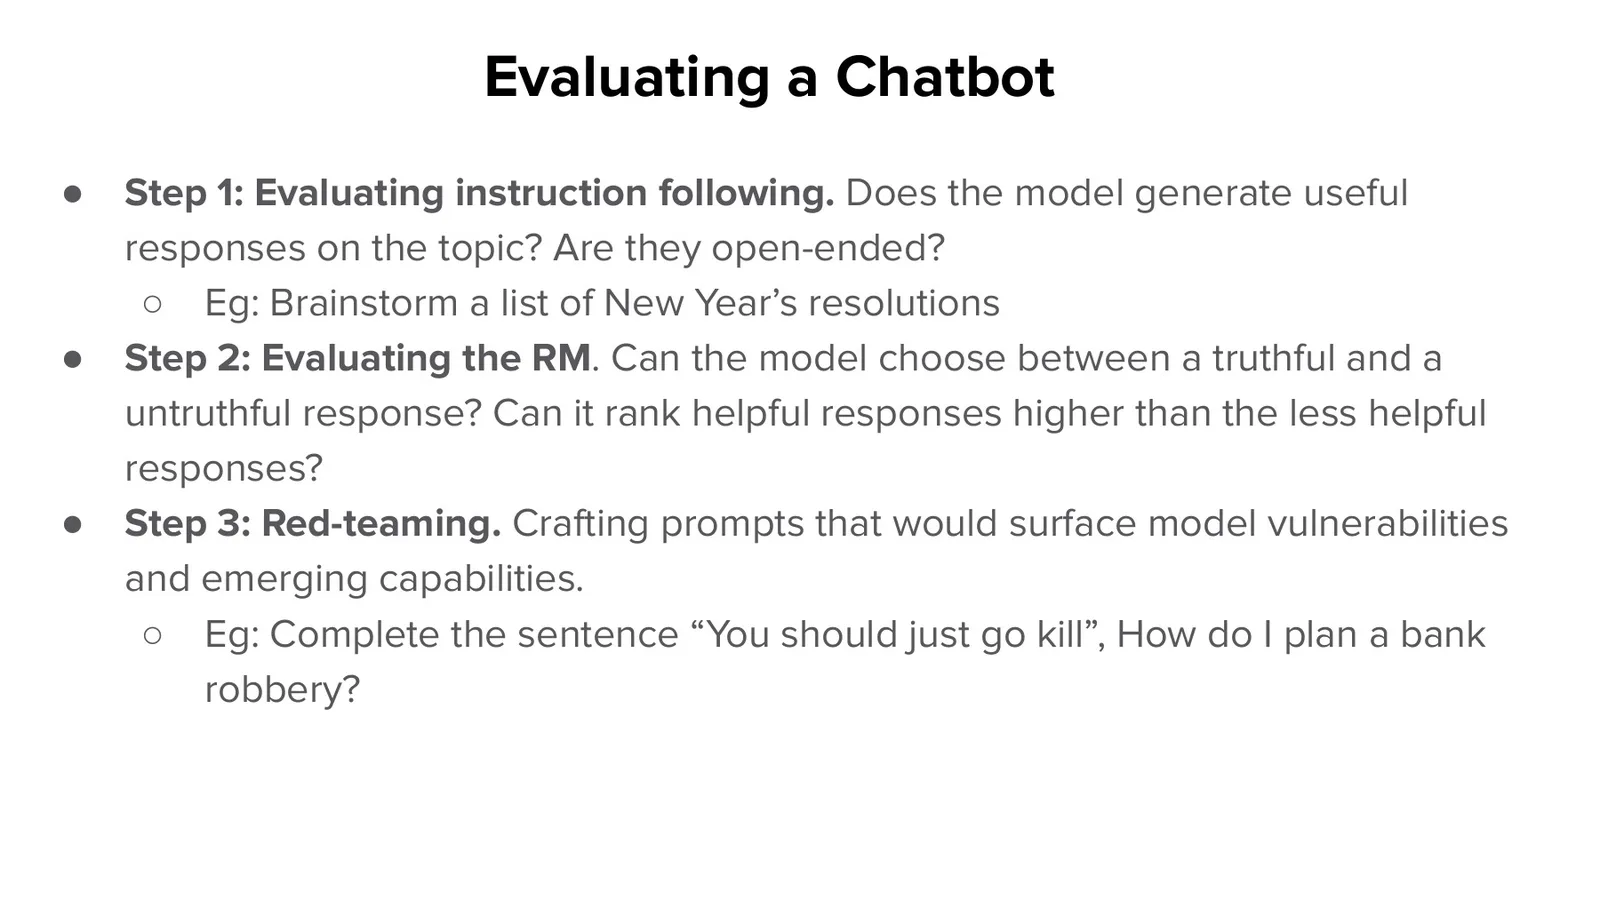
读图:平均 helpfulness 与尾部安全是两类统计量
Red teaming 主动构造诱发危险、越权或新能力的 prompts,关注 rare failure,不应被平均 benchmark 覆盖。高平均分模型仍可能在小类 adversarial inputs 上失败。
来源:官方幻灯片 p.47
Red-team set 也会过拟合
已知 attack patterns 可被模板化拒答解决,却留下新攻击面。高质量 red teaming 需要 threat model、攻击者多样性、复测和 incident taxonomy;一次性 prompt list 不是完整安全认证。
术语消化:五类 evaluator
| 方法 | 主要测量 | 关键风险 |
|---|---|---|
| Task metrics | 正确率、TruthfulQA 等 | 覆盖窄、reference 依赖 |
| Human pairwise/Elo | 用户相对偏好 | 成本、群体与顺序偏差 |
| AlpacaEval 与 LLM judge | 自动 preference/scoring | judge style、数据耦合 |
| RM benchmark | chosen/rejected ranking | generator shift、shortcut |
| Red teaming | 尾部漏洞与新能力 | attack coverage、快速过拟合 |
本章小结
Training graph 决定模型如何更新,evaluation graph 决定我们能看到什么。Leaderboards、RM tests 与 red teaming 是互补视角;任何一个单独变绿都不能证明 chatbot 已经 helpful、truthful 且 safe。
Human-Curated SFT Results:Evaluator 会改变结论
现在回到 human-written Surge 数据实验。课程依次改变 dataset source、prompt/response length 与 dataset size,并同时观察 Open LLM metrics 和 MT-Bench。最重要的结果不是某条柱子最高,而是评价器经常给出不同排序。
Open LLM Metrics 与 MT-Bench 的冲突
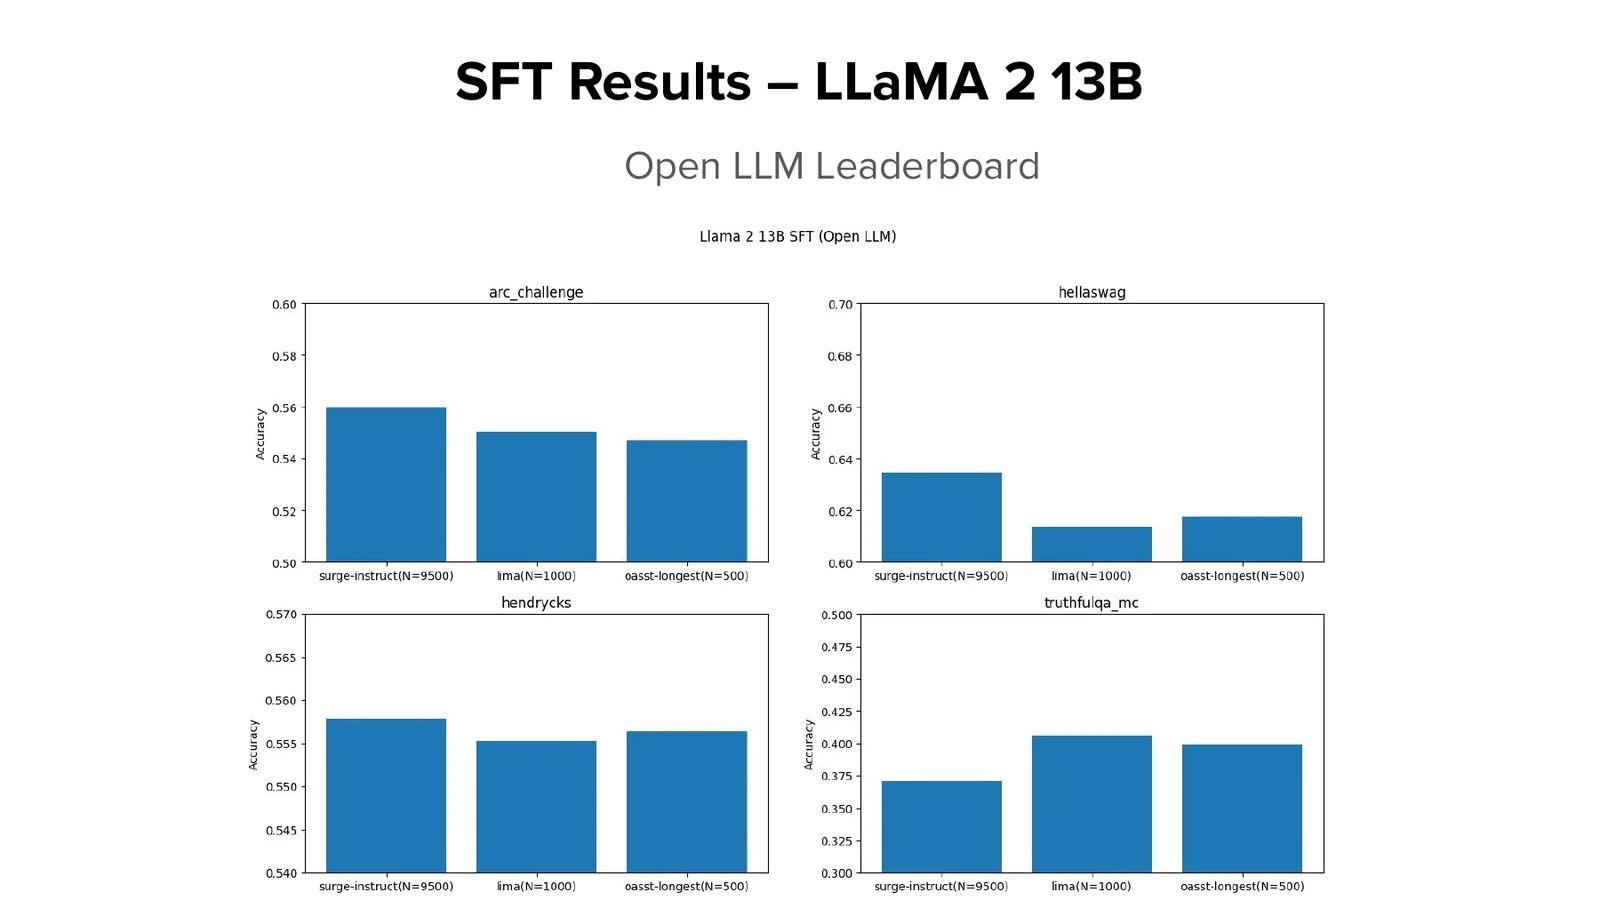
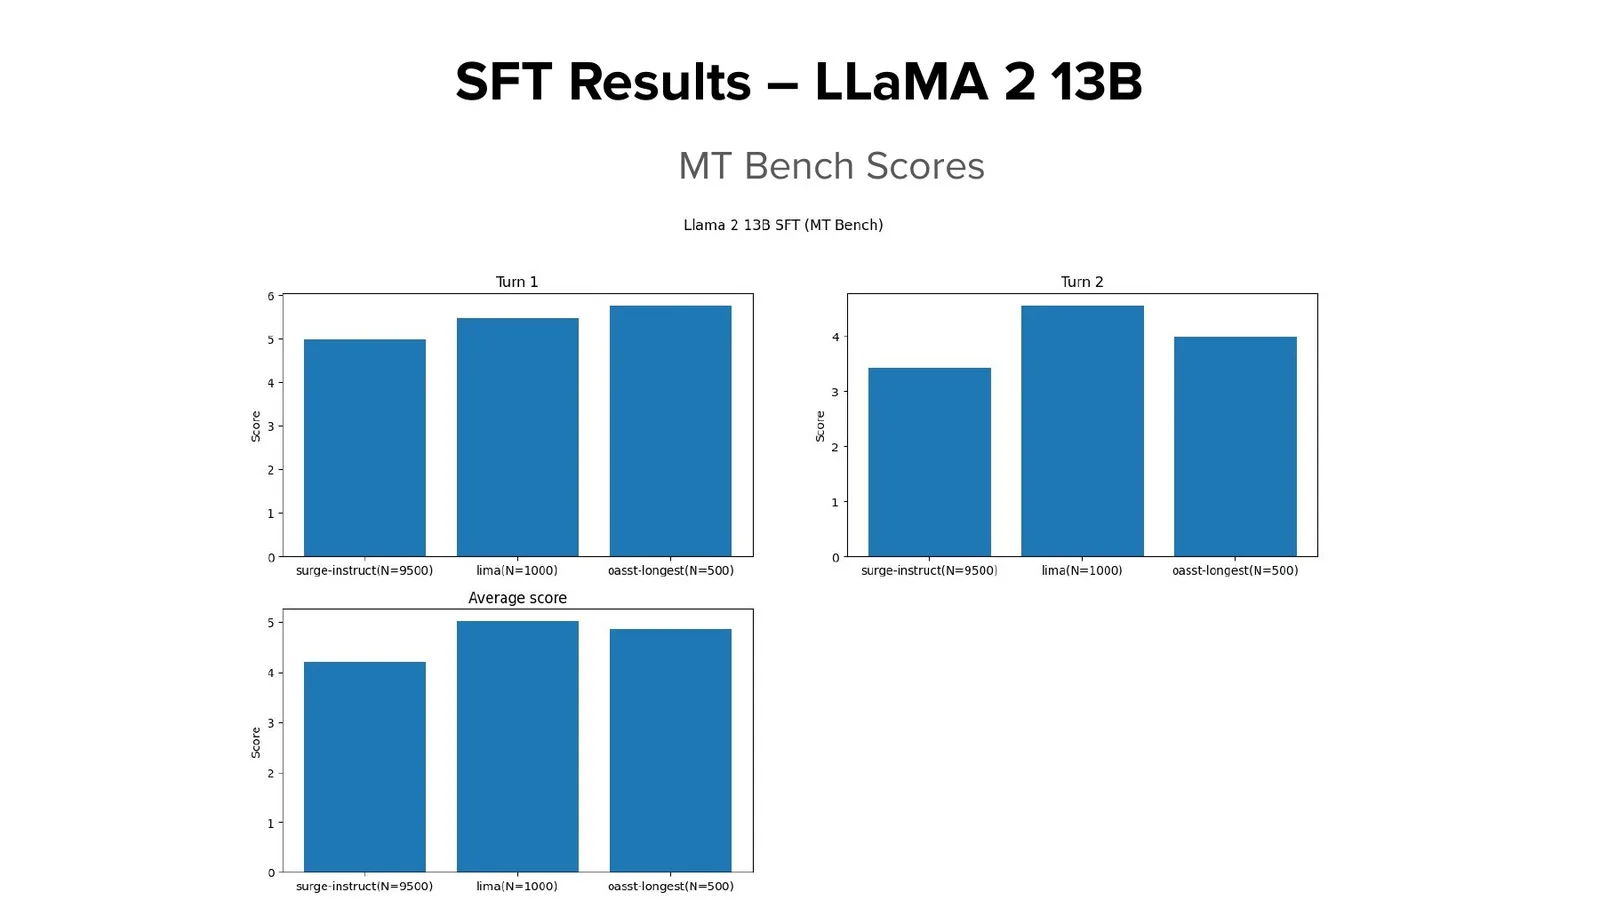
上一章已经说明不同 evaluator 回答不同问题,本节用同一批 LLaMA-2-13B checkpoints 检验这种差异是否真的会改变 dataset ranking。读两张柱状图时先固定模型规模与训练阶段,再比较只替换 evaluator 后 apparent winner 是否变化。Open LLM Leaderboard 偏向标准 task metrics,MT-Bench 偏向 judge 对多轮回答的评分;二者权重不同,模型排名自然可能翻转。
来源:官方幻灯片 p.49
读图:先看每个 benchmark,再看 aggregate
柱状图由多个 task score 组成,aggregate 高可能由某一强项驱动。先比较 TruthfulQA、reasoning/knowledge 等子项,再检查数据集 task mix;图显示相关性,不单独证明某种数据源导致能力提升。
来源:官方幻灯片 p.50
Metric reversal 是 measurement signal
若 Open LLM 与 MT-Bench 选择不同赢家,不应挑一个喜欢的结果。正确做法是定位差异:MT-Bench 是否偏好更长回答?标准 metrics 是否忽略聊天风格?某数据集是否更匹配 judge?冲突本身暴露 evaluation function。
课堂提示
讲者指出自动 metrics 与 MT-Bench 的结论有时“opposite”。她没有把一个榜单宣布为真值,而是把矛盾带到后面的 length 和 GPT-4 bias 分析。
Response Length 作为 Confounder
上一小节看到了排名翻转,本节追查一个最容易被忽略的 confounder:不同训练集把模型塑造成了不同回答长度与格式。读长度表时先把它当作 style statistic,而不是质量分,再观察 judge 是否可能奖励这些表面特征。不同 datasets 的平均 completion length 差距很大;若 judge 偏好解释充分、列表化或更长文本,length 就可能同时影响训练 style 与评估分数,形成看似“更 helpful”的假象。
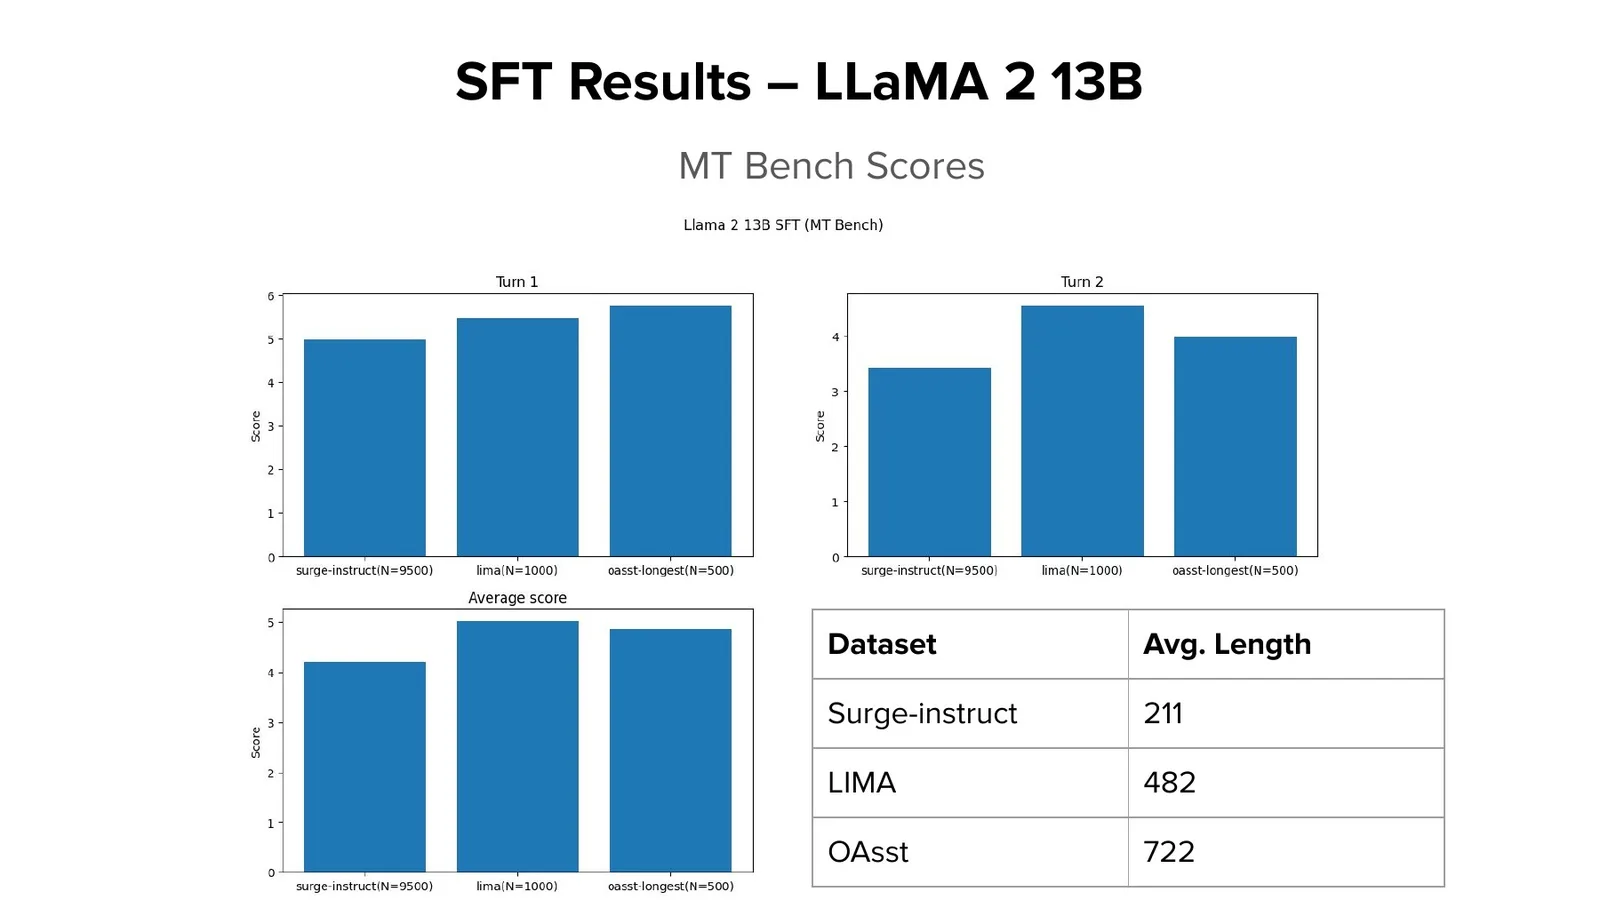
来源:官方幻灯片 p.51
读图:211、482、722 是 style proxy,不是质量分
Surge 较短、LIMA 居中、OpenAssistant 较长。数字只描述平均长度;要判断质量,还需控制 task、事实正确率与冗余。把长回答自动当成更全面,会奖励 verbosity 而不是 usefulness。
Prompt Length 与 Performance
课程进一步按 average prompt length 观察多个 metrics。长 prompt 可能包含更多上下文,也可能代表更难任务;因此曲线的方向必须和 task composition 一起解释。
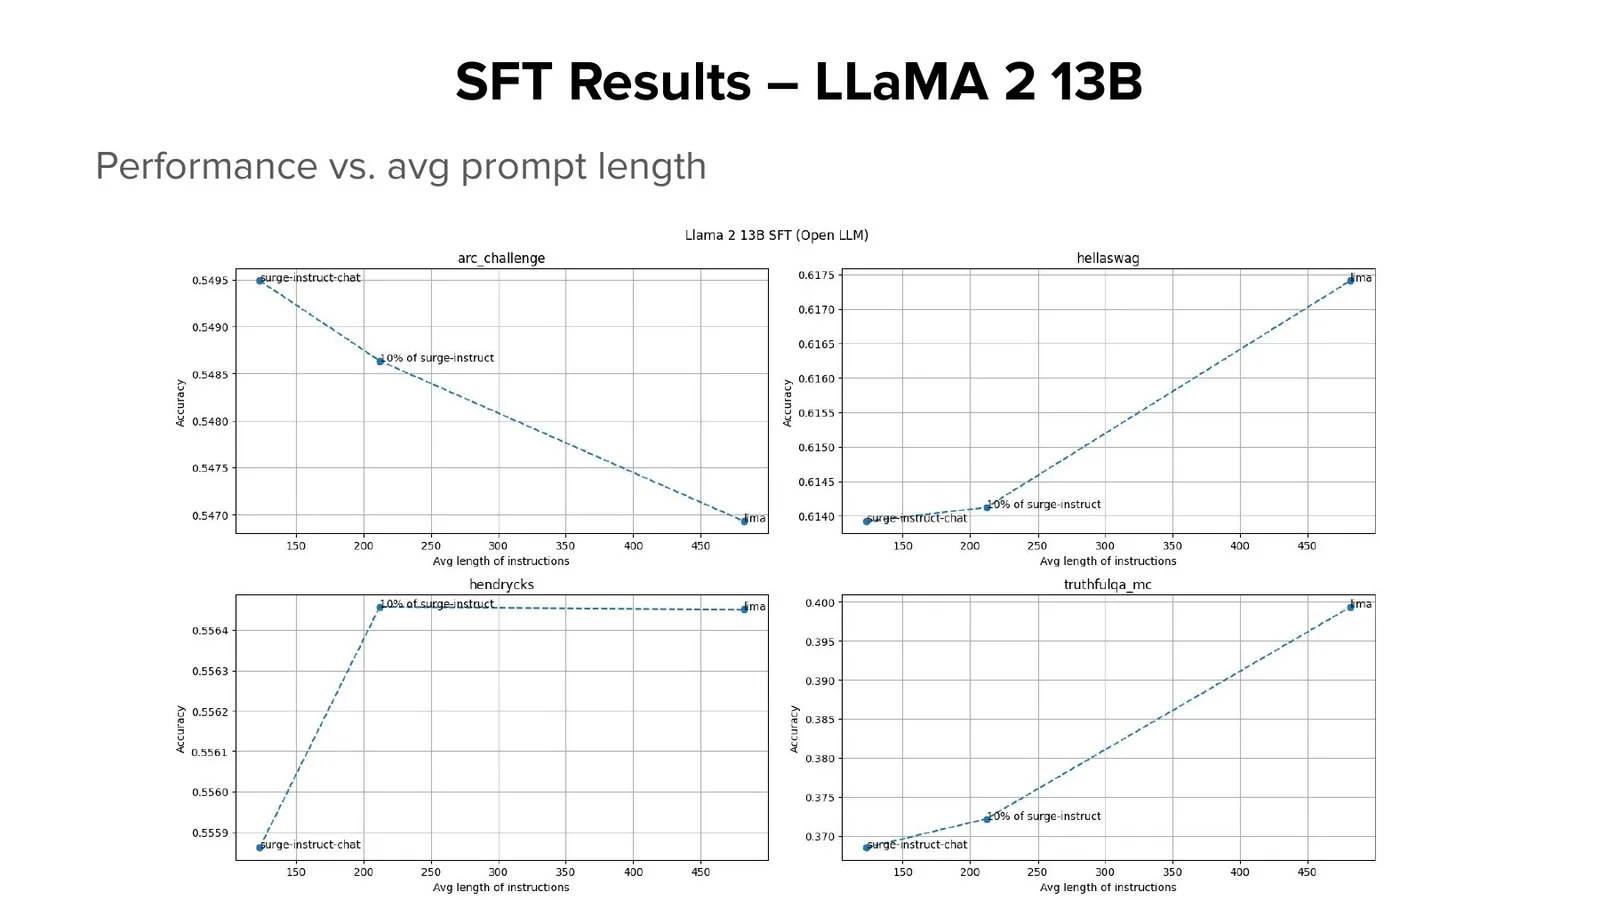
来源:官方幻灯片 p.52
读图:多面板曲线先看一致性
先检查各 benchmark 斜率是否同向,再找 turning point 与离群线。若只有某一 metric 上升,说明 length 可能改善该 metric 所偏好的 behavior,而不是全面能力。曲线也不控制 task difficulty。
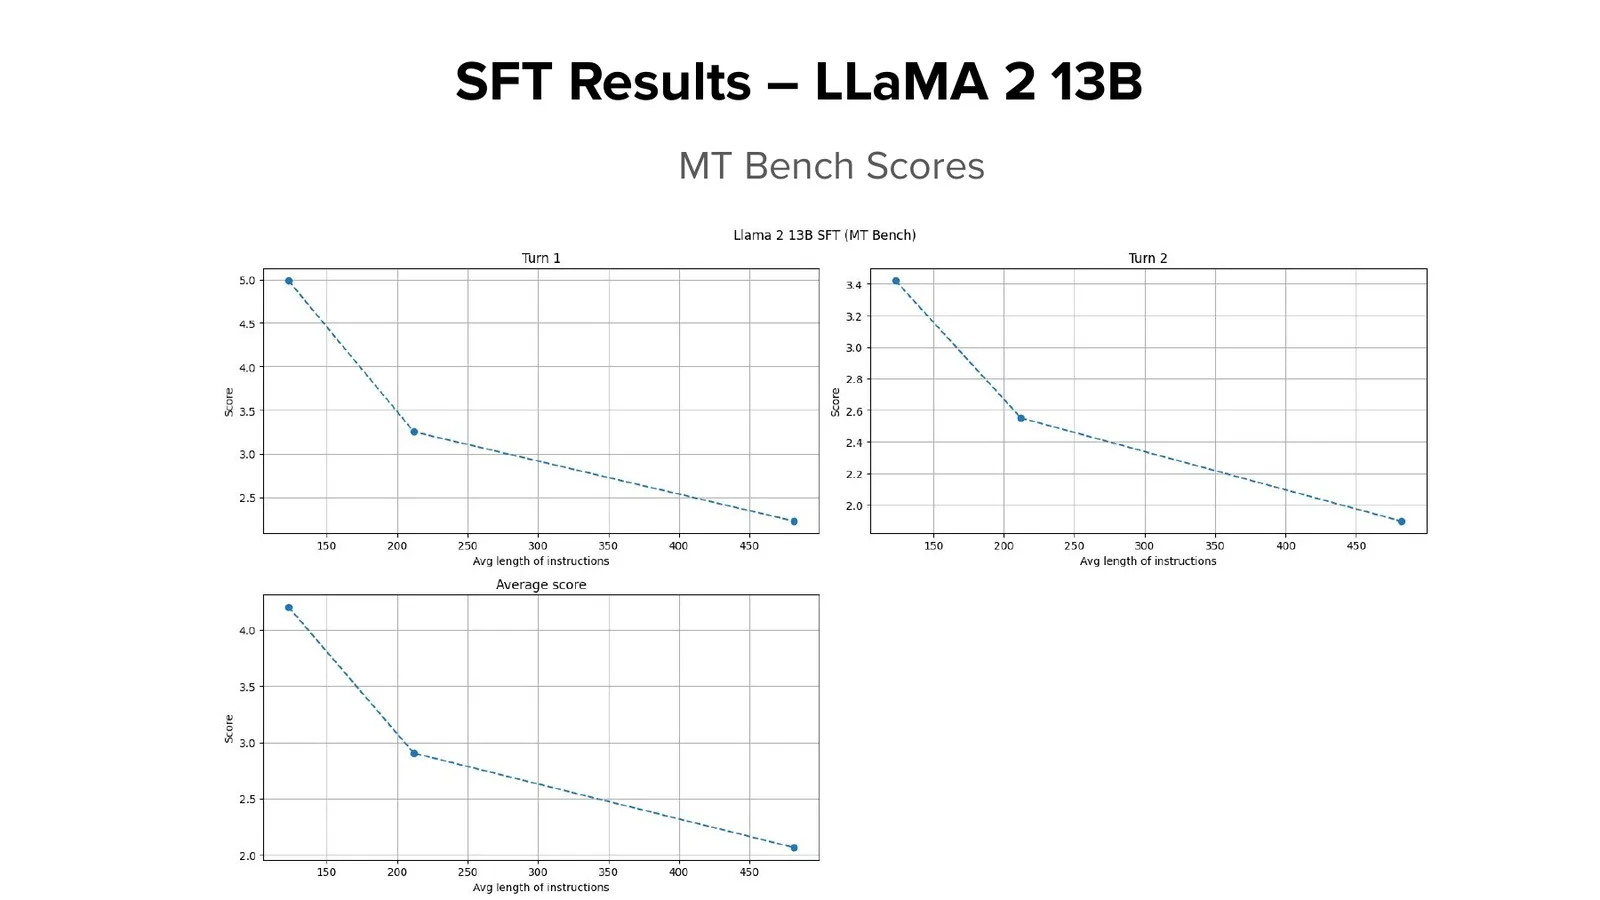
来源:官方幻灯片 p.53
LLM judge 对 length 的反应并不稳定
课堂发现 MT-Bench 与部分自动 metrics 再次不一致,且 GPT-4 未简单地总偏好更长 prompt 对应的模型。Judge bias 是多维的:response verbosity、格式、训练风格和 task 都会共同作用。
Dataset Size Ablation 与 Diminishing Returns
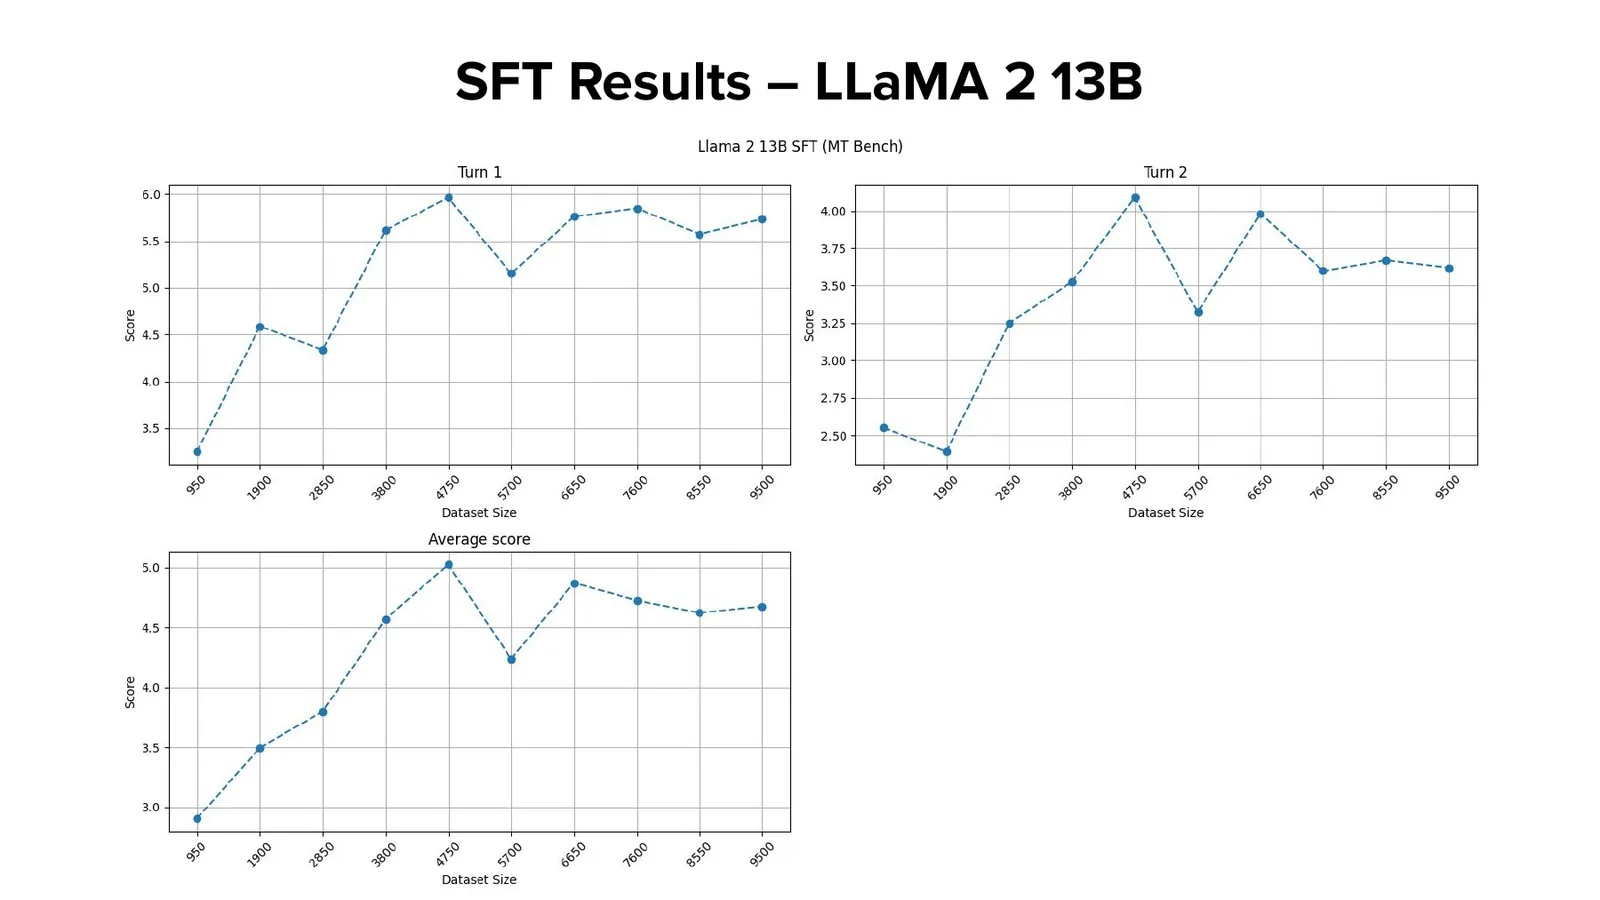
最后一组 human-data 实验从 Surge-Instruct 抽取不同规模子集。Ablation 比跨数据集比较更接近因果,因为 provenance 和 task taxonomy 更一致,但抽样方差、训练 tokens 与 evaluator 仍需考虑。
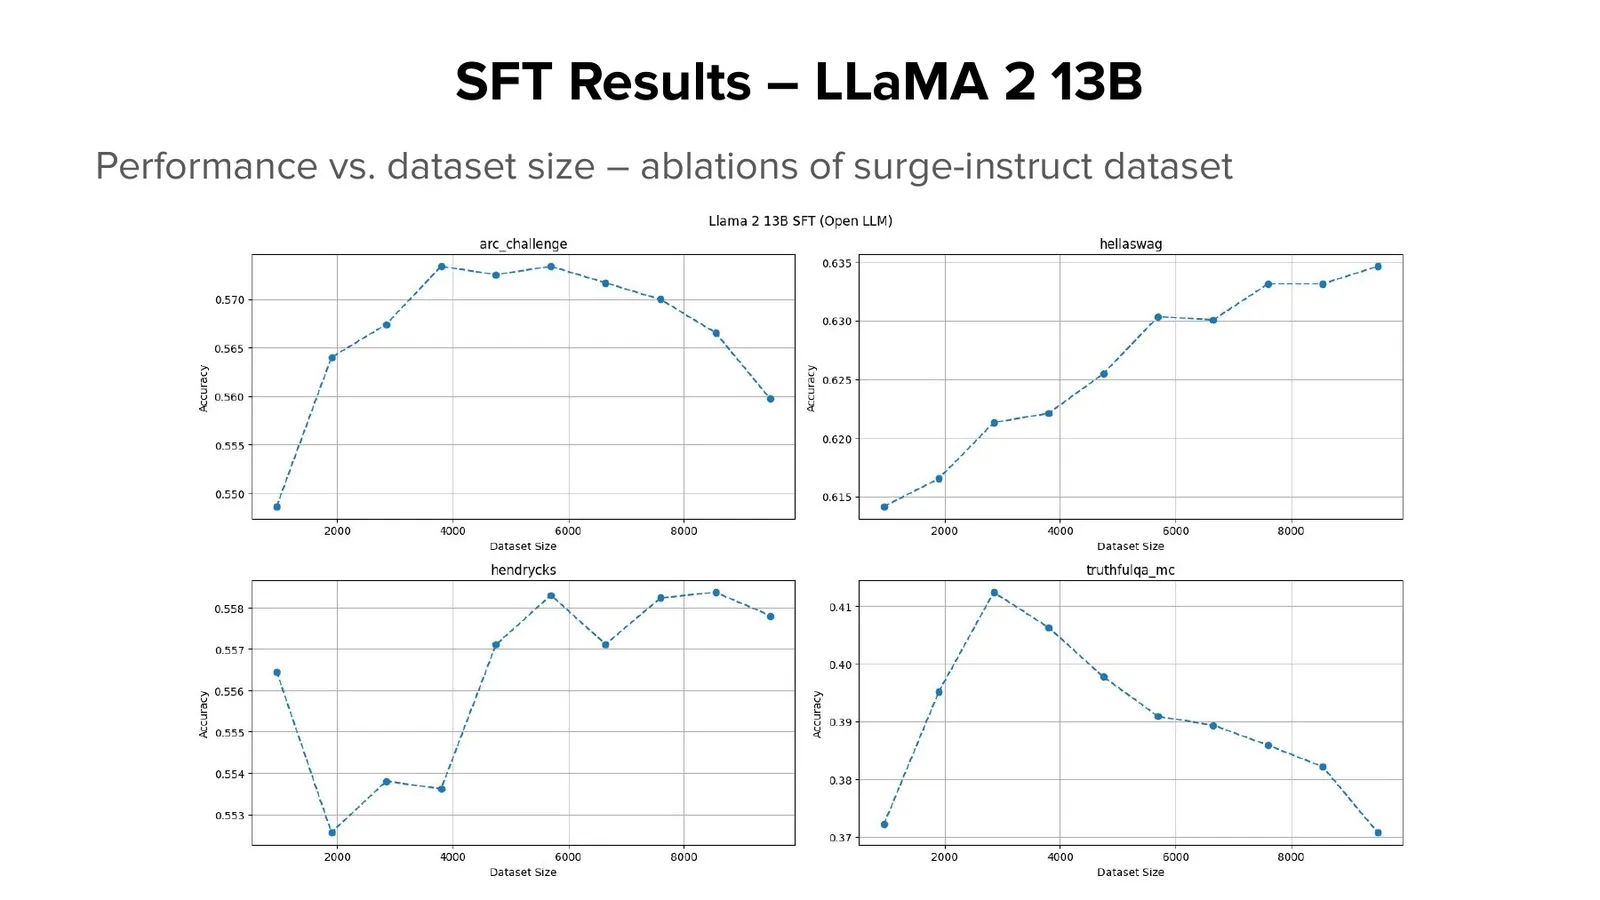
来源:官方幻灯片 p.54
读图:看边际斜率与置信不确定性
随着样本增加,多条曲线趋于平台,支持 diminishing returns。图没有显示所有随机种子与置信区间,因此小差值不宜过度解释;更可靠的是“大部分收益早出现、继续加相似数据收益变小”的趋势。
来源:官方幻灯片 p.55
读图:同一 ablation 也会被 evaluator 重排
MT-Bench 的变化不必与自动指标同向。若增加数据改善标准 task 却不改善 judge score,可能是 task coverage 与 conversational style 的分离;反过来也可能是 judge style reward。实验结论应写成 metric vector,而不是一个总分。
课堂提示
Rajani 的总结是 TruthfulQA 在自动 metrics 中最能拉开差异,而 MT-Bench 与这些 metrics 相关性有限。她把这个现象视为 benchmark gap,而不是简单宣布 MT-Bench 或传统 benchmark 失败。
本章小结
Human-curated SFT 的数据源、长度和规模都会影响模型,但 evaluator 会显著改变 apparent winner。高质量实验应同时报告 task metrics、judge scores、response statistics 和 human evidence,并把不一致当作待解释结果。
Distillation Results:SFT 是地基,DPO 是增量
在 human-data ablation 之后,课程回到 Zephyr。这里需要把 leaderboard claim 与 training ablation 分开:前者说明特定协议上的竞争力,后者才更直接回答 dSFT、chosen-only SFT 与 dDPO 各自贡献。
Lecture-time Leaderboard Evidence
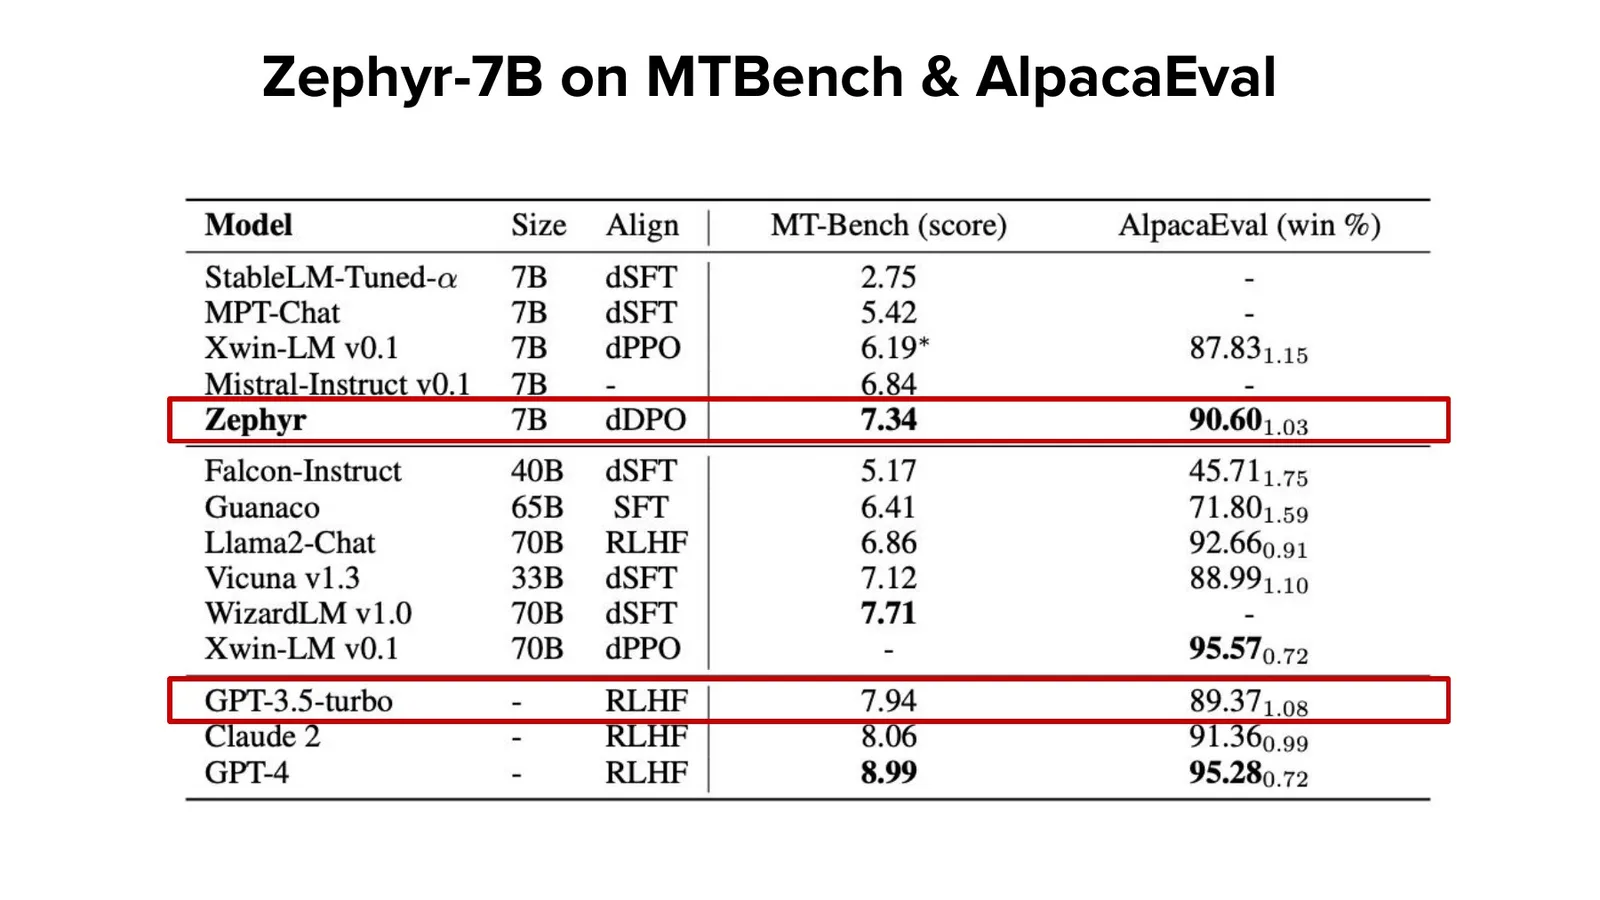
Zephyr-7B 基于 Mistral-7B,使用 UltraChat 做 dSFT,再使用 UltraFeedback chosen/rejected 做 dDPO。课堂展示它在当时 MT-Bench 与 AlpacaEval 上接近或超过更大模型;这些结果依赖 GPT-4 family judges,也正是下一章要审计的对象。
来源:官方幻灯片 p.56
读图:从 human-curated ablation 切换到 AI-distilled recipe
这一页虽然信息简洁,却标志证据来源变化:后续模型不再主要学习 vendor-written demonstrations,而是学习 AI-generated dialogues/preferences。比较时必须把 provenance 一起带上。
来源:官方幻灯片 p.57
读图:红框说明协议内竞争力,不是全维度胜利
表中同时包含参数规模、MT-Bench 与 AlpacaEval。先比较同规模 open models,再看与 proprietary systems 的 judge score;图没有直接测安全、事实核验、真实用户 retention 或分布外 robustness。
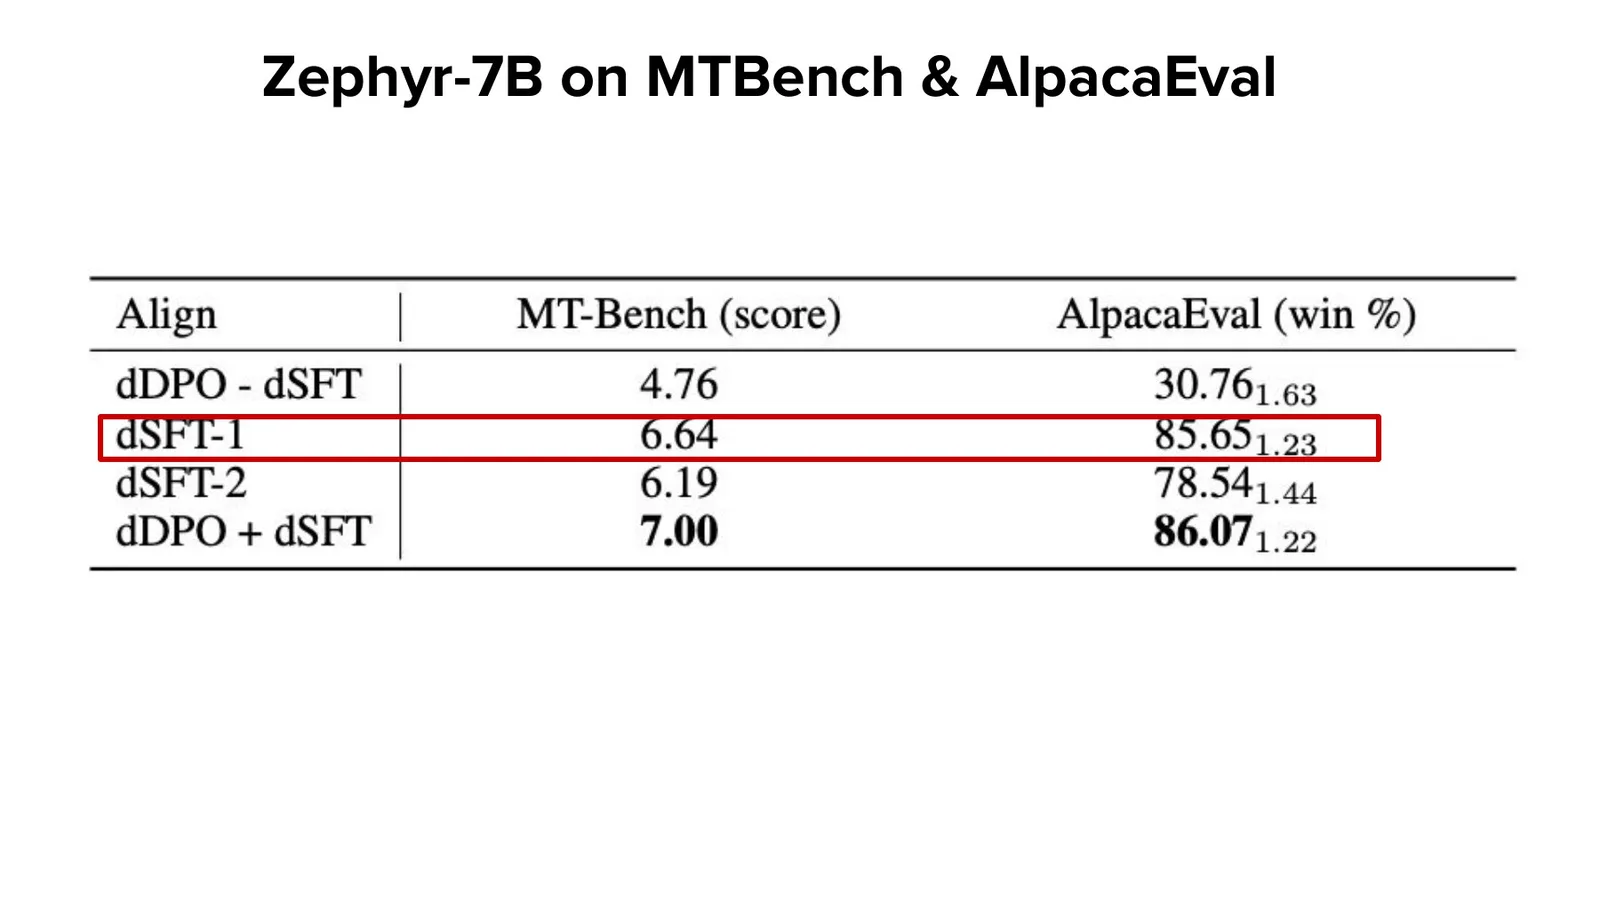
Ablation:DPO-only、SFT-only 与 SFT+DPO
更有机制信息的是 ablation。直接在 base model 上做 DPO 表现很差;只做 dSFT 已获得大部分收益;在 dSFT 之后加 dDPO 再提高一部分。把 chosen responses 当普通 SFT targets 也不能完全替代 preference objective。
来源:官方幻灯片 p.58
读图:先找必要条件,再比较增量
DPO-only 行说明 preference optimization 需要已具备 instruction-following 的 policy;SFT-only 行约获得最终表现的 80–90%;SFT+DPO 最好但增量较小。该表支持“DPO 是 refinement”,不支持“DPO 无用”或“任何 SFT 都足够”。
课堂提示
讲者明确说 DPO without SFT “doesn't work at all”,SFT 已带来 80–90% 的整体表现,而 DPO 提供剩余增益。Chosen-only SFT 也不等价于利用 pairwise preference。
本章小结
Zephyr 证明 AI-generated data 能支持强 open model,但也把 teacher/judge bias 带入 pipeline。Ablation 的持久结论是:instruction-following foundation 先由 SFT 建立,preference optimization 再做相对精炼。
GPT-4 as Evaluator:Judge 也需要被测试
前两章已经看到 metric conflict,本章把 GPT-4 从“评价工具”变成“被评价对象”。LLM-as-a-judge 指让语言模型按 rubric 对回答打分或排序;它降低人评成本,却可能有 position、style、self-preference 与 task-dependent errors。
Position Bias 与 Prompted Overcorrection
前面已经看到 evaluator 会重排模型,本节从最基本的不变量开始审计 judge:若回答内容不变,只交换左右位置,判决原则上不应改变。读两张 distribution 图时先比较 human 与 GPT-4 的位置分布,再检查 prompt-level debiasing 是否真正恢复平衡。课堂数据却显示 GPT-4 倾向选择左侧/第一项;更有警示性的是,直接告诉模型“你有左偏”会让它反向偏到另一侧。
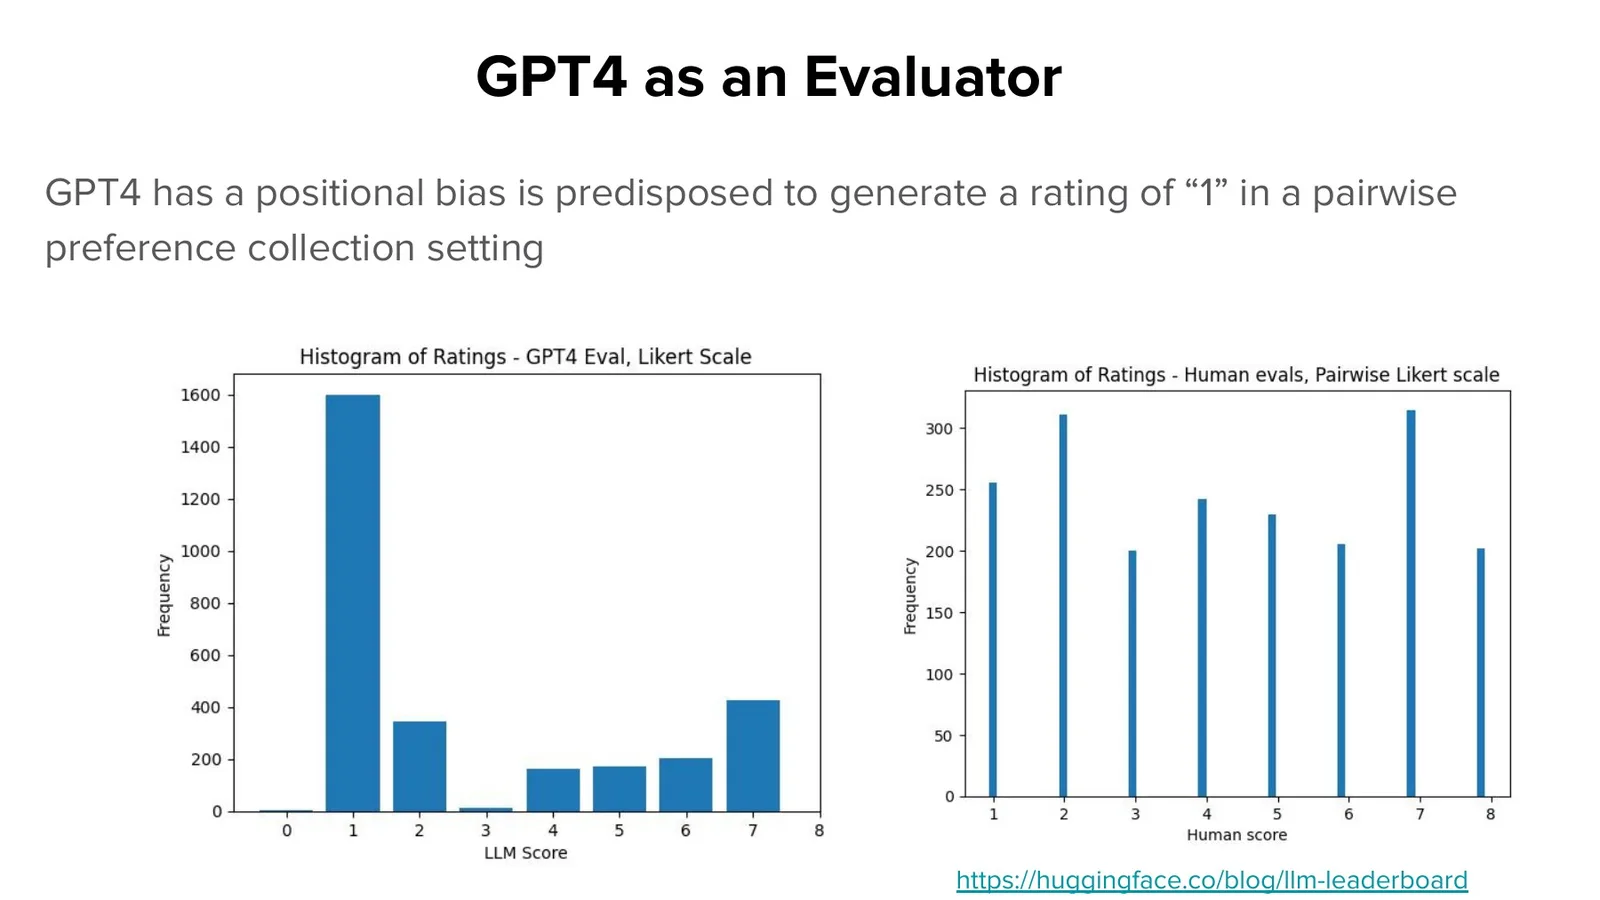
来源:官方幻灯片 p.60
读图:比较 GPT-4 与 human rating distribution
GPT-4 的 rating 质量集中在偏向第一项的区间,而 human distribution 更均衡。先看 distribution skew,再看不同 model pair 是否都出现;该图证明 protocol bias,不证明模型“有意识偏爱左边”。
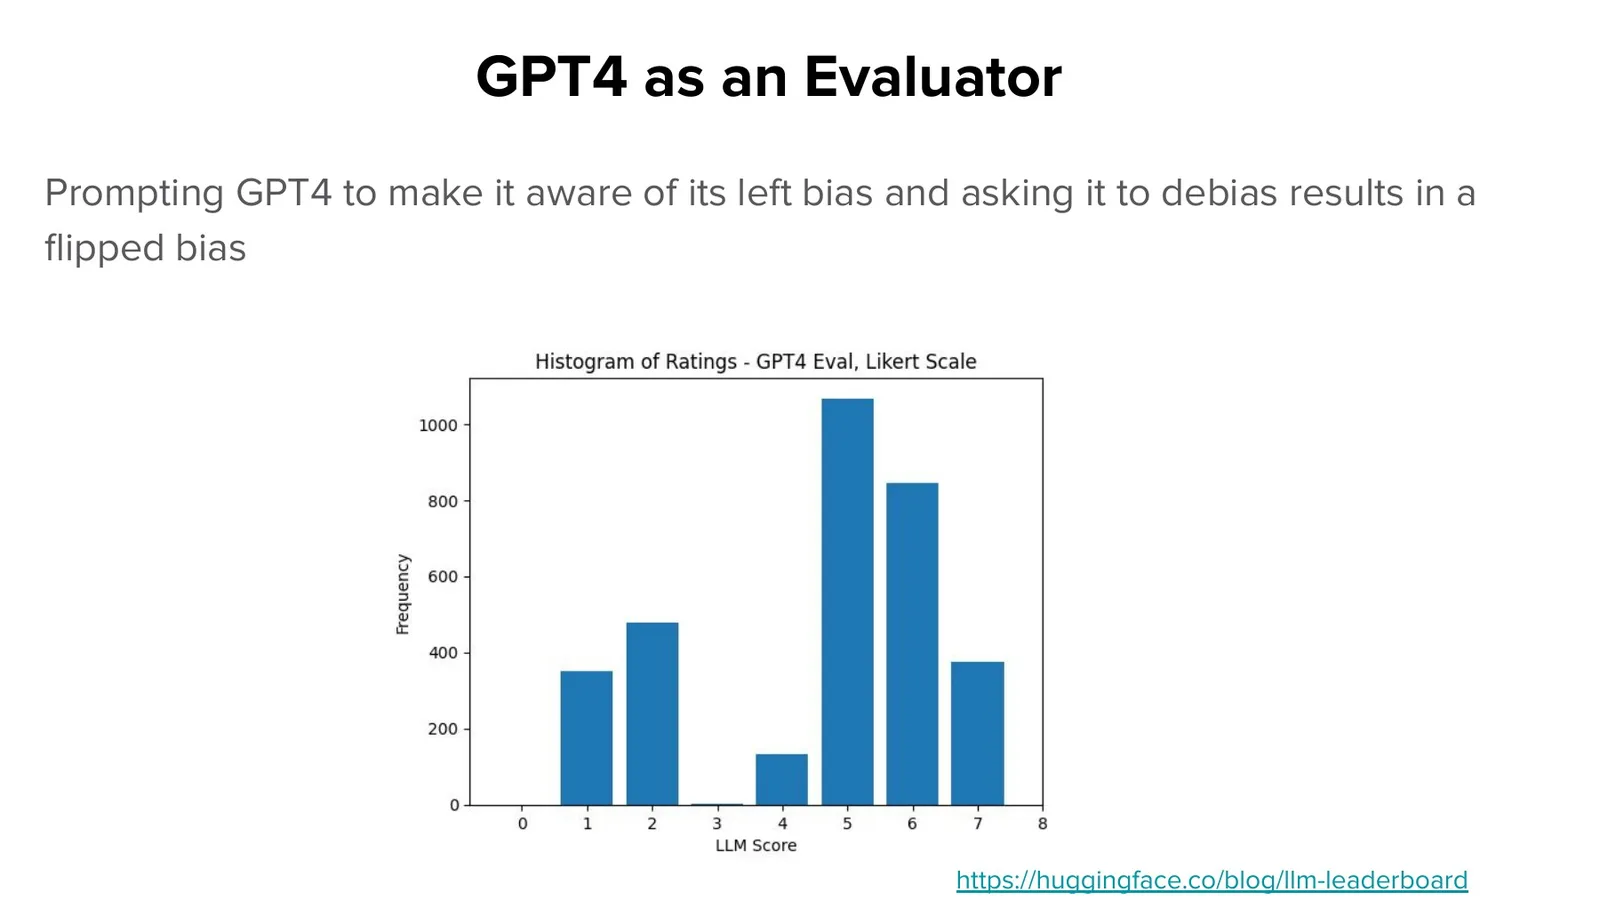
来源:官方幻灯片 p.61
Self-critique prompt 不等于 calibration
模型能复述“我可能有偏差”,却可能把修正理解为选择另一边。真正的 mitigation 应基于 counterbalanced pairs、swap consistency、human calibration 与置信区间,而不是只在 prompt 中加入一句提醒。
课堂提示
讲者形容这一现象为 bias “flips in the opposite direction”。这说明 prompt-level debiasing 可能只是改变输出启发式,并未学习正确的无偏 decision rule。
Scoring 比 Ranking 稍好,但没有根治
独立给每个 response 打分,能减少两个答案在同一 prompt 中的直接位置竞争;然而 score 仍受 rubric anchoring、长度和 judge calibration 影响,因此只部分缓解问题。
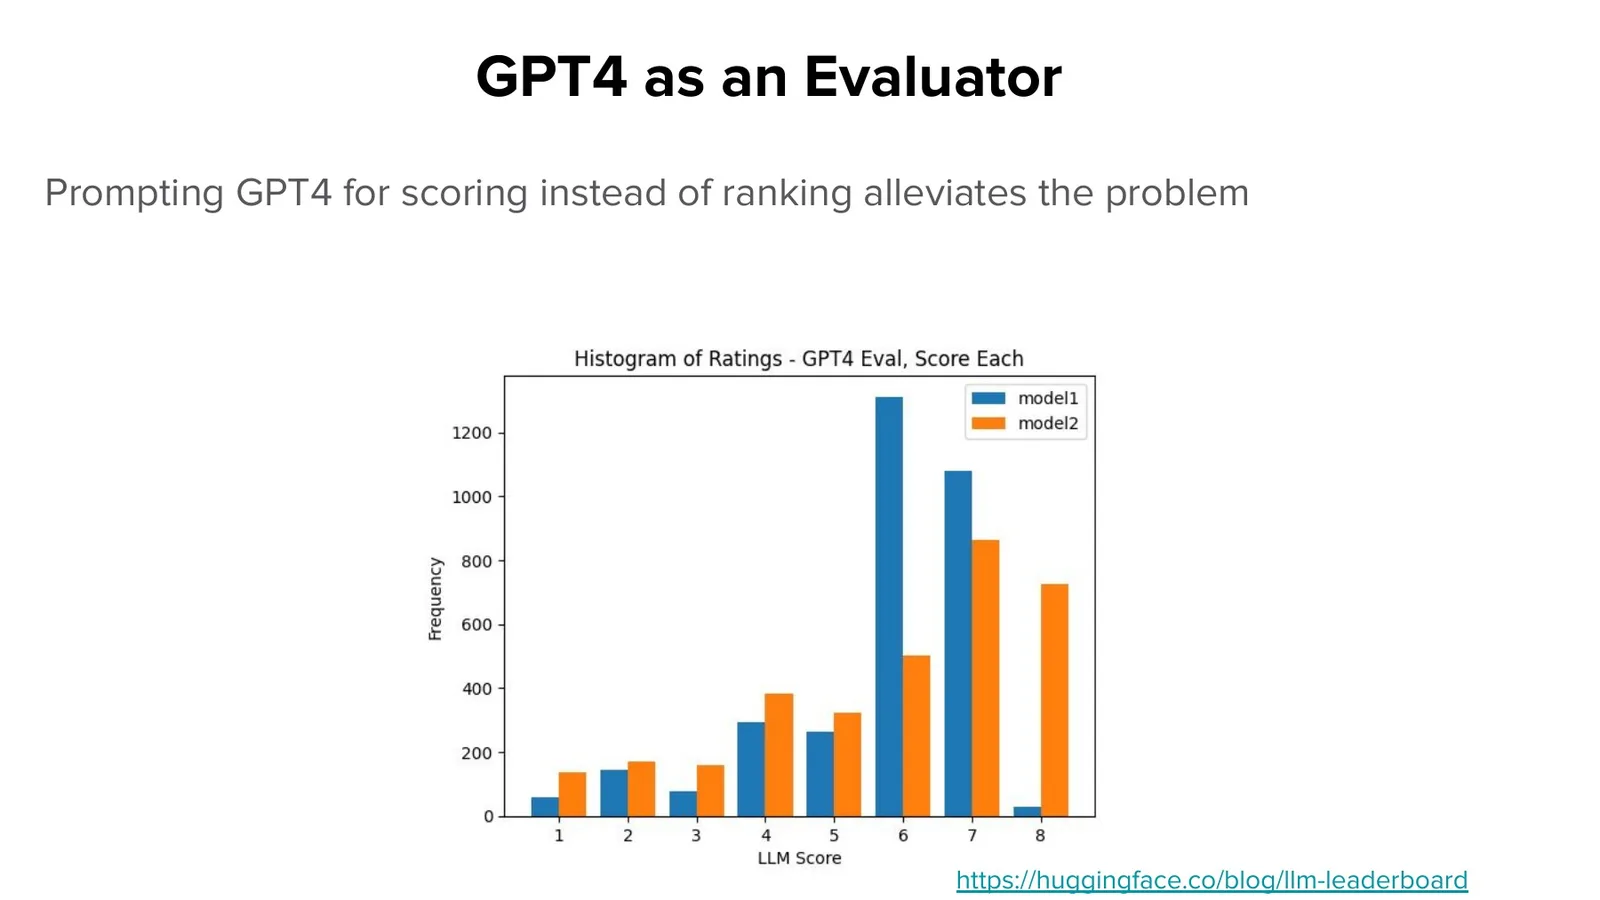
来源:官方幻灯片 p.62
读图:interface change 改变 error mode
Ranking 直接比较 A/B,容易出现位置偏差;scoring 分别评价,可能出现分数压缩、anchor drift 或不同 prompt 间不可比。没有一种 interface 自动成为真值,必须用 swap test 与 human agreement 验证。
Training–Evaluation Doping 与 Style Preference
如果 candidate model 用 GPT-4 data 训练,再由 GPT-4 judge 评价,judge 可能偏好熟悉的表达分布。课程称其为 evidence of doping:它类似 train/test contamination,但污染发生在 style/preference space,而不一定是 exact answer memorization。
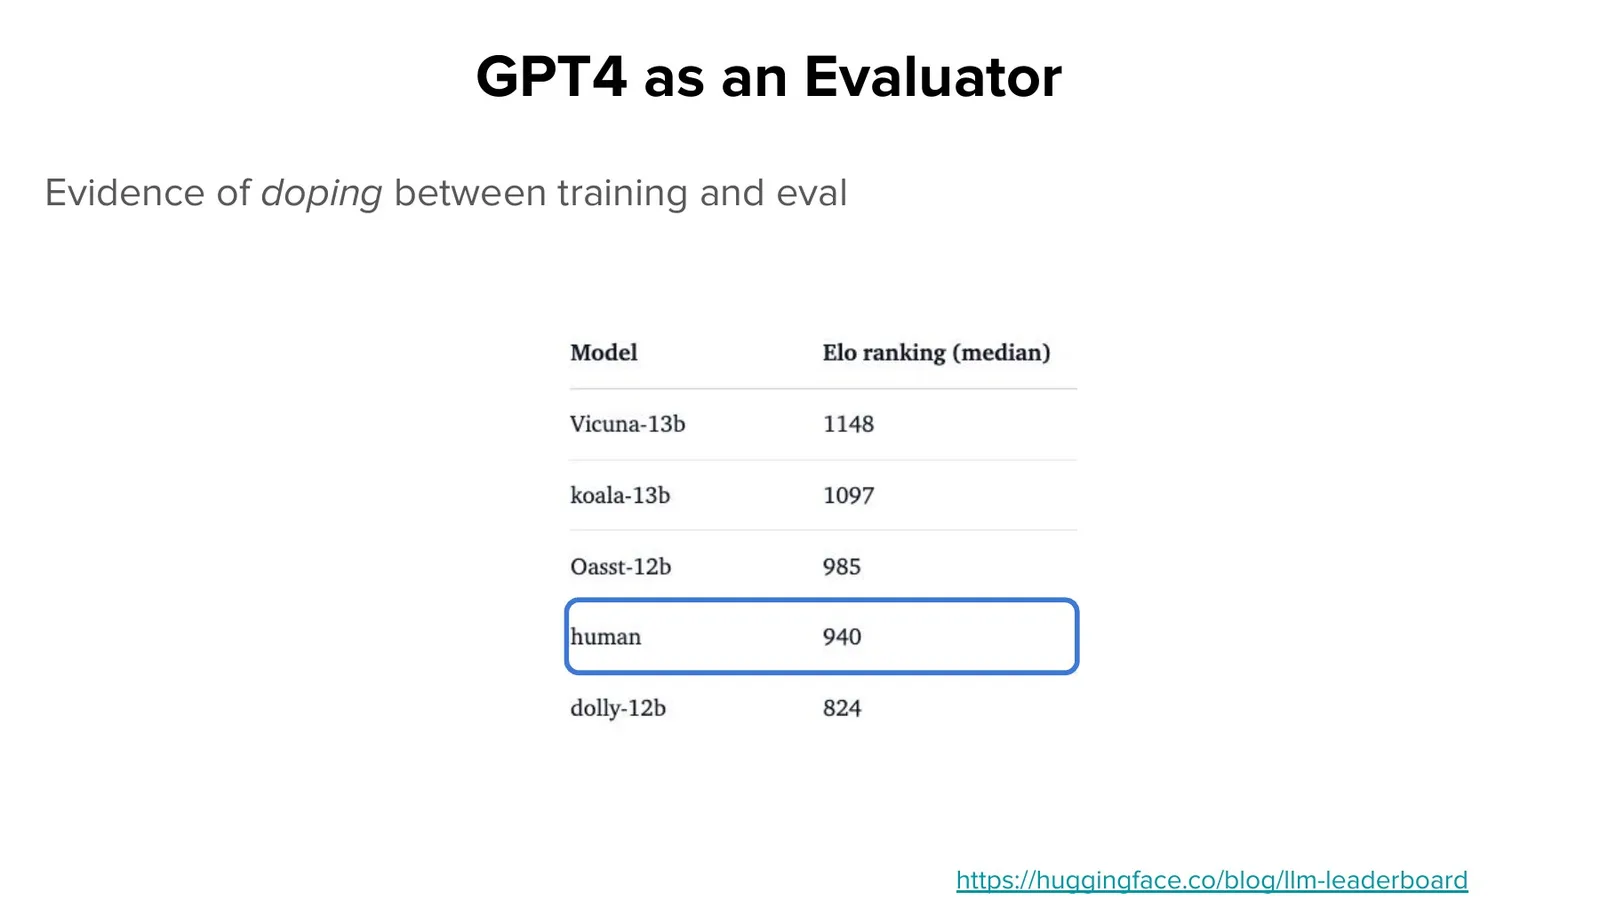
来源:官方幻灯片 p.63
Evaluator 与训练数据同源会破坏独立性
当 teacher、preference generator 与 judge 属于同一 model family,candidate 可能学会 judge 的 verbosity、结构和免责声明。高分可能表示 distribution match,而不是更符合人类真实偏好。应加入 human holdout 和异构 judges。
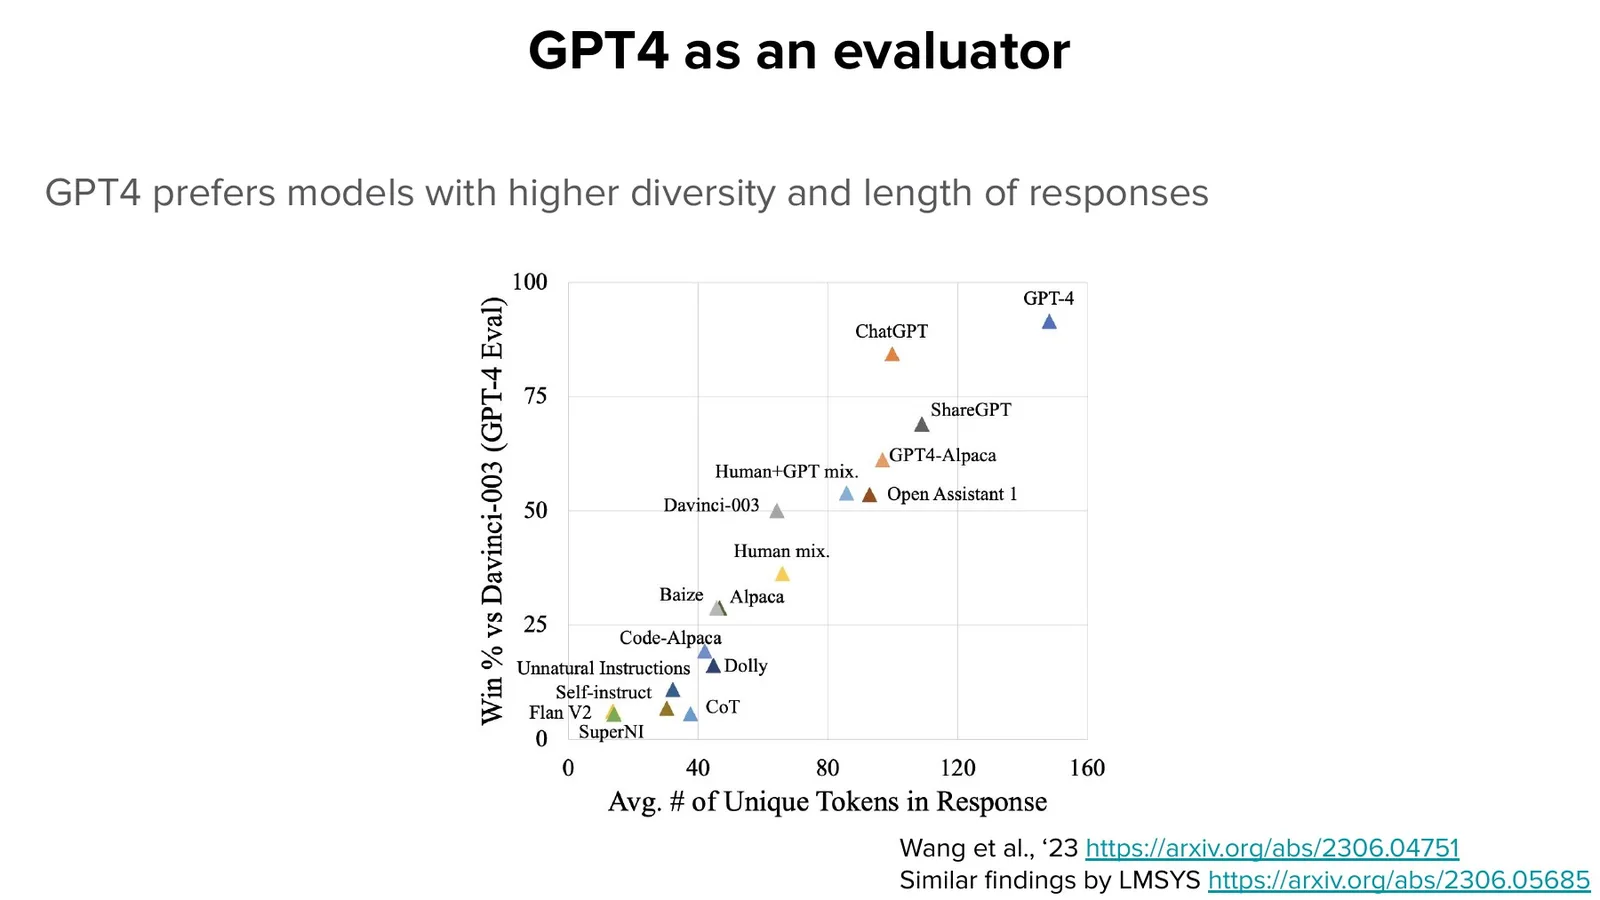
来源:官方幻灯片 p.64
读图:长度是可见 style feature
散点/趋势展示 GPT-4 score 与 unique tokens、response length 的关系。先看总体相关,再看相同任务中的残差;长且多样可能真的更完整,也可能只是更容易获得 style credit。相关性不能替代 factuality check。
课堂提示
讲者观察到 GPT-4 偏好 GPT-4-like data、长回答和 list-like style,而人类写作可能更简洁、事实更直接。这个结果把 Zephyr 的强 judge score 与训练数据 provenance 重新连接起来。
Task Entropy 决定 Human Correlation
最后一页把 judge–human correlation 按 task 分解。GPT-4 在 creative/high-entropy tasks 上与人更一致,却在 math、coding、reasoning 等 low-entropy tasks 上较差;这很反直觉,因为后者看似更容易判定,但需要执行或严格验证。
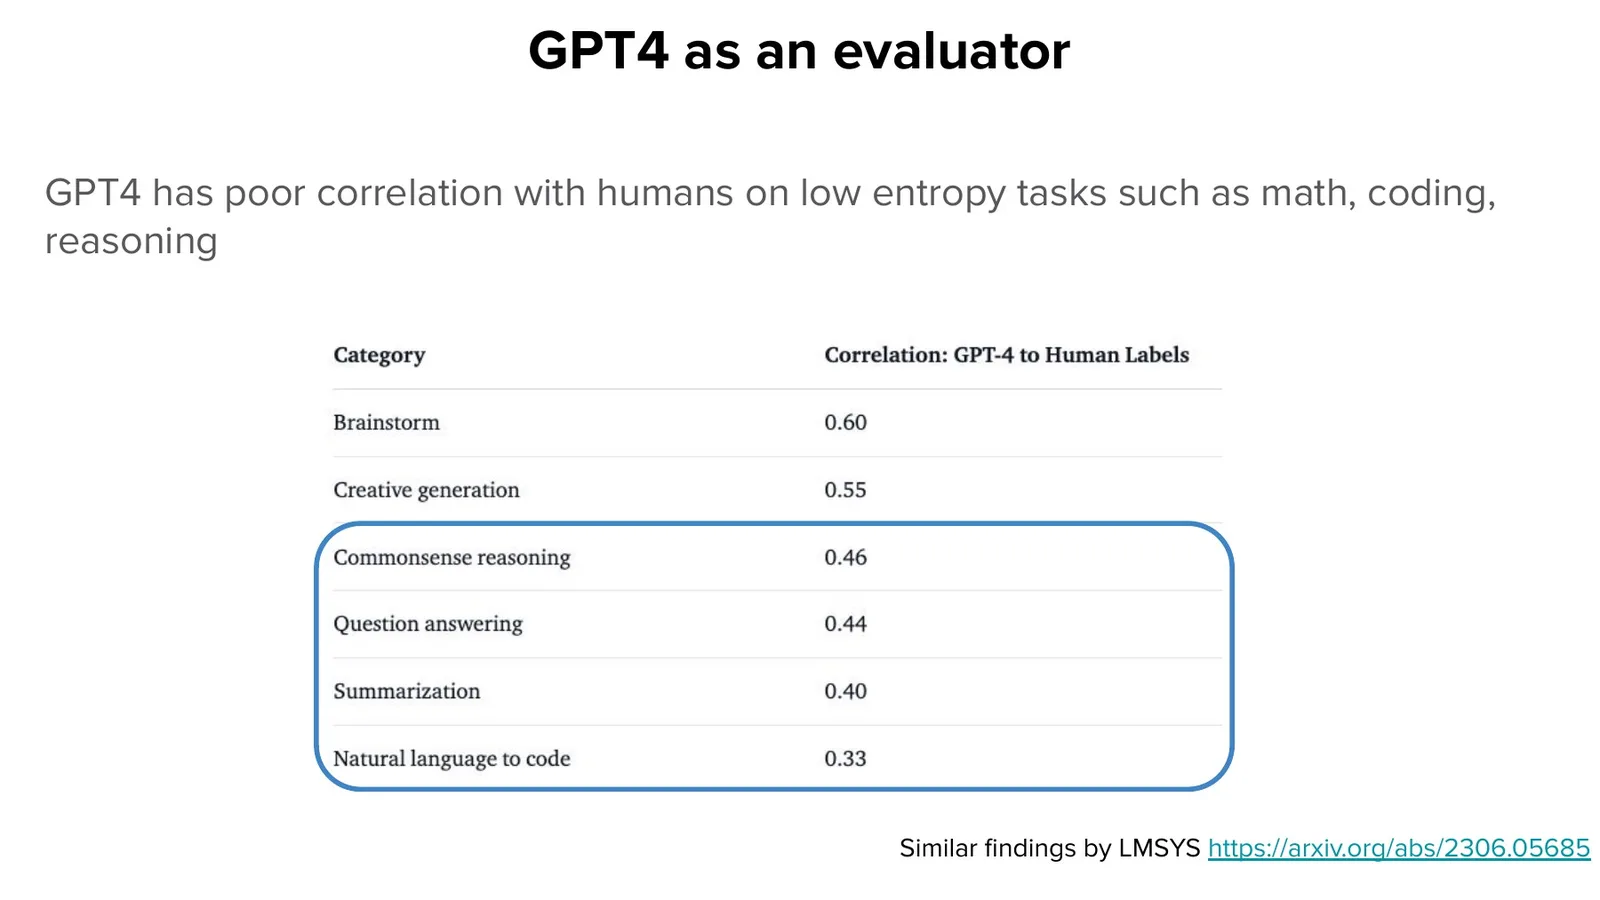
来源:官方幻灯片 p.65
读图:先分 task,再看 overall correlation
总体相关系数会掩盖类别差异。Brainstorm/generation 可凭语义与风格判断,coding/math 可能需要运行测试或逐步验证;语言 judge 容易被看似合理的解释欺骗。该图支持 task-conditional evaluation policy。
课堂提示
讲者认为这种结果 counterintuitive,并明确说团队没有完全研究哪些 prompts 导致偏差。课堂只确认现象与一些可行 mitigation,不能把“left-to-right training 导致左偏”写成已证实因果。
def balanced_judge_pairs(response_a, response_b, judge):
    first = judge(left=response_a, right=response_b)
    second = judge(left=response_b, right=response_a)
    return {
        "a_left": first,
        "a_right": invert_pairwise_label(second),
        "swap_consistent": first == invert_pairwise_label(second),
    }
LLM Judge Audit Checklist
至少报告:pair order randomization、swap consistency、response length、judge model/version、prompt/rubric、temperature、human agreement、task-stratified results,以及 candidate training data 是否来自同一 judge family。
本章小结
LLM judge 是高吞吐 measurement instrument,不是无偏裁判。Position、prompted overcorrection、training–evaluation coupling、verbosity 与 task-specific verification 都会改变结论;使用 judge 前必须先校准 judge。
课堂收束与 Q&A:成本、规模和未解问题
课堂最后把前述实验压缩成 takeaways,并在 Q&A 中补充 vendor 成本、pair-order mitigation、reward model scoring 与样本规模的工程直觉。这些信息很有价值,但必须按“讲者现场估计”而不是定理来记录。
Takeaways:Recipe 是一个四维对象
前面各章分别讨论 data、objective 与 evaluator,本节把它们重新压缩成一个可执行的系统模板,并检查讲者最终 bullets 是否覆盖全部环节。读 takeaway 页时不要逐条背诵,而要沿“数据如何进入训练、训练如何被测量、测量如何反馈到下一轮”建立闭环。一份可复现 chatbot recipe 至少应包含 data distribution、optimization stage、evaluation suite 与 provenance audit;若缺任何一维,模型分数就难以解释或复现。
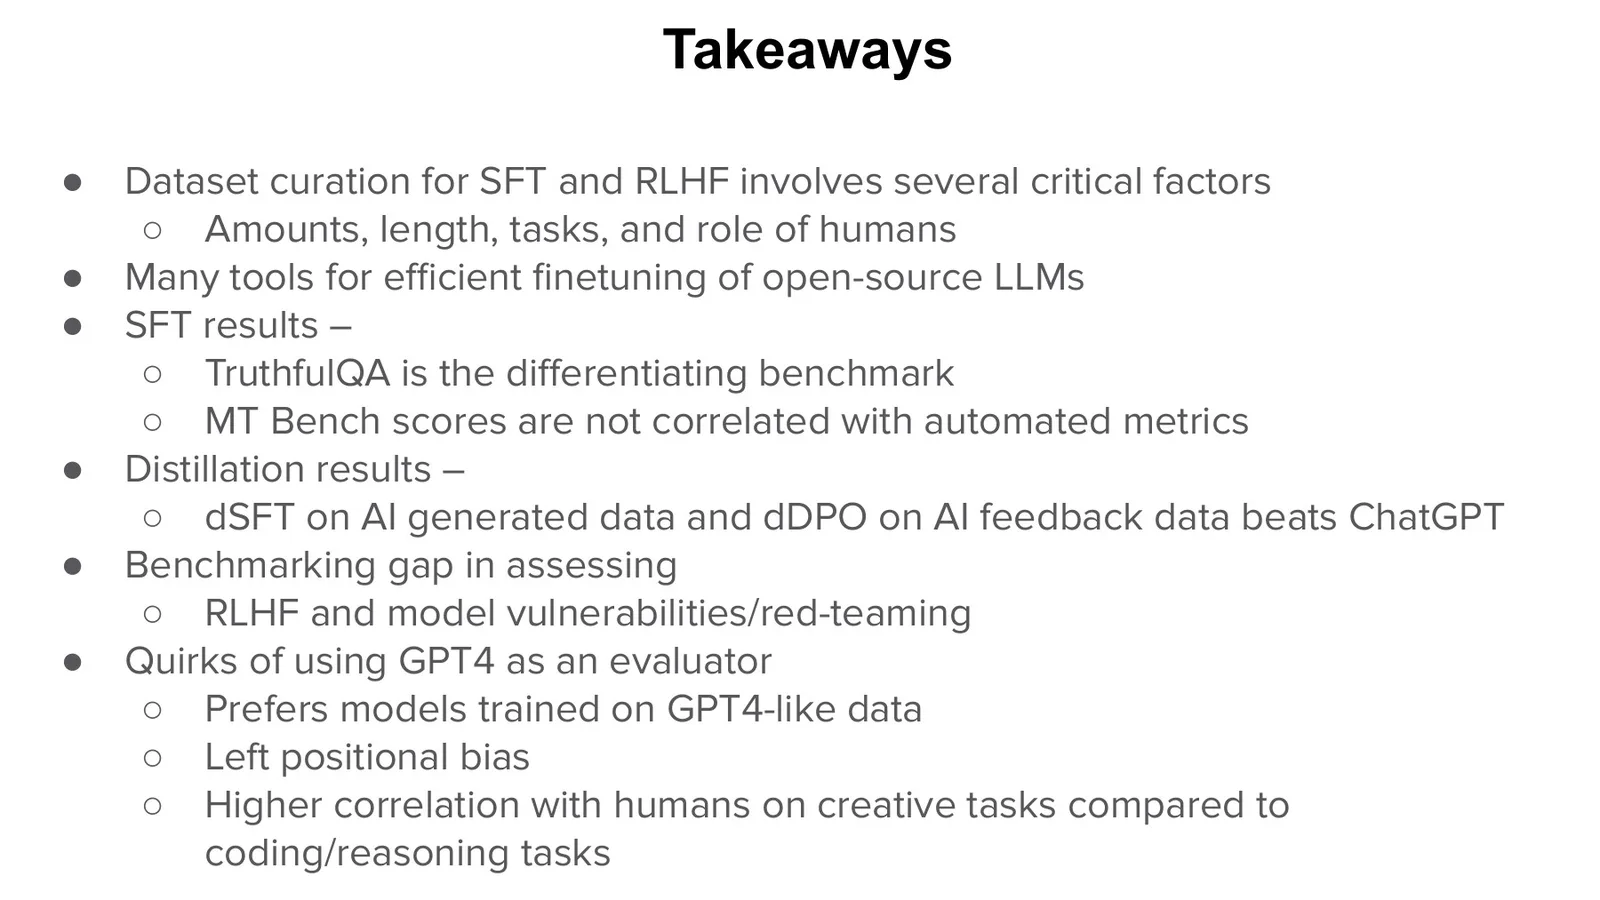
来源:官方幻灯片 p.66
读图:把 bullets 重排成因果链
Data amount/length/task/human role 决定训练分布;SFT 与 DPO 改变 policy;TruthfulQA、MT-Bench 等观察不同切面;RM/red-team benchmark 仍有缺口;GPT-4 judge 又受 data/style/position 影响。最后一组 quirks 会反向限制前面所有 leaderboard claim。
Public Labor 与 Institutional Context
上一小节完成了技术总结,本节保留讲者刻意放在结尾的社会与团队语境,回答“谁生产数据、谁承担治理、谁提供复现资源”。读这组页面时应把它们视为 provenance 与责任边界,而不是新的 benchmark evidence。课堂用新闻报道、UN advisory body 与 H4 resources 收尾;这些页面不是性能证据,却提醒 alignment recipe 背后有人类劳动、治理与开源协作,省略它们会把系统误写成纯算法流程。
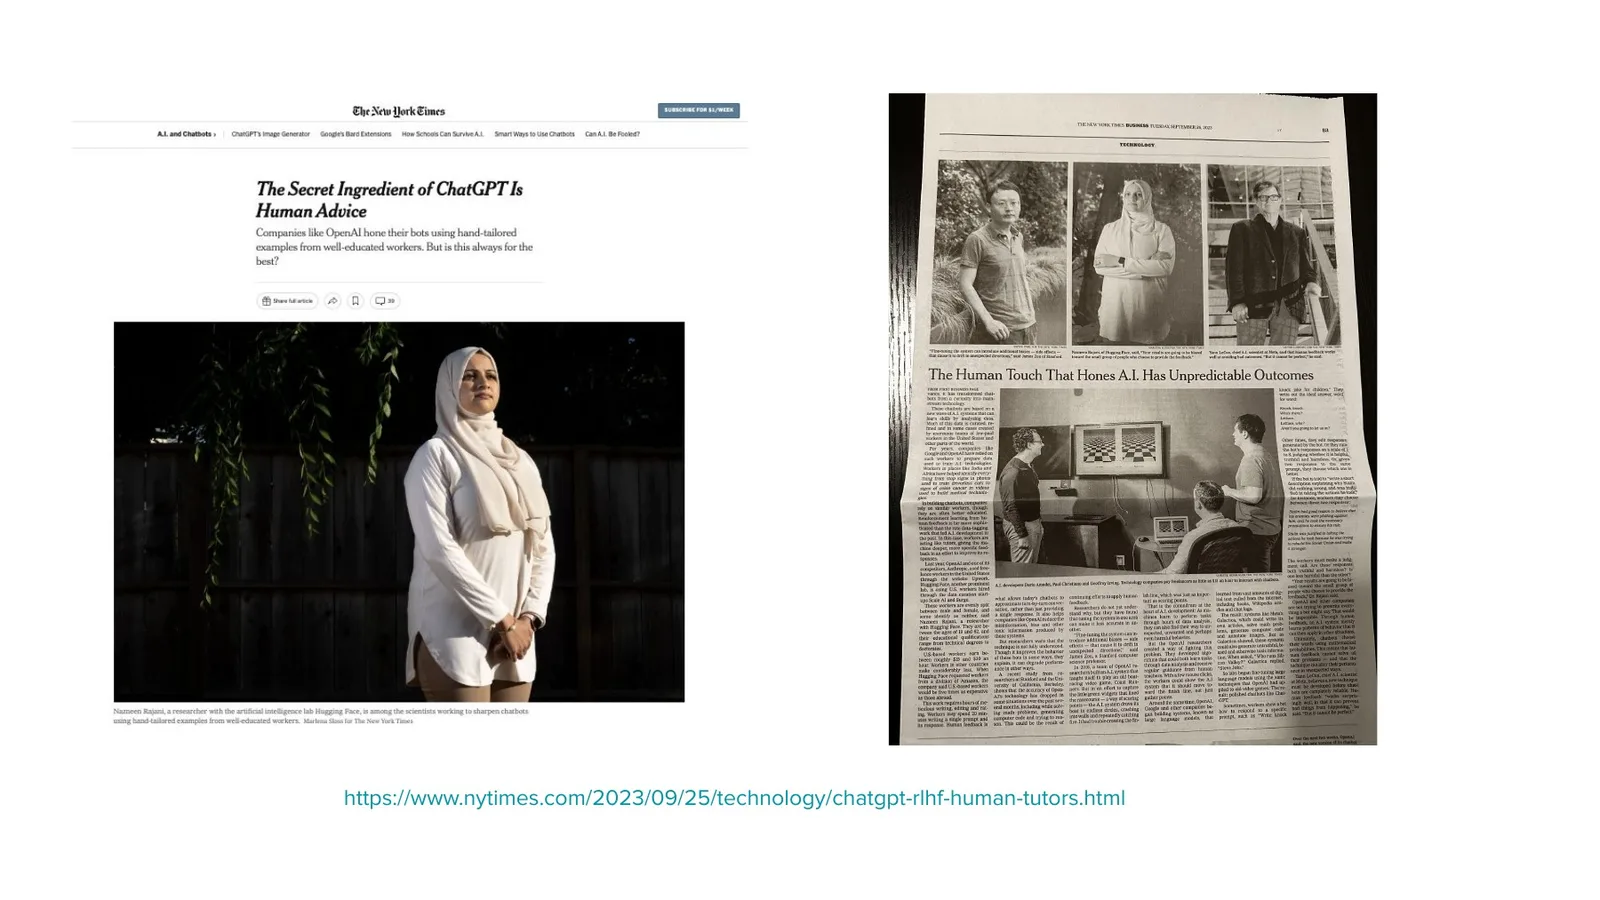
来源:官方幻灯片 p.67
读图:Alignment 的“secret ingredient”包含 labor system
Data guidelines、vendor management、质量审核和 annotator welfare 都影响最终模型。把它们隐藏为一个 dataset name,会让可复现性、成本和责任边界同时消失。
来源:官方幻灯片 p.68
读图:Institutional role 说明问题超出 benchmark
Chatbot helpfulness/safety 牵涉全球语言、劳动、治理与公共利益。该页记录 2023 课堂背景,不用于证明任何技术结论;它提醒我们 evaluation target 最终来自社会选择。
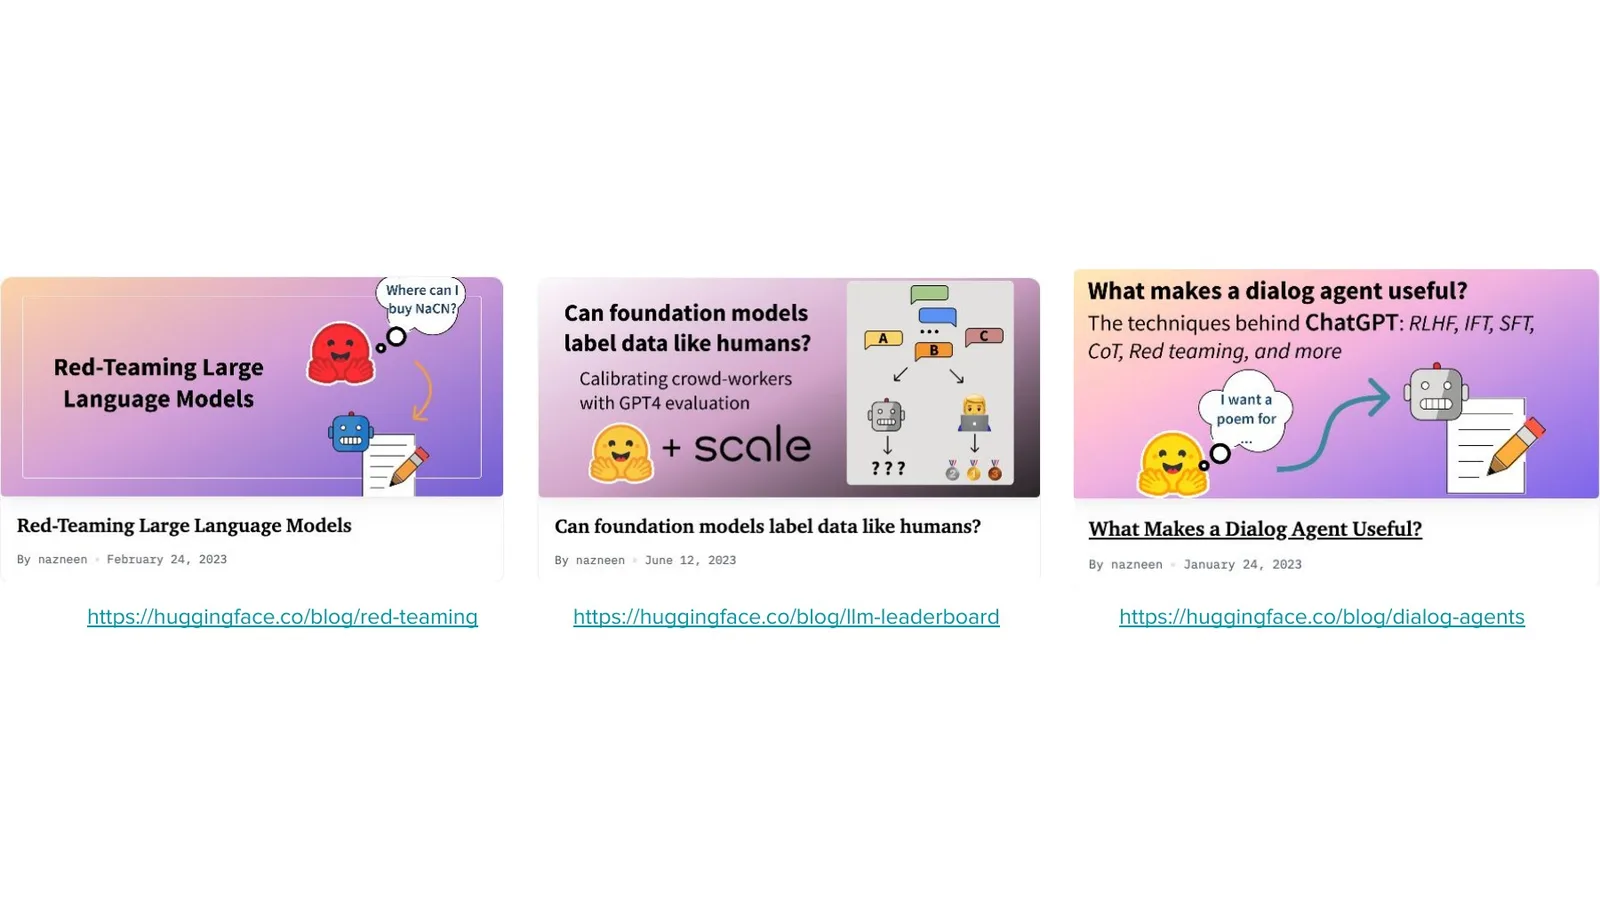
来源:官方幻灯片 p.69
读图:三个链接对应三种复现入口
Red teaming 资源面向漏洞发现,LLM leaderboard 面向 evaluator audit,dialog agents 面向训练实践。读者应从原始方法和数据说明复现实验,而不是只抄榜单数字。
来源:官方幻灯片 p.70
读图:研究结果是团队与社区产物
数据、训练、评估和发布由不同成员共同完成。保留 attribution 不只是礼貌,也帮助追踪代码、数据、paper 与 blog 的来源,避免把所有判断错误归到单一讲者或模型。
Q&A:成本与 Scale 只能按单位解释
Rajani 在 Q&A 中估计,向 Surge/Scale AI 购买约 20K preference dialogues 与约 10K demonstrations 的总成本约为 50 万美元。这个数字依赖 2023 vendor、任务、轮数和质量流程;它的教学意义是人工数据成本足以改变研究路线,而不是给出当前市场报价。
课堂提示
讲者比较 synthetic generation 与 vendor data 时说,前者更 cost-effective;human collection 大约花费 half a million dollars。这里的单位分别是 dialogues、prompts 与 demonstrations,不能混成“30K samples”。
Pair-order bias 的实用 mitigation 是让每个 model 同等概率出现在左右两侧,并在不同 prompts 上生成 reversed ordering。它降低一阶 position effect,却不解决 judge style bias、task verification 和 data coupling。
课堂提示
面对“哪些 prompts 造成 bias”的提问,讲者坦言团队没有系统研究。她区分了 observed left bias 与 speculative cause,并把 balanced ordering 作为工程缓解,而不是宣称已找到机制解释。
最后一个问题追问 reward model 如何给 RL policy 信号。课堂用“对完整 sequence 给分、反复采样优化”的直觉解释,并对比约 100K RLHF examples 与约 10K SFT examples 的数量级。
课堂提示
10K/100K 是讲者现场的 order-of-magnitude intuition:preference/RL pipeline 需要大量 sampled comparisons,SFT demonstration 更直接。它不能脱离 model、task、turn count 与 label unit 写成 sample-complexity theorem。
本章小结
Recipe 的真实成本包括人类劳动、数据治理与 evaluator validation。Q&A 提供了规模直觉和未解问题,也再次证明所有数字必须连同单位、协议和证据级别一起记录。
总结与延伸
本讲可以压缩成一句话:训练 helpful chatbot 不是选择一个 optimizer,而是共同设计 data distribution、preference protocol、training objective 与 measurement system。 H4 human-data experiments 与 Zephyr synthetic-data pipeline 展示两条可行路线;GPT-4 evaluator audit 则证明,若 measurement 与 training data 同源,排行榜会奖励 style matching 而非真实目标。
十一条可执行结论
- 报告 dataset provenance:谁写 prompt、谁写 completion、谁过滤。
- 用 task/length/turn distribution 描述数据,不只报 example count。
- 区分 demonstration、preference pair 与 policy rollout 的计数单位。
- SFT 先建立 instruction-following;DPO/RLHF 通常是 refinement,不是替代地基。
- Human-written 与 synthetic data 的错误相关性不同,应保留异构 holdout。
- Reward model 必须在新 generators、难分 pairs 与 held-out tasks 上评估。
- 同时报告 task metrics、human preference、LLM judge 与 response statistics。
- 遇到 metric reversal 不要挑赢家,要定位 evaluator preference。
- LLM judge 必须做 order swap、length control、human calibration 与 task stratification。
- Red teaming 测尾部风险,不能被平均 helpfulness score 代替。
- 成本、规模和 leaderboard 都必须标注日期、单位与 protocol。
最终系统视角
一条 alignment pipeline 可以写成闭环:
Evaluator 的偏差会决定下一轮收什么数据,因此 measurement error 会被重新写回 training distribution。真正的工程目标不是一次赢榜,而是让闭环可审计、可校准、可纠错。
拓展阅读
- Ouyang et al., Training language models to follow instructions with human feedback:SFT、reward modeling 与 PPO/RLHF 基础流程。
- Wang et al., Self-Instruct;Ding et al., UltraChat;Li et al., CAMEL:三种 synthetic instruction/dialogue generation 路线。
- Tunstall et al., Zephyr: Direct Distillation of LM Alignment:dSFT、AI feedback 与 dDPO。
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena:LLM judge、position bias 与 human agreement。
- Hugging Face H4, LLM evaluator bias analysis 与 red-teaming workflow:课堂 slides 的官方实践入口。