Lecture 26:Overview of Transformers
课程定位与 NLP 历史:Transformer 不是凭空出现的
这堂 V4 开场课承担两个任务。第一,它给后续嘉宾讲座建立共同词汇:attention、large language model、alignment、reasoning 与 agent。第二,它展示一条尚未收束的研究路线:模型能力快速扩张,但数据效率、持续学习、记忆、可靠性和安全边界仍然缺口明显。阅读时应把 2024 年课堂中的产品例子与更稳定的机制分开,前者是时间点证据,后者才是可迁移的知识。
来源:官方 CS25 V4 slide deck,第 1 页
读图:Overview 不是“快速过一遍名词”
标题页列出四位课程组织者,后续内容也确实由不同讲者分段完成。它覆盖历史、机制、应用、弱点、推理与 agent,因此更像一张课程地图。讲义会补足公式和系统边界,但不会把课堂未出现的 dashboard、incident runbook 或合规流程塞回去。
课堂提示
开场说明 CS25 的目标不是重复教材,而是让正在做研究的人直接解释新结果,使学生能够把想法带回自己的研究或形成合作。这个定位决定了课堂会并列呈现共识、开放问题和讲者个人判断。
课程希望学生带走什么
技术概览容易退化为模型名称列表。课程给出的学习目标更具体:理解 Transformer 怎样工作,理解它为何能跨越 NLP,识别前沿研究方向,并持续追问剩余的弱点。这个框架要求我们既解释成功条件,也解释失败边界。读下面的目标页时,先看四个动词分别指向 mechanism、application、research 与 limitation,而不是把它当作课程宣传页。
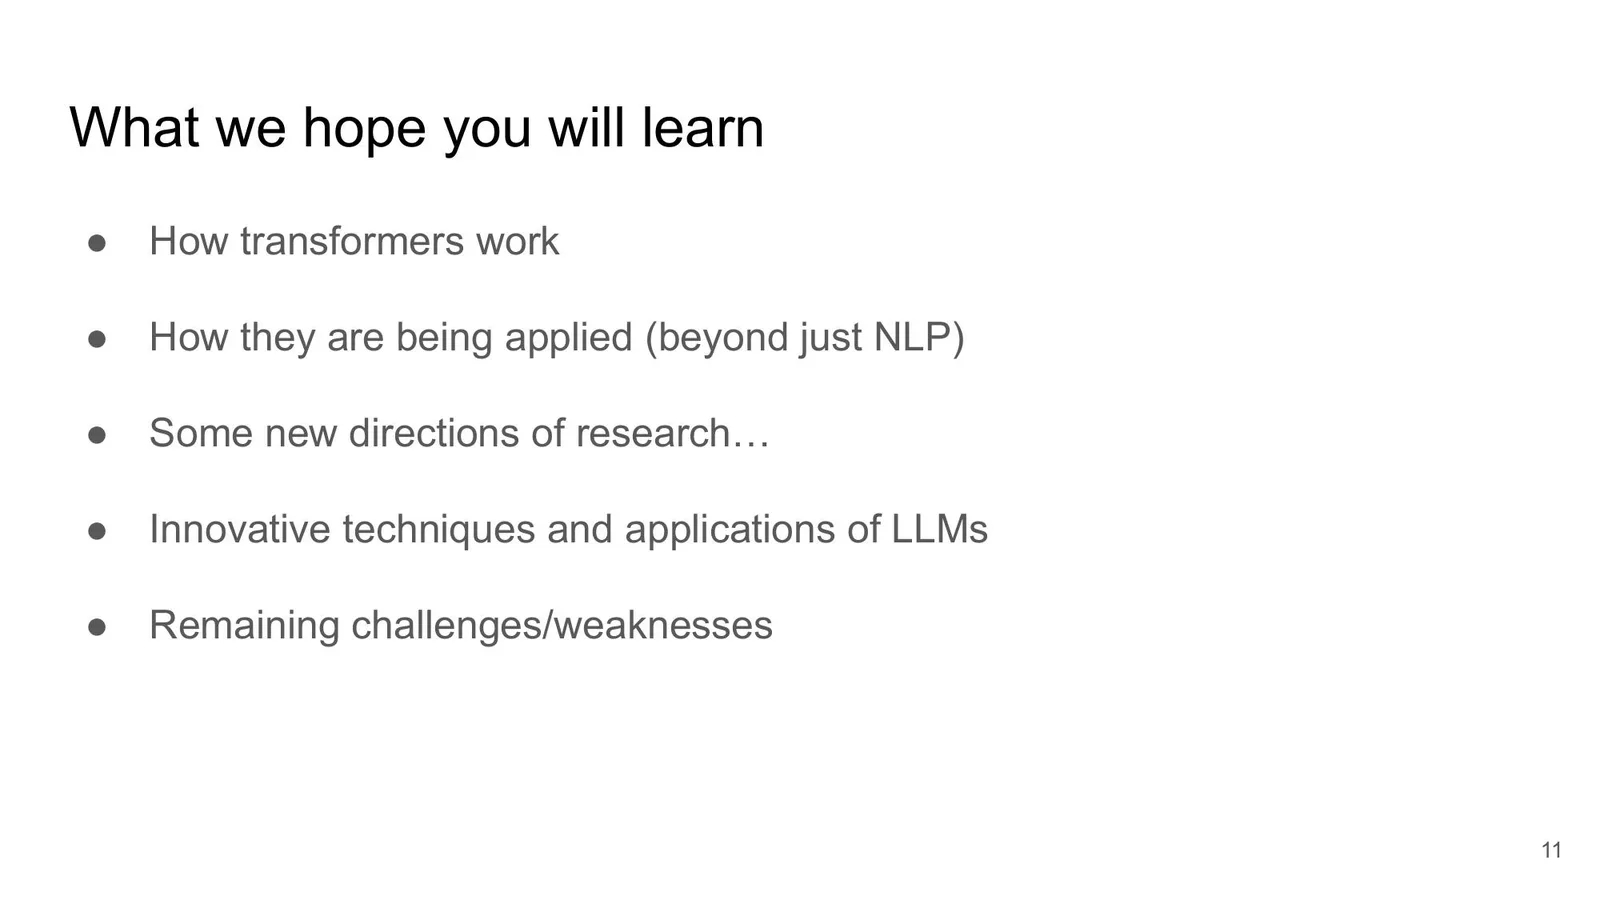
来源:官方 CS25 V4 slide deck,第 11 页
本讲的四条主线
- Mechanism:attention、self-attention、multi-head 与 cross-attention 怎样传递信息;
- Scale and training:参数、数据、alignment 与 preference optimization 怎样塑造能力;
- Adaptation:记忆、检索、持续学习、model editing 与 reasoning scaffold 怎样补模型缺口;
- System:agent、tool、memory、multi-agent communication 与 safety 怎样把模型变成可执行系统。
从 rule system 到 attention timeline
课程先给出时间轴,不是为了争论某项技术的“第一篇论文”,而是为了说明每一代方法在修补什么瓶颈。Rule-based NLP 把语言写成规则;word embedding 把离散词映成连续向量;RNN/LSTM 处理序列;attention 让模型对不同位置分配不同权重;Transformer 再把 attention 变成主体计算结构。
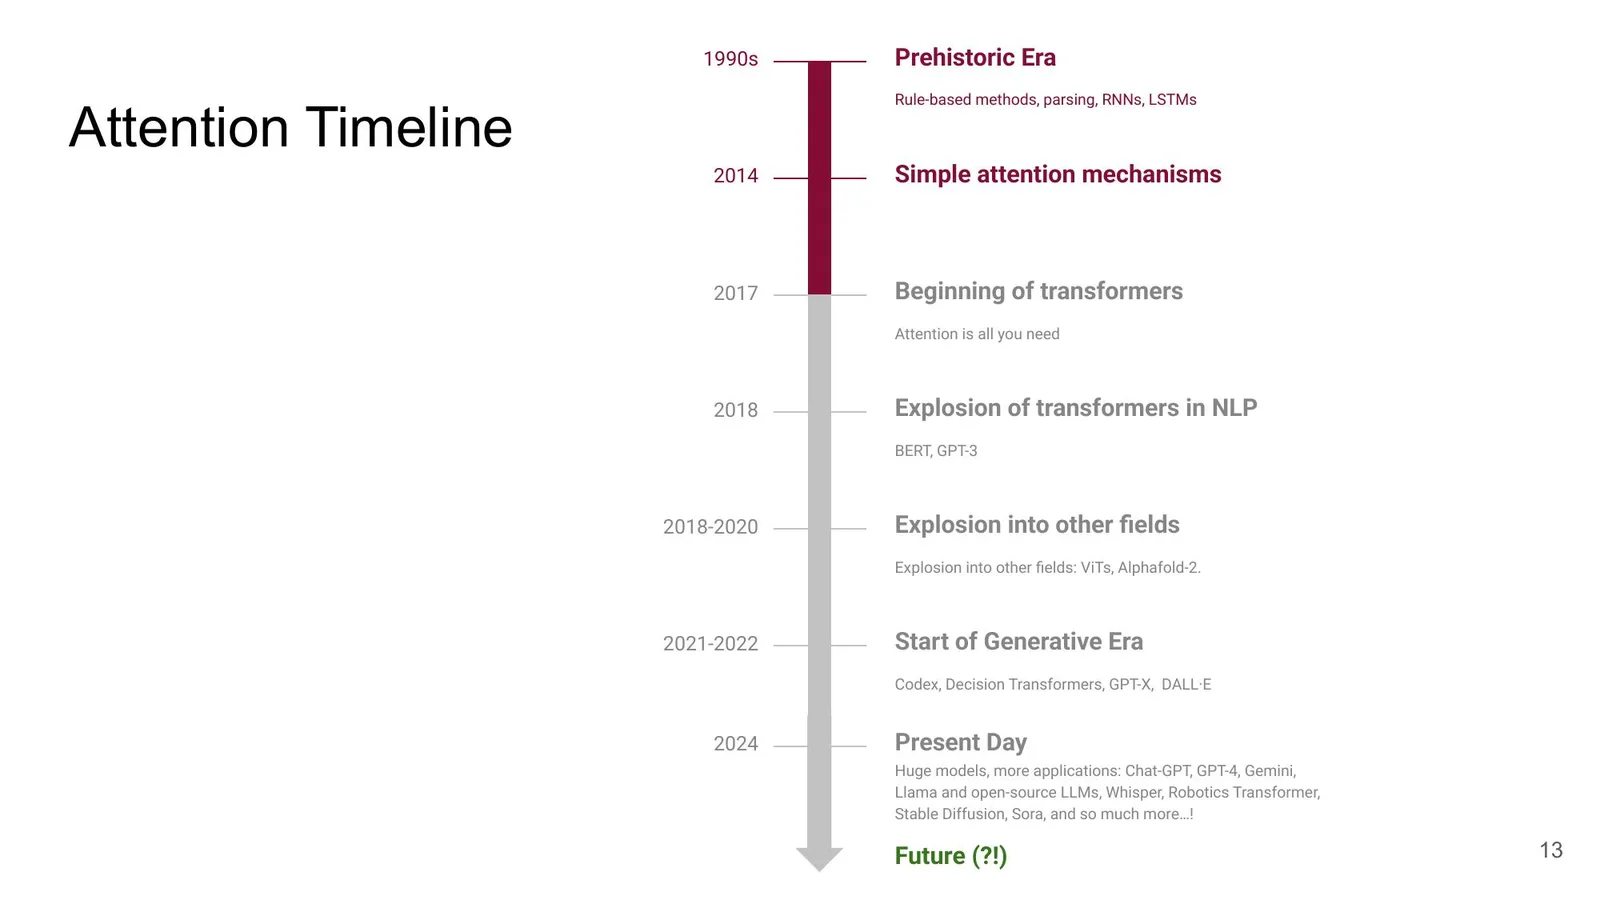
来源:官方 CS25 V4 slide deck,第 13 页
术语消化:时间轴上的五个台阶
| 阶段 | 它主要解决的问题 |
|---|---|
| Rule-based system | 用人工规则编码句法与语义,透明但覆盖脆弱,迁移成本高。 |
| Word embedding | 用连续向量表达相似性,使模型能共享词之间的统计结构。 |
| RNN/LSTM | 用 recurrent state 处理可变长序列,但训练串行,长距离信息容易衰减。 |
| Attention | 对输入位置做内容相关加权,不再把全部历史压进单个状态。 |
| Transformer | 以 attention 和前馈网络为主干,扩大并行训练和规模化的空间。 |
来源:官方 CS25 V4 slide deck,第 14 页
历史页不支持“旧方法完全无用”
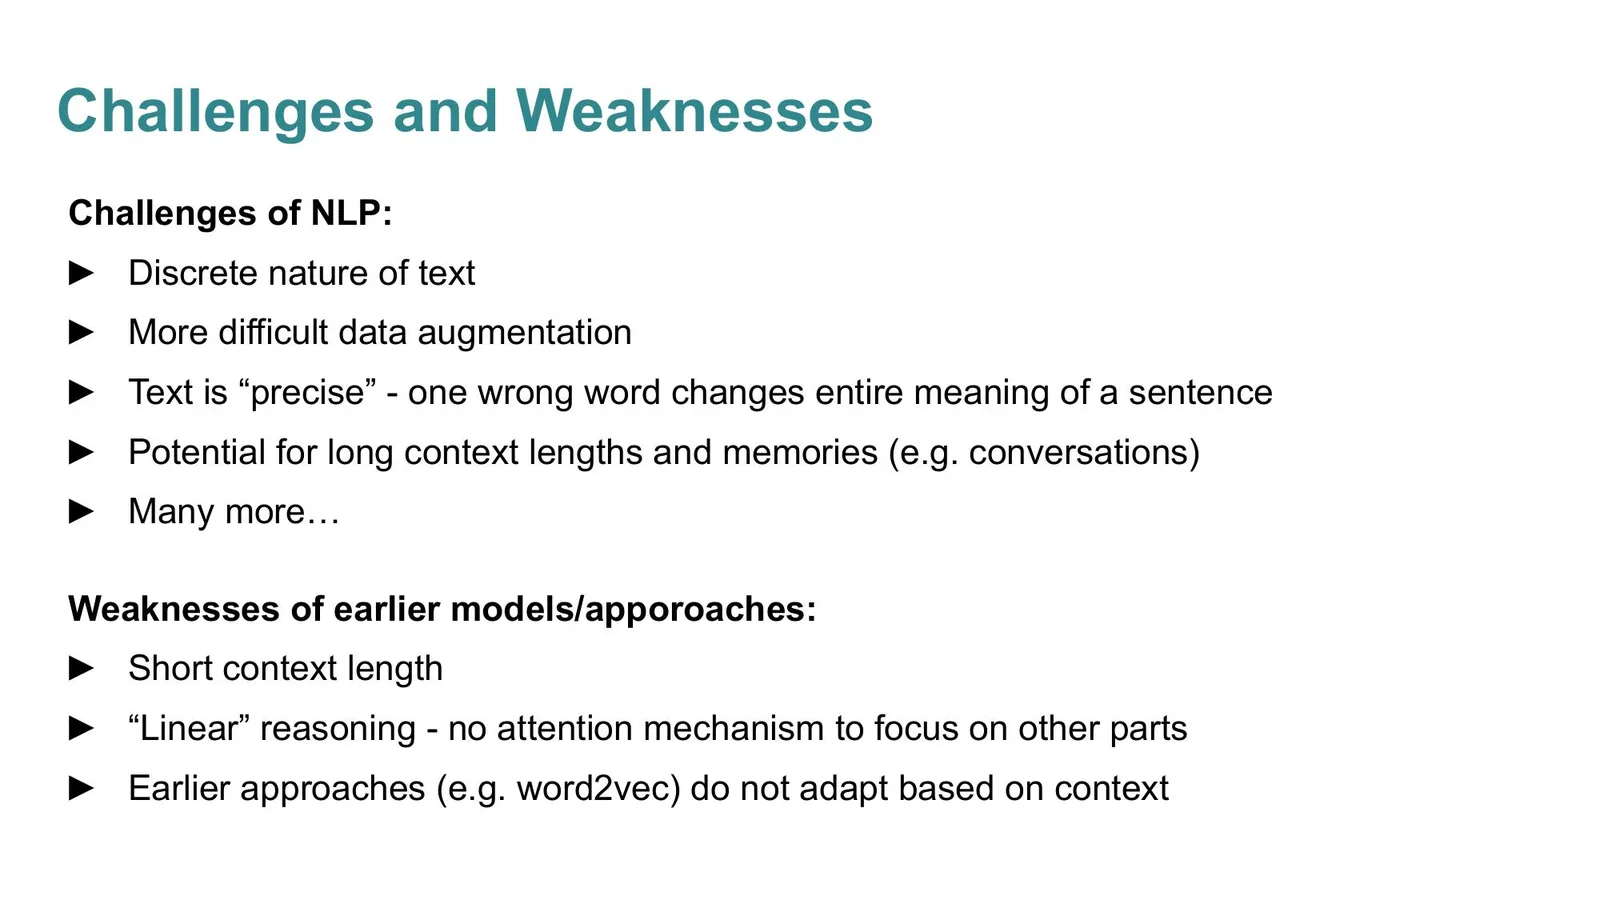
规则、词典、检索、有限状态机和传统特征仍然适合高约束任务。Transformer 的优势在于端到端表示学习和规模化,不是让所有结构化方法失效。工程系统通常会把 learned model 与规则、数据库、验证器一起使用。
来源:官方 CS25 V4 slide deck,第 15 页
来源:官方 CS25 V4 slide deck,第 16 页
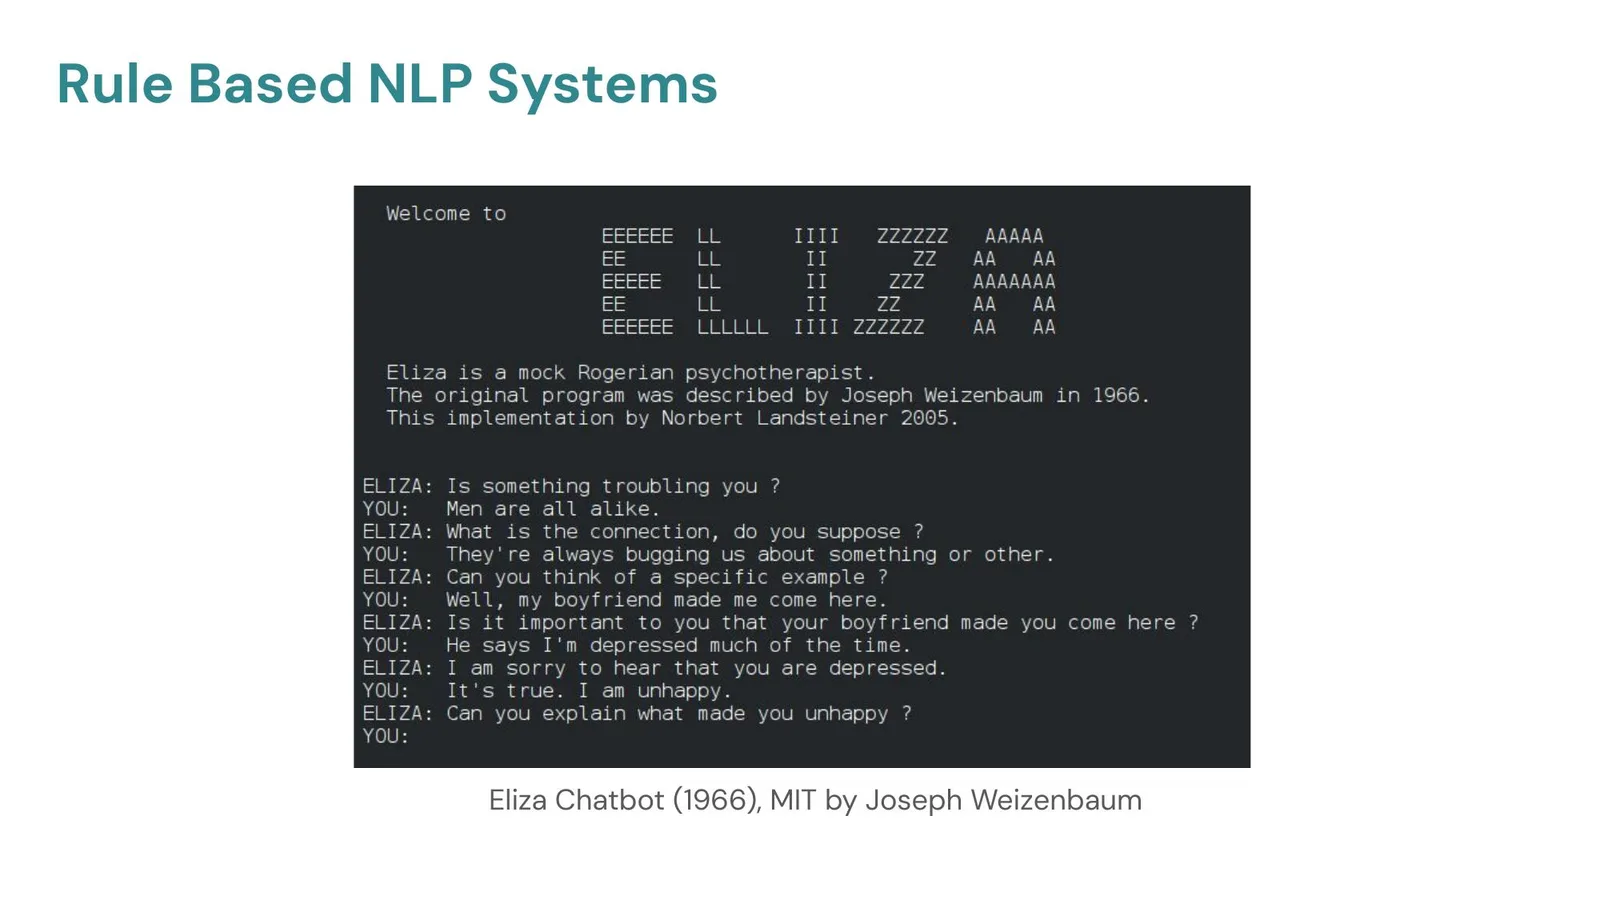
读图:ELIZA 为什么能“像在对话”
ELIZA 使用模式匹配与模板重写,把用户句子中的片段填入预设回答。它说明表面流畅不等于内部理解:只要交互形式足够合适,有限规则也能制造连贯感。今天评估 LLM 时,同样不能把语言自然度直接等同于事实性、推理正确性或行动可靠性。
来源:官方 CS25 V4 slide deck,第 17 页
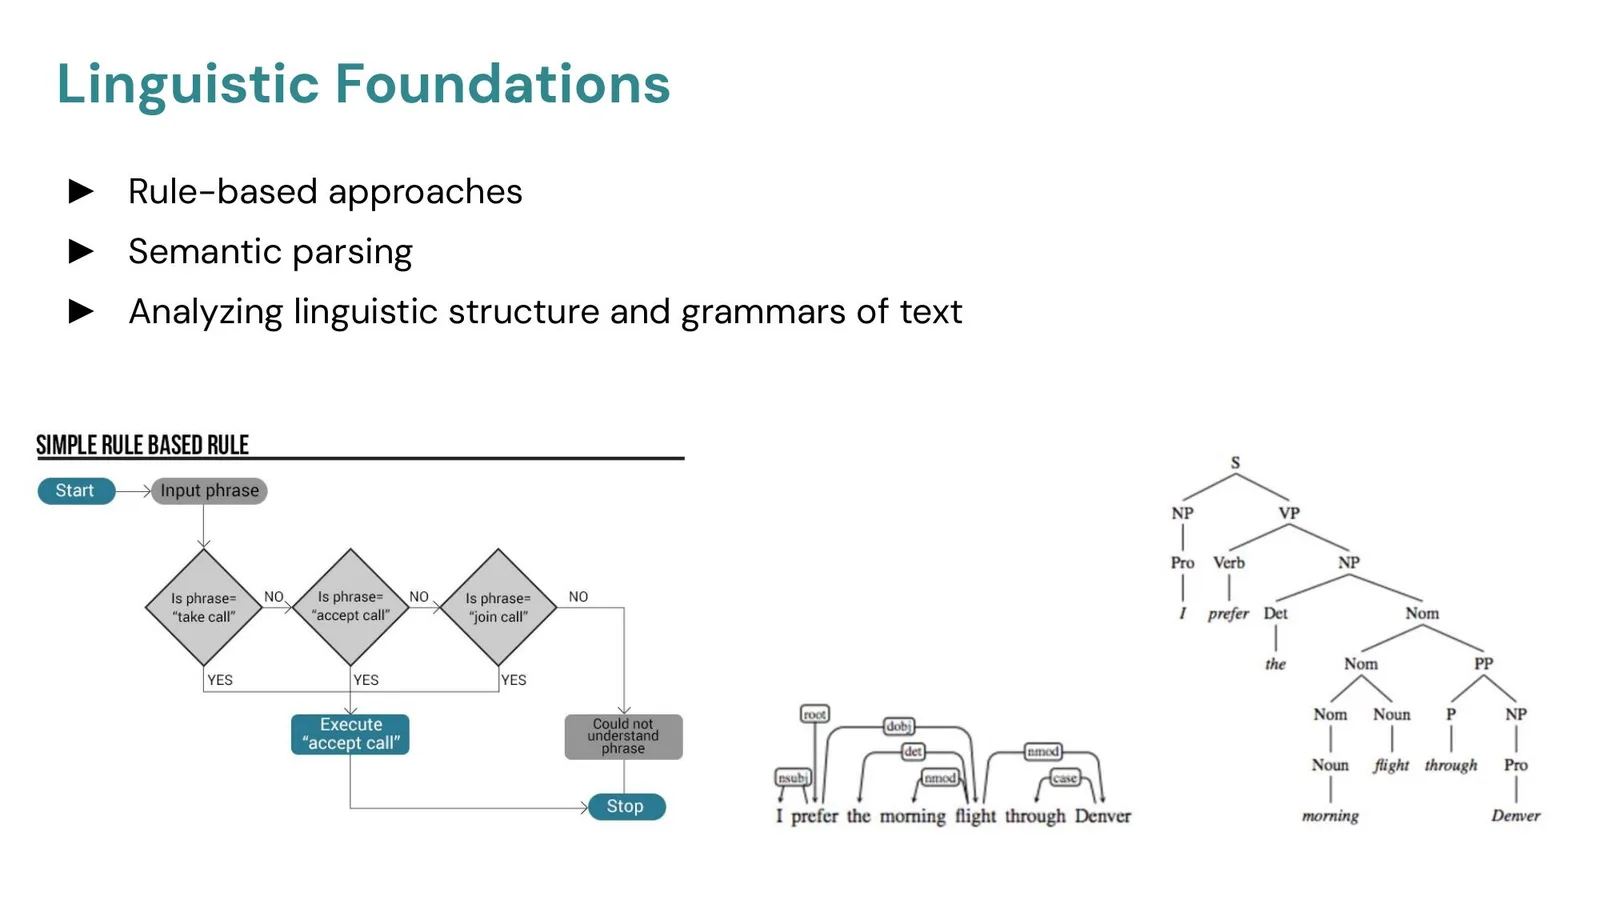
结构知识仍然有价值
Semantic parsing 把自然语言映射成逻辑形式或可执行表示。现代 LLM 可以减少手写规则,却没有消除结构需求:tool calling 的 schema、SQL、程序、证明步骤和 agent protocol 都是在重新引入可验证结构。
来源:官方 CS25 V4 slide deck,第 18 页
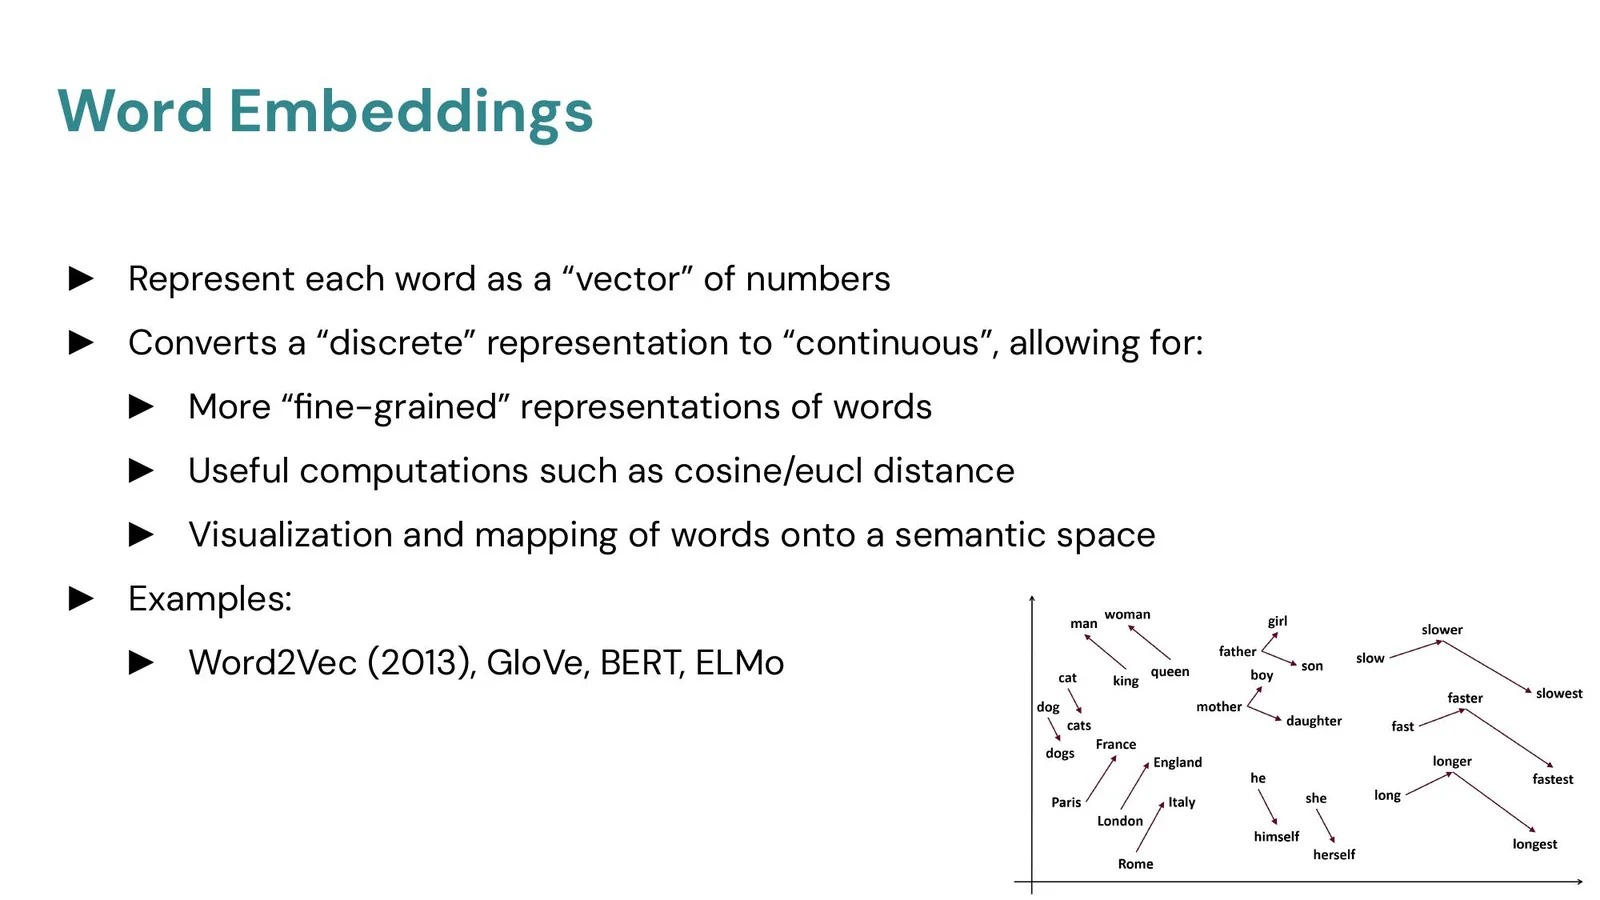
Embedding 的最小定义
设词表项 \(w\) 的向量为 \(e_w\in\mathbb{R}^{d}\)。Embedding(嵌入)把离散符号映射到 \(d\) 维连续空间,使相似词在某种训练目标下获得接近的表示。常见相似度是
其中 \(e_i,e_j\) 是两个 token 或对象的向量,分子是内积,分母消除向量长度影响。接近只表示表示空间中的相关性,不自动等于事实关系或因果关系。
本章小结
Transformer 的历史位置可以压缩成一句话:它把“从序列中选择相关信息”提升为可并行、可堆叠、可扩展的主要计算模式。后续能力并非来自单一公式,而是 architecture、data、optimization、hardware 与 interface 共同演化的结果。
Attention 与 Transformer:信息怎样被选择和组合
前一章回答“为什么会走到 Transformer”,本章回答“它具体做了什么”。课堂从 seq2seq 进入 Q/K/V,再区分 self-attention、multi-head attention 与 cross-attention。理解这些差异,才能在后面判断 decoder-only LLM、encoder–decoder、retrieval 与 agent memory 的接口位置。
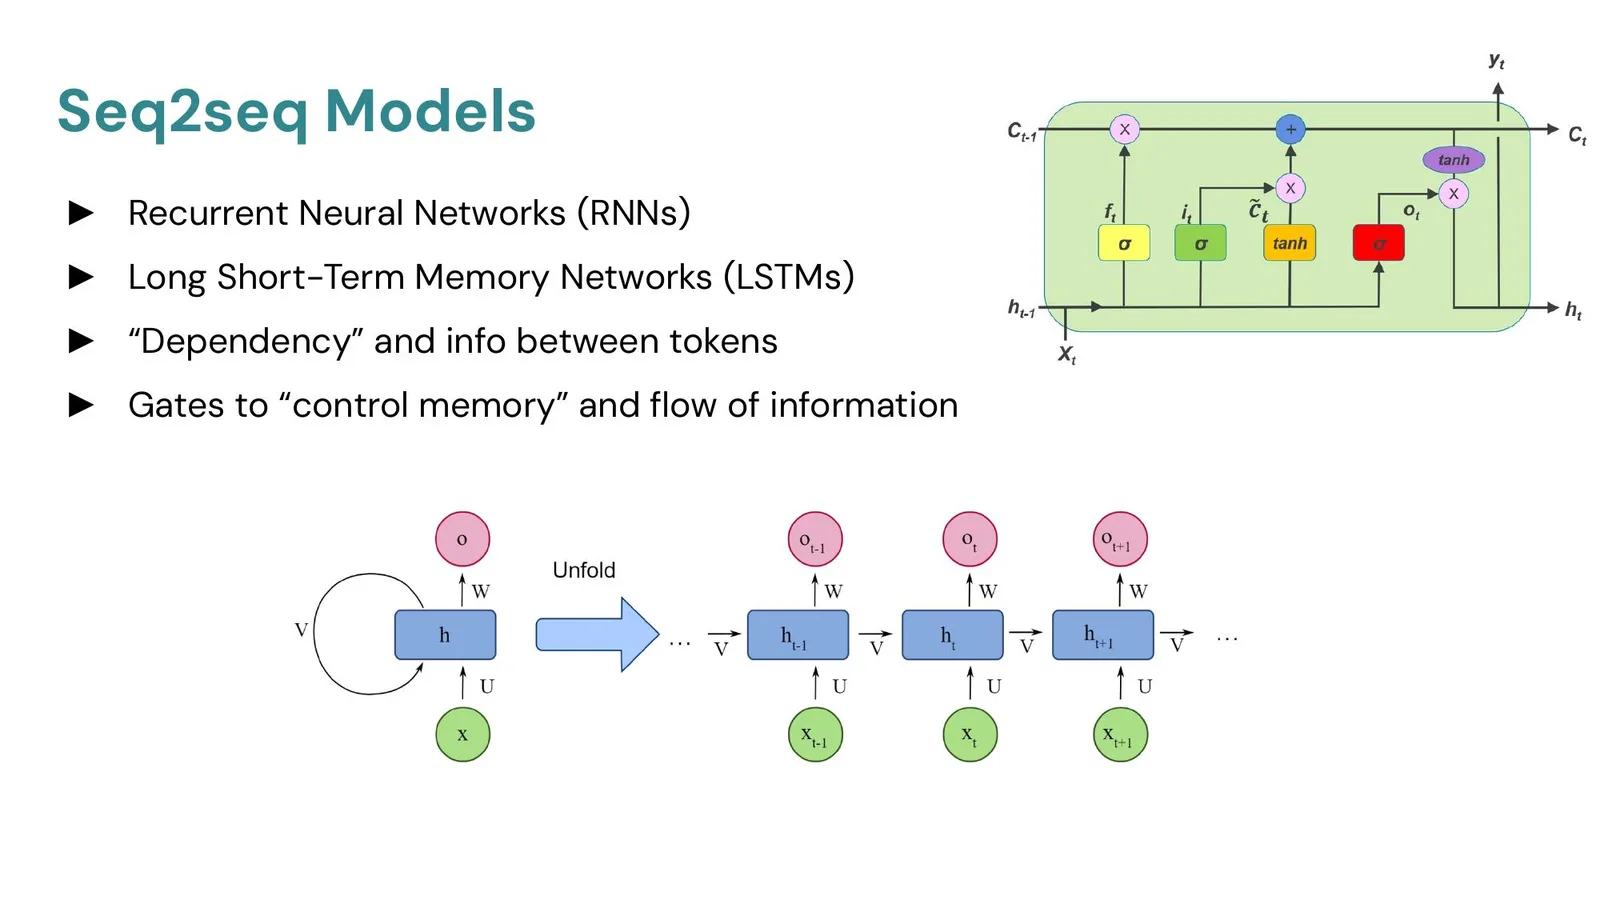
Seq2seq 的瓶颈:单个 state 承担太多
早期 sequence-to-sequence(序列到序列)模型用 encoder 把输入压进隐藏状态,再由 decoder 逐步生成。长度增加时,单个向量必须同时保存词义、顺序与远距离依赖,信息瓶颈会越来越明显。下面两页先展示 recurrent path,再展示 attention 增加的直接读通路;比较重点是信息从哪里流向 decoder。
来源:官方 CS25 V4 slide deck,第 19 页
Recurrent update
最简 RNN 可以写成
\(x_t\) 是第 \(t\) 个输入,\(h_t\) 是隐藏状态,\(W_x,W_h,W_o\) 是可学习矩阵,\(\phi\) 是非线性函数。每一步依赖 \(h_{t-1}\),因此时间维难以完全并行;长序列还要让梯度穿过很多 recurrent steps。
来源:官方 CS25 V4 slide deck,第 20 页
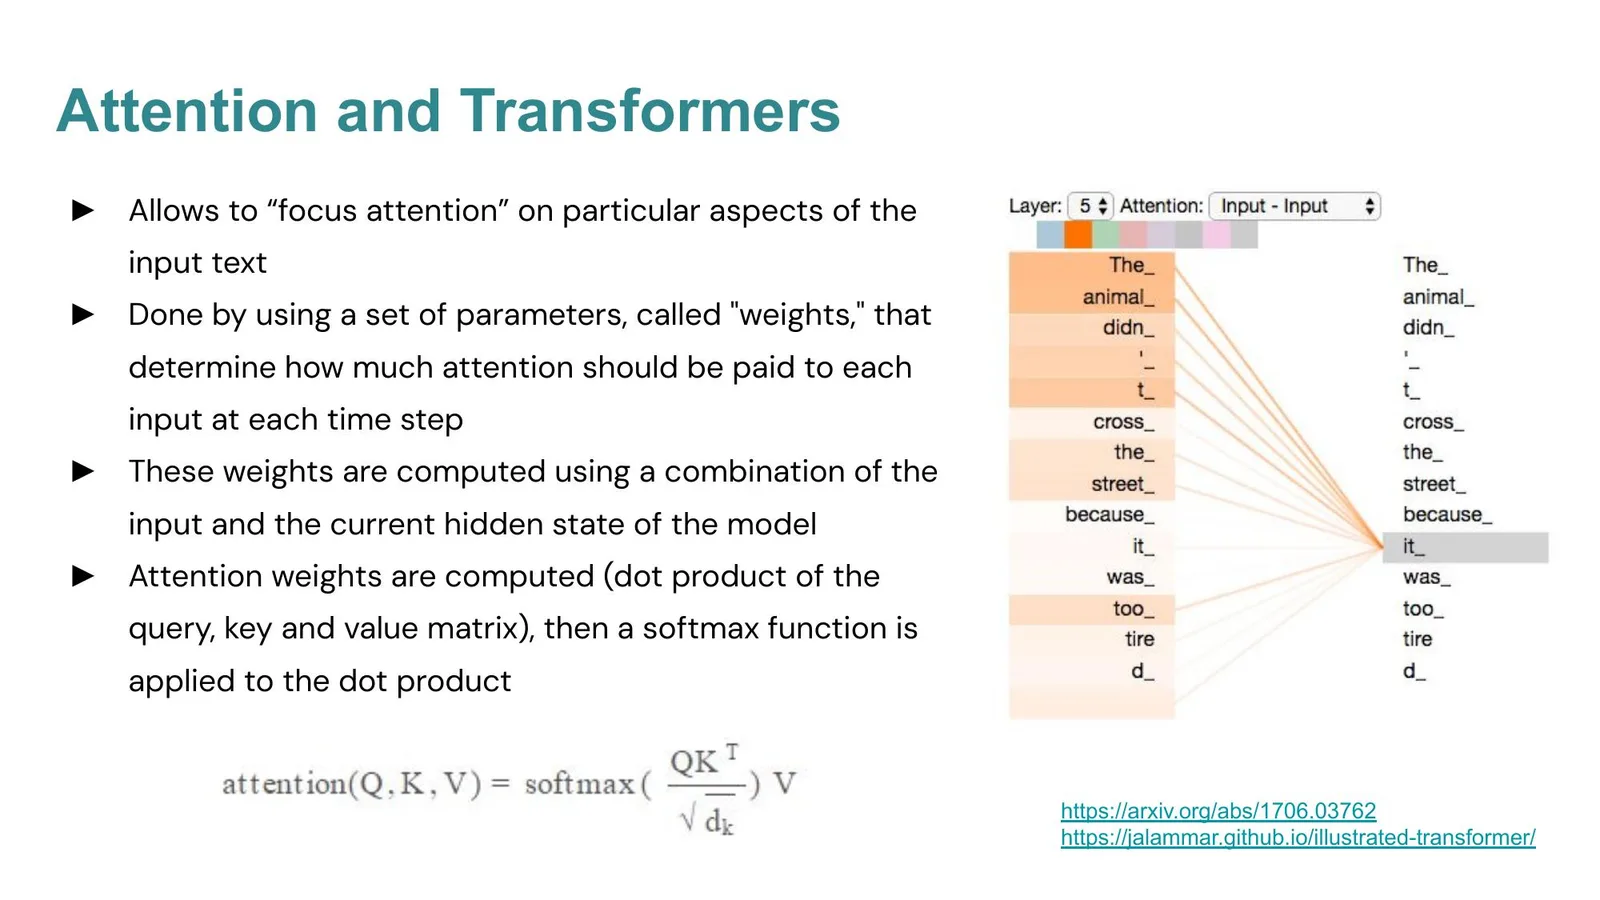
读图:Attention 改变的是信息通路
没有 attention 时,decoder 主要依赖最终 encoder state;加入 attention 后,每个输出位置都能对全部输入位置打分并做加权求和。模型不再被迫把整句压成一个固定瓶颈,而是按当前生成需求重新读取输入。
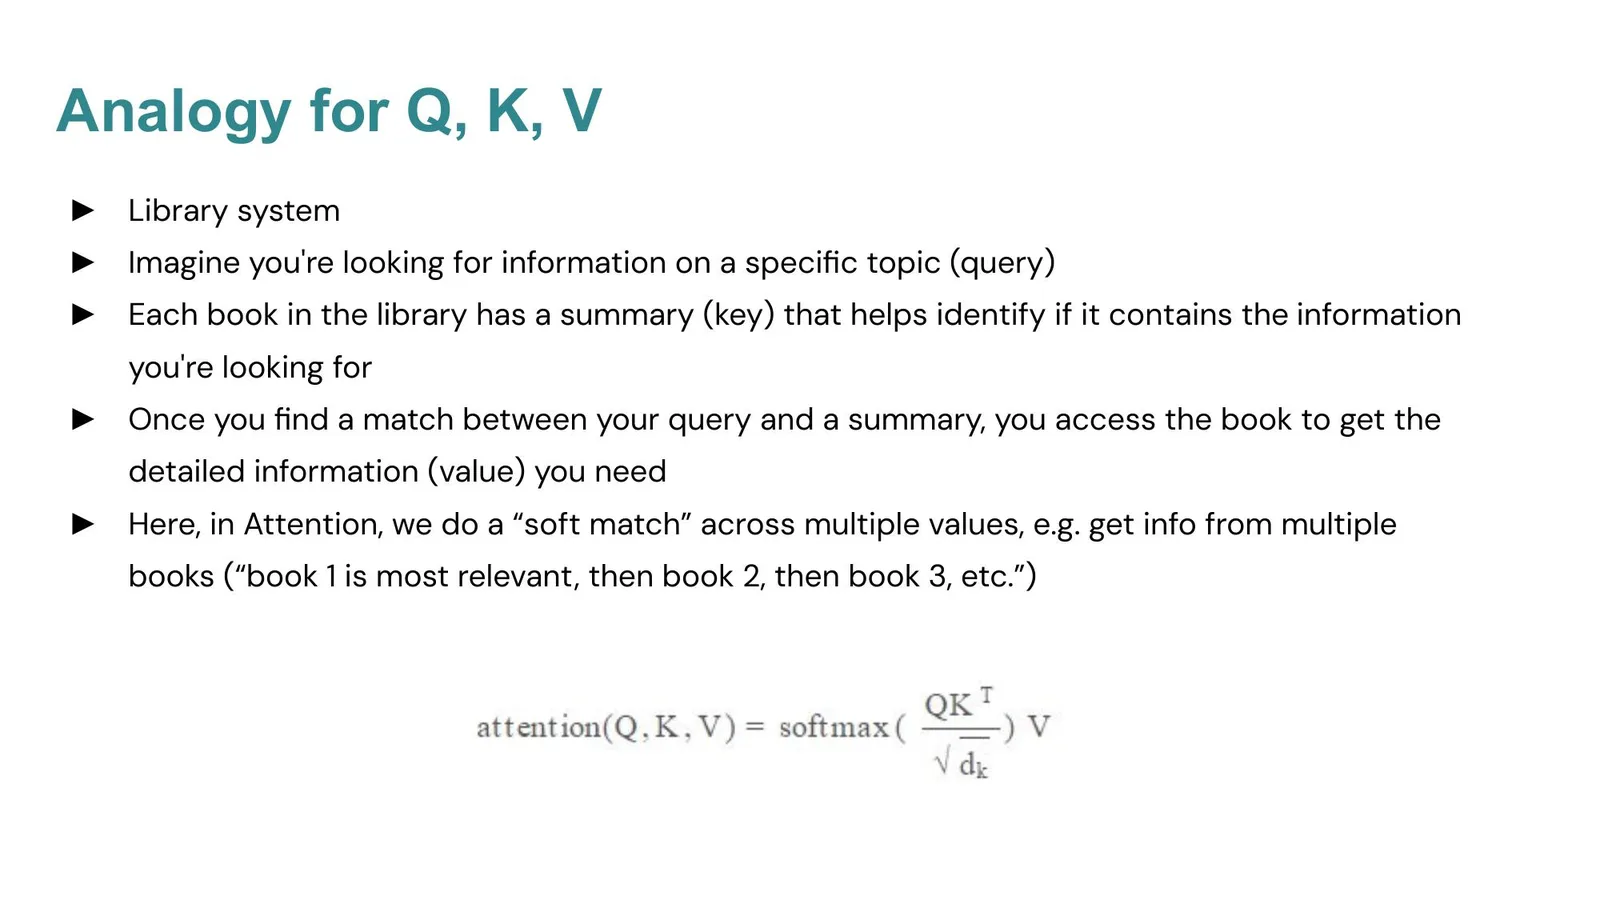
Q、K、V:查询、索引与内容
课堂用 library system 类比 Query、Key、Value。读者提出查询,书目索引承担 key,书中内容承担 value。模型先比较 query 与各 key 的相关性,再用权重组合对应 value。读图时要把“检索到哪本书”和“从书中取出什么”分开,这正对应 key matching 与 value aggregation 两个步骤。
来源:官方 CS25 V4 slide deck,第 21 页
Scaled dot-product attention
令 \(Q\in\mathbb{R}^{n_q\times d_k}\)、\(K\in\mathbb{R}^{n_k\times d_k}\)、\(V\in\mathbb{R}^{n_k\times d_v}\),attention 为
\(QK^\top\) 给出每个 query 与 key 的匹配分数;\(\sqrt{d_k}\) 控制点积尺度;\(M\) 是可选 mask;softmax 把分数变成权重;最后对 \(V\) 做加权求和。Query 决定“现在要找什么”,Key 决定“我是否相关”,Value 决定“相关时提供什么内容”。
Attention weight 不是完整解释
权重展示了某层某头如何混合 value,但输出还经过 value projection、residual、MLP 和后续层。不能仅凭一张 attention map 就断言模型“因为什么做出决定”,更不能把高权重直接解释为因果贡献。
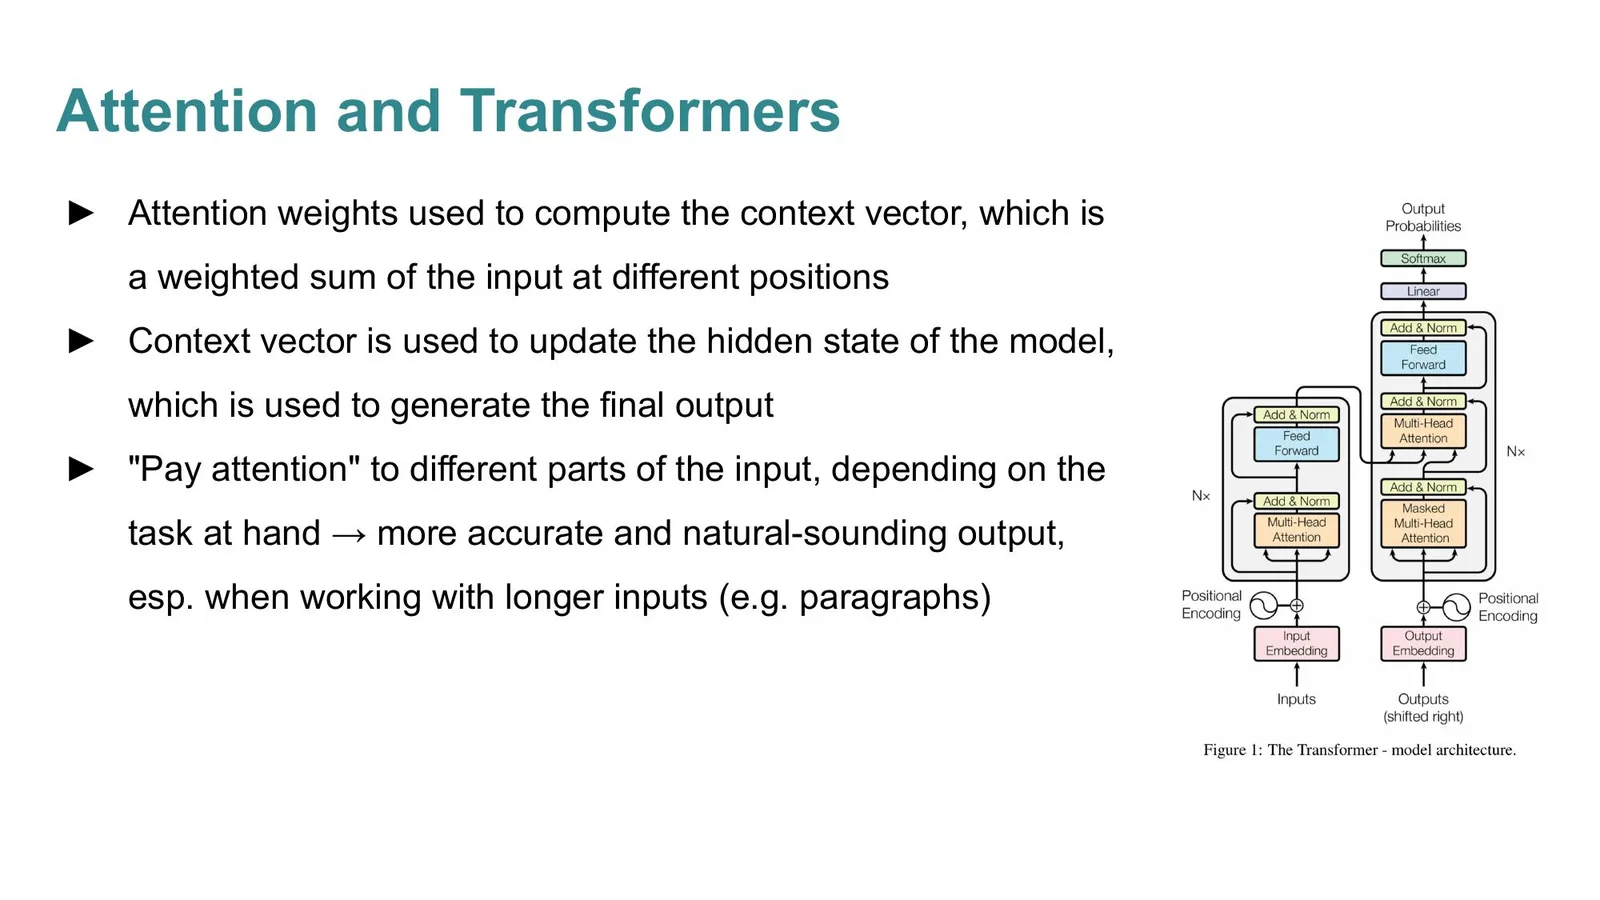
来源:官方 CS25 V4 slide deck,第 22 页
def attention(query, key, value, mask=None):
    scores = query @ key.transpose(-1, -2)
    scores = scores / sqrt(key.shape[-1])
    if mask is not None:
        scores = scores + mask
    weights = softmax(scores, dim=-1)
    return weights @ value, weights
课堂提示
讲者强调这是“soft match”:一个 query 不必只选一个 value,而可以从多个位置取信息。这个性质让 attention 与数据库精确匹配不同,也解释了它为什么能表达模糊、组合式的语言关系。
Self-attention 与 Multi-head attention
Self-attention(自注意力)让同一序列同时产生 \(Q\)、\(K\)、\(V\)。每个 token 都能根据内容读取其他 token;causal decoder 会用 mask 禁止读取未来位置。Multi-head attention(多头注意力)则让多个子空间并行学习不同的匹配模式。接下来的三页从单头连接、完整 block 到多头可视化逐层展开,先看信息来源,再看 projection 与融合。
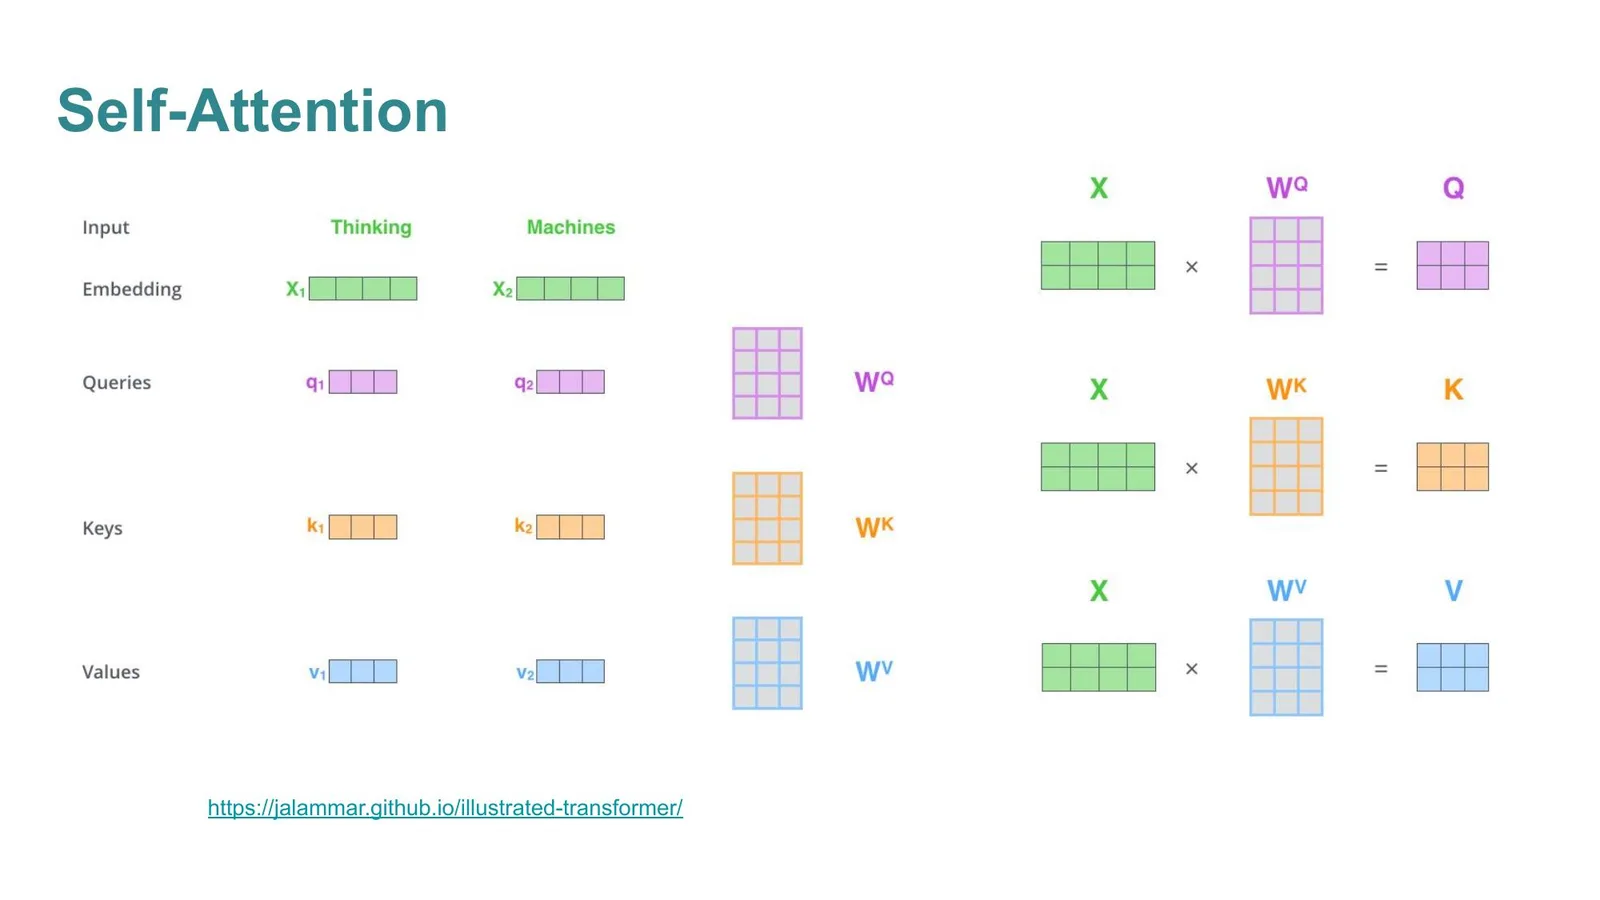
来源:官方 CS25 V4 slide deck,第 23 页
背景概念:self-attention 的三种常见 mask
| 形式 | 允许的信息流 |
|---|---|
| Bidirectional | 每个位置可读取整个输入,典型于 encoder。 |
| Causal | 位置 \(t\) 只能读取 \(\le t\) 的 token,典型于 autoregressive decoder。 |
| Block/sparse | 只允许局部块、全局 token 或预定义连接,用于降低长序列成本。 |
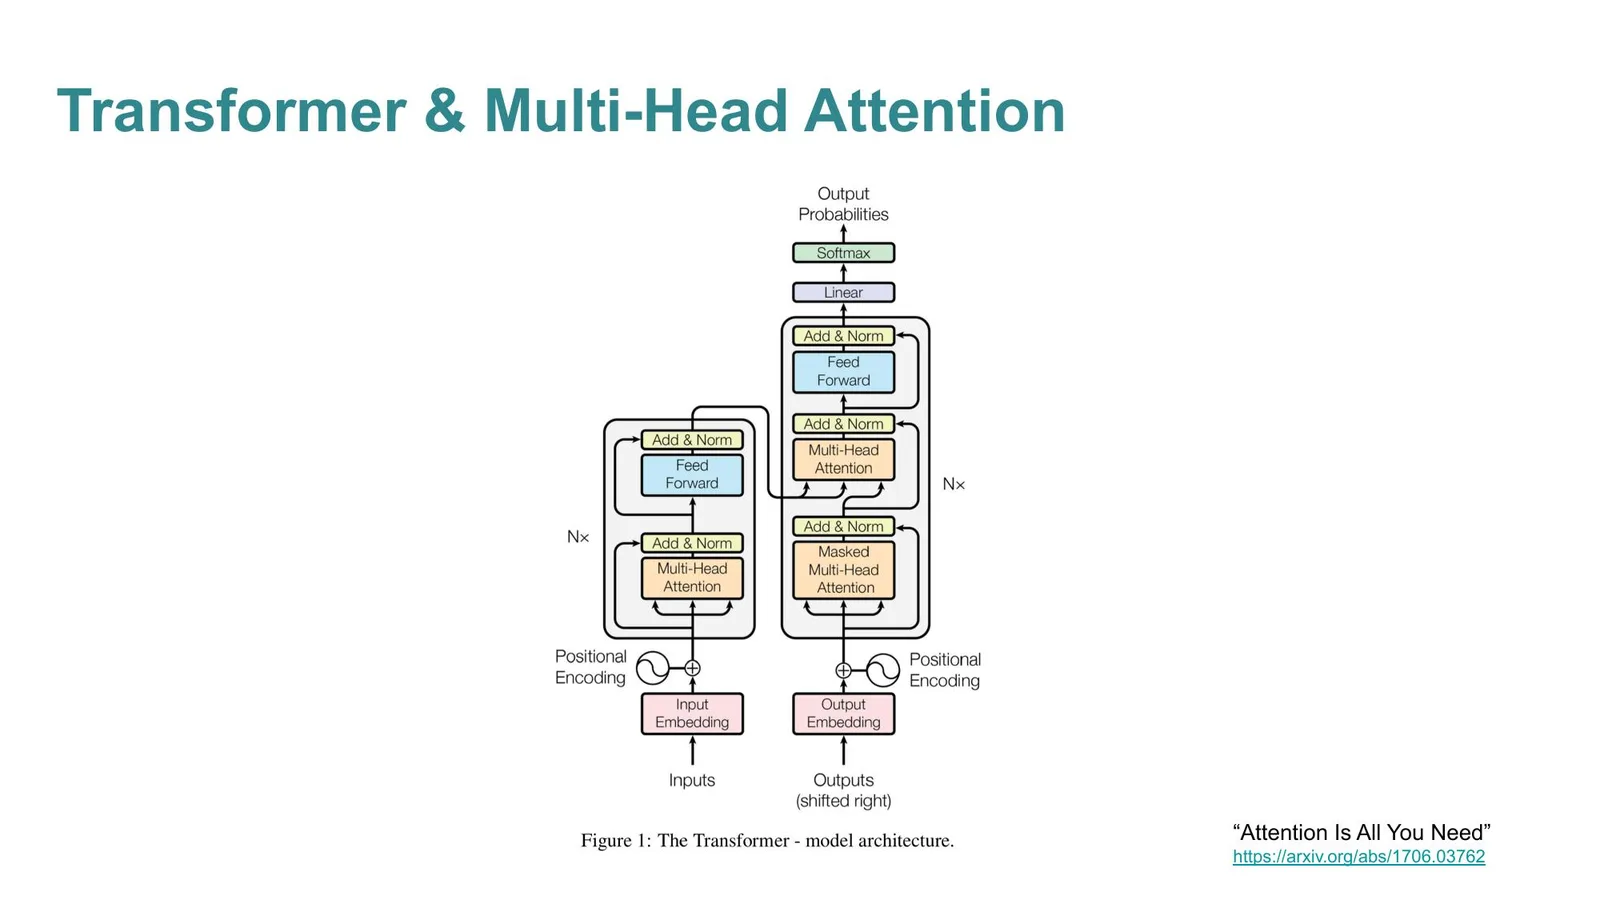
来源:官方 CS25 V4 slide deck,第 24 页
Multi-head attention
第 \(i\) 个 head 先做独立投影:
再把所有 head 拼接并输出:
\(h\) 是 head 数,\(W_i^Q,W_i^K,W_i^V\) 是每个 head 的投影,\(W^O\) 负责融合。多头并不保证每个 head 自动对应清晰语义,但它增加了并行表示子空间。
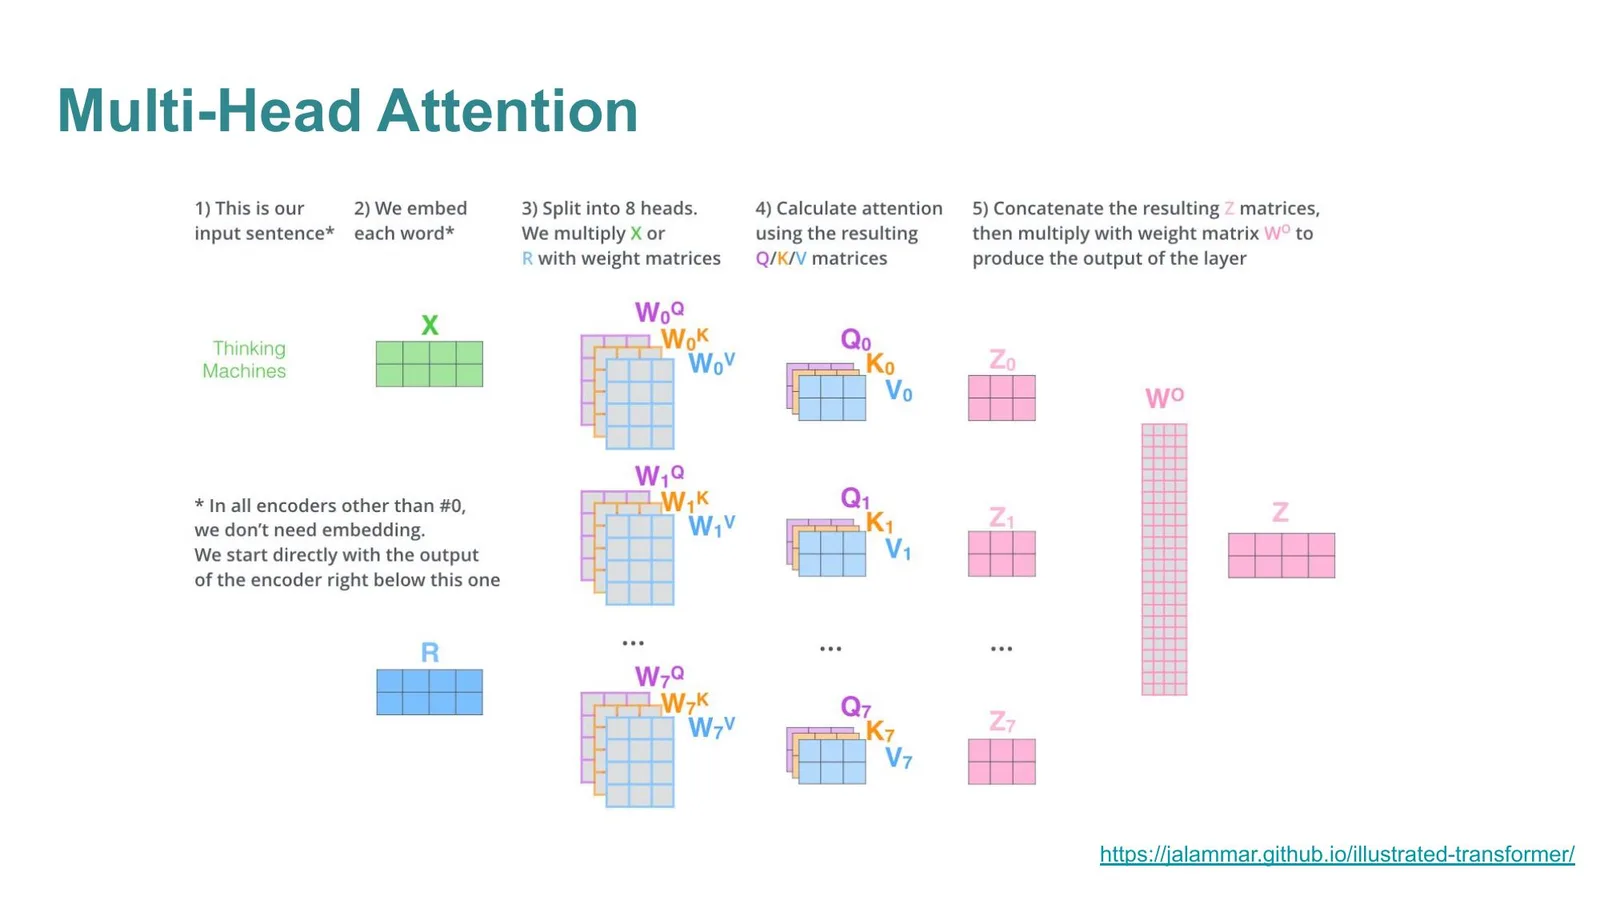
来源:官方 CS25 V4 slide deck,第 25 页
“一个 head 负责一种语法”只是观察,不是接口契约
某些 head 会呈现位置、指代或句法模式,但训练没有要求 head 永久承担固定角色。剪枝、再训练或换模型后模式可能变化。工程设计不能依赖某个编号 head 必然保存某类知识。
Cross-attention:两个序列之间怎样对齐
Cross-attention(交叉注意力)把 query 与 key/value 放在不同来源。机器翻译 decoder 产生 query,encoder hidden states 提供 key 和 value;检索增强、视觉语言模型和 encoder–decoder 也会使用类似接口。
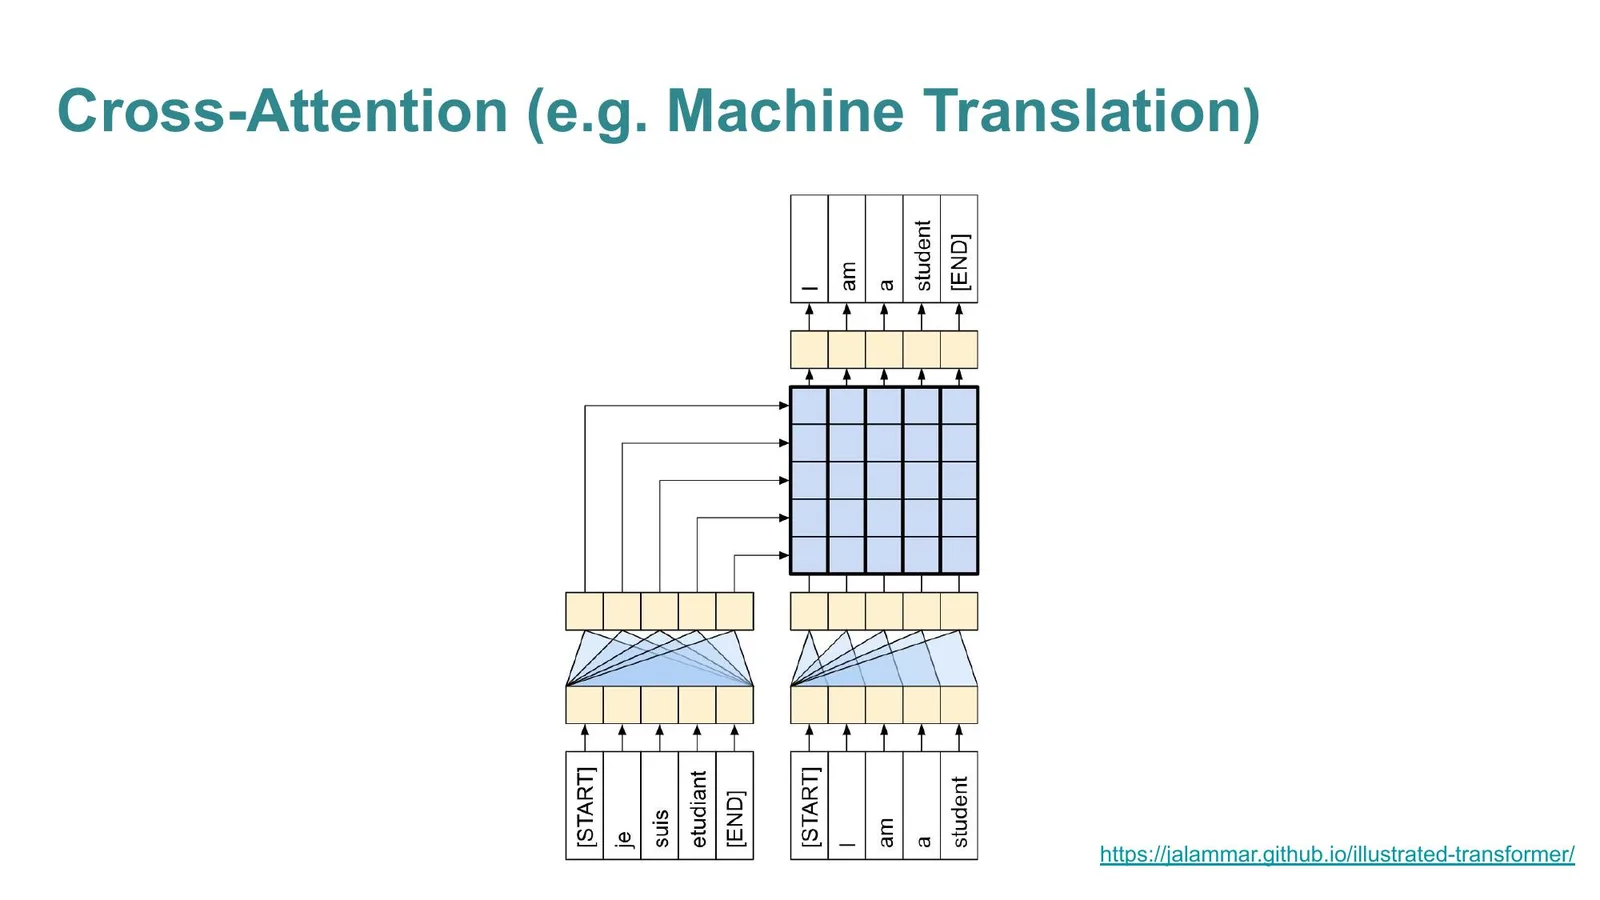
来源:官方 CS25 V4 slide deck,第 26 页
术语表:三种 attention 不要混在一起
| 类型 | Q/K/V 来源 | 主要用途 |
|---|---|---|
| Self-attention | 同一序列 | 建立序列内部依赖。 |
| Causal self-attention | 同一序列,带未来 mask | 自回归生成。 |
| Cross-attention | Q 来自 decoder/一种模态,K/V 来自 encoder/另一模态 | 条件生成与跨模态、跨序列融合。 |
Transformer 相比 RNN 赢在哪里
最后一页对比把优势归纳为长距离访问、稳定训练与并行计算。需要补上一个限制:标准 dense self-attention 的 score matrix 是 \(n\times n\),序列长度增长会带来二次计算和内存成本。读这张表时应同时比较 dependency path、sequential steps 与 resource cost,避免只记“Transformer 更好”。
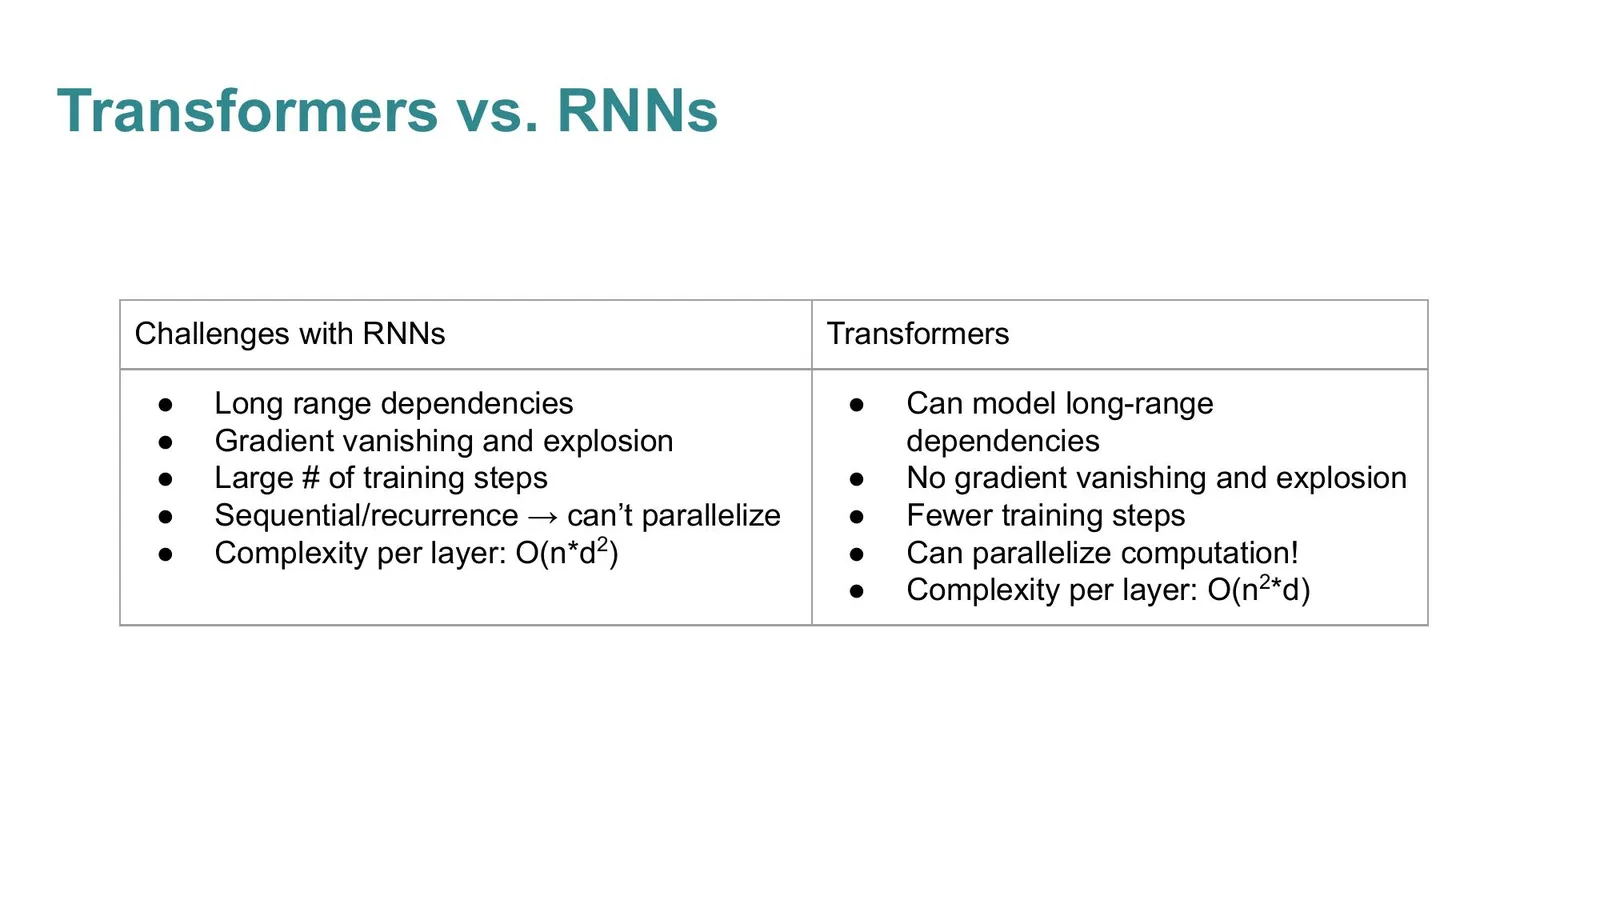
来源:官方 CS25 V4 slide deck,第 27 页
复杂度与并行性的交换
对长度 \(n\)、隐藏维度 \(d\) 的序列,dense attention 的主要 score 计算约为 \(O(n^2d)\),attention matrix 占 \(O(n^2)\);RNN 单步约为 \(O(d^2)\),总计算随 \(n\) 线性增长,却必须沿时间顺序执行。Transformer 用更多全局配对换取了训练并行性与短的信息路径。
课堂提示
课堂把 GPU parallelism 视为 Transformer 成功的重要原因。架构不仅要表达得好,还要能匹配硬件吞吐;这也是后续 scale、成本与研究集中化问题的起点。
本章小结
Attention 通过内容相关加权让模型按需读取信息。自注意力处理序列内部关系,交叉注意力连接不同来源,多头机制提供多个表示子空间。Transformer 由此摆脱 recurrent bottleneck,却引入长序列的二次成本和更复杂的可解释性问题。
Scale、Emergence 与 Alignment:能力从哪里来
理解 attention 后,课程把视角从单层机制拉到大规模训练。这里有三条不能混为一谈的线:规模怎样改变可观测能力,alignment 怎样改变输出偏好,产品模型怎样在数据、架构和训练配方上形成不同取舍。
Large Language Model 是被放大的训练系统
Large language model(大语言模型,LLM)通常仍以 next-token prediction 为核心,但参数、数据与计算规模显著增加。它的“large”不仅指参数,还意味着数据 pipeline、并行训练、评估与部署基础设施共同扩大。
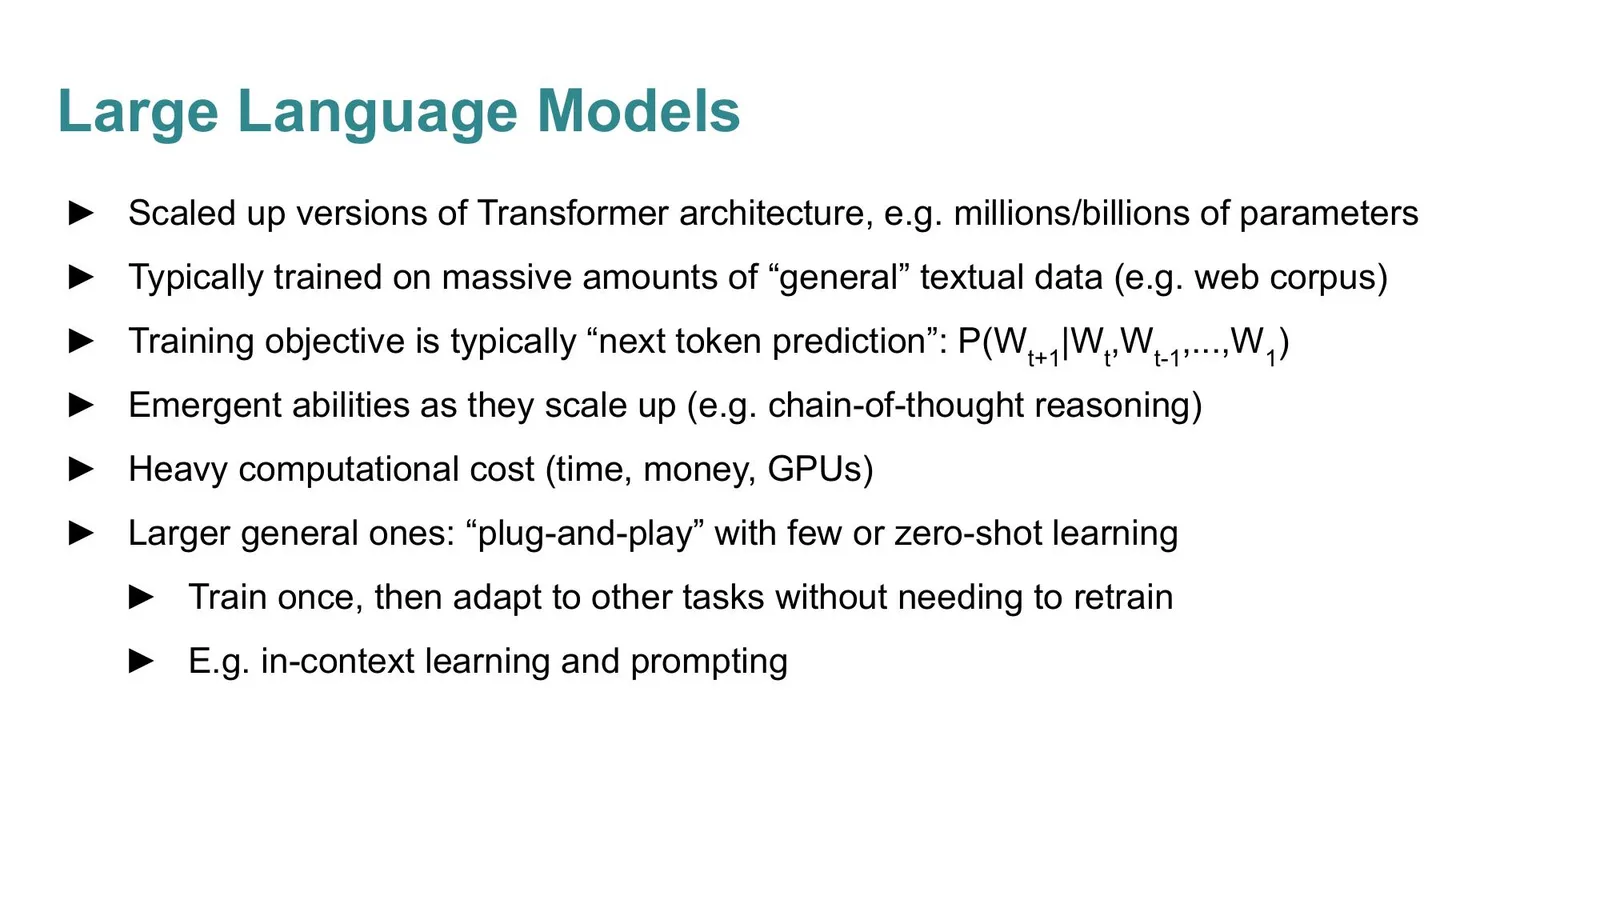
来源:官方 CS25 V4 slide deck,第 28 页
Autoregressive objective
对序列 \(x_{1:T}\),训练损失常写成
\(\theta\) 是模型参数,\(x_{< t}\) 是历史 token。目标只要求提高下一个 token 的似然;遵循指令、引用证据、拒绝危险操作和长期规划都不是这个目标直接保证的能力。
参数量不是能力的充分统计量
同样参数规模下,token 数、数据质量、architecture、optimizer、context length、post-training 与评估污染都会改变结果。课堂后面讨论 Phi、BabyLM、DPO 和 MoE,正是在说明“更大”之外还有大量设计自由度。
Emergent ability 与度量陷阱
Emergent ability(涌现能力)被定义为大模型出现而小模型没有的能力。课堂图展示若干任务在规模阈值附近突然上升,但讲者也引用研究质疑:离散或非线性 metric 可能把平滑改善显示成跳变。接下来的图要分两遍读:第一遍看任务曲线,第二遍检查纵轴定义与评分 threshold。
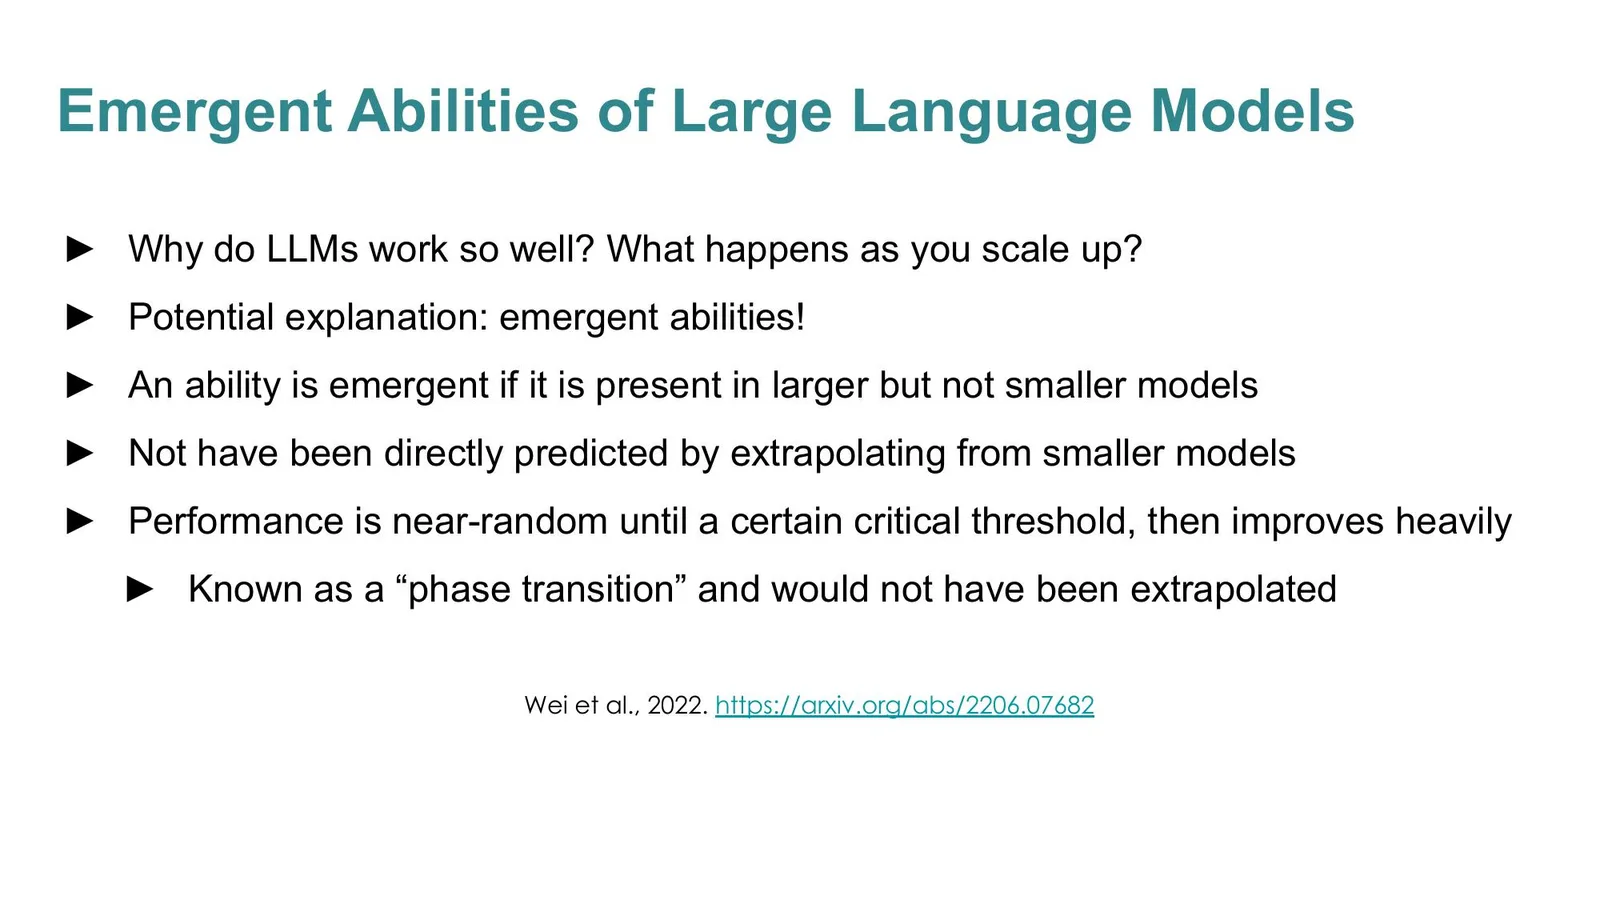
来源:官方 CS25 V4 slide deck,第 29 页
读图:先分清横轴、纵轴与 threshold
横轴通常是模型规模或训练计算,纵轴是 task metric。若 metric 只有“完全正确”才得分,底层概率的小幅连续改善也可能跨过阈值后突然记为 1。图能证明某个评估上的非线性,不能单独证明模型内部发生了离散相变。
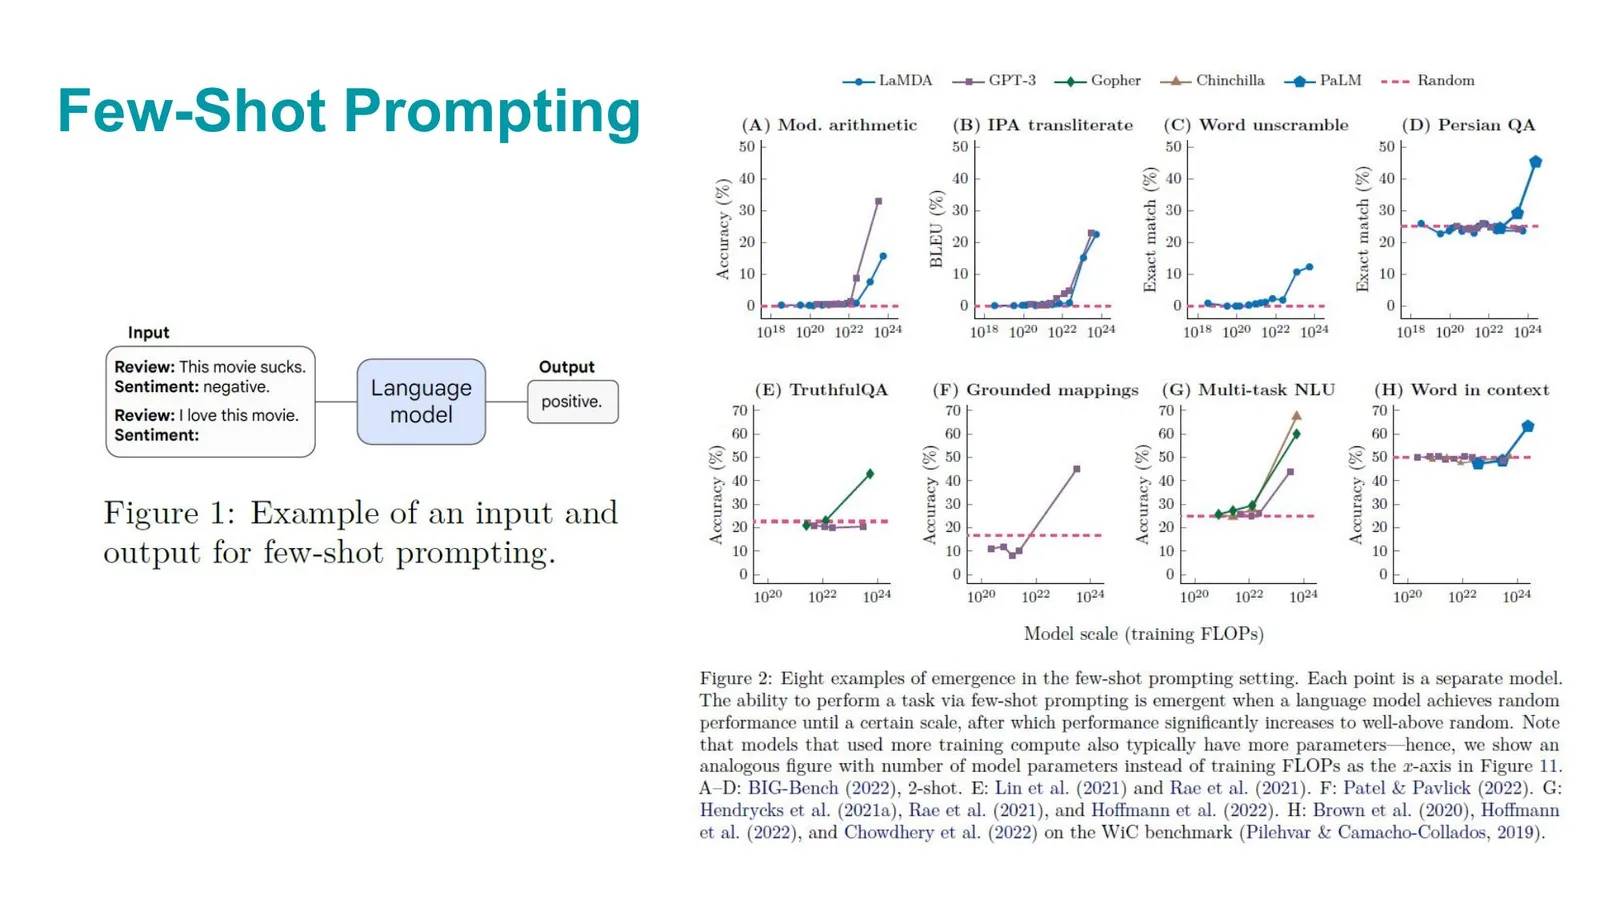
来源:官方 CS25 V4 slide deck,第 30 页
Metric-induced emergence 的简单例子
设模型给正确答案的概率随规模 \(s\) 平滑增加为 \(p(s)\)。若评估要求连续 \(k\) 个步骤全部正确,则整体准确率近似
即使 \(p(s)\) 平滑,\(A(s)\) 也会在高区间急剧上升。更稳妥的分析应同时看 token likelihood、partial credit、calibration 与不同阈值下的曲线。
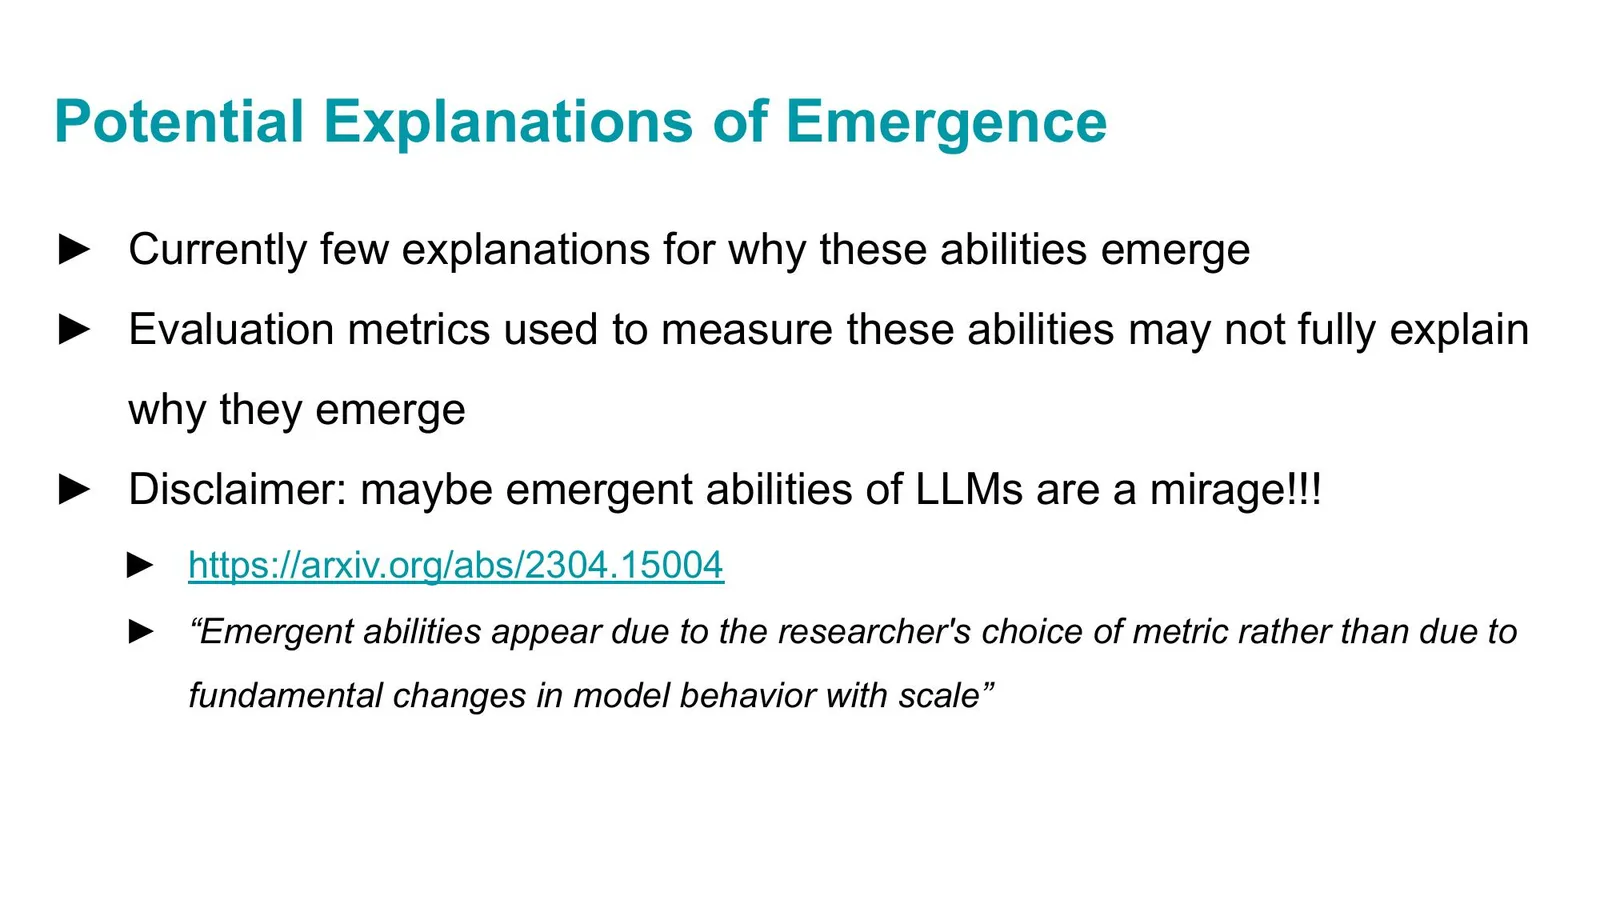
来源:官方 CS25 V4 slide deck,第 31 页
课堂提示
讲者明确提出:emergence 可能部分来自研究者选择的非线性 metric,而不是模型能力真正突然出现。这不是否认 scale 的作用,而是要求把观测工具也纳入因果分析。
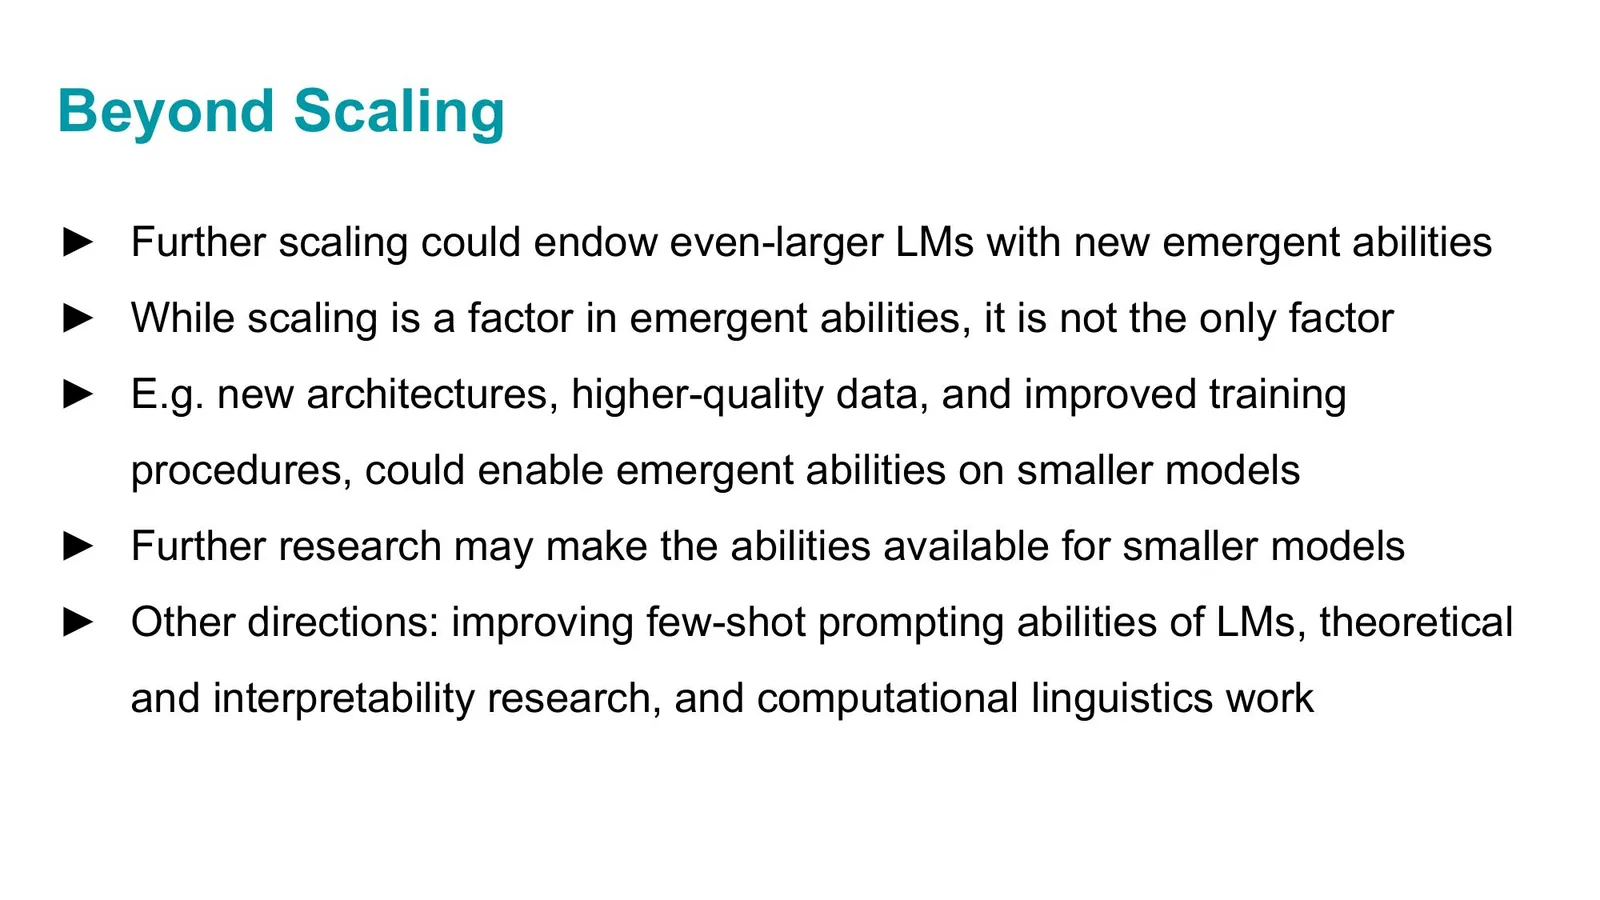
来源:官方 CS25 V4 slide deck,第 32 页
为什么 beyond scaling 值得单独讨论
更好的 architecture 可以改善归纳偏置;更高质量数据提高每个 token 的学习价值;更稳定的 optimizer 与 curriculum 改善训练效率;retrieval、tool 和 memory 把部分能力移出参数。它们共同决定能力密度与可访问性。
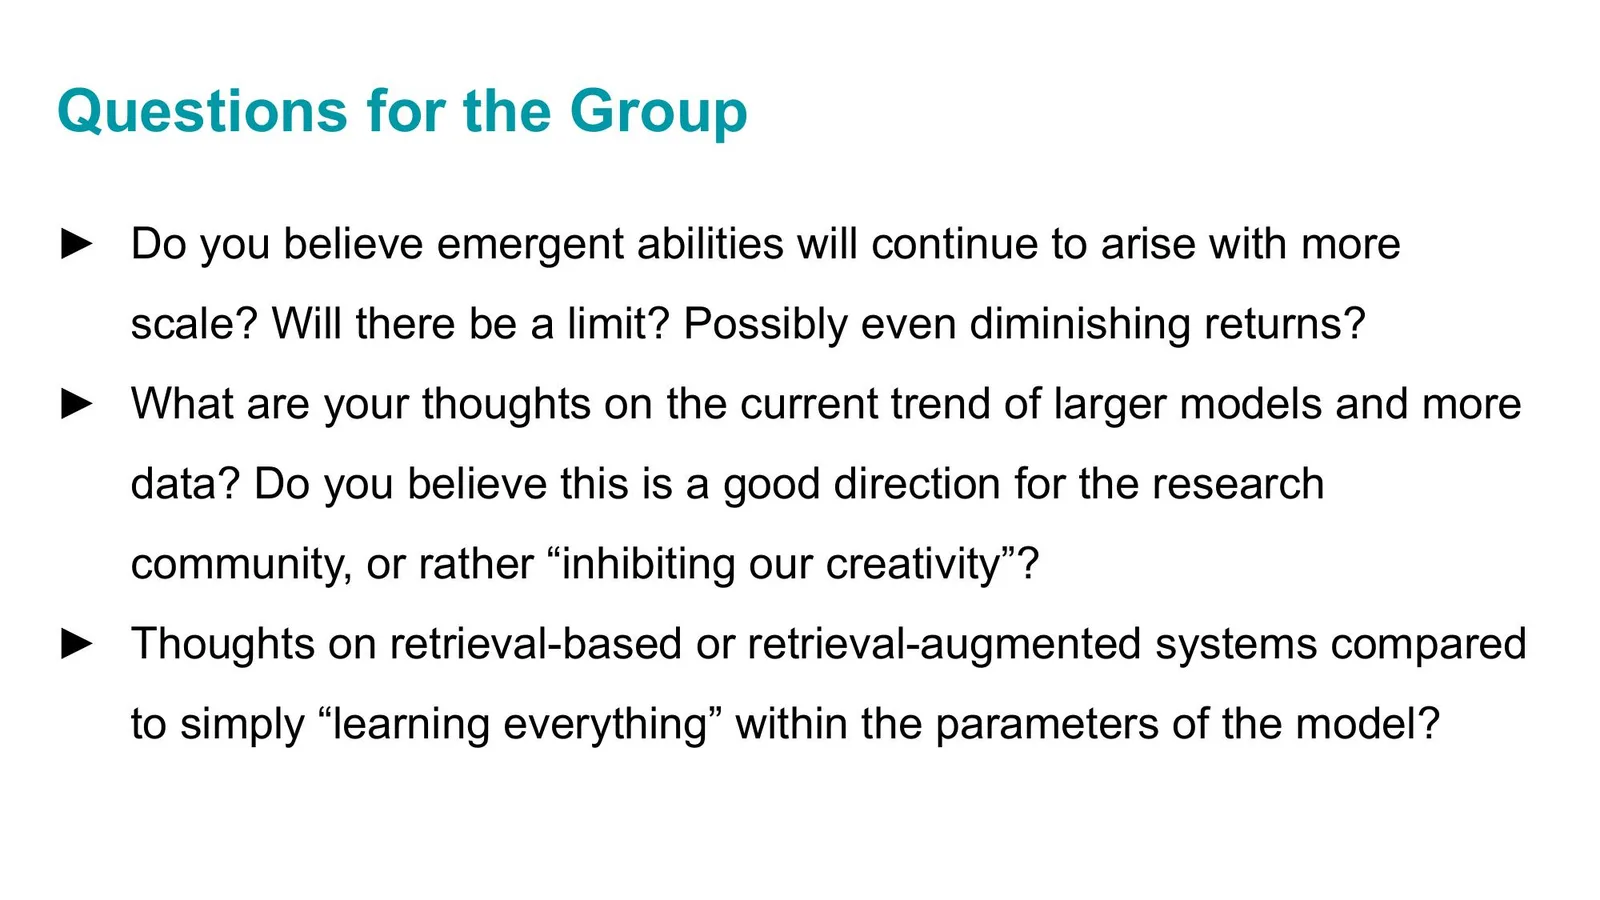
来源:官方 CS25 V4 slide deck,第 33 页
课堂问题没有唯一答案
“继续扩大模型是否足够”“参数记忆与 retrieval 哪个更好”都是设计轴,不是二选一。规模可带来通用表示,retrieval 提供可更新证据,小模型可降低成本,专用结构可提高效率。实际系统通常组合这些路线。
RLHF 与 DPO:从 likelihood 到 preference
预训练让模型拟合语料分布,post-training 则让输出更接近人类偏好和任务规范。Reinforcement Learning from Human Feedback(基于人类反馈的强化学习,RLHF)常训练 reward model,再用强化学习优化 policy;Direct Preference Optimization(直接偏好优化,DPO)直接从偏好对构造分类式目标。
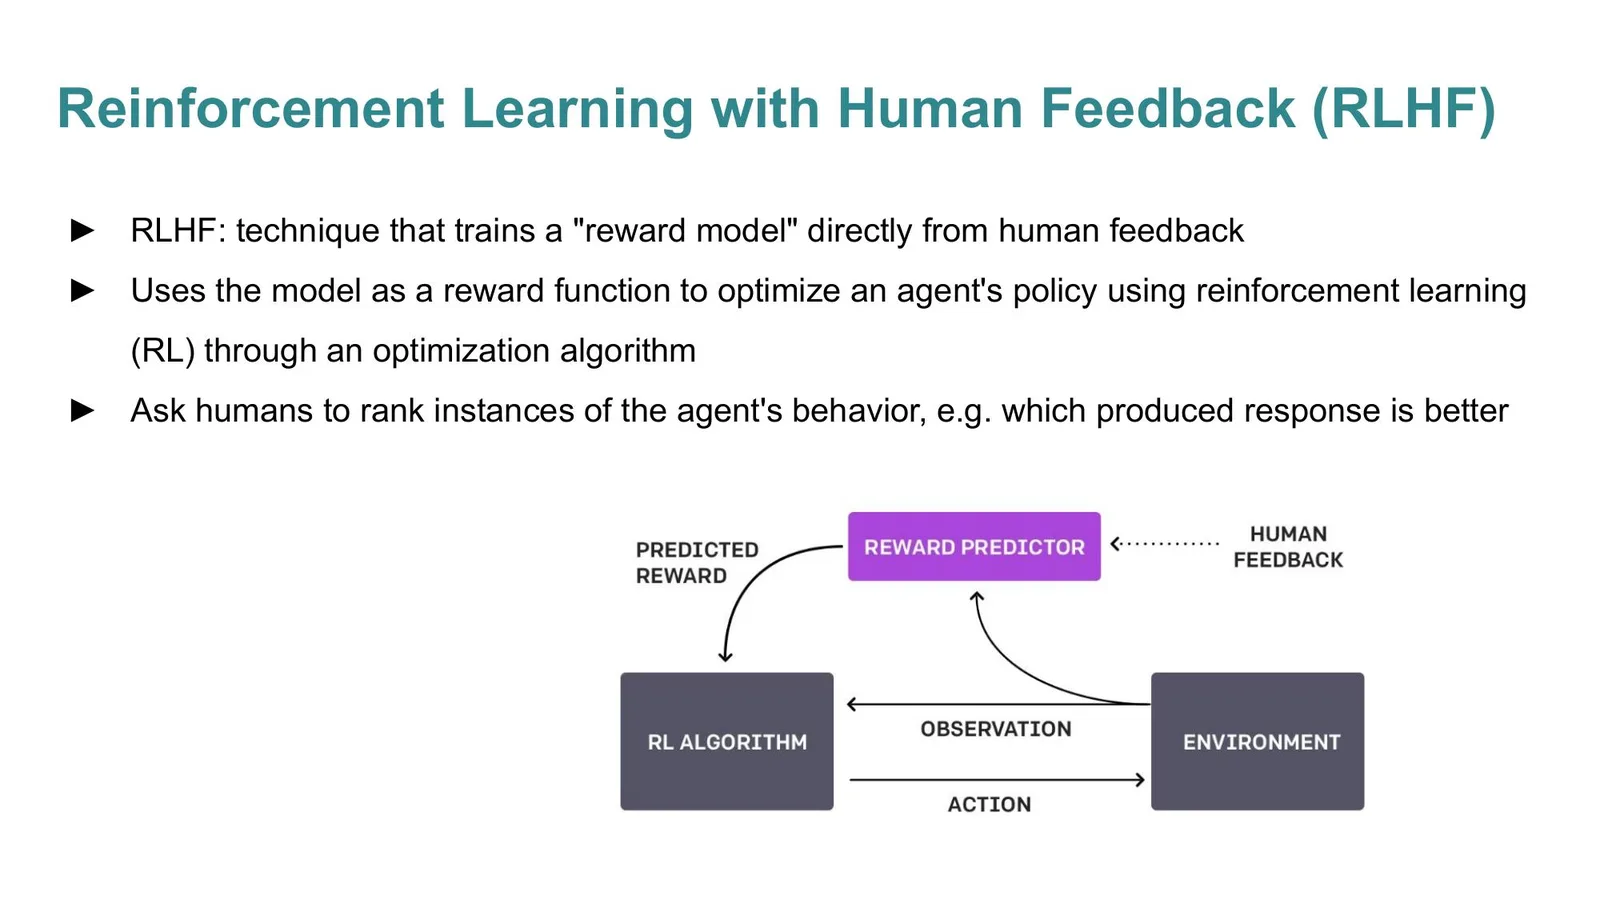
来源:官方 CS25 V4 slide deck,第 35 页
Preference data 的基本形式
对 prompt \(x\),人类或规则比较两个回答 \(y_w\) 与 \(y_l\),其中 \(y_w\) 是 preferred response。Reward model 常学习
\(r_\phi\) 是 reward score,\(\sigma\) 是 logistic function。数据只表达相对偏好,不等于客观真理;标注者构成、rubric 与采样策略会进入模型行为。
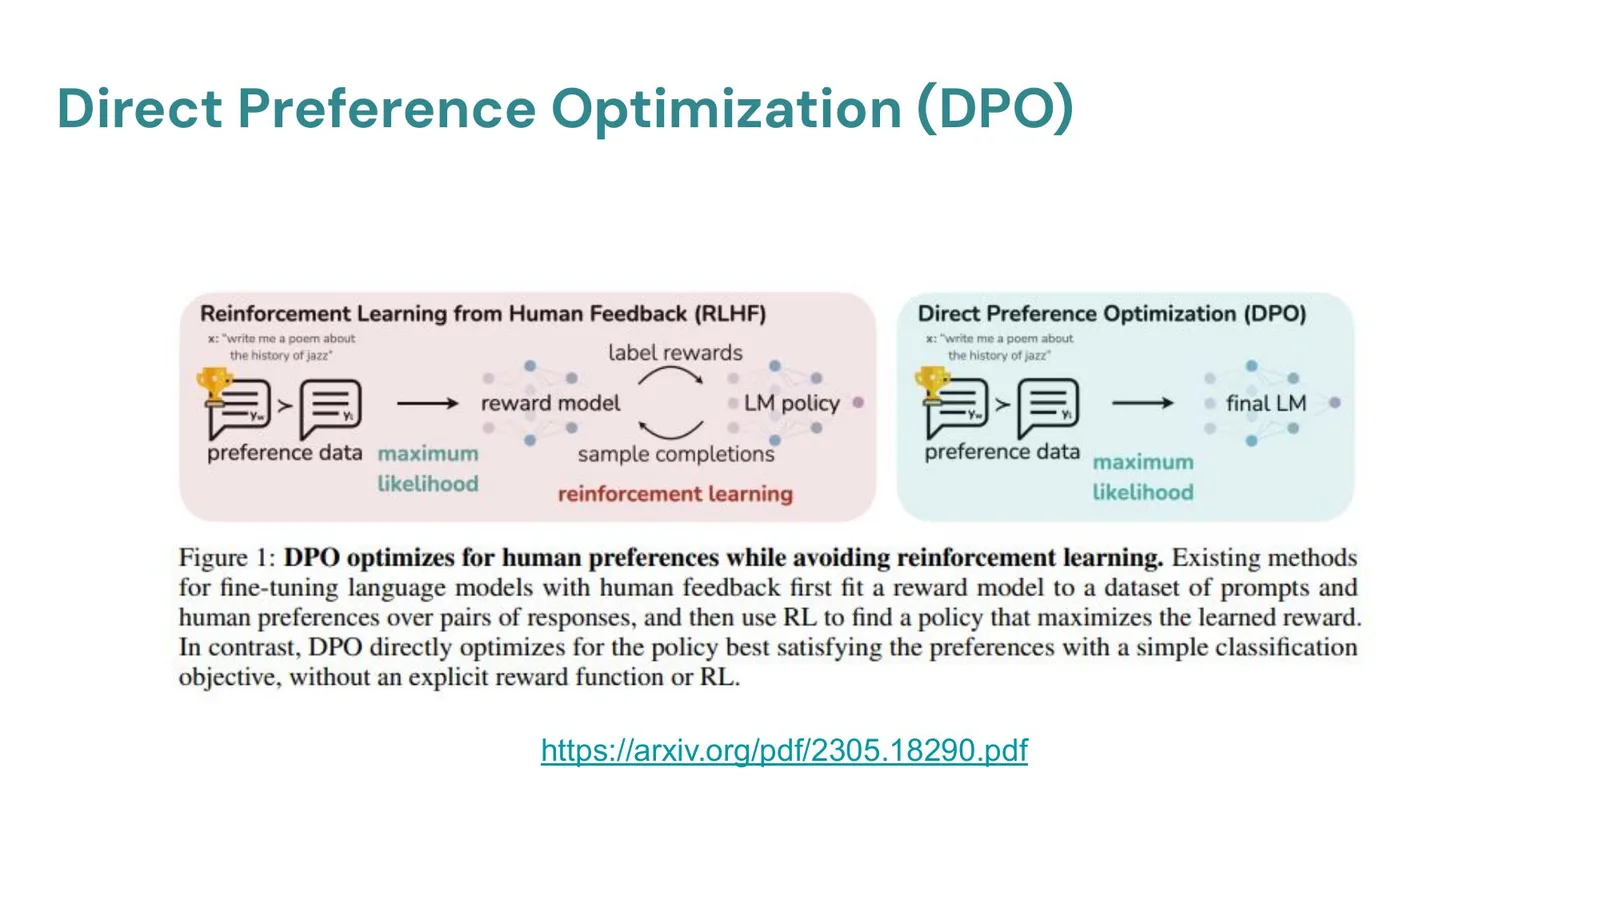
来源:官方 CS25 V4 slide deck,第 36 页
DPO objective 的直觉
一种常见写法是
\(\pi_\theta\) 是待训练 policy,\(\pi_{\mathrm{ref}}\) 是 reference model,\(\beta\) 控制偏离 reference 的强度。DPO 简化了训练管线,但 preference bias、coverage 和 over-optimization 仍然存在。
课堂提示
课堂没有把 DPO 描述成“RLHF 已被淘汰”,而是强调 RLHF 依赖高质量反馈、reward 与 policy optimization,DPO 提供了一条更直接的 preference-learning 路线。
ChatGPT、GPT-4 与 Gemini:2024 年的课堂快照
接下来的模型页属于 2024 年课程语境。它们用于说明 post-training、多模态、context、benchmark 与 MoE 等方向,不应被解读为 2026 年最新产品排名。阅读顺序应从训练阶段和 architecture 出发,再看当时 benchmark,而不是先依据品牌名称预设结论。
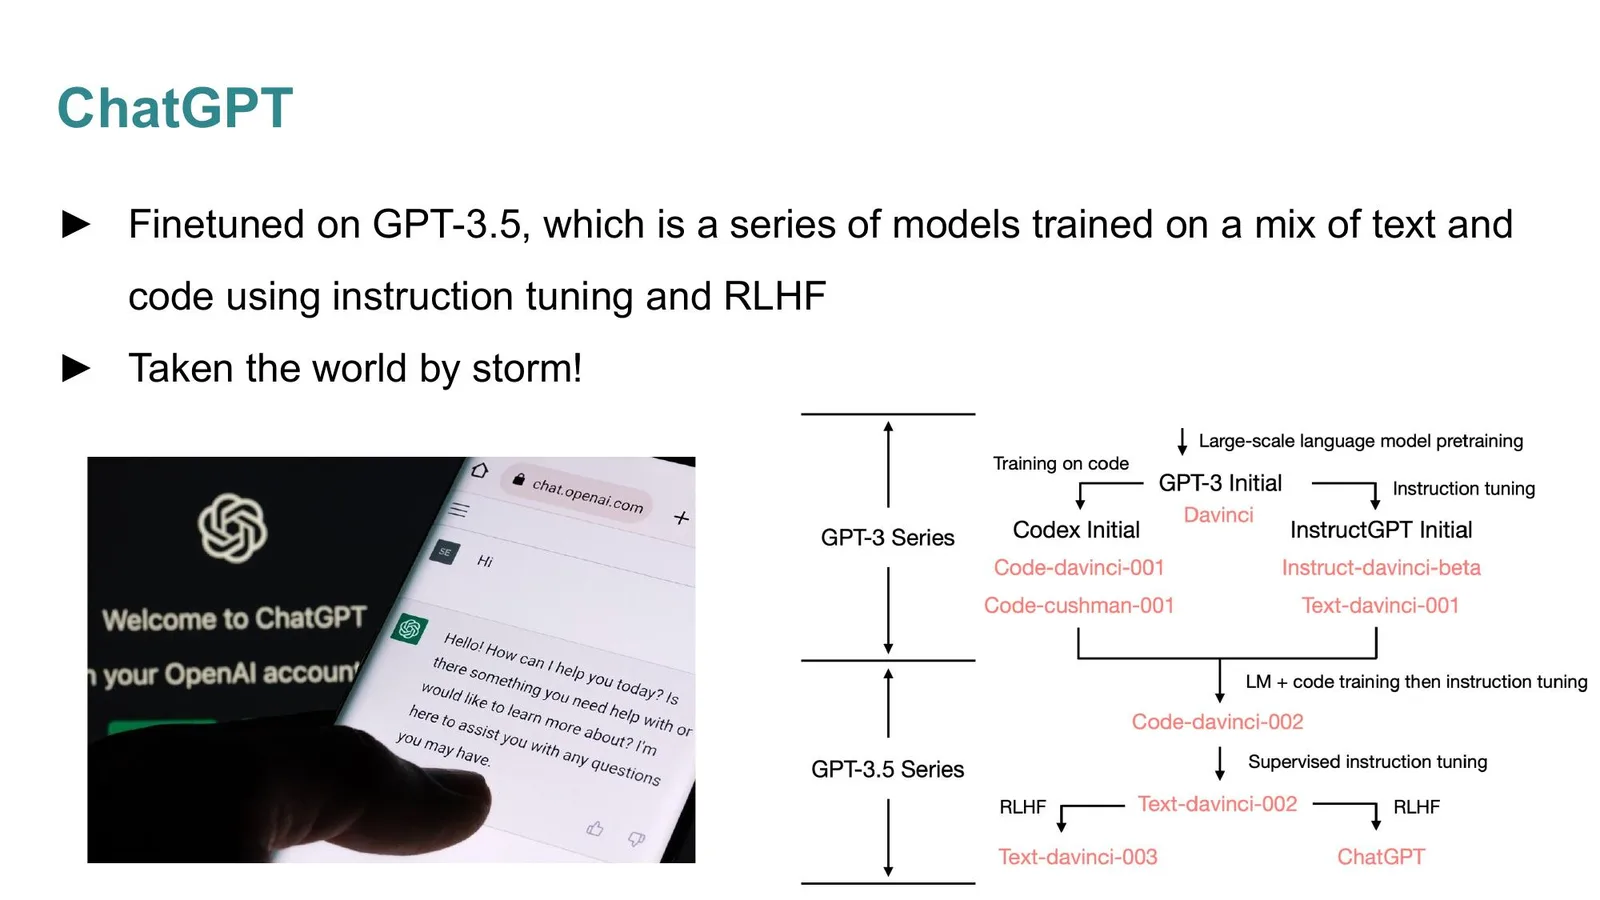
来源:官方 CS25 V4 slide deck,第 37 页
读图:产品名称背后要拆成训练阶段
一个 chat model 通常经历通用预训练、监督式 instruction tuning、preference optimization、安全数据与部署策略。界面相似不代表训练数据、模型结构或行为边界相同;公开信息不足时,不应从产品体验反推全部内部机制。
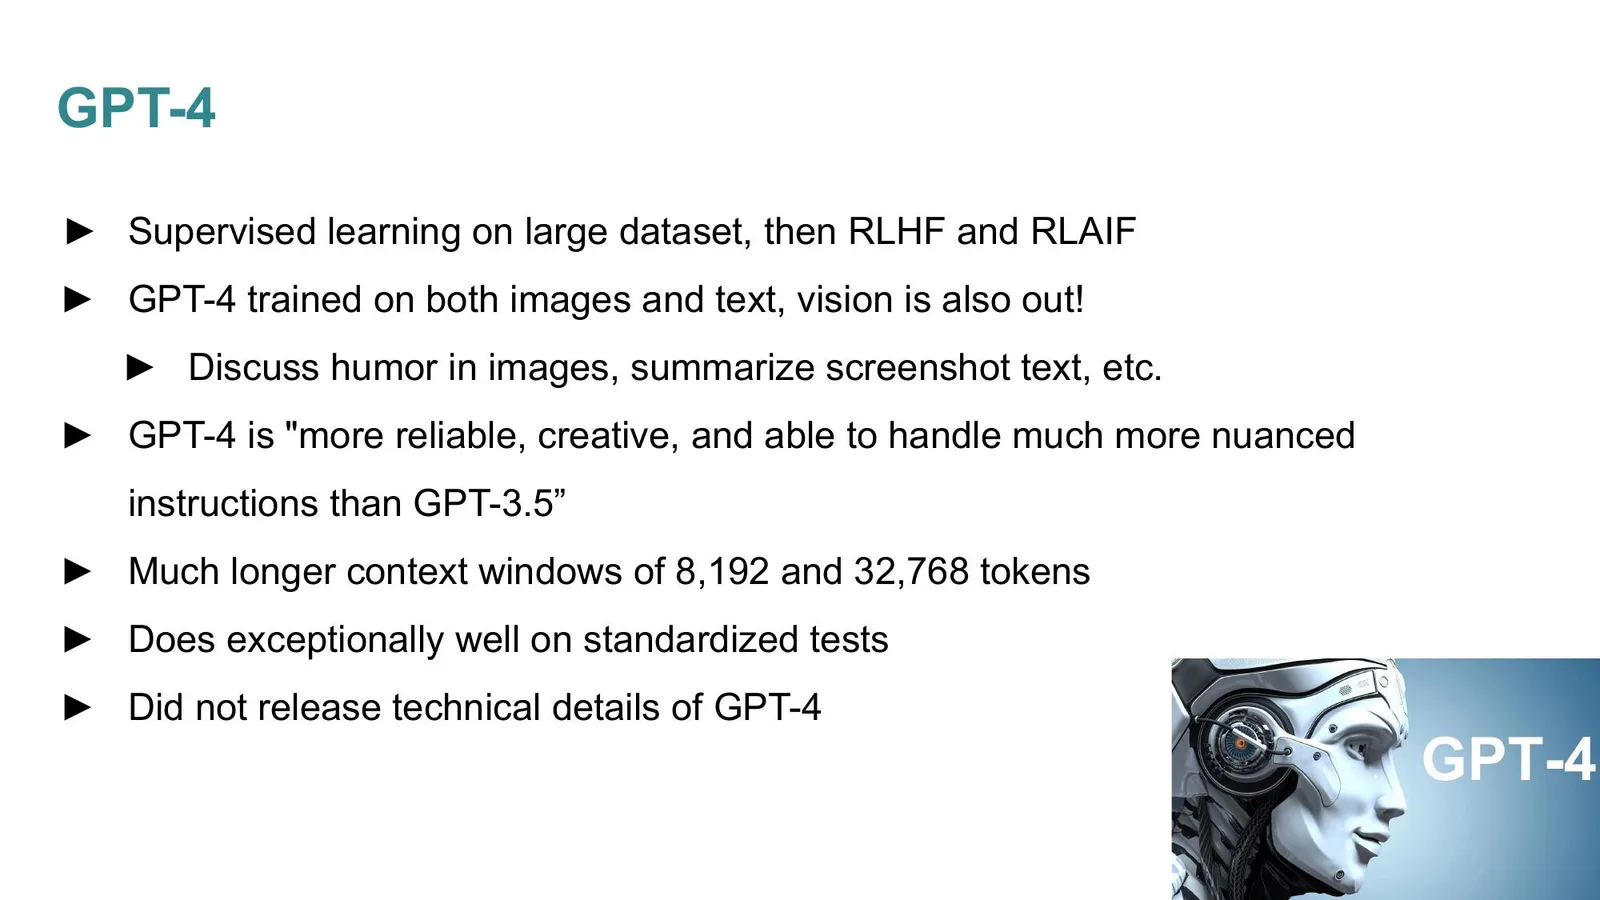
来源:官方 CS25 V4 slide deck,第 38 页
Benchmark snapshot 不是永久排序
分数依赖版本、prompt、评估集、污染程度与 judge。课堂给出的结果应保留日期,不能用旧 benchmark 声明今天某模型绝对领先。更重要的是理解评估维度:知识、reasoning、multimodality、safety 与 cost 并不由一个总分覆盖。
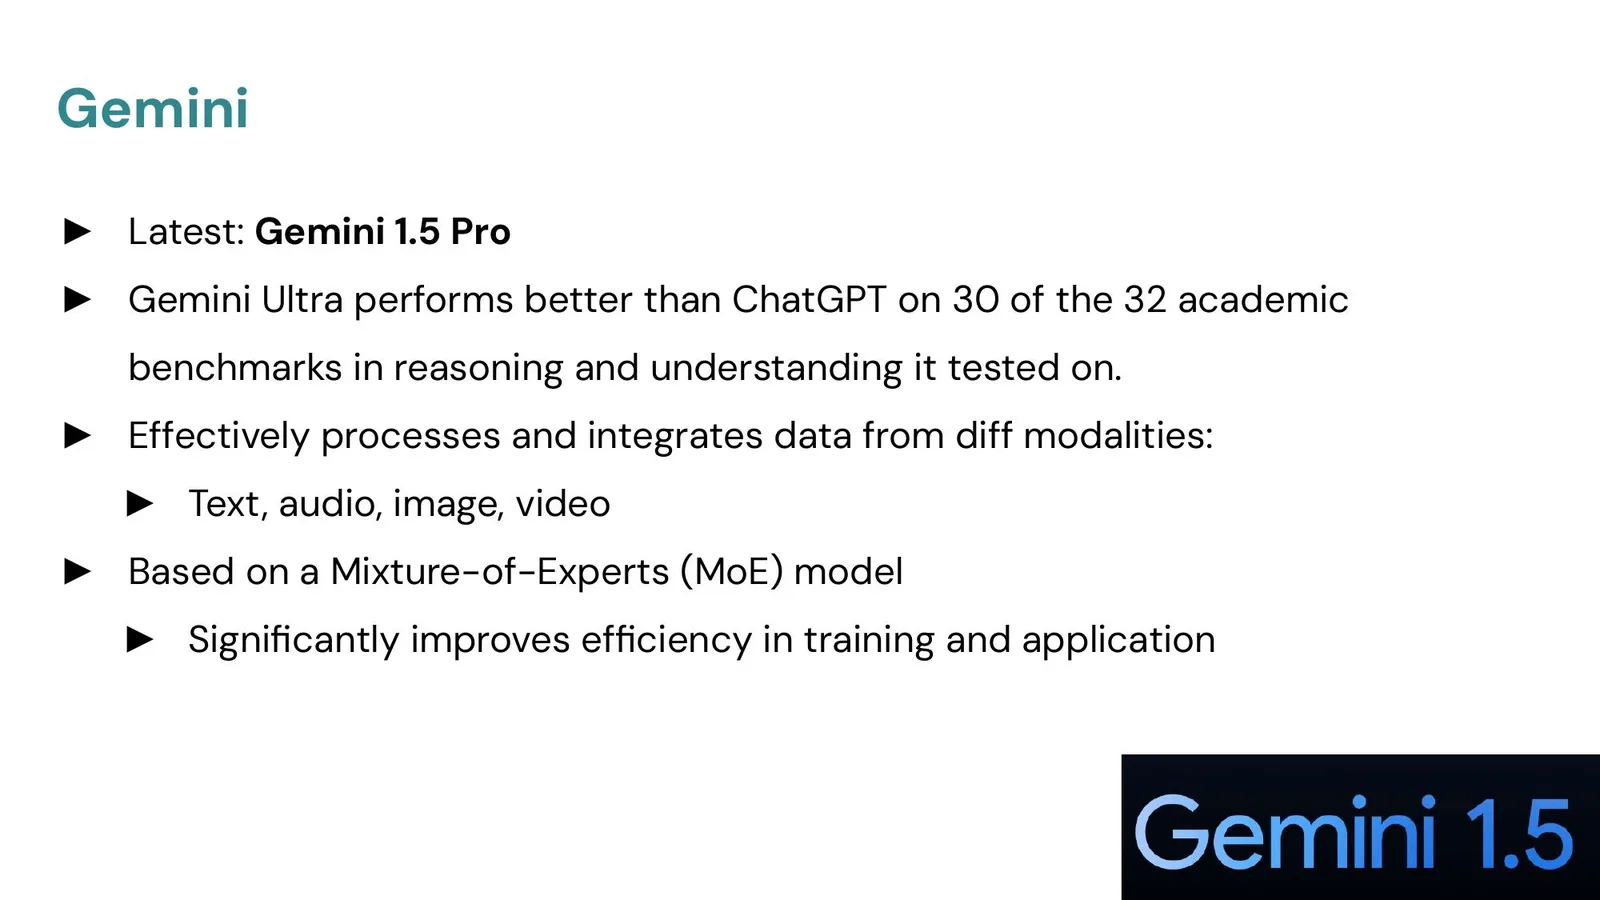
来源:官方 CS25 V4 slide deck,第 39 页
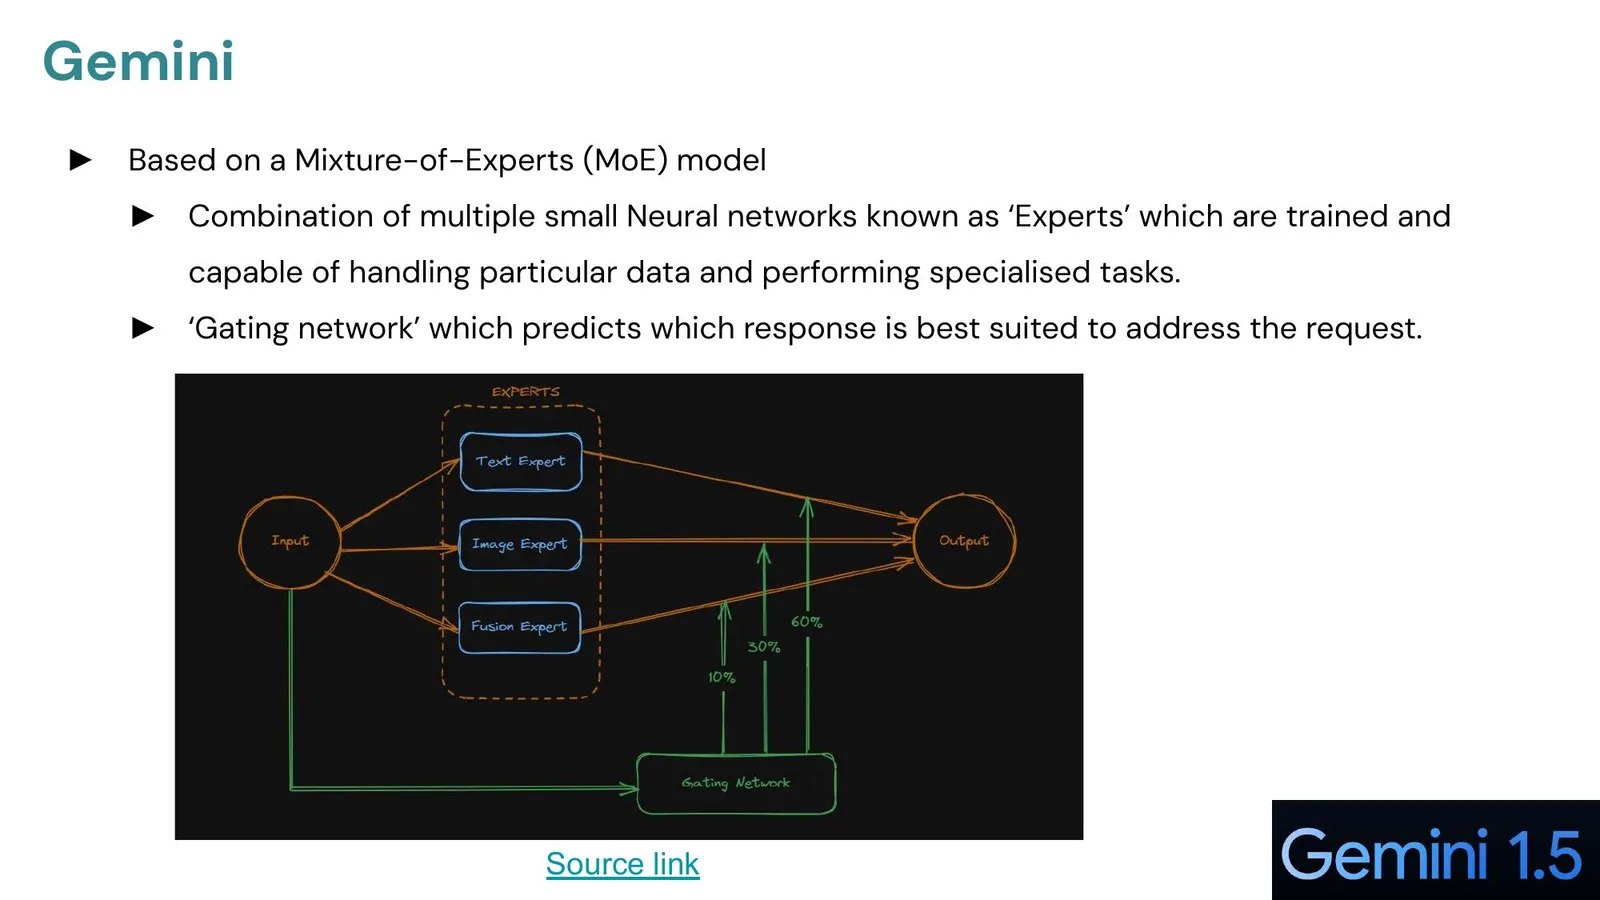
来源:官方 CS25 V4 slide deck,第 40 页
Mixture of Experts 的最小机制
Mixture of Experts(专家混合,MoE)用 router 为 token 选择少量 expert:
\(W_r\) 是 router 参数,\(p_i\) 是 expert 权重,\(E_i\) 是第 \(i\) 个 expert。Sparse activation 让总参数量增加时,每个 token 只计算少数 expert;代价是 load balancing、通信和 capacity 管理更复杂。
“Expert”不等于可命名的人类专家
某个 expert 可能呈现主题或功能偏好,但训练通常没有保证它只负责图像、数学或某种语言。把 MoE 直接画成稳定职业分工只是一种直觉,不能替代 routing 与 activation 的实测分析。
2024 的位置与下一步缺口
课程用两页总结当时状态:LLM、alignment、多模态和 diffusion transformer 快速发展;下一步则包括更通用的 agent、效率、世界模型、持续学习与安全控制。本节用这组图承担章节转场:先区分已经形成产品的能力,再标出仍停留在研究目标的缺口,并为后面的跨域应用与系统限制建立问题清单。
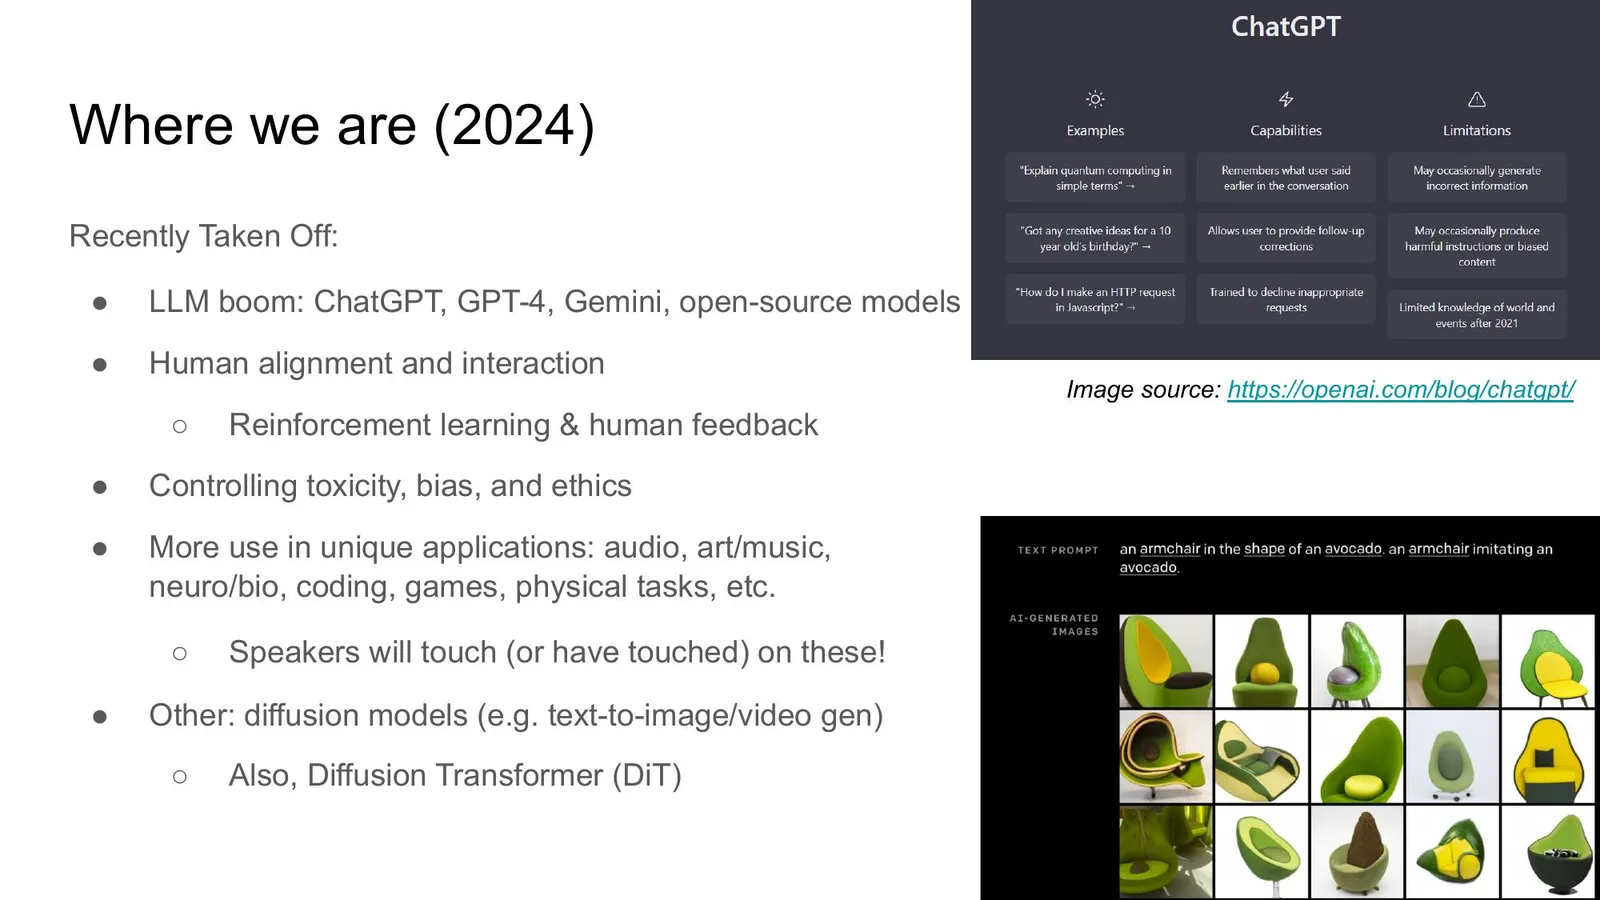
来源:官方 CS25 V4 slide deck,第 41 页
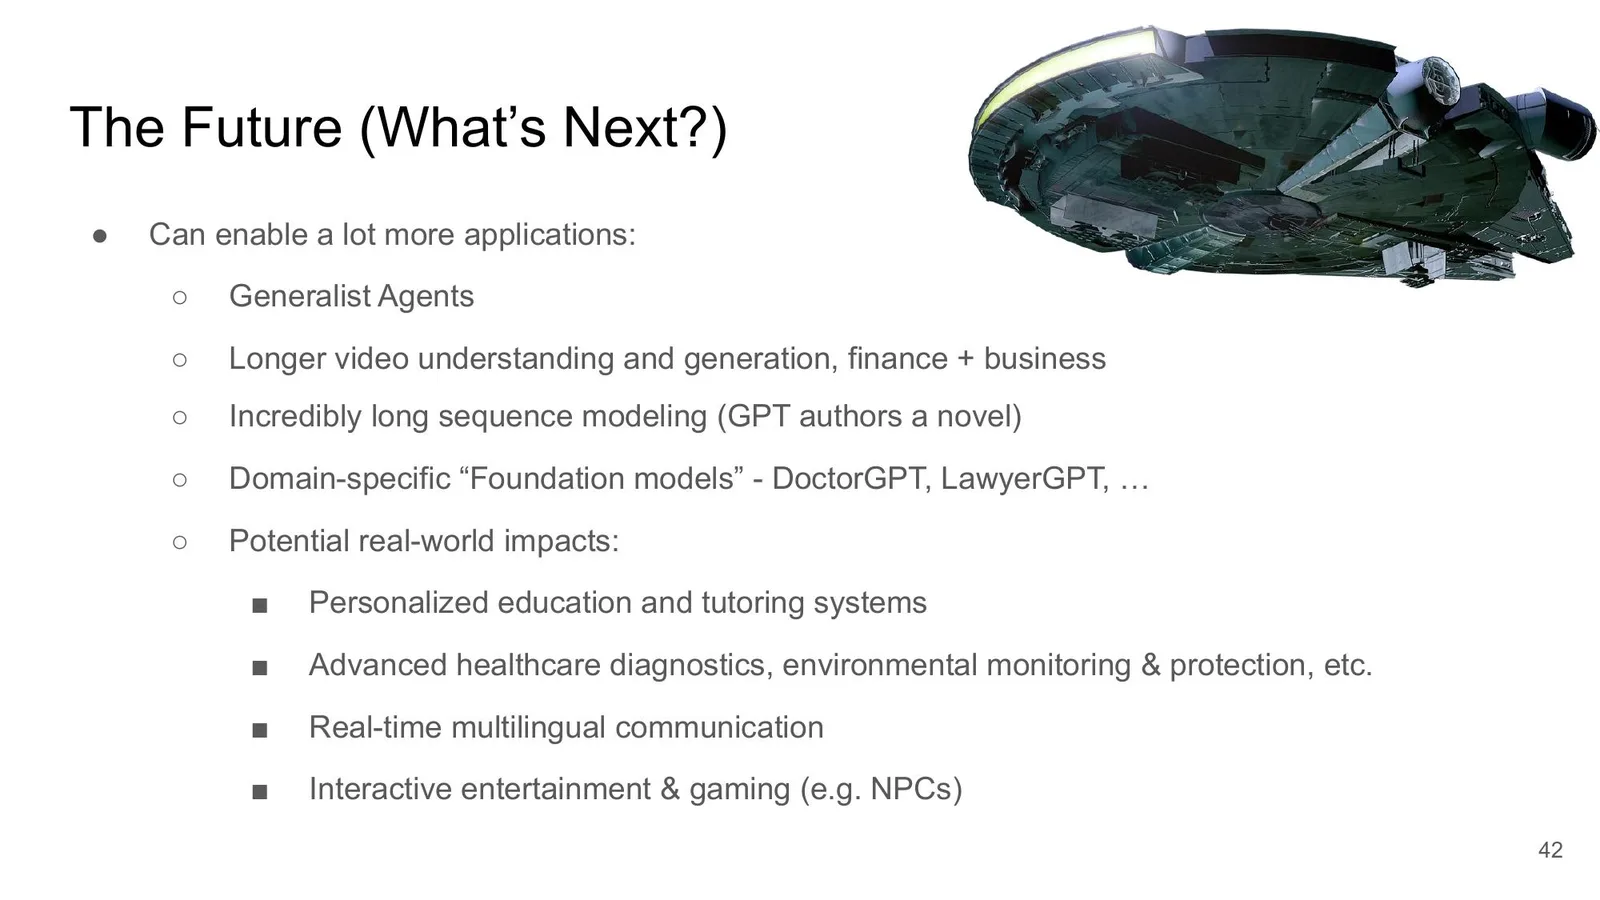
来源:官方 CS25 V4 slide deck,第 42 页
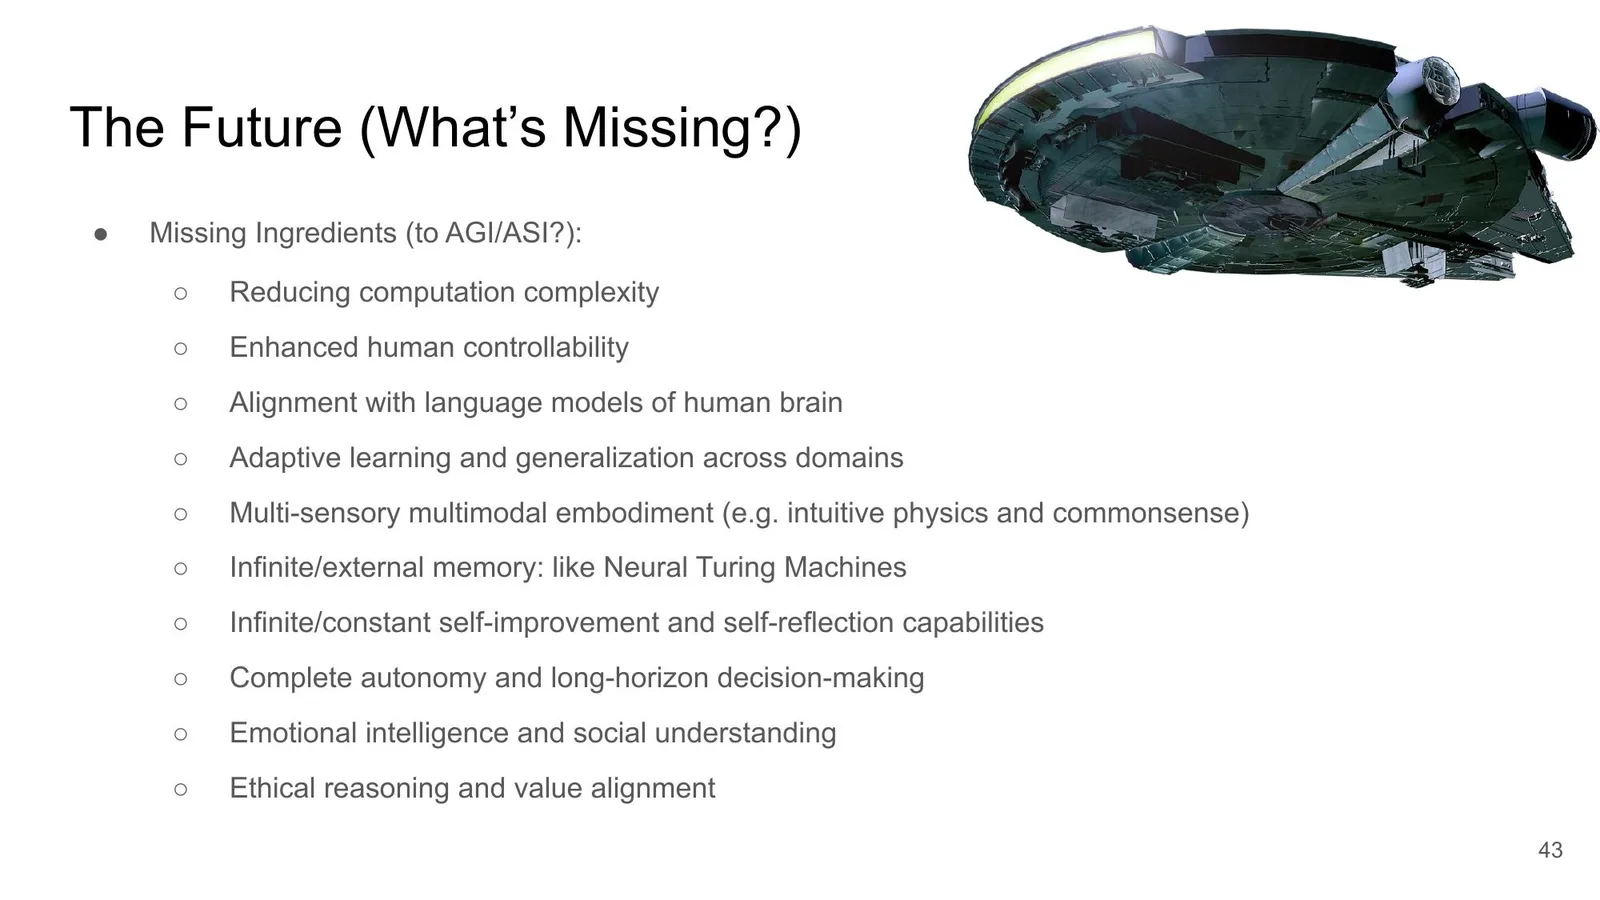
读图:Future 页混合了技术趋势与研究愿景
有些方向已有系统原型,例如 multimodal generation、tool use 与 smaller models;另一些仍是目标,例如稳定自主 agent、低成本持续学习与更接近人类的数据效率。讲义会把“已经演示”与“可靠部署”分开。
来源:官方 CS25 V4 slide deck,第 43 页
能力扩展后的六个缺口
- 更低的训练与推理成本;
- 对现实世界与因果关系更稳健的表示;
- 可更新的长期记忆与持续学习;
- 可检查、可编辑的内部机制;
- 长轨迹中的 error correction;
- 用户权限、security 与 value alignment。
本章小结
Scale 能扩大表示与任务覆盖,但 emergent curve 受 metric 影响;preference optimization 改变行为,却继承数据与目标偏差;MoE、retrieval、data quality 与 specialized training 提供 scale 之外的杠杆。模型页最有价值的部分不是旧排名,而是把能力拆成训练阶段和系统组件。
Transformer 的跨域应用:同一计算模式,不同数据接口
课堂用七页展示 Transformer 从文本扩展到语音、音乐、视觉、机器人、游戏和生物。真正可迁移的结论不是“所有任务都被统一”,而是许多领域都能把对象表示成 token 或 set,再用 attention 建模远距离交互。数据表示、输出约束和评估标准仍然高度领域化。
文本与语言:最成熟的 token interface
文本天然是离散序列,因而最容易接入 autoregressive objective。翻译、摘要、问答、代码和对话看似不同,往往都可转写为条件 token generation。下面的应用页应按输入、输出与验证标准拆解,不能因为都输出文字就认为任务结构相同。
来源:官方 CS25 V4 slide deck,第 45 页
读图:统一接口不等于统一任务
把任务写成 text-to-text 可以共享模型与训练代码,但 loss、decoding、事实性和评价目标仍不同。翻译关注语义保持,摘要关注覆盖与压缩,代码关注可执行性,对话还要处理上下文、人格与安全规范。
Audio:波形需要先变成可建模表示
音频是高频连续信号。系统通常先把波形转换为 spectrogram、codec token 或 learned feature,再用 Transformer 建模时间关系;输出也可能是文字、声学 token 或音乐事件。读图时先找 signal representation,再判断模型是在识别、生成还是跨模态对齐。
来源:官方 CS25 V4 slide deck,第 46 页
课堂提示
这组 application slide 只做方向导览,讲者把深入机制留给后续嘉宾。讲义因此解释共同接口和领域差异,不把每个模型名称扩写成未经课堂支持的产品结论。
模态建模的共同三步
- Tokenizer/encoder:把原始信号变成有限长度表示;
- Backbone:用 attention 建模表示之间的条件关系;
- Decoder/rendering:把 hidden state 转回文字、图像、声音或动作。
统一的是中间计算,最难的往往是两端的表示与评价。
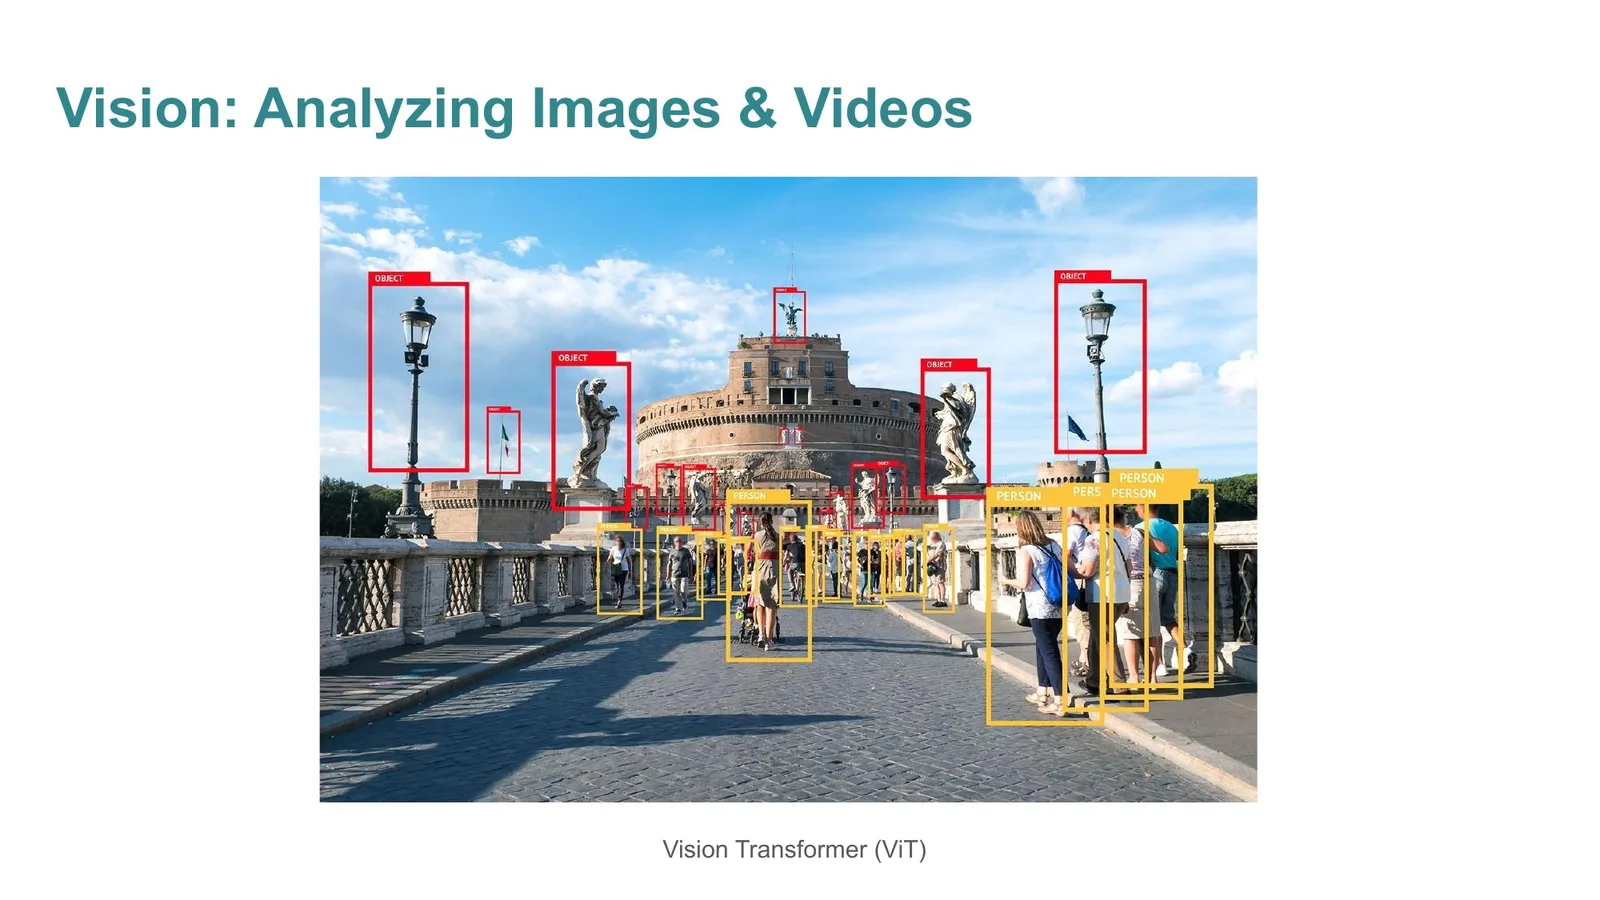
Vision:patch、frame 与跨模态对齐
Vision Transformer(视觉 Transformer,ViT)把图像切成 patch token;视频还要编码时间维。分析任务输出 label、box 或文字,生成任务则需要把 latent/token 解码成像素序列。接下来的两页分别对应 perception 与 generation,比较重点是 tokenization、decoder 和评价目标。
来源:官方 CS25 V4 slide deck,第 47 页
Patch embedding
若图像大小为 \(H\times W\),patch 大小为 \(P\times P\),则 token 数约为
更小 patch 保留更多局部细节,却让 attention 的 \(N^2\) 成本迅速增加。视觉系统因此常使用分层结构、局部 attention、downsampling 或 latent bottleneck。
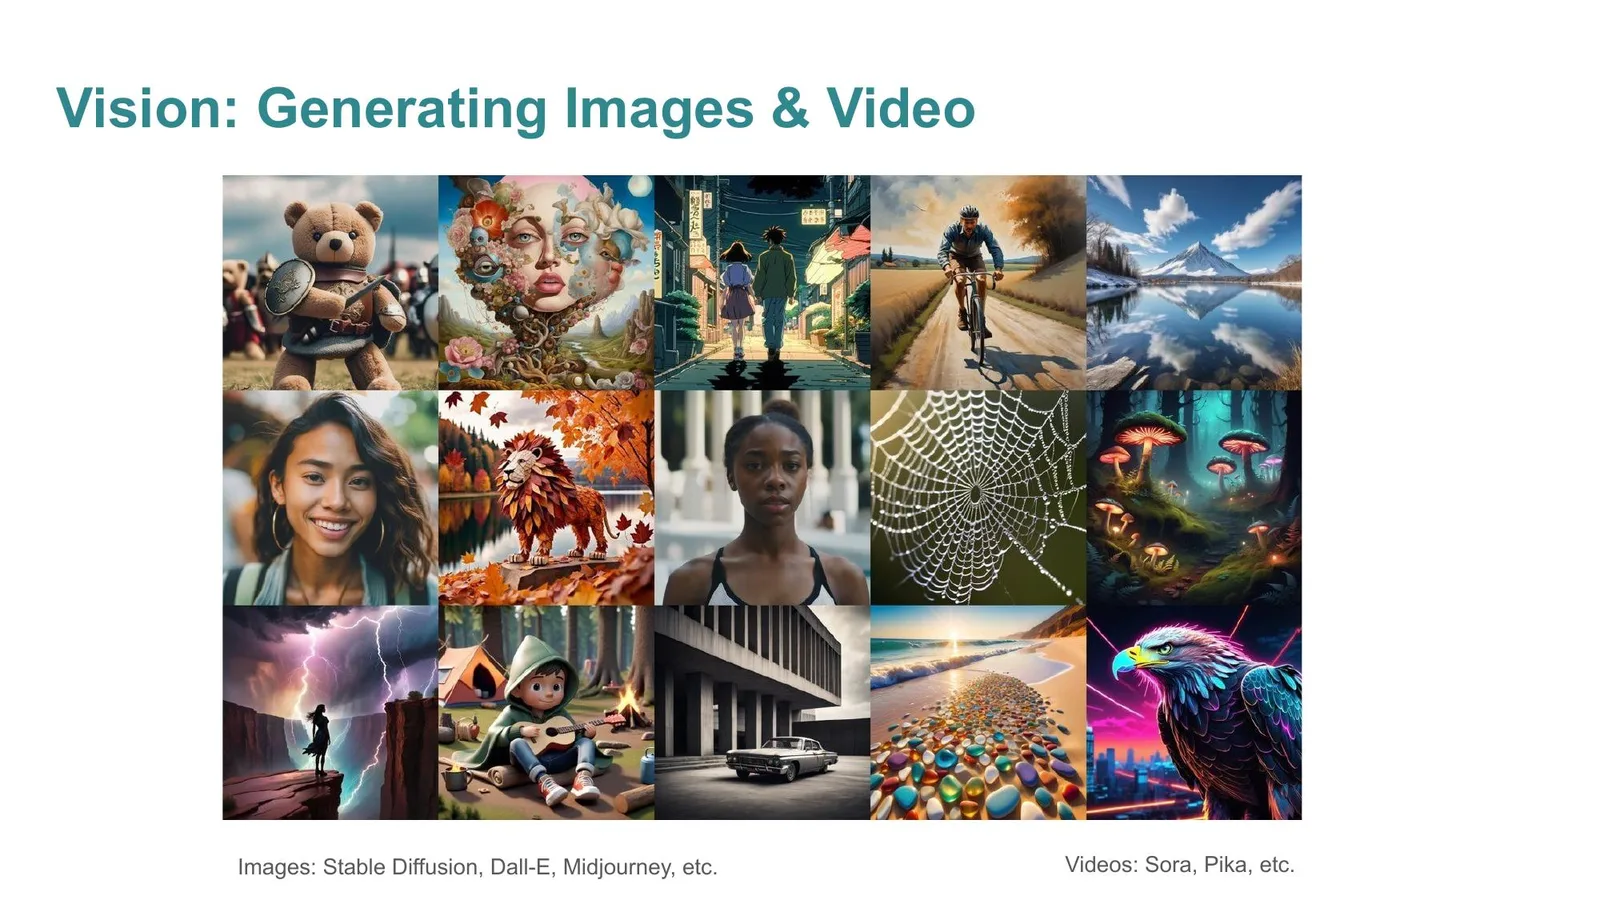
来源:官方 CS25 V4 slide deck,第 48 页
生成画面真实不等于世界模型正确
图像和视频模型可以产生高保真纹理,却仍可能违反物体恒常、几何、因果或长时间一致性。视觉质量 metric 与物理正确性不是同一目标,不能用“看起来像”替代对结构和动态的验证。
Robotics、游戏与生物:输出必须进入外部约束
机器人和游戏把输出映射到 action;生物模型把序列或三维结构映射到功能与预测。此时错误不再只是生成一个坏句子,而可能改变物理轨迹、策略或实验选择。下面三页要从环境反馈和验证成本出发阅读,而不是把跨域模型只当成应用拼图。
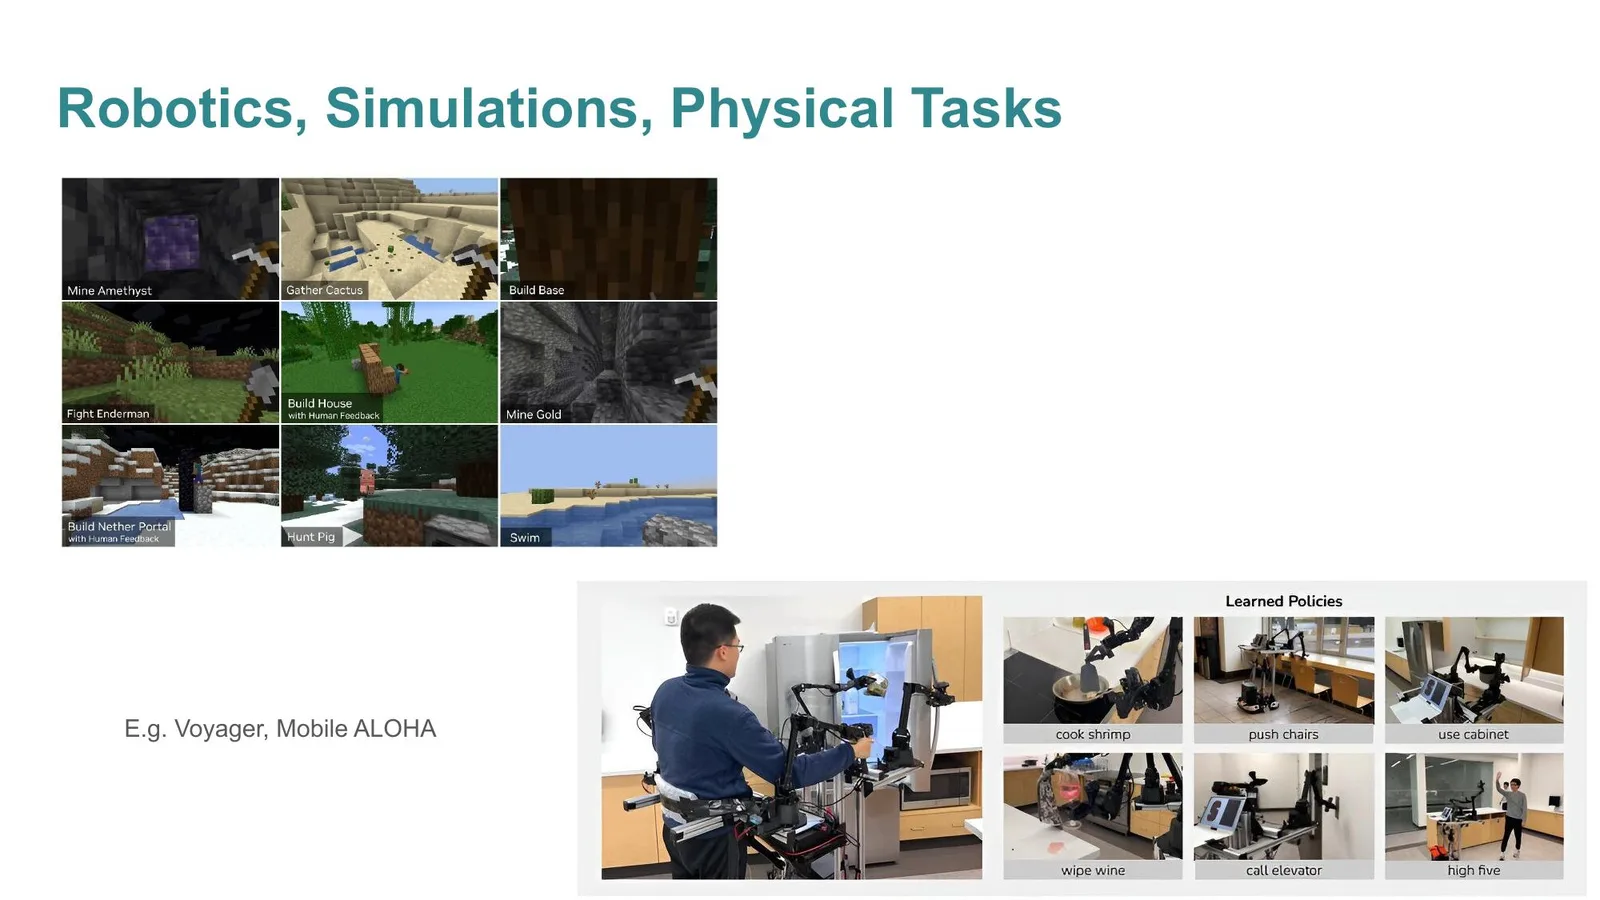
来源:官方 CS25 V4 slide deck,第 49 页
术语消化:policy 与 world feedback
Policy(策略)把 observation 映射到 action。语言模型常一次生成 token,机器人 policy 则持续接收传感器反馈并更新动作。闭环中的延迟、误差累积、碰撞约束和恢复机制,使 embodied system 比离线生成更难验收。
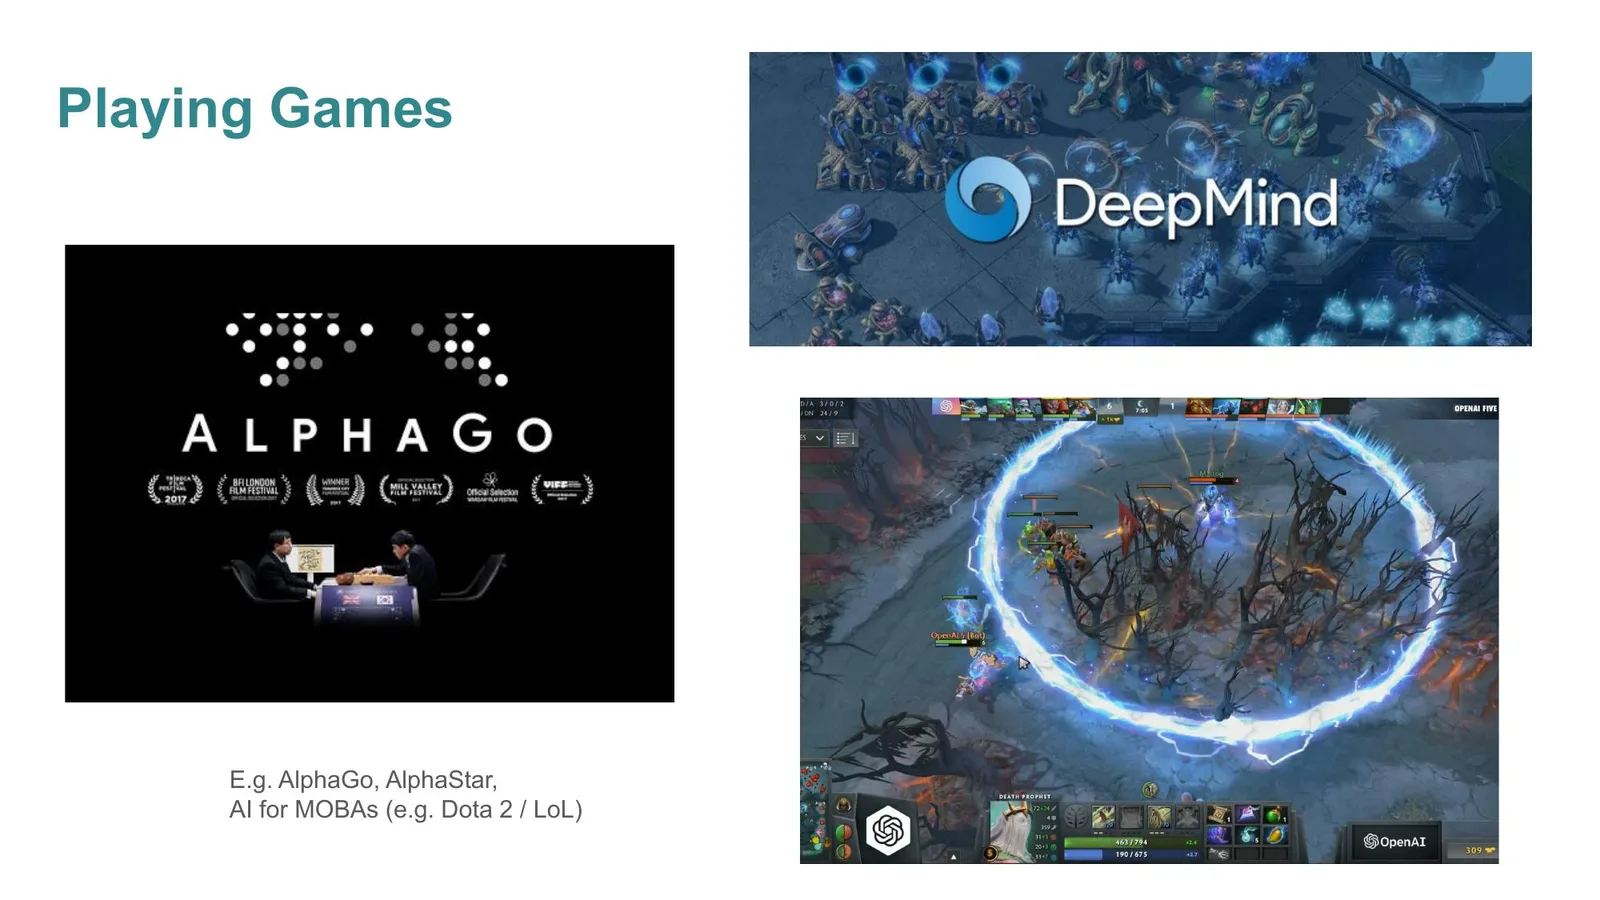
来源:官方 CS25 V4 slide deck,第 50 页
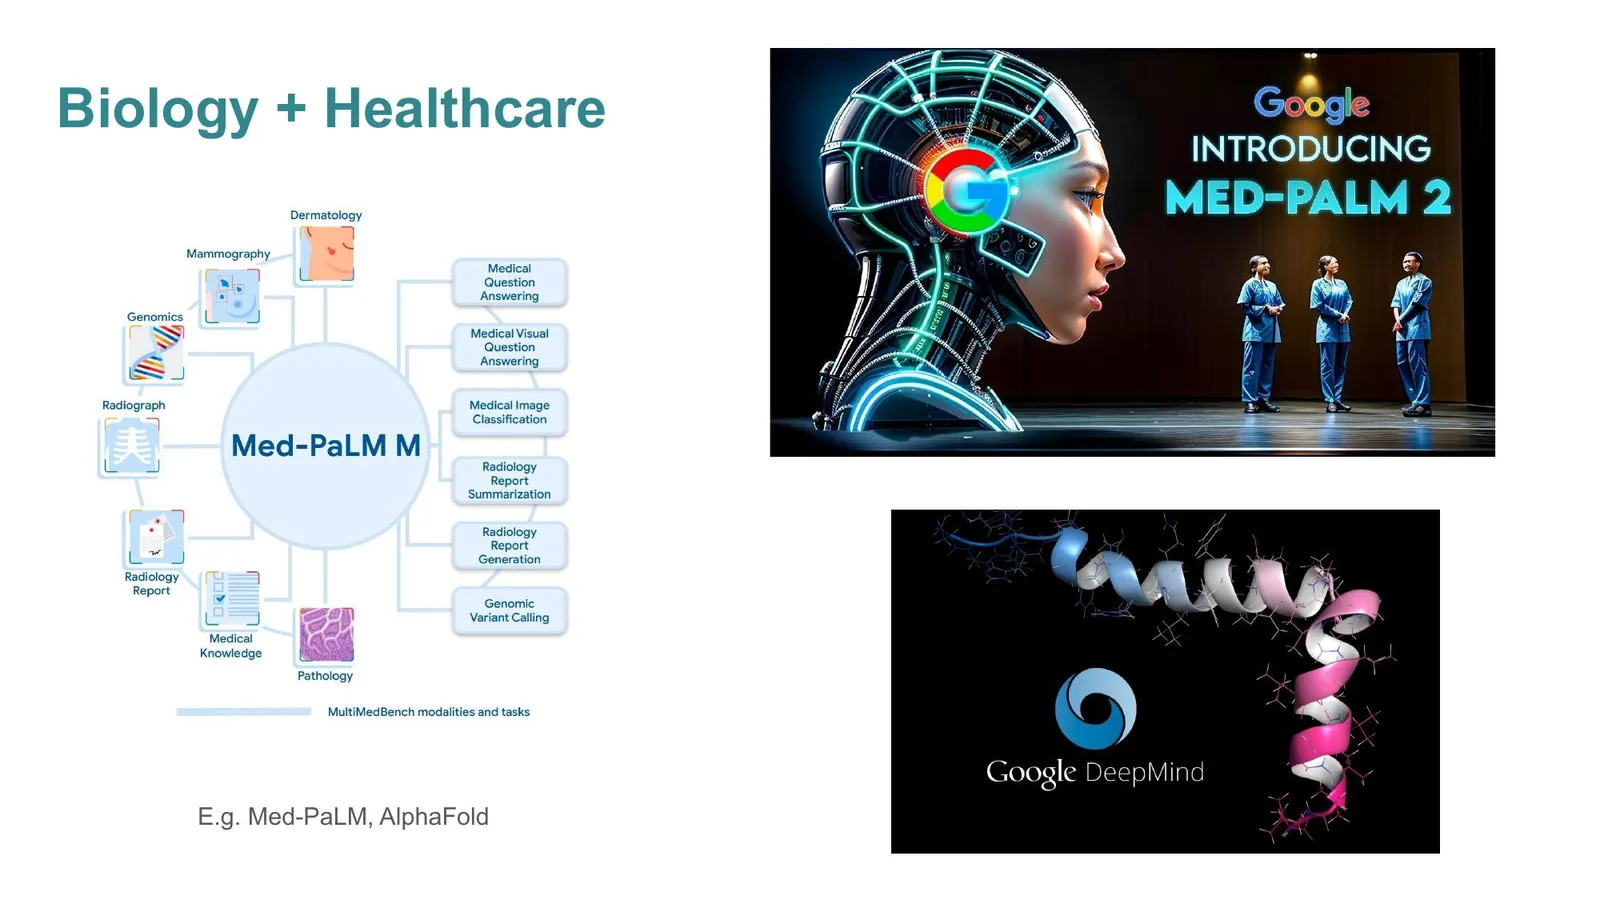
来源:官方 CS25 V4 slide deck,第 51 页
领域名称列表必须回到任务与证据
Med-PaLM、AlphaFold、robotics transformer 与 game agent 解决的对象、监督信号和安全要求完全不同。记住名称不如记住三件事:输入如何表示、输出如何验证、错误由谁承担。
本章小结
Transformer 的跨域扩张来自 attention 对集合与序列关系的通用建模能力,但每个领域仍需要自己的 tokenizer、decoder、constraint 与 evaluation。统一 backbone 降低了模型设计成本,没有消除领域知识和闭环验证。
LLM 的限制与适应:数据、记忆、更新和可解释性
应用越广,模型缺口越明显。本章沿课堂顺序讨论五组问题:训练成本与数据效率,记忆和个性化,合成数据与 memorization,持续学习与 model editing,self-reflection 与 hallucination。它们都在回答同一个问题:冻结参数之后,系统怎样继续学习、更新和自我纠错。
数据、计算与研究集中化
训练大型模型需要海量 token、accelerator time、energy 与工程基础设施。课堂把这一点与研究民主化联系起来:当可重复实验只能由少数机构承担时,方法比较、开放审计和学生参与都会受限。本节先看成本页,再转向 BabyLM 与小模型,回答“能力提升是否只能购买更多计算”。
来源:官方 CS25 V4 slide deck,第 53 页
训练计算的粗略尺度
Dense Transformer 预训练常用近似
其中 \(N\) 是参数量,\(D\) 是训练 token 数,\(C\) 是浮点运算量级。常数会随 architecture 与实现变化,但近似揭示两个事实:参数和数据都会线性推高训练计算;更高质量 token、稀疏激活与高效 kernel 可以改变实际成本。
成本不只是一张 GPU 账单
数据收集和过滤、失败实验、checkpoint、网络通信、推理服务、评估与人类反馈都消耗资源。只报最终训练 FLOPs 会低估完整研发链路,也无法说明单位能力的成本。
BabyLM:人类数据效率提出了什么问题
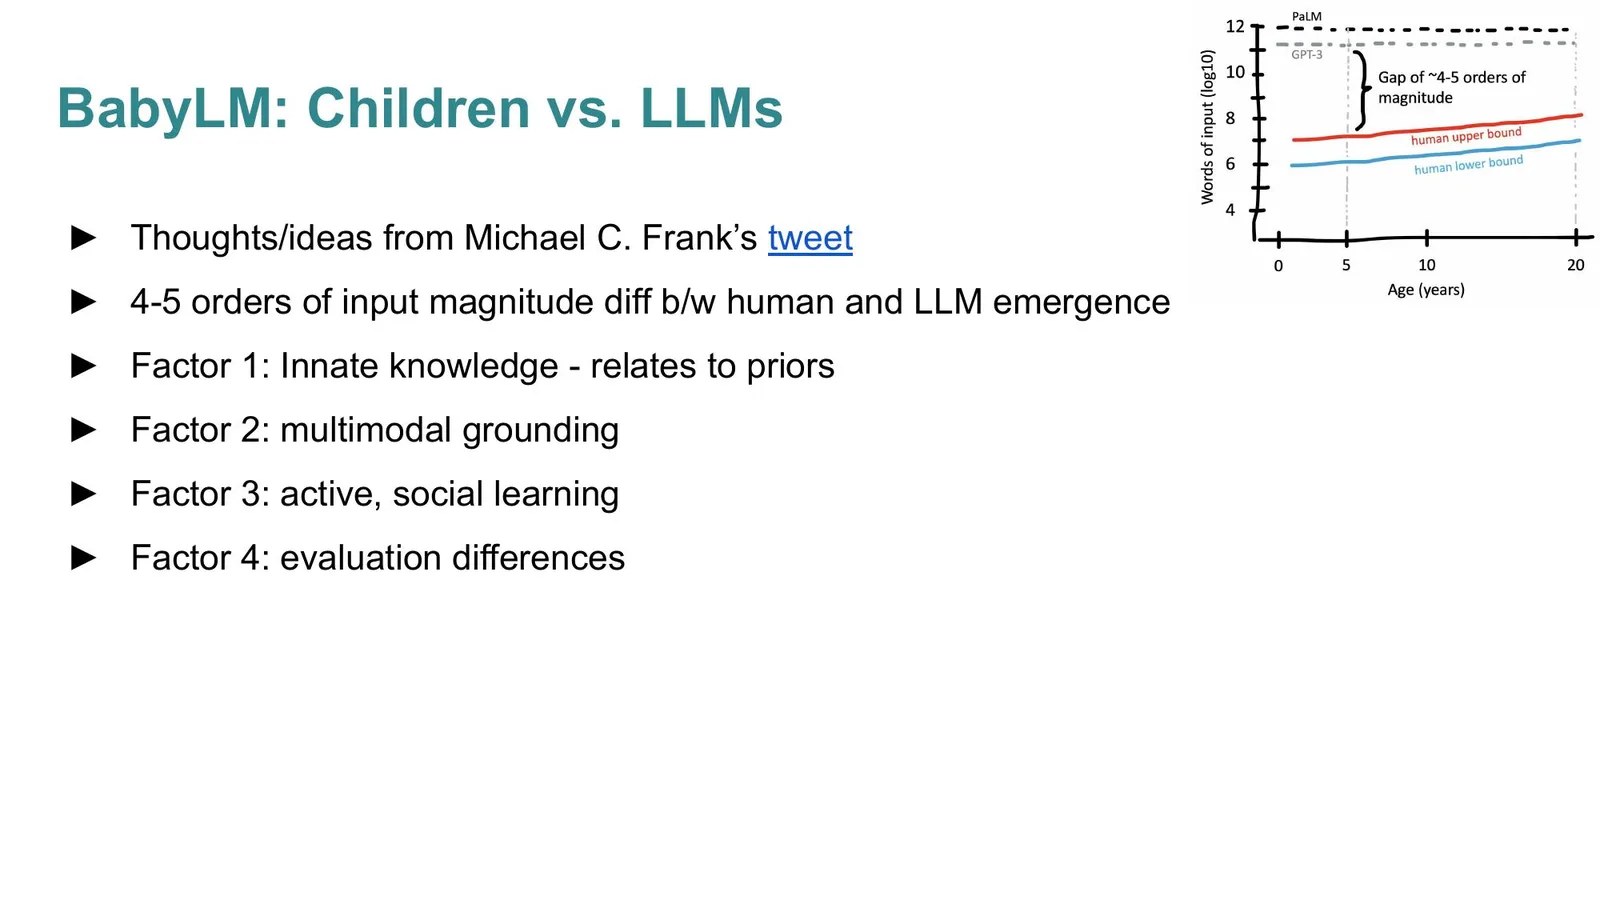
BabyLM 页把儿童与 LLM 对比:儿童接触的语言量小得多,却能依靠感知、互动、社会反馈和具身经验形成稳健概念。这个类比不能证明机器必须复制儿童学习,但它暴露了纯文本规模化的数据效率问题。读两页对照时要关注 supervision density 和 interaction,而不是只比较词数。
来源:官方 CS25 V4 slide deck,第 54 页
来源:官方 CS25 V4 slide deck,第 55 页
读图:儿童并不是“小数据语言模型”
儿童拥有视觉、动作、共同注意、情绪反馈、因果干预和持续环境。把词数直接与 LLM token 比较,会忽略 supervision density 与 interaction。BabyLM 的价值在于逼迫研究者探索更好的 data curriculum、architecture 与 inductive bias。
课堂提示
课堂没有把 BabyLM 当成“儿童证明 scaling 错了”,而是把它作为研究问题:如果人类可以用更少语言数据学习,模型是否也能借助更高质量数据、不同结构或交互获得更高 sample efficiency。
小模型与 on-device model
Minified LLM 与 on-device model 把目标从“最大通用能力”改成“可接受能力下的成本、延迟与隐私”。较小模型可以通过蒸馏、quantization、pruning、专用数据和 retrieval 提高实用性。
来源:官方 CS25 V4 slide deck,第 56 页
术语表:四种模型压缩路线
| 方法 | 核心机制 |
|---|---|
| Distillation | 用 teacher 的输出、logit 或 reasoning trace 训练 smaller student。 |
| Quantization | 用更低 bit-width 表示 weight/activation,降低内存与计算。 |
| Pruning | 删除低贡献连接、channel、head 或 block。 |
| Specialization | 用领域数据、adapter、tool 或 retrieval 缩小必须参数化的能力范围。 |
Memory augmentation 与 personalization
冻结 LLM 的参数不会随每次对话自动更新。Memory augmentation(记忆增强)把部分信息放到外部 store,需要时检索回 context;personalization(个性化)则让系统持续利用用户偏好、历史与约束。接下来的两页把“改输入、改外部记忆、改参数”并列,读图时先确认每条路线改变的对象。
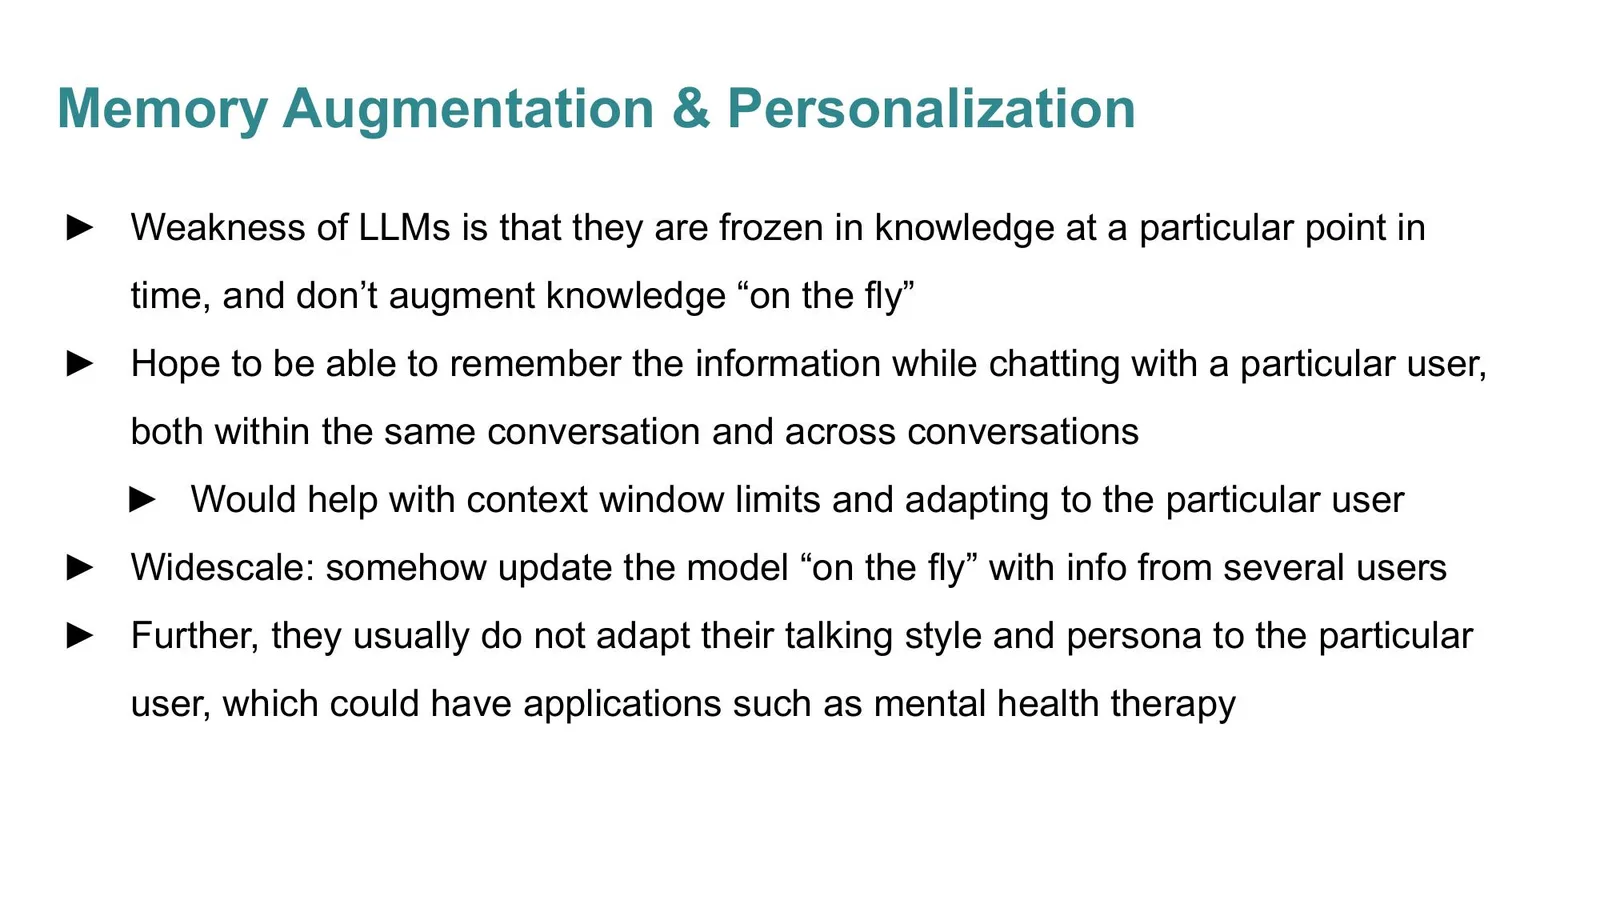
来源:官方 CS25 V4 slide deck,第 57 页
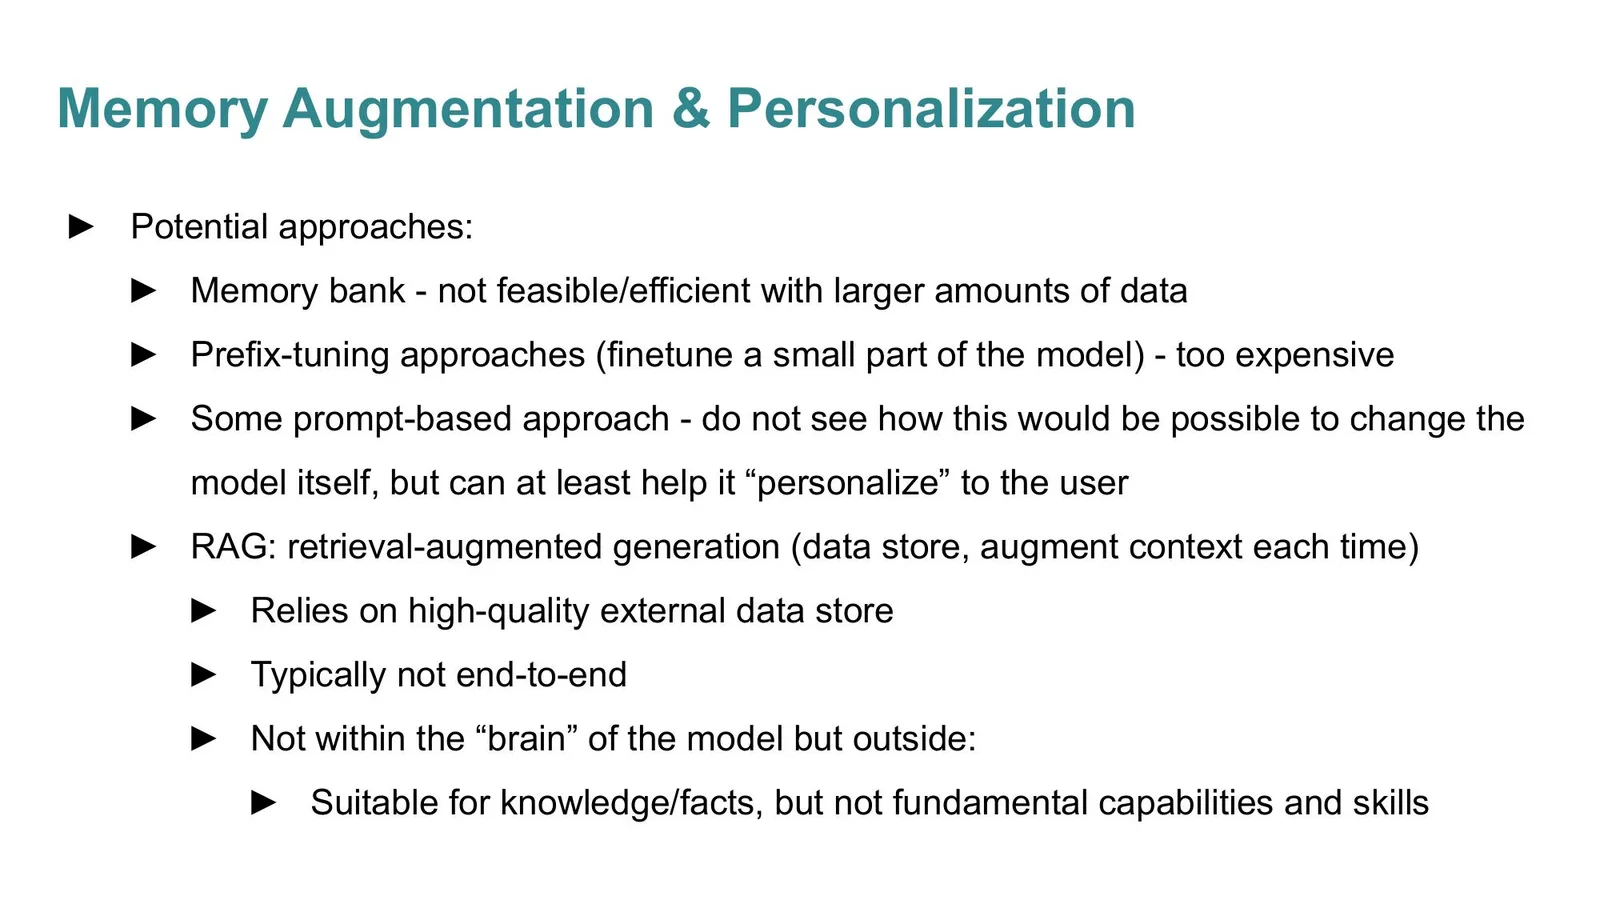
来源:官方 CS25 V4 slide deck,第 58 页
四种适应机制不要互相替代
| 机制 | 改变什么 | 适合的问题 |
|---|---|---|
| Prompt/context | 本次输入 | 临时任务说明与少量证据。 |
| Retrieval/RAG | 外部可更新 memory | 事实、文档、用户历史与可引用证据。 |
| Adapter/fine-tuning | 部分或全部参数 | 稳定行为、格式、领域分布与技能适应。 |
| Model editing | 定位后的局部参数 | 少量事实或关联的定向修改,需验证副作用。 |
最简 retrieval-augmented generation
给定 query \(q\)、文档库 \(\mathcal{D}\)、检索器 \(R\) 和生成器 \(G\):
\(z_{1:k}\) 是 top-\(k\) evidence。检索扩大可访问知识,却不保证 evidence 正确、排序合理或 generator 真正使用它。
def answer(query, memory, encoder, generator, top_k=5):
    query_vector = encoder(query)
    evidence = memory.search(query_vector, top_k=top_k)
    prompt = build_prompt(query=query, evidence=evidence)
    return generator(prompt), evidence
课堂提示
讲者特别区分了外部 memory 与内部 skill:RAG 适合补事实和用户历史,但不会自动让模型获得新的基础能力。若 datastore 质量差,检索只会把错误更快送进 context。
Synthetic data 与 Phi:数据质量能否替代部分规模
合成数据(synthetic data)用强模型生成 instruction、answer 或 reasoning trace,再训练其他模型。它降低人工收集成本,也可能复制 teacher 的错误、风格偏差和盲区。本节用 Phi 作为数据质量路线的代表案例,先看数据生成与筛选,再看小模型结果的适用范围。
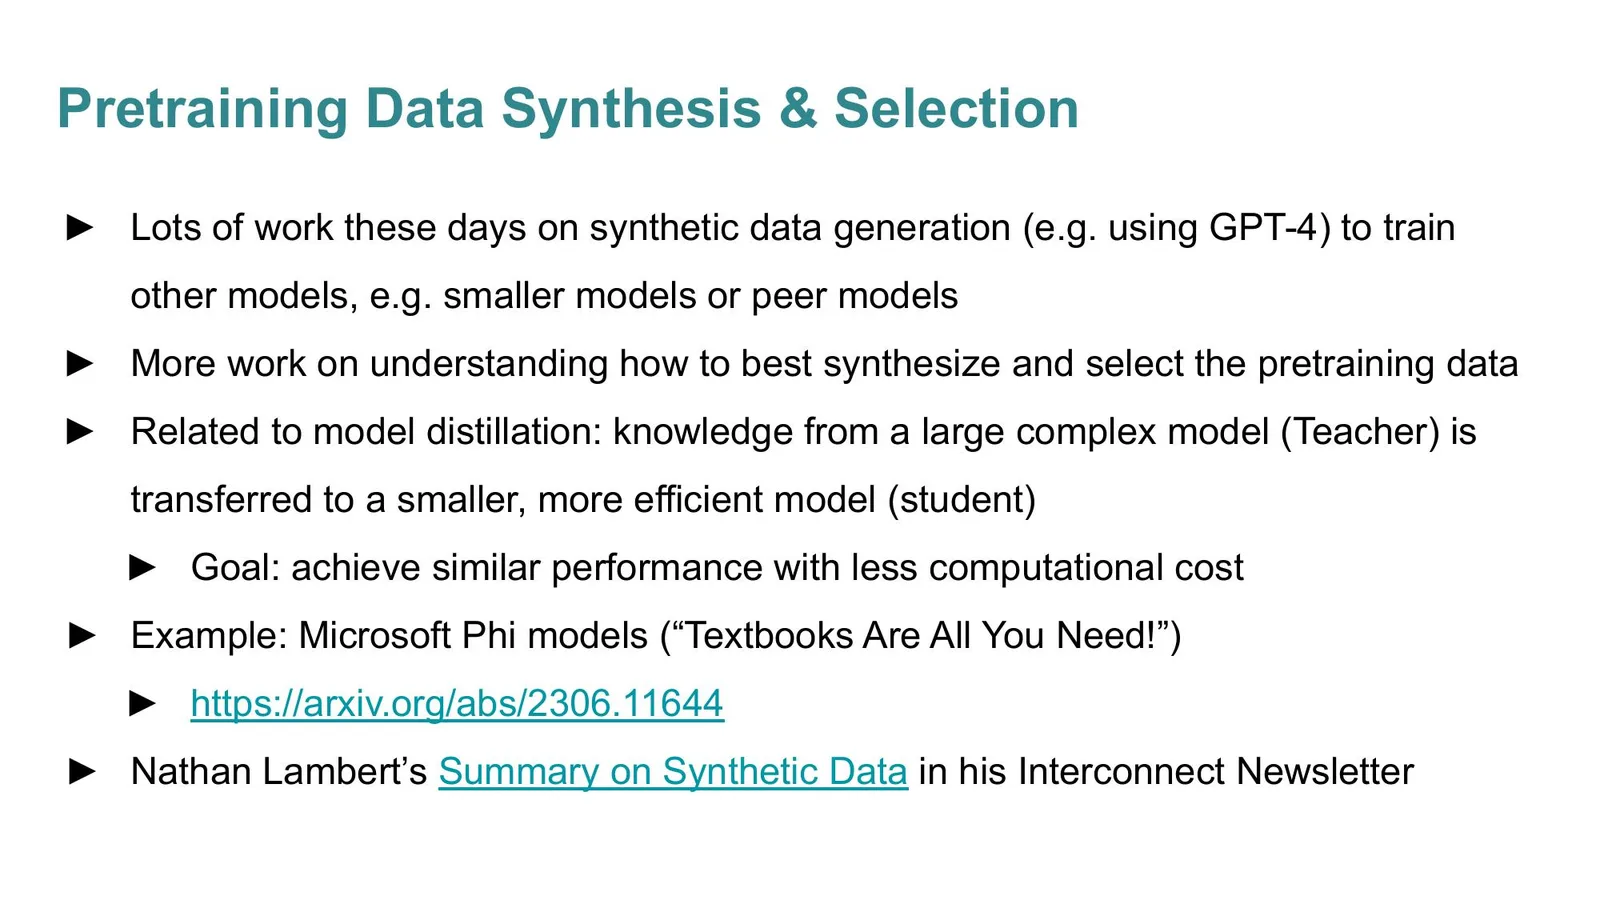
来源:官方 CS25 V4 slide deck,第 59 页
Synthetic data 的三个闭环风险
- Error inheritance:teacher 的错误被 student 重复学习;
- Diversity collapse:生成分布比真实世界更窄,反复训练后模式趋同;
- Evaluation leakage:prompt 或答案与 benchmark 重合,造成虚高分数。
因此需要 provenance、deduplication、quality filter 与真实数据对照。
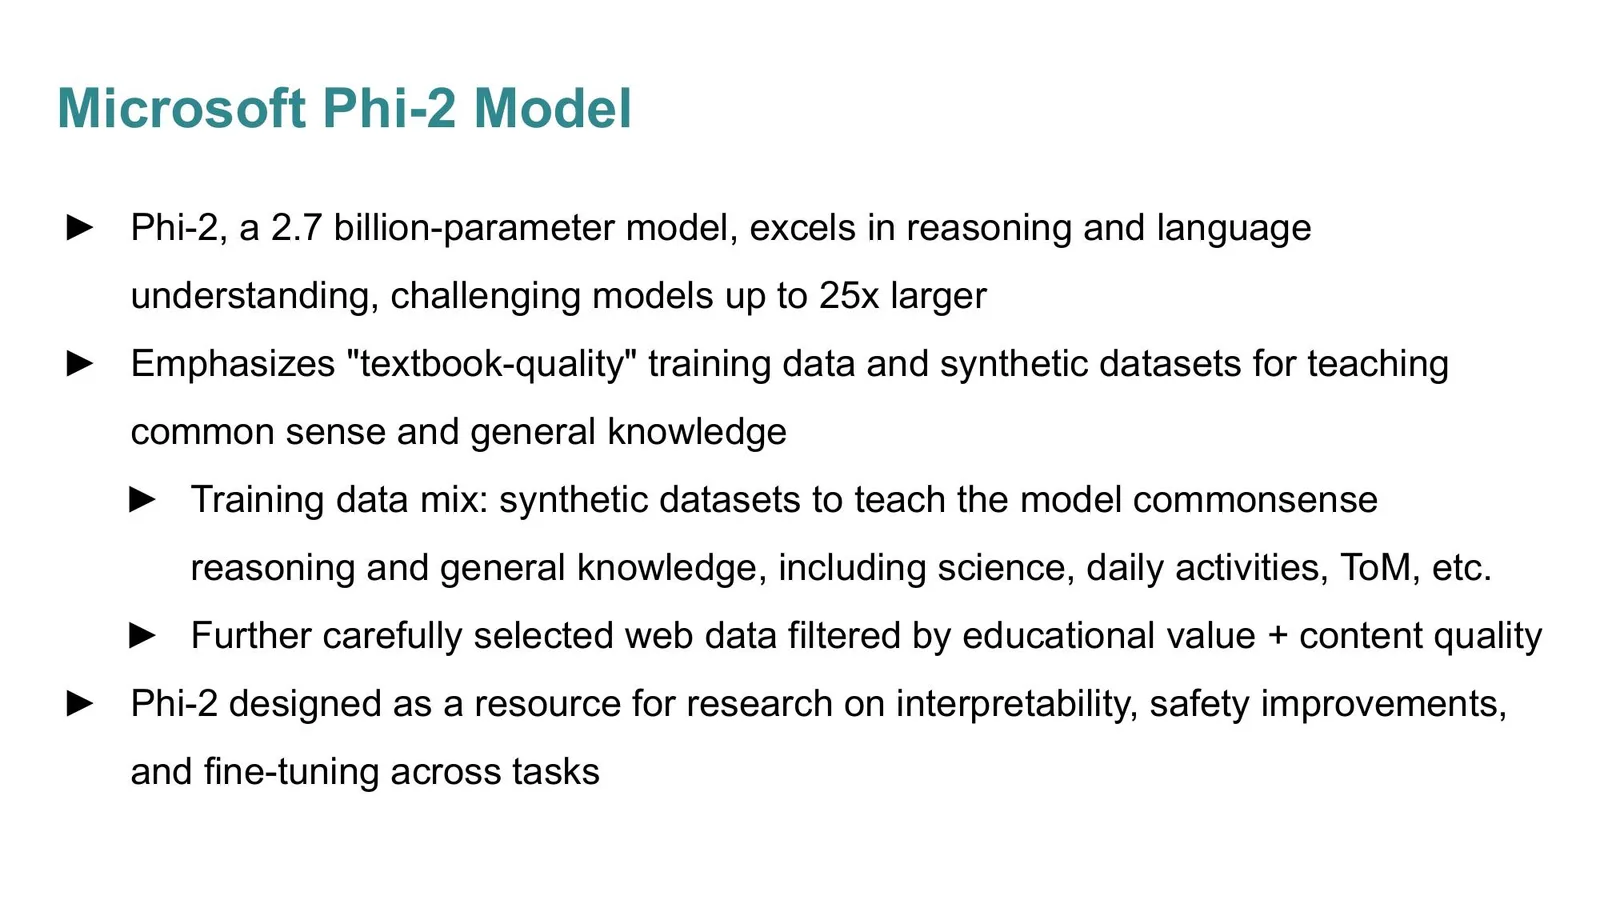
来源:官方 CS25 V4 slide deck,第 60 页
课堂提示
讲者把 Phi 的关键 takeaway 放在 data source 与 quality,而不是把小参数量本身写成魔法。更少参数能否保持能力,取决于任务覆盖、数据筛选和评估范围。
读图:Phi 代表“每个 token 更有价值”的路线
课堂强调 textbook-quality data 与 synthetic reasoning data,使较小模型在部分任务上接近更大模型。图不证明小模型在所有能力上等价,而是说明参数规模之外,data selection 和 curriculum 可以显著改变结果。
Learning 还是 memorizing
训练数据与 benchmark 不透明时,模型输出可能来自组合式泛化,也可能来自近似记忆。测试污染(test contamination)会让模型在评估前见过题目或高度相似内容,使分数无法代表新任务泛化。下面的争论页应作为 evaluation design 问题阅读,而不是要求在“会思考”和“只背诵”之间仓促二选一。
来源:官方 CS25 V4 slide deck,第 61 页
Memorization audit 的三个层次
- Exact match:能否复现训练文本的长片段;
- Near duplicate:训练集是否含题目、模板或答案的轻微改写;
- Behavioral generalization:换实体、结构或约束后,机制是否仍然成立。
只做第一层会漏掉大量 contamination,只看最终准确率又无法区分记忆与泛化。
版权争议与认知争议不要混为一谈
模型是否“理解”是认知与行为问题;训练数据是否获授权、输出是否过度复现原作是法律与治理问题。两者相关,但不能用一个结论替代另一个。
Continual learning:不是定期重训的别名
Continual learning(持续学习)要求模型在新经验到来时更新,同时保留旧能力并控制灾难性遗忘。课堂用人类日常学习作对照,批评把 trace distillation 或周期 fine-tuning 直接称为永久自我改进。本节先定义 stability–plasticity tradeoff,再解释为什么单次新任务提分不足以证明持续学习。
来源:官方 CS25 V4 slide deck,第 62 页
Continual-learning objective
对任务流 \(\mathcal{T}_1,\ldots,\mathcal{T}_m\),更新后模型既要降低新任务损失,也要限制旧任务退化:
\(\Omega_i\) 是保持旧知识的 regularization、replay 或 parameter constraint,\(\lambda\) 控制 plasticity 与 stability 的平衡。真正困难的是没有完整旧数据时仍能验证遗忘。
课堂提示
讲者用一个直观反差说明问题:人类不会每两个月坐下来重新“读完整个互联网”才能继续学习。把新 trace 蒸馏进模型更接近再训练,不等于在线、终身的持续学习。
Interpretability 与 model editing
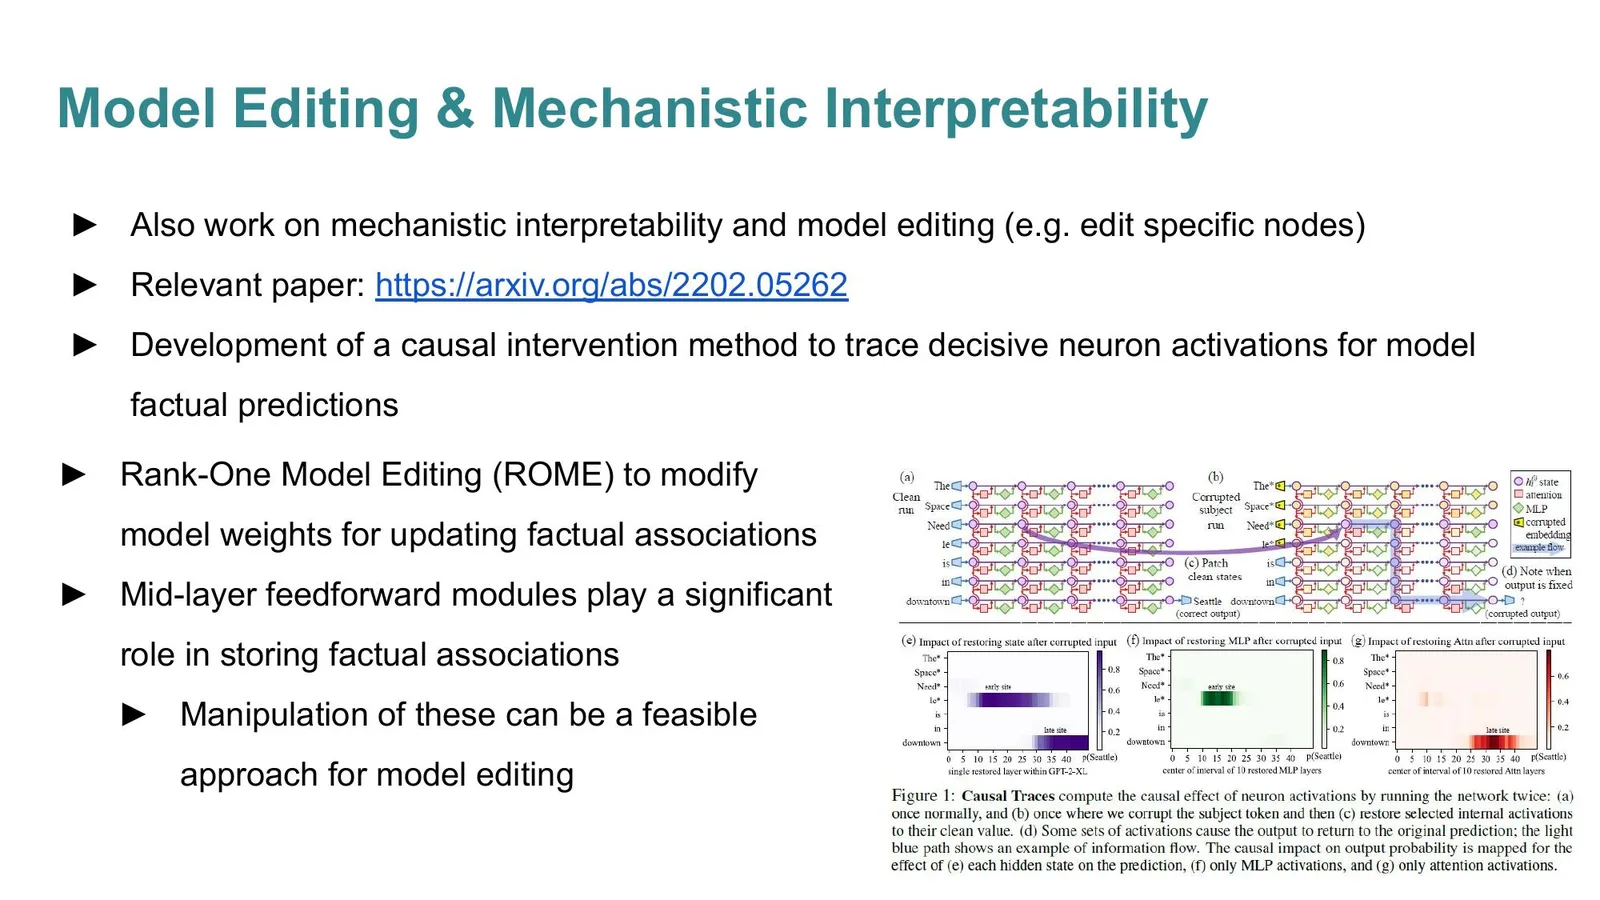
Interpretability(可解释性)试图理解内部表示和计算如何导致输出;mechanistic interpretability 更关注具体 component、circuit 与 causal intervention。Model editing 则希望定向改变某个事实关联,而不完整重训模型。
来源:官方 CS25 V4 slide deck,第 63 页
三种“解释”不要混用
| 层次 | 回答的问题 |
|---|---|
| Behavioral explanation | 输入变化怎样影响输出,模型在什么分布失效? |
| Attribution/probing | 哪些 token、activation 或 feature 与输出相关? |
| Mechanistic/causal analysis | 干预某个 component 是否稳定改变目标行为? |
相关性可帮助定位,不自动构成因果机制。
来源:官方 CS25 V4 slide deck,第 64 页
Rank-one edit 的抽象形式
若希望将某层权重 \(W\) 定向更新,可写成
其中 \(u,v\) 是由目标 key/value relation 求得的向量。Rank-one update 成本低,但验收必须同时检查 edit success、paraphrase generalization、locality 与 unrelated knowledge damage。
改对一条事实不代表模型“知识库已修复”
事实可能分布在多个层和上下文中;局部编辑还可能改变相邻实体或语言模式。Model editing 需要 regression suite,而不是只展示目标 prompt 已输出新答案。
MoE、modularity 与自我反思
课程再次回到 MoE,并提出一个更大胆的问题:能否像人脑功能分区一样,让单一模型内部形成可复用模块。这个类比适合激发 architecture 设计,却不能掩盖 router、expert specialization 与 global coordination 的实际难题。
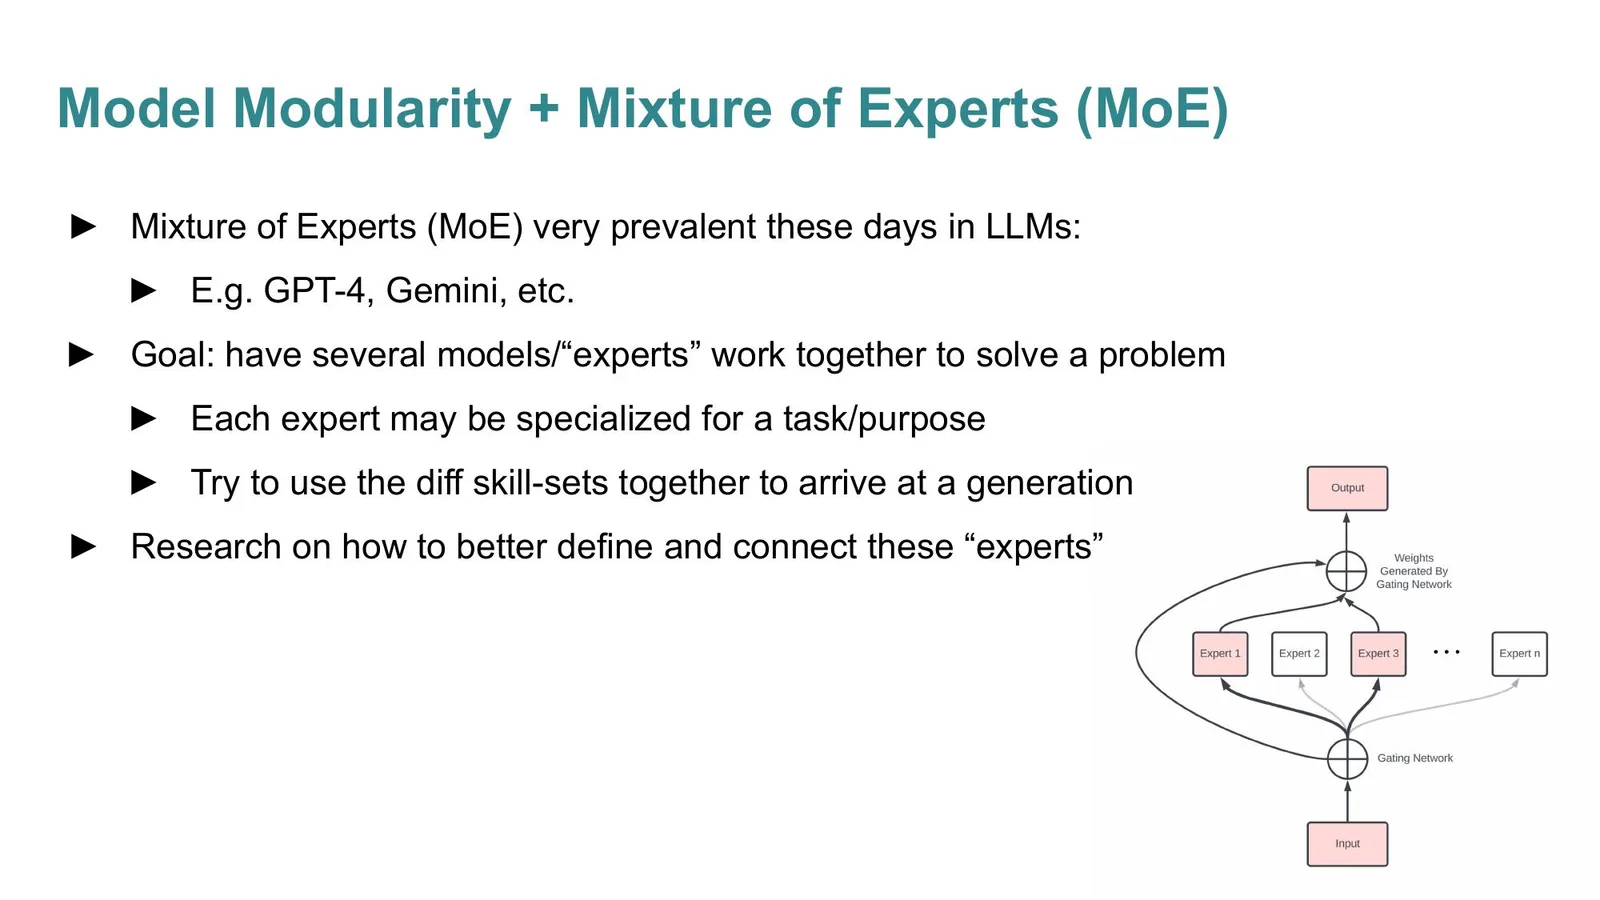
来源:官方 CS25 V4 slide deck,第 65 页
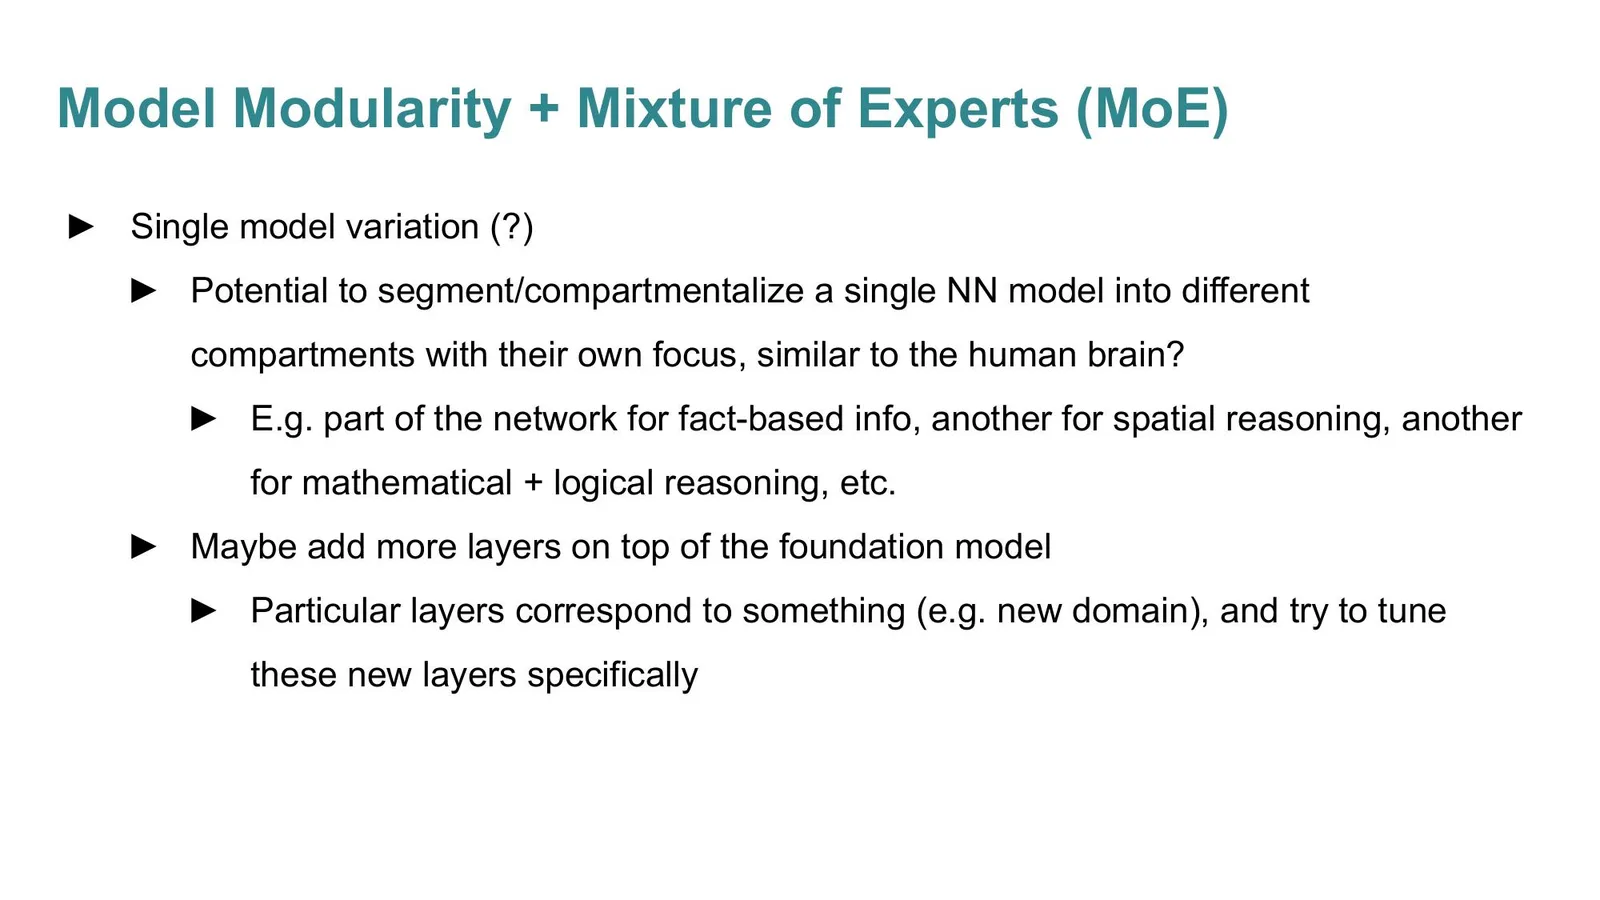
来源:官方 CS25 V4 slide deck,第 66 页
模块化必须有接口和验收指标
如果模块之间没有明确输入输出、routing criterion、capacity 和 failure isolation,“模块化”只是一张概念图。可测指标包括 expert load、token drop、routing entropy、specialization、通信成本与故障传播。
Self-reflection(自我反思)让模型读取自己的答案、生成 critique,再迭代修改。它可以增加 test-time compute,也能把错误暴露出来;如果 critique model 与原模型共享盲区,循环可能只产生更长、更自信的错误。
来源:官方 CS25 V4 slide deck,第 67 页
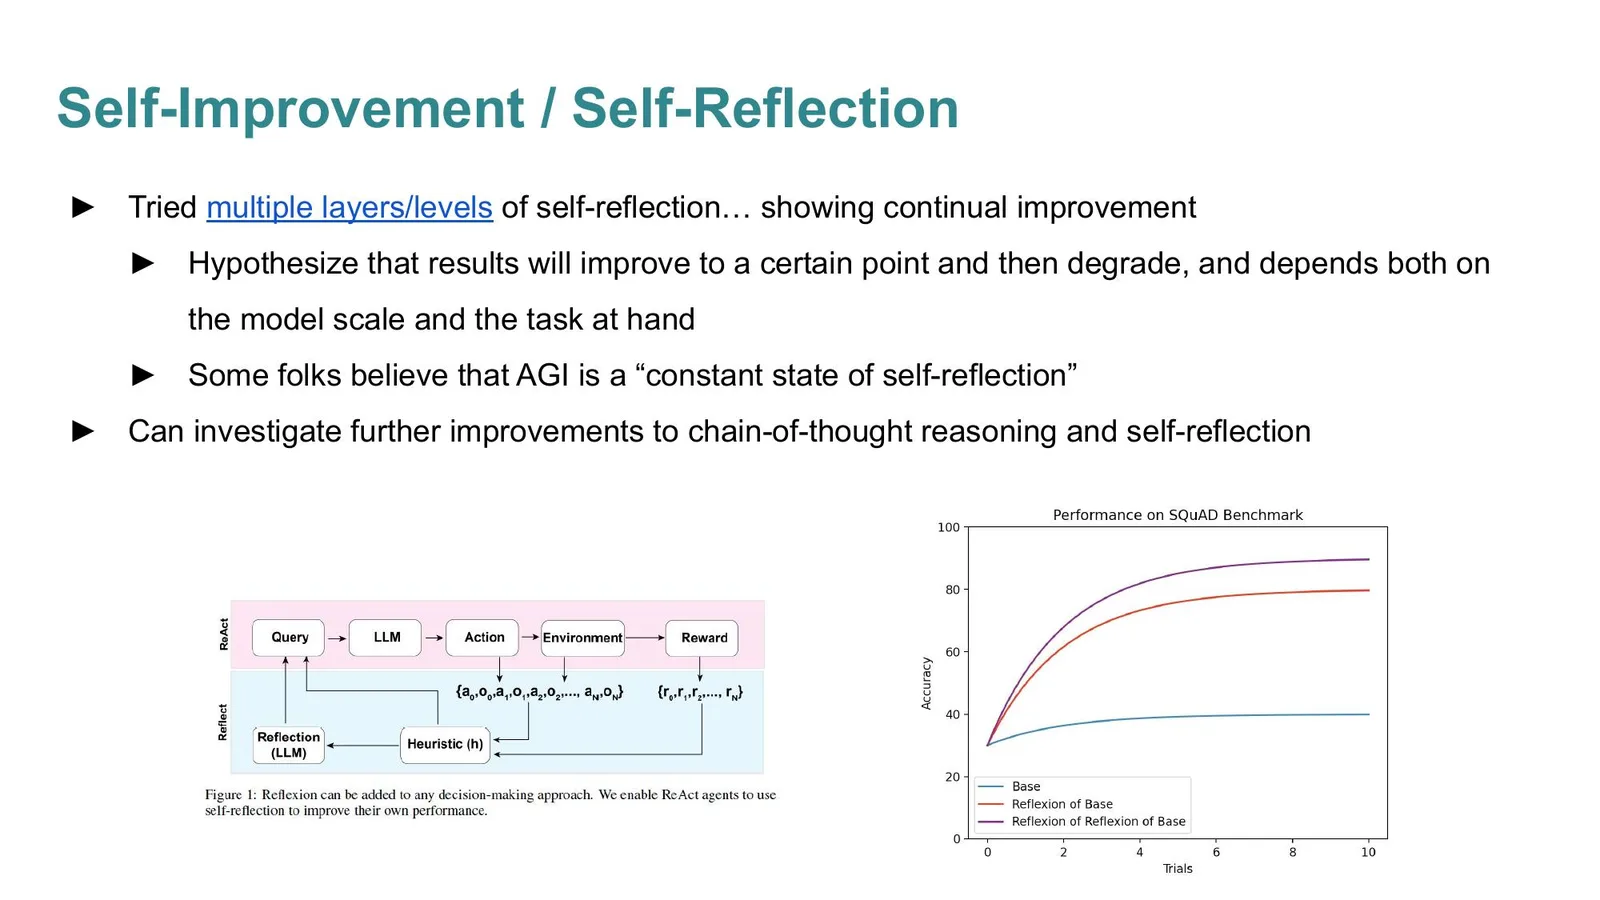
来源:官方 CS25 V4 slide deck,第 68 页
Reflection loop
设初始回答为 \(y_0=G(x)\),第 \(t\) 轮生成 critique \(c_t=C(x,y_t)\),再修订
\(G\) 是生成器,\(C\) 是 critique 过程,\(R\) 是 revision 过程。循环需要外部 stopping rule 与 verifier;否则“继续反思”可能增加成本而不增加正确性。
Hallucination、calibration 与外部证据
Hallucination 页把问题描述为“模型不知道自己不知道”。更精确地说,模型可能在缺乏证据时仍给出高置信语言。Calibration(校准)关注置信度与实际正确率是否匹配;retrieval 和 verifier 则尝试引入外部证据。
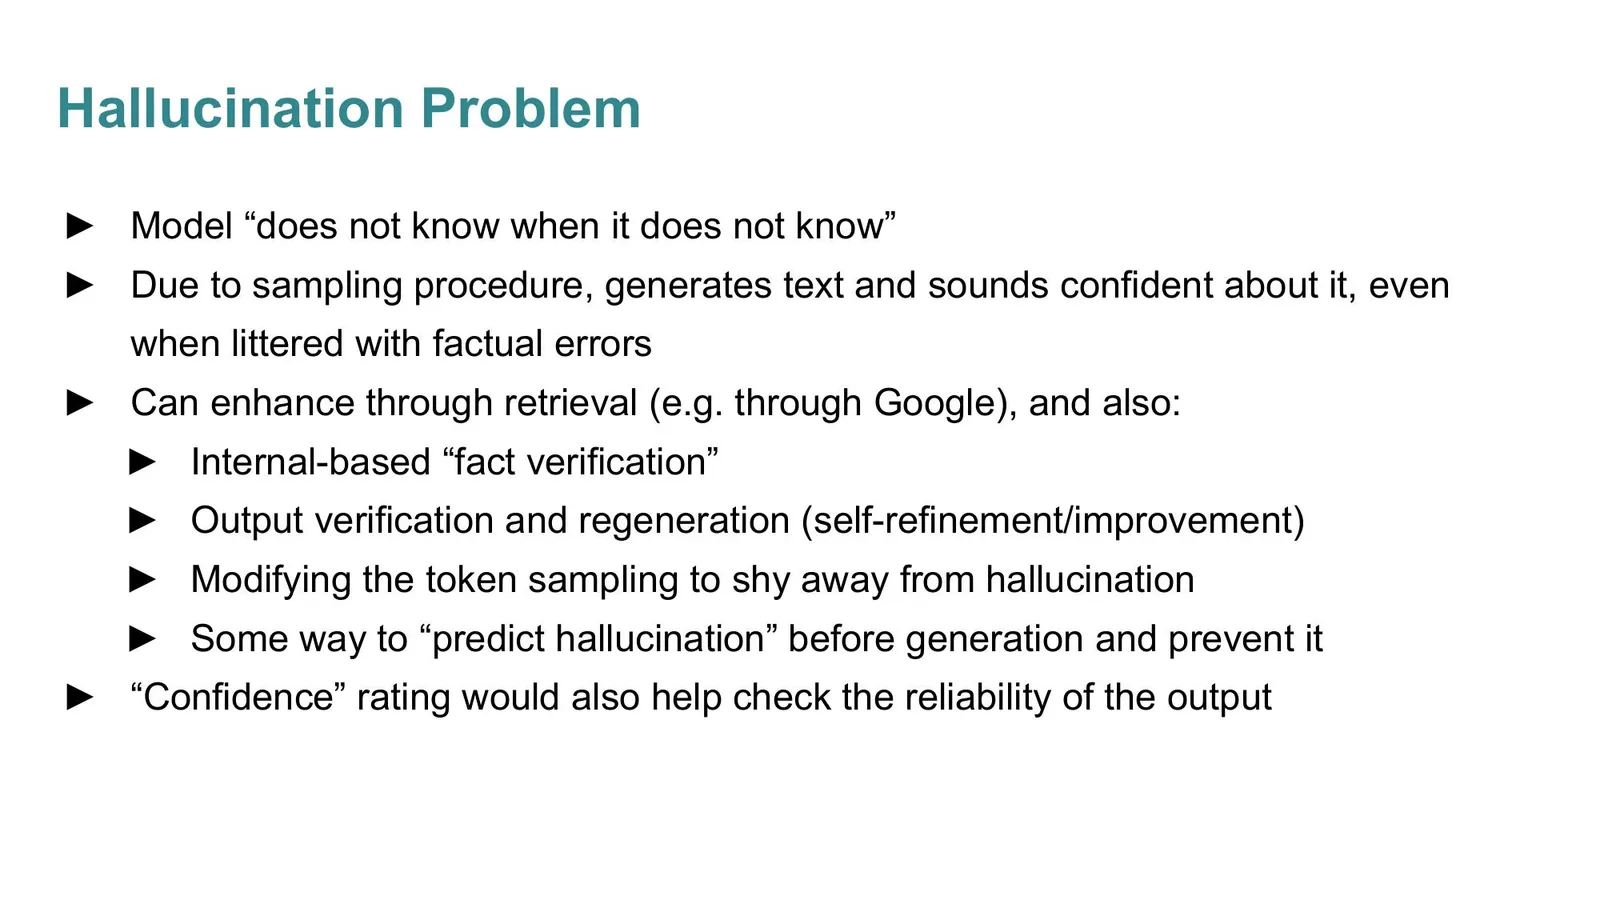
来源:官方 CS25 V4 slide deck,第 69 页
Calibration 的定义
若模型对一组回答给出置信度 \(q\),理想校准要求
校准良好不等于准确率高;一个经常回答“不确定”的模型可能很校准。反过来,高准确率模型也可能对少数错误过度自信。
Temperature 不是事实性旋钮
降低 sampling temperature 会让分布更尖、更接近 greedy decoding,却不能把错误知识变成正确知识。事实性需要 evidence、retrieval、verification、训练数据与任务约束共同支持。
本章小结
LLM 的主要缺口不是一个独立 bug,而是一组相互耦合的问题:数据和计算决定可学范围,外部 memory 提供更新通道,持续学习与 model editing 改变参数,interpretability 帮助定位机制,reflection 和 calibration 改变推理时行为。任何单一方法都不能自动同时解决知识、技能、事实性和长期适应。
Reasoning scaffold:让中间过程可搜索、可检查
课程最后一段模型内容讨论 Chain-of-Thought、Tree of Thoughts 与 Socratic Questioning。共同思路是把“一次直接输出”改成多步中间过程,使模型获得更多 test-time compute,也给系统留下检查和回退的位置。
CoT 为什么可能有用
Chain-of-Thought(思维链,CoT)通过示例或指令要求模型生成中间步骤。对多步算术和符号任务,直接映射问题到答案很难;把任务分解后,每一步局部关系可能更接近训练分布。接下来的两页先展示 intermediate guidance,再比较 standard prompt 与 CoT example 的信息差。
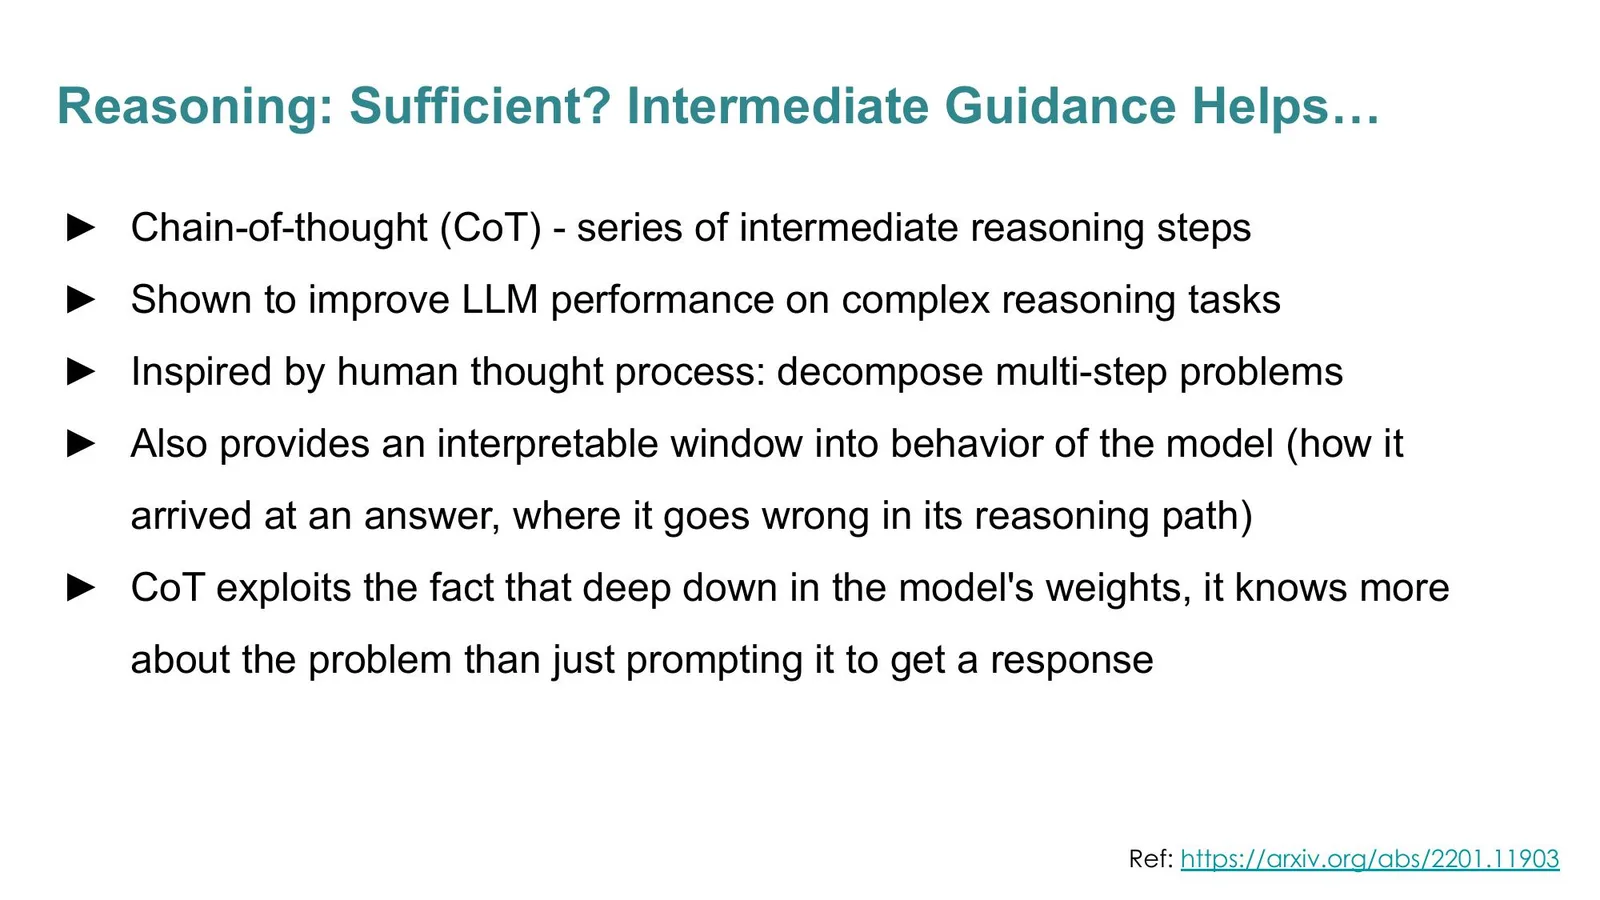
来源:官方 CS25 V4 slide deck,第 70 页
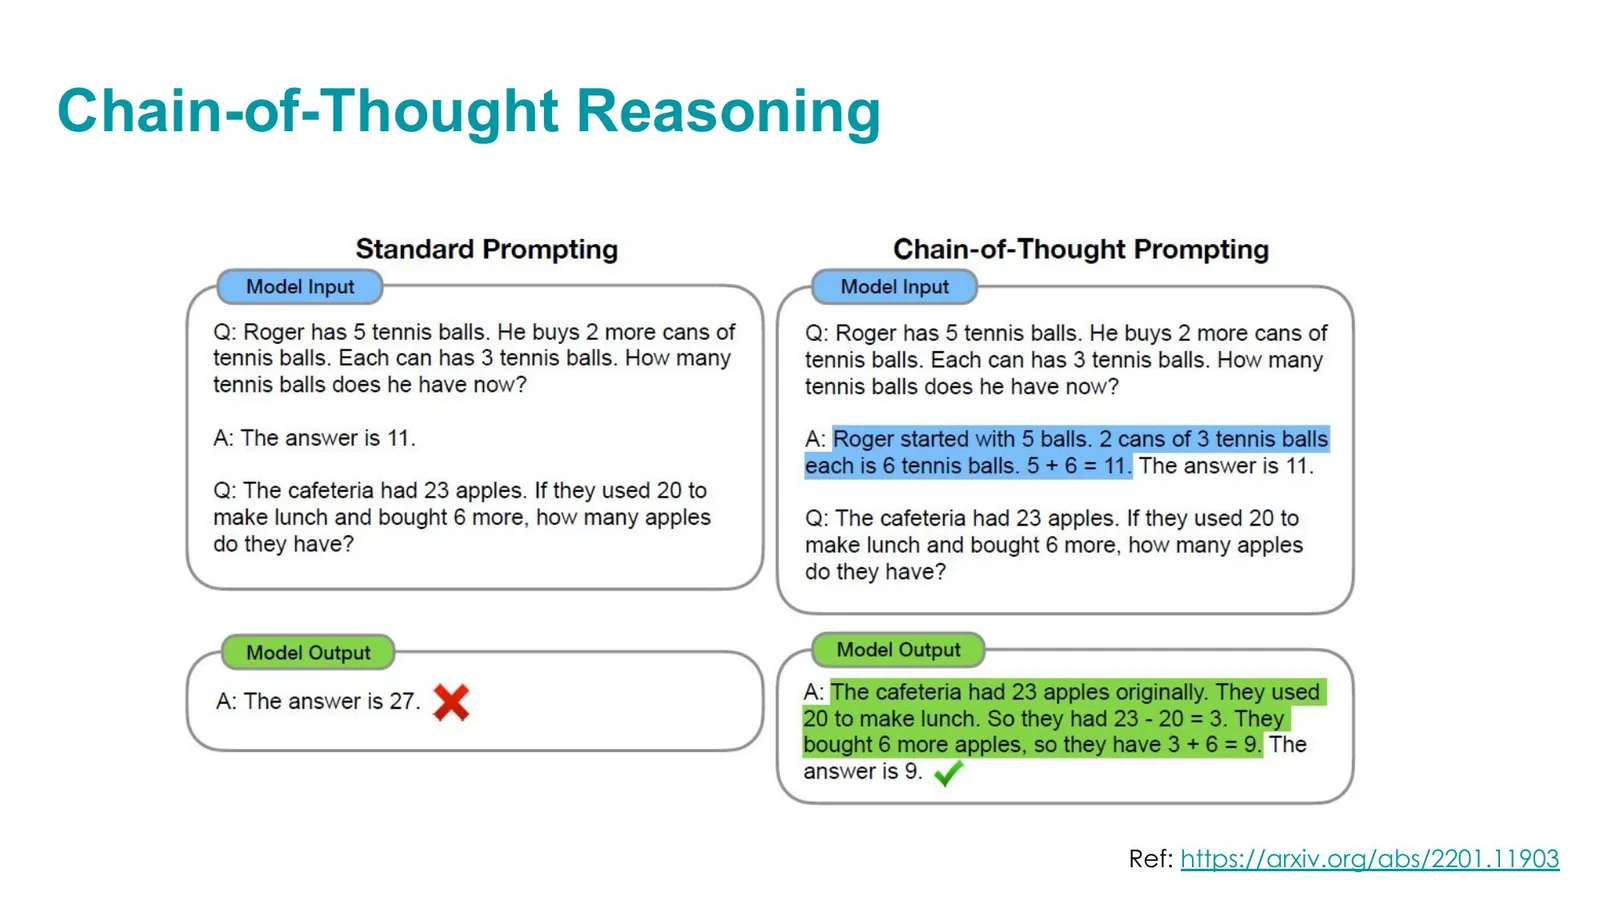
来源:官方 CS25 V4 slide deck,第 71 页
CoT 的概率分解
令中间 reasoning trace 为 \(r\)、最终答案为 \(y\),生成过程可写成
实际 decoding 只采样或搜索少量 \(r\)。CoT 的优势来自更丰富的中间计算与分解,不保证采样到的 trace 真实反映模型内部因果过程。
课堂提示
讲者用十位数乘法说明中间步骤的直觉:人类通常也要分步计算。CoT 的额外价值是错误可见,读者能定位模型在哪一步遗漏或误解,而不是只看到一个错误答案。
性能提升之外,要看错误类型
CoT 在大模型上常有提升,但仍会生成无关步骤、局部错误或正确过程后的错误结论。课堂把错误分成 missing step 与 semantic misunderstanding,尤其强调小模型可能连局部 mapping 都不稳定。本节读图重点是 error taxonomy 与 model size,而不是只记住平均性能上升。
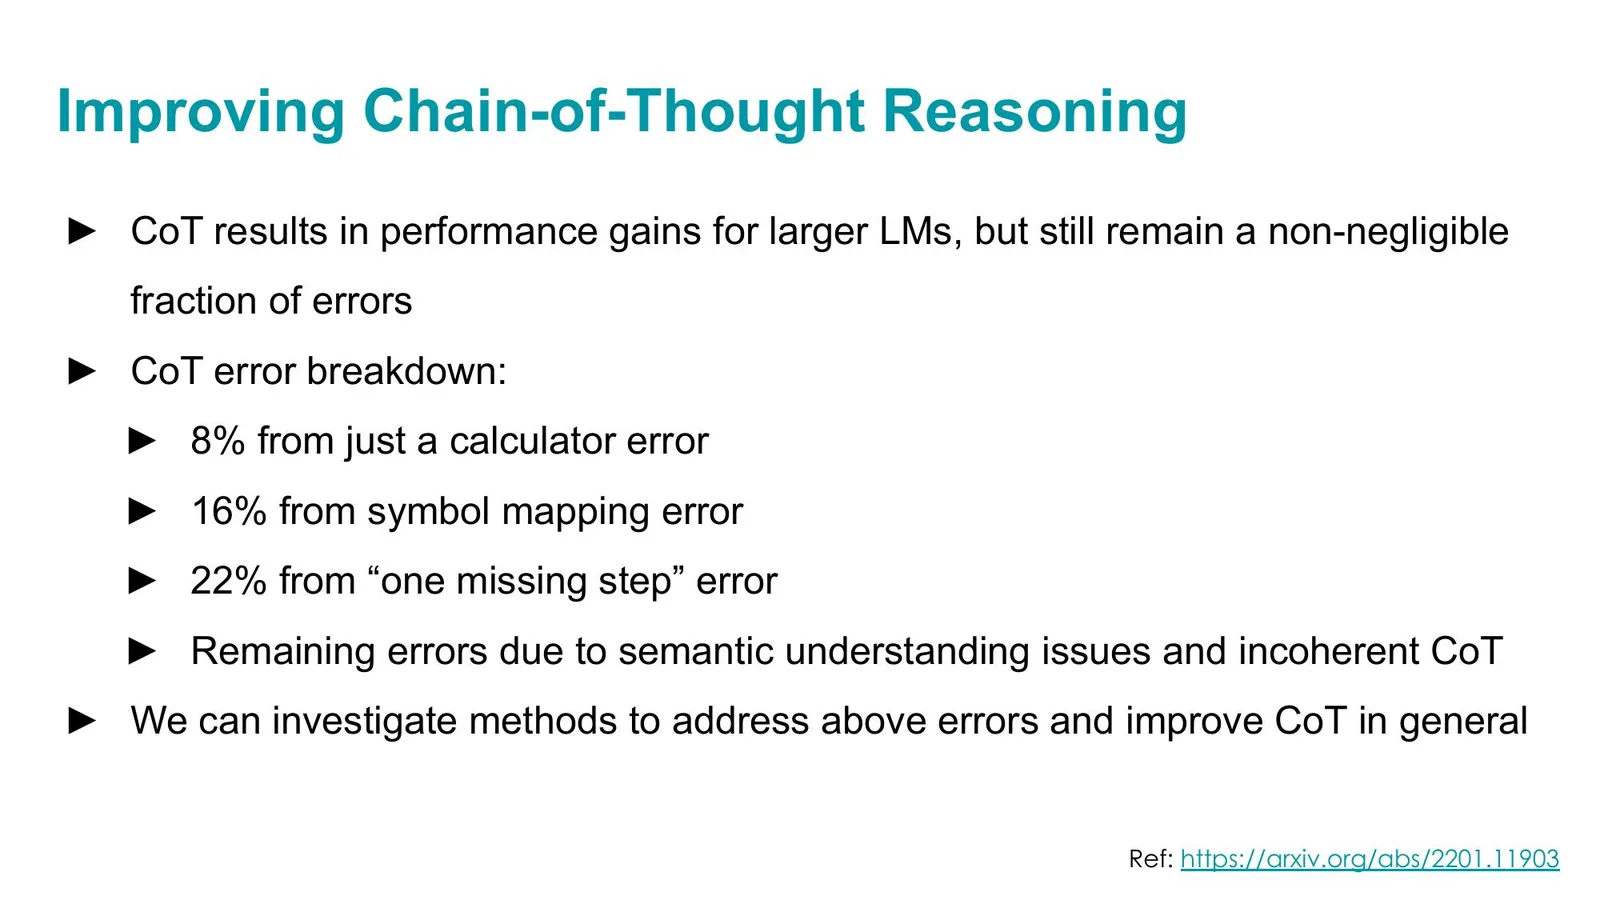
来源:官方 CS25 V4 slide deck,第 72 页
长 rationale 不等于可靠 reasoning
模型可以生成格式完整却与答案无关的解释,也可以在得到答案后反向编写理由。验收应看中间状态是否可执行、可验证、能否支持 counterfactual change,而不是只看文字是否像推理。
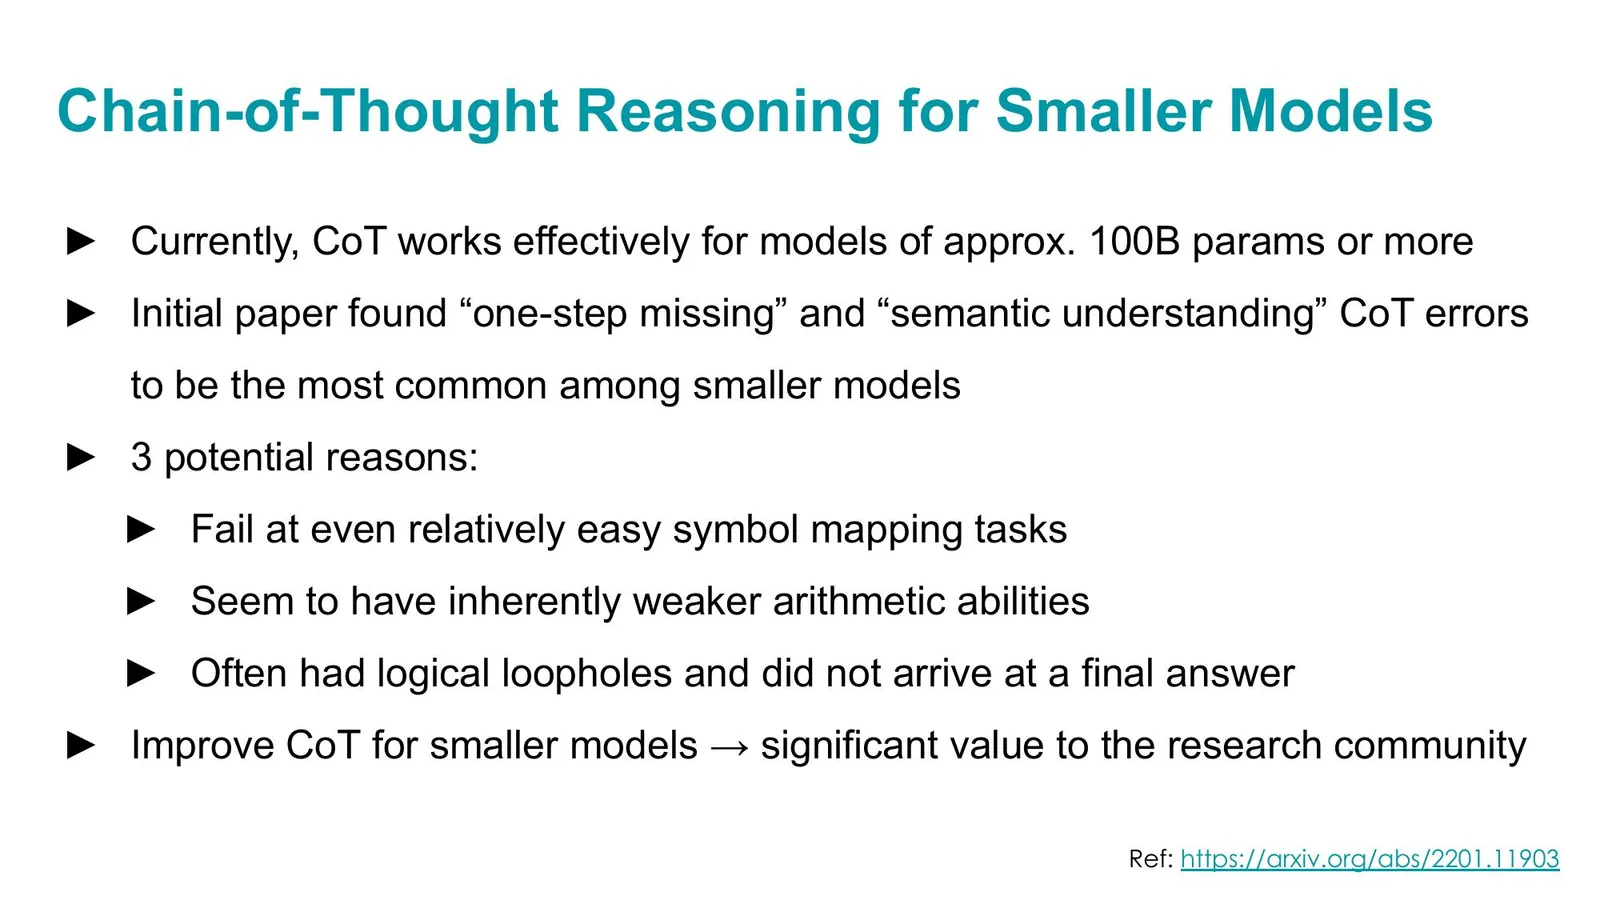
来源:官方 CS25 V4 slide deck,第 73 页
为什么小模型更容易在 CoT 中失败
CoT 增加了序列长度和必须保持的一致性。若模型缺少基本语义或算术能力,更多 token 会创造更多出错位置。改进路线包括分步 supervision、tool execution、verifier、distillation 与更结构化的 state representation。
Generalized CoT:推理不只有一条线
课程提出 CoT 定义过于刚性:不同问题可能需要分支搜索、回溯、子问题递归或外部工具。Generalized reasoning 的重点是选择合适的 computation graph。下面三页从线性 trace 过渡到 tree search 和 recursive decomposition,比较 state、transition 与 verifier。
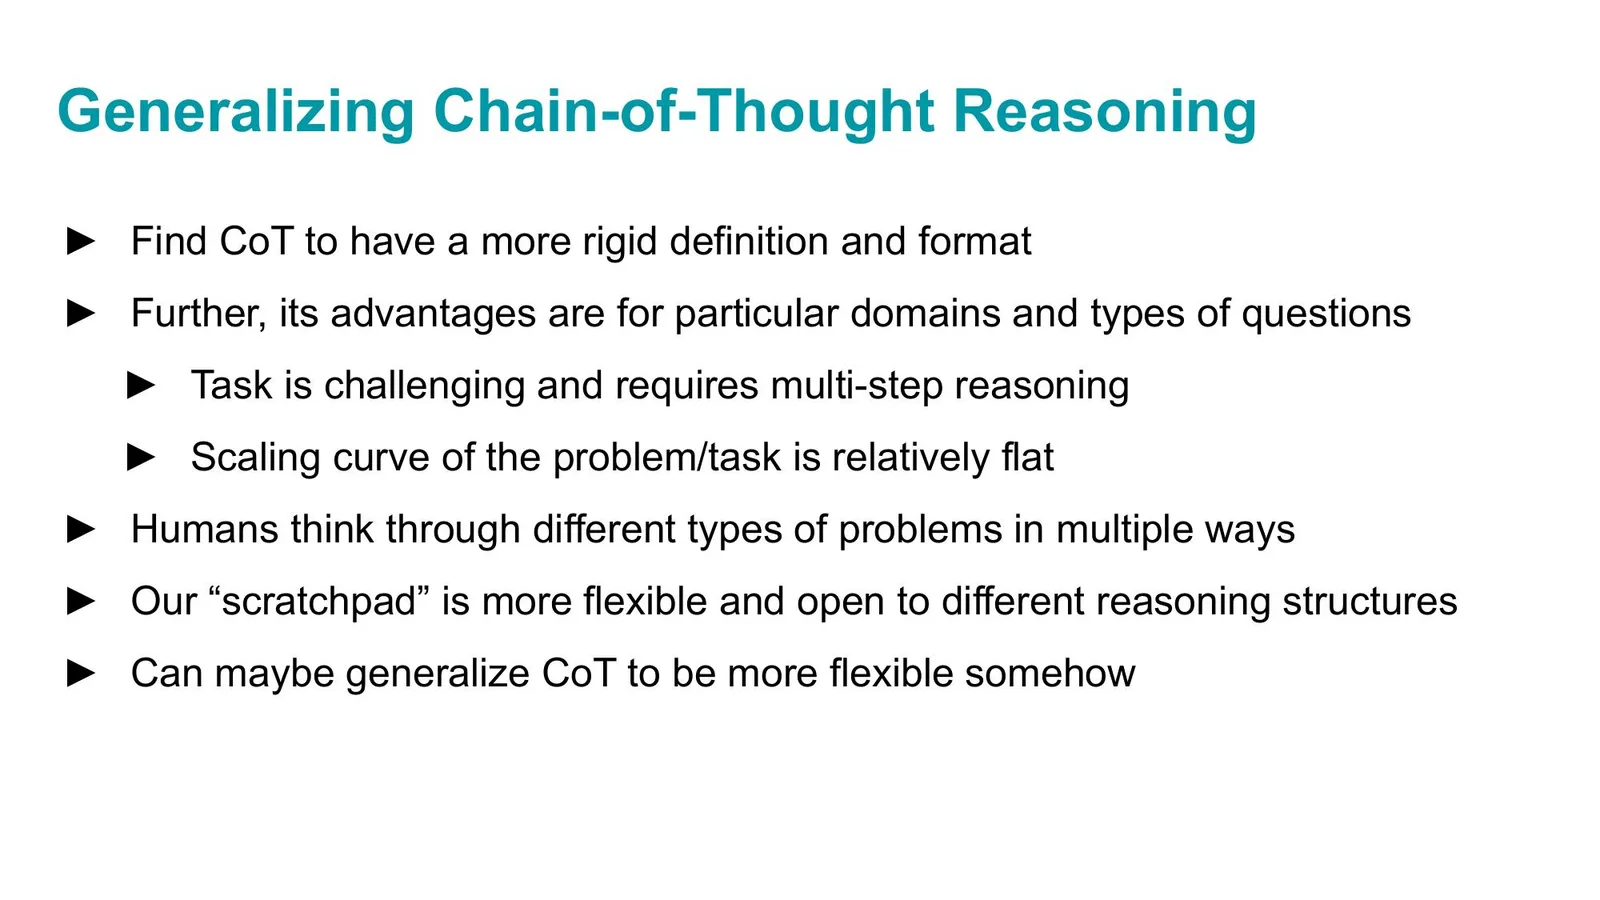
来源:官方 CS25 V4 slide deck,第 74 页
Reasoning scaffold 的三个设计轴
- State:中间状态是自然语言、程序、方程还是环境 observation;
- Transition:下一步由模型采样、规则、搜索或工具执行产生;
- Verifier:局部状态怎样评分、剪枝、回退与终止。
只有把三者写清楚,推理方法才不只是 prompt 风格。
Tree of Thoughts 与 Socratic decomposition
Tree of Thoughts(思维树,ToT)维护多个候选状态并进行 lookahead/backtracking;Socratic Questioning(苏格拉底式提问)递归提出子问题,再把答案组合回原问题。两者都用更多 inference compute 换取搜索空间。
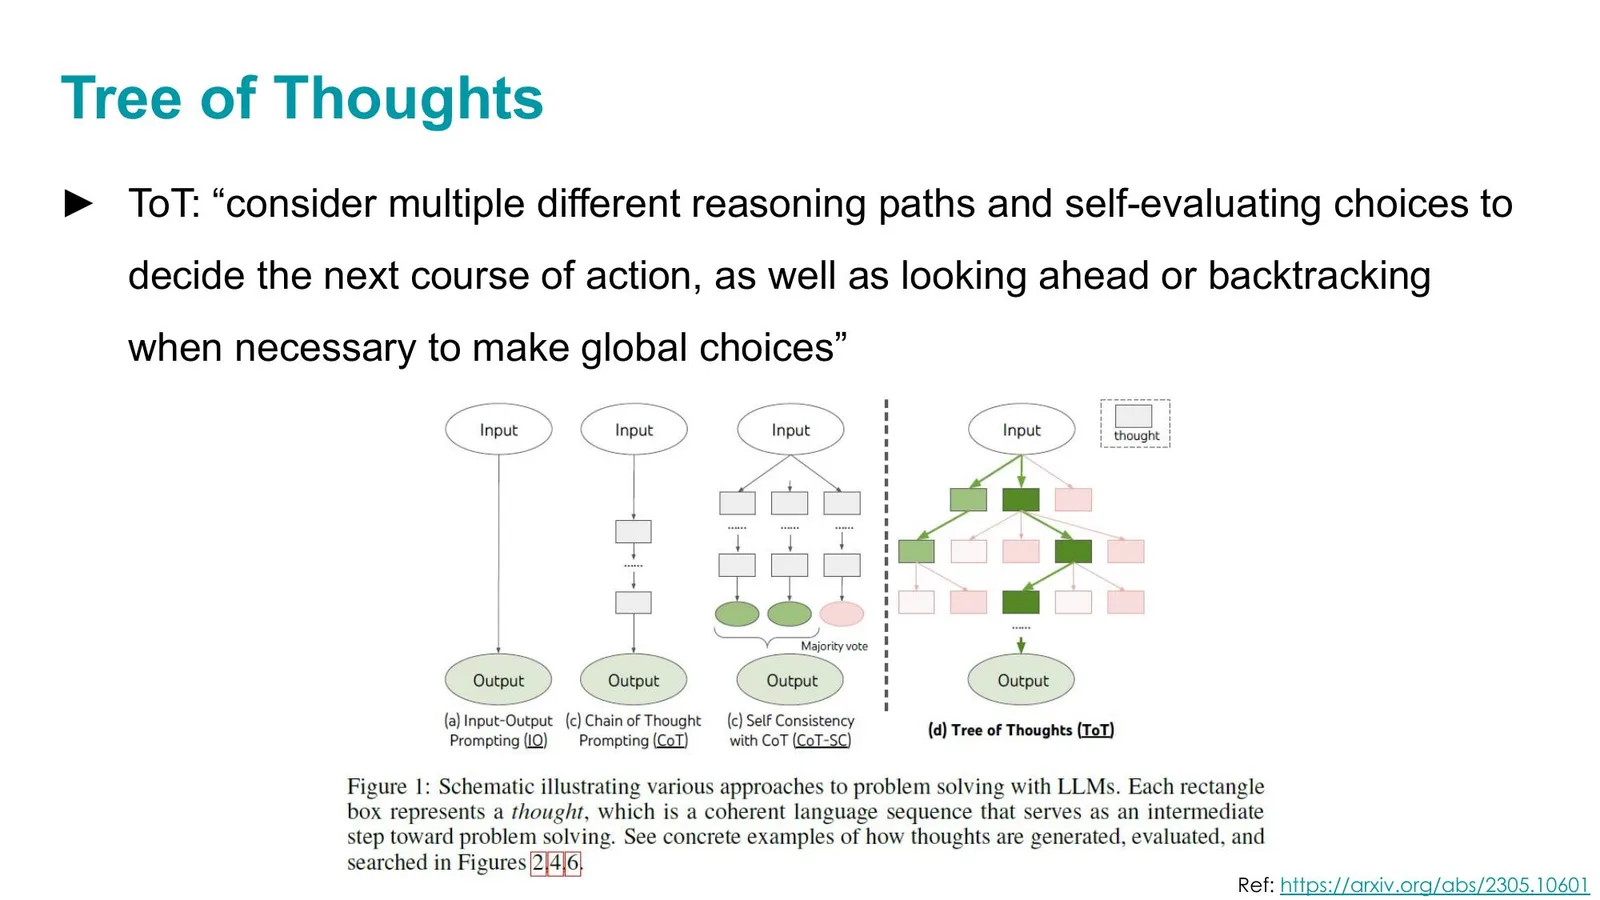
来源:官方 CS25 V4 slide deck,第 75 页
有限宽度搜索
若每个状态扩展 \(b\) 个候选、保留 top-\(k\)、深度为 \(d\),粗略模型调用量随 \(O(dkb)\) 增长。Verifier 的偏差会决定哪些分支被过早删除,因此搜索质量不仅取决于 generator,还取决于 state scoring。
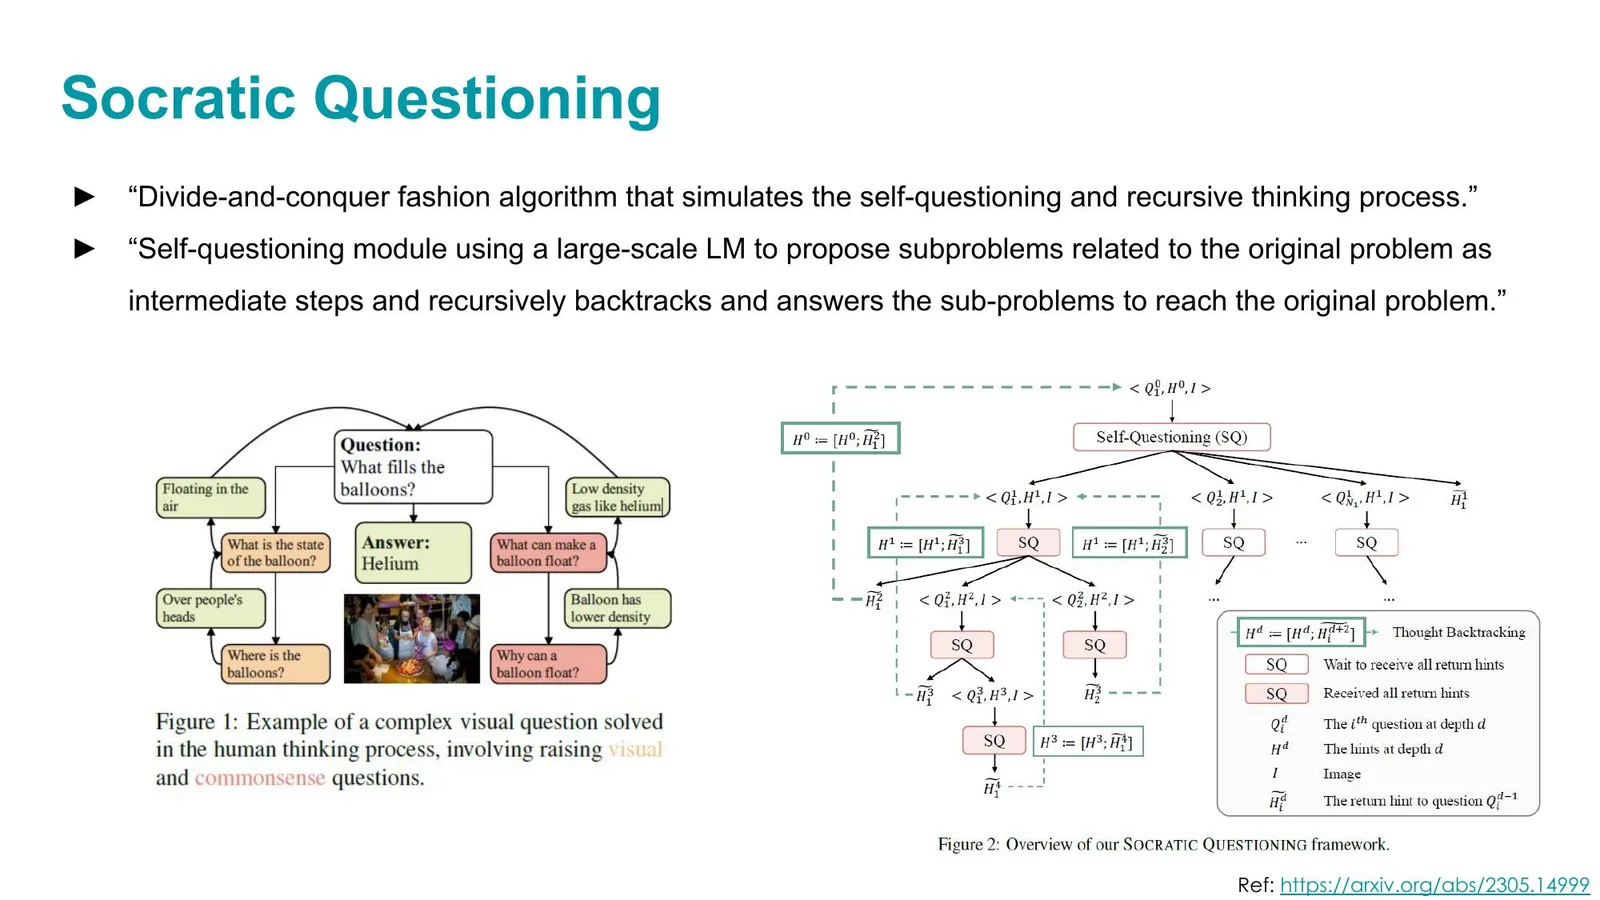
来源:官方 CS25 V4 slide deck,第 76 页
读图:decomposition 与 search 的差别
Decomposition 把大问题拆成相对独立的小问题;search 在多个候选路径中选择。Socratic method 更强调子问题结构,ToT 更强调候选状态和回溯。复杂系统常把两者结合,并在叶节点调用 calculator、code executor 或 retrieval。
本章小结
Reasoning scaffold 的价值在于增加中间计算、暴露错误并提供搜索与验证接口。CoT、ToT 和 Socratic decomposition 并不自动产生真 reasoning;它们只有与结构化状态、tool、verifier 和 stopping rule 结合时,才更接近可控计算过程。
从 Language Model 到 AI Agent:一次调用为什么不够
课堂在 49 分钟处切换到 agent。这个转场不是更换 buzzword,而是改变系统单位:language model 接受 token 并生成 token;agent 还要保持 state、读取 memory、选择 action、观察环境结果并根据反馈继续执行。一次模型调用可以是 agent 的 component,但不是完整 agent。
Agent stack:model 外面还需要什么
开场页列出 action、memory、communication 与 emergent architecture。Building AI Agents 页则把问题拆成 why 与 how:为什么需要 agent,怎样让模型进入现实接口。
来源:官方 CS25 V4 slide deck,第 78 页
来源:官方 CS25 V4 slide deck,第 79 页
Agent 的最小闭环
设环境状态为 \(s_t\),模型根据 observation \(o_t\)、memory \(m_t\) 与目标 \(g\) 选择 action:
\(\pi_\theta\) 是 policy,\(\mathcal{E}\) 是环境转移,\(U\) 是 memory update。Agent 必须处理行动结果,而不仅是预测下一个 token。
来源:官方 CS25 V4 slide deck,第 80 页
来源:官方 CS25 V4 slide deck,第 81 页
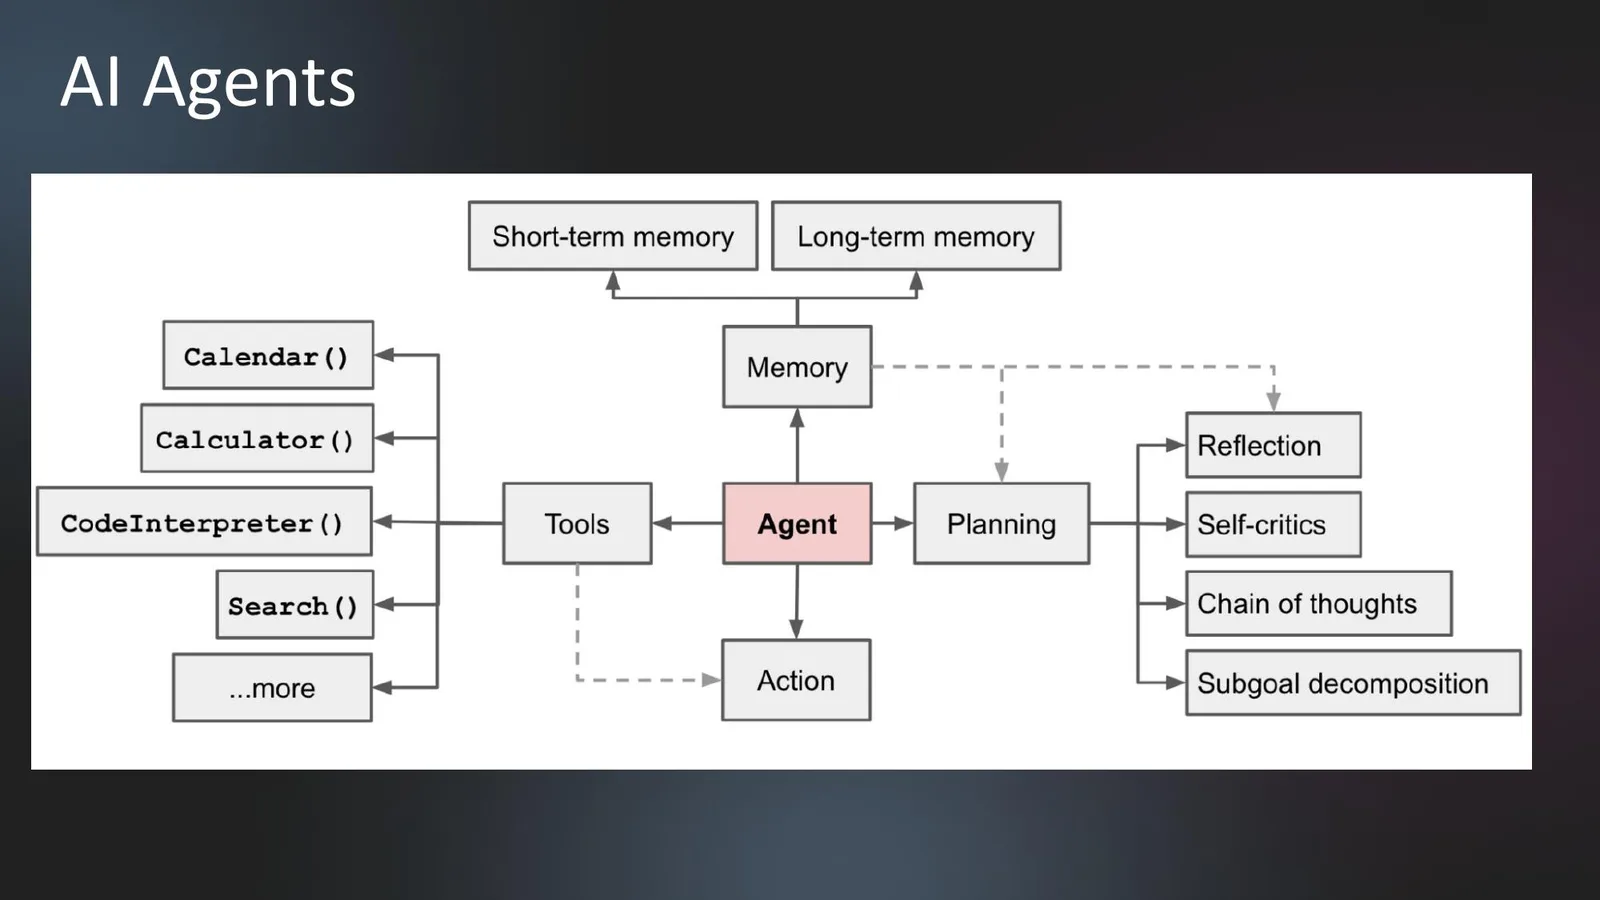
术语消化:Agent stack 的六个部件
| 部件 | 职责 |
|---|---|
| Model/policy | 解释 observation、提出计划或 action。 |
| State | 保存当前任务、页面、文件、变量和执行位置。 |
| Memory | 保存跨步骤或跨会话信息,并支持检索。 |
| Tool/action layer | 把结构化 action 映射到 API、browser、shell 或设备。 |
| Environment feedback | 返回成功、错误、页面变化、测试结果或传感器 observation。 |
| Verifier/guardrail | 检查约束、权限、结果与终止条件。 |
课堂提示
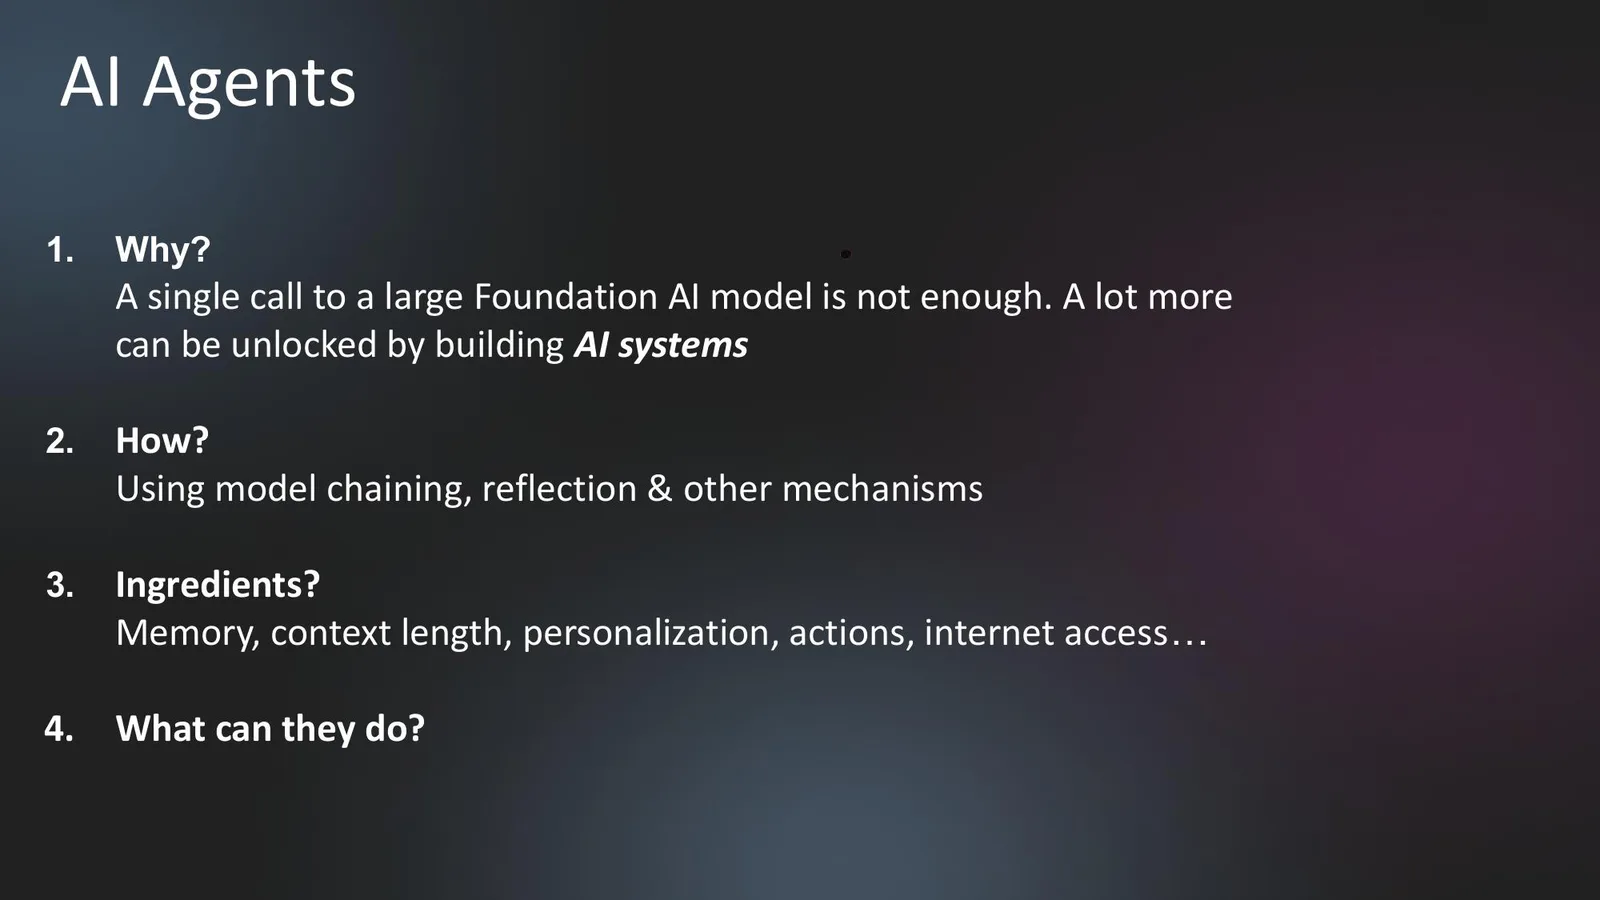
讲者把转向 agent 的理由说得很直接:一次 foundation-model call 不够,因为真实任务还需要 memory、long context、personalization、actions、internet access 和跨步骤反馈。
Flight 与 driving-test demo:展示 action,不证明可靠性
两页 demo 展示 MultiOn 早期 agent 预订航班和完成 California online driving test。它们说明模型可以把自然语言目标映射到浏览器操作,但公开视频中的单次成功不能推出一般成功率、支付安全或跨网站鲁棒性。读图时先辨认 observation、action 与完成条件,再区分演示证据和部署证据。
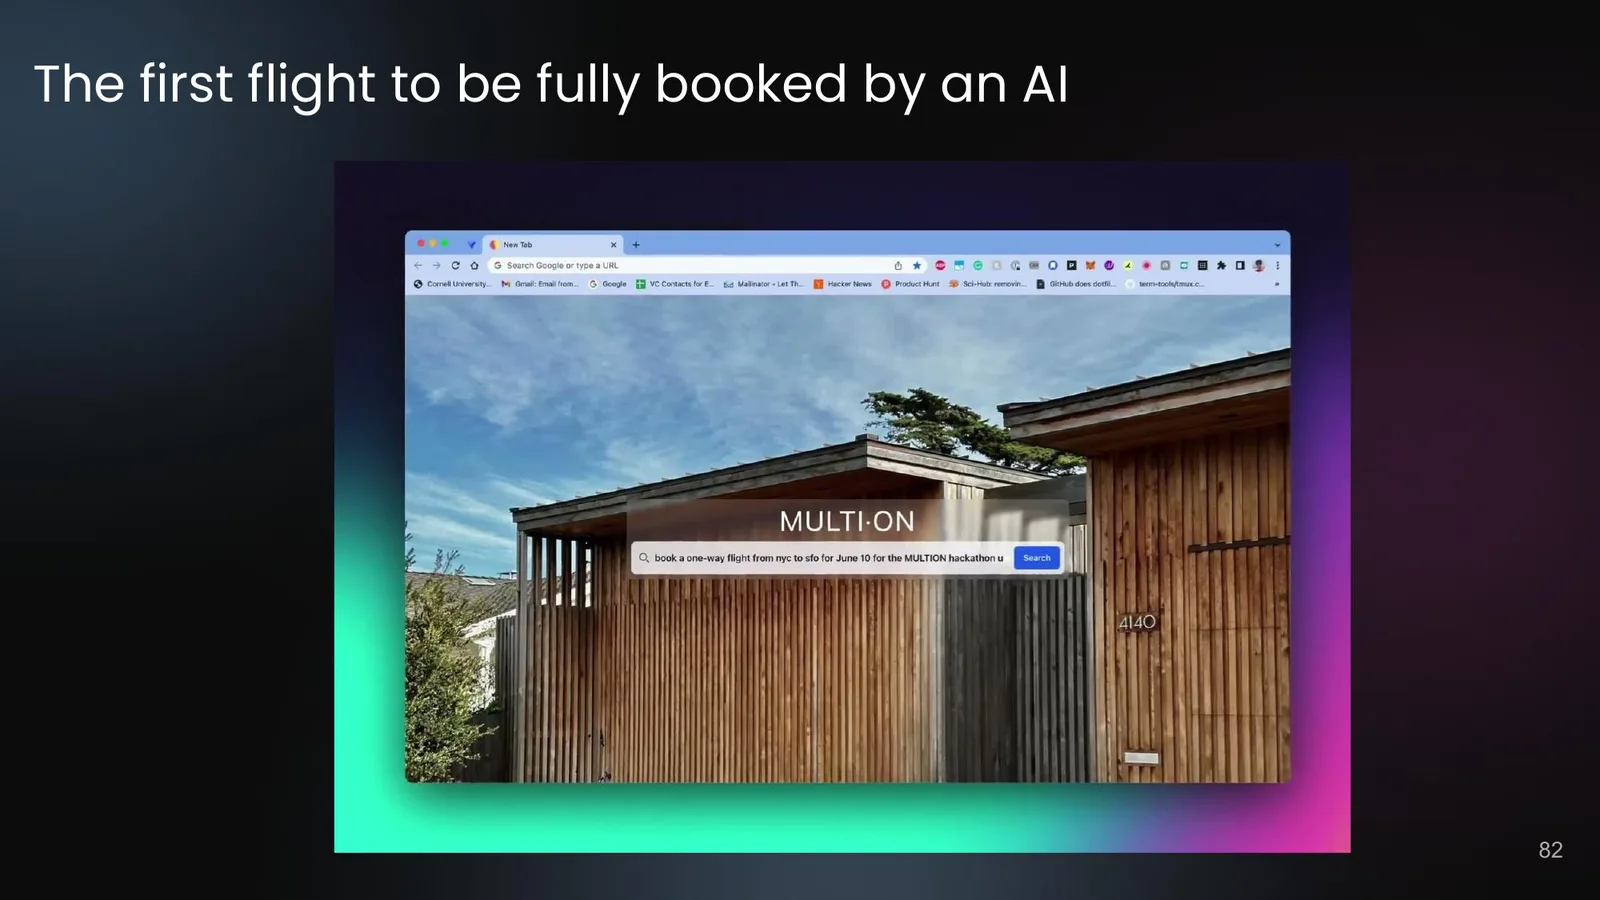
来源:官方 CS25 V4 slide deck,第 82 页
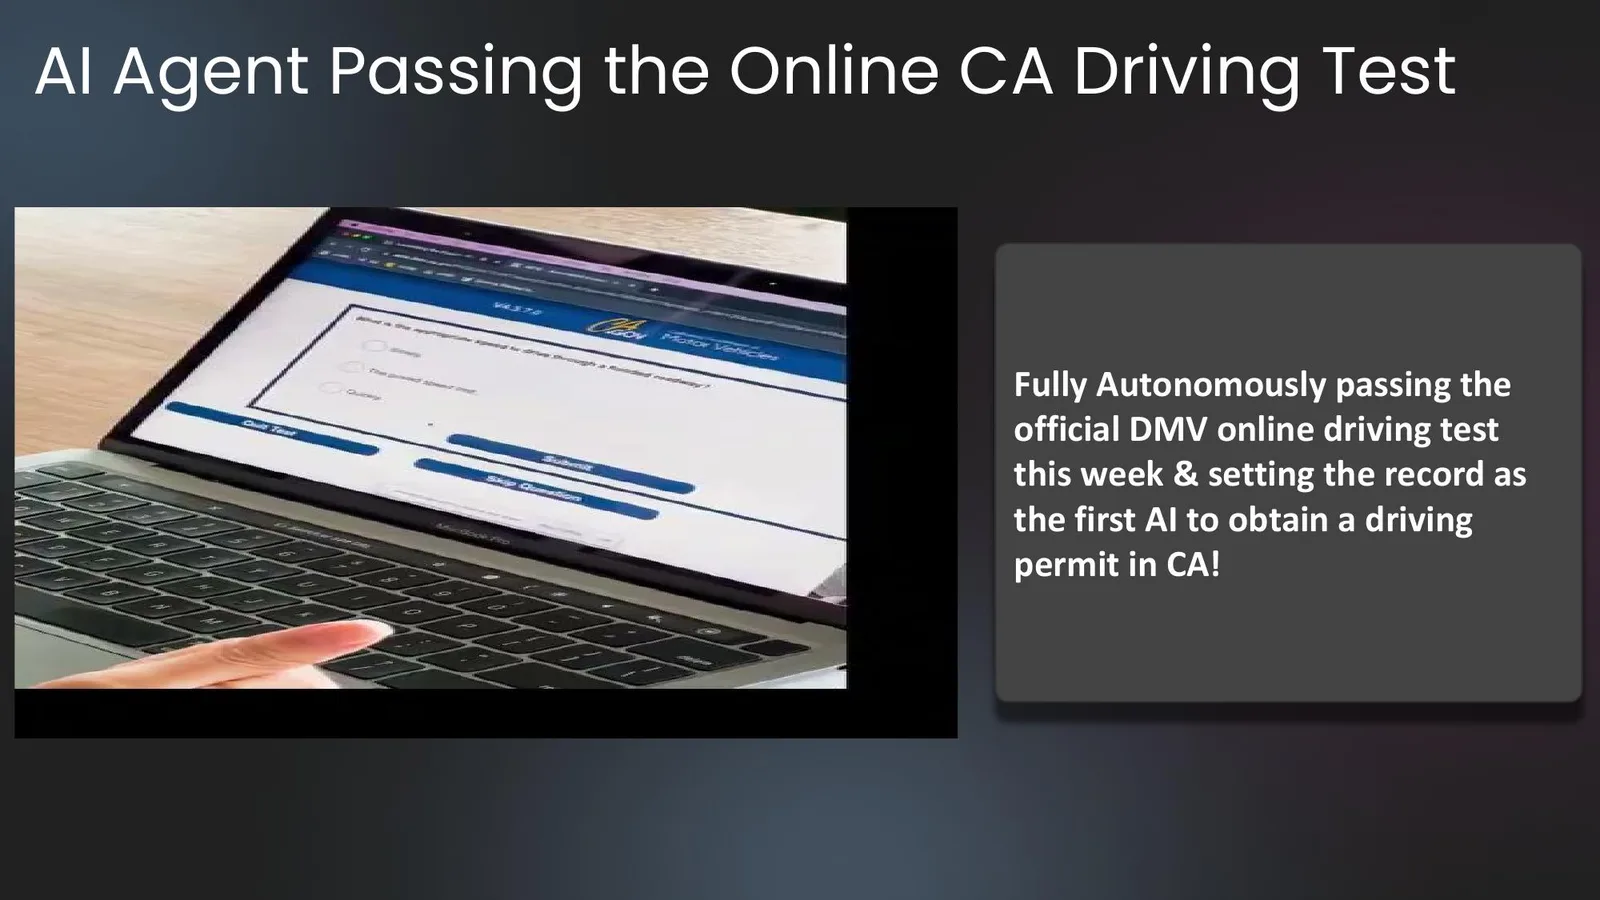
来源:官方 CS25 V4 slide deck,第 83 页
Demo evidence 的正确读法
Demo 可以证明“这条 action trajectory 至少发生过”,不能证明平均成功率、worst-case safety 或无人监督部署。需要补充任务集、重复次数、失败分类、权限范围、恢复策略与独立复现,才能从 capability demo 走向 engineering claim。
课堂提示
讲者把 driving-test demo 称为早期 real-world agent 展示。讲义保留这个历史事实,但不把它写成任何网站、账号或设备上都能稳定运行的结论。
为什么追求 human-like interface
Human-like agent 的吸引力是复用现有界面:网页、desktop 和 mobile app 已为人设计。Agent 若能看、点击和输入,就不必等待每个服务提供 API;它也可能通过用户示范学习偏好。相同优势同时扩大风险,因为登录、支付和个人数据也暴露在 action space 中。
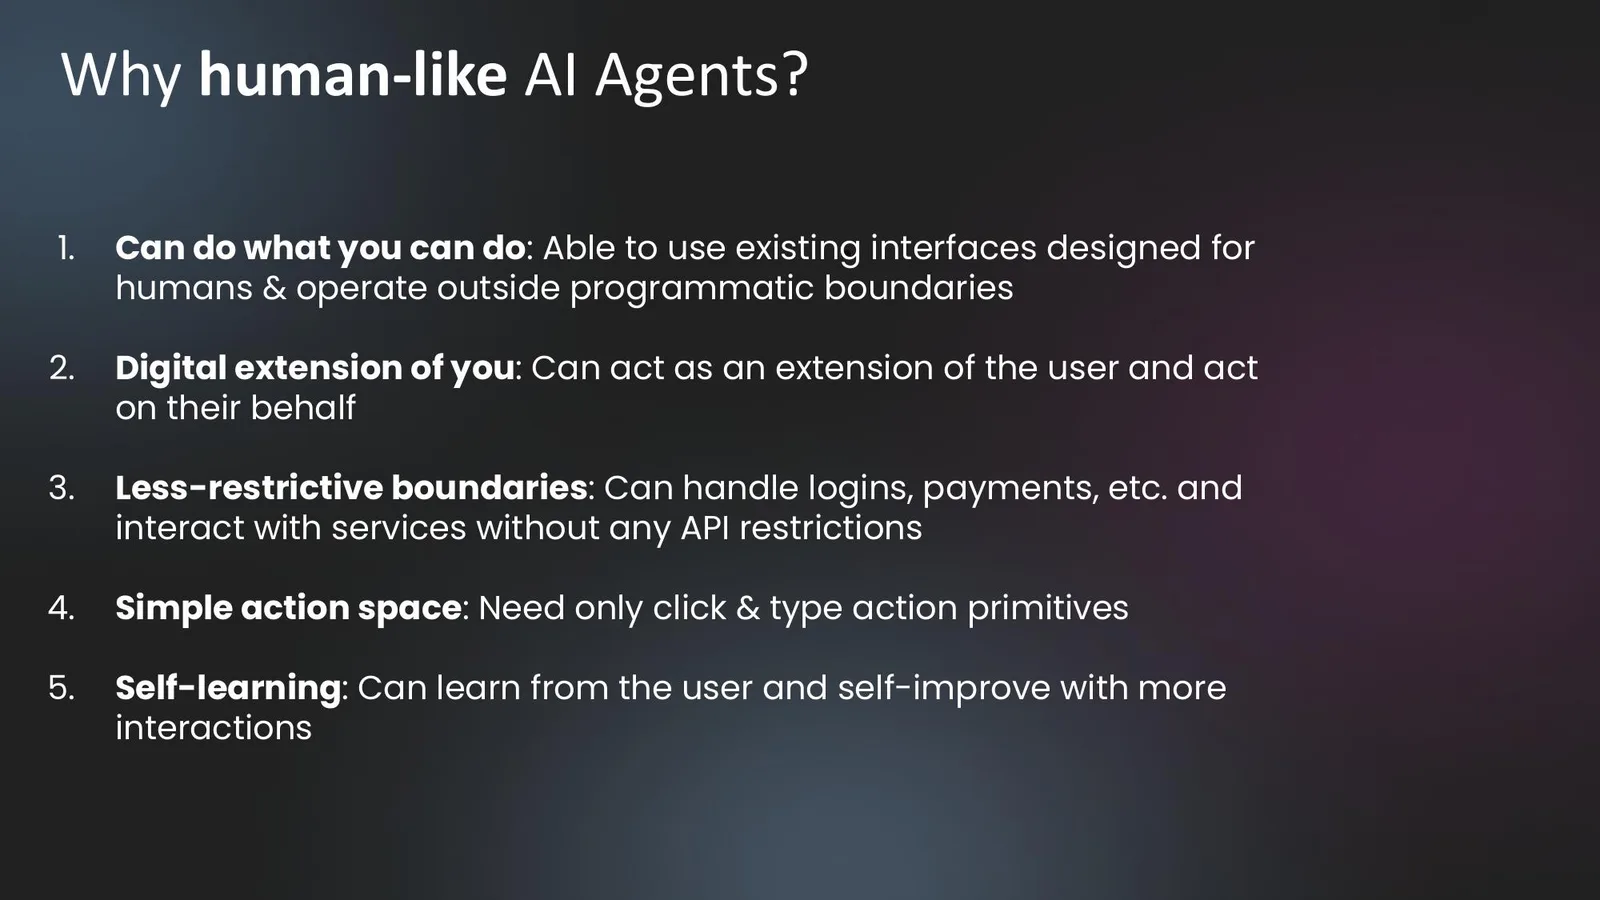
来源:官方 CS25 V4 slide deck,第 84 页
Interface coverage 与 safety boundary 是同一枚硬币
更一般的 UI control 提高覆盖面,却削弱 typed API 提供的 schema、权限与 error code。设计时应优先使用受约束 API;只有在缺少接口时才扩大到 UI control,并为高风险 action 加 confirmation、least privilege、audit log 与 rollback/recovery。
Autonomy level 是责任梯度,不是营销等级
课程借用 L0–L5 自动驾驶分级讨论 agent:低等级由人掌控,高等级逐步移除 human fallback。这个类比有助于说明责任变化,但不能直接用来给具体汽车或 agent 产品定级。下面的图要按“谁在监控、谁能接管、失败时谁负责”来读,而不是把等级当作单一能力分数。
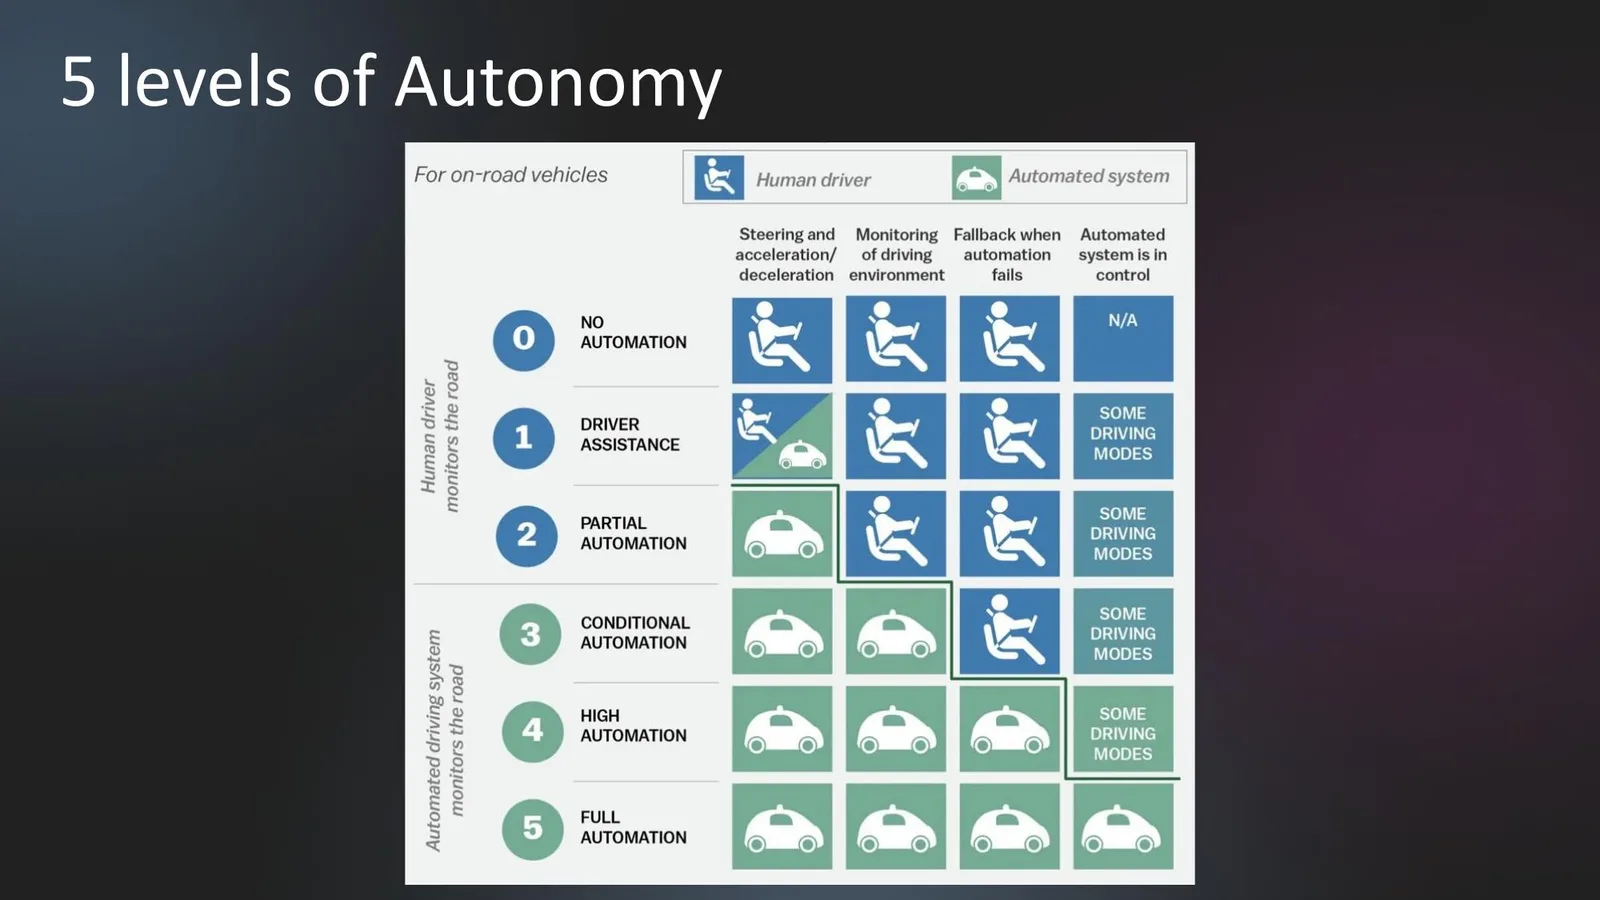
来源:官方 CS25 V4 slide deck,第 85 页
课堂中的产品举例是非正式类比
讲者口头把若干车辆系统对应到 L4/L5。正式 SAE 定义、运行设计域和当前产品状态比课堂类比严格得多,也会随时间变化。这里保留的教学结论只有一个:移除 human fallback 会显著提高验证与责任要求。
Agent autonomy 的可操作分级
| 等级 | 一个更适合软件 agent 的定义 |
|---|---|
| Assist | 提供建议,不执行外部 action。 |
| Approve-each-step | 每个 action 都需用户确认。 |
| Bounded delegation | 在预定义 scope、预算和工具内自动执行。 |
| Supervised autonomy | 可长时间执行,但有实时 monitor、interrupt 与 fallback。 |
| Unsupervised autonomy | 无在线人类监督完成高影响任务;需要最严格的形式化边界和独立验证。 |
API 与 direct computer interaction
Agent 有两条主要 action 路线。API 提供结构化参数、返回值和权限;direct interaction 通过 screen、keyboard、mouse 或 accessibility tree 操作人类界面。后者覆盖面广,但更容易受 layout、latency、popup 和视觉歧义影响。
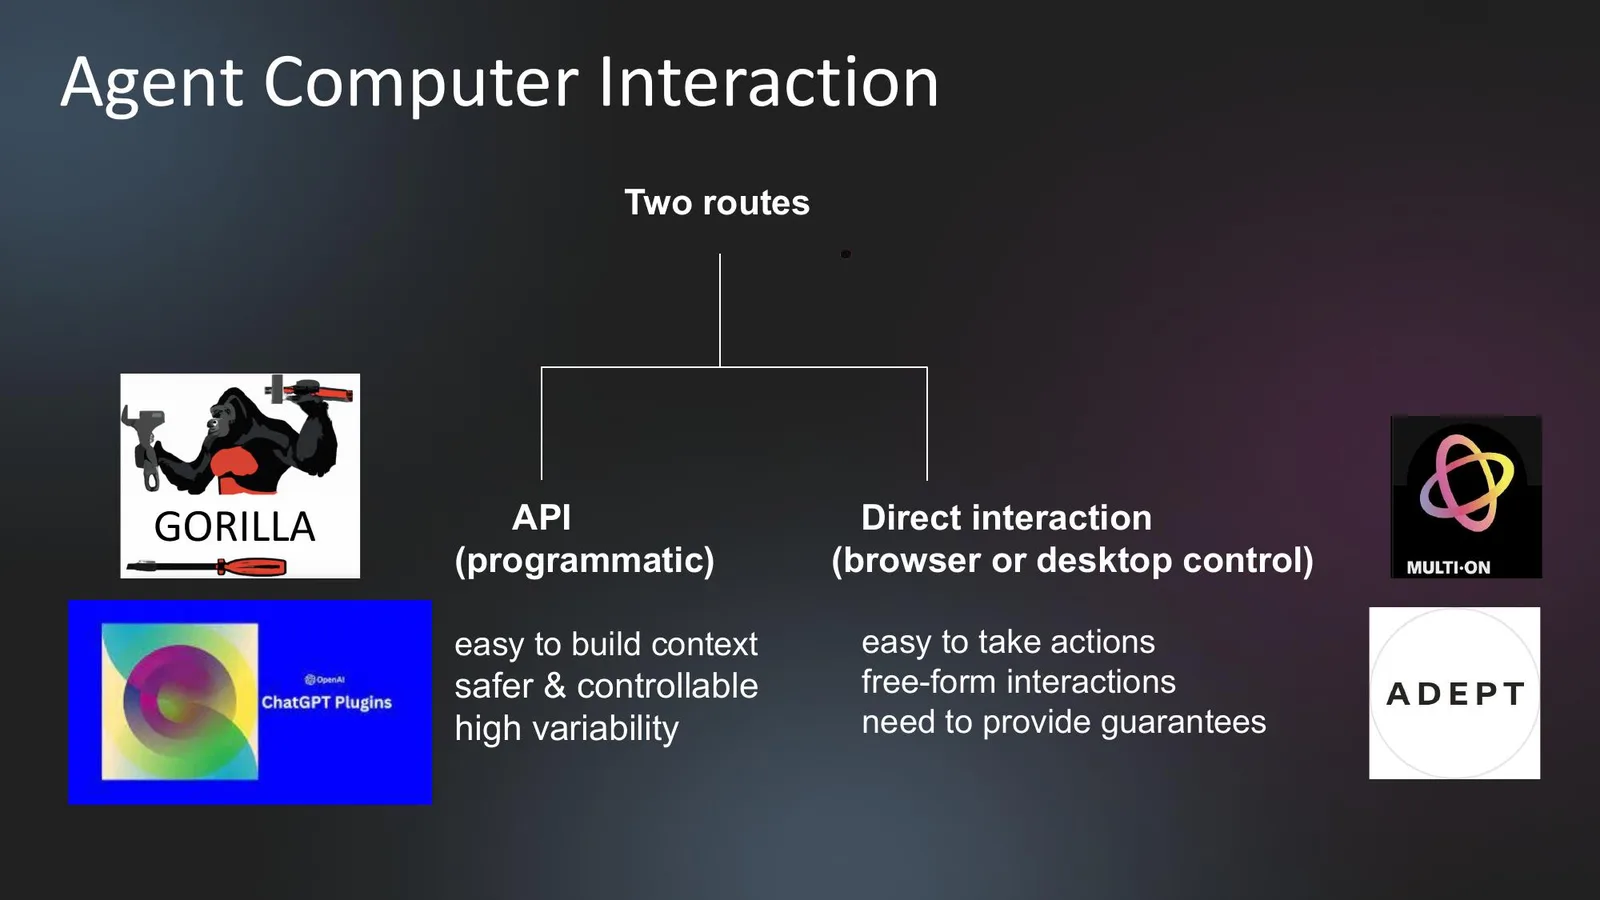
来源:官方 CS25 V4 slide deck,第 87 页
Action schema
一个可审计 action 不应只是自由文本,而应接近
precondition 描述执行前状态,risk 决定是否需要确认,idempotency 说明重复调用是否安全。结构化 action 让 verifier 和 recovery 有明确对象。
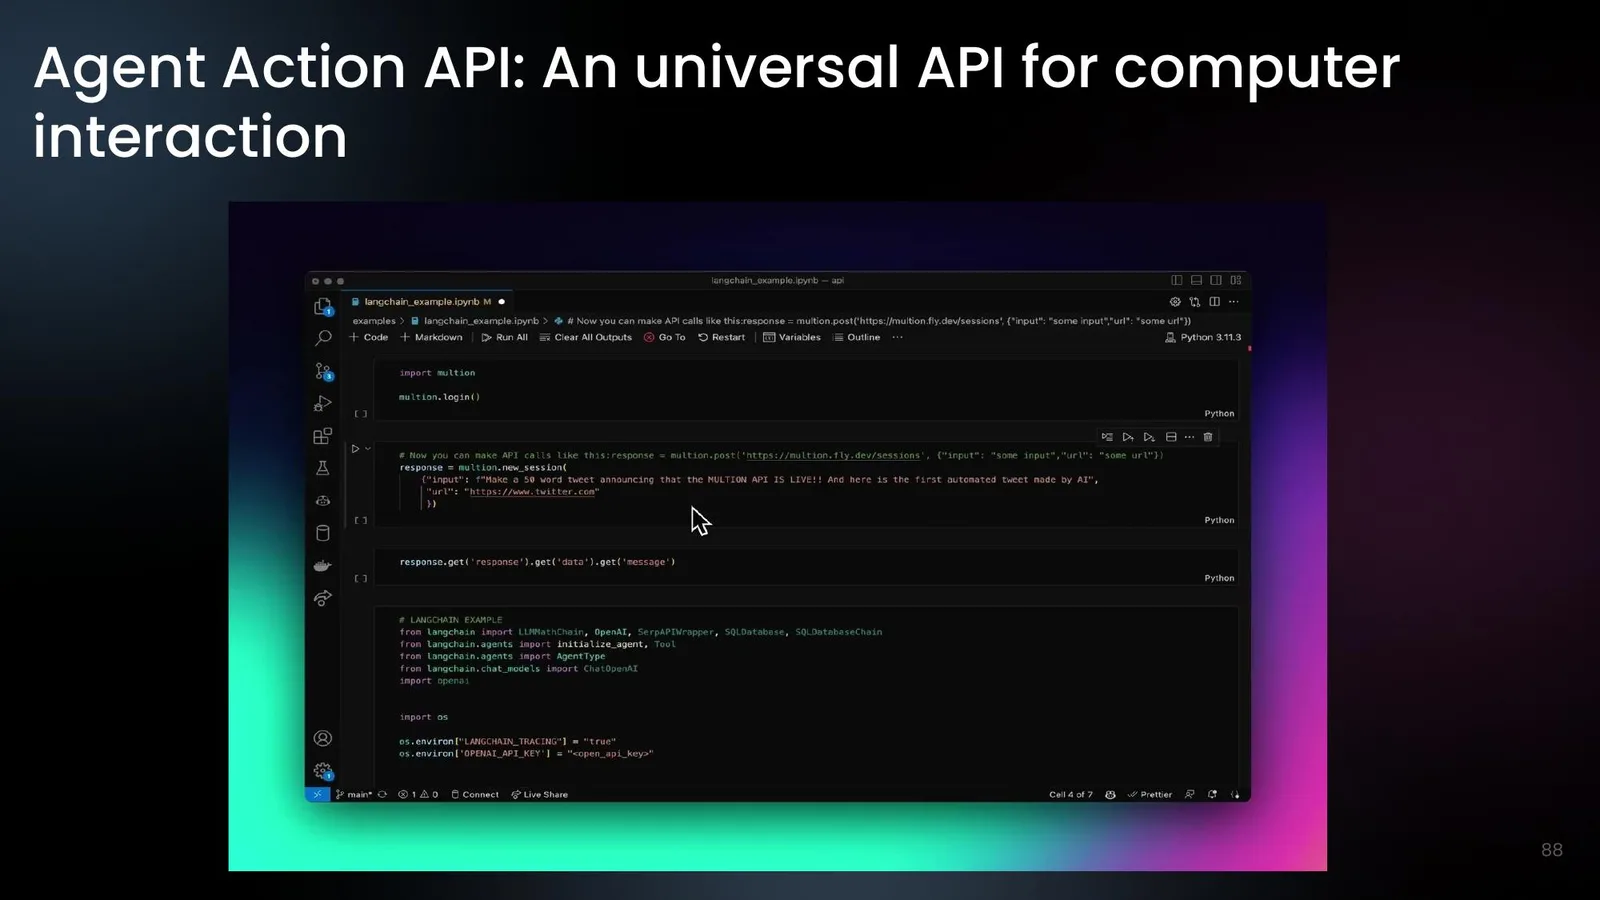
来源:官方 CS25 V4 slide deck,第 88 页
“不需要 API”不等于“API 没价值”
UI agent 可以覆盖没有 API 的系统,但稳定 API 通常更快、更便宜、更容易授权和测试。理想架构是 capability routing:优先选择受约束工具,在必须使用 UI 时缩小可见区域、action set 与 credential scope。
本章小结
Agent 把语言模型放进 observation–action–feedback loop,并增加 state、memory、tool、verifier 与 recovery。课堂 demo 展示了 action capability,autonomy 与 UI control 则暴露了责任和权限问题。真正的系统边界不在“模型会不会点击”,而在失败能否被发现、限制和恢复。
Neural Compute Unit、长期记忆与个性化
把 LLM 看成 neural compute unit 是后半场最重要的系统类比。模型像计算单元一样接收 token instruction 并输出 token,但它没有自动获得 persistent memory、process isolation、device driver 或 permission model。理解类比的适用范围,才能正确设计 agent architecture。
Model as compute unit
课堂把自然语言 token 与 binary instruction 对比。共同点是输入经过计算变成输出;不同点是 LLM 的行为是概率性的,语义空间开放,输入输出也没有传统 ISA 那样严格的类型与确定性。读图时应把 compute analogy 与 missing systems guarantees 同时保留。
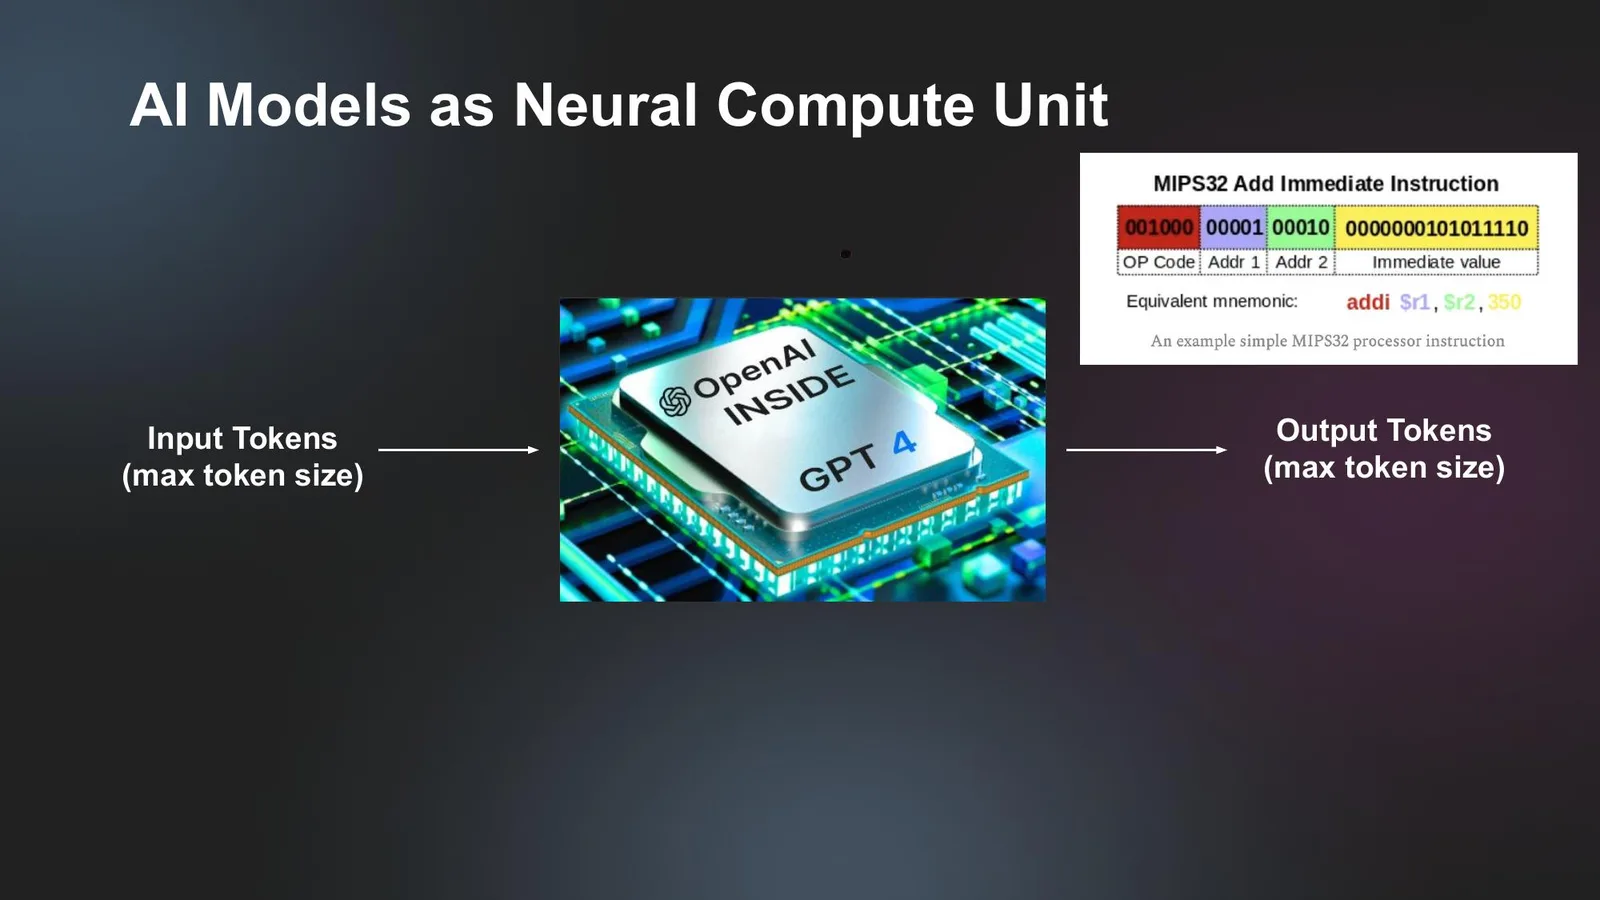
来源:官方 CS25 V4 slide deck,第 90 页
读图:CPU analogy 的有效边界
| 层次 | 类比有效处 | 类比失效处 |
|---|---|---|
| Instruction | Prompt/context 指定本轮计算 | 自然语言含歧义,缺少固定 opcode 与类型系统。 |
| Compute | 参数执行大规模矩阵运算 | 输出是概率分布,不能默认确定性与正确性保证。 |
| Memory | Context 提供工作区 | Context 有长度上限,也不会自动持久化。 |
| I/O | Tool 扩展外部能力 | 权限、异常和副作用必须由系统显式处理。 |
课堂提示
讲者把模型称为 neural compute unit,并设想为 Transformer 编写新的 programming language。这个类比的教学价值在于把 prompt、memory、tool 和 variable 变成系统部件,而不是把模型拟人化成完整大脑。
Looped Transformer 与反复计算
一次 forward pass 对应固定深度计算。Looped Transformer 页提出共享或重复 block,让模型在同一参数上执行更多迭代。它与 reasoning loop 相似:都用更多 computation steps 换取更复杂处理,但必须解决 termination 与 stability。
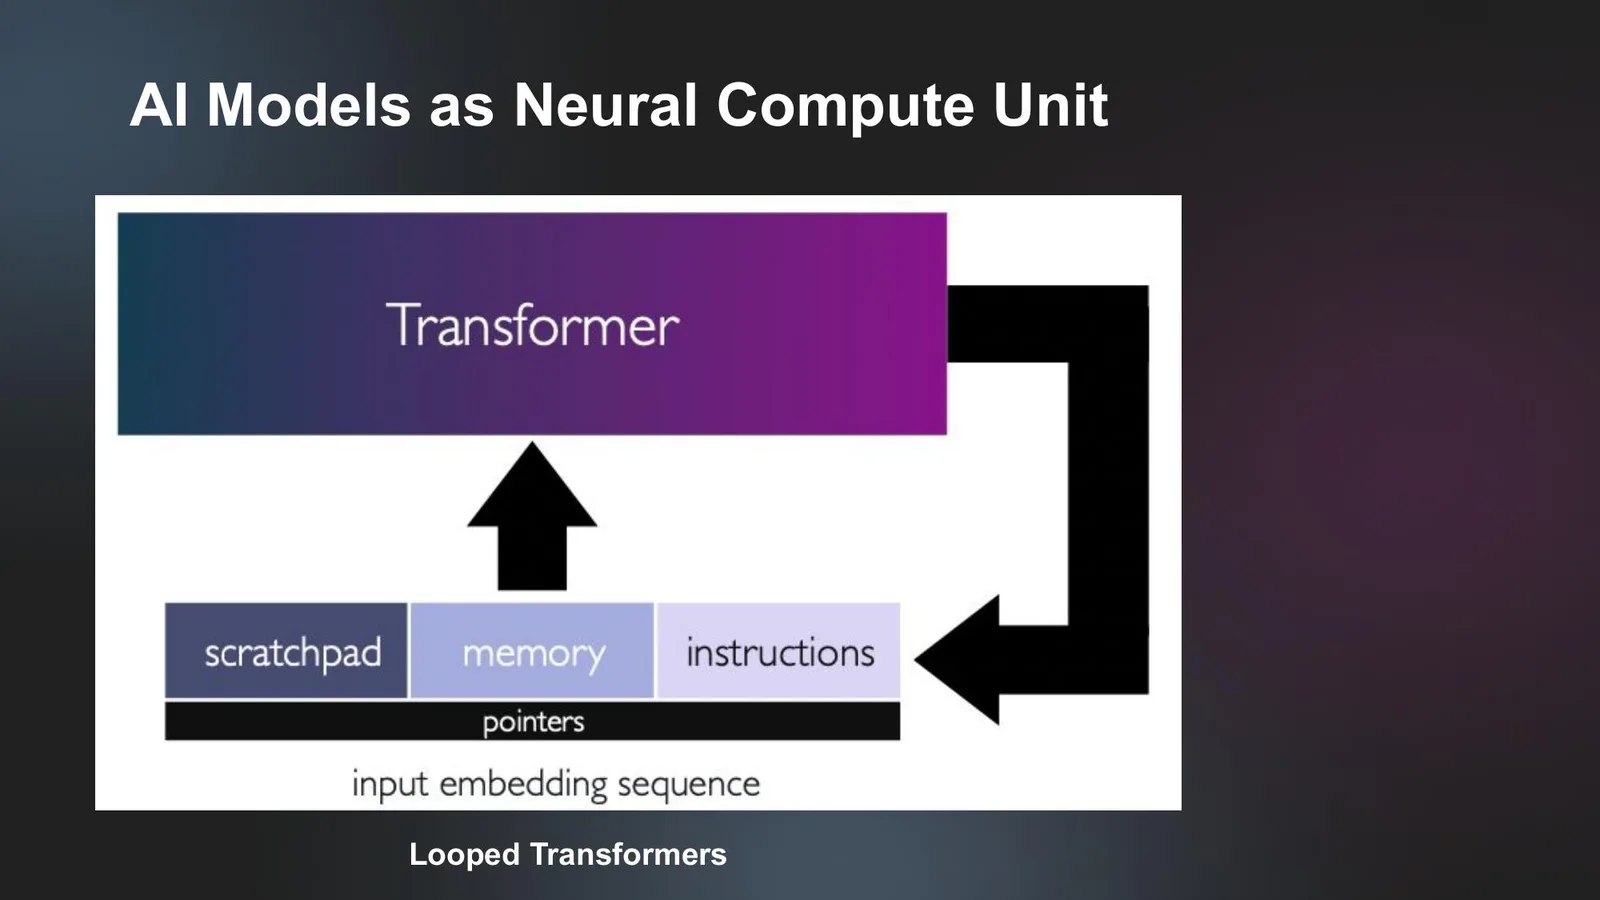
来源:官方 CS25 V4 slide deck,第 91 页
Iterative computation
若同一 block \(F_\theta\) 被重复 \(K\) 次:
共享参数降低模型增长速度,却可能带来 optimization、fixed-point stability 和动态 stopping 问题。重复层数多不自动等于 reasoning 更深。
Long-term memory 不只是 vector search
课堂将 persistent memory 类比为 disk:先把文档或经历编码成 embedding 存储,需要时再检索进 context。现有系统常用 nearest-neighbor search,但真实长期记忆还需要时间、层级、关系和更新策略。本节先解释当前 embedding pipeline,再用课堂提出的 open questions 扩展 memory schema。
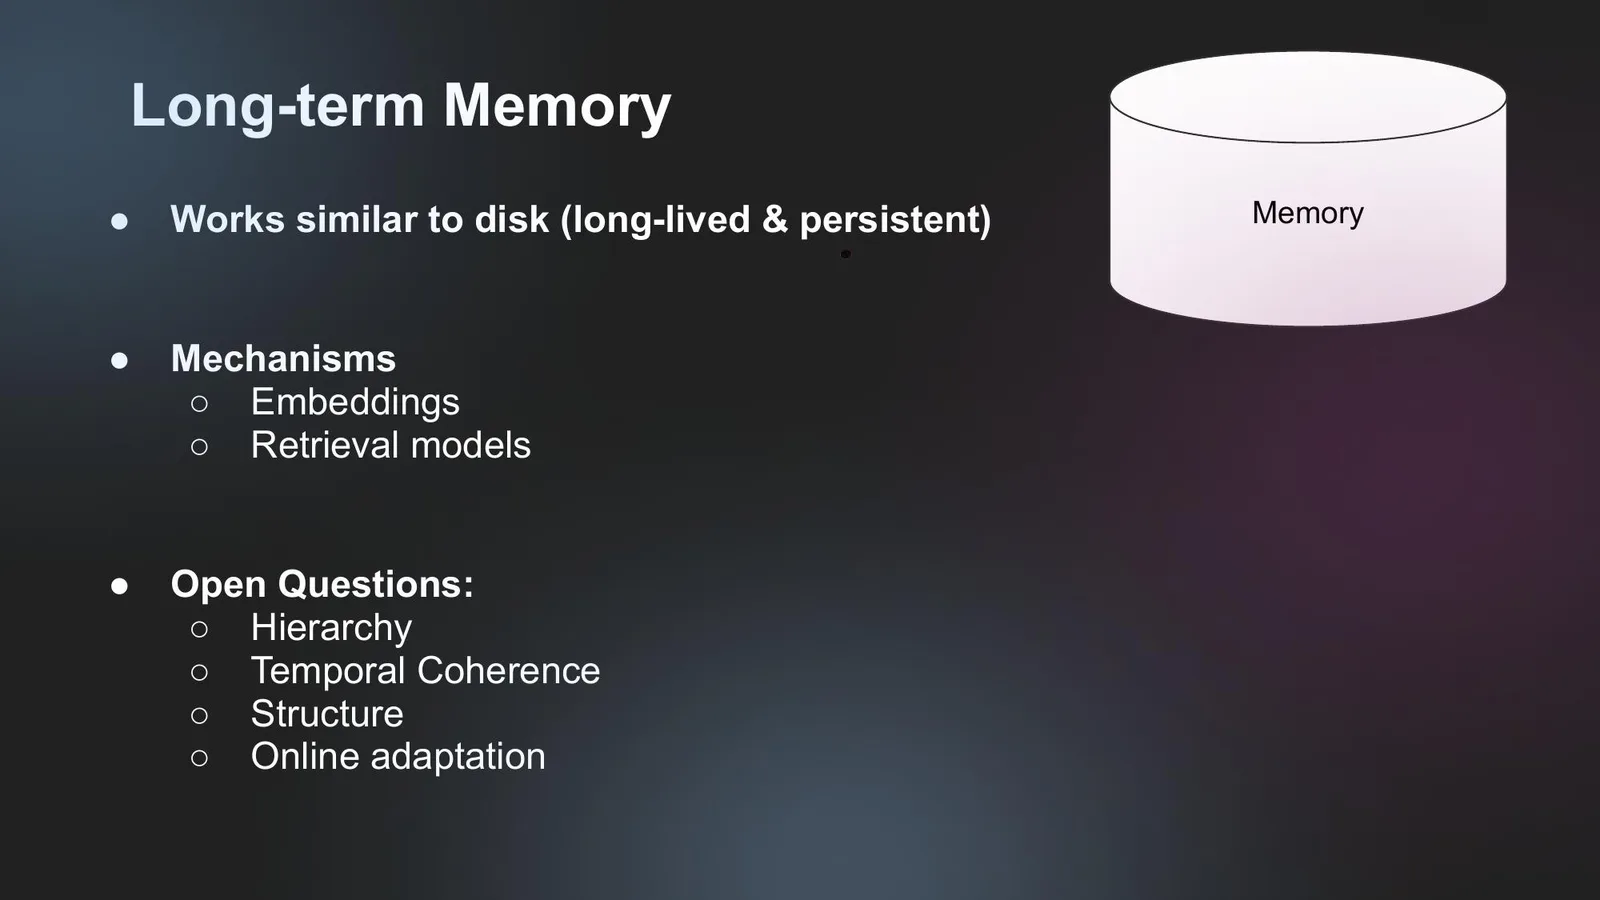
来源:官方 CS25 V4 slide deck,第 92 页
Memory retrieval score
对 query embedding \(q\) 与 memory item \(m_i\),最简相似度可写成
这只利用语义相似。真实 memory ranking 还应加入 recency、importance、user scope、causal link、task state 与 access control。
背景概念:Agent memory 的四种层次
- Working memory:当前 context、scratchpad 和 tool result;
- Episodic memory:过去 interaction 与 action trajectory;
- Semantic memory:稳定事实、文档和用户知识;
- Procedural memory:可复用 workflow、policy 和 skill。
只建一个向量库,通常无法同时满足四种语义。
课堂提示
讲者指出现有 memory 常停留在简单 k-NN。时间一致性、graph structure、online adaptation 和不断变化的数据都没有被自然解决;“接一个 vector database”只是起点。
Personalization:偏好会变化,数据也有边界
Personalization 页希望 agent 成为用户的数字延伸。它需要学习写作风格、日程、风险偏好和长期目标,同时区分稳定偏好、一次性指令与敏感信息。接下来的两页要同时读 capability 和 data boundary,尤其关注偏好怎样被收集、更新、撤销与覆盖。
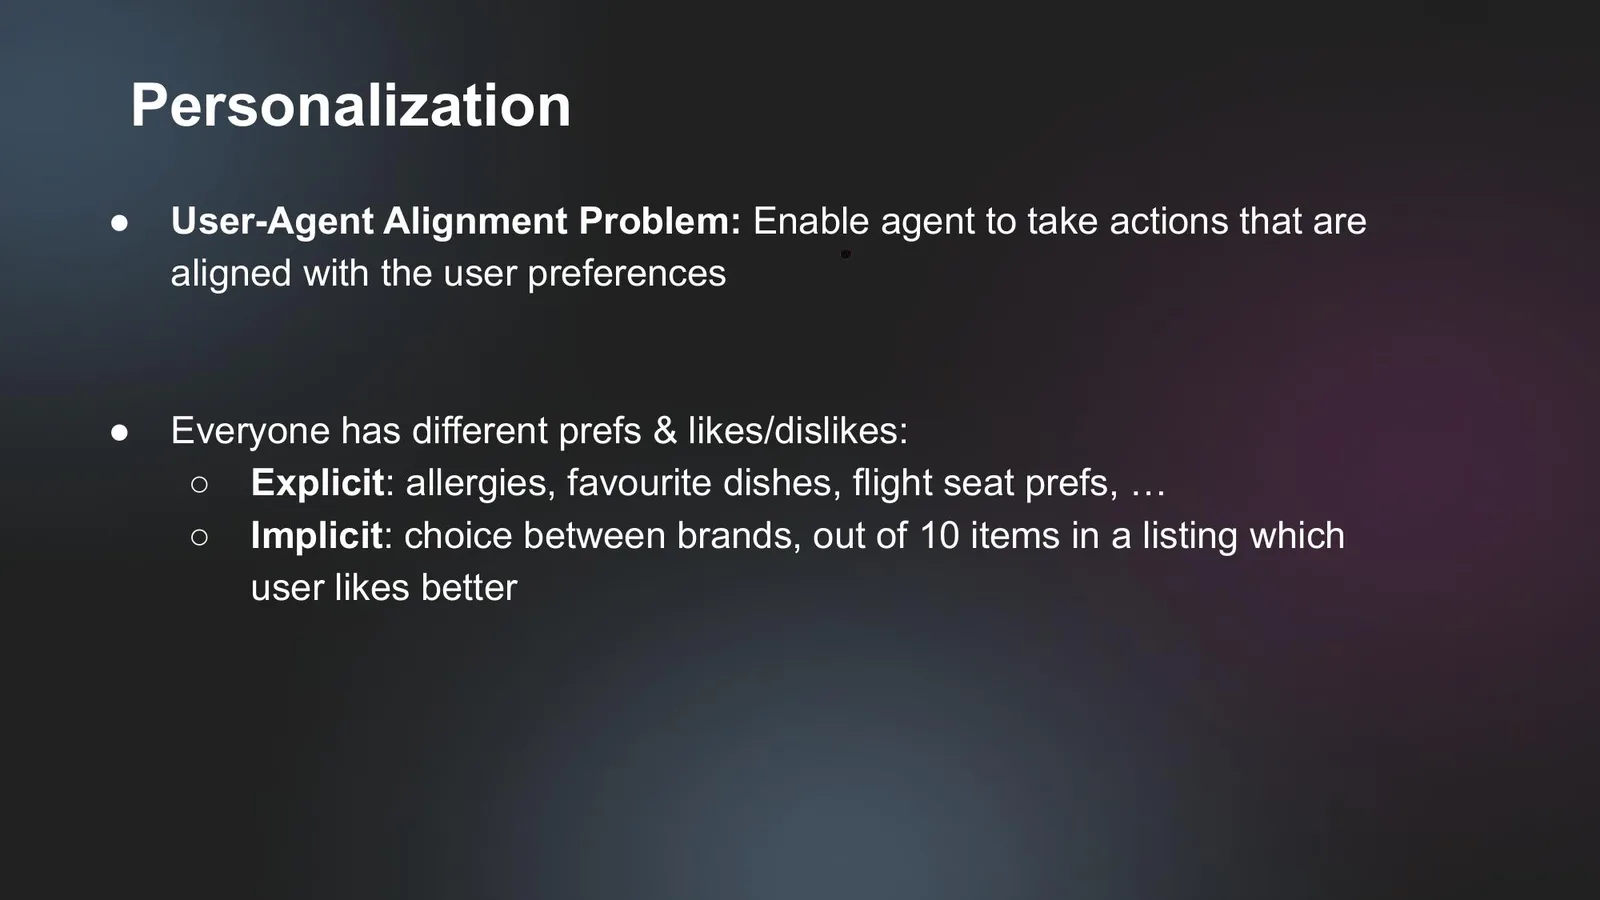
来源:官方 CS25 V4 slide deck,第 93 页
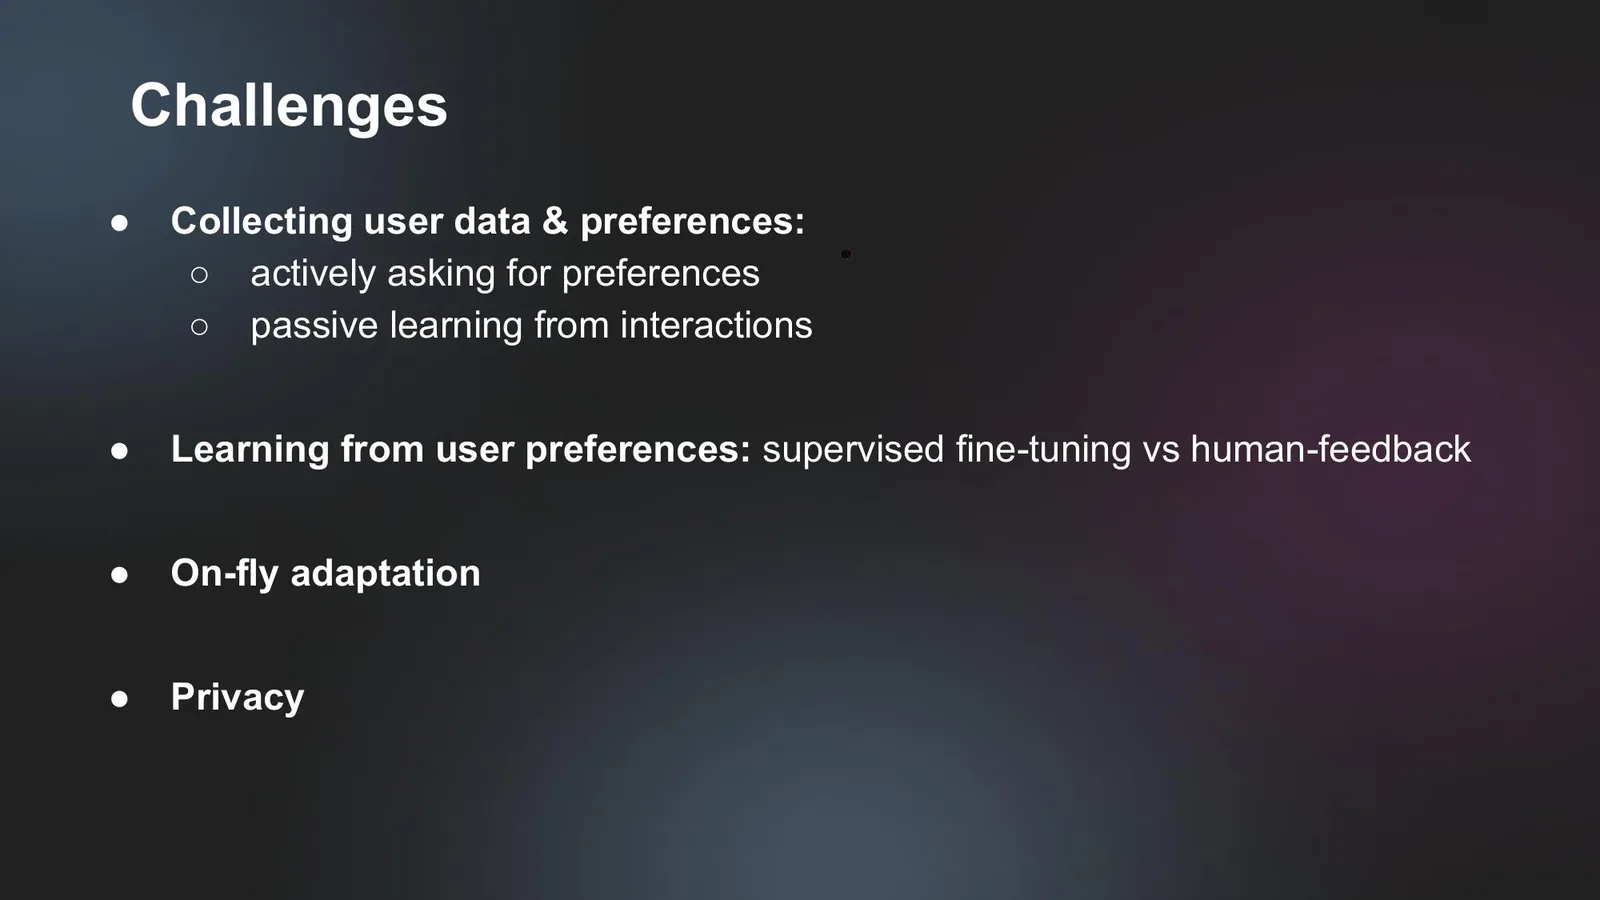
来源:官方 CS25 V4 slide deck,第 94 页
课堂提示
讲者用 hippocampus 和不断变化的个人数据提醒读者:memory 不是静态文档仓库。系统要处理时间顺序、关系结构、在线更新和用户偏好变化。
Personalization 的四个常见失败
- 把一次行为误判为永久偏好;
- 将不同用户或 workspace 的 memory 混用;
- 为了“更懂用户”无限保存敏感数据;
- 用户偏好与安全、法律或组织 policy 冲突时盲目服从。
系统需要 consent、scope、retention、edit/delete 与 policy precedence。
Preference update 需要时间衰减与确认
可把 preference \(p\) 的 score 写成
其中 \(w_j\) 表示证据可靠性,\(\Delta t_j\) 是时间间隔,\(\lambda\) 控制衰减。高风险偏好不应只靠隐式行为推断,而应要求显式确认。
本章小结
Neural-compute analogy 让 model、context、memory 与 tool 的边界更清楚,但不能把 LLM 当成具有确定 ISA 和隔离保证的 CPU。长期记忆需要层级、时间和权限,个性化需要 consent、更新和删除机制。系统能力越贴近用户,memory governance 越成为核心设计。
Multi-Agent Systems:并行容易,通信和纠错更难
单 agent 的长轨迹可能慢,也难覆盖复杂任务。Multi-agent system 试图把任务拆给多个 specialized worker,再由 manager 汇总。课堂最有价值的部分不是“多开几个模型”,而是用连续构图演示 delegation、verification、conflict 与 redo。
为什么需要多个 agent
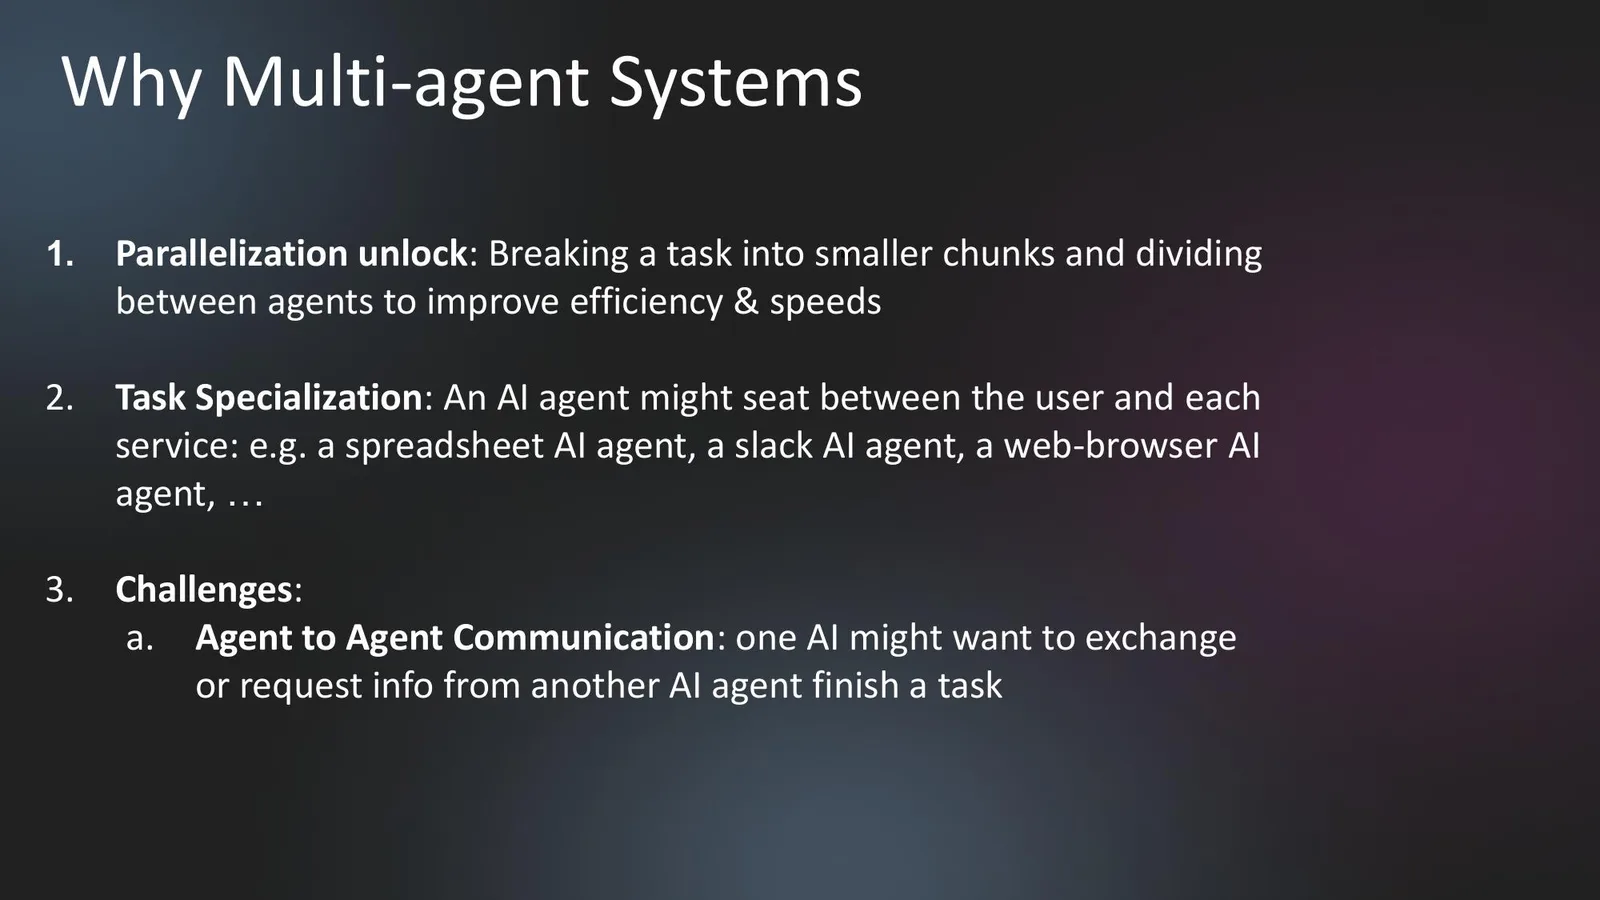
并行化可以缩短独立子任务的 wall-clock time,specialization 可以让不同 worker 使用不同工具或 prompt。前提是任务能被正确分解,结果能够合并,shared state 不会相互覆盖。下面两页先给出系统形态,再列出并行和 specialization 的收益,随后才进入协议成本。
来源:官方 CS25 V4 slide deck,第 96 页
来源:官方 CS25 V4 slide deck,第 97 页
并行收益的上限
若任务中可并行比例为 \(p\),使用 \(n\) 个 worker 的理想加速受 Amdahl's law 限制:
分解、通信、验证和合并开销会让真实加速更低。Multi-agent 的价值必须以 end-to-end latency、cost 和 success rate 验证,而不是以 agent 数量衡量。
课堂提示
讲者强调 multi-agent 的直接好处是 parallelization 和 specialized workers,但随后马上把重点转向 communication:自然语言有歧义,agent 之间也会像人一样产生误解。
Hierarchy 与 message protocol
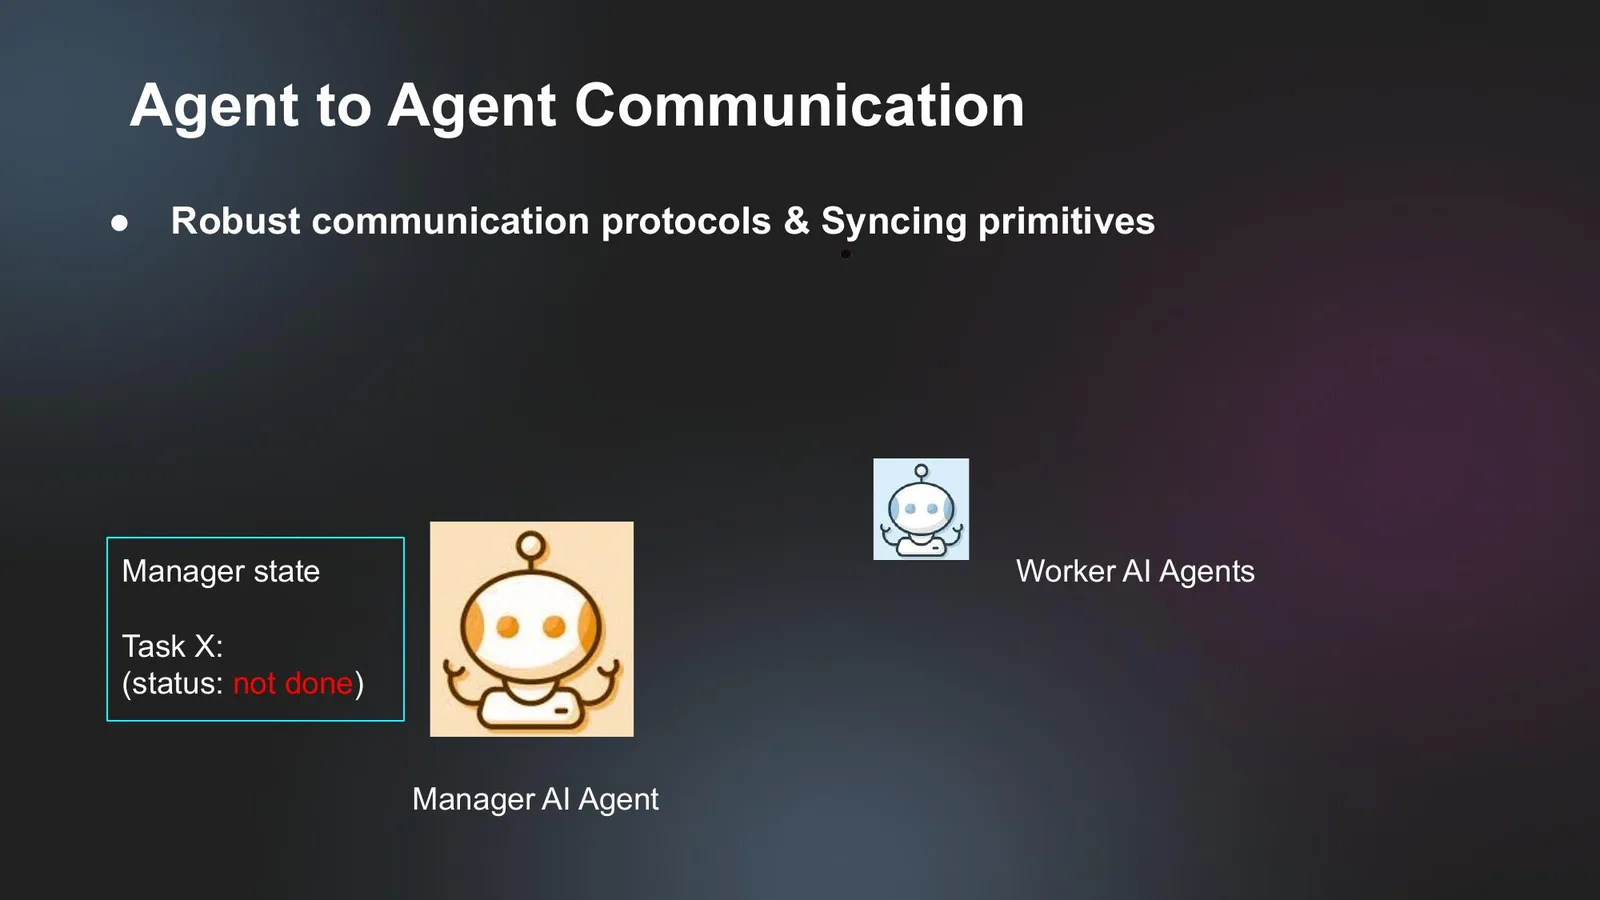
课堂提出 manager–worker hierarchy:用户与 manager 对话,manager 分派任务并维护全局状态,worker 处理局部目标。层级减少用户面对的接口,却把正确分解与状态同步集中到 manager。接下来的三页从抽象层级走到 message 和 state,读图时先找 ownership 与 version boundary。
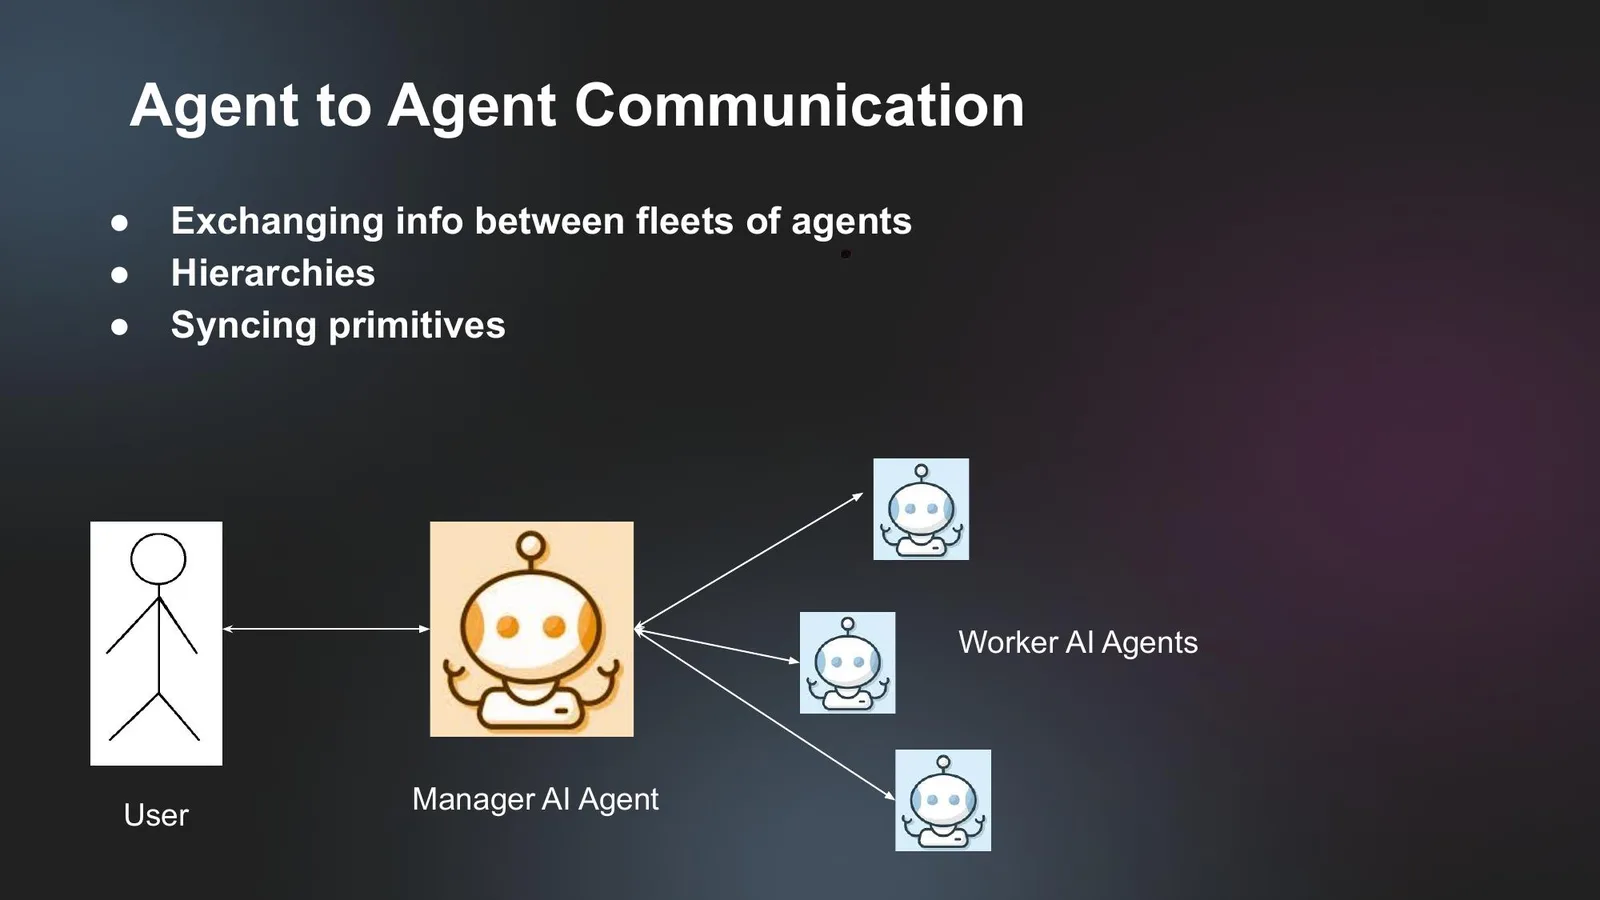
来源:官方 CS25 V4 slide deck,第 98 页
来源:官方 CS25 V4 slide deck,第 99 页
Typed message 比自由文本更容易验证
一个 worker request 至少应包含
返回消息应包含 status、artifact、evidence、error 与 side effect。自然语言可保留在 explanation 字段,但关键控制信息应结构化。
来源:官方 CS25 V4 slide deck,第 100 页
读图:需要同步的是 state,不只是聊天记录
Manager 必须知道任务版本、输入快照、worker 已执行的 action 和产物位置。若两个 worker 在不同 snapshot 上工作,最后文本都“说完成了”也可能无法合并。状态版本和 ownership 比措辞流畅更重要。
Verification:完成声明不能直接当事实
Progressive diagram 的关键变化是加入 verify step。Worker 返回 “done” 只是一条 claim;manager 或独立 verifier 必须检查 artifact、测试、环境状态或外部证据。下面两个 retained state 分别展示正常 verification 与 claim 冲突,重点是证据通道怎样改变控制流。
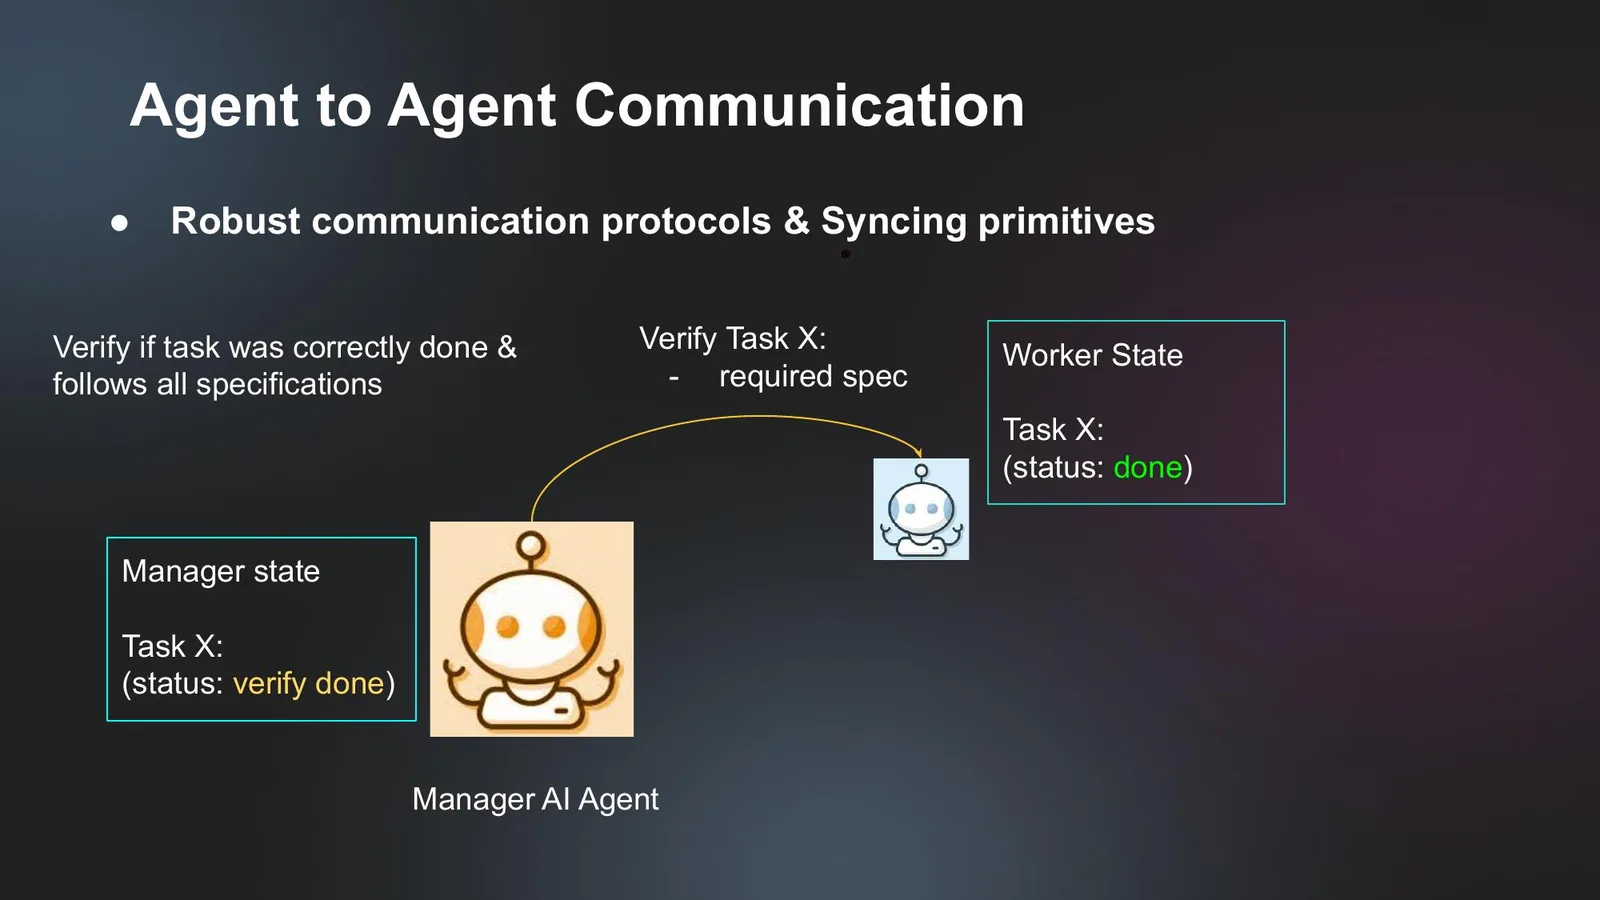
来源:官方 CS25 V4 slide deck,第 103 页
Verification contract
对 worker 产物 \(a\) 与规格 \(c\),verifier 输出
其中 \(e\) 是测试、日志、文件、页面或环境证据。unknown 很重要:证据不足时不应被强行压成 pass。
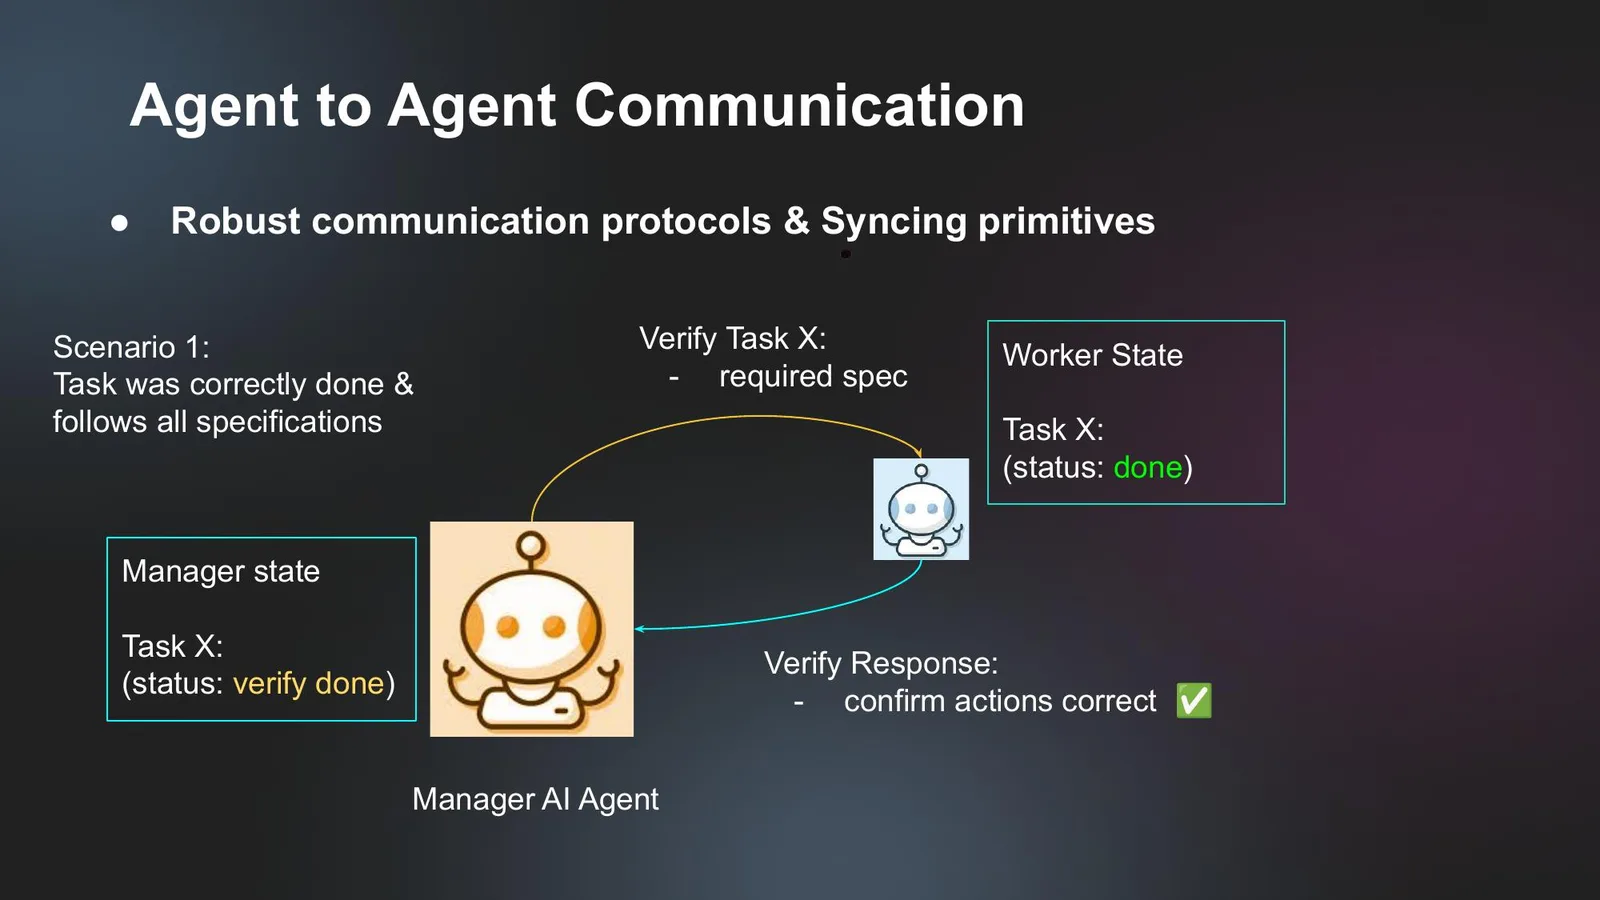
来源:官方 CS25 V4 slide deck,第 104 页
Conflict handling 不应变成“再问同一个模型一次”
若 verifier 只使用同一上下文、同一模型和同一错误假设,复核可能重复原错误。更强的验证应改变证据通道:运行测试、读取真实状态、使用不同 tool、检查 checksum 或要求可执行 proof。
Correction 与 redo path
最终状态图加入 re-do:manager 将失败原因和更新后的 context 发送给 worker,worker 重新执行。有效 recovery 需要区分 transient failure、bad plan、permission error 与不可逆 side effect。
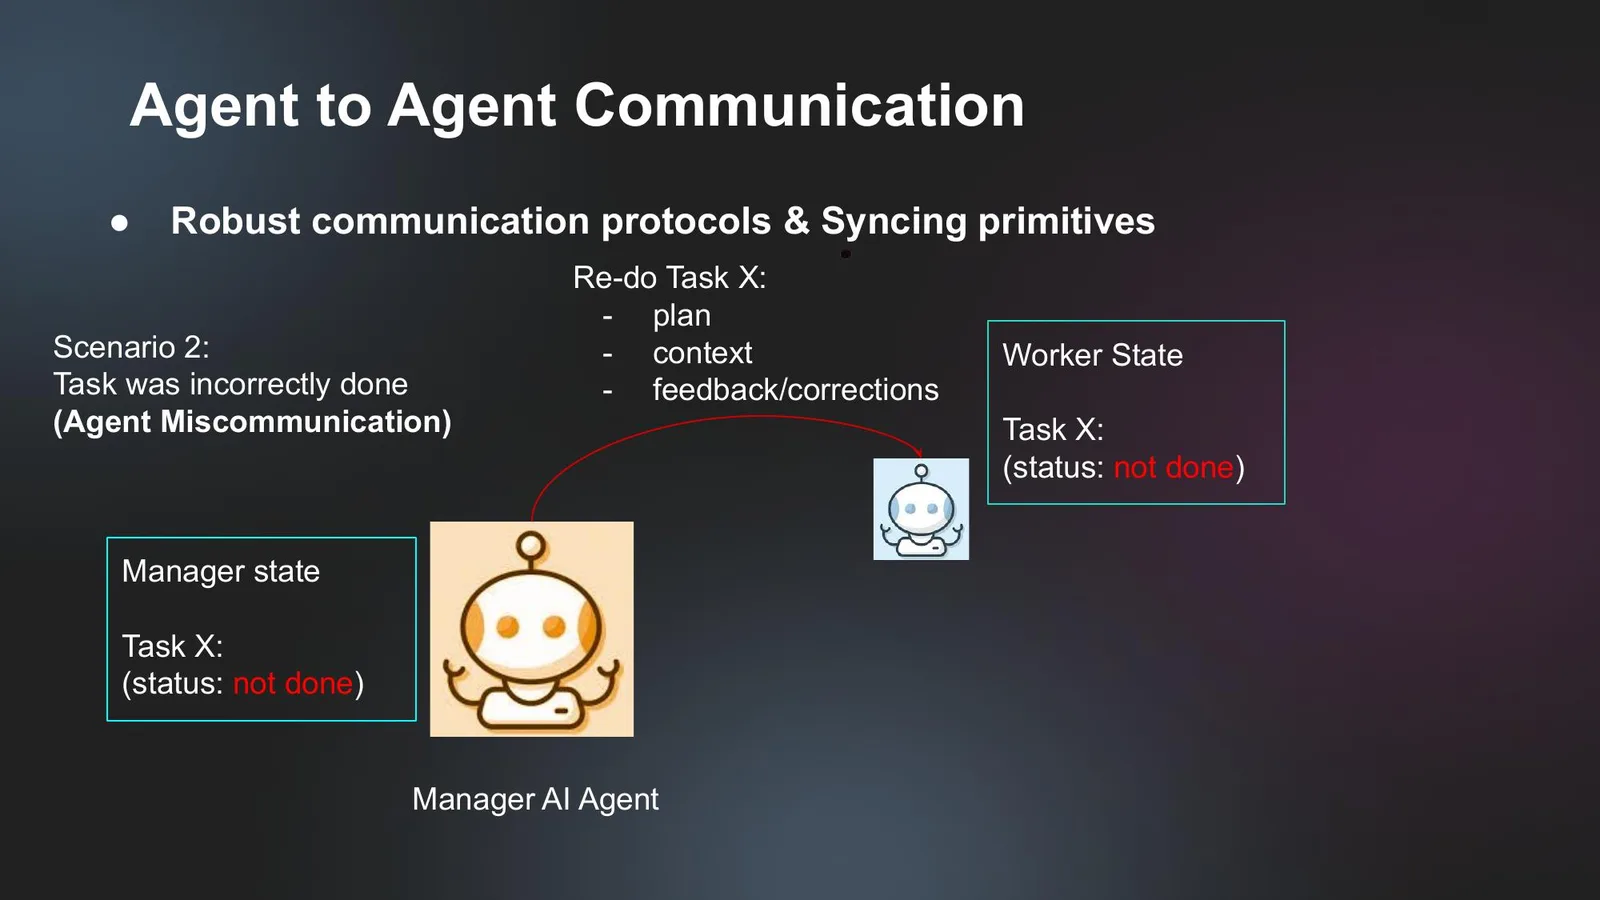
来源:官方 CS25 V4 slide deck,第 107 页
def run_task(manager, worker, verifier, task, max_attempts=3):
    context = manager.snapshot(task)
    for attempt in range(max_attempts):
        result = worker.execute(task, context=context)
        verdict = verifier.check(task.spec, result.artifact)
        if verdict.status == "pass":
            return manager.commit(result)
        context = manager.revise_context(
            previous=context,
            evidence=verdict.evidence,
            error=verdict.reason,
        )
    raise TaskFailed(task.id, context)
Redo 之前先判断 action 是否可重复
发送邮件、支付、删除文件和提交表单可能不是 idempotent。Recovery 需要 action ID、side-effect log、deduplication key 与 compensation plan;否则“重新执行”会把一次错误变成重复副作用。
课堂提示
课堂用 progressive diagram 说明 manager 不能相信 worker 的完成声明,必须验证;若结果错误,应把 failure context 回传并重做。这个闭环比“多 agent 自动协作”的口号更接近真实系统。
本章小结
Multi-agent system 的收益来自并行和 specialization,主要风险来自分解、通信、共享状态、验证与副作用。Manager–worker hierarchy 只有配合 typed protocol、evidence-based verification、versioned state 和 bounded redo,才会比单 agent 更可靠。
可靠性、Plan Divergence 与 LLM OS
课程最后把 agent 的剩余问题集中到 reliability。传统软件可以在相同输入下重复执行,agent policy 则会跨许多 stochastic step 与动态环境互动。局部成功率看似很高,长轨迹仍会快速累积失败。
自主 Agent 的关键问题
Key Issues 页列出 reliability、looping、plan divergence、benchmark、observability、security 与 human fallback。它们不是部署后的附加功能,而是 agent architecture 的一部分。
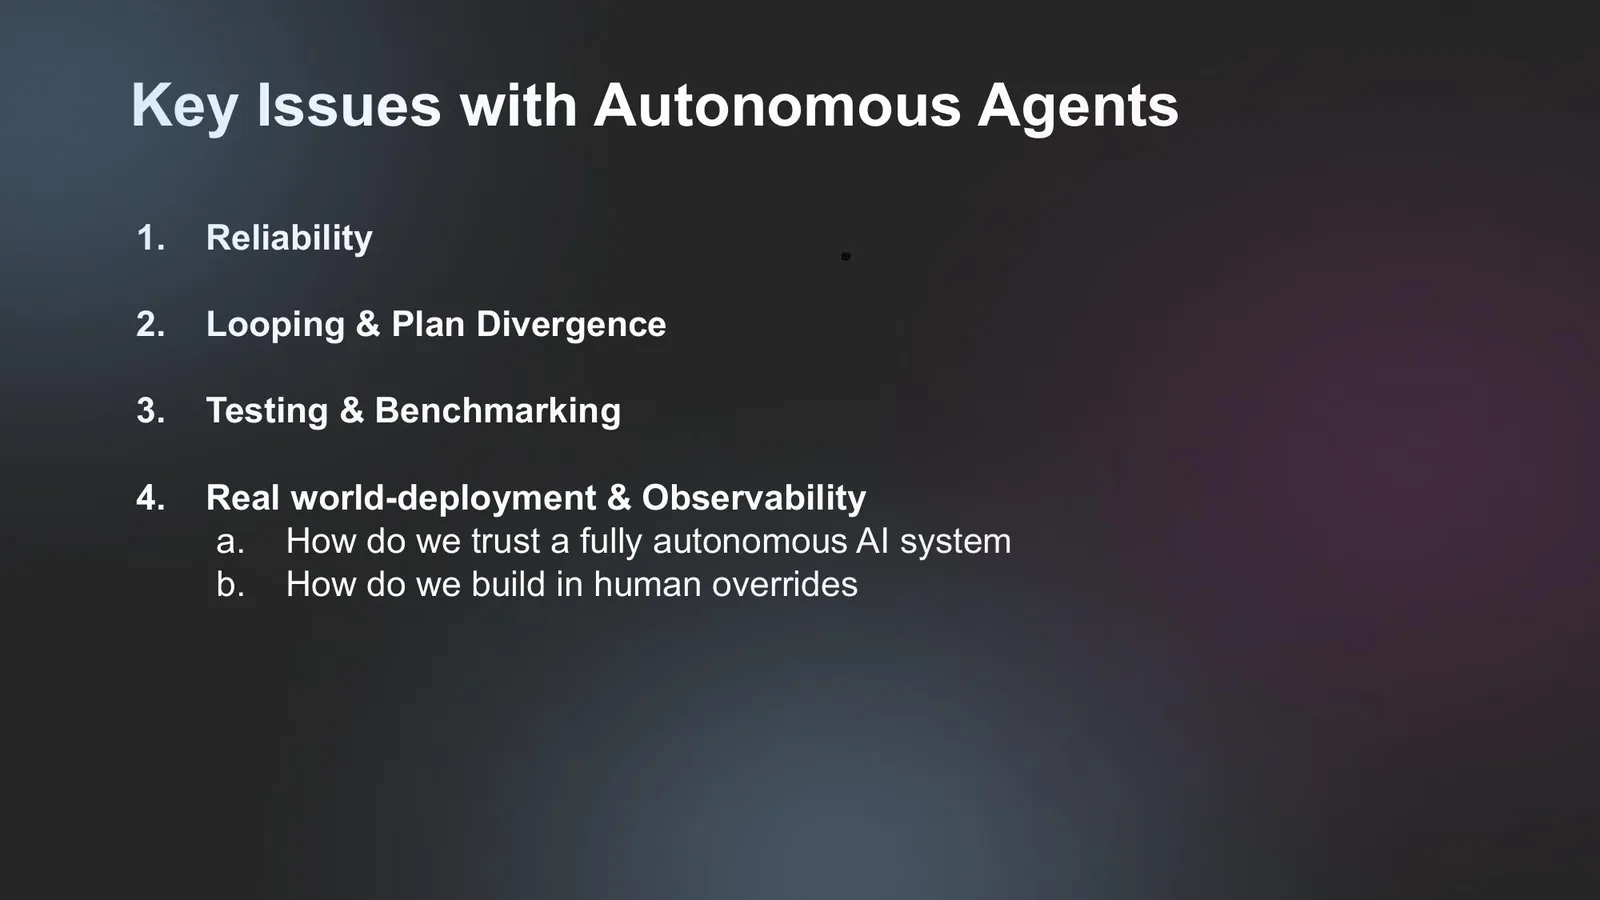
来源:官方 CS25 V4 slide deck,第 109 页
长轨迹成功率的乘法效应
若每一步独立成功概率为 \(p\),长度为 \(T\) 的 trajectory 全部成功概率近似
即使 \(p=0.99\),执行 100 步也只有约 \(0.99^{100}\approx 36.6\%\) 的全程无错概率。真实错误并不独立,早期偏离还会改变后续 observation,使失败更严重。
课堂提示
讲者用“95% 的 agent 仍有 5% 会失败”说明软件部署差异:传统程序可以修复 deterministic bug,stochastic agent 的少数失败会在大规模用户和长轨迹中不断出现。
Observability 要记录什么
- 每一步 observation、selected action 与 tool response;
- model/prompt/tool version 和 memory snapshot;
- permission decision、user confirmation 与 side effect;
- verifier verdict、retry、fallback 与 final outcome。
日志的目标是支持复现和定位,不是无限保存敏感内容;必须配合最小化、加密与 retention policy。
Plan divergence:偏离后怎样回到轨道
Plan divergence 页用 ideal path 与 actual path 对比。Agent 在某一步误读页面、工具报错或目标分解错误后,后续 action 可能建立在错误 state 上,最终进入 loop。本节承接前一页的 reliability,进一步解释为什么系统必须周期性比较计划 state 与真实 observation。
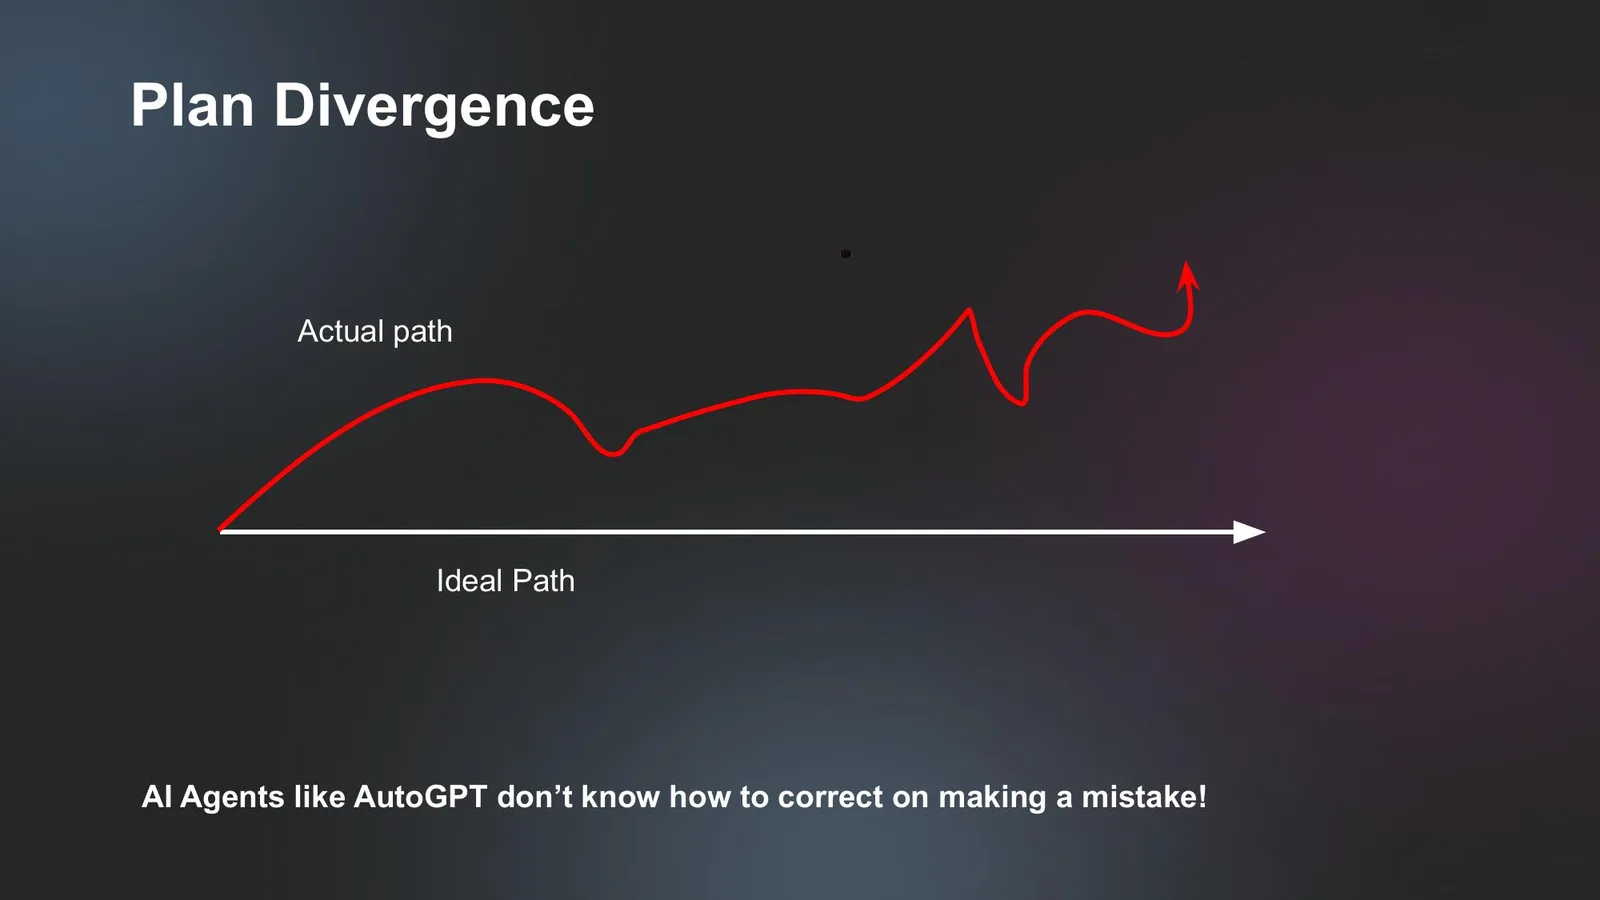
来源:官方 CS25 V4 slide deck,第 110 页
Recovery policy
Agent 不应只问“下一步是什么”,还要周期性检查
其中 \(s_t\) 是真实 observation,\(\hat{s}_t\) 是计划预期 state,\(g\) 是目标。当 divergence score \(d_t\) 超过阈值时,系统应暂停、重新观察、回滚到 checkpoint、重规划或请求人工介入。
Loop detector 不能只统计重复文本
Agent 可能用不同措辞重复同一失败 action,也可能在页面间循环。检测应结合 action signature、state hash、error pattern、progress metric 与预算消耗。达到步数、时间或成本上限时必须硬停止。
课堂提示
讲者评价 AutoGPT 是很好的 prototype,却“实际上做不了什么”,因为它容易循环、偏离并持续犯错。这里的重点不是否定原型,而是指出缺少 error correction 的长轨迹系统无法靠继续生成自行恢复。
LLM OS:一个有用但不完整的系统类比
Karpathy 的 LLM OS 图把 LLM 视为 CPU,把 context window 视为 RAM,把 embedding store 视为 file system,把 calculator、Python、terminal 视为传统软件或 ALU,把图像、音频、浏览器和其他模型视为 peripheral。
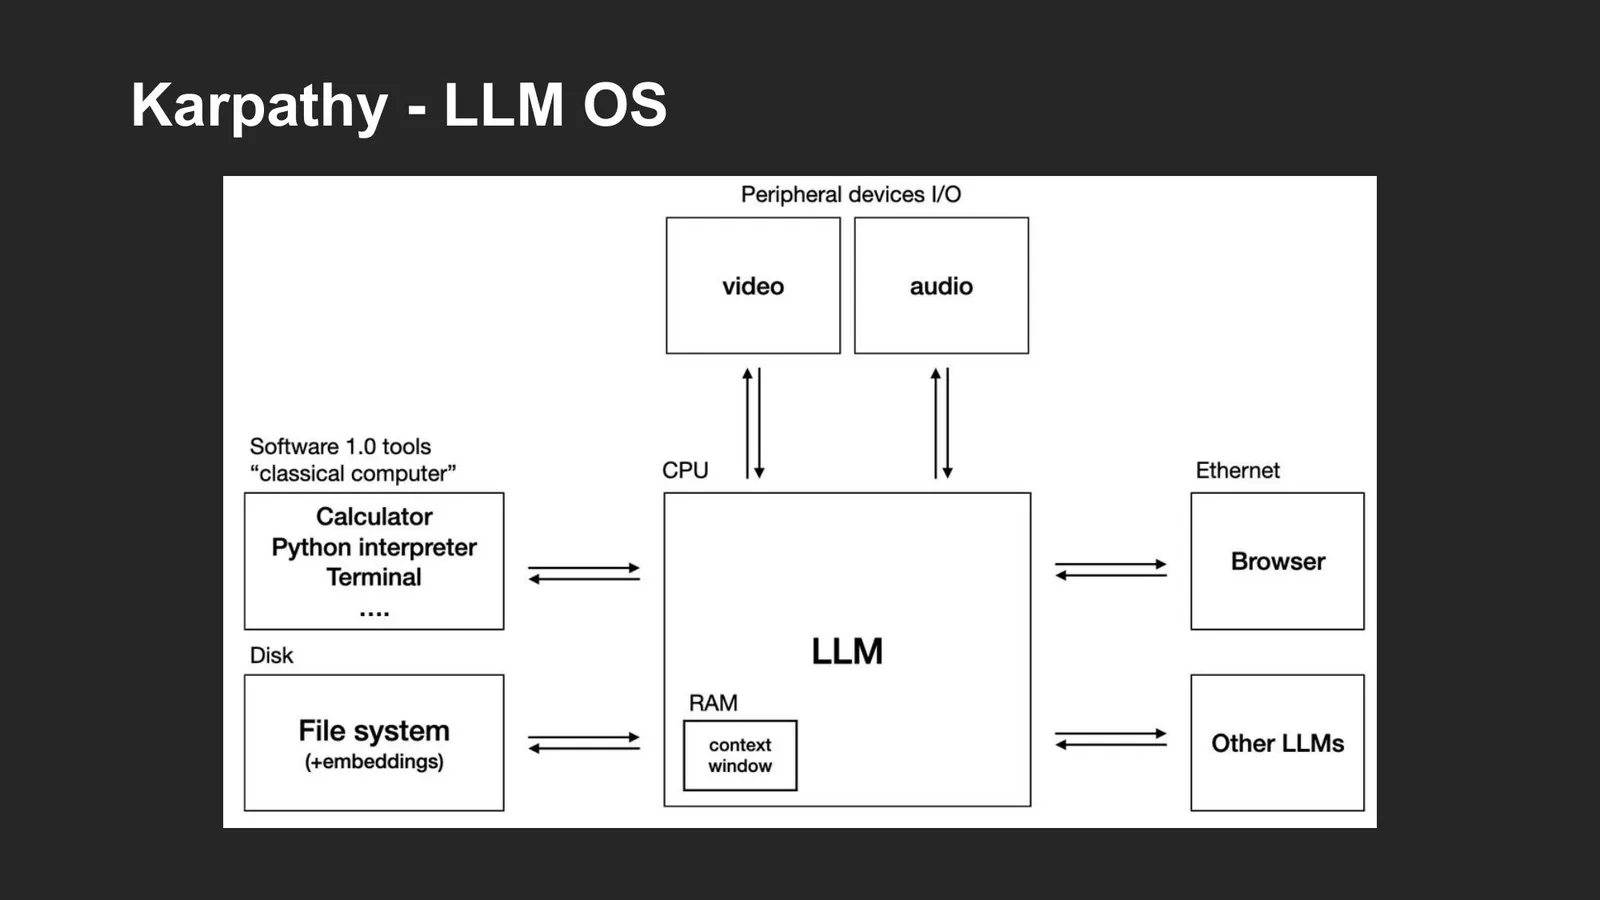
来源:官方 CS25 V4 slide deck,第 111 页
读图:LLM OS 映射表
| 传统系统 | LLM system 类比 | 尚缺的保证 |
|---|---|---|
| CPU | Foundation model | 确定执行、类型化指令与正确性。 |
| RAM | Context window | 隔离、分页一致性与受控写入。 |
| File system | Retrieval/memory store | 事务、权限、版本与删除语义。 |
| ALU/software | Calculator、Python、tools | 沙箱、资源上限与错误语义。 |
| Peripheral/network | Vision、audio、browser、other agents | 认证、信任边界与输入验证。 |
“OS”这个词不会自动带来操作系统能力
真正 OS 负责 scheduling、memory protection、process isolation、permission、interrupt 与 recovery。LLM orchestration framework 若没有这些机制,只是形状像 OS,而没有 OS 的安全和可靠性保证。
Generalized AI system 与 action engine
下一页把用户 chat interface、action engine、agents、memory、tools 与外部世界连接成 generalized system。Action engine 负责 route、plan、permission 与 aggregation,是模型之外最关键的 control plane。
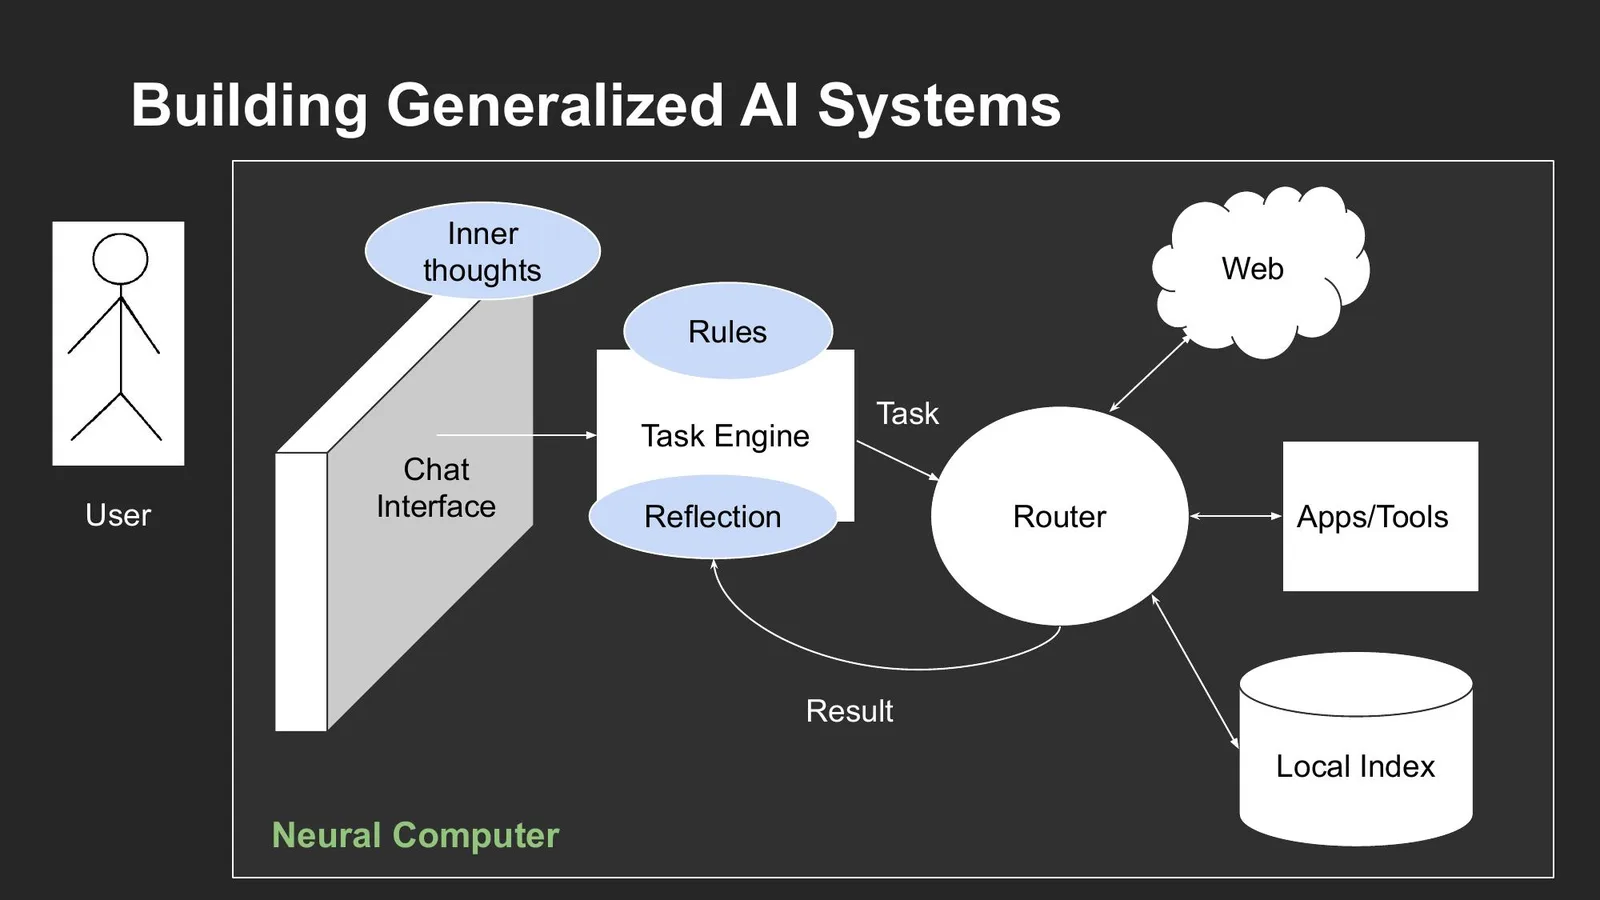
来源:官方 CS25 V4 slide deck,第 112 页
课堂提示
结尾愿景把 chat interface 后面的 action engine 设为路由中心:它把任务分给不同 agent,再汇总结果。这个位置也应承担权限、预算、验证和中止,而不能只是一个 prompt router。
Control plane 与 data plane
- Control plane:解析目标、选择 agent/tool、分配权限、维护 state、决定 retry/fallback;
- Data plane:实际执行 search、code、browser、database、message 或 device action。
把两者分离后,可以限制某个 model proposal 不直接等于真实 side effect。
Future needs:error correction、permission 与 sandbox
最后一页没有给出“agent 已解决”的结论,而是列出未完成的基础设施:error correction、better framework、security、user permission、risky-domain stability 与 sandboxing。读图时应把这些项目视为 deployment precondition,并与前面的 long-horizon failure、权限和 side effect 逐项对应。
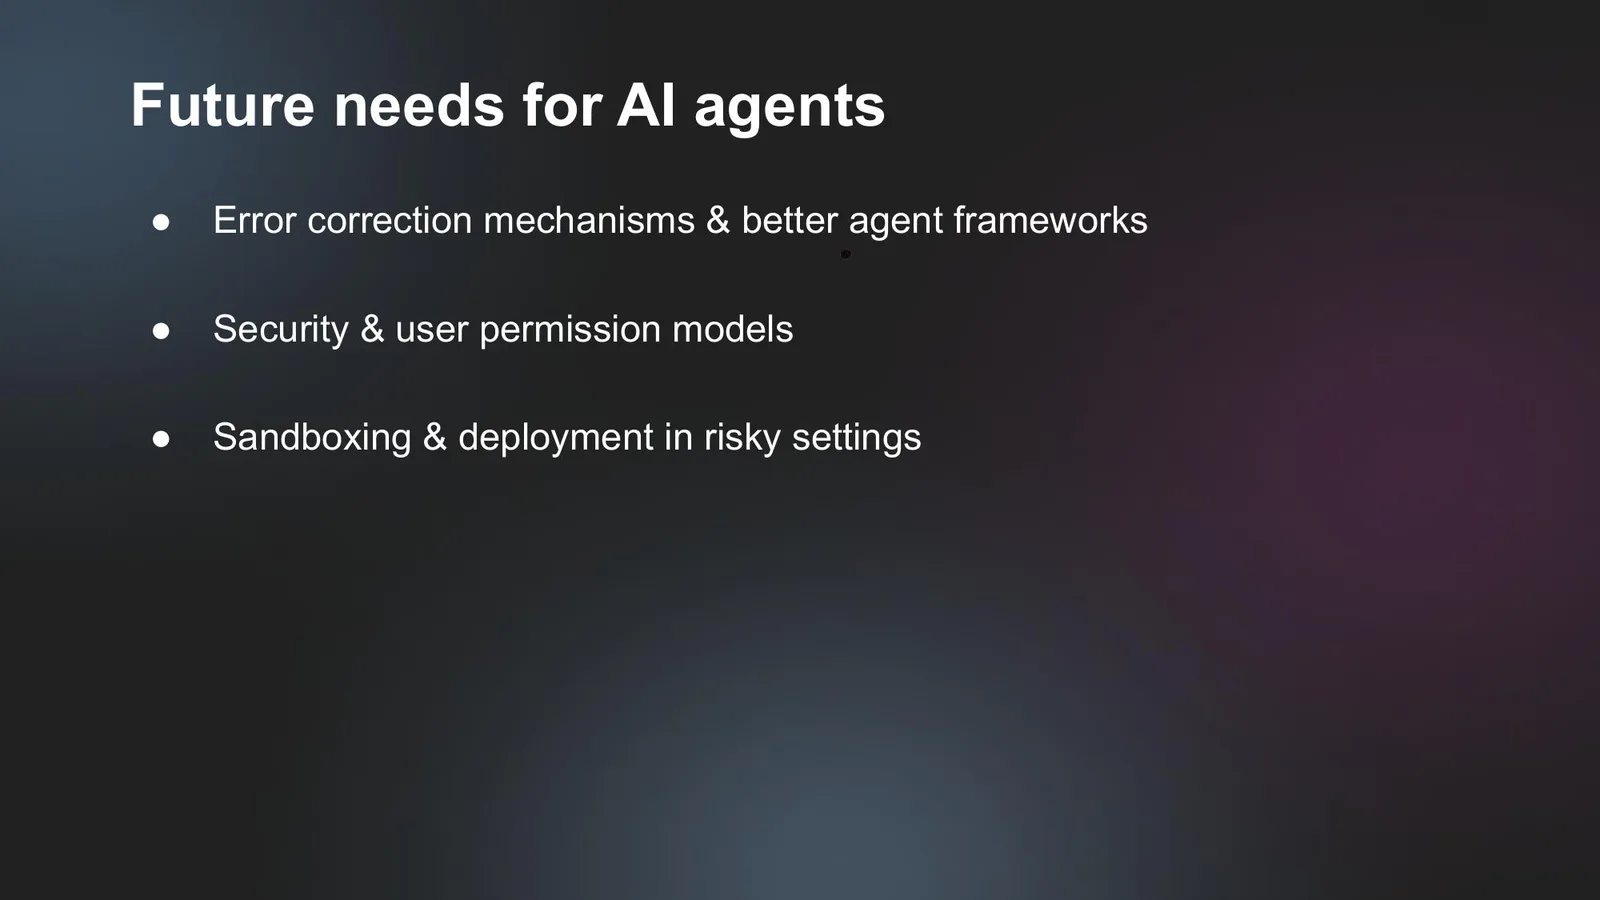
来源:官方 CS25 V4 slide deck,第 113 页
高风险 action 的最小安全栈
- Least privilege:只授予完成当前任务所需的最小 credential 和 action scope;
- Confirmation gate:支付、发送、删除、发布和权限变更需要显式确认;
- Sandbox:代码、文件和网络访问在隔离环境中运行;
- Budget:限制 token、步骤、时间、费用和外部调用;
- Audit and recovery:记录副作用,支持取消、补偿或人工接管。
课堂提示
课程的最终落点不是“agent 很快会全自动”,而是 error correction、security、user permission 与 sandbox 仍未解决。尤其在 finance、legal 等高风险场景,稳定和安全必须先于更长 autonomy。
本章小结
Agent reliability 受长轨迹乘法效应和 plan divergence 支配。LLM OS 提供了组织组件的语言,却不会自动产生 isolation、transaction 或 recovery。可部署系统需要 control plane、least privilege、verification、budget、fallback 与 sandbox 共同约束模型 proposal。
总结与延伸
这堂 Overview 从 attention 的信息选择机制一路走到 agent 的安全边界。表面上主题很多,底层可以压成三次边界扩张:第一,Transformer 让每个 token 直接读取相关上下文;第二,LLM 用规模、数据和 post-training 扩大可处理任务;第三,agent 在模型外增加 memory、tool、state、communication 与 environment feedback。每次扩张都带来新能力,也把验证从单个输出推向完整系统。
十个核心结论
从模型机制到系统工程
- Attention 用 query–key matching 选择 value,multi-head 提供多个表示子空间;
- Transformer 以 \(O(n^2)\) 全局配对换取短信息路径和训练并行性;
- LLM 仍以 next-token objective 为基础,instruction following 与 safety 来自额外训练和系统约束;
- Emergence curve 既可能反映 scale,也可能被 metric threshold 放大;
- RLHF、DPO、MoE 与 data quality 是不同层次的设计,不能压成“模型更大”;
- 外部 memory、RAG、continual learning 与 model editing 改变的对象不同;
- CoT、ToT 与 Socratic decomposition 增加中间计算,但必须配合 verifier;
- Agent 是 observation–action–feedback loop,不是一次模型调用;
- Multi-agent 的主要难点是 state、protocol、verification 与 recovery,而不是并行启动;
- LLM OS 是组件地图,真正部署还需要 permission、isolation、budget、fallback 与 sandbox。
一张表串起整堂课
| 层次 | 新增能力 | 新增失败模式 | 必要验证 |
|---|---|---|---|
| Embedding | 共享连续表示 | 相似度不等于事实关系 | 近邻、偏差与分布测试 |
| Attention | 按内容读取上下文 | 权重难以直接解释、长序列二次成本 | ablation、causal test、效率测试 |
| LLM scale | 更广任务覆盖与 few-shot behavior | 成本、污染、不可预测能力 | 多维 benchmark、数据审计 |
| Preference tuning | 更符合人类或组织偏好 | reward hacking、偏好偏差 | held-out preference、安全评估 |
| External memory | 可更新事实与个性化 | 错误检索、越权、过期 memory | 检索、证据与权限检查 |
| Reasoning scaffold | 更多 test-time compute 与可见步骤 | 自洽但错误、搜索成本 | 工具、验证与反事实测试 |
| Agent loop | 执行长期外部任务 | side effect、loop、plan divergence | 状态日志、预算、回退与恢复 |
| Multi-agent | 并行和 specialization | 协议歧义、冲突、重复副作用 | 结构化消息、版本和独立复核 |
课堂结尾真正留下的问题
讲者的 closing discussion 把 agent 未来集中在 error correction、security、permission 与 sandbox。这里还有几条值得继续追踪的开放问题:
- 如何测量 long-horizon success,而不是只测单步 tool call?
- 如何在不无限保存隐私数据的前提下实现 personalization?
- 如何让 memory 同时支持时间、层级、关系和遗忘?
- 如何区分 reasoning trace 的解释价值与真实因果机制?
- 如何让 multi-agent verification 独立于原始错误通道?
- 如何定义可撤销、可补偿和不可逆 action 的不同执行策略?
- 如何让更小模型、专用模型与 retrieval 在能力和成本之间协作?
最后的工程判断
模型给出的 action proposal 必须与真实 side effect 分离。任何涉及资金、身份、发布、删除、权限或不可逆操作的系统,都应把模型放在受约束 control plane 后面;没有 confirmation、audit、recovery 和 sandbox 的 autonomy,不应被包装成可靠自动化。
自测问题
- 为什么 attention 的 \(\sqrt{d_k}\) scaling 有助于 softmax 稳定?
- self-attention 与 cross-attention 的 Q/K/V 来源有何不同?
- 为什么 emergent metric 可能在底层能力平滑时出现跳变?
- RLHF 与 DPO 分别在哪一步使用 preference data?
- MoE 的总参数量与 active parameters 为什么不同?
- RAG、fine-tuning、continual learning 与 model editing 各改变什么?
- CoT 的可读中间步骤为什么不必然是忠实解释?
- 单次 LLM call 缺少哪些 agent component?
- UI control 相比 API control 多了哪些风险?
- manager 为什么不能直接相信 worker 的 “done”?
- 当 action 不可重复时,redo loop 应增加什么机制?
- LLM OS 类比中,哪些传统 OS 保证仍然缺失?
拓展阅读
- Vaswani et al., Attention Is All You Need:Transformer 与 multi-head attention 的原始论文。
- Wei et al., Emergent Abilities of Large Language Models 与 Schaeffer et al., Are Emergent Abilities of Large Language Models a Mirage?:分别理解现象与 metric caveat。
- Rafailov et al., Direct Preference Optimization:DPO objective 与 RLHF 关系。
- Meng et al., Locating and Editing Factual Associations in GPT:ROME 与 factual model editing。
- Wei et al., Chain-of-Thought Prompting 与 Yao et al., Tree of Thoughts:线性 rationale 与搜索式 reasoning。
- CS25 V4 official slide deck:本讲 114 页 canonical source。