Lecture 36:AGI 的到来与可用 Agent 系统
课程主线:AGI 不是一个形状,而是一套可承担责任的系统
“The Advent of AGI” 很容易被读成关于时间表、能力上限或超级智能的预测。Div Garg 的课堂主线更工程化:即使模型已经能聊天、推理和调用工具,把智能变成日常可用的行动系统仍需要定义任务、权限、记忆、训练、评测、通信与失败恢复。AGI 的 form factor 尚未确定,因此不能先假设它一定是更大的聊天窗口;应先问用户把什么责任交给系统、系统凭什么被信任、失败时谁能接管。
来源:Stanford CS25 V5 official recording, 00:00:15
来源:Stanford CS25 V5 official recording, 00:01:50
课堂提示
00:01:18–00:02:10,讲者说聊天与推理能力已经迅速提高,但“AGI 看起来像什么”仍没有共同答案。课堂提示:能力水平与产品形态是两个问题;后者决定系统如何进入社会、如何被验证以及谁承担风险。
本讲的操作性定义
本讲不把 AGI 定义为某个参数规模或 benchmark 阈值,而把它视为一个逐渐扩大的责任边界:系统能感知环境、形成计划、使用工具、持续记忆并代表用户行动。能力每扩大一步,都必须同时扩大评测、权限、观测和恢复机制。
Agent 的四层契约:Memory、Tools、Planning、Action
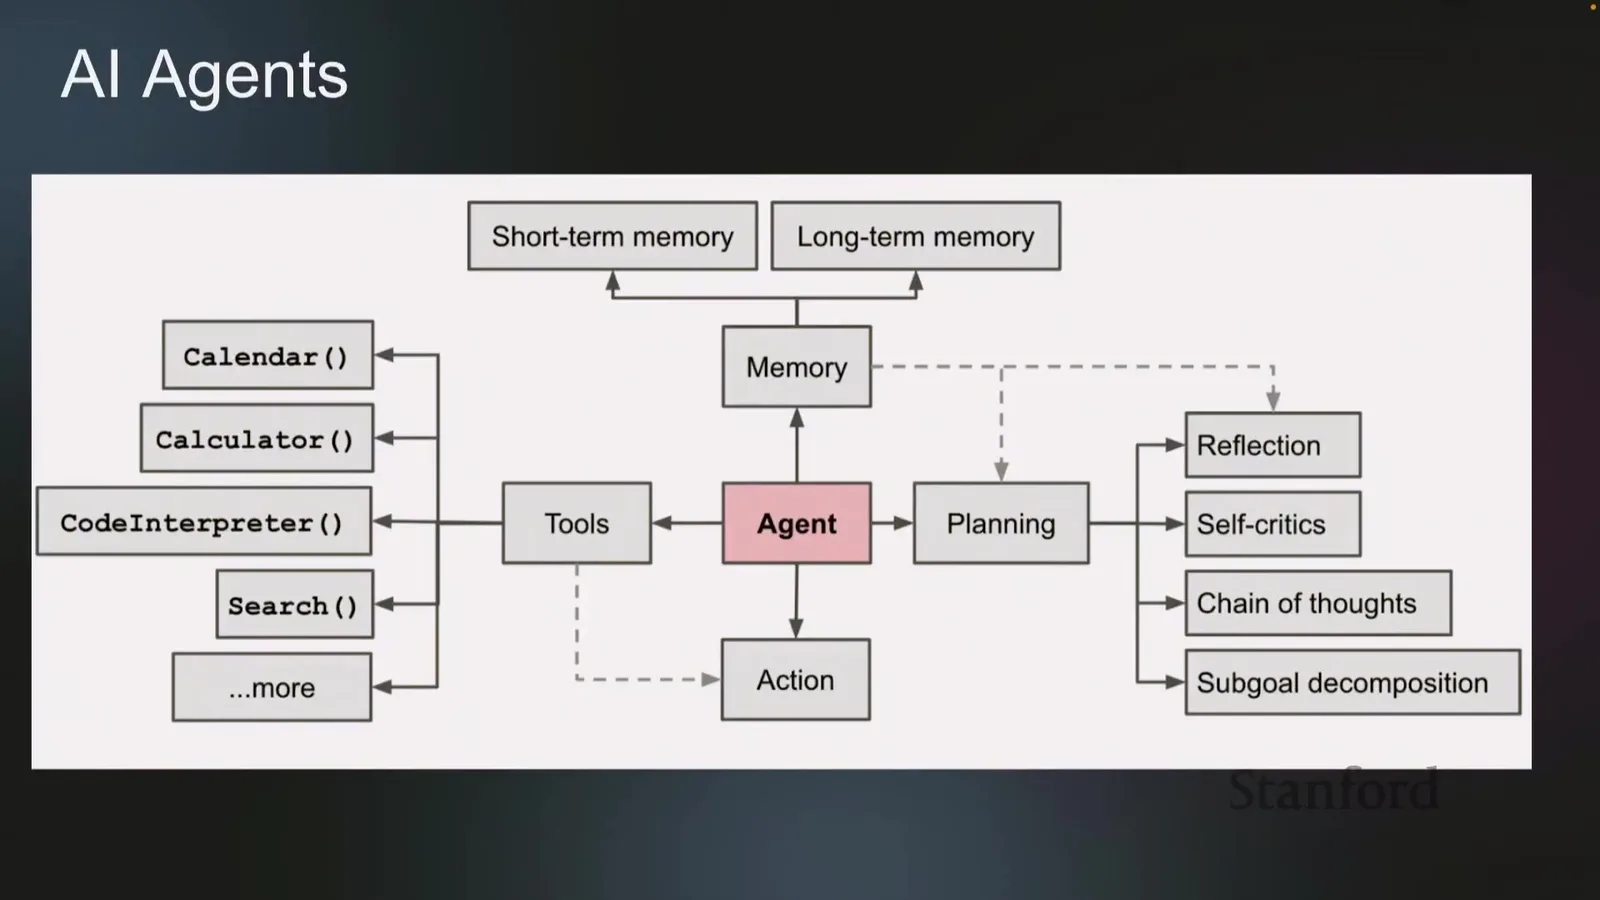
第一张系统图来自 Lilian Weng 对 LLM-powered agents 的经典拆分。读图时不要只记四个名词,而要看信息怎样流动:短期上下文和长期记忆给出状态;工具把语言连接到外部世界;规划产生可执行子目标;动作改变环境并带回新观察。任何一层缺失,系统都会退化成无法持续闭环的单次生成器。
来源:Stanford CS25 V5 official recording, 00:03:53
可把一个工具型 agent 写成部分可观测决策过程(Partially Observable Markov Decision Process, POMDP):
其中 \(\mathcal{S}\) 是真实环境状态,\(\mathcal{A}\) 是动作集合,\(P\) 是状态转移,\(R\) 是奖励,\(\Omega\) 是可见观察,\(O\) 描述状态怎样生成观察,\(\gamma\) 是折扣因子。模型通常只能看到网页、消息、工具返回和压缩记忆构成的 \(o_t\in\Omega\),而不是完整的 \(s_t\in\mathcal{S}\);因此“看起来合理”的下一步不一定是全局正确动作。
首次使用:Tool、Memory 与 Planning 分别解决什么
Tool 是模型可调用的外部能力,例如浏览器、数据库、日历或代码执行器;memory 是跨步骤保存和检索状态的机制,不等于把所有历史塞进 prompt;planning 是把目标分解为子目标、检查进展并在失败后改路。三者的接口必须显式,否则错误无法定位到“模型不会”“工具失败”还是“状态丢失”。
把 CoT 当作计划的危险
Chain-of-Thought(CoT)是语言化推理轨迹,不自动等于可执行计划。真实计划还需要动作前置条件、权限、预算、终止条件、幂等性和回滚。一个语言上连贯的步骤序列,可能在第三步就已经违反环境约束。
Everyday AGI:愿景必须立刻翻译成研究议程
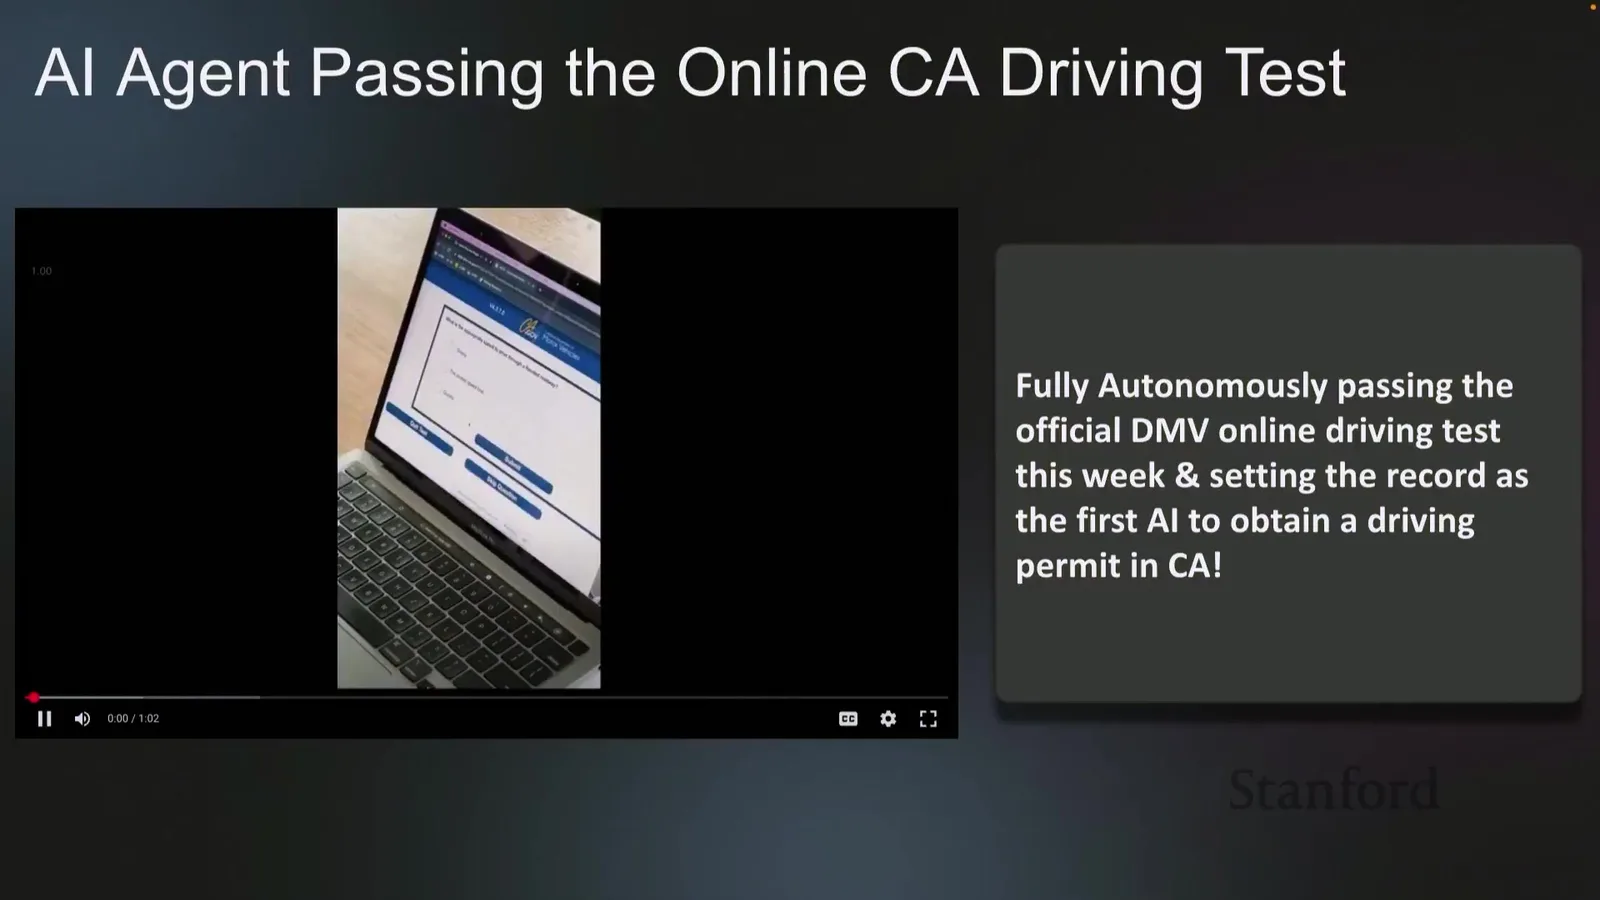
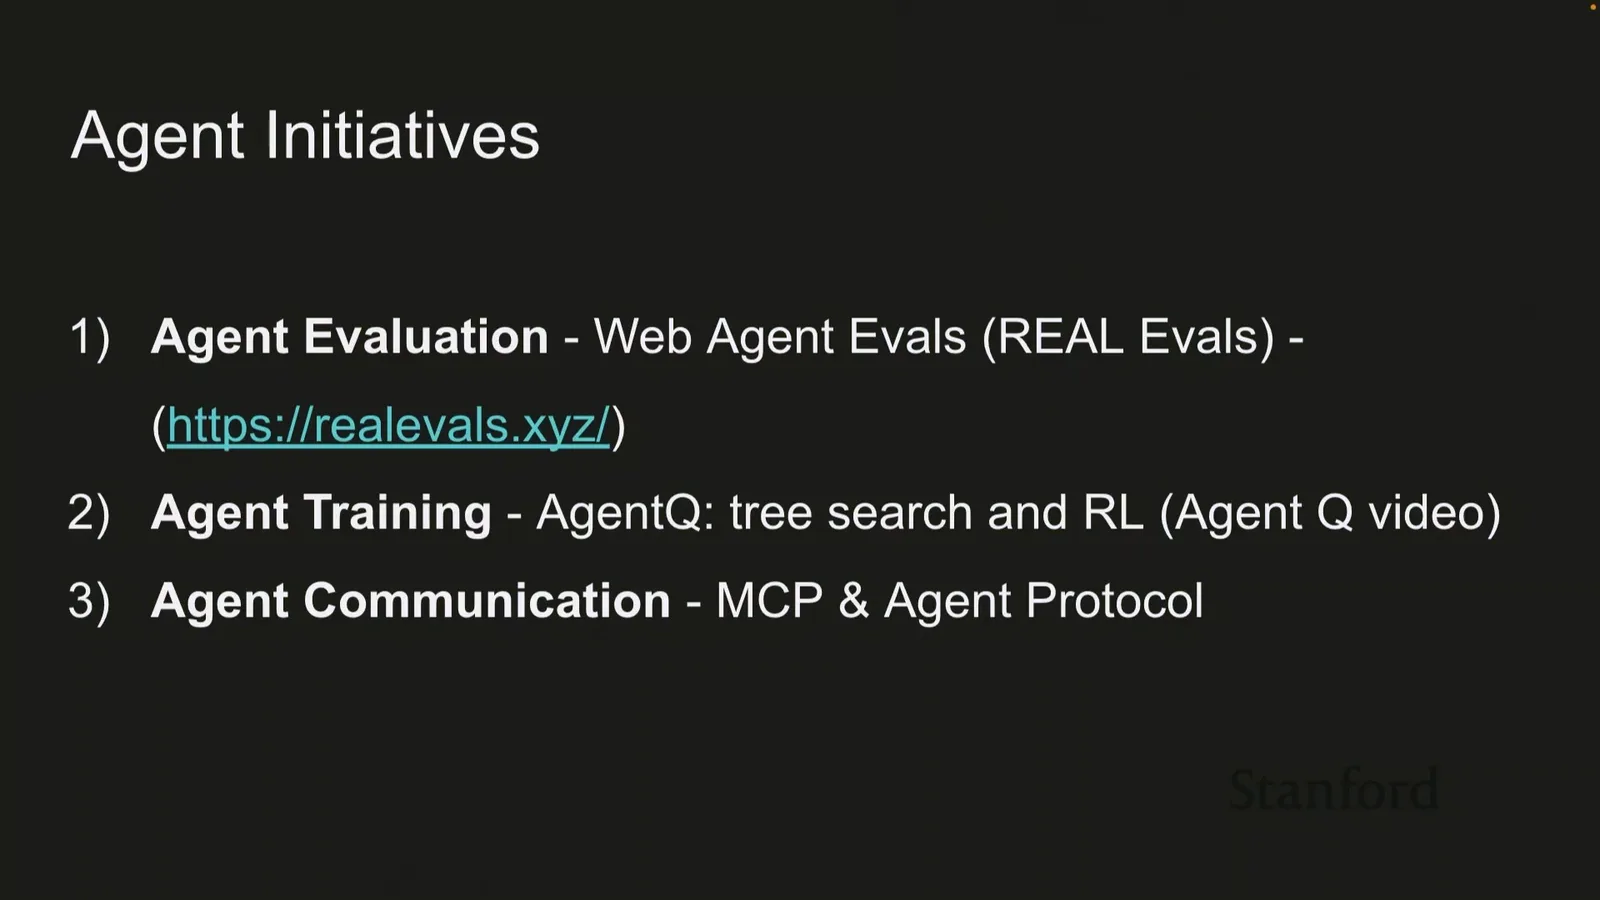
讲者用 Everyday AGI 和 DMV 驾驶考试演示表达一种产品愿景:AI 不只是回答问题,而是能够替用户完成现实流程。画面本身只能证明当时存在一个课堂 demo,不能证明所有州、所有考试或所有网站均可稳定完成。更重要的是,下一张 slide 立即把愿景拆成 evaluation、training 与 communication 三条研究线,说明产品承诺必须被转成可检验的系统问题。
来源:Stanford CS25 V5 official recording, 00:04:11
来源:Stanford CS25 V5 official recording, 00:05:28
来源:Stanford CS25 V5 official recording, 00:05:44
这三张图共同展示了“愿景–能力–基础设施”的递进。Everyday AGI 给出用户可感知的目标,DMV 画面给出一个具体交互样本,initiatives 则列出让样本变成可重复系统所需的研究工作。若只保留第一层,课程会退化成未来叙事;若只保留第三层,又会失去为什么需要这些技术。产品团队应把每个高影响 demo 写成任务规范,再反推需要哪些 deterministic environments、训练轨迹和跨 agent 协议。
课堂提示
00:04:11–00:07:10,讲者先展示“日常 AGI”愿景,再列出 REAL Evals、AgentQ 与 agent communication。讲义提醒:demo 是提出问题的入口,不是可靠性证书;真正的主线是怎样评、怎样学、怎样协作。
从 Demo 到系统验收的五个问题
- 任务是否有可判定的完成条件?
- 环境变化后能否复现同一测试?
- 中间动作是否全部可追踪?
- 失败能否恢复而不是重头盲试?
- 高风险动作是否需要用户确认或人工接管?
本章小结
本章把“AGI 到来”压缩为一个系统合同:模型必须在部分可观测环境中,用记忆、工具、规划与行动完成闭环;而任何产品愿景都要被立即翻译成评测、训练、通信和责任边界。下一章进一步回答:为什么要采用“human-like”计算机交互,以及自主程度怎样分级。
Human-like Agents:能力扩张必须与权限分级同步
这一部分从“为什么需要 agents”走向“为什么让 agents 使用人类界面”。讲者的答案不是界面更酷,而是现实世界已经为人类建立了浏览器、桌面、表单、登录与支付流程;如果 agent 能在这些界面上操作,就能跨越 API 不完整、服务异构和长尾任务。但直接控制也扩大了动作空间与风险,因此必须把自治级别、确认点和回滚写入产品合同。
来源:Stanford CS25 V5 official recording, 00:07:10
来源:Stanford CS25 V5 official recording, 00:07:37
从问题清单到交互 thesis
“Why、How、Ingredients、What can they do” 四个问题给后文提供了教学框架。最终 build 展示讲者的 thesis:人类用自然语言表达意图,AI 操作机器。这里的关键不是自然语言本身,而是把模糊意图变成受约束的动作,并让用户能够观察、修改和撤销。
来源:Stanford CS25 V5 official recording, 00:07:54
来源:Stanford CS25 V5 official recording, 00:08:27
来源:Stanford CS25 V5 official recording, 00:08:53
设任务由 \(n\) 个必须成功的步骤组成,第 \(i\) 步成功概率为 \(p_i\)。若错误无法恢复,端到端成功率近似为
若每步都是 \(p_i=0.98\),20 步任务也只有 \(0.98^{20}\approx 0.668\)。这解释了为什么聊天中“偶尔犯错”的模型,一旦进入长任务就会显得非常脆弱;agent 系统必须加入验证、重试、分支搜索和恢复,而不是只期待基础模型再提升一点。
长任务的可靠性不是单步准确率
平均单步正确率会掩盖关键步骤和风险差异。支付确认、删除文件或发送公开消息的错误成本远高于一次无效搜索;验收应按步骤重要性、错误可逆性和暴露频率分层。
为什么追求 human-like interface
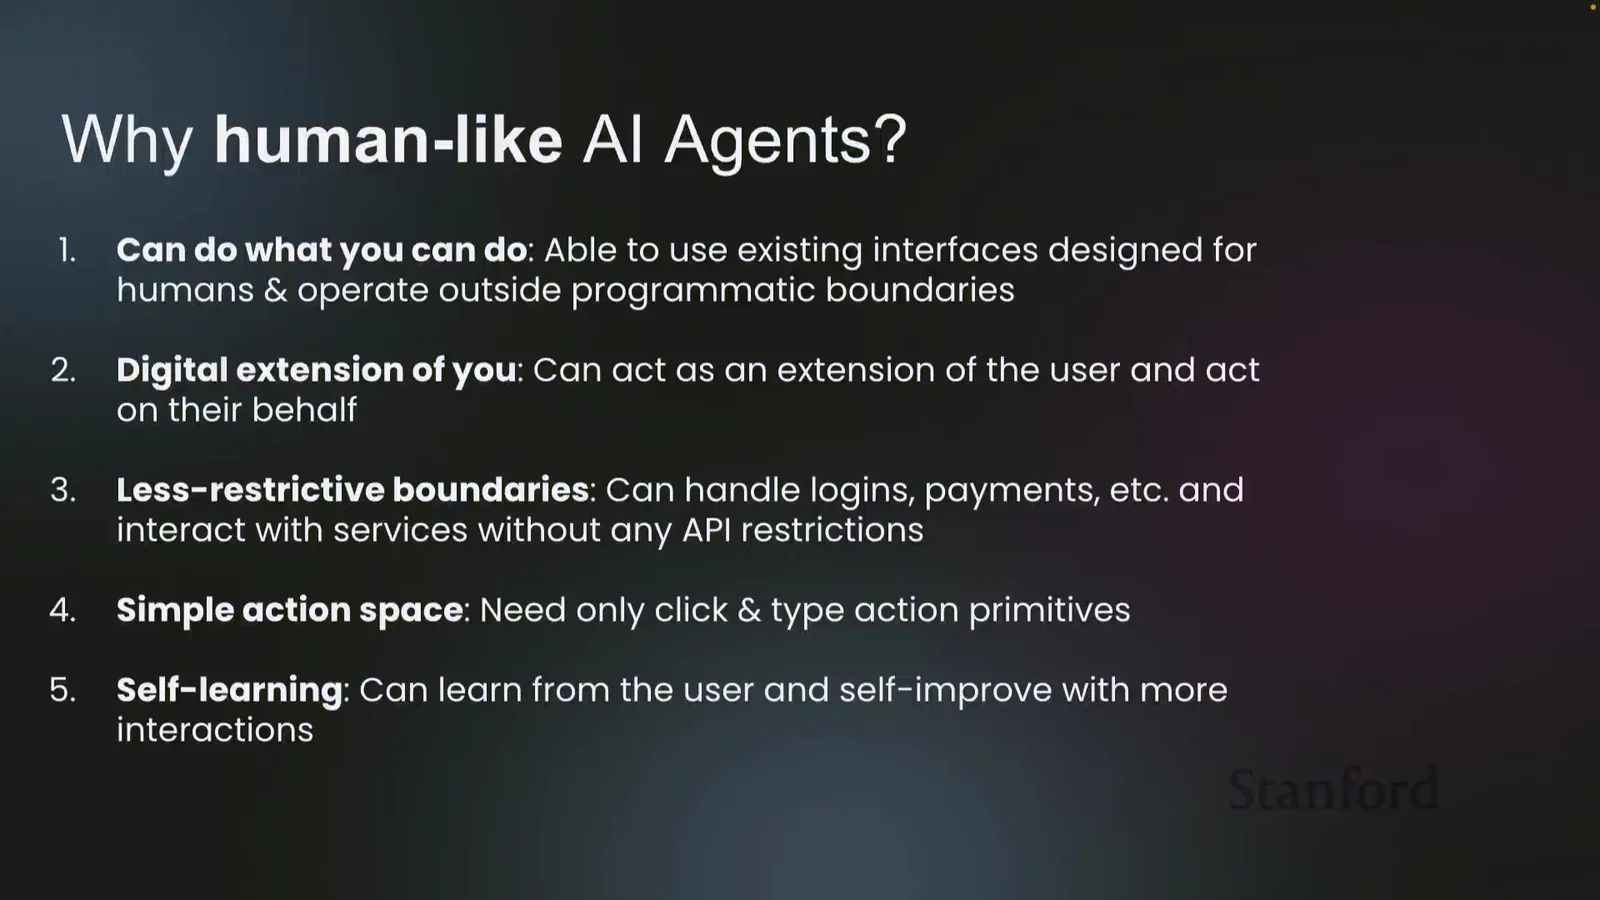
最终完整 slide 给出五个动机:复用为人设计的界面、成为用户的数字延伸、跨越 API 限制、使用简单 click/type 动作,以及从用户交互中持续学习。读图时要同时看到反面:界面为人设计,不等于适合机器;视觉变化、弹窗、广告、登录、反自动化机制和模糊反馈都会制造分布偏移。
来源:Stanford CS25 V5 official recording, 00:11:29
课堂提示
00:08:53–00:11:36,讲者强调“一次 LLM call 不够”,并把 human-like agent 定义为能在现有界面上代表用户行动、处理登录与支付、使用 click/type primitives、再从用户处学习。课堂提示:每个优势同时扩大了权限与攻击面。
术语消化:Agent 能力栈
| 术语 | 解决的问题 | 本讲中的系统关系 |
|---|---|---|
| Browser control | 没有稳定 API 时怎样操作服务 | 扩大覆盖面,但引入视觉变化与不可逆动作 |
| Tool calling | 怎样把语言请求映射到结构化调用 | 更可控,但受 schema、权限和错误返回约束 |
| Computer use | 怎样操作桌面、键鼠与多应用 | 动作通用,观测和恢复更困难 |
| Long-term memory | 怎样跨会话保存用户与任务状态 | 支持连续性,同时带来过期、隐私和污染风险 |
| Self-correction | 怎样从失败状态寻找替代路径 | 需要可判定反馈、预算与停止条件 |
API 与直接控制是两种不同的风险模型
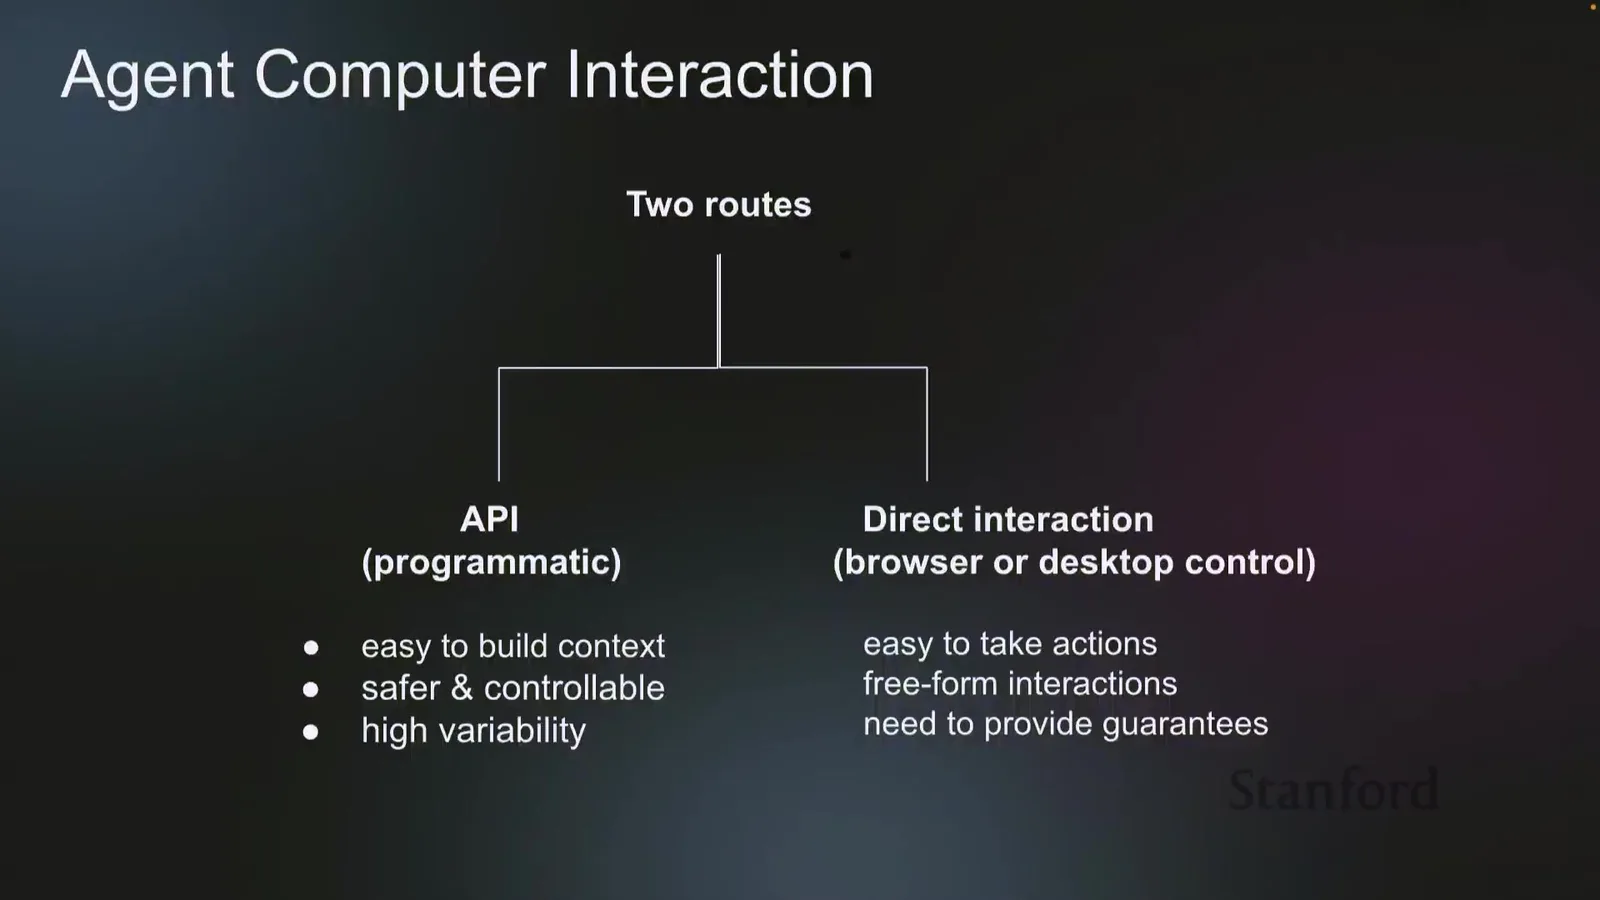
API 路线提供结构化 schema、明确错误码和较小动作空间,通常更易审计;直接浏览器或桌面控制覆盖长尾任务,但观察是像素或 accessibility tree,动作含义依赖上下文。二者不是“旧方式与新方式”,而是应按任务风险选择的两种 contract。
读这张对照图时应沿着三个维度判断。第一是状态可见性:API 往往返回结构化字段,直接控制只能从页面推断;第二是动作可逆性:读取接口容易重试,提交表单或点击购买可能产生真实副作用;第三是兼容成本:API 会版本升级,网页也会重排。好的系统不会永久押注一种路线,而会优先使用结构化接口,在缺少覆盖时才降级到浏览器,并对降级动作提高确认等级。
来源:Stanford CS25 V5 official recording, 00:12:31
动作合同应该显式记录什么
对每次动作 \(a_t\),至少记录目标资源、参数、调用者、权限依据、幂等键、预期后置条件和回滚方法。若动作是网页点击,也应把“点击哪个可访问节点”转成稳定标识,而不是只保存坐标。
自治等级:能做与应该做不是同一个问题
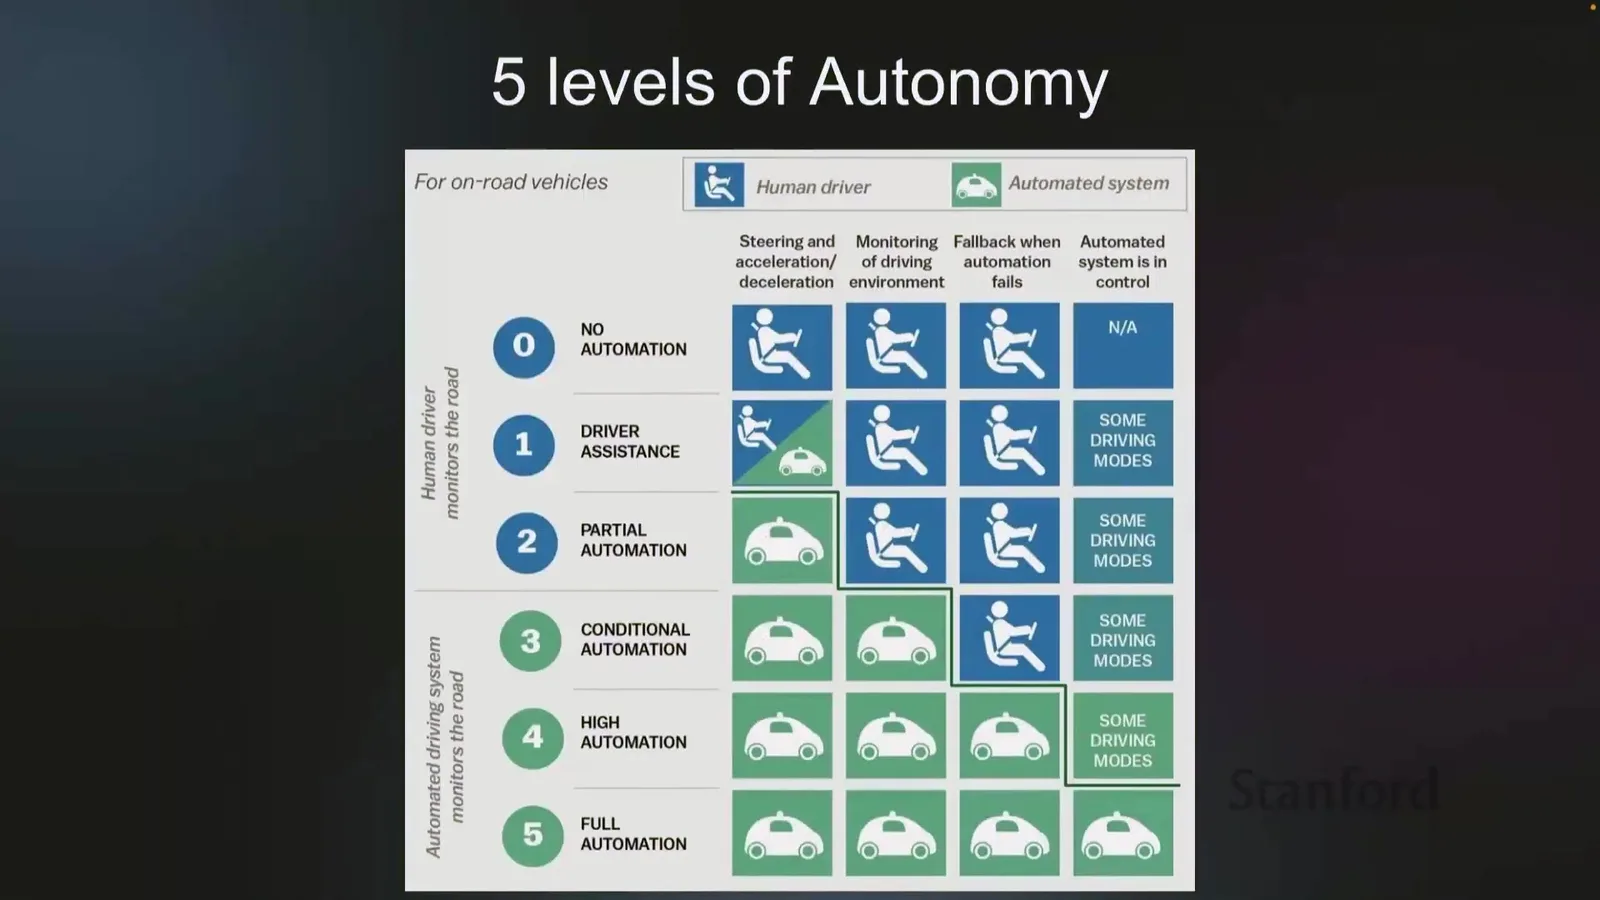
讲者借用自动驾驶等级图来讨论 agents。更高自治不是简单减少用户点击,而是把环境监控、异常判断和 fallback 责任从人移向系统。每提升一级,都要说明谁监控、谁确认、谁负责终止,以及系统失效时是否仍有安全状态。
来源:Stanford CS25 V5 official recording, 00:13:50
自动驾驶类比的边界
网页任务与道路驾驶共享“感知–决策–行动–接管”结构,但风险、时延和法律责任不同。类比可帮助定义 fallback,不应把某个 agent 产品直接宣传为“L4/L5”。
本章小结
Human-like agents 的价值是复用现实接口并代表用户完成长尾流程;它们的风险也来自同一来源。API 与直接控制应按可控性、覆盖面和可恢复性选择,自治等级必须与监控、确认和接管责任同步设计。下一章用 REAL Bench 说明如何把这些复杂性放进可复现评测。
REAL Bench:不要只报总分,要评估任务分布
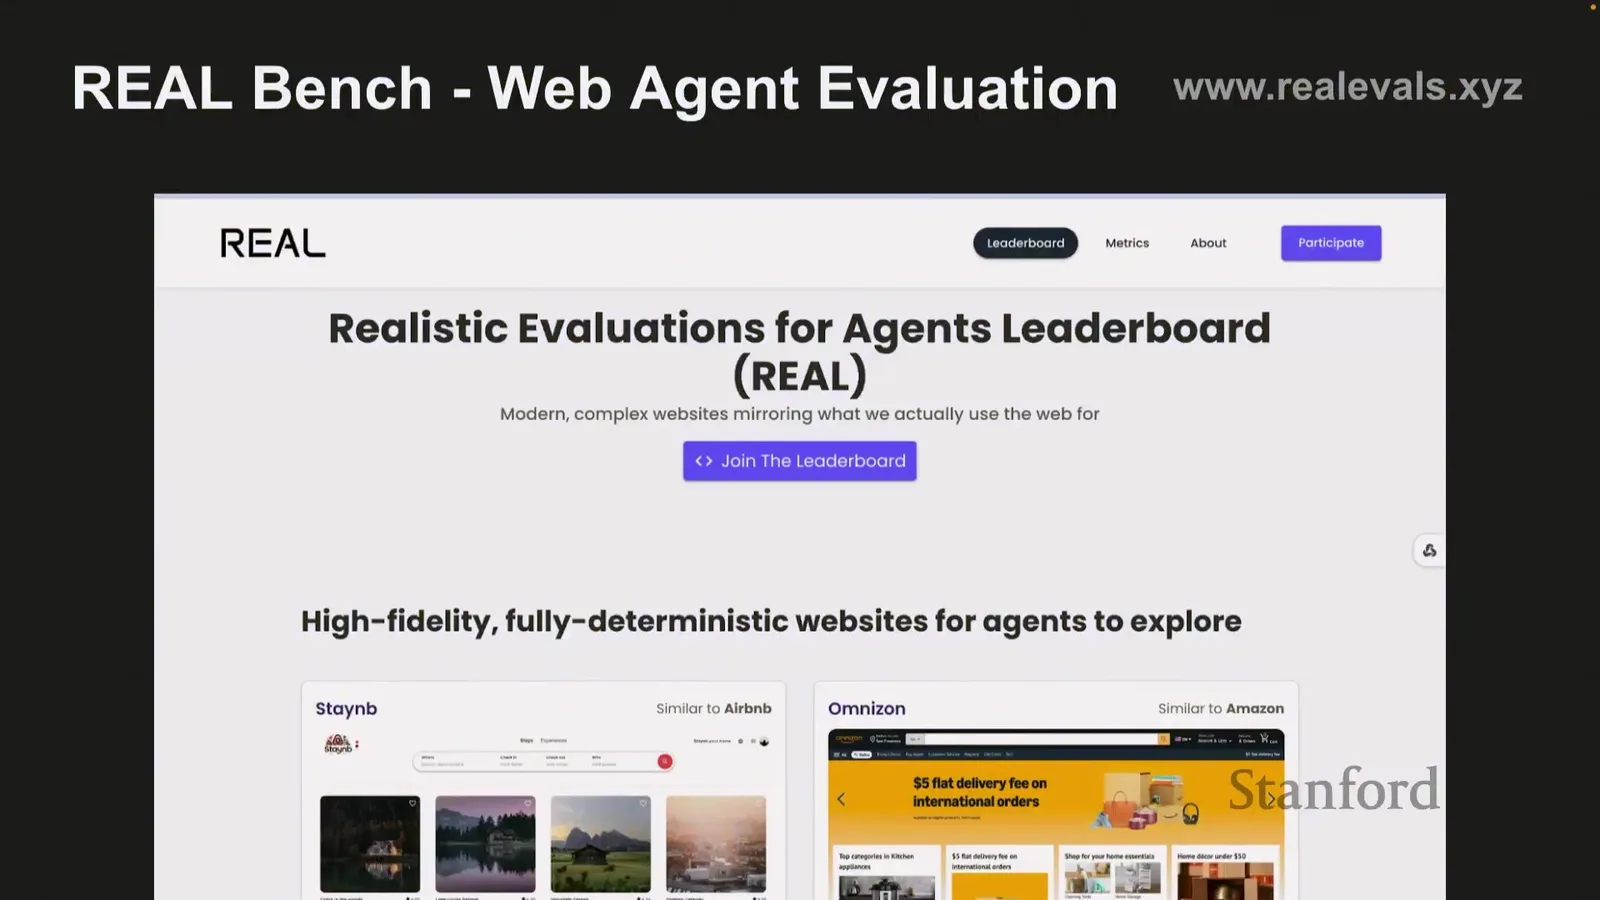
线上网页不断变化,直接在真实网站上测 agent 会遇到页面更新、库存变化、登录状态和安全风险,导致不同模型不在同一环境中比较。REAL 的核心价值是建立高保真但确定性的站点副本,使动作轨迹可以重复执行、失败可以复盘、模型可以按相同任务集比较。
来源:Stanford CS25 V5 official recording, 00:14:43
定义:确定性环境不等于简单环境
Deterministic simulation 表示同一初始状态和动作序列产生可复现结果;它仍可以包含复杂页面、多个站点和长任务。确定性主要解决实验可比性,不保证环境覆盖真实世界的全部噪声。
从单模型总分到多域能力向量
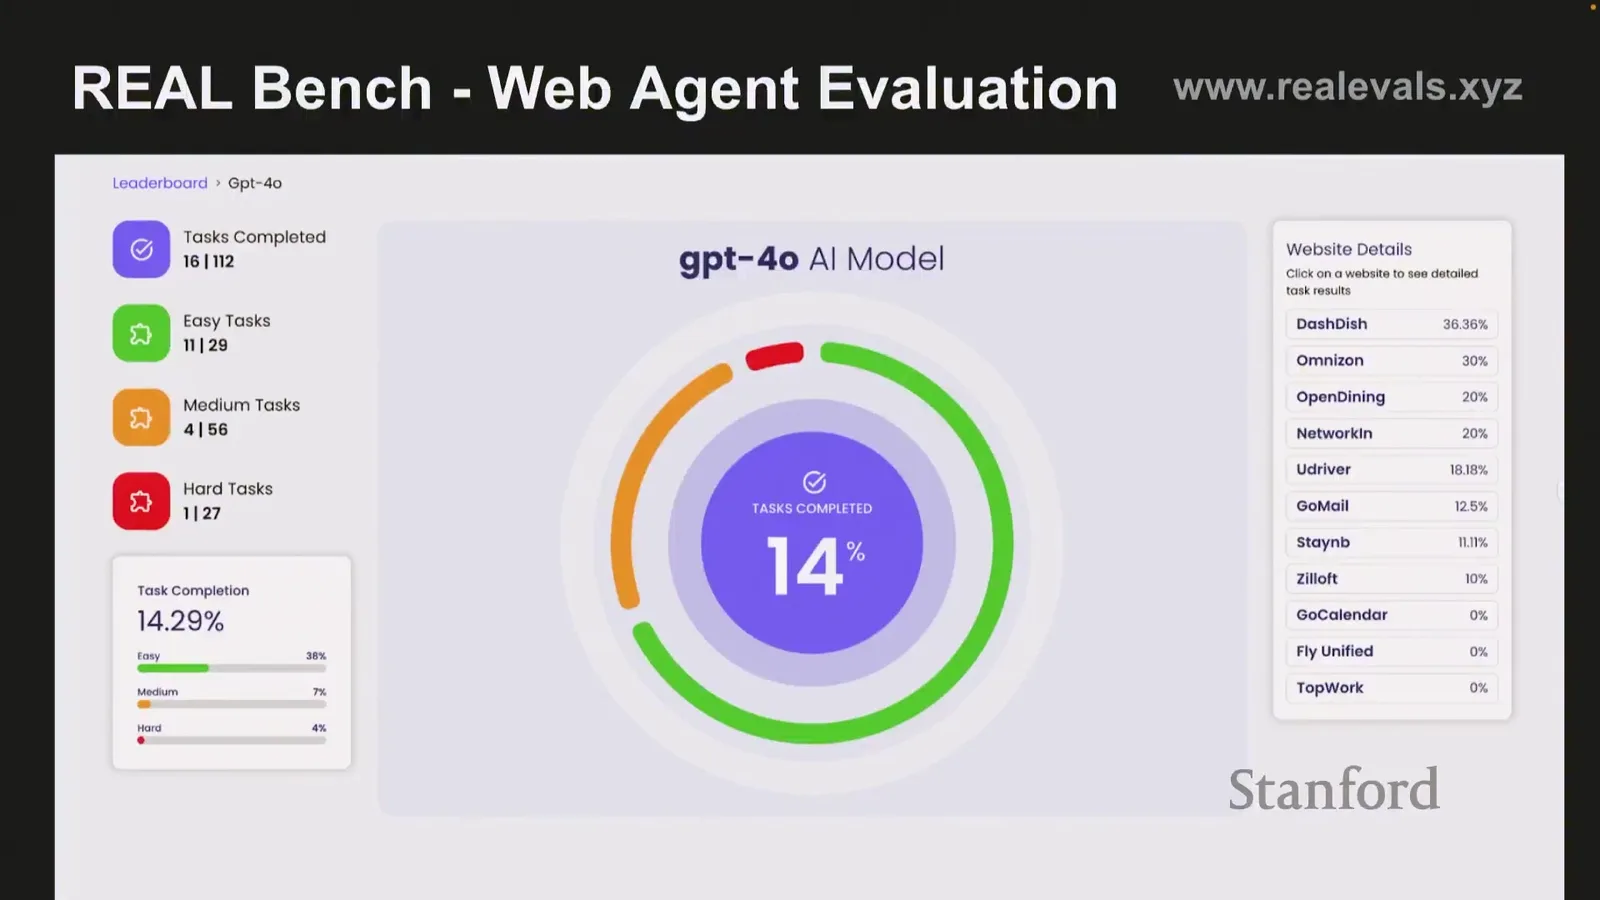
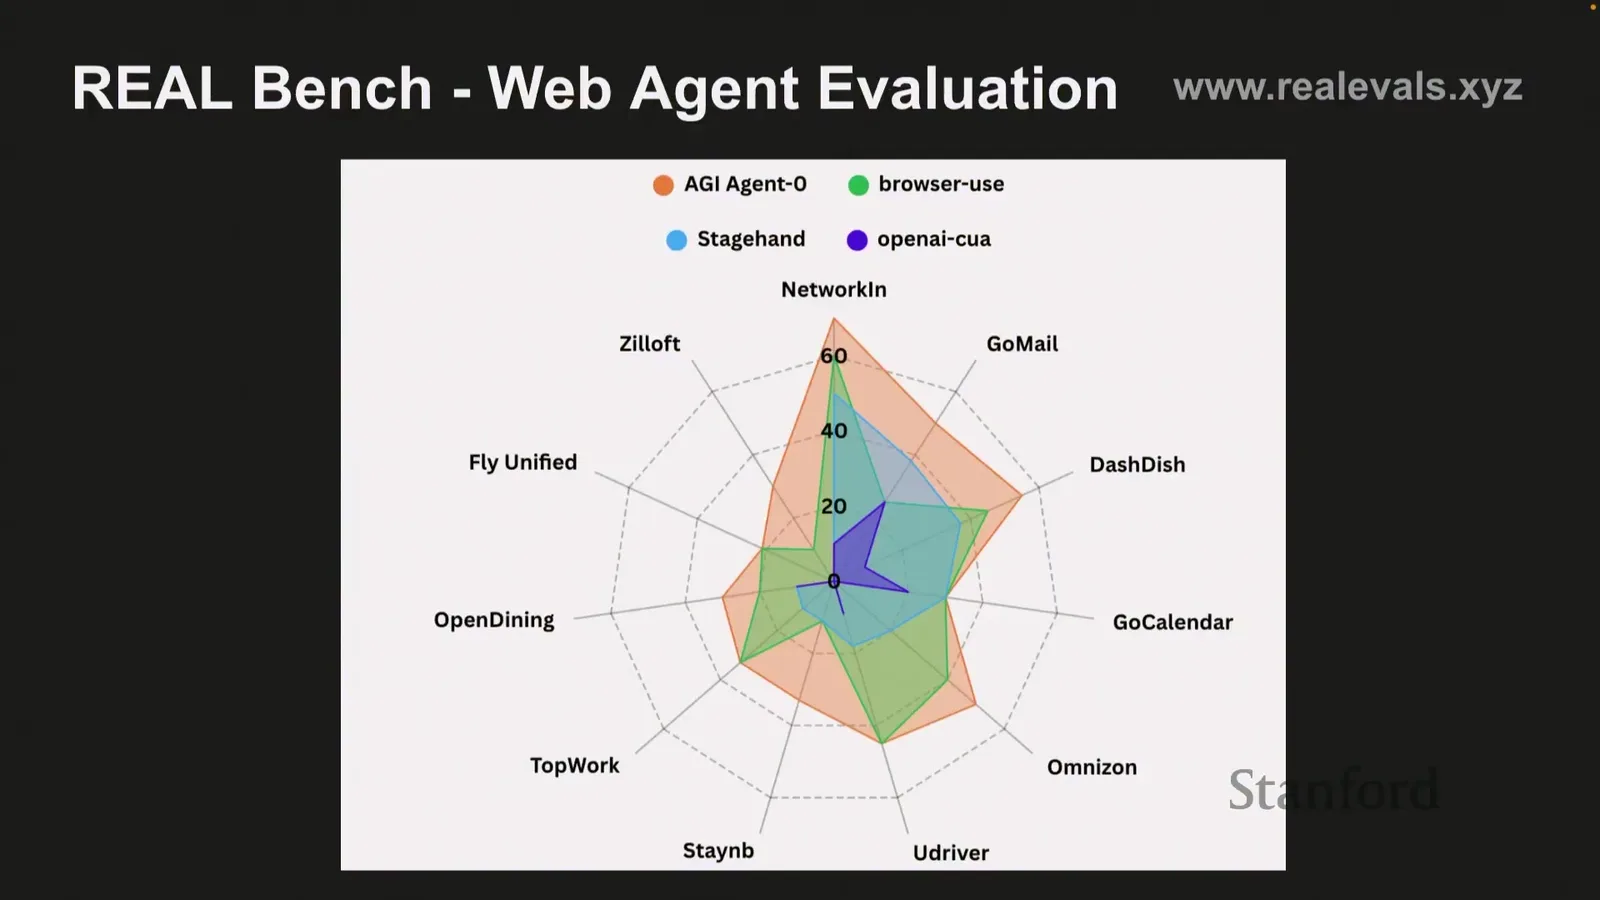
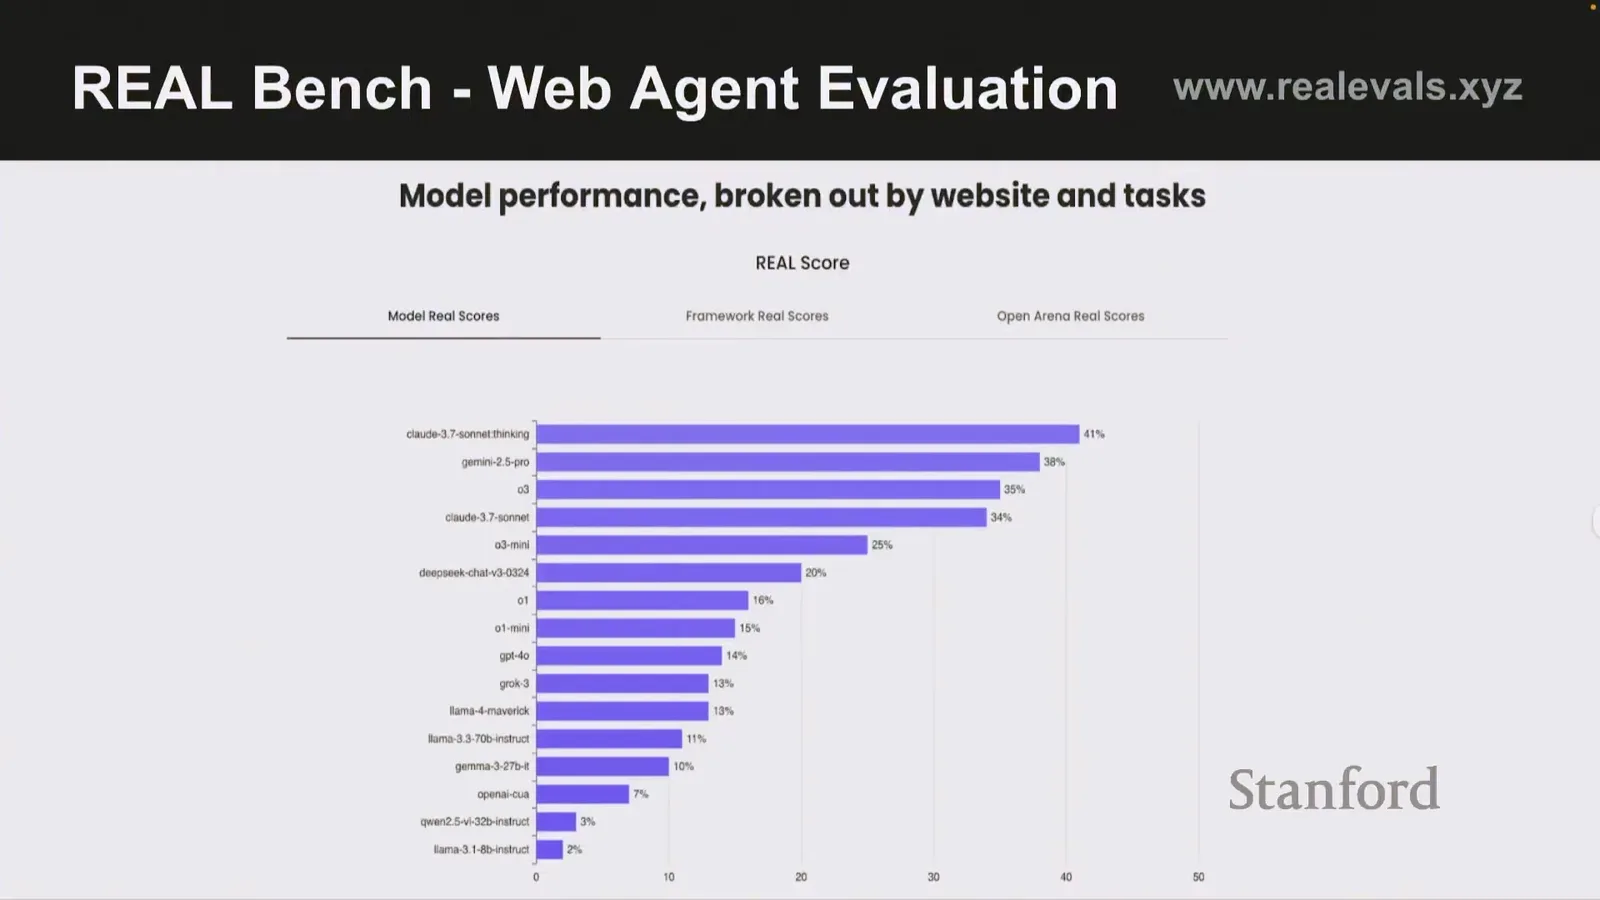
圆环页展示一个模型的总体 REAL score;雷达图和横向条形图则揭示站点差异。读图时第一步不是问“谁第一”,而是问任务采样怎样构成、每个站点有多少题、失败是否集中在某类交互,以及总体分数是否被简单任务主导。
这三张图形成由粗到细的诊断链。总分适合回答“系统是否整体进步”,站点雷达图适合回答“进步发生在哪里”,任务条形图则适合定位“哪种页面、工具或动作仍失败”。如果一个模型在购物站点表现很好、在日历和航班站点持续失败,平均值可能看起来尚可,但产品团队应优先检查日期解析、身份状态、长表单与跨站切换,而不是盲目继续扩大模型。
来源:Stanford CS25 V5 official recording, 00:15:22
来源:Stanford CS25 V5 official recording, 00:16:16
来源:Stanford CS25 V5 official recording, 00:17:22
从产品角度看,站点与任务拆分还决定修复顺序。若多个模型都在同一网站失败,问题可能来自环境设计、工具接口或任务歧义;若只有一个模型在所有站点的长表单任务上失败,更可能是该模型的状态保持或动作规划不足。评测平台因此不仅给研究排行榜,也应输出可操作的失败聚类、可重放 trace 和最小反例,让工程人员可以复现而不是凭视频猜测。
设网站集合为 \(\mathcal{W}\),网站 \(w\) 的任务集合为 \(\mathcal{T}_w\),单任务成功指示为 \(s_{w,t}\in\{0,1\}\)。宏平均为
\(S_{\text{macro}}\) 让每个站点等权;微平均则让任务多的站点权重更大。报告必须说明使用哪种聚合,否则同一结果可能被讲成不同故事。
进一步把任务按风险、长度和交互类型分 slice \(g\in\mathcal{G}\):
\(S_{\min}\) 是最差 slice。高风险产品不能只优化均值;如果支付、权限或删除任务是最差组,总体 90% 也不能说明可部署。
读图:三张结果页分别回答什么
总分页回答“这个系统整体处于什么水平”;雷达图回答“能力是否均衡”;任务条形图回答“失败集中在哪里”。三者应共同使用:总分用于排序,分布用于诊断,最差 slice 用于上线门槛。
Benchmark saturation 不等于开放世界可靠
确定性副本可支持稳定回归测试,但真实网站还包含界面更新、延迟、权限、个性化、反自动化和不可逆后果。benchmark 应作为训练与调试平台,而不是把 leaderboard 分数直接换算成真实事故率。
课堂提示
00:14:03–00:17:58,讲者强调 REAL 使用现代、复杂且确定性的站点副本,并逐站点比较模型。老师强调:网页 agent 的核心不是“会点按钮”,而是能否在不同站点、任务和错误状态中稳定完成。
本章小结
REAL Bench 解决的是 agent 评测的可复现性和分布可见性。一个可信报告至少包含总体分、站点宏平均、任务 slice、最差组和轨迹级失败原因。下一章进入 AgentQ:如何让 agent 不只被测,还能从失败轨迹中学习。
AgentQ:从“失败截图”到可学习的恢复轨迹
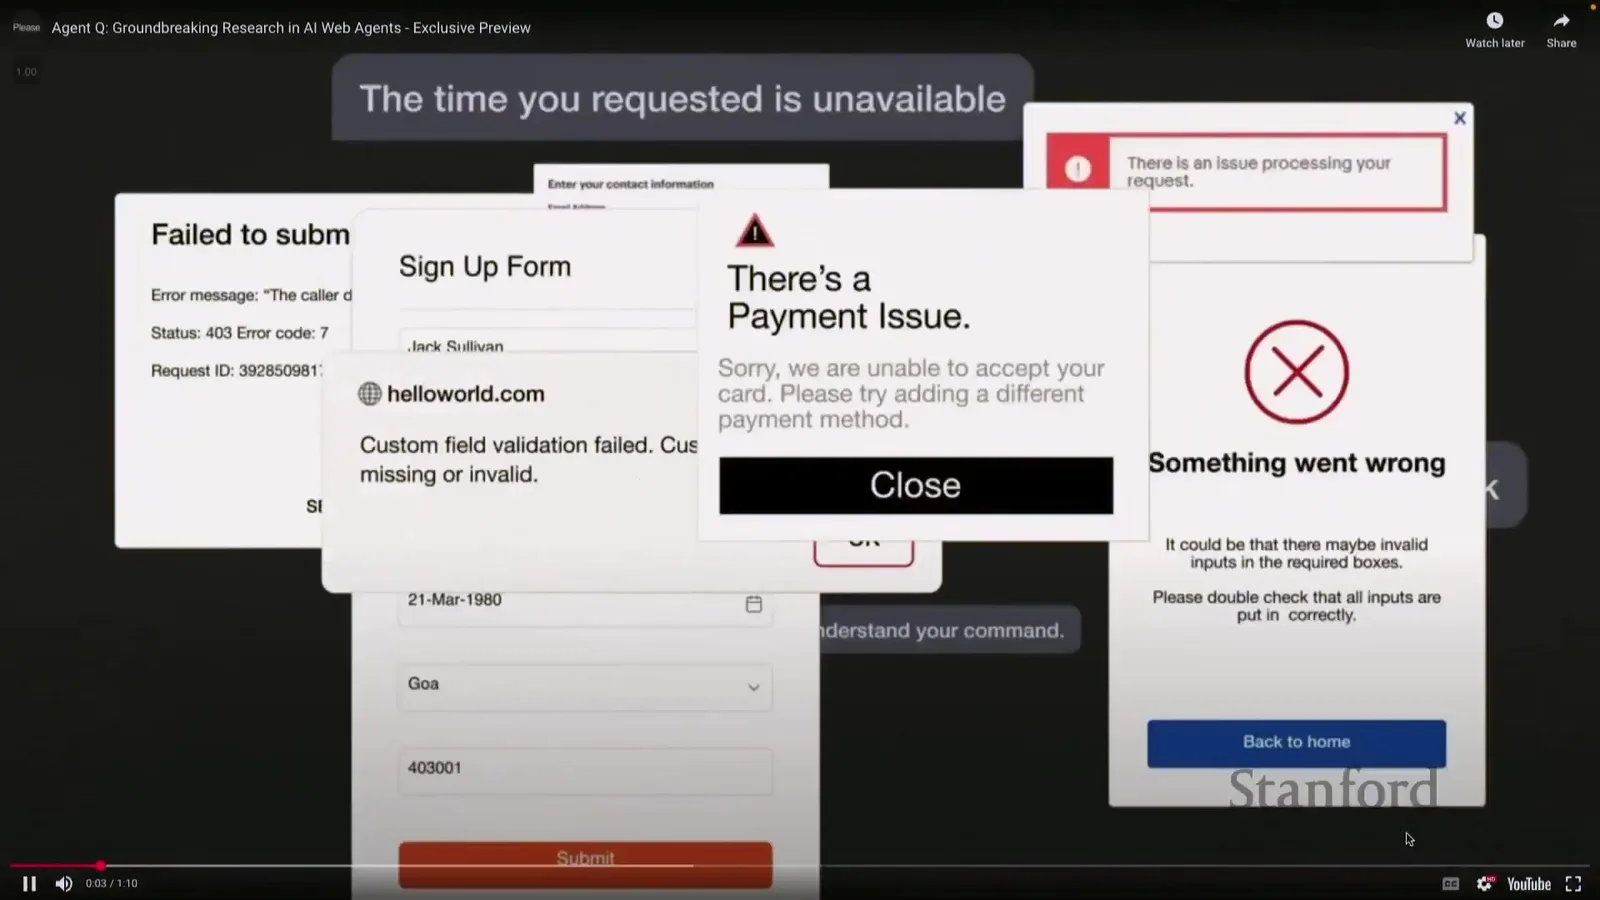
这一段是整堂课最容易被 demo 节奏掩盖的部分。讲者先展示常见失败,再展示预约、日历和航班任务。真正的教学点不是“agent 能订餐厅”,而是系统怎样搜索替代路径、修正错误、同时维护多个决策,并把成功与失败轨迹回收为训练数据。
先承认 Agent 并不完美
失败 collage 包含表单校验、支付、不可用时间和错误页面。它提醒读者:真实环境的反馈往往不是一个干净的 reward,而是错误消息、空结果、半完成页面和隐藏约束。AgentQ 的研究动机正是让 agent 在这些状态下继续搜索,而不是把一次失败当作任务结束。
这一小节承接上一章的评测分布:REAL 告诉我们失败集中在哪些站点,AgentQ 则追问失败之后怎样行动。阅读开场图时应先把错误按“可恢复”和“不可恢复”分开:表单字段缺失通常可修改,支付被拒可能需要用户介入,错误身份或错误收件人则可能必须终止。只有先定义恢复边界,搜索算法才不会把“坚持尝试”误当成正确行为。
来源:Stanford CS25 V5 official recording, 00:17:59
来源:Stanford CS25 V5 official recording, 00:18:08
失败必须被结构化
一次失败至少分为 observation error、planning error、tool/action error、environment constraint 与 policy/safety rejection。只记录“任务失败”无法决定应该改 prompt、工具、数据、奖励还是权限。
餐厅任务:搜索、回退与完成
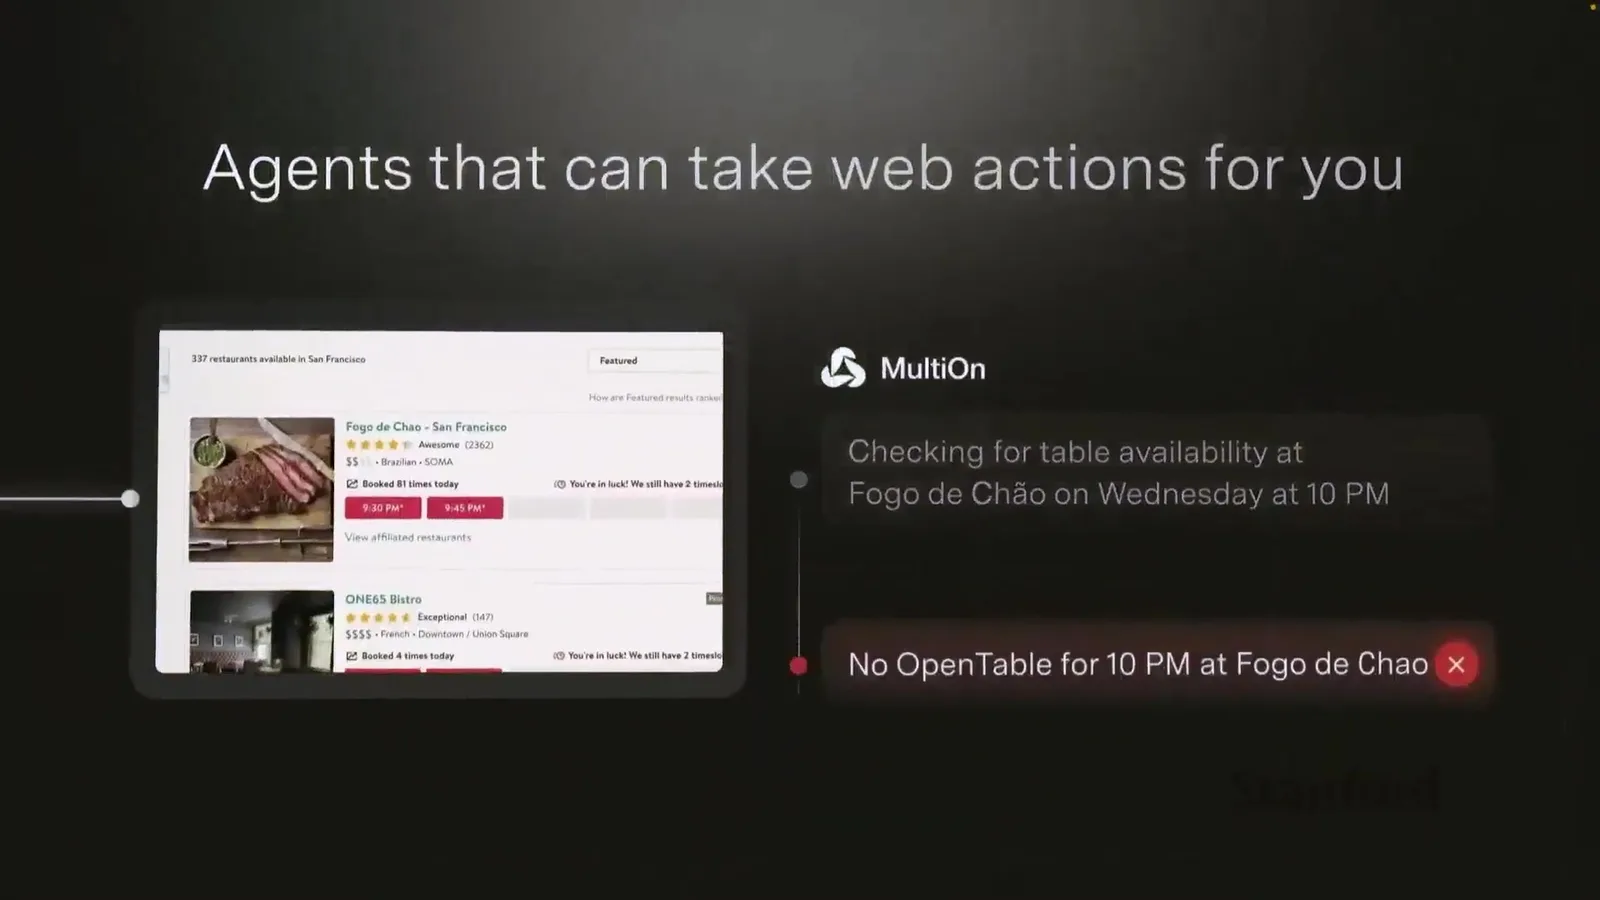
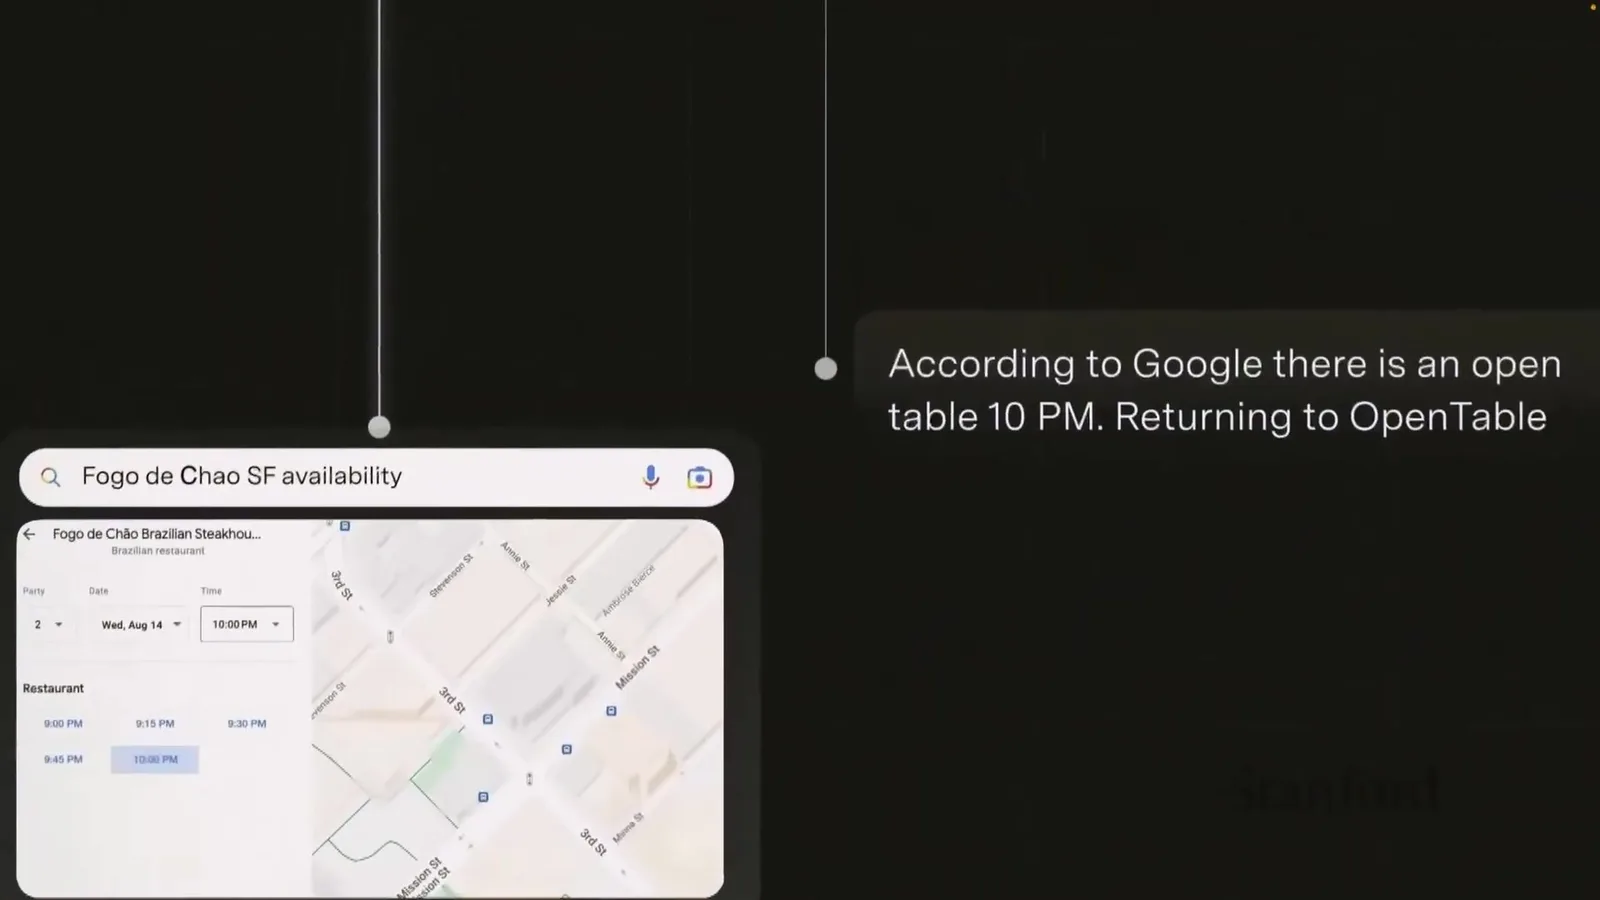
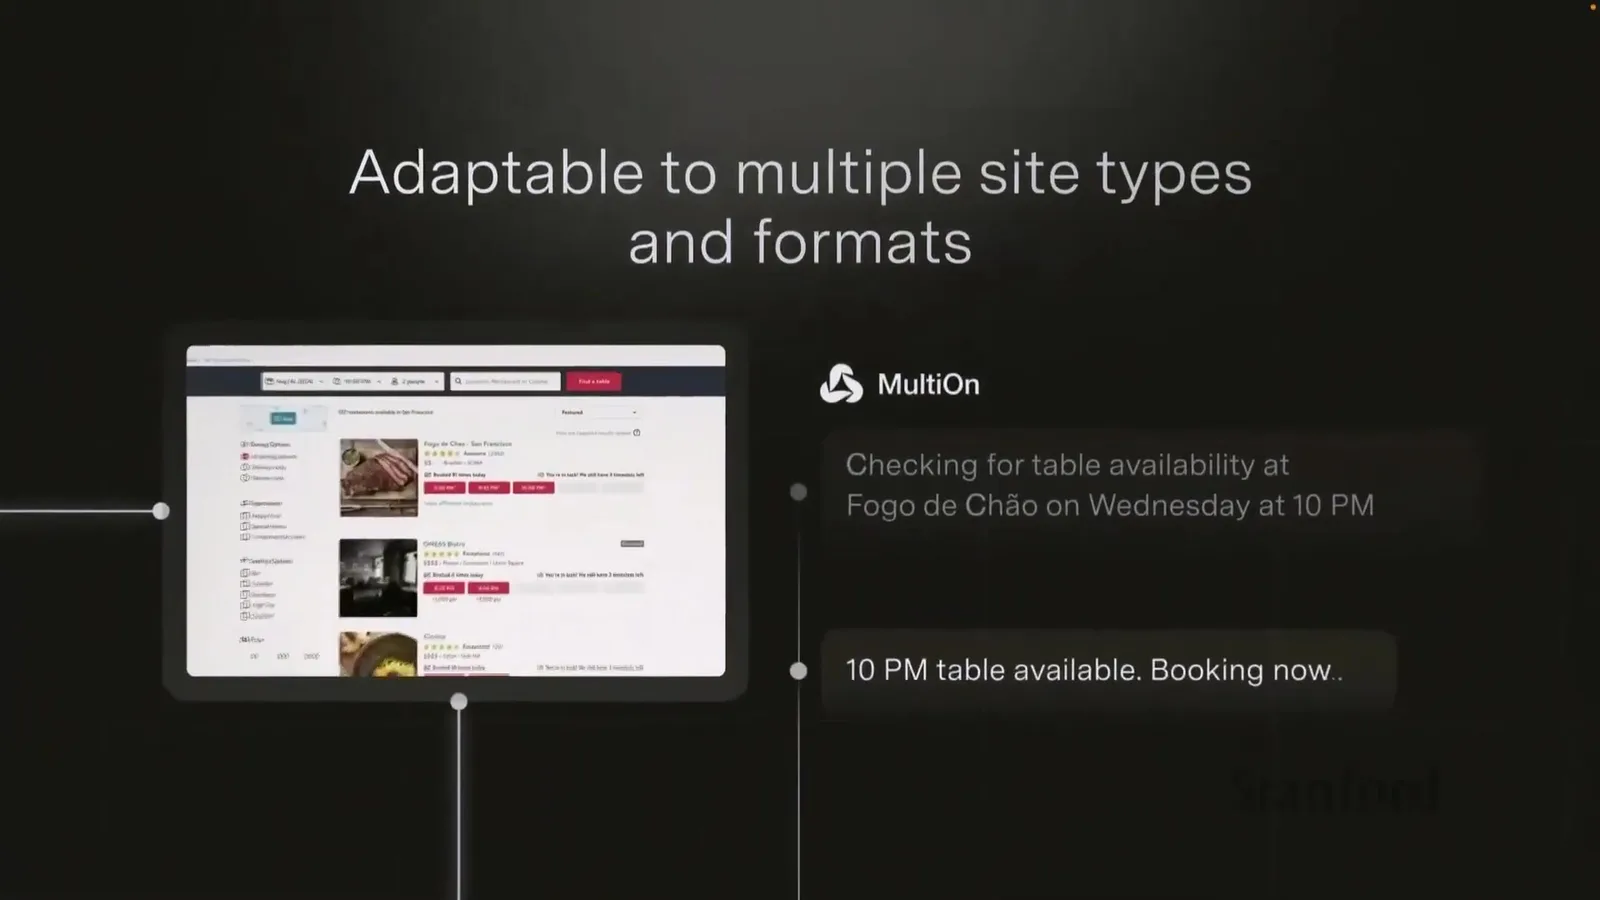
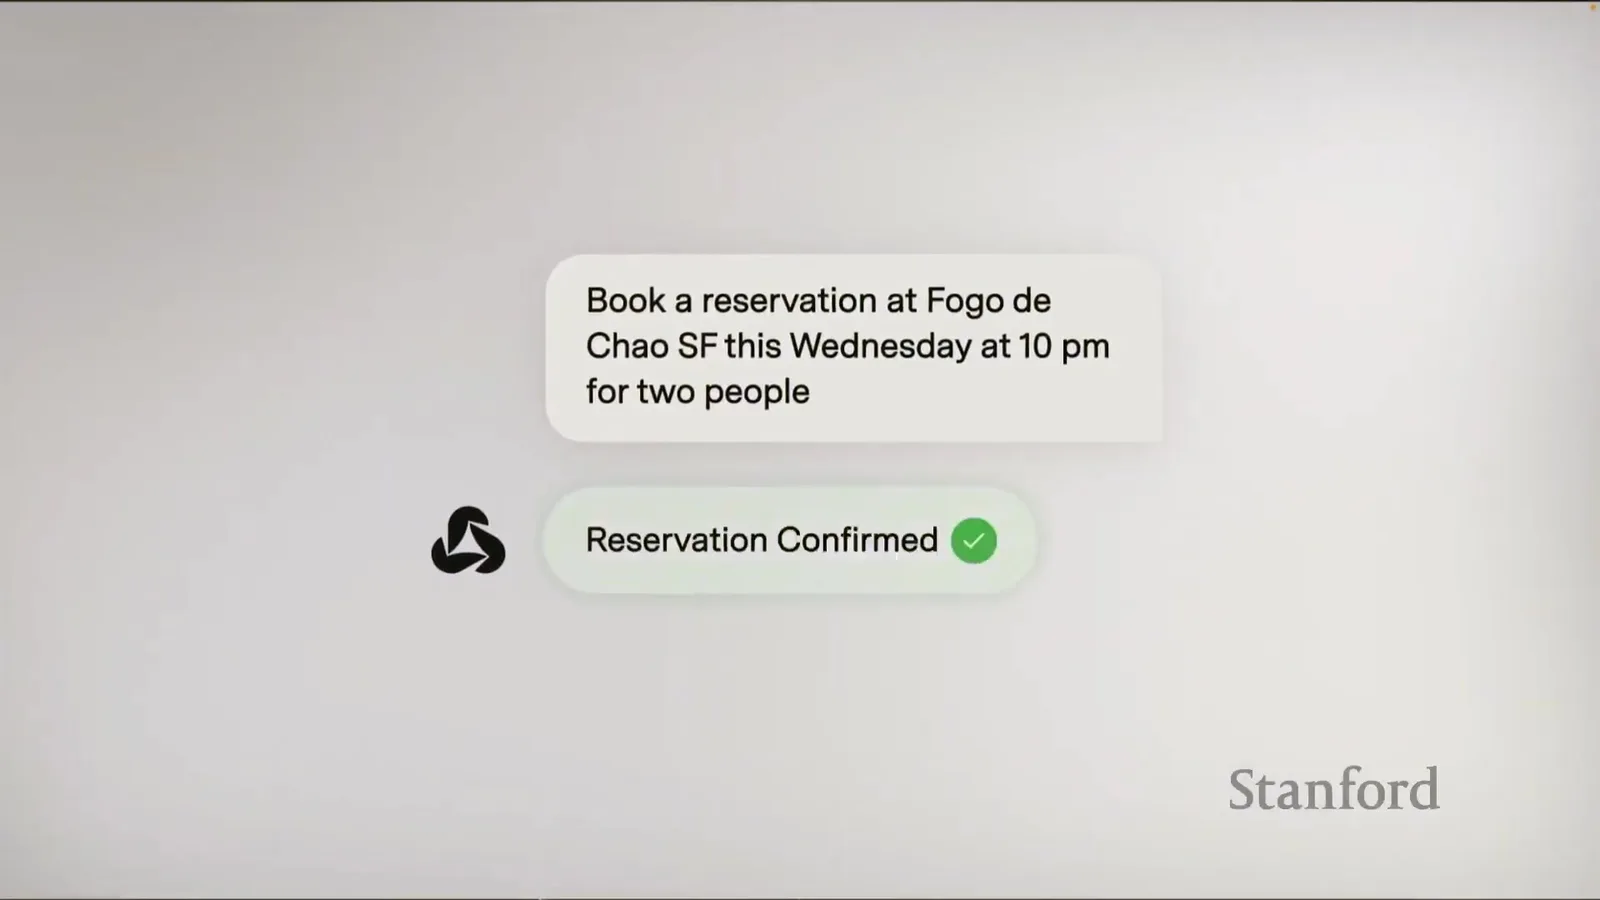
预约 demo 的关键转折是目标时间不可用。Agent 先查 OpenTable,再用 Google 获取补充信息,最后返回原站点完成预约。下面四个状态不是为了展示动画,而是说明一个恢复过程:动作失败、跨工具搜索、重新定位、完成并确认。
来源:Stanford CS25 V5 official recording, 00:18:11
来源:Stanford CS25 V5 official recording, 00:18:15
来源:Stanford CS25 V5 official recording, 00:18:19
来源:Stanford CS25 V5 official recording, 00:18:22
来源:Stanford CS25 V5 official recording, 00:18:25
读图:恢复链应该怎样验收
先确认 agent 是否识别“10 PM 不可用”这一环境约束;再看跨站搜索是否引入了同名餐厅、日期和时区混淆;最后检查确认页是否与原始意图一致。只有最终页面、结构化订单和用户目标三者对齐,任务才算成功。
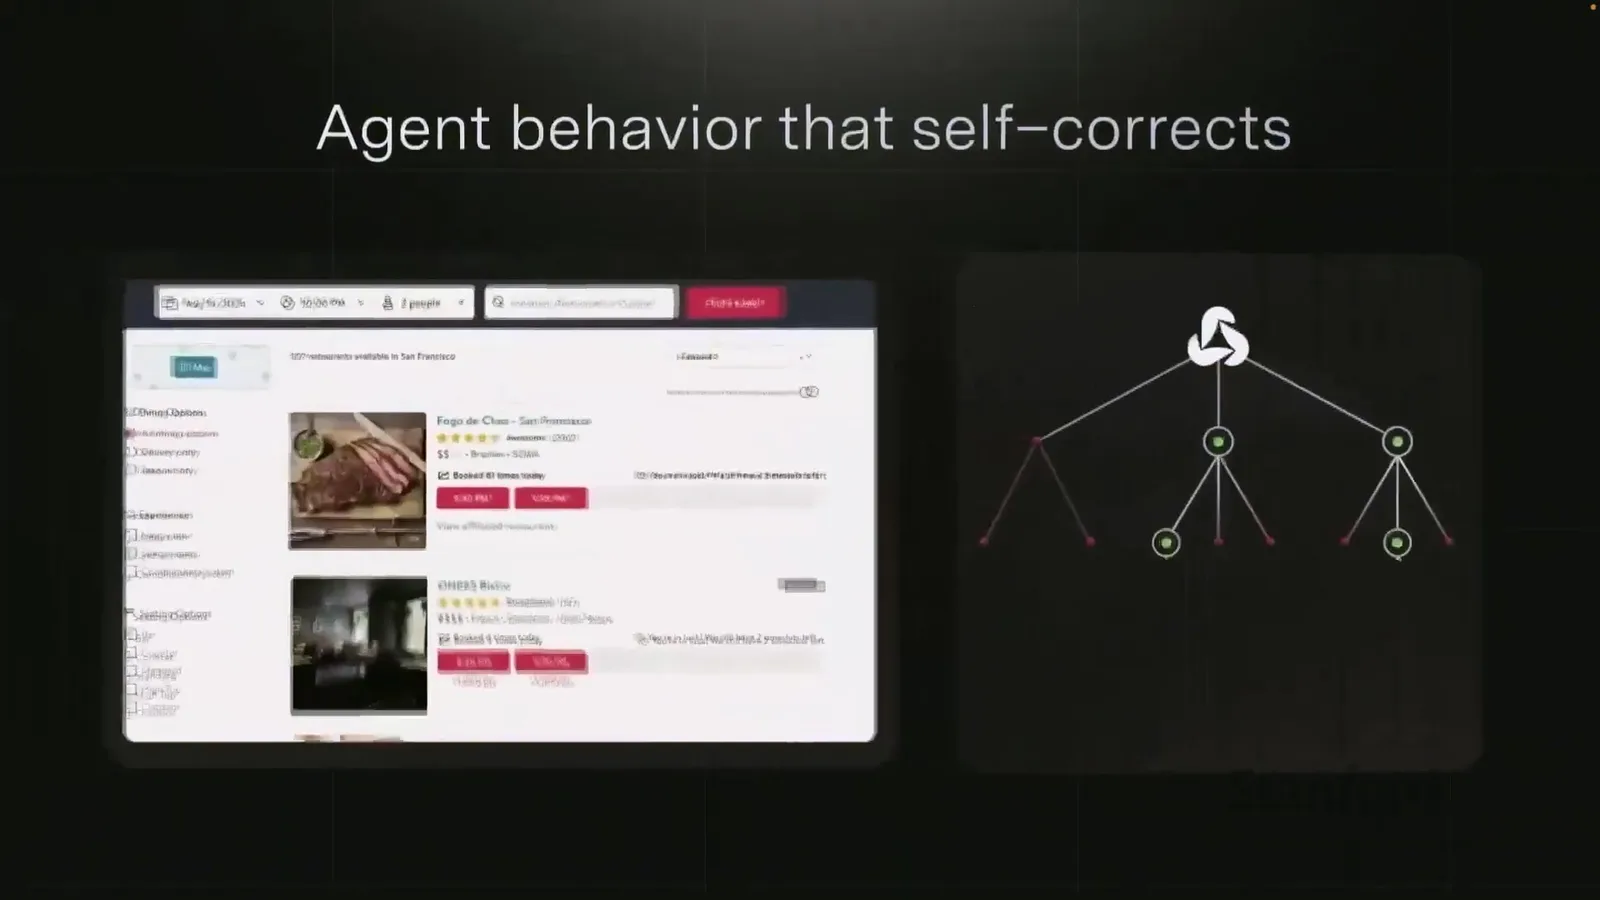
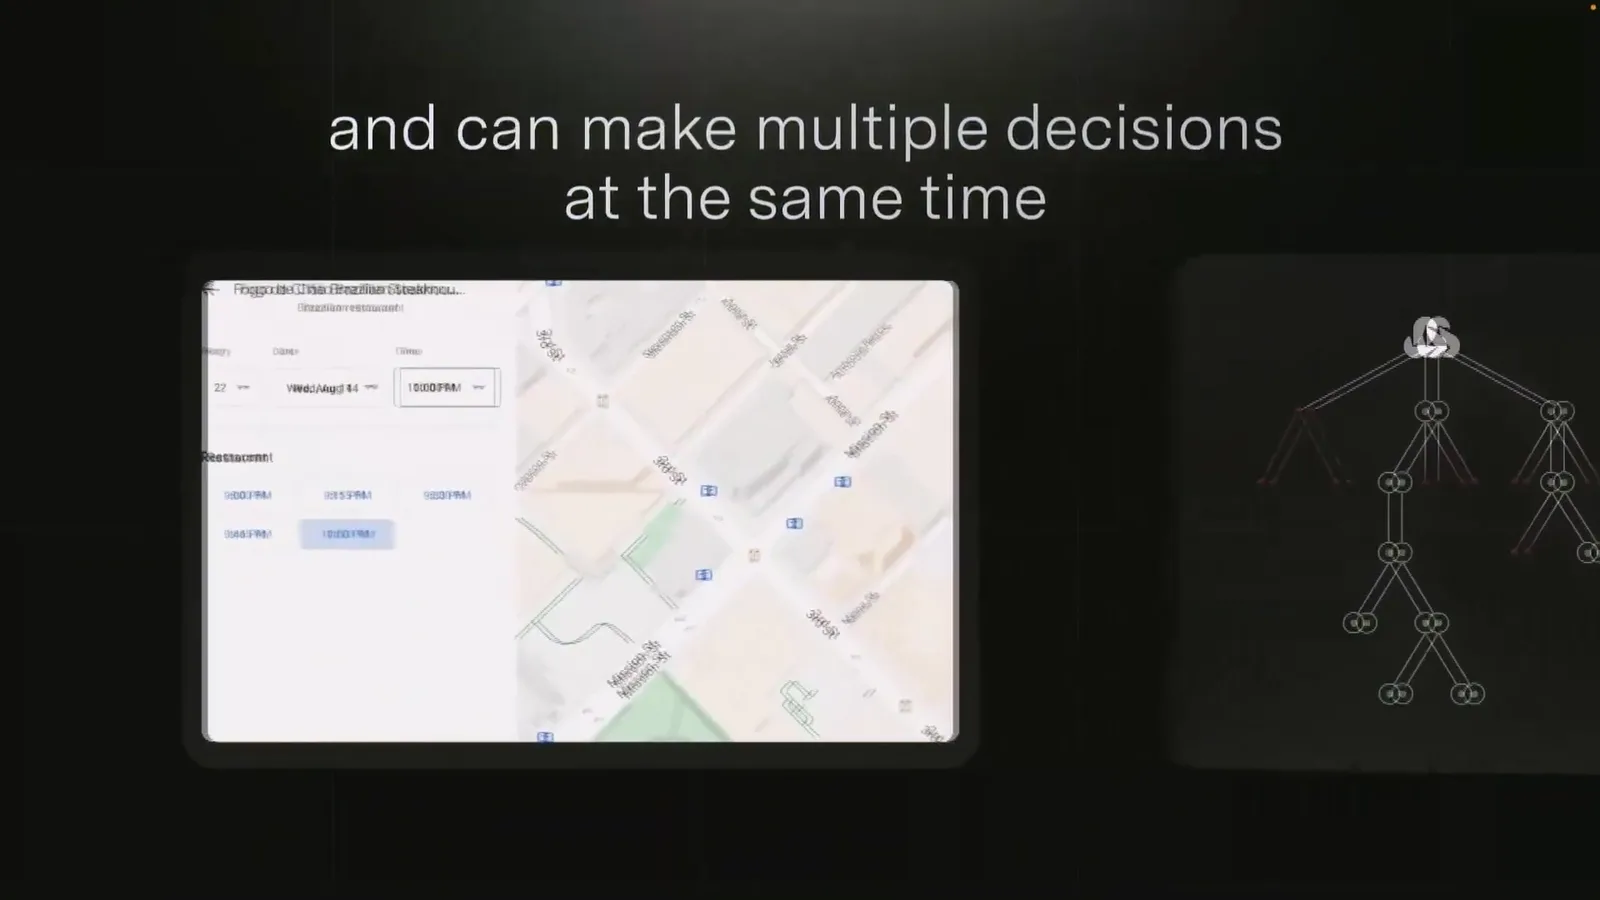
Self-correction 与并行决策
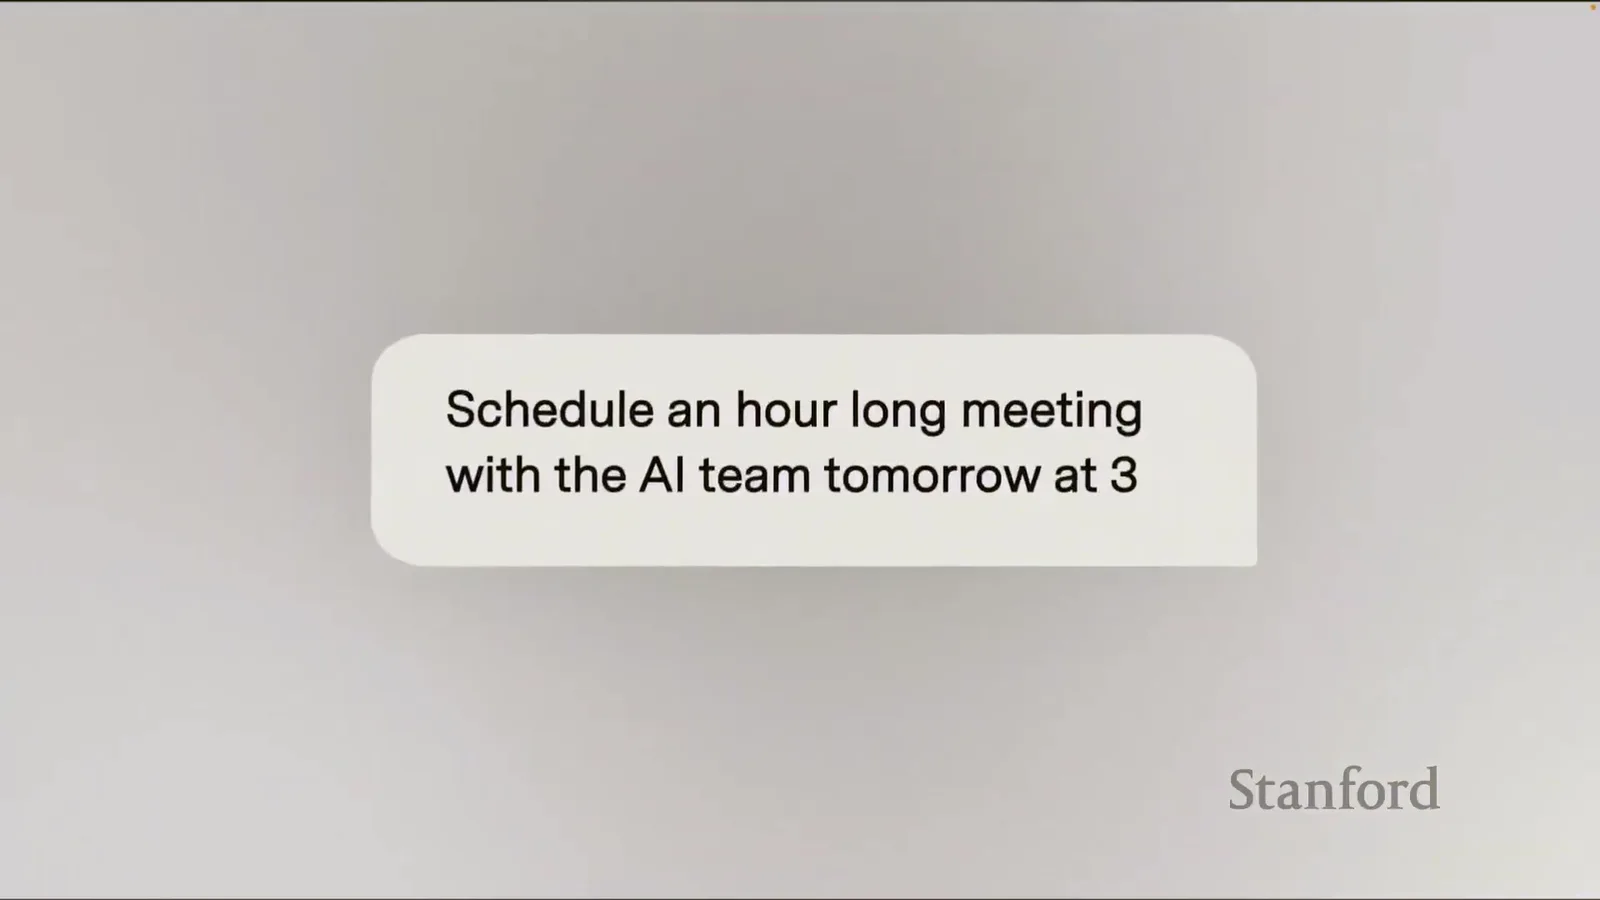
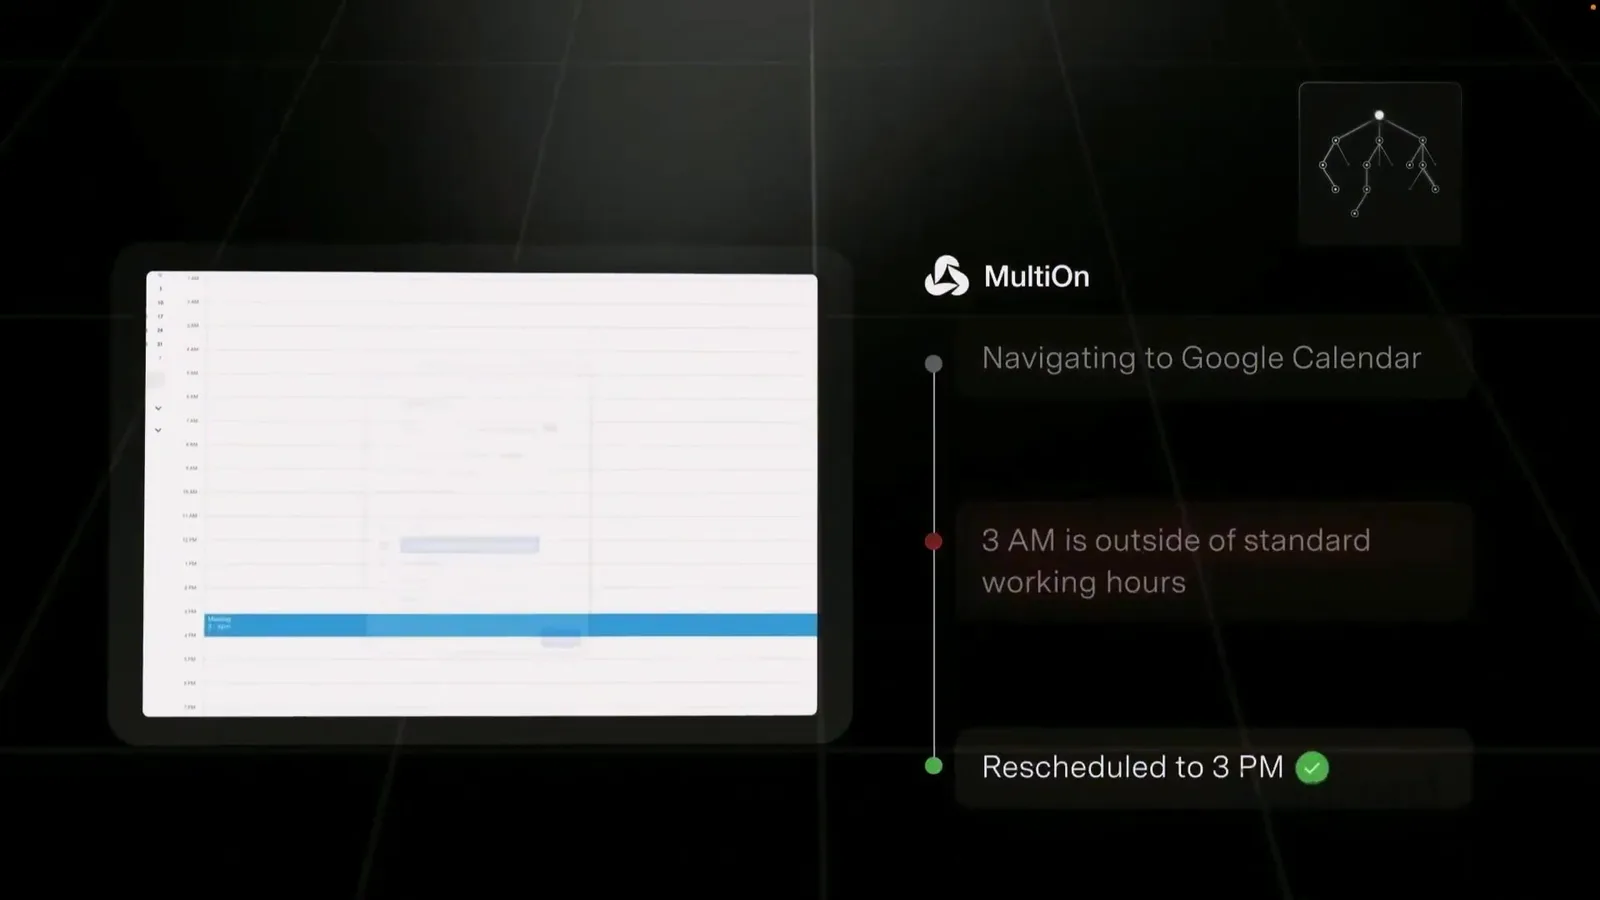
下一组图把能力拆成三个层级:能够自我修正、能够同时处理多个决策、能够识别不合理日历时间并重排。这里的“self-correction”不应理解成模型说一句“我错了”,而是状态机检测后置条件失败、生成替代动作并保留原任务约束。
来源:Stanford CS25 V5 official recording, 00:18:28
来源:Stanford CS25 V5 official recording, 00:18:31
来源:Stanford CS25 V5 official recording, 00:18:32
来源:Stanford CS25 V5 official recording, 00:18:39
“自动修正”最容易越权
如果用户写“3”,系统把它从 3 AM 改成 3 PM 是合理推断还是擅自改变?低风险日历任务可以通过确认解决;高风险任务必须把修正方案呈现给用户,而不是静默执行。
Skills routing 与动作上下文
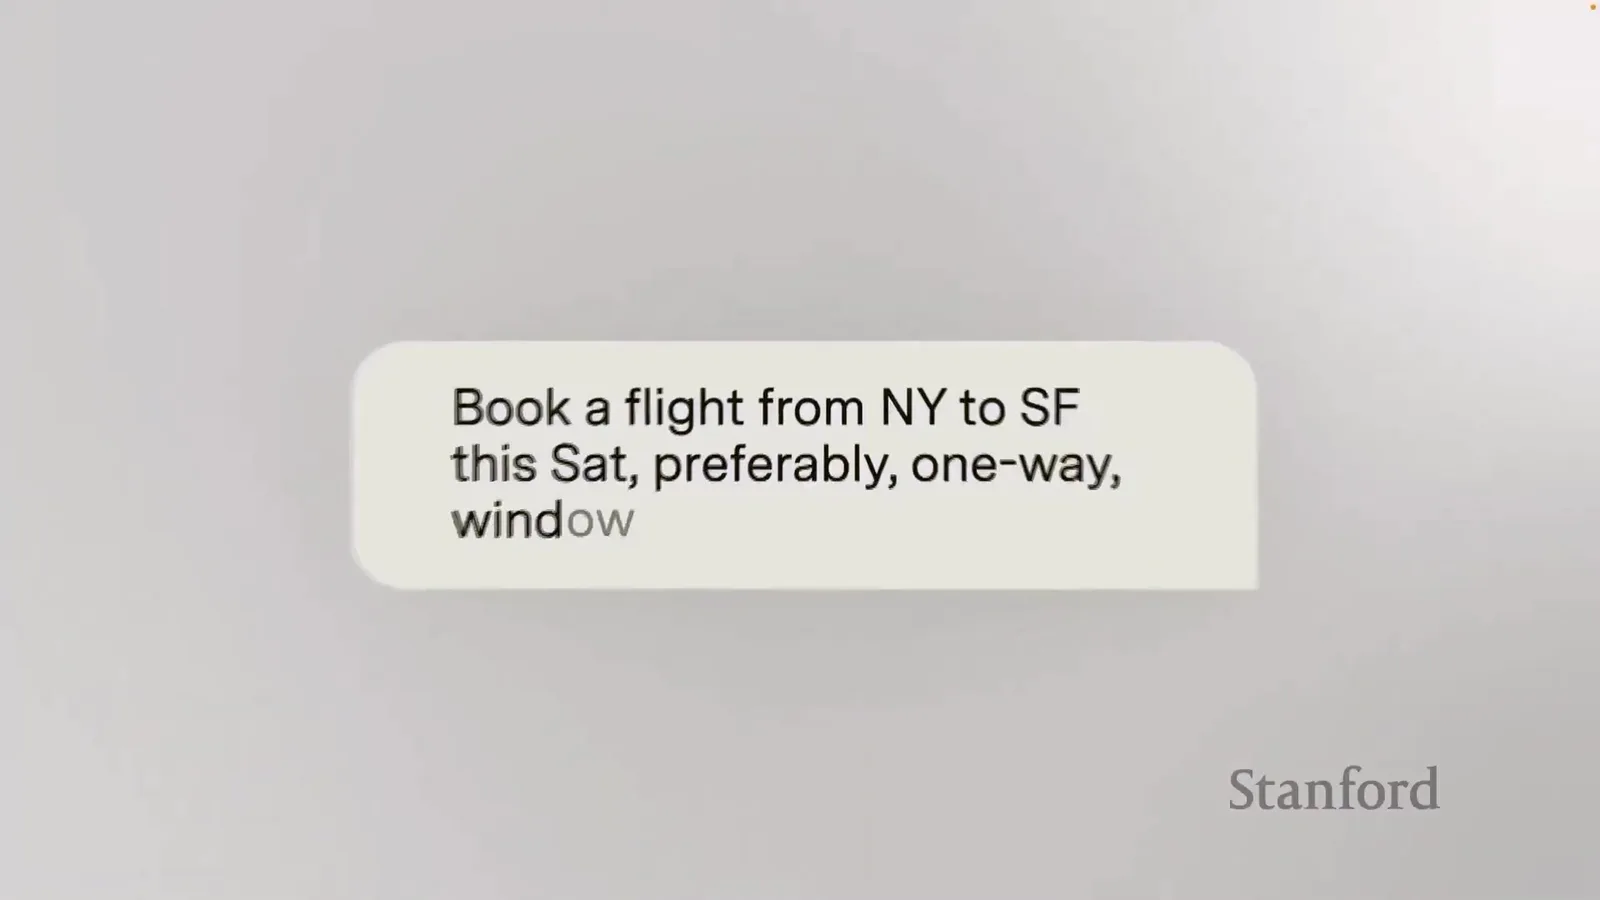
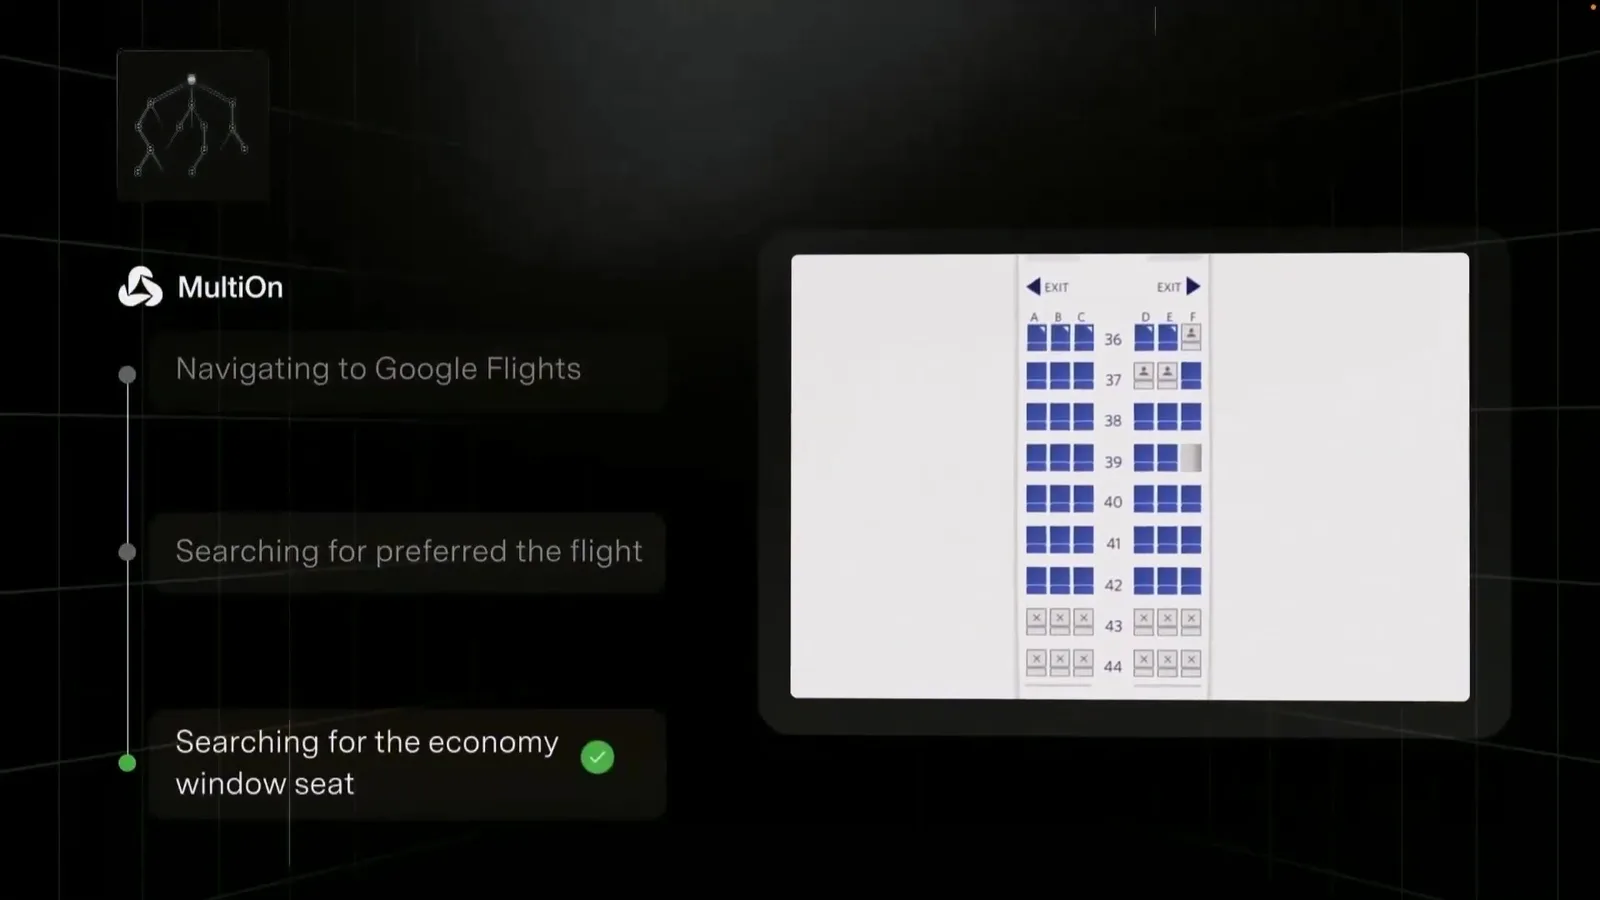
“right skills at the right time” 强调工具路由。航班任务需要解析城市、日期、单程、价格偏好和座位偏好,再选择搜索工具。路由器不只是分类器;它还要决定哪些约束进入工具参数,哪些保留给后续筛选,以及失败后是否换工具。
前面的餐厅与日历案例主要展示恢复,本节转向能力选择。一个 agent 即使拥有十个工具,也不代表应该把所有工具同时暴露给模型;工具越多,名称相似、参数冲突和权限误用越容易发生。读图时应关注约束在链路中的保真度:用户说“preferably one-way”和“window seat”,搜索阶段可以暂时放宽价格,但不能在最终推荐时忘掉座位偏好,更不能因为某个工具返回快就静默改变出发日期。
来源:Stanford CS25 V5 official recording, 00:18:41
来源:Stanford CS25 V5 official recording, 00:18:42
来源:Stanford CS25 V5 official recording, 00:18:48
来源:Stanford CS25 V5 official recording, 00:18:54
这一串 demo 也暴露了最终成功率之外的隐性成本。跨站搜索增加页面加载与 token,日历纠错需要解释时间歧义,航班筛选同时维护多个软约束;一个看似简单的“替我完成”请求,实际上包含状态跟踪、工具切换、偏好保持和结果验证。若系统只优化成功标签,可能学会更激进地点击或忽略软约束。训练数据必须把用户意图的完整保真度作为结果的一部分。
课堂提示
00:17:58–00:20:47,讲者明确说 AgentQ 不是完美系统;这些 demo 用来展示失败、回退、自修正、多决策和 skill routing。讲义提醒:课堂结果属于特定任务与模型设置,不应推广为任意网站的可靠性。
一个最小可复现 Agent trace
trace = {
  "goal": user_goal,
  "initial_state": state_snapshot,
  "steps": [
    {"observation": obs, "thought_summary": plan,
     "action": action, "tool_result": result,
     "postcondition": check, "cost": cost}
  ],
  "outcome": outcome,
  "user_confirmations": confirmations,
  "rollback": rollback_record
}
本章小结
AgentQ 的 demo 不是“自动订票”宣传,而是一组失败恢复案例:环境给出约束,agent 搜索替代路径,状态机验证后置条件,路由器选择 skill,并把轨迹保存为学习材料。下一章把这些现象写成 MCTS、process feedback 和 preference learning。
搜索、Critique 与 Preference Learning:AgentQ 的训练机制
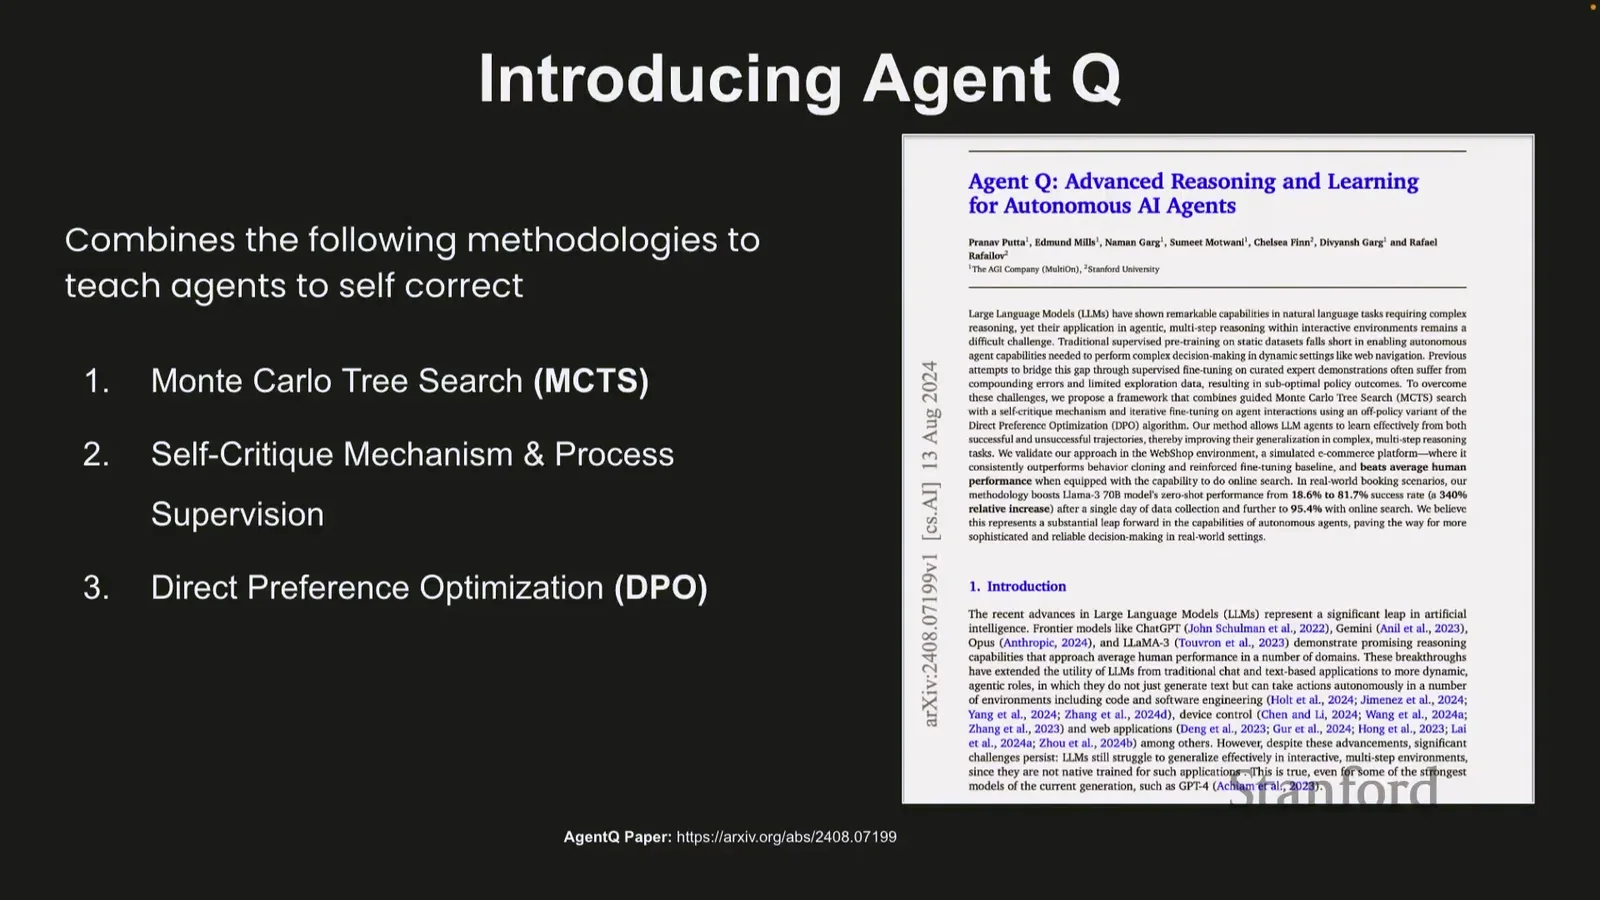
AgentQ 论文把三种机制组合起来:Monte Carlo Tree Search(MCTS)扩大探索,LLM critique 为中间节点提供过程反馈,Direct Preference Optimization(DPO)风格目标从较好与较差轨迹中学习。三者分别解决“没有探索”“不知道哪里错”“成功经验不能沉淀”的问题。
来源:Stanford CS25 V5 official recording, 00:20:47
MCTS:为长任务保留替代分支
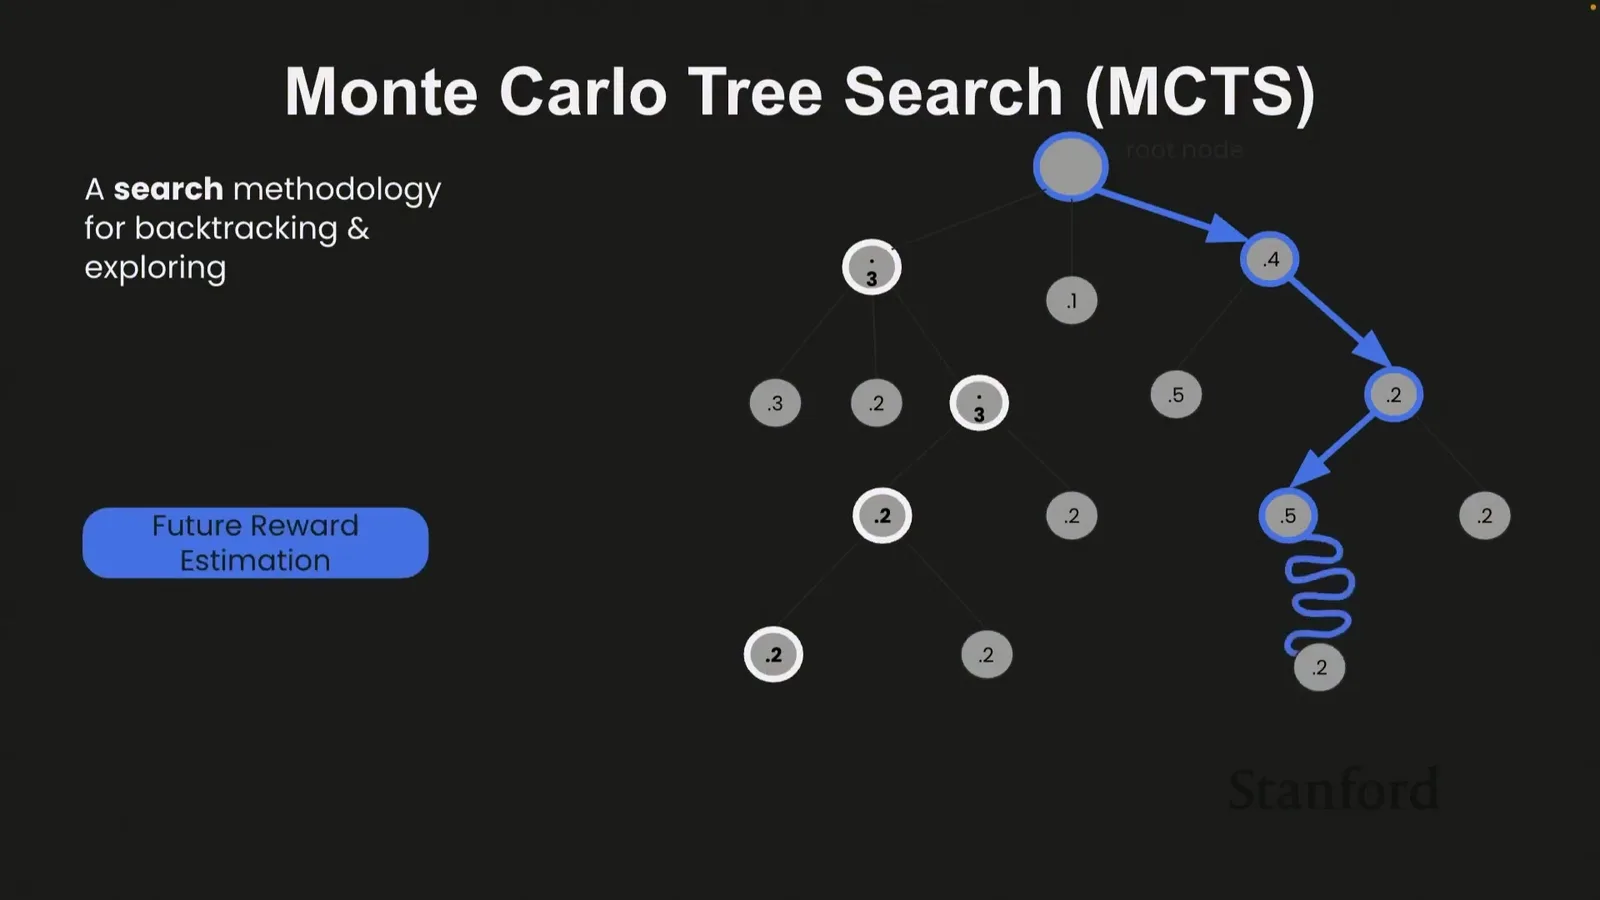
树搜索把一个状态下的多个候选动作保留下来,而不是贪心地承诺第一条路径。典型 UCT 选择公式为
这一步承接 demo 中的自我修正:如果 policy 每次只输出一个动作,失败后只能从相同上下文重新采样,很容易重复原路径;树结构则显式保存“已经试过什么、哪些分支价值较高、哪里仍值得探索”。阅读 MCTS 图时先找 root、候选分支和叶节点,再区分 value estimate 与真实执行结果。对网页 agent 而言,搜索树应优先在模拟器或可回滚副本中展开,真实网站只执行经过筛选的少量动作。
\(Q(s,a)\) 是当前价值估计,\(N(s)\) 是父状态访问次数,\(N(s,a)\) 是动作访问次数,\(c\) 控制 exploration。第一项偏向已知好路径,第二项鼓励尝试访问较少的动作。
来源:Stanford CS25 V5 official recording, 00:21:40
网页环境中的 MCTS 不是免费回溯
许多动作不可逆:提交订单、发送消息和支付不能像棋盘一样撤销。安全实现应在模拟环境搜索,或只对可回滚状态展开;真实环境中的探索必须有权限、预算与沙箱限制。
Process feedback:奖励中间决策,而非只看结局
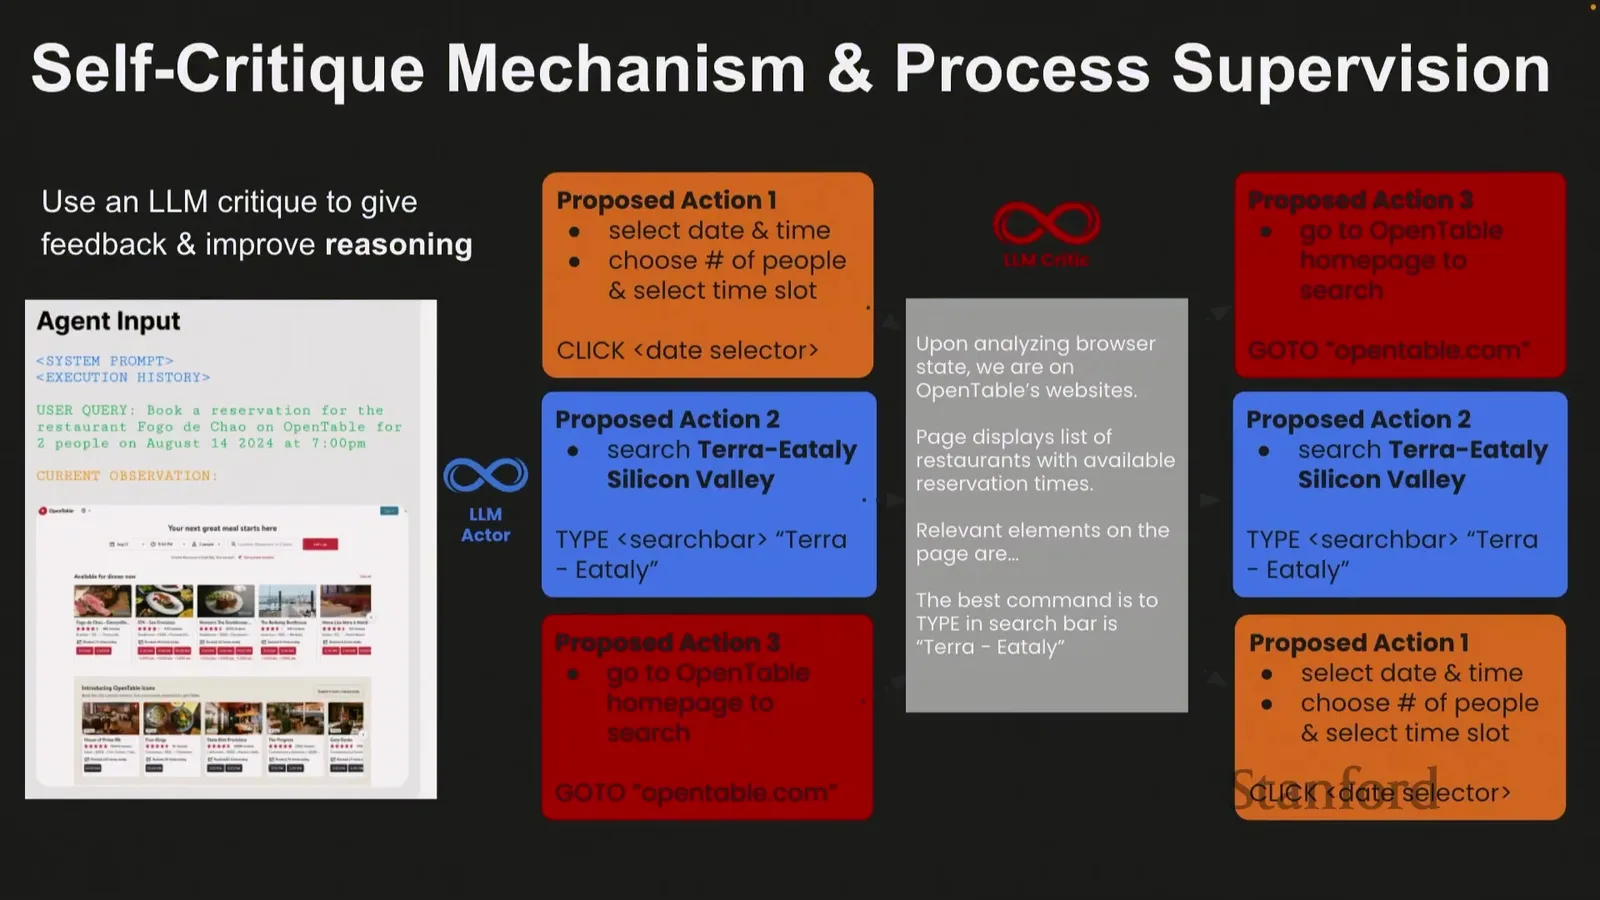
仅用最终成功 \(r_{\text{outcome}}\) 会产生稀疏信号,也可能把“偶然成功但过程危险”的轨迹标为正例。过程奖励可写成
\(\tau\) 是完整轨迹,\(r_{\text{process},t}\) 评价第 \(t\) 步是否合理,\(C(\tau)\) 记录工具成本、违规或不可逆风险。\(\alpha,\beta_t,\lambda\) 决定结果、过程与成本的权衡。
来源:Stanford CS25 V5 official recording, 00:22:58
Critique 的三个层次
Syntax critique 检查动作格式;state critique 检查动作是否符合当前页面和约束;goal critique 检查动作是否仍服务原始用户目标。只做语言流畅度 critique,无法发现日期、身份、权限和预算错误。
从成功与失败分支构造偏好
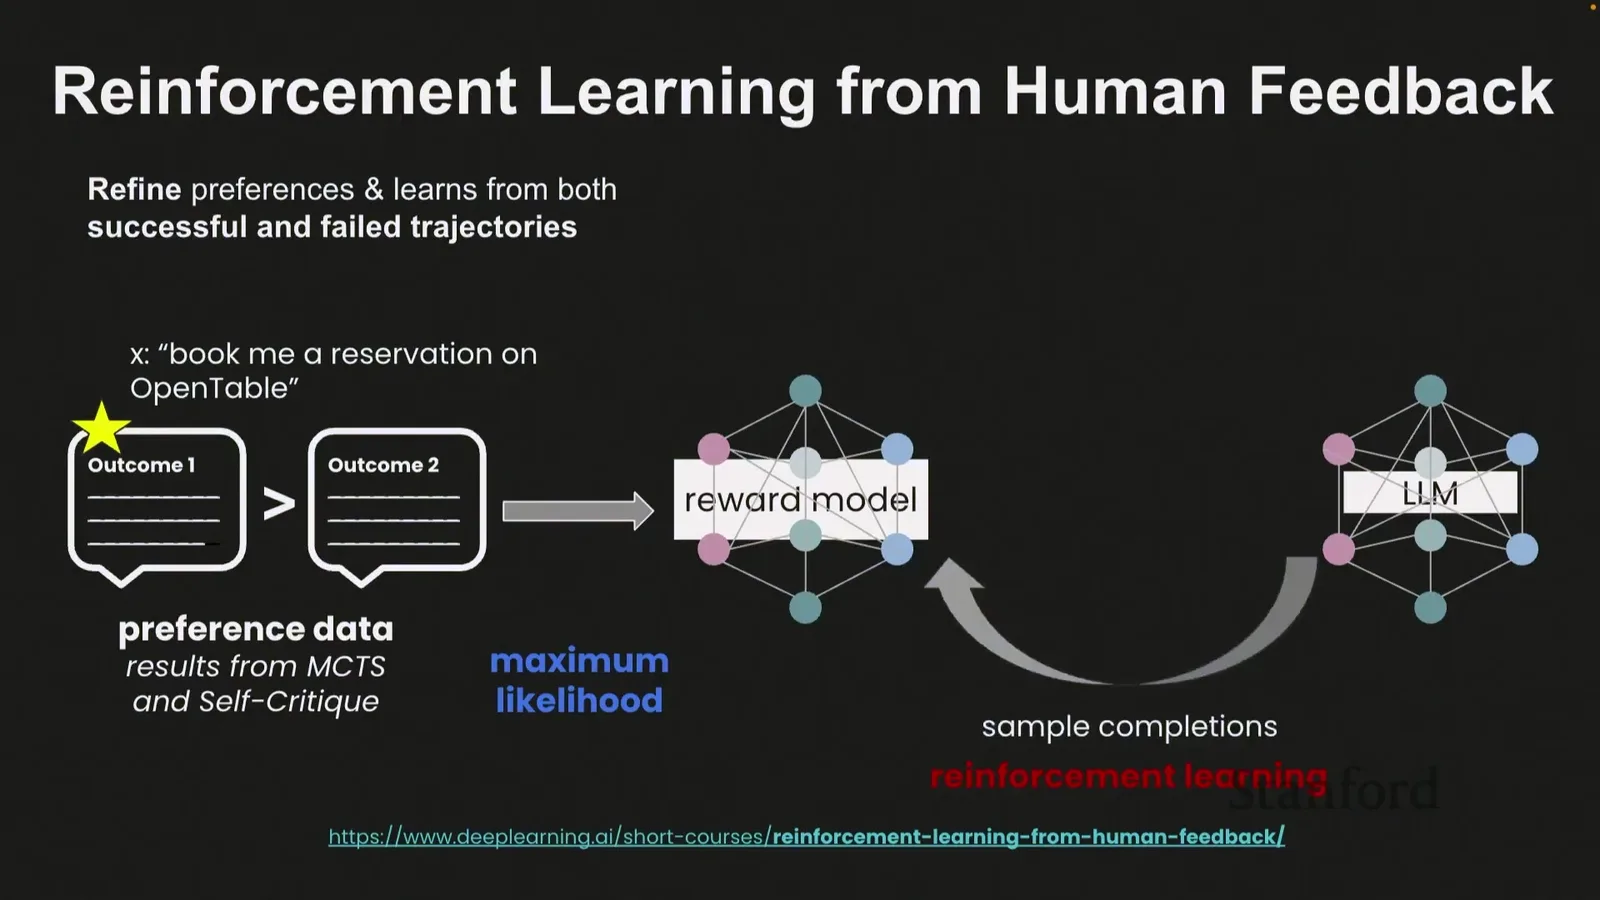
AgentQ 将搜索产生的分支排序为 preferred 与 rejected,再用离线偏好目标更新 policy。DPO 的常见形式为
\(x\) 是状态与任务上下文,\(y^+\) 是较好动作或轨迹,\(y^-\) 是较差分支,\(\pi_{\text{ref}}\) 是参考策略,\(\beta\) 控制偏好强度。对 agents 而言,偏好不能只来自最终网页截图;应结合过程 critique、工具错误和安全约束。
来源:Stanford CS25 V5 official recording, 00:23:23
课堂提示
00:20:47–00:23:24,讲者用 MCTS、LLM critique 和 preference learning 解释 AgentQ。老师强调:成功与失败轨迹都应进入学习,尤其要让模型学会在复杂环境中 backtrack 与 recover。
七步 OpenTable 轨迹:最终成功不隐藏中间错误
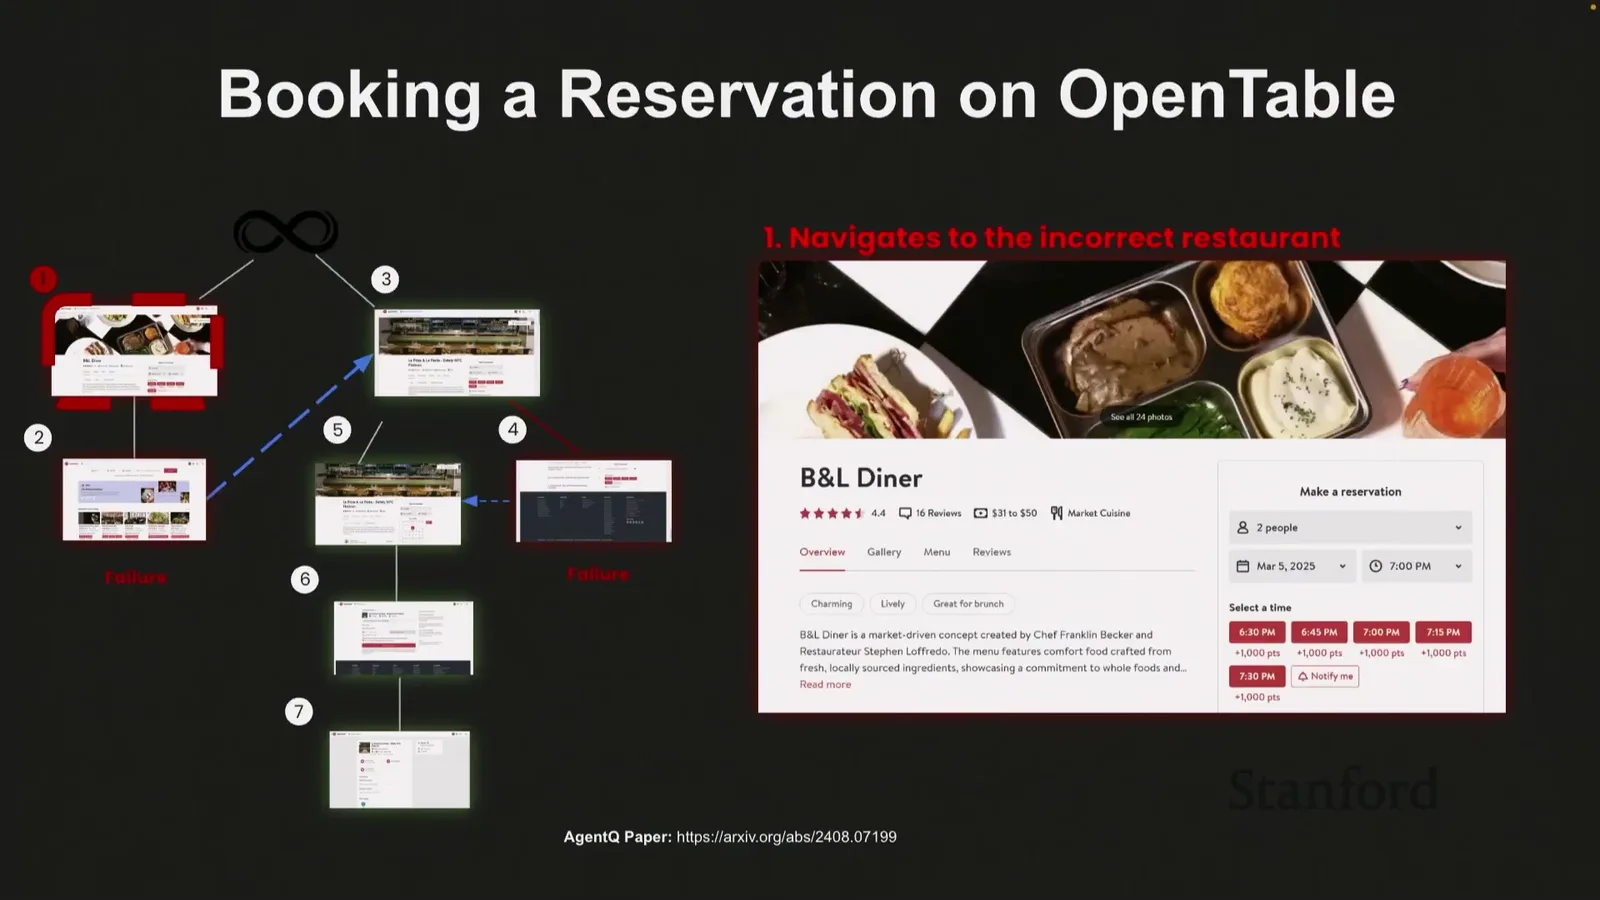
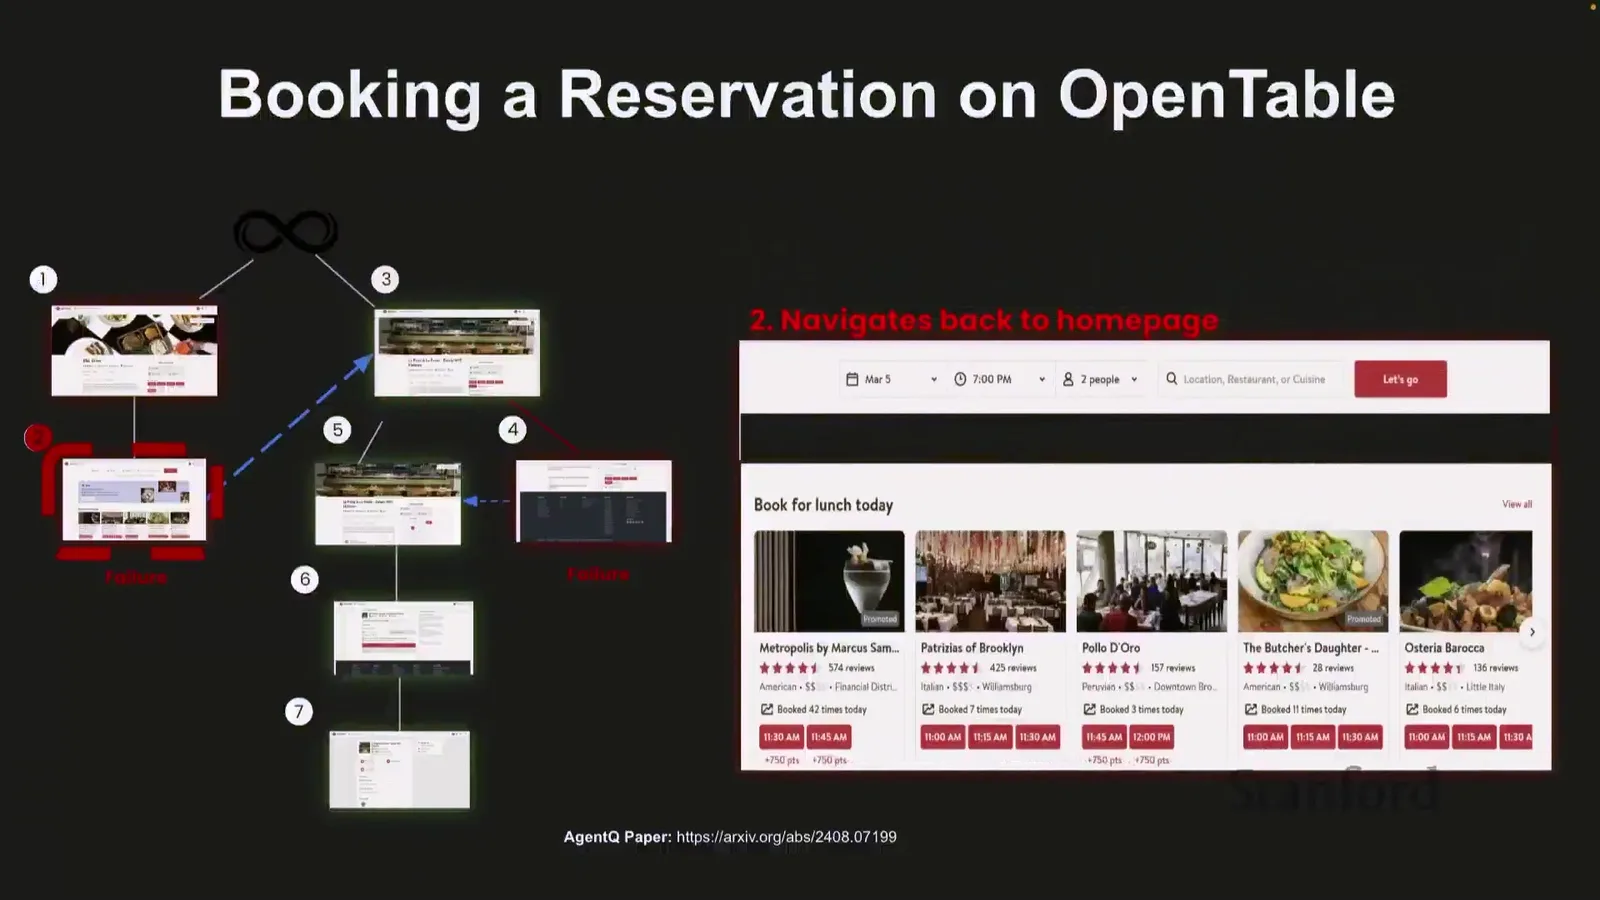
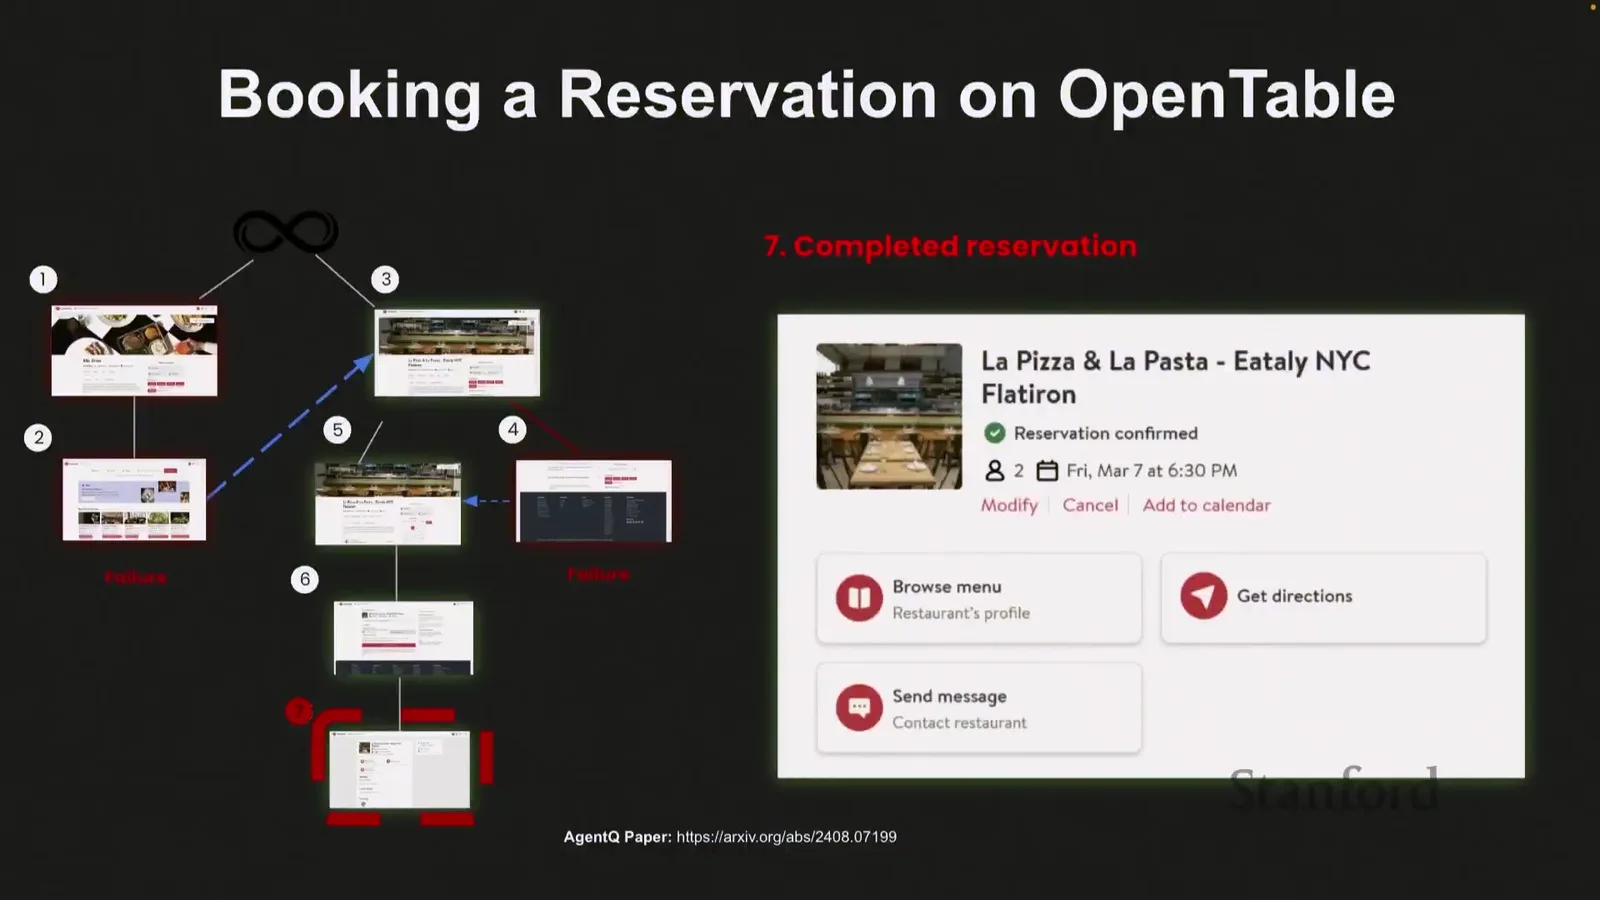
这组图应按状态转移阅读,而不是当作七张相似截图。轨迹先导航目标餐厅,进入主页,定位餐厅,再选择了错误日期;之后打开日期选择器、纠正日期并完成预约。错误发生在第四步,恢复发生在第五、六步,最终确认是第七步。
这组轨迹的教学价值在于它同时包含目标保持和局部纠错。系统没有因为日期出错就重新搜索另一家餐厅,也没有把用户请求压缩成“订到任意餐厅即可”;它保留餐厅、人数和时间范围,只修改错误字段。读每张图时应追踪三条线:当前页面状态、agent 宣称的下一动作、原始目标中仍未满足的约束。这样才能判断恢复是真修正还是偶然绕到一个可完成结果。
来源:Stanford CS25 V5 official recording, 00:24:10
来源:Stanford CS25 V5 official recording, 00:24:15
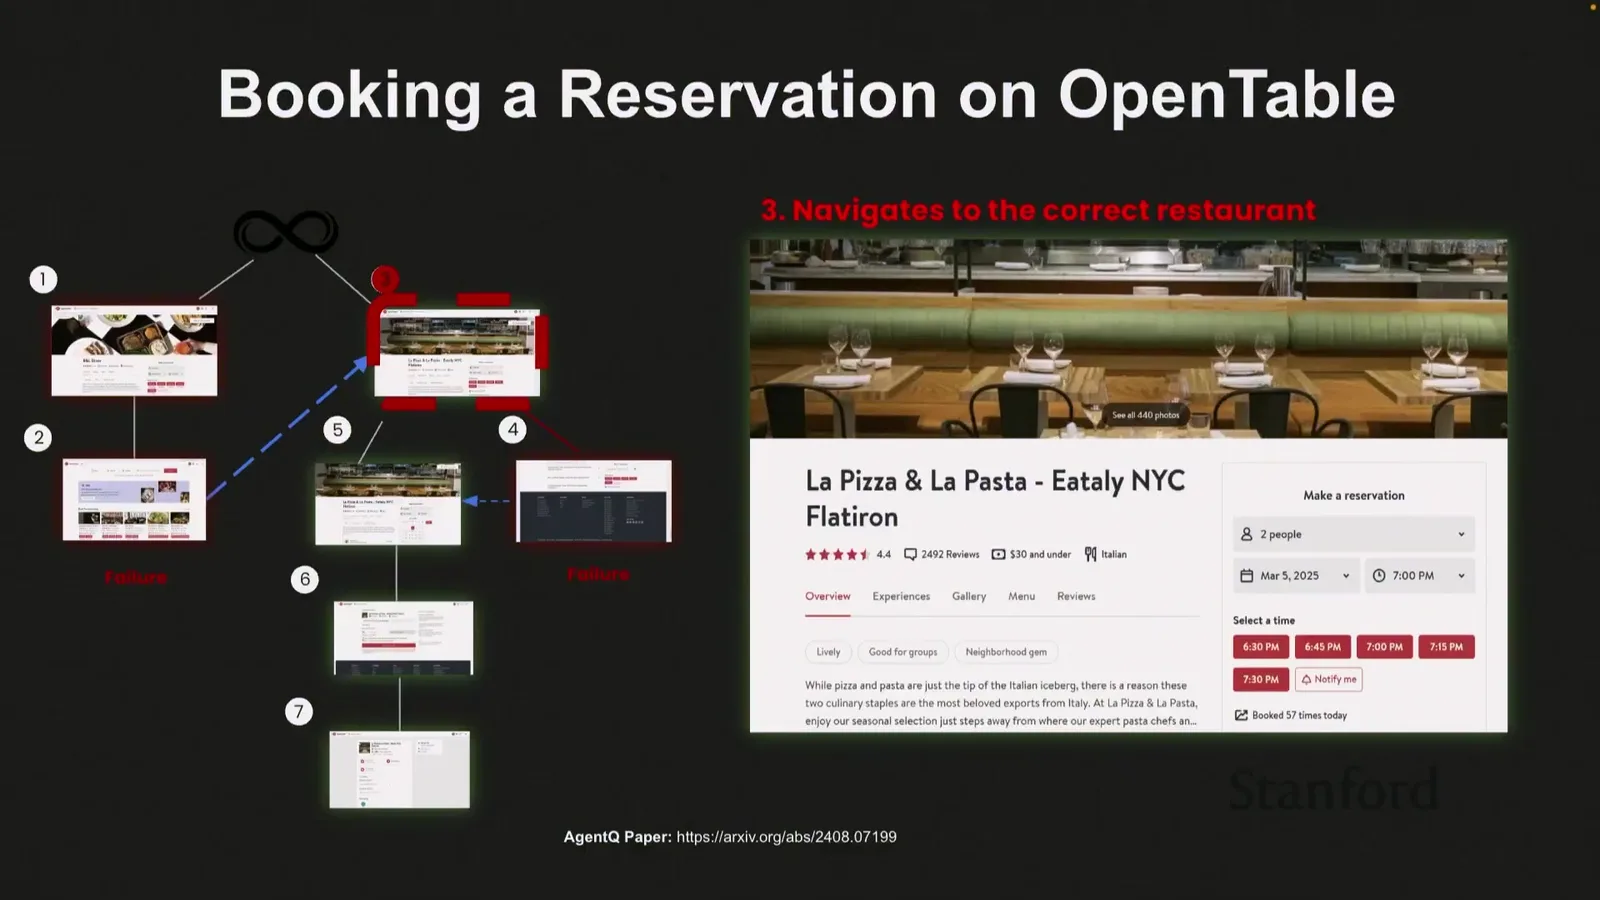
来源:Stanford CS25 V5 official recording, 00:24:42
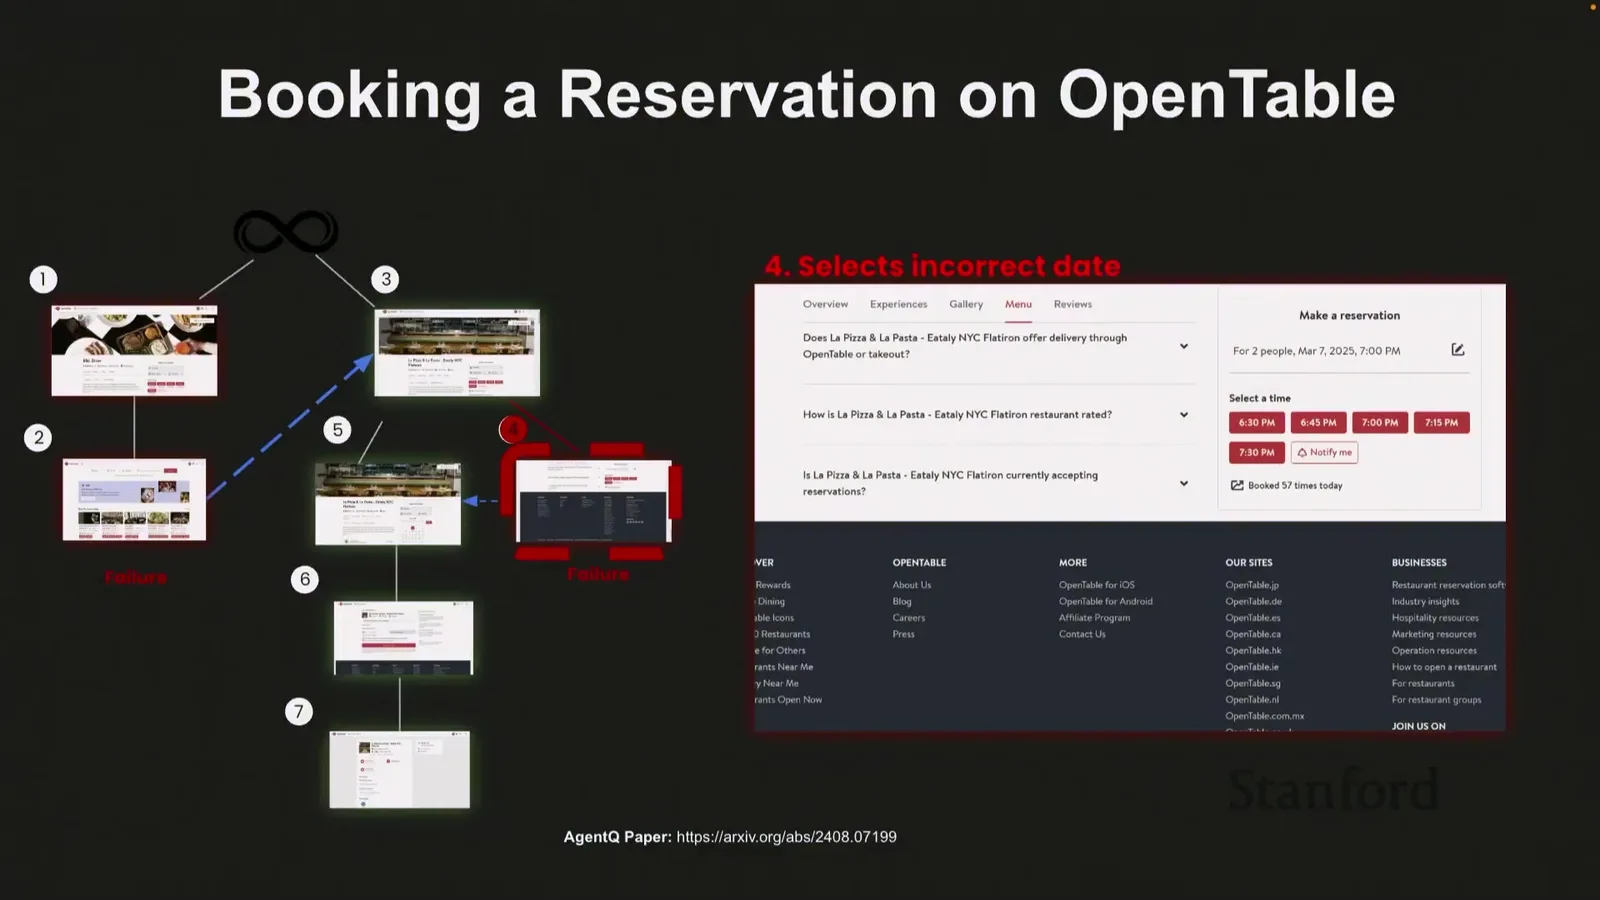
来源:Stanford CS25 V5 official recording, 00:24:49
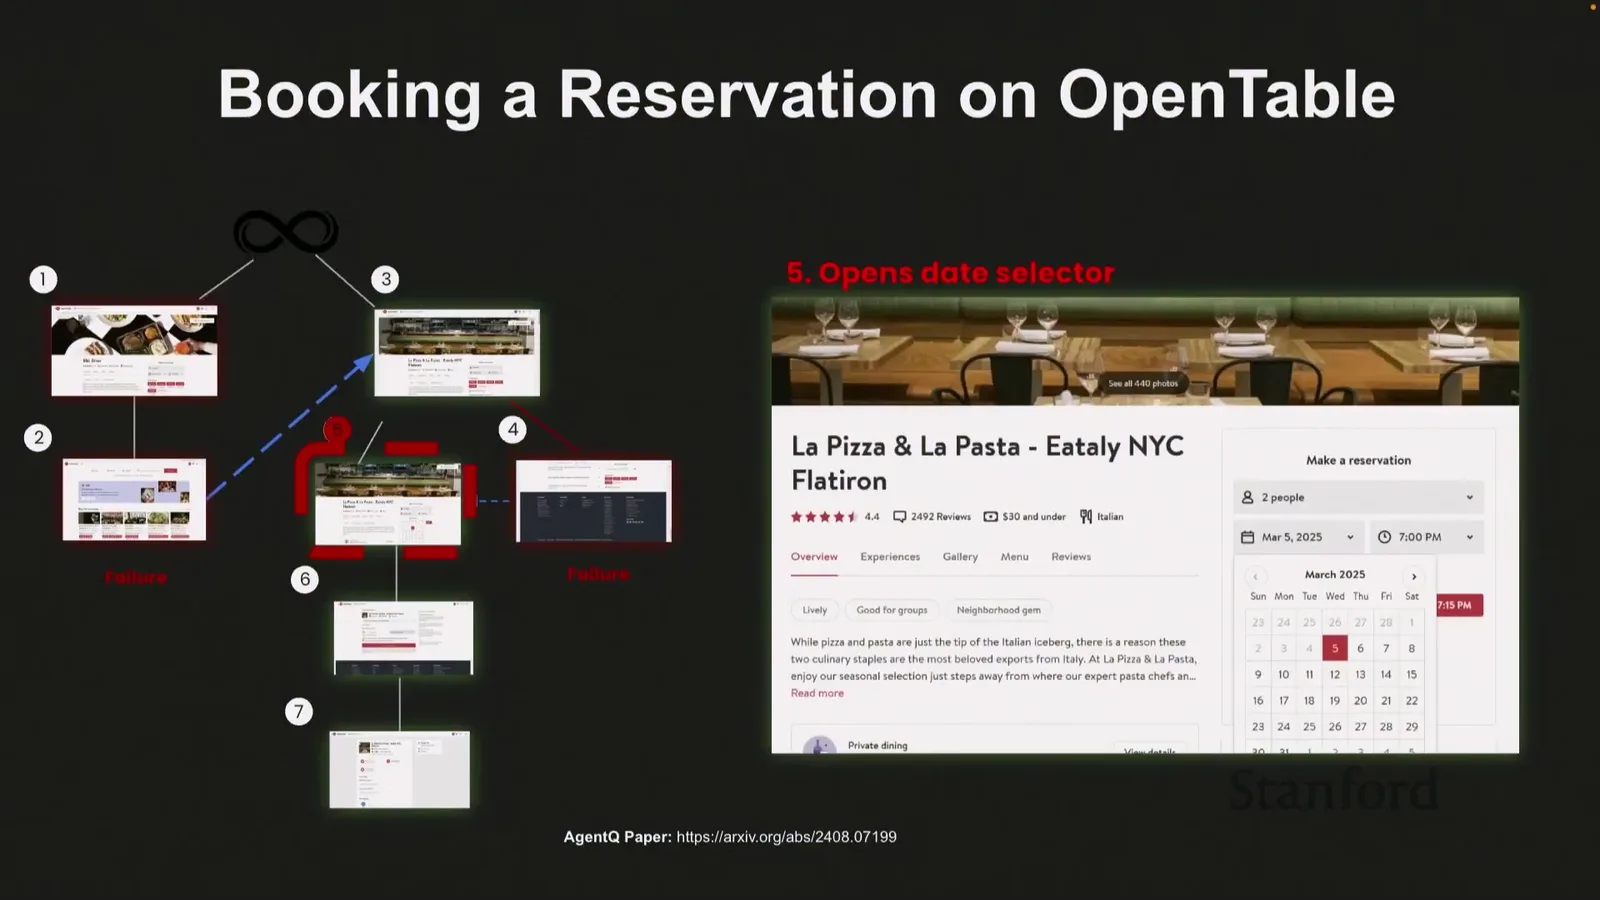
来源:Stanford CS25 V5 official recording, 00:24:52
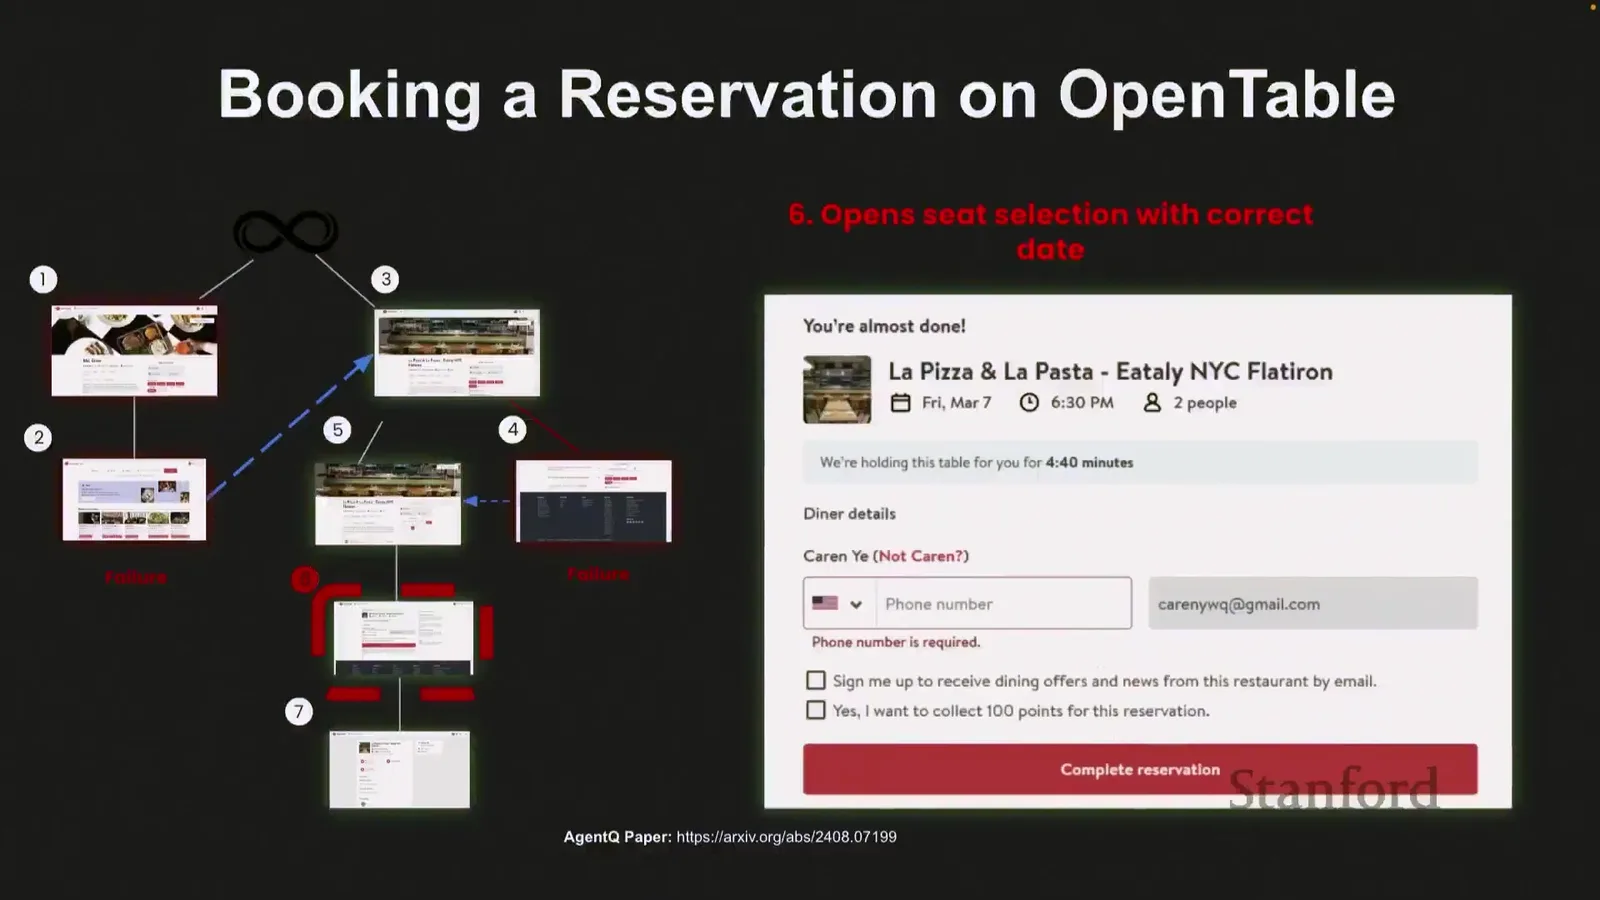
来源:Stanford CS25 V5 official recording, 00:24:54
来源:Stanford CS25 V5 official recording, 00:24:56
Trajectory-level acceptance
最终成功记为 \(s_T=1\) 仍不够。建议同时报告:错误动作数、恢复次数、不可逆动作数、用户确认次数、总工具成本和完成时延。这样才能区分“一次顺利完成”与“绕路、误点、但最后碰巧成功”。
for step in range(max_steps):
    observation = environment.observe()
    action = policy.propose(goal, observation, memory)
    if not permission_check(action):
        action = request_user_confirmation(action)
    result = environment.execute(action, idempotency_key=step)
    if postcondition_holds(goal, result):
        return SUCCESS
    if repeated_state(result) or budget_exhausted():
        return HUMAN_FALLBACK
    memory.record(observation, action, result)
return TIMEOUT
结果页:数字必须绑定实验设置
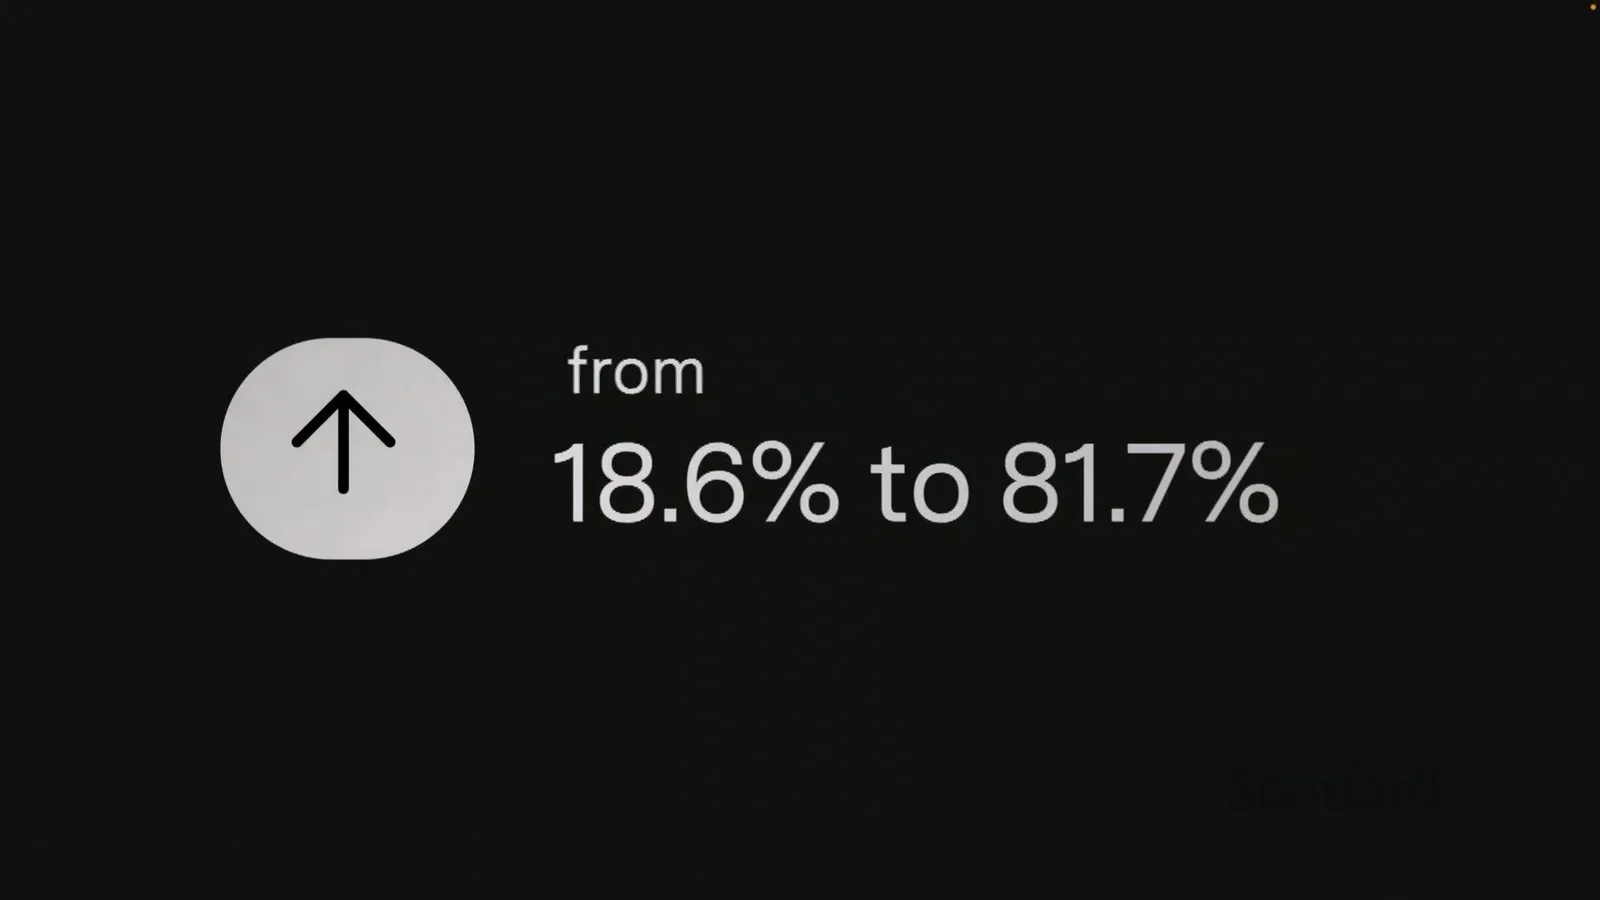
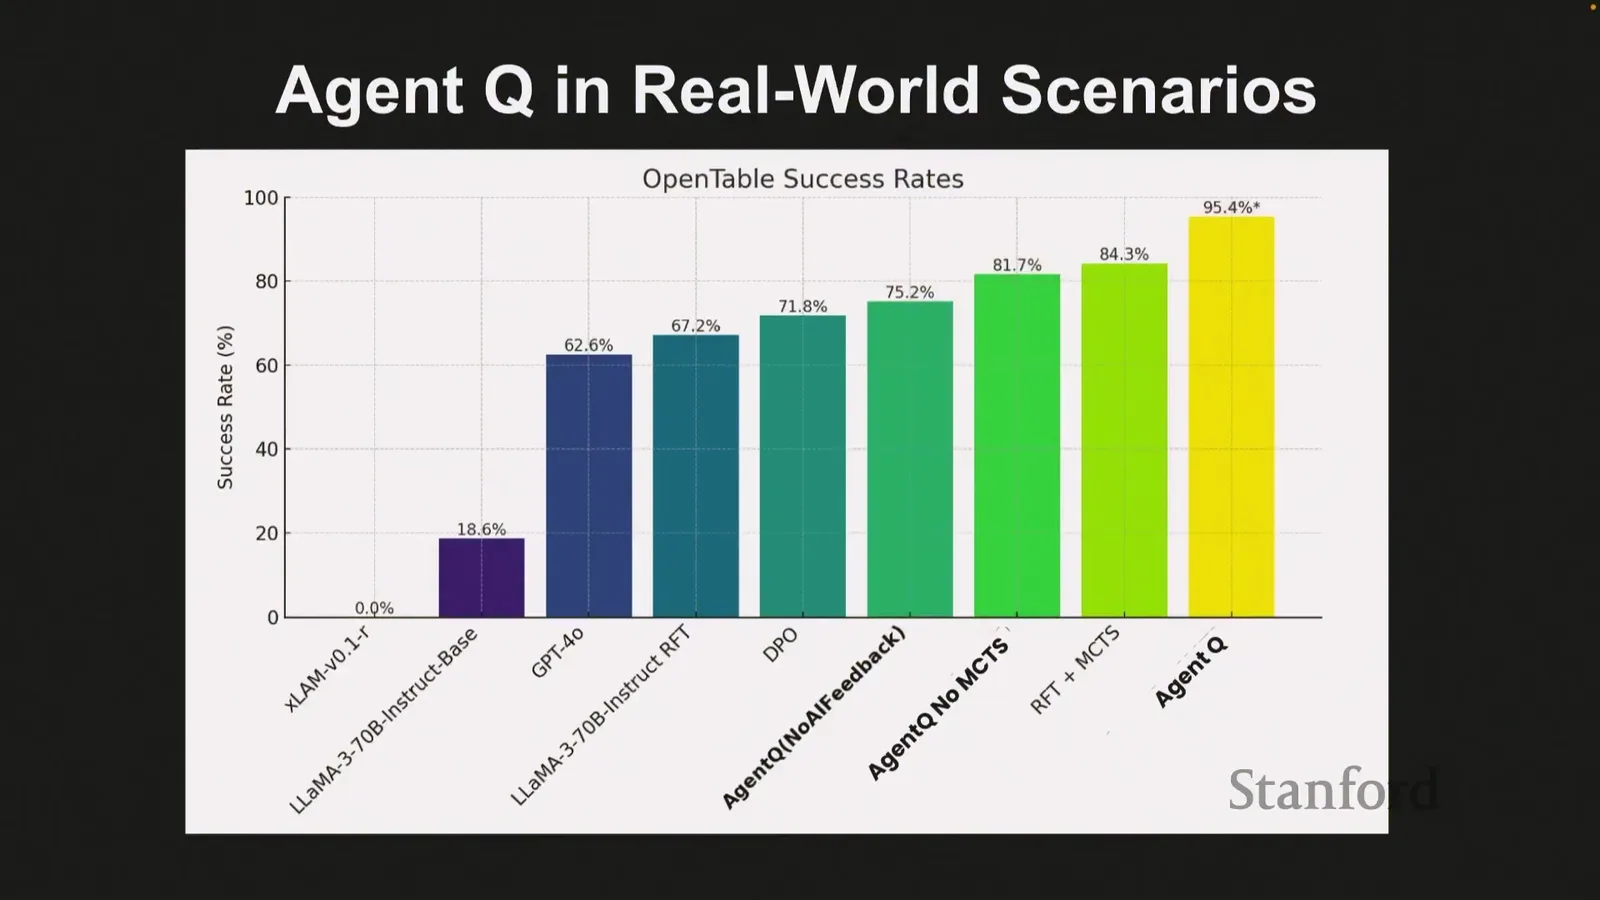
课堂展示的 OpenTable 成功率图比较多个设置,并突出 AgentQ、online search 等组件带来的提升。论文报告 Llama-3 70B 零样本从 18.6% 提升到 81.7%,加入 online search 后达到 95.4%。这些数字是特定任务、数据收集、模型和判定方法下的结果;它们支持“搜索与学习有效”,不支持“所有网页任务已经 95% 可靠”。
读柱状图时先比较相同 base model 下增加组件后的变化,再比较不同模型之间的差异;不要把所有柱子的差额都归因于一个算法。还应检查成功判定是否只看最终页面、是否允许人工或外部搜索、每个设置用了多少交互数据,以及失败是否来自相同任务分布。若实验配置不同,柱高只能作为系统组合的结果,不能直接推出单个 MCTS、DPO 或 search 模块的独立因果贡献。
来源:Stanford CS25 V5 official recording, 00:26:41
相对提升与绝对可靠性不要混淆
从 18.6% 到 81.7% 是巨大研究进步,但 81.7% 意味着约五次任务仍有一次失败。即使 95.4%,若每天执行一百次高风险动作,期望失败数仍不可接受。上线门槛必须结合频率、严重性和可恢复性。
本章小结
AgentQ 的机制链是:树搜索产生多样分支,process critique 判断中间步骤,偏好目标把好坏分支写回策略,轨迹级评测同时检查结果与过程。OpenTable 案例说明错误并不可怕,无法发现、无法恢复和无法学习才是系统性缺陷。
Neural Compute、Memory 与 Personalization
讲者随后用计算机系统类比 agent:模型像可调用的 neural compute unit,重复调用形成循环,scratchpad 保存工作状态,长期记忆承担跨会话持久化。这个类比很有教学价值,但必须明确:Transformer 不是 CPU,embedding store 也不是磁盘;类比的用途是帮助拆分计算、工作记忆与持久状态。
模型作为 Neural Compute Unit
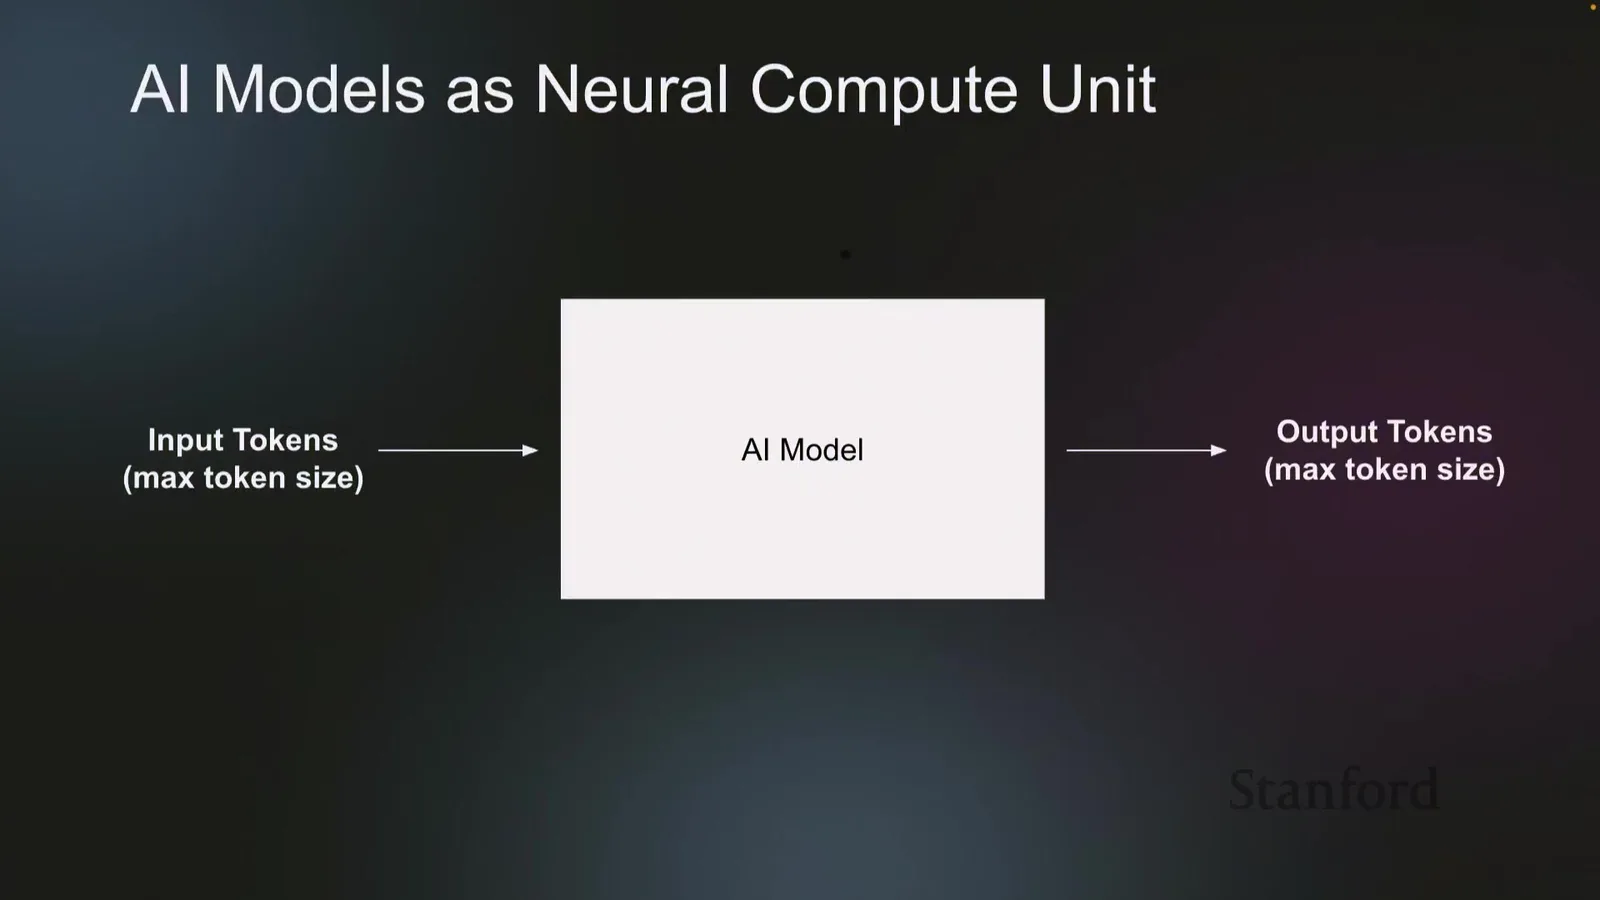
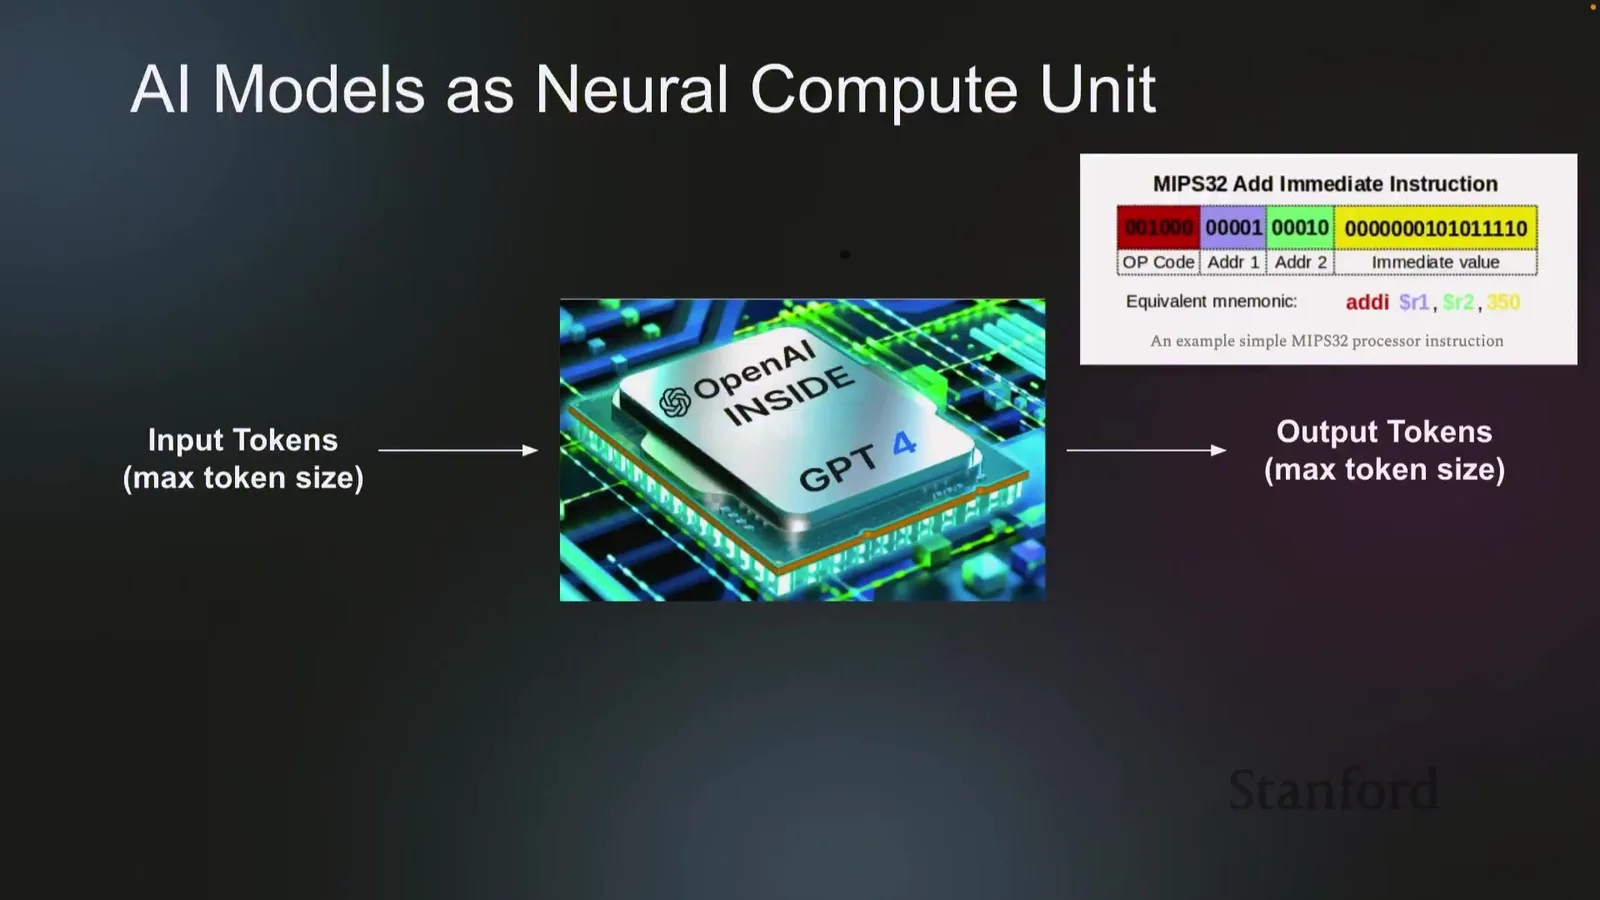
第一张图把最大输入 token 序列映射到最大输出 token 序列,强调一次模型调用是有限窗口内的计算。第二张 MIPS 指令类比提示:传统处理器有固定指令语义,而语言模型的“指令”由自然语言和上下文共同解释,因此灵活但不稳定。
来源:Stanford CS25 V5 official recording, 00:28:00
来源:Stanford CS25 V5 official recording, 00:28:34
类比中的对应关系
输入 tokens 类似程序与数据,模型参数类似固定计算结构,输出 tokens 类似计算结果,scratchpad 类似工作区。但语言模型没有硬件 ISA 的严格语义、事务和确定性;因此每次调用都需要 schema、验证和错误处理来补足。
Looped Transformer:把一次生成变成迭代计算
Looped Transformer 图把输出重新送入输入,并在 scratchpad、memory、instructions 之间循环。Agent 系统正是用 orchestration 把一次前向生成扩展成多步算法。若第 \(k\) 轮内部状态为 \(z_k\),可抽象为
\(F_\theta\) 是模型计算,\(o_k\) 是新观察,\(m_k\) 是检索记忆,\(G\) 把内部状态映射到工具动作。系统必须定义何时停止,否则循环本身会成为故障模式。
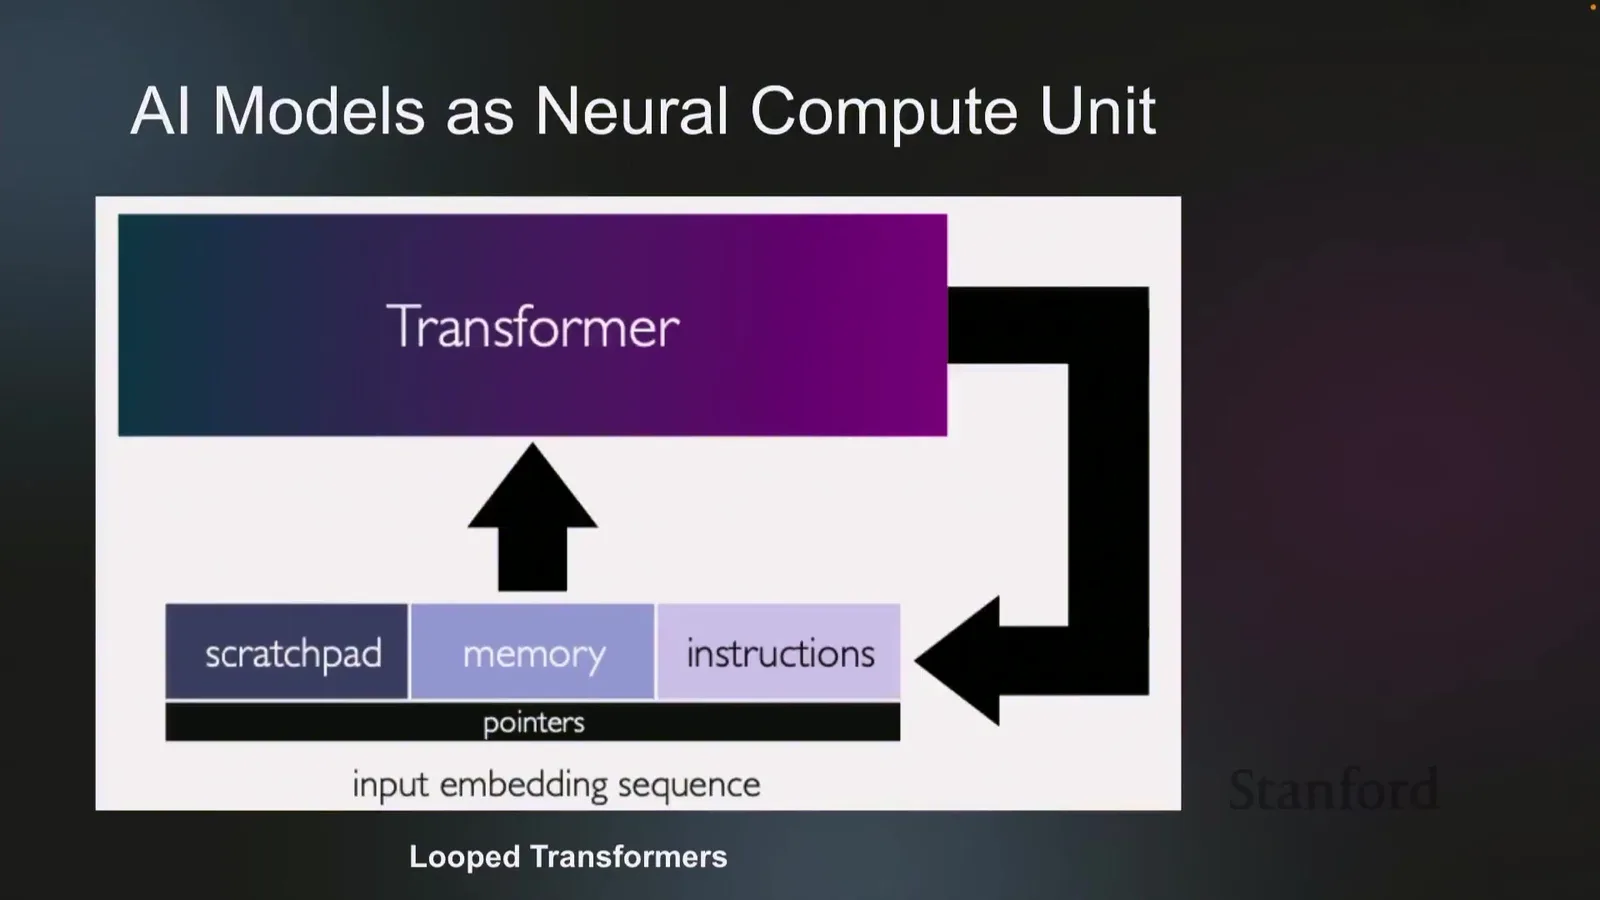
来源:Stanford CS25 V5 official recording, 00:28:51
停止条件比“再思考一下”重要
终止条件至少包括任务完成、预算耗尽、状态重复、风险阈值、用户取消和人工接管。没有停止条件的 reasoning loop 会把不确定性转化为 token、延迟和工具费用。
Long-term Memory:持久、检索、更新与遗忘
长期记忆 slide 把 memory 描述为 long-lived、persistent,并列出 embedding、retrieval models、层级、时间一致性、结构与在线适应。首次出现时必须区分:working memory 是当前任务状态;long-term memory 是跨会话持久信息;model memory 则可能指参数中学到的知识,三者的更新机制不同。
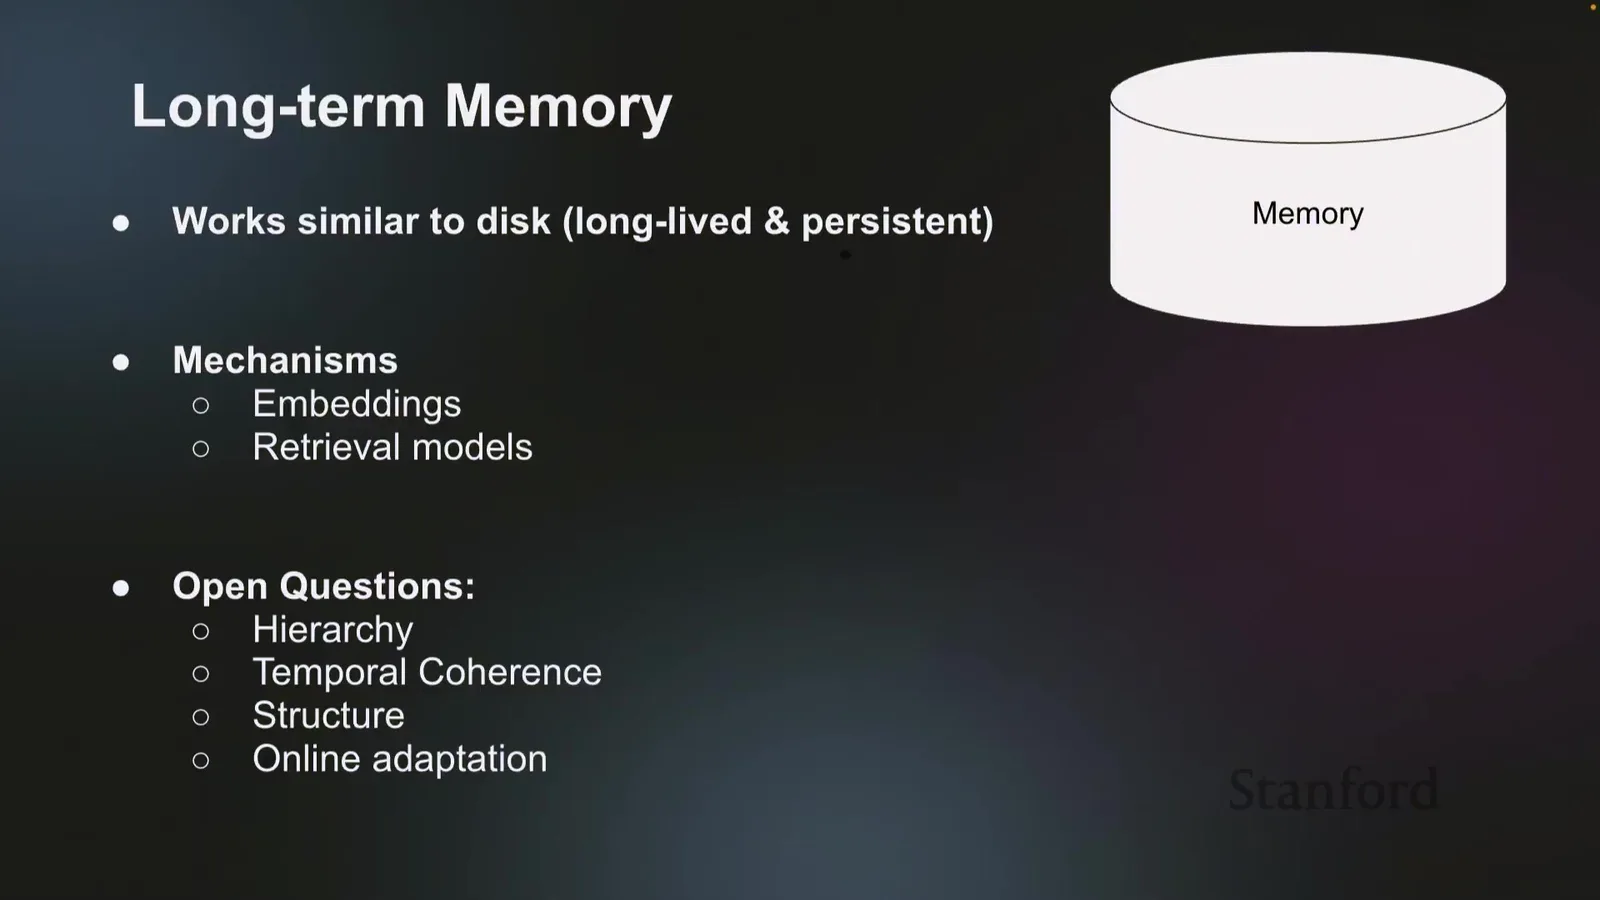
来源:Stanford CS25 V5 official recording, 00:35:17
一个基础检索式为
\(q_t\) 是当前查询 embedding,\(e_i\) 是记忆条目表示,\(m_t\) 是返回的 top-\(k\) 条目。仅按相似度会召回过期或敏感内容,因此实际分数应加入时间、来源、权限与置信度:
记忆污染与错误持久化
一次聊天误解若被写入长期记忆,会在未来被反复强化。写入前应区分用户明确陈述、系统推断和临时任务状态;高影响偏好应允许用户查看、更正和删除。
memory_item = {
  "fact": normalized_content,
  "source": source_event,
  "confidence": confidence,
  "scope": ["travel", "restaurants"],
  "created_at": timestamp,
  "expires_at": expiry,
  "sensitivity": sensitivity,
  "user_editable": True
}
Personalization 是用户–Agent 对齐问题
个性化 slide 同时列出显式偏好与隐式偏好。显式偏好如过敏、座位和收藏菜品,通常可以直接确认;隐式偏好来自行为统计,更容易把偶然选择、价格约束或历史环境误当成稳定喜好。系统目标可写为约束优化:
\(U_{\text{user}}\) 是用户效用,\(C_{\text{privacy}}\) 与 \(C_{\text{safety}}\) 是隐私和安全成本,\(\epsilon_p,\epsilon_s\) 是允许阈值。个性化不能以越界收集数据为代价。
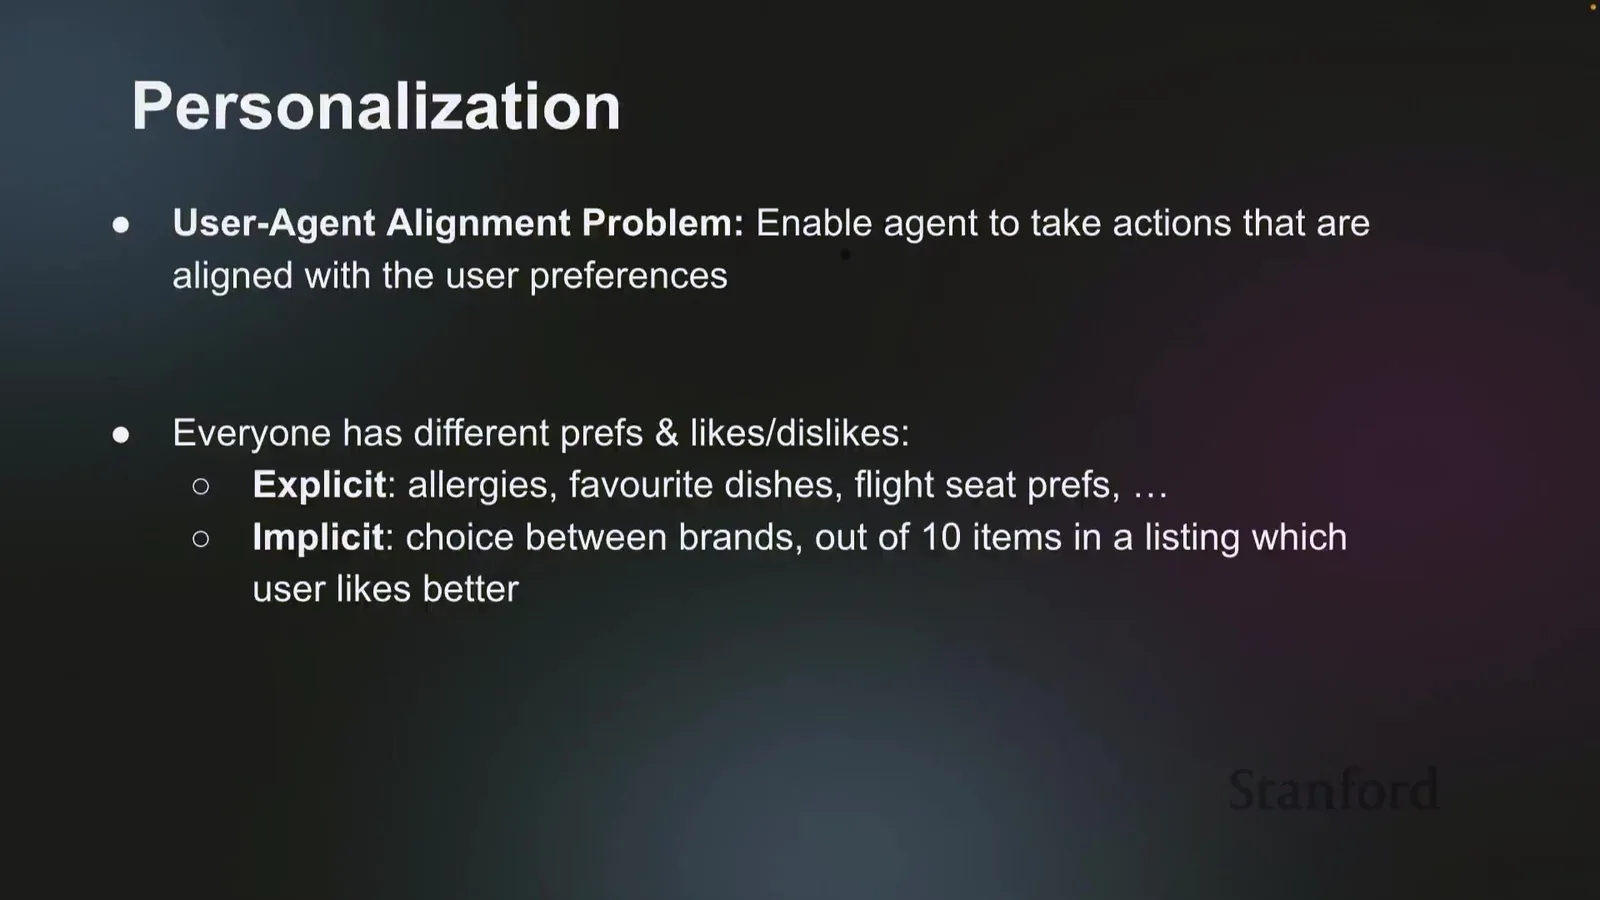
来源:Stanford CS25 V5 official recording, 00:36:42
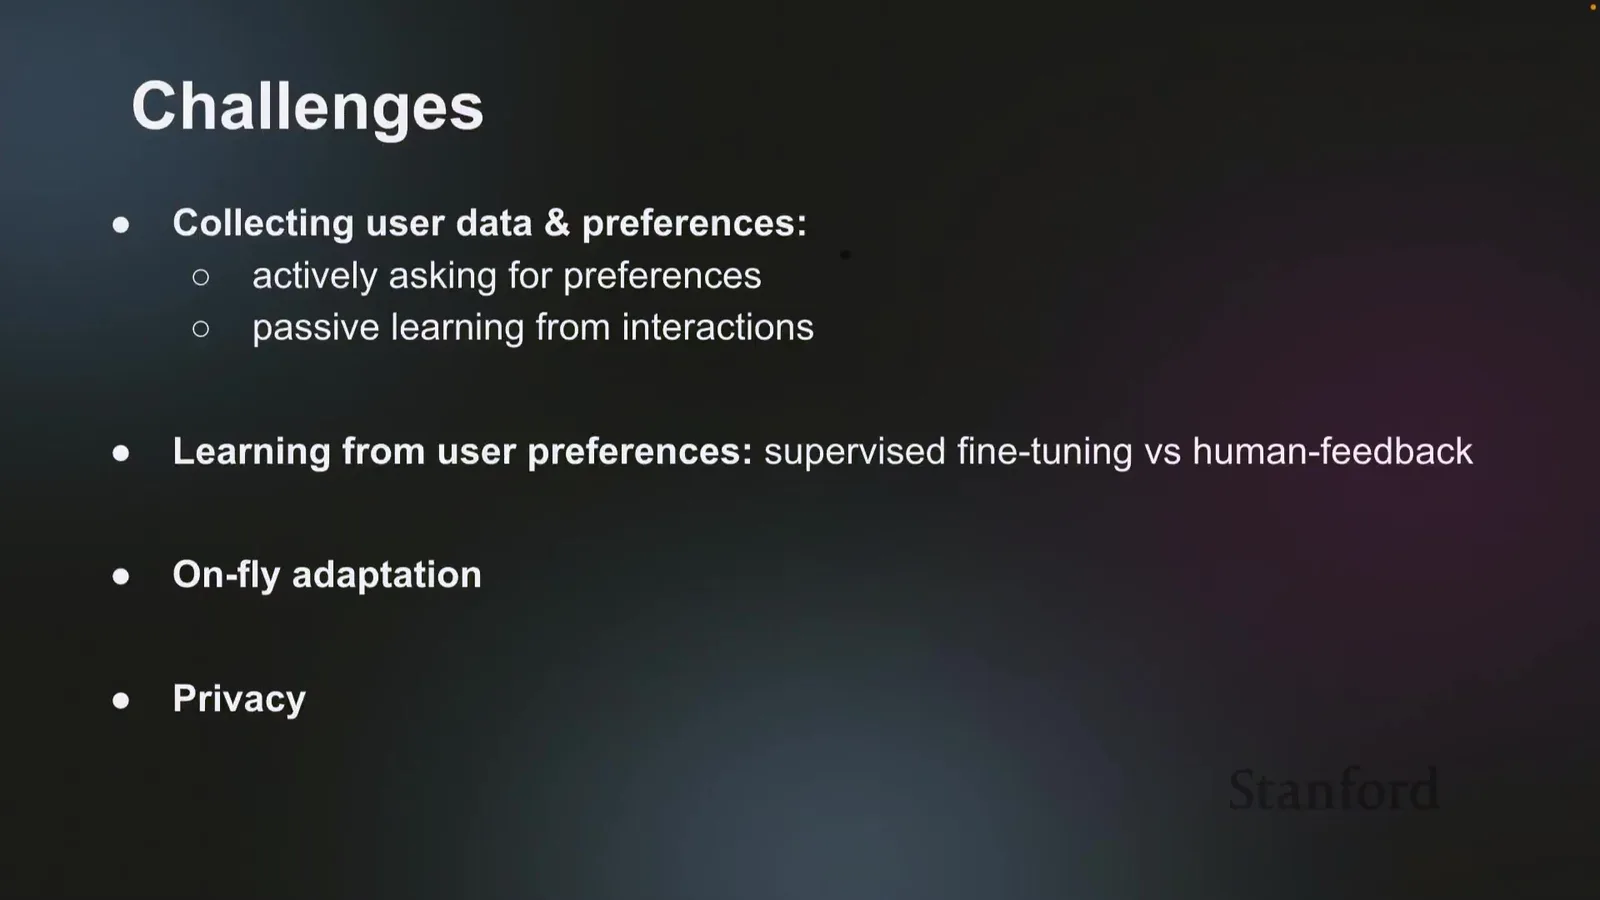
来源:Stanford CS25 V5 official recording, 00:37:56
两张个性化图应和前面的长期记忆一起阅读:memory 决定“保存什么”,personalization 决定“如何使用”,privacy 决定“什么时候不能用”。例如用户曾为一次商务旅行选择靠走道座位,不应被永久归纳成全局偏好;系统需要保存来源、场景和置信度,并在高影响决策前重新确认。真正的个性化不是让 agent 猜得更多,而是让它知道哪些偏好可信、哪些过期、哪些必须再次询问。
课堂提示
00:35:17–00:38:00,讲者把长期记忆类比为磁盘,把个性化定义为 user-agent alignment,并强调主动询问、被动学习、SFT、human feedback、on-the-fly adaptation 与 privacy。课堂提示:学习偏好必须带来源和可撤销机制。
术语消化:Memory 与 Personalization
| 术语 | 核心机制 | 主要失败 |
|---|---|---|
| Embedding memory | 相似度检索文本或事件 | 语义近但事实错、时间过期 |
| Episodic memory | 保存具体交互与结果 | 噪声多、隐私敏感 |
| Semantic memory | 把多次事件压缩为稳定事实 | 归纳错误被长期固化 |
| Online adaptation | 根据新反馈即时改变行为 | 灾难性漂移、被恶意反馈操纵 |
| Preference model | 预测用户选择或满意度 | 把历史选择当成真实价值 |
本章小结
Neural-compute 类比帮助把模型调用、循环、工作状态和长期记忆分层,但不能替代真实接口设计。长期记忆需要检索、来源、过期、权限和用户编辑;个性化需要在效用、隐私与安全约束下学习,而不是无限收集行为数据。
Multi-Agent Systems:并行化、专业化与通信协议
单 agent 面对长任务时会受上下文、工具数量和错误累积限制。多 agent 系统尝试把任务拆分给不同 worker,由 manager 协调结果。它可以并行化和专业化,也引入新的分布式系统问题:任务划分、消息一致性、重复执行、同步等待、权限传播和故障恢复。
为什么使用多个 Agents
第一张图用多个机器人表示自主系统;完整 build 列出 parallelization 和 task specialization。并行化只有在子任务依赖较弱时才缩短时延;若每个 worker 都等待同一共享状态,通信开销会抵消收益。
这一节从单 agent 的 memory 与 personalization 转向协作边界。拆分前应先画依赖图:检索多个独立来源可以并行,写最终报告必须等待证据汇总;不同 worker 可以各自使用专门工具,但共享用户身份和付款权限则需要中央控制。读图时不要把机器人数量当作能力指标,而要问每个 agent 是否承担独立职责、输出能否合并、冲突由谁裁决,以及一个 worker 超时或返回恶意内容时 manager 是否会隔离它。
来源:Stanford CS25 V5 official recording, 00:39:49
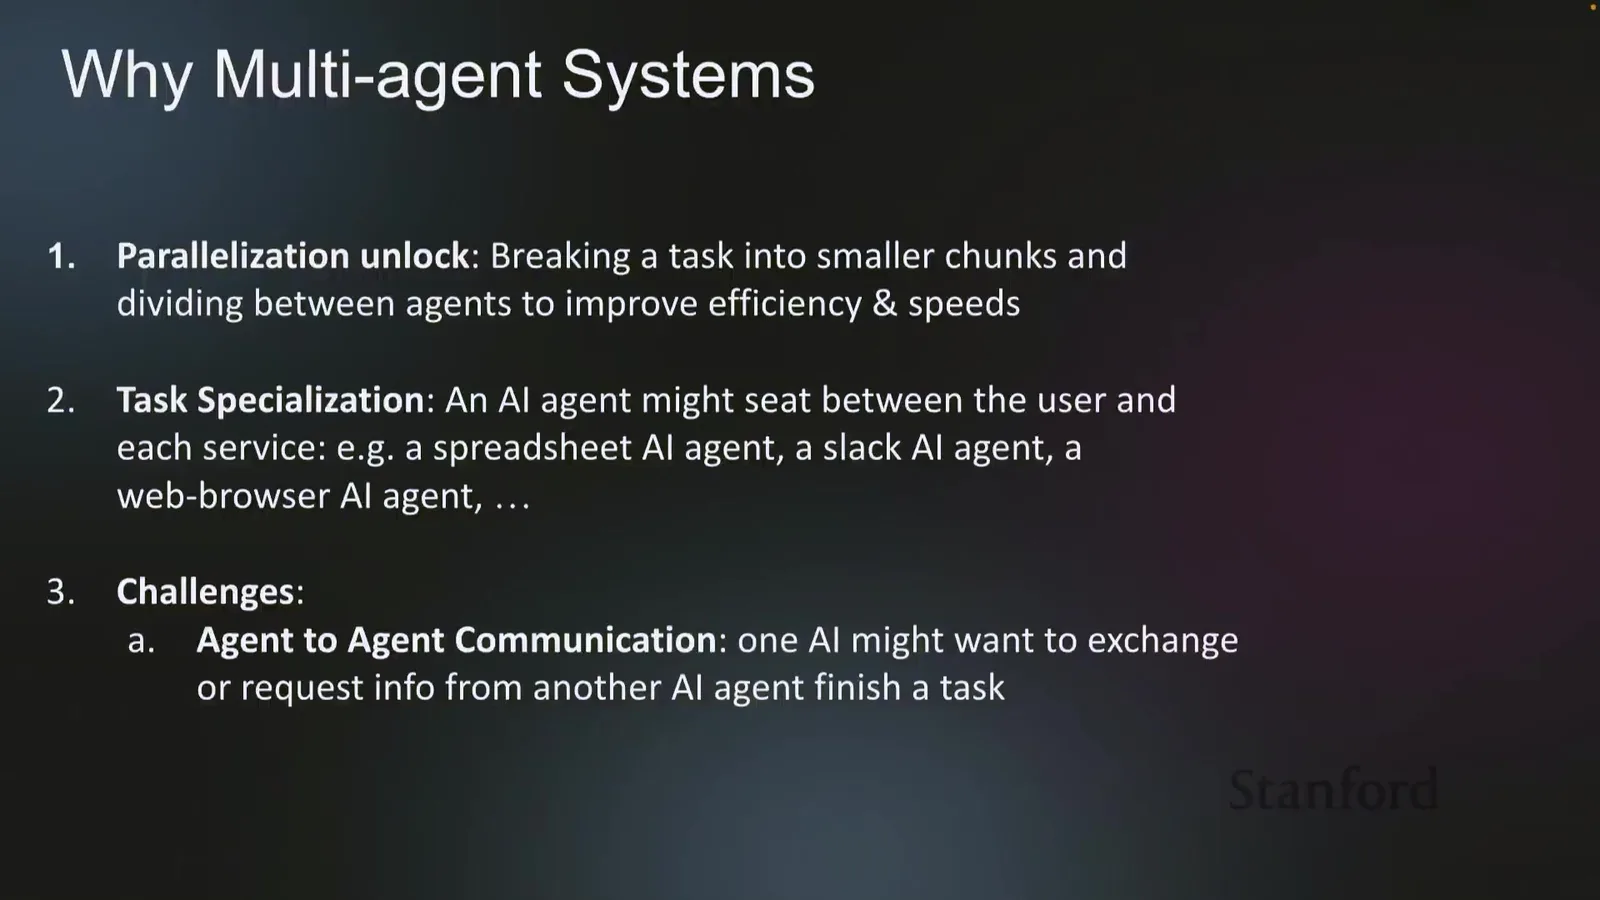
来源:Stanford CS25 V5 official recording, 00:40:48
若任务被分为 \(K\) 个子任务,串行时延为 \(\sum_k T_k\);理想并行时延近似为
\(T_{\text{coord}}\) 是调度与通信,\(T_{\text{merge}}\) 是结果合并与验证。若协调成本太高或最长子任务占主导,多 agent 不会自动更快。
“多 Agent”不是把同一 Prompt 复制多份
没有角色边界、共享状态协议和冲突解决的多 agent,通常只是提高 token 成本。每个 worker 应有明确输入、输出 schema、权限、截止时间和失败处理。
Hierarchy 与 syncing primitives
层级图把用户请求交给 manager,再分派给多个 worker。Manager 的责任不只是转发消息,还要规划依赖、控制预算、判断结果冲突,并在 worker 失败时重新分配。所谓 syncing primitives 是让多个 agent 对共享状态达成可操作一致的机制,例如锁、版本号、barrier、消息确认和幂等任务 ID。
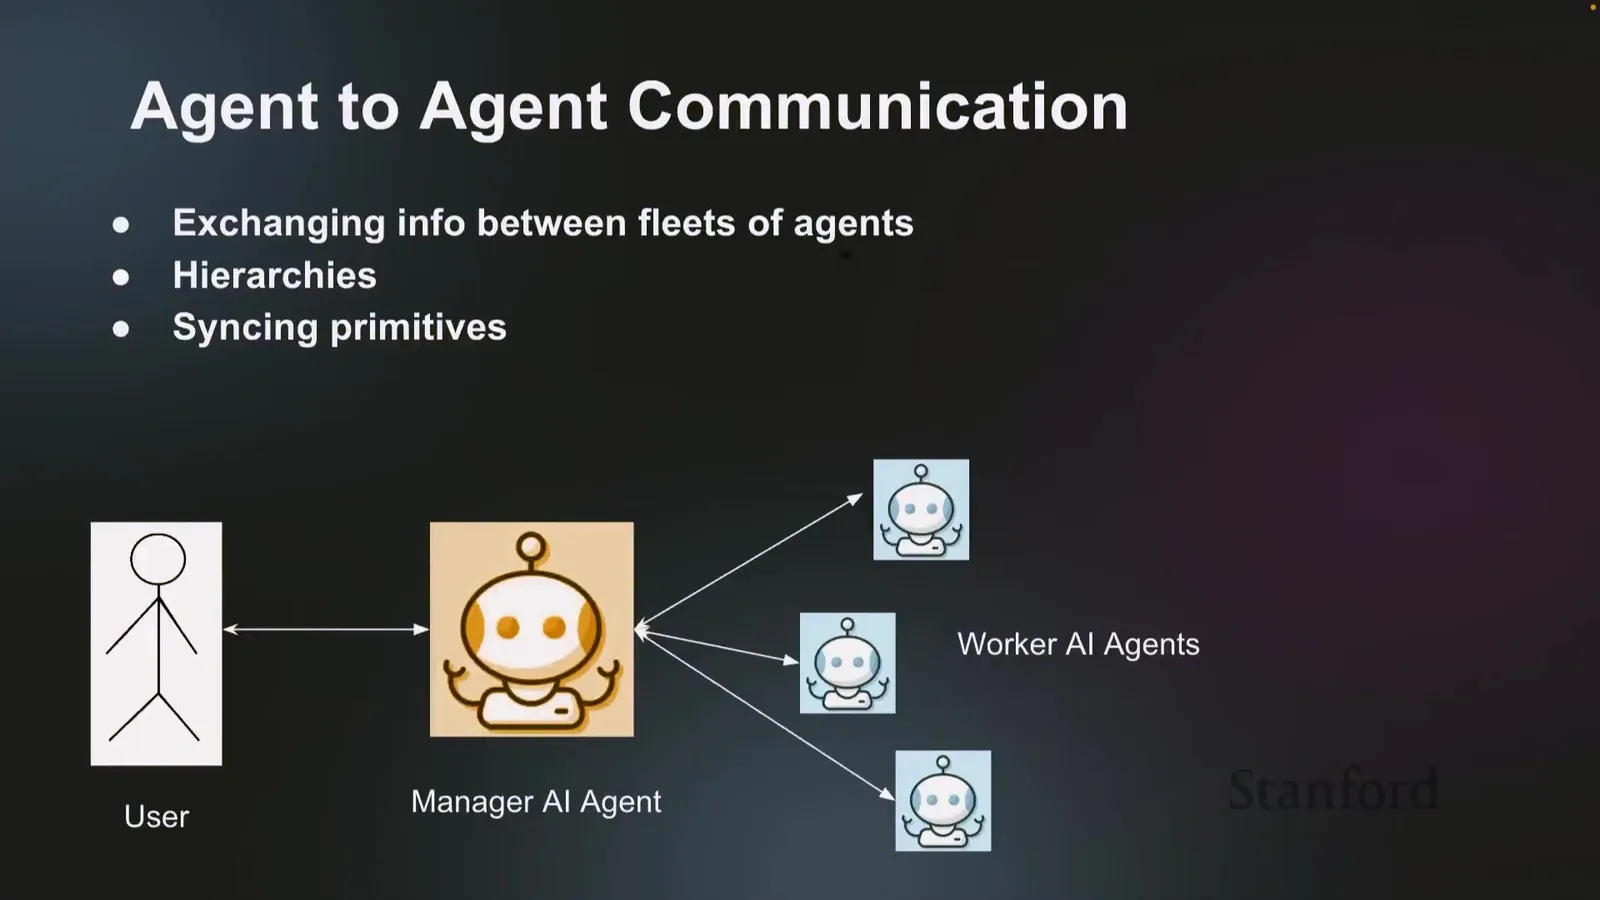
来源:Stanford CS25 V5 official recording, 00:42:21
task = {
  "task_id": stable_id,
  "goal": scoped_goal,
  "inputs": immutable_inputs,
  "permissions": allowed_tools,
  "depends_on": prerequisite_task_ids,
  "deadline": deadline,
  "output_schema": schema,
  "retry_policy": retry_policy
}
MCP 与 A2A:连接标准不等于安全保证
协议 slide 把 MCP(Model Context Protocol)用于模型、工具和数据连接,把 A2A(Agent-to-Agent)用于 agent 通信。MCP 的价值是统一发现和调用接口,减少每个应用为每个工具写定制 glue code;A2A 则需要定义身份、消息、任务状态与协作语义。二者解决互操作性,不自动解决授权和正确性。
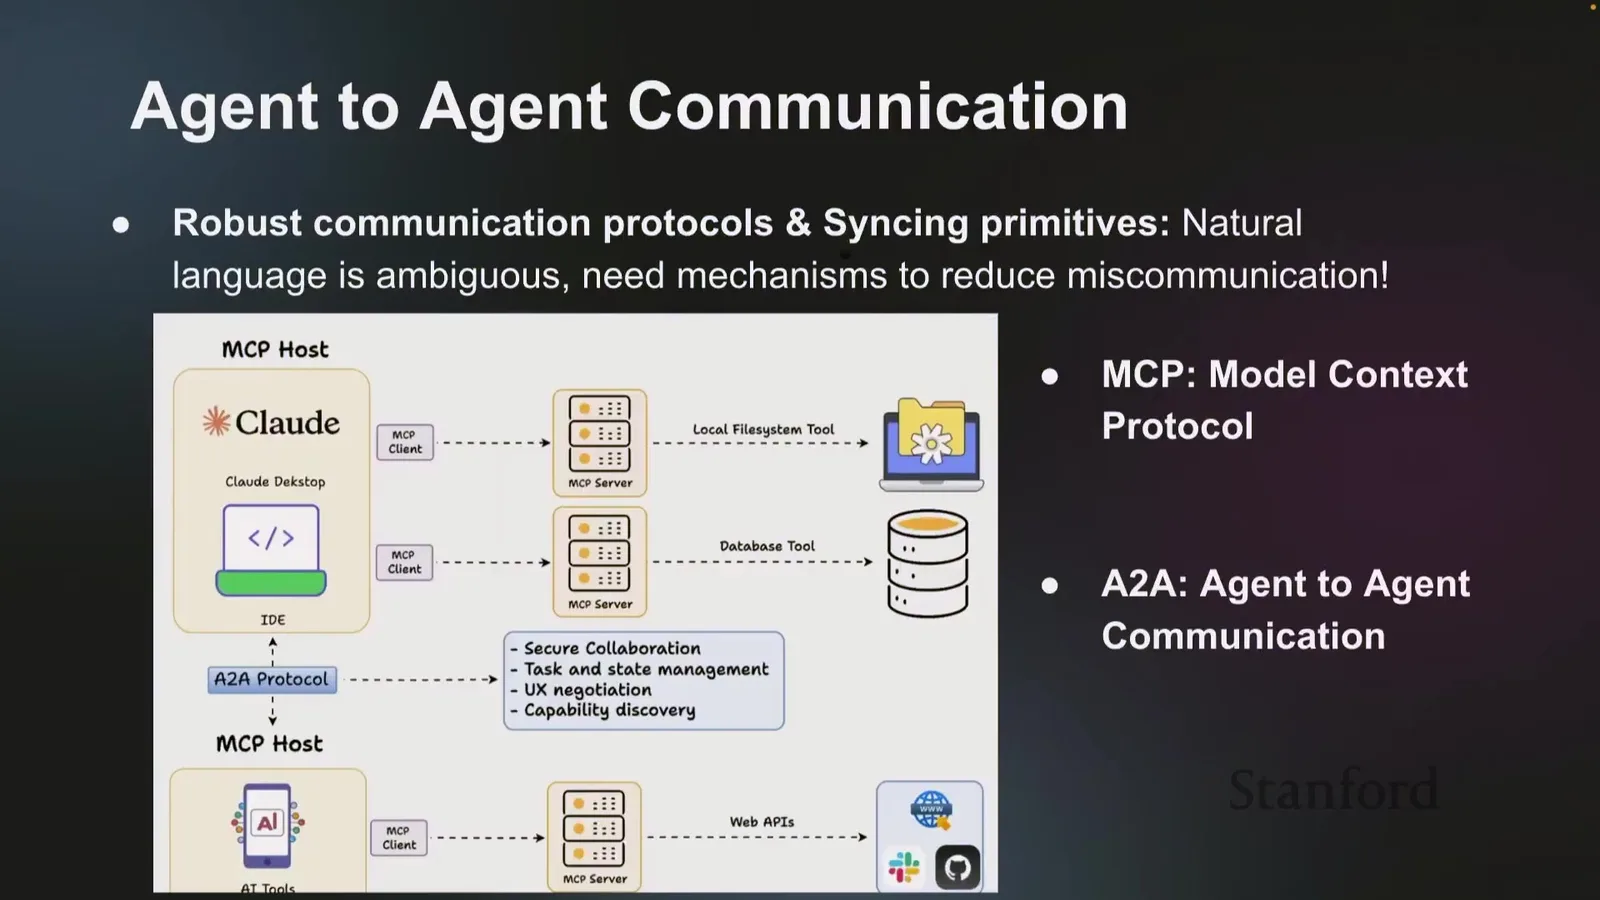
来源:Stanford CS25 V5 official recording, 00:43:44
首次使用:Protocol、Schema 与 Authorization
Protocol 定义参与方怎样通信;schema 定义消息字段及类型;authorization 决定谁可执行什么动作。MCP server 暴露工具,不代表任何 client 都应拥有调用权限;权限仍需最小化、可审计且可撤销。
为什么 MCP 被比作 USB-C
第一张 MCP 图强调统一连接模型、数据与工具;最终 build 进一步列出 resilience、dynamic tool discovery 和 intent-based execution。读图时应把“吸收 API 变化”理解为抽象层隔离,而不是接口永不出错:server schema 变化、语义变化和权限变化仍需版本管理和兼容测试。
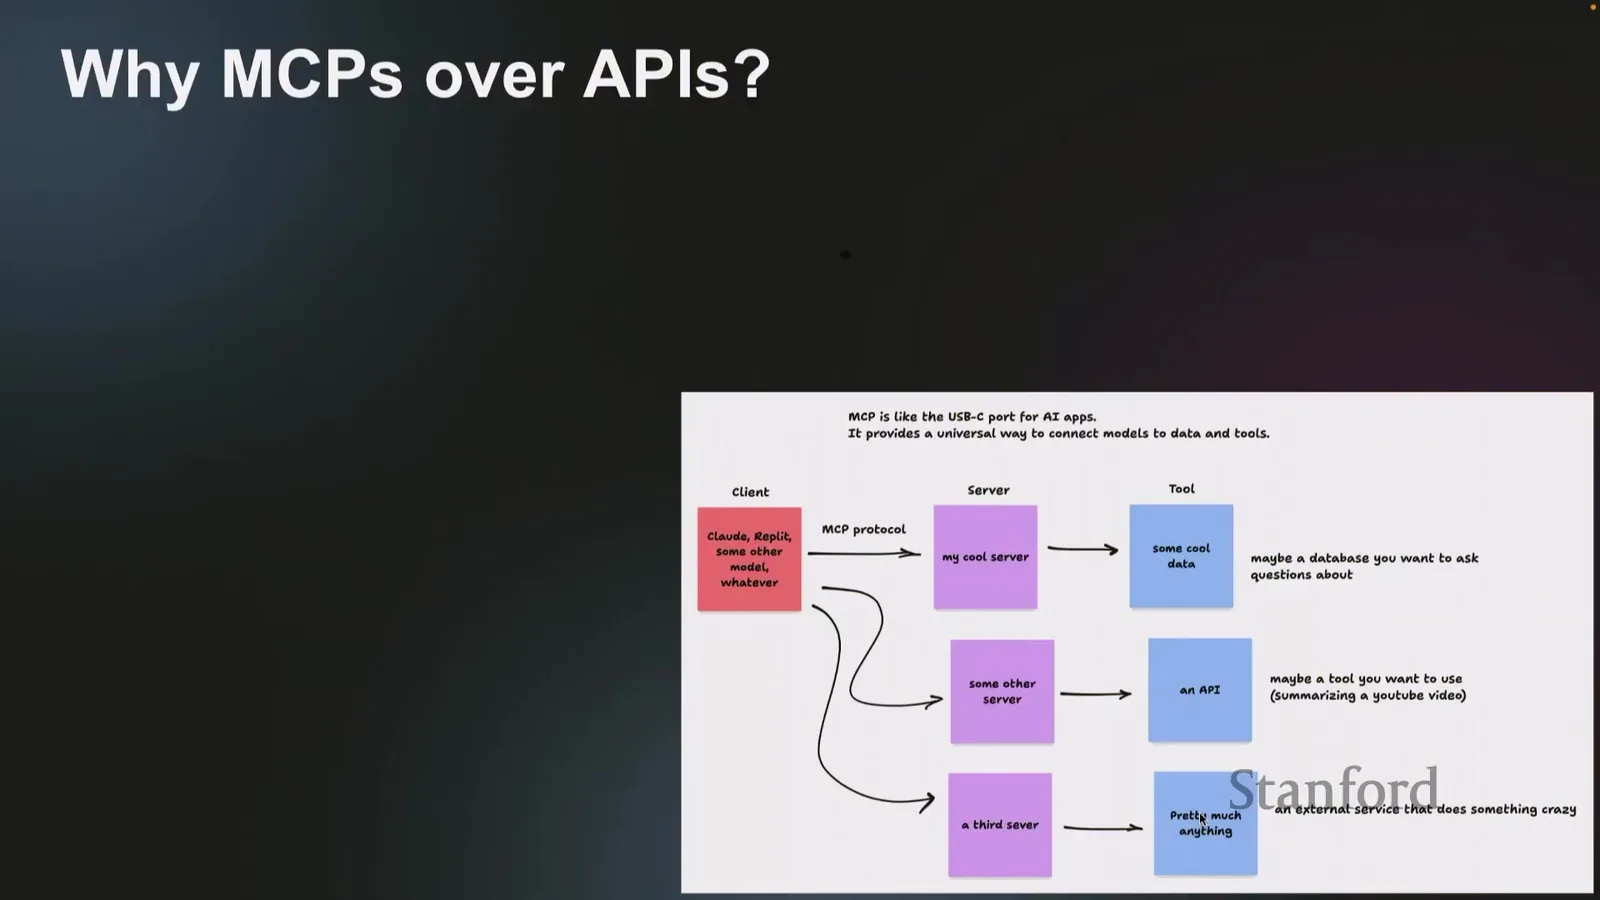
来源:Stanford CS25 V5 official recording, 00:45:11
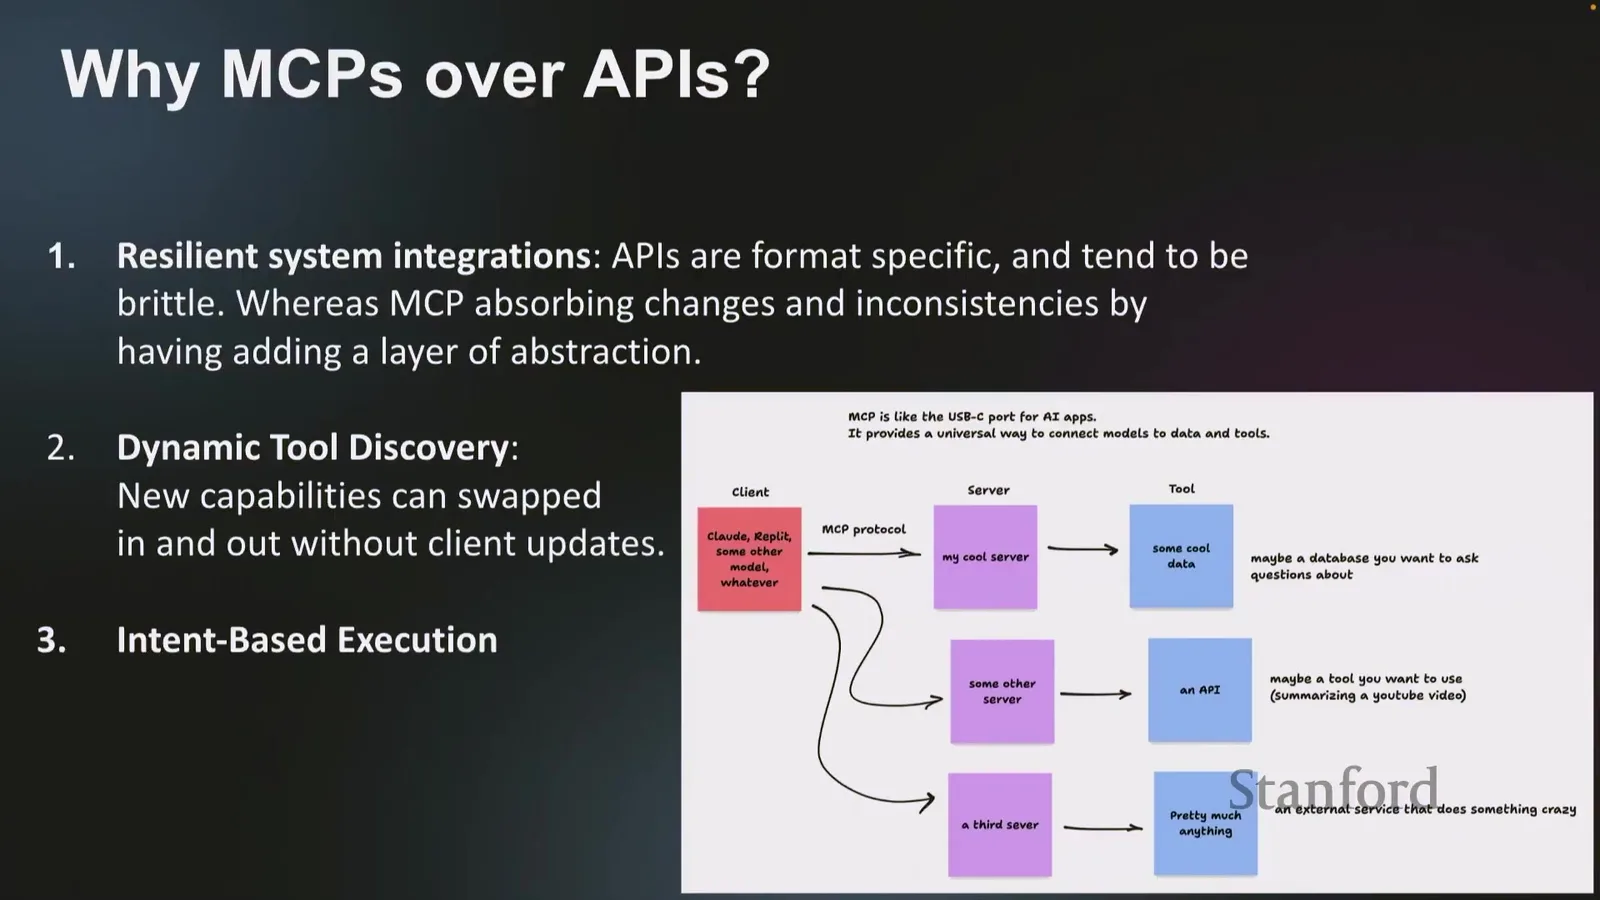
来源:Stanford CS25 V5 official recording, 00:45:46
协议标准化还会改变故障定位。点对点集成失败时,应用、模型和 API 的责任常混在一起;引入协议层后,可以分别检查 server 是否可发现、schema 是否匹配、权限是否足够、调用是否超时、返回是否通过验证。代价是协议层本身也成为关键依赖,必须版本化、监控并防止恶意 server 注入误导性工具描述。所谓 resilience 来自清晰分层和测试,不是来自一个统一名字。
课堂提示
00:38:00–00:46:09,讲者把多 agent 的价值归纳为 parallelization 与 specialization,并强调 hierarchy、synchronization、MCP、A2A、resilient integrations 和 dynamic discovery。课堂提示:自然语言本身含糊,通信必须有结构化协议和状态。
协议层的最小安全清单
工具发现应与权限授予分离;敏感工具要求显式 scope;每次调用包含调用者身份和任务 ID;输出需要 schema 验证;协议升级要做兼容测试;高风险动作应要求用户确认或双重控制。
本章小结
多 agent 系统把单模型问题转成分布式系统问题。并行化和专业化只有在任务可拆、通信可控时有收益;manager–worker 合同、同步 primitives、MCP/A2A schema、身份与权限共同决定系统是否可靠。
Deployment Contract:Reliability、Loop、Observability 与 Human Override
最后一张教学 slide 把前文全部收束为四类部署问题:可靠性、循环与计划漂移、测试与 benchmark、真实部署与可观测性。它不是附录,而是对“Everyday AGI”愿景的验收条件。系统越接近用户邮箱、日历、支付和公开账号,越不能用平均 demo 成功率代替操作保障。
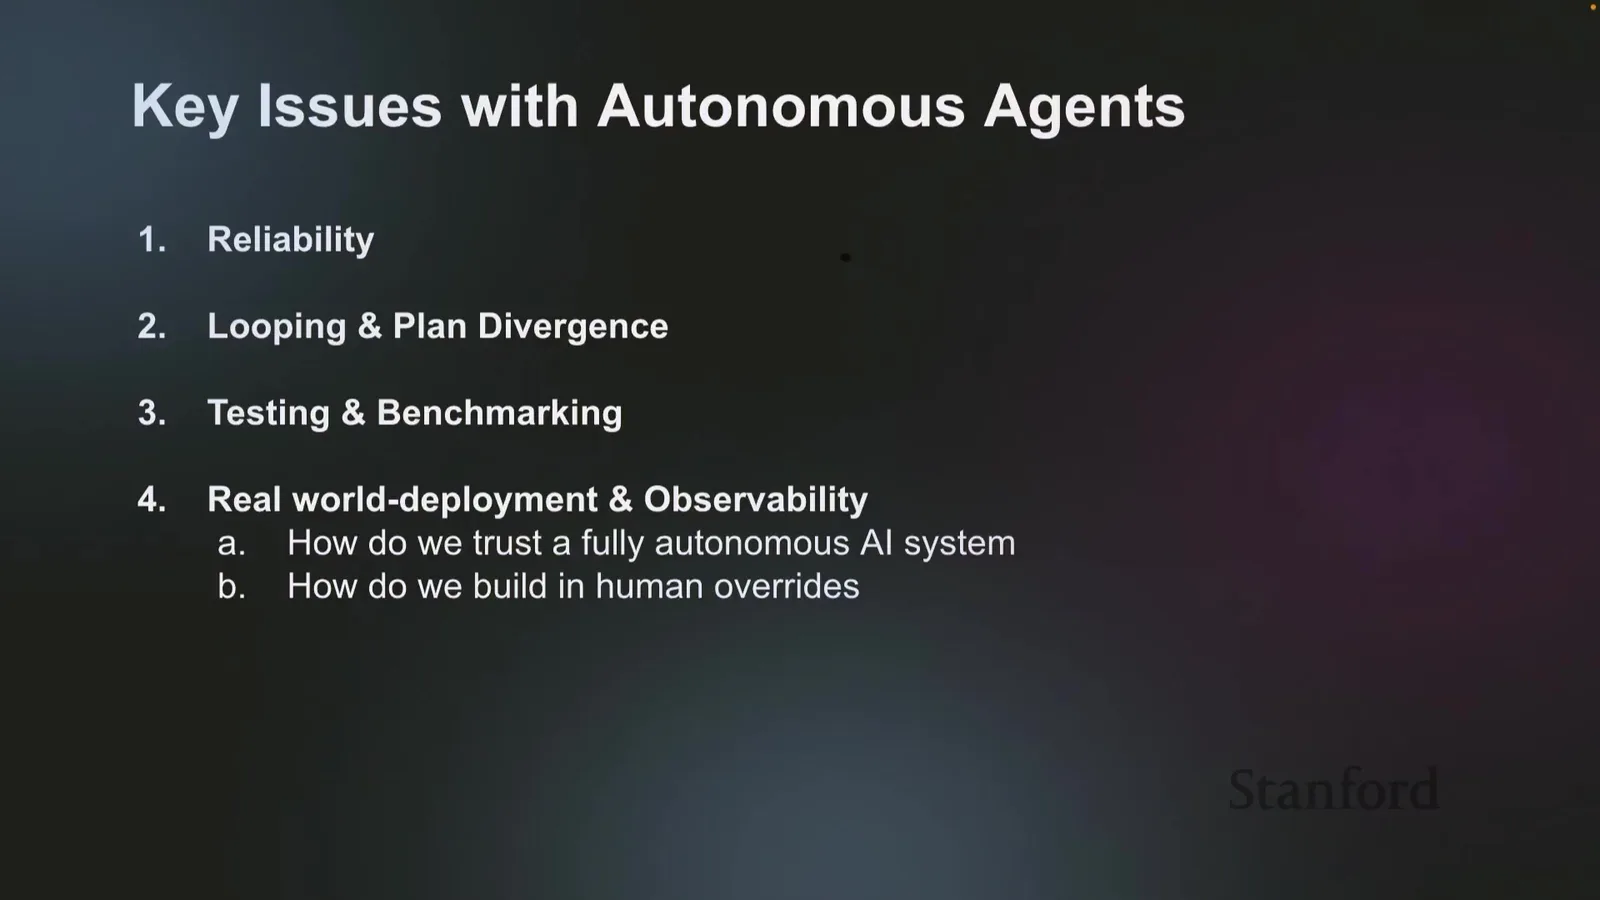
来源:Stanford CS25 V5 official recording, 00:46:09
这张总结页与开场的 Everyday AGI 形成首尾对应:前者问“如果智能进入日常生活会怎样”,后者回答“在进入之前必须满足什么”。可靠性决定能否授权,loop control 决定成本和失控边界,testing 决定改动是否可验证,observability 决定事故是否能被解释。四项不是上线后的运维补丁,而应在 agent architecture、数据收集和训练环境阶段就被设计进去。
Reliability:99.9% 也要问任务频率与事故成本
若单次高风险动作失败概率为 \(q\),一年执行 \(N\) 次,至少一次失败的概率为
当 \(q=0.001\)、\(N=1000\) 时,该概率约为 \(63.2\%\)。因此“99.9% reliable”并不是天然安全;还要减少高风险自动动作、增加确认、限制权限并保证可恢复。
课堂提示
00:46:09–00:50:00,讲者说支付、银行、邮箱和社交账号要求接近生产级可靠性;系统不能发错内容、做错交易或陷入循环。老师强调 audit trail、在线监控、human fallback 与用户接管。
平均成功率会掩盖灾难性尾部
可靠性报告应同时给出严重错误率、不可逆错误率、未经确认的权限使用、最长循环、最高单任务成本和人工接管率。只报平均任务成功,无法证明系统不会制造低频高损事故。
Loop 与 plan divergence:给系统预算和可检测状态
循环可能是重复同一动作,也可能是计划不断扩张却没有推进。检测可以结合状态 hash、动作 n-gram、目标距离和预算:
当风险超过阈值,系统应停止、降级或请求人工,而不是自动增加 token budget。
while not done:
    if spent_cost > cost_limit or elapsed > time_limit:
        return escalate("budget exceeded")
    if state_hash in recent_states:
        return escalate("loop detected")
    action = agent.next_action()
    if action.risk >= confirmation_threshold:
        action = wait_for_user_confirmation(action)
    execute(action)
    append_audit_log(action)
Q&A:从 zero-shot 到 task-specific training
面对“如何从 40% 到接近 99%”的问题,讲者指出很多 frontier models 对 agent interfaces 是 zero-shot:预训练分布并不包含特定网页和操作流程。通过任务特定 RL、自我修正和反复收集轨迹,某一窄域可以被推高;但这不等于开放世界所有任务都能同步饱和。
课堂提示
00:50:00–00:54:20,讲者用 AgentQ 说明 task-specific RL 可以显著提高预约任务准确率,同时承认新网站、新任务和新约束仍会形成分布偏移。讲义提醒:局部饱和与通用可靠性必须分开报告。
可把部署飞轮写为
每一步都要保留版本和数据 provenance,才能判断提升来自模型、prompt、工具还是环境变化。
Hallucination 与 domain-specific regression suites
讲者的工程答案包含两层:更强基础模型会降低一些错误;具体产品仍需自己的测试与评测。对一个垂直 agent,应维护真实任务、极端输入、权限边界、工具失败和历史事故组成的 regression suite,并在模型、prompt、工具 schema 或 policy 改动后每日重放。
课堂提示
00:54:20–00:57:55,讲者强调建立约一千个关心的 domain scenarios、持续检查 prompt 变化和回归、比较不同模型,并用 fine-tuning 或 reinforcement learning 进一步优化。实践经验:不要把供应商模型升级当作自己的验收。
一个可交付的 Agent 发布门槛
- strict offline suite 无严重回归;
- shadow traffic 不执行真实副作用;
- canary 用户和低权限工具先开放;
- 高风险动作必须确认并可撤销;
- 监控覆盖成功、成本、循环、错误与人工接管;
- 事故能够定位到模型、prompt、memory、tool 或 policy 版本。
小模型、Manager–Worker 与真实世界检验
Q&A 讨论 smaller versus larger models。讲者认为经过 reasoning traces 与 RL 训练的小模型可能在窄任务上更有效,并提出大模型 manager、较小模型 workers 的可能架构。这里应保持证据边界:模型大小只是路由变量之一,还要看质量、时延、成本、隐私、工具使用和上下文需求。
课堂提示
00:57:55–00:59:47,讲者认为“需要更聪明而非只更大”的模型,并提出 large manager + small workers 的可能组合;他同时把 real-world task success 作为 litmus test,而不是按参数量决定。
设任务 \(x\) 可路由到模型 \(m\),一个简单目标是
\(Q\) 是质量,\(L\) 是时延,\(C\) 是成本,\(R\) 是风险。路由器应按任务动态选择,而不是永久绑定“manager 必须最大、worker 必须最小”。
Memory 问题没有单一硬件答案
最后一个问题把 agent memory 类比 RAM、ROM 与 hard drive。讲者没有给出统一架构,而是强调应用不同、组件组合不同。这个保留非常重要:有些任务只需短期 scratchpad,有些需要可编辑用户档案,有些需要事件日志和知识库;把它们都叫“memory”会导致错误共享和过度持久化。
课堂提示
00:59:47–01:00:57,面对 RAM/ROM/disk 类比,讲者明确说没有 straight answer;应根据 coding、chat、actions 等应用寻找合适模型和组件。课堂提示:memory architecture 是产品与风险决定,不是越多越好。
本章小结
部署合同把 Agent 的研究指标转成现实责任:可靠性要结合任务频率,循环要有检测与预算,测试要覆盖领域分布,线上要有 trace、监控、审计和人工接管。局部 RL 可以提高窄域任务,但不能抹去分布偏移;模型大小和 memory 结构都应按任务路由。
总结与延伸
这堂课从 AGI 的抽象形态出发,最终落到一套可执行的系统地图。Agent 的核心不是“模型会调用工具”,而是让目标、状态、动作、权限、评测、学习、记忆、通信和恢复形成闭环。任何一层缺失,都会把能力演示变成不可维护的自动化。
更进一步说,本讲把“模型智能”与“系统可信”明确分开:前者决定候选动作的上限,后者决定哪些动作能进入真实世界。一个更强模型可以减少部分推理错误,却不会自动提供审计、授权、回滚、版本和责任人。学习 Agent 系统时,应始终把模型改进放回完整控制面中评价。
一张表串起整套 Agent stack
| 层次 | 核心问题 | 代表机制 | 失败信号 |
|---|---|---|---|
| Goal | 用户真正要什么 | 约束解析、确认 | 目标漂移、隐含约束丢失 |
| Policy | 下一步做什么 | planning、MCTS、routing | 贪心、循环、越权 |
| Environment | 动作在哪里执行 | browser/API/tools | 页面变化、不可逆动作 |
| Evaluation | 怎样知道做对 | REAL、slice、trace checks | 总分掩盖尾部 |
| Learning | 怎样从轨迹改进 | critique、DPO、RL | 奖励投机、污染数据 |
| Memory | 怎样跨步骤与会话保存状态 | scratchpad、retrieval、profile | 过期、泄露、错误持久化 |
| Coordination | 多个 Agent 怎样合作 | hierarchy、sync、MCP/A2A | 冲突、重复、等待 |
| Deployment | 怎样承担现实责任 | budget、audit、override | 失控、无追踪、无法恢复 |
本讲最重要的压缩
AGI 的产品形态尚未确定,但可靠 Agent 的工程约束已经很清楚:可复现地评、在轨迹上学、按权限行动、带来源记忆、通过协议协作、在失败时停止并交还控制。
开始一个 Agent 项目前的十二问
- 用户目标和完成条件能否机器判定?
- 哪些动作可逆,哪些需要确认?
- Agent 通过 API 还是直接控制界面?
- benchmark 是否覆盖真实网站、任务长度和风险 slice?
- 是否记录完整 observation–action–result trace?
- 失败 taxonomy 能否定位到模型、工具、memory 或 policy?
- 搜索和 self-critique 是否有成本与停止条件?
- preference data 是否同时包含成功和失败分支?
- 长期记忆是否有来源、过期、权限和用户编辑?
- 多 agent 是否真的可并行,还是只增加通信?
- MCP/A2A 之外,身份、授权和版本怎样管理?
- 上线后谁监控、谁接管、怎样回滚?
拓展阅读
- Putta et al., Agent Q: Advanced Reasoning and Learning for Autonomous AI Agents:MCTS、self-critique 与偏好学习。arXiv:2408.07199
- AGI, Inc., REAL: Benchmarking Autonomous Agents on Deterministic Simulations of Real Websites:确定性网页环境与 leaderboard。REAL repository
- Lilian Weng, LLM Powered Autonomous Agents:memory、planning、tools 与 action 的架构综述。article
- Model Context Protocol 官方文档:工具、资源与 prompt 的开放连接协议。official docs
证据边界。 本讲记录的是 2025 年 4 月的课堂内容。REAL、AgentQ、MultiOn、MCP 和当时的模型结果都应按课堂时间点理解;讲义保留它们的机制与工程启示,不把 demo、产品状态或 benchmark 数字改写成 2026 年的当前产品保证。