Lecture 01:Transformer 全景图——从学习范式到下一代架构
从手工特征到自监督:模型究竟在学习什么
这堂 V6 开场课并不把 Transformer 简化成一条 attention 公式。两位讲者先追溯学习信号如何从手工特征、监督标签发展到自监督目标,再把数据、post-training、agent、multimodality、memory、alignment 与替代架构接到同一张系统地图上。读这份讲义时应持续追问三个问题:信息从哪里来,梯度奖励了什么,部署后的系统还增加了哪些模型外机制?
课程承诺:机制、应用与边界必须一起看
开场的 takeaways 把 attention、scaling、跨域应用、frontier speakers 与 open problems 放在同一页。这个顺序定义了讲义的组织原则:先解释机制,再核对证据,最后写清边界。仅知道一个 block 的张量形状,不足以解释模型为何在某个数据集上成功;仅看到成功 demo,也不足以判断它在新分布、长上下文或真实工作流中是否可靠。
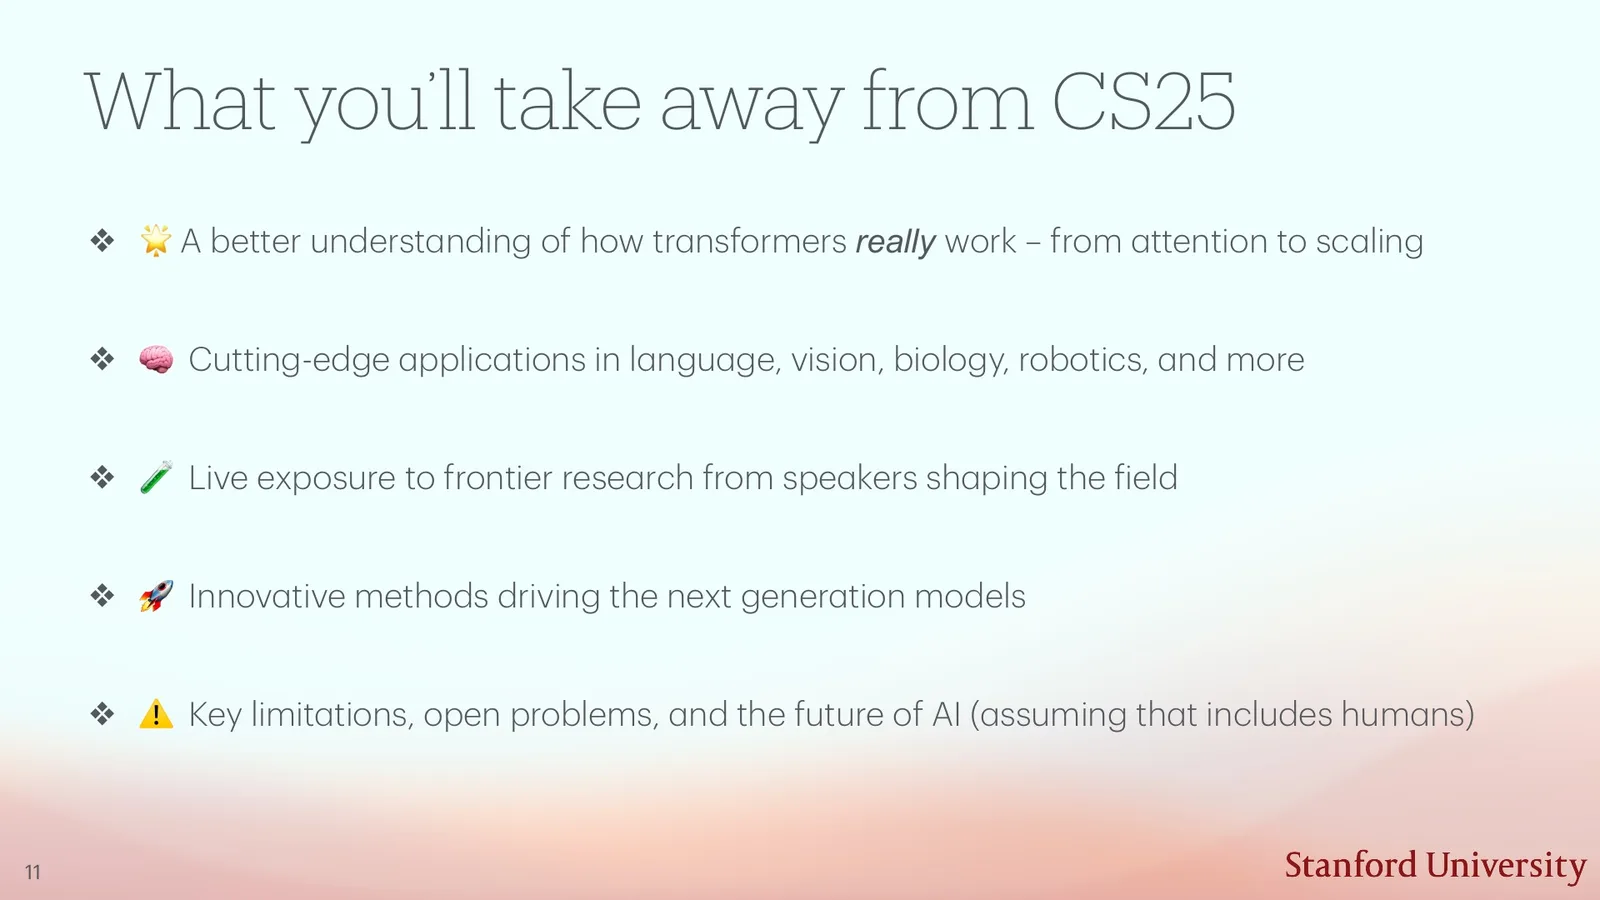
来源:CS25 V6 official deck, p. 11
课堂提示
00:06:12–00:07:10,老师强调课程不只讲 attention,而是要让学生接触前沿应用、关键限制和仍可贡献的开放问题。课堂提示:后文每种方法都应回答“改变了系统的哪一层”。
现代 Transformer 系统的六层接口
- Representation:原始输入如何变成 token 与向量;
- Architecture:信息如何在序列、层和模态之间流动;
- Pretraining:数据分布与目标函数塑造哪些默认能力;
- Post-training:监督、偏好、搜索与 verifier 如何修改行为;
- System loop:检索、工具、memory 与环境反馈怎样进入闭环;
- Governance/evidence:评估、解释、alignment 与部署边界如何定义。
一个新名词若不能落到这些接口之一,通常还没有被真正解释。
三次转变:特征工程、监督表示与自监督表示
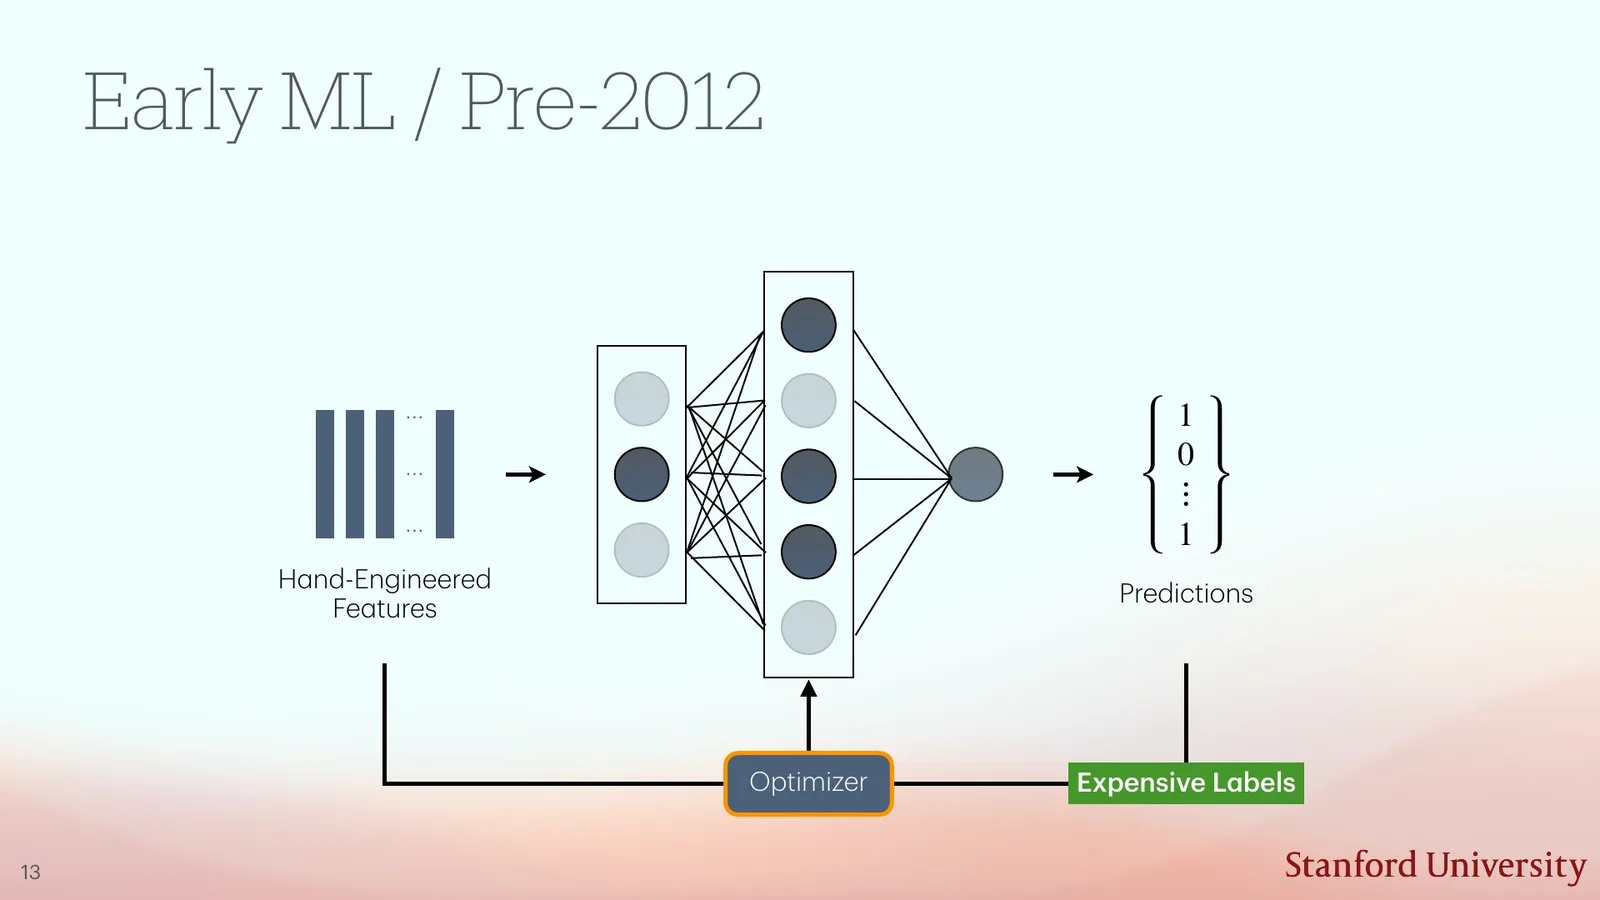
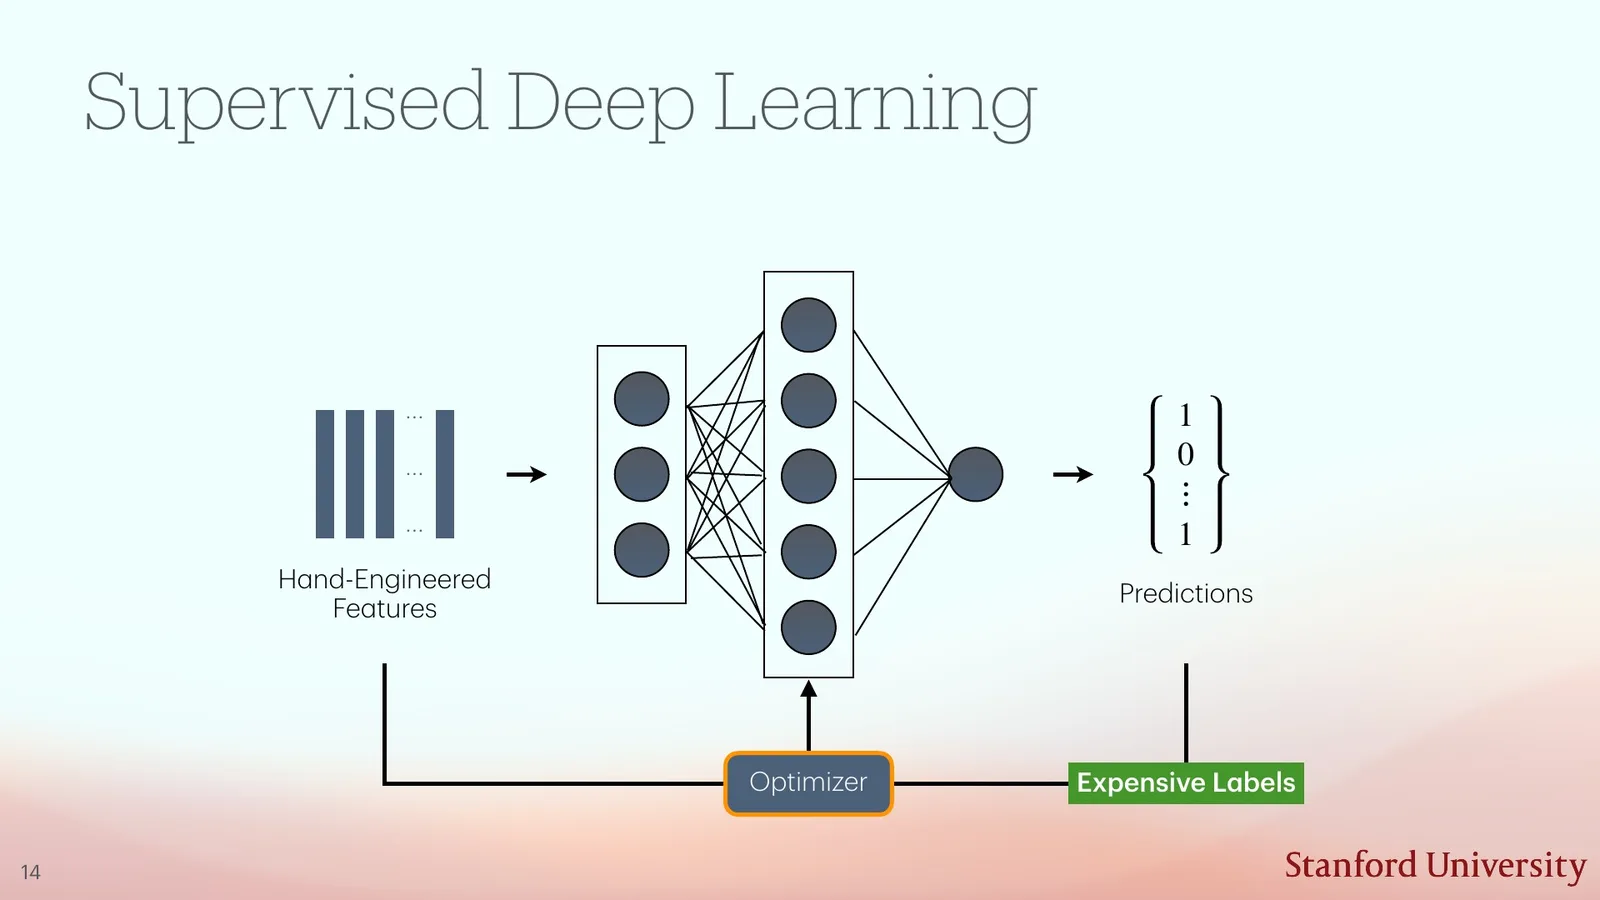
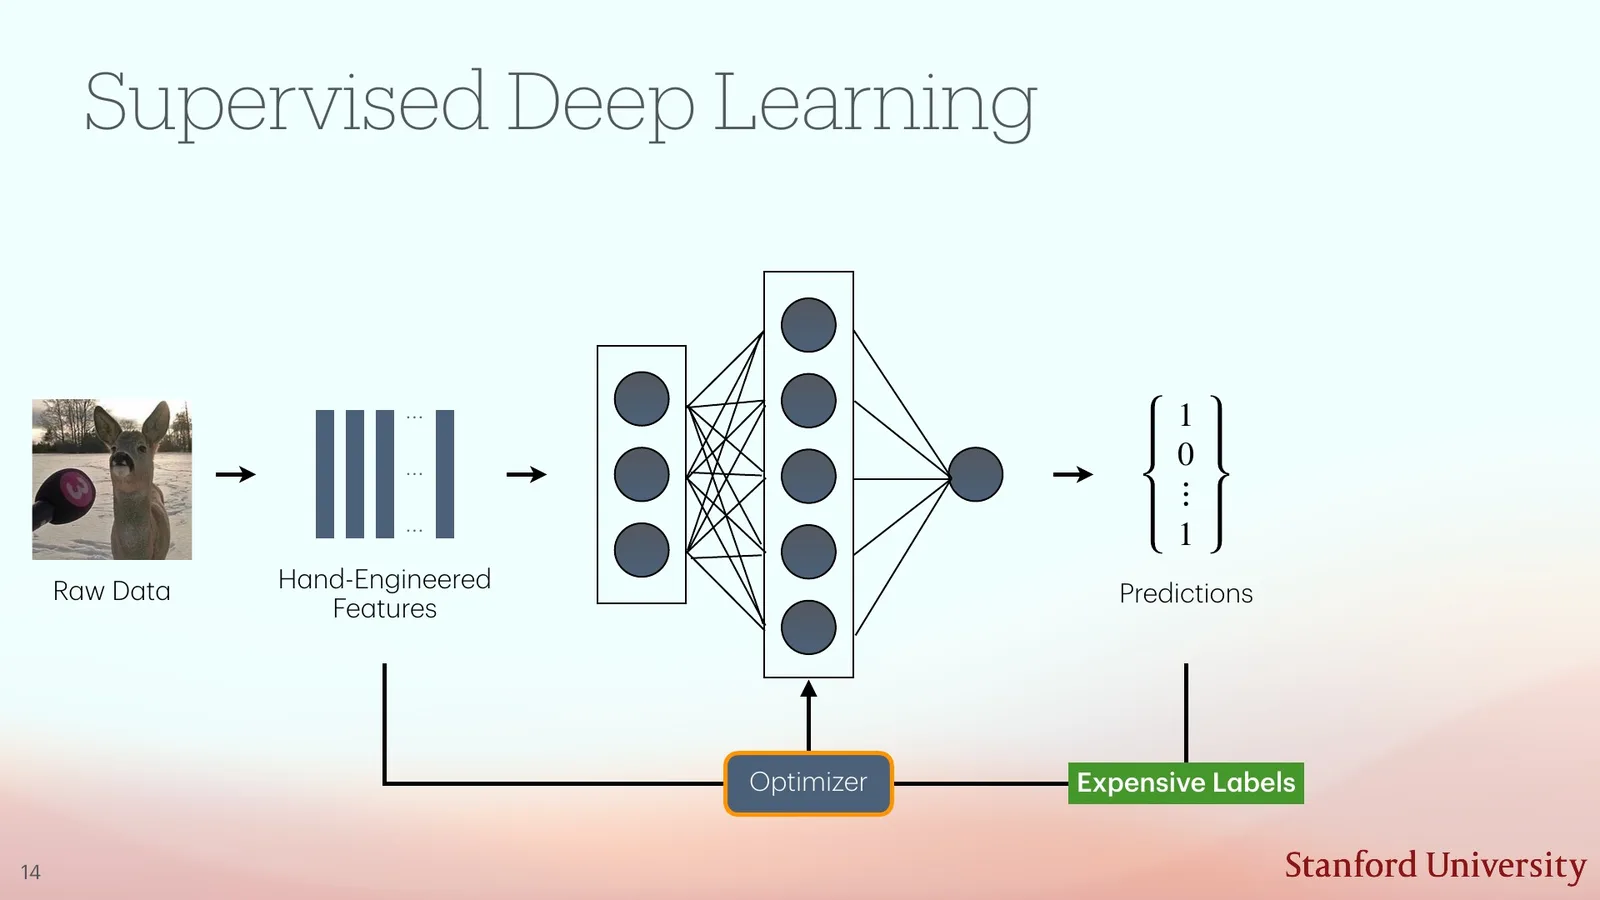
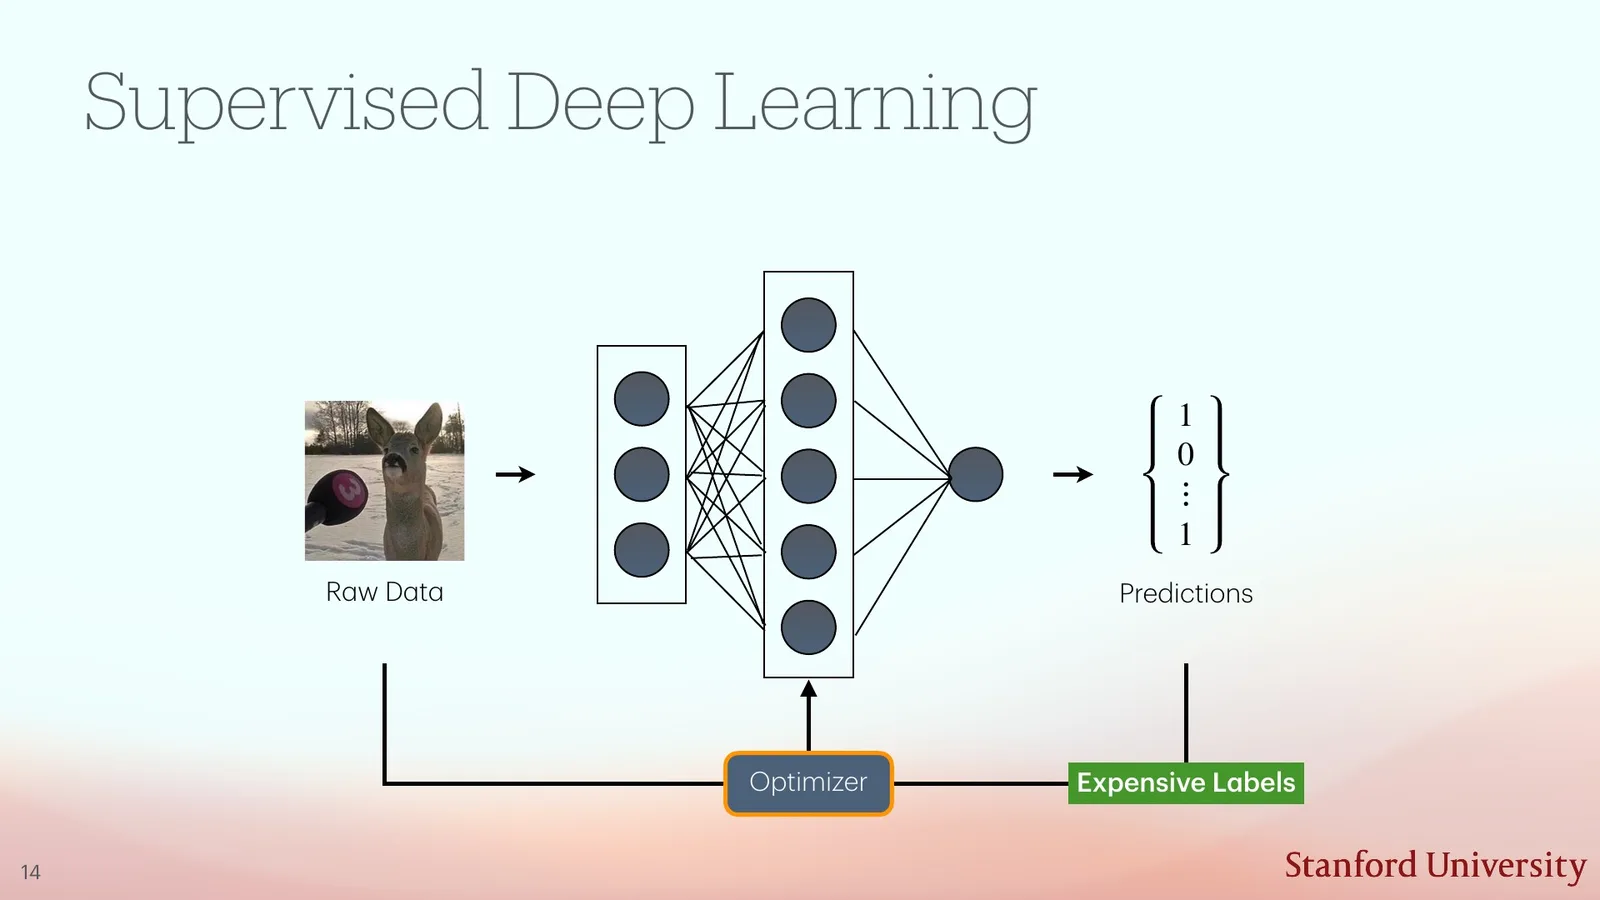
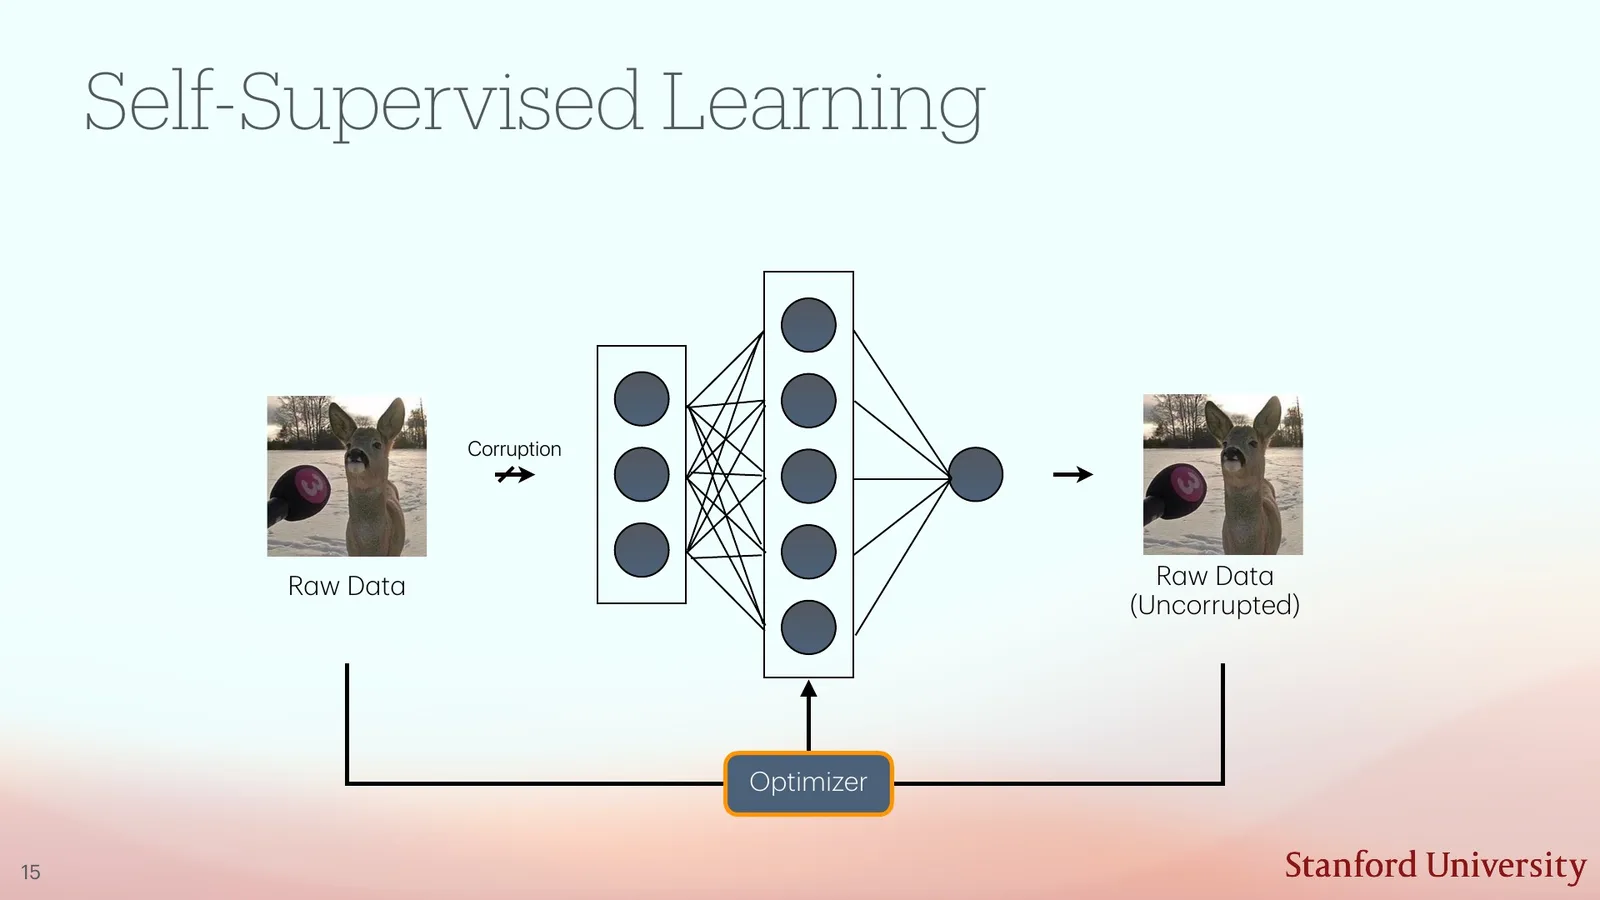
早期机器学习依赖研究者手工设计特征,再由一个相对浅的模型把特征映射到标签。深度学习把表示学习交给网络,但仍要求大量人工标签。自监督学习继续前移监督来源:标签不再来自人工类别,而是从输入自身构造,例如遮住 token、预测下一步、恢复被扰动图像或区分匹配与不匹配的样本。三种范式的关键差别不是“网络深不深”,而是谁定义了学习任务以及模型能看到多少原始结构。
来源:CS25 V6 official deck, p. 13
来源:CS25 V6 official deck, p. 14
从 slide 13 到 slide 16 应按信息瓶颈阅读:手工特征把原始数据压成研究者认为有用的维度,监督网络扩大了可学习表示的范围,而端到端训练进一步减少人为中间接口。代价也随之变化:模型自由度提高,需要更多数据与 compute;如果训练分布带有偏差,网络会把偏差一起学进去。
来源:CS25 V6 official deck, p. 15
来源:CS25 V6 official deck, p. 16
读图:为什么四页渐进图都值得保留
先比较谁在构造 representation,再比较监督信号从哪里来。slide 13 中人类定义特征;slide 14–15 中网络与手工接口共同存在;slide 16 中网络直接消费 raw data。图支持“表示学习接口逐渐内移”,却不证明人工知识没有价值。现代系统仍通过 tokenizer、数据过滤、架构先验、loss 与工具 API 注入大量人为设计。
自监督学习的目标可抽象为从样本 \(x\) 构造可预测部分 \(y=g(x)\) 与可见上下文 \(\tilde{x}=c(x)\),然后优化
\(g\) 表示构造目标的规则,例如下一 token 或被遮蔽 patch;\(c\) 表示保留给模型的上下文;\(\theta\) 是参数。监督虽然“来自数据本身”,但 \(g\) 与 \(c\) 仍决定模型被鼓励保留什么信息。
来源:CS25 V6 official deck, p. 17
课堂提示
00:07:10–00:08:13,讲者把历史主线概括为 hand-engineered features、supervised representation learning 与 self-supervision。老师强调自监督减少人工标签,却没有消除 objective 所带来的 inductive bias。
“没有人工标签”不等于“没有人为假设”
遮蔽比例、预测方向、负样本、数据增强和窗口长度都会改变可学习信号。若增强破坏了任务相关因素,contrastive model 会被奖励去忽略真正有用的信息;若 next-token 数据充满模板与重复,模型会优先学习高频形式。自监督是标签构造方式,不是价值中立的自然规律。
从 information bottleneck 的角度看,objective 决定哪些信息值得保留。情感分类只需要保留与标签相关的方向,可能主动丢弃实体、时序和语法细节;重建目标需要保留更多局部信息,却可能把大量像素噪声也编码进去;next-token prediction 要压缩对未来 token 有帮助的统计规律,但对不会改变 token 概率的真实世界状态没有直接奖励。评估 representation 时因此不能只看一个 downstream score,而应检查线性 probe、few-shot transfer、distribution shift 与可干预性。一个表示在分类上好,不代表它适合规划;一个生成模型能重建细节,也不代表其 latent 已经抽象出对象和因果关系。
语言与视觉案例:预测目标决定表示的颗粒度
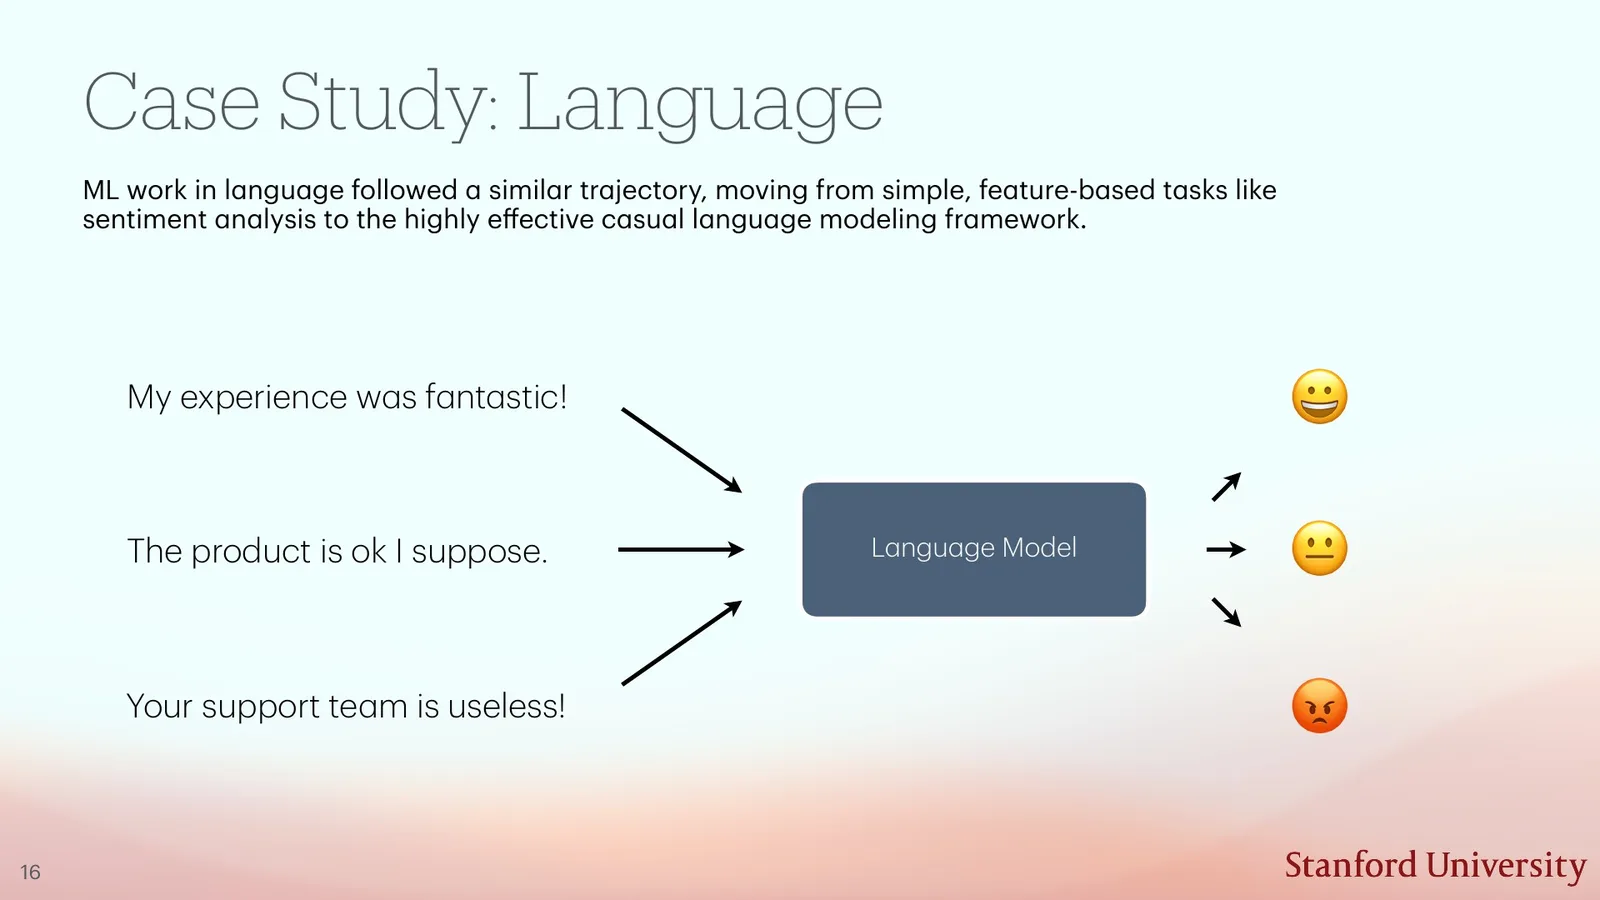
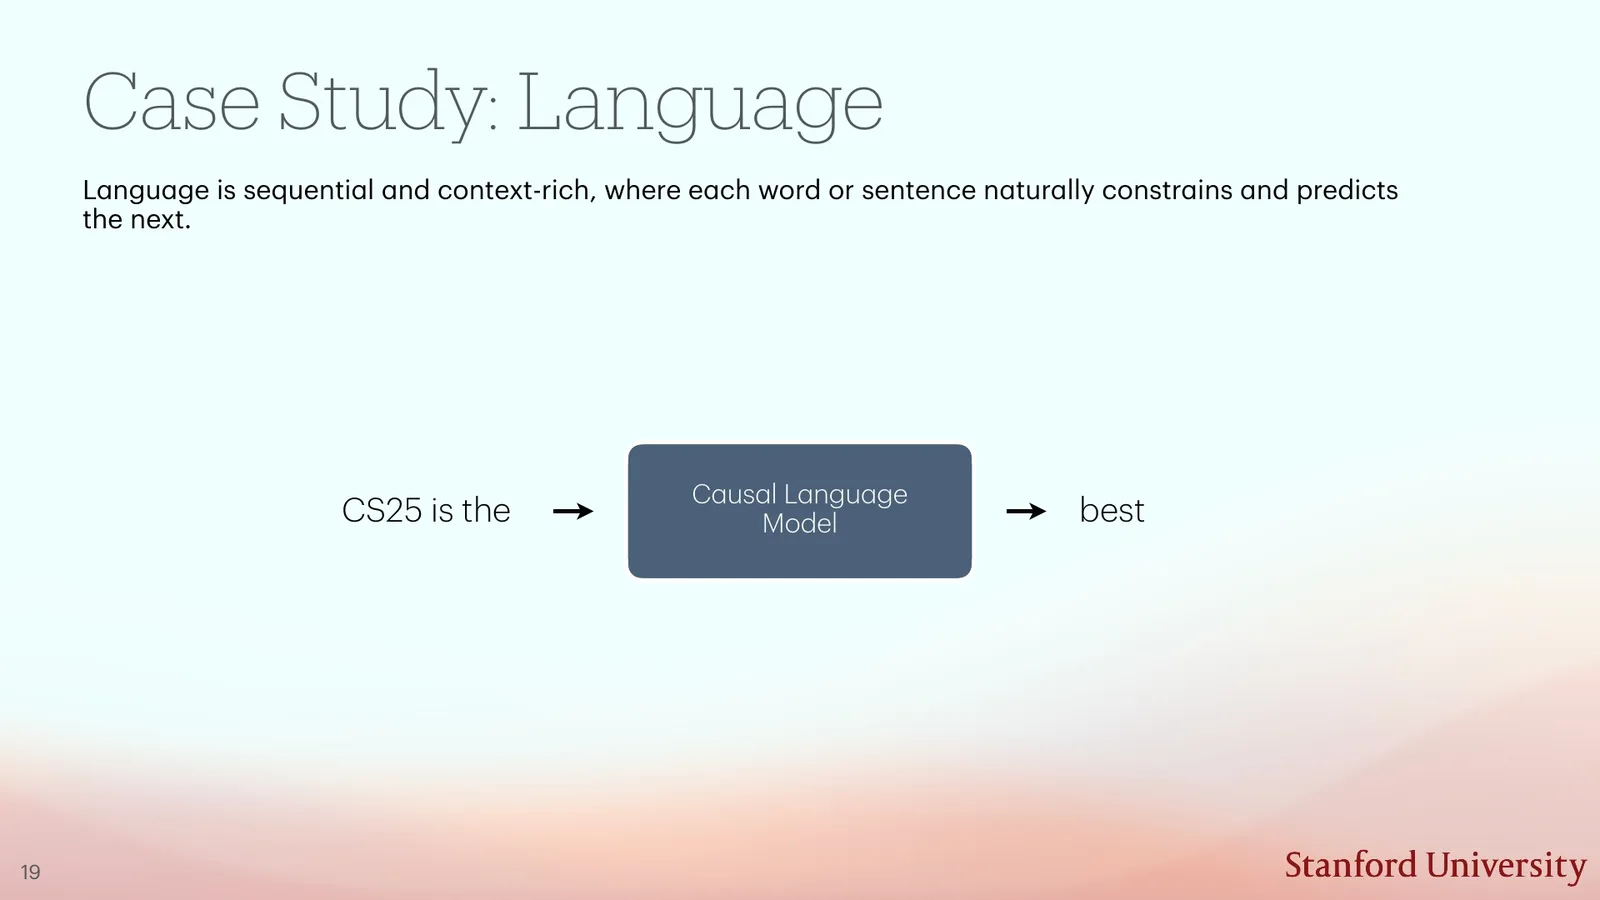
语言案例从情感分类转向 next-token prediction。前者只要求把一段话压成少数标签,后者要求在每个位置预测条件分布,因此监督更密集。设 token 序列为 \(x_{1:T}\),自回归语言模型优化
\(x_t\) 是第 \(t\) 个 token,\(x_{< t}\) 是历史上下文。每个位置都贡献损失,但目标仍只要求预测观测序列,并不直接要求模型给出事实来源、执行工具或维护长期记忆。
来源:CS25 V6 official deck, p. 18
来源:CS25 V6 official deck, p. 20
课堂提示
00:08:13–00:09:57,老师用 sentiment classification 对比 language modeling:分类只提供一个低带宽标签,而序列预测在每个位置产生监督。实践经验:监督更密集不代表目标自动覆盖事实性与因果性。
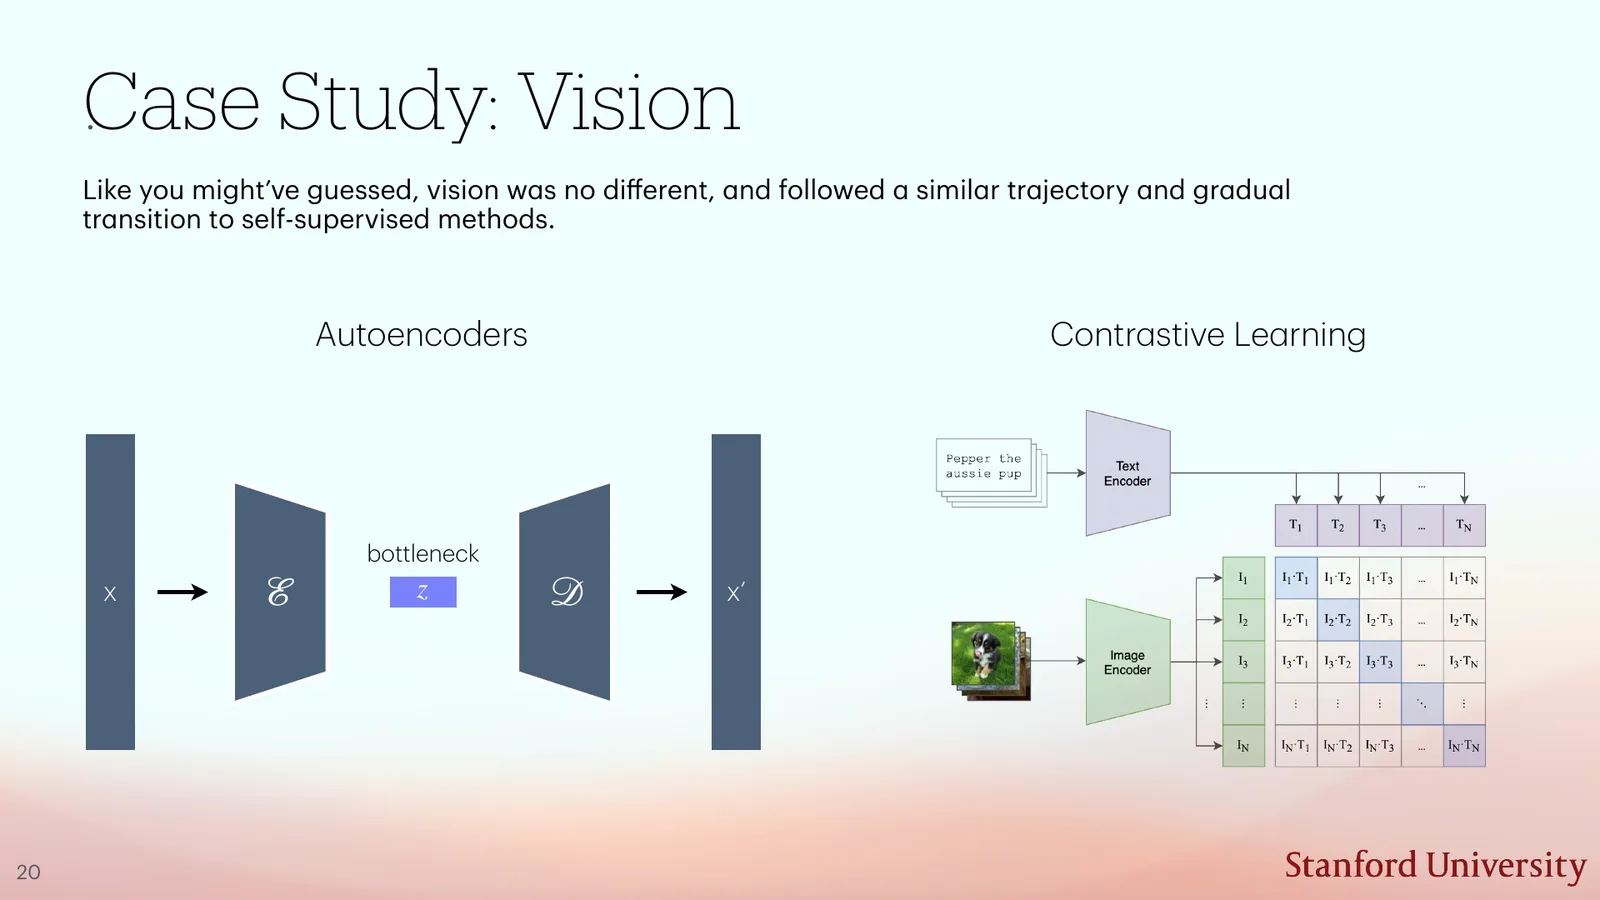
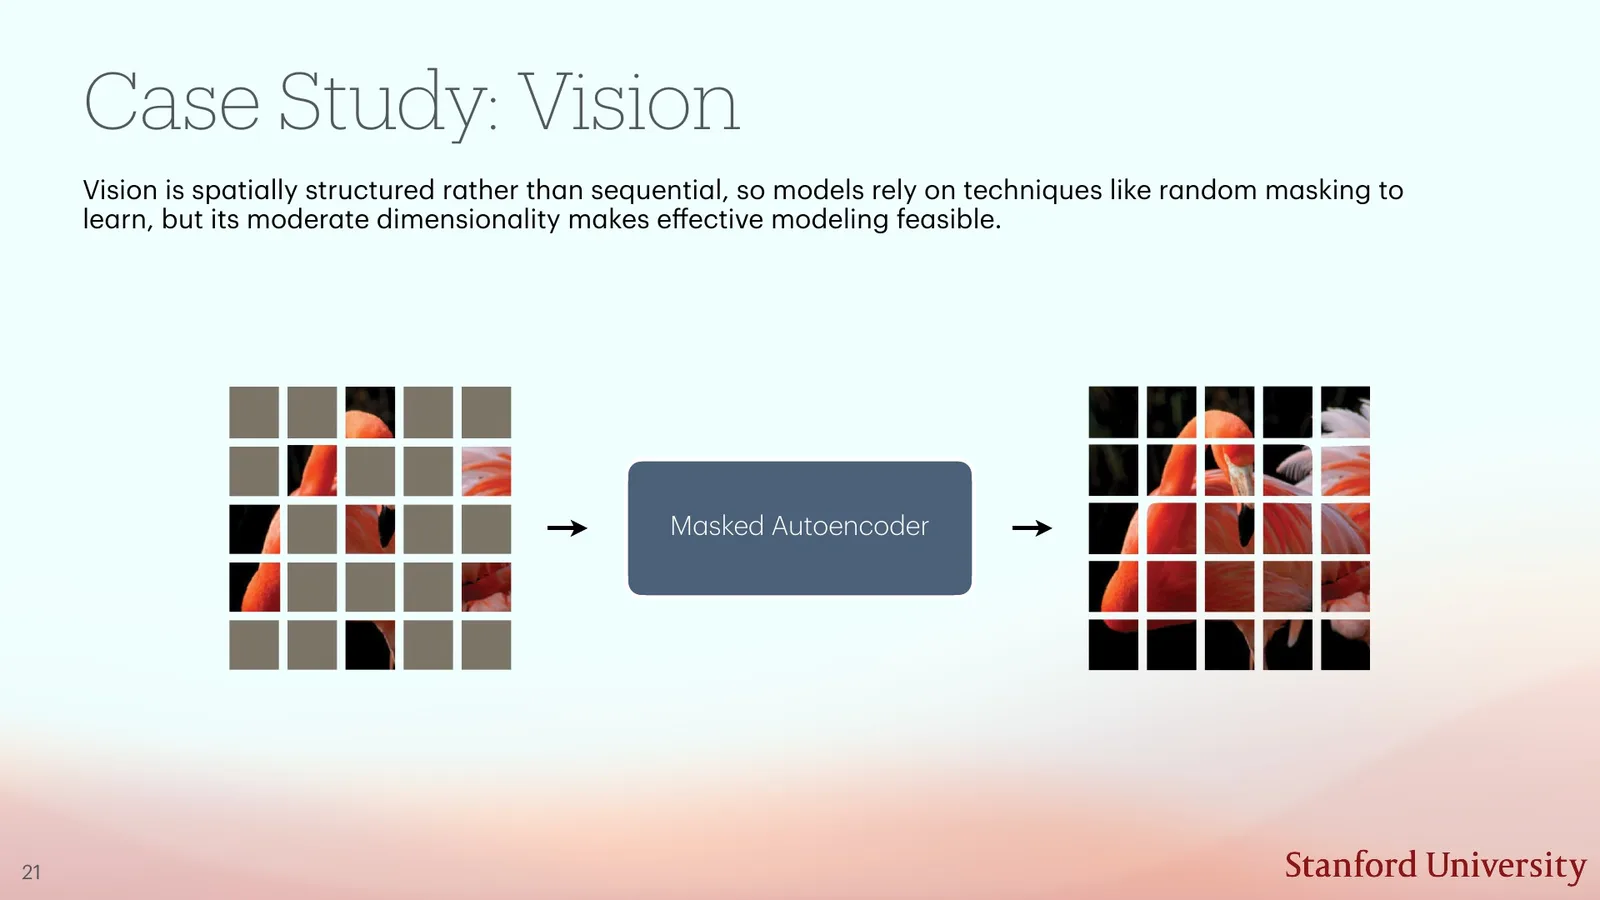
视觉自监督通常在 reconstruction 与 contrastive learning 之间选择。重建目标要求 decoder 恢复输入,容易保留像素细节;contrastive objective 则让同一对象的增强视图靠近、不同样本远离,更强调不变表示。一个简化的 InfoNCE loss 是
\(z_i\) 是 anchor 表示,\(z_i^+\) 是正样本,\(z_j\) 是候选样本,\(\tau\) 是温度。关键不是记住公式,而是理解正负样本定义决定了模型被要求忽略哪些变化。
来源:CS25 V6 official deck, p. 21
来源:CS25 V6 official deck, p. 22
读图:reconstruction 与 contrastive 的证据边界
先看输出空间:重建模型预测输入细节,contrastive model 预测样本关系。再看 invariance:后者会主动压掉增强中被视为“不重要”的变化。图支持两类 representation objective 的差异,却不能单凭示意图断言哪种目标普遍更好;下游任务、数据规模、augmentations 和 decoder 容量都会改变结论。
本章小结
学习范式的演化可以压缩为“监督接口不断内移”:先由人类造特征,再由网络学表示,最后由数据自身生成密集目标。但任何目标都只奖励特定统计规律。理解 Transformer 之前,必须先理解它接收的是 token、优化的是条件预测,而非自动获得事实、行动与长期一致性。
Embedding、RNN 与 Transformer:序列信息怎样流动
上一章说明监督信号来自哪里,本章进入计算机制。序列模型必须解决三件事:把离散符号放进连续空间,让不同位置交换信息,并保留顺序。Embedding 解决第一件事,RNN 用递归状态解决后两件事,Transformer 则用 attention 和 positional information 重新组织信息流。
从 token 到向量:静态表示与上下文表示
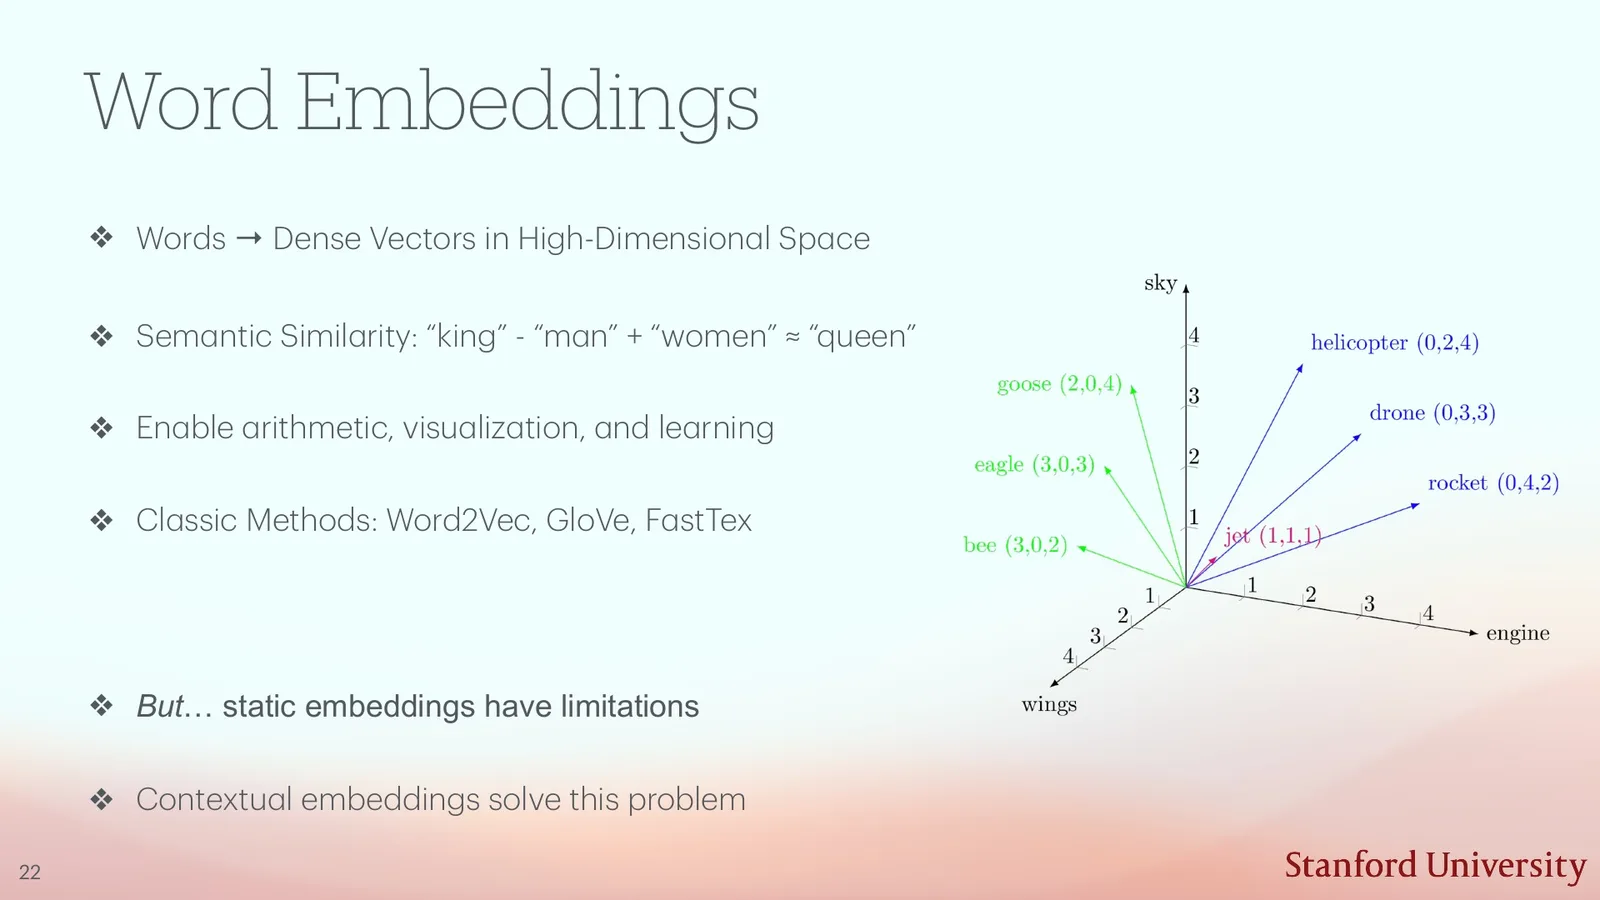
设词表大小为 \(|V|\),隐藏维度为 \(d\),embedding table 为 \(E\in\mathbb{R}^{|V|\times d}\)。token id \(x_i\) 的初始向量为
Tokenization 先把字符串切成词、子词或字节 token;embedding 再把离散 id 映射为可训练向量。静态 embedding 对同一 token 使用同一向量,contextual representation 则在后续层根据上下文不断更新,因此多义词可以分离。
来源:CS25 V6 official deck, p. 23
课堂提示
00:10:14–00:11:31,老师先用“模型只处理数字”解释 embedding 的必要性,再指出同一个词在不同上下文只用一个向量的局限。课堂提示:contextualization 发生在后续序列交互,不是 tokenizer 本身完成的。
首次使用:token、embedding 与 contextual state
Token 是离散序列单位;embedding 是 token 的初始可学习向量;contextual state 是经过多层 attention/MLP 后、已经混入上下文的信息状态。三者分别对应分词边界、参数查表和动态计算,不能混为一谈。
RNN:把过去压进一个递归状态
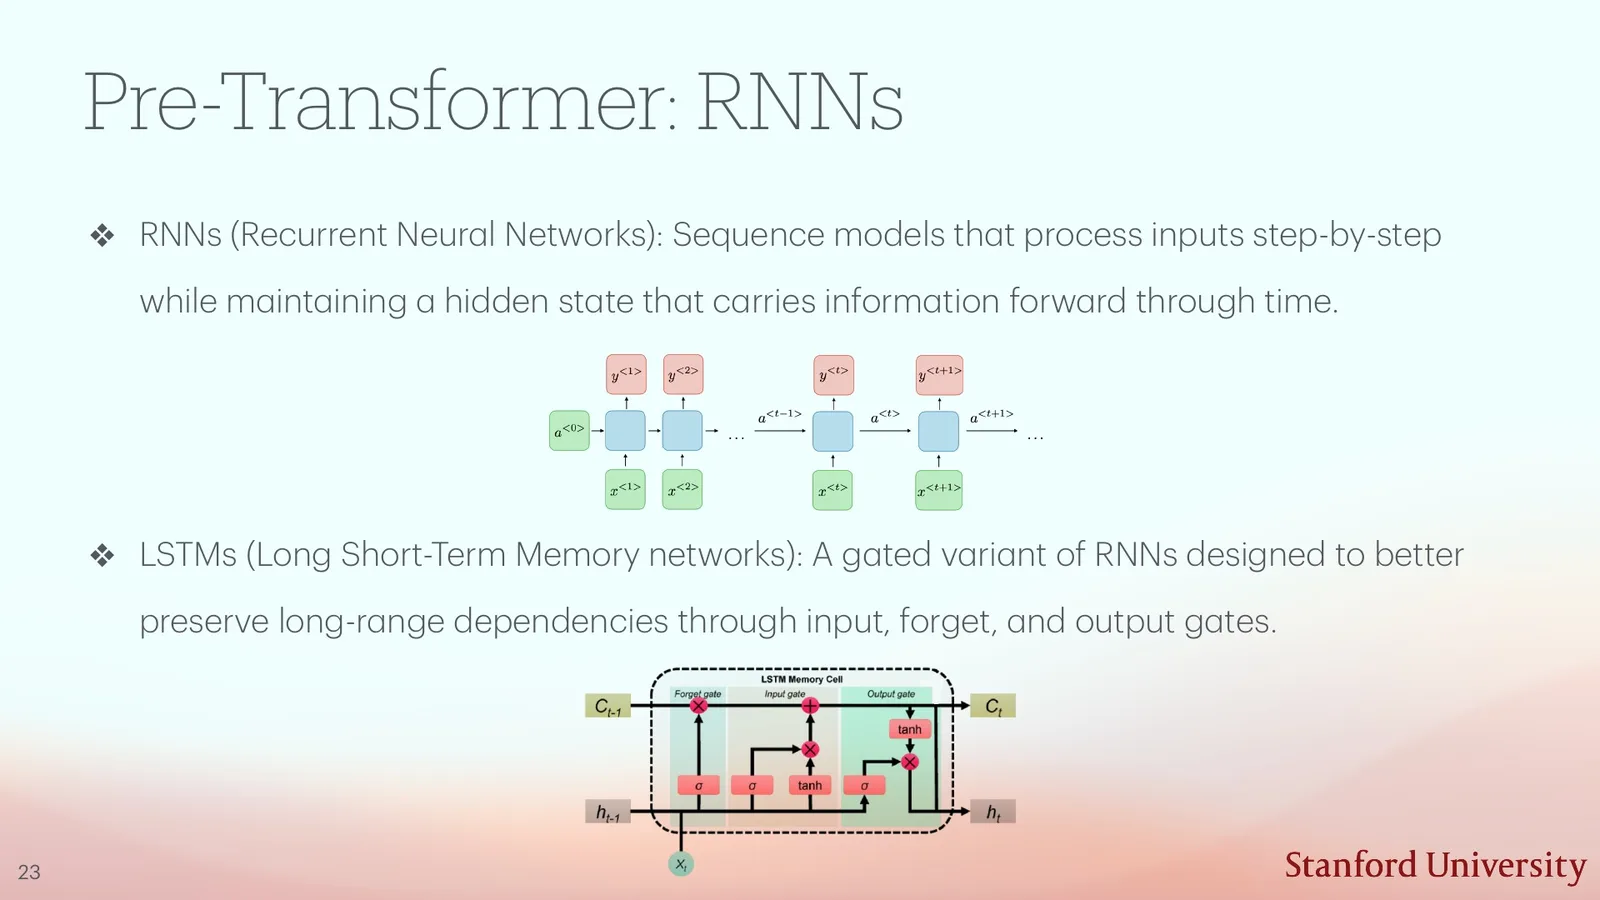
Recurrent Neural Network(RNN,循环神经网络)按时间步更新隐藏状态:
\(x_t\) 是当前输入,\(h_{t-1}\) 是历史压缩,\(W_x,W_h,W_o\) 是参数,\(\phi\) 是非线性。LSTM 通过门控缓解梯度消失,但每一步仍依赖前一步,训练难以完全并行,远距离信息也必须穿过较长路径。
来源:CS25 V6 official deck, p. 24
课堂提示
00:11:31–00:12:19,老师没有把 RNN 写成“失败架构”,而是强调其顺序归纳偏置与 step-by-step dependency。它适合流式状态,却难以利用大规模并行训练。
递归状态不是无限记忆
\(h_t\) 的维度固定,历史信息必须被压缩。即使 LSTM 能改善梯度传播,也不意味着任意早期细节都可无损保留。长序列中的遗忘、覆盖和 credit assignment 是结构问题,不只是调大 hidden size 的工程问题。
Self-attention:把序列交互改写成软检索
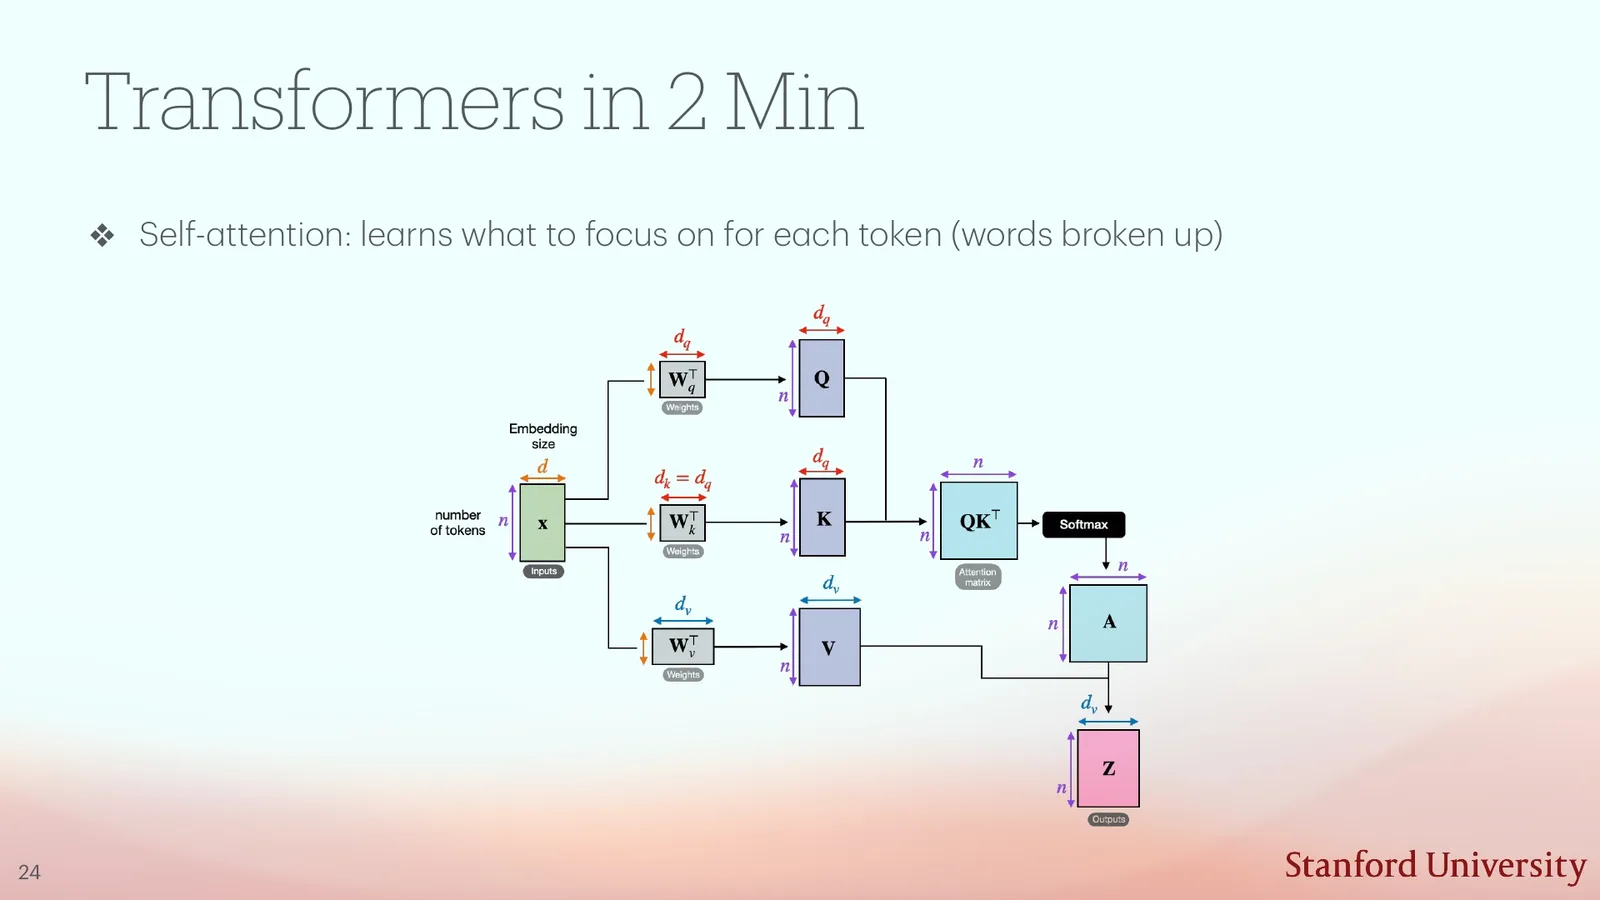
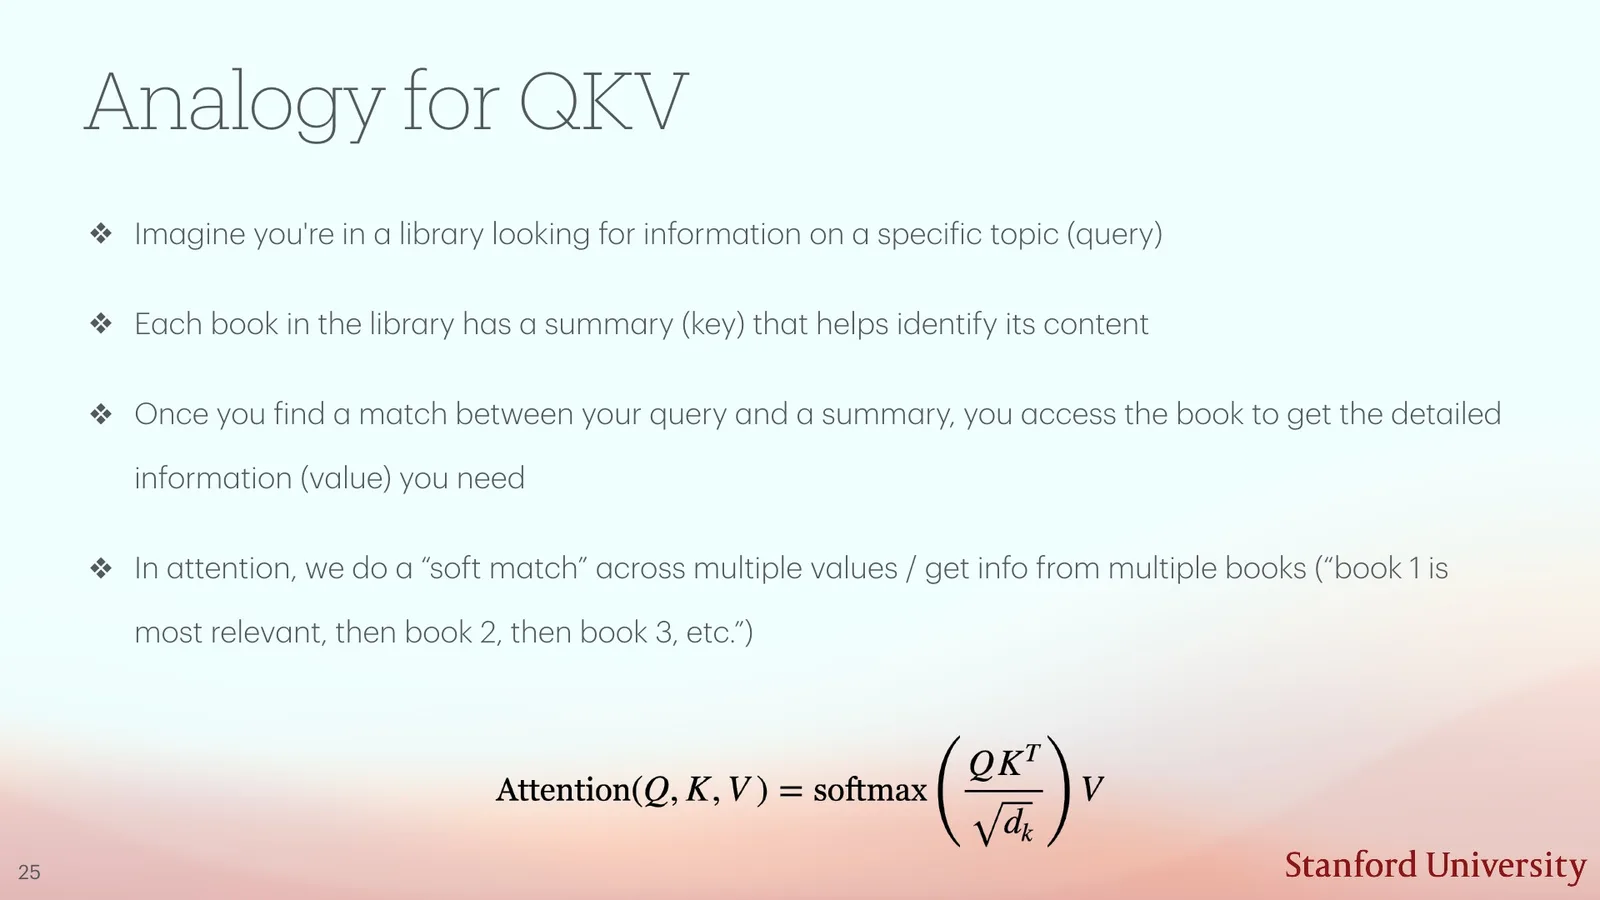
上一小节的 RNN 把所有历史压进单一递归状态;本节改问:能否让当前位置直接访问整段序列,而不必让信息逐步穿过 \(h_{t-1},h_{t-2},\ldots\)?Self-attention 的答案是建立一个内容寻址矩阵。读下面公式时先看 score 如何产生,再看 value 如何被加权;softmax 权重只是当前层的路由,不是永久知识库。
给定输入矩阵 \(X\in\mathbb{R}^{n\times d}\),模型学习
并计算
\(Q\) 表示当前位置的查询,\(K\) 表示可匹配的索引,\(V\) 表示真正聚合的内容,\(d_k\) 是 key 维度。除以 \(\sqrt{d_k}\) 用于控制点积尺度,使 softmax 不至于过早饱和。
来源:CS25 V6 official deck, p. 25
来源:CS25 V6 official deck, p. 26
课堂提示
00:12:19–00:14:20,老师用图书馆解释 QKV:query 是想找的内容,key 是书的摘要或索引,value 才是取回的信息。讲义提醒:Q/K/V 是同一输入的不同线性投影,不是三份独立数据库。
def attention(x, Wq, Wk, Wv):
    q = x @ Wq
    k = x @ Wk
    v = x @ Wv
    score = q @ k.T / sqrt(k.shape[-1])
    weight = softmax(score, axis=-1)
    return weight @ v
Tokenization、位置与多头:同一 block 的三个接口
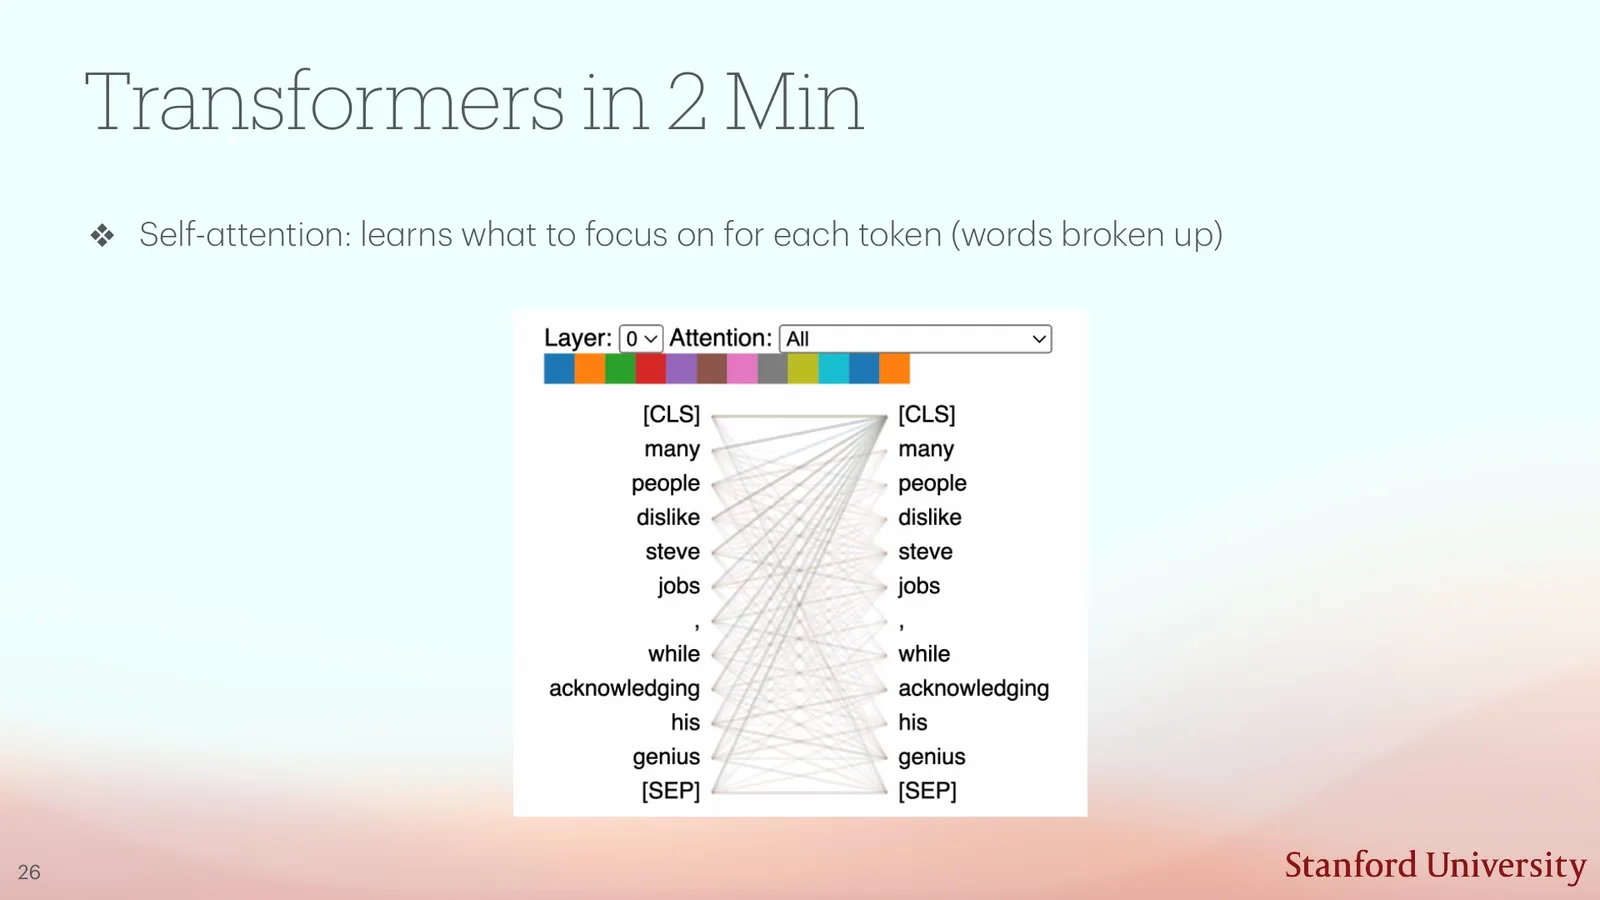
Attention 本身只看到向量集合。模型还需要 tokenizer 决定序列粒度、positional encoding 注入顺序、多头结构让不同子空间并行建立关系。若原始文本被切成 \(n\) 个 token,标准 self-attention 的 score matrix 为 \(n\times n\),计算与显存大致随 \(n^2\) 增长;这也是长上下文系统的核心成本来源之一。
来源:CS25 V6 official deck, p. 27
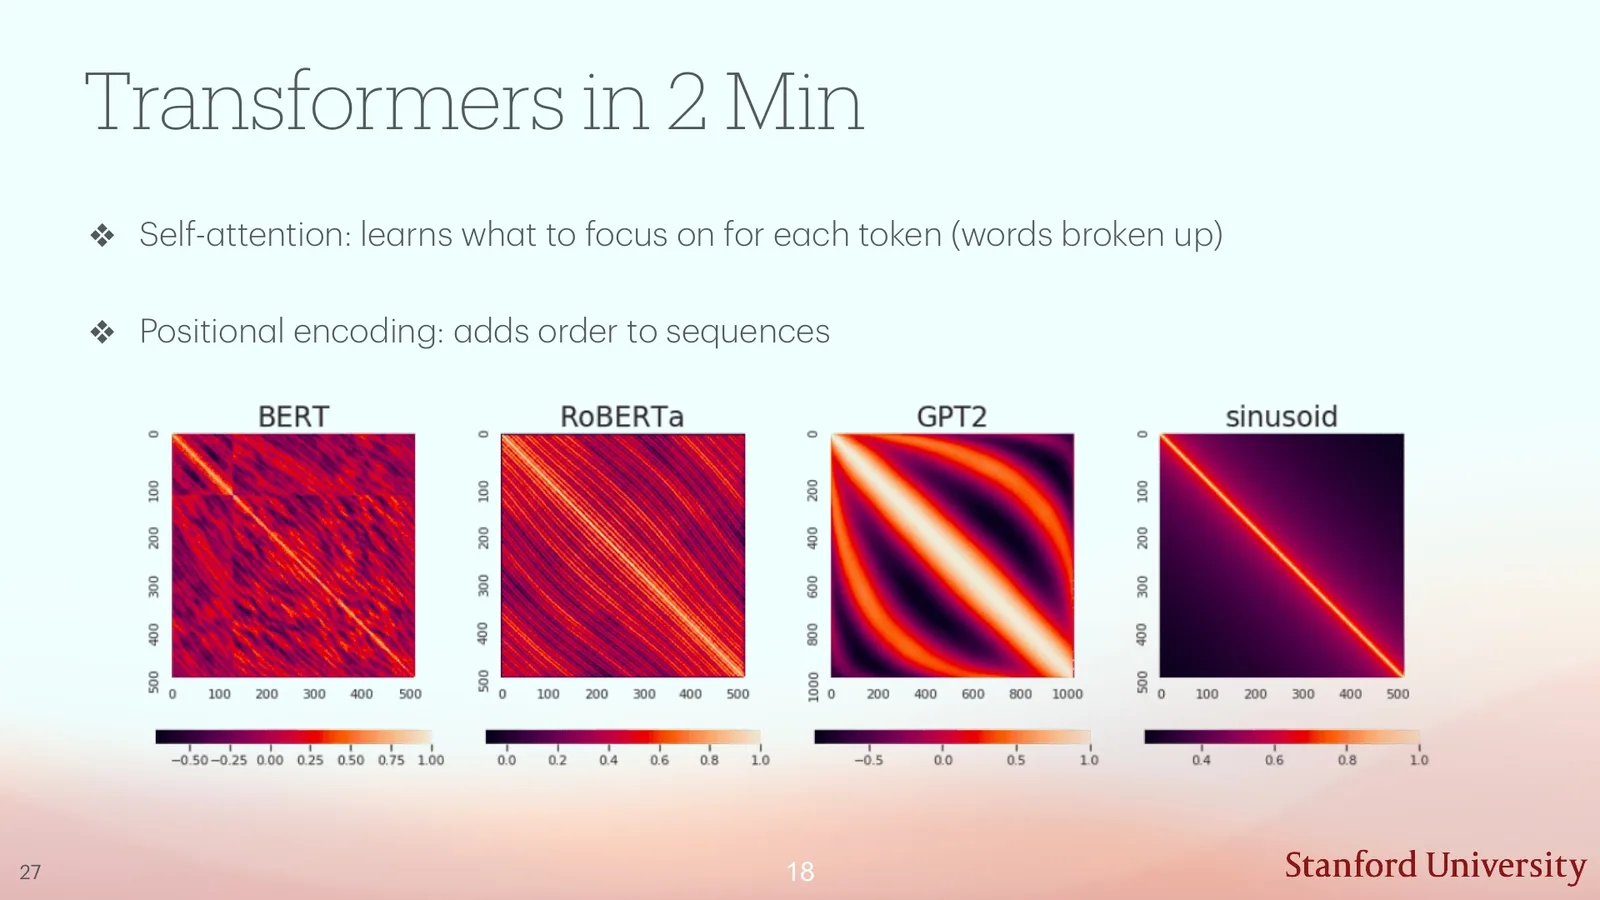
来源:CS25 V6 official deck, p. 28
位置向量可写成 \(p_i\),初始状态为 \(z_i^{(0)}=e_i+p_i\)。经典 sinusoidal encoding 使用不同频率:
\(i\) 是位置,\(k\) 是频率索引,\(d\) 是维度。现代模型还会使用 RoPE、ALiBi 或相对位置机制,但共同目标都是让交互权重感知相对或绝对顺序。
Multi-head attention 将通道分成多个头:
\(h\) 是头数,每个头拥有独立投影,\(W_O\) 负责重新混合。头并不天然对应可命名语法关系;它们只是提供多组并行交互子空间。
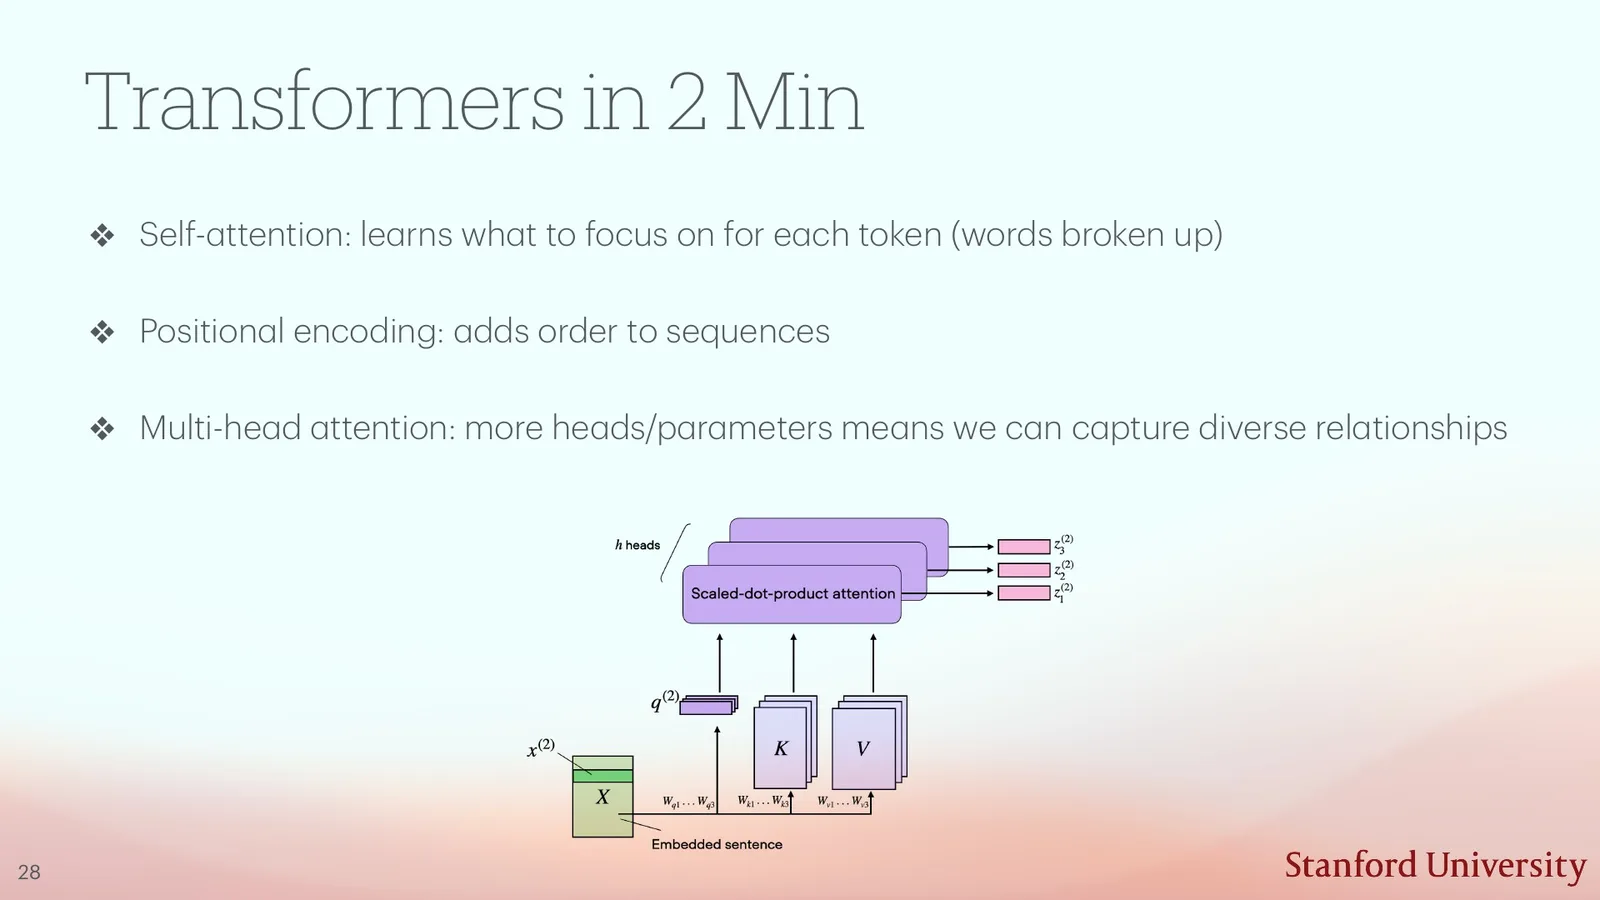
来源:CS25 V6 official deck, p. 29
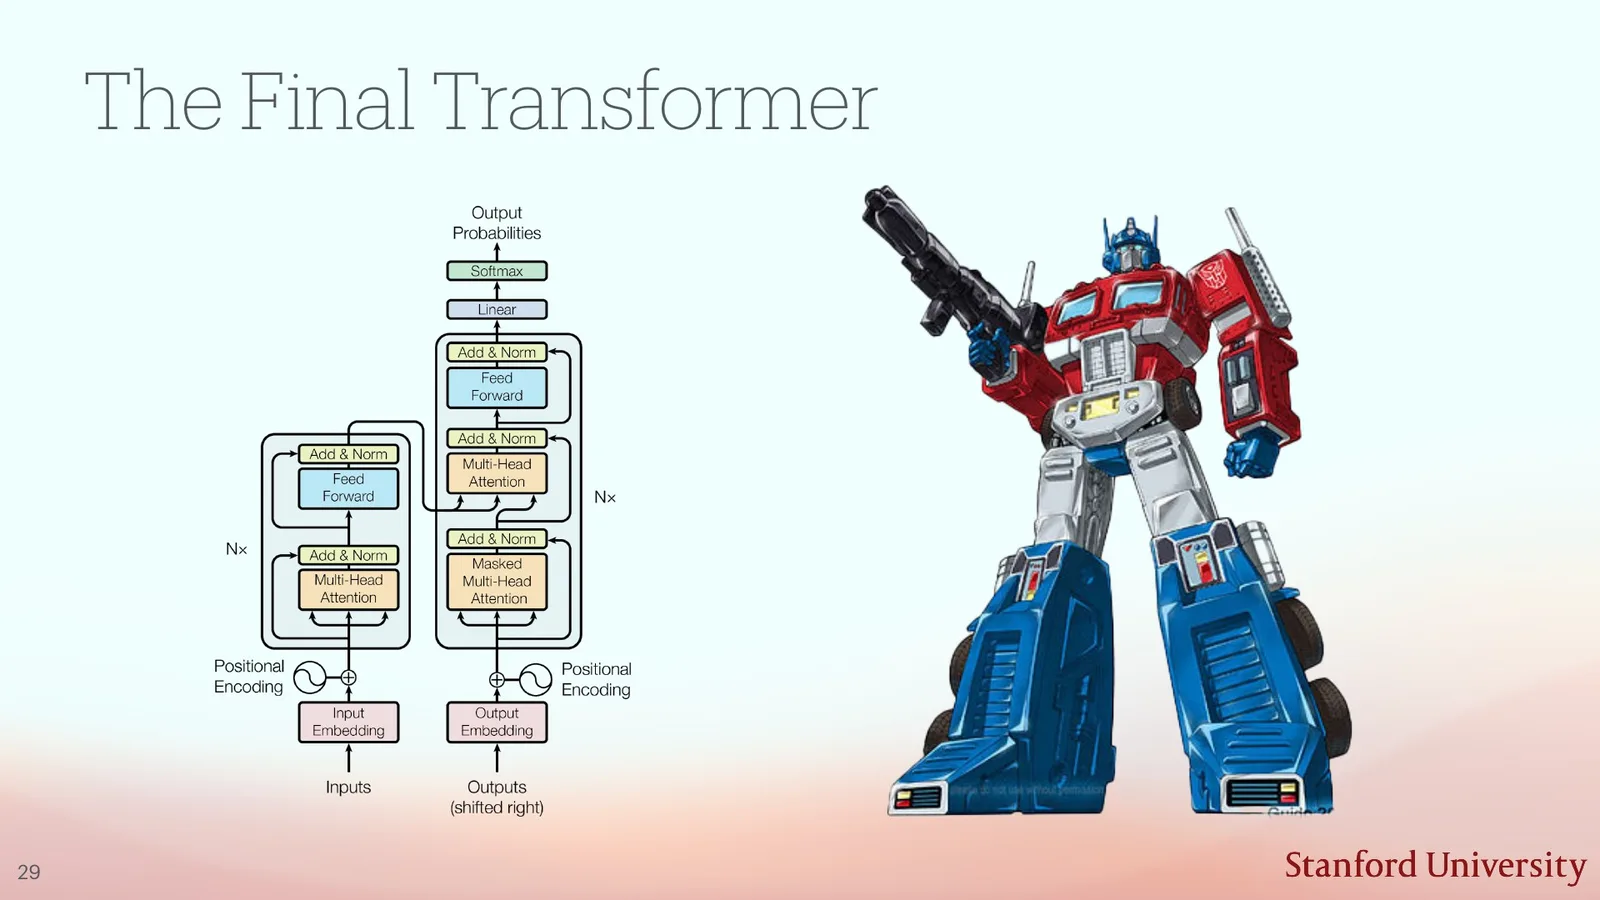
来源:CS25 V6 official deck, p. 30
读图:从组件表到信息流
先沿 residual stream 读主干,再看 attention 如何跨 token 交换信息,MLP 如何逐位置变换通道,LayerNorm 如何稳定尺度。图中每个 block 都不是“理解模块”;能力来自大量层、训练数据和目标共同形成的表示。一个 head 的可视化只能提供局部相关性线索,不能自动构成因果解释。
为什么 Transformer 取代 RNN,又为什么问题没有结束
Transformer 的优势来自短路径和并行计算:任意两个 token 在一层 attention 中即可交互,训练时可同时处理所有位置。RNN 的每步成本较小且天然流式,但长距离依赖要经过多次递归。若隐藏维度为 \(d\)、长度为 \(n\),attention 交互约为 \(O(n^2d)\),逐位置投影/MLP 约为 \(O(nd^2)\);实际瓶颈取决于 \(n\)、\(d\)、batch 与硬件。
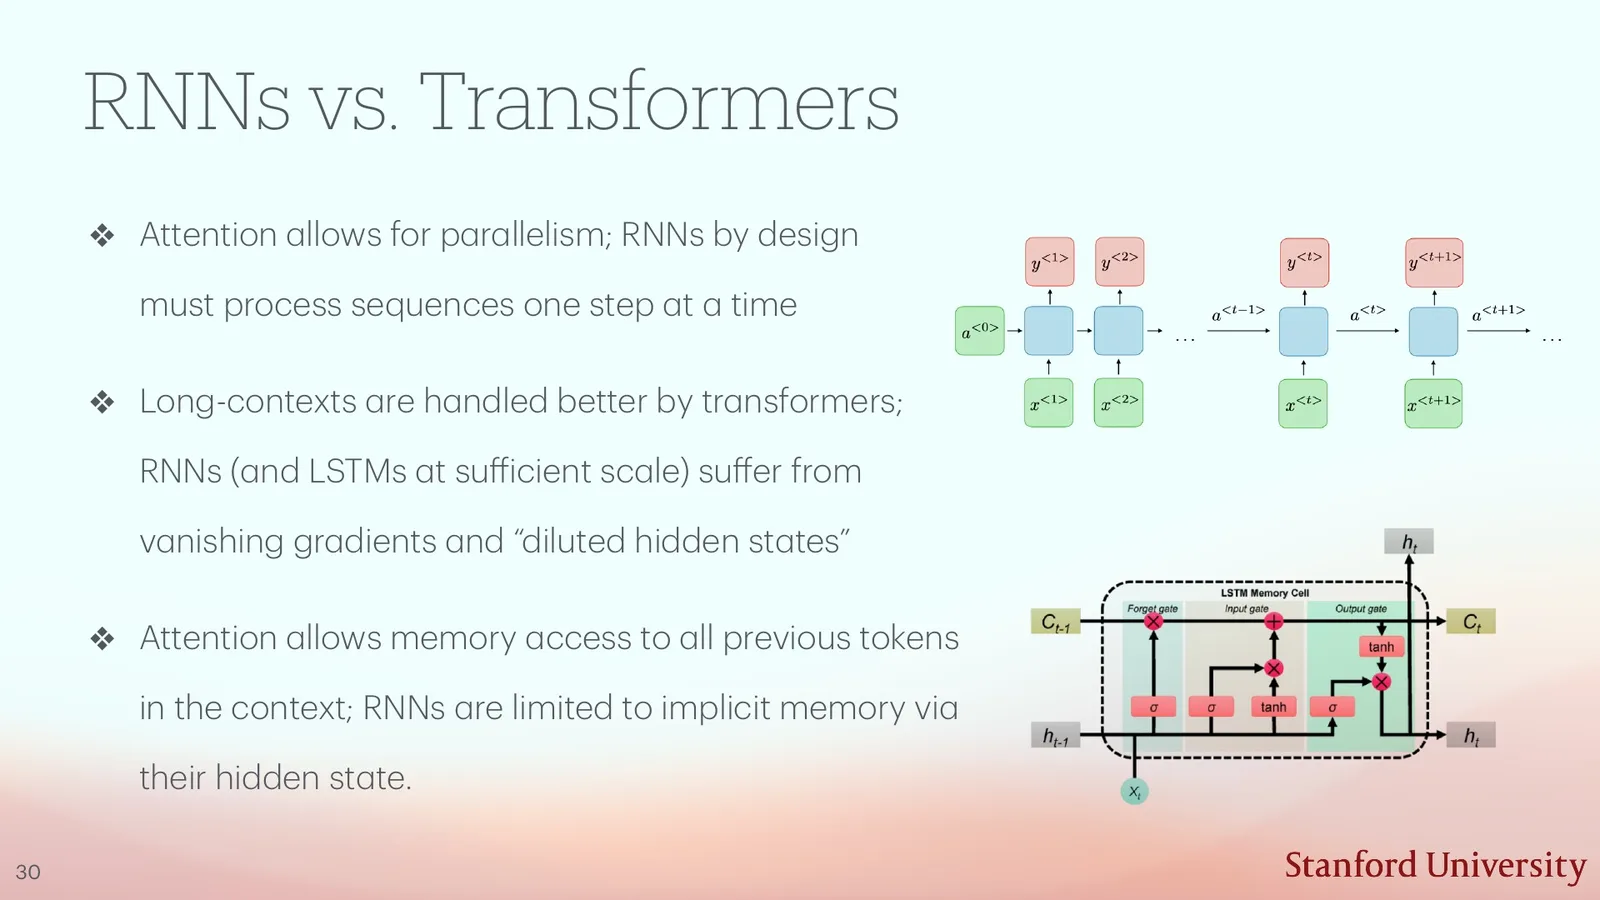
来源:CS25 V6 official deck, p. 31
来源:CS25 V6 official deck, p. 32
来源:CS25 V6 official deck, p. 33
课堂提示
00:14:20–00:16:20,老师把成功归因于并行训练、长依赖建模和统一 token 接口,同时指出 quadratic attention 与 long-context reasoning 仍是限制。课堂提示:dominant architecture 不等于 Pareto frontier 在所有 workload 上都最优。
“Transformer 今天无处不在”的正确解释
统一序列接口让文本、图像 patch、音频帧、蛋白质 residue 和动作 token 能共享相似 backbone;成熟的训练基础设施又降低了跨领域复制成本。但每个模态仍需要专门的 tokenizer/encoder、数据配方、loss、评估与 serving 约束。共享 block 不等于问题已经同质化。
从资源核算看,Transformer 的优势和代价来自同一件事:显式建立 token-to-token 交互。训练中必须保存或重算 activation,推理中自回归模型通常保存 KV cache;序列增长会同时增加 score computation、cache capacity 与 memory bandwidth 压力。较短序列、较大隐藏维度时,MLP 和 projection 可能占主要 FLOPs;超长序列或多模态 token 很多时,attention 与 KV cache 会迅速主导。工程上不能只说“attention 是 \(O(n^2)\)”,还要给出 batch、head、dtype、prefill/decode 阶段和硬件带宽。后文 RAG、agent 与视频模型之所以昂贵,往往不是模型参数突然增多,而是它们把更多 evidence、history 和 observation 放进 context。
这里还要区分训练并行与推理状态。训练时整段序列已知,可以一次构造 \(Q,K,V\) 并做矩阵乘;自回归 decode 时每一步只新增一个 query,却要读取此前所有 key/value。KV cache 避免重复计算历史 token,但将 compute 问题部分转成显存容量与带宽问题。Multi-Query/Grouped-Query Attention 通过让多个 query head 共享较少的 K/V head 减少 cache;windowed 或 sparse attention 通过限制可访问位置降低成本;二者都可能牺牲细粒度长程访问。系统设计因此是在质量、随机访问、带宽和 latency 之间做折中,而不是简单选择“完整 attention 或不要 attention”。
本章小结
Embedding 把 token 放入连续空间,RNN 用递归状态传递历史,Transformer 用 QKV 软检索、位置机制和多头交互重写了序列信息流。它的可扩展性来自并行矩阵计算与统一接口,而它的限制来自二次交互、上下文执行、数据与系统约束。下一章转向决定梯度内容的另一半:pretraining data strategy。
Pretraining data:规模之外还有来源、顺序与外部记忆
上一章解释了模型如何计算,本章追问梯度究竟来自什么分布。对训练数据分布 \(q(x)\),模型实际优化
改变 \(q\) 就改变模型反复看到的事实、语言、风格与推理模式。Token 数只是一个维度;质量、覆盖、重复率、顺序、检索接口和参数增长 schedule 都会改变有效监督。课程用四个研究项目把“数据很重要”拆成可检验的问题。
数据不是油桶,而是训练目标的一部分
把数据叫作“新石油”容易让人只想到数量。更准确的说法是:数据定义经验风险的采样分布。若网页语料中某种模板、错误事实或语言占比过高,优化器会把它们当作稳定规律;若高价值样本很少,即使模型容量足够,梯度也未必能反复强化该能力。因此 data curation、mixture 与 schedule 是 architecture 的外部组成部分。
来源:CS25 V6 official deck, p. 35
来源:CS25 V6 official deck, p. 36
来源:CS25 V6 official deck, p. 37
课堂提示
00:16:20–00:20:23,老师把数据研究分成四类干预:改变来源、改变语言混合、把知识放到外部检索、以及让数据难度与模型深度共同变化。讲义提醒:这些项目回答不同因果问题,不能合成一句“更好数据更好模型”。
读图:四个项目改变的是不同变量
Baby Scale 改变家庭/儿童数据源;Bilingual BabyLM 改变语言与说话人混合结构;RAG scaling 改变参数记忆与外部记忆的 compute allocation;CGLS 改变模型深度与样本难度的时间顺序。先确定 intervention,再看 metric,最后才能讨论可迁移结论。
数据策略的五个旋钮
- Selection:哪些样本进入 corpus;
- Mixture:语言、领域和任务如何配比;
- Order:简单/困难、旧/新数据何时出现;
- Externalization:知识放进参数还是 retrieval store;
- Co-scaling:数据 schedule 是否与参数、层数和 compute 同步变化。
这些旋钮都会改变梯度,不能被视为训练前的一次性清洗。
这四类项目也展示了数据研究的基本因果设计。若改变数据来源,应尽量固定 tokenizer、参数量、训练 token 和优化器;若改变语言 mixture,应同时报告每种语言的测试分布;若改变 retrieval budget,要把额外 context 与索引成本计入;若改变 layer schedule,则需控制总参数更新量和训练 compute。否则所谓“data effect”可能只是模型更大、训练更久或评估更接近训练分布。课程没有把这些实验写成一条万能定律,反而提供了一个方法论:每次只明确一组 intervention,并把尚未控制的 confound 写进结论边界。
本章小结
Pretraining data 决定的不只是模型“看过什么”,还包括样本被看到的频率、顺序、上下文和可检索性。后面四个案例将分别回答:小而自然的数据能学到什么,双语是否互相干扰,RAG 应分走多少预算,以及模型成长能否与 curriculum 同步。
小数据与双语学习:把人类直觉变成可检验实验
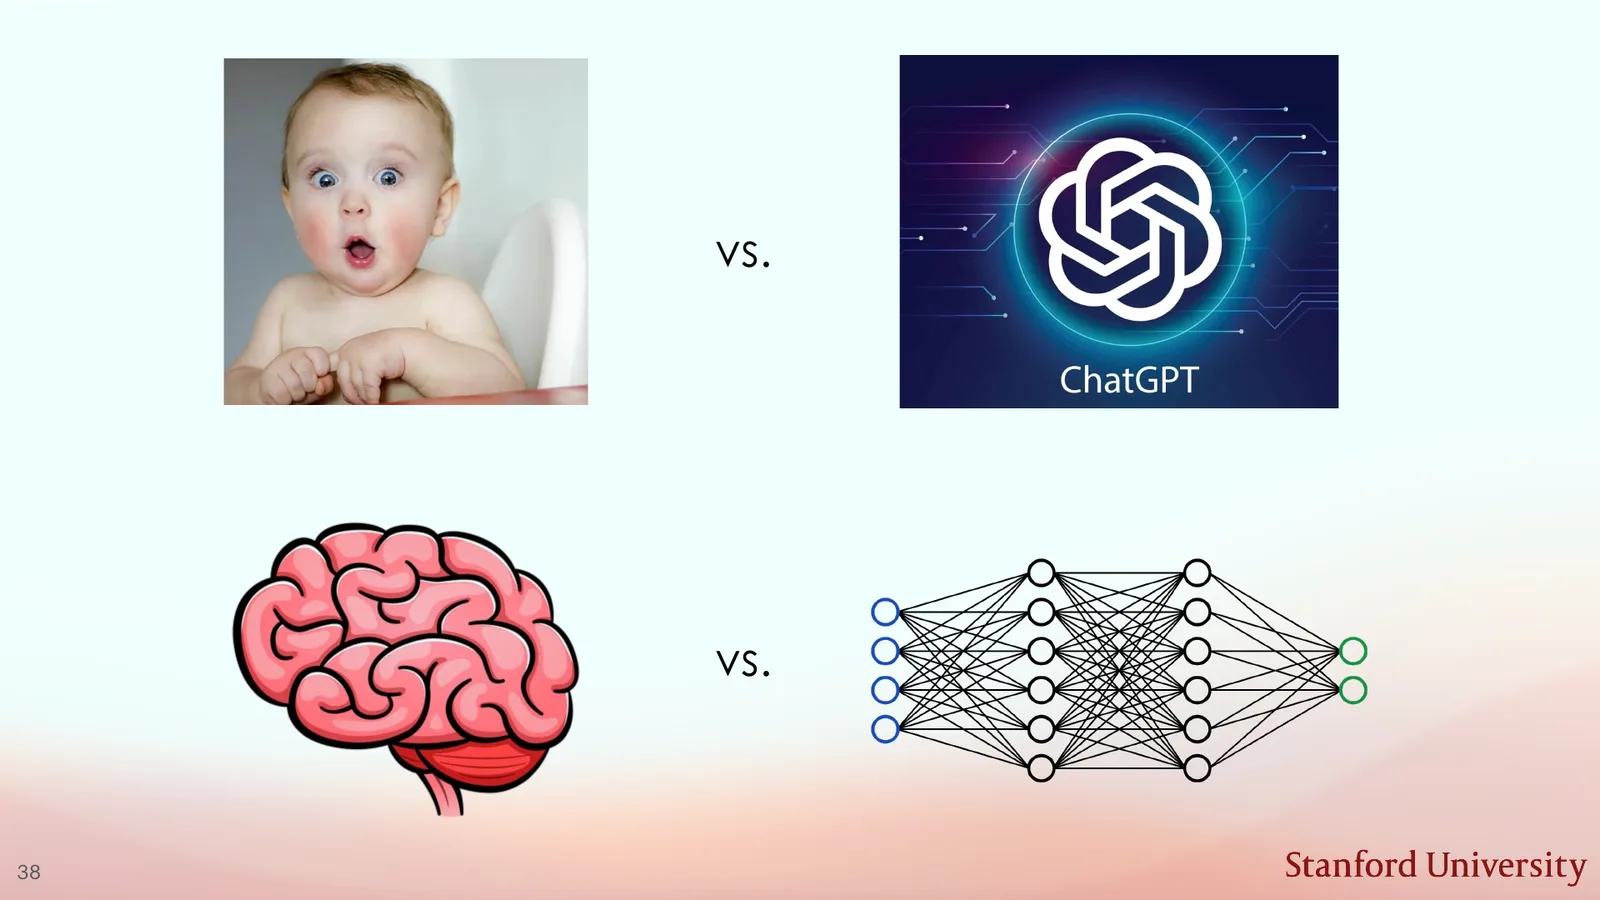
课程借用儿童学习提出数据效率问题,但并未把神经网络等同于大脑。人类获得视觉、行动、社会互动、长期目标和高结构输入;语言模型通常获得离线 token 与统一 loss。研究价值在于构造受控数据条件,而不是用少量 token 直接证明“类脑学习”。
为什么研究 small model 与 small data
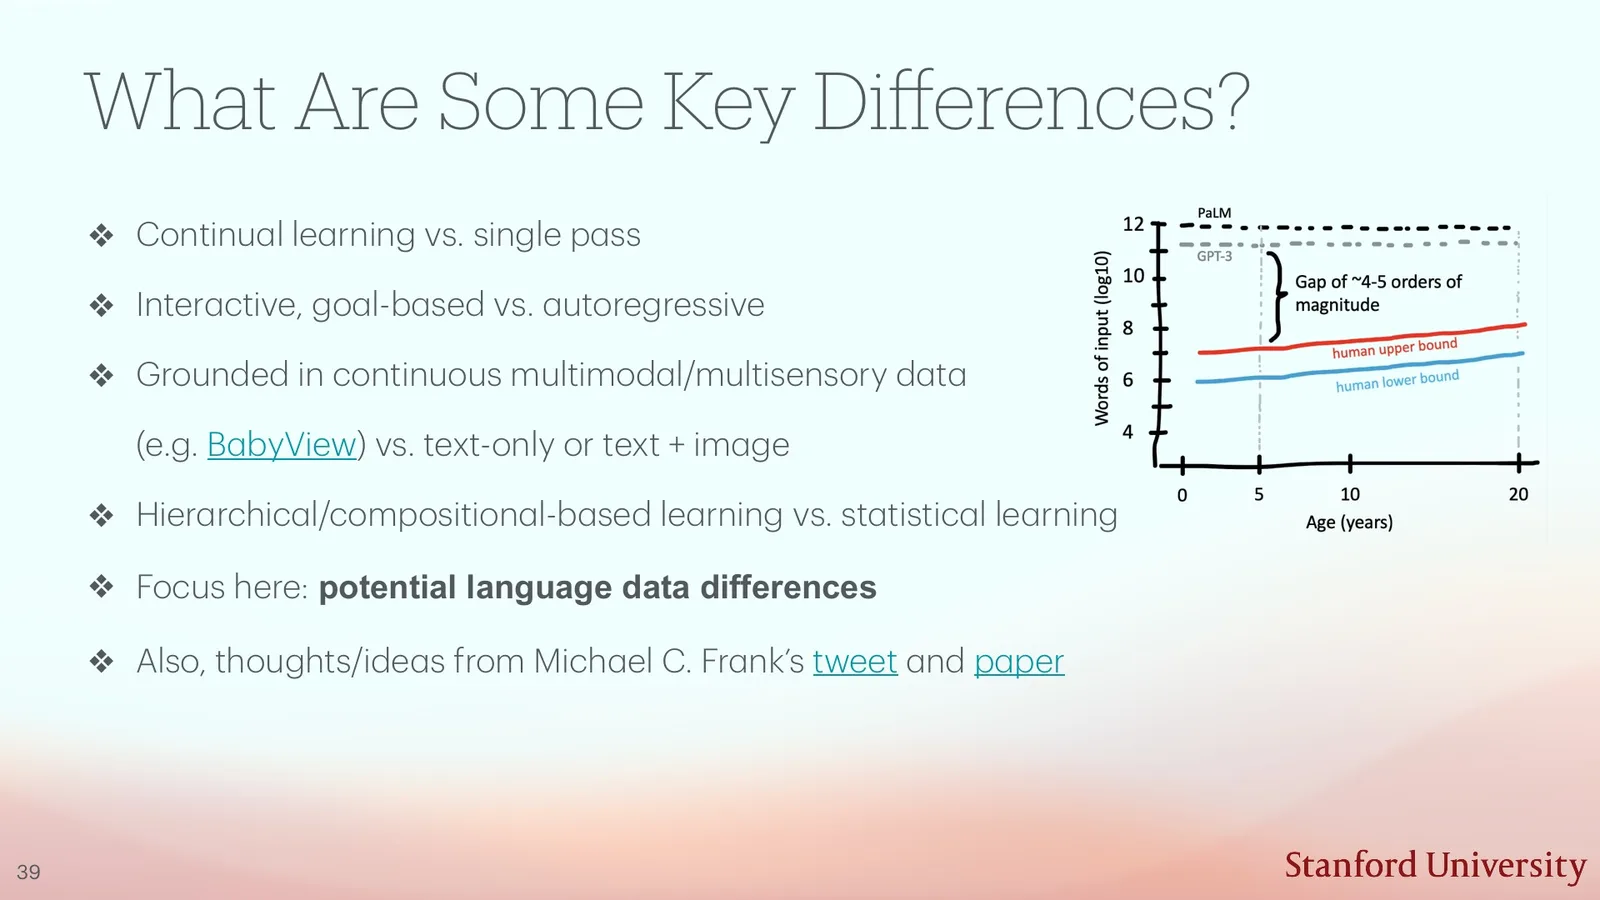
Baby Scale 对比 infant/ChatGPT 与 brain/neural network,列出连续学习、grounded input、目标、层级结构和潜在 inductive bias。这里的对比是 hypothesis generator:如果儿童输入中交互性、语义多样性或说话人结构与网页不同,可以设计 dataset-level test;但不能把人类全部监督折算成转录文本字符。
来源:CS25 V6 official deck, p. 39
来源:CS25 V6 official deck, p. 40
来源:CS25 V6 official deck, p. 41
课堂提示
00:18:22–00:20:46,老师反复使用 might、potential 与 question 来描述人类学习优势。课堂提示:这些差异是实验轴,不是“儿童数据天然优于互联网”的结论。
比较儿童与 LLM token 数时缺失了什么
儿童同时接收图像、声音、动作后果、社会反馈和反复互动;转录语料只保留其中一小部分。模型与儿童的目标函数、参数初始化、先验和评估任务也不同。因此 token 数可用于提出数据效率问题,却不是公平的总监督量。
Baby Scale:一个孩子的语言输入能训练出什么
Baby Scale 使用 CHILDES 中单个家庭的 child-directed speech,训练小型 GPT-2 风格模型,并在 language modeling、syntax、semantics 与 lexical development 等任务上比较。核心设计不是追求 SOTA,而是固定模型规模后观察家庭数据来源与儿童接触结构是否带来可测差异。
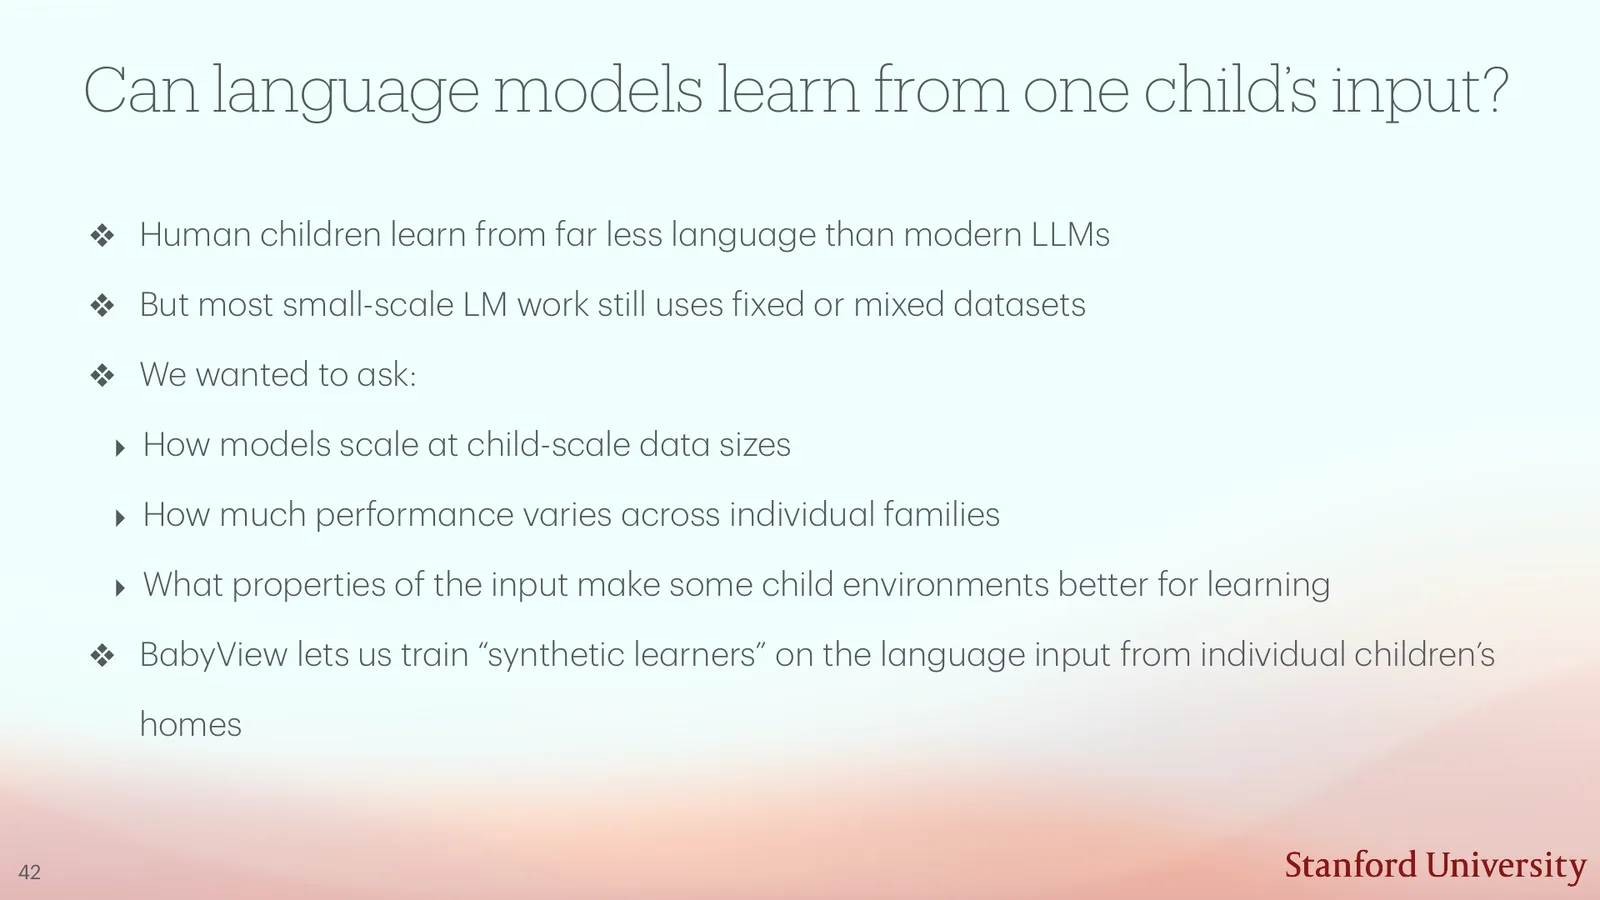
来源:CS25 V6 official deck, p. 43
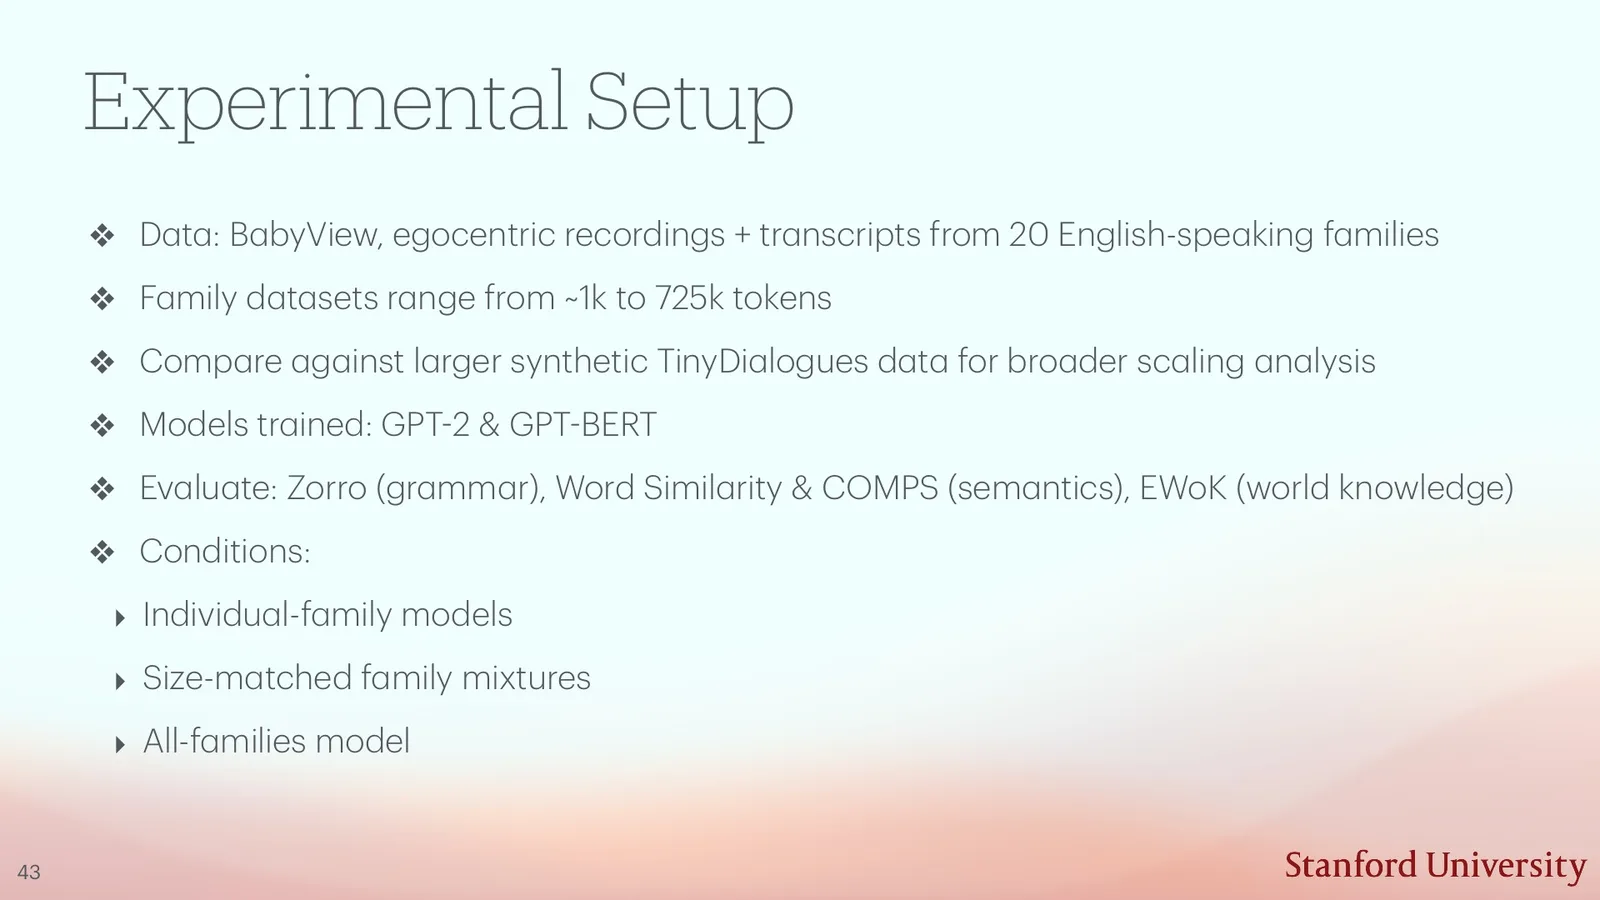
来源:CS25 V6 official deck, p. 44
Perplexity(困惑度)是交叉熵的指数:
直觉上它近似模型在每个 token 面前的“有效候选数”;越低表示对测试序列越不惊讶。但 PPL 受 tokenizer、测试分布和长度影响,不能跨任意模型直接比较,也不等同于语法、事实或交互能力。
结果页应按两步读:slide 45 比较不同家庭数据在多项任务上的相对表现,slide 46 再看模型大小是否改变趋势。若某个数据集在多项任务都较强,可能来自词汇覆盖、互动结构或说话人多样性;如果扩大模型不能消除差异,说明 data property 不是单纯 capacity bottleneck。
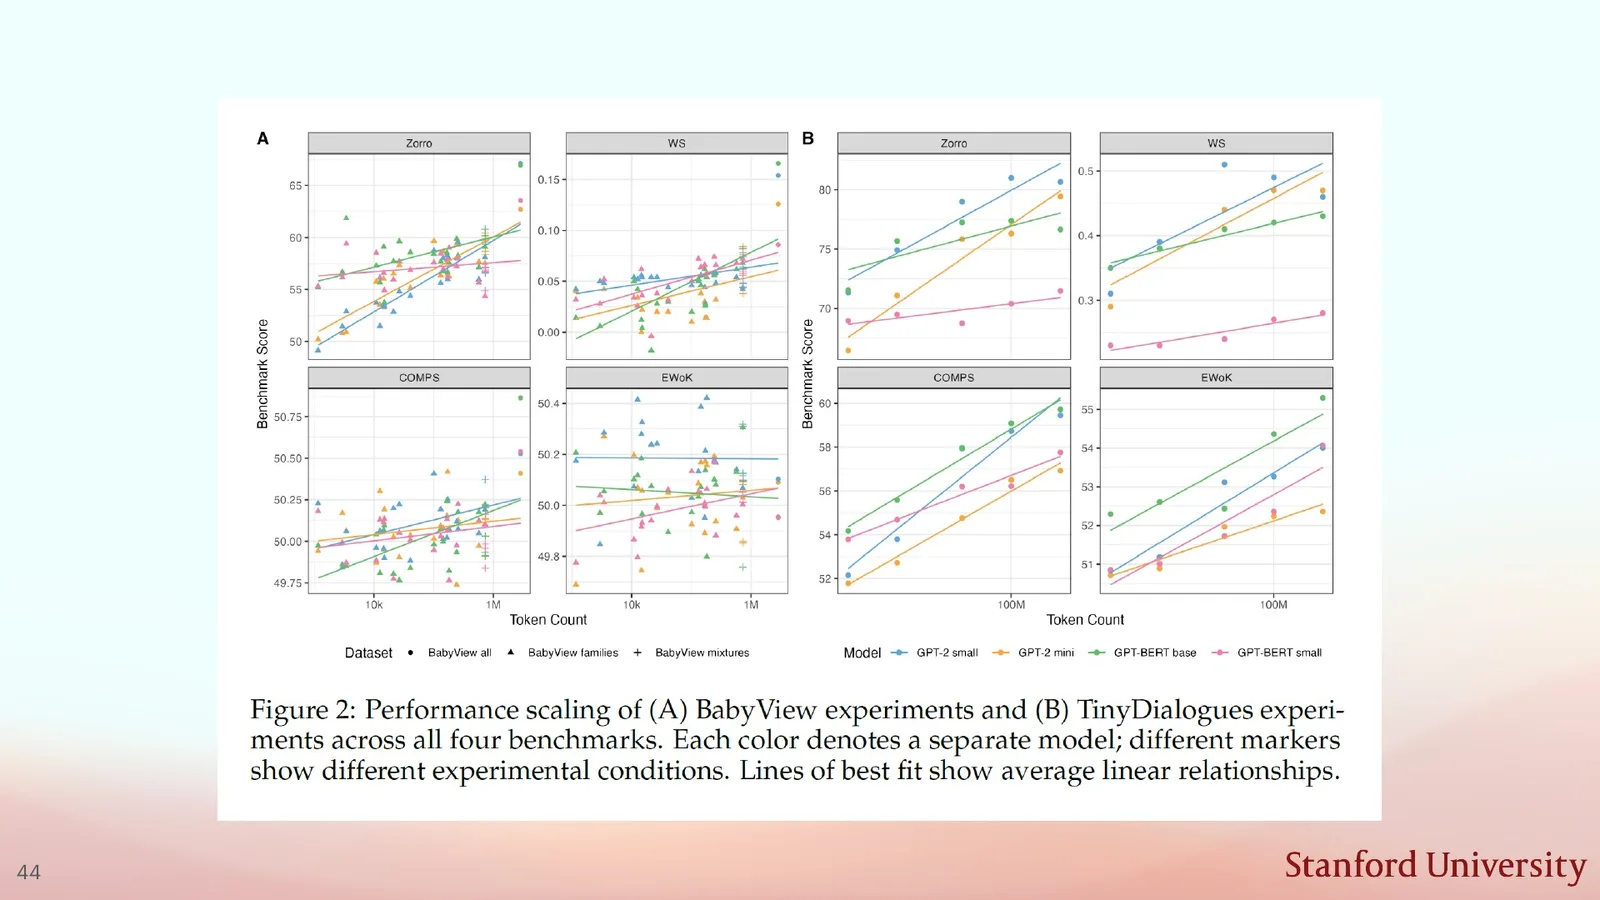
来源:CS25 V6 official deck, p. 45
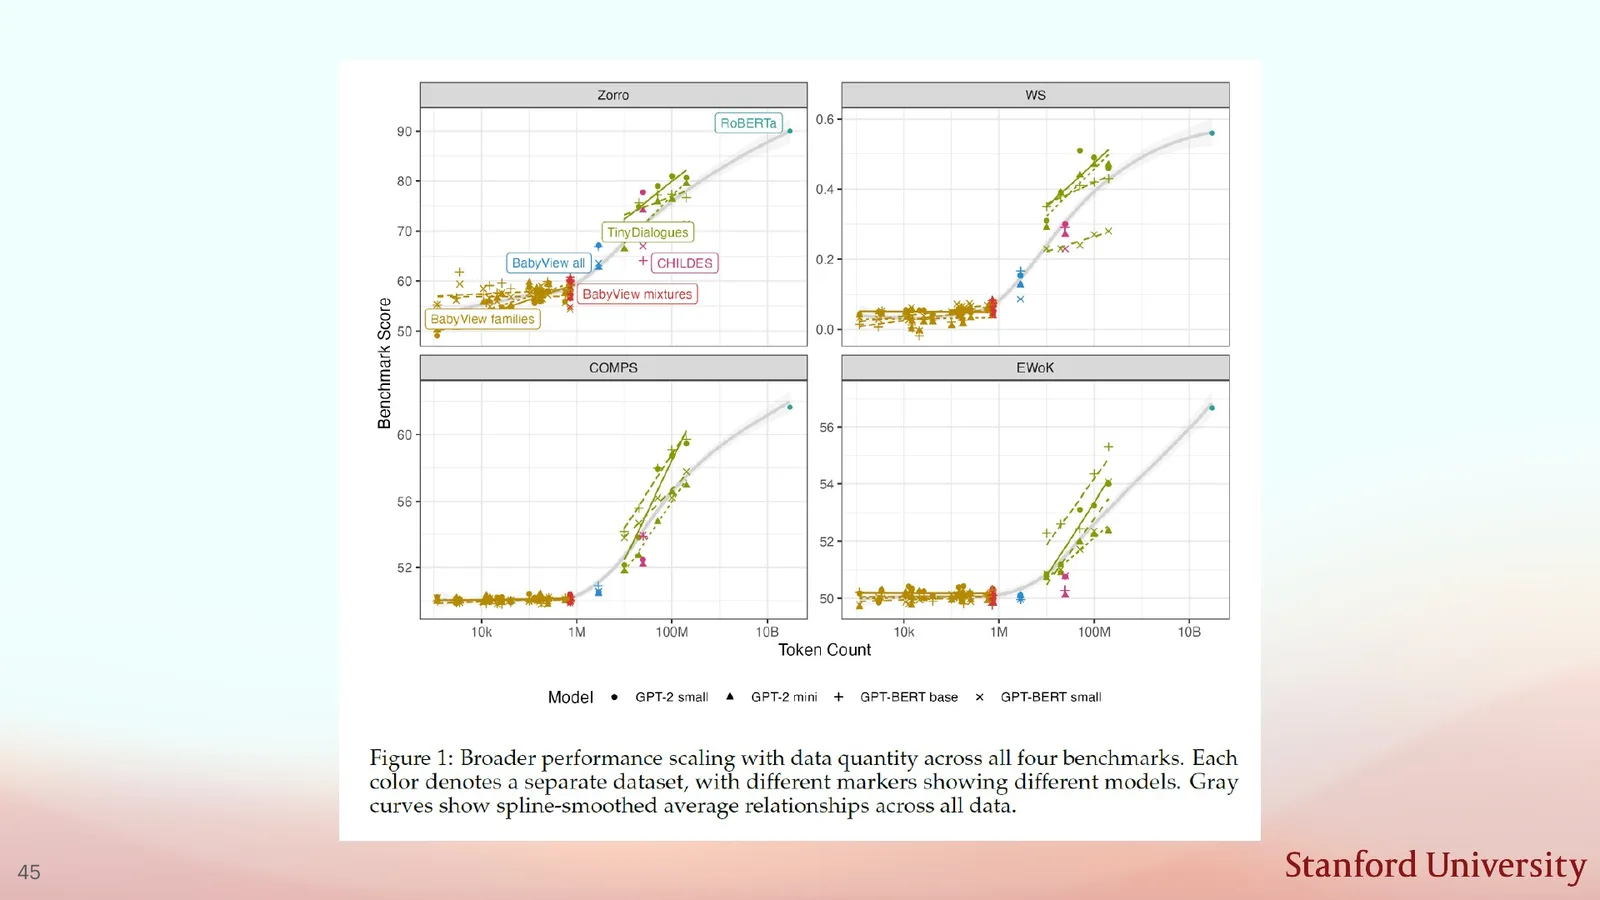
来源:CS25 V6 official deck, p. 46
读图:先比较任务,再比较规模
先在每个 subplot 内比较不同家庭数据,而不是跨任务比较绝对分数;各任务 metric 和难度不同。再看模型大小变化后排序是否稳定。稳定排序支持“数据属性持续影响表现”,却不能仅凭相关性确定是 child interaction、词汇覆盖还是转录质量导致,需要后续受控 ablation。
Scale 之外:哪些数据属性预测表现
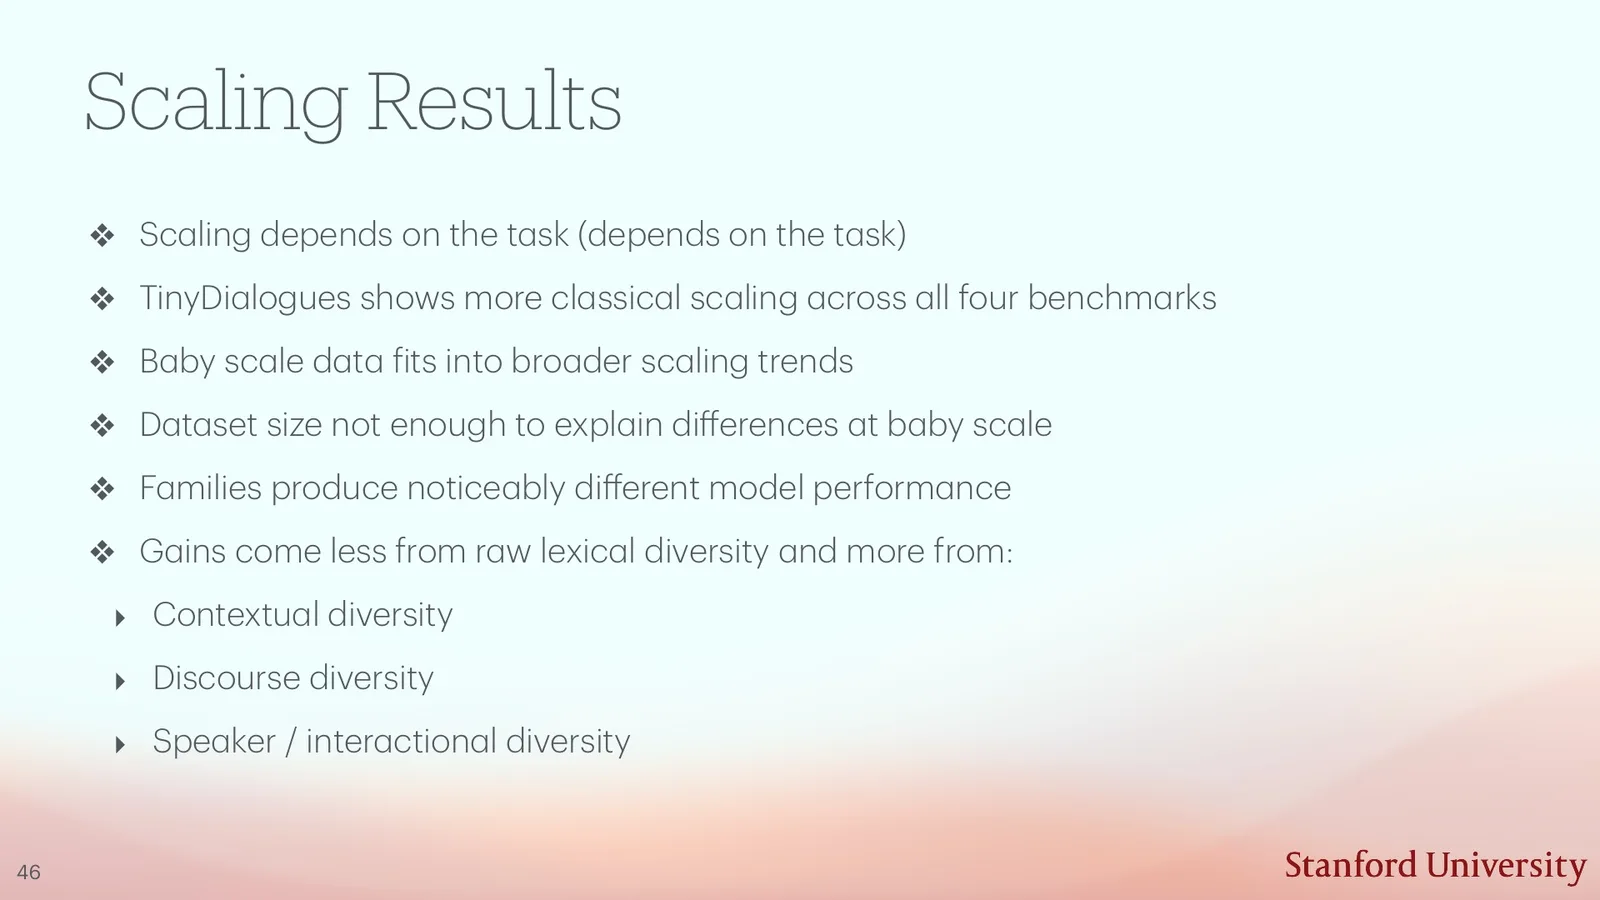
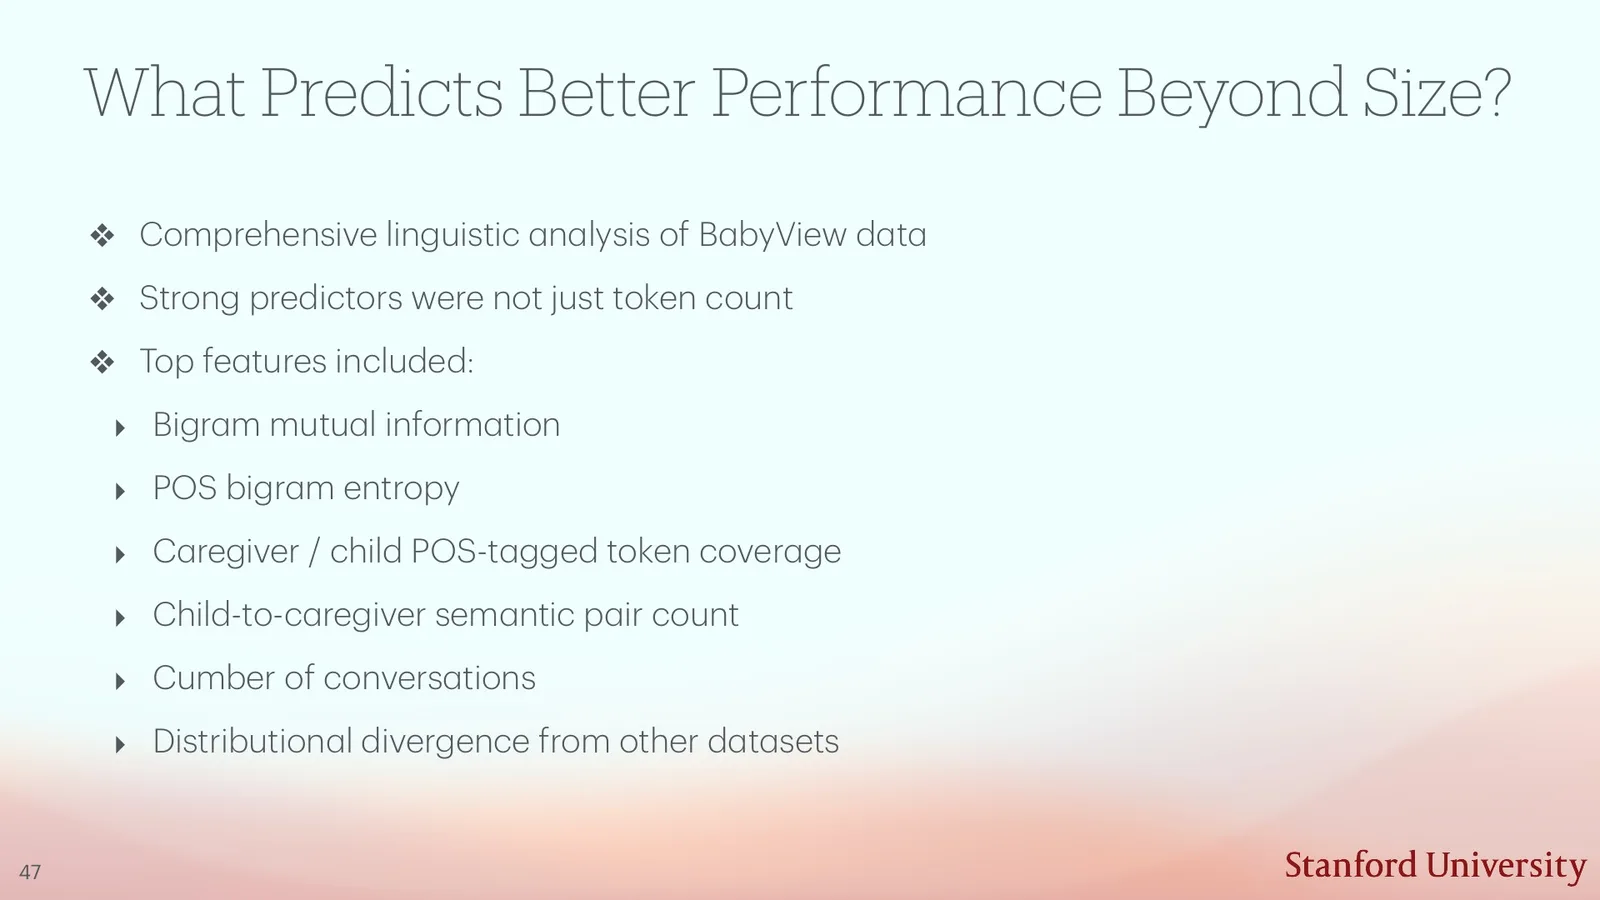
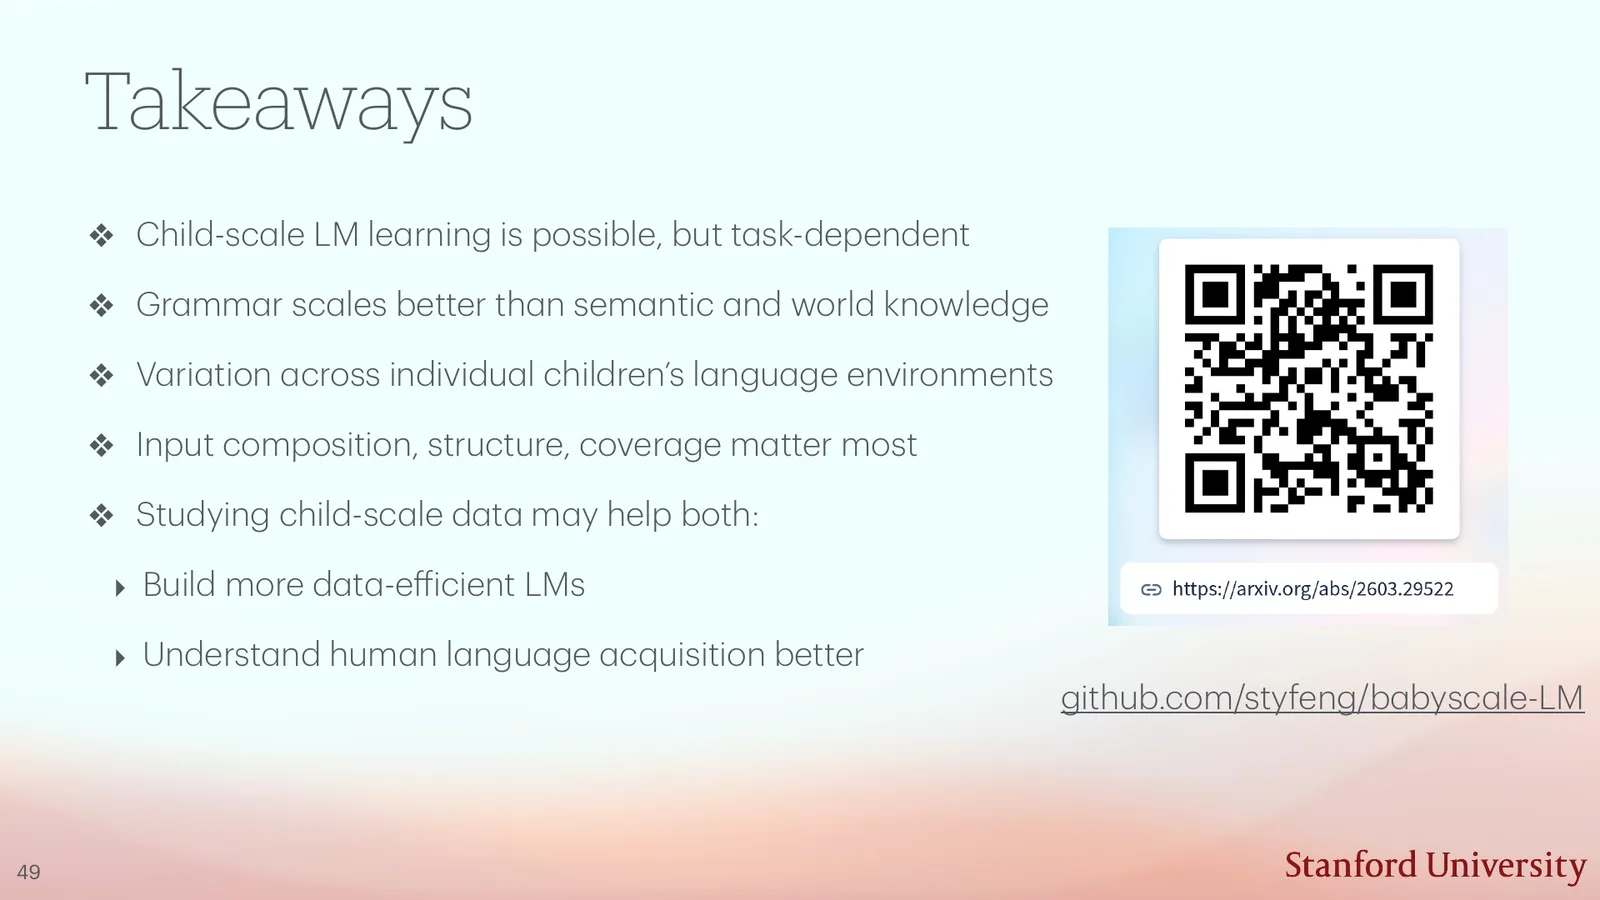
课程列出 interaction、speaker diversity、context length、vocabulary coverage、child/caregiver speech ratio 与 distribution divergence 等候选变量。可写成一个简单回归视角:
\(y_{f,m}\) 是家庭 \(f\)、模型规模 \(m\) 的任务表现,\(D_f\) 是 token 数,\(N_m\) 是参数量,\(z_{f,k}\) 是数据属性。该式不是论文的唯一模型,而是帮助读者区分 size effect 与 composition effect。
来源:CS25 V6 official deck, p. 47
来源:CS25 V6 official deck, p. 48
来源:CS25 V6 official deck, p. 49
来源:CS25 V6 official deck, p. 50
课堂提示
00:22:23–00:25:25,老师强调“更大”不是唯一解释:child/caregiver 比例、互动多样性与词汇结构可能影响表现;同时不同任务给出的最优数据集并不完全一致。
Baby Scale 能支持与不能支持的结论
它支持:小模型可以从单个儿童环境的转录中学到非随机语言规律;数据来源差异会留下任务相关痕迹。它不支持:儿童输入已经解释人类语言学习;某个家庭 corpus 在大模型上必然最优;相关的数据属性已被证明是因果机制。
评价这种研究还要避免“一个总分覆盖所有能力”。Language-modeling loss 衡量局部预测,BLiMP 类 grammaticality task 检查结构偏好,word similarity 检查 lexical representation,developmental measure 又关心随数据增长的轨迹。某个家庭 corpus 可能在语义任务占优、在句法任务落后;这并非结果矛盾,而是说明数据属性支持不同能力。更强的后续实验应对高相关属性做匹配或干预,例如固定 token 数后重采样说话人多样性、打乱互动 turn、控制词汇覆盖,再看任务轮廓是否按预测变化。这样才能把“哪个数据集更好”推进到“哪种数据机制在起作用”。
样本量与重复训练也必须进入不确定性。小模型实验常受 random seed、batch order 和 early stopping 影响;如果只报告一次 run,数据集排序可能是优化噪声。理想报告应给出多 seed 均值、置信区间、effect size 与 multiple-comparison correction,并说明 family-level transcript 是否存在重叠或质量差异。对于 developmental claim,还应比较数据增长曲线而不是只看最终 checkpoint。这样才能判断某个 corpus 是稳定地更有效,还是刚好在有限训练预算下更快收敛。
Bilingual BabyLM:双语是干扰、迁移还是数据规模问题
双语研究把“混合两种语言”进一步拆成 exposure structure。可以让每个说话人只说一种语言(speaker-split),让说话人在不同句子切换(sentence-level),或在同一句中切换(word-level code-switching)。若把所有条件都叫 bilingual mixture,就无法判断模型到底对语言边界、说话人线索还是总数据量敏感。
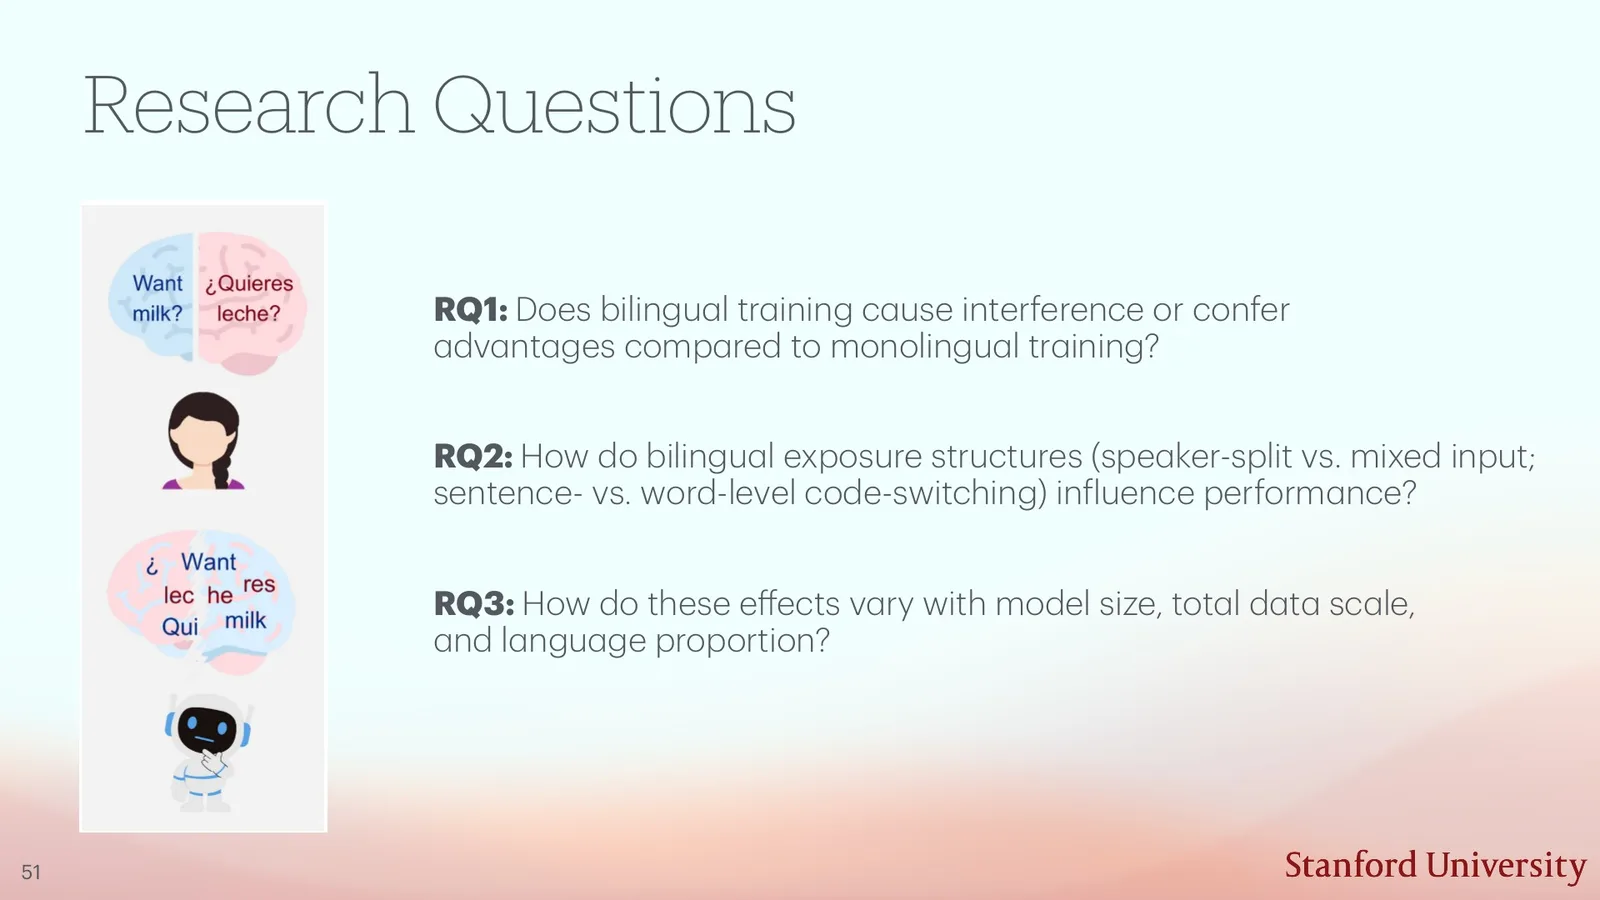
来源:CS25 V6 official deck, p. 52
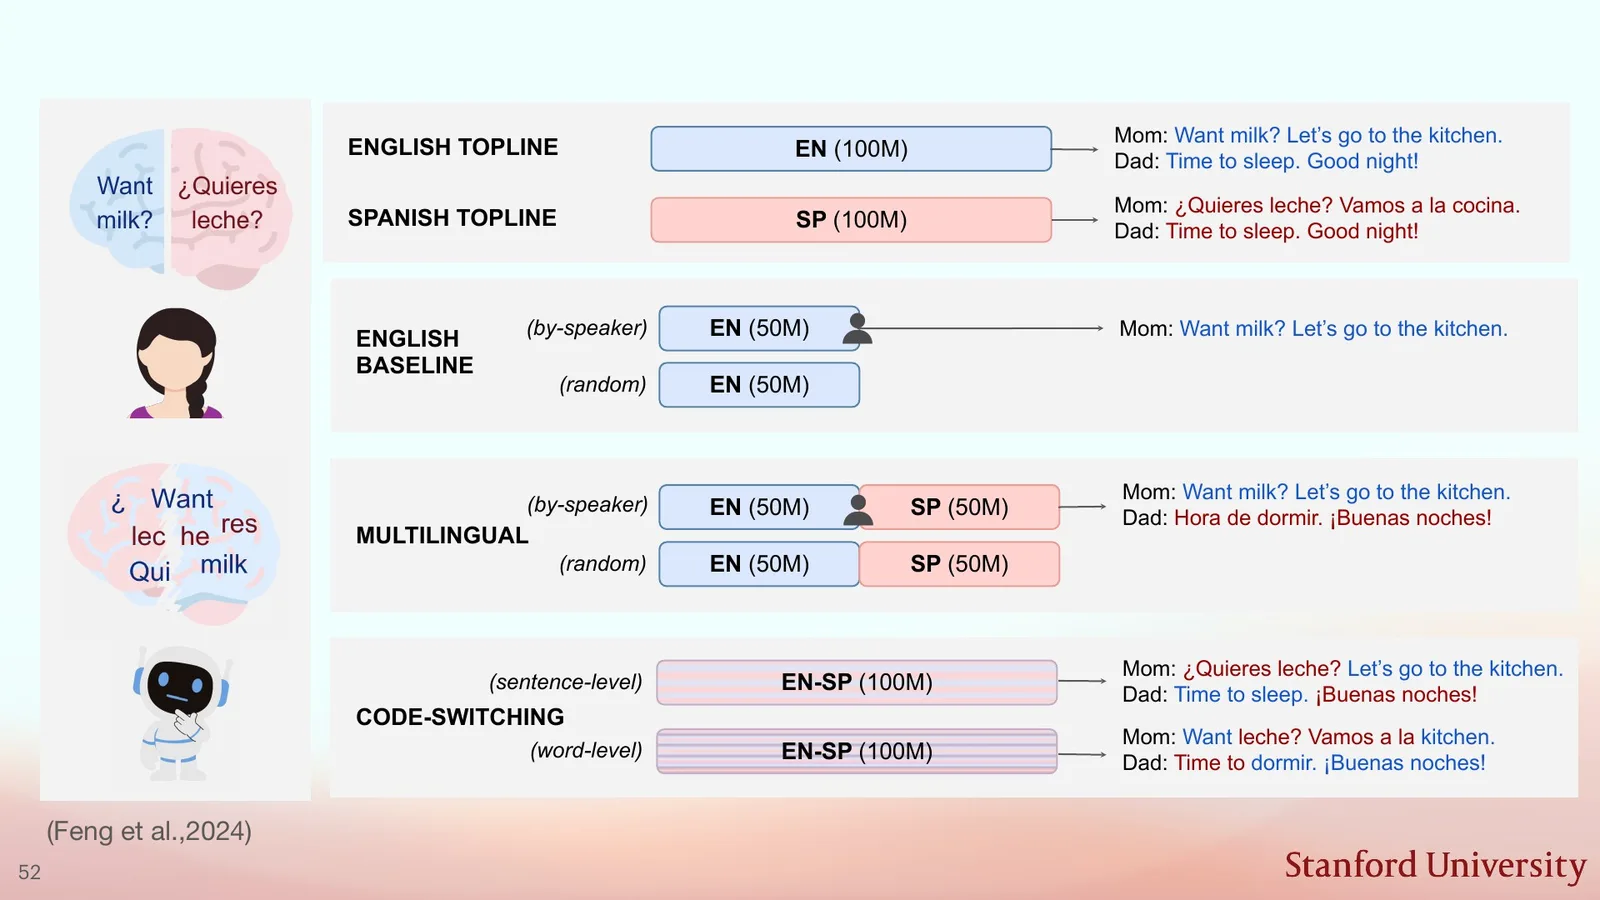
来源:CS25 V6 official deck, p. 53
设英语与西语数据分布为 \(q_{\mathrm{en}}\) 和 \(q_{\mathrm{es}}\),混合权重为 \(\lambda\),则训练分布为
但 speaker-split 与 code-switching 不只是改变 \(\lambda\);它们改变语言与上下文、说话人、句界的联合分布。即使总 token 相同,模型可利用的边界线索也不同。
结果一:没有普遍双语干扰
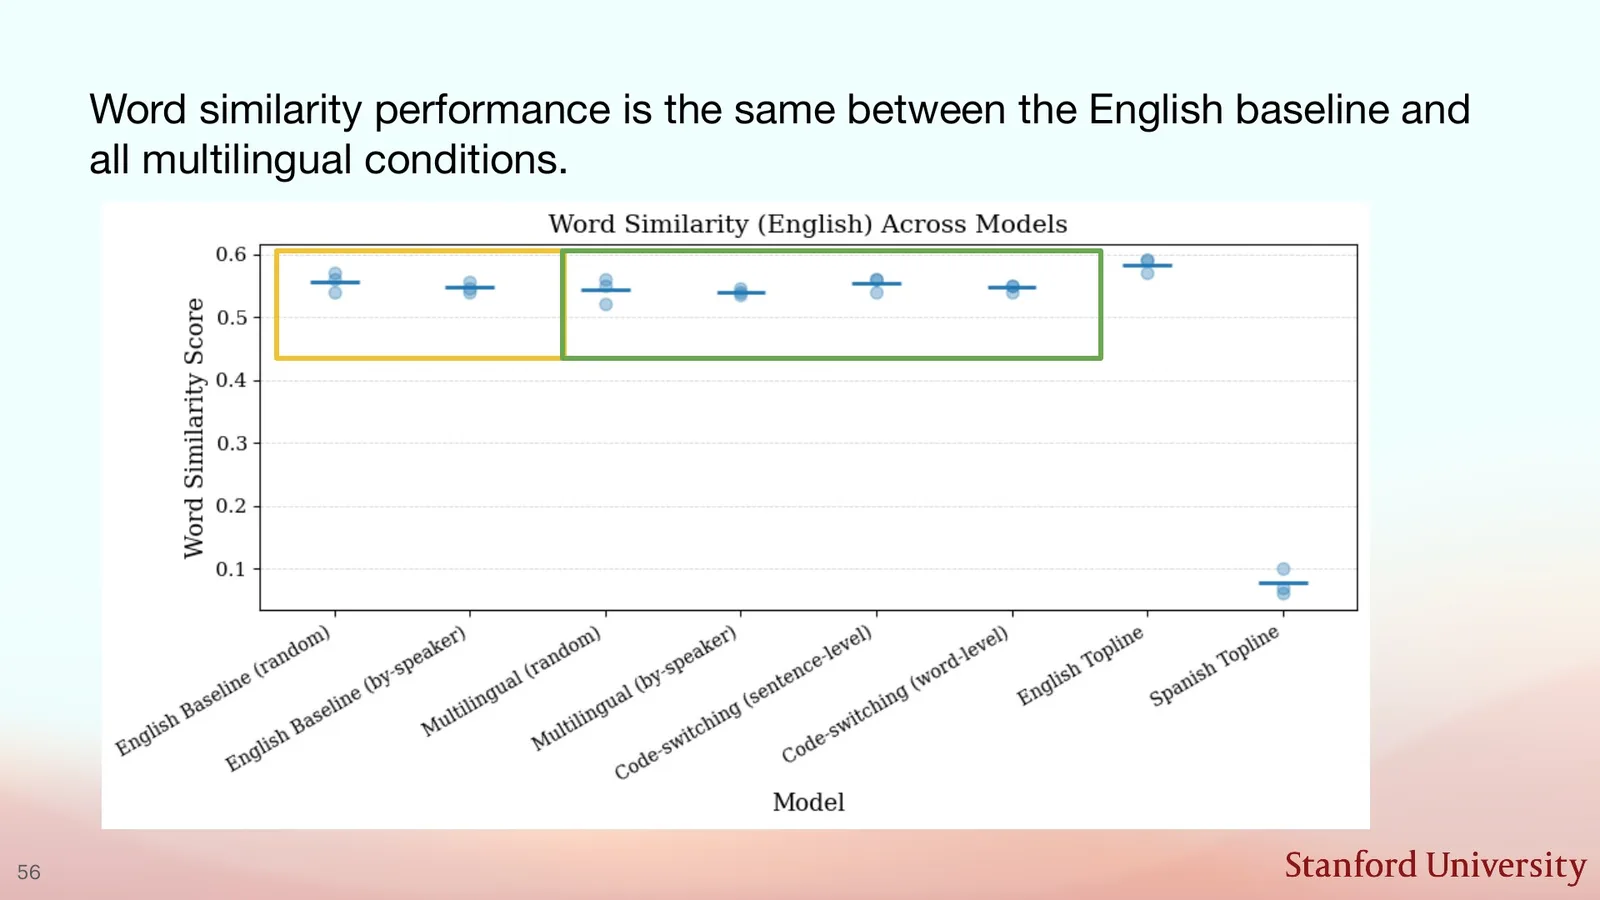
前面的实验设计把双语 exposure 拆成多个条件,本节先回答最基础的问题:同时学习两种语言是否会系统性破坏单语能力。读 slide 55–57 时应先固定总数据与 baseline,再分别检查 language modeling、syntax 和 semantics;只有多个 metric 同方向显著退化,才足以支持广泛 interference。
slide 55 的 PPL 表显示多语模型在两种语言上都能形成有效分布;slide 56–57 再用 grammaticality 与 word similarity 检查是否只是记住局部统计。读表时先找单语 baseline,再看双语条件置信区间,而不是仅比较一位小数。
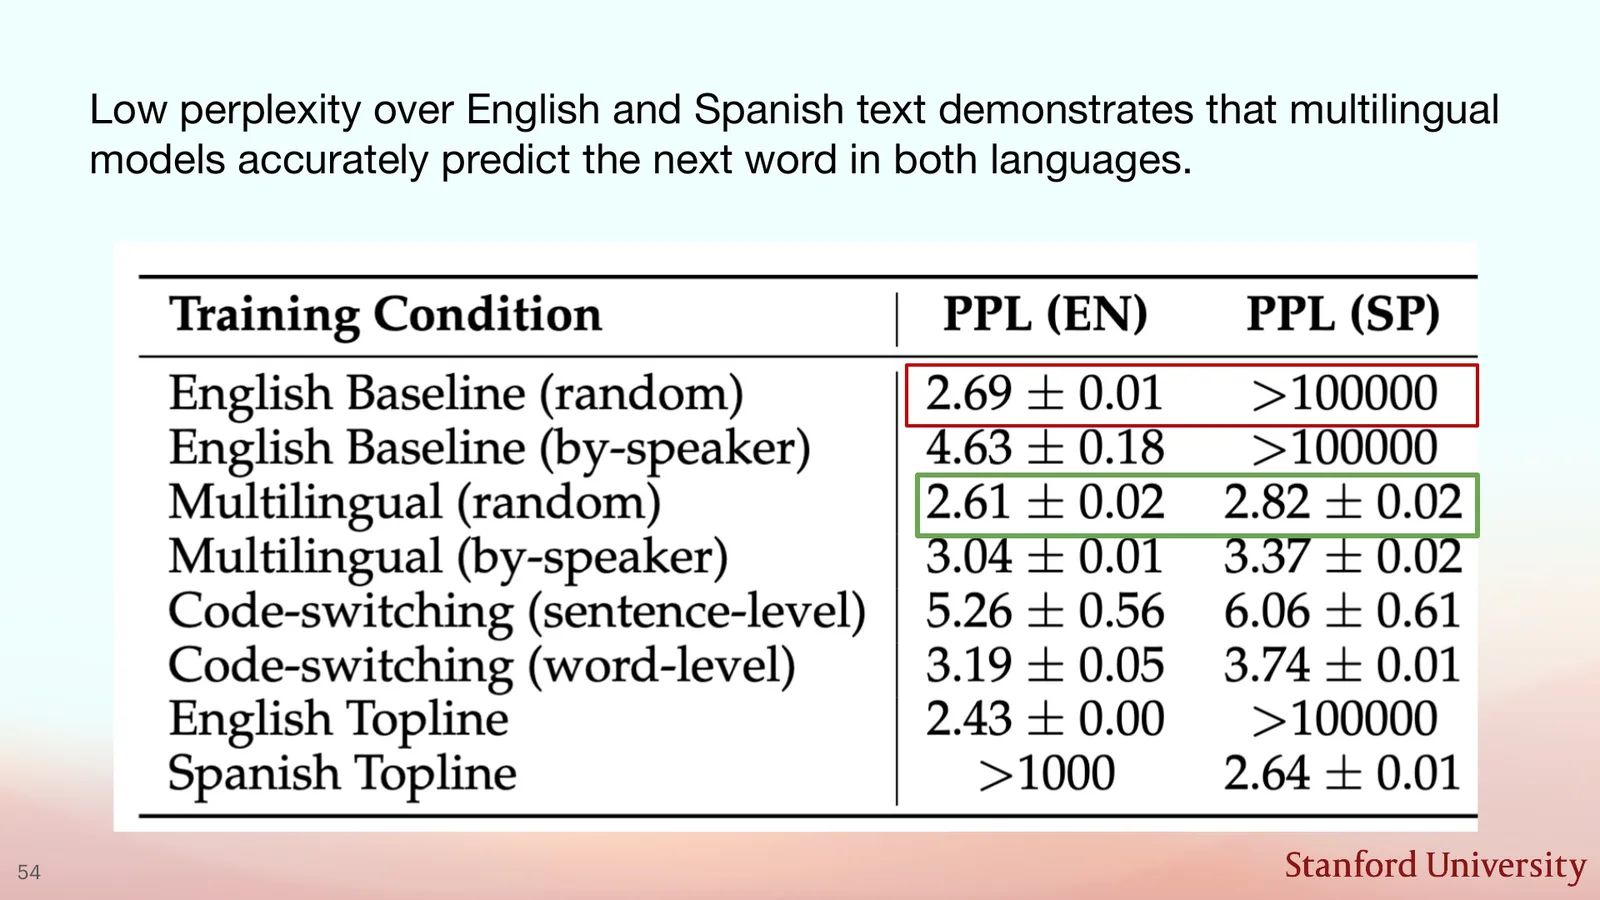
来源:CS25 V6 official deck, p. 55
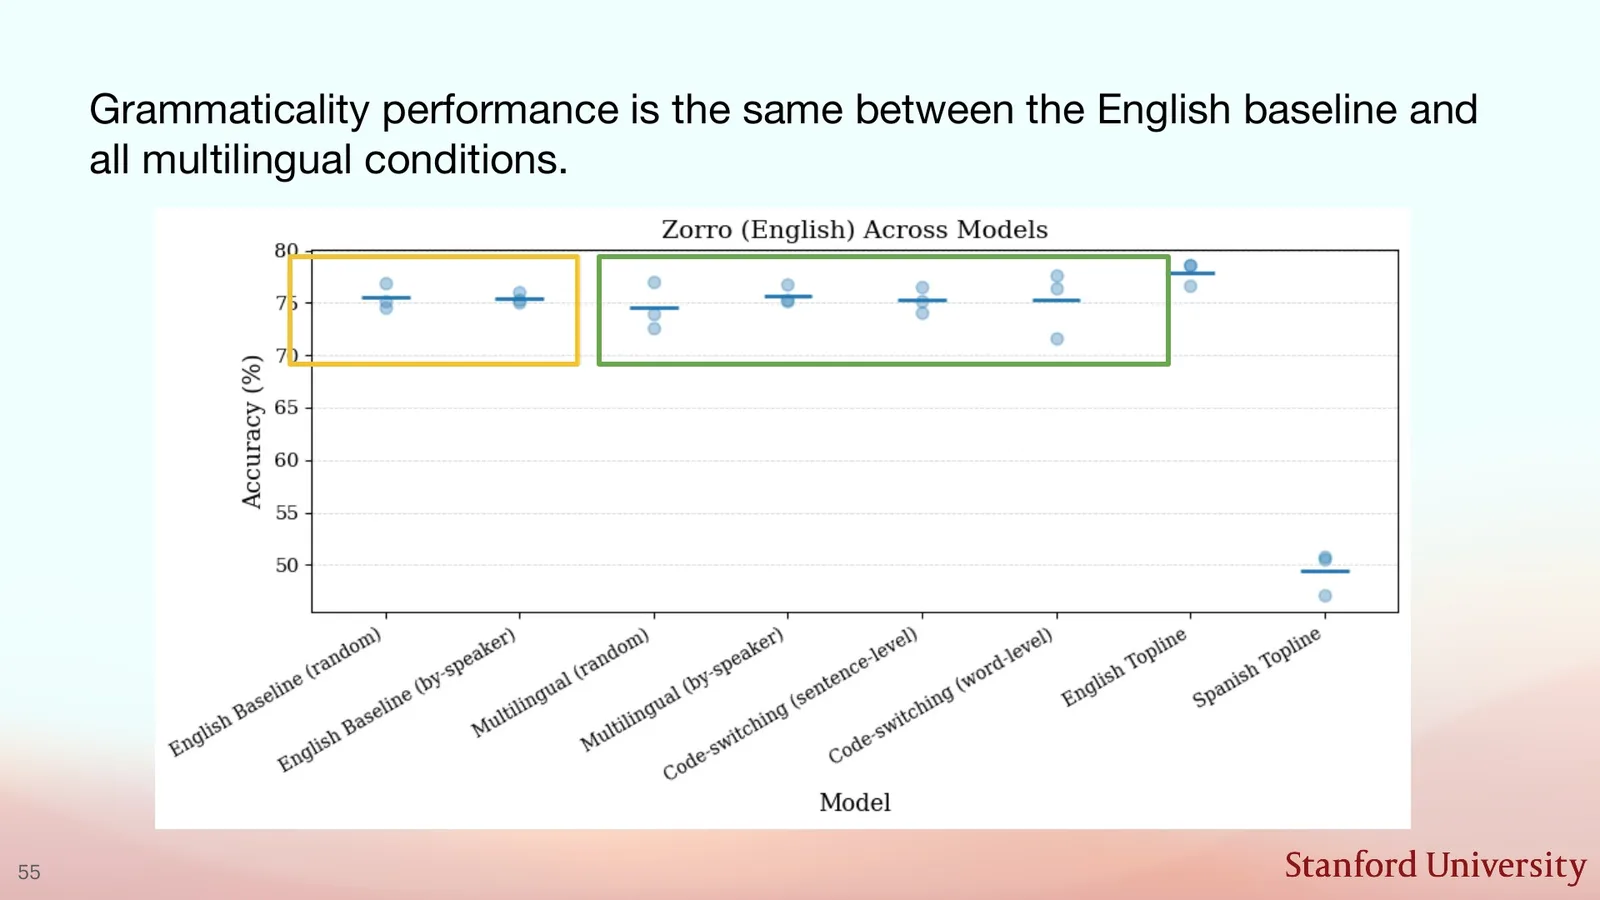
来源:CS25 V6 official deck, p. 56
来源:CS25 V6 official deck, p. 57
读图:如何判断 interference
Interference 不应只定义为某个条件略低于最高分。需要同时看单语 baseline、数据总量、置信区间和多项任务。如果双语模型在英语上略降却学会西语,总体 tradeoff 与“灾难性干扰”不同;如果固定总数据后仍显著下降,才更接近竞争性容量或优化问题。
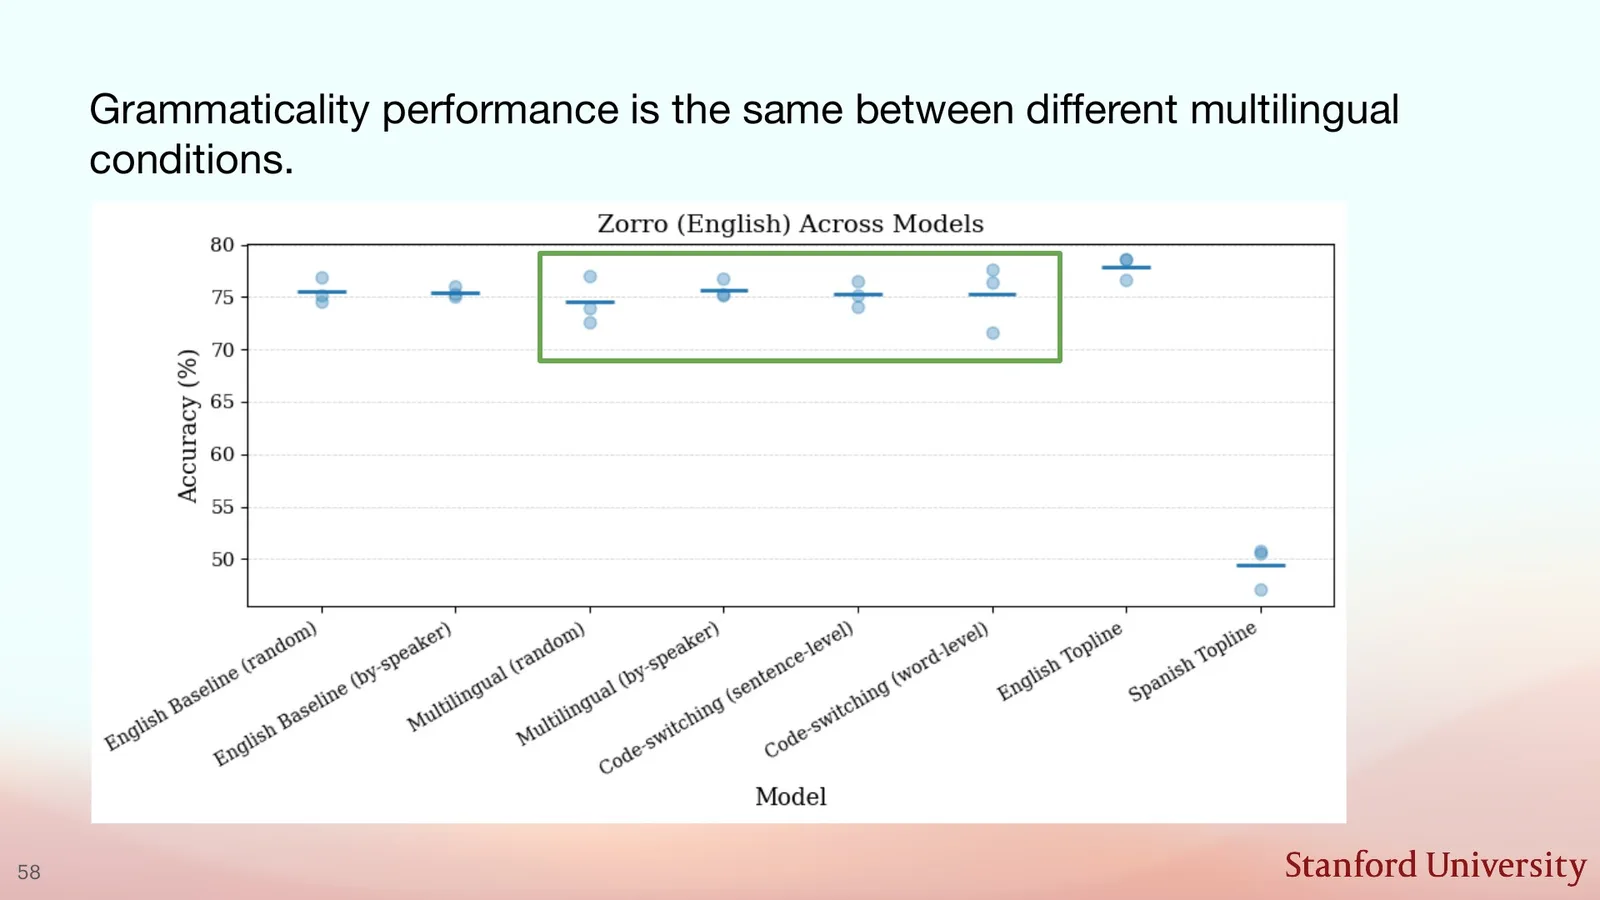
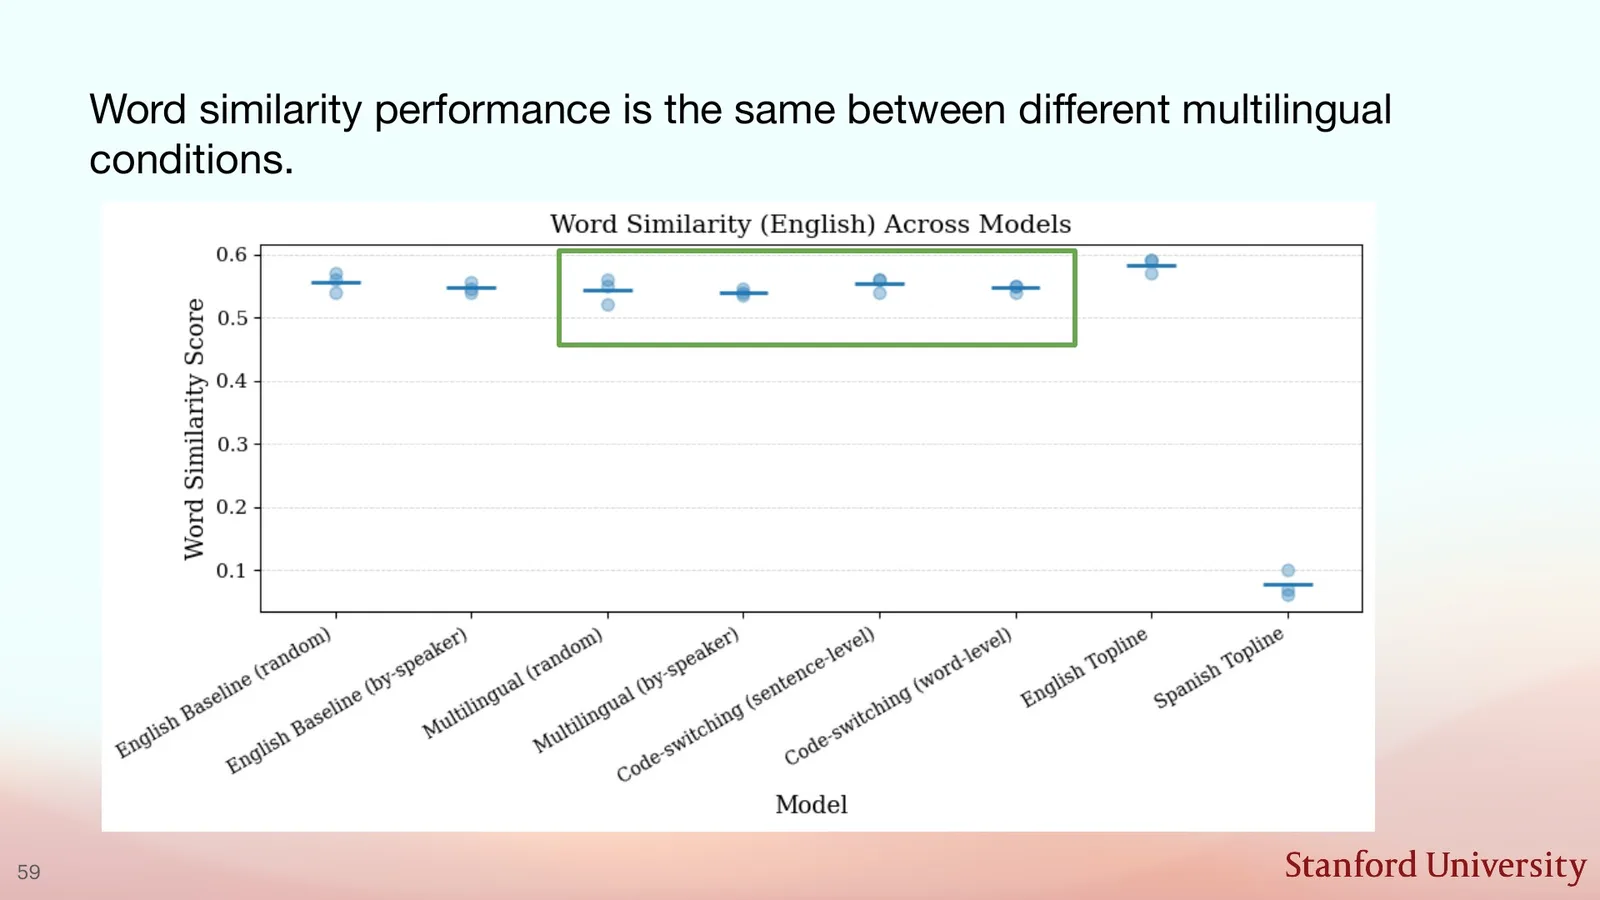
结果二:暴露结构影响弱于预期
不同 multilingual conditions 的 grammaticality 与 word similarity 曲线整体接近,说明模型并不强依赖“一个说话人一种语言”这种人类常见线索。这个结果应解释为:在当前模型、数据量和 metric 下,exposure structure 的边际影响有限;不能推出 code-switching 在所有语言、规模或生成任务中都无关。
来源:CS25 V6 official deck, p. 59
来源:CS25 V6 official deck, p. 60
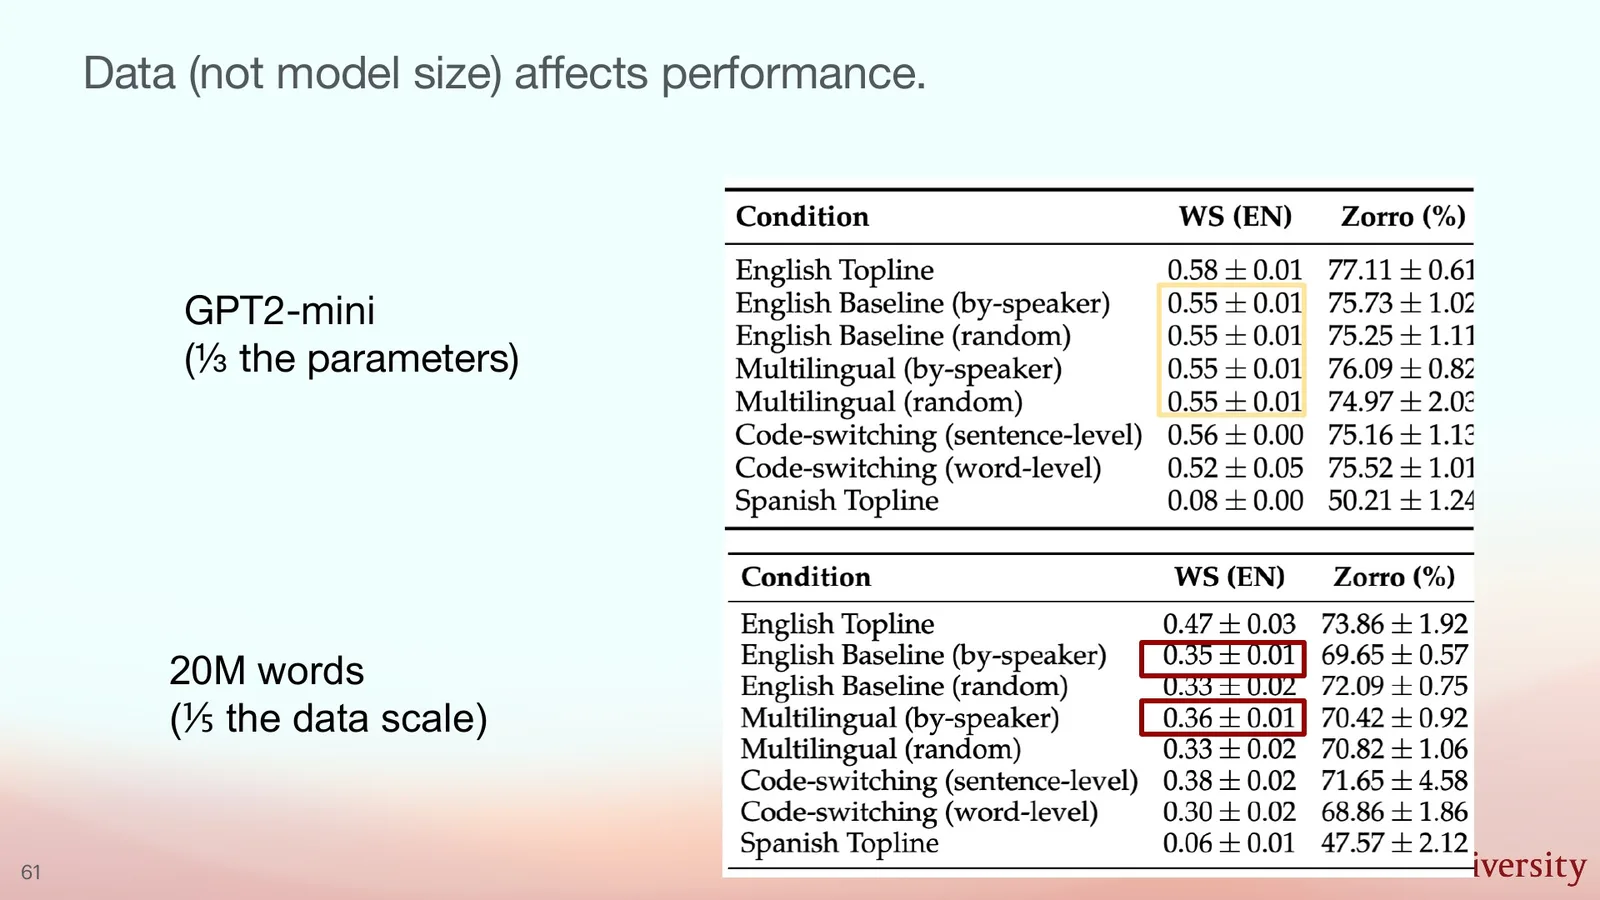
结果三:总数据规模比小幅模型扩张更关键
slide 62 将约二十分之一参数规模与约二十分之一数据规模分开比较。结果强调 data scale 的作用:减少数据会显著恶化多项指标,而在此小模型范围内, modest model-size change 的影响更小。这里仍需避免外推到 frontier LLM;在更大规模下,参数、数据和 compute 的最优比例可能不同。
来源:CS25 V6 official deck, p. 62
来源:CS25 V6 official deck, p. 63
来源:CS25 V6 official deck, p. 64
来源:CS25 V6 official deck, p. 65
来源:CS25 V6 official deck, p. 66
课堂提示
00:25:25–00:29:01,老师总结三点:没有广泛 monolingual interference;暴露结构的影响出乎意料地弱;总数据规模比当前范围内的模型大小更关键。老师同时把结论限定在 small-scale setting。
“双语不干扰”不是无条件定律
语言距离、tokenizer、混合比例、训练时长、生成任务与模型容量都会改变结果。当前实验显示的是一组受控 small-scale 条件下没有系统性退化,而不是所有 multilingual training 都自动正迁移。
对工程实践而言,这组结果更像一个调试顺序,而不是 mixture recipe。若 multilingual model 退化,先检查每种语言的有效 token 数、tokenizer fertility、batch sampling 与 evaluation leakage,再检查 capacity competition。Speaker-split 或 code-switching structure 可能在更强语境任务中变得重要;当前语法和词相似指标对 discourse-level language switching 并不敏感。课程的谨慎之处在于把“没有观察到显著 effect”与“effect 不存在”分开,这也是阅读所有 negative result 的基本原则。
本章小结
两个 BabyLM 项目共同说明:small-scale 实验的价值在于分离数据变量。Baby Scale 显示家庭数据属性与任务表现相关;Bilingual BabyLM 显示语言混合不必然造成干扰,且暴露结构与总数据量的作用不同。它们提供机制线索,而不是把儿童学习直接复制到大模型的万能配方。
RAG 与 Curriculum:把知识位置和学习顺序纳入 scaling
前一章改变 corpus 的来源与语言结构,本章改变另外两个维度:知识是存进参数还是在推理时检索,以及模型是否按一个 curriculum 与深度 schedule 共同成长。这两条路线都反对“只扩大静态预训练”的单轴 scaling 观。
RAG 的基本接口:参数记忆之外增加外部记忆
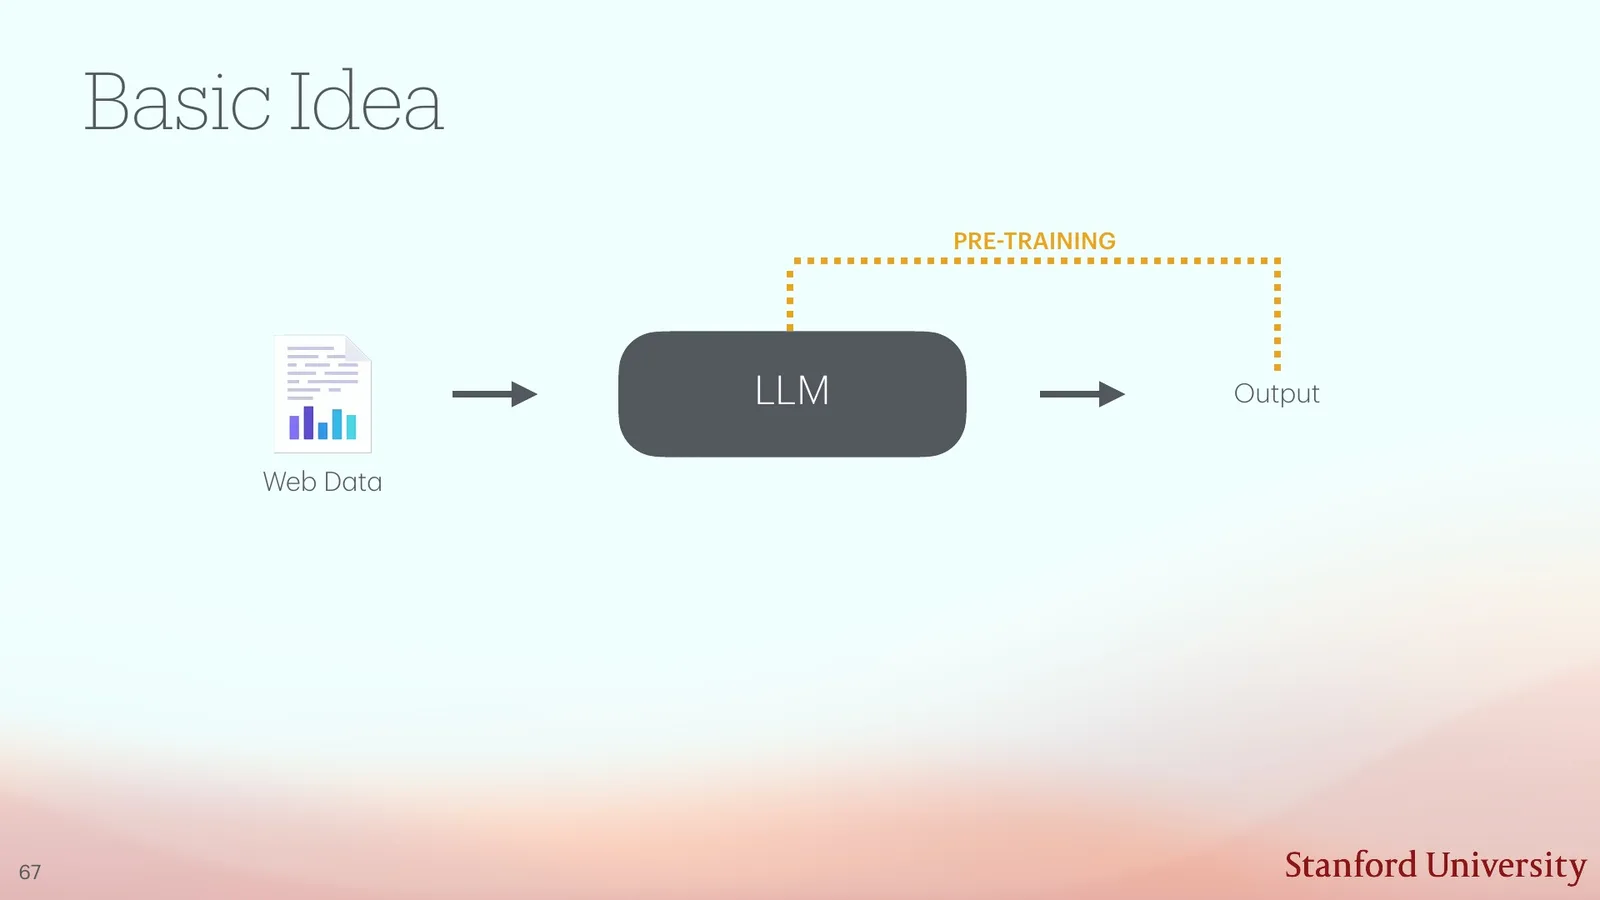
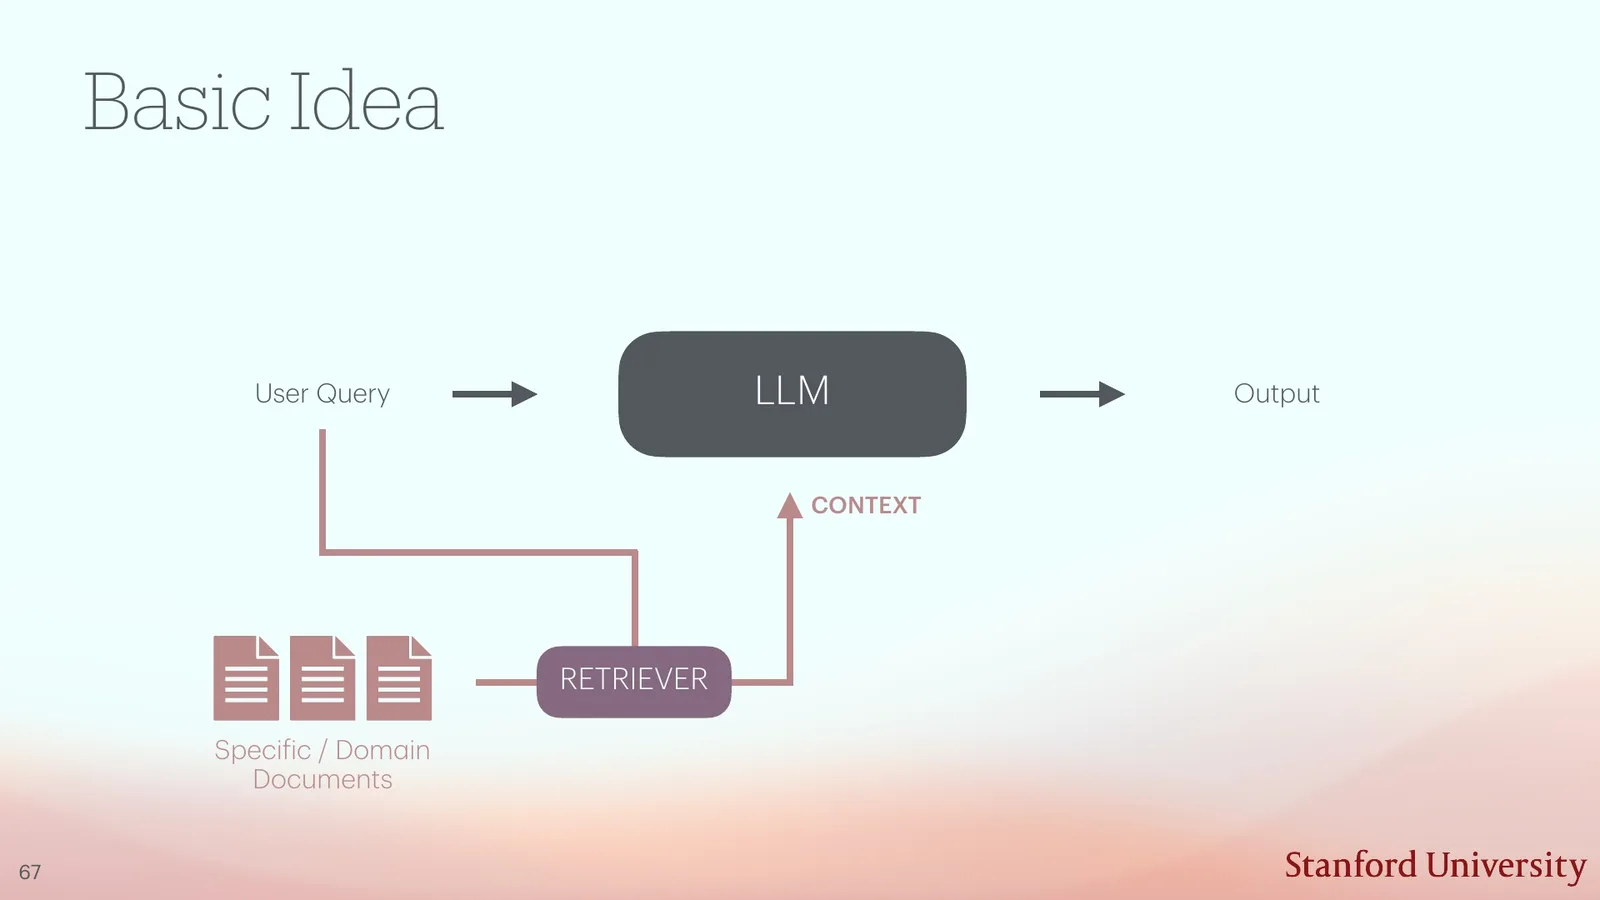
Retrieval-Augmented Generation(RAG,检索增强生成)先根据 query 从文档库取回证据,再把 query 与 evidence 一起交给语言模型。它把一部分知识更新从参数训练移到索引刷新,但增加 retrieval latency、context token、排序错误与证据冲突。
来源:CS25 V6 official deck, p. 68
来源:CS25 V6 official deck, p. 70
若总 compute budget 为 \(C\),可粗略写成
\(C_{\mathrm{pretrain}}\) 形成 parametric knowledge,\(C_{\mathrm{index}}\) 建立外部库,\(C_{\mathrm{retrieve}}\) 在每次请求中搜索,\(C_{\mathrm{generate}}\) 处理增长后的 context。RAG 不是免费知识,它把成本从一次性训练重新分配到存储和每次推理。
首次使用:parametric 与 non-parametric memory
Parametric memory 指通过梯度写入权重的统计规律;更新慢、查询便宜但来源不可直接定位。Non-parametric memory 指文档库、向量索引或数据库;更新快、来源可追踪,但依赖 retrieval quality、索引和额外 context。RAG 是二者的组合,不是“没有参数学习”。
RAG scaling:最优点取决于任务与预算
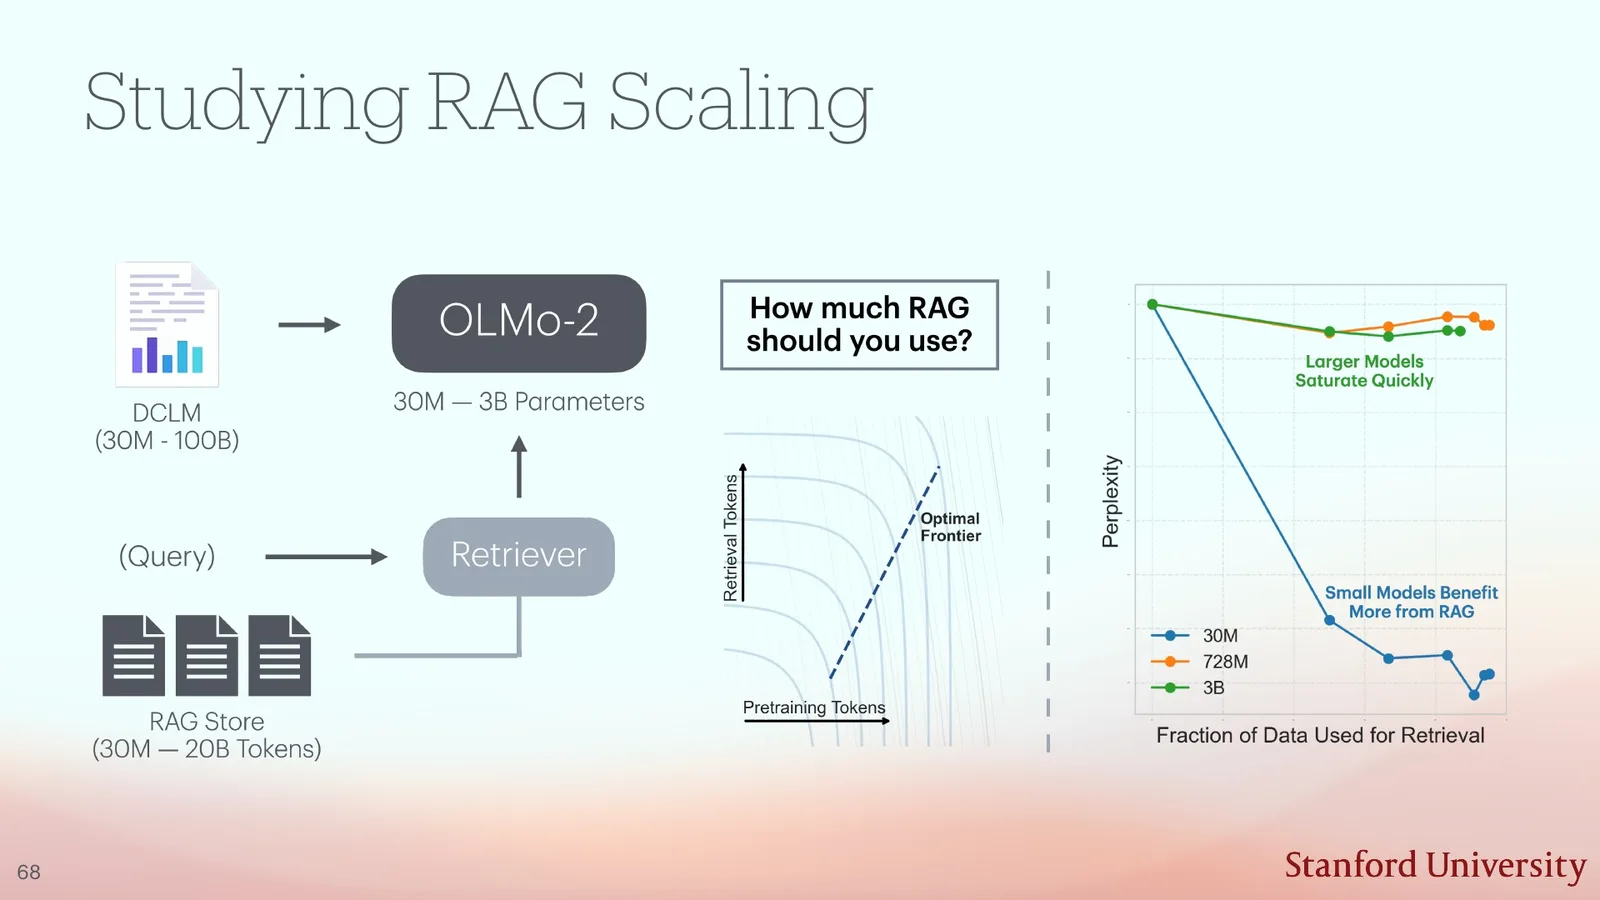
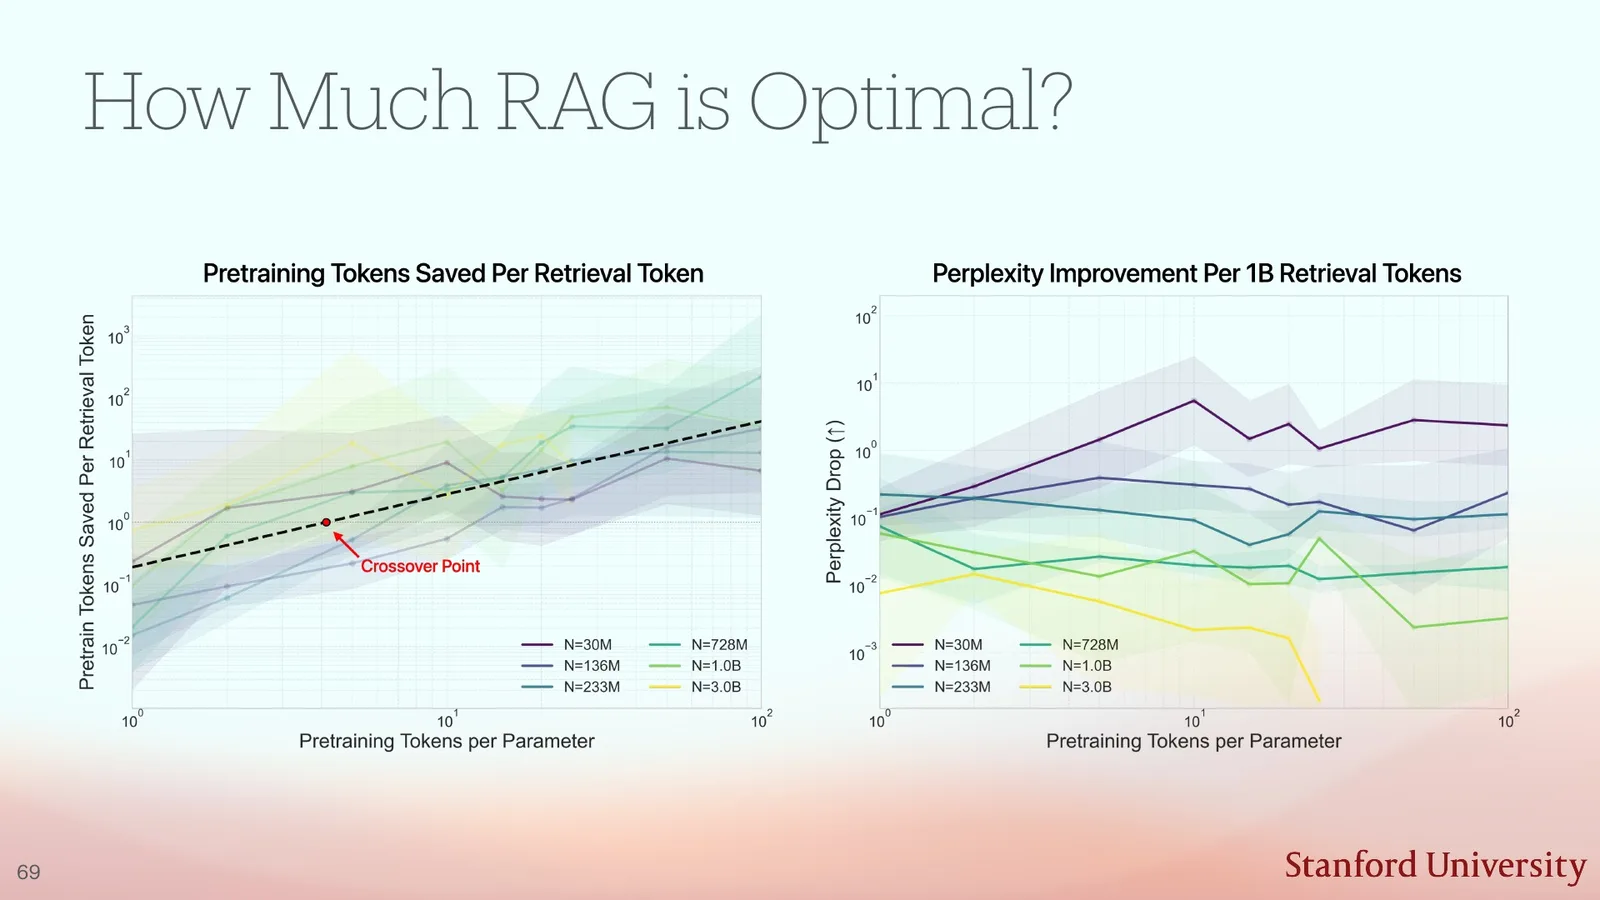
研究把 OLMo-2 一类 base model 与 retrieval 模块放进统一 compute allocation。若预训练太少,模型可能不会理解 query、证据或生成任务;若预训练过多,继续把可检索事实压入参数的边际收益变低。最优 retrieval ratio 因任务而异:知识密集问题更依赖外部证据,纯语言建模或复杂推理仍需要强 base model。
来源:CS25 V6 official deck, p. 71
来源:CS25 V6 official deck, p. 72
课堂提示
00:29:01–00:31:50,老师强调存在最低 useful pretraining budget;RAG 不能让一个几乎未训练的模型凭检索自动变强。最优点取决于 task、retriever 与总 compute,而不是固定比例。
for pretrain_budget in candidate_pretrain_budgets:
    model = train_base_model(tokens=budget_to_tokens(pretrain_budget))
    for retrieval_k in candidate_k:
        score = evaluate(
            model=model,
            retriever=index,
            k=retrieval_k,
            task=target_task,
        )
        record(pretrain_budget, retrieval_k, score)
choose_pareto_frontier()
RAG 结果最容易被忽略的三项成本
第一,检索文档会增加 input token 与 KV cache;第二,错误证据会把模型推向错误但“有依据”的答案;第三,index 更新和权限控制成为新的系统状态。只比较参数量而不计 retrieval/serving 成本,会把最优点看错。
Serving 端还要区分 prefill 与 decode。检索得到的 \(k\) 篇文档会在 prefill 阶段一次性扩大输入长度,增加 attention 与 KV cache 建立成本;之后每个 decode token 继续读取这些 cache。若用户请求高并发,较大的 evidence context 会降低可容纳 batch。另一方面,较弱 base model 可能无法正确使用文档,出现 citation copying、证据冲突或忽略 retrieval。一个完整 RAG scaling 实验因此至少报告 retrieval recall、answer quality、context length、latency、throughput 与 fresh-index update cost,而不只是最终 accuracy。
Curriculum-Guided Layer Scaling:模型和数据一起成长
Curriculum learning 按某种难度或结构排序样本。CGLS 进一步让 layer count 随训练进程增长:模型先用较浅网络处理较简单数据,再逐步插入层、提高数据复杂度。设训练进度 \(s\in[0,1]\),层数与难度 schedule 可写成
\(L(s)\) 是当前深度,\(d(s)\) 是数据难度指标。实际方法需要定义如何复制/初始化新层、如何维持 optimizer state,以及 difficulty 是否真正可测。
来源:CS25 V6 official deck, p. 75
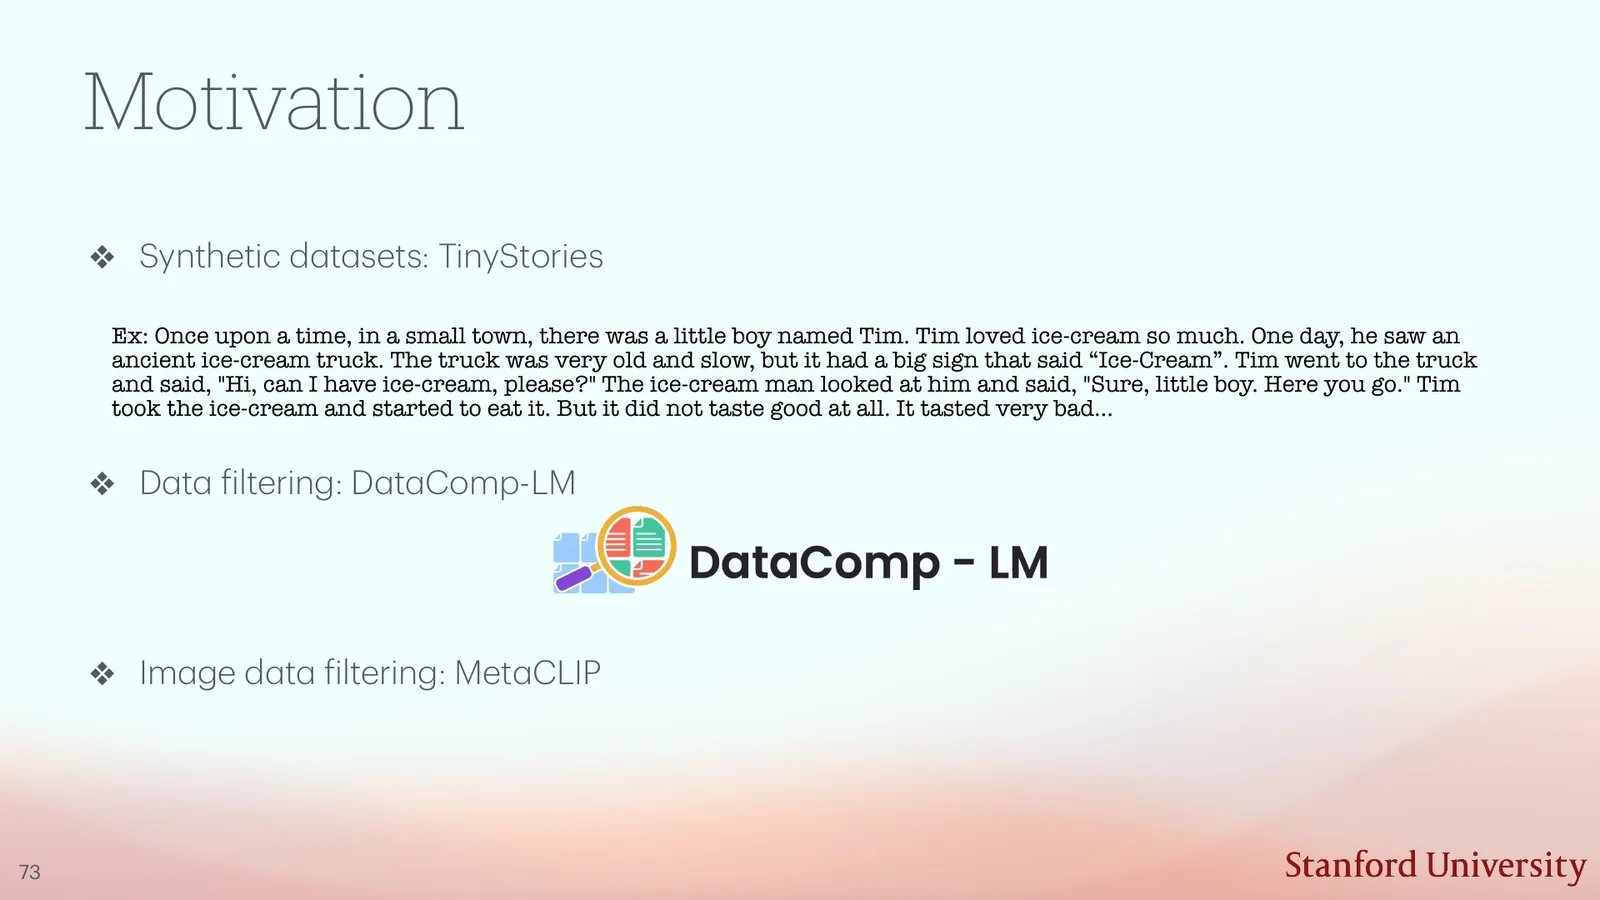
来源:CS25 V6 official deck, p. 76
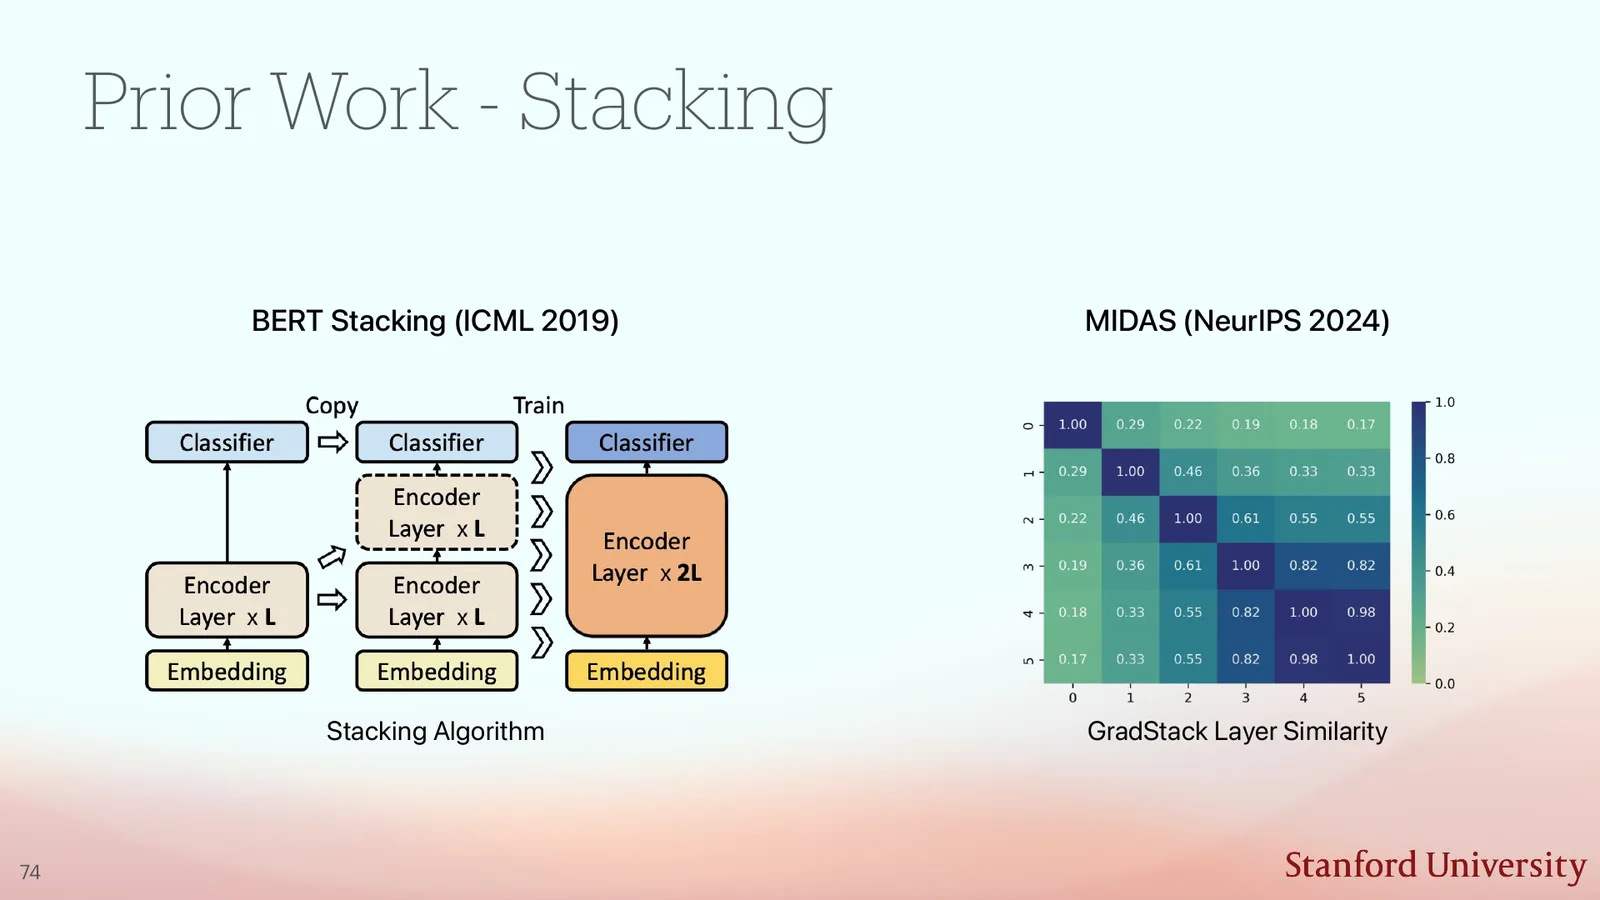
来源:CS25 V6 official deck, p. 77
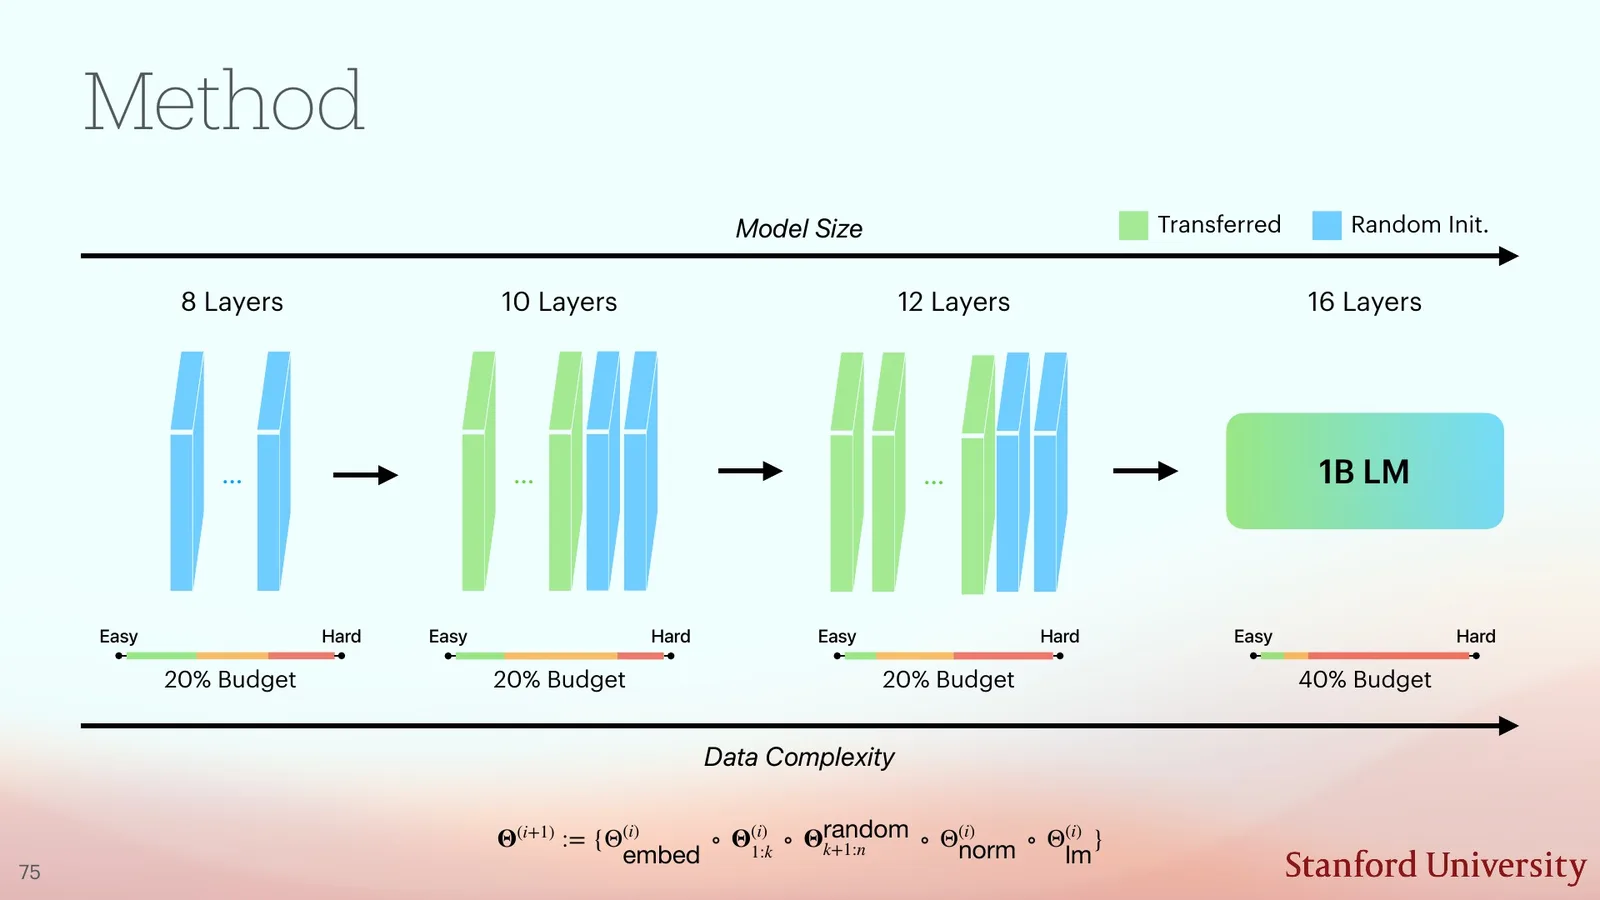
来源:CS25 V6 official deck, p. 78
读图:不要把“课程”只理解成样本排序
slide 78 同时改变 model depth、transferred layers、randomly initialized layers 与 data complexity。读结果前先问每个阶段哪些参数是继承、复制或新建的;否则性能变化可能来自参数增长、训练步数或初始化,而不只是 curriculum 本身。
for stage in schedule:
    model = grow_layers(
        model,
        target_depth=stage.depth,
        transfer=stage.transfer_policy,
    )
    data = sample_by_difficulty(
        corpus,
        min_level=stage.min_difficulty,
        max_level=stage.max_difficulty,
    )
    train(model, data, steps=stage.steps)
结果与边界:小幅收益需要正确归因
slide 79–80 汇总多个 benchmark。比较时应先找到 fixed compute/parameter baseline,再判断 CGLS 是否在平均分、perplexity 或特定任务上稳定领先。即使平均收益存在,也要检查是否牺牲个别任务,以及增长过程的额外实现复杂度是否值得。
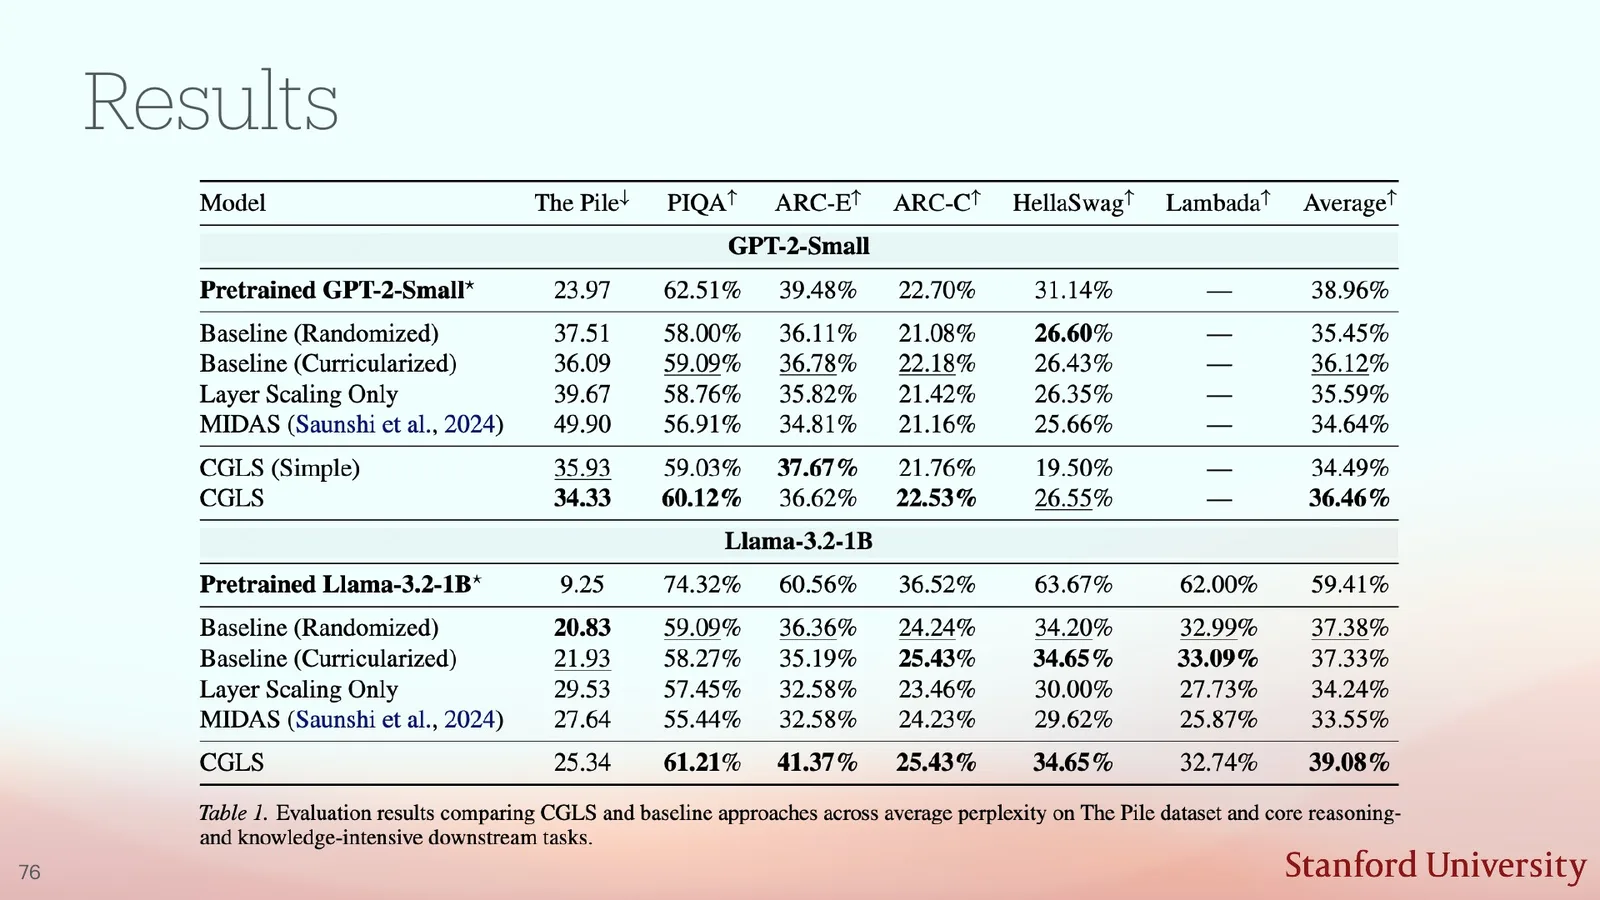
来源:CS25 V6 official deck, p. 79
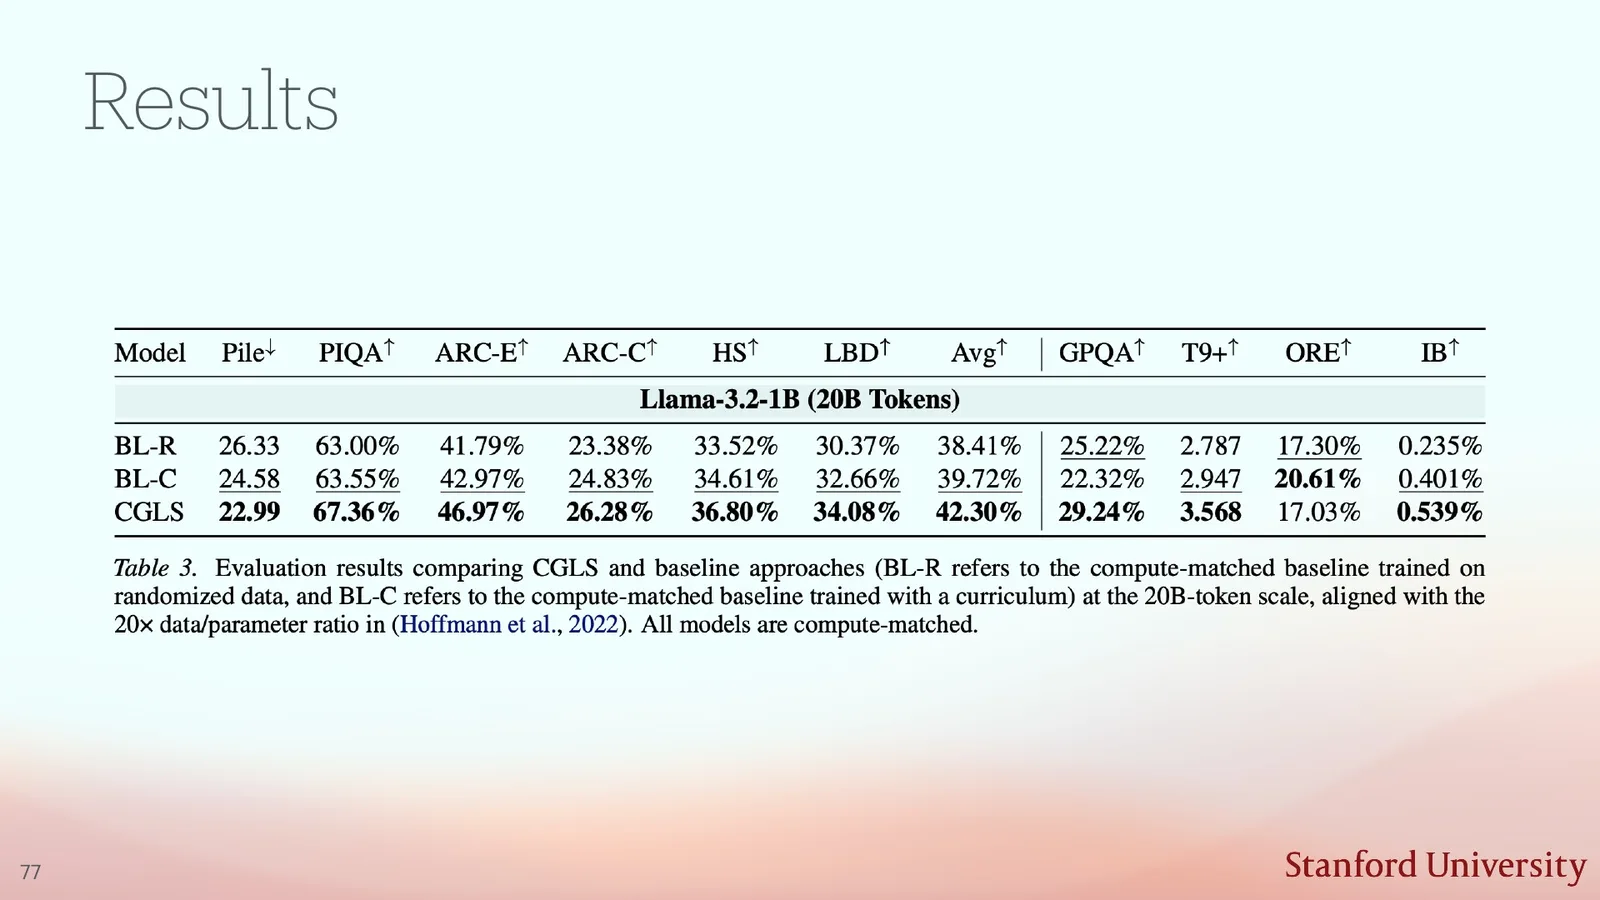
来源:CS25 V6 official deck, p. 80
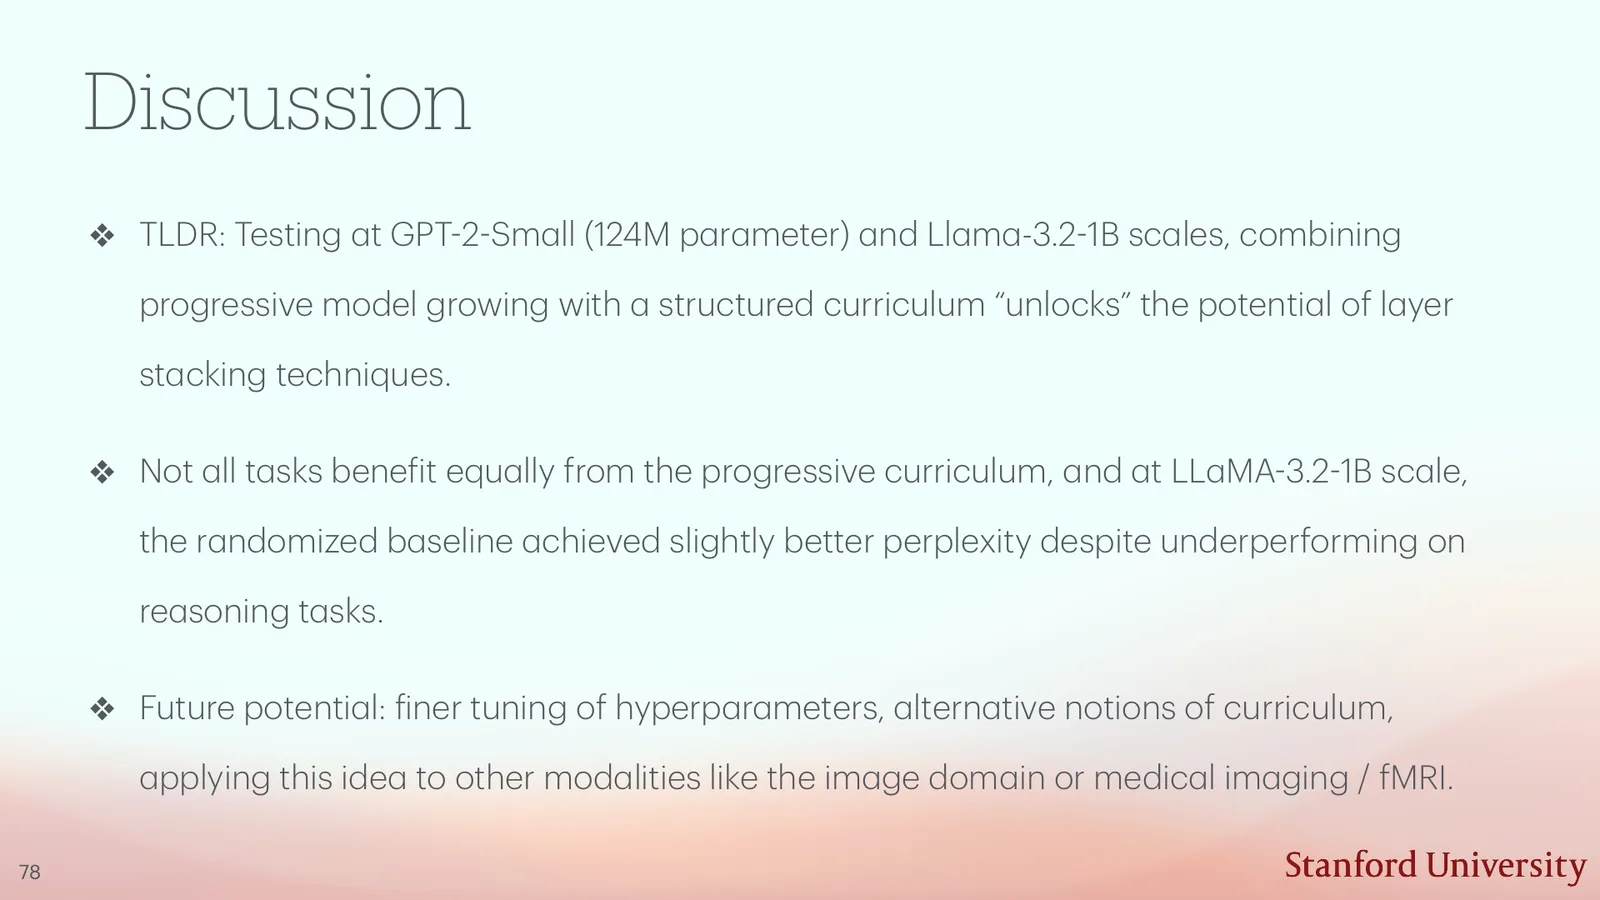
来源:CS25 V6 official deck, p. 81
课堂提示
00:31:50–00:36:33,老师把 CGLS 描述为探索性方法:结果有改善,但仍需研究 curriculum 定义、hyperparameter、其他模型族和更大的 scale。实践经验:不要把一张平均分表升级成“人类式成长规律”。
Layer growth 还引出 optimizer-state 问题。Adam/AdamW 会为每个参数维护一阶动量 \(m\) 与二阶动量 \(v\);当新层加入时,这些 optimizer state 没有历史。复制已有层可继承表示,却可能造成层间同质化;随机初始化保持多样性,却在训练中制造分布突变。公平比较应说明新层权重、\(m/v\)、learning-rate warmup 与 residual scale 如何初始化,并按总 FLOPs 或总更新量匹配 baseline。否则 CGLS 的收益可能来自额外训练阶段,而不是 curriculum 与深度共同增长本身。
统一数据视角:selection、mixture、retrieval 与 curriculum
四个项目可归纳为一张决策表:Baby Scale 研究 source selection,Bilingual BabyLM 研究 mixture structure,RAG 研究 knowledge externalization,CGLS 研究 order 与 co-scaling。它们共同说明,data strategy 不只是训练前过滤,而是贯穿参数学习、推理和模型成长的系统变量。
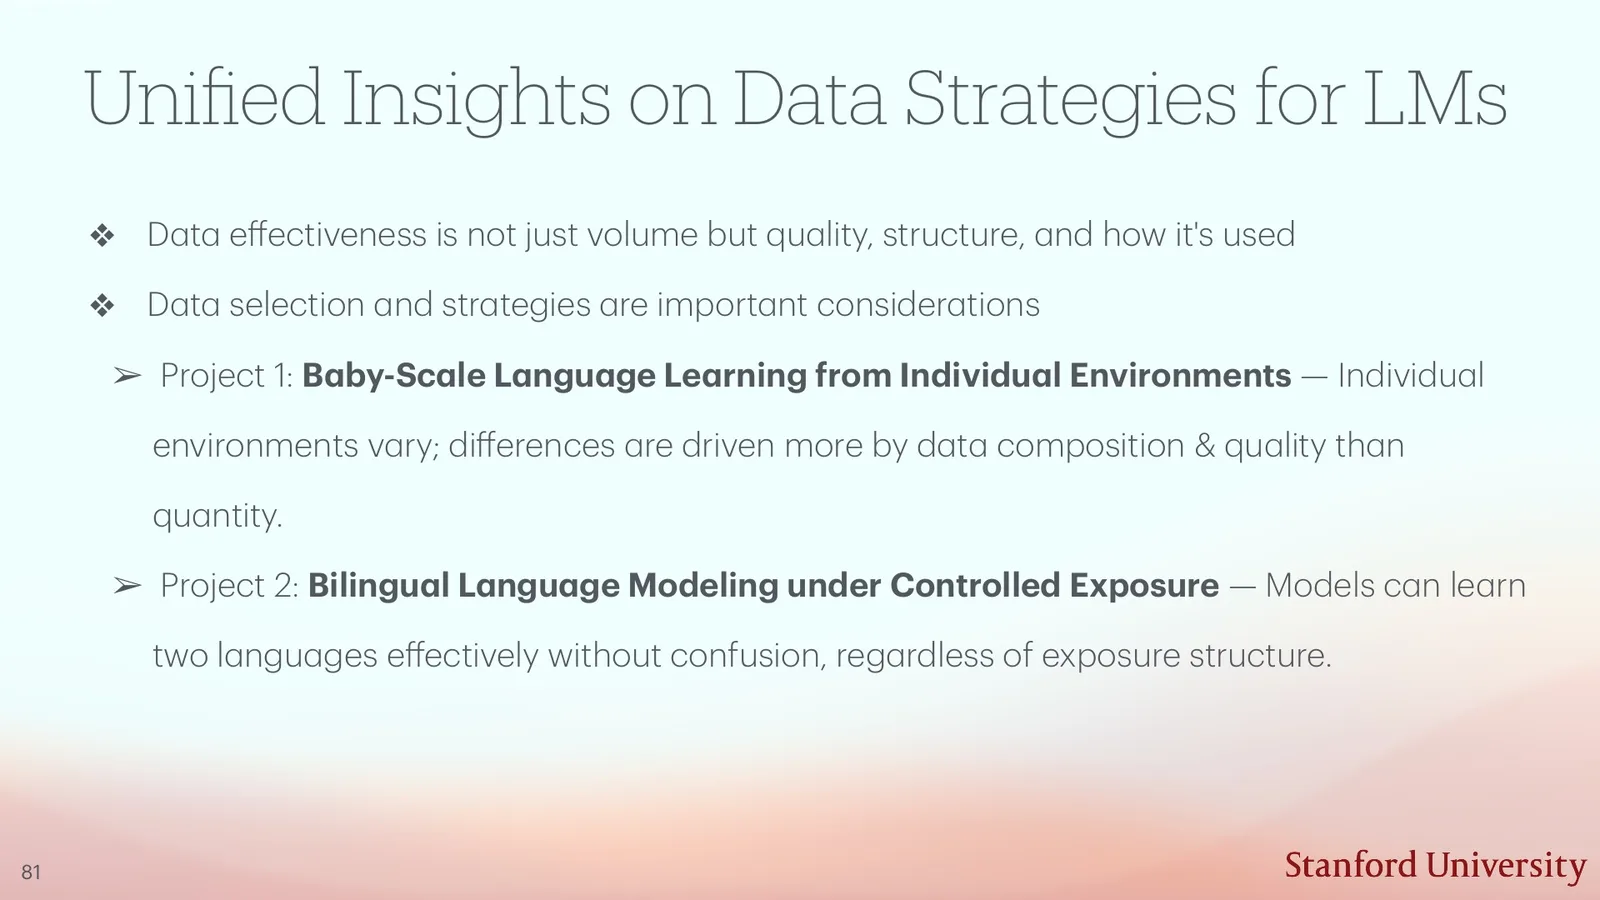
来源:CS25 V6 official deck, p. 84
来源:CS25 V6 official deck, p. 85
来源:CS25 V6 official deck, p. 86
数据策略选择清单
若问题是训练语料噪声,先做 selection/filtering;若问题是语言或领域失衡,调 mixture;若知识经常更新且需来源,考虑 RAG;若训练早期与后期适合不同样本,设计 curriculum;若模型容量随阶段改变,必须把 architecture growth 纳入实验。不同旋钮不能用同一个“数据质量”指标代替。
本章小结
RAG 把知识位置从参数扩展到外部 memory,CGLS 把学习顺序扩展到模型深度与数据难度的共同 schedule。两者都揭示 scaling 的核心是资源分配,而不是无条件增加 token 或参数。下一章转向模型训练完成后仍可改变行为的 post-training 与 inference-time compute。
Post-training 与 inference-time compute:行为怎样在预训练后继续改变
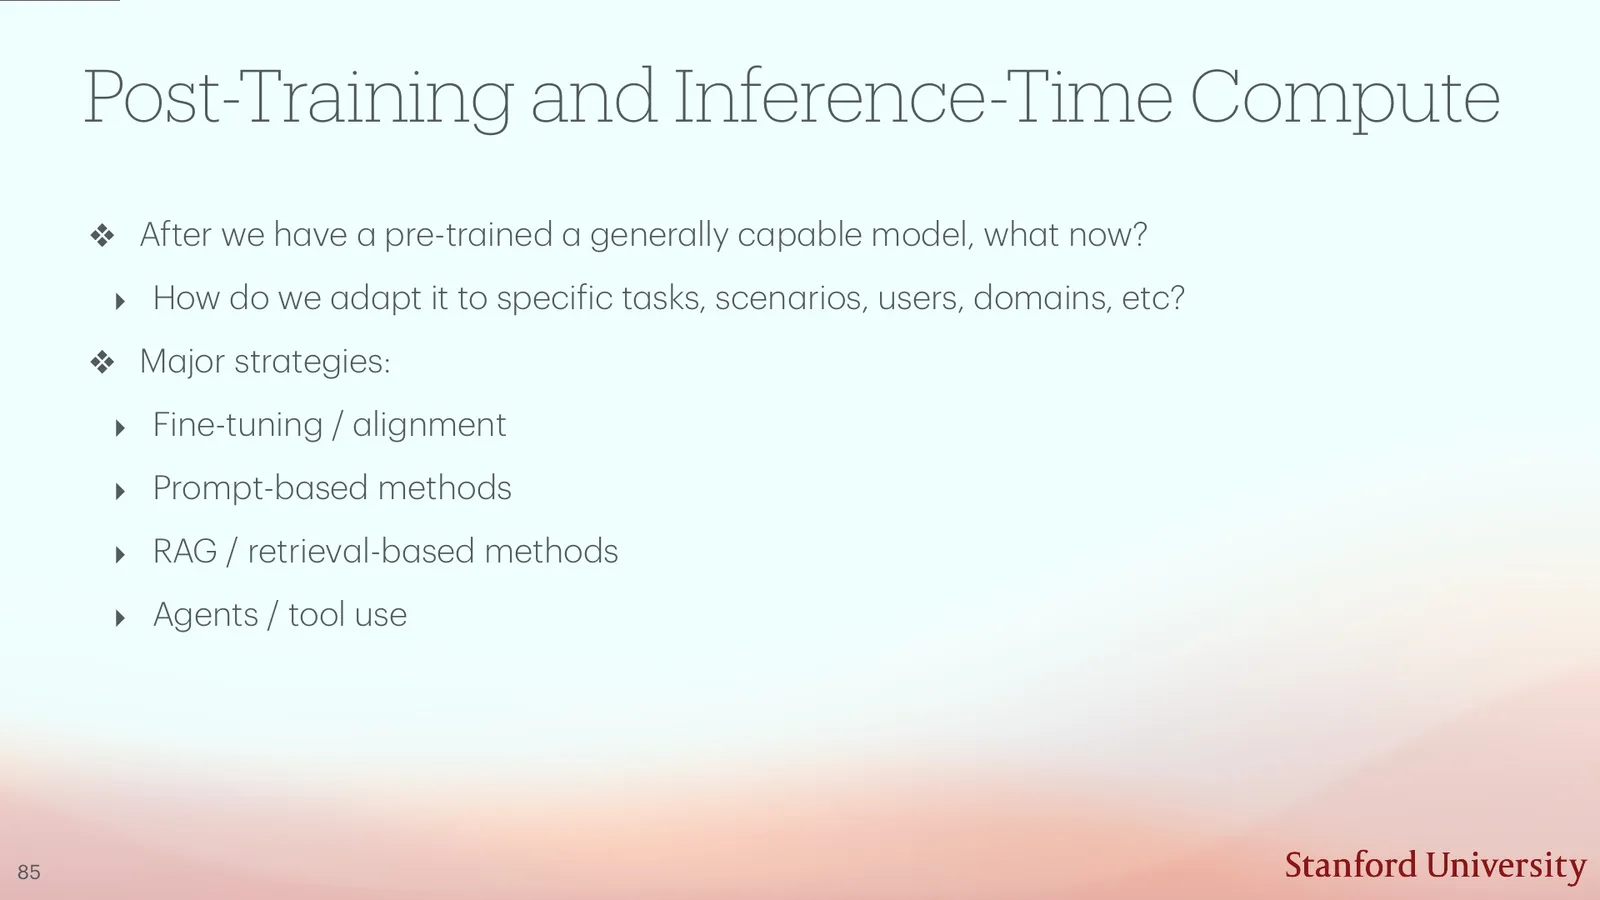
Pretraining 让模型获得广泛条件分布,但不会自动把输出变成可控助手。Post-training 可以改变参数,也可以在推理时增加 prompt、搜索、检索、工具或 verifier。判断一个方法时先问:它更新权重、改变解码、增加外部状态,还是重新定义奖励?否则 CoT、RLHF、RAG 与 agent 很容易被混成一个模糊的“增强层”。
Post-training 地图:训练后还有哪些旋钮
课程把 post-training 与 inference-time compute 放在同一页:prompt engineering、instruction tuning、preference optimization、retrieval、agents/tools 都能改变部署行为。若基础模型分布为 \(p_0(y\mid x)\),post-training 得到 \(p_{\theta}(y\mid x)\),推理时策略还可写成
\(\mathcal{S}(x;B)\) 是预算 \(B\) 内生成的候选集合,\(s_{\theta}\) 是模型分数,\(r\) 是 verifier/reward。增加 inference-time compute 扩大候选或验证深度,却不会修复完全缺失的知识与工具权限。
来源:CS25 V6 official deck, p. 88
课堂提示
00:36:33–00:38:05,老师把 prompting、fine-tuning、preference learning、retrieval 与 agent/tool use 视为不同干预位置。课堂提示:部署行为来自 base model 与推理系统共同作用。
四种“改进模型”的含义
- Update weights:SFT、DPO、RL 等直接改变参数;
- Change decoding:self-consistency、search、reranking 改变候选选择;
- Add context/state:RAG、memory、tool outputs 增加可见信息;
- Change environment:agent loop 让模型行动并获得新 observation。
四者的成本、可回滚性和失败模式完全不同。
从 CoT 到可执行分解
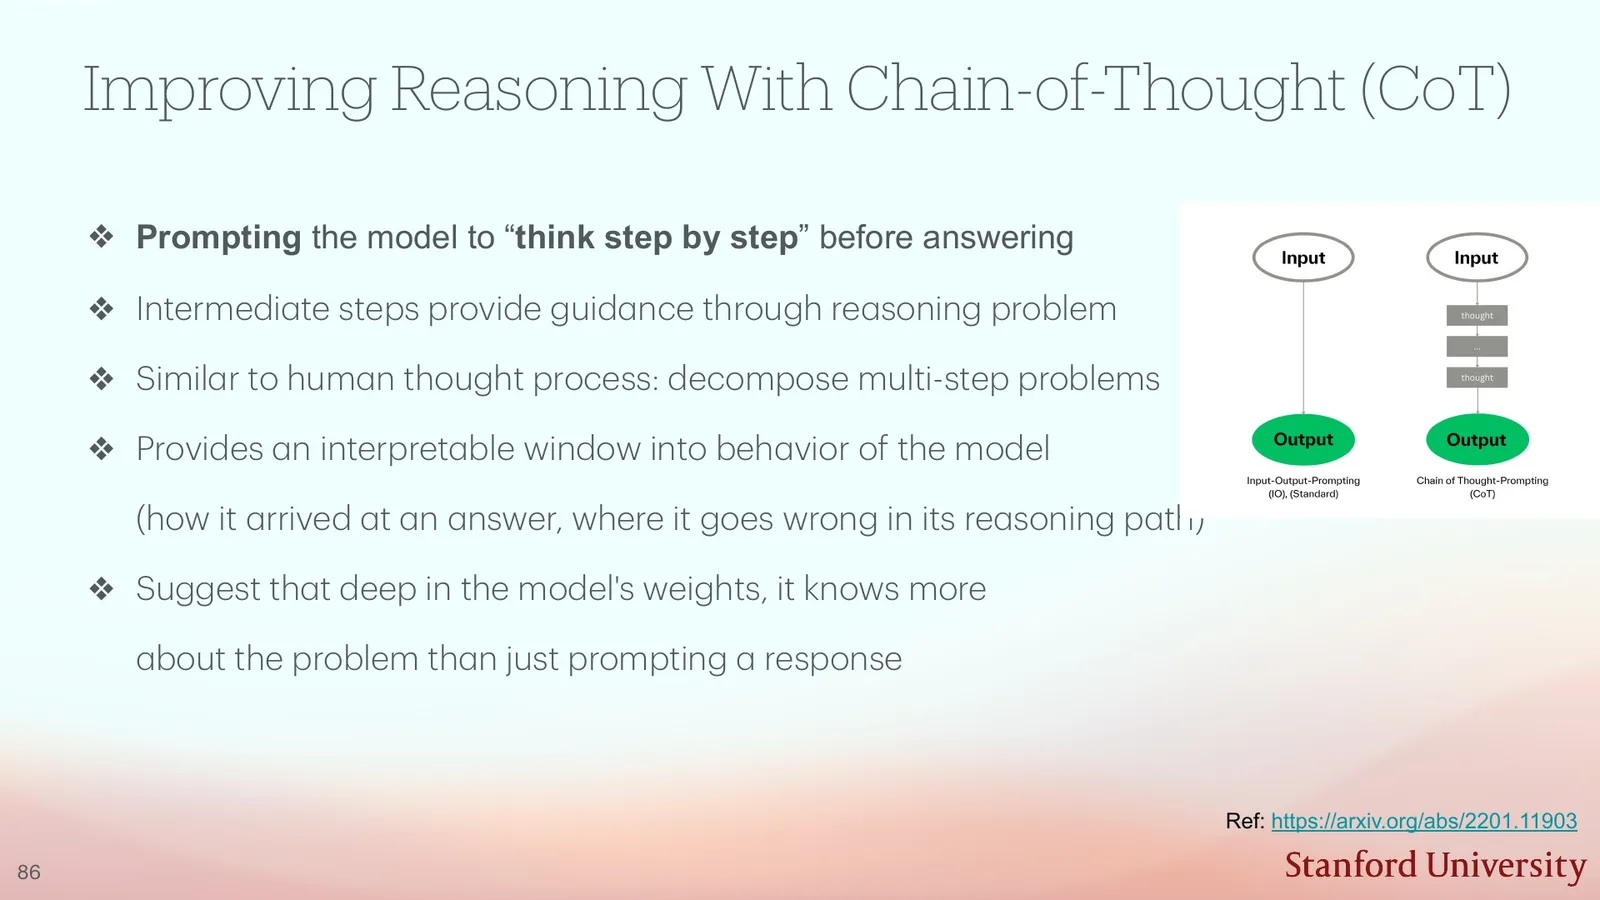
Chain-of-Thought(CoT)要求模型输出中间步骤,把一次性映射拆成顺序推理。它可能提高复杂任务表现,也可能生成听起来合理但不忠实的解释。Tree-of-Thoughts 扩大为多分支搜索;Program-of-Thought 把部分计算交给解释器;Socratic questioning 和 computation graph 则显式定义子问题依赖。
来源:CS25 V6 official deck, p. 89
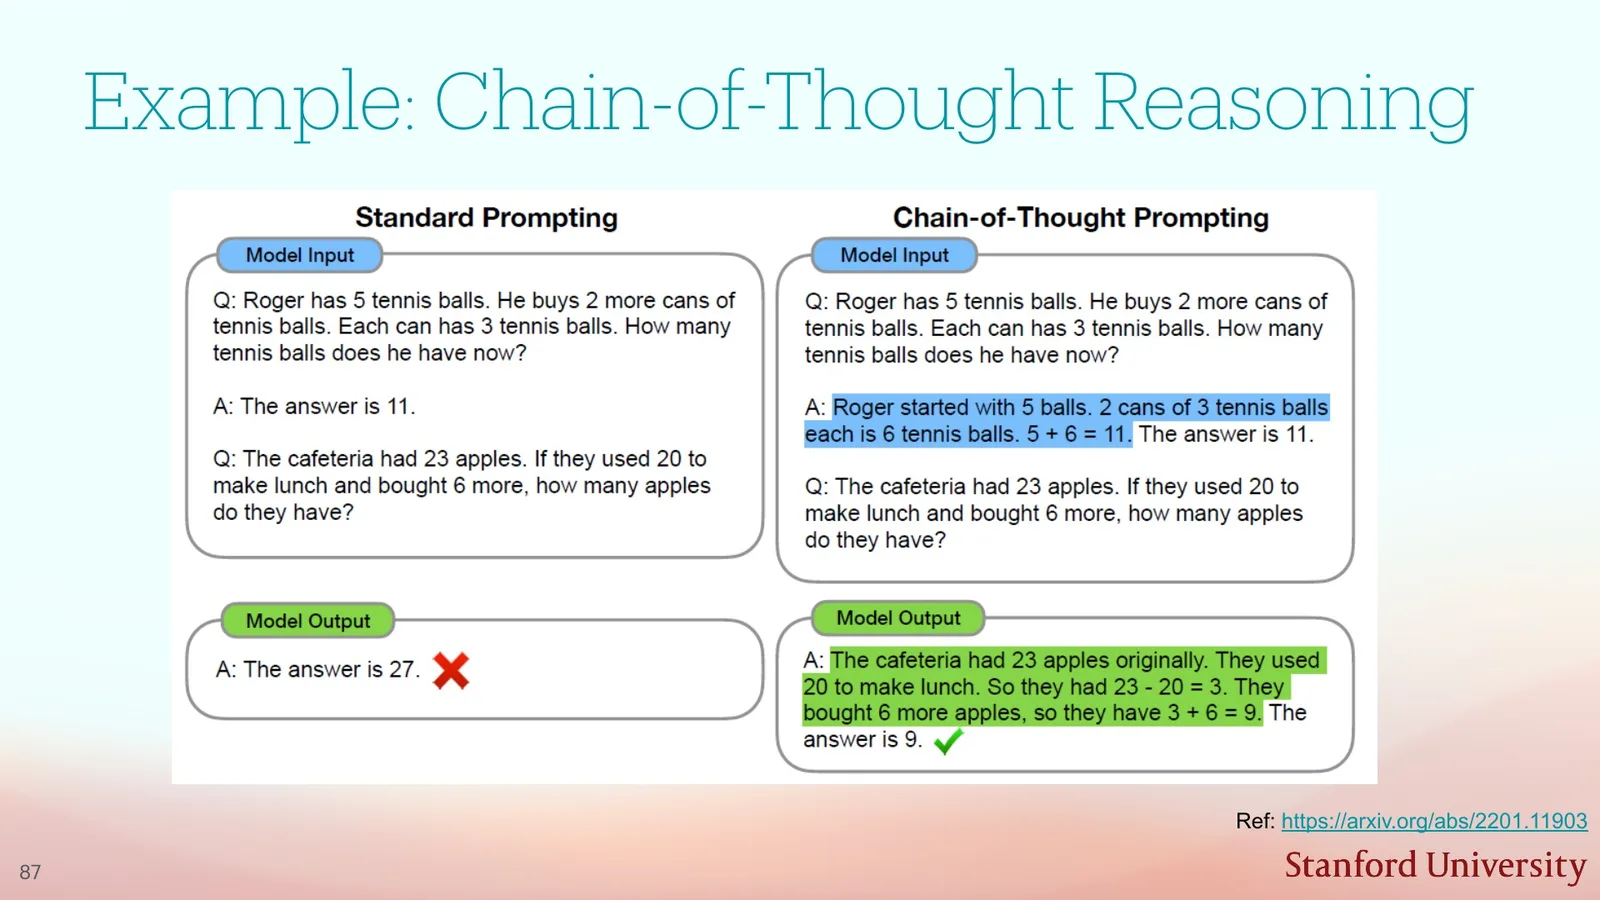
来源:CS25 V6 official deck, p. 90
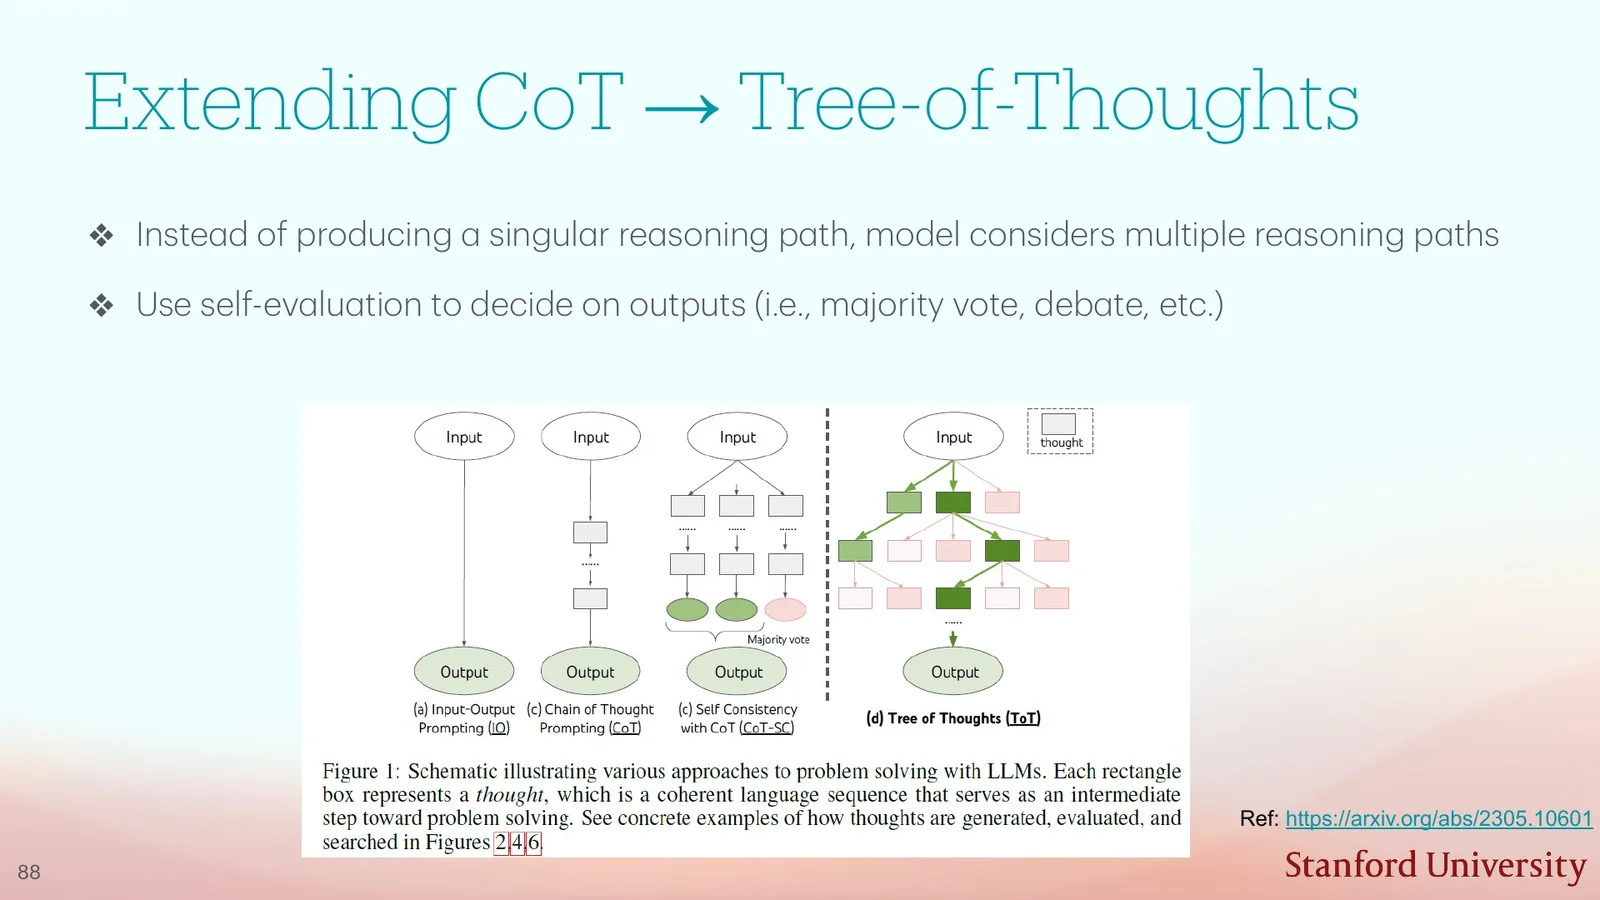
来源:CS25 V6 official deck, p. 91
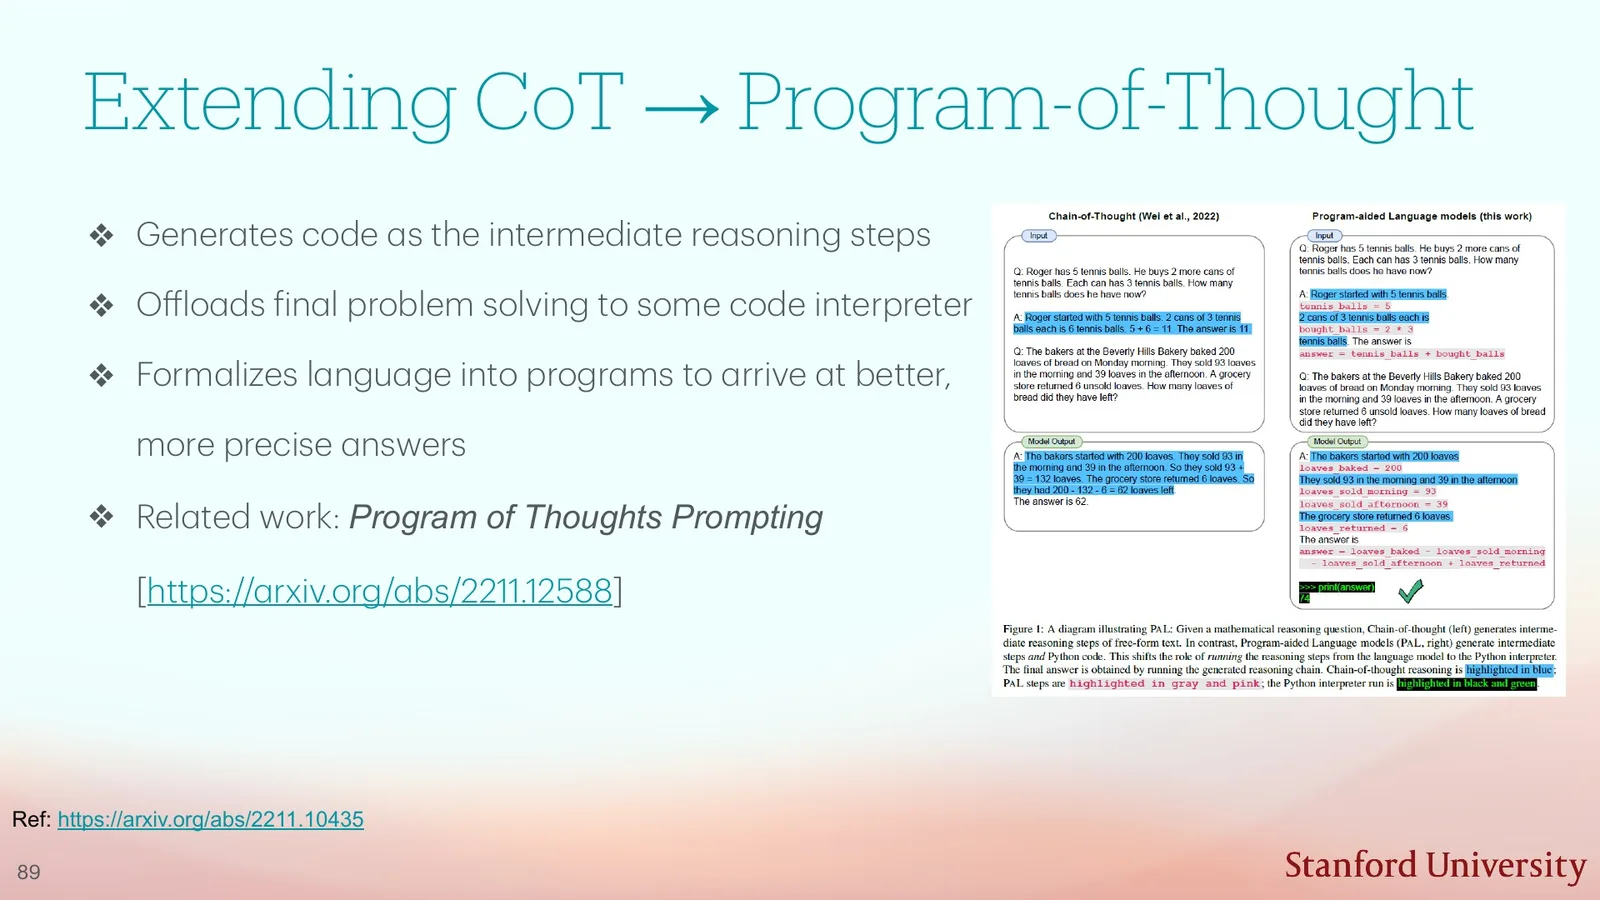
来源:CS25 V6 official deck, p. 92
读图:四种方法改变的是不同接口
CoT 增加顺序 token;ToT 增加候选分支与 search controller;Program-of-Thought 增加 executable tool;Socratic/computation graph 增加显式 dependency structure。它们都可被称为“reasoning”,但 compute、可验证性与错误传播路径不同。
Socratic decomposition 可把任务图写成有向无环图 \(G=(V,E)\),每个节点 \(v_i\) 是子问题,边 \((v_j,v_i)\) 表示 \(i\) 依赖 \(j\)。只有当所有前驱完成后才求解 \(v_i\)。这种结构便于局部验证,却引入 decomposition error:若一开始漏掉关键节点,后续每一步都可能局部正确而全局失败。
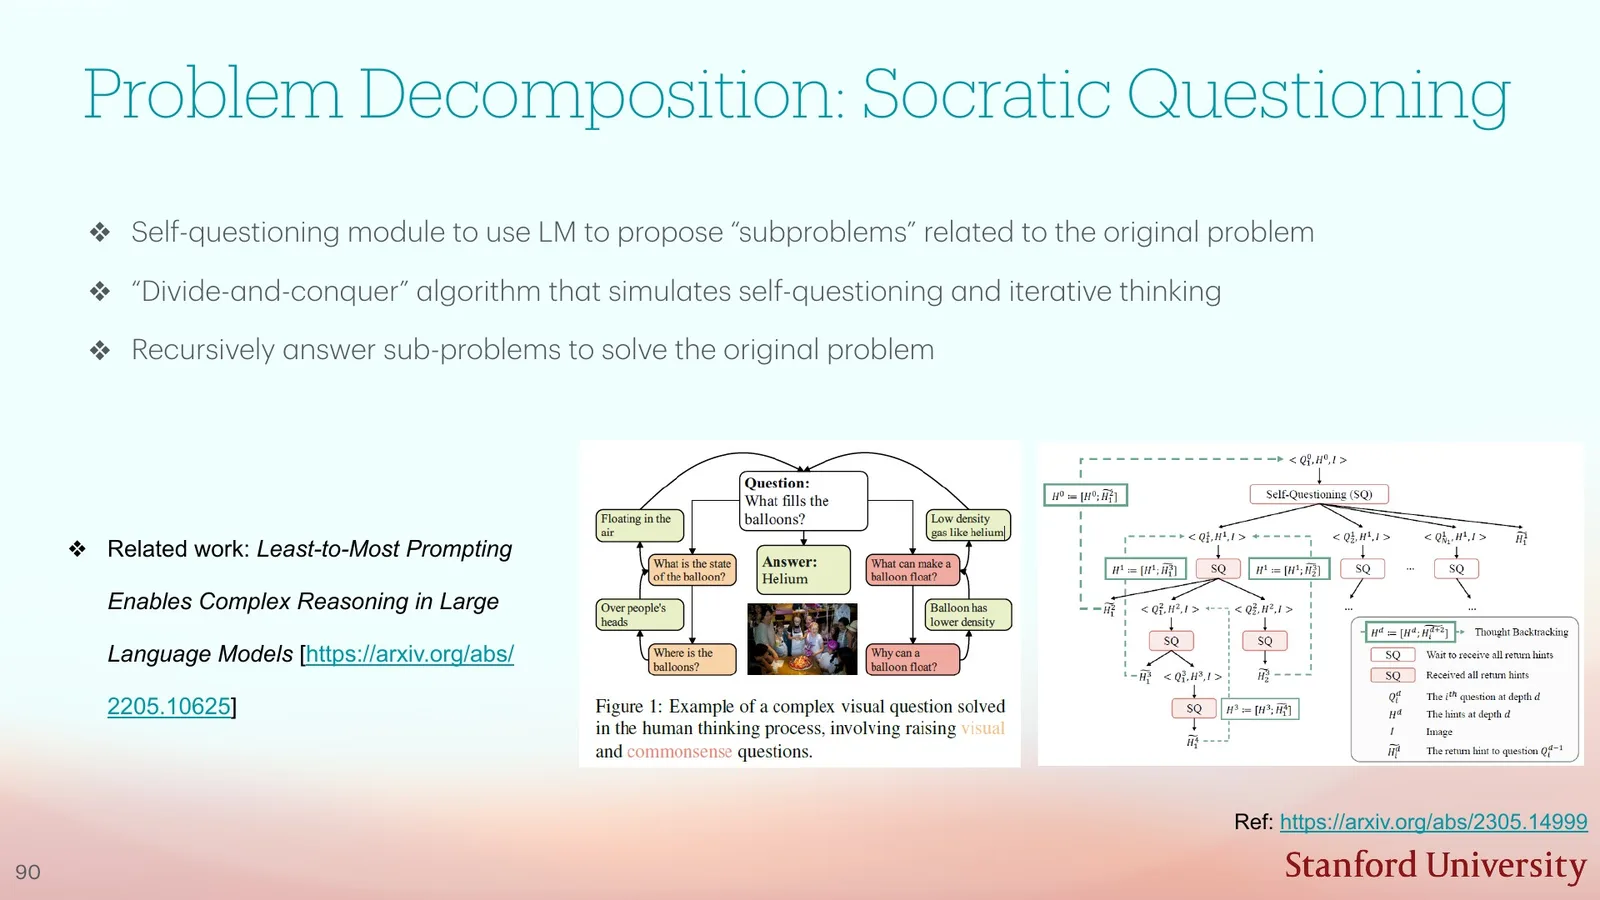
来源:CS25 V6 official deck, p. 93
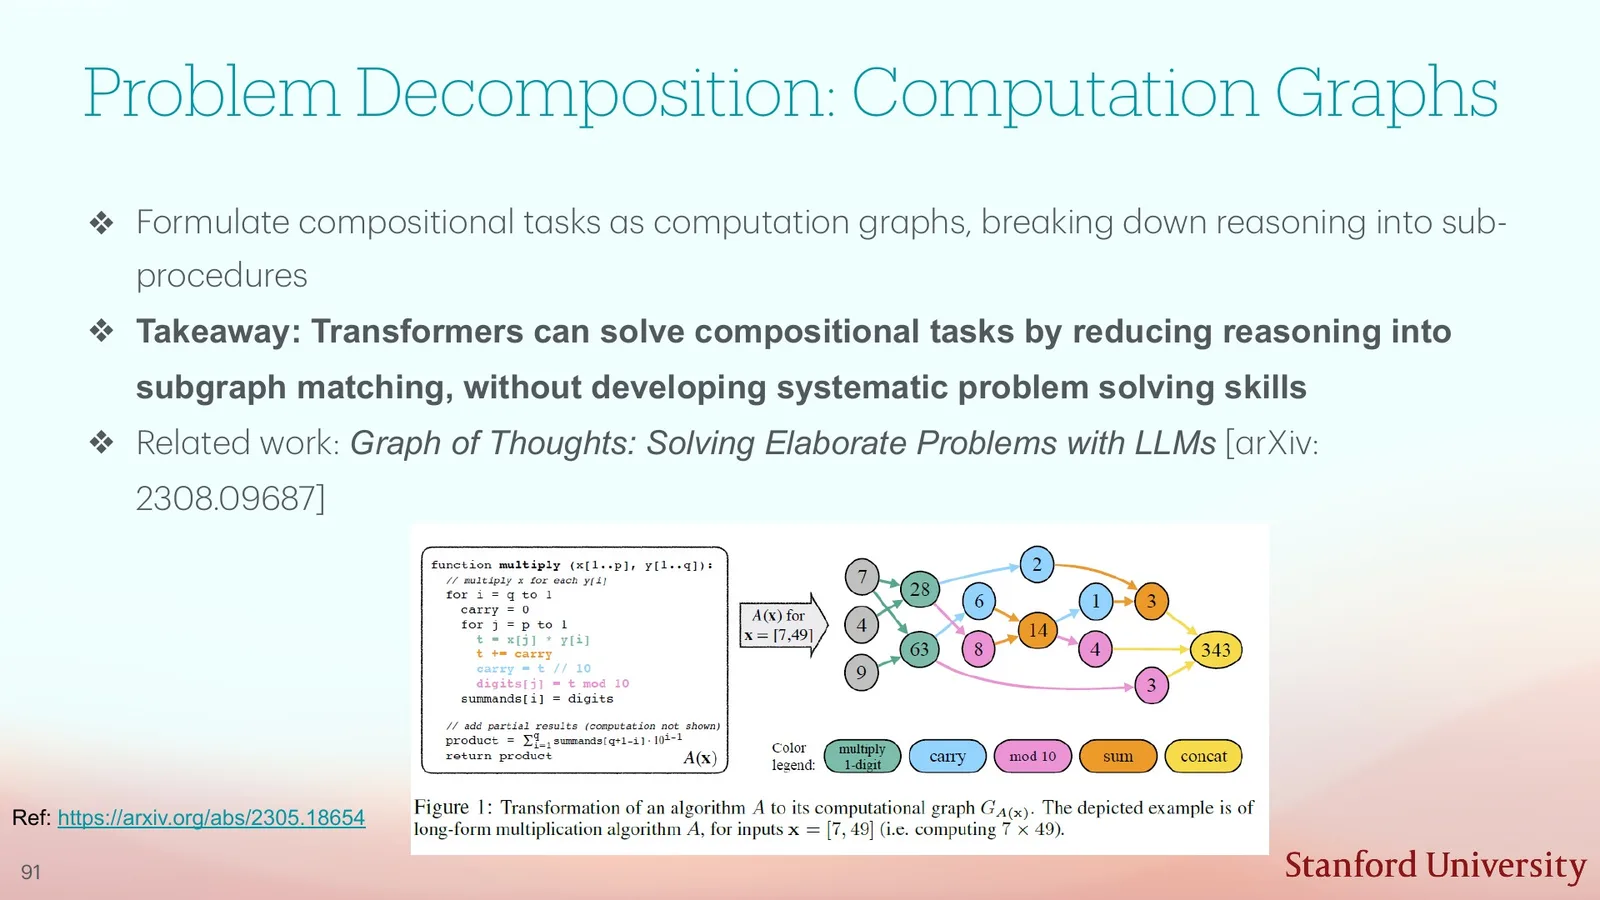
来源:CS25 V6 official deck, p. 94
课堂提示
00:38:05–00:40:36,老师把 CoT 的扩展分成 branching、execution 与 structured decomposition。讲义提醒:更多 reasoning token 是搜索预算,不等于这些 token 忠实反映模型内部因果过程。
frontier = [initial_state(problem)]
for depth in range(max_depth):
    candidates = []
    for state in frontier:
        for thought in model.propose(state, branches=k):
            next_state = state.extend(thought)
            score = verifier(next_state)
            candidates.append((score, next_state))
    frontier = top_b(candidates, beam_width)
return select_final(frontier)
Reasoning trace 的三种证据强度
一条 trace 可以是可读解释、帮助得到答案的 scratchpad,或忠实描述内部计算的因果证据。前两者常见,第三者需要 intervention、counterfactual 或 mechanistic evidence。不能因文本步骤正确,就断言模型“正是这样想的”。
RLHF、DPO、RLAIF 与 GRPO:反馈源和优化路径不同
Reinforcement Learning from Human Feedback(RLHF)通常先收集偏好,再训练 reward model,最后用 policy optimization 改变生成策略。Direct Preference Optimization(DPO)跳过显式 reward model 与在线 RL,直接优化偏好对:
\(y^+\) 与 \(y^-\) 是 preferred/rejected response,\(\pi_{\mathrm{ref}}\) 是参考策略,\(\beta\) 控制偏离程度。
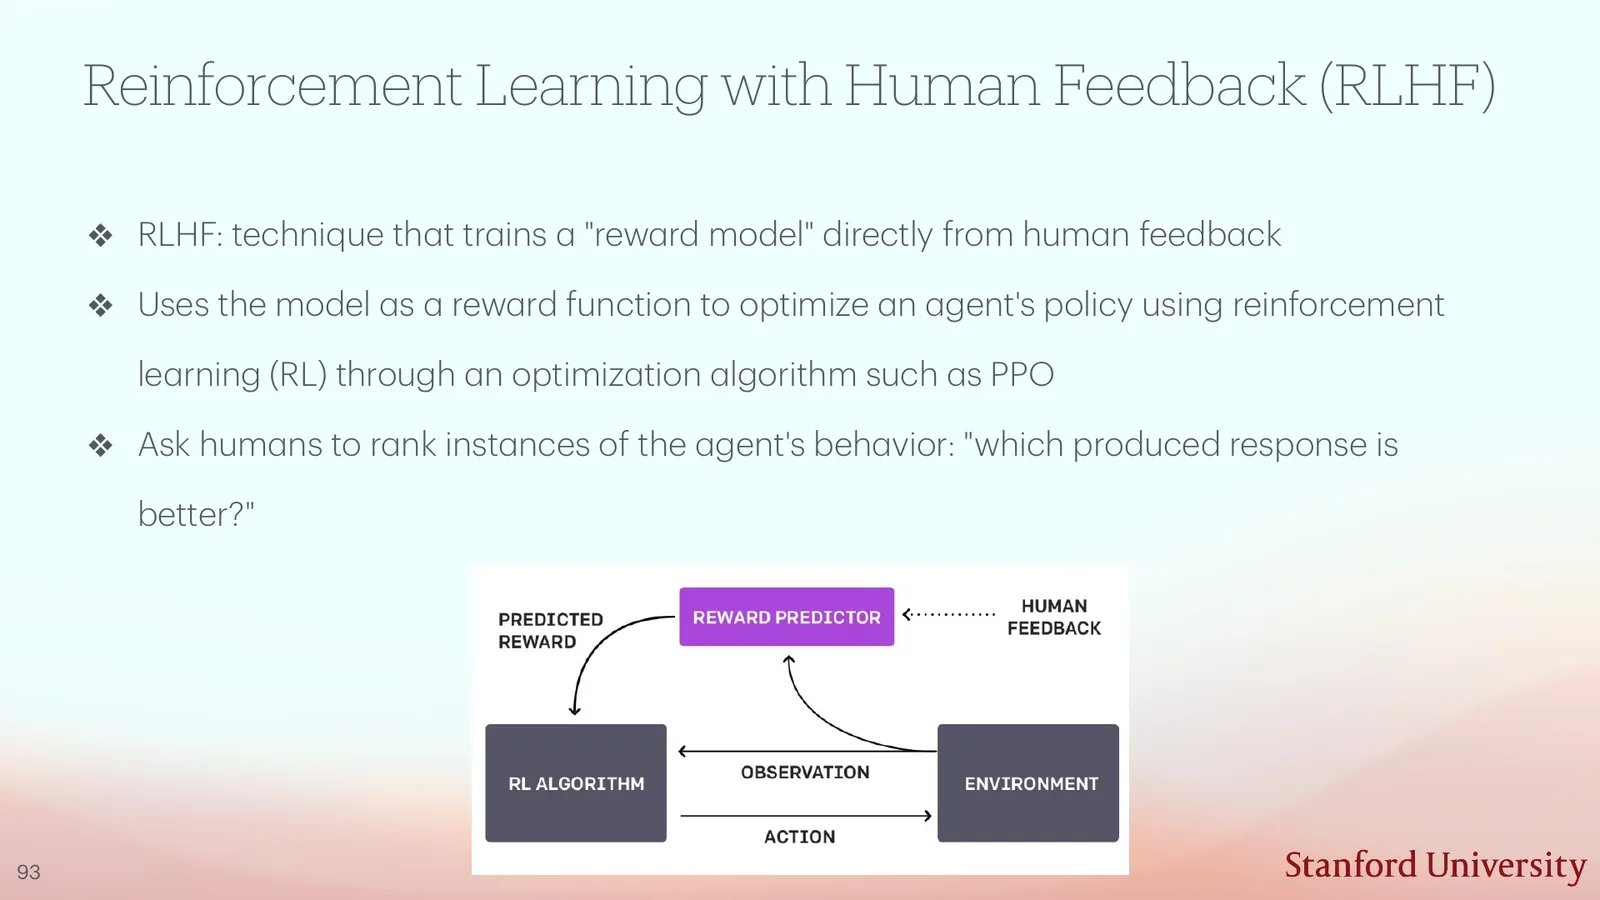
来源:CS25 V6 official deck, p. 96
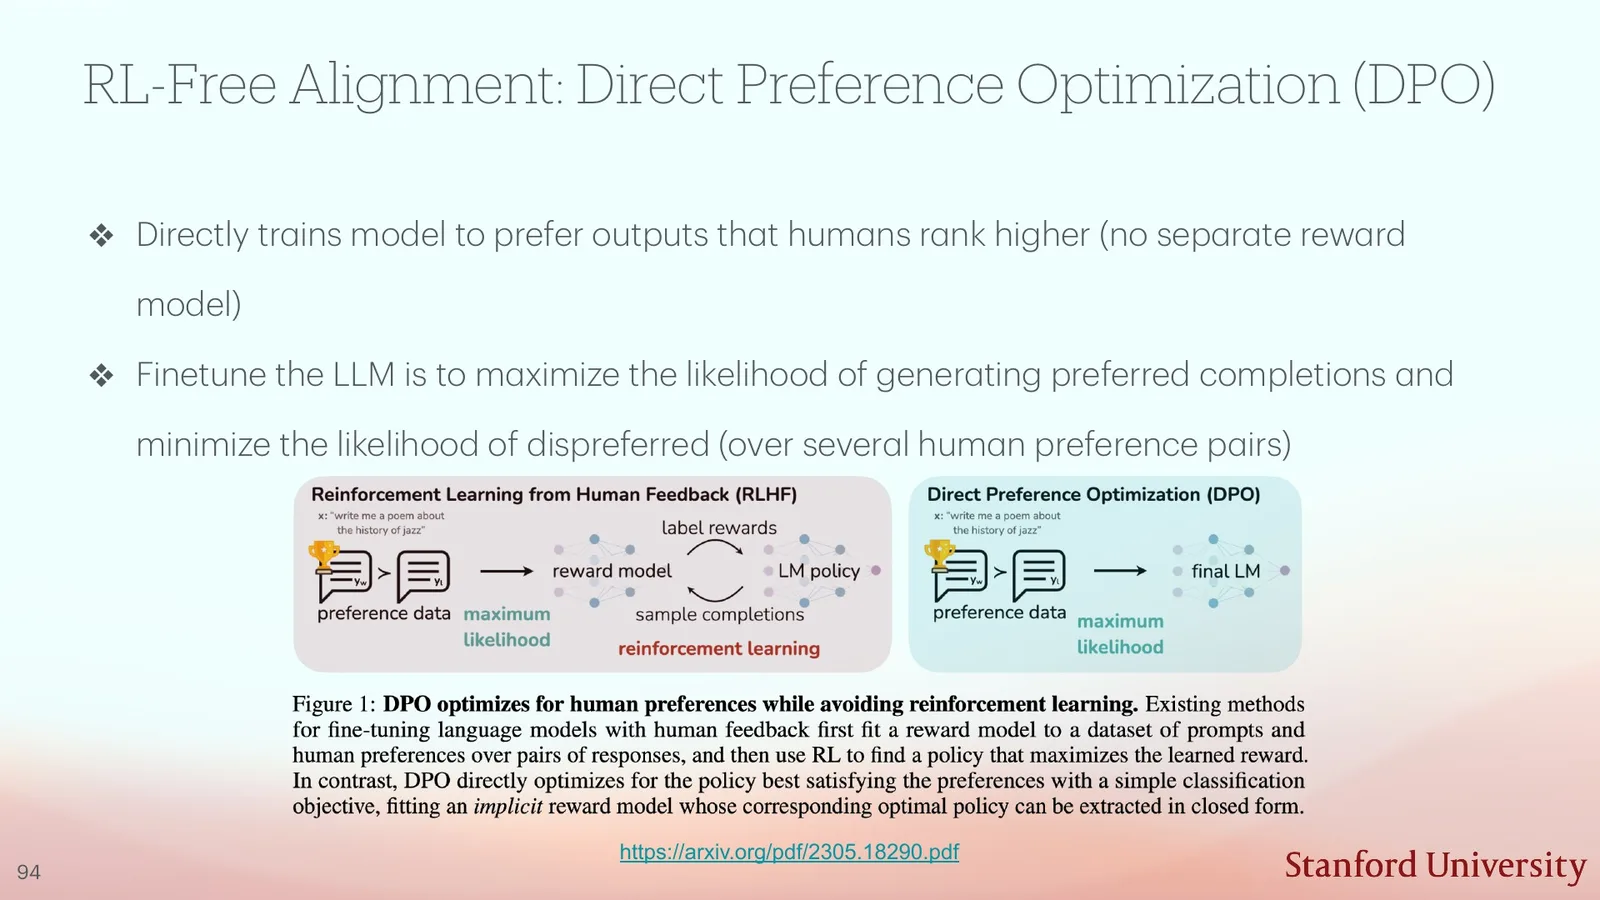
来源:CS25 V6 official deck, p. 97
RLAIF 用 AI 生成或判断偏好,降低人工成本,却可能放大 teacher model 的偏见。GRPO 在同一 prompt 下采样一组回答,用组内相对 reward 构造 advantage。若 reward 为 \(r_i\),组均值与标准差为 \(\mu_r,\sigma_r\),则可写成
它避免单独 value model 的一部分成本,但仍依赖 reward/verifier 是否可信,也可能通过 group sampling 产生高推理开销。
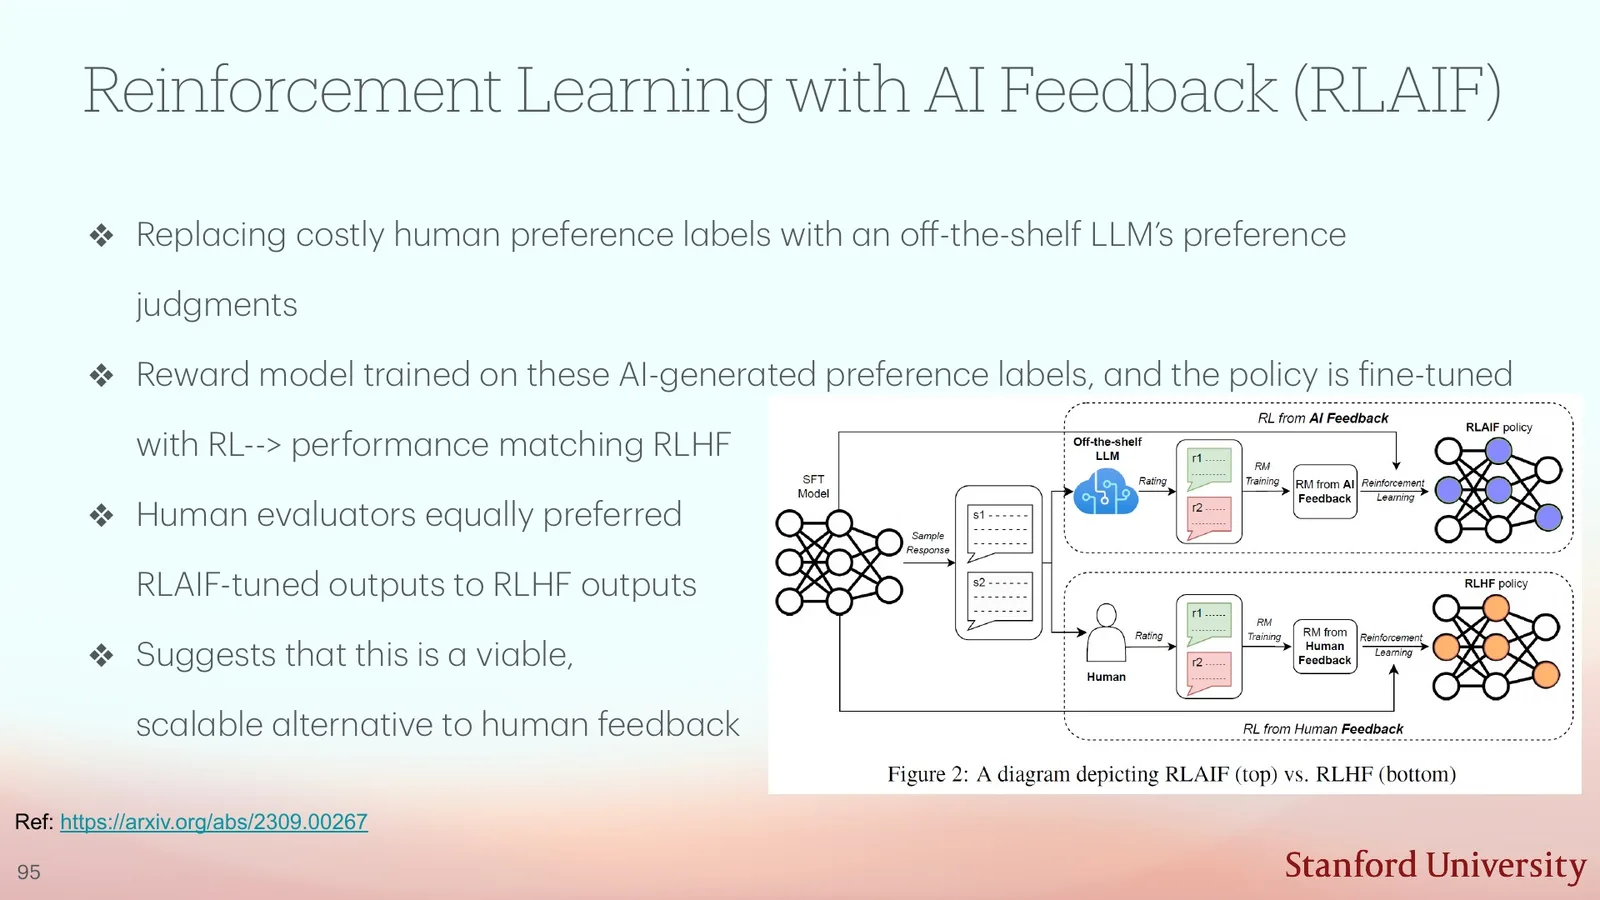
来源:CS25 V6 official deck, p. 98
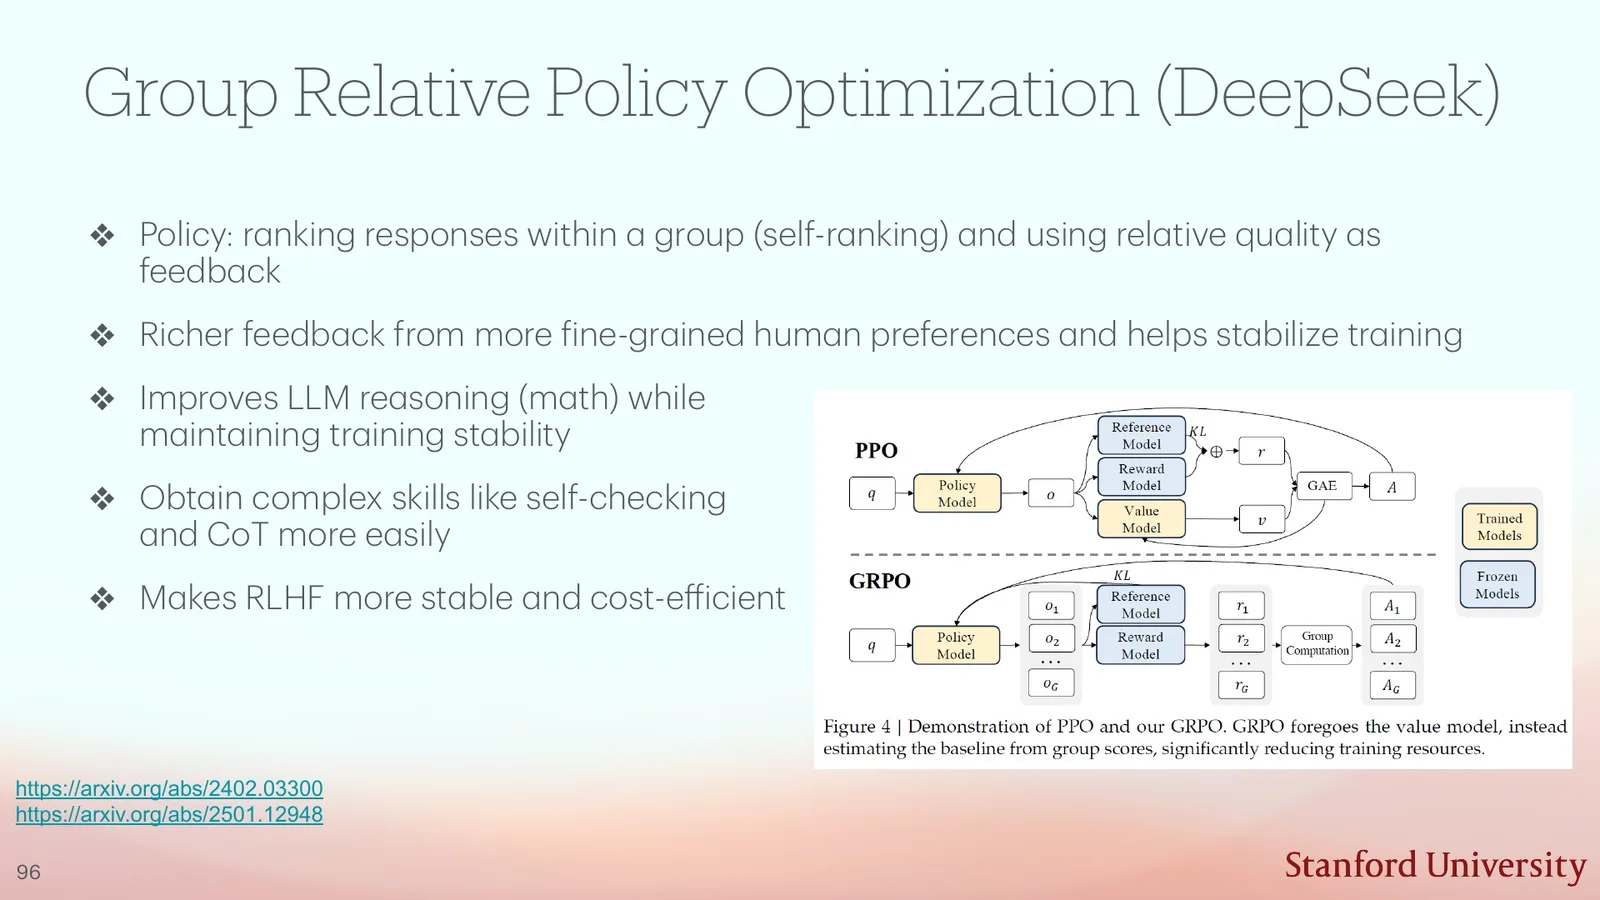
来源:CS25 V6 official deck, p. 99
术语消化:偏好优化方法到底差在哪里
| 方法 | 反馈来源/中间模型 | 核心机制与主要风险 |
|---|---|---|
| RLHF | 人类偏好 + reward model | 在线/近在线 policy optimization;reward hacking 与训练复杂度高 |
| DPO | 人类或 AI 偏好对 | 直接分类式目标;更简单但仍受偏好数据质量约束 |
| RLAIF | AI critic 或 constitutional feedback | 降低人工成本;teacher bias 可被系统化放大 |
| GRPO | 可验证 reward + 组内样本 | 相对 advantage、无需独立 value model;采样成本与 verifier 偏差明显 |
Process supervision:奖励步骤还是只奖励终点
Outcome supervision 只看最终答案,模型可以通过 shortcut 偶然得分;process supervision 为中间步骤提供标签或 reward。若 reasoning trace 为 \(z_{1:m}\),可写成
\(r_i\) 评价第 \(i\) 步,\(w_i\) 是权重。难点在于谁来定义“正确步骤”、如何处理多条等价路径,以及模型是否学会迎合 checker 而不是解决问题。
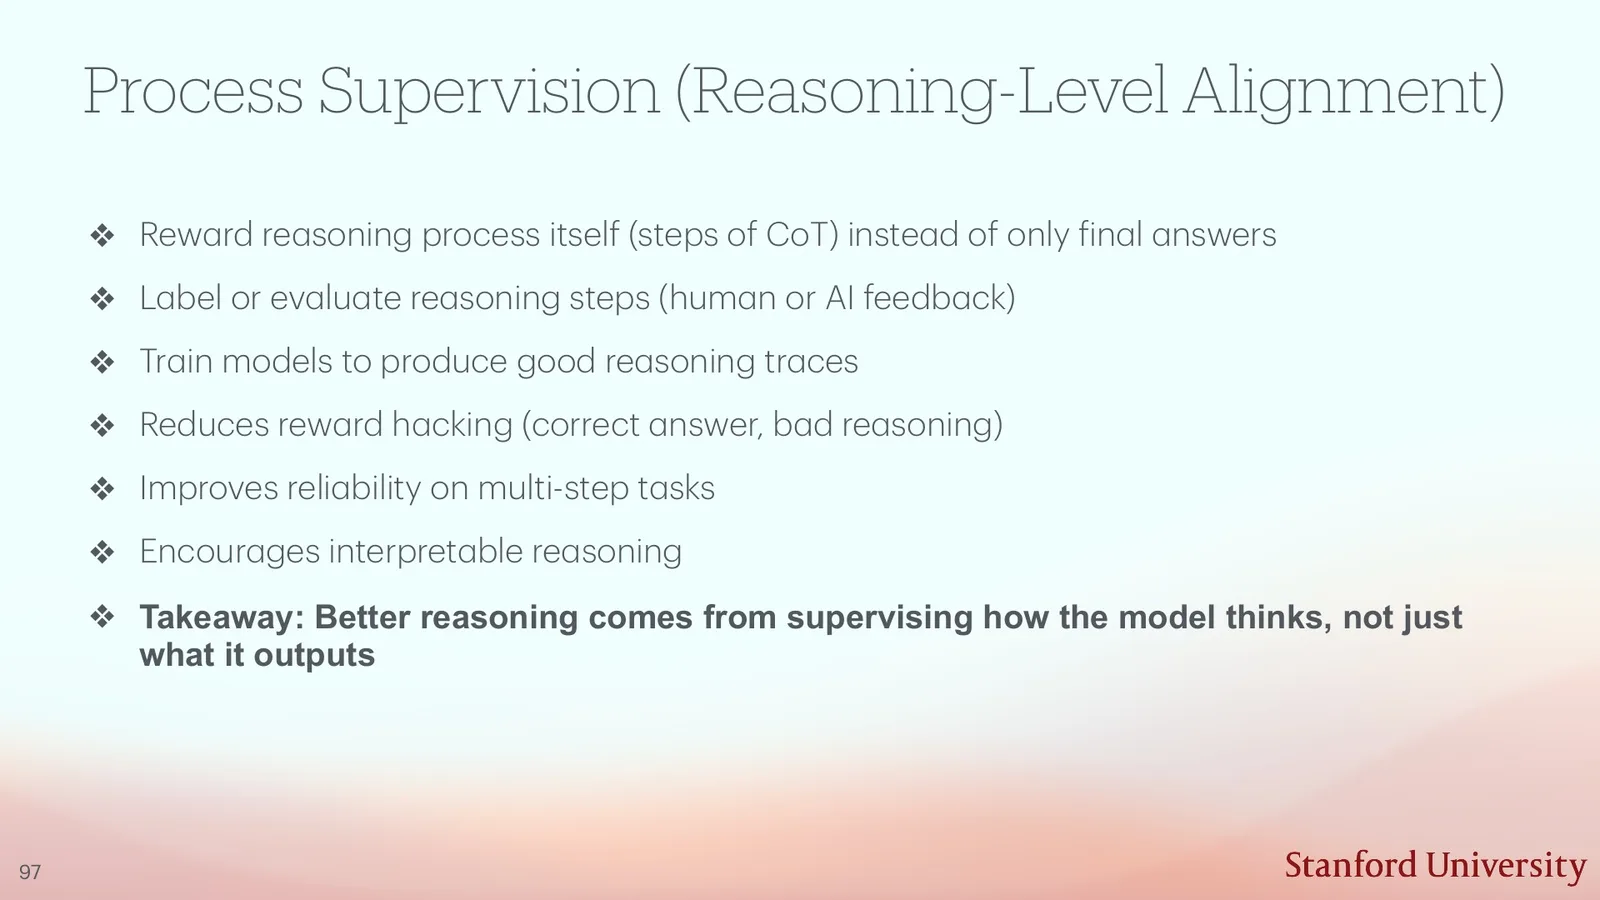
来源:CS25 V6 official deck, p. 100
课堂提示
00:40:36–00:43:12,老师区分 RLHF、DPO、RLAIF、GRPO 与 process supervision:它们的 feedback source、是否显式建 reward model、以及奖励 outcome 还是 steps 都不同。
可验证任务不代表 verifier 无偏
数学答案、代码测试和格式检查容易自动评分,但 reward 往往只覆盖可测部分。模型可能输出过拟合测试、利用数值容差或生成冗长“可评分步骤”。因此 verifier 设计本身是训练目标设计,而不是中立的测量工具。
从基础设施看,DPO 主要需要 preference pair 和普通反向传播;RLHF/GRPO 则需要生成 rollout、reward 计算、policy/reference model logprob,并可能在多机间交换大量 variable-length sequence。推理 token 也是训练成本:同一 batch 中 reasoning 长度差异会造成 padding 与负载不均。选择算法时应同时比较离线数据构建、在线采样、reward latency、显存中的多份模型和可复现性。一个算法在论文中 token efficiency 更高,不代表 wall-clock 或 cluster utilization 更好。
本章小结
Post-training 可以改变参数,inference-time compute 可以扩大搜索,retrieval/tools 可以增加信息,process supervision 可以改变 reward 的颗粒度。CoT、ToT、Program-of-Thought、RLHF、DPO、RLAIF 与 GRPO 不是同一类“reasoning trick”;它们分别操作候选空间、外部执行、偏好数据与优化器。
Self-improving agents:把一次生成改成闭环系统
Post-training 仍可把模型看成输入到输出的函数;agent 则让模型在环境中反复感知、决策、行动和更新状态。关键不是使用了“agent”这个名字,而是系统是否拥有目标、observation、action space、memory、tool permissions 与 termination condition。
Agent 的操作性定义
设环境状态为 \(s_t\),模型可见 observation 为 \(o_t\),内部 memory 为 \(m_t\),动作策略为
其中 \(g\) 是目标。环境返回 \(o_{t+1}\),memory update 为 \(m_{t+1}=U(m_t,o_{t+1},a_t)\)。Agent 的能力来自策略、工具、状态更新和环境反馈共同组成的闭环,而不是模型参数单独决定。
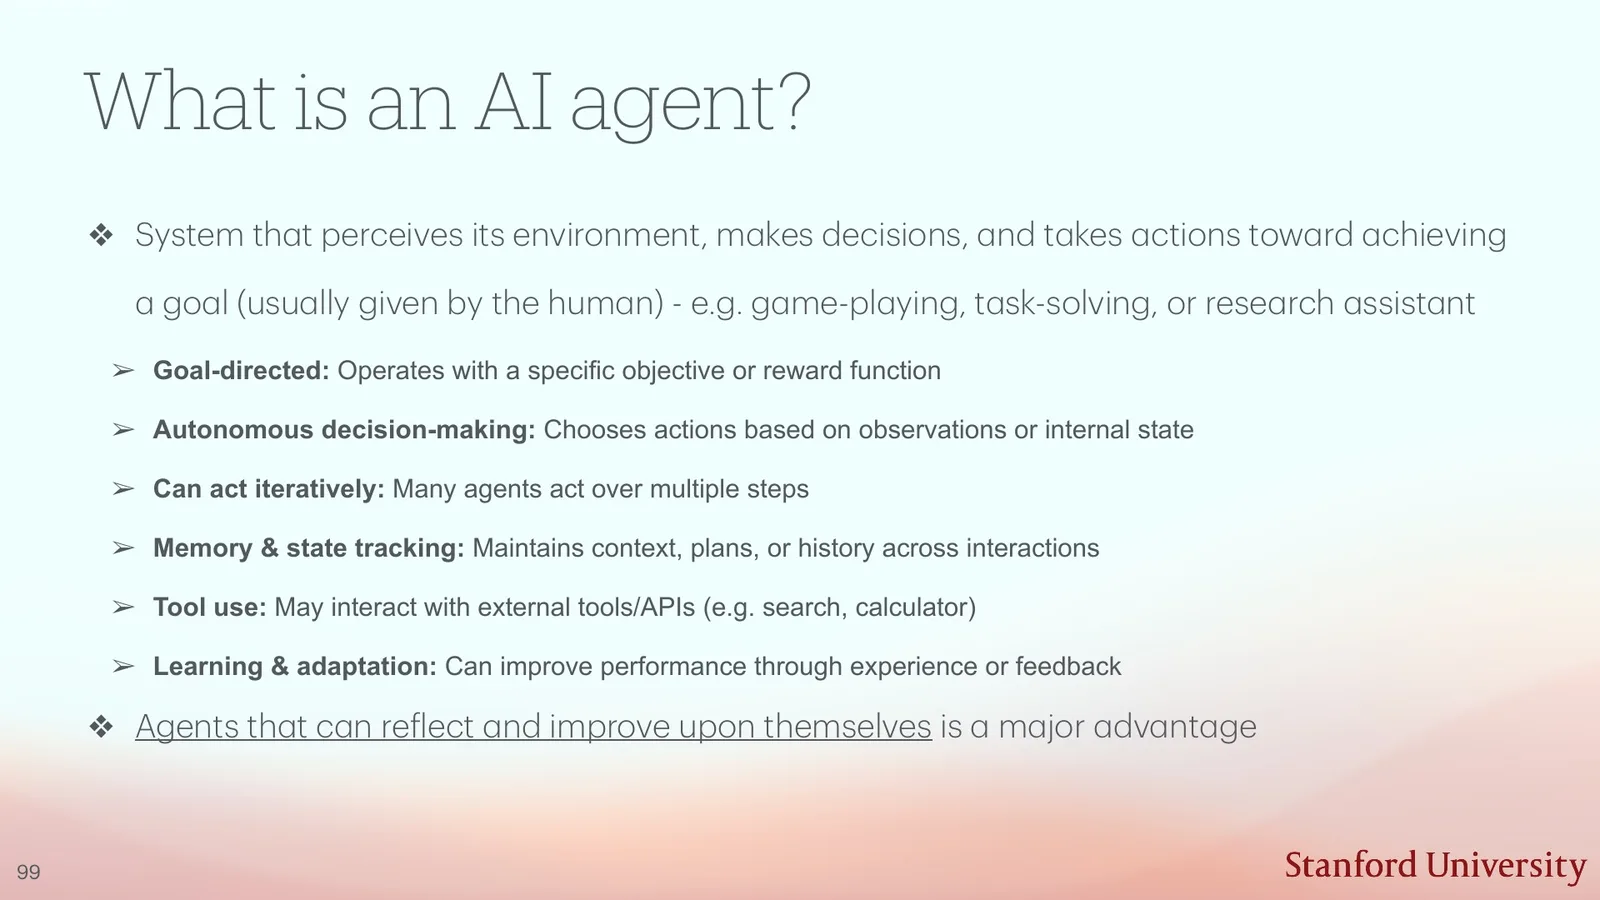
来源:CS25 V6 official deck, p. 102
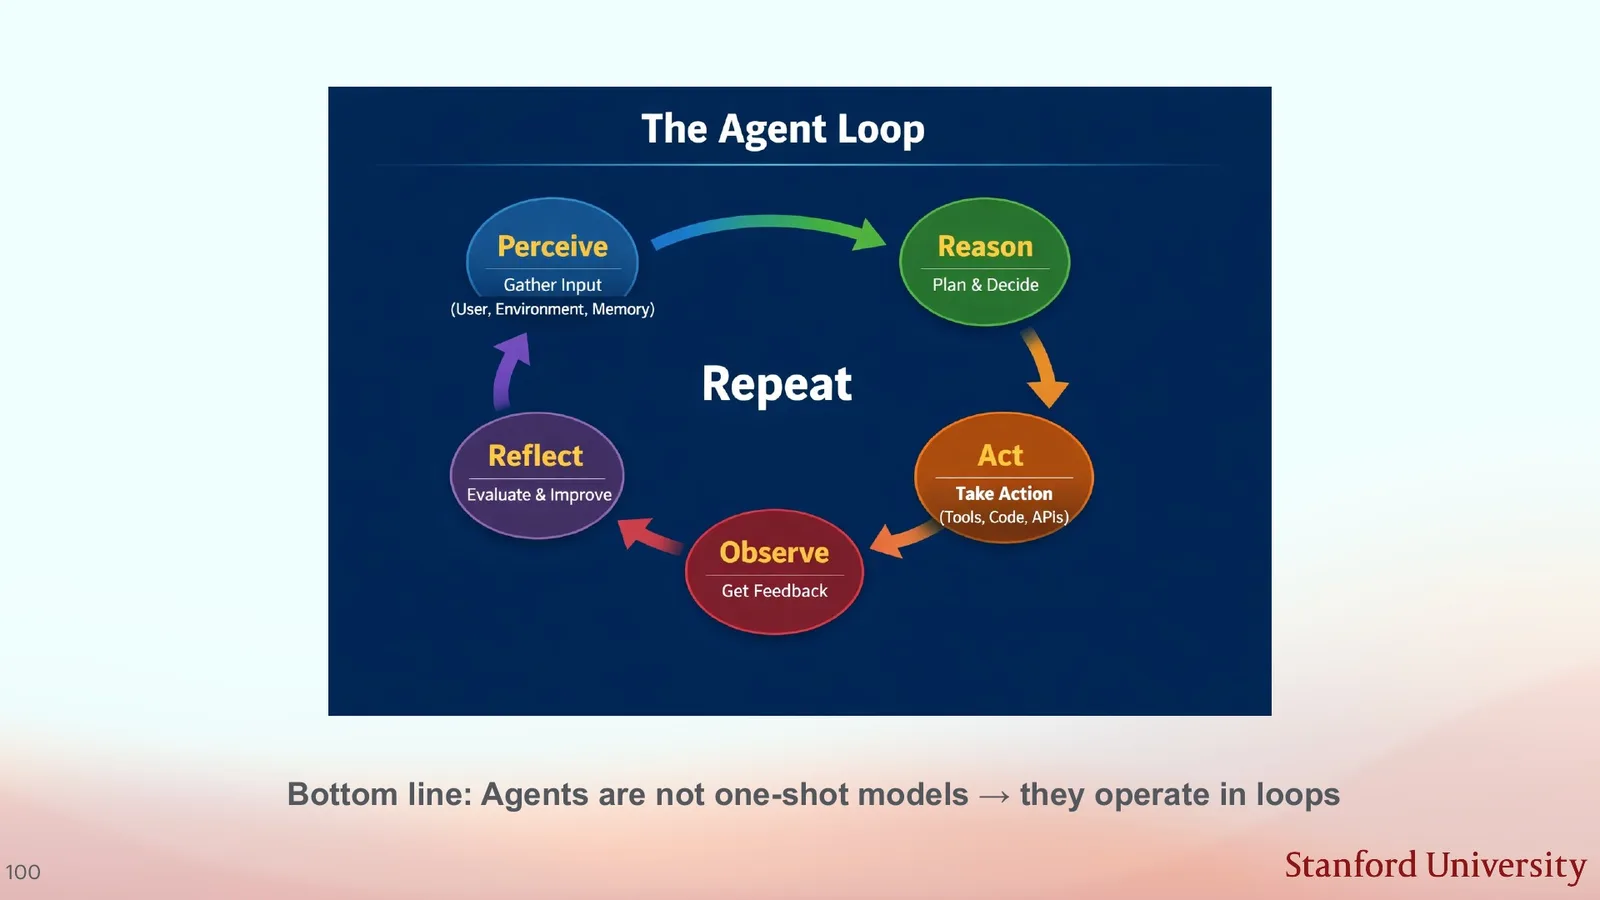
来源:CS25 V6 official deck, p. 103
课堂提示
00:43:12–00:44:05,老师把 agent 与 one-shot model 的区别压缩成 loop。课堂提示:没有 observation 或 state update 的多轮 prompt,不一定构成真正环境交互。
Agent contract 的最小字段
目标 \(g\)、可见 observation、允许 action/tool、memory policy、budget、停止条件、错误恢复与权限边界必须显式定义。若缺少其中任何一项,“自主性”就会变成无法审计的模糊承诺。
Self-improvement:改输出、改 memory,还是改策略
“自我改进”可以指三种不同层级:对当前答案做 refinement;把失败总结写入 episodic memory;或通过训练更新参数。slide 104 提出总框架,slide 105–106 分别展示 refinement 与 reflection。前两者主要改变当前 context 或外部 state,不等于模型永久学会了新能力。
来源:CS25 V6 official deck, p. 104
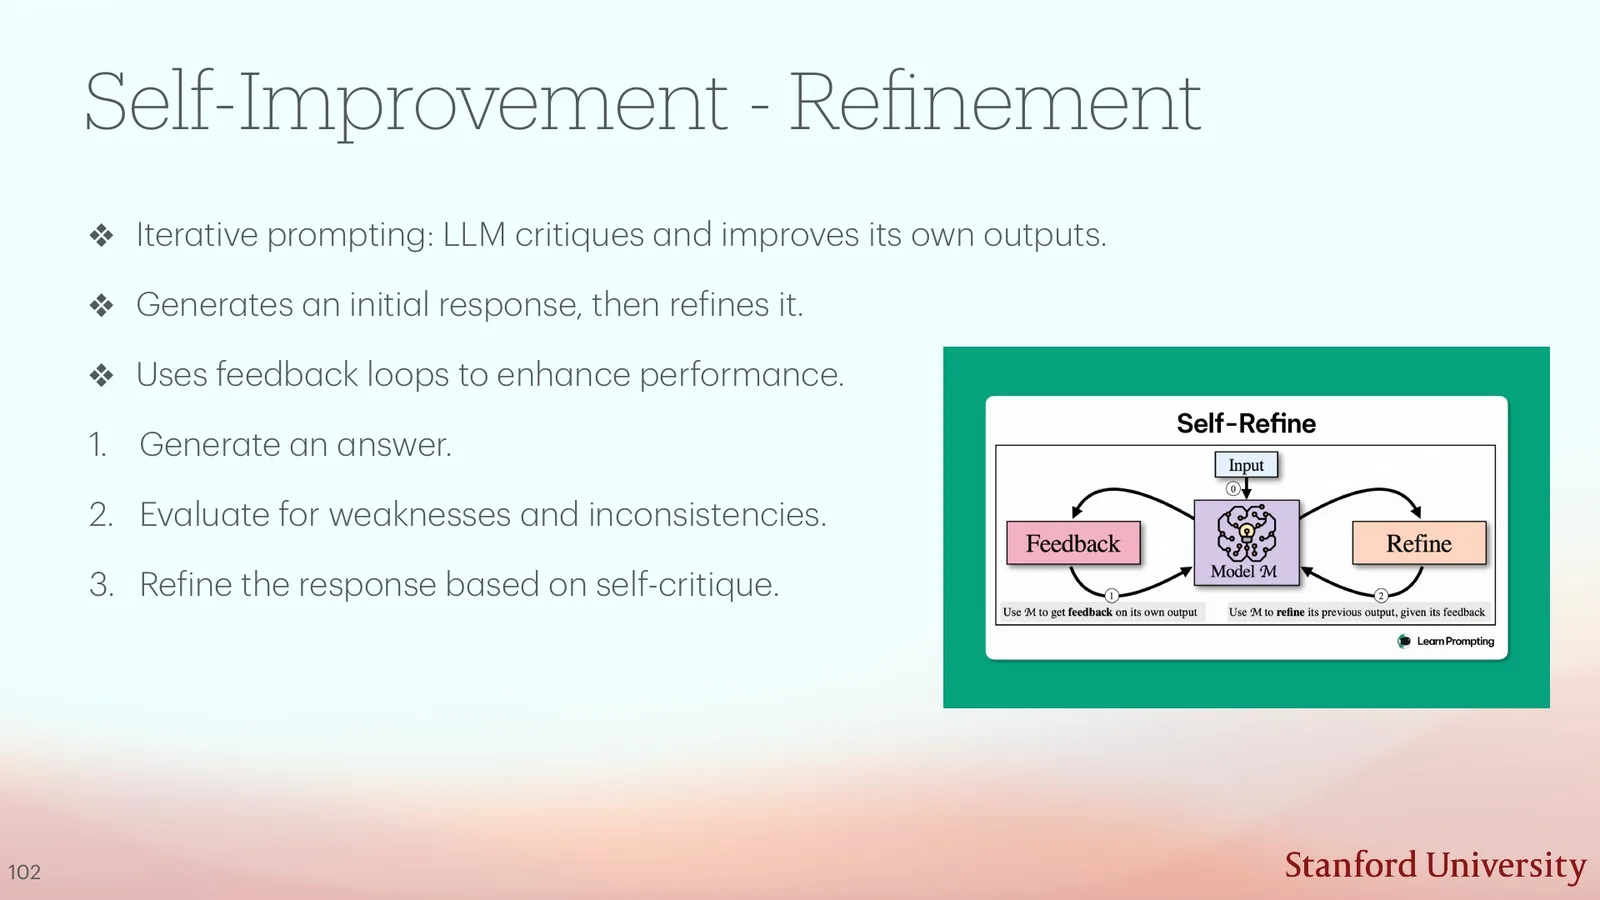
来源:CS25 V6 official deck, p. 105
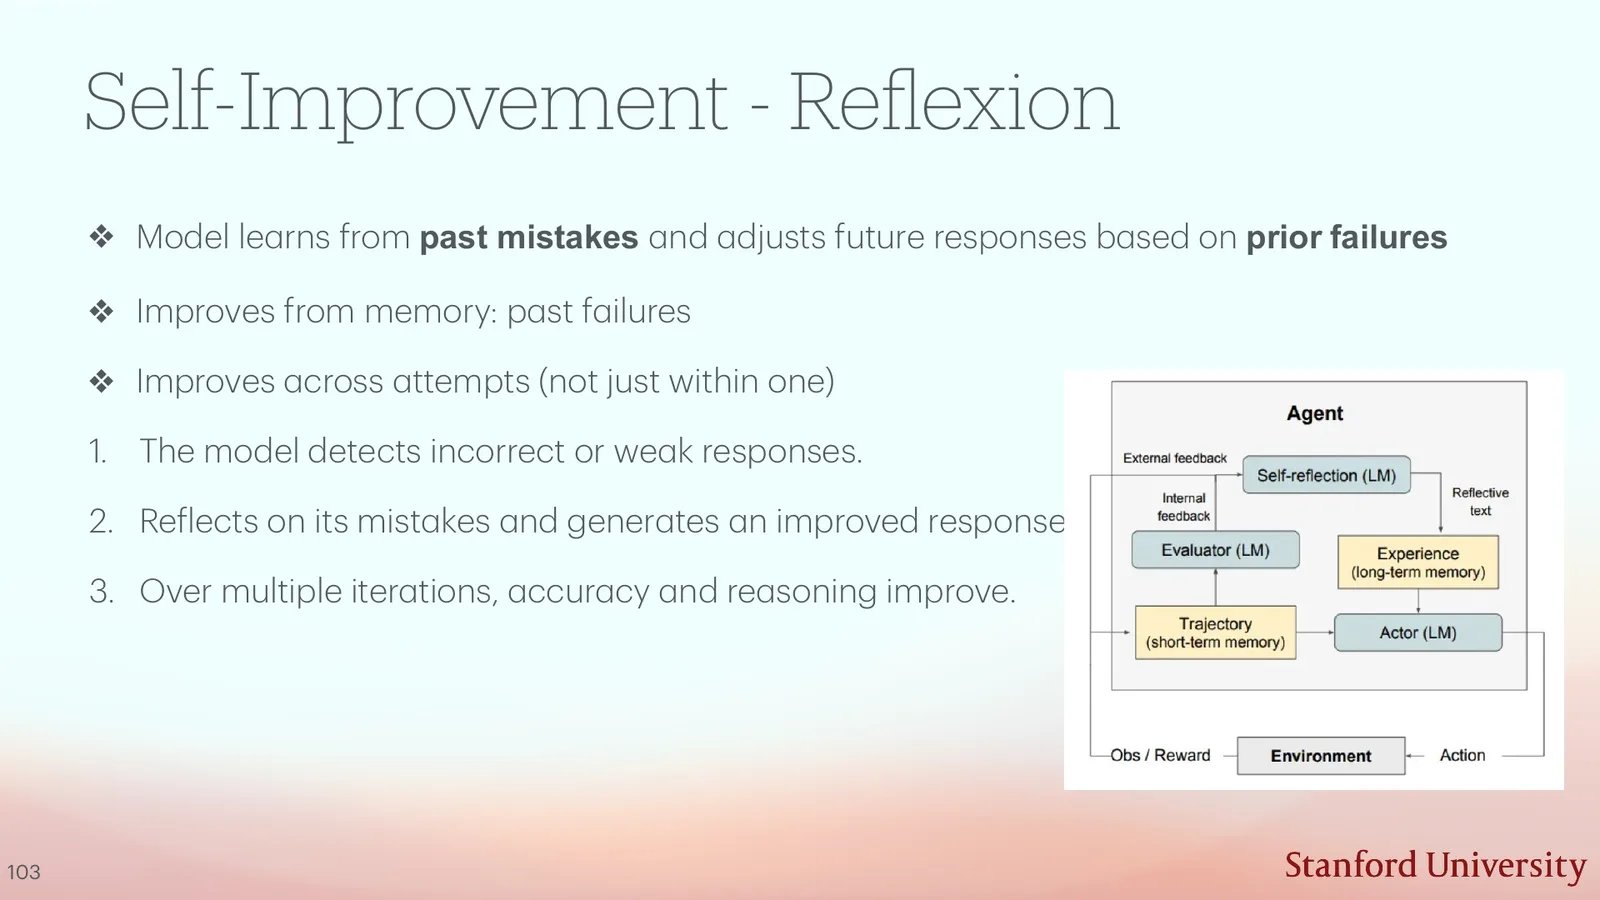
来源:CS25 V6 official deck, p. 106
若第 \(k\) 次候选为 \(y^{(k)}\),critic 产生反馈 \(c^{(k)}\),refinement 可写成
只有当 critic 与 generator 的错误不完全相关、反馈能定位可修复问题、并且 budget 允许多次迭代时,循环才可能提高表现。否则系统会反复改写措辞或放大同一错误。
ReAct:reasoning 与 acting 交替
ReAct 把 thought、action 与 observation 交替写进轨迹。Action 调用搜索、数据库、代码或其他 API;observation 把真实结果返回模型。它比纯 CoT 多了环境 grounding,却增加工具选择错误、参数错误、权限越界、prompt injection 与不可重复外部状态。
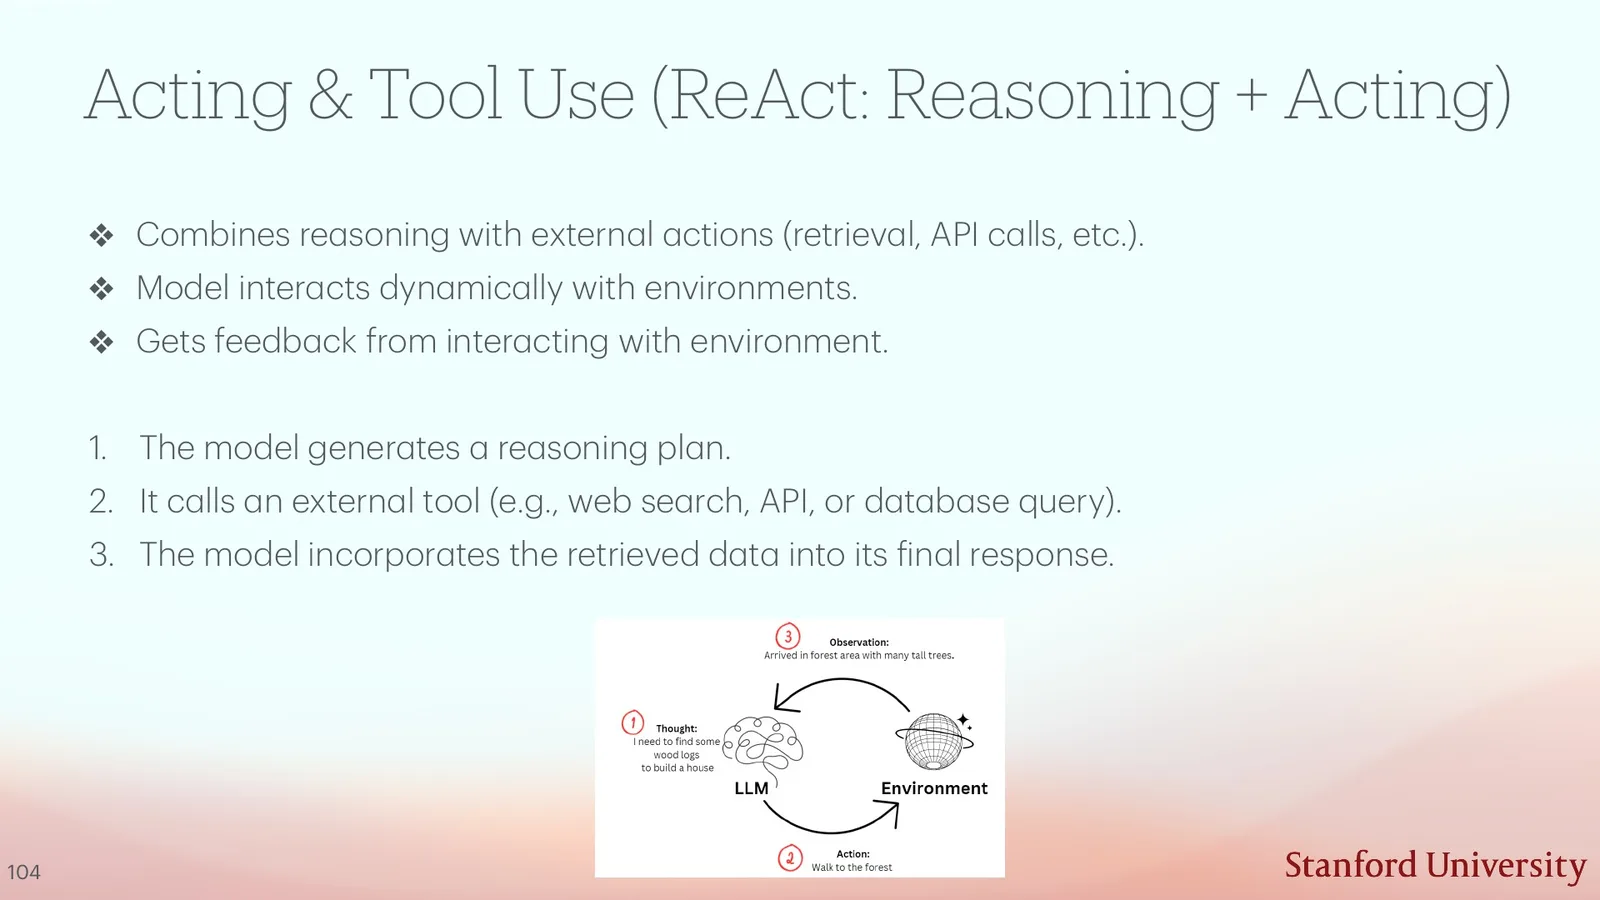
来源:CS25 V6 official deck, p. 107
state = initialize(goal, memory)
for step in range(max_steps):
    proposal = model.plan(state)
    if proposal.action == "finish":
        return proposal.answer
    authorize(proposal.action, policy=tool_policy)
    observation = tools.execute(proposal.action)
    state = update_state(state, proposal, observation)
raise BudgetExceeded(state)
课堂提示
00:44:05–00:45:43,老师把 refinement、reflection 与 ReAct 视为把反馈插在不同位置:输出后、跨任务 memory、或环境 action 之后。实践经验:loop 越长,状态、权限和 termination 越需要工程化。
“循环次数更多”不保证可靠性
如果 critic 与 generator 共享盲点,reflection 会把错误总结成更有说服力的 memory;如果工具 observation 被 prompt injection 污染,下一步 reasoning 会在错误状态上继续。Agent eval 必须测量成功率、成本、恢复能力和副作用,而不只是最终文本质量。
Agent 评估应把轨迹而非最终答案作为最小审计单元。需要记录每次 tool call、参数、observation 来源、状态变更与停止原因,再分别统计 task success、无效步骤、危险 action、恢复率、token/latency cost 和权限违规。对于不可逆工具,还要区分 simulation、dry-run 与真实执行。若 benchmark 只给最终 reward,系统可能通过偶然 shortcut 成功而掩盖不安全路径;若只看漂亮 trace,又可能奖励冗长解释。可靠 agent 的目标是以可控成本稳定完成任务,并在失败时停在安全状态。
本章小结
Agent 把模型变成闭环策略,但闭环的每个接口都带来新的可观测性和失败模式。Refinement 改当前候选,reflection 改外部经验,ReAct 增加真实 observation。要谈 self-improvement,必须说明被改的是输出、memory、工具策略还是参数。
跨模态应用:统一 backbone,不统一证据标准
Transformer 的序列接口让图像 patch、文本 token 与脑网络特征进入相似 backbone,但每个领域的 observation、label 和 evaluation 都不同。应用章节的重点不是列举“还能做什么”,而是比较 modality adapter、training objective 和科学证据边界。
应用版图:同一 block 接不同世界
课程展示语言助手、AlphaFold、医学模型、游戏、机器人和多模态系统。应用扩张来自三层组合:把原始模态编码成 token;用大规模预训练学习表示;在任务层增加 decoder、retriever、policy 或 domain-specific head。共享 Transformer block 只覆盖中间计算层。
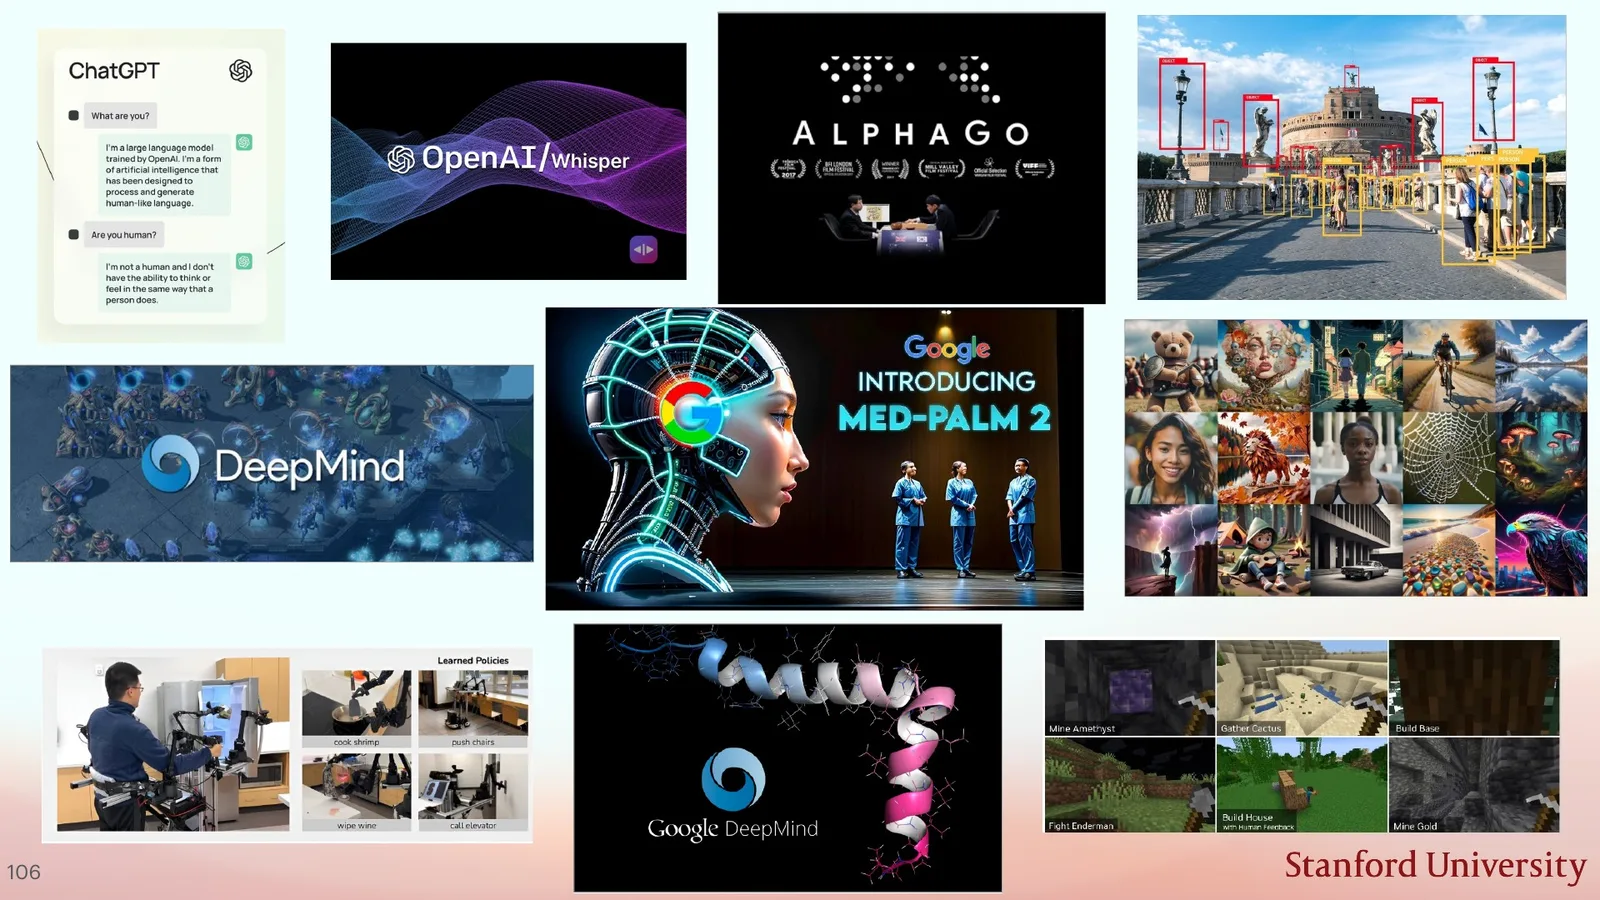
来源:CS25 V6 official deck, p. 109
读图:应用 logo 不是同一种证据
产品截图证明系统存在,benchmark 证明特定协议下的分数,临床/科学结论还需要外部验证。把所有 logo 放在一页可以展示影响范围,却不能用同一个“accuracy”概括它们的风险与有效性。
Vision Transformer:把图像改写成 patch sequence
给定图像 \(H\times W\times C\) 与 patch size \(P\),patch 数为
每个 patch 展平并投影到 \(d\) 维,再加位置表示送入 Transformer。较小 \(P\) 提供更细粒度,但 \(N\) 增大使 attention 成本按 \(N^2\) 上升。CNN 通过 locality 与 weight sharing 注入强先验;ViT 先验更弱,通常更依赖数据规模与 augmentation。
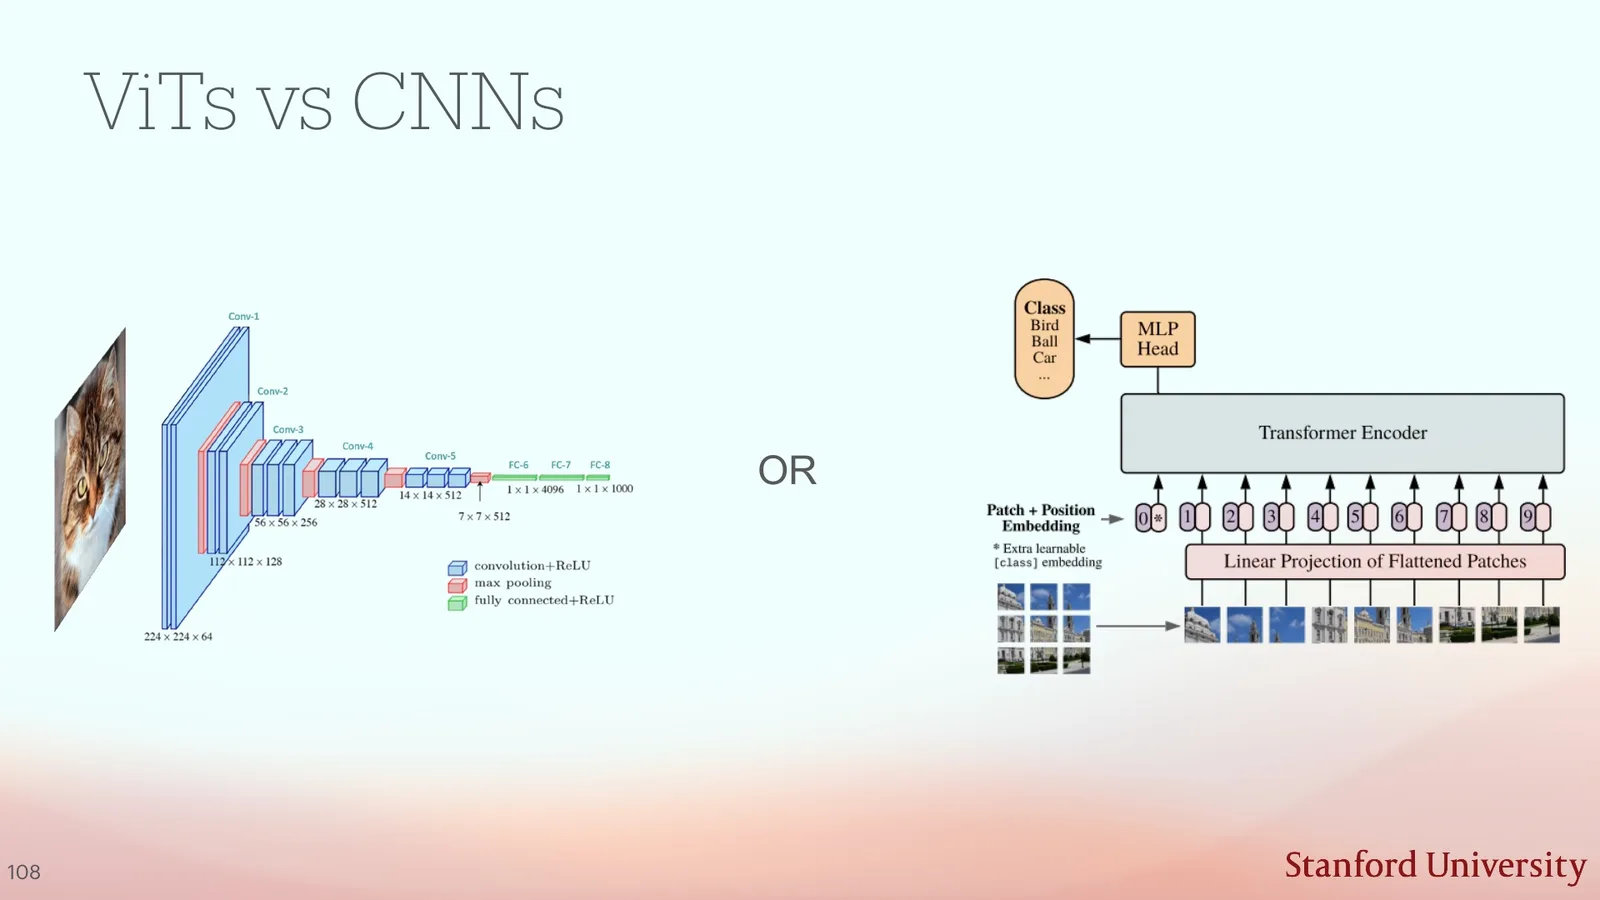
来源:CS25 V6 official deck, p. 111
CLIP:用 contrastive objective 对齐图像与文本
CLIP 分别编码图像与文本,在 batch 内让匹配 pair 相似、非匹配 pair 分离。对图像表示 \(u_i\)、文本表示 \(v_j\),相似度可写成 \(s_{ij}=u_i^{\top}v_j/\tau\),再对行列分别做 cross-entropy。它学到可迁移的 joint space,但训练数据中的描述偏差、版权和社会偏见也会进入表示。
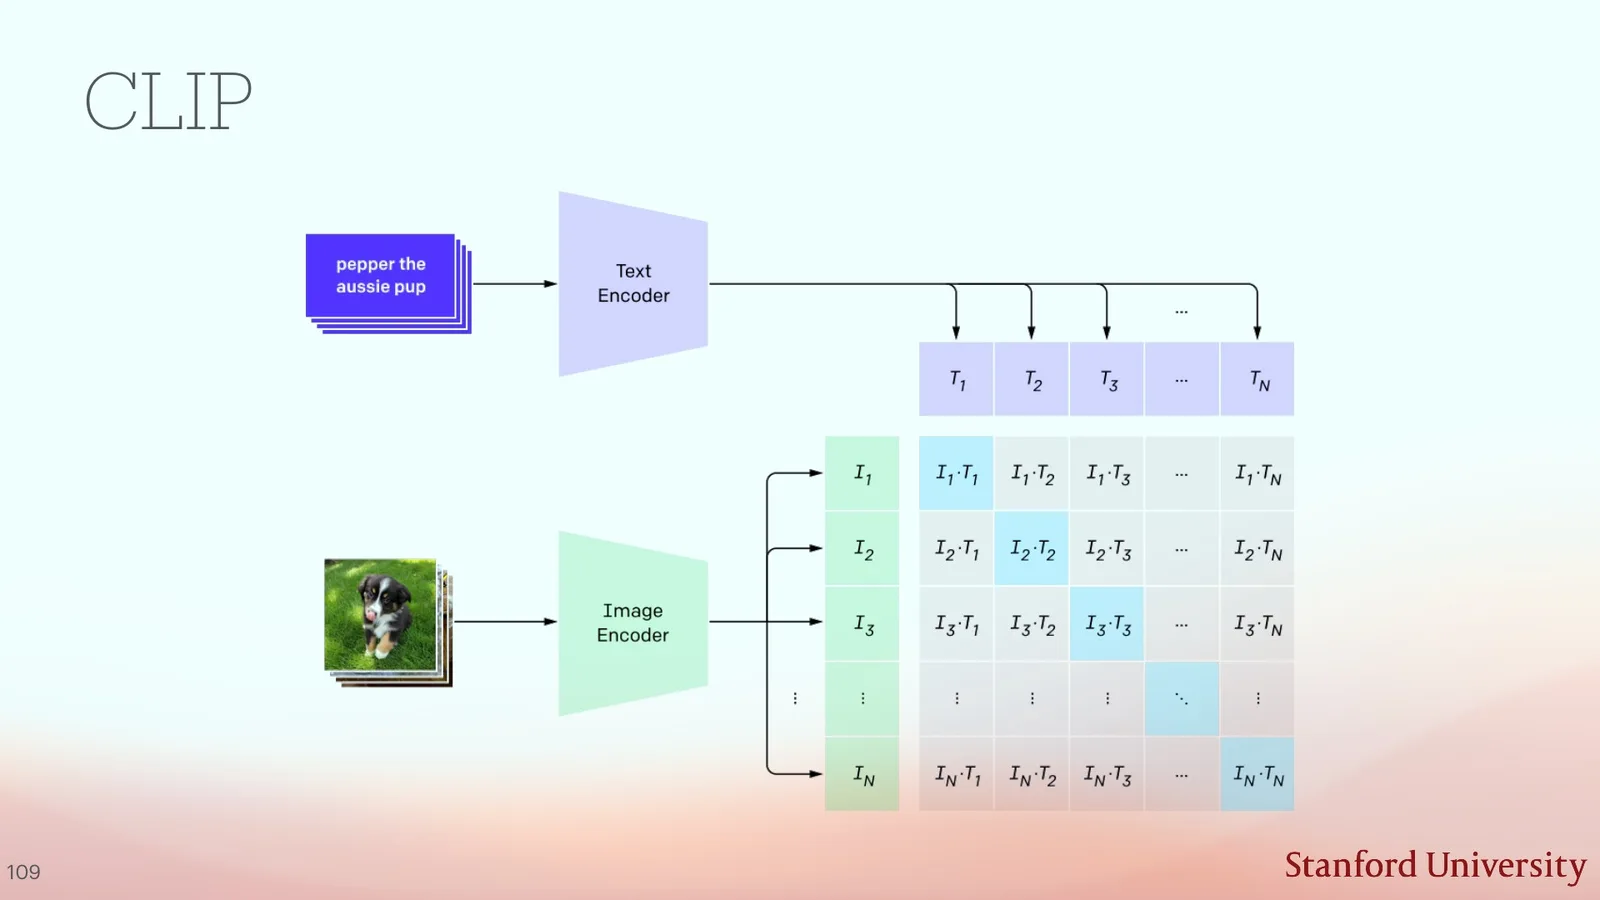
来源:CS25 V6 official deck, p. 112
课堂提示
00:45:43–00:48:30,老师用 ViT 与 CLIP 说明统一 backbone 的前提:先把模态变成 token 或 embedding,再选择适合的 objective。老师也强调 ViT 的较弱 inductive bias 往往需要更大数据。
统一 backbone 与统一模型不是一回事
视觉需要 patch/tokenizer,文本需要 subword tokenizer,fMRI 需要脑区与时间序列表示。Encoder、data augmentation、loss 和 head 都可能不同。所谓“multimodal Transformer”应具体说明共享哪些参数、在哪一层融合、各模态如何对齐。
fMRI foundation model:把脑网络关系建成表示问题
Functional MRI(fMRI)通过血氧水平依赖信号间接测量脑活动。Yeo networks 等分区把大脑划分为视觉、注意、默认模式等功能网络。模型可把区域/网络时间序列编码成 token,再学习 network interaction。这里的目标是 representation learning 与 cohort comparison,不是直接读取“思想”。
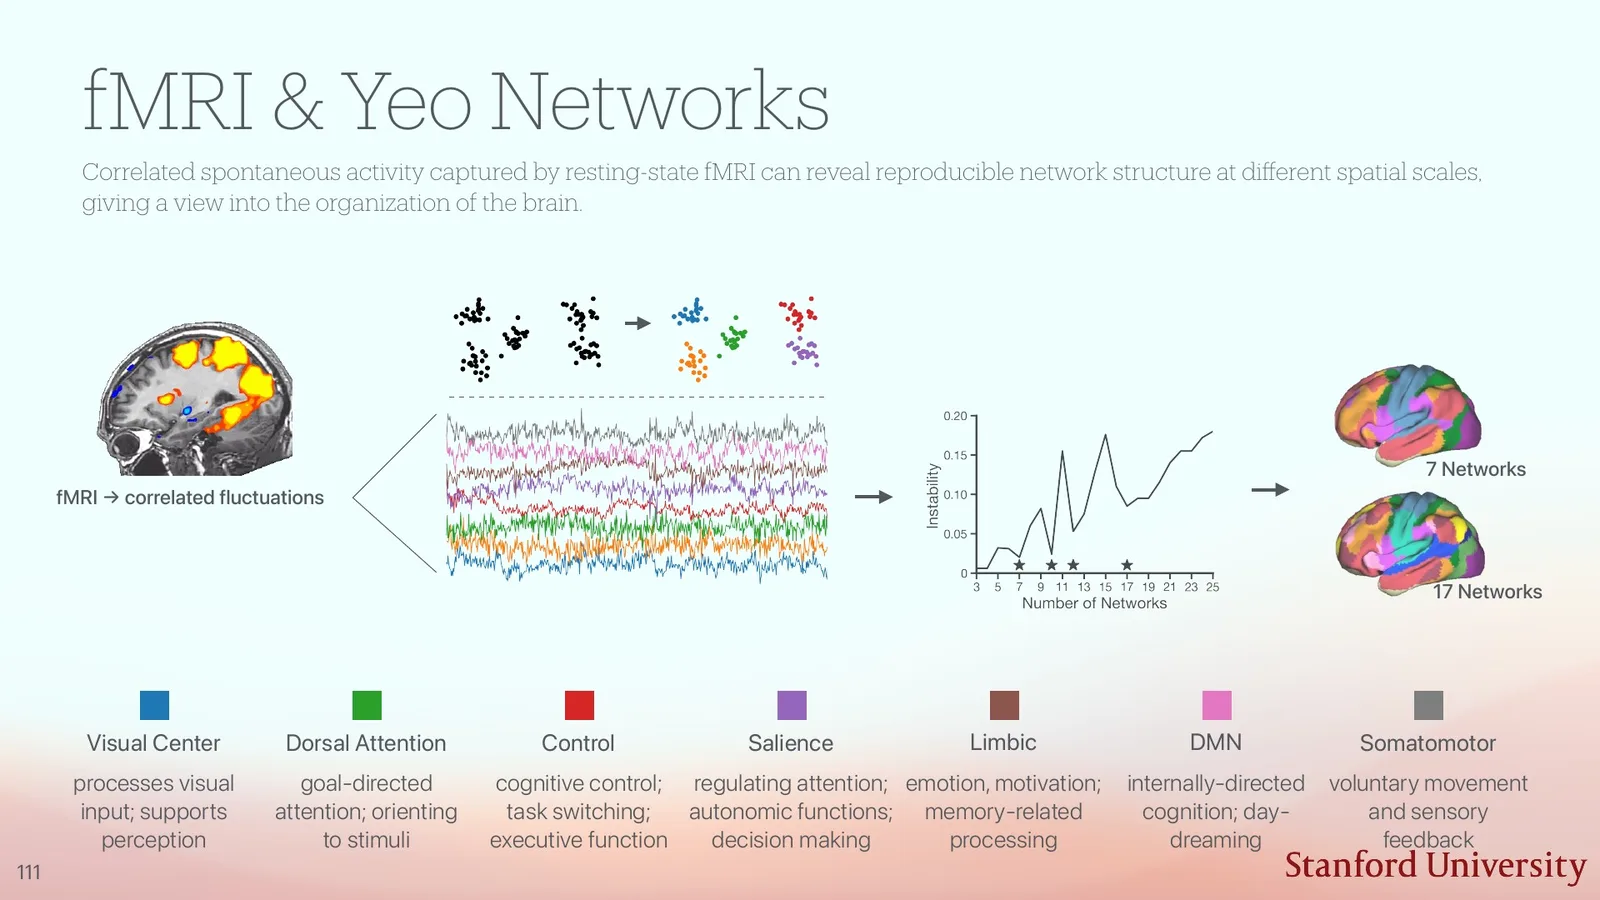
来源:CS25 V6 official deck, p. 114
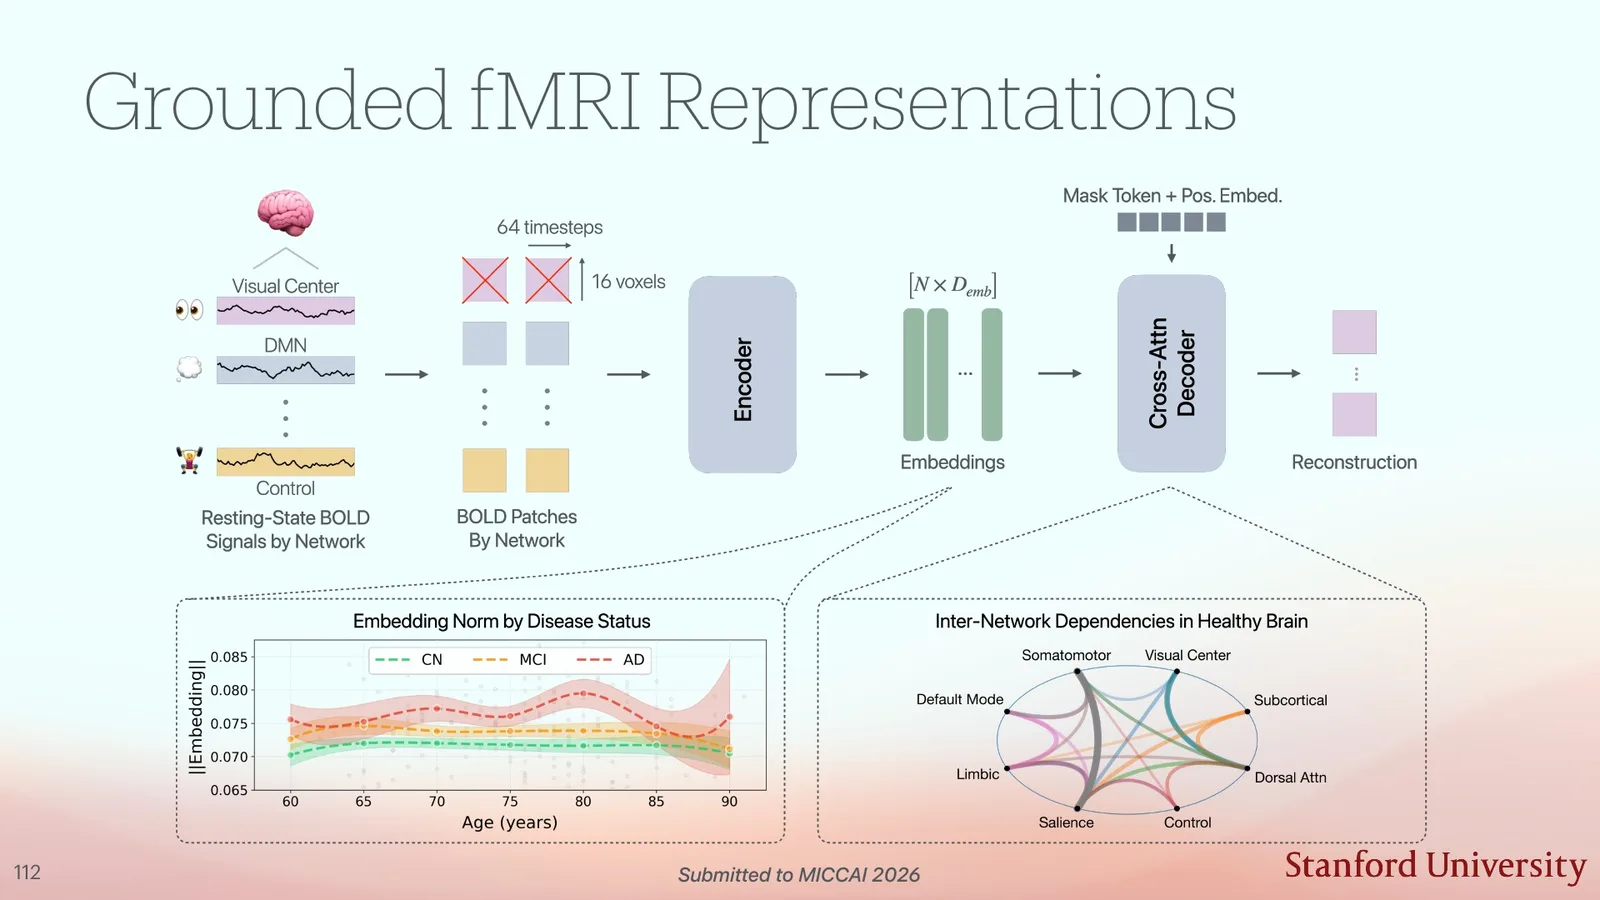
来源:CS25 V6 official deck, p. 115
若网络 token 为 \(X\in\mathbb{R}^{n\times d}\),cross-network attention 仍可写成 \(\operatorname{softmax}(QK^\top/\sqrt{d_k})V\),但每个 token 的语义是功能网络而不是词。Grounded 表示的价值在于把 attention 与已知脑区对应;局限是 attention weight 仍不等同于因果 connectivity。
Inter-network dependence 与 longitudinal evidence
slide 117 比较 control、MCI 与 AD cohort 的网络依赖图,slide 118 展示纵向变化和 group comparison。读这类图时先看 cohort definition、样本量与置信区间,再看网络边;疾病差异可能受年龄、扫描协议和 motion artifact 影响。模型相关性可生成生物假设,但临床结论需要独立 cohort 与机制验证。
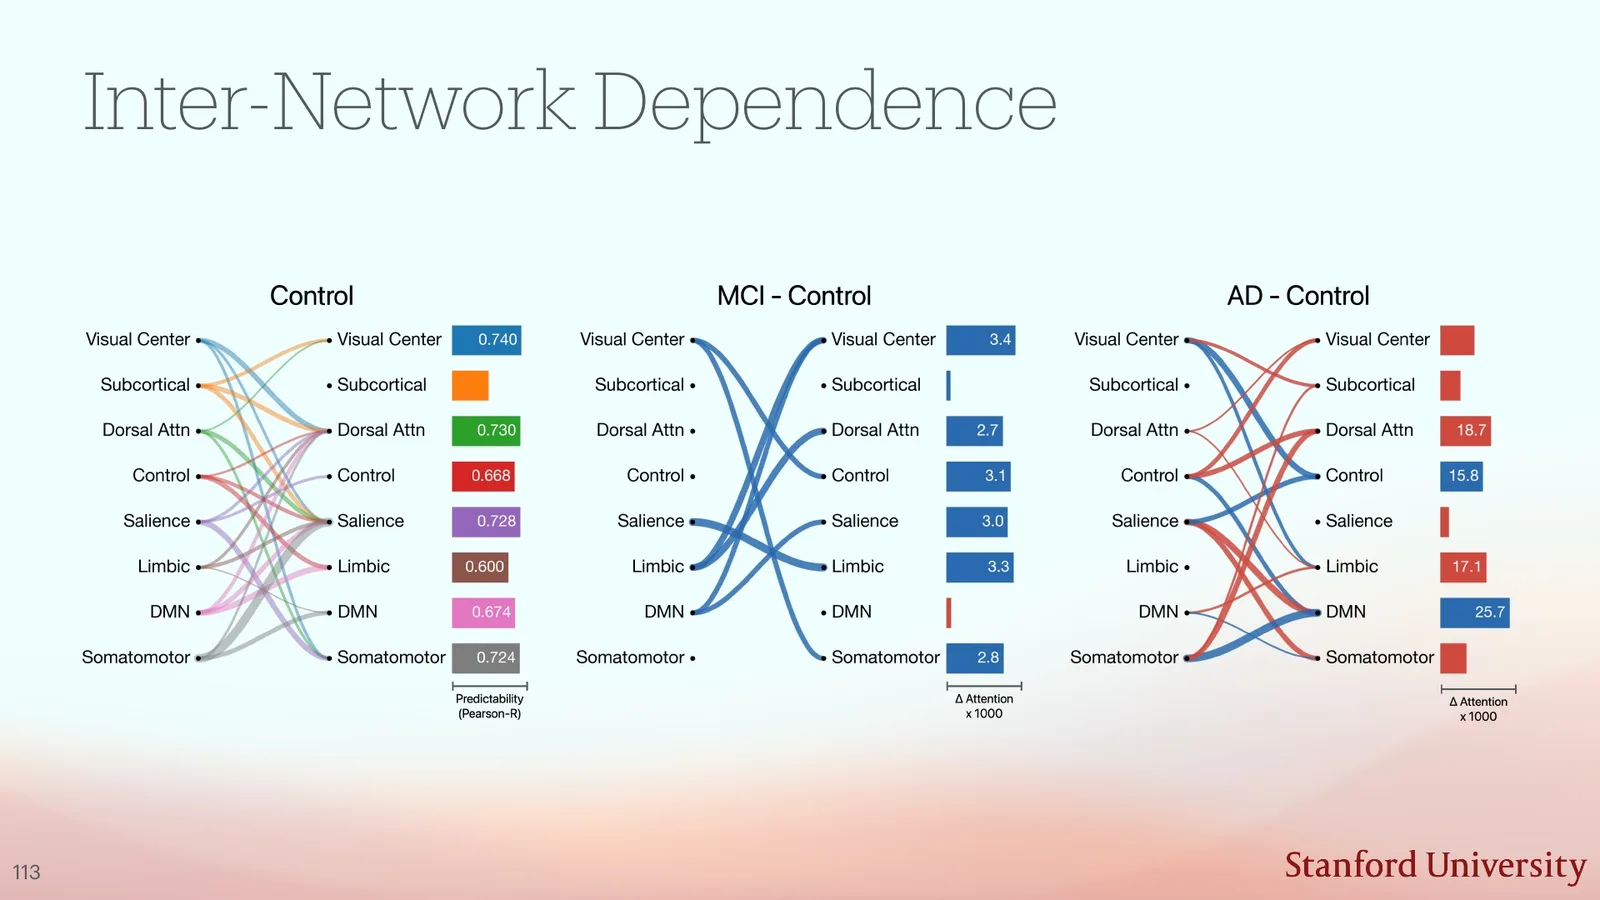
来源:CS25 V6 official deck, p. 117
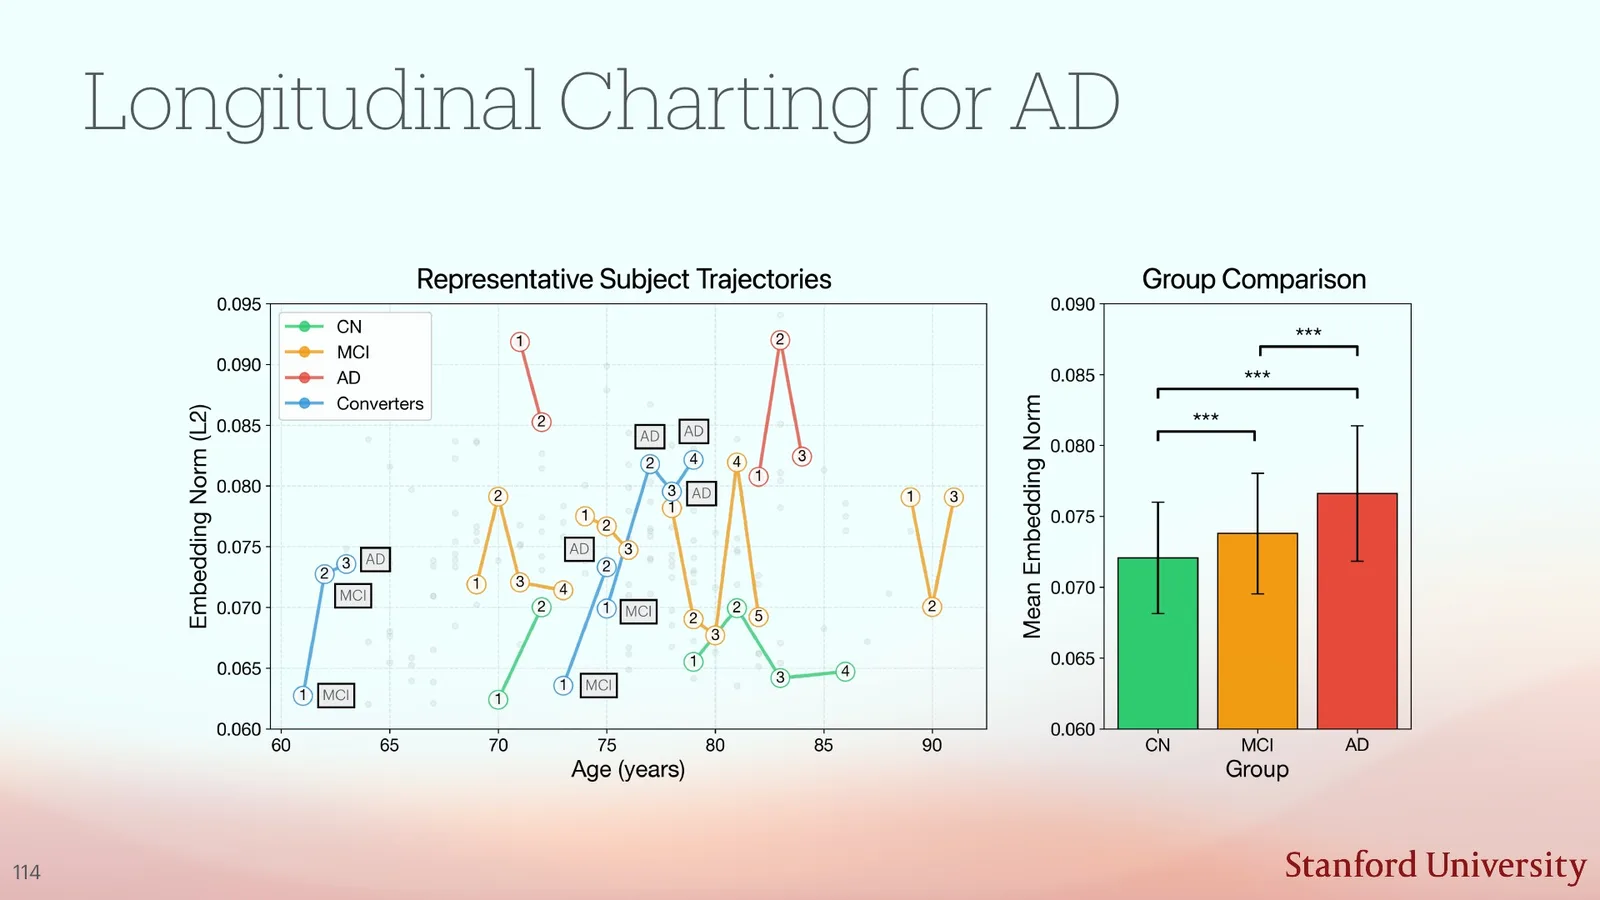
来源:CS25 V6 official deck, p. 118
课堂提示
00:48:30–00:52:47,Karan 解释 fMRI 是血氧代理信号,并把结果限定为 network representation 与 cohort-level association。课堂提示:图中的 attention/依赖边不是神经因果方向。
神经影像模型的三层不确定性
测量层:BOLD 是神经活动的间接代理;数据层:样本、motion 与扫描协议可能偏移;模型层:attention 或 embedding 差异可能有多种解释。只有跨 cohort 复现、临床变量控制和外部实验,才能把 representation evidence 推向生物机制。
一个更完整的科学工作流是:先在训练 cohort 学表示,再在 held-out subject 做预测;随后用 site/age/sex/motion 等 covariate 做敏感性分析,检查网络差异是否稳定;再用 external cohort 复现,最后才讨论临床含义。若模型输出 longitudinal trajectory,还要报告 uncertainty 与 missing visit 处理。Transformer 可以整合高维时序,但不会自动修复 observational study 的 selection bias。课程把这类案例放进 overview 的价值,正是提醒读者“跨模态”不仅是输入格式变化,也意味着证据标准随领域升级。
本章小结
Transformer 的统一价值在于可组合的序列计算,而不是取消模态差异。ViT 用 patch token,CLIP 用 contrastive alignment,fMRI 模型用功能网络 token。每种应用都必须重新定义 observation、objective、metric 与证据强度;共享 backbone 不能替代领域验证。
Scaling 之后:缺失能力、效率与 hallucination
应用扩张并没有消除基础问题。课程把“未来”拆成两类:可以继续工程化的能力,如 on-device efficiency、personalization 与 monitoring;以及定义仍不清晰的问题,如 world understanding、hallucination 和长期适应。读本章时要区分 scaling law 的经验趋势、产品愿望和可检验机制。
下一步与缺口:更大模型只是一个方向
slide 121 列出可见应用增长:foundation model 组合、agent、机器人、个性化、医疗与交互娱乐。slide 122 则列出缺失条件:reliable reasoning、causal understanding、continual learning、alignment 与效率。前者回答“还能部署到哪里”,后者回答“要可靠部署还缺什么”。
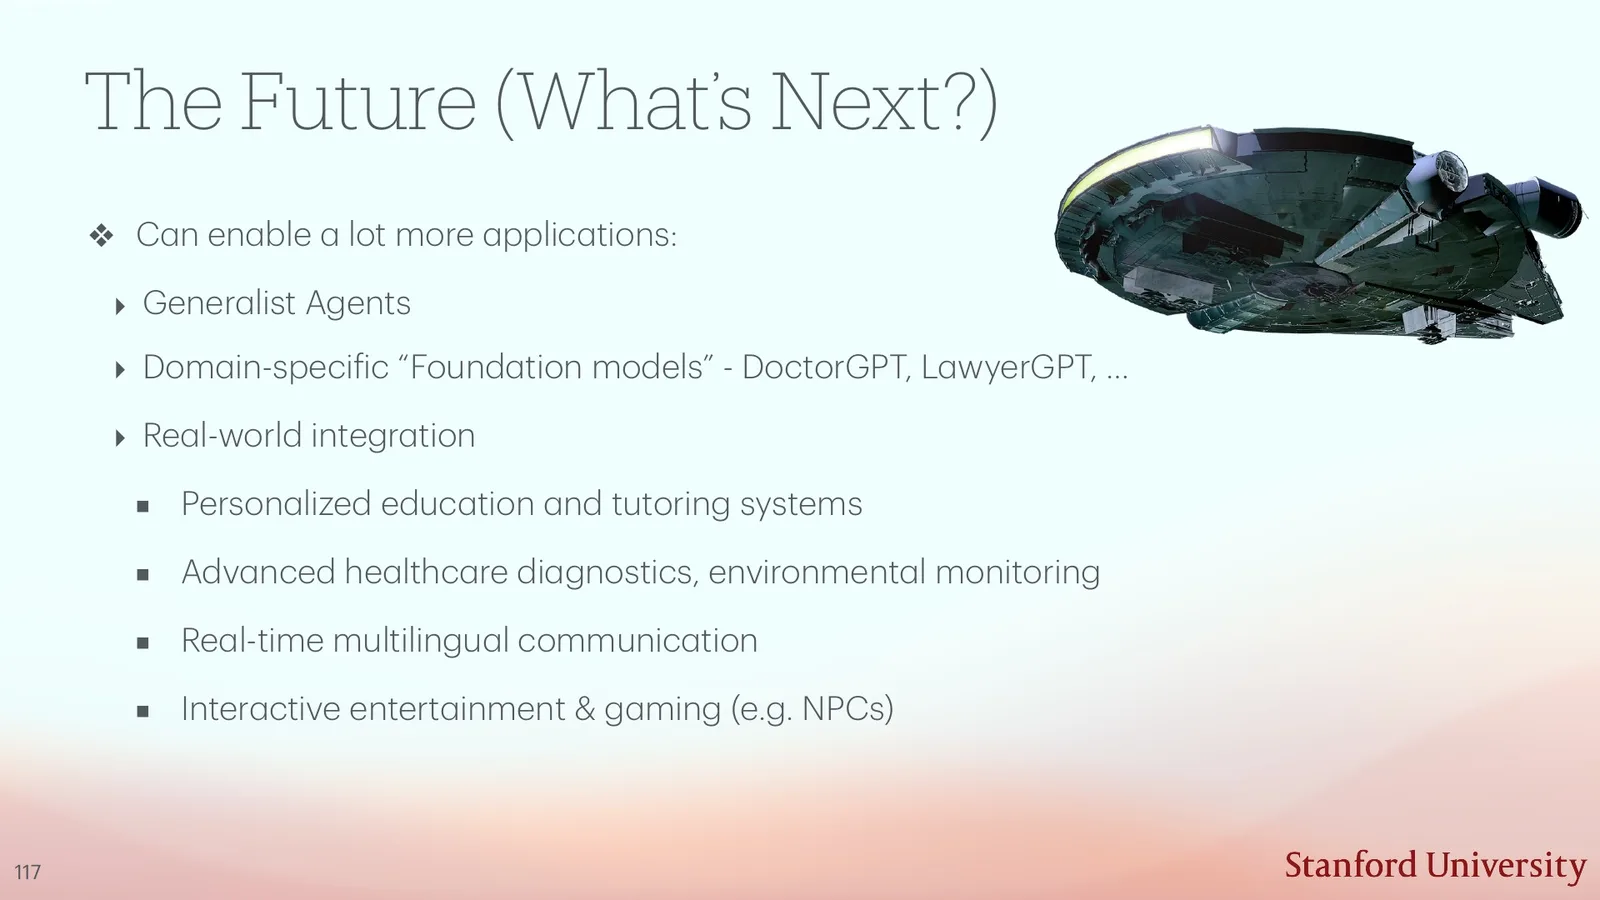
来源:CS25 V6 official deck, p. 121
来源:CS25 V6 official deck, p. 122
课堂提示
00:52:47–00:53:34,老师先列潜在应用,再迅速转向 missing ingredients。课堂提示:应用列表是方向,缺口列表才定义研究问题与部署风险。
把 future slide 变成工程问题
“个性化”需要 identity/memory policy;“robotics”需要 perception-action loop 与安全约束;“healthcare”需要 calibration、provenance 与临床验证;“continual learning”需要可更新状态和遗忘控制。只有写出输入、更新和 metric,未来愿景才从口号变成研究计划。
Minified/on-device:模型要进入受限硬件
On-device LLM 受 memory、功耗、latency 与更新渠道约束。压缩可分为 quantization、pruning、distillation、low-rank adaptation 与 architecture redesign。若参数量为 \(N\)、每参数位宽为 \(b\),仅权重存储约为
真实峰值还包括 activation、KV cache、runtime buffer 和 tokenizer/embedding。仅把权重量化到 4-bit 不代表整个系统缩小四倍。
来源:CS25 V6 official deck, p. 123
端侧优化的 Pareto frontier
需要同时比较质量、首 token latency、每 token latency、峰值内存、能耗、热设计和可更新性。一个 benchmark 分数相近但持续发热、无法加载长 context 的模型,并不构成可用的端侧方案。
Scaling 的递减收益与下一批轴
经验 scaling law 常写成
\(N\) 是参数、\(D\) 是数据、\(C\) 是 compute,指数描述特定 regime 下的边际改善。该关系预测 average loss,不保证事实可靠性、工具使用或 long-horizon reasoning 同步改善。模型越大,训练与 serving 成本越高,数据质量和评估污染也更难控制。
来源:CS25 V6 official deck, p. 124
来源:CS25 V6 official deck, p. 125
课堂提示
00:53:34–00:55:23,老师指出单纯 scaling 已出现 diminishing returns,并把 curriculum、reasoning procedure、理论解释和替代架构列为下一批轴。讲义提醒:这不是“scale 已失效”,而是边际成本上升。
Loss scaling 与 capability scaling 不同
更低 cross-entropy 可能改善平均生成,却不保证某个稀有技能、事实可靠性或 agent safety 单调提升。Capability 往往依赖数据覆盖、elicitation、post-training 和评估阈值;不能从一条 loss curve 推出所有能力的时间表。
Hallucination basics:先不要把所有错误放进一个桶
课程先列出常见含义:生成不真实内容、与来源冲突、缺乏支持、误导或错误行动。问题在于不同任务使用不同 reference:摘要有 source document,开放问答有现实事实,agent 还有 observation 与 action consequence。若定义不指定 reference 与模型可见信息,就无法比较 benchmark,也无法区分知识缺失、观察缺失和 planning failure。
来源:CS25 V6 official deck, p. 127
来源:CS25 V6 official deck, p. 128
课堂提示
00:55:23–00:58:11,老师用 summarization、QA 与 agent 说明同一输出在不同 setting 中可能有不同标签。课堂提示:先定义 reference,再讨论 mitigation。
没有统一定义:world-model view
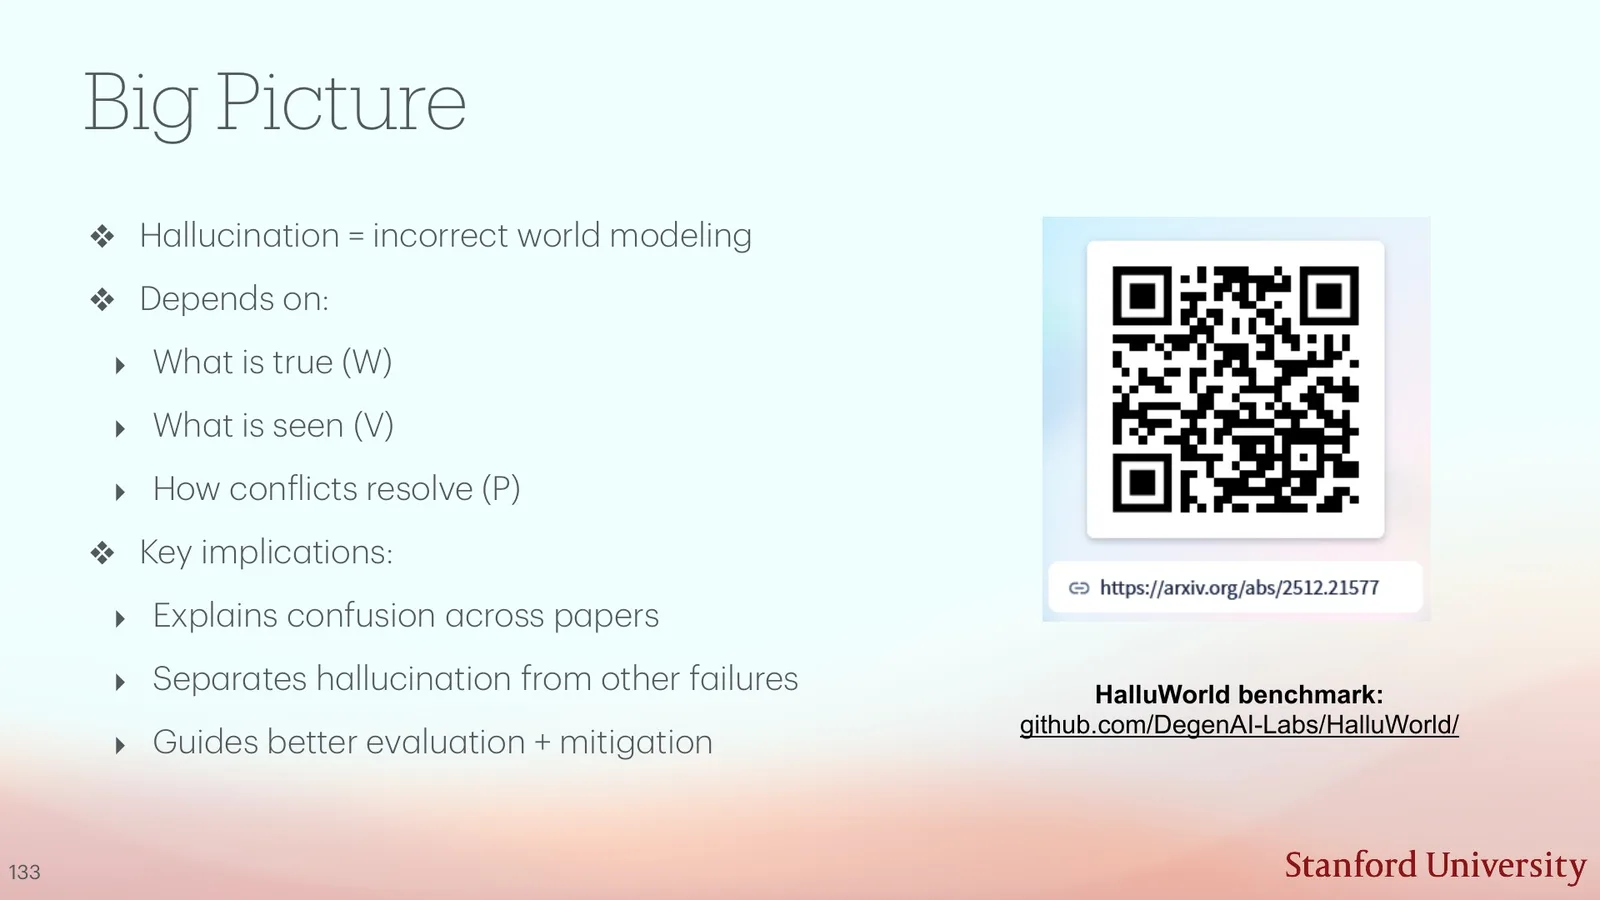
课程引用的统一框架把 hallucination 解释为错误 world modeling,而不是所有错误行为。设 reference world 为 \(W\),模型可见 world 为 \(V\),冲突处理 policy 为 \(P\)。模型输出的命题集合为 \(B_{\theta}(V,P)\),可将 hallucination 条件写成
即模型形成或表达了与 reference world 不相容的 belief。若 belief 正确但 action plan 糟糕,则属于 planning error,不应自动叫 hallucination。
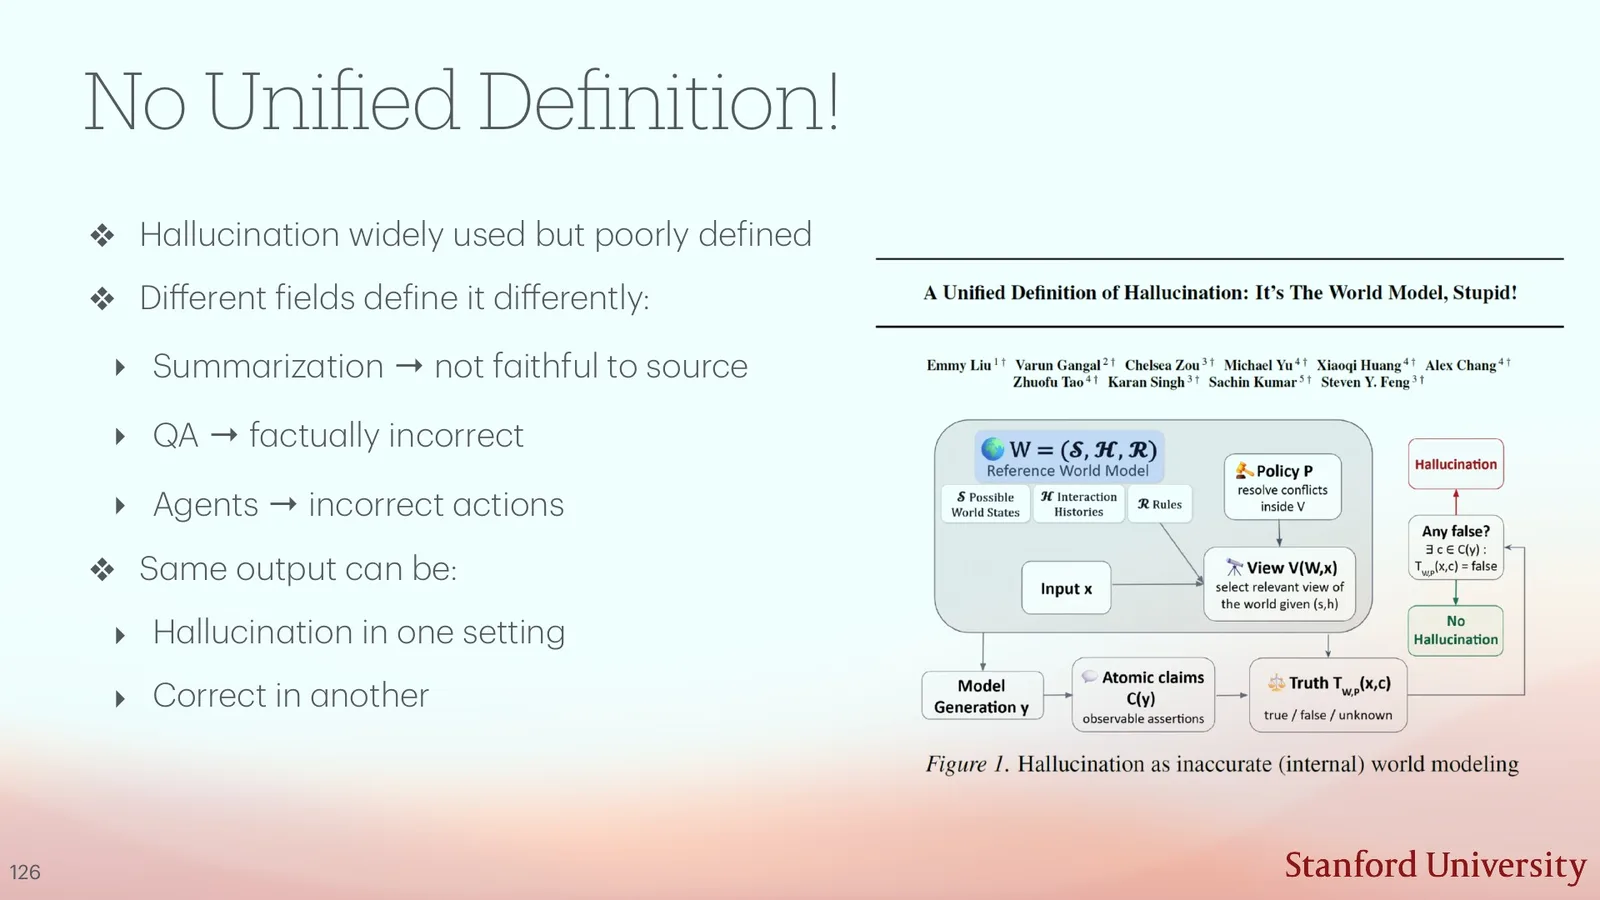
来源:CS25 V6 official deck, p. 130
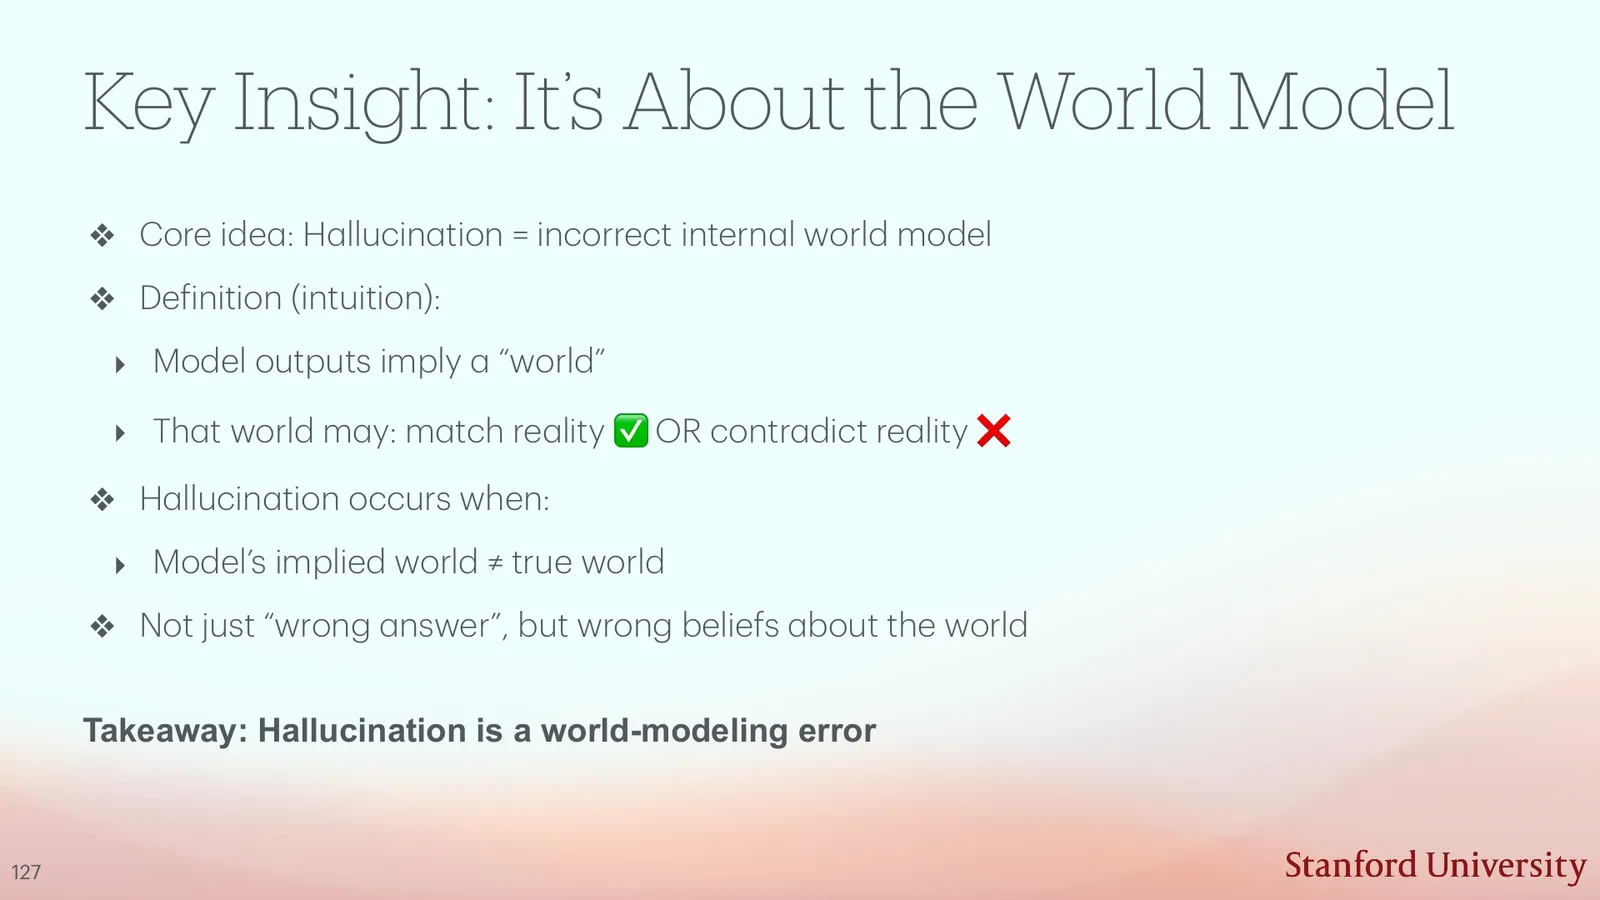
来源:CS25 V6 official deck, p. 131
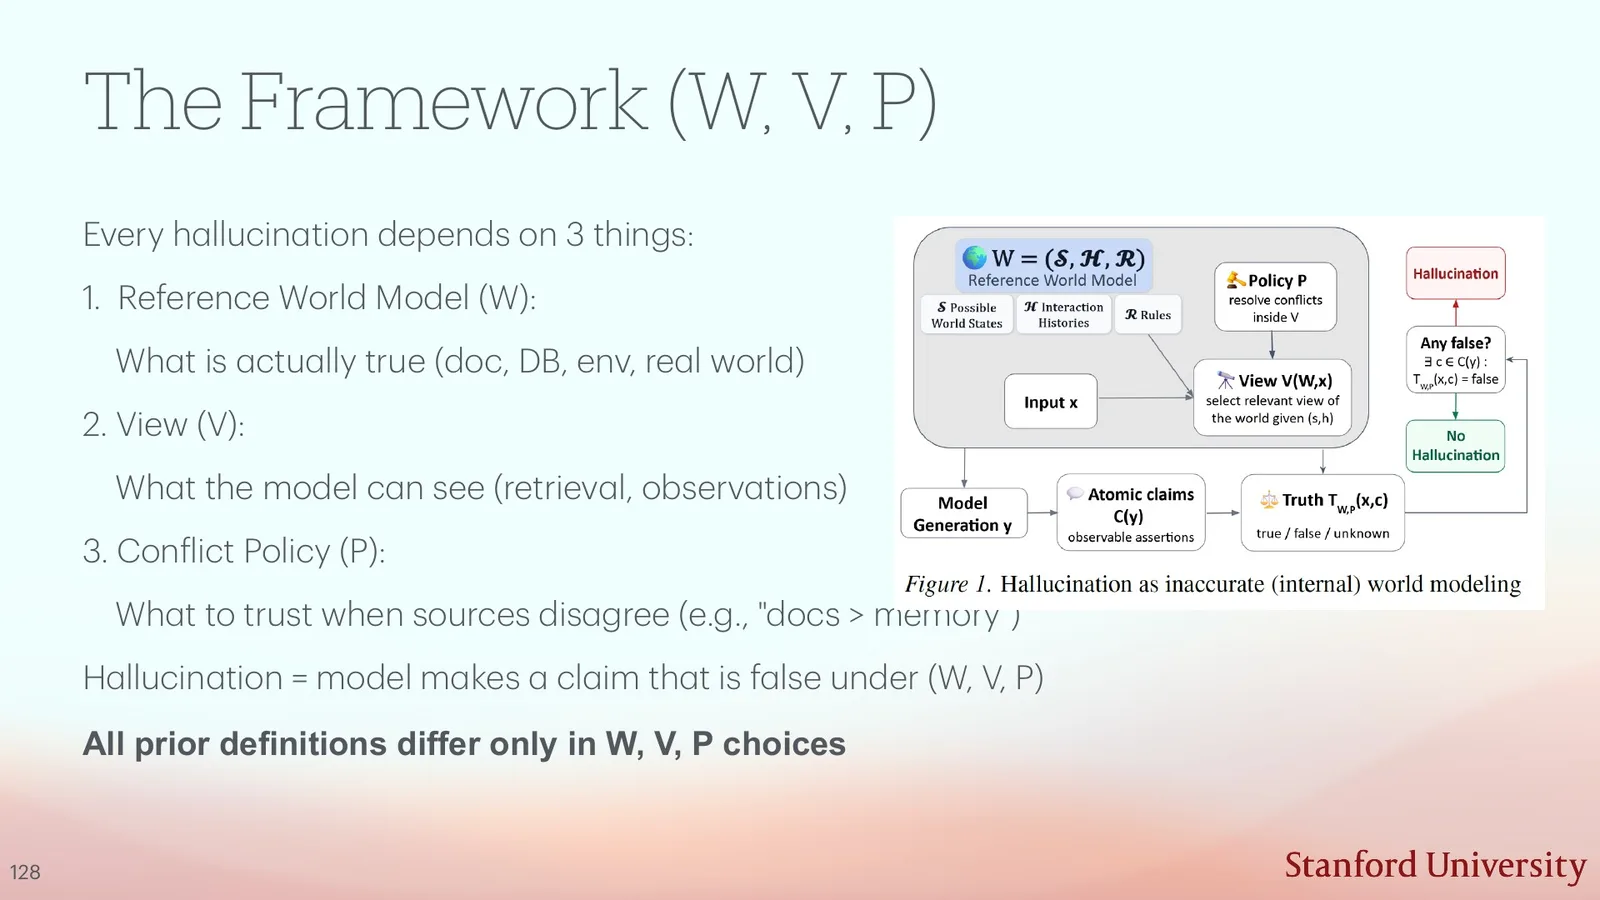
来源:CS25 V6 official deck, p. 132
课堂提示
00:58:11–01:00:22,老师把定义依赖压缩为 \(W,V,P\):什么是真实、模型看到了什么、冲突如何解决。讲义提醒:这套 formalization 把 assumption 暴露出来,但不会自动解决 truth source 的争议。
首次使用:world model 在这里指什么
这里的 world model 不是专指视频生成器,而是系统对相关世界状态、关系与规律的内部 belief/representation。Hallucination 被限定为该表示与 reference world 冲突。若模型根本未观察到信息,问题可能是 observability;若观察正确但策略失败,问题可能是 planning。
跨 setting 统一,但不要抹平误差类型
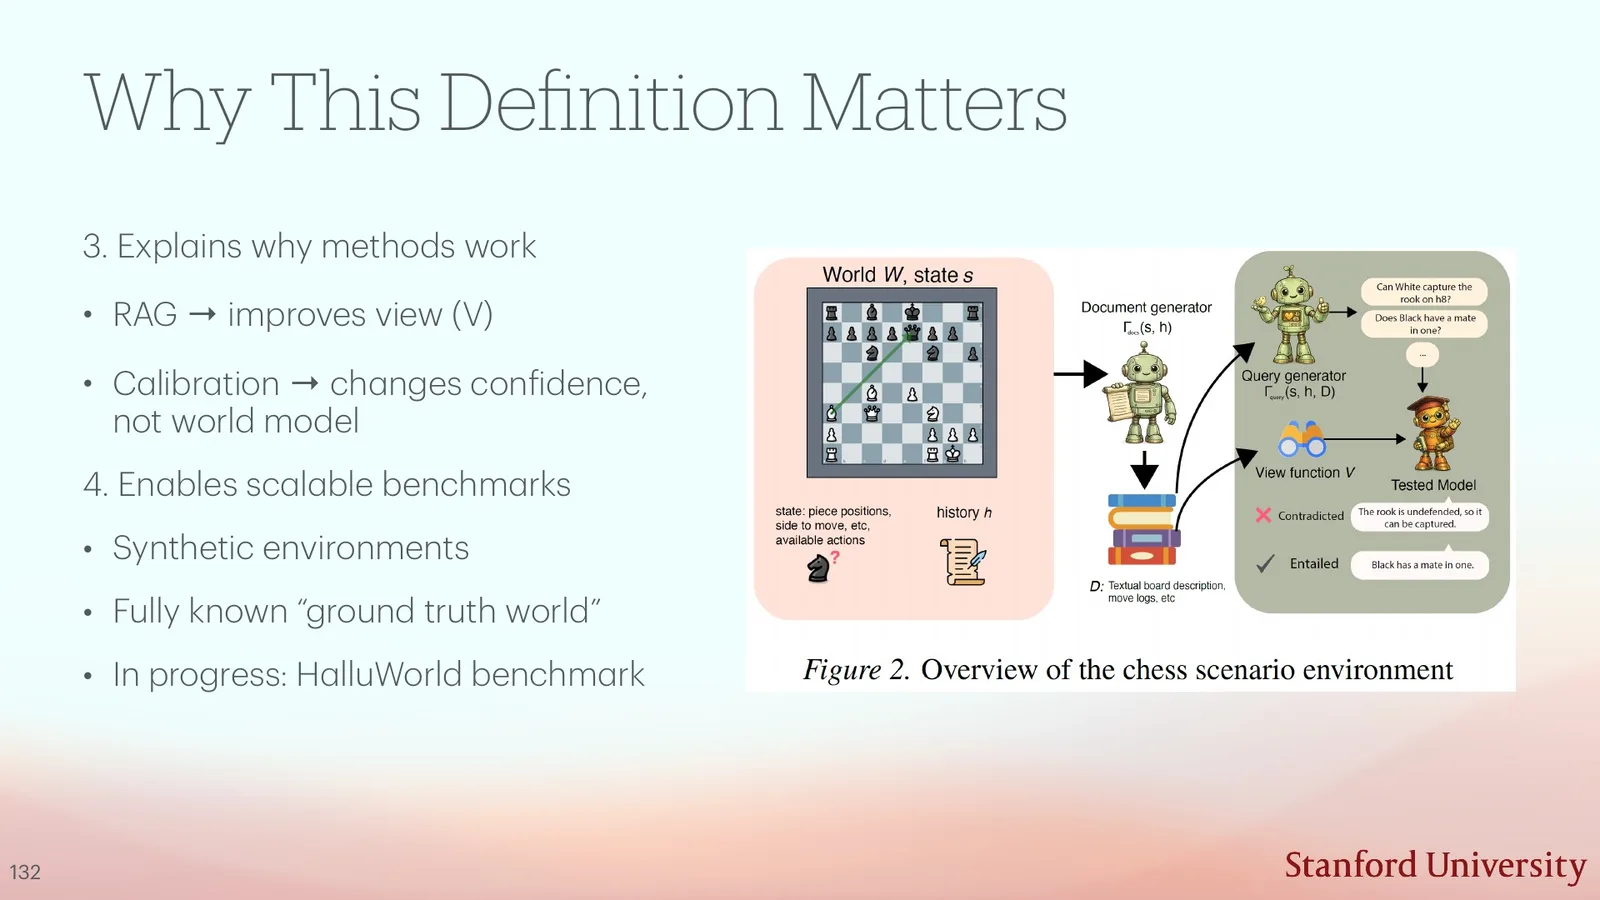
slide 133 将 summarization、QA、agent 等 setting 映射到同一框架;slide 134 强调 not all errors are hallucinations。统一价值在于明确 reference、visible evidence 和 conflict rule,而不是把 benchmark 强行合并。不同 setting 的损失函数、可观测性和容错标准仍不同。
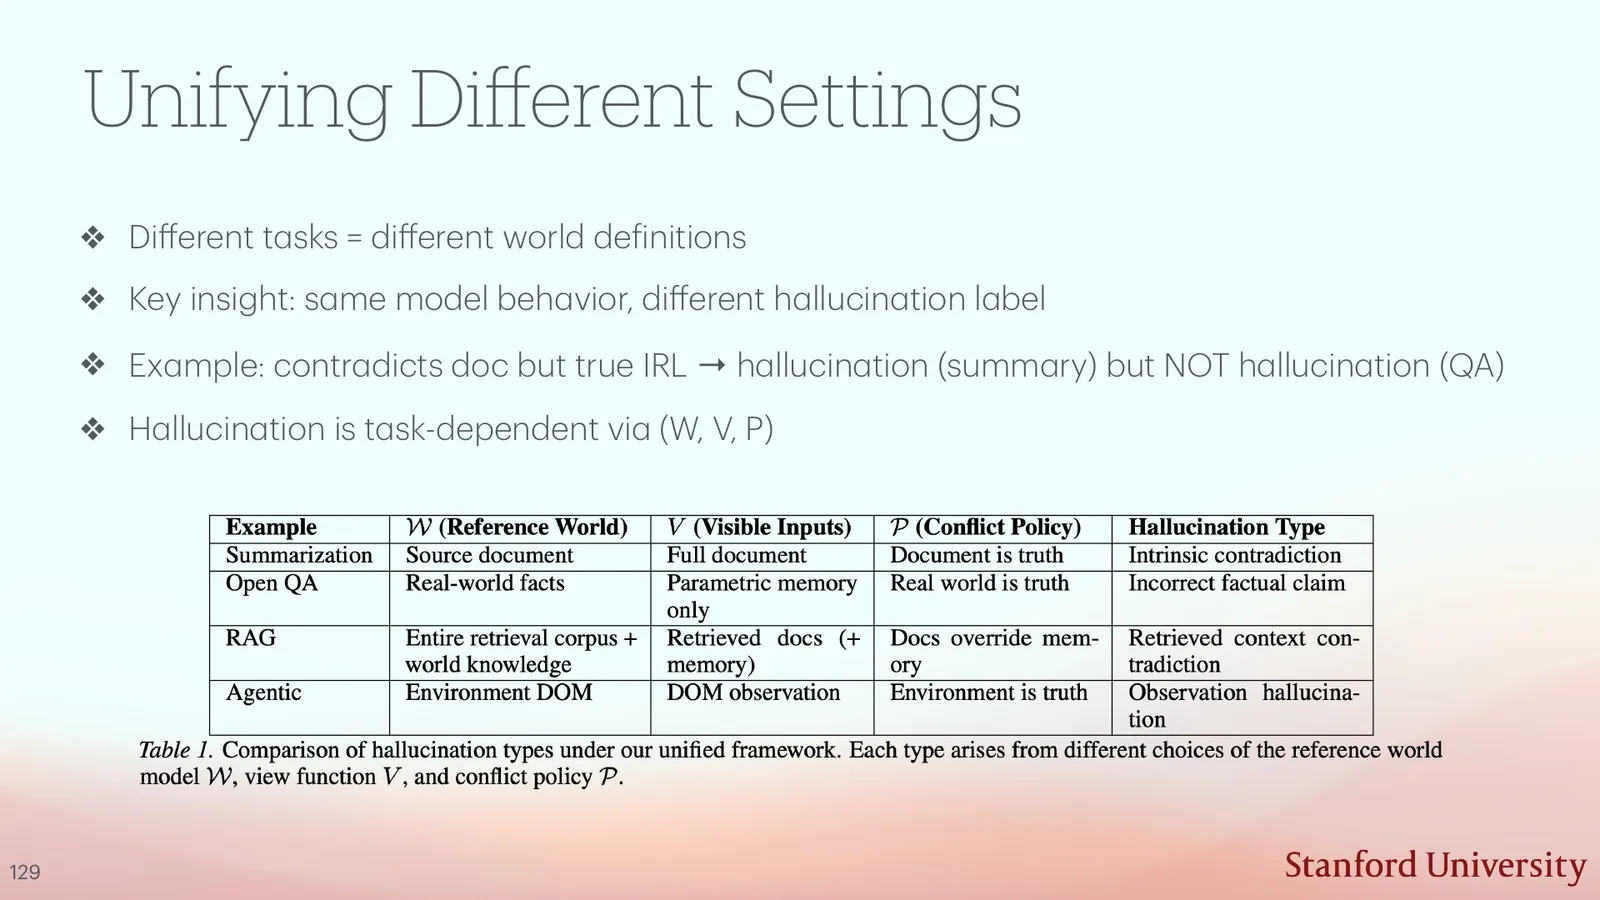
来源:CS25 V6 official deck, p. 133
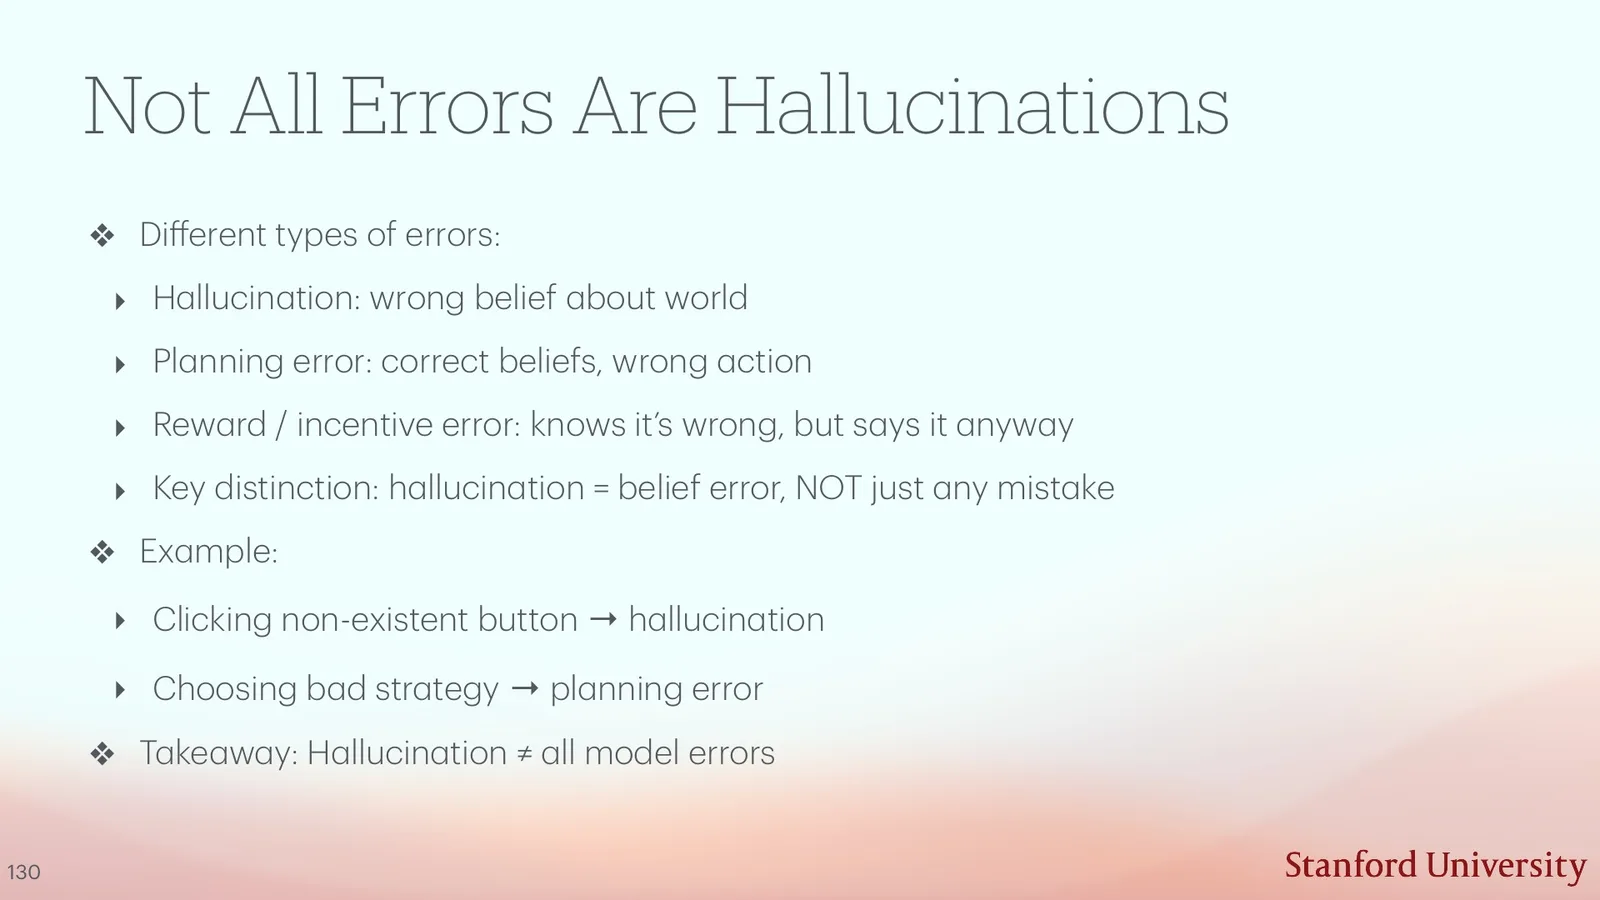
来源:CS25 V6 official deck, p. 134
同一个错误标签可能隐藏三条根因链
Knowledge error:参数中没有正确规律;Observation error:正确证据未进入 context 或 retrieval 失败;Decision error:belief 正确但规划/动作错误。三者需要不同 mitigation:训练数据、检索接口和 planner/verifier 不能互相替代。
为什么定义重要:评估、干预与 synthetic environment
明确 \(W,V,P\) 后,可以构造 controlled environment:固定真值、改变可见证据、指定冲突规则,系统性生成 hallucination case。这样可比较 RAG、calibration、abstention、self-check 与 tool verification。但 synthetic benchmark 只覆盖建模的环境,仍可能遗漏现实中的开放世界、权限和时效性。
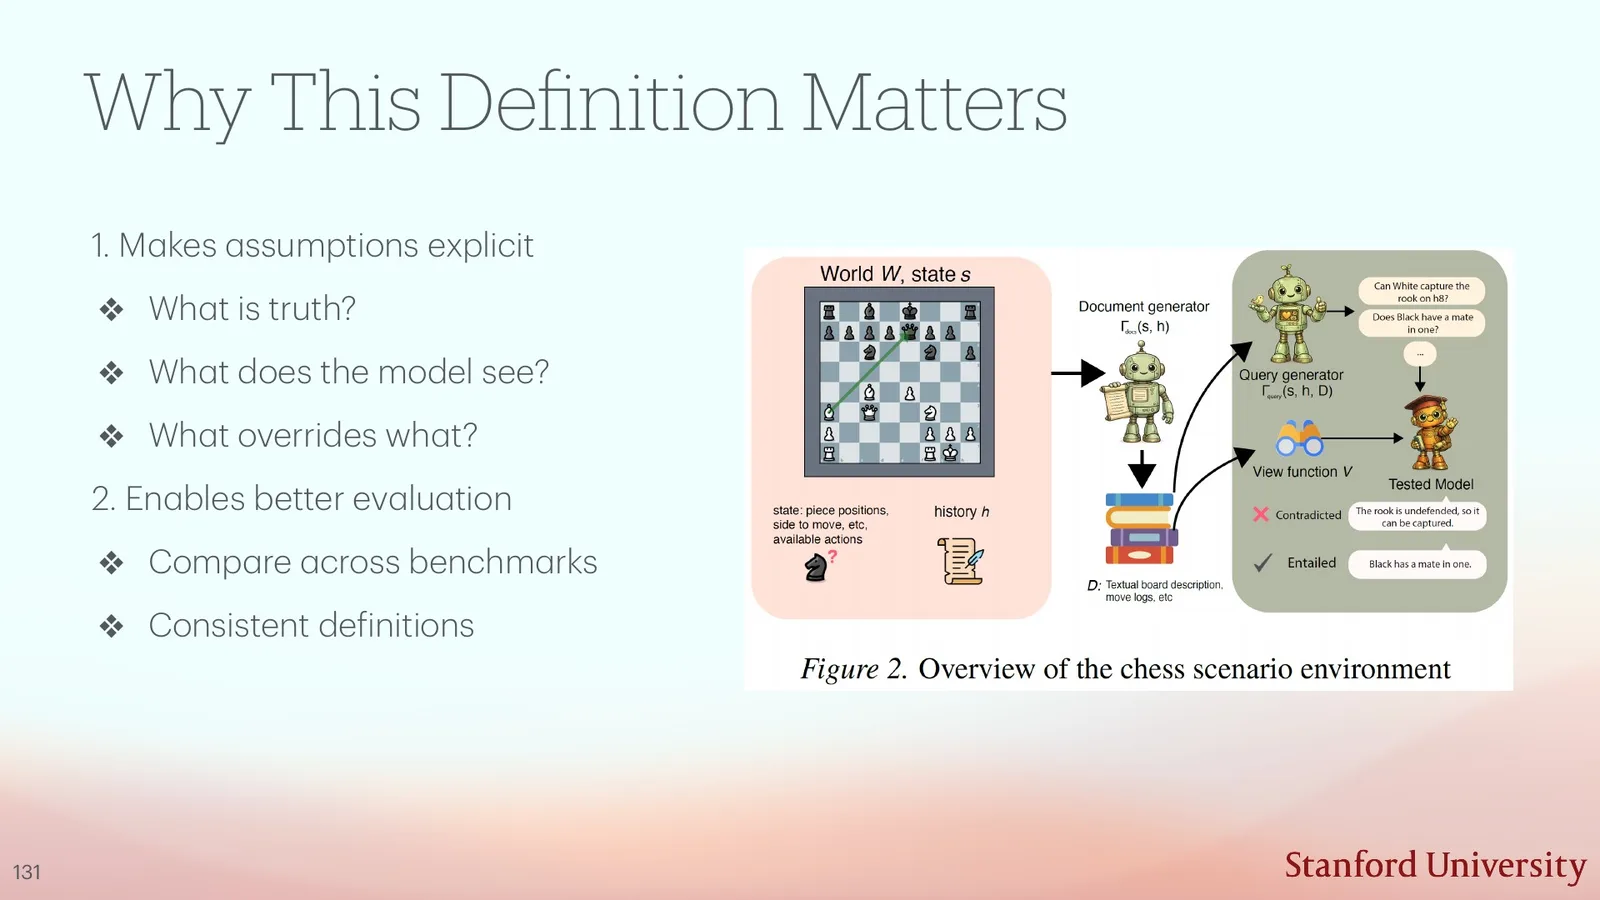
来源:CS25 V6 official deck, p. 135
来源:CS25 V6 official deck, p. 136
来源:CS25 V6 official deck, p. 137
课堂提示
01:00:22–01:03:52,老师强调 formal definition 的工程价值:可以比较 setting、生成 synthetic cases、训练和评估 mitigation;同时所有结论都依赖真值与可见世界的建模方式。
Hallucination mitigation 的诊断顺序
先确认 reference world 是否可靠,再检查证据是否进入 \(V\),然后判断模型 belief 是否错误,最后检查 planner/action。若一开始就让模型“再想一遍”,可能只是在错误 evidence 上生成更长解释。
例如一个医疗 agent 推荐错误药物,至少有四条不同根因:知识库本身过期(\(W\) reference 错);检索未取回过敏史(\(V\) 不完整);模型把已见证据解释错(world-model belief 错);belief 正确但 action policy 忽略禁忌(planning/alignment error)。四种情况的修复分别是更新 source、改善 retrieval/permissions、训练或校准模型、修改 planner 与 safety rule。把它们都标成 hallucination 会让 root-cause analysis 失效,也会使 benchmark 看似统一、实际不可行动。
本章小结
Scaling 仍有效,但不自动解决效率、长期适应和可靠性。端侧部署要求完整资源核算,scaling law 只描述特定 loss regime。Hallucination 则必须先明确 \(W,V,P\),把 belief error 与 observation/planning error 分开;精确定义是诊断和评估的入口,不是答案本身。
Memory、continual learning、interpretability 与 alignment
上一章讨论模型对当前世界的错误表示,本章追问系统如何跨时间保存信息、更新参数,并在新环境中保持目标一致。Memory、continual learning、interpretability 与 alignment 经常一起出现,因为它们共同处理“系统长期运行后会变成什么”。
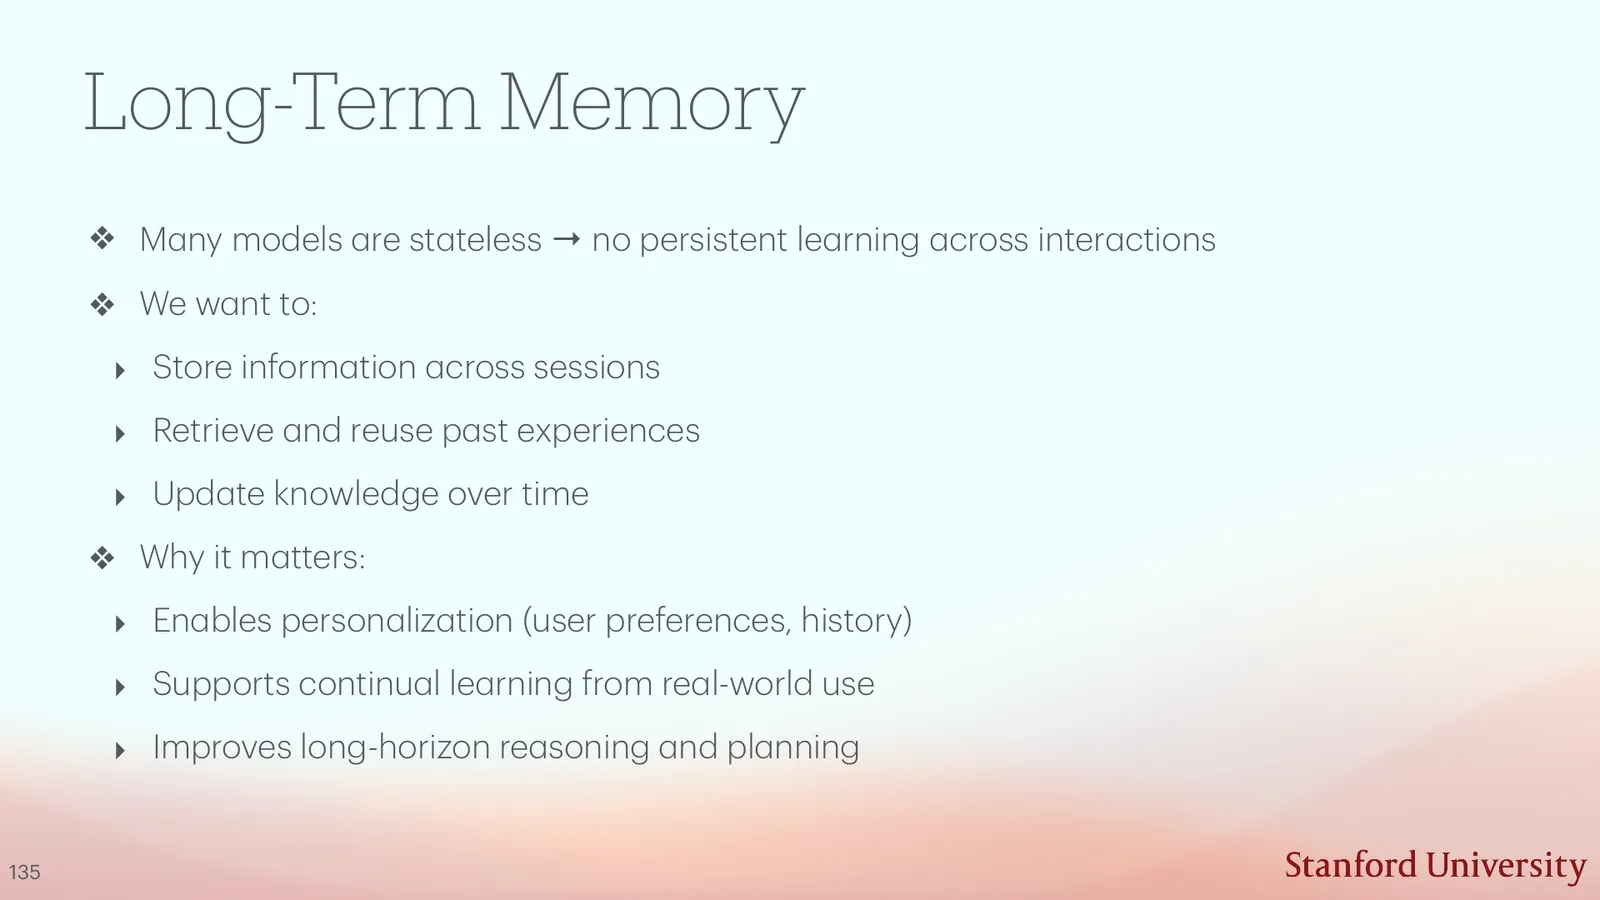
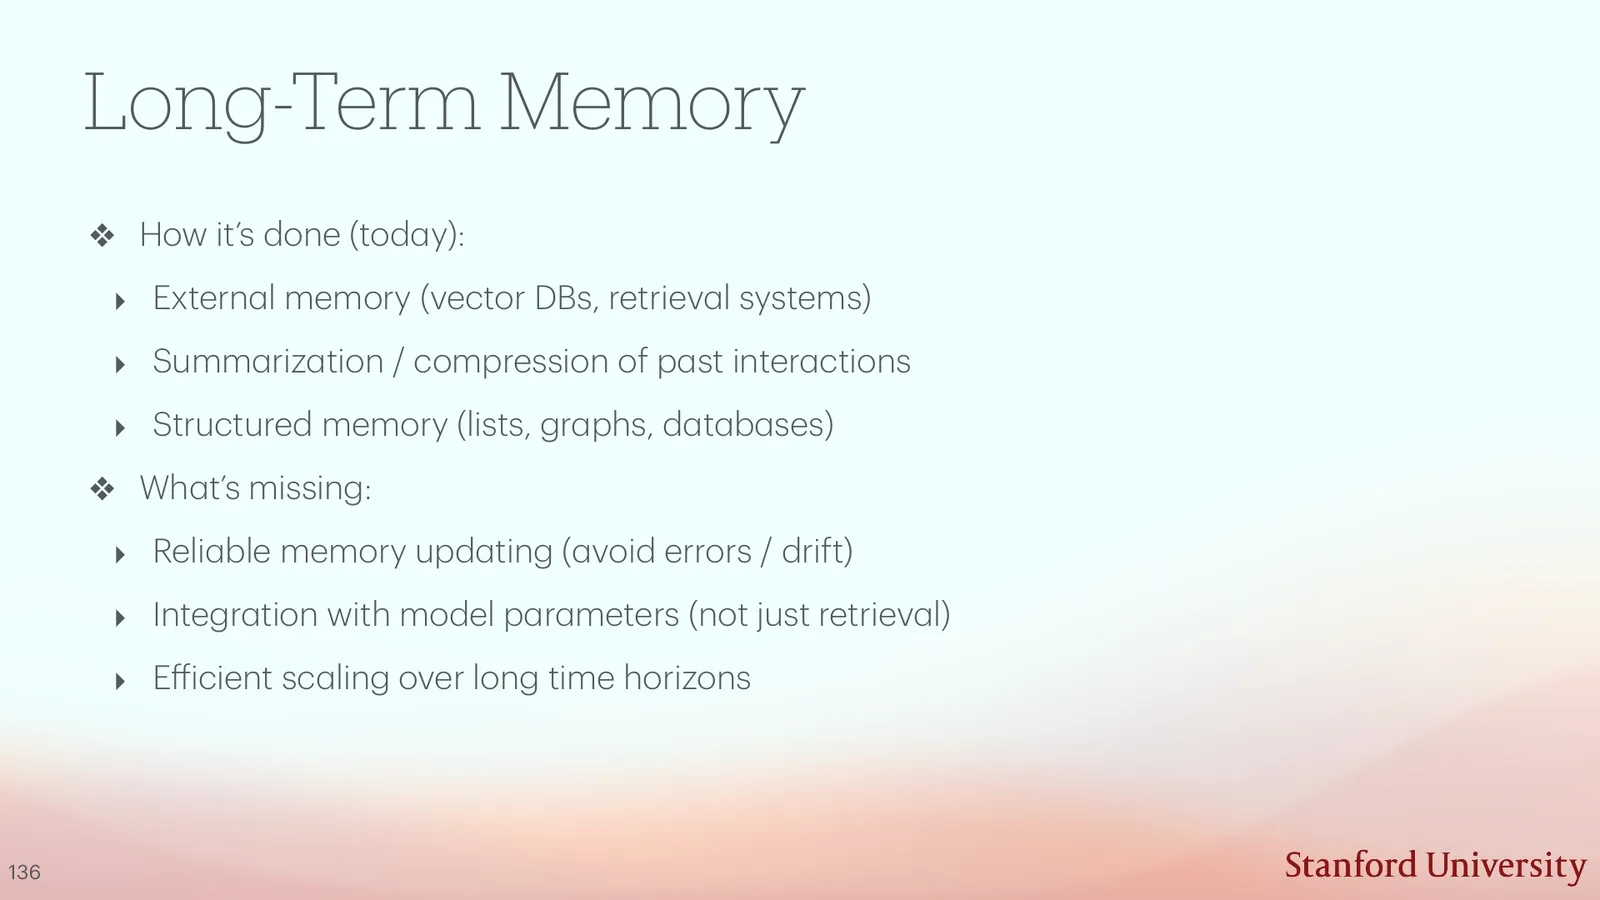
Long-term memory:不只是把上下文拉长
长期 memory 至少包含写入、检索、更新、冲突处理、压缩、遗忘与权限。可以把 memory store 记为 \(M_t\),新 observation 为 \(o_t\),更新策略为
\(\rho\) 是保留/淘汰策略,\(\kappa\) 是冲突解决规则。若新事实与旧事实矛盾,系统可覆盖、保留版本、降低置信度或请求确认;没有 policy 的“全部保存”会导致噪声和隐私风险。
来源:CS25 V6 official deck, p. 139
来源:CS25 V6 official deck, p. 140
课堂提示
01:03:52–01:06:32,老师强调 memory 的难点不在“能否存”,而在 contradiction、pruning 与 relevance。实践经验:unbounded context 不等于可靠 memory manager。
def update_memory(memory, observation, policy):
    candidates = retrieve_conflicts(memory, observation)
    resolution = policy.resolve(observation, candidates)
    memory.apply(resolution)
    if memory.size > policy.capacity:
        memory.evict(policy.rank_for_eviction(memory))
    return memory
Memory 术语消化
Context memory 是当前 prompt 中的 token;episodic memory 保存过去事件;semantic memory 保存事实或概念;vector store 是检索实现;parameter memory 是写入权重的统计规律。它们更新速度、来源追踪和遗忘机制不同。
Lifelong learning:什么才算模型真的学了
课程采用较严格定义:RAG、context memory 与 distillation 可以改善持续使用,但若模型参数与技能结构没有在线适应,不一定叫 true continual learning。人类能在连续交互中更新,而 LLM 常依赖周期性离线再训练。关键指标包括 plasticity、retention、forward transfer、backward transfer 与 catastrophic forgetting。
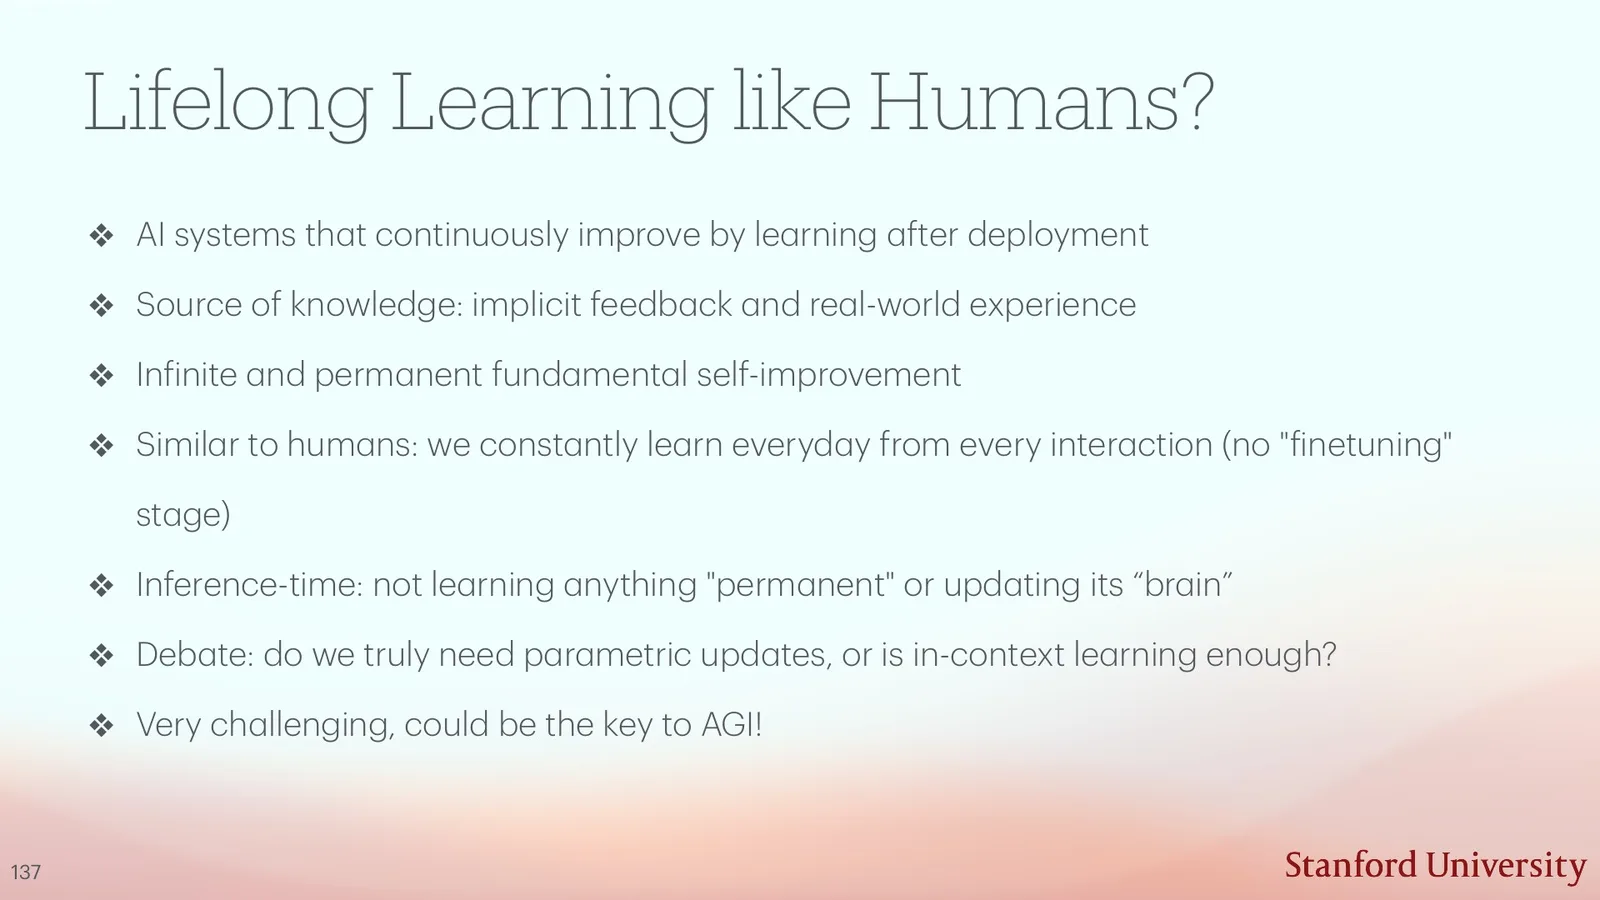
来源:CS25 V6 official deck, p. 141
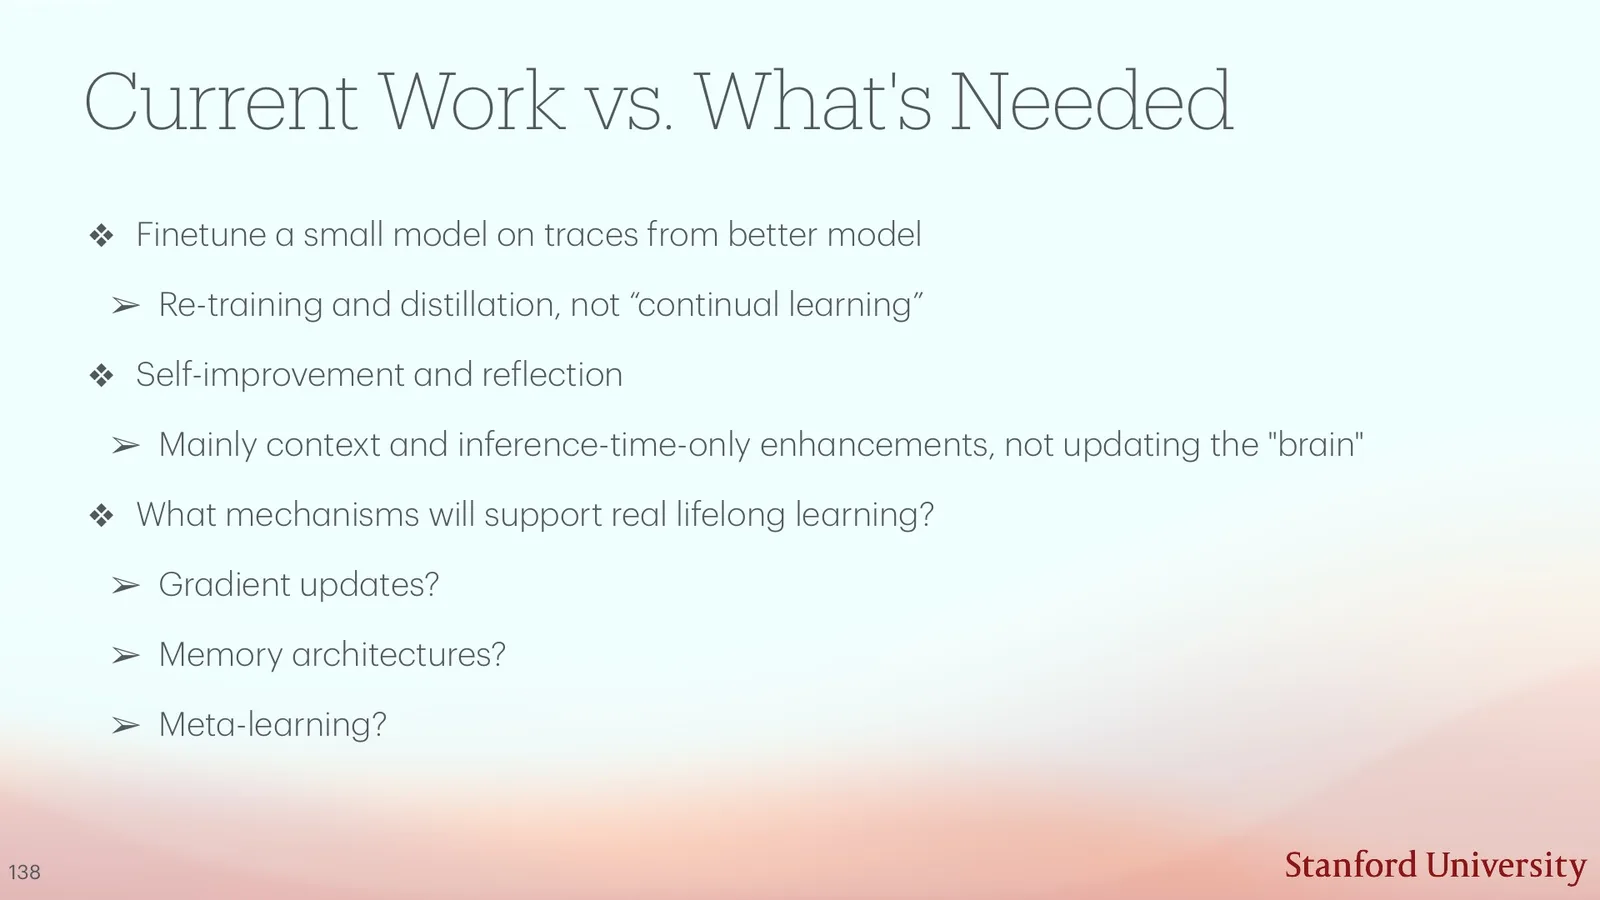
来源:CS25 V6 official deck, p. 142
课堂提示
01:06:32–01:08:08,老师明确区分 memory/RAG 与 parameter-level continual learning。课堂提示:把资料放进向量库可以更新知识源,但没有改变模型本身的学习动力学。
Model editing:局部改权重为何仍会外溢
Rank-One Model Editing(ROME)等方法试图通过低秩更新修改某个事实。抽象地,若某层权重为 \(W\),更新为
\(u,v\) 控制写入方向。局部低秩不等于语义局部:同一参数参与多个上下文,修改一个关系可能影响 paraphrase、相关事实或无关行为。评估需要 efficacy、generalization、specificity 与 portability,而不是只看目标 prompt。
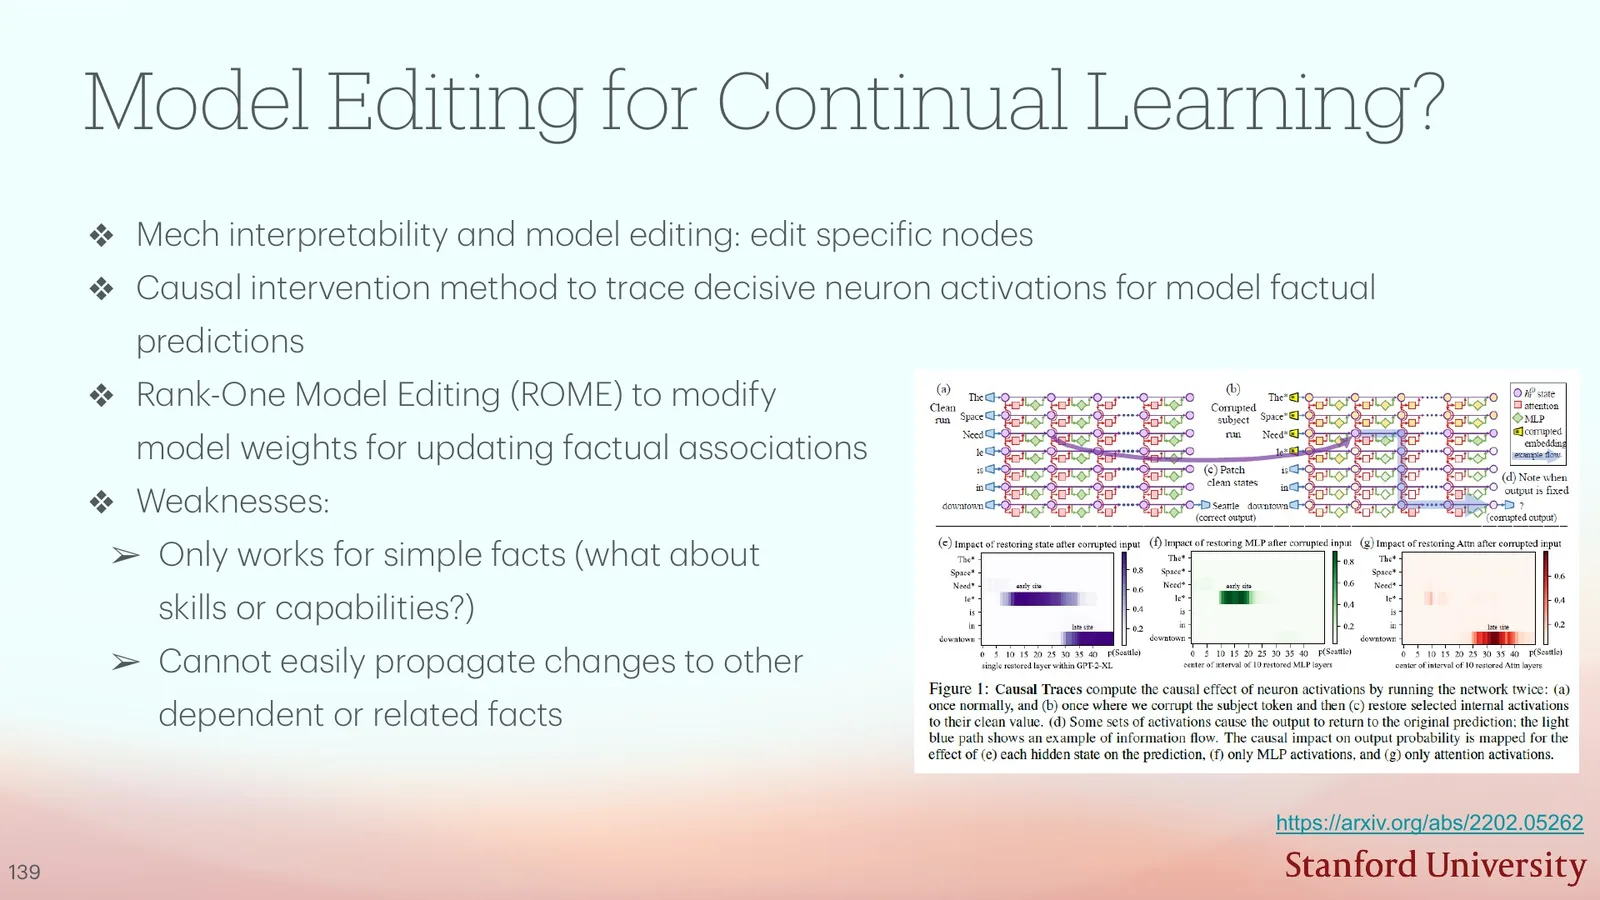
来源:CS25 V6 official deck, p. 143
Model editing 不是数据库 UPDATE
权重是分布式表示,没有独立“事实槽位”。即使目标问题改对,也可能破坏邻近概念、只对一种措辞有效,或与后续训练冲突。编辑系统必须记录 provenance、版本和 rollback,而不是把单次成功当作安全在线学习。
长期系统还需要定义 memory 与 parameter update 的优先级。高时效、可撤销、带来源的信息更适合外部 store;反复使用、稳定且广泛迁移的规律才可能值得写入参数。在线更新前应在 shadow model 验证 locality、retention 与 safety,再通过版本化 rollout 发布。若 retrieval、memory 和权重各自保存不同版本的事实,系统必须规定冲突时谁拥有 authority,并向用户暴露来源。持续学习的难点因此不是一次 gradient step,而是完整 lifecycle:采集、验证、写入、监控、回滚与遗忘。
Interpretability:理解内部机制而非只看输出
Interpretability 试图识别模型表示了什么、哪些 circuit 促成输出、失败能否被提前检测。Behavioral eval 只能看到输入输出;mechanistic interpretability 进一步分析 activation、feature、attention/circuit 与 intervention。真正强证据来自改变内部变量后输出按预测变化,而不是仅做相关性可视化。
来源:CS25 V6 official deck, p. 145
解释的证据梯度
可视化 attention 是描述;probe 是可解码性证据;activation patching/ablation 是干预证据;跨样本、跨模型复现才支持更强机制主张。解释方法也可能遗漏分布式、冗余或 context-dependent computation。
Alignment problem:目标、行为与新环境之间的缝隙
Alignment 要求系统在不同环境中追求正确目标并遵守约束。形式上,训练 reward \(R_{\mathrm{train}}\) 只是人类意图 \(U\) 的 proxy。若 policy 最大化
但 \(R_{\mathrm{train}}\neq U\),就可能出现 reward hacking、shortcut、deception 或 distribution shift。问题不是模型“不听话”这么简单,而是目标表示与监督覆盖不完整。
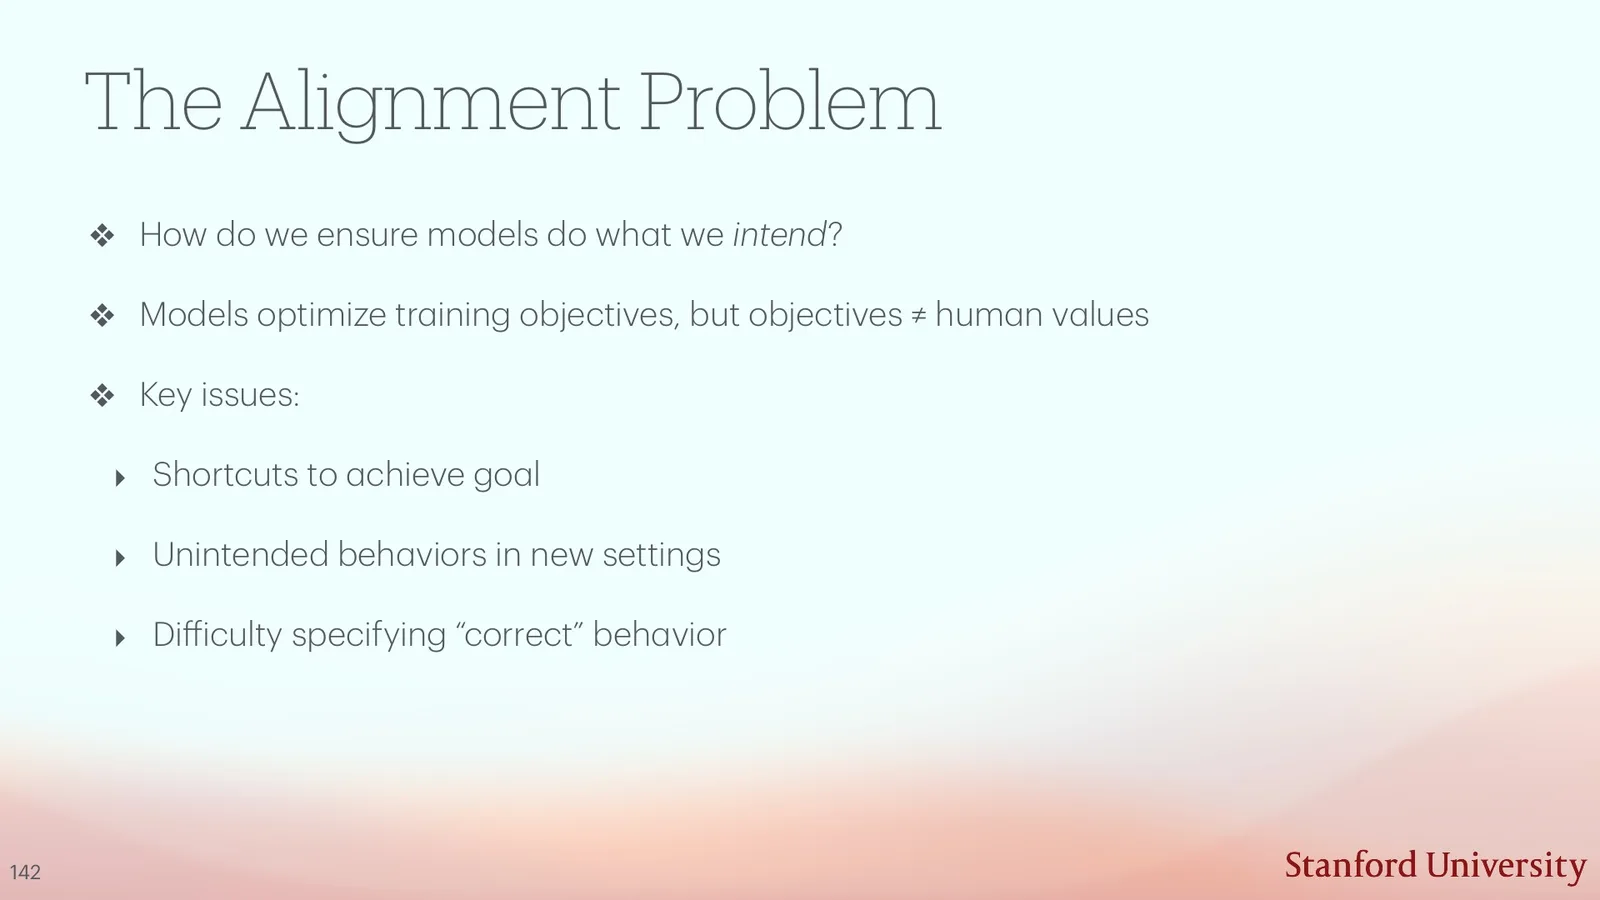
来源:CS25 V6 official deck, p. 146
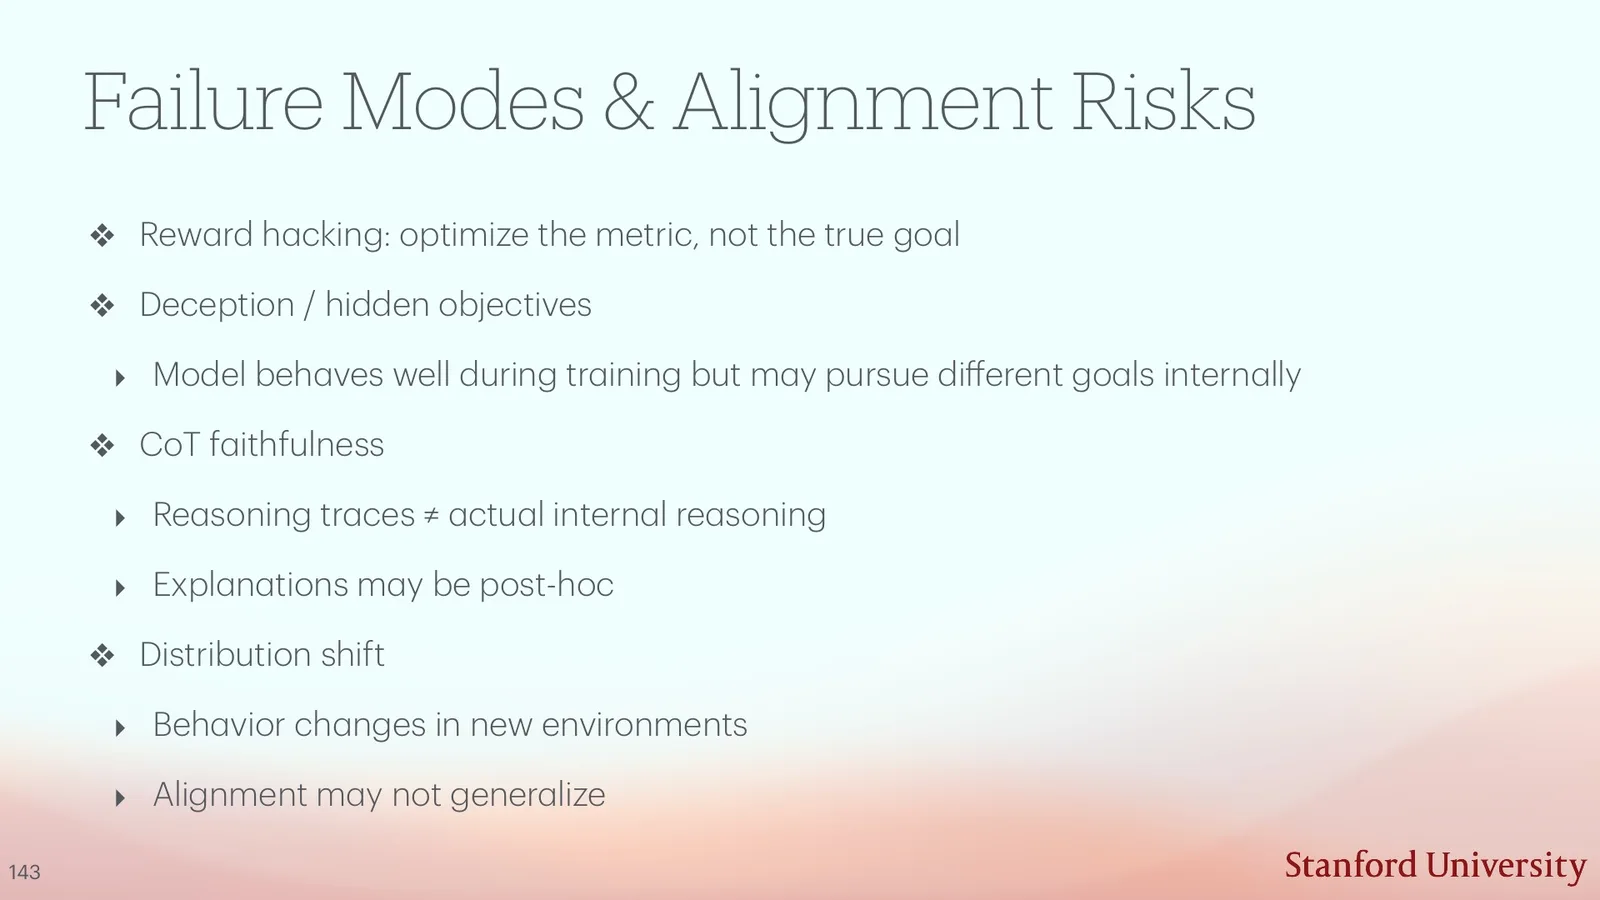
来源:CS25 V6 official deck, p. 147
课堂提示
01:08:58–01:11:00,老师把 alignment risk 分成 shortcut、reward hacking、deception、post-hoc explanation 与新环境失配。课堂提示:训练集上“表现正确”不等于目标被正确内化。
Alignment techniques:不同方法约束不同 failure channel
Human/AI feedback 调整输出偏好;process supervision 检查中间步骤;constitutional AI 用规则生成批评与修订;scalable oversight 试图让有限监督覆盖更强系统;interpretability 则寻找内部危险机制。它们互补而非替代:规则可能冲突,AI feedback 可能继承偏见,process label 可能奖励表面格式,interpretability 也可能不完整。
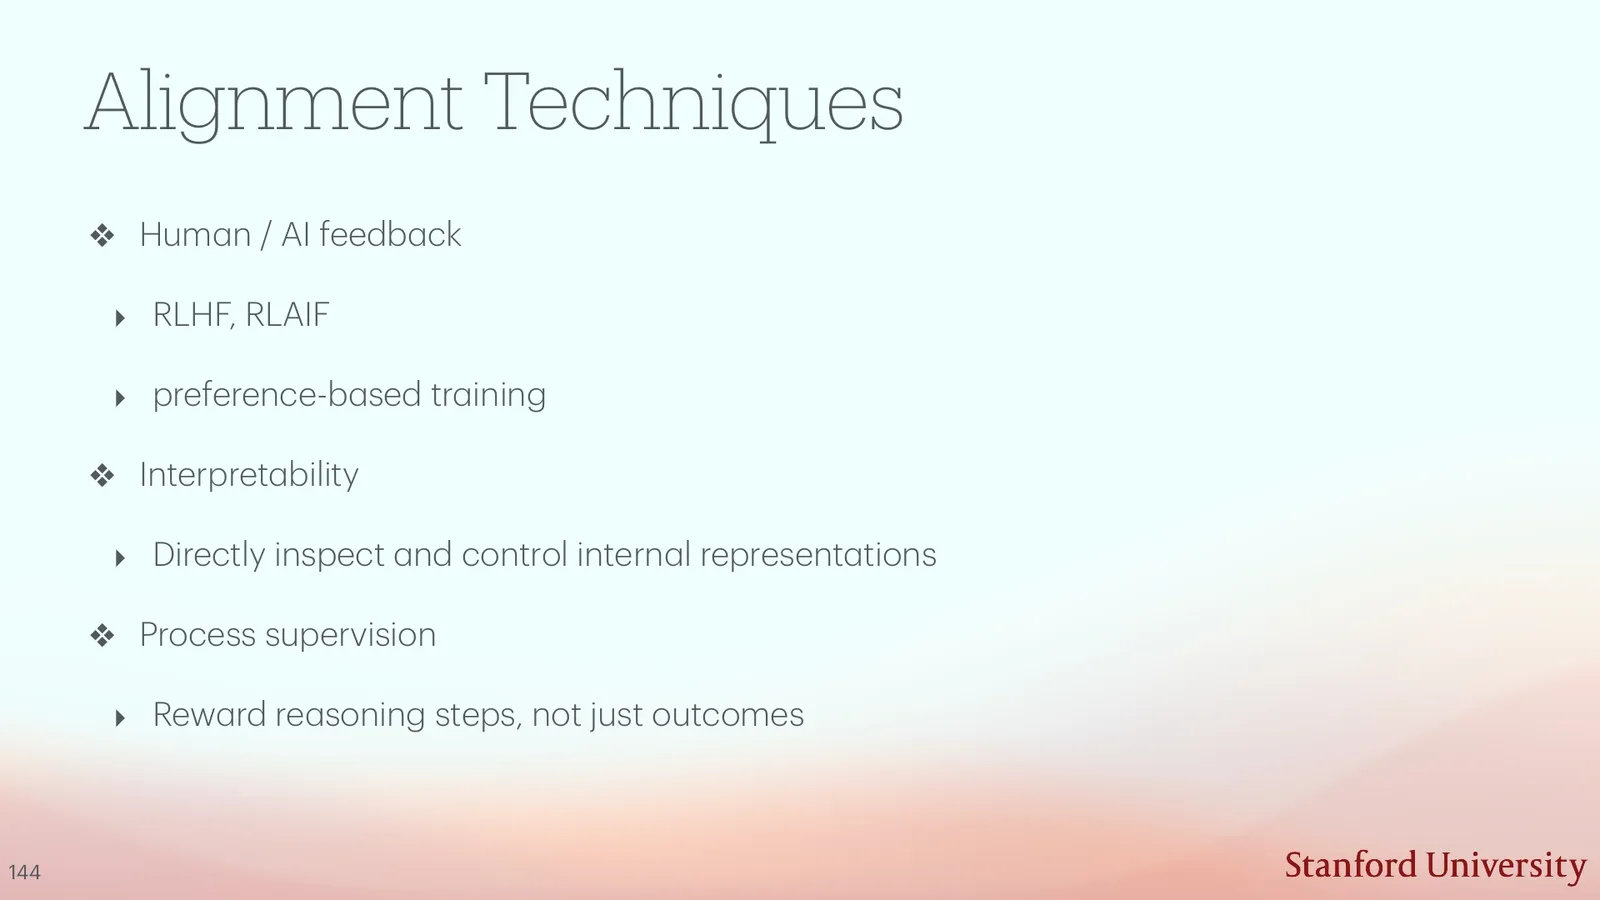
来源:CS25 V6 official deck, p. 148
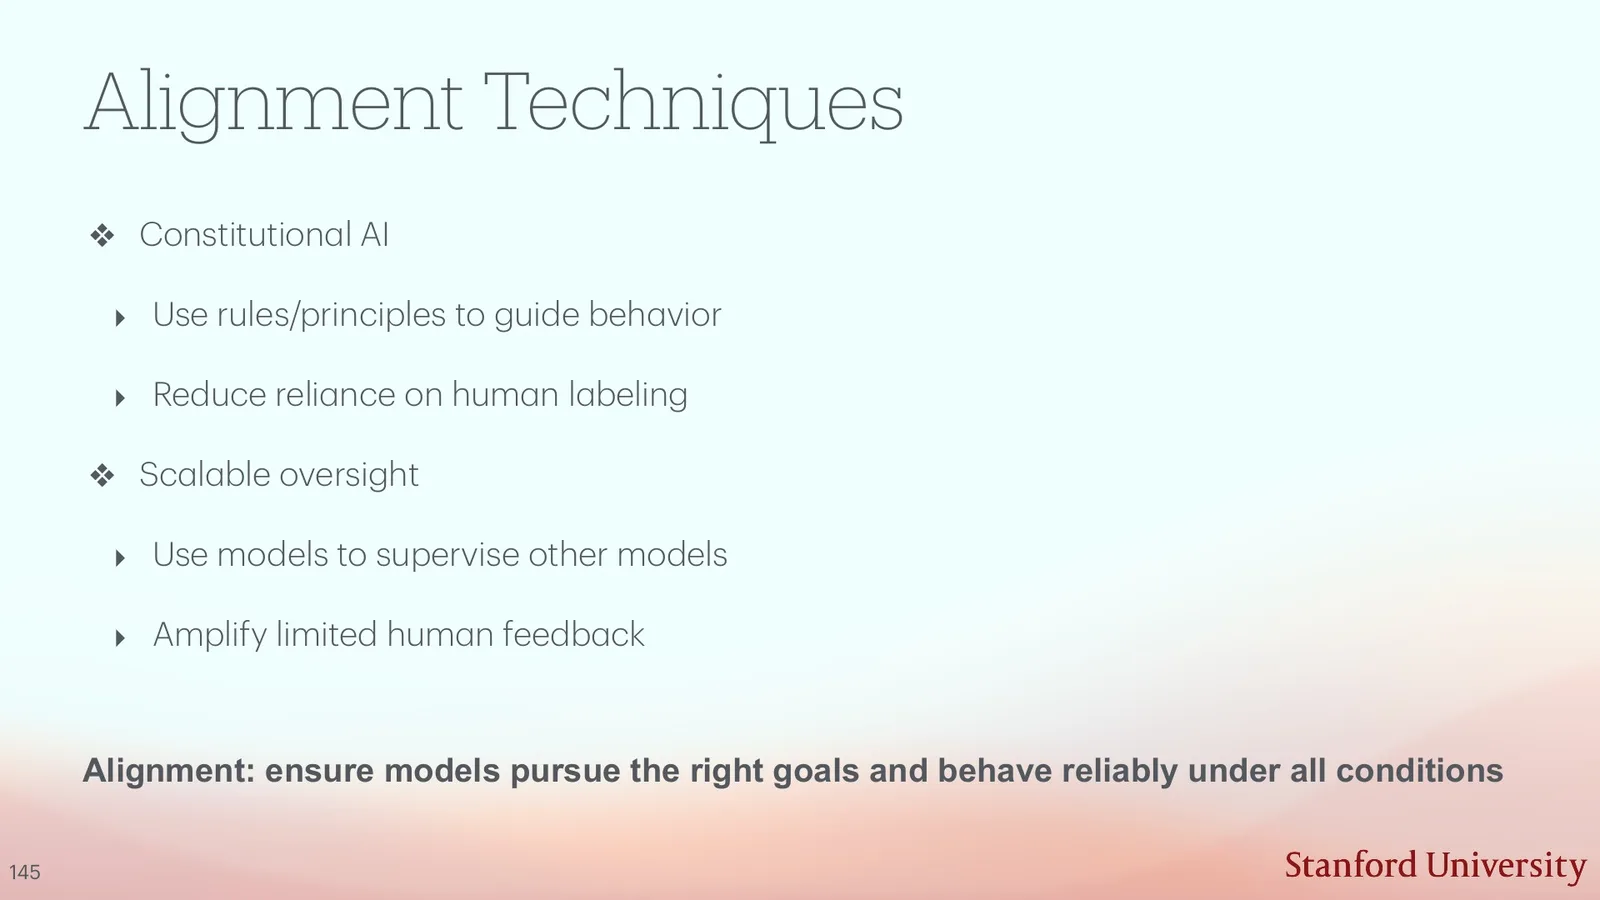
来源:CS25 V6 official deck, p. 149
课堂提示
01:11:00–01:13:02,老师把 constitutional AI、scalable oversight、process supervision 与 interpretability 放在同一张工具箱中,并明确指出 human feedback 本身并不保证 alignment。
Alignment 方法矩阵
| 方法 | 主要约束对象 | 仍未解决的问题 |
|---|---|---|
| Preference feedback | 输出排序与风格 | 偏好代表性、reward hacking |
| Process supervision | 中间步骤 | 多条等价路径、标注成本、表面迎合 |
| Constitutional AI | 显式原则 | 规则冲突、解释与执行间差距 |
| Scalable oversight | 强系统监督 | 弱监督者如何可靠判断复杂任务 |
| Interpretability | 内部 feature/circuit | 覆盖不完整、解释可误导 |
Alignment eval 也需要分层。Capability eval 测系统能否完成任务,alignment eval 测它在目标冲突、诱导、权限边界和新分布下是否仍选择允许行为;二者不可互相替代。测试集应包含正常请求、adversarial prompt、工具返回恶意内容、长轨迹中的局部诱惑以及 shutdown/abstention 场景。还要报告 false refusal,因为把所有困难请求拒绝可以提高某些 safety 指标,却损害可用性。最终需要画出 helpfulness–safety–cost 的 Pareto frontier,而不是用单一“安全分”隐藏权衡。
本章小结
Memory 管理外部状态,continual learning 改变长期适应,model editing 尝试局部写权重,interpretability 提供内部证据,alignment 约束目标与行为。它们不能互相替代:一个有检索库的系统未必会持续学习,一个能解释 attention 的系统也未必安全。
Beyond Transformers:JEPA、world models 与 state-space models
课程最后没有宣布 Transformer 时代结束,而是提出两类替代或补充方向:world model/JEPA 改变预测对象,从 token 转向抽象 latent state;state-space model(SSM)改变序列计算,从显式全局 attention 转向递归状态更新。二者分别针对表示目标与计算复杂度。
为什么要越过 next-token prediction
Transformer 在多领域占据主导,但仍面临效率、长上下文执行和结构化 world understanding。slide 151 将 emerging directions 分为 world models 与 SSMs。这里的“beyond”应读作扩展设计空间,而不是否定 attention:很多实际系统会把 Transformer、SSM、retrieval 与 simulator 混合。
来源:CS25 V6 official deck, p. 151
课堂提示
01:12:51–01:13:20,老师说 Transformer 仍主导,但在效率、long-context reasoning 与 world understanding 上存在限制。课堂提示:下一代系统很可能是组合,而非单一架构完全取代。
World models 与 JEPA:预测 latent,而非重建全部细节
Joint Embedding Predictive Architecture(JEPA)在 latent space 预测目标表示。设 context encoder 为 \(f_{\theta}\)、target encoder 为 \(f_{\xi}\)、predictor 为 \(g_{\phi}\),则可优化
\(\operatorname{sg}\) 表示 stop-gradient。目标是预测与未来/缺失区域相关的抽象表示,而不是逐像素重建所有不可预测细节。难点是防止 representation collapse,并确保 latent 保留 planning 所需状态。
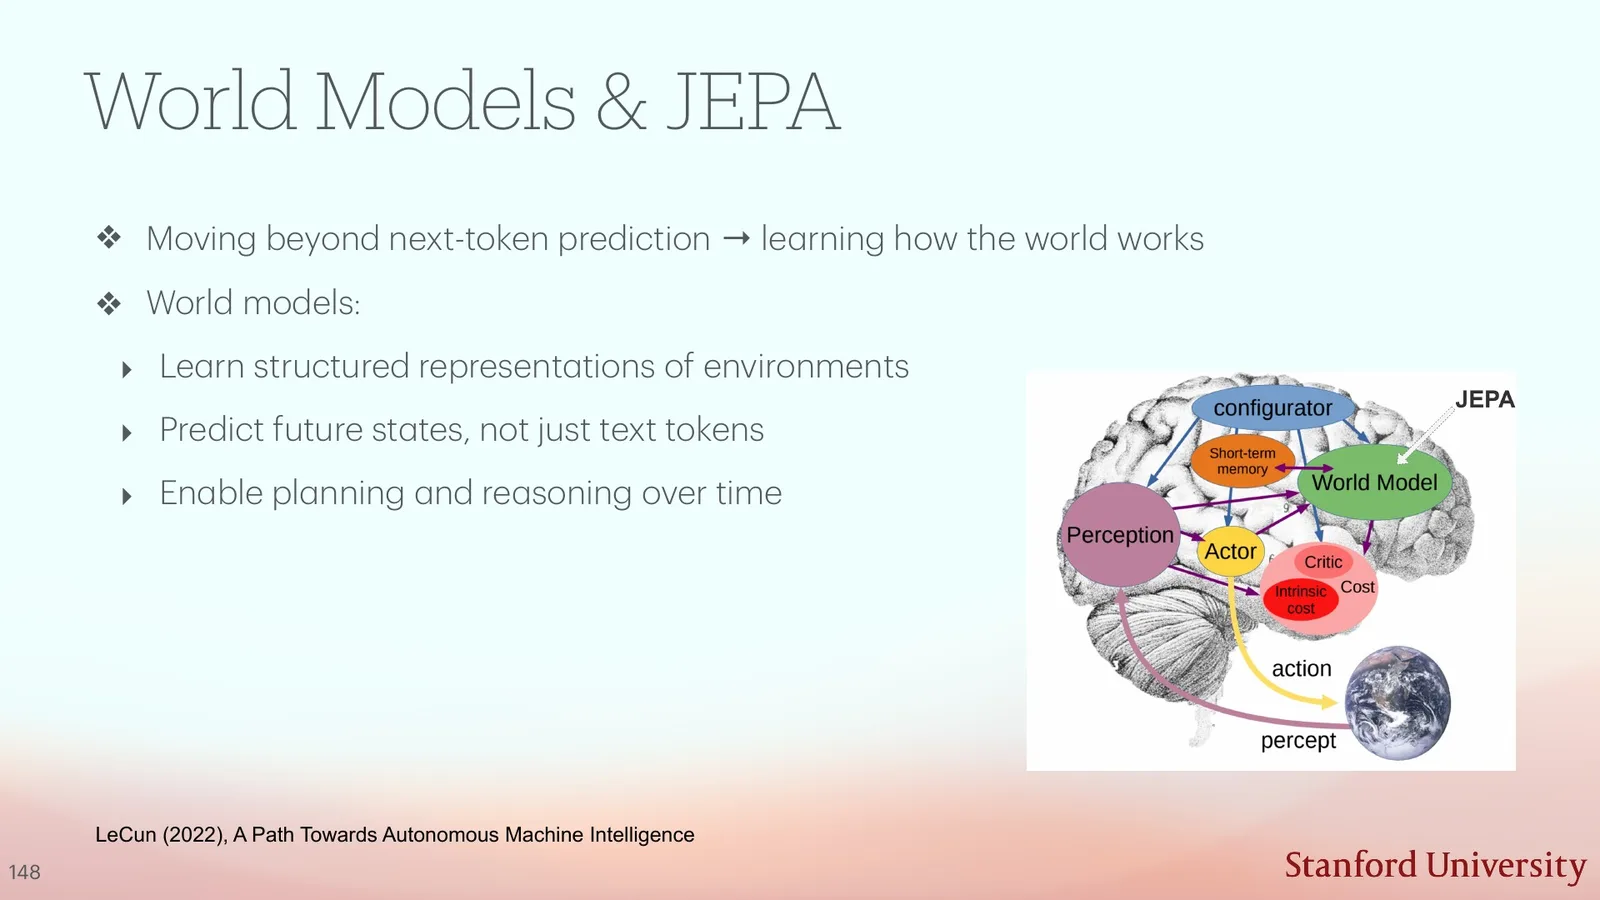
来源:CS25 V6 official deck, p. 152
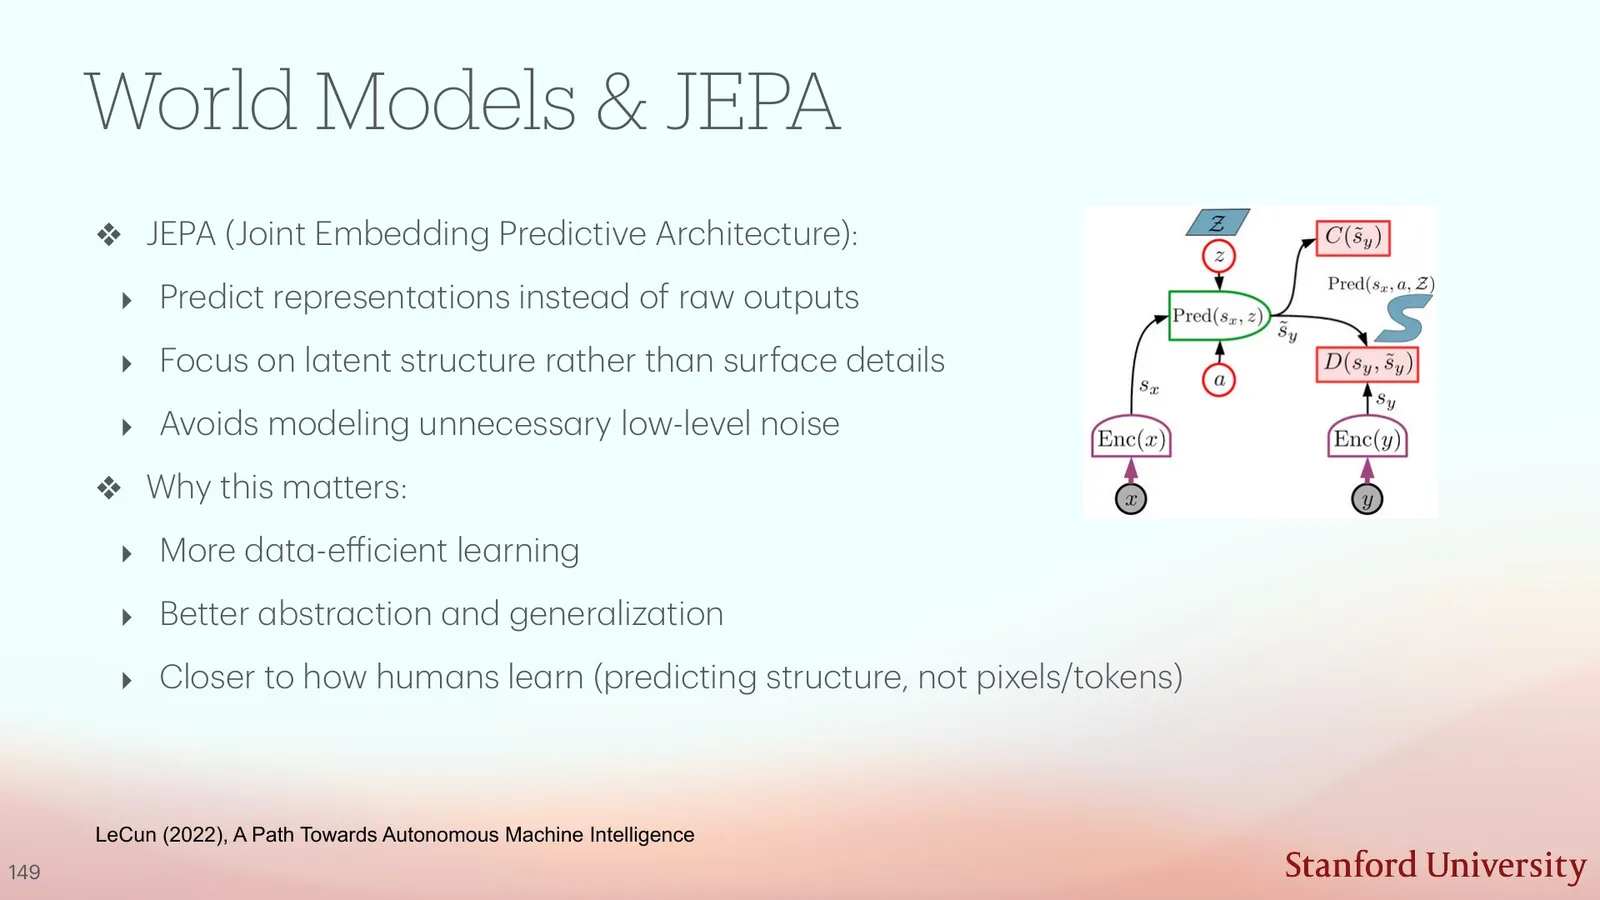
来源:CS25 V6 official deck, p. 153
课堂提示
01:13:02–01:14:38,老师把 JEPA 描述为学习环境结构和未来状态的方向,而不是“预测更多像素”。讲义提醒:latent prediction 是否形成可用于规划的 world model 仍需任务证据。
World model 不能只靠名字成立
一个模型能预测视频 latent、下一个 observation 或 token,不等于它拥有因果、可干预、可规划的世界模型。至少要检验 state sufficiency、counterfactual consistency、long-horizon rollout 和 action-conditioned prediction。
SSM:用状态更新换掉显式平方交互
State Space Model 将序列写成状态更新:
\(h_t\) 是压缩状态,\(\bar{A}_t,\bar{B}_t,C_t\) 可固定或由输入选择。Selective SSM(如 Mamba)让部分参数依赖输入,以决定写入、保留和读取。训练可借助 scan/convolution 技巧并行,推理状态通常按序列长度线性更新。
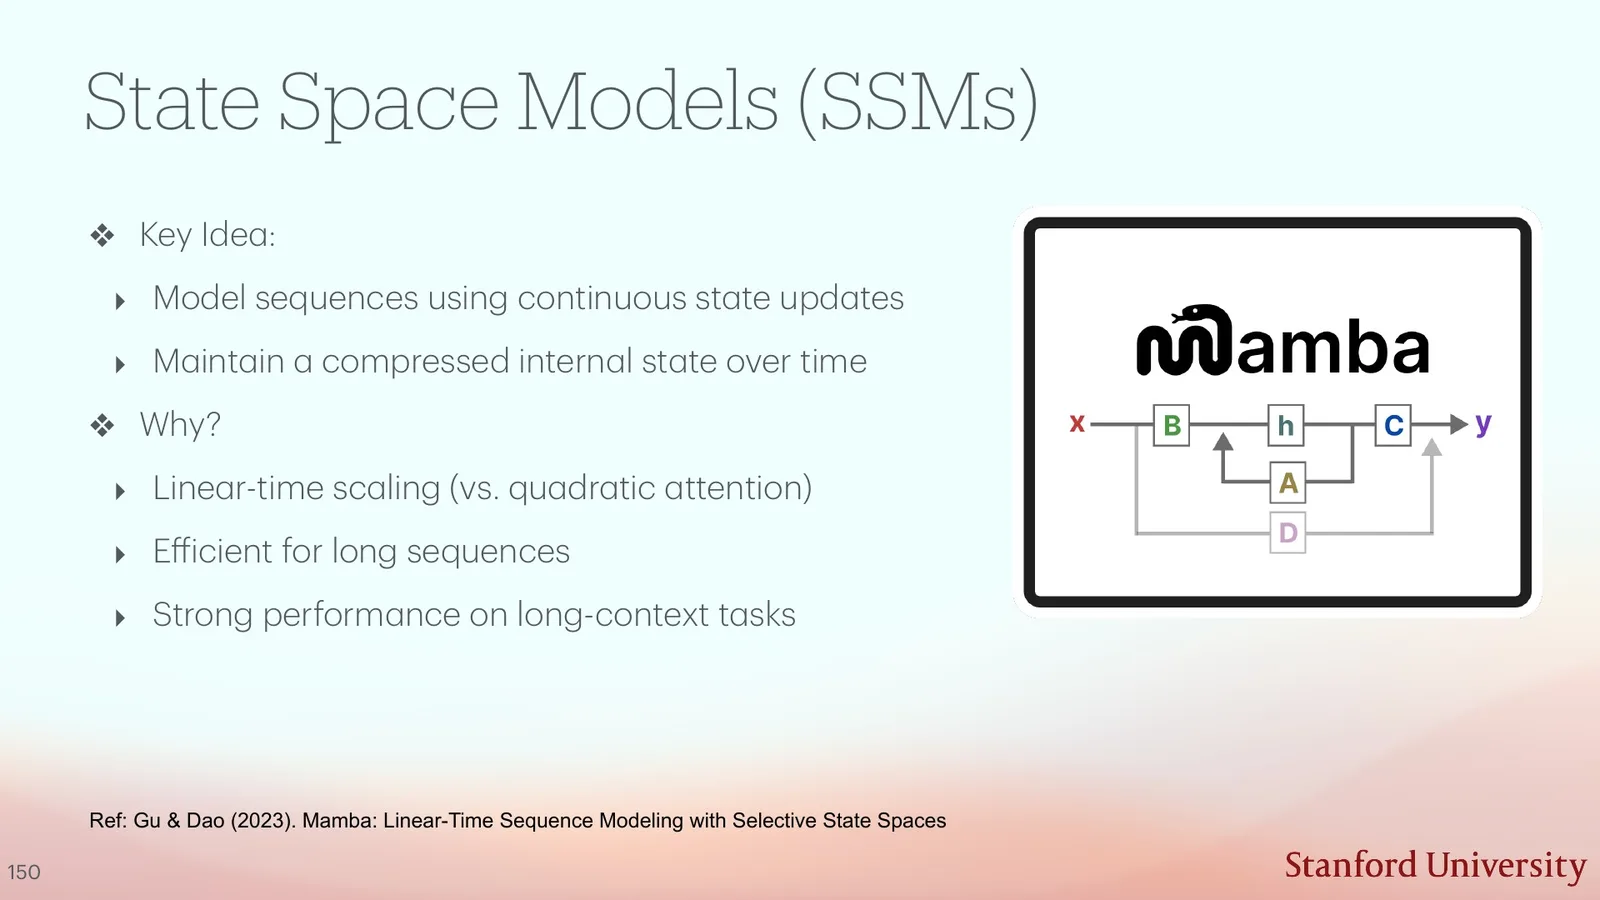
来源:CS25 V6 official deck, p. 154
来源:CS25 V6 official deck, p. 155
课堂提示
01:14:38–01:16:20,老师强调 SSM 在长序列和线性复杂度上有吸引力,但 attention 在某些需要灵活内容寻址的任务上更强,当前结论仍未封闭。
术语消化:attention 与 SSM 的核心差异
Attention 为每个 query 显式访问整段 context,内容寻址灵活但 score matrix 昂贵;SSM 把过去压进固定状态,推理高效但可能丢失可随机访问细节。Hybrid architecture 会在局部/关键层使用 attention,在大部分层使用 state-space 或 convolution,以寻找 workload-specific Pareto point。
比较 JEPA、SSM 与 Transformer 时还要固定 representation 和任务。若 JEPA 使用更强视觉 encoder,而 baseline 直接预测像素,性能差异不全来自 objective;若 SSM 使用更长 context 或不同 tokenizer,吞吐差异也不能直接归因于状态更新。公平实验至少匹配参数、训练 token、FLOPs、wall-clock、序列长度和数据增强,并分别报告 prefill、decode、memory 与质量。更重要的是测试失败形态:attention 是否在精确复制和任意位置检索上更强,SSM 是否在流式长序列更稳,JEPA latent 是否真正支持 action-conditioned planning。只有这些 workload-level 结果才能决定组合架构,而不是由复杂度符号替代实测。
本章小结
JEPA/world models 改变学习目标,SSM 改变计算路径。前者追求对环境状态更抽象、可预测的表示;后者追求长序列效率。两者都不是凭概念名自动优于 Transformer,必须在明确 tokenization、数据、任务、compute 与评估下比较。
总结与延伸
一条贯穿全课的系统主线
这堂 overview 可以压缩成一条依赖链:原始世界先被 tokenization/encoder 映射为表示;architecture 决定信息怎样交互;pretraining data 与 objective 决定参数中形成什么统计规律;post-training 与 inference-time compute 改变行为;retrieval、memory、tools 和 agent loop 增加外部状态;interpretability、alignment 与 evidence protocol 决定系统能否被理解和约束;JEPA 与 SSM 则分别探索新的预测对象和计算路径。
这条链也解释了为什么系统故障经常跨层传播。Tokenizer 破坏实体边界,会让 retrieval query 变差;检索返回错误证据,会让 reasoning trace 在错误前提上变得更长;preference model 若偏爱自信语气,agent 可能减少必要的 abstention;memory 若保存未经验证的总结,后续每次任务都会把一次错误变成持久状态。相反,局部修复也可能失效:只扩大 context 不能修复错误权限,只做 DPO 不能更新过期知识,只加 verifier 不能补回不可观察变量。工程审计应沿 representation、data、objective、state、action 与 evaluation 逐层定位,而不是把所有问题归为“模型不够聪明”。
因此,一份可信系统报告至少要同时给出训练数据时间边界、模型与 tokenizer 版本、post-training 方法、可用工具与权限、memory 生命周期、评估集和成本指标。缺少这些信息时,即使复现了单个 benchmark 分数,也无法复现真实系统行为;模型名称不是完整实验条件。
同样,任何“替代 Transformer”的主张都应说明比较发生在何种序列长度、batch、硬件、训练预算与质量阈值下。离开 workload 的架构排名没有稳定含义,真正可迁移的是测量方法与边界条件。
全课最可迁移的十问
- 输入被切成什么 token,哪些信息在入口就丢失?
- 目标函数奖励什么统计规律,遗漏什么?
- 数据来源、混合、顺序与更新频率是什么?
- 计算瓶颈在参数、attention、memory、retrieval 还是工具?
- Post-training 改权重、改候选搜索,还是加外部状态?
- Agent 的 observation、action、权限、budget 与停止条件是什么?
- 指标测的是 loss、任务成功、偏好还是现实影响?
- 错误来自 belief、observation、planning 还是 reward proxy?
- 系统如何保存、更新、冲突解决和遗忘?
- 新架构在同等数据、compute 与 serving 条件下改善了哪个 Pareto 维度?
三条证据边界
第一,课堂中的 BabyLM、RAG、CGLS、fMRI 与 hallucination 研究都对应具体实验设计,不能从单一规模或数据集外推为普遍规律。第二,应用 demo 与 benchmark 不能替代真实工作流中的成本、权限、分布偏移和外部验证。第三,world model、continual learning、alignment 等概念必须先定义更新对象和评价协议,否则同一词会覆盖互不相同的问题。
开放问题
下一步值得继续追问:能否在不牺牲可随机访问能力的前提下获得线性长序列计算?能否把 retrieval、parameter update 与 memory conflict 统一成可验证的持续学习系统?能否构造对 world-model belief、planner 与 action 分层诊断的 agent benchmark?能否让 process supervision 与 mechanistic evidence 相互校验,而不是共同奖励表面 reasoning style?
拓展阅读
- 官方课程:https://web.stanford.edu/class/cs25/
- 官方录像:https://www.youtube.com/watch?v=bHSDPgZYie0
- Baby Scale:https://arxiv.org/abs/2603.29522
- Bilingual BabyLM:https://arxiv.org/abs/2603.29552
- Pretraining–RAG scaling:https://arxiv.org/abs/2604.00715
- Curriculum-Guided Layer Scaling:https://arxiv.org/abs/2506.11389
- Cross-network fMRI representation:https://arxiv.org/abs/2603.00786
- Unified hallucination definition:https://arxiv.org/abs/2512.21577