Lecture 37:大语言模型推理——解码、训练、聚合与检索
先定义问题:这里的“推理”到底指什么
关于“大语言模型是否真正会推理”的争论,经常把哲学、认知科学、形式逻辑和产品能力混在一起。Denny Zhou 在开场主动缩小问题:本讲只研究一种可操作、可测量的对象——模型在输入与最终答案之间生成的中间 token 序列。这个定义不要求轨迹像人脑,也不保证轨迹忠实解释模型内部计算;它只问:增加可见的中间生成步骤,是否能扩大模型可完成的计算、改变训练信号,并改善最终答案的选择。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 1
课堂提示
00:00:52–00:02:30,老师明确说自己不参加“LLM 到底算不算推理”的无定义争论。本讲把 reasoning 固定为 input 与 output 之间的 intermediate tokens;后续所有理论、解码和训练方法都围绕这个操作性定义展开。
中间 token 是计算接口,不是人格证明
令输入为 \(x\),中间推理序列为 \(r=(r_1,\ldots,r_T)\),最终答案为 \(a=(a_1,\ldots,a_M)\)。自回归模型给整个响应分配概率:
其中 \(\theta\) 是模型参数,\(T\) 是中间 token 数,\(M\) 是答案 token 数,\(r_{< t}\) 与 \(a_{< j}\) 分别表示已经生成的前缀。关键变化不是“模型突然拥有内心独白”,而是原本一次前向式的答案生成,被展开成 \(T+M\) 个条件计算步骤;每个新 token 都能读取此前结果,并把临时状态写回上下文。
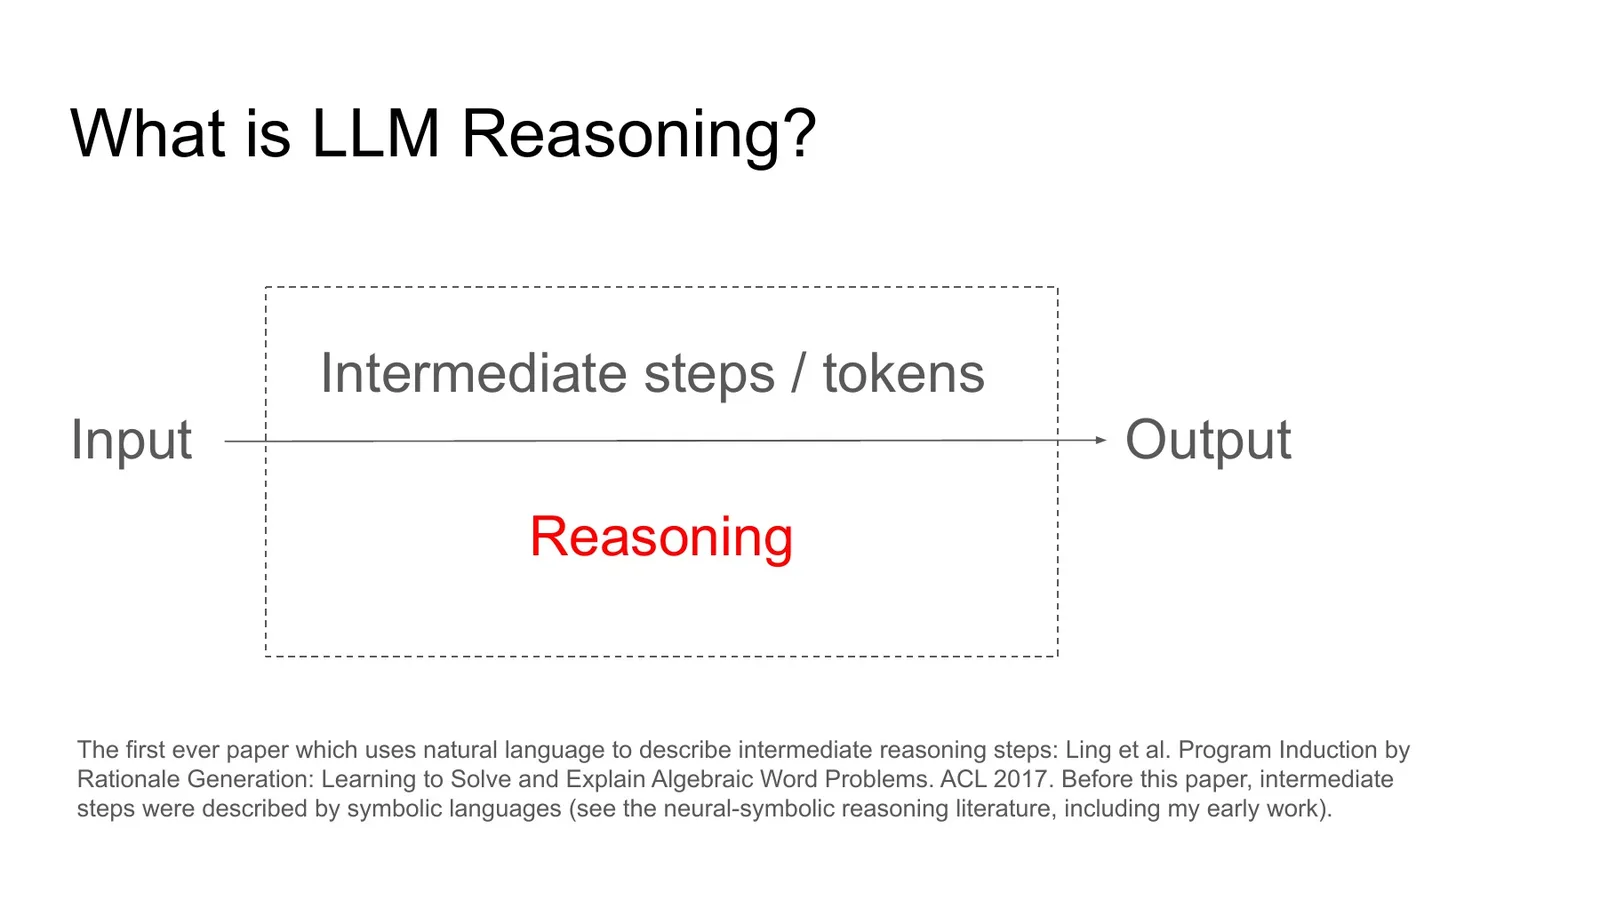
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 2
操作性定义
本讲中的 LLM reasoning 指模型在最终答案之前生成的中间 token。它是一种可观测计算轨迹:可用于继续计算、训练、筛选和聚合;但“可读”不等于“忠实”,“像人”不等于“机制相同”。
最常见的概念偷换
看到自然语言步骤后,容易把“轨迹能帮助得到正确答案”偷换成“轨迹完整揭示了模型内部因果过程”。本讲支持前者,不自动推出后者。评价轨迹至少要分开看最终正确性、步骤有效性、可验证性与解释忠实性。
最后一个字母:为什么要设计不会被捷径破解的任务
“artificial intelligence”的最后字母拼接为 “le”。直接答案只有两个字符,看不出模型如何获得它;分步版本则先抽取 artificial 的末字母 \(l\),再抽取 intelligence 的末字母 \(e\),最后拼接。这个小任务的教学价值不是难度,而是把一个串行过程拆成明确的临时状态,让研究者能区分“记住了常见模式”与“按步骤执行了转换”。
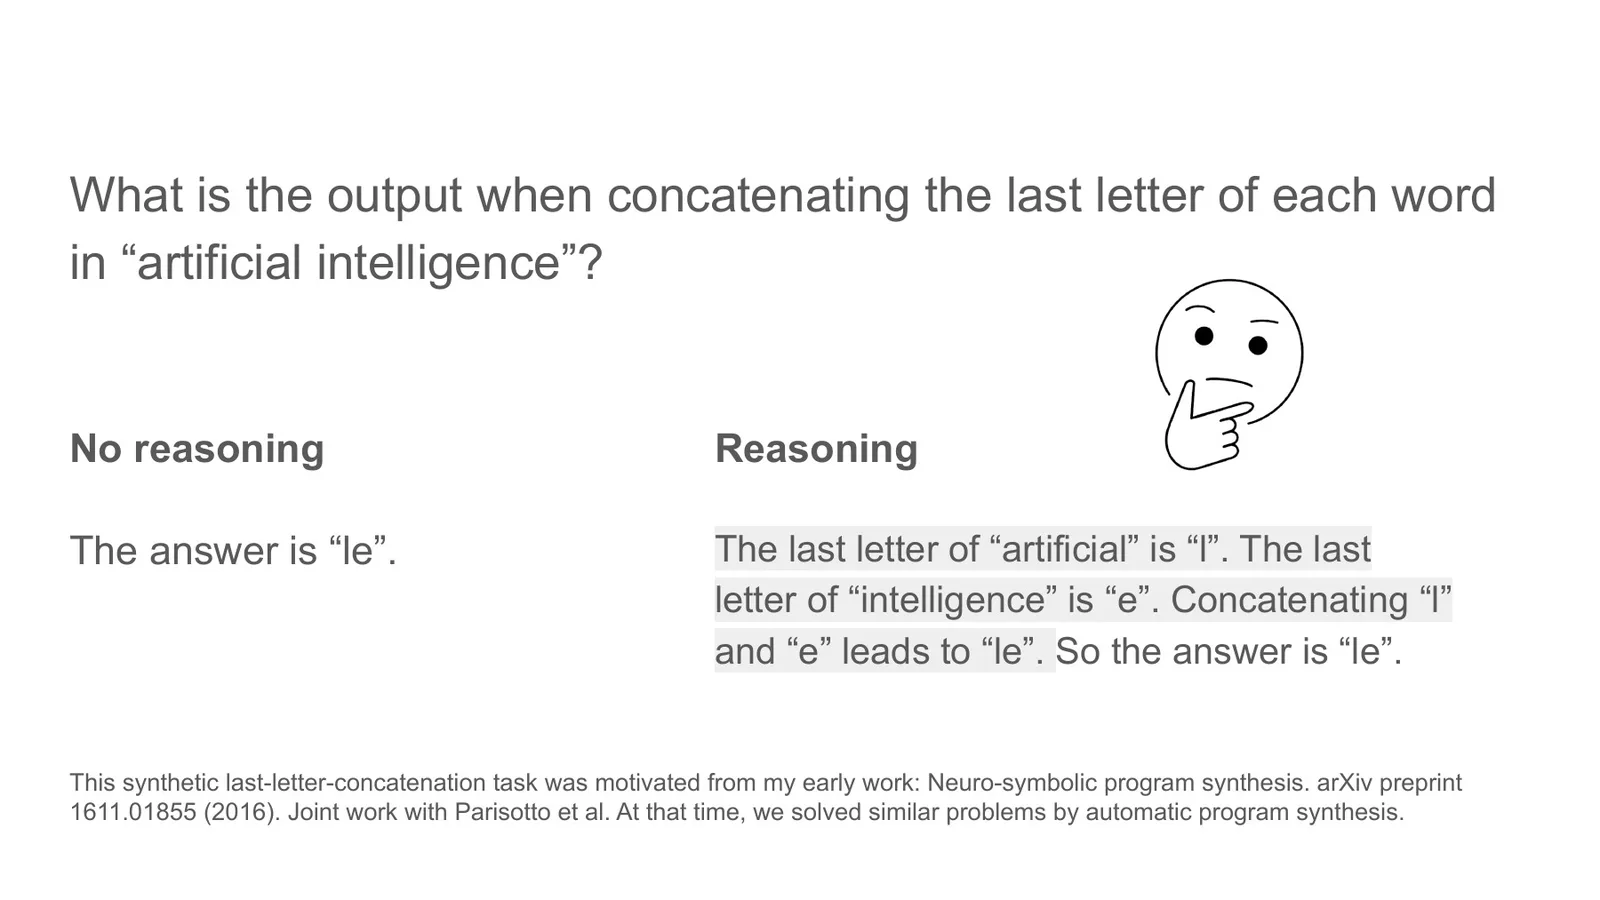
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 3
课堂提示
00:03:18–00:05:10,老师解释最初试过“首字母拼接”,但网页中大量缩写让旧模型也能轻松答对,因此改用末字母。实践经验:合成任务必须检查训练语料中的捷径,否则 benchmark 测到的可能是共现记忆而不是目标算法。
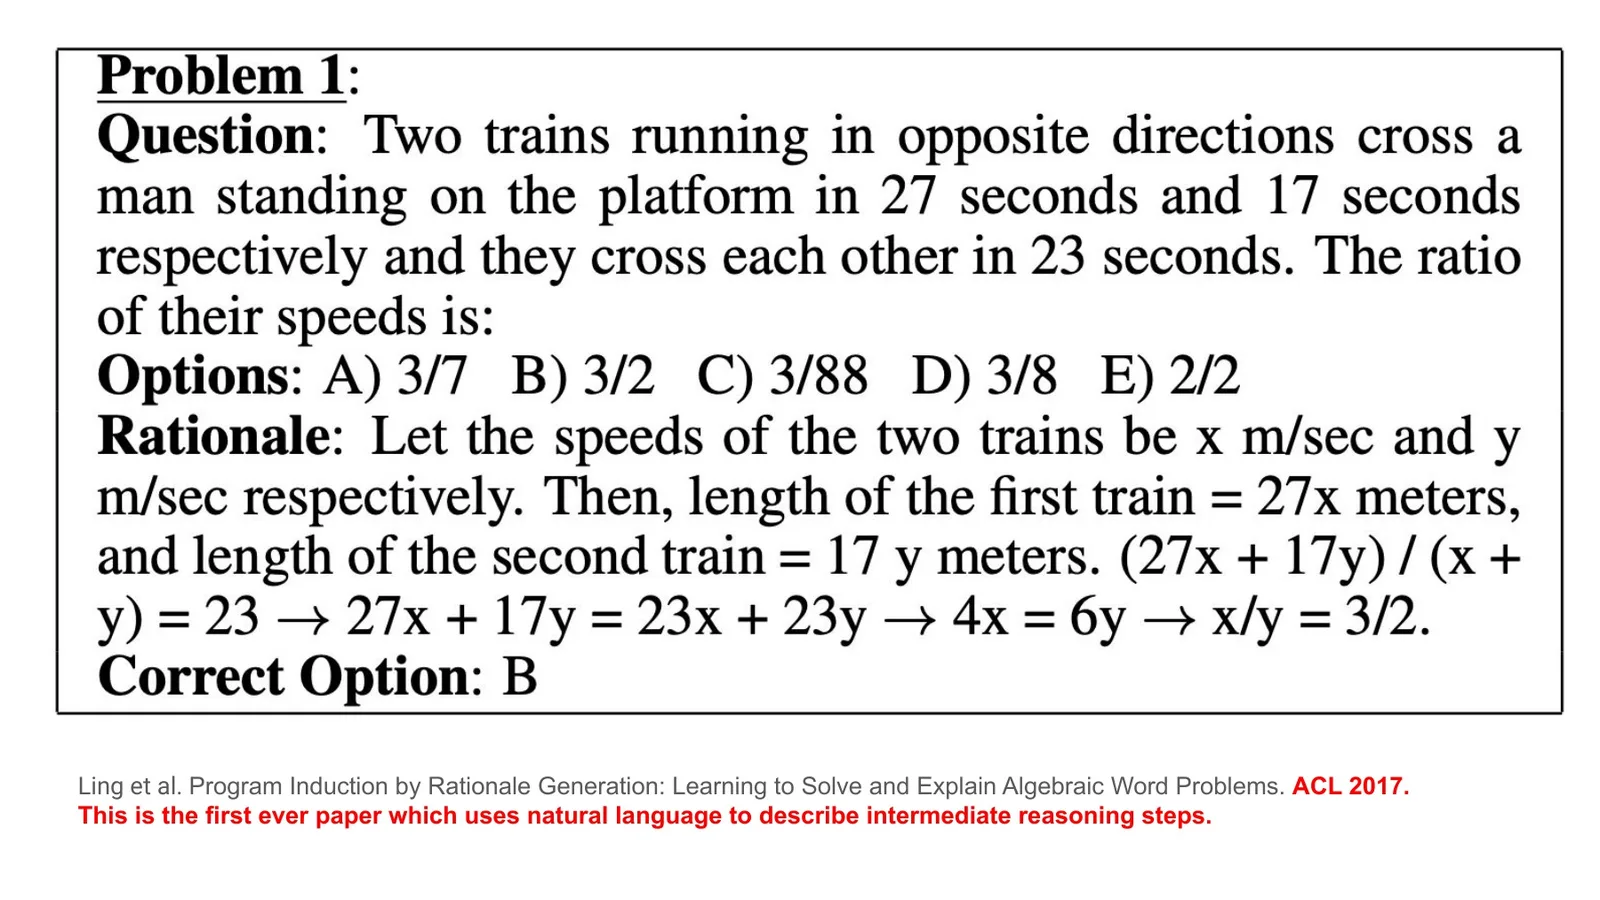
2017 年的 rationale generation 工作把自然语言中间步骤用于代数应用题;更早的神经符号研究常用程序、逻辑式或搜索状态表达中间过程。这里的历史转折不在于“第一次有中间状态”,而在于把状态放进与输入输出相同的语言序列中,从而可以直接用序列模型生成和学习。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 4
术语消化:rationale、scratchpad 与 Chain-of-Thought
rationale 强调解释或解题依据;scratchpad 强调用可写的中间空间完成计算;Chain-of-Thought(CoT) 通常指连续的语言化步骤。三者在工程上可能使用相似 token 序列,但研究目标不同:解释、计算工作区与推理能力不应只靠名称混为一谈。
为什么中间 token 能增加可计算性
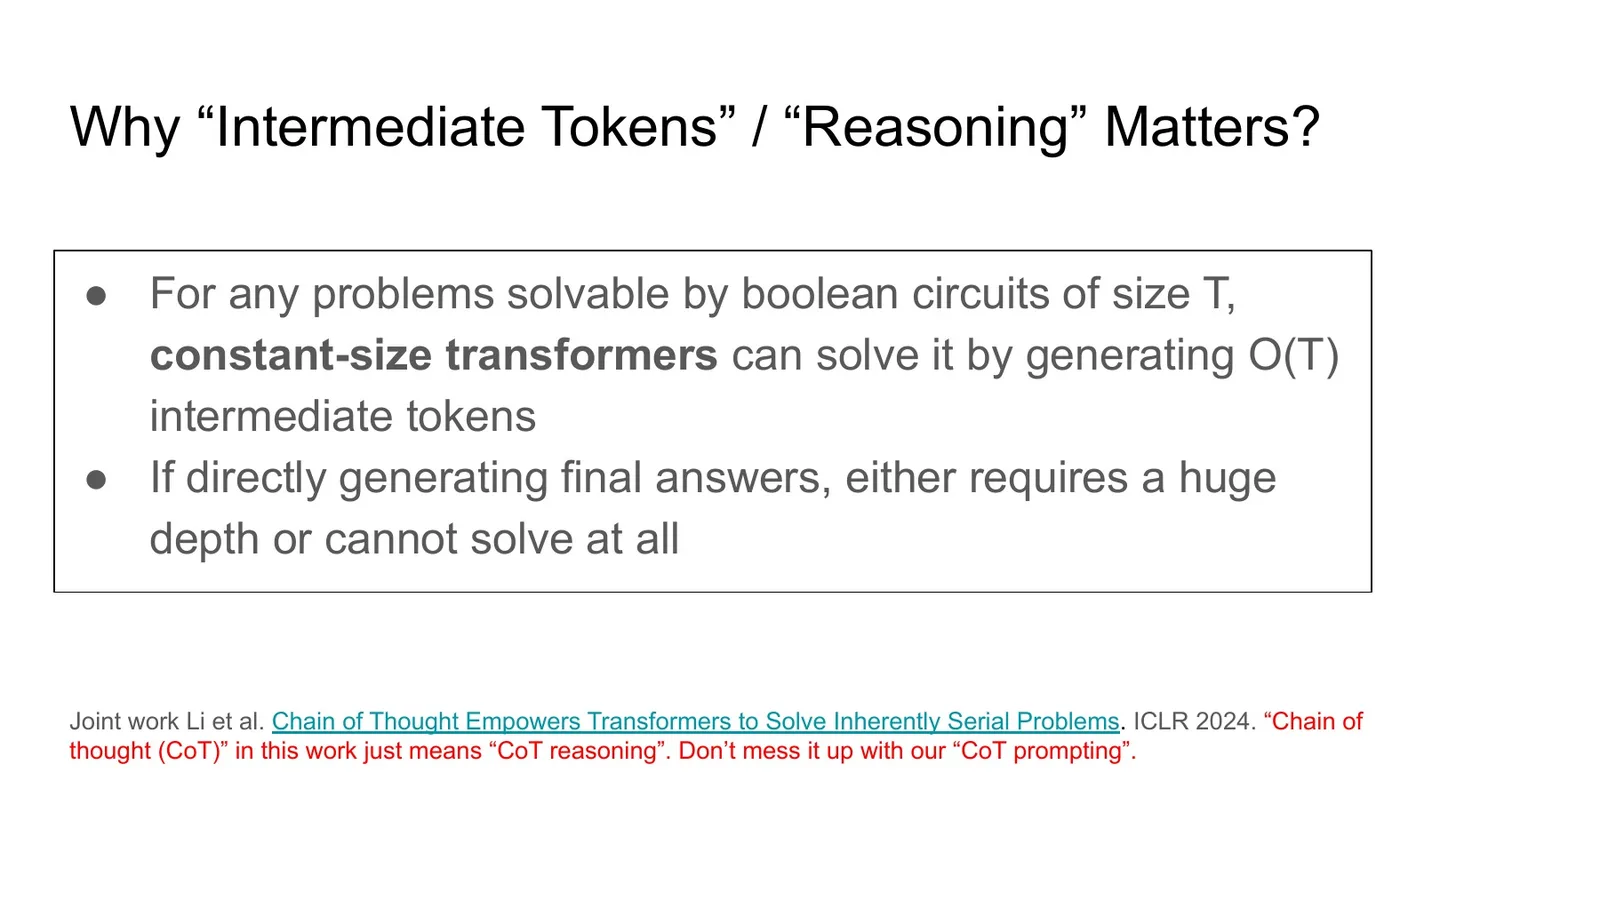
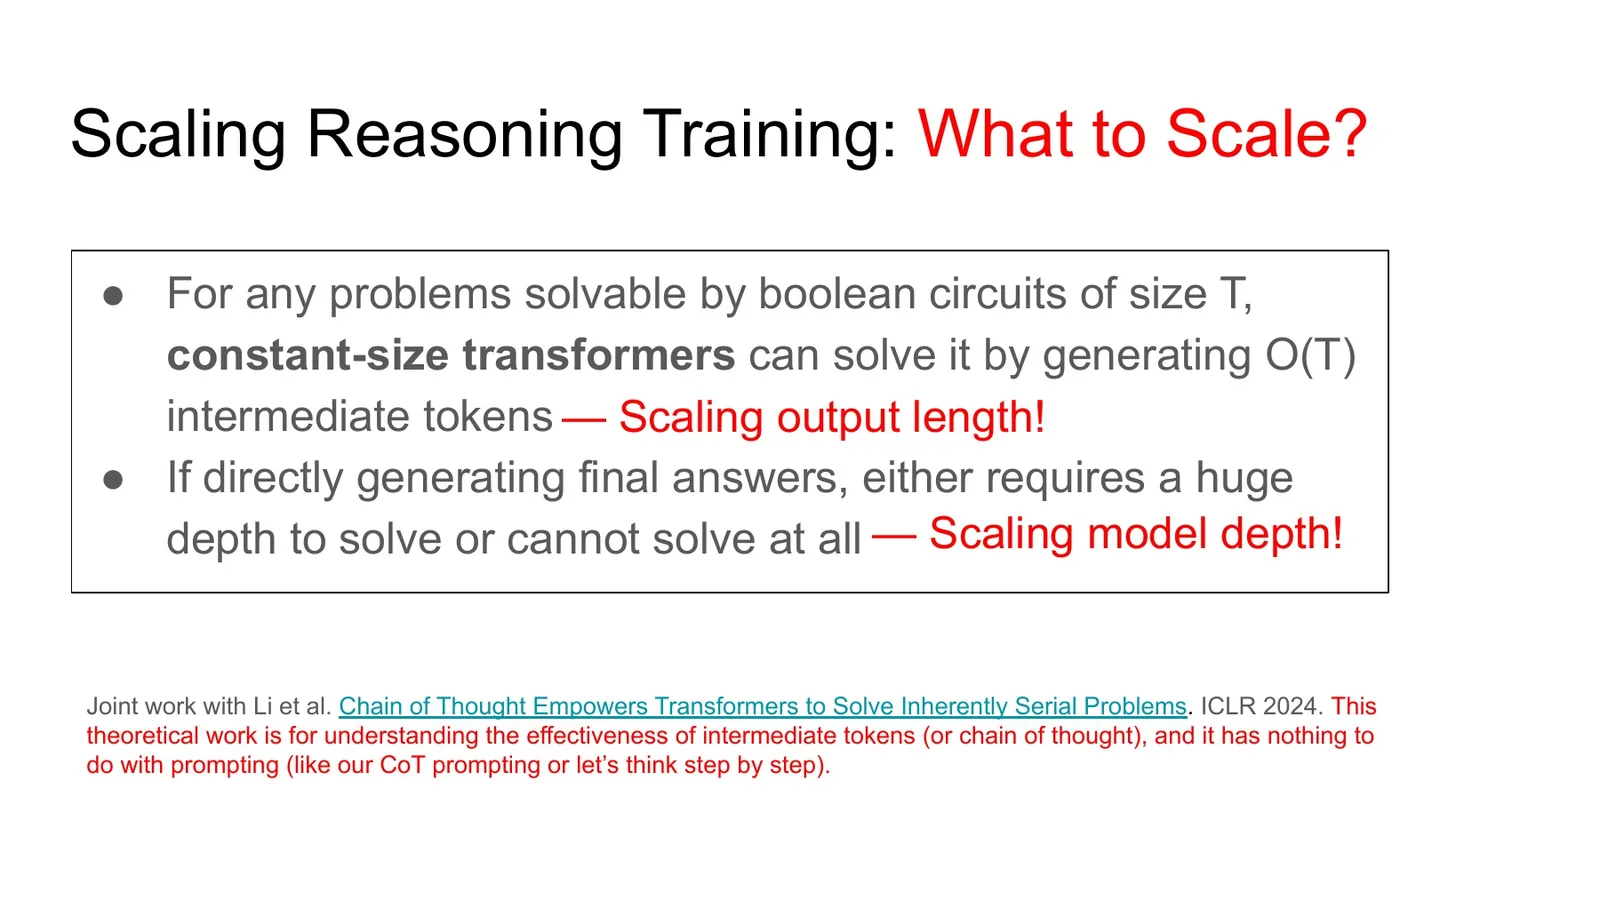
官方讲义给出一个理论方向:若某问题可由规模为 \(T\) 的 Boolean circuit 求解,那么固定规模的 Transformer 可以通过生成 \(O(T)\) 个中间 token 来逐步模拟该计算;若强迫模型直接输出最终答案,则可能需要很深的网络,甚至无法在给定深度下表达。直觉上,网络深度提供“参数内的串行层数”,生成长度提供“推理时的串行步数”。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 5
可把总计算预算粗略写成
其中 \(C_{\text{prefill}}\) 是处理输入的成本,\(C_{\text{decode-step}}\) 是生成一个新 token 的边际成本,\(T\) 是中间步骤长度。更长轨迹提供更多串行计算,但同时增加延迟、KV cache 占用和错误累积,因此“允许更多 token”不是免费提升,而是把能力问题转成预算与选择问题。
计算视角的核心结论
中间 token 的价值首先是增加推理时可用的串行计算深度。它解释了为什么同一参数模型在允许展开步骤后可能解决直接回答时失败的问题,也解释了为什么 test-time compute 必须明确“到底扩展了长度、样本数、搜索宽度还是工具调用”。
本章小结
本章把 reasoning 固定为中间 token,并用概率分解、合成任务与计算深度解释其作用。这个定义刻意避免人类心智类比:后续真正要解决的是如何找到好轨迹、如何训练其分布、如何聚合多个轨迹,以及如何证明最终答案可靠。
预训练模型已经会推理吗:从 greedy decoding 到 CoT decoding
如果中间轨迹有用,下一个问题不是立即微调,而是先检查预训练分布中是否已经存在这样的轨迹。课堂提出一个反直觉假设:模型并非“完全不会”,而可能只是 greedy decoding 过早选中了一个短、局部高概率但错误的分支。于是研究对象从参数能力转向解码策略。
“不会”可能只是第一个候选不对
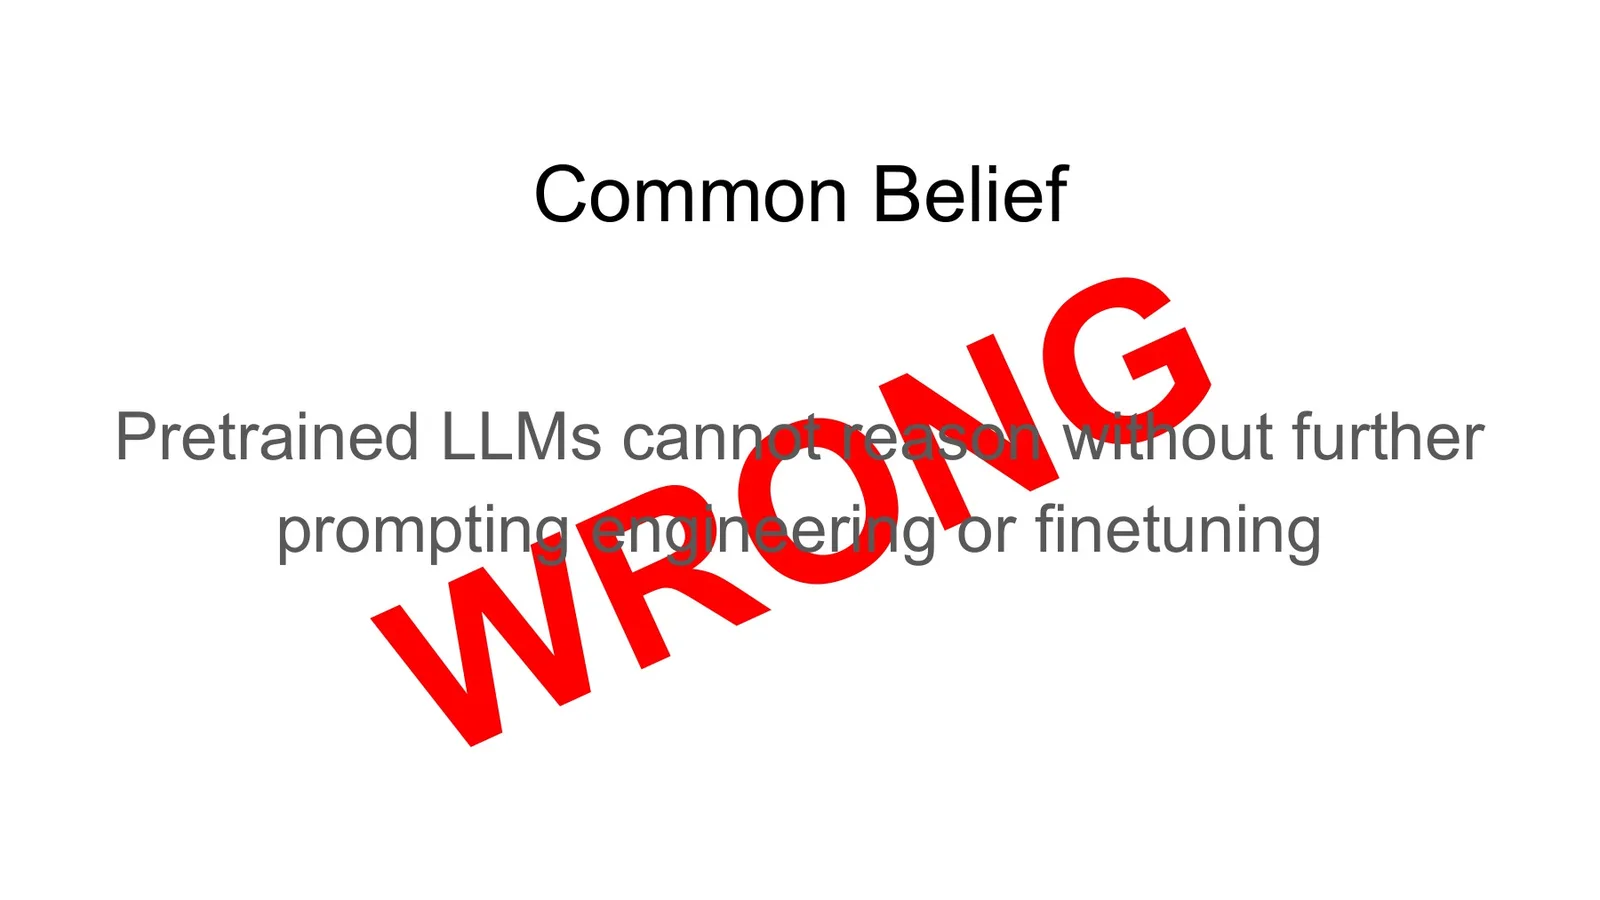
讲义先展示当时的常见信念:预训练 LLM 必须经过提示工程或微调才能产生推理。下一页直接否定它,强调“all we need is decoding”。读这两页时要保留限定词:这不是说任何预训练模型都能解决任何任务,而是说不能仅凭 top-1 贪心输出失败,就断言其分布中不存在正确轨迹。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 6
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 7
课堂提示
00:06:20–00:08:30,老师把重点从“再训练一次模型”移到“先检查生成分布”。讲义提醒:latent capability 与 top-1 behavior 不是同一概念;失败输出可能来自搜索和排序,也可能来自分布中根本没有正确解,两者必须用候选分析区分。
苹果题:候选生成、错误排序与答案置信度
下面三页把一次失败拆成“候选是否存在”和“排序是否正确”两个阶段。苹果题的 greedy 输出是 5,但候选集合中已经出现“父亲有 5 个,总数 \(3+5=8\)”的正确轨迹。页 8 先证明多看候选可以找到正确解;页 9 再否定一个诱人的捷径——按响应长度选答案,因为长文本也可能自信地犯错;页 10 最后提出按最终答案部分的模型置信度排序。读图时应追踪同一组候选在三页中如何被不同选择规则重新排序,而不是把三页当作重复截图。
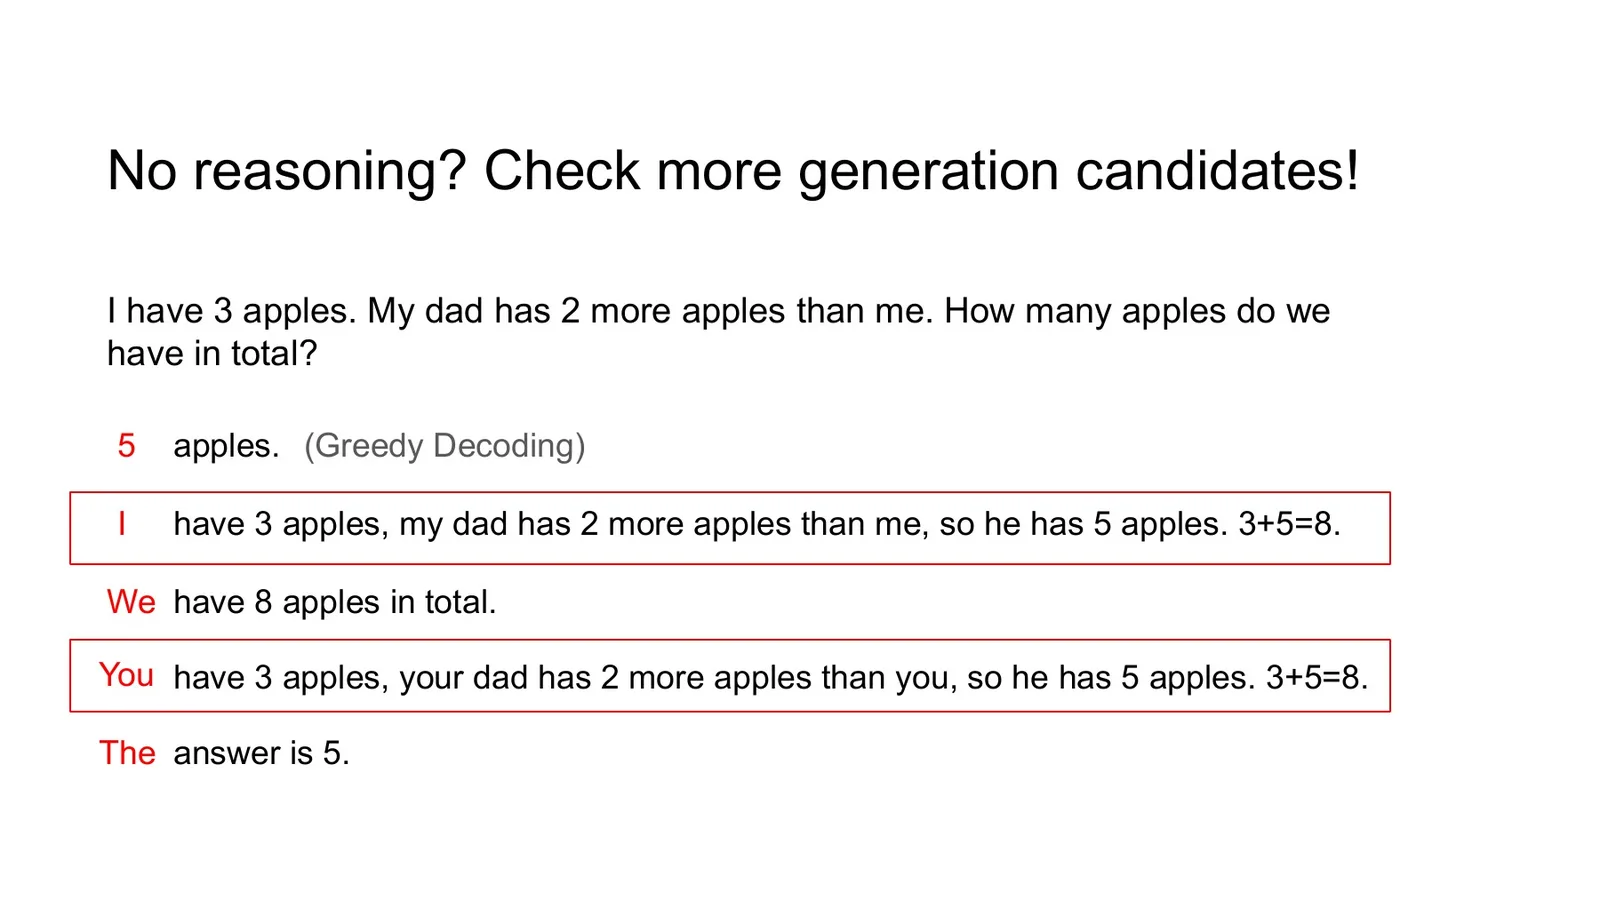
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 8
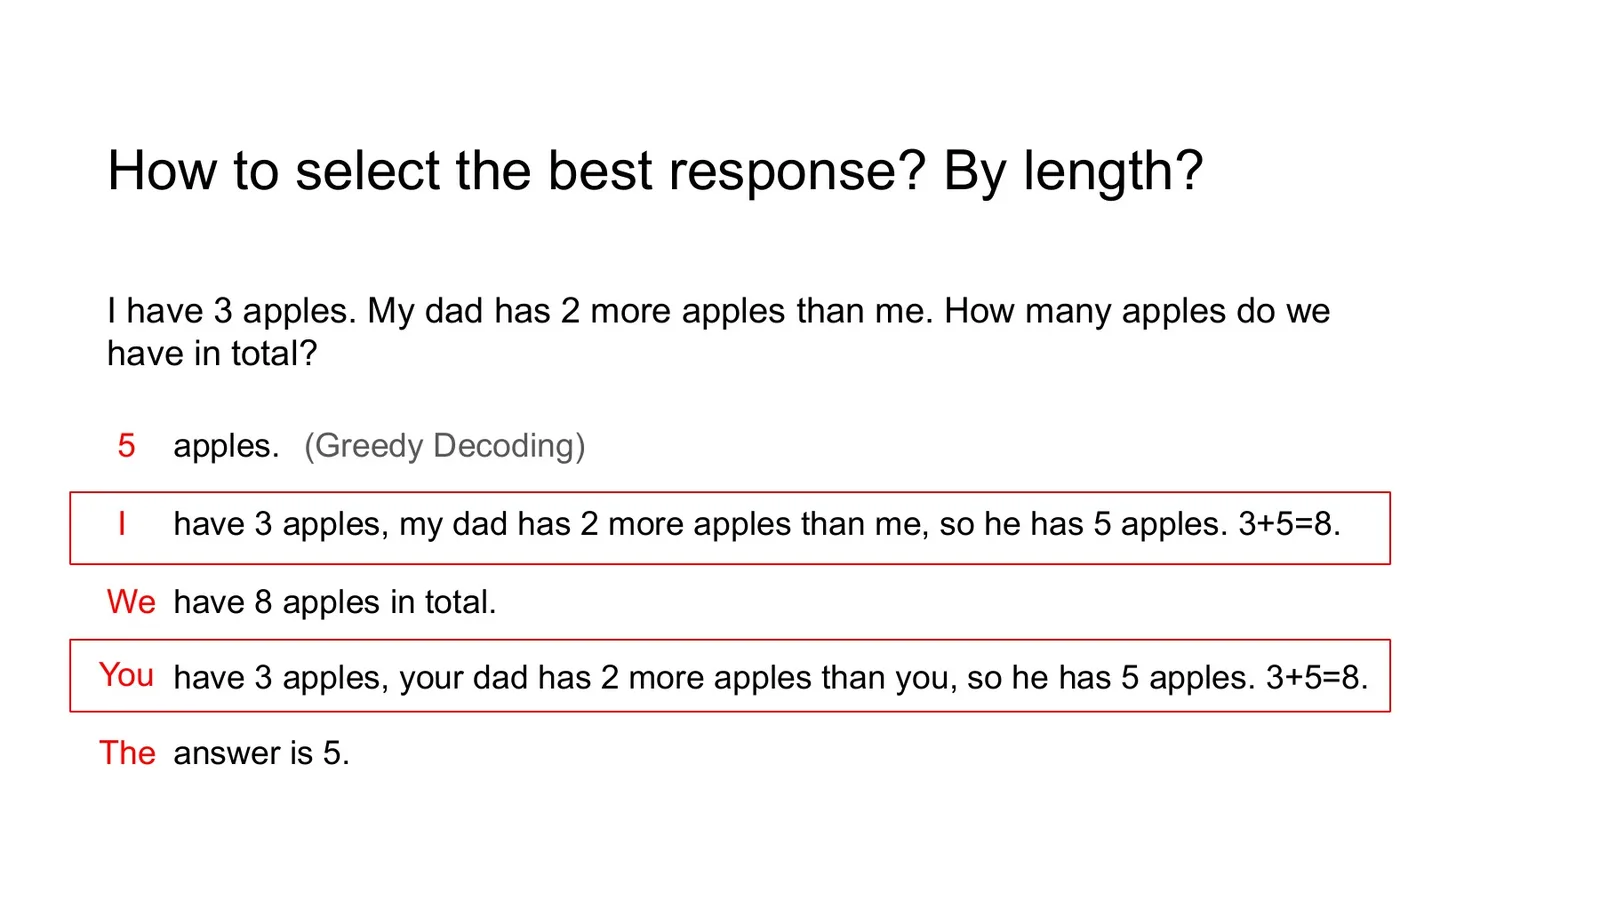
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 9
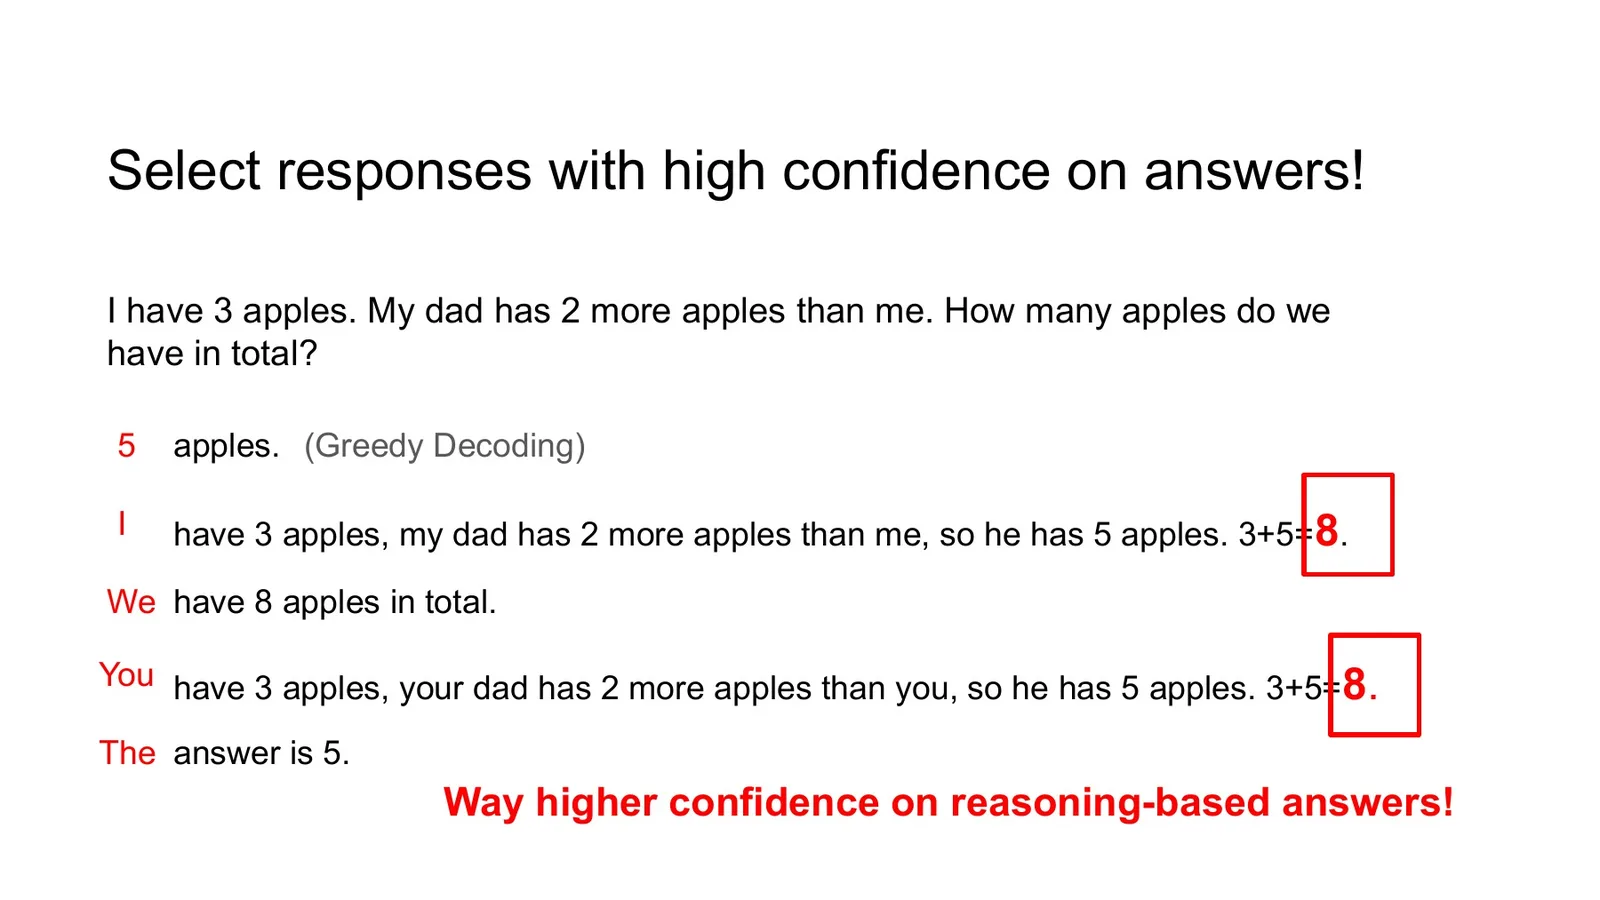
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 10
对候选 \(y^{(k)}=(r^{(k)},a^{(k)})\),可定义答案区间的平均对数概率:
其中 \(s_k\) 是第 \(k\) 个候选答案的归一化置信度,\(|a^{(k)}|\) 是答案 token 数,\(k^*\) 是最终选择。只看最后一个 token 适合标签式答案;多 token 数字、程序或自由文本应使用明确的答案边界和长度归一化,否则短答案会得到不公平优势。
置信度不是正确性证明
模型概率来自自身分布,可能系统性过度自信;答案抽取也可能把单位、符号或程序主体切错。置信度适合做候选排序信号,不应单独承担 hallucination 检测、上线门槛或安全证明。
Chain-of-Thought Decoding 的两步算法
CoT decoding 的结构很简单:先超越 greedy,探索多个生成候选;再根据最终答案置信度选择。它与 CoT prompting 不同:前者修改解码和排序,后者修改输入提示。同一个模型可以不加示例地做 CoT decoding,也可以在 CoT prompt 下继续使用 greedy;两条轴必须分开。
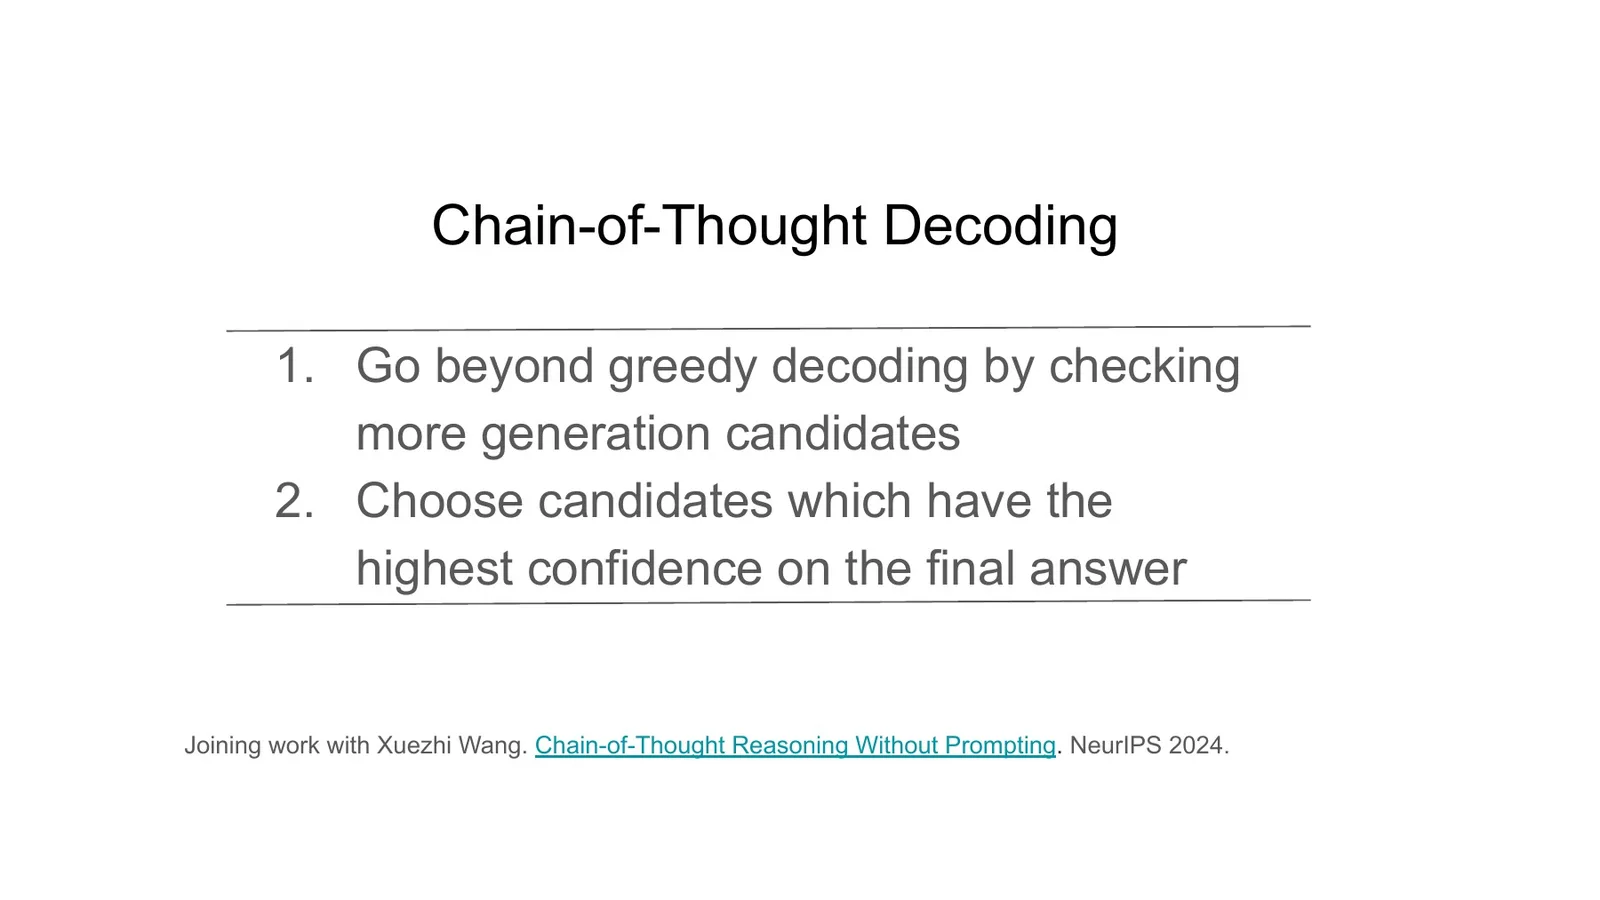
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 11
def cot_decode(model, prompt, samples, answer_parser):
    candidates = model.sample(prompt, n=samples)
    ranked = []
    for response in candidates:
        answer_span = answer_parser(response.text)
        if answer_span is None:
            continue
        score = mean(response.logprobs[answer_span])
        ranked.append((score, response.text))
    if not ranked:
        raise ValueError("no parseable answer")
    return max(ranked)[1]
工程检查表:候选排序需要什么
必须记录采样温度与 top-\(p\)、候选数、答案解析器版本、答案区间 log-prob、重复候选比例和无效解析率。否则“解码提升”可能只是多花 token、改变格式或意外泄漏答案边界,无法复现实验。
课堂提示
00:10:24–00:12:10,老师强调分数看 final answer 的条件概率,而不是把整条长轨迹的概率相乘后直接比较。课堂提示:轨迹越长,联合概率天然越小;不做答案边界和归一化会把长度偏差误当质量。
本章小结
这一章把“预训练模型不会推理”拆成两个可检验命题:正确轨迹是否存在于候选分布,以及解码器是否能把它排到第一。CoT decoding 解决第二个问题,但它依赖答案解析和概率校准;若分布中根本缺少正确轨迹,就必须转向提示或训练。
从 Prompting 到 SFT:怎样让好轨迹自然排到前面
CoT decoding 承认正确轨迹可能藏在分布深处,再用额外候选把它找出来。更直接的目标是改变分布本身:让有步骤、能导向正确答案的响应在第一次生成时就拥有更高概率。Prompting 和 supervised finetuning(SFT)都在做分布重排,但前者通过上下文临时改变条件分布,后者通过参数更新形成长期偏好。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 12
Few-shot CoT 与 zero-shot trigger 改变了什么
Few-shot CoT 在 prompt 中放入相似问题及分步解法,模型据此模仿输出格式与求解策略;“Let's think step by step” 则用通用触发语诱导更长的中间过程。两者都不修改参数,优点是部署快、可针对任务调试,缺点是上下文占用、示例选择敏感,以及性能常被措辞和顺序影响。
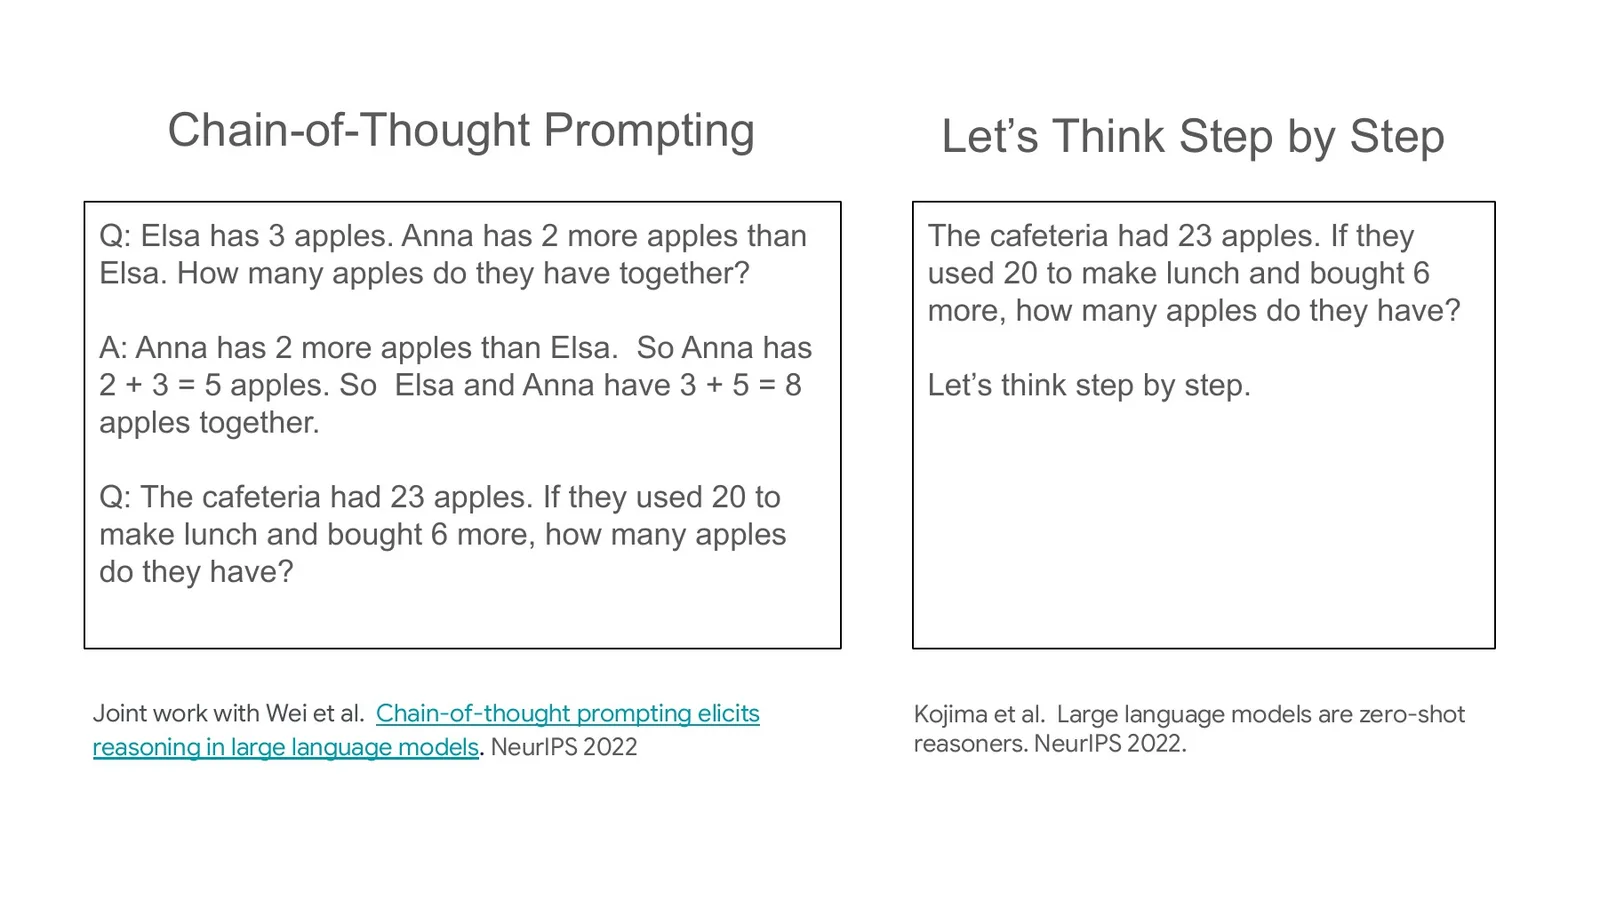
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 13
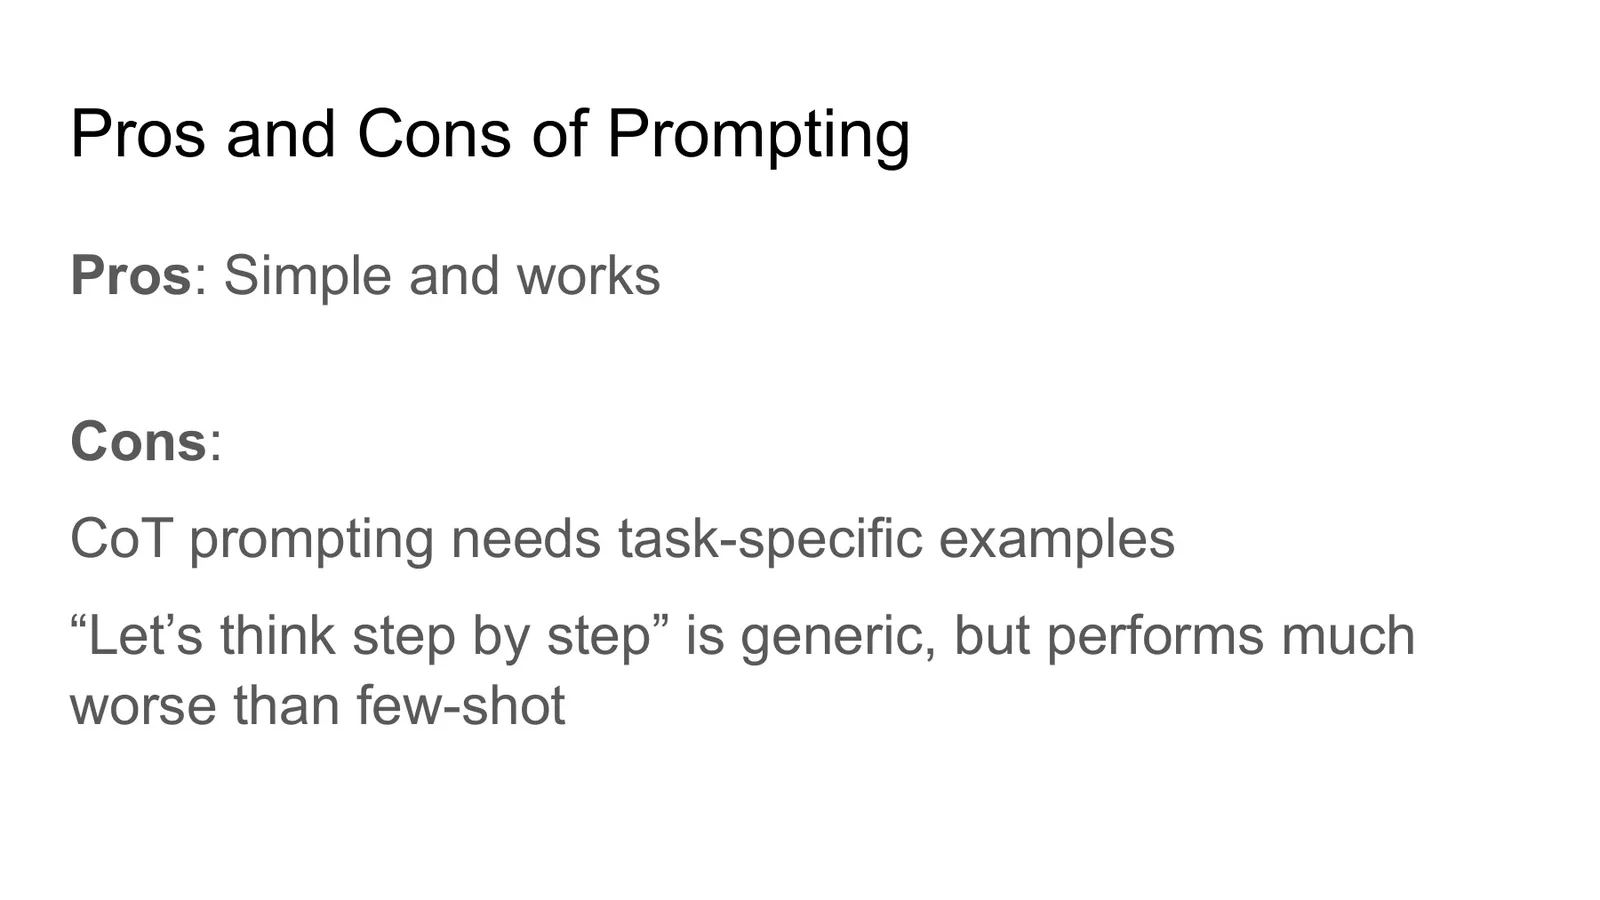
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 14
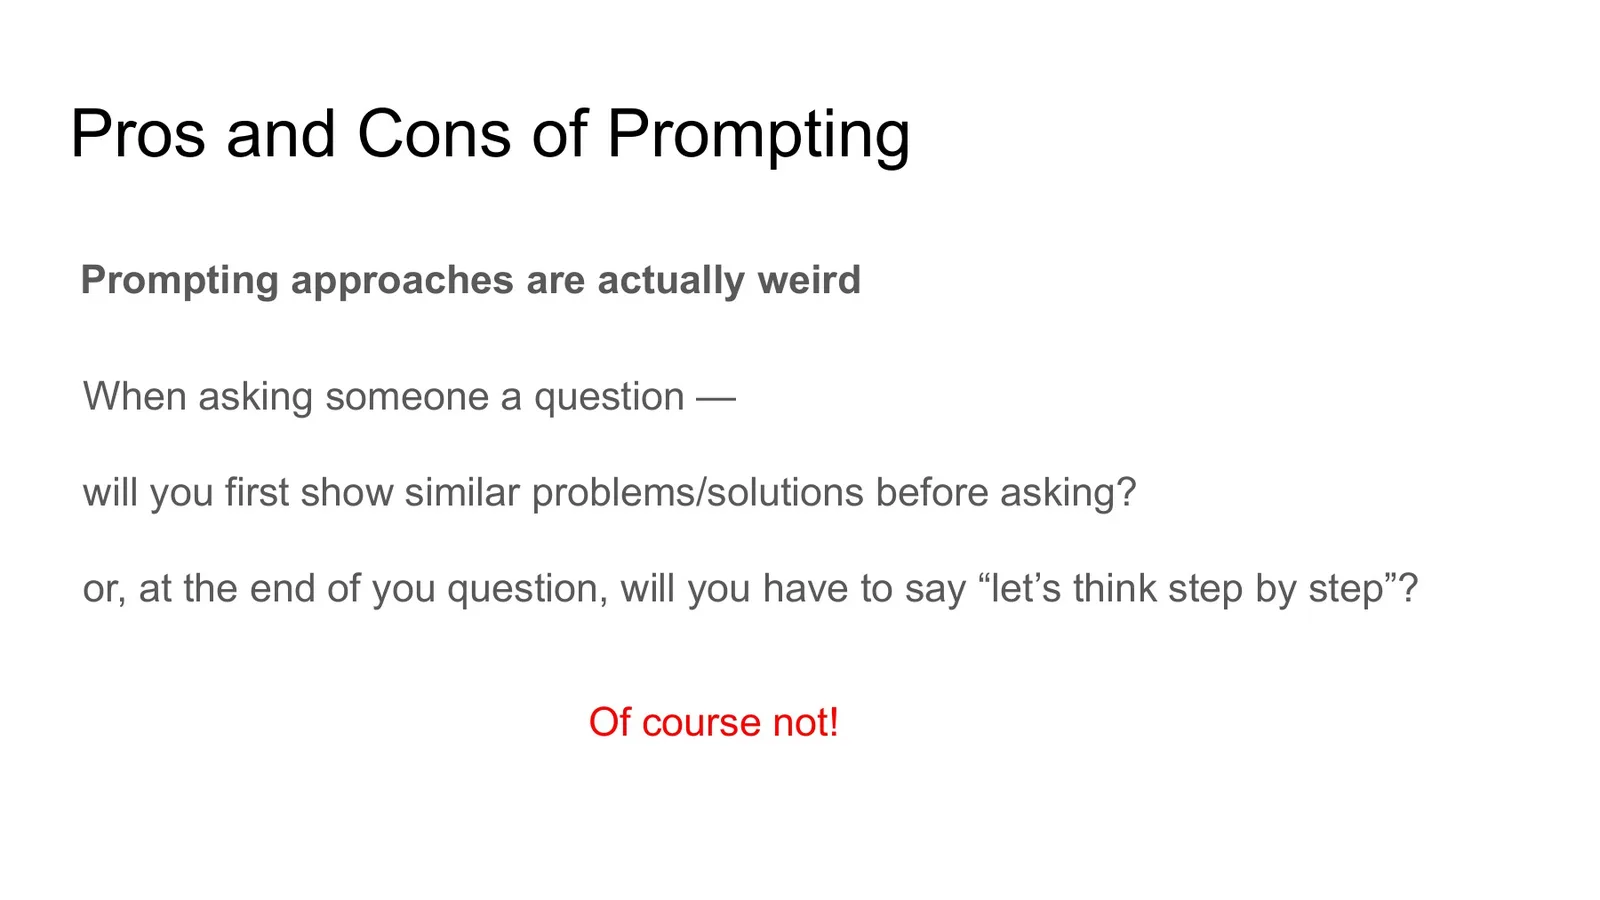
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 15
读这三页时应区分任务信息与推理控制信号。示例既告诉模型输出格式,也可能泄漏领域词汇、难度与答案分布;通用触发语减少任务工程,却通常弱于高质量 few-shot。若只报告“prompt A 比 prompt B 好”,而不报告示例、顺序、token 预算和解码设置,就无法判断改进来自真正的策略迁移,还是更有利的上下文条件。
课堂提示
00:12:40–00:16:20,老师说 few-shot CoT 很有效,但如果提问者已经拥有相似问题和完整解法,为什么还要问模型;而每次都补一句“逐步思考”也不像自然能力。老师强调:成功的 prompt 是有用接口,不等于训练问题已经解决。
术语消化:Prompting、In-Context Learning 与 Finetuning
Prompting 是在输入中加入指令、示例或结构;in-context learning 是模型在不更新参数时从上下文适配任务;finetuning 则用梯度更新参数。前两者的状态通常随请求结束而消失,后者改变模型在未来请求中的基础分布。
SFT:把人类轨迹变成最大似然目标
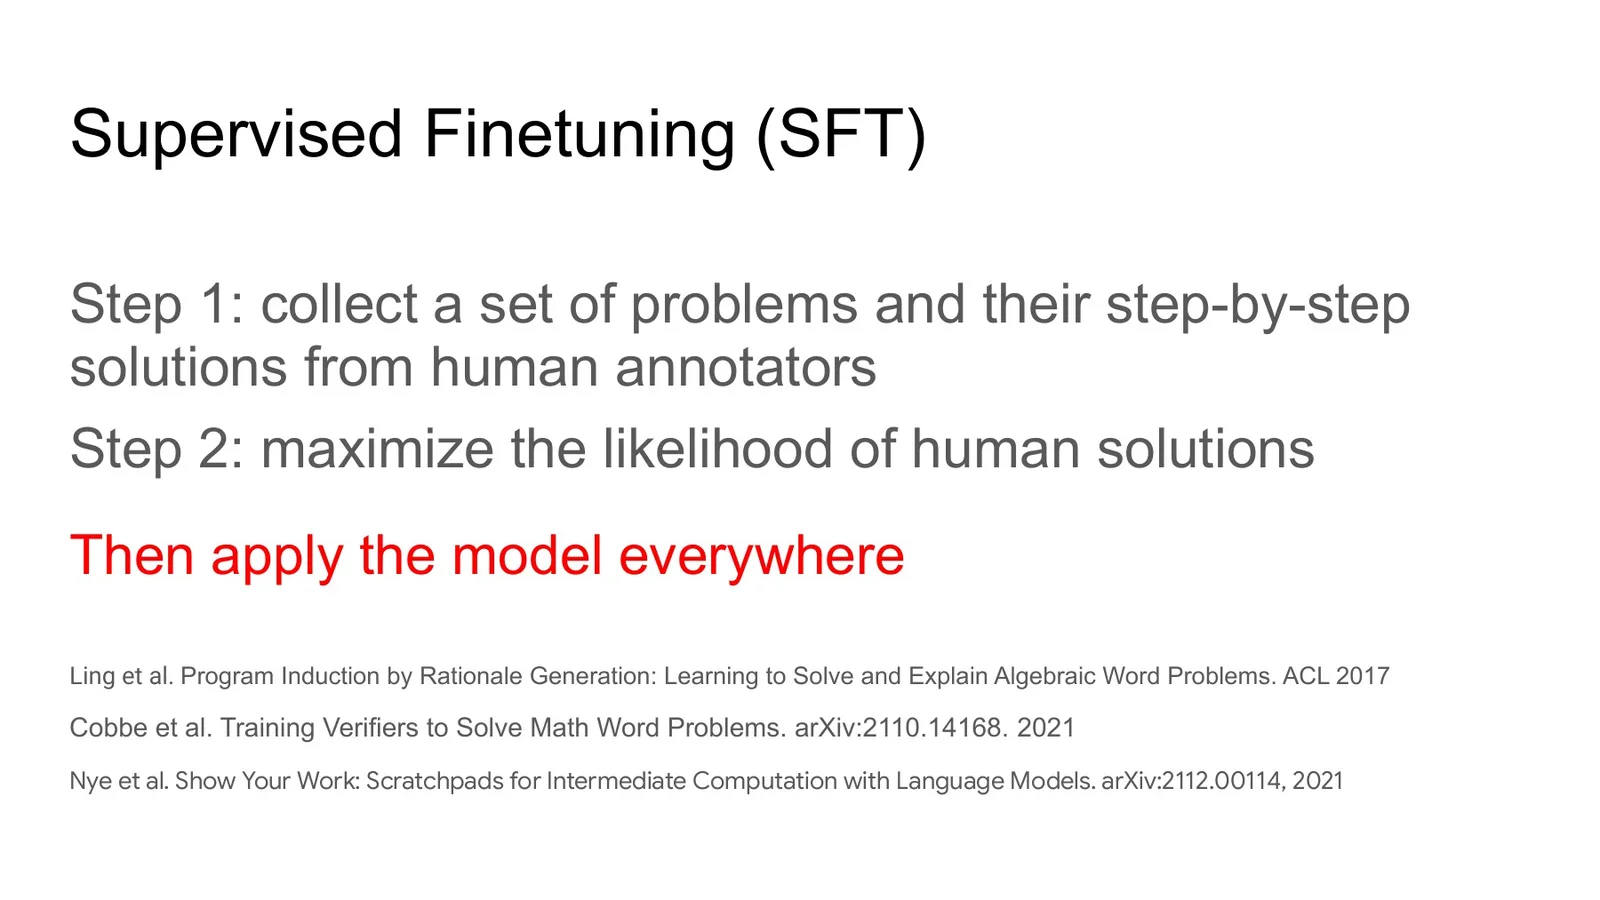
SFT 收集问题 \(x\) 与人工分步解答 \(y^*=(r^*,a^*)\),再最大化参考序列的似然。对数据集 \(\mathcal D\),损失为
其中 \(\theta\) 是待更新参数,\(|y^*|\) 是参考响应长度。Teacher forcing 训练时总把正确前缀 \(y_{< t}^*\) 喂给模型;部署时模型必须消费自己生成的前缀,因此一步偏差可能把后续状态带到训练分布之外。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 16
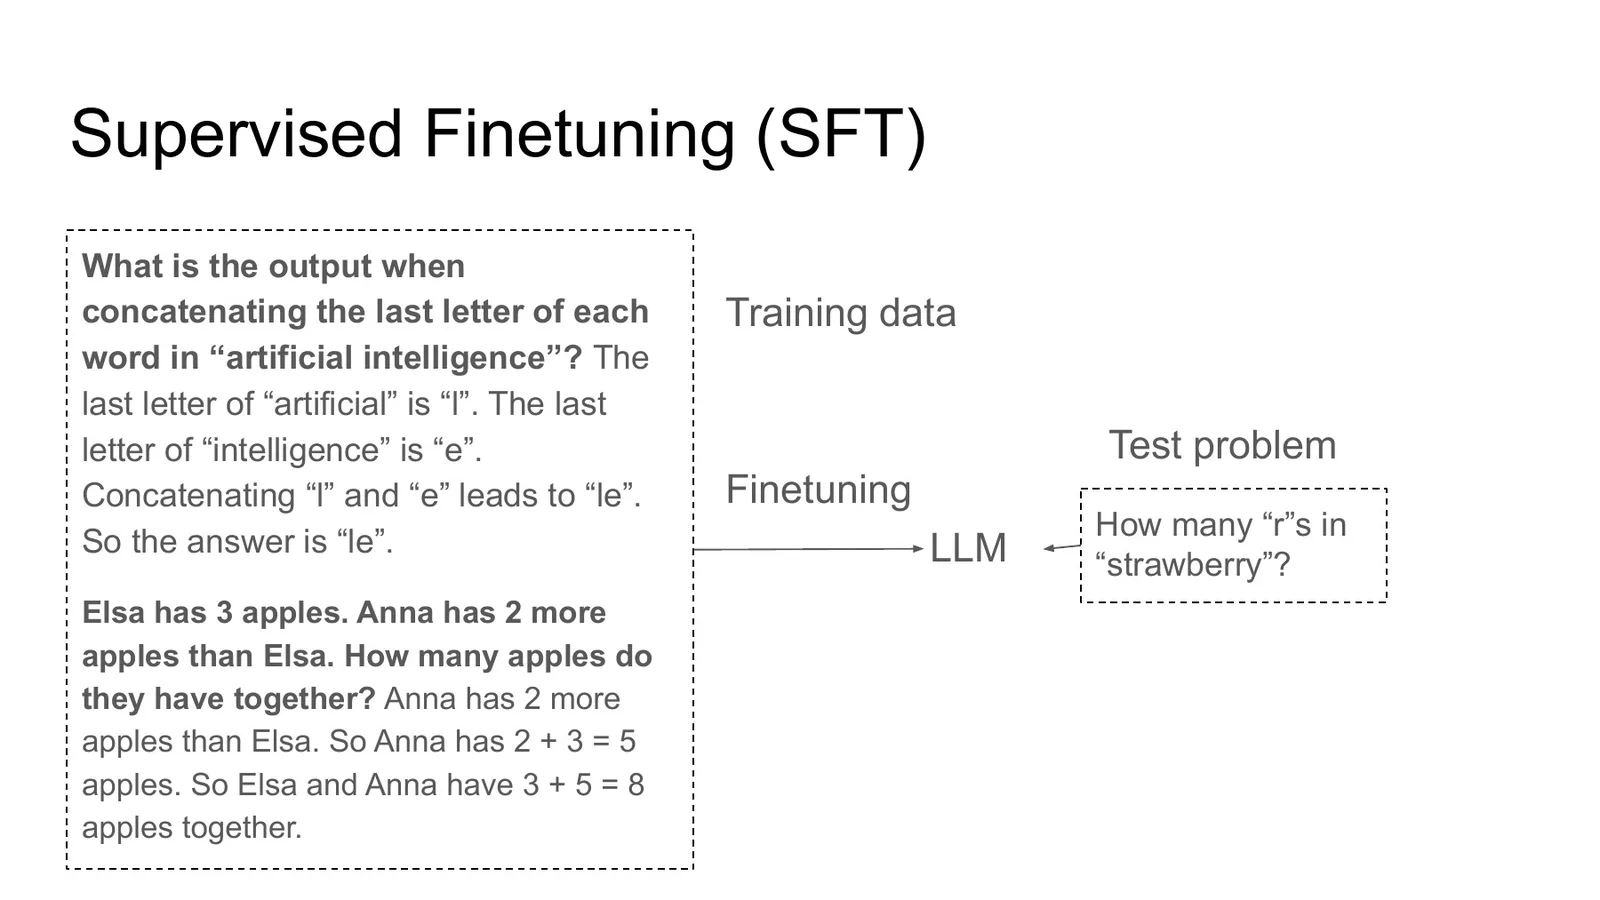
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 17
图 17 用末字母、苹果题训练,再测试 “strawberry 有几个 r”。即使任务都能写成自然语言步骤,表面格式一致也不保证算法迁移。模型可能学到“复述训练示例的词形和句式”,却没有学到对任意字符串执行逐字符计数;这就是为什么需要按组合长度、词形、领域与难度做 out-of-distribution 切分,而不是随机拆分近似样本。
Teacher forcing 的隐藏假设
SFT 假设参考轨迹既正确又是模型容易生成的路径,并假设局部 next-token imitation 能产生全局正确行为。若参考步骤风格与模型分布差异太大,模型可能在训练损失下降时仍无法稳定进入那条轨迹。
为什么“多收数据再放大”未必解决泛化
SFT 的优点是通用:一旦构建统一的输入—响应格式,同一个训练管线可以覆盖数学、代码和解释任务。缺点是对新组合与新难度的泛化不稳定,而且扩大同类人工轨迹常带来递减收益。页面上的 “Don't scale blindly” 不是反对 scale,而是要求先确认学习目标与数据生成过程是否对准部署目标。
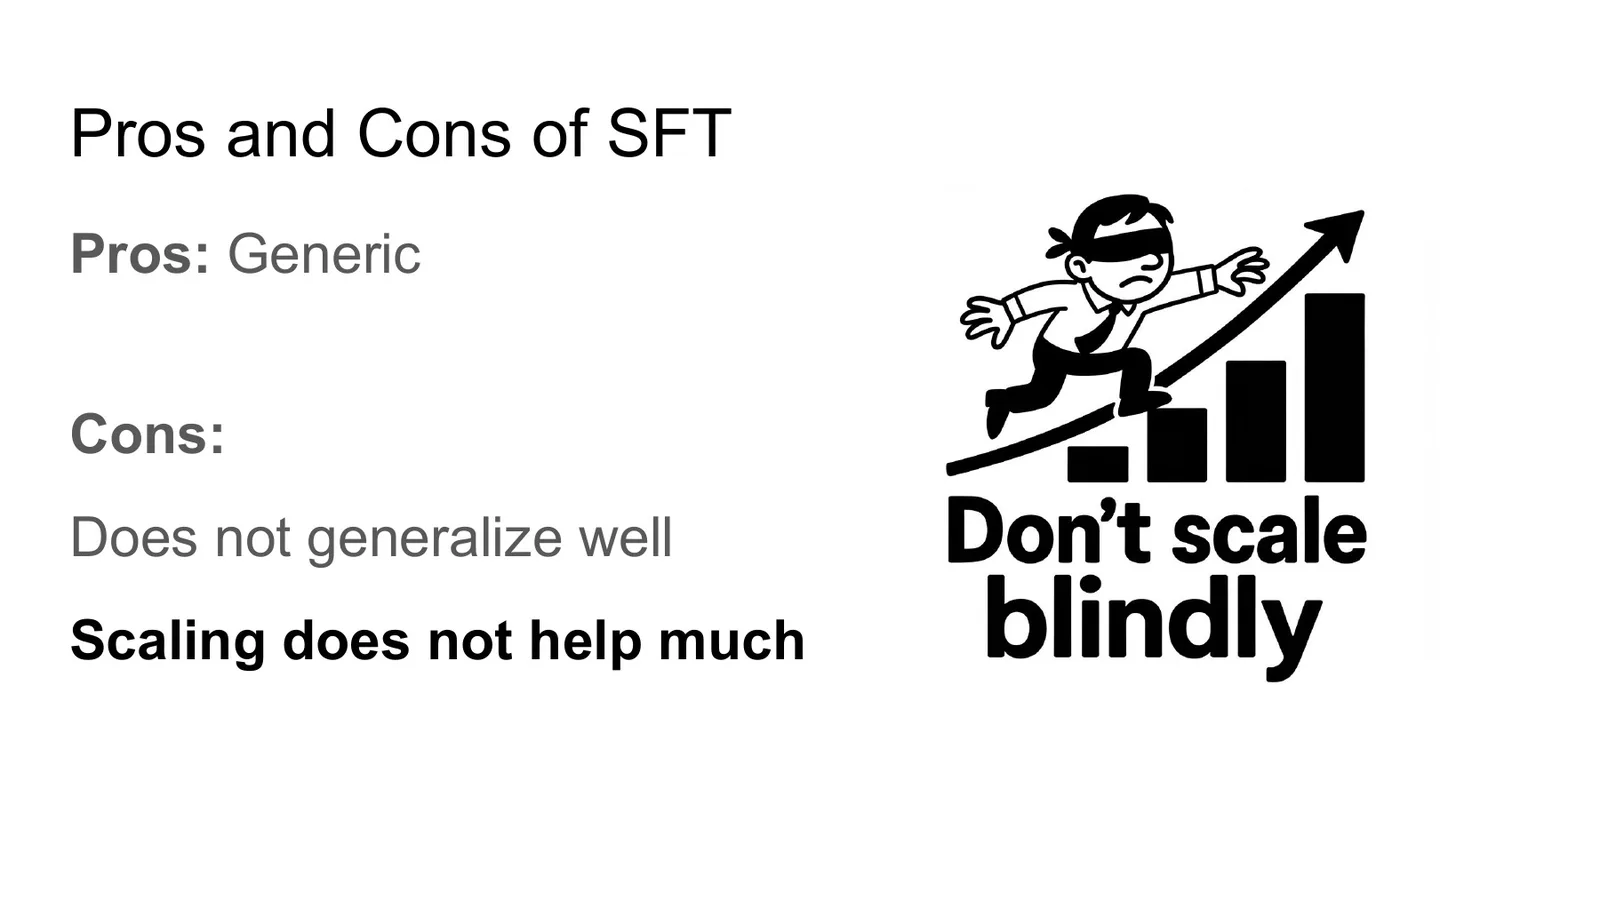
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 18
课堂提示
00:16:20–00:19:55,老师回顾 2021 年团队发现 SFT 在推理上泛化不佳,并给出本讲最强的实践警告之一:如果 paradigm 本身错了,继续扩大同类数据和训练规模也不会自动修复。
可用三类测试区分“没学够”与“目标错位”:
- 同分布扩量:增加近似训练样本是否继续稳定提升;
- 组合外推:长度、数字范围或操作组合变大时是否崩溃;
- 轨迹替换:不同但同样正确的解法是否被错误惩罚。
若模型只在第一类提升,说明它更像在插值;若第三类中把有效替代轨迹视为错误,最大似然目标本身就在压缩解空间。
本章小结
Prompting 用上下文临时诱导轨迹,SFT 用人工参考永久重排分布。两者都能让 reasoning 更常出现,但都依赖人类指定“应该长什么样”。当部署问题拥有多个有效路径、难度超出标注分布或正确轨迹难以人工书写时,下一步应直接优化结果质量,而不是继续模仿单一路径。
RL Finetuning:从模仿人类轨迹到优化生成质量
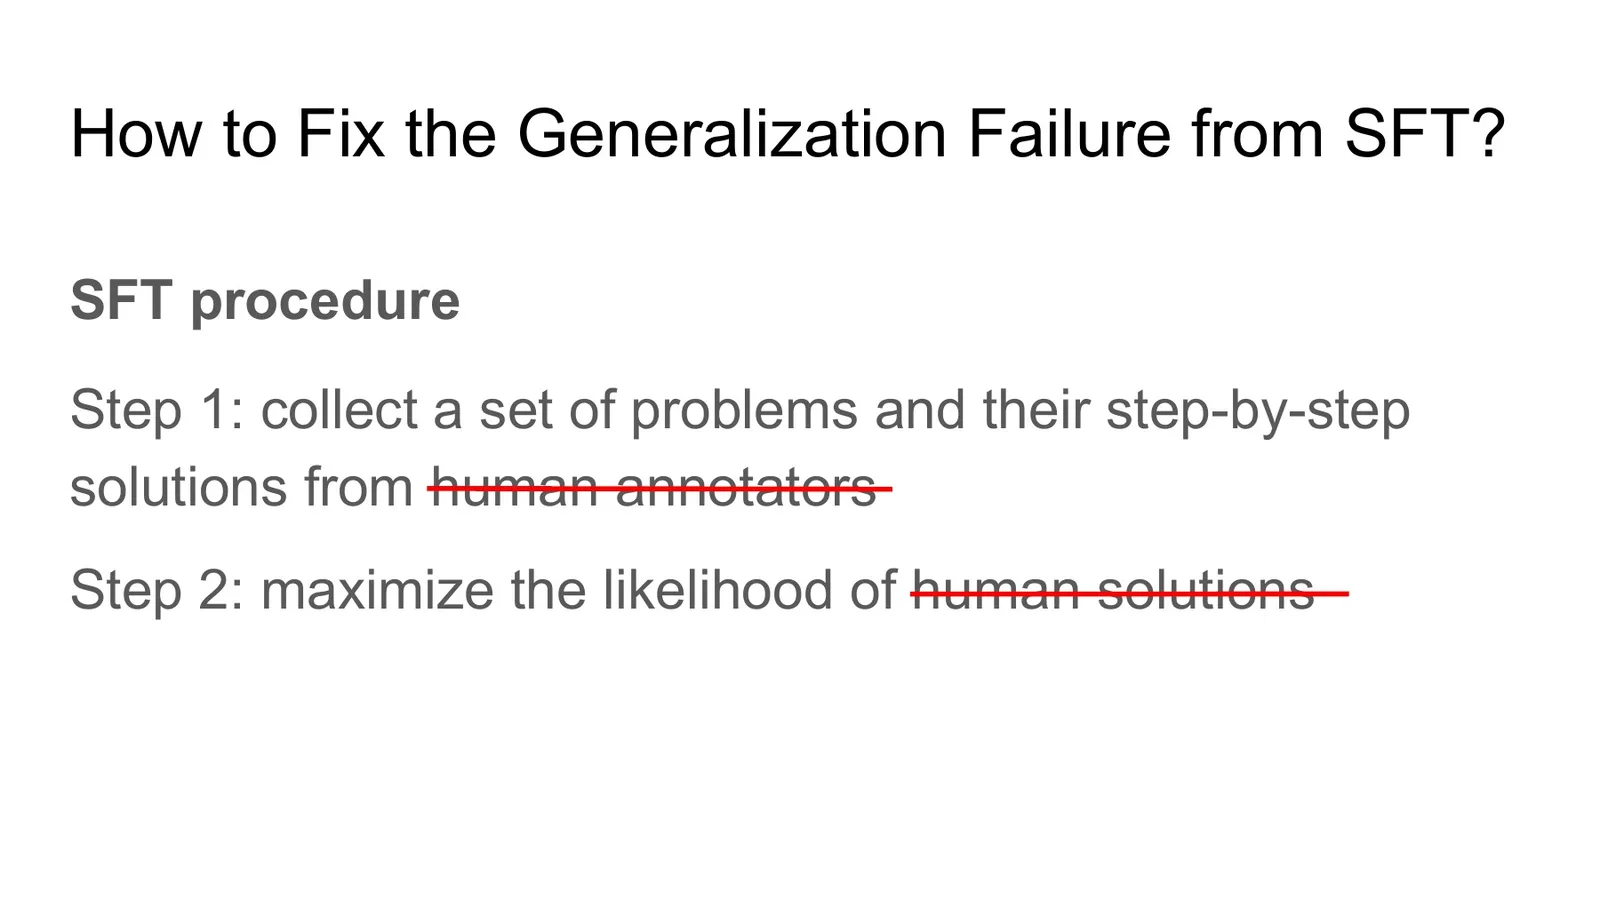
课堂把 SFT 的关键故障定位在 “from humans”:人工解法昂贵、覆盖有限,而且未必位于模型容易生成的区域。替代方案是让模型自己提出候选,使用可验证的最终结果筛选,再把成功轨迹反馈给模型。这个循环连接了 rejection sampling、self-training 与更一般的 reinforcement learning finetuning。
第一步:把数据源换成模型自己的分布
slide 19 先保留 SFT 的两步流程,再划掉“human-annotated”;slides 20–21 展示两种逐步增强:先最大化正确的模型生成轨迹,再同时降低错误轨迹的概率。核心不是“合成数据一定优于人类数据”,而是训练样本来自当前策略 \(\pi_\theta\),因此更贴近模型实际会走到的状态。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 19
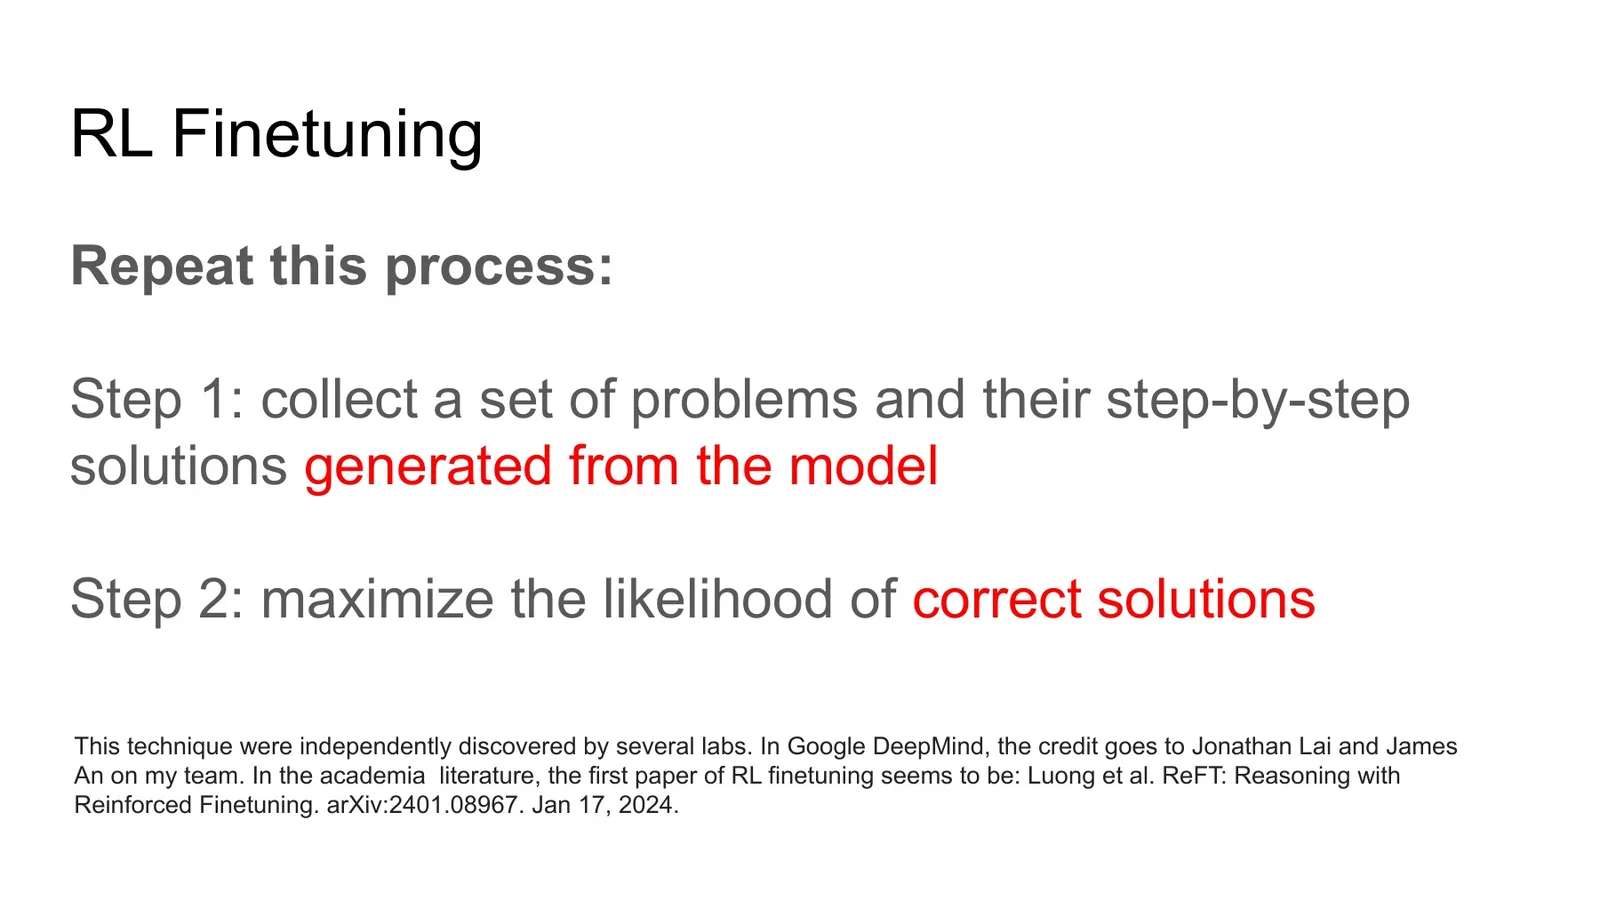
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 20
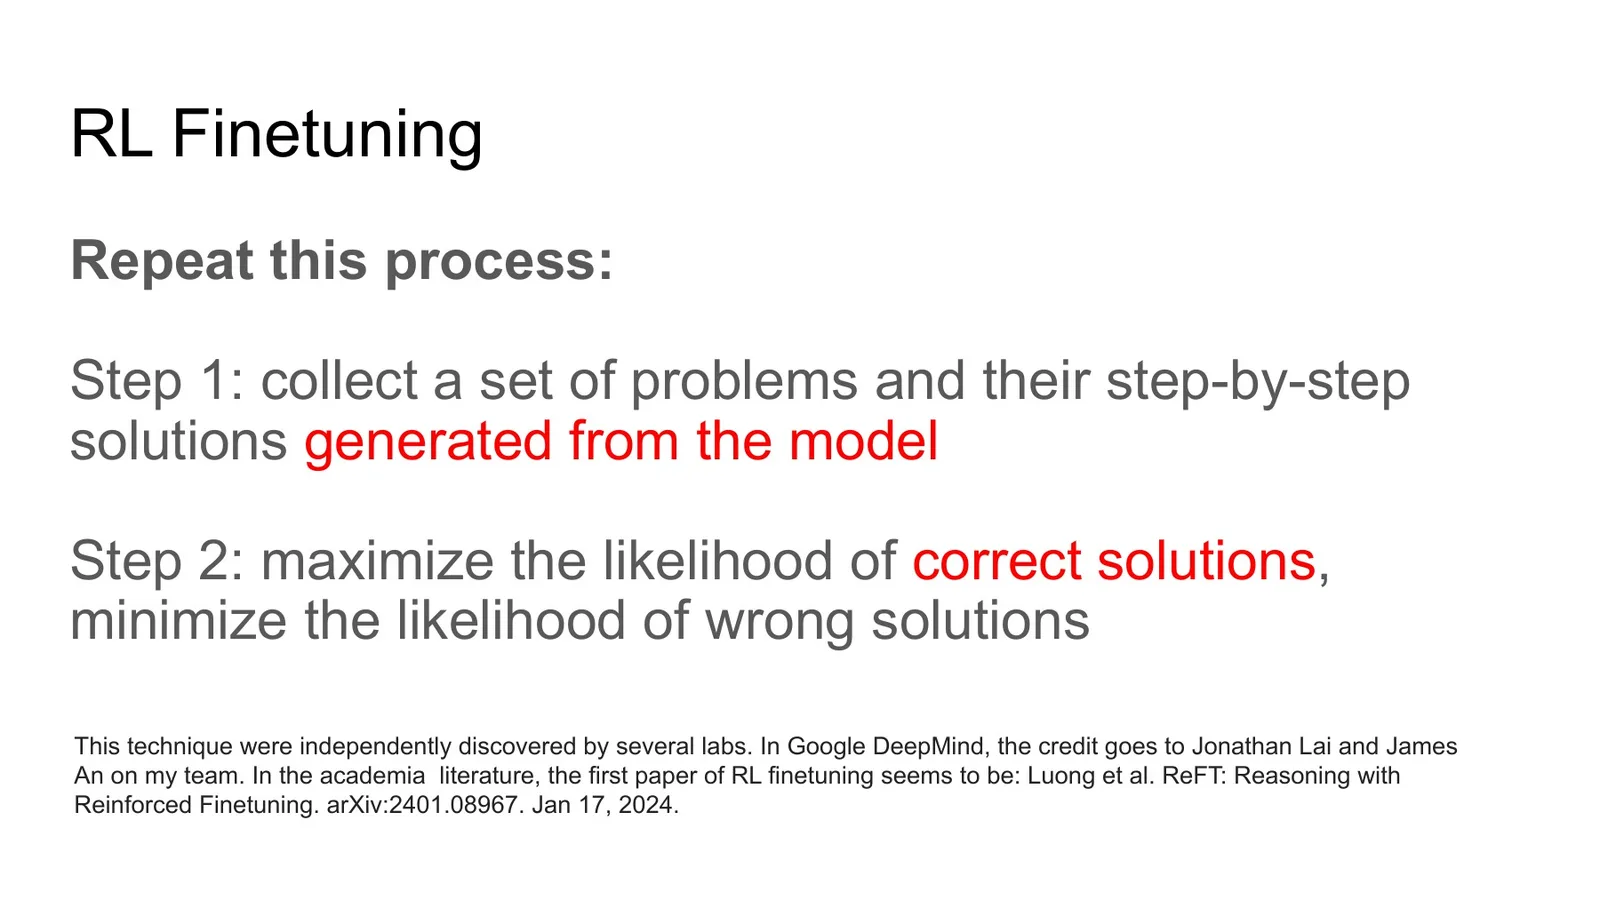
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 21
设模型对问题 \(x\) 生成 \(K\) 条轨迹 \(y^{(k)}\),verifier 给出 \(v(x,y^{(k)})\in\{0,1\}\)。最简单的 rejection-sampling 更新只保留 \(v=1\) 的样本:
其中 \(K\) 决定探索宽度,\(v\) 决定哪些轨迹进入训练集。循环多轮后,模型分布会向自己曾经成功生成的区域移动;但若 verifier 误判,错误轨迹也会被不断放大。
def build_round(policy, problems, verifier, parse_answer, n=16):
    accepted, rejected = [], []
    for problem in problems:
        for sample in policy.sample(problem, n=n):
            answer = parse_answer(sample.text)
            if answer is None:
                rejected.append((problem, sample.text, "parse_error"))
            elif verifier(problem, answer):
                accepted.append((problem, sample.text))
            else:
                rejected.append((problem, sample.text, "wrong_answer"))
    return accepted, rejected
课堂提示
00:20:00–00:24:50,老师回忆第一次听到“机器生成的响应可以比人工数据更适合训练”时也很惊讶。实践经验:优势不来自“机器更聪明”,而来自样本与当前模型分布对齐,并且可以在改进后重新采样、形成迭代闭环。
直接优化我们真正想要的东西
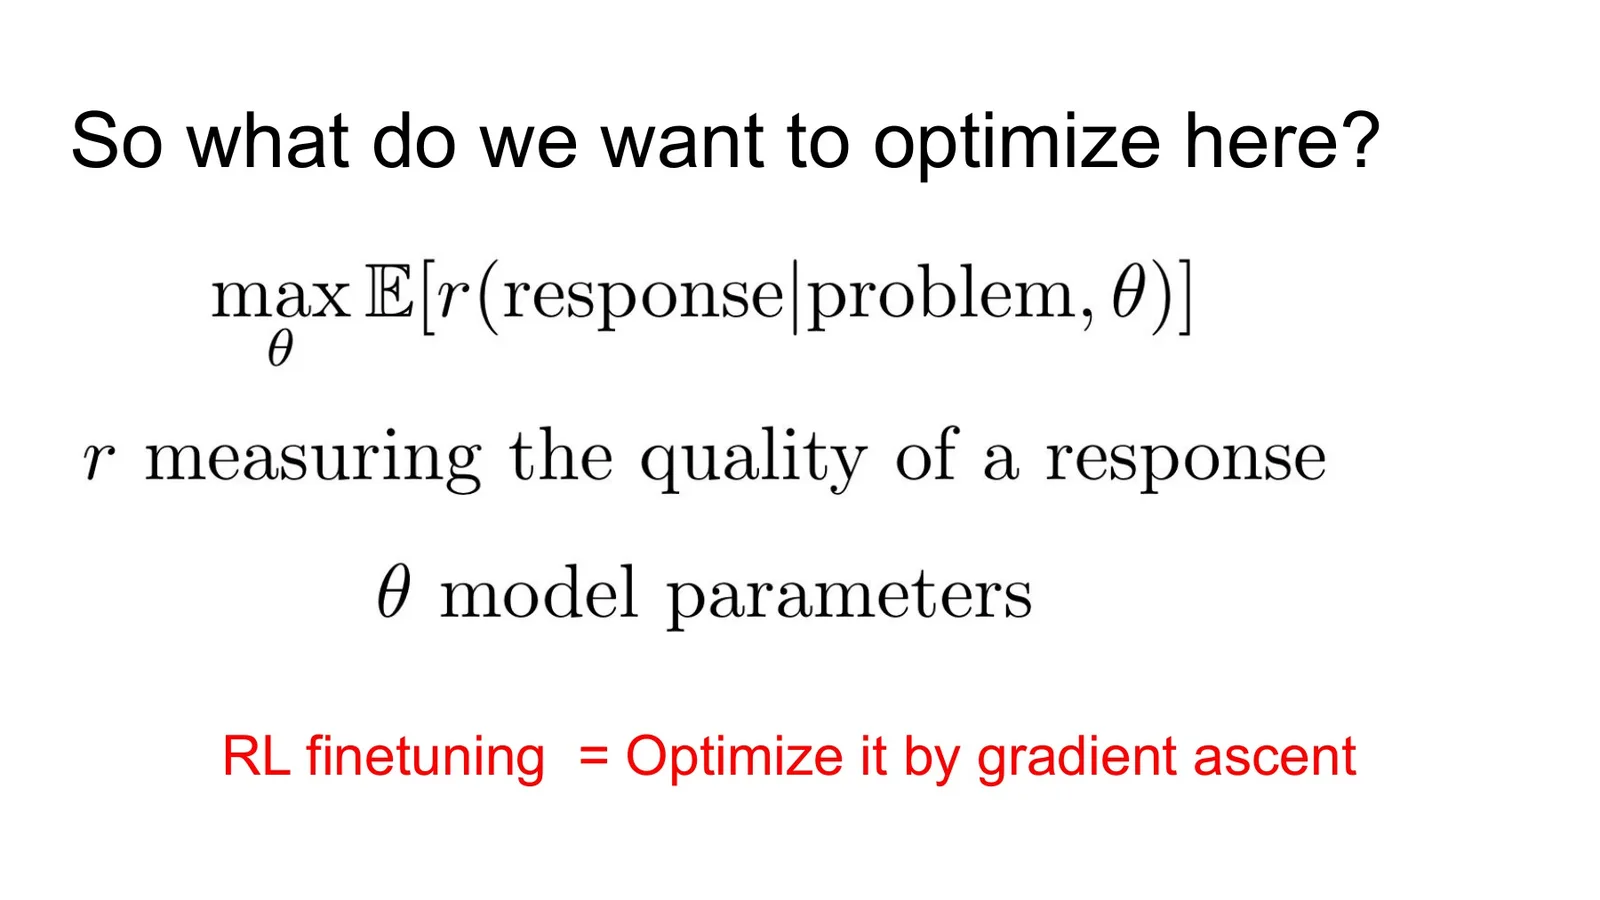
slides 22–24 把复杂算法压缩成一句话:先定义 generation quality,再做 gradient ascent。对策略 \(\pi_\theta(y\mid x)\) 和奖励 \(R(x,y)\),目标可以写成
其中 \(R\) 可以是数学答案正确性、代码测试通过率、翻译质量或学习到的偏好分数。公式强调奖励决定优化方向;policy gradient、group-relative 更新或过滤式 SFT 只是估计和实现该方向的不同方法。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 22
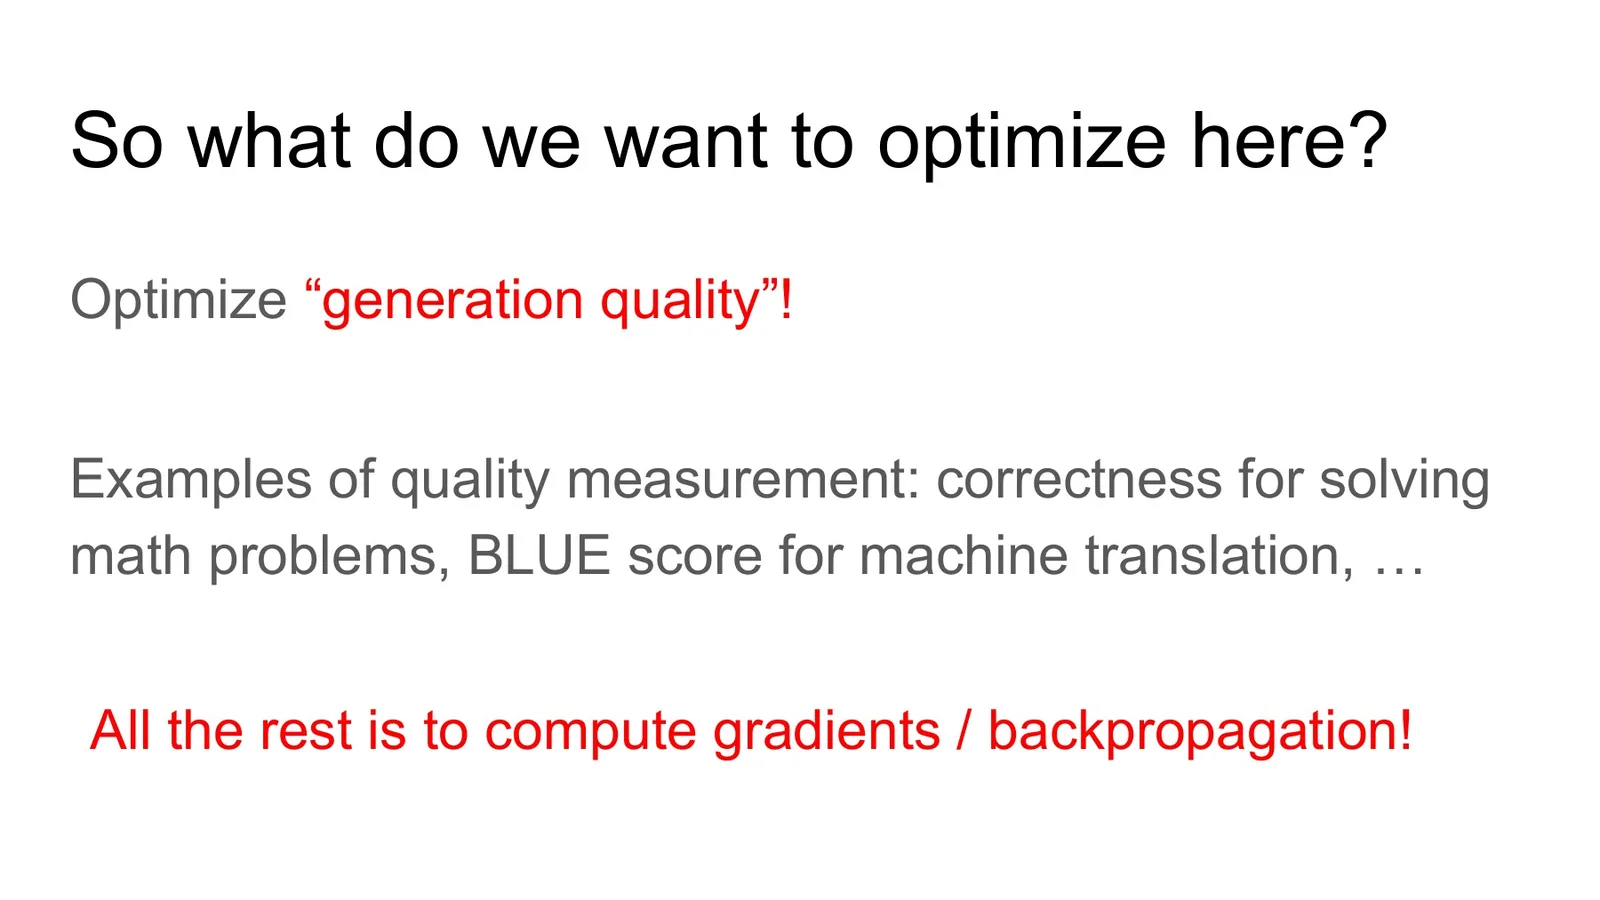
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 23
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 24
目标函数优先于算法名称
“用了 RL”本身没有说明系统在优化什么。必须先写清 reward、答案解析、采样分布、长度成本、无效输出处理与 KL/稳定约束,再讨论 PPO、GRPO、REINFORCE 或 rejection sampling。错误目标被优化得越好,系统越危险。
讲义在质量示例中提到机器翻译指标,通常应写作 BLEU。指标只是代理:数学 exact match 可能忽略等价表达,代码单元测试可能漏掉隐藏边界,BLEU 可能偏好表面 n-gram 重合。真实目标与可计算 reward 之间的差距,就是 reward hacking 的入口。
Verifier 才是当前自动扩展的瓶颈
slide 25 引用 “Verification, the key to AI”,并给出明确判断:可靠 verifier 往往比具体 RL 算法更关键。设真实正确性为 \(z\in\{0,1\}\),verifier 输出为 \(v\)。若 false-positive rate
不够低,生成规模越大,模型越容易搜索到“骗过验证器”的错误轨迹;若 false-negative rate
过高,则多样但正确的解法被丢弃,训练分布会越来越窄。这里 \(\alpha\) 控制错误污染,\(\beta\) 控制正确覆盖,二者都应按任务难度和风险 slice 报告。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 25
“最终答案正确”不保证轨迹正确
结果 verifier 可能接受碰巧猜对、单位错误后抵消、使用泄漏信息或不可复现工具状态的轨迹。高风险训练应组合 outcome verifier、process checks、去污染检测、执行沙箱与人工抽样,而不是只看最后字符串。
课堂提示
00:27:30–00:30:20,老师强调在当前自动可验证任务上,最关键的是 verifier,而不是争论哪一种 RL 更新更漂亮。课堂提示:可扩展性的上限由“能否便宜、稳定地判断好坏”决定。
推理训练到底扩展什么
slide 26 回到最初的理论:推理可以扩展 output length,而直接答案能力往往依赖 model depth。训练 reasoning model 时,“scale”至少有四个维度:参数量、训练问题数、每题采样数和最大轨迹长度。只报告总 FLOPs 会掩盖这些预算如何分配,也无法解释收益来自更强模型、更多探索还是更长计算。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 26
若每题采样 \(K\) 条、平均长度 \(T\),训练生成成本近似与 \(KT\) 成正比;可接受样本率为 \(q\) 时,获得一个正轨迹的期望成本约为 \(KT/(Kq)=T/q\),但扩大 \(K\) 会提高“至少找到一个正确轨迹”的概率 \(1-(1-q)^K\)。这解释了为什么稀疏奖励任务会迅速消耗推理预算,也说明 verifier 与课程难度必须共同设计。
术语消化:SFT、Rejection Sampling、RL Finetuning
SFT 模仿给定参考序列;rejection sampling 从当前模型采样并只保留通过验证的轨迹;RL finetuning 更一般地直接优化期望奖励,可同时利用正负样本。三者可以组成连续管线,不应仅按论文名称划成互斥阵营。
本章小结
RL finetuning 的关键转向是:从“复现一条人类写出的轨迹”变为“在模型自己的候选分布中,依据可验证质量提高成功轨迹的概率”。它为推理扩展提供循环数据源,但也把 verifier 偏差、答案解析、奖励漏洞和采样成本推到系统中心。
推理轨迹为何看起来像人:涌现、搜索与可验证边界
有了中间 token 和 outcome-guided training,模型可能产生长而有结构的解题过程。课堂称之为 LLM reasoning 的“beauty”:不必显式编写穷举搜索器,token-to-token generation 也能出现分解、估计、回退和局部验证。这个现象值得研究,但最危险的误读是把语言表面直接当作认知同一性。
从 token 生成中涌现出的结构
slide 27 把现代 LLM 与经典人工智能的 exhaustive search 对比。更准确的理解是:模型把大量模式压进参数,并在生成时沿一条或少数轨迹展开;它未必显式枚举完整状态树。优势是推理路径紧凑、可与自然语言和工具接口结合;代价是覆盖不完备,且错误分支不一定能被系统性发现。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 27
课堂提示
00:31:20–00:32:10,老师用 Kasparov 对 Deep Blue 的评价做对照,强调现在看到的轨迹不再只是人工写好的搜索程序。讲义提醒:这是对行为形态的描述,不足以证明模型没有进行隐式搜索,也不证明轨迹忠实。
“涌现”在这里应怎样理解
涌现不是魔法标签,而是指训练目标没有逐条编码“先估规模、再找分解、最后验证”的脚本,模型却在规模、数据和训练后呈现这种可复用结构。研究问题应继续追问:哪些数据与奖励诱发它、在哪些分布失效、能否被 verifier 检查。
2025 算术题:长轨迹提供了什么
题目要求用 1 到 10 各一次,只用加法和乘法得到 2025。简洁构造是
其中第一组构成 45,第二组也构成 45。slide 28 对比人工式简洁解和 2024 年 12 月 Gemini 2.0 thinking mode 的长轨迹:模型先注意 2025 是 \(45^2\),再把目标转化为构造两个 45,并在很长的候选探索后给出答案。
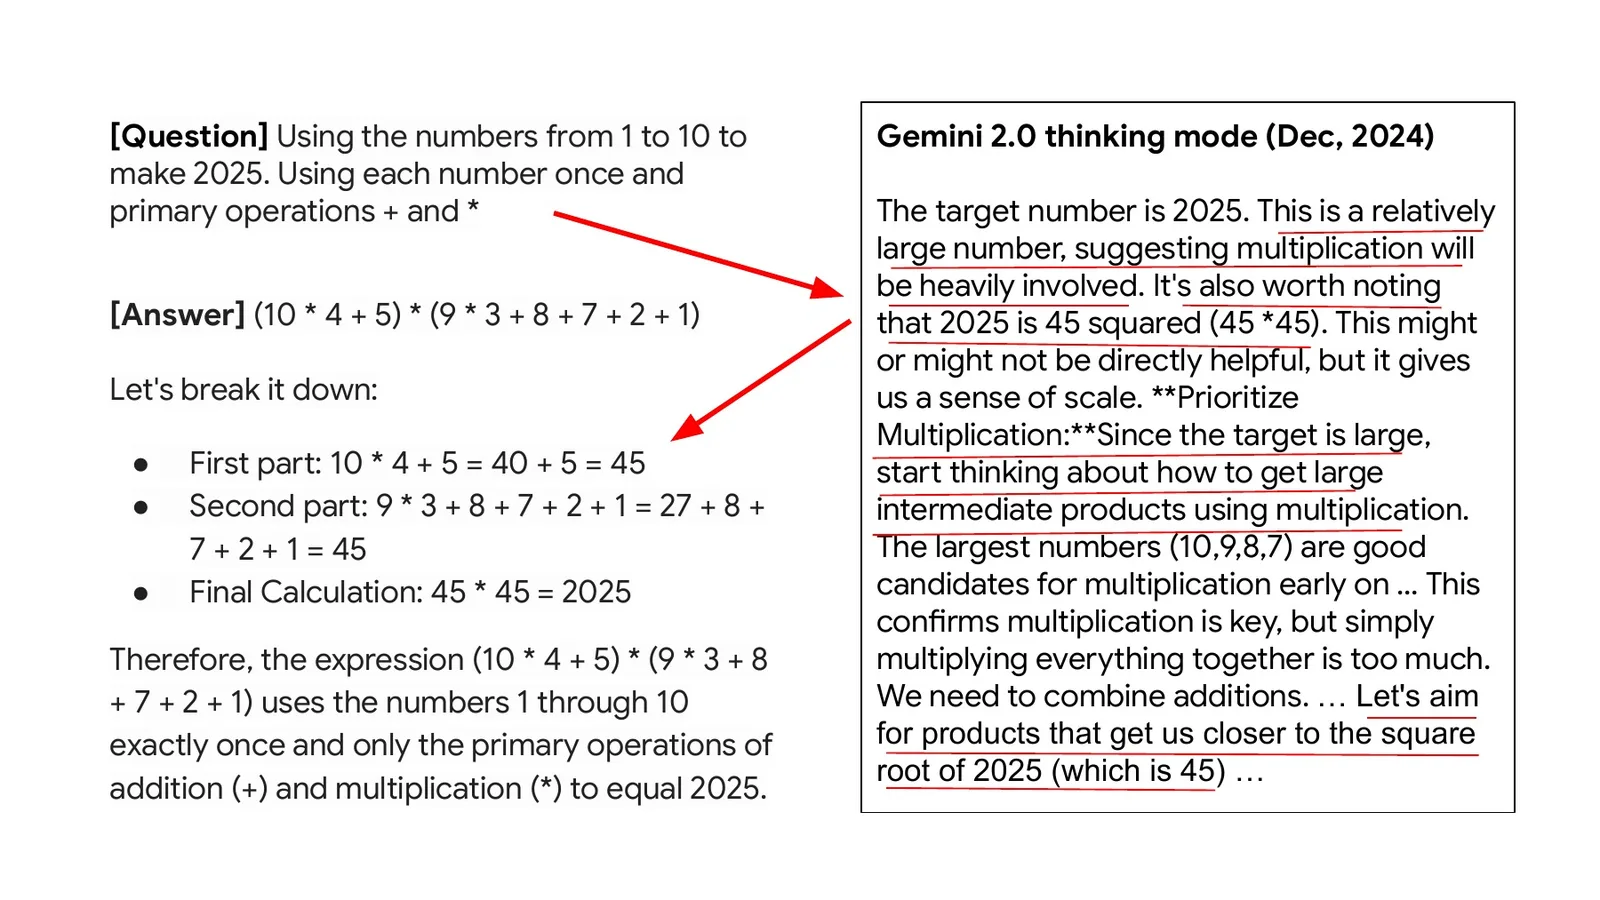
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 28
读图时先看右侧轨迹的问题重表述:大目标提示乘法,平方结构提示两个因子;再看搜索过程是否保持“每个数字只用一次”的约束;最后才看答案。长 CoT 的价值不是字数,而是把约束、启发式与中间目标显式化,使 verifier 可以逐步检查,也让后续 token 读取已经发现的 \(45\) 结构。
长轨迹的三类幻觉
第一,先猜到答案再编造合理过程;第二,中间违反约束但最终式子碰巧正确;第三,重复、绕圈或无效探索消耗大量 token。评测应同时检查最终表达式、数字使用集合、运算约束和轨迹成本。
学习发现过程,而不只是装入发现结果
Rich Sutton 的引文强调:希望 agent 学会 discovery process,而不是只包含人类已经发现的答案。对 reasoning model,这意味着训练数据不能只有高质量终稿,还要提供可探索的问题分布、可靠反馈和从失败中恢复的机会。否则模型更像庞大的解答检索器,在新组合上仍缺少发现机制。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 29
课堂提示
00:32:10–00:39:00,老师用长算术轨迹说明模型会形成类似人类的启发式,但反复提醒 LLM 是 probabilistic model。课堂提示:可读步骤是工程资产,可用于验证与训练;“像人”只是一种描述,不应成为正确性的证据。
搜索在这里并未消失,而是分成三层:参数中的模式压缩、token 序列中的局部探索,以及可选的外部 symbolic search/tool use。Q&A 中老师进一步澄清,模型可以写 Python 或调用搜索器;这属于工具使用。研究“基础 reasoning ability”时可以单独考察无外部搜索的生成,但产品系统通常应把两者组合,而不是把 search 与 learning 设成意识形态对立。
RL reasoning 的能力边界:不是所有任务都有自动 verifier
slide 30 给出 RL finetuning 的核心优缺点:在答案可自动验证的任务上泛化较好,但大量开放任务没有唯一、便宜、可靠的评分函数。数学 exact match、代码测试、棋局输赢属于相对友好的区域;政策建议、长文研究、产品设计和社会判断往往有多目标、延迟反馈与价值冲突。
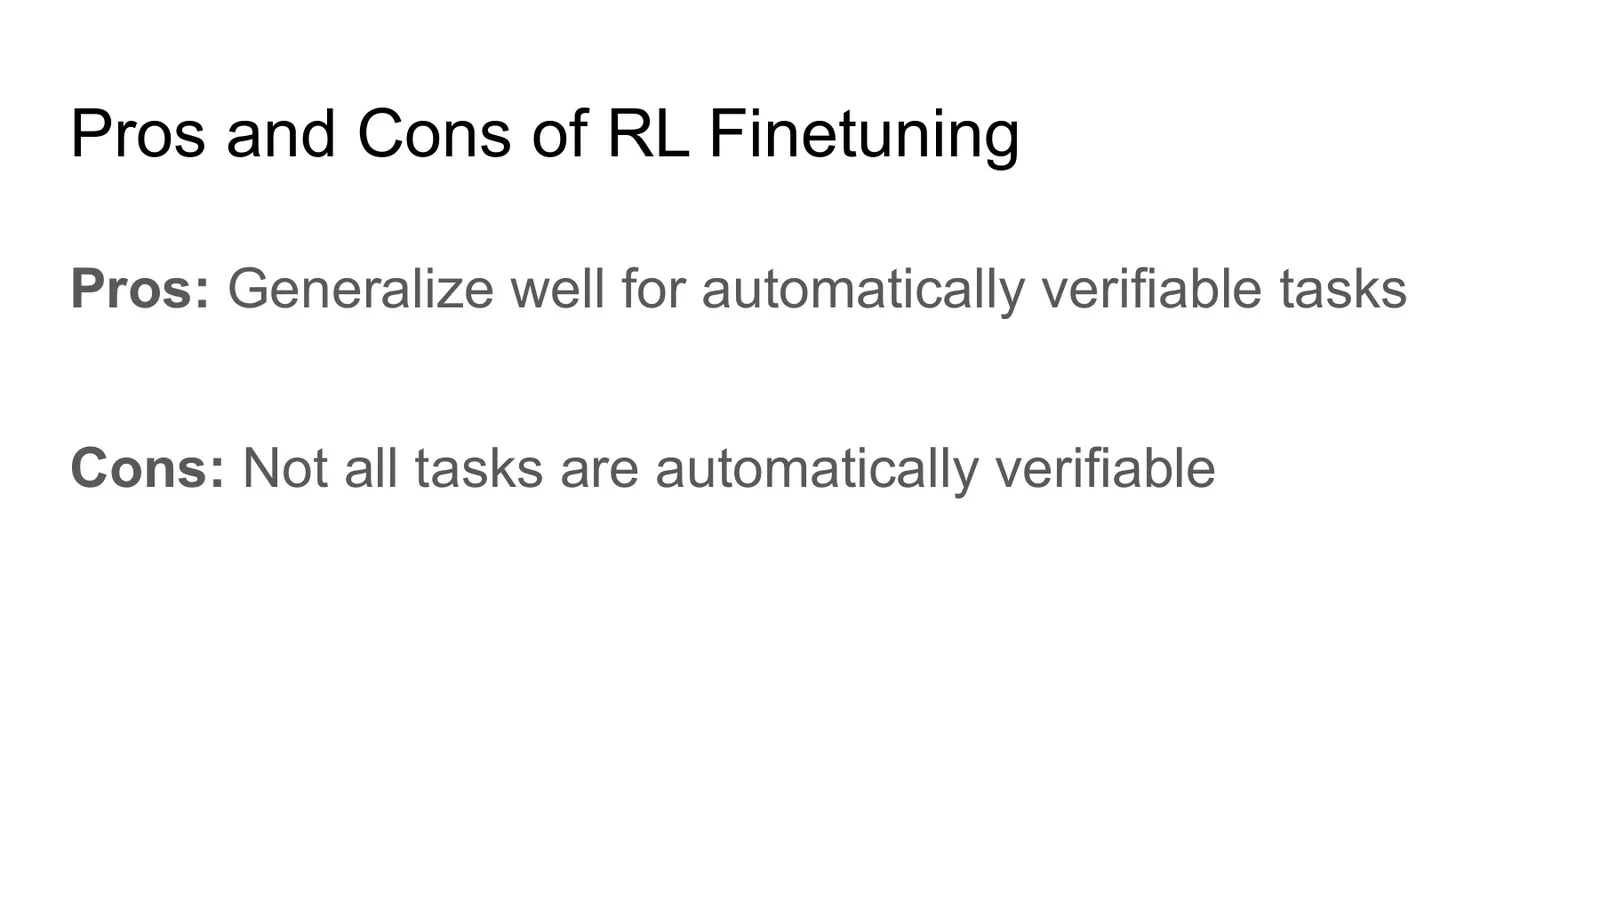
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 30
可把任务按 verifier 条件分成四类:
| 类型 | 典型反馈 | 主要风险 |
|---|---|---|
| 唯一答案 | exact match、数值容差 | 解析错误、答案泄漏 |
| 可执行结果 | 单元测试、模拟器回报 | 测试不完备、reward hacking |
| 成对偏好 | 人类/模型 judge 选择 | judge 偏差、风格偏好 |
| 长期开放目标 | 业务结果、社会影响 | 延迟归因、多目标冲突、不可逆成本 |
Verifier frontier
推理训练的下一阶段不是把已有 RL 配方机械移到所有领域,而是构造更可靠的过程反馈、可执行环境、反事实测试和多指标验收。没有这些基础设施,开放任务上的“奖励”很容易只测格式、讨好或短期代理。
为什么下一步是聚合与检索
即使单条 reasoning path 已经很强,生成仍是随机过程:同一问题可能得到不同中间步骤和答案。slide 31 预告两个互补方向:aggregation 用多个候选估计答案概率,retrieval 从外部或上下文中补充相关知识。slide 32 再次提醒,LLM 是 next-token probability model,不是人类;“先生成轨迹再给答案”的自然流程仍可能在概率目标上错位。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 31
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 32
课堂提示
00:39:00–00:40:17,老师从 RL 的 verifier 限制转向 inference-time 改进:当单条轨迹不稳定时,不要假设一次生成足够;应利用多个样本的统计结构,或先找回相关知识再解题。
本章小结
长 reasoning trace 能承载中间目标、约束和局部验证,但不能靠“像人”证明正确。RL 在自动可验证任务上具有优势,其扩展瓶颈是开放目标的 verifier。接下来要解决的,是单条随机轨迹与最终答案概率不一致的问题。
从路径概率到答案概率:Self-Consistency 与自由文本聚合
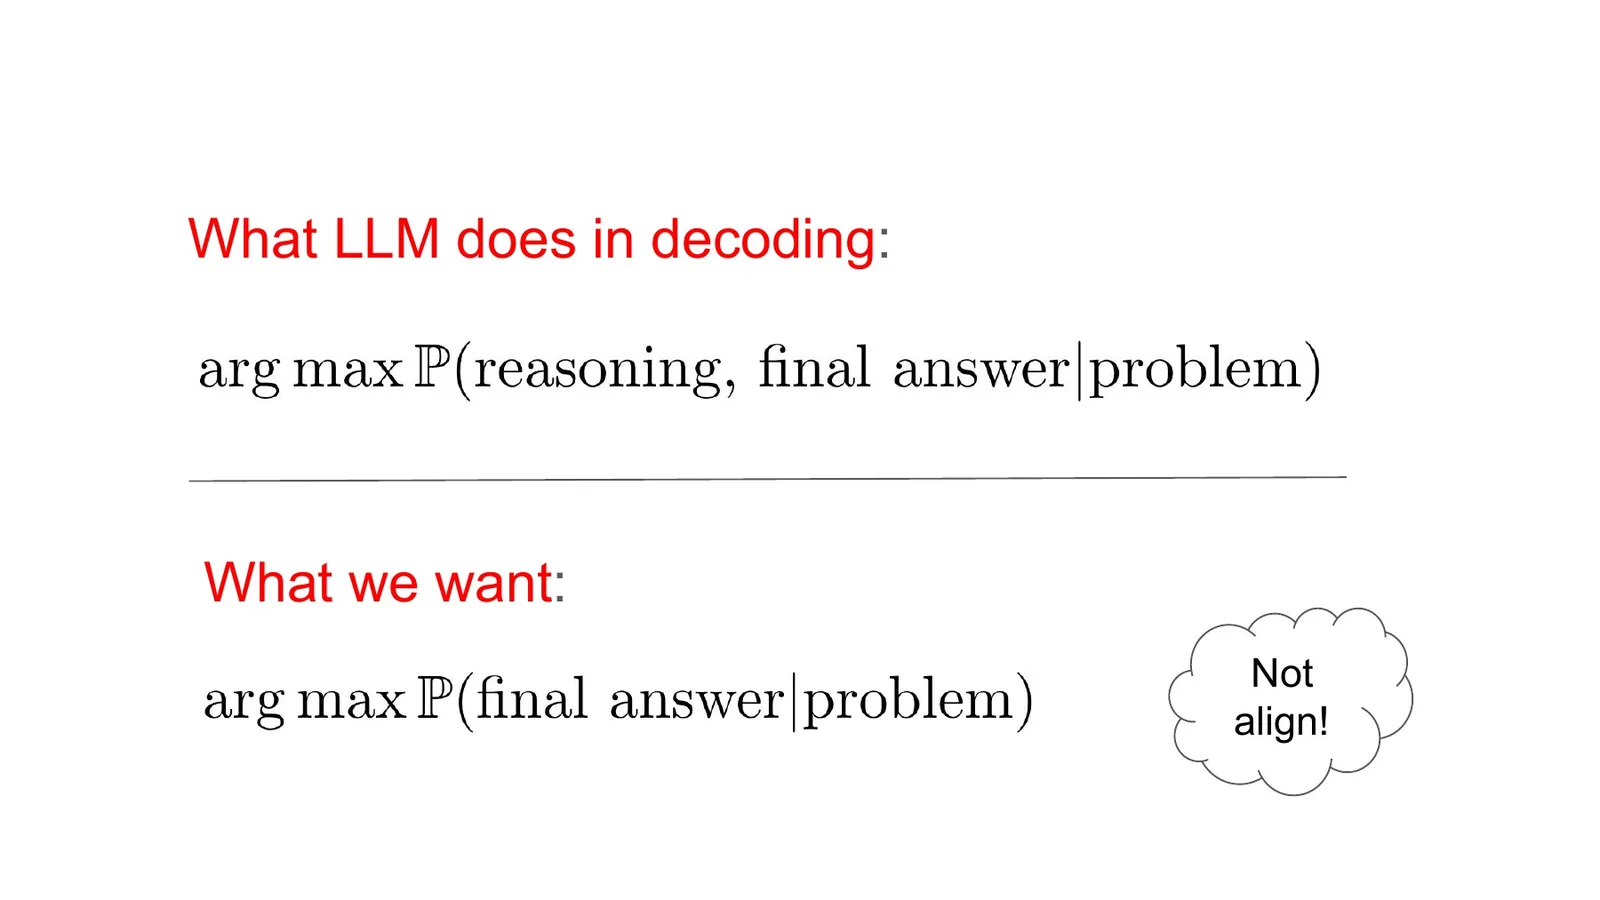
语言模型原生优化的是每一步 next-token probability。用户真正关心的却常是最终答案 \(a\) 的概率,而同一个答案可能由许多不同的 reasoning path \(r\) 导出。若只选联合概率最高的一条完整响应,就把“最可能路径”误当成“最可能答案”。Self-consistency 的理论入口就是对潜在路径做 marginalization。
最可能路径不等于最可能答案
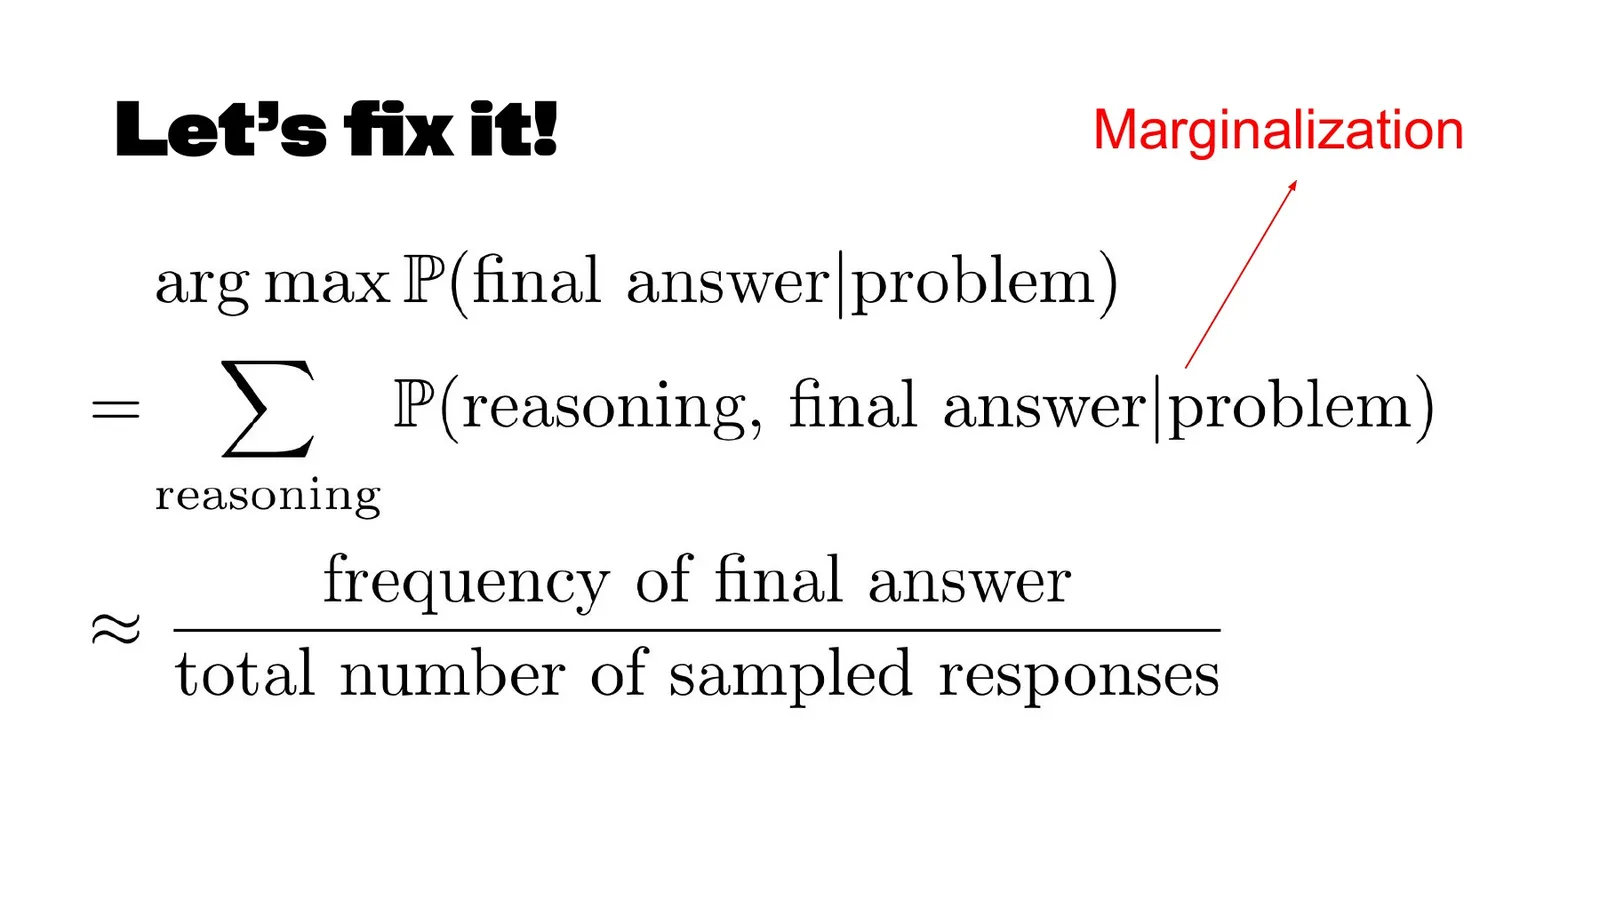
本节先把 slide 33–34 的图形直觉翻译成概率式。读图时要区分一条完整响应的联合概率与多个路径汇聚到同一答案后的总概率;前者对应“哪条路径最常见”,后者才对应“哪个答案拥有最多概率质量”。
对输入 \(x\),答案概率应为
其中 \(r\) 是潜在 reasoning path。Greedy 或 beam search 更接近寻找
而用户要的是
如果答案 A 有十条中等概率路径,答案 B 只有一条最高概率路径,单路径解码可能选 B,但总概率质量可能集中在 A。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 33
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 34
Self-consistency 的概率含义
它不是简单的“多数人投票”,而是用随机样本近似答案边缘概率。每条 reasoning path 是潜变量,最终只按规范化答案聚合;不同路径得到同一答案时,它们的概率质量应累加。
课堂提示
00:40:17–00:43:00,老师把这件事称为“高中条件概率也能看懂”的错位:模型按整条序列概率生成,而任务希望选最终答案概率最大的结果。课堂提示:很多推理改进来自把优化对象写对,而不是引入复杂架构。
Self-Consistency:用 Monte Carlo 估计答案质量
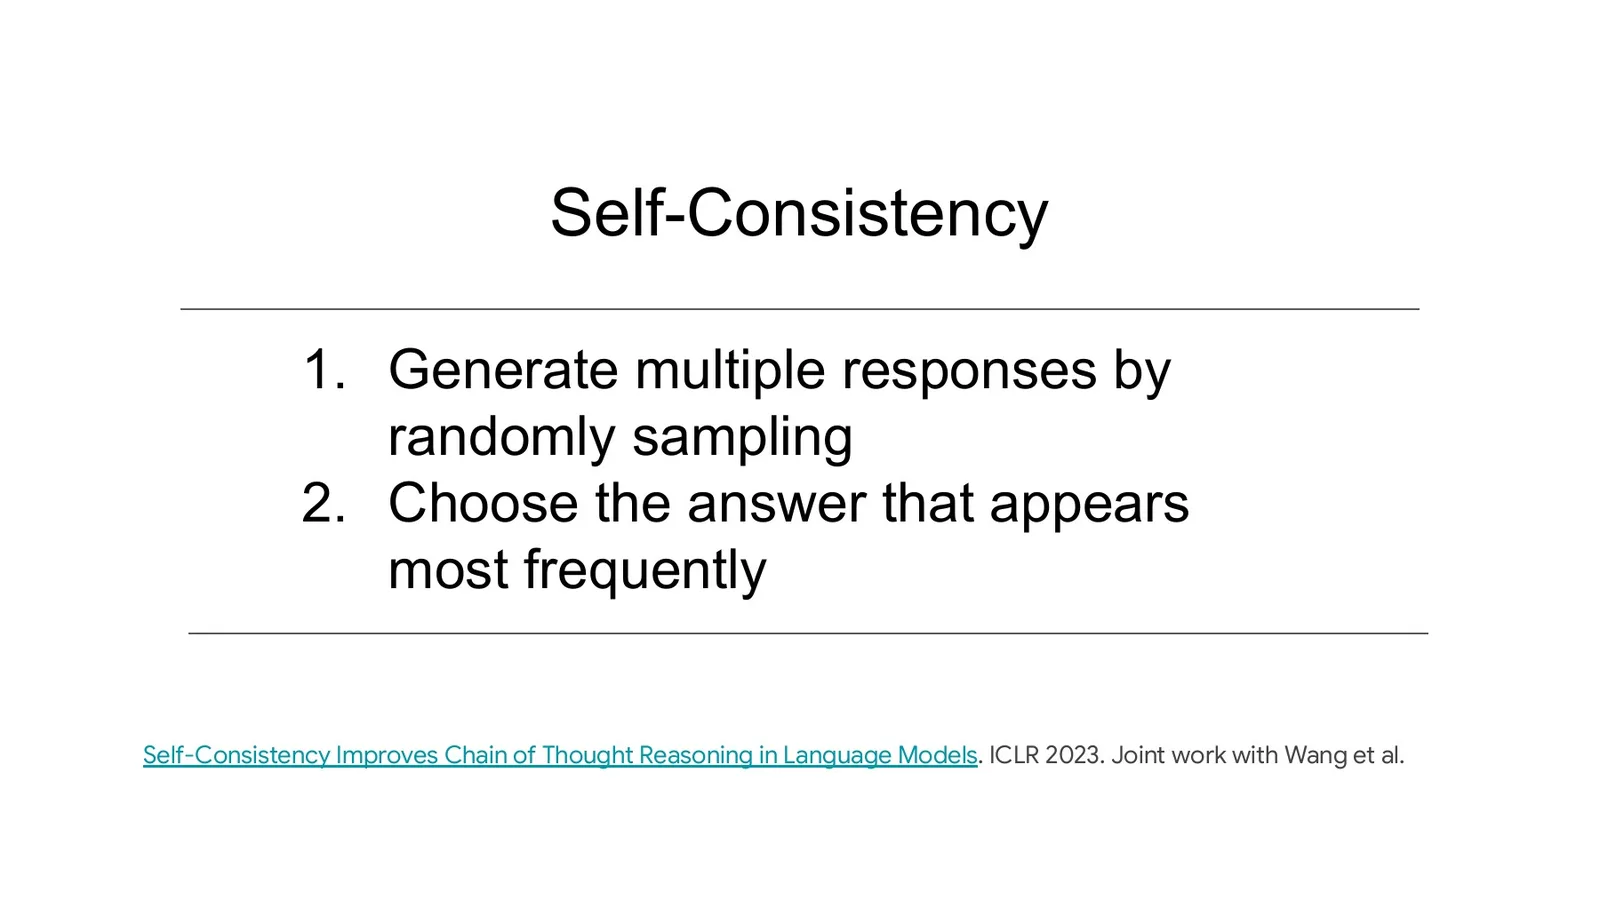
采样 \(K\) 条轨迹 \((r^{(k)},a^{(k)})\) 后,exact-answer 场景的估计器为
其中 \(K\) 是采样数,\(\mathbf 1[\cdot]\) 是指示函数,\(\widehat p_K\) 是答案出现频率。随着 \(K\) 增大,Monte Carlo 方差下降,但成本线性增长;如果样本高度相关或共享同一错误,增加 \(K\) 也不会产生独立证据。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 35
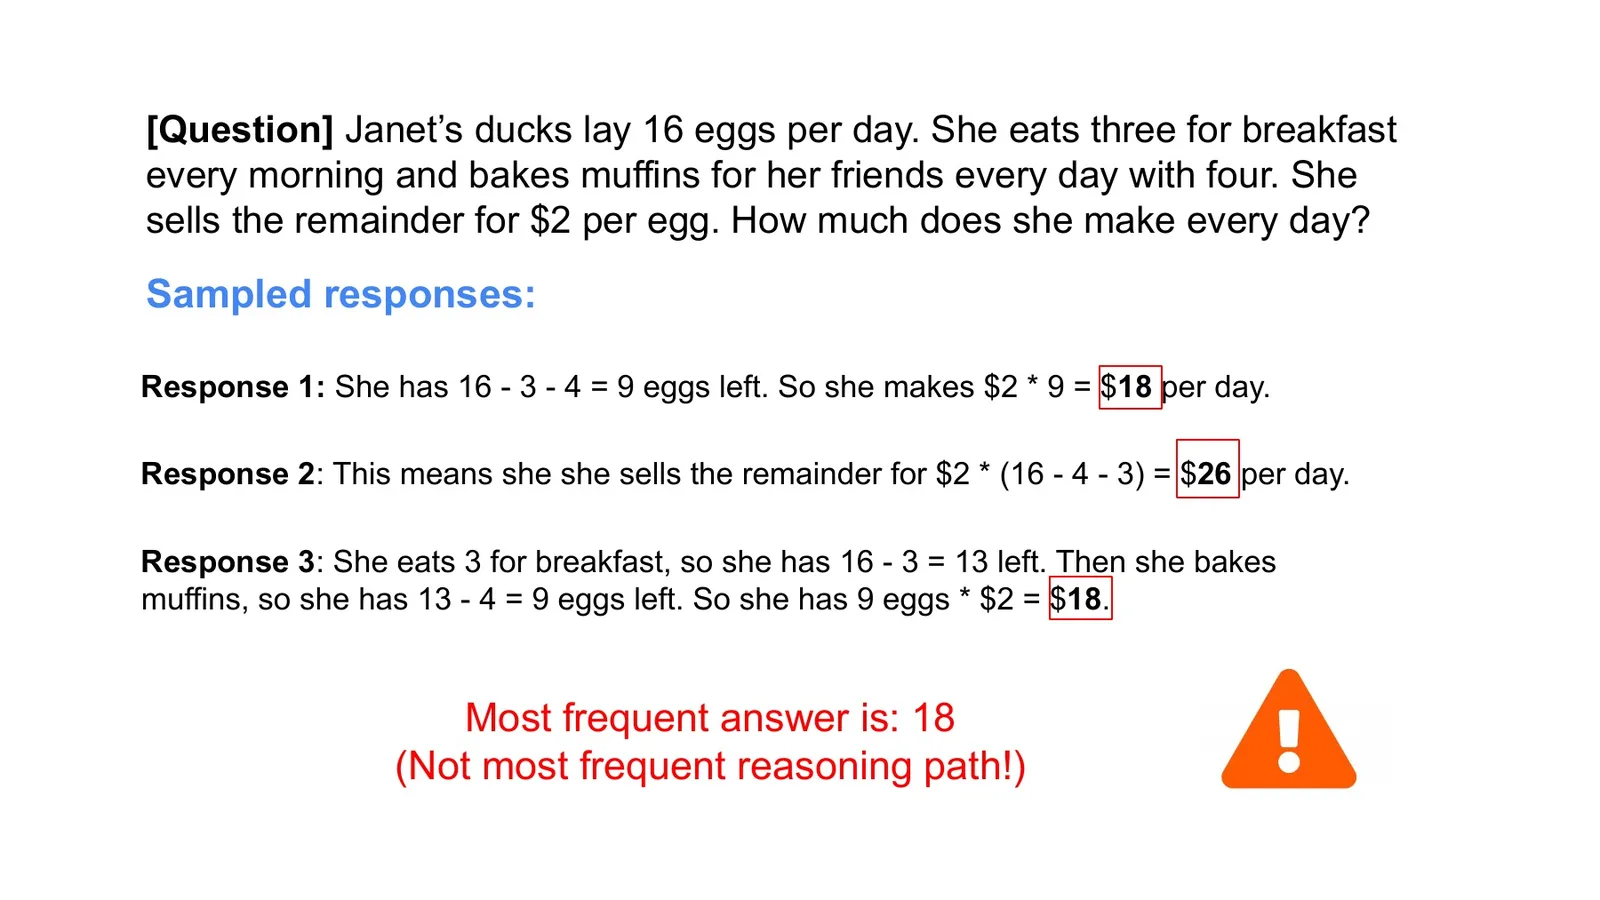
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 36
鸭蛋题三条响应中,两条得到 18,一条得到 26;正确聚合单位是规范化后的答案 18。两条正确轨迹文字不同,但表达同一计算。若按整段字符串投票,它们不会合并;若过度规范化,又可能把 \(18\)、\(18\%\) 和 \(18\) 美元错误合并。因此答案 parser 是 self-consistency 的一部分,不是无关的后处理。
from collections import Counter

def self_consistency(model, prompt, parse_answer, n=32):
    counts = Counter()
    traces = []
    for sample in model.sample(prompt, n=n, temperature=0.8):
        answer = parse_answer(sample.text)
        if answer is not None:
            counts[answer] += 1
            traces.append((answer, sample.text))
    if not counts:
        raise ValueError("all samples failed answer parsing")
    answer, votes = counts.most_common(1)[0]
    return answer, votes / sum(counts.values()), traces
怎样读 GSM8K 与后续模型结果
slide 37 汇总早期 GSM8K 结果,视觉重点不是记住每个小数,而是看同一模型加 CoT 后提升、再加 self-consistency 后进一步跃升。slide 38 引用后续 reasoning model 的 aggregation 结果,说明“多样本形成 consensus”并未因单模型变强而失效。两页跨模型、跨年份、跨设置,不能直接当统一 leaderboard;它们支持的是机制层结论:答案级聚合仍能利用候选多样性。
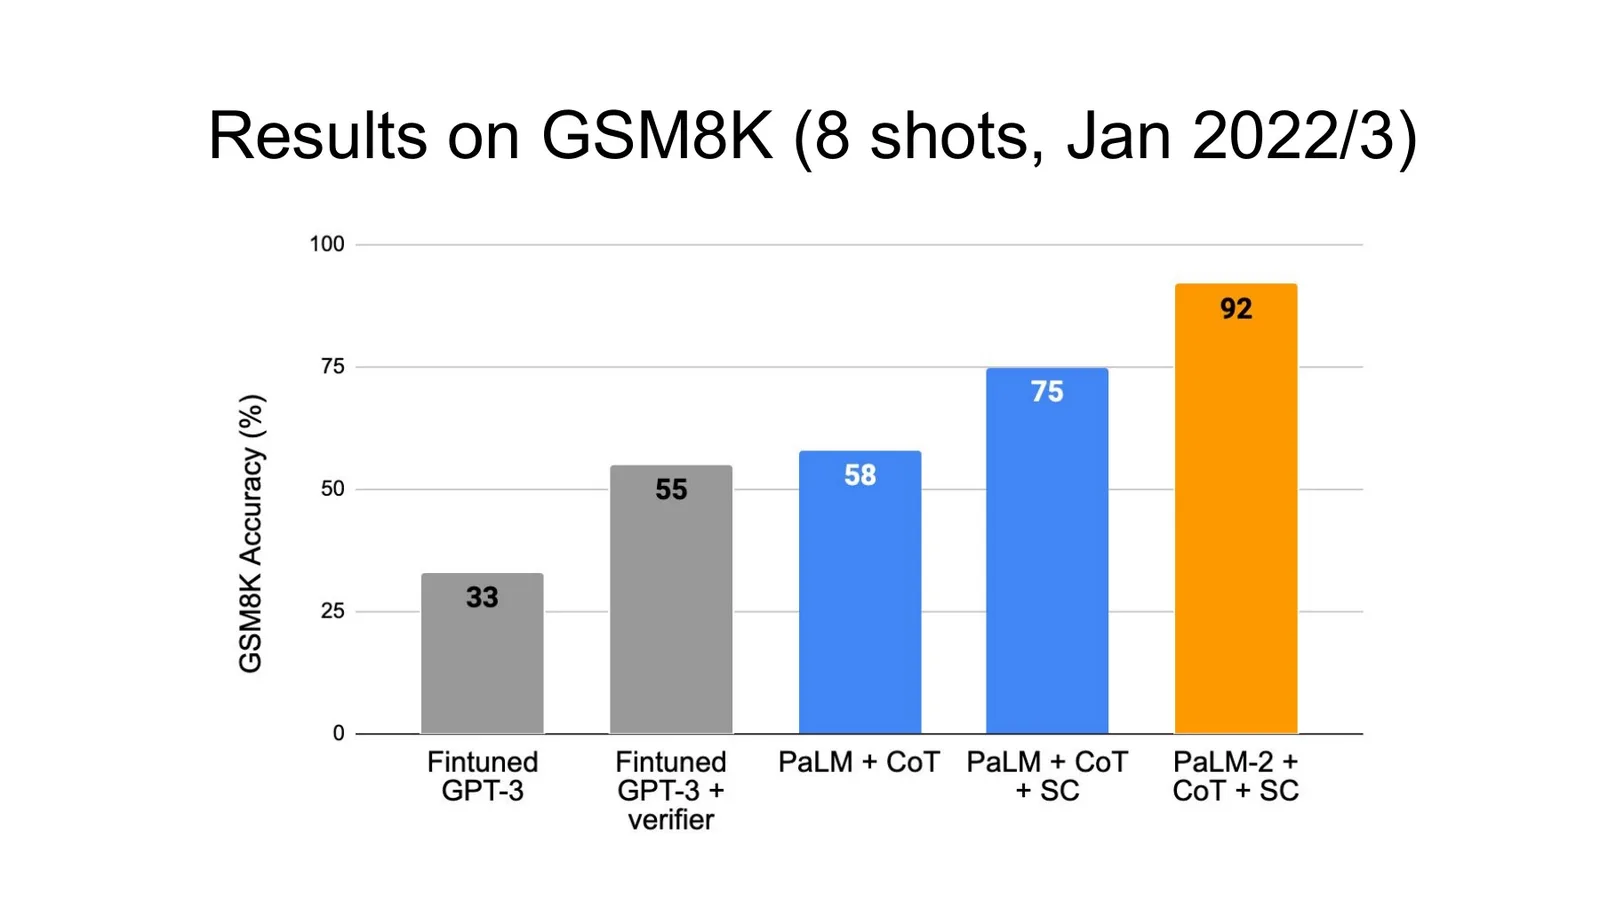
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 37
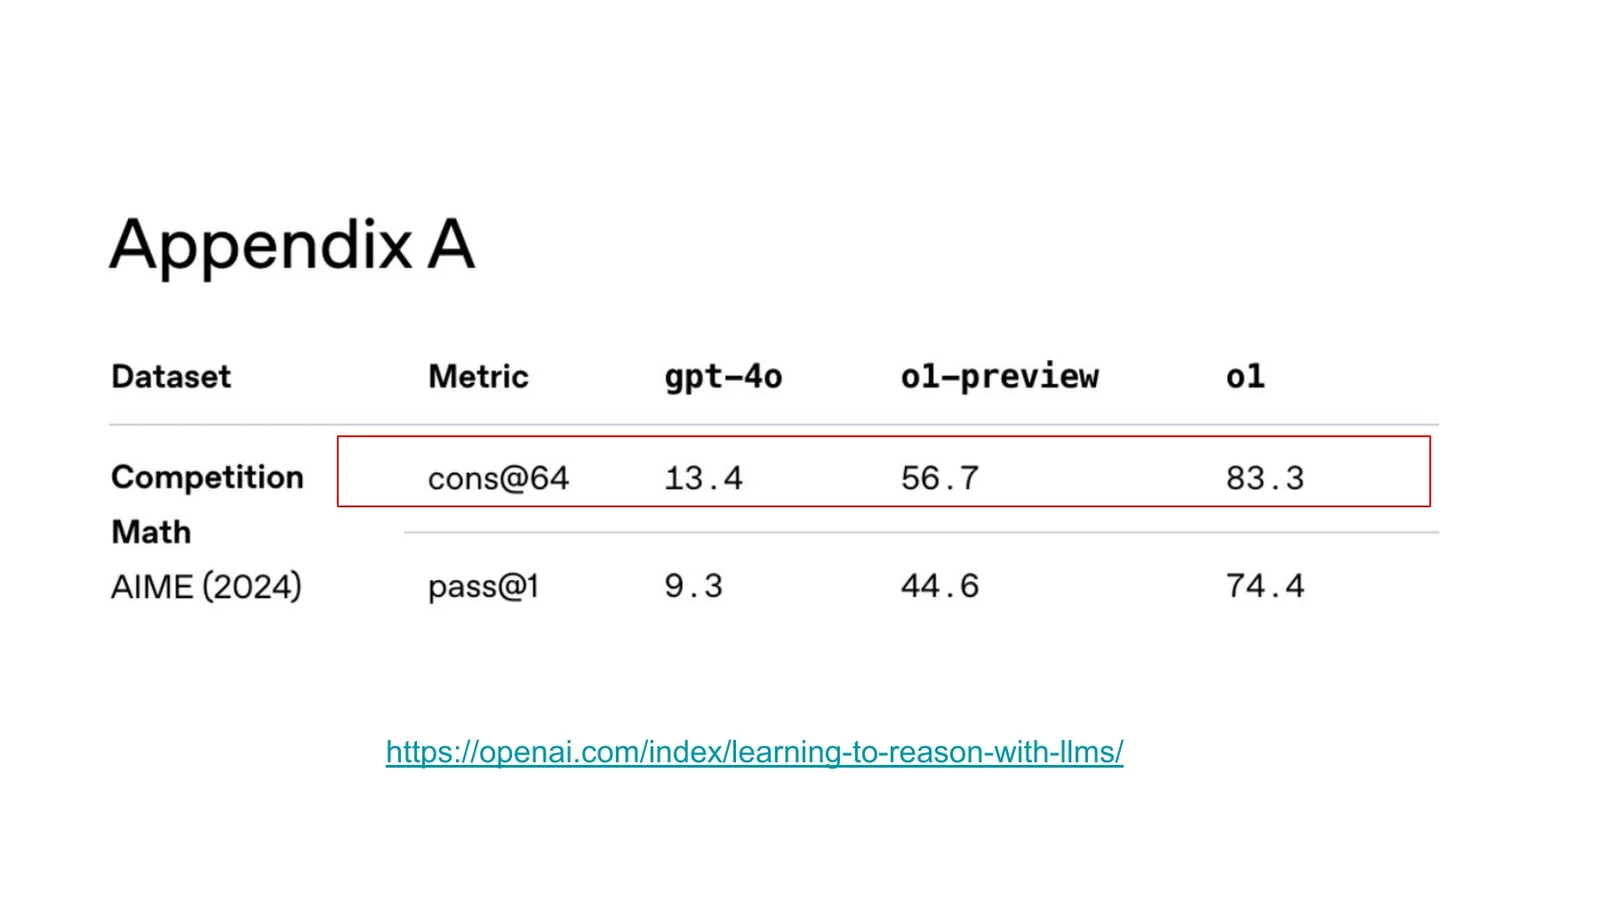
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 38
Inference-time scaling 必须说明“扩展了什么”
多采样扩大宽度,长 CoT 扩大深度,tree search 扩大结构,tool use 扩大外部能力。它们的延迟、并行性、内存和错误模式完全不同;只写“增加 test-time compute”无法复现实验,也无法做成本比较。
课堂提示
00:44:10–00:47:20,老师强调 self-consistency 的提升很大,但也立即接受学生关于成本的追问:更多样本意味着更多 token。实践经验:报告提升时必须同时给出采样数、总 token、墙钟延迟与并发条件。
一致性可以做置信度,但不能自动变成保证
slide 39 显示在该 GSM8K 设置中,一致性越高,准确率整体越高。可定义 consistency
\(c(x)\) 接近 1 表示大多数样本汇聚到同一答案;但它只测内部共识。若模型对同一错误拥有稳定偏见,\(c(x)\) 仍会很高。部署前应在验证集上画 reliability diagram,比较预测置信度区间与真实正确率,而不是把课堂相关图直接当校准证明。
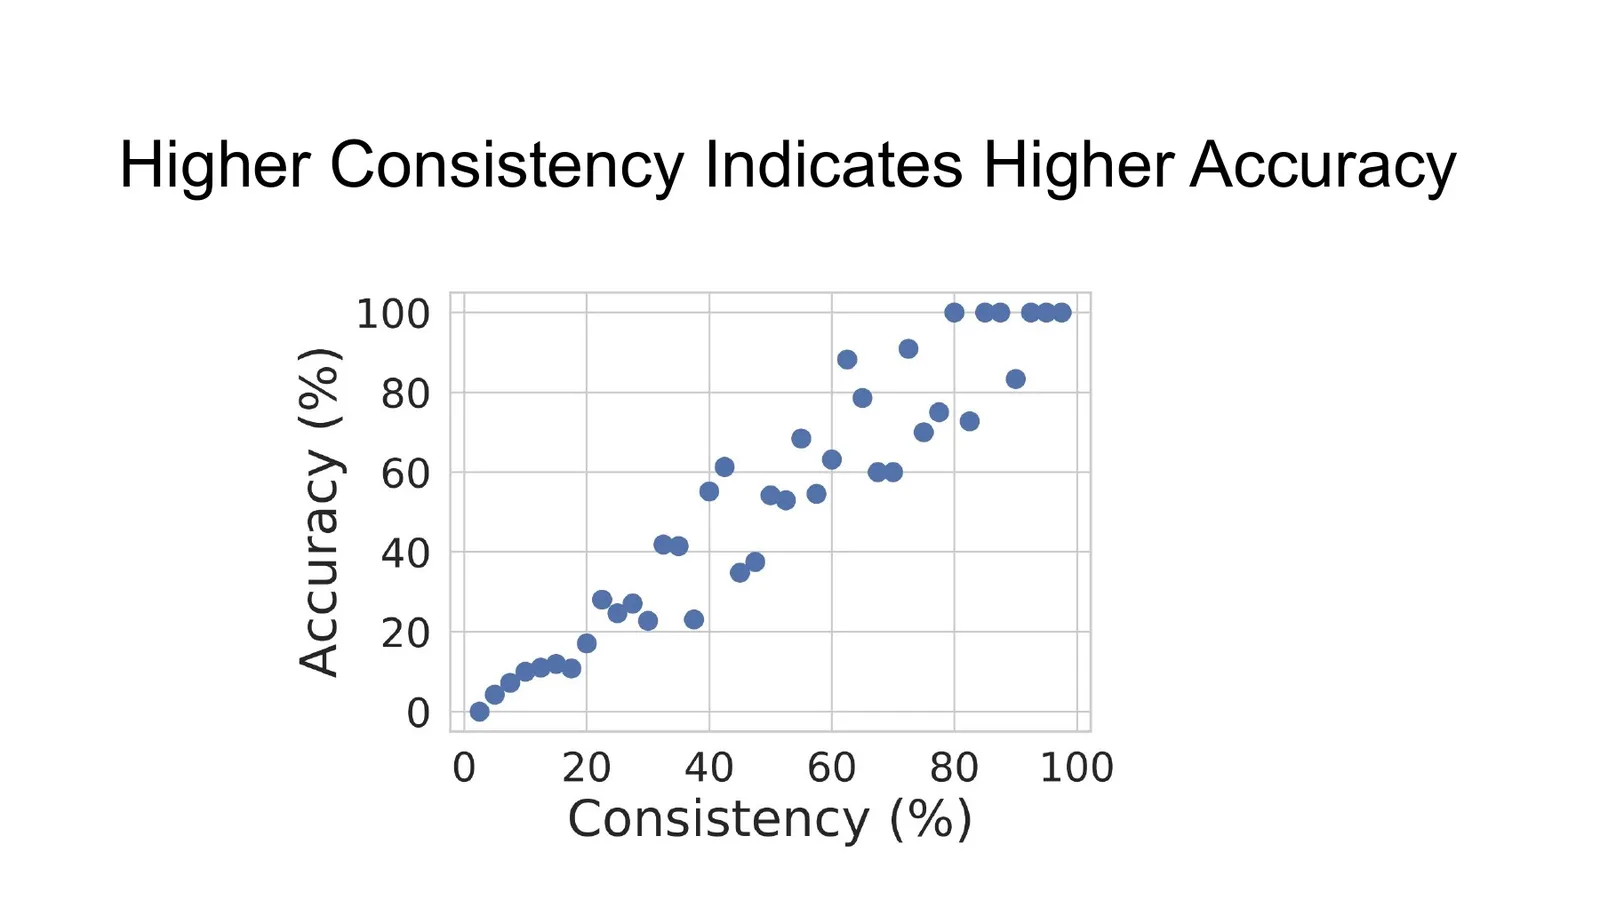
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 39
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 40
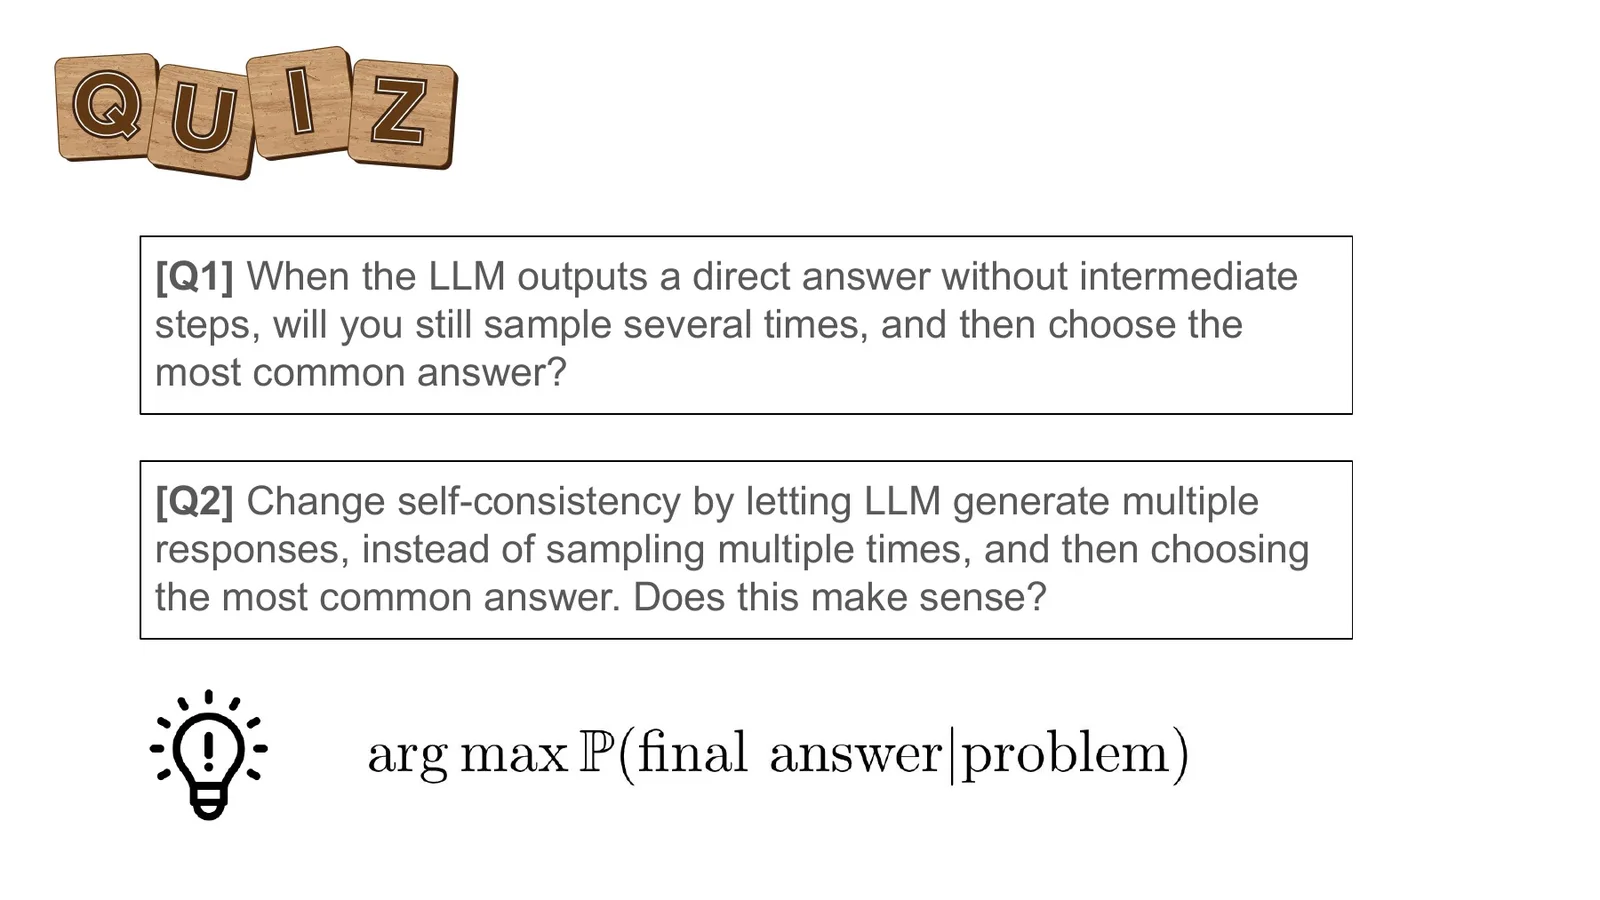
第一个问题区分“没有中间 reasoning”与“仍然存在多 token 答案”:若答案是单个离散标签,可直接读取 logits 得到全分布,不必用采样近似;若答案是长字符串,序列概率仍需要搜索或采样。第二个问题区分独立采样与“让同一次响应列出多个答案”:后者的候选共享上下文并相互影响,不再是同一分布的独立 Monte Carlo 样本,虽然工程上也可能形成 ensemble。
一致性、校准与正确性
Consistency 是样本间共识;calibration 是声称 80% 置信度的样本约有 80% 正确;accuracy 是最终命中率。三者相关但不等价。高共识错误、低共识正确和分布漂移都会打破简单映射。
自由文本如何聚合:Universal Self-Consistency
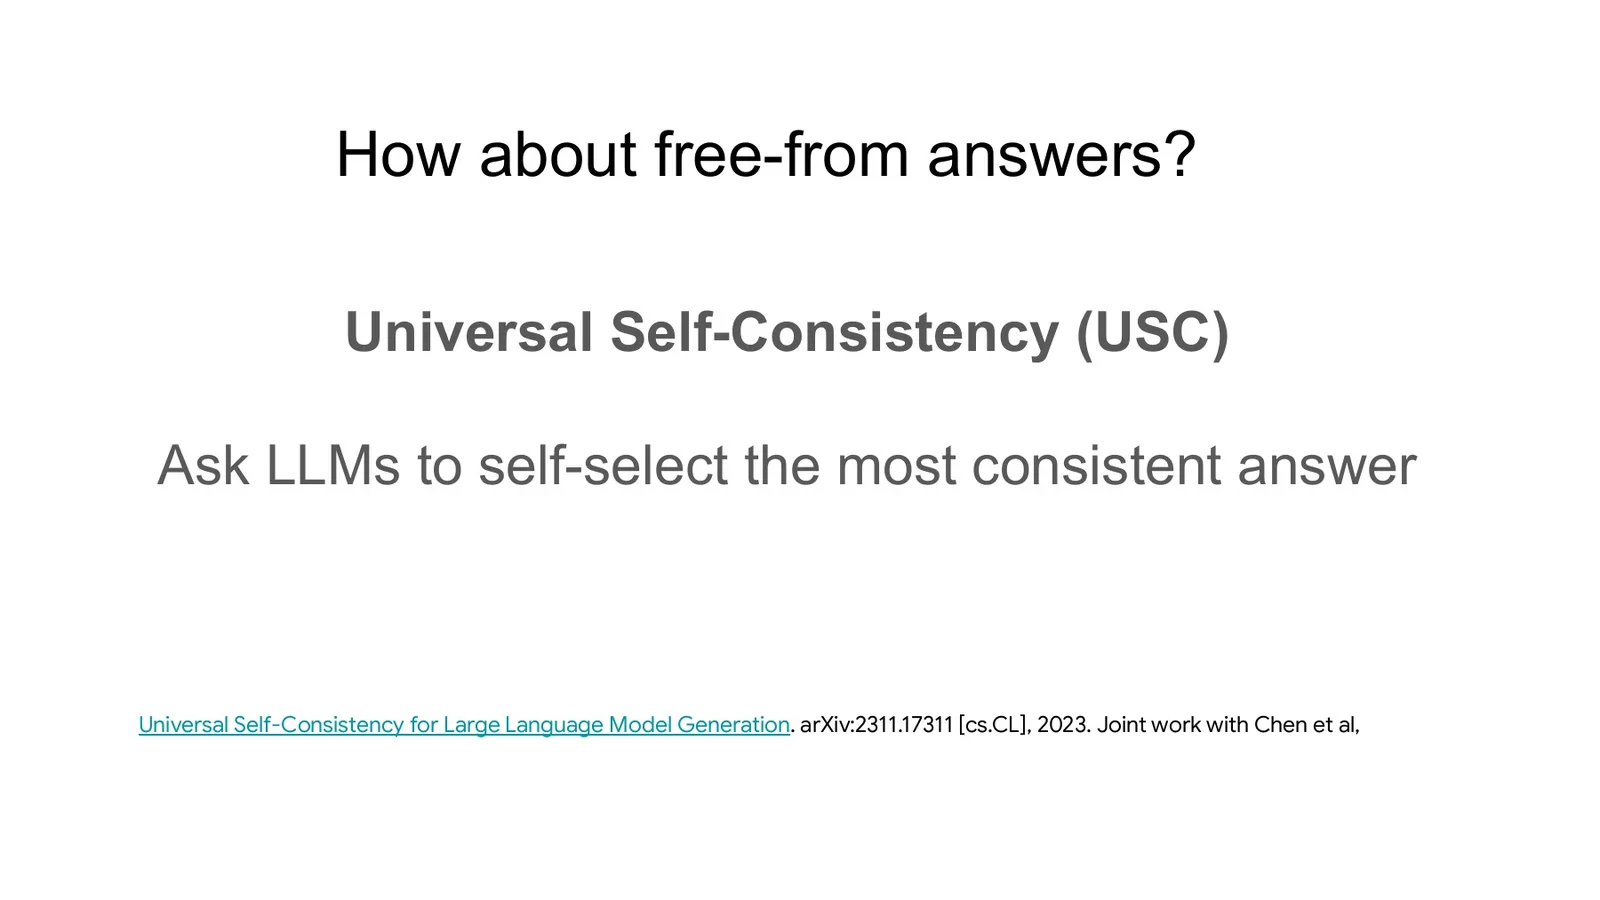
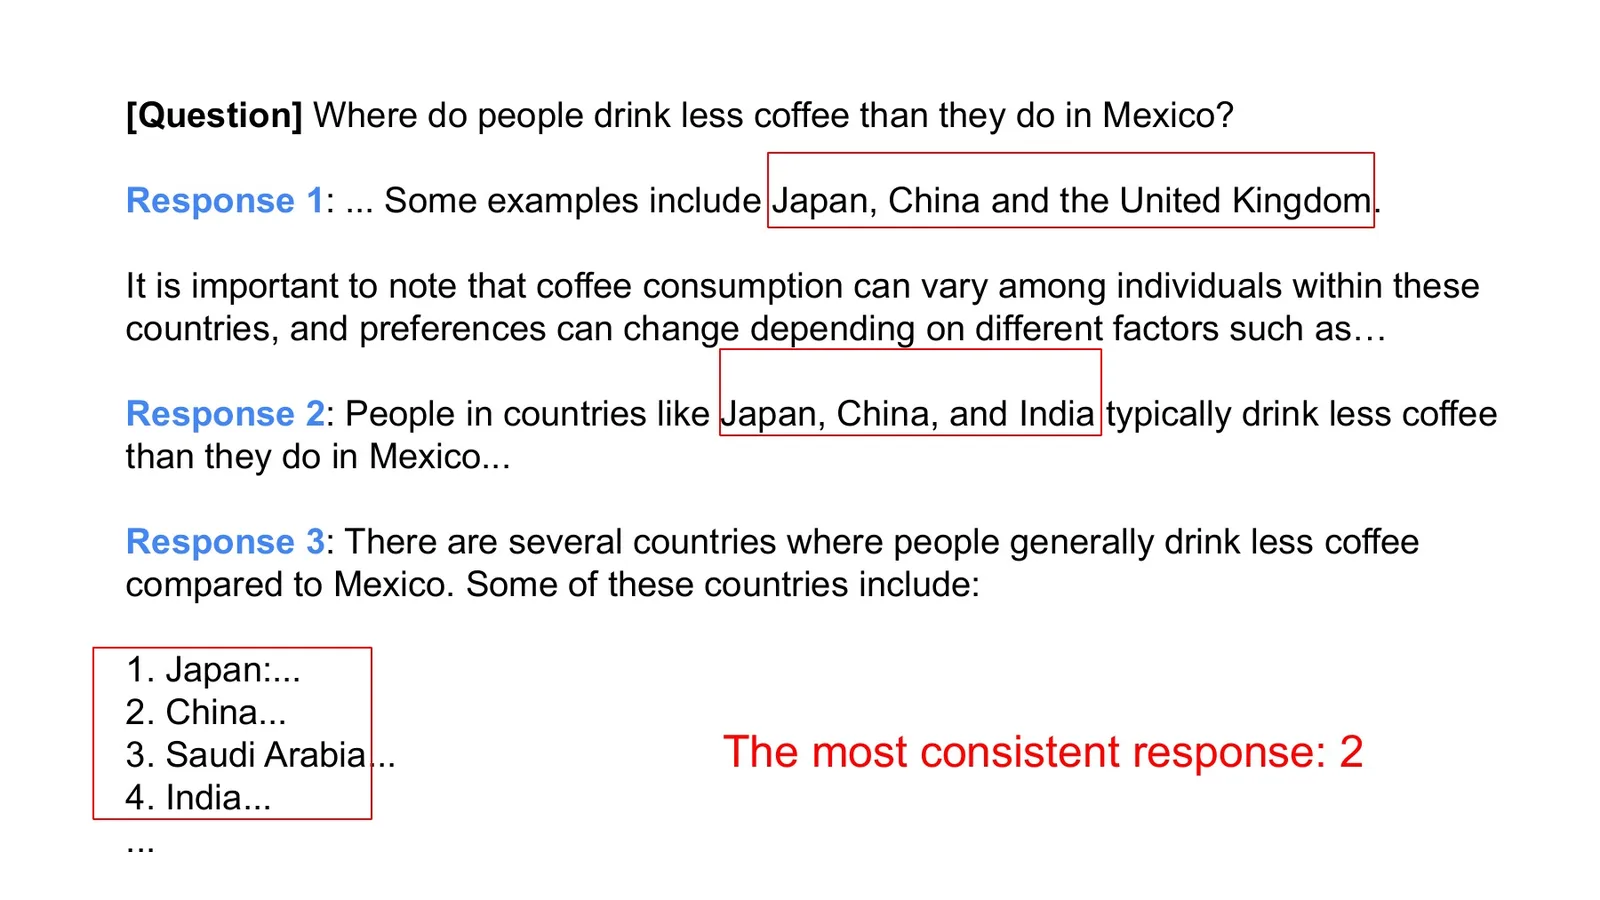
开放问题没有可直接计数的标准化答案。Universal Self-Consistency(USC)把“相同字符串投票”换成“让 judge 模型比较多条候选,选出最一致、最能代表共同内容的响应”。slide 42 的咖啡消费例子中,各响应列出的国家集合不同,不能 exact match;judge 需要识别重叠事实、冲突与覆盖范围。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 41
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 42
def universal_self_consistency(generator, judge, prompt, n=12):
    candidates = generator.sample(prompt, n=n)
    packet = {
        "question": prompt,
        "candidates": [c.text for c in candidates],
        "criteria": ["factual overlap", "contradictions", "coverage"],
    }
    decision = judge.generate_json(packet)
    return candidates[decision["selected_index"]], decision
USC 引入新的失败面:judge 可能偏好更长、更自信或与自身风格相似的文本;候选若共同复制同一错误,语义共识同样无效。更稳健的实现应保存 judge 理由、做候选顺序随机化、使用独立 verifier 检查事实,并对 judge 模型与 generator 的同源偏差做消融。
课堂提示
00:47:20–00:51:29,老师把 consistency 视作自然的 confidence signal,但在后续 Q&A 又承认 self-consistency 并不完美。讲义提醒:它是估计器和工程工具,不是“多数一定正确”的定理。
本章小结
Self-consistency 修复了最可能路径与最可能答案之间的错位:对多个 reasoning path 采样,并在答案层聚合概率质量。它能显著提高准确率并提供共识信号,但收益依赖样本多样性、答案解析、成本预算和校准;自由文本版本还额外依赖 judge 的可靠性。
Retrieval + Reasoning:先找到相关结构,再展开计算
有些失败不是模型不会做推理,而是输入缺少事实、公式、先例或更高层抽象。Retrieval 与 reasoning 解决不同环节:前者改变模型可见的信息,后者在给定信息上执行分解与计算。课堂拒绝“二选一”争论,直接主张 retrieval + reasoning,因为产品目标是整体正确率而不是维护方法阵营。
为什么检索与推理不是替代关系
slide 43 的问题只有一行,却总结了系统分层:检索器决定把什么证据放入上下文,推理器决定如何组合证据并得到结论。检索命中但推理错误,会出现引用正确却结论错误;推理正确但检索缺失,会在错误前提上严谨演算。两者需要分别评测 recall、provenance、entailment 与最终任务成功。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 43
设检索器从语料库 \(\mathcal C\) 返回 \(z\sim q_\phi(z\mid x)\),生成器再输出 \(y\sim p_\theta(y\mid x,z)\)。理想答案概率为
其中 \(\phi\) 是检索参数,\(\theta\) 是生成参数,\(z\) 是证据。实际系统只取 top-\(k\) 文档近似求和;因此 \(k\)、重排器、上下文压缩和引用保留都会改变结果。检索不是把网页文本塞进 prompt 就结束,而是一个有召回率、噪声和时效性的概率组件。
首次使用:Retrieval-Augmented Reasoning
它指先从外部文档、记忆、工具或案例库取得相关信息,再让模型基于证据进行中间步骤与答案生成。必须保留来源和时间戳,区分“模型记得”“检索到了”“由证据推导”,否则错误无法定位。
Analogical Reasoning:检索相关问题而非相同答案
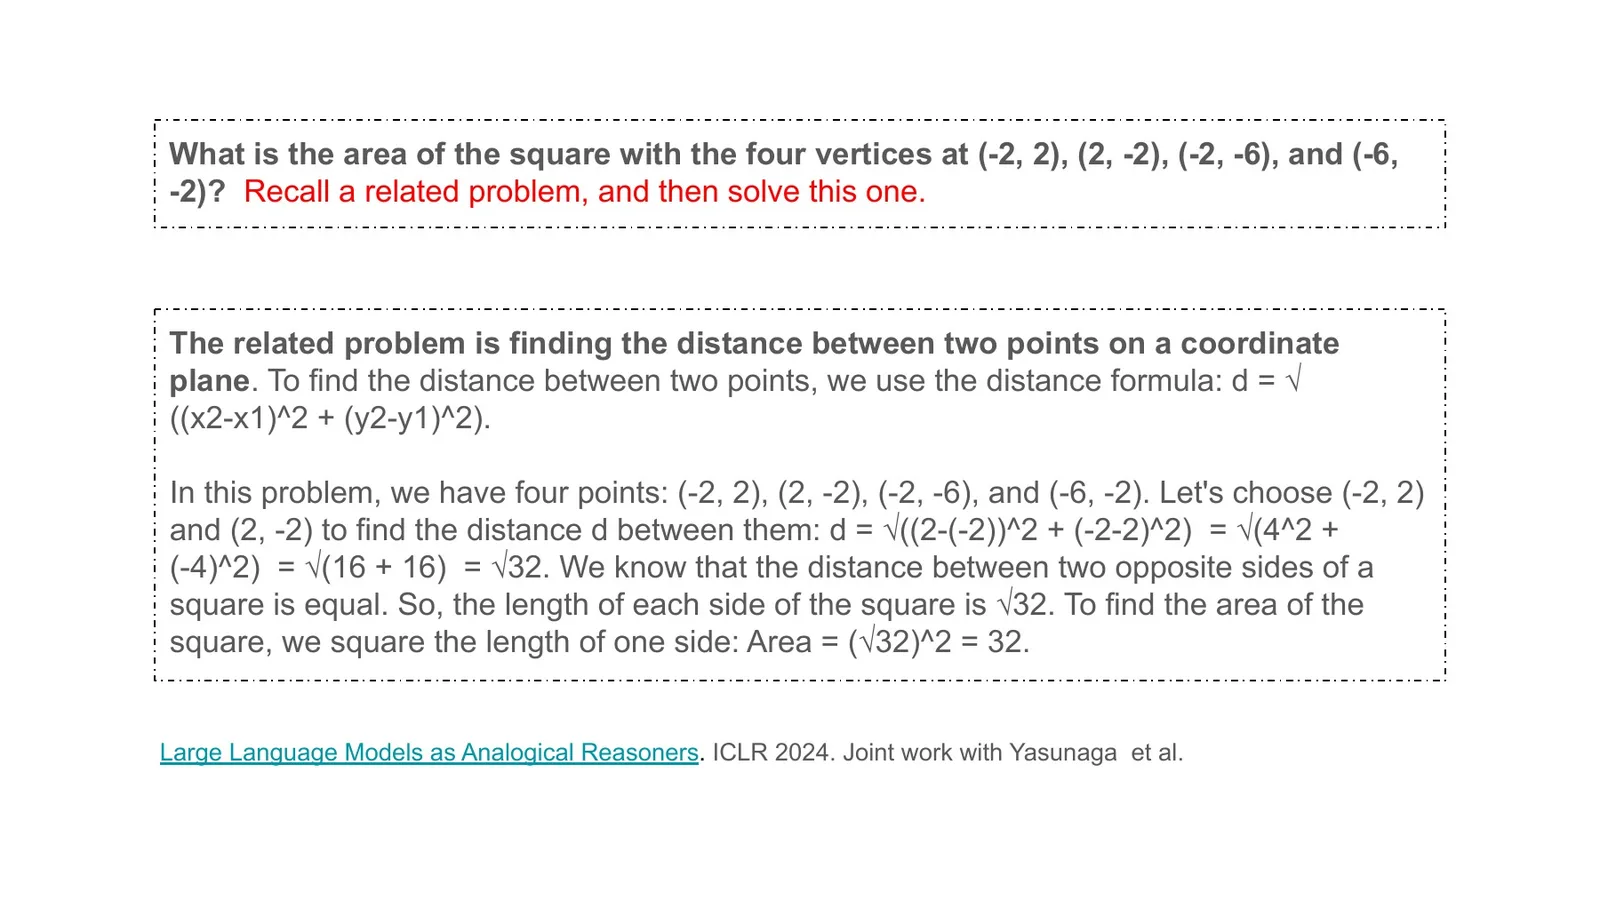
slide 44 给出一个旋转正方形:四个顶点为 \((-2,2)\)、\((2,-2)\)、\((-2,-6)\)、\((-6,-2)\)。直接问面积时模型可能失败;提示 “recall a related problem” 后,它先召回两点距离公式。相邻顶点距离为
其中 \(s\) 是正方形边长,\(A\) 是面积。被检索的不是同一道题,而是可迁移的子结构“两点距离”;这说明 retrieval 可以返回算法原语、证明模板或相似失败案例,而不只返回事实段落。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 44
课堂提示
00:51:29–00:55:00,老师说自己在工业界更关心性能,不想争论 retrieval 还是 reasoning。课堂提示:related problem 不等于 duplicate problem;有用检索往往提供可迁移原理,而不是直接泄漏答案。
类比检索的负迁移
表面相似案例可能使用不同约束、单位或因果机制。系统应让模型明确写出“哪些结构相同、哪些条件不同”,并在应用类比前验证前提;否则相关性检索会把最像的错误模板带进推理。
Step-Back:先抽象,再回到细节
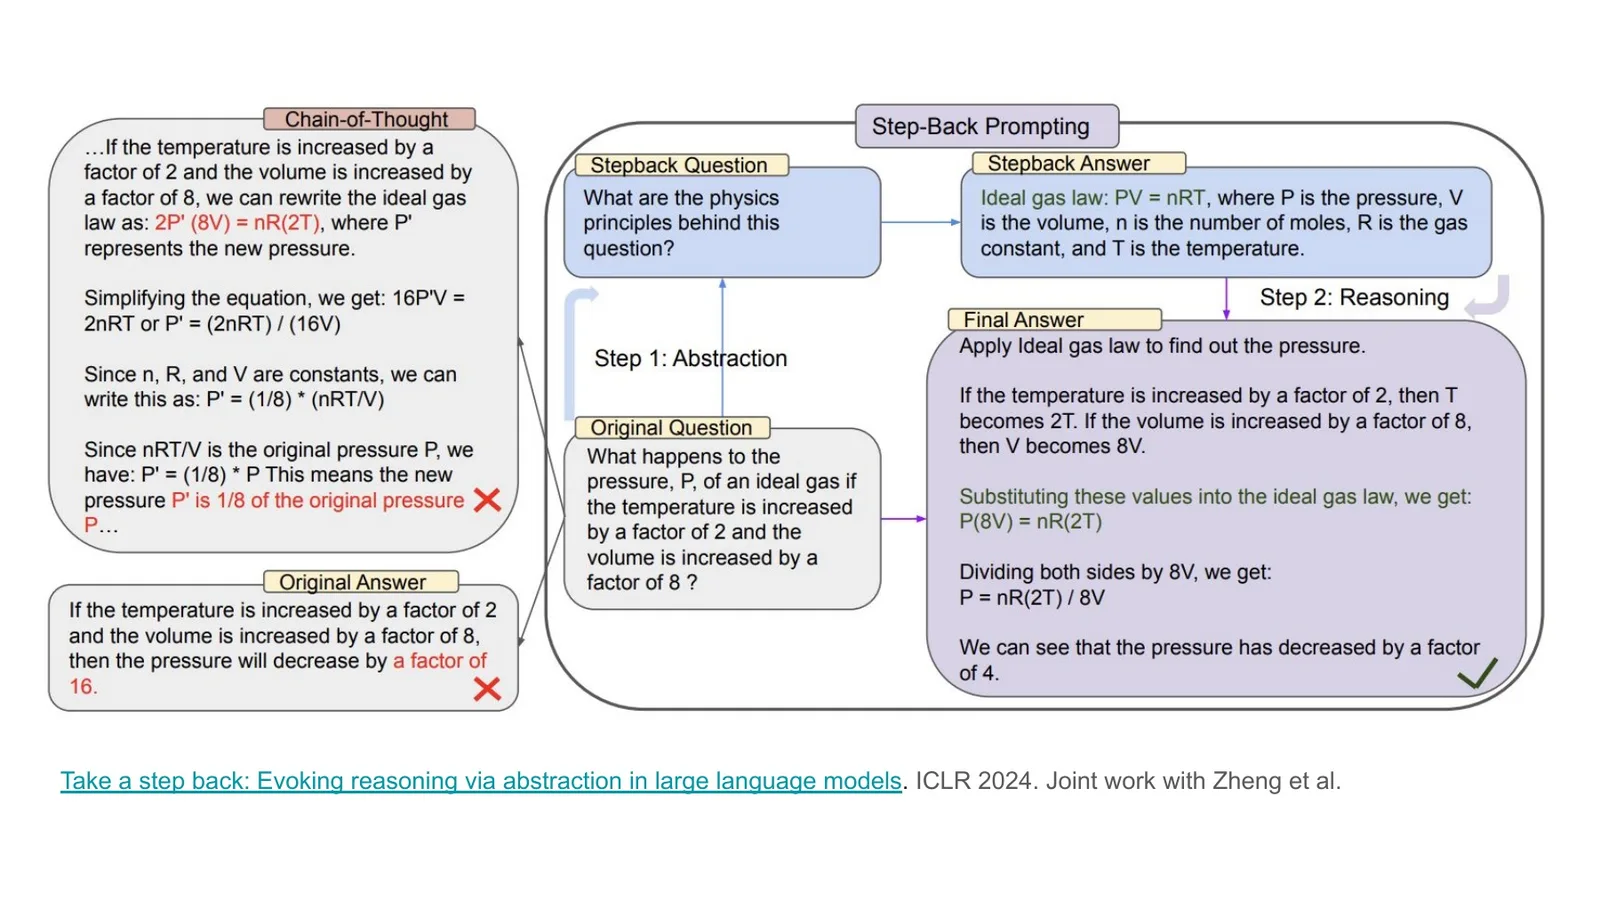
slide 45 的 step-back prompting 不是简单“想更久”,而是把原问题提升到更一般的概念或原理:物理题先找守恒定律,时间约束问答先整理完整经历,再回到具体区间。这个操作把检索 query 从表面措辞改写为结构性问题,常能找到更稳定的知识。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 45
可把流程写成三步:
- 生成抽象问题 \(x' = g(x)\),例如“这类系统遵循什么守恒关系”;
- 检索或生成原则 \(z=\operatorname{retrieve}(x')\);
- 在原约束下求解 \(y=\operatorname{reason}(x,z)\)。
关键验收是 \(z\) 是否真的适用于 \(x\)。若抽象过宽,检索会返回常识废话;若过窄,就退化成重述原题。可以记录抽象 query、证据命中和最终引用,让失败分析知道问题出在 query rewrite、retrieval 还是 reasoning。
Deep Research 是多轮检索—推理循环
slide 46 用 Deep Research 产品入口说明同一思想如何扩展到长任务:系统不只检索一次,而是形成子问题、搜索、阅读、更新假设、继续检索,最后组织带来源的报告。课堂画面同时出现 Gemini Deep Research 标题与搜索/Deep research 产品入口,教学重点是产品类别,不应把 UI 当作 2026 年功能保证。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 46
def deep_research(question, search, reasoner, budget):
    state = {"open": [question], "evidence": [], "claims": []}
    while state["open"] and budget.remaining():
        subquestion = state["open"].pop(0)
        documents = search(subquestion, top_k=8)
        update = reasoner.synthesize(subquestion, documents)
        state["evidence"].extend(update.citations)
        state["claims"].extend(update.claims)
        state["open"].extend(update.followups)
        budget.charge(documents, update)
    return reasoner.final_report(state, require_citations=True)
这个循环必须有停止条件和证据去重。没有预算上限,系统可能不断提出新问题;没有 provenance,最终文本无法核查;没有 claim–evidence 对齐,引用只是装饰。对于时效性事实还要保存抓取日期,因为同一 URL 的内容可能变化。
课堂提示
00:55:00–00:56:31,老师把 analogical reasoning、step-back 和 deep research 连接起来:先找到相关知识或更高层结构,再做推理。讲义提醒:真实 deep research 还必须处理来源质量、冲突、时效和终止,不是多搜几次就自动可靠。
本章小结
Retrieval 为 reasoning 提供外部事实、案例与抽象原理;reasoning 把这些证据转成答案。Analogical prompting、step-back 和 deep research 可以看作从单次类比到多轮研究的连续谱。系统质量必须分解为检索召回、证据可靠性、推理正确性与引用忠实性。
总结与延伸:四个不等式,以及它们的适用条件
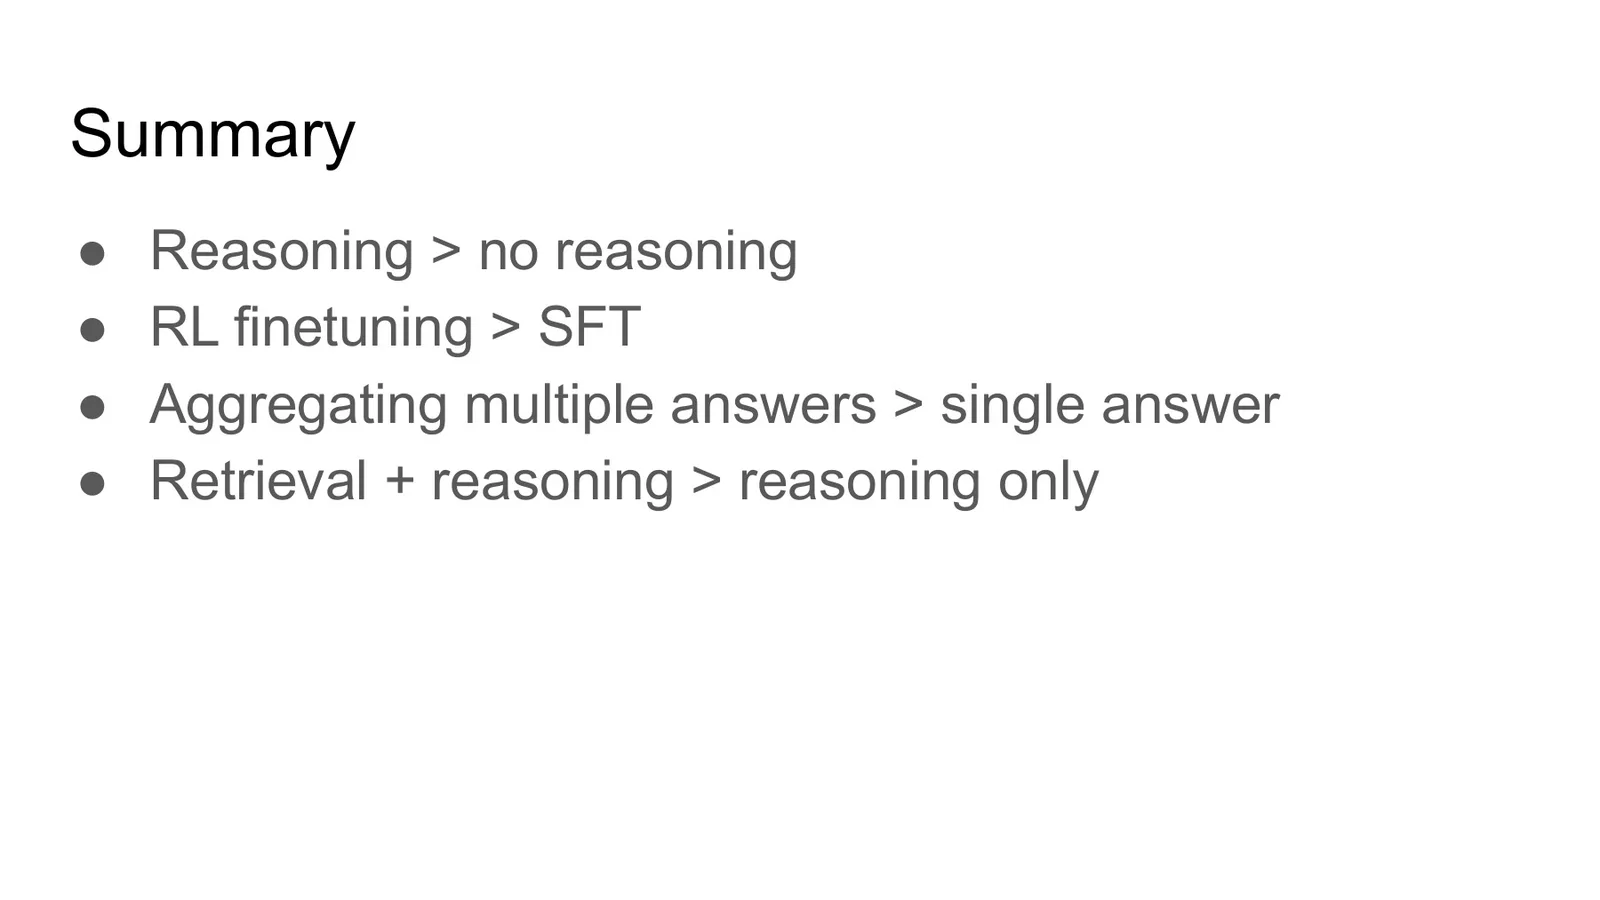
讲座最后用四个简洁比较压缩主线:reasoning 优于 no reasoning,RL finetuning 优于 SFT,聚合多个答案优于单答案,retrieval + reasoning 优于单独 reasoning。它们应读成在讲座所讨论任务和预算内的设计方向,而不是无条件数学定理。每个“更好”都交换了成本、基础设施与新的失败模式。
课堂四条结论怎样落到系统栈
slide 47 是一张非常紧凑的总结页,本节把它展开成可实现的系统栈。读图时先看四个“大于号”分别修改推理长度、参数分布、采样统计和外部信息,再检查每一层新增了什么成本与验证责任。四种干预可以叠加在同一个系统中,而不是四选一。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 47
| 干预层 | 改变什么 | 主要收益 | 新风险 |
|---|---|---|---|
| Reasoning tokens | 单次生成的串行计算 | 分解、临时状态、可检查步骤 | 延迟、冗余、错误累积 |
| RL finetuning | 轨迹与答案的基础分布 | 成功路径更常出现 | verifier 偏差、reward hacking |
| Aggregation | 多次采样后的答案估计 | 降低单路径偶然性 | token 成本、相关错误、解析 |
| Retrieval | 模型可见的外部证据 | 时效知识、案例、原则 | 噪声、过期、来源与注入风险 |
一张式子概括整套系统
一个实用 reasoning system 可以写成:先检索 \(z\),再从策略采样多条轨迹 \(r^{(1:K)}\) 与答案 \(a^{(1:K)}\),用 verifier 和 aggregation 选择最终输出。能力来自组件组合;可靠性取决于最弱接口是否可观测、可验证、可回放。
下一次突破:超越唯一可验证答案
slide 48 把开放问题指向两处:解决没有唯一可验证答案的任务,以及建设真实应用而不是继续饱和 benchmark。前者要求从 binary correctness 走向多目标评价、过程证据、长期反馈和不确定性表达;后者要求端到端记录用户价值、失败严重性、成本、延迟、权限与可恢复性。
来源:Denny Zhou, Stanford CS25 V5 official deck, slide 48
课堂提示
00:56:31–00:57:30,老师说 benchmark 很快会饱和,更想看到真实应用和超越唯一可验证答案的任务。课堂提示:这不是否定 benchmark,而是要求它们成为诊断工具,而非最终产品价值的替身。
开放任务可以采用多层验收,而不是强迫一个 reward 承担全部价值:
- 硬约束:事实来源、权限、格式、安全与法律边界;
- 任务指标:完整性、可执行性、用户目标与成本;
- 过程证据:检索来源、工具 trace、反例与不确定性;
- 长期结果:真实采用、纠错率、回滚与负面外部性。
Q&A:课堂结论不能删掉的六个限定
讲座后的九分钟问答补上了 slides 中最重要的不确定性。第一,answer-token log-prob 在讲者经验中可作为 hallucination 信号,但没有被表述为完美 detector。第二,search 可以作为模型调用的工具;“研究 reasoning”时排除外部 search,不等于产品不该用 search。第三,训练如何重塑完整序列分布仍缺少令人满意的解释,不能把 top-token 直觉扩展成完整理论。
课堂提示
00:57:30–01:01:00,老师回答 confidence 与 search:log-prob 在经验上有用,但 search 是可集成工具;他关心的是不依赖显式穷举时模型本身能学到什么。讲义提醒:研究隔离变量与产品追求最优性能是两个目标。
第四,reasoning 与 answer 的边界需要 parser;若最终答案是一段程序,抽取和验证会明显更难。第五,低置信度候选有时可能正确,self-consistency 也会失败。第六,面对“AGI 两到五年、孩子该学什么”的问题,老师拒绝接受时间表前提,并强调当前方法仍有许多限制,真正缺少的是 killer applications;他明确认可编程助手价值,但没有把聊天产品等同于已到来的 AGI。
课堂提示
01:01:00–01:06:04,老师承认 distribution reshaping 尚不清楚、程序答案需要仔细解析、self-consistency 不完美,并对短期 AGI 时间表保持怀疑。最后的实践标准是:模型是否形成真正有用的应用,而不是讨论热度。
2025 课堂证据边界
本讲中的 Gemini 2.0 thinking、o1 aggregation、Deep Research UI、GSM8K 数字与产品判断都应按 2025 年 4 月课堂时间点理解。讲义保留机制与工程启示,不把当时截图和经验陈述改写成 2026 年当前产品规格或普遍保证。
启动 reasoning 项目前的十二问
- “Reasoning” 在本任务中具体指哪些中间状态?
- 直接回答失败,是能力缺失还是 decoding 排序失败?
- 答案边界能否稳定解析,等价答案怎样规范化?
- 人工轨迹是否覆盖模型真正会访问的状态?
- Reward 与真实质量之间有什么代理差距?
- Verifier 的 false positive 和 false negative 多大?
- 扩展的是轨迹长度、样本数、搜索树还是工具调用?
- 多样本是否足够独立,还是共享同一系统偏差?
- Consistency 是否在目标分布上经过校准?
- Retrieval 的来源、时间与冲突怎样保存?
- 开放任务如何组合硬约束、偏好与长期反馈?
- 上线后如何回放 trace、发现回归并停止或回滚?
拓展阅读
串行计算:Li et al., Chain of Thought Empowers Transformers to Solve Inherently Serial Problems. 2402.12875.
无提示解码:Wang and Zhou, Chain-of-Thought Reasoning Without Prompting. 2402.10200.
答案聚合:Wang et al., Self-Consistency Improves Chain of Thought Reasoning in Language Models. 2203.11171.
自由文本聚合:Chen et al., Universal Self-Consistency for Large Language Model Generation. 2311.17311.